분산에 대한 카이제곱 검정
분산에 대한 카이제곱 검정은 모집단의 분산이 지정된 값과 다른지 판정한다. 모분산이 알려져 있거나 가설로 주어질 때 적용하는 일표본 검정이다. 이 검정은 자료가 정규분포를 따른다는 가정에 매우 민감하며, 정규성에서 크게 벗어나면 결과를 신뢰할 수 없다.
가설
분산에 대한 카이제곱 검정의 가설은 다음과 같이 세운다.
귀무가설 (\(H_0\)): 모분산 \(\sigma^2\)이 지정된 값 \(\sigma_0^2\)과 같다.
대립가설 (\(H_1\)): 모분산이 지정된 값 \(\sigma_0^2\)과 다르다. 양측검정인지 단측검정인지에 따라 다음과 같이 표현한다.
- 양측검정 (분산이 단지 다르다):
- 단측검정 (분산이 지정된 값보다 크거나 작다):
가정
분산에 대한 카이제곱 검정이 타당하려면 다음 가정이 충족되어야 한다.
- 자료가 정규분포를 따르는 모집단에서 추출되어야 한다. 이 검정은 정규성 이탈에 로버스트하지 않으므로 이 가정이 결정적이다.
- 표본이 독립인 관측값으로 이루어져야 한다.
- 모분산 \(\sigma^2\)이 지정된 값 \(\sigma_0^2\)과 같다는 가설을 세운다.
이 가정들, 특히 정규성 가정이 위배되면 검정 결과가 오도할 수 있다.
검정통계량
분산에 대한 카이제곱 검정의 검정통계량은 표본분산 \(s^2\)과 가설 모분산 \(\sigma_0^2\)에 기반한다.
여기서
- \(n\)은 표본크기,
- \(s^2\)은 표본분산,
- \(\sigma_0^2\)은 가설 모분산이다.
귀무가설 아래에서 검정통계량 \(\chi^2\)은 자유도 \(n-1\)인 카이제곱분포를 따른다. 자유도는 표본크기를 반영하며, 표본이 클수록 분산 추정이 정밀해진다.
기각역과 판정규칙
귀무가설을 기각할지 판정하려면 검정통계량을 카이제곱분포의 임계값과 비교한다. 임계값은 유의수준 \(\alpha\)와 자유도 \(n-1\)에 의존한다.
양측검정에서는 카이제곱분포의 아래 꼬리와 위 꼬리를 모두 확인한다.
계산된 검정통계량이 이 범위 안에 있으면 귀무가설을 기각하지 못한다. 범위를 벗어나면 \(H_0\)을 기각한다.
양측검정에서는 꼬리마다 \(\alpha/2\)를 써야 한다
양측검정에서 흔한 실수는 양쪽 임계값을 각각 \(\alpha\) 수준의 값으로 잡는 것이다. 예컨대 \(\alpha = 0.05\), \(\text{df} = 24\)에서 \(13.848\)과 \(36.415\)를 쓰는 경우가 있는데, 이 둘은 각각 하단 5%와 상단 5% 지점이므로 합치면 10% 검정이 된다.
올바른 5% 양측 임계값은 각 꼬리에 2.5%씩 배분한 \(12.401\)과 \(39.364\)이다.
이 실수가 왜 검정을 두 배로 헐겁게 만드는지는 그림으로 보면 분명하다. 아래 두 그림은 같은 분포, 같은 자료, 같은 \(\alpha = 0.05\)를 쓴다. 다른 것은 임계값을 어디에 긋느냐뿐이다.
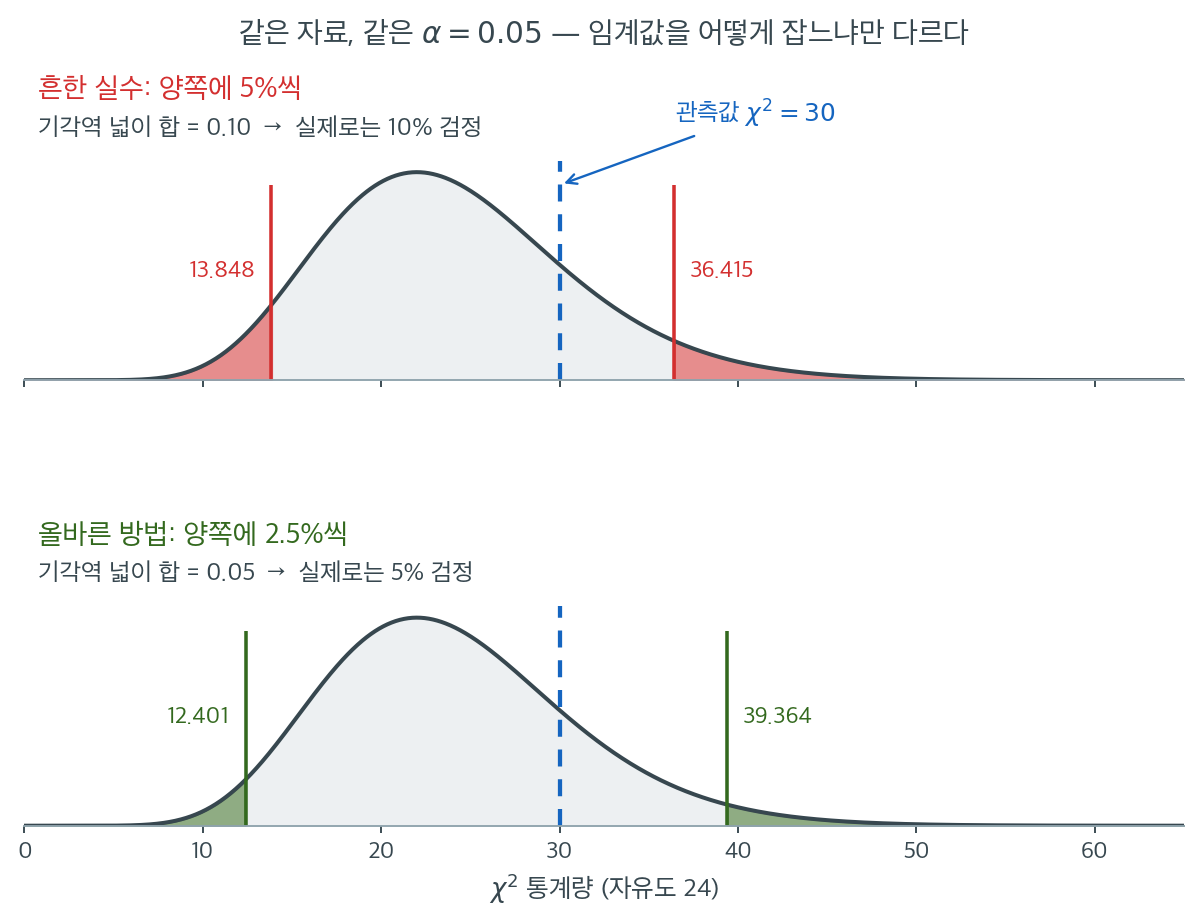
위 그림은 각 꼬리에 5%씩 잘라 \(13.848\)과 \(36.415\)를 임계값으로 삼았다. 두 붉은 영역의 넓이를 더하면 \(0.05 + 0.05 = 0.10\)이다. \(\alpha = 0.05\)라고 부르면서 실제로는 10% 검정을 하고 있는 것이다. 제1종 오류율이 약속의 두 배다.
아래 그림이 올바른 배분이다. 각 꼬리에 2.5%씩 주어 \(12.401\)과 \(39.364\)를 쓰면 기각역의 넓이 합이 정확히 \(0.05\)가 된다. 두 그림을 겹쳐 보면 올바른 임계값 쌍이 바깥으로 더 벌어져 있다. 같은 총 오류율을 두 꼬리가 나눠 가져야 하니 각 꼬리가 더 얇아지고, 그만큼 임계값이 밖으로 밀리는 것이다.
카이제곱분포가 대칭이 아니라는 점이 이 그림에서 또 하나 드러난다. 하단 임계값은 \(12.401 \to 13.848\)로 \(1.4\)만 움직이는데 상단은 \(36.415 \to 39.364\)로 \(2.9\)나 움직인다. 오른쪽 꼬리가 길게 늘어져 있어 같은 확률을 떼어 내려면 더 멀리 가야 하기 때문이다. 평균 검정의 \(\pm t_{\alpha/2}\)처럼 한 숫자로 양쪽을 처리할 수 없는 이유가 여기 있다.
파란 점선이 보기 1의 관측값 \(\chi^2 = 30\)이다. 두 그림 모두에서 채택역 안에 들어 있으므로 이 자료에서는 판정이 바뀌지 않는다. 그러나 통계량이 \(37\)이었다면 잘못된 방식은 기각하고 올바른 방식은 기각하지 못한다. 임계값을 잘못 잡은 검정은 틀린 답을 낼 때까지 틀린 줄 모른다.
단측검정에서는 분포의 한쪽 끝만 확인한다.
- \(H_1: \sigma^2 > \sigma_0^2\)을 검정한다면 검정통계량을 상단 임계값과 비교한다.
- \(H_1: \sigma^2 < \sigma_0^2\)을 검정한다면 하단 임계값과 비교한다.
임계값은 카이제곱분포표에서 얻으며 원하는 유의수준(흔히 \(\alpha = 0.05\))에 의존한다.
보기 1. 공장이 주장하는 중량 분산. 어떤 공장이 제품 중량의 분산이 \(0.04\) 그램\(^2\)이라고 주장한다. 제품 \(25\) 개를 표본으로 뽑았더니 표본분산이 \(0.05\) 그램\(^2\)이었다.
(1) 유의수준 \(5\%\) 에서 모분산이 \(0.04\) 그램\(^2\) 과 다른지 검정하시오. 통계량·임계값·양측 \(p\) 값을 모두 적을 것.
(2) 위 경고대로 꼬리마다 \(\alpha\) 를 통째로 주면 실제 유의수준이 얼마가 되는지 구하고, 두 규칙의 판정이 갈리는 \(\chi^2\) 값의 구간을 밝히시오. 이 자료에서는 판정이 바뀌는가.
풀이
(1) 단계별로.
1단계 — 가설 설정.
분산이 크든 작든 "주장과 다르다"가 관심이므로 양측검정이다.
2단계 — 검정통계량. \(n = 25\), \(s^2 = 0.05\), \(\sigma_0^2 = 0.04\) 를 추축량에 넣는다.
\(H_0\) 아래에서 이 값은 \(\chi^2_{24}\) 를 따른다. 이 사실이 정규모집단에서만 참이라는 것은 15.2절이 유도해 두었다.
3단계 — 임계값. 자유도 \(24\), \(\alpha = 0.05\) 를 양쪽 꼬리에 \(0.025\) 씩 나눈다.
- 하단 임계값 \(\chi^2_{0.975,\,24} = 12.401\)
- 상단 임계값 \(\chi^2_{0.025,\,24} = 39.364\)
4단계 — 판정. \(12.401 < 30 < 39.364\) 이므로 채택역 안이다. \(H_0\) 을 기각하지 못한다.
양측 \(p\) 값은 작은 쪽 꼬리의 두 배다. \(P(\chi^2_{24} \le 30) = 0.8152\) 이고 \(P(\chi^2_{24} \ge 30) = 0.1848\) 이므로 오른쪽이 작고
이다.
5단계 — 결론. 유의수준 \(5\%\) 에서 모분산이 \(0.04\) 그램\(^2\) 과 다르다고 볼 증거가 충분하지 않다. \(p = 0.37\) 로 문턱에서 한참 멀다.
(2) 꼬리마다 \(\alpha\) 를 주면 크기가 정확히 두 배가 된다. 잘못된 규칙은 \(\chi^2 < \chi^2_{0.95,\,24}\) 또는 \(\chi^2 > \chi^2_{0.05,\,24}\) 로 기각한다. 두 사건이 서로 배반이므로 크기가
이다. \(\alpha = 0.05\) 라 부르면서 실제로는 \(10\%\) 검정을 하는 것이고, 이 두 배는 근사가 아니라 정확하다.
판정이 갈리는 구간. 두 규칙은 모두 "양쪽 바깥이면 기각"인데 잘못된 쪽의 경계가 안쪽에 있으므로, 잘못된 쪽이 더 많이 기각한다. 갈리는 자리는 두 경계 사이의 띠 둘이다.
\(H_0\) 아래에서 통계량이 이 띠에 떨어질 확률은 두 크기의 차 \(0.10 - 0.05 = 0.05\) 다. 스무 번에 한 번은 두 규칙이 서로 다른 답을 낸다.
관측값 \(30\) 은 두 띠 어디에도 들어 있지 않으므로 이 자료에서는 판정이 바뀌지 않는다. 둘 다 기각하지 못한다. 통계량이 \(37\) 이었다면 갈렸을 것이다.
확인한다.
from scipy import stats

df, alpha = 24, 0.05
lower = stats.chi2.ppf(alpha / 2, df)
upper = stats.chi2.ppf(1 - alpha / 2, df)
print(f"lower = {lower:.4f}, upper = {upper:.4f}")

# 관측된 통계량과 양측 p-값
n, s2, sigma2_0 = 25, 0.05, 0.04
T = (n - 1) * s2 / sigma2_0
rv = stats.chi2(df=df)
print(f"\nT = (24 x 0.05) / 0.04 = {T:.4f}")
print(f"  왼쪽 꼬리 P(chi2_24 <= T) = {rv.cdf(T):.4f}")
print(f"  오른쪽 꼬리 P(chi2_24 >= T) = {rv.sf(T):.4f}")
print(f"  양측 p = 2 x {min(rv.cdf(T), rv.sf(T)):.4f} = {2 * min(rv.cdf(T), rv.sf(T)):.4f}")
print(f"  판정: {'기각' if (T < lower or T > upper) else '기각 못함'}")

# 꼬리마다 alpha 를 통째로 주면 어떻게 되는가.
w_lo = stats.chi2.ppf(alpha, df)
w_hi = stats.chi2.ppf(1 - alpha, df)
print(f"\n잘못된 임계값(꼬리마다 5%) = {w_lo:.4f}, {w_hi:.4f}")
print(f"  그 규칙의 실제 크기 = {rv.cdf(w_lo) + rv.sf(w_hi):.4f}")
print(f"  올바른 규칙의 크기  = {rv.cdf(lower) + rv.sf(upper):.4f}")
dis = (rv.cdf(w_lo) - rv.cdf(lower)) + (rv.cdf(upper) - rv.cdf(w_hi))
print(f"  두 규칙이 갈리는 구간 = [{lower:.4f}, {w_lo:.4f}) 와 ({w_hi:.4f}, {upper:.4f}]")
print(f"  H0 아래에서 거기 떨어질 확률 = {dis:.4f}")
for t in (13.0, 30.0, 37.0):
    a = "기각" if (t < lower or t > upper) else "기각 못함"
    b = "기각" if (t < w_lo or t > w_hi) else "기각 못함"
    print(f"    T = {t:5.1f}:  올바른 규칙 {a:>6s},  잘못된 규칙 {b:>6s}")
출력:
lower = 12.4012, upper = 39.3641

T = (24 x 0.05) / 0.04 = 30.0000
  왼쪽 꼬리 P(chi2_24 <= T) = 0.8152
  오른쪽 꼬리 P(chi2_24 >= T) = 0.1848
  양측 p = 2 x 0.1848 = 0.3695
  판정: 기각 못함

잘못된 임계값(꼬리마다 5%) = 13.8484, 36.4150
  그 규칙의 실제 크기 = 0.1000
  올바른 규칙의 크기  = 0.0500
  두 규칙이 갈리는 구간 = [12.4012, 13.8484) 와 (36.4150, 39.3641]
  H0 아래에서 거기 떨어질 확률 = 0.0500
    T =  13.0:  올바른 규칙  기각 못함,  잘못된 규칙     기각
    T =  30.0:  올바른 규칙  기각 못함,  잘못된 규칙  기각 못함
    T =  37.0:  올바른 규칙  기각 못함,  잘못된 규칙     기각
(1)과 (2)의 수가 모두 맞는다. 임계값 \(12.4012\) 와 \(39.3641\), 양측 \(p = 0.3695\), 잘못된 규칙의 크기 \(0.1000\), 갈리는 띠의 확률 \(0.0500\) 이다. 마지막 세 줄이 띠의 쓸모를 보여 준다. \(T = 13\) 은 아래쪽 띠 안이라 잘못된 규칙만 기각하고, \(T = 37\) 은 위쪽 띠 안이라 역시 잘못된 규칙만 기각하며, 실제 관측값 \(T = 30\) 은 어느 띠에도 없어 두 규칙이 같은 답을 낸다.
이것이 임계값 실수의 고약한 점이다. 스무 번에 열아홉 번은 두 규칙이 같은 답을 내므로 틀린 줄 모르고 지나간다. 그러다 통계량이 띠에 떨어진 바로 그 한 번에 잘못된 결론을 내는데, 그때도 자기 규칙이 틀렸다는 신호는 어디에도 나타나지 않는다. 임계값이 맞는지는 자료가 아니라 분포표에서 확인해야 한다.
위 띠의 너비가 아래 띠보다 넓다는 것도 눈여겨볼 만하다. 아래는 \(12.401\) 에서 \(13.848\) 까지 \(1.45\) 인데 위는 \(36.415\) 에서 \(39.364\) 까지 \(2.95\) 로 두 배가 넘는다. 같은 확률 \(0.025\) 를 떼어 내는 데 오른쪽에서는 더 멀리 가야 하기 때문이고, 이것이 \(\chi^2\) 분포의 오른쪽 치우침이다. 평균 검정의 \(\pm t_{\alpha/2}\) 처럼 한 숫자로 양쪽을 처리할 수 없는 까닭이 여기 있다.
분산의 신뢰구간
가설검정에 더해 카이제곱분포로 모분산의 신뢰구간을 구성할 수 있다. 모분산 \(\sigma^2\)의 \(100(1 - \alpha)\%\) 신뢰구간은
여기서 \(\chi^2_{\alpha/2,\,n-1}\)과 \(\chi^2_{1-\alpha/2,\,n-1}\)은 자유도 \(n-1\)인 카이제곱분포의 상단·하단 임계값이고 \(s^2\)은 표본분산이다.
앞의 보기에 적용하면 모분산의 95% 신뢰구간은
따라서 모분산의 95% 신뢰구간은 \(0.0305\)와 \(0.0968\) 그램\(^2\) 사이이다. 가설값 \(0.04\)가 이 구간에 포함되므로 앞의 검정 결과와 일관된다.
표준편차의 구간은 양 끝에 제곱근을 취하면 된다.
구간이 매우 넓다는 점에 주목하라. 상한이 하한의 1.8배이다. \(n = 25\)로는 분산을 정밀하게 추정할 수 없다는 뜻이며, 분산 추론에 큰 표본이 필요한 이유를 보여준다.
연습문제
연습문제 1. 어떤 품질관리 기술자가 제품 \(n = 25\)개의 중량을 측정하여 \(s^2 = 4.5\)를 얻었다. \(\alpha = 0.05\)에서 \(H_0: \sigma^2 = 3.0\)을 \(H_a: \sigma^2 > 3.0\)에 대해 검정하라.
풀이
검정통계량은
\(H_0\) 아래에서 \(\chi^2 \sim \chi^2_{24}\)이다. 상단 단측검정이므로 임계값은 \(\chi^2_{0.05, 24} = 36.415\)이다.
\(36.0 < 36.415\)이므로 5% 수준에서 \(H_0\)을 기각하지 못한다. 아슬아슬하다. \(p\)값은
로 0.05를 간신히 넘는다. 자료가 지정된 분산과 일관되지만 결과는 경계선상이다.
이런 상황에서는 이분법적 판정에 기대기보다 신뢰구간을 함께 보고하는 편이 낫다. \(\sigma^2\)의 90% 하단 신뢰한계는 \(24 \times 4.5/\chi^2_{0.10,24} = 108/33.196 = 3.253\)이므로, 실제로는 \(\sigma^2 > 3\)을 시사한다. \(p = 0.055\)와 \(p = 0.045\)를 질적으로 다르게 취급해서는 안 된다. \(\square\)
연습문제 2. 정규성 아래에서 \(S^2\)의 표집분포로부터 카이제곱 검정통계량을 유도하라.
풀이
\(X_1, \dots, X_n \sim N(\mu, \sigma^2)\)이면
이다. 자유도가 \(n\)이 아니라 \(n-1\)인 이유는 \(\mu\) 대신 \(\bar{X}\)를 썼기 때문이다. 편차 \(X_i - \bar{X}\)는 제약 \(\sum_i (X_i - \bar{X}) = 0\)을 만족하므로 자유롭게 변할 수 있는 성분이 \(n-1\)개뿐이다.
\(H_0: \sigma^2 = \sigma_0^2\) 아래에서 대입하면 \(\chi^2 = (n-1)S^2/\sigma_0^2 \sim \chi^2_{n-1}\)을 얻는다.
\(\chi^2\)이 크면 \(S^2 \gg \sigma_0^2\)을 뜻하고(\(\sigma^2 > \sigma_0^2\)의 증거), 작으면 \(S^2 \ll \sigma_0^2\)을 뜻한다. \(\square\)
연습문제 3. 분산에 대한 카이제곱 검정이 평균에 대한 \(t\) 검정보다 비정규성에 훨씬 민감한 이유를 설명하라.
풀이
\(t\) 검정에는 \(\bar{X}\)가 들어가는데, 중심극한정리에 의해 자료 분포와 무관하게 \(n\)이 어느 정도만 되면 근사적으로 정규이다. 카이제곱 검정에는 \(S^2 = \frac{1}{n-1}\sum(X_i - \bar{X})^2\)이 들어가는데, 제곱편차를 쓰므로 분포의 꼬리 거동에 직접 영향을 받는다.
꼬리가 두꺼운 분포는 이따금 극단적인 \((X_i - \bar{X})^2\) 값을 만들어 \(S^2\)을 부풀린다. 카이제곱 기준분포는 정규성을 가정하므로 이렇게 부풀려진 값들이 검정통계량을 지나치게 크게 만들고 과도한 기각(제1종 오류 팽창)으로 이어진다.
정량적으로는 \(\operatorname{Var}(S^2) \approx \sigma^4(\gamma_2+2)/n\)이므로 초과첨도 \(\gamma_2\)가 크면 \(S^2\)의 변동이 정규 이론값의 \((\gamma_2+2)/2\)배가 된다. \(\gamma_2 = 6\)인 지수분포 자료에서는 4배이다.
결정적인 점은 이 왜곡이 표본을 키워도 사라지지 않는다는 것이다. 팽창 인자 \((\gamma_2+2)/2\)는 \(n\)에 의존하지 않는다. 표본분산은 \(\bar{X}\)가 받는 것과 같은 중심극한정리의 보호를 받지 못한다. \(\square\)
연습문제 4. \(n = 20\), \(s^2 = 15\)일 때 \(\sigma^2\)의 95% 신뢰구간을 구성하라.
풀이
신뢰구간은 \((n-1)s^2/\sigma^2 \sim \chi^2_{n-1}\)에 기반한다.
\(n-1 = 19\)에서 \(\chi^2_{0.025, 19} = 32.852\)(상단), \(\chi^2_{0.975, 19} = 8.907\)(하단)이므로
\(\sigma^2\)의 95% 신뢰구간은 \((8.67, 32.00)\)이다.
비대칭성에 주목하라. 상한이 \(s^2 = 15\)에서 \(17.0\)만큼 떨어져 있는 반면 하한은 \(6.3\)만큼만 떨어져 있다. 카이제곱분포가 오른쪽으로 치우쳐 있기 때문이다. 평균에 대한 \(t\) 구간처럼 점추정값을 중심으로 대칭이 아니다.
구간의 폭도 인상적이다. 상한이 하한의 \(32.00/8.67 = 3.7\)배이다. \(n = 20\)으로 분산을 추정하면 3~4배의 불확실성이 남는다는 뜻이다. 표준편차로 옮기면 \((\sqrt{8.67}, \sqrt{32.00}) = (2.94, 5.66)\)으로 비율이 \(1.9\)배가 되어 다소 완화된다. \(\square\)
정리하며
일표본 분산 검정은 카이제곱 추축량을 쓴다.
- 비대칭 분포라 양측 임계값이 대칭이 아니다. 평균 검정처럼 \(\pm\) 로 적을 수 없다.
- 품질관리에서는 대개 단측이다. "분산이 규격을 넘는가"를 묻기 때문이다.
- 정규성에 매우 민감하다. 이 장이 거듭 강조하는 점이며, 4장과 8장에서 재어 본 대로 로그정규 자료에서는 사실상 쓸 수 없다.
- 표본을 늘려도 나아지지 않는다. 중심극한정리가 돕는 것은 평균이지 분산이 아니다.
- \(\sigma\) 에 대한 결론은 제곱근을 취하면 된다. 변환이 단조이므로 구간의 포함확률이 보존된다.
다음 절 유도에서 이 추축량이 어디서 오는지 본다.