포아송분포의 최대가능도
개요
품질검사원이 회로기판 여섯 장의 결함 수를 세어 평균 \(2.0\) 을 얻었다. 포아송에서는 그 수 하나로 여섯 막대의 높이가 모두 정해진다 — 모수가 하나뿐이니 평균을 정하면 분산도 꼬리도 따라 정해진다. 자료는 들쭉날쭉한데 맞춘 분포는 매끄럽다는 것이 그 간결함의 값이고, 치르는 값도 같은 자리에서 나온다. 산포가 평균보다 뚜렷이 크면 표준오차가 절반으로 나오고 \(z\) 가 두 배로 부풀어 없는 유의성이 쏟아지는데, 추정값 \(\bar x\) 자체는 아무 일 없다는 듯 그대로 나온다. 모수 하나로 분포 전체를 정하는 일은 무엇을 벌고 무엇을 거는 것인가.
포아송분포(Poisson distribution)는 계수 자료의 표준 모형이다. 시간당 받는 이메일 수, 제품 하나당 결함 수, 교차로에서 연간 발생하는 사고 수 등이 그렇다. 관측된 계수로부터 비율 모수 \(\lambda\)를 추정하는 것은 가장 흔한 통계 작업 중 하나이다. 포아송의 MLE는 표본평균(sample mean)이며, 모든 불편추정량 중에서 가능한 최선의 정밀도를 달성한다.
1. 설정
비율 모수가 \(\lambda > 0\)인 포아송분포에서 독립적으로 뽑은 확률표본 \(X_1, X_2, \ldots, X_n\)을 생각하자. 각 관측값은 다음 확률질량함수(probability mass function)를 가지고 \(\{0, 1, 2, \ldots\}\)의 값을 취한다.
목표는 관측된 계수를 가장 그럴듯하게 만드는 \(\lambda\) 값을 찾는 것이다.
2. 유도
정리 1. 포아송분포의 최대가능도추정량
\(X_1, \ldots, X_n \overset{\text{iid}}{\sim} \text{Poisson}(\lambda)\) 에 대해
이고, 적어도 하나의 관측값이 양수이면 이것이 유일한 전역 최대점이다.
증명
관측값이 독립이므로 결합 PMF 가 곱이고, 로그를 취하면
다. 마지막 항은 \(\lambda\) 를 담지 않으므로 최적화에서 아무 역할도 하지 않는다. 미분해 0 으로 둔다.
두 번 미분하면
이고, 관측값 중 적어도 하나가 양수이면 엄격하게 음수다. 그러면 \(\ell\) 이 엄격 오목이므로 정류점이 유일한 전역 최대점이다. \(\square\)
모든 관측값이 0 이면 사정이 다르다. 그때 \(\ell(\lambda) = -n\lambda\) 는 단조 감소이므로 최대점이 경계 \(\hat\lambda = 0\) 이고, 미분으로는 잡히지 않는다. 베르누이에서 \(s = 0\) 인 경우와 같은 상황이다.
표본평균 하나가 분포 전체를 정한다. 포아송은 모수가 하나뿐이므로 \(\bar x\) 를 알면 모든 막대의 높이가 정해진다. 그 \(\bar x\) 가 \(\sum x_i\) 의 함수라는 점도 눈여겨볼 만하다 — \(\sum x_i\) 가 충분통계량이라는 사실(충분성 정리 1 의 포아송 예)이 여기서 다시 나타난다.
보기 1. 회로기판의 결함 수. 품질검사원이 회로기판 6개의 결함 수를 세어 \(x_1 = 3\), \(x_2 = 1\), \(x_3 = 4\), \(x_4 = 0\), \(x_5 = 2\), \(x_6 = 2\)를 관측했다고 하자. 비율 모수 \(\lambda\)의 MLE를 구하시오.
풀이
정리 1 에 따라 MLE 는 표본평균이다.
따라서 비율 모수의 MLE는 기판당 \(\hat{\lambda} = 2.0\)개의 결함이다.
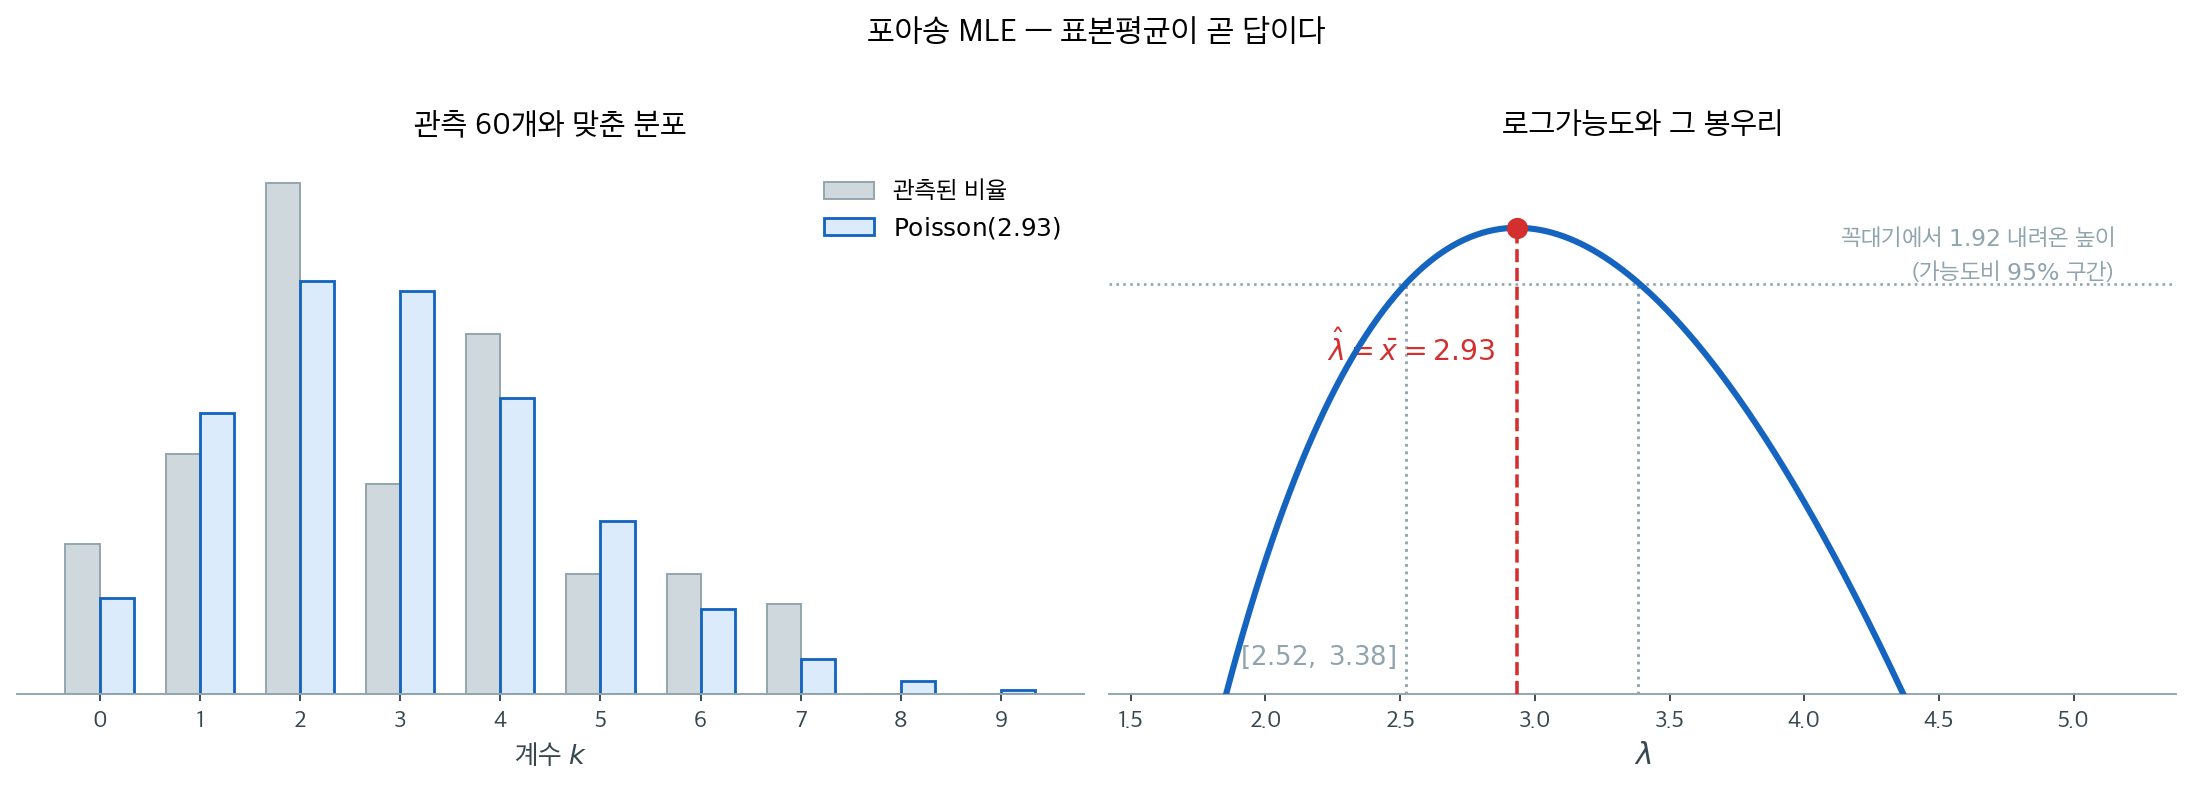
왼쪽은 관측된 계수의 비율과 \(\hat\lambda\)로 맞춘 확률질량함수를 나란히 놓은 것이다. 자료는 들쭉날쭉하지만 맞춘 분포는 매끄럽다. 표본평균 하나만으로 모든 막대의 높이가 정해진다는 점이 포아송분포의 특징이다. 모수가 하나뿐이라 평균이 정해지면 분산도, 꼬리도 함께 정해진다.
오른쪽 로그가능도의 봉우리가 그 \(\bar x\)에 있다. 점선은 꼭대기에서 \(1.92\)만큼 내려온 높이인데, 곡선이 그 위에 머무는 구간이 가능도비(likelihood ratio) 방식의 95% 신뢰구간이다(\(\chi^2_1\)의 95% 분위수(quantile) \(3.84\)의 절반이 \(1.92\)다). 정규근사로 \(\hat\lambda \pm 1.96\sqrt{\hat\lambda/n}\)을 쓰면 거의 같은 구간이 나오지만, 가능도비 쪽은 \(\lambda\)가 작아 분포가 치우칠 때도 좌우 폭을 다르게 잡아 준다.
3. 성질 — 지수와 달리 불편이다
MLE를 구했으니 이제 그 통계적 특성을 살펴보자. 불편인지, 얼마나 정밀한지, 다른 불편추정량이 더 나을 수 있는지를 본다.
불편성. 다음 절에서 볼 지수분포(exponential distribution)의 MLE와 달리 포아송의 MLE는 불편이다. \(E[\bar{X}] = E[X_1] = \lambda\)이므로 표본크기와 무관하게 평균적으로 참 모수를 맞힌다.
피셔 정보량. 관측값 하나당 피셔 정보량은
크기 \(n\)인 표본에서 전체 피셔 정보량은 \(I_n(\lambda) = n / \lambda\)이다.
효율성. \(\lambda\)의 임의의 불편추정량의 분산에 대한 크라메르–라오 하한(CRLB)은
\(\text{Var}(\bar{X}) = \text{Var}(X_1)/n = \lambda/n\)이므로 MLE가 이 한계를 정확히 달성한다. \(\lambda\)의 어떤 불편추정량도 이보다 작은 분산을 가질 수 없으며, 따라서 \(\bar{X}\)는 포아송 비율에 대한 일률최소분산불편추정량(UMVUE)이다.
그림으로 보는 통계학 1. 나눗셈 한 번이 전시의 물음에 답했다
\(1944\) 년 \(6\) 월 \(13\) 일 새벽, 런던 마일엔드의 철교에 독일의 새 무기가 떨어져 여섯 사람이 죽었다. 뒤이은 아홉 달 동안 비행폭탄 V-\(1\) 이 \(2{,}300\) 발 넘게 런던에 떨어졌고 \(5{,}500\) 명쯤이 목숨을 잃었다.
떨어지는 자리가 뭉쳐 있다는 말이 돌았다. 그 말이 맞느냐는 한가한 물음이 아니었다. 뭉쳐 떨어진다면 조준이 되고 있다는 뜻이고, 그러면 V-\(1\) 은 공포를 주는 무기가 아니라 군수공장을 때릴 수 있는 전략 무기가 된다.
\(1946\) 년, 서른한 살의 보험계리인 R. D. 클라크가 『계리학회지』에 한 쪽짜리 글을 실었다. 첫 문단에서 그는 이 예가 「요즈음 어떤 실무 조사를 하다가 다루게 된 것」이라고만 적었다. 전시에 항공기생산부에서 한 일을 에둘러 말한 것이다 — 기록에 그의 보직은 「특수 임무」로만 남아 있다.
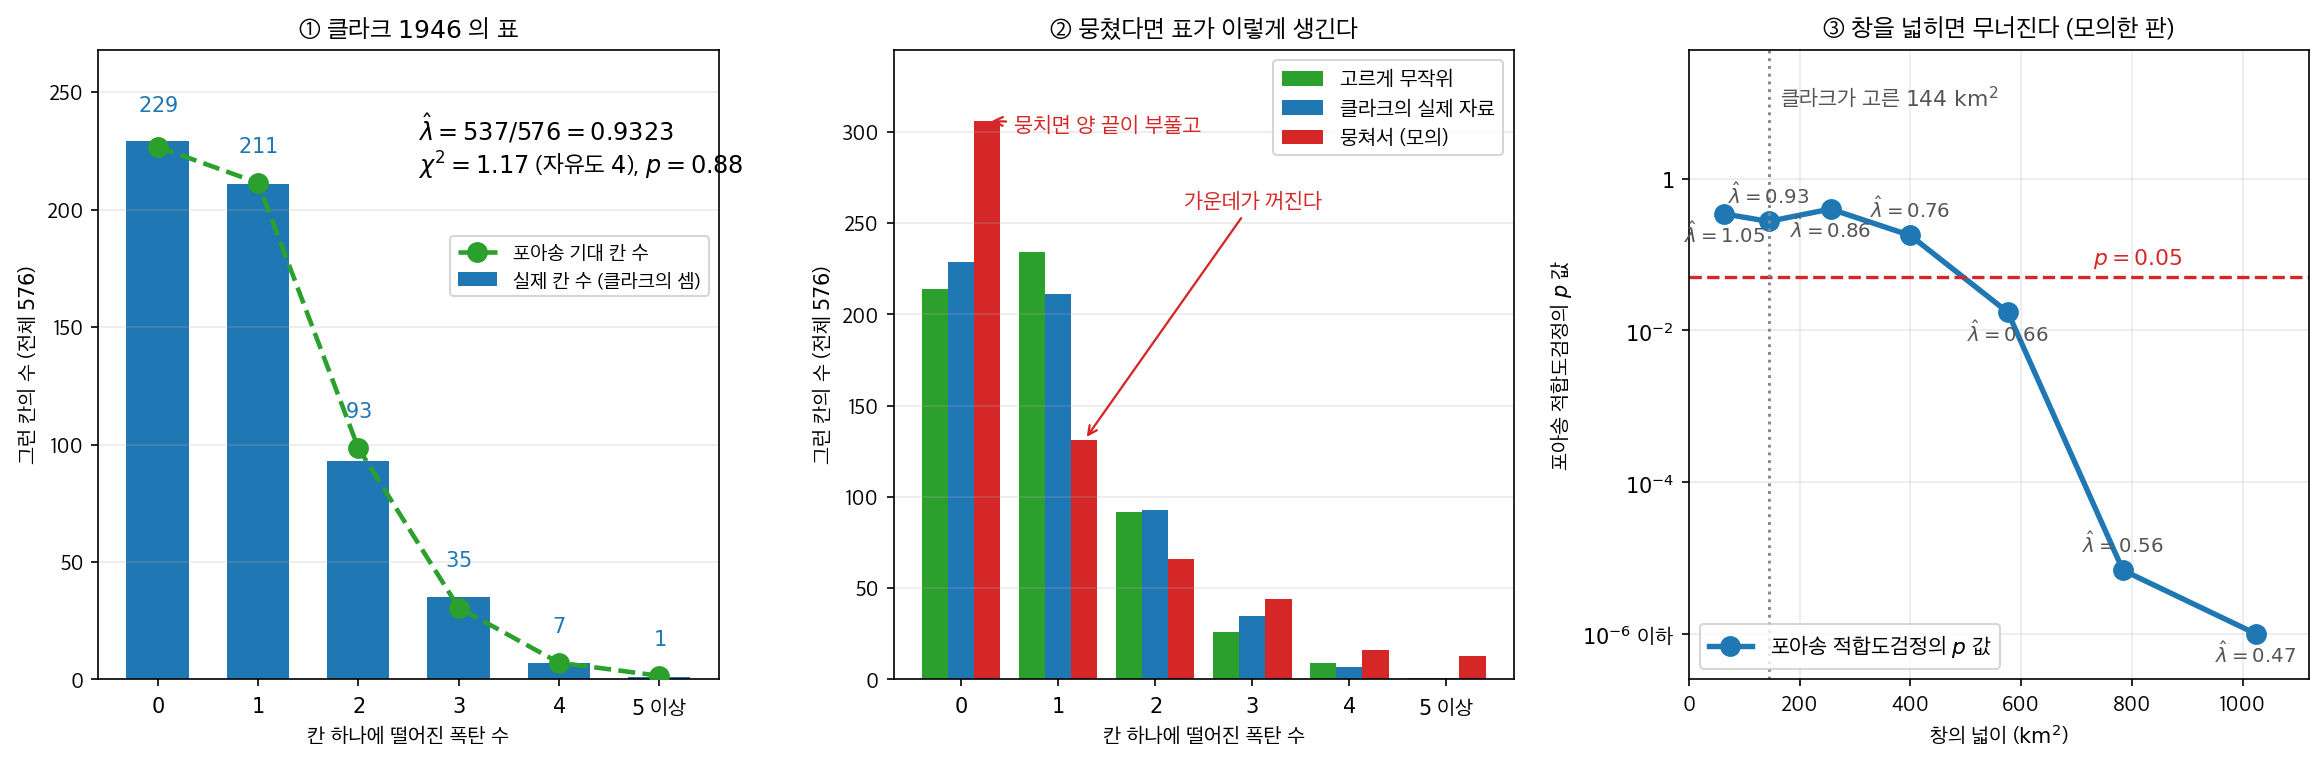
① 그가 한 계산. 남런던에서 평균 밀도가 거의 일정한 \(144\ \mathrm{km^2}\) 를 골라 \(0.25\ \mathrm{km^2}\) 짜리 \(576\) 칸으로 나누고, 그 안에 떨어진 폭탄 \(537\) 발이 칸마다 몇 발인지 셌다. 그다음이 전부다.
정리 1 이 바로 이 나눗셈이다. 칸당 폭탄 수를 포아송으로 보면 \(\hat\lambda_{\text{MLE}} = \bar x\) 이고, \(\bar x\) 는 전체 폭탄 수를 전체 칸 수로 나눈 것이다. 그 수 하나로 여섯 막대 높이가 모두 정해진다.
| 칸당 폭탄 수 | \(0\) | \(1\) | \(2\) | \(3\) | \(4\) | \(5\) 이상 |
|---|---|---|---|---|---|---|
| 실제 칸 수 | \(229\) | \(211\) | \(93\) | \(35\) | \(7\) | \(1\) |
| 포아송 기대 | \(226.74\) | \(211.39\) | \(98.54\) | \(30.62\) | \(7.14\) | \(1.57\) |
\(\chi^2 = 1.17\), 자유도 \(4\), \(p = 0.88\) 이다. 자유도가 \(6\) 이 아니라 \(4\) 인 것은 칸의 합을 맞추느라 하나, \(\lambda\) 를 추정하느라 또 하나를 뺐기 때문이고, 이것이 11.1절 자유도에서 다루는 바로 그 셈이다. 클라크는 이 표가 「포아송 법칙에 들어맞는 아주 깔끔한 예이고 뒷날 통계학 교과서를 쓰는 이들에게 쓸모가 있을지 모른다」고 적었다. 정말로 그렇게 되었다.
② 뭉쳤다면 표가 달랐을 것이다. 클라크는 군집이 어떤 자국을 남기는지도 적어 두었다 — 「폭탄이 많이 든 칸이나 하나도 없는 칸이 지나치게 많고 가운데 칸이 모자랐을 것이다.」 같은 \(576\) 칸에 같은 \(537\) 발을 뭉치게 떨어뜨려 보면 꼭 그 모양이 된다. \(0\) 인 칸이 \(229\) 에서 \(306\) 으로 늘고 \(1\) 인 칸이 \(211\) 에서 \(131\) 로 꺼지며 \(\chi^2\) 이 \(1.17\) 에서 \(169\) 로 뛴다. 실제 자료는 그 쪽으로 조금도 가 있지 않았다.
③ 그런데 맞춘 것은 분포가 아니라 창이었다. \(2019\) 년에 리엄 쇼와 루크 쇼가 런던시의회 폭격피해지도 \(190\) 쪽을 손으로 훑어 V-\(1\) 낙하점 \(887\) 개를 좌표로 옮겼다. 클라크처럼 남런던에서 \(144\ \mathrm{km^2}\) 를 잘라 같은 검정을 하면 \(p = 0.70\) 으로 잘 맞는다. 그런데 지도 전체에서 뽑으면 \(p = 0.02\) 가 되고, 밀도를 혼합정규로 맞춰 보면 중심이 셋으로 나온다. V-\(1\) 은 런던 전체에 고르게 떨어진 것이 아니라 남쪽으로 치우쳐 있었다.
③은 그 일이 왜 일어나는지를 밀도가 천천히 변하는 모의한 판에서 되짚은 것이다. 창이 좁으면 밀도가 거의 일정해 포아송이 맞고(\(144\ \mathrm{km^2}\) 에서 \(\hat\lambda = 0.93\), \(p = 0.27\)), 창을 넓힐수록 \(\hat\lambda\) 가 \(0.47\) 까지 떨어지면서 \(p\) 가 무너진다. 추정값 자체는 언제나 나온다 — 나눗셈이니까. 무너지는 것은 그 추정값이 뜻을 갖게 해 주던 가정이다.
클라크는 이것을 알고 있었다. 영국 정보부는 \(1944\) 년 늦가을에 이미 V-\(1\) 이 런던 한복판에 못 미쳐 떨어진다는 것을 알아차렸고, 사람을 덜 죽게 하려고 거짓 정보를 흘려 그 미달을 더 키우려 했다. 그가 고른 구역이 「평균 밀도가 거의 일정한」 곳이라고 글머리에 또박또박 적어 둔 까닭이다.
\(\S 3\) 은 \(\bar X\) 가 크라메르–라오 하한을 달성하는 UMVUE 라고 말한다. 맞다. 다만 그 최적성은 \(\lambda\) 가 칸마다 같다는 가정 위에서만 성립한다. 클라크가 한 일 가운데 어려운 쪽은 나눗셈이 아니라 그 가정이 서는 구역을 고른 것이었다.
덧붙이자면, 이 표는 교과서 바깥으로도 갔다. 토머스 핀천의 \(1973\) 년 소설 『중력의 무지개』에서 통계학자 로저 멕시코가 들여다보는 지도가 「\(576\) 칸, 한 칸이 \(4\) 분의 \(1\) 제곱킬로미터」다.
확인한 곳 — 클라크의 한 쪽짜리 논문 「An application of the Poisson distribution」(『Journal of the Institute of Actuaries』 \(72\) 권 \(481\) 쪽, \(1946\), doi:10.1017/S0020268100035435)을 전문으로 읽었다 — 「\(144\) 제곱킬로미터」·「\(576\) 칸」·「\(537\) 발」·\(N=576,\ m=537/576\)·기대도수 여섯·\(\chi^2=1.17\)·자유도 \(4\)·\(p=.88\), 그리고 「요즈음 어떤 실무 조사를 하다가」, 「뒷날 통계학 교과서를 쓰는 이들에게」, 군집이 양 끝을 부풀리고 가운데를 모자라게 했을 것이라는 문장, 「드러난 들어맞음의 정도는 군집 가설을 전혀 뒷받침하지 않는다」가 모두 그 쪽에 있다 · 클라크가 당시 서른한 살이고 프루덴셜 보험 소속이었다는 것, 항공기생산부의 「특수 임무」, 첫 V-\(1\) 이 \(1944\) 년 \(6\) 월 \(13\) 일 마일엔드 철교에 떨어져 여섯이 죽은 것, 아홉 달 동안 \(2{,}300\) 발 넘게 떨어져 \(5{,}500\) 명쯤이 죽은 것, 지도 \(190\) 쪽에서 낙하점 \(887\) 개를 옮긴 것, \(144\ \mathrm{km^2}\) 재현에서 \(p=0.70\) 과 지도 전체에서 \(p=0.02\)·\(\lambda=0.757\)·혼합정규 중심 셋, V-\(1\) 이 한복판에 못 미쳐 떨어진다는 것을 정보부가 알고 거짓 정보로 그 미달을 키우려 한 것, 『중력의 무지개』의 「\(576\) 칸」 구절은 리엄 P. 쇼·루크 F. 쇼의 「The Flying Bomb and the Actuary」(『Significance』 \(16\) 권 \(5\) 호 \(12\)–\(17\) 쪽, \(2019\), doi:10.1111/j.1740-9713.2019.01315.x)에서 확인했다 · ①의 기대도수와 \(\chi^2\) 은 클라크의 인쇄값과 따로 다시 계산해 소수 둘째 자리까지 모두 일치함을 보았다 · ②와 ③의 수는 직접 모의실험한 값이고, ③의 판은 밀도가 치우친 가상의 판이지 런던 지도가 아니다
연습문제
연습문제 1. 어떤 병원 응급실이 24시간 동안 시간당 도착 환자 수를 기록했고 총합이 168명이다. 시간당 도착률 \(\lambda\)의 MLE를 구하고 근사적인 95% 신뢰구간을 구성하라.
풀이
\(n = 24\)시간이고 \(\sum x_i = 168\)이므로 이렇게 된다.
포아송 관측값 하나에 대한 피셔 정보량이 \(I(\lambda) = 1/\lambda\)이므로 점근분산은 이렇게 된다.
표준오차는 \(\text{SE} = \sqrt{0.2917} \approx 0.5401\)이다.
95% 신뢰구간은 이렇게 된다.
연습문제 2. 확률표본 \(X_1, \dots, X_n \overset{\text{iid}}{\sim} \text{Poisson}(\lambda)\)에 대해 \(\lambda\)의 MLE를 유도하라.
풀이
로그가능도는 이렇게 된다.
도함수를 0으로 두면 이렇게 된다.
2계도함수가 (\(\sum x_i > 0\)일 때) \(-\sum x_i / \lambda^2 < 0\)이므로 최댓값임이 확인된다.
연습문제 3. MLE \(\hat{\lambda} = \bar{X}\)가 불편임을 보이고 그 정확한 분산을 계산하라.
풀이
각 \(X_i\)가 \(E[X_i] = \lambda\)를 만족하므로 이렇게 된다.
따라서 \(\hat{\lambda}\)는 불편이다.
포아송분포에서 \(\text{Var}(X_i) = \lambda\)이고 \(X_i\)들이 독립이므로 이렇게 된다.
이는 정확히 크라메르–라오 하한 \(1/(nI(\lambda)) = \lambda/n\)이므로 \(\hat{\lambda} = \bar{X}\)는 \(\lambda\)에 대한 UMVUE(일률최소분산불편추정량)이다. \(\square\)
연습문제 4. 관측 단위마다 노출량이 다른 경우를 생각하자. 지역 \(i\)의 인구가 \(t_i\)이고 사건 수가 \(X_i \sim \text{Poisson}(\lambda t_i)\)일 때 \(\lambda\)의 MLE를 구하라. 각 지역의 비율 \(X_i/t_i\)를 단순평균한 것과 어떻게 다른가?
풀이
로그가능도는 상수를 빼고
이므로
이다. 총 사건 수를 총 노출량으로 나눈 값이며, 이를 합동비율(pooled rate)이라 한다.
단순평균과의 차이. 단순평균은
로 각 지역에 같은 가중치를 준다. MLE는 노출량으로 가중한 평균이다.
인구가 큰 지역의 비율이 더 정확하므로 그쪽에 큰 가중치를 주는 것이 옳다. 실제로 \(\operatorname{Var}(X_i/t_i) = \lambda/t_i\)이므로 정밀도가 \(t_i\)에 비례하고, 정규분포의 최대가능도 연습문제 14 의 정밀도 가중 원리와 정확히 일치한다.
단순평균을 쓰면 인구 100명인 마을의 요동치는 비율이 인구 100만 도시의 안정된 비율과 같은 무게를 갖게 되어 추정이 불안정해진다.
일반화. 이 구조가 포아송 회귀의 오프셋이다. \(\ln E[X_i] = \ln t_i + \mathbf{x}_i^\top\boldsymbol\beta\)로 두면 \(\ln t_i\)가 계수 1로 고정된 항(오프셋)이 되고, 모형이 계수(count)가 아니라 비율(rate)을 설명하게 된다. 관찰 기간, 인구, 노출 면적이 다른 자료에서 반드시 필요한 장치다.
연습문제 5. 0을 관측할 수 없는 자료(예: 병원에 온 환자만 기록하므로 방문 횟수가 1 이상)의 분포는 영절단 포아송이다. 그 PMF를 쓰고 MLE 방정식을 유도하라. \(\bar x = 2.5\)일 때 \(\hat\lambda\)를 근사하라.
풀이
PMF. \(P(X \ge 1) = 1-e^{-\lambda}\)로 나누어 정규화한다.
평균.
보통의 포아송보다 크다. 0을 잘라 냈으니 당연하다.
MLE 방정식. 로그가능도가
이므로
정리하면
이다. 적률방정식과 같은 꼴(관측 평균 = 모형 평균)이며, 닫힌 해가 없어 수치적으로 풀어야 한다.
\(\bar x = 2.5\)일 때. \(g(\lambda) = \lambda/(1-e^{-\lambda})\)가 증가함수이고 \(g(2.2) = 2.474\), \(g(2.3) = 2.556\)이므로 그 사이에서 \(\hat\lambda \approx 2.23\)이다.
주의할 점. 절단을 무시하고 보통의 포아송 MLE \(\hat\lambda = \bar x = 2.5\)를 쓰면 \(\lambda\)를 12% 과대추정한다. 절단이 심할수록(\(\lambda\)가 작을수록) 오차가 커진다. \(\bar x = 1.2\)라면 \(\hat\lambda \approx 0.376\)으로 세 배 넘게 차이 난다.
같은 발상이 절단 정규분포, 절단 회귀(토빗 모형), 길이편향 표집 보정에 쓰인다. 표본이 어떻게 관측되었는지가 가능도에 반영되어야 한다는 것이 요점이다.
연습문제 6. 지역 A에서 10년간 45건, 지역 B에서 10년간 30건의 사고가 났다. 두 지역의 사고율이 같은지 가능도비 검정으로 판정하라. 조건부 이항검정과 견주어라.
풀이
MLE. 각각 \(\hat\lambda_A = 4.5\), \(\hat\lambda_B = 3.0\)건/년이고, 귀무가설(null hypothesis) 아래의 공통 비율은 \(\hat\lambda_0 = 75/20 = 3.75\)다.
가능도비 통계량. 로그가능도에서 \(\lambda\)에 의존하는 부분만 남기면
(\(-\lambda t\) 항들은 \(\sum\hat\lambda_i t_i = \hat\lambda_0 t\)로 상쇄된다.) 값을 넣으면
이고 \(\chi^2_1\)에서 \(p\text{-값} = 0.082\)다. 5%에서 기각하지 못한다.
조건부 이항검정. 총합 \(x_A+x_B = 75\)를 고정하면 \(X_A \mid 75 \sim \text{Binomial}(75,\ t_A/(t_A+t_B)) = \text{Binomial}(75, 0.5)\)이다. 정확 이항검정의 양측 \(p\) 값은 0.105다.
비교. 두 방법이 같은 방향의 결론을 주지만 \(p\) 값이 0.082 대 0.105로 꽤 다르다. 가능도비는 카이제곱 근사라 다소 낙관적이고, 이항 정확검정은 이산성 때문에 보수적이다.
어느 쪽을 쓸 것인가. 사건 수가 충분히 많으면(각각 10건 이상) 둘이 가까워지므로 계산이 편한 쪽을 쓴다. 사건 수가 적으면 정확검정이 안전하다. 조건부 접근의 또 다른 장점은 장애모수(nuisance parameter)인 전체 사건율 — 관심은 없지만 모형에 들어 있어 함께 다루어야 하는 모수 — 이 조건화로 사라진다는 점이며, 노출 기간이 달라도 \(t_A/(t_A+t_B)\)를 성공확률로 두면 그대로 통한다.
연습문제 7. 계수 자료에 포아송 MLE를 적합한 뒤 가정을 점검하려 한다. 이탈도와 피어슨 카이제곱을 정의하고, 과대산포를 어떻게 진단하는지 적어라.
풀이
적합값을 \(\hat\mu_i\)라 하자(단순 포아송이면 모두 \(\bar x\), 회귀모형이면 \(\exp(\mathbf{x}_i^\top\hat{\boldsymbol\beta})\)).
이탈도. 포화모형(각 관측에 모수 하나)과의 가능도비다.
(\(x_i=0\)이면 첫 항을 0으로 본다.)
피어슨 카이제곱.
분모가 \(\hat\mu_i\)인 것은 포아송에서 분산 = 평균이기 때문이다.
진단. 모형이 맞으면 둘 다 근사적으로 \(\chi^2_{n-p}\)를 따르므로
이어야 한다. 이 값이 1보다 뚜렷이 크면 과대산포다.
| \(\hat\phi\) | 판단 |
|---|---|
| \(\approx 1\) | 포아송 적합 |
| \(1.5\sim2\) | 경미한 과대산포. 준포아송으로 표준오차만 보정 |
| \(> 2\) | 음이항이나 영과잉 모형 검토 |
왜 중요한가. 과대산포를 놓치면 표준오차를 \(\sqrt{\hat\phi}\)배만큼 과소평가한다. \(\hat\phi = 4\)면 표준오차가 절반으로 나와 \(z\) 통계량이 두 배가 되고, 없는 유의성이 쏟아진다. 계수 추정값 자체는 대체로 일치하므로 문제를 알아채기 어렵다.
주의. 이탈도를 적합도 검정(goodness-of-fit test)에 쓰려면 \(\hat\mu_i\)가 충분히 커야 한다(\(\ge5\) 정도). 계수가 작으면 이탈도의 \(\chi^2\) 근사가 나쁘고, 특히 0이 많은 자료에서는 믿을 수 없다. 그때는 잔차 그림이나 예측분포와 관측분포의 비교(루트그램)가 더 유용하다.
연습문제 8. 포아송 자료에 \(\sqrt{X}\) 변환을 쓰면 분산이 안정된다고 알려져 있다. 델타 방법으로 확인하고, 그럼에도 요즘은 변환보다 포아송 회귀를 권하는 이유를 적어라.
풀이
분산안정화 확인. \(g(x) = \sqrt x\)이므로 \(g'(\lambda) = 1/(2\sqrt\lambda)\)이고 \(\operatorname{Var}(X) = \lambda\)이므로
로 \(\lambda\)에 무관한 상수가 된다. \(\square\)
일반 원리로 \(\operatorname{Var}(X) = V(\mu)\)일 때 \(g(\mu) = \int d\mu/\sqrt{V(\mu)}\)가 분산을 안정시키며, 포아송은 \(V(\mu)=\mu\)라 제곱근이 나온다. 이항의 \(\arcsin\sqrt{\hat p}\), 상관계수의 \(\operatorname{arctanh}\)도 같은 계산이다.
실무에서는 \(\lambda\)가 작을 때 근사가 나빠져 앤스컴 변환 \(2\sqrt{X+3/8}\)이나 프리먼–투키 변환 \(\sqrt X + \sqrt{X+1}\)을 쓴다.
그럼에도 변환을 권하지 않는 이유.
- 해석이 망가진다. \(\sqrt{X}\)의 평균은 \(\sqrt{E[X]}\)가 아니다(옌센 부등식). 변환 척도에서 얻은 결과를 되돌리면 편향이 생기고, 회귀계수(regression coefficient)를 원래 척도의 효과로 읽을 수 없다.
- 0을 다루기 어렵다. 계수 자료에는 0이 많은데 \(\sqrt0 = 0\)이 경계에 붙어 정규성(normality)이 깨진다. 로그 변환이라면 아예 정의되지 않아 \(\ln(x+1)\) 같은 임시방편을 쓰게 되고, 더하는 상수에 따라 결과가 달라진다.
- 한 가지 문제만 고친다. 변환은 등분산을 겨냥하지만 정규성과 선형성까지 동시에 만족시킨다는 보장이 없다. 세 가지를 한 변환으로 맞추는 것은 대개 불가능하다.
- 일반화선형모형(generalized linear model)이 더 낫다. 포아송 회귀는 원래 척도에서 평균을 모형화하면서 분산구조를 따로 지정한다. 변환할 필요가 없고, 계수가 비율비로 바로 해석되며, 과대산포도 준포아송이나 음이항으로 자연스럽게 확장된다.
분산안정화 변환은 컴퓨터가 귀하던 시절에 선형모형 도구를 계수 자료에 억지로 맞추려던 장치였다. 원리를 아는 것은 여전히 유용하지만, 분석의 기본 도구로 쓸 이유는 없다.
연습문제 9. 포아송의 MLE \(\hat{\lambda} = \bar{X}\)는 (척도를 제외하면) 충분통계량이기도 하다. 라오–블랙웰 정리를 사용하여 다른 어떤 불편추정량도 더 작은 분산을 가질 수 없는 이유를 설명하라.
풀이
(인수분해 정리에 의해) \(\lambda\)에 대한 충분통계량은 \(T = \sum X_i\)이다. MLE \(\hat{\lambda} = T/n\)은 이미 \(T\)의 함수이다.
라오–블랙웰 정리에 의해 임의의 불편추정량 \(W\)를 \(T\)로 조건화한 \(E[W \mid T]\)는 여전히 불편이고 원래보다 분산이 크지 않다. \(\hat{\lambda}\)가 이미 \(T\)의 함수이므로, 다른 어떤 불편추정량을 \(T\)로 조건화해도 \(\hat{\lambda}\)보다 나아질 수 없다.
나아가 포아송 족은 완비 지수족이므로 레만–셰페 정리가 \(\hat{\lambda} = T/n\)이 유일한 UMVUE임을 보장한다. 그 분산 \(\lambda/n\)이 크라메르–라오 하한과 같으므로 (선형추정량뿐 아니라) 어떤 불편추정량도 이보다 나을 수 없음이 확인된다.
연습문제 10. 설명변수(explanatory variable)가 있는 포아송 회귀 \(\ln\mu_i = \mathbf{x}_i^\top\boldsymbol\beta\)의 로그가능도를 쓰고 점수방정식을 유도하라. 왜 로그연결함수를 쓰며, 닫힌 해가 없는 이유는 무엇인가?
풀이
로그가능도. \(\mu_i = \exp(\mathbf{x}_i^\top\boldsymbol\beta)\)이므로
점수방정식. \(\boldsymbol\beta\)로 미분하면
"관측값 빼기 적합값"에 설명변수를 가중한 형태로, 로지스틱 회귀(logistic regression)의 점수방정식과 똑같은 모양이다. 지수족에 정준연결함수를 쓰면 언제나 이 꼴이 나온다.
헤세행렬.
\(\mu_i > 0\)이므로 언제나 음반정치다. 로그가능도가 오목하므로 국소 최대가 곧 전역 최대이고, 뉴턴–랩슨(IRLS)이 안정적으로 수렴한다.
왜 로그연결인가.
- 모수공간을 지킨다. \(\mu_i = e^{\eta_i} > 0\)이 자동으로 보장된다. 항등연결 \(\mu_i = \mathbf{x}_i^\top\boldsymbol\beta\)를 쓰면 음수 평균이 나올 수 있다.
- 포아송의 정준연결이다. 지수족 표준형 \(\exp\{x\theta - b(\theta)\}\)에서 \(\theta = \ln\mu\)이므로, 이를 선형으로 두면 위와 같은 깔끔한 점수방정식과 오목성이 따라온다.
- 곱셈적 해석. \(\ln\mu = \beta_0+\beta_1x\)이면 \(x\)가 1 늘 때 \(\mu\)가 \(e^{\beta_1}\)배가 된다. 비율의 상대적 변화로 읽히며, 이는 계수 자료에 자연스러운 해석이다.
닫힌 해가 없는 이유. 점수방정식에 \(\boldsymbol\beta\)가 지수함수 안에 들어 있다. 선형모형이라면 \(\sum(y_i-\mathbf{x}_i^\top\boldsymbol\beta)\mathbf{x}_i=0\)이 \(\boldsymbol\beta\)에 대한 선형방정식이라 정규방정식(normal equations)으로 풀리지만, 여기서는 \(e^{\mathbf{x}_i^\top\boldsymbol\beta}\) 때문에 초월방정식이 된다. 일반화선형모형 대부분이 같은 이유로 반복 알고리즘을 필요로 한다.
정리하며
포아송의 최대가능도추정량도 표본평균이다.
- 로그가능도가 \(\left(\sum x_i\right)\log\lambda - n\lambda - \sum\log(x_i!)\) 이고, 마지막 항은 \(\lambda\) 와 무관해 버려도 된다.
- 불편이고 효율적이다. \(\mathbb{E}[\bar X]=\lambda\) 이며 분산 \(\lambda/n\) 이 크라메르–라오 하한 \(1/(nI(\lambda))=\lambda/n\) 과 일치한다. 모든 불편추정량 중 최선이다.
- 평균과 분산이 같다는 것이 포아송의 지문이다. 자료에서 표본분산(sample variance)이 표본평균보다 뚜렷이 크면(과대산포) 포아송 가정이 틀린 것이며, 음이항 같은 모형이 필요하다. 이 진단은 적합 뒤에 반드시 해야 한다.
- \(\sum x_i\) 가 충분통계량이고, 포아송의 가법성 덕분에 그 합 자체가 다시 \(\text{Poisson}(n\lambda)\) 를 따른다.
- 관측이 모두 \(0\) 이면 \(\hat\lambda=0\) 이 되어 표준오차 \(\sqrt{\hat\lambda/n}\) 도 \(0\) 이 되므로 정규근사 신뢰구간을 만들 수 없다. 드문 사건에서 실제로 마주치는 경계 문제다.
다음 절 지수분포의 최대가능도로 넘어간다. 닫힌 형태가 나오지만, 이번에는 비선형 변환이 편향을 들여오는 모습을 함께 보게 된다.