직교사영행렬
개요
세 번 잰 값 \((1,\, 3,\, 4)\) 를 두 설명벡터 \((1,\, 1,\, 1)\) 과 \((0,\, 1,\, 2)\) 의 섞음으로 설명하려 하면, 잰 값이 두 벡터가 만드는 평면 위에 있지 않아 정확히 맞힐 수 없다. 할 수 있는 최선은 그 평면에서 가장 가까운 점을 고르는 것이고, 그 점은 수선의 발이므로 남는 벡터가 두 설명벡터에 모두 수직이어야 한다. 그 수직조건 두 개가 그대로 최소제곱법(least squares)의 정규방정식(normal equations)이고, 거기에 미분은 한 번도 나오지 않는다.
직교사영행렬은 모든 벡터를 어떤 부분공간 안에서 가장 가까운 점으로 보내며, 여기서 "가깝다"는 유클리드 거리로 잰다. 이것이 통상 최소제곱의 기하학적 내용이다. 적합값 벡터 \(\hat{\mathbf{y}}\)는 반응벡터 \(\mathbf{y}\)를 설계행렬 \(\mathbf{X}\)의 열공간 위로 직교사영한 것이고, 잔차벡터 \(\mathbf{e} = \mathbf{y} - \hat{\mathbf{y}}\)는 그 열공간에 수직이다. 직교사영은 멱등이면서 대칭인 것으로 특징지어지며, 그 명시적 공식 \(\mathbf{H} = \mathbf{X}(\mathbf{X}^\top\mathbf{X})^{-1}\mathbf{X}^\top\)이 회귀의 모자 행렬이다. 이 공식은 \(\mathbf{X}\)의 열이 선형독립일 때에만 뜻을 갖는다. 그때에만 \(\mathbf{X}^\top\mathbf{X}\)가 가역이기 때문이다(정리 2).
정의 1. 직교사영행렬
정사각행렬 \(\mathbf{P} \in \mathbb{R}^{n \times n}\)이 멱등이면서 대칭이면 직교사영행렬이라 한다.
대칭성 조건이 직교사영을 빗각 사영과 구별해 준다. 멱등행렬 \(\mathbf{P}\)에 대해
이 성립한다. 곧 대칭성은 "영공간이 열공간의 직교여공간"이라는 기하적 조건과 정확히 같은 말이다. 이 동등성은 멱등행렬 쪽의 정리 3에서 증명했으므로 여기서는 인용만 한다.
1. 최선근사 성질
직교사영을 규정하는 기하적 성질은 가장 가까운 점 문제를 푼다는 것이다.
정리 1. 최선근사
\(\mathbf{P}\)가 부분공간 \(\mathcal{V} \subseteq \mathbb{R}^n\) 위로의 직교사영이라 하자. 임의의 \(\mathbf{x} \in \mathbb{R}^n\)에 대해 벡터 \(\mathbf{P}\mathbf{x}\)는 \(\mathbf{x}\)까지의 거리를 최소화하는 \(\mathcal{V}\)의 유일한 원소다.
증명
\(\mathbf{v} \in \mathcal{V}\)를 임의로 잡자. 그러면
이다. (\(\mathbf{P}\)가 직교사영이므로) \(\mathbf{x} - \mathbf{P}\mathbf{x} \in \mathcal{V}^\perp\)이고 \(\mathbf{P}\mathbf{x} - \mathbf{v} \in \mathcal{V}\)이므로 이 두 벡터는 직교한다. 피타고라스 정리에 의해
이다. 등호는 \(\mathbf{v} = \mathbf{P}\mathbf{x}\)일 때에 한해 성립한다. \(\square\)
바로 이것이 최소제곱이 잔차제곱합을 최소화하는 이유다. \(\hat{\mathbf{y}} = \mathbf{H}\mathbf{y}\)가 \(\operatorname{col}(\mathbf{X})\) 안에서 \(\mathbf{y}\)에 가장 가까운 점이다.
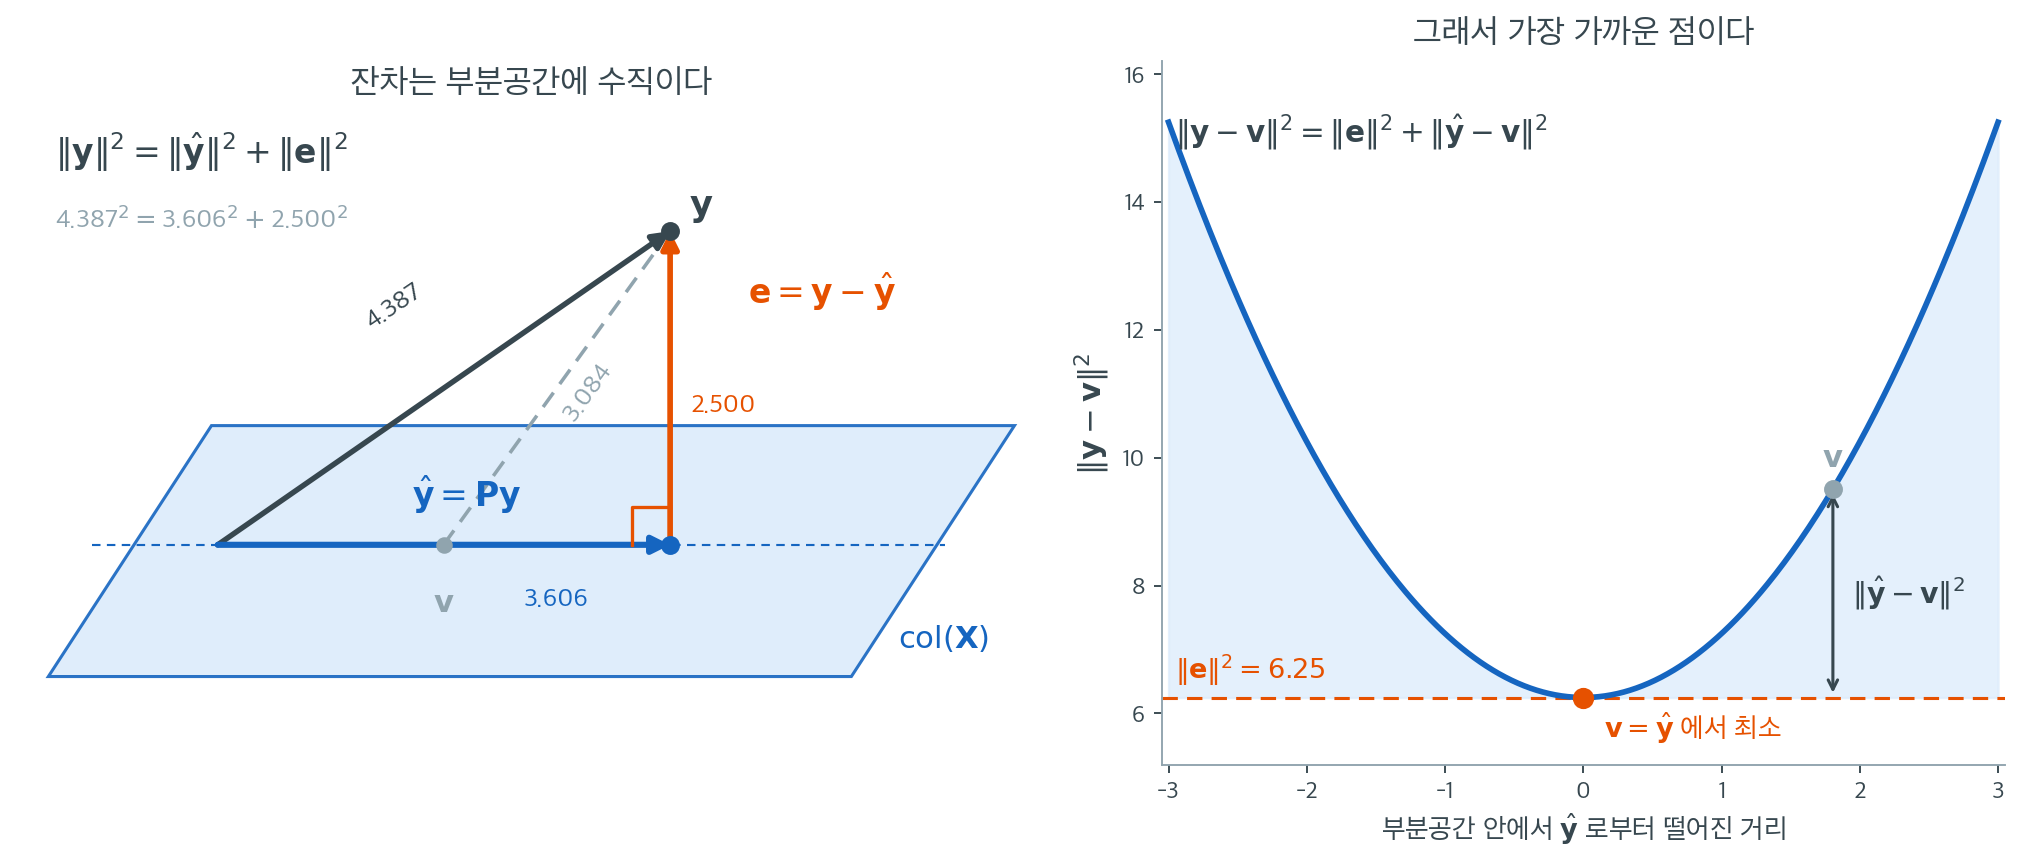
왼쪽 그림의 세 변은 길이가 실제 값이다. \(\lVert\hat{\mathbf{y}}\rVert = 3.606\), \(\lVert\mathbf{e}\rVert = 2.500\), \(\lVert\mathbf{y}\rVert = 4.387\)이고 \(4.387^2 = 3.606^2 + 2.500^2 = 19.25\)가 정확히 맞는다. 맞아떨어지는 이유는 하나뿐이다. \(\mathbf{e}\)가 평면 \(\operatorname{col}(\mathbf{X})\)에 수직이라 \(\hat{\mathbf{y}}\)에서의 각이 직각이기 때문이다. 피타고라스 분해는 직교성을 길이의 언어로 바꿔 쓴 것일 뿐이다.
이제 평면 안에서 다른 점 \(\mathbf{v}\)를 골라 보자. 그림에서 \(\mathbf{v}\)까지 그은 회색 점선의 길이는 \(3.084\)로 \(2.500\)보다 길다. 그럴 수밖에 없다. \(\mathbf{y} - \mathbf{v}\)를 평면에 수직인 \(\mathbf{e}\)와 평면 안에 놓인 \(\hat{\mathbf{y}} - \mathbf{v}\)로 쪼개면 다시 직각삼각형이 되어 \(\lVert\mathbf{y}-\mathbf{v}\rVert^2 = \lVert\mathbf{e}\rVert^2 + \lVert\hat{\mathbf{y}}-\mathbf{v}\rVert^2\)이고, 오른쪽 둘째 항은 결코 음수가 될 수 없다. 위 증명이 한 일이 바로 이것이다.
오른쪽 그림은 그 식을 \(\mathbf{v}\)의 위치에 대한 함수로 그린 것이다. 부분공간 안에서 \(\hat{\mathbf{y}}\)로부터 멀어진 거리를 가로축에 놓으면 거리의 제곱은 꼭짓점이 \(\mathbf{v} = \hat{\mathbf{y}}\)인 포물선이 되고, 바닥 높이가 \(\lVert\mathbf{e}\rVert^2 = 6.25\)다. 잔차제곱합은 아무리 잘 해도 이 아래로 내려가지 않으며, 그 바닥에 닿는 점은 단 하나다. 최소제곱해가 존재하고 유일하다는 말의 기하가 이 포물선이다.
2. 열공간 위로의 직교사영 공식
정리 2. 사영 공식
\(\mathbf{X} \in \mathbb{R}^{n \times p}\)가 완전 열계수를 갖는다고 하자(\(\operatorname{rank}(\mathbf{X}) = p\)). \(\operatorname{col}(\mathbf{X})\) 위로의 직교사영은
이다.
증명
직교사영을 규정하는 두 성질(멱등성과 대칭성)을 확인하고, 치역이 \(\operatorname{col}(\mathbf{X})\)임을 본다.
멱등성:
대칭성:
마지막 단계에서는 \((\mathbf{X}^\top\mathbf{X})^{-1}\)이 대칭이라는 사실을 썼다(대칭행렬의 역행렬은 대칭이다).
치역: 임의의 \(\mathbf{v}\)에 대해 \(\mathbf{P}_{\mathbf{X}}\mathbf{v} = \mathbf{X}\bigl[(\mathbf{X}^\top\mathbf{X})^{-1}\mathbf{X}^\top\mathbf{v}\bigr] \in \operatorname{col}(\mathbf{X})\)이고, 거꾸로 \(\mathbf{P}_{\mathbf{X}}\mathbf{X} = \mathbf{X}\)이므로 \(\operatorname{col}(\mathbf{X})\)의 벡터는 모두 제자리에 남는다. 따라서 치역이 정확히 \(\operatorname{col}(\mathbf{X})\)다. \(\square\)
AI로 보는 통계학 1. 자료에 식을 맞추는 일은 수선의 발을 찾는 일이다
정리 2 의 공식 \(\mathbf{P}_{\mathbf{X}}=\mathbf{X}(\mathbf{X}^\top\mathbf{X})^{-1}\mathbf{X}^\top\) 을 거꾸로 읽으면 연립방정식 하나가 나온다. \(\mathbf{P}_{\mathbf{X}}\mathbf{c}=\mathbf{X}\boldsymbol\beta\) 라 두면 \(\mathbf{X}^\top\mathbf{X}\boldsymbol\beta=\mathbf{X}^\top\mathbf{c}\), 곧 「남는 벡터가 \(\mathbf{X}\) 의 모든 열에 수직」이다. 기계가 자료에 식을 맞출 때 실제로 푸는 식이 바로 이것이다.
세 번 잰 값 \(c_1\), \(c_2\), \(c_3\) 을 두 설명값으로 \(c_i\fallingdotseq s\,a_i+t\,b_i\) 꼴로 설명하려 한다고 하자. 세 쌍을 한꺼번에 벡터로 적으면 \(\vec a\), \(\vec b\), \(\vec c\) 가 되고, \(s\vec a+t\vec b\) 는 \(\vec a\) 와 \(\vec b\) 가 만드는 평면 — 곧 \(\mathbf{X}=[\vec a\ \ \vec b]\) 의 열공간 — 위를 훑는다. 잰 값 \(\vec c\) 는 대개 그 평면 위에 있지 않으므로 가장 가까운 점을 고르는데, 정리 1 이 그 점이 수선의 발임을 보장한다. 그래서 오차를 가장 작게 만드는 \(s\), \(t\) 는 수직조건
을 푼 값이다. 이것이 최소제곱법의 정규방정식이고, 위에서 \(\mathbf{X}^\top\mathbf{X}\boldsymbol\beta=\mathbf{X}^\top\mathbf{c}\) 라 적은 식과 글자 그대로 같은 식이다.
눈여겨볼 것은 미분이 한 번도 나오지 않는다는 점이다. 오차를 가장 작게 하라는 요구가 정리 1 에서 이미 「수선의 발을 찾으라」로 바뀌었기 때문에, 남은 일은 수직조건 둘을 적는 것뿐이다.
# 세 번 잰 값 c 를 두 설명벡터 a, b 가 만드는 평면 위로 정사영한다.
# 정리 2 가 말하는 「남는 벡터가 두 방향에 모두 수직」이 그대로 연립방정식이 된다.
a = [1, 1, 1]          # 상수항에 붙는 벡터
b = [0, 1, 2]          # 설명변수의 값
c = [1, 3, 4]          # 실제로 잰 값 — 평면 위에 있지 않다

dot = lambda u, v: sum(p * q for p, q in zip(u, v))   # 성분으로 적은 내적

# (c - sa - tb)·a = 0, (c - sa - tb)·b = 0  — 수직조건 두 개
A, B, C = dot(a, a), dot(a, b), dot(b, b)
p, q = dot(c, a), dot(c, b)
det = A * C - B * B                      # 두 설명벡터가 평행하지 않으면 0 이 아니다
s, t = (p * C - q * B) / det, (A * q - B * p) / det

fit = [s * ai + t * bi for ai, bi in zip(a, b)]       # 정사영 — 평면 위의 점
res = [ci - fi for ci, fi in zip(c, fit)]             # 남는 벡터
print("s, t      =", round(s, 4), round(t, 4))
print("정사영     =", [round(v, 4) for v in fit])
print("남는 벡터  =", [round(v, 4) for v in res])
print("수직 확인  =", round(dot(res, a), 12) + 0, round(dot(res, b), 12) + 0)
실행하면 다음이 나온다.
s, t      = 1.1667 1.5
정사영     = [1.1667, 2.6667, 4.1667]
남는 벡터  = [-0.1667, 0.3333, -0.1667]
수직 확인  = 0.0 0.0
맞춘 값 \(s=\dfrac76\), \(t=\dfrac32\) 에서 정사영은 \(\left(\dfrac76,\ \dfrac83,\ \dfrac{25}{6}\right)\) 이고, 남는 벡터 \(\left(-\dfrac16,\ \dfrac13,\ -\dfrac16\right)\) 은 \(\vec a\), \(\vec b\) 와의 내적이 둘 다 \(0\) 이다. 여기서 \(A\), \(B\), \(C\) 로 적은 세 수가 바로 \(\mathbf{X}^\top\mathbf{X}\) 의 네 성분이고 \(\det\) 이 그 행렬식이니, 위 열 줄은 정리 2 의 \(\mathbf{X}(\mathbf{X}^\top\mathbf{X})^{-1}\mathbf{X}^\top\) 을 \(p=2\) 에서 손으로 펼친 것이다. 설명값을 더 늘리면 벡터가 사는 공간의 차원만 커질 뿐, 푸는 식은 여전히 「남는 벡터가 모든 설명벡터에 수직」이다 — 아래 절 \(6\) 의 모자 행렬이 그 일반형이고, 요즘 학습 모형이 마지막 층에서 하는 계산도 이 꼴에서 출발한다.
한계는 분명하다. 이 계산은 잰 값과 식 사이의 거리를 제곱해서 잰다고 미리 정해 놓은 결과이고, 다른 방식으로 오차를 재면 답도 수선의 발이 아니게 된다.
3. 멱등성과 대칭성에서 따라 나오는 것들
고윳값
직교사영의 고윳값은 (멱등성에서 물려받아) 0과 1이며,
이다.
여집합 사영
행렬 \(\mathbf{M} = \mathbf{I} - \mathbf{P}_{\mathbf{X}}\)는 \(\operatorname{col}(\mathbf{X})^\perp\) 위로의 직교사영이다.
사영들의 직교성
\(\mathbf{P}_{\mathbf{X}}\)의 치역과 \(\mathbf{M}\)의 치역은 서로 직교여공간이므로
이다.
열공간의 특성화
벡터 \(\mathbf{v}\)가 \(\operatorname{col}(\mathbf{X})\)에 속할 필요충분조건은 \(\mathbf{P}_{\mathbf{X}}\mathbf{v} = \mathbf{v}\)이고, \(\mathbf{v}\)가 \(\operatorname{col}(\mathbf{X})\)에 직교할 필요충분조건은 \(\mathbf{P}_{\mathbf{X}}\mathbf{v} = \mathbf{0}\)이다.
4. 하나의 벡터 위로의 사영
부분공간이 1차원일 때, 즉 0이 아닌 벡터 \(\mathbf{u}\)에 대해 \(\mathcal{V} = \operatorname{span}\{\mathbf{u}\}\)일 때 사영 공식은
으로 간단해진다. 이것은 임의의 벡터 \(\mathbf{x}\)를 \(\mathbf{u}\) 위로 사영한다.
스칼라 \(\frac{\mathbf{u}^\top\mathbf{x}}{\mathbf{u}^\top\mathbf{u}}\)가 \(\mathbf{u}\) 위로 사영된 \(\mathbf{x}\)의 계수다.
5. 예 — 중심화행렬
중심화행렬은
이며, 여기서 \(\mathbf{1}_n = (1, \dots, 1)^\top\)이다. 이 행렬은 다음을 만족한다.
- \(\mathbf{C}^2 = \mathbf{C}\) (멱등)
- \(\mathbf{C}^\top = \mathbf{C}\) (대칭)
- \(\operatorname{tr}(\mathbf{C}) = n - 1\)
따라서 \(\mathbf{C}\)는 계수 \(n - 1\)인 직교사영이다. \(\mathbf{1}_n\)에 직교하는 부분공간(성분의 합이 0인 벡터들의 부분공간) 위로 사영한다. 임의의 자료벡터 \(\mathbf{x}\)에 대해
이며, 여기서 \(\bar{x} = \frac{1}{n}\sum_i x_i\)는 표본평균(sample mean)이다. 자료를 중심화하는 것은 하나의 직교사영이다.
6. 예 — 모자 행렬
완전 열계수를 갖는 \(\mathbf{X} \in \mathbb{R}^{n \times p}\)에 대한 선형모형 \(\mathbf{y} = \mathbf{X}\boldsymbol{\beta} + \boldsymbol{\varepsilon}\)에서 모자 행렬은
이다. 이것이 \(\operatorname{col}(\mathbf{X})\) 위로의 직교사영이다. 이름은 \(\hat{\mathbf{y}} = \mathbf{H}\mathbf{y}\)라는 사실에서 왔다. 모자 행렬이 "\(\mathbf{y}\)에 모자를 씌우는" 것이다.
회귀에서의 핵심 성질은 다음과 같다.
- \(\hat{\mathbf{y}} = \mathbf{H}\mathbf{y}\) (적합값)
- \(\mathbf{e} = (\mathbf{I} - \mathbf{H})\mathbf{y}\) (잔차)
- \(\hat{\mathbf{y}} \perp \mathbf{e}\) (적합값과 잔차의 직교성)
- \(\operatorname{tr}(\mathbf{H}) = p\) (모형 자유도)
- \(\operatorname{tr}(\mathbf{I} - \mathbf{H}) = n - p\) (잔차 자유도)
7. 회귀에서의 피타고라스 정리
직교성 \(\hat{\mathbf{y}} \perp \mathbf{e}\)가 피타고라스 정리를 준다.
이것은 원점을 기준으로 한 분해다. 모형이 절편(intercept)을 포함하면 \(\mathbf{1} \in \operatorname{col}(\mathbf{X})\)이므로 \(\mathbf{e} \perp \mathbf{1}\), 곧 \(\sum_i e_i = 0\)이고 \(\hat{\mathbf{y}}\)의 평균이 \(\bar{y}\)와 같다. 양변에서 \(\mathbf{1}\) 위로의 사영 \(\bar{y}\mathbf{1}\)을 먼저 걷어내면 분산분석(analysis of variance) 분해가 나온다.
여기서 SST는 총제곱합, SSR은 회귀제곱합, SSE는 오차제곱합이다. 교차항이 사라지는 것은 \(\mathbf{e}\)가 \(\hat{\mathbf{y}}\)과 \(\mathbf{1}\) 모두에 직교하기 때문이다. 통상 보고하는 \(R^2\)은 이 중심화된 양들의 비
이고, 이는 중심화한 두 벡터 \(\mathbf{y} - \bar{y}\mathbf{1}\)과 \(\hat{\mathbf{y}} - \bar{y}\mathbf{1}\) 사이 각의 코사인의 제곱이다. 중심화하지 않은 비 \(\lVert\hat{\mathbf{y}}\rVert^2/\lVert\mathbf{y}\rVert^2\)도 같은 기하적 의미를 갖지만 기준점이 평균이 아니라 원점이어서 값이 다르다. 절편이 있는 모형에서는 평균 수준 \(\bar{y}\)를 절편이 언제나 정확히 맞히므로 중심화하지 않은 비가 부풀려진다. 두 양을 섞지 않는 것이 중요하다(연습문제 3, 10).
연습문제
연습문제 1. \(\mathbf{X} = \begin{pmatrix} 1 & 1 \\ 1 & 2 \\ 1 & 3 \end{pmatrix}\)이라 하자. 모자 행렬 \(\mathbf{H} = \mathbf{X}(\mathbf{X}^\top\mathbf{X})^{-1}\mathbf{X}^\top\)를 계산하고 \(\operatorname{tr}(\mathbf{H}) = 2\)임을 확인하라.
풀이
먼저 다음을 계산한다.
그러면
이다. 대각합은 \(\operatorname{tr}(\mathbf{H}) = (5 + 2 + 5)/6 = 12/6 = 2\)로 \(\mathbf{X}\)의 열 개수(\(p = 2\))와 같다. 이는 일반적인 결과 \(\operatorname{tr}(\mathbf{H}) = \operatorname{rank}(\mathbf{H}) = p\)를 확인해 준다.
연습문제 2. \(\hat{\mathbf{y}} = \mathbf{H}\mathbf{y}\), \(\mathbf{e} = (\mathbf{I} - \mathbf{H})\mathbf{y}\)일 때 피타고라스 분해 \(\lVert \mathbf{y} \rVert^2 = \lVert \hat{\mathbf{y}} \rVert^2 + \lVert \mathbf{e} \rVert^2\)를 증명하라.
풀이
\(\mathbf{y} = \hat{\mathbf{y}} + \mathbf{e}\)이므로
이다. 교차항은 다음과 같이 사라진다.
\(\mathbf{H}(\mathbf{I} - \mathbf{H}) = \mathbf{H} - \mathbf{H}^2 = \mathbf{H} - \mathbf{H} = \mathbf{0}\)이므로 교차항이 0이 되어 \(\lVert \mathbf{y} \rVert^2 = \lVert \hat{\mathbf{y}} \rVert^2 + \lVert \mathbf{e} \rVert^2\)를 얻는다. \(\square\)
연습문제 3. 절편을 포함하는 모형에서 \(R^2 = \text{SSR}/\text{SST}\)를 각의 코사인 제곱으로 해석하라. \(R^2 = 1\)과 \(R^2 = 0\)은 기하적으로 각각 무엇을 뜻하는가? 중심화하지 않은 비 \(\lVert\hat{\mathbf{y}}\rVert^2/\lVert\mathbf{y}\rVert^2\)은 무엇이 다른가?
풀이
중심화한 두 벡터 \(\tilde{\mathbf{y}} = \mathbf{y} - \bar{y}\mathbf{1}\)과 \(\tilde{\mathbf{y}}_{\!*} = \hat{\mathbf{y}} - \bar{y}\mathbf{1}\)을 잡고 \(\theta\)를 둘 사이의 각이라 하자. \(\tilde{\mathbf{y}} = \tilde{\mathbf{y}}_{\!*} + \mathbf{e}\)이고 \(\mathbf{e}\)가 \(\hat{\mathbf{y}}\)과 \(\mathbf{1}\) 모두에 직교하므로 \(\tilde{\mathbf{y}}_{\!*}^\top\mathbf{e} = 0\)이며, 따라서
이다. 곧 \(R^2 = \text{SSR}/\text{SST} = \cos^2\theta\)로, 평균만 맞히는 모형에서 출발한 반응벡터와 그것을 모형 부분공간 위로 사영한 벡터 사이 각의 코사인의 제곱이다.
\(R^2 = 1\)은 \(\theta = 0\), 곧 \(\mathbf{e} = \mathbf{0}\)이므로 \(\mathbf{y}\)가 정확히 \(\text{col}(\mathbf{X})\) 안에 놓인다는 뜻이다. 자료가 잔차 없이 모형에 완벽히 들어맞는다. \(R^2 = 0\)은 \(\tilde{\mathbf{y}}_{\!*} = \mathbf{0}\), 곧 \(\hat{\mathbf{y}} = \bar{y}\mathbf{1}\)이므로 사영이 절편 방향밖에 쓰지 못한 경우다. 설명변수(explanatory variable)가 아무것도 설명하지 못한다.
중심화하지 않은 비 \(\lVert\hat{\mathbf{y}}\rVert^2/\lVert\mathbf{y}\rVert^2\)은 같은 계산을 원점 기준으로 한 것이어서 \(\mathbf{y}\)와 \(\hat{\mathbf{y}}\) 사이 각의 코사인 제곱이다. 절편이 있는 모형에서는 \(\lVert\mathbf{y}\rVert^2\) 안에 평균 수준 \(n\bar{y}^2\)이 들어 있고 그 부분은 절편이 언제나 정확히 맞히므로, 이 비는 중심화한 \(R^2\)보다 크게 나온다. 실제로 \(\lVert\hat{\mathbf{y}}\rVert^2 = \text{SSR} + n\bar{y}^2\), \(\lVert\mathbf{y}\rVert^2 = \text{SST} + n\bar{y}^2\)이므로 분자와 분모에 같은 양을 더한 꼴이며, 두 값이 일치하는 것은 \(\bar{y} = 0\)이거나 \(R^2 = 1\)일 때뿐이다. 연습문제 7에서 같은 자료에 대해 두 값을 나란히 계산한다.
연습문제 4. 영이 아닌 벡터 \(\mathbf{a}\) 하나가 펼치는 직선 위로의 직교사영이 \(\mathbf{P} = \dfrac{\mathbf{a}\mathbf{a}^\top}{\mathbf{a}^\top\mathbf{a}}\)임을 보이고, 이것이 절편 없는 단순회귀(simple linear regression)와 어떻게 연결되는지 설명하라.
풀이
사영 공식 \(\mathbf{P}_{\mathbf{X}} = \mathbf{X}(\mathbf{X}^\top\mathbf{X})^{-1}\mathbf{X}^\top\)에서 \(\mathbf{X} = \mathbf{a}\)(\(n \times 1\))로 두면 \(\mathbf{X}^\top\mathbf{X} = \mathbf{a}^\top\mathbf{a}\)가 스칼라이므로 역행렬이 곧 역수다.
멱등성은 \(\mathbf{P}^2 = \dfrac{\mathbf{a}(\mathbf{a}^\top\mathbf{a})\mathbf{a}^\top}{(\mathbf{a}^\top\mathbf{a})^2} = \mathbf{P}\), 대칭성은 \((\mathbf{a}\mathbf{a}^\top)^\top = \mathbf{a}\mathbf{a}^\top\)에서 나온다. 계수가 1이므로 \(\operatorname{tr}(\mathbf{P}) = 1\)이다.
\(\mathbf{P}\mathbf{y} = \mathbf{a}\dfrac{\mathbf{a}^\top\mathbf{y}}{\mathbf{a}^\top\mathbf{a}}\)로 쓰면 계수가 바로 읽힌다.
이것이 절편 없는 단순회귀 \(y_i = \beta a_i + \varepsilon_i\)의 최소제곱추정량이다.
import numpy as np

a = np.array([1., 2., 2.])
y = np.array([3., 1., 4.])

P = np.outer(a, a) / (a @ a)
print("P =\n", P.round(4))
print("멱등:", np.allclose(P @ P, P), " 대칭:", np.allclose(P, P.T),
      " tr:", round(np.trace(P), 6))
print("beta_hat =", round(a @ y / (a @ a), 6))
print("P y =", (P @ y).round(6), " = beta_hat * a =", (a @ y / (a @ a) * a).round(6))
출력:
P =
 [[0.1111 0.2222 0.2222]
 [0.2222 0.4444 0.4444]
 [0.2222 0.4444 0.4444]]
멱등: True  대칭: True  tr: 1.0
beta_hat = 1.444444
P y = [1.444444 2.888889 2.888889]  = beta_hat * a = [1.444444 2.888889 2.888889]
벡터 하나 위로의 사영은 앞으로 계속 쓰인다. 중심화행렬 \(\mathbf{C}\)에서 덜어 내는 \(\mathbf{I} - \mathbf{C} = \frac{1}{n}\mathbf{1}\mathbf{1}^\top\)이 \(\mathbf{1}\) 위로의 사영이고, 그람–슈미트의 각 단계도 이 형태다. \(\square\)
연습문제 5. 모자 행렬의 대각 성분 \(h_{ii}\)를 지렛대라 한다. \(0 \le h_{ii} \le 1\)이고 \(\sum_i h_{ii} = p\)임을 보여라. \(h_{ii} = 1\)이면 무엇을 뜻하는가?
풀이
\(\mathbf{H}\)가 대칭 멱등이므로 \(\mathbf{H} = \mathbf{H}^2 = \mathbf{H}^\top\mathbf{H}\)이고, 따라서
이다. 오른쪽의 합이 음이 아니므로 \(h_{ii} \ge h_{ii}^2\), 곧 \(h_{ii}(1 - h_{ii}) \ge 0\)이고 \(0 \le h_{ii} \le 1\)이다. 합은 \(\sum_i h_{ii} = \operatorname{tr}(\mathbf{H}) = p\)다.
\(h_{ii} = 1\)인 경우. 위 식에서 \(j \neq i\)인 모든 \(h_{ji} = 0\)이어야 한다. 그러면 \(\hat{y}_i = \sum_j h_{ij}y_j = y_i\)이므로 그 관측값은 정확히 맞춰진다. 잔차가 항상 0이고, 그 점은 회귀선을 자기 쪽으로 완전히 끌어당긴다.
import numpy as np

rng = np.random.default_rng(0)
n = 40
X = np.column_stack([np.ones(n), rng.normal(size=n), rng.normal(size=n)])
H = X @ np.linalg.inv(X.T @ X) @ X.T
h = np.diag(H)

print(f"지렛대 최소 {h.min():.4f}, 최대 {h.max():.4f}")
print(f"합 = {h.sum():.6f}  (= p = {X.shape[1]})")
print(f"평균 = {h.mean():.4f}  (= p/n = {X.shape[1]/n:.4f})")
출력:
지렛대 최소 0.0285, 최대 0.2371
합 = 3.000000  (= p = 3)
평균 = 0.0750  (= p/n = 0.0750)
지렛대의 평균이 \(p/n\)이므로 \(2p/n\)을 넘는 점을 주의해서 보라는 실무 규칙이 여기서 나온다. 2.3절 이상치와 지렛대점의 논의와 이어진다. \(\square\)
연습문제 6. \(\mathbf{M}_1 = \mathbf{I} - \mathbf{H}_1\)을 \(\mathbf{X}_1\)에 대한 잔차생성행렬이라 하자. \(\mathbf{y}\)를 \([\mathbf{X}_1, \mathbf{x}_2]\)에 회귀했을 때 \(\mathbf{x}_2\)의 계수가, \(\mathbf{M}_1\mathbf{y}\)를 \(\mathbf{M}_1\mathbf{x}_2\)에 회귀한 계수와 같음을 수치로 확인하라.
풀이
이것이 Frisch–Waugh–Lovell 정리다. 다중회귀(multiple regression)의 한 계수는 "다른 변수들의 영향을 걷어낸 뒤"의 단순회귀 계수와 같다.
import numpy as np

rng = np.random.default_rng(0)
n = 40
x1 = np.ones(n)
x2 = rng.normal(size=n)
x3 = 0.5 * x2 + rng.normal(size=n)          # x2 와 상관된 변수
y = 1 + 2 * x2 - 1.5 * x3 + rng.normal(size=n)

# (1) 전체 다중회귀
X = np.column_stack([x1, x2, x3])
beta_full = np.linalg.lstsq(X, y, rcond=None)[0]

# (2) x1, x2 의 영향을 걷어낸 뒤 단순회귀
X1 = np.column_stack([x1, x2])
M1 = np.eye(n) - X1 @ np.linalg.inv(X1.T @ X1) @ X1.T
y_res, x3_res = M1 @ y, M1 @ x3
beta_fwl = (x3_res @ y_res) / (x3_res @ x3_res)

print("다중회귀의 x3 계수 :", round(beta_full[2], 8))
print("FWL 로 구한 계수   :", round(beta_fwl, 8))
출력:
다중회귀의 x3 계수 : -1.44939995
FWL 로 구한 계수   : -1.44939995
두 값이 소수점 여덟째 자리까지 같다.
해석적 의미가 크다. 다중회귀의 계수 \(\hat\beta_3\)은 "\(x_3\)이 한 단위 늘 때 \(y\)의 변화"가 아니라 "다른 변수로 설명되지 않는 부분의 \(x_3\)이 한 단위 늘 때, 다른 변수로 설명되지 않는 부분의 \(y\)의 변화"다. 이것이 다중회귀 계수를 "다른 변수를 통제했을 때의 효과"로 읽는 근거이며, 13.6절의 부분회귀 그림(추가변수 그림)의 바탕이기도 하다. 그 그림은 정확히 \(\mathbf{M}_1\mathbf{y}\)를 \(\mathbf{M}_1\mathbf{x}_2\)에 대해 찍은 산점도다. \(\square\)
연습문제 7. 설계행렬 하나를 잡아 \(\mathbf{H}\)의 성질(대칭·멱등·대각합), \(\hat{\mathbf{y}} \perp \mathbf{e}\), 피타고라스 분해, 그리고 \(R^2 = \cos^2\theta\)(연습문제 3)를 모두 수치로 확인하라.
풀이
import numpy as np

rng = np.random.default_rng(1)
n, p = 30, 3
X = np.column_stack([np.ones(n), rng.normal(size=(n, p - 1))])
y = X @ np.array([1., 2., -1.]) + rng.normal(size=n)

H = X @ np.linalg.inv(X.T @ X) @ X.T
y_hat = H @ y
e = y - y_hat

print("대칭   :", np.allclose(H, H.T))
print("멱등   :", np.allclose(H @ H, H))
print("tr(H)  :", round(np.trace(H), 6), " (= p =", p, ")")
print("y_hat . e :", round(float(y_hat @ e), 12), " (직교)")

print("\n||y||^2          =", round(y @ y, 6))
print("||y_hat||^2 + ||e||^2 =", round(y_hat @ y_hat + e @ e, 6))
print("원점 기준 cos^2(theta) =", round((y_hat @ y_hat) / (y @ y), 6))

# 중심화: 1 위로의 사영을 걷어낸 뒤 같은 분해를 반복한다
yt = y - y.mean()
yt_hat = y_hat - y.mean()
sst, ssr, sse = yt @ yt, yt_hat @ yt_hat, e @ e
print("\nSST =", round(sst, 6), " SSR =", round(ssr, 6), " SSE =", round(sse, 6))
print("SSR + SSE =", round(ssr + sse, 6))
print("R^2 = SSR/SST     =", round(ssr / sst, 6))
print("R^2 = 1 - SSE/SST =", round(1 - sse / sst, 6))
출력:
대칭   : True
멱등   : True
tr(H)  : 3.0  (= p = 3 )
y_hat . e : -0.0  (직교)

||y||^2          = 158.337856
||y_hat||^2 + ||e||^2 = 158.337856
원점 기준 cos^2(theta) = 0.885583

SST = 121.938838  SSR = 103.822325  SSE = 18.116513
SSR + SSE = 121.938838
R^2 = SSR/SST     = 0.85143
R^2 = 1 - SSE/SST = 0.85143
네 성질이 모두 확인된다. 잔차와 적합값의 내적은 반올림 오차 수준에서 0이고, 피타고라스 분해는 원점 기준(\(158.337856\))과 평균 기준(\(121.938838\)) 양쪽에서 모두 성립한다.
두 \(R^2\)이 다르다. 원점 기준 값은 \(0.885583\)이고 보고되는 통상의 \(R^2\)은 \(0.851430\)이다. 차이는 \(\bar{y} = 1.1015\) 때문이다. \(\lVert\mathbf{y}\rVert^2 = \text{SST} + n\bar{y}^2 = 121.938838 + 30 \times 1.1015^2 = 158.34\)에서 보듯, 원점 기준 비는 절편이 공짜로 맞히는 평균 수준까지 설명력으로 세는 셈이다. \(R^2\)을 보고할 때는 \(\mathbf{1}\) 위로의 사영을 먼저 걷어낸 중심화된 쪽을 쓴다. \(\square\)
연습문제 8. \(\hat{\mathbf{y}} = \mathbf{H}\mathbf{y}\)가 \(\text{col}(\mathbf{X})\) 안에서 \(\mathbf{y}\)에 가장 가까운 점임을 증명하여, 모자 행렬 \(\mathbf{H}\)가 \(\lVert \mathbf{y} - \mathbf{X}\boldsymbol{\beta} \rVert^2\)을 최소화함을 보여라.
풀이
\(\mathbf{z} = \mathbf{X}\boldsymbol{\beta}\)을 \(\text{col}(\mathbf{X})\)의 임의의 벡터라 하자. \(\lVert \mathbf{y} - \hat{\mathbf{y}} \rVert \leq \lVert \mathbf{y} - \mathbf{z} \rVert\)를 보이면 된다.
\(\mathbf{y} - \mathbf{z} = (\mathbf{y} - \hat{\mathbf{y}}) + (\hat{\mathbf{y}} - \mathbf{z})\)로 쓰자. \(\mathbf{y} - \hat{\mathbf{y}} = \mathbf{e} \in \text{col}(\mathbf{X})^\perp\)이고 \(\hat{\mathbf{y}} - \mathbf{z} \in \text{col}(\mathbf{X})\)이므로 이 두 벡터는 직교한다. 피타고라스 정리에 의해
이다. 등호는 \(\mathbf{z} = \hat{\mathbf{y}}\)일 때에 한해 성립하므로 \(\hat{\mathbf{y}}\)이 유일한 최근접점임이 확인된다. \(\square\)
연습문제 9. \(\operatorname{col}(\mathbf{X}_1) \subseteq \operatorname{col}(\mathbf{X}_2)\)이고 각각의 사영을 \(\mathbf{H}_1\), \(\mathbf{H}_2\)라 하자. \(\mathbf{H}_2\mathbf{H}_1 = \mathbf{H}_1\mathbf{H}_2 = \mathbf{H}_1\)임을 보여라.
풀이
임의의 \(\mathbf{x}\)에 대해 \(\mathbf{H}_1\mathbf{x} \in \operatorname{col}(\mathbf{X}_1) \subseteq \operatorname{col}(\mathbf{X}_2)\)이다. 사영은 자기 치역의 벡터를 그대로 두므로 \(\mathbf{H}_2(\mathbf{H}_1\mathbf{x}) = \mathbf{H}_1\mathbf{x}\)이고, 따라서 \(\mathbf{H}_2\mathbf{H}_1 = \mathbf{H}_1\)이다.
두 행렬 모두 대칭이므로 전치를 취하면
이다.
F 검정의 근거. 이 성질에서 \(\mathbf{H}_2 - \mathbf{H}_1\)도 사영임이 따라 나온다.
게다가 \((\mathbf{H}_2 - \mathbf{H}_1)(\mathbf{I} - \mathbf{H}_2) = \mathbf{O}\)이므로 두 사영이 직교한다. 그래서 큰 모형과 작은 모형의 제곱합(sum of squares) 차이 \(\lVert(\mathbf{H}_2 - \mathbf{H}_1)\mathbf{y}\rVert^2\)과 잔차제곱합 \(\lVert(\mathbf{I}-\mathbf{H}_2)\mathbf{y}\rVert^2\)이 (정규성(normality) 아래에서) 독립인 카이제곱이 되고, 그 비가 \(F\) 분포를 따른다. 내포모형 F 검정의 기하가 바로 이것이다. \(\square\)
연습문제 10. 부분공간 \(\mathcal{V}\)가 주어지면 그 위로의 직교사영행렬은 유일함을 보여라.
풀이
\(\mathbf{P}_1\)과 \(\mathbf{P}_2\)가 모두 \(\mathcal{V}\) 위로의 직교사영이라 하자. 연습문제 9의 논법을 양방향으로 쓴다. 두 치역이 같으므로 \(\mathbf{P}_2\mathbf{P}_1 = \mathbf{P}_1\)이고 \(\mathbf{P}_1\mathbf{P}_2 = \mathbf{P}_2\)다.
대칭성에서
이므로 둘은 같다.
왜 중요한가. 사영 공식 \(\mathbf{X}(\mathbf{X}^\top\mathbf{X})^{-1}\mathbf{X}^\top\)은 겉보기에 \(\mathbf{X}\)에 의존하지만, 실제로는 \(\operatorname{col}(\mathbf{X})\)에만 의존한다. 같은 열공간을 주는 다른 설계행렬(예: 설명변수를 재척도화하거나 선형결합한 것)을 써도 모자 행렬은 똑같다. 회귀에서 적합값 \(\hat{\mathbf{y}}\)과 \(R^2\)이 모수화 방식에 영향받지 않는 이유가 이것이다. 반면 계수 \(\hat{\boldsymbol{\beta}}\)은 모수화에 따라 달라진다.
빗각 사영에서는 이 유일성이 성립하지 않는다. 치역이 같아도 눌러 없애는 방향이 다르면 다른 사영이다. \(\square\)
정리하며
직교사영행렬은 벡터를 부분공간 안에서 가장 가까운 점으로 보내는 대칭 멱등행렬이다. 공식 \(\mathbf{P}_{\mathbf{X}} = \mathbf{X}(\mathbf{X}^\top\mathbf{X})^{-1}\mathbf{X}^\top\)이 회귀의 모자 행렬이고, 여집합 사영 \(\mathbf{I} - \mathbf{P}_{\mathbf{X}}\)이 잔차를 만들어낸다. 적합값과 잔차의 직교성이 제곱합의 피타고라스 분해를 낳으며, 이것이 분산분석과 \(R^2\)의 기하학적 토대다.
다음 절부터 카이제곱분포와 이차형식으로 넘어간다. A.3절이 행렬의 부류를 하나씩 세웠다면, A.4절은 그것을 확률에 건다 — 적합도(goodness of fit) 통계량·분산비·잔차제곱합이 모두 정규벡터의 이차형식이고, 그것이 언제 카이제곱이 되는지는 여기서 본 멱등성과 직교사영이 정한다.