조건부 독립
앞 절의 독립은 "\(B\)를 알아도 \(A\)에 대한 믿음이 바뀌지 않는다"였다. 그런데 현실에서 우리는 보통 여러 가지를 동시에 알고 있다. 그러면 자연스러운 물음이 생긴다. \(C\)를 이미 알고 있는 상태에서 \(B\)를 추가로 알면 \(A\)에 대해 더 알게 되는 것이 있는가?
없다면 \(A\)와 \(B\)는 \(C\)가 주어졌을 때 조건부 독립이다. 기호로는 \(A \perp\!\!\!\perp B \mid C\)로 쓴다.
이 개념이 중요한 것은 놀라운 사실 하나 때문이다. 독립과 조건부 독립 사이에는 어느 방향으로도 논리적 함의가 없다. 독립이던 두 사건이 조건을 걸면 종속이 되기도 하고, 종속이던 두 사건이 조건을 걸면 독립이 되기도 한다.
이 절은 세 개의 정리로 이루어진다. 조건부 독립의 정의(정리 1), 독립이 조건부 독립을 함의하지 않는다는 것(정리 2), 그리고 그 역도 성립하지 않는다는 것(정리 3)이다.
1. 이미 알고 있는 것 위에서의 독립
정의는 앞 절의 독립에 "모든 확률을 \(C\)로 조건 건 채로"라는 단서를 붙인 것이다.
정리 1. 조건부 독립의 정의 — 조건을 건 세계 안에서의 곱
\(P(C) > 0\)일 때, 사건 \(A\)와 \(B\)가 \(C\)가 주어졌을 때 조건부 독립이라는 것은
를 뜻한다. \(P(B \cap C) > 0\)이면 이는
와 동등하며, 이 형태가 뜻을 더 잘 드러낸다. \(C\)를 이미 알고 있다면 \(B\)는 \(A\)에 대해 새로운 정보를 주지 않는다.
증명
\(P(B \cap C) > 0\)이라 하자. 조건부확률의 정의를 두 번 쓰면
이다(분자와 분모를 각각 \(P(C)\)로 나누었다). 따라서
이다. 즉 두 형태는 동등하다. 곱 형태는 \(P(B \mid C) = 0\)일 때도 양변이 \(0\)이 되어 성립하므로 단서가 덜 붙는다. \(\square\)
3.1절 조건부확률 문서의 연습문제 3에서 \(P(\cdot \mid C)\)가 그 자체로 확률측도임을 확인했다. 그래서 조건부 독립은 "\(C\)로 좁혀진 세계 안에서의 보통의 독립"일 뿐이며, 독립의 모든 성질이 그대로 성립한다.
보기 1. 같은 시험을 치르는 두 학생. 학생 \(A\)와 \(B\)가 같은 시험을 친다. \(C\) = "시험이 쉬웠다"라 하자.
시험 난이도를 알고 나면 \(A\)의 합격 여부는 \(B\)에 대해 거의 아무것도 말해 주지 않는다. 둘의 실력은 별개이기 때문이다. 그러나 난이도를 모르는 상태라면 \(A\)가 합격했다는 소식은 시험이 쉬웠을 가능성을 높이고, 따라서 \(B\)의 합격 가능성도 높인다.
풀이
이 절에서 볼 두 상황은 \(A\), \(B\), \(C\) 셋이 놓인 모양이 다르다. 미리 나란히 놓고 보면 나머지가 그 두 그림의 설명이다.
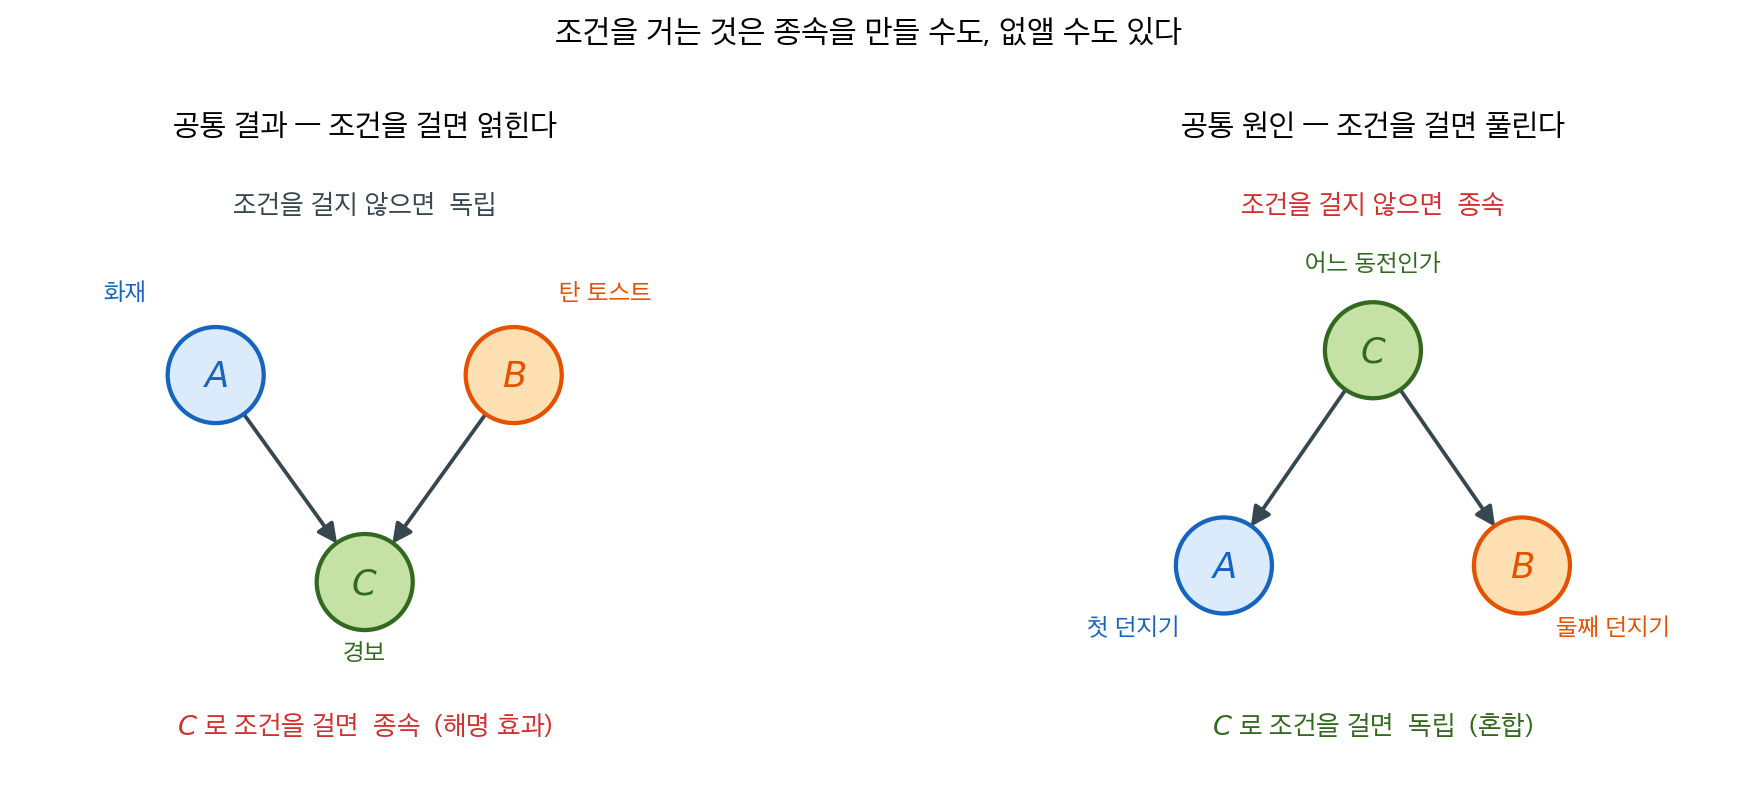
화살표는 "원인에서 결과로"를 뜻한다. 왼쪽은 \(A\)와 \(B\)가 같은 결과를 만들어 내는 두 원인이고, 오른쪽은 \(A\)와 \(B\)가 같은 원인에서 갈라져 나온 두 결과다. 화살표를 뒤집은 것뿐인데 조건을 걸었을 때 벌어지는 일이 정반대다. 왼쪽에서는 \(C\)를 알면 두 원인이 서로 경쟁하게 되어 종속이 생기고, 오른쪽에서는 \(C\)를 알면 두 결과가 공유하던 것이 사라져 종속이 없어진다.
조건을 거는 것은 정보를 더하는 일이지 종속을 줄이는 일이 아니다. 아래 두 절이 각각 이 두 그림을 자세히 본다.
2. 독립이던 것이 조건을 걸면 종속이 된다
두 사건이 독립이라고 해서 조건을 건 뒤에도 독립일 이유는 없다. 특히 조건이 되는 사건이 두 사건의 공통 결과일 때 반드시 종속이 생긴다.
정리 2. 해명 효과 — 공통 결과로 조건을 걸면 원인들이 얽힌다
\(A\)와 \(B\)가 독립인 두 원인이고 \(C\)가 그 공통 결과라 하자. 그러면 일반적으로
이다. 이를 해명 효과(explaining away) 또는 버크슨의 역설이라 한다.
보기 2. 화재경보기. 경보(\(C\))는 화재(\(A\)) 때문에 울릴 수도 있고 탄 토스트(\(B\)) 때문에 울릴 수도 있다. 두 원인은 서로 무관하다.
풀이
그런데 경보가 울렸다는 사실을 알고 나면 사정이 달라진다. 원인 중 하나가 아니라는 것을 알면 다른 하나일 가능성이 올라간다.
화재가 아니라는 말을 듣는 순간 토스트 쪽으로 무게가 쏠린다. 한 원인이 결과를 "해명해 버리면" 다른 원인이 필요 없어지는 것이다.
import numpy as np

def berkson_paradox_simulation(n_simulations=200_000):
    """버크슨의 역설: 독립인 두 사건이 조건을 걸면 종속이 된다.

    공통의 결과를 조건으로 삼으면, 원인 하나가 일어났다는 사실이
    나머지 원인의 확률을 낮춘다. 한쪽이 이미 설명해 버리기 때문이다.
    """
    np.random.seed(42)

    # 두 원인과 하나의 공통 결과.
    #   fire  = 화재 (드묾)
    #   toast = 토스트 태움 (흔함)
    #   alarm = 경보기 울림 (둘 중 하나만 일어나도 울린다)
    p_fire = 0.01
    p_toast = 0.10

    # 두 원인을 서로 **완전히 독립으로** 생성한다는 점이 중요하다.
    # 각자 따로 난수를 뽑으므로 설계상 아무 관계가 없다.
    fire = np.random.rand(n_simulations) < p_fire
    toast = np.random.rand(n_simulations) < p_toast
    alarm = fire | toast      # 공통 결과(충돌부, collider)

    # 조건 없이 보면 정말 독립이다.
    # fire[toast] 는 "토스트를 태운 시행들만" 골라 낸 것이고,
    # 그 안에서의 화재 비율이 전체 화재 비율과 같아야 한다.
    p_fire_given_toast = fire[toast].mean()
    print(f"P(fire) = {fire.mean():.4f}")
    print(f"P(fire | toast) = {p_fire_given_toast:.4f}")
    print(f"Unconditionally independent: {abs(fire.mean() - p_fire_given_toast) < 0.005}\n")

    # 그런데 공통 결과인 alarm 으로 조건을 걸면 둘이 얽힌다.
    # 경보가 울렸는데 토스트를 태우지 않았다면, 남은 설명은 화재뿐이다.
    # 한 원인을 배제하면 다른 원인의 확률이 치솟는 이 현상을
    # "설명해 없애기(explaining away)" 또는 버크슨의 역설이라 한다.
    p_fire_given_alarm = fire[alarm].mean()
    p_fire_given_alarm_no_toast = fire[alarm & ~toast].mean()
    print(f"P(fire | alarm) = {p_fire_given_alarm:.4f}")
    print(f"P(fire | alarm, no toast) = {p_fire_given_alarm_no_toast:.4f}")
    print(f"Conditionally dependent (explaining away): "
          f"{abs(p_fire_given_alarm - p_fire_given_alarm_no_toast) > 0.01}")

berkson_paradox_simulation()
출력:
P(fire) = 0.0098
P(fire | toast) = 0.0101
Unconditionally independent: True

P(fire | alarm) = 0.0899
P(fire | alarm, no toast) = 1.0000
Conditionally dependent (explaining away): True
이것이 1장의 길이 편향·충돌변수와 같은 구조다
해명 효과는 확률의 퍼즐로 끝나지 않는다. 12장에서 충돌변수(collider) 라 부르는 것이 정확히 이 구조이며, 회귀에 변수를 무분별하게 넣으면 추정이 나아지기는커녕 나빠지는 이유가 여기에 있다.
실제 사례도 많다. 병원 입원 환자만 조사하면 서로 무관한 두 질병이 음의 상관을 보인다(입원이 공통 결과다). 명문대 합격생만 보면 성적과 특기가 음의 상관을 보인다(합격이 공통 결과다).
규칙: 공통 원인은 통제해야 하고, 공통 결과는 통제하면 안 된다. 12장의 방향성 비순환 그래프가 이 규칙을 형식화한다.
보기 3. 합이 알려진 주사위. 극단적인 경우도 있다. 공정한 주사위 두 개에서 \(A\) = "1번이 4", \(B\) = "2번이 3"이라 하면 이 둘은 독립이다. 그런데 \(C\) = "합이 7"로 조건을 걸면
풀이
이고 \(\tfrac{1}{6} \neq \tfrac{1}{36}\)이다. 합이 7인 세계에서는 1번이 4이면 2번이 3임이 확정된다. 독립이 완전한 종속으로 뒤집혔다.
3. 종속이던 것이 조건을 걸면 독립이 된다
반대 방향도 성립한다. 이쪽은 오히려 통계 모형에서 훨씬 흔하게 쓰이는 구조다.
정리 3. 혼합과 조건부 독립 — 숨은 공통 원인이 종속을 만든다
관측들이 어떤 숨은 변수 \(C\)를 공유하면, \(C\)를 모르는 상태에서는 서로 종속이지만 \(C\)를 알고 나면 독립이 된다.
보기 4. 어느 동전인지 모르는 두 번의 던지기. 동전을 무작위로 하나 고른다. 1번 동전은 \(P(H) = 0.3\), 2번 동전은 \(P(H) = 0.7\)이다. \(C\)를 "어느 동전을 골랐는가", \(A\)와 \(B\)를 두 번의 던지기 결과라 하자.
동전이 정해지고 나면 두 던지기는 명백히 독립이다.
풀이
그러나 어느 동전인지 모르면 두 던지기는 종속이다. 첫 던지기가 앞면이면 앞면이 잘 나오는 동전일 가능성이 높아지고, 그러면 두 번째도 앞면일 확률이 올라간다. 첫 던지기가 두 번째에 대해 정보를 주는 것이다.
import numpy as np

def mixture_coin_simulation(n_simulations=200_000):
    """혼합모형에서 조건부독립을 보인다.

    앞 절의 버크슨 역설과 정확히 반대 방향의 예다.
      버크슨: 독립이던 것이 조건을 걸면 종속이 된다 (공통 결과로 조건)
      여기  : 종속이던 것이 조건을 걸면 독립이 된다 (공통 원인으로 조건)
    """
    np.random.seed(42)

    # 숨은 공통 원인: 어느 동전을 골랐는가.
    #   동전 0은 앞면 확률 0.3, 동전 1은 0.7.
    # 관측자는 이 값을 볼 수 없고 던진 결과만 본다.
    coin = np.random.randint(0, 2, size=n_simulations)
    p_heads = np.where(coin == 0, 0.3, 0.7)

    # 같은 동전을 두 번 던진다. 두 번의 던짐은 동전이 정해지면 서로 무관하다.
    flip1 = np.random.rand(n_simulations) < p_heads
    flip2 = np.random.rand(n_simulations) < p_heads

    # 조건 없이 보면 종속이다.
    # 첫 번째가 앞면이면 "0.7짜리 동전일 가능성"이 커지고,
    # 그 정보가 두 번째 던짐의 예측을 바꾸기 때문이다.
    p_f2 = flip2.mean()
    p_f2_given_f1 = flip2[flip1].mean()
    print("=== Unconditional (marginal) ===")
    print(f"P(flip2=H) = {p_f2:.4f}")
    print(f"P(flip2=H | flip1=H) = {p_f2_given_f1:.4f}")
    print(f"Not independent: {abs(p_f2 - p_f2_given_f1) > 0.01}\n")

    # 그런데 동전이 무엇인지 알고 나면(= 공통 원인으로 조건을 걸면)
    # 첫 번째 결과가 더 알려 줄 것이 없어져 두 던짐이 독립이 된다.
    mask_c0 = coin == 0
    p_f2_c0 = flip2[mask_c0].mean()
    p_f2_given_f1_c0 = flip2[mask_c0 & flip1].mean()
    print("=== Conditional on coin 0 (P(H)=0.3) ===")
    print(f"P(flip2=H | coin=0) = {p_f2_c0:.4f}")
    print(f"P(flip2=H | flip1=H, coin=0) = {p_f2_given_f1_c0:.4f}")
    print(f"Conditionally independent: {abs(p_f2_c0 - p_f2_given_f1_c0) < 0.02}")

mixture_coin_simulation()
출력:
=== Unconditional (marginal) ===
P(flip2=H) = 0.5008
P(flip2=H | flip1=H) = 0.5809
Not independent: True

=== Conditional on coin 0 (P(H)=0.3) ===
P(flip2=H | coin=0) = 0.3007
P(flip2=H | flip1=H, coin=0) = 0.3004
Conditionally independent: True
이 구조가 통계 모형의 표준 골격이다. "모수 \(\theta\)가 주어지면 관측들은 i.i.d.이다" 라는 문장이 바로 \(X_i \perp\!\!\!\perp X_j \mid \theta\)를 말하고 있다. \(\theta\)를 모르는 우리에게 관측들은 종속으로 보이며, 그 종속성이 바로 자료가 \(\theta\)에 대해 알려 주는 정보다.
네 가지 조합이 모두 가능하다.
| 상황 | \(A \perp\!\!\!\perp B\) | \(A \perp\!\!\!\perp B \mid C\) |
|---|---|---|
| 독립이고 조건을 걸어도 독립 | ✓ | ✓ |
| 독립이지만 조건을 걸면 종속 (해명 효과) | ✓ | ✗ |
| 종속이지만 조건을 걸면 독립 (혼합) | ✗ | ✓ |
| 종속이고 조건을 걸어도 종속 | ✗ | ✗ |
연습문제
연습문제 1. 구름 \(C\), 비 \(R\), 우산 \(U\)에 대해 \(P(C) = 0.4\), \(P(R \mid C) = 0.6\), \(P(R \mid C^c) = 0.1\), \(P(U \mid R) = 0.9\), \(P(U \mid R^c) = 0.2\)이고 \(U \perp\!\!\!\perp C \mid R\)을 가정한다. (a) \(C\)와 \(U\)는 독립인가? (b) \(C \perp\!\!\!\perp U \mid R\)을 확인하라.
풀이
(a) \(P(R) = 0.6 \cdot 0.4 + 0.1 \cdot 0.6 = 0.30\)이고 \(P(U) = 0.9 \cdot 0.3 + 0.2 \cdot 0.7 = 0.41\)이다.
\(P(U \mid C) = P(U \mid R) P(R \mid C) + P(U \mid R^c) P(R^c \mid C) = 0.9 \cdot 0.6 + 0.2 \cdot 0.4 = 0.62\)이다.
\(0.62 \ne 0.41\)이므로 \(C\)와 \(U\)는 조건 없이는 독립이 아니다.
(b) 가정에 의해 \(P(U \mid R, C) = P(U \mid R)\)이다. 따라서
이므로 \(C \perp\!\!\!\perp U \mid R\)이다. 비가 구름과 우산 사이의 연관을 "가려낸다". 비가 오는지 알고 나면 구름은 우산에 대해 더 이상의 정보를 주지 않는다.
연습문제 2. 버크슨의 역설. \(A, B\)가 입원 \(C\)에 대한 서로 독립인 두 위험요인이라 하자. 전체적으로는 독립인데도 \(C\)를 조건으로 하면 \(A\)와 \(B\)가 음의 상관을 갖게 됨을 보여라.
풀이
\(A, B \in \{0, 1\}\)이 독립인 Bernoulli(\(p\))이고 \(A = 1\) 또는 \(B = 1\)이면 입원한다고 하자(즉 \(C = A \cup B\)).
\(P(A = 1 \mid C) = P(A = 1, C)/P(C) = P(A = 1)/P(C) = p/(2p - p^2)\)이며, \(p = 0.5\)이면 \(0.5/0.75 = 2/3\)이다.
\(P(A = 1 \mid B = 1, C) = P(A = 1 \mid B = 1) = p = 0.5\)이다(\(B = 1\)이면 \(C\)가 따라오므로).
\(P(A = 1 \mid B = 0, C) = 1\)이다(\(B = 0\)인 입원자 중에서는 \(A\)가 반드시 1이어야 하므로).
따라서 \(C\)가 주어졌을 때 \(B = 1\)임을 알면 \(P(A = 1)\)이 2/3에서 1/2로 줄어들고, \(B = 0\)임을 알면 1로 올라간다. 조건 없이는 독립인데도 \(C\)를 조건으로 하면 둘이 음으로 연관된다. 공통 결과(충돌변수)로 조건을 걸면 허위 연관이 생긴다.
현실적 영향: 입원 환자로 국한된 의학 연구는 독립적인 위험요인들 사이에서 음의 연관을 흔히 발견한다. 버크슨의 병원 편향이다.
연습문제 3. 혼합분포. 동전을 무작위로 고르는데 1번 동전은 \(P(H) = 0.3\), 2번 동전은 \(P(H) = 0.7\)이다. 고른 동전을 두 번 던져 \(X_1, X_2\)를 얻는다. \(X_1 \perp\!\!\!\perp X_2\)는 성립하지 않지만 \(X_1 \perp\!\!\!\perp X_2 \mid \text{동전}\)은 성립함을 보여라.
풀이
동전 선택이 주어지면 두 던지기는 조건부 독립이다(같은 동전이고, 어느 동전인지 주어지면 던지기끼리 독립이다).
조건 없이는 다음과 같다.
\(P(X_1 = H) = 0.5 \cdot 0.3 + 0.5 \cdot 0.7 = 0.5\)이고 \(X_2\)도 같다.
\(P(X_1 = H, X_2 = H) = 0.5 \cdot 0.3^2 + 0.5 \cdot 0.7^2 = 0.045 + 0.245 = 0.29 \ne 0.25 = 0.5 \cdot 0.5\).
따라서 조건 없이는 \(X_1\)과 \(X_2\)가 양의 상관을 갖는다. 첫 던지기가 앞면이면 앞면 쪽으로 치우친 동전이 선택되었을 가능성이 높아 두 번째도 앞면일 가능성이 커진다.
양의 상관 \(\rho(X_1, X_2) > 0\)은 잠재적인 동전 선택에 관한 정보를 반영한다. 동전 선택을 알고 나면(즉 그것으로 조건을 걸면) 상관이 사라진다. 이것이 통계학에서 잠재변수 모형의 근거다. 관측된 상관이 관측되지 않은 공통 원인으로 설명될 수 있다.
연습문제 4. 마르코프 연쇄. 마르코프 연쇄 \(X_0, X_1, X_2, \ldots\)는 \(X_n \perp\!\!\!\perp \{X_0, \ldots, X_{n-2}\} \mid X_{n-1}\)을 만족한다. 이 성질을 말로 표현하고 그것이 어떻게 다루기 쉬운 추론을 가능하게 하는지 설명하라.
풀이
마르코프 성질(말로): 현재(\(X_{n-1}\))가 주어지면 미래(\(X_n\))는 과거(\(X_0, \ldots, X_{n-2}\))와 조건부 독립이다. 현재가 과거로부터 미래를 "가려낸다".
다루기 쉬운 추론: \((X_0, \ldots, X_T)\)의 결합분포가 다음과 같이 분해된다.
각 조건부확률이 전체 이력이 아니라 바로 앞 상태에만 의존한다. 상태공간의 크기가 \(k\)로 유한하면 초기 상태 확률 \(k\)개와 전이 확률 \(k^2\)개만 필요하고, \(T + 1\)개 변수에 대한 완전히 일반적인 결합분포가 요구하는 지수적으로 많은 모수가 필요 없다.
마르코프 연쇄는 언어 모형, 은닉 마르코프 모형, MCMC 표집, 대기행렬 이론, 페이지랭크의 바탕이 된다. 이들을 다루기 쉽게 만드는 것이 바로 이 조건부 독립 구조다.
연습문제 5. 사슬 구조. 세 변수 \(X, Y, Z\)가 "사슬" \(X \to Z \to Y\)을 이룬다. 분해 \(P(X, Y, Z) = P(X) P(Z \mid X) P(Y \mid Z)\)로부터 \(X \perp\!\!\!\perp Y \mid Z\)를 확인하라.
풀이
\(P(Y \mid X, Z) = P(X, Y, Z)/P(X, Z) = P(X) P(Z \mid X) P(Y \mid Z)/(P(X) P(Z \mid X)) = P(Y \mid Z)\)이다.
\(P(Y \mid X, Z) = P(Y \mid Z)\)가 \(X\)에 의존하지 않으므로 \(Y\)는 \(Z\)가 주어졌을 때 \(X\)와 조건부 독립이다.
동등한 방식: \(P(X \cap Y \mid Z) = P(X \mid Z) P(Y \mid Z, X) = P(X \mid Z) P(Y \mid Z)\).
인과적 해석: \(X\)가 오직 \(Z\)를 통해서만 \(Y\)에 영향을 준다면(\(X \to Y\)의 직접 화살표가 없다면) \(Z\)를 알고 난 뒤에는 \(X\)가 \(Y\)에 대해 더 이상의 정보를 주지 않는다. 이것이 인과 그래프의 d-분리 규칙에서 말하는 "사슬" 패턴이다.
이와 대조적으로 충돌변수 \(X \to Z \leftarrow Y\)에서는 \(Z\)로 조건을 걸면 \(X\)와 \(Y\) 사이에 허위 종속성이 생긴다. 사슬 패턴과 정반대다. 사슬, 갈래, 충돌변수를 구별하는 것이 그래프 인과모형의 핵심이다.
연습문제 6. "해명" 효과. 결과 \(E\)에 대해 두 원인 \(A, B\)가 있는 베이즈 망에서 \(A\)와 \(B\)의 사전확률이 독립이라 하자. \(E\)를 관측한 뒤 \(A\)가 일어났음을 알게 되면 \(B\)도 일어났을 사후확률이 줄어든다. \(P(A) = P(B) = 0.1\), \(P(E \mid A, B) = 1\), \(P(E \mid A, B^c) = 0.8\), \(P(E \mid A^c, B) = 0.8\), \(P(E \mid A^c, B^c) = 0\)으로 보여라.
풀이
결합확률을 계산한다.
\(P(A, B, E) = 0.1 \cdot 0.1 \cdot 1 = 0.01\). \(P(A, B^c, E) = 0.1 \cdot 0.9 \cdot 0.8 = 0.072\). \(P(A^c, B, E) = 0.9 \cdot 0.1 \cdot 0.8 = 0.072\). \(P(A^c, B^c, E) = 0.9 \cdot 0.9 \cdot 0 = 0\).
\(P(E) = 0.01 + 0.072 + 0.072 + 0 = 0.154\).
사후확률:
\(P(B \mid E) = (0.01 + 0.072)/0.154 = 0.082/0.154 \approx 0.532\).
\(P(B \mid A, E) = P(A, B, E)/P(A, E) = 0.01/(0.01 + 0.072) = 0.01/0.082 \approx 0.122\).
따라서 결과를 관측한 뒤 \(A\)도 일어났음을 알게 되면 \(B\)의 확률이 53%에서 12%로 떨어진다. 관측된 결과가 \(A\)에 의해 "해명된" 것이다. \(A\)가 \(E\)를 일으켰음을 알고 나면 대안 원인 \(B\)의 가능성이 낮아진다.
현실 사례: 경보가 울렸을 때 처음에는 도둑이나 지진을 의심한다. 라디오에서 방금 지진이 났다는 소식을 들으면 경보가 설명되고 도둑 가설의 가능성이 낮아진다. 이것이 베이즈적 추론에서 "경쟁하는 설명"의 형식적 기제다.
연습문제 7. 연습문제 \(2\)(충돌부), \(3\)(포크), \(5\)(사슬)가 다룬 세 구조를 하나로 정리하라. 사슬·포크·충돌부에서 조건을 걸면 각각 어떻게 되는가?
풀이
import numpy as np

rng = np.random.default_rng(0)
N = 600_000

def partial_corr(a, b, c):
    """c 에 회귀한 잔차들의 상관 = c 를 조건으로 한 상관"""
    ra = a - np.polyval(np.polyfit(c, a, 1), c)
    rb = b - np.polyval(np.polyfit(c, b, 1), c)
    return np.corrcoef(ra, rb)[0, 1]

# 사슬 X → Z → Y
x1 = rng.normal(size=N); z1 = x1 + rng.normal(size=N); y1 = z1 + rng.normal(size=N)
# 포크 X ← Z → Y
z2 = rng.normal(size=N); x2 = z2 + rng.normal(size=N); y2 = z2 + rng.normal(size=N)
# 충돌부 X → Z ← Y
x3 = rng.normal(size=N); y3 = rng.normal(size=N); z3 = x3 + y3 + rng.normal(size=N)

print(f"{'구조':>18}{'주변 상관':>12}{'Z 조건부':>12}")
for name, (a, b, c) in [("사슬  X→Z→Y", (x1, y1, z1)),
                        ("포크  X←Z→Y", (x2, y2, z2)),
                        ("충돌부 X→Z←Y", (x3, y3, z3))]:
    print(f"{name:>18}{np.corrcoef(a, b)[0, 1]:>+12.4f}{partial_corr(a, b, c):>+12.4f}")
출력:
                구조       주변 상관       Z 조건부
         사슬  X→Z→Y     +0.5782     -0.0006
         포크  X←Z→Y     +0.5004     +0.0009
         충돌부 X→Z←Y     +0.0015     -0.4999
세 구조가 정확히 두 부류로 갈린다.
| 구조 | 주변 | \(Z\) 조건부 | \(Z\) 의 역할 |
|---|---|---|---|
| 사슬 \(X\to Z\to Y\) | 종속 \((+0.58)\) | 독립 \((-0.001)\) | 매개 |
| 포크 \(X\leftarrow Z\to Y\) | 종속 \((+0.50)\) | 독립 \((+0.001)\) | 공통 원인 |
| 충돌부 \(X\to Z\leftarrow Y\) | 독립 \((+0.001)\) | 종속 \((-0.50)\) | 공통 결과 |
사슬과 포크에서는 조건을 걸면 경로가 막힌다. 정보가 \(Z\)를 통해 흐르고 있었으므로, \(Z\)를 고정하면 흐름이 끊긴다.
충돌부는 정반대다. 조건을 걸면 없던 경로가 열린다. 정리 \(2\)의 해명 효과가 이것이며, 1장 관찰연구 문서에서 본 충돌부 편향과 같다.
이 세 규칙이 d-분리의 전부다. 임의의 베이즈망에서 두 노드가 조건집합 \(S\)에 의해 분리되는지는, 두 노드를 잇는 모든 경로에 대해
- 경로 위의 사슬이나 포크 중심이 \(S\)에 있으면 → 그 경로는 막힌다
- 경로 위의 충돌부가 \(S\)에 없고 그 후손도 \(S\)에 없으면 → 그 경로는 막힌다
를 확인하면 된다. 모든 경로가 막히면 조건부 독립이다.
후손 조항이 미묘하다. 충돌부 \(Z\) 자체가 아니라 \(Z\)의 자식에 조건을 걸어도 경로가 열린다. \(Z\)에 대한 부분적 정보만으로도 \(X\)와 \(Y\)가 얽히기 때문이다.
실무적 함의는 1장의 결론 그대로다. 무엇을 통제할지는 자료가 아니라 그래프가 정한다. 사슬·포크의 중심은 통제하고(교란 제거), 충돌부는 통제하지 않는다(편향 생성). \(\square\)
연습문제 8. 주변 독립과 조건부 독립 사이에는 어떤 함의도 없다. 네 가지 조합이 모두 가능함을 보여라.
풀이
import numpy as np

rng = np.random.default_rng(2)
N = 600_000

def partial_corr(a, b, c):
    ra = a - np.polyval(np.polyfit(c, a, 1), c)
    rb = b - np.polyval(np.polyfit(c, b, 1), c)
    return np.corrcoef(ra, rb)[0, 1]

cases = {}
# (1) 둘 다 독립: X, Y, Z 모두 무관
x = rng.normal(size=N); y = rng.normal(size=N); z = rng.normal(size=N)
cases["주변 O, 조건부 O"] = (x, y, z)
# (2) 주변 독립, 조건부 종속: 충돌부
x = rng.normal(size=N); y = rng.normal(size=N); z = x + y + rng.normal(size=N)
cases["주변 O, 조건부 X"] = (x, y, z)
# (3) 주변 종속, 조건부 독립: 포크
z = rng.normal(size=N); x = z + rng.normal(size=N); y = z + rng.normal(size=N)
cases["주변 X, 조건부 O"] = (x, y, z)
# (4) 둘 다 종속: 포크 + 직접 경로
z = rng.normal(size=N); x = z + rng.normal(size=N); y = z + 0.8 * x + rng.normal(size=N)
cases["주변 X, 조건부 X"] = (x, y, z)

print(f"{'경우':>18}{'주변 상관':>12}{'조건부 상관':>14}")
for name, (a, b, c) in cases.items():
    print(f"{name:>18}{np.corrcoef(a, b)[0, 1]:>+12.4f}{partial_corr(a, b, c):>+14.4f}")
출력:
                경우       주변 상관        조건부 상관
       주변 O, 조건부 O     -0.0001       -0.0000
       주변 O, 조건부 X     +0.0000       -0.5003
       주변 X, 조건부 O     +0.5000       +0.0009
       주변 X, 조건부 X     +0.8328       +0.6254
네 조합이 모두 실현된다. 따라서
이다. 두 개념은 논리적으로 무관하다.
이것이 왜 중요한가.
- "통제하면 관계가 사라진다"와 "통제하면 관계가 생긴다"가 둘 다 가능하다. 어느 쪽인지는 자료가 아니라 인과 구조가 정한다.
- 회귀에서 변수를 추가할 때마다 계수가 어떻게 변할지 예측할 수 없다. 커질 수도, 작아질 수도, 부호가 바뀔 수도 있다(1장 교란 문서 연습문제 7의 억제 현상).
- "모든 변수를 통제하는 것이 안전하다"는 틀렸다. 경우 (2)가 반례다.
한 가지 예외적인 상황이 있다. 모든 변수가 결합정규이고 관계가 선형이면, 조건부 독립이 편상관 \(= 0\)과 동치가 된다. 그래서 가우시안 그래프 모형에서는 정밀도행렬(공분산의 역행렬)의 \(0\) 원소가 곧 조건부 독립이다. 일반 분포에서는 이런 깔끔한 대응이 없다. \(\square\)
연습문제 9. 나이브 베이즈 분류기는 "특징들이 클래스가 주어졌을 때 조건부 독립"이라고 가정한다. 이 가정이 깨지면 어떻게 되는가?
풀이
import numpy as np
from sklearn.naive_bayes import GaussianNB
from sklearn.discriminant_analysis import LinearDiscriminantAnalysis
from sklearn.model_selection import cross_val_score

rng = np.random.default_rng(1)
n = 4000

print(f"{'클래스 내 상관':>14}{'나이브 베이즈':>15}{'LDA (상관 반영)':>18}{'확률 보정 오차':>16}")
for rho in (0.0, 0.5, 0.9, 0.99):
    y = rng.integers(0, 2, n)
    L = np.linalg.cholesky([[1, rho], [rho, 1]])
    X = rng.normal(size=(n, 2)) @ L.T + np.column_stack([y * 1.2, y * 1.2])

    acc_nb = cross_val_score(GaussianNB(), X, y, cv=5).mean()
    acc_lda = cross_val_score(LinearDiscriminantAnalysis(), X, y, cv=5).mean()

    proba = GaussianNB().fit(X, y).predict_proba(X)[:, 1]
    err = cnt = 0.0
    for lo in np.arange(0, 1, 0.2):
        m = (proba >= lo) & (proba < lo + 0.2)
        if m.sum() > 30:
            err += abs(proba[m].mean() - y[m].mean()) * m.sum()
            cnt += m.sum()
    print(f"{rho:>14.2f}{acc_nb:>15.4f}{acc_lda:>18.4f}{err / max(cnt, 1):>16.4f}")
출력:
      클래스 내 상관        나이브 베이즈       LDA (상관 반영)        확률 보정 오차
          0.00         0.8105            0.8095          0.0068
          0.50         0.7525            0.7550          0.0589
          0.90         0.7335            0.7343          0.0879
          0.99         0.7233            0.7238          0.1035
놀라운 결과가 나온다.
| 클래스 내 상관 | NB 정확도 | LDA 정확도 | NB 보정 오차 |
|---|---|---|---|
| \(0.0\) | \(0.811\) | \(0.810\) | \(0.007\) |
| \(0.9\) | \(0.734\) | \(0.734\) | \(0.088\) |
| \(0.99\) | \(0.723\) | \(0.724\) | \(\mathbf{0.104}\) |
분류 정확도는 상관을 제대로 반영하는 LDA와 사실상 같다. 가정이 심하게 깨져도 그렇다.
그런데 확률 추정은 무너진다. 보정 오차가 \(0.007\)에서 \(0.104\)로 \(15\)배 커진다. 1장 모형 대 알고리즘 문서 연습문제 8에서 본 나이브 베이즈의 과신이 정확히 이 현상이다.
왜 정확도는 견디는가. 분류에서 중요한 것은 \(P(y=1\mid x) > 0.5\)인지 여부, 즉 결정 경계의 위치다. 조건부 독립 가정이 깨지면 확률 추정값이 극단으로 밀리지만, 밀리는 방향이 단조적이라 순서가 보존된다. 순서가 보존되면 경계도 대체로 유지된다.
함의.
- 분류가 목적이면 나이브 베이즈는 가정이 깨져도 쓸 만하다. 계산이 빠르고 고차원에서 안정적이라 텍스트 분류에서 여전히 기준선으로 쓰인다.
- 확률이 목적이면 쓰지 마라. 기대손실 계산이나 임계값 최적화처럼 확률의 크기가 중요한 곳에서는 심각하게 틀린다.
- 보정으로 고칠 수 있다. 이소토닉 회귀나 플랫 스케일링으로 사후 보정하면 순서를 유지한 채 확률만 바로잡는다.
더 일반적인 교훈. 모형의 가정이 틀렸다고 모형이 쓸모없는 것은 아니다. 어떤 목적에는 치명적이고 어떤 목적에는 무해하다. "이 가정이 틀리면 내가 쓰려는 양이 얼마나 틀리는가" 를 물어야 하며, 그 답은 목적마다 다르다. \(\square\)
연습문제 10. 연습문제 \(3\)의 혼합 구조를 일반화하라. 교환가능성이란 무엇이며 조건부 독립과 어떤 관계인가?
풀이
확률변수열 \(X_1, X_2, \ldots\)가 교환가능하다는 것은, 임의의 유한 부분열의 결합분포가 순서를 바꾸어도 같다는 뜻이다.
i.i.d.이면 교환가능하지만 역은 성립하지 않는다.
import numpy as np
from scipy import stats

rng = np.random.default_rng(5)
N = 400_000
n = 6

# 동전의 앞면 확률 theta 를 Beta(2,2) 에서 뽑고, 그 동전을 n 번 던진다
theta = rng.beta(2, 2, N)
X = (rng.random((N, n)) < theta[:, None]).astype(int)

print("교환가능성 확인: 순서만 다른 수열의 확률")
for pattern in [(1, 1, 0, 0, 0, 0), (0, 0, 1, 1, 0, 0), (0, 0, 0, 0, 1, 1)]:
    print(f"  {pattern}: {np.mean((X == np.array(pattern)).all(axis=1)):.6f}")

print(f"\n주변 독립인가?")
print(f"  P(X1=1)        = {X[:, 0].mean():.6f}")
print(f"  P(X1=1 | X2=1) = {X[X[:, 1] == 1, 0].mean():.6f}   ← 다르다")

print(f"\ntheta 를 조건으로 하면?")
for lo in (0.2, 0.5, 0.8):
    m = np.abs(theta - lo) < 0.02
    p1 = X[m, 0].mean()
    p1_given = X[m & (X[:, 1] == 1), 0].mean()
    print(f"  theta≈{lo}: P(X1=1)={p1:.4f}, P(X1=1|X2=1)={p1_given:.4f}   ← 같다")
출력:
교환가능성 확인: 순서만 다른 수열의 확률
  (1, 1, 0, 0, 0, 0): 0.011795
  (0, 0, 1, 1, 0, 0): 0.012190
  (0, 0, 0, 0, 1, 1): 0.012105

주변 독립인가?
  P(X1=1)        = 0.498875
  P(X1=1 | X2=1) = 0.598010   ← 다르다

theta 를 조건으로 하면?
  theta≈0.2: P(X1=1)=0.2038, P(X1=1|X2=1)=0.2044   ← 같다
  theta≈0.5: P(X1=1)=0.4969, P(X1=1|X2=1)=0.4962   ← 같다
  theta≈0.8: P(X1=1)=0.7959, P(X1=1|X2=1)=0.7984   ← 같다
순서만 다른 세 수열의 확률이 모두 같다. 교환가능하다.
그런데 독립이 아니다. \(P(X_1=1) = 0.5\)인데 \(P(X_1 = 1 \mid X_2 = 1) = 0.6\)이다. 앞면이 나왔다는 사실이 동전이 어느 쪽인지에 대한 정보를 주기 때문이다.
\(\theta\)를 조건으로 하면 독립이 회복된다. 세 번째 출력에서 조건부확률이 일치한다.
드 피네티 정리가 이를 일반화한다. 무한 교환가능한 \(0\)–\(1\) 수열은 반드시 어떤 \(\theta\)의 혼합으로 표현된다.
즉 "교환가능"과 "어떤 숨은 모수를 조건으로 하면 i.i.d."가 같은 말이다.
이것이 베이즈 통계의 철학적 토대다.
- 사전분포는 임의로 도입한 장치가 아니다. 관측이 교환가능하다고 믿는 순간, 드 피네티 정리가 모수와 그 사전분포의 존재를 강제한다. \(F(\theta)\)가 곧 사전분포다.
- "i.i.d. 표본"이라는 가정을 다시 보게 한다. 실제로 우리가 가정하는 것은 대개 교환가능성(관측의 순서가 무의미하다)이지 진짜 독립이 아니다.
- 계층모형의 구조가 여기서 나온다. 2장 분산 문서 연습문제 7의 총분산의 법칙에서 본 집단내·집단간 분해가 이 혼합 구조의 다른 표현이다.
유한 수열에서는 정리가 정확히 성립하지 않는다. 비복원추출은 교환가능하지만 혼합으로 표현되지 않는다(음의 상관을 갖는다). 무한 교환가능성이 필요한 이유다. \(\square\)
정리하며
이 절의 결론은 짧고 강하다. 독립과 조건부 독립 사이에는 어느 방향으로도 함의가 없다.
- 정리 1은 조건부 독립을 정의했다. \(C\)로 좁혀진 세계 안에서의 보통의 독립이다.
- 정리 2는 독립이 조건부 독립을 함의하지 않음을 보였다. 공통 결과로 조건을 걸면 무관하던 원인들이 얽힌다(해명 효과).
- 정리 3은 그 역도 성립하지 않음을 보였다. 숨은 공통 원인을 알고 나면 종속이 사라진다(혼합).
두 방향이 실무에서 갖는 의미는 정반대다.
정리 3은 통계 모형을 세우는 방식이다. "모수 \(\theta\)가 주어지면 관측은 i.i.d."라는 문장이 6장 이후 거의 모든 모형의 출발점이며, 이 책이 표본을 다루는 방식 전체가 여기에 기대고 있다.
정리 2는 분석을 망치는 방식이다. 공통 결과로 조건을 걸면 없던 상관이 생긴다. 12장의 충돌변수, 1장의 생존자 편향과 길이 편향이 모두 이 구조이며, "변수를 많이 넣을수록 좋다"는 흔한 직관이 왜 틀리는지를 설명한다.
규칙 한 줄: 공통 원인은 통제하고, 공통 결과는 통제하지 않는다.
여기까지가 사건의 확률이다. 지금까지 우리는 "짝수가 나온다", "경보가 울린다"처럼 일어나거나 일어나지 않는 대상을 다루었다. 그런데 대부분의 실제 문제에서 관심사는 참·거짓이 아니라 수다. 주사위의 눈, 대기 시간, 수익률처럼.
다음 절부터 확률을 수 위에서 다루기 시작한다. 그 다리를 놓는 것이 확률변수다.