X̄₁ - X̄₂의 표본분포 (등분산 정규모집단)
개요
두 집단을 비교하는 일은 통계학에서 가장 자주 하는 일이다. 그 중심에 \(\bar X_1 - \bar X_2\)의 표본분포가 있다.
이 페이지는 모든 가정이 맞는 경우를 본다. 두 모집단이 정규이고 분산이 같다. 이 자리에서는 근사가 하나도 필요하지 않다. 표본크기는 견주기 쉽도록 같게 잡았을 뿐 정리가 요구하는 것이 아니며, 연습문제 6에서 \(n_1 \ne n_2\)여도 결과가 그대로임을 확인한다.
- \(\bar X_1 - \bar X_2\)가 정확히 정규분포를 따른다.
- 합동분산 \(S_p^2\)을 쓴 \(t\) 통계량이 정확히 \(t_{n_1+n_2-2}\)를 따른다.
- 명목 95% 신뢰구간의 실제 포함률이 정확히 0.95다.
"정확히"라는 말이 세 번 나온다. 5.4절에서 \(\bar X\)가 정규모집단에서 정확히 정규였고, 5.6절에서 \((n-1)S^2/\sigma^2\)이 정확히 카이제곱이었던 두 결과가 여기서 하나로 합쳐지기 때문이다. 이 페이지는 그 합쳐지는 과정을 따라가고, 모의실험으로 "정확히"를 확인한다.
이 쪽이 기준선이다. 이어지는 두 쪽에서 가정을 하나씩 깨뜨리며 그 대가를 수치로 잰다. 등분산을 깨면(다음 쪽) 표본을 키워도 고쳐지지 않는 문제가 생기고, 정규성을 깨면(그다음 쪽) 표본을 키우면 고쳐진다. 그 차이를 보려면 먼저 아무것도 깨지지 않은 자리를 알아 두어야 한다.
설정
두 모집단에서 서로 독립인 확률표본을 뽑는다.
두 모집단의 분산이 같은 값 \(\sigma^2\)이라는 것이 이 쪽의 핵심 가정이다. 모의실험에서 쓸 구체적인 값은 다음과 같다.
| 항목 | 모집단 1 | 모집단 2 |
|---|---|---|
| 분포 | \(N(0, 1)\) | \(N(0.5, 1)\) |
| 평균 | \(\mu_1 = 0\) | \(\mu_2 = 0.5\) |
| 표준편차 | \(\sigma_1 = 1\) | \(\sigma_2 = 1\) |
| 표본크기 | \(n_1 = 15\) | \(n_2 = 15\) |
따라서 참 차이는 \(\mu_1 - \mu_2 = -0.5\)이고, 효과크기는 \((\mu_1-\mu_2)/\sigma = -0.5\)로 코헨 기준의 "중간"이다. 두 표본분산을
로 쓴다.
표본분포 이론
차는 정확히 정규
\(\bar X_1\)과 \(\bar X_2\)는 각각 정규이고 서로 독립이다. 독립인 정규확률변수의 선형결합은 정규이므로
이다. 근사가 아니라 등식이다. 표준오차는
이다. \(1/n_1 + 1/n_2\)라는 꼴에 주목하라. 전체 표본수 \(n_1 + n_2\)를 고정하면 이 값은 \(n_1 = n_2\)에서 최소가 된다(산술-조화 평균 부등식). 등분산이면 반씩 나누는 것이 가장 정밀하다.
분산을 하나로 모은다
\(\sigma^2\)을 모르면 추정해야 한다. 두 모집단의 분산이 같으므로 \(S_1^2\)과 \(S_2^2\)은 같은 값을 겨누는 두 개의 추정량이다. 버릴 이유가 없으니 둘을 합친다.
자유도를 가중값으로 쓴 가중평균이다. 분자를 제곱합으로 다시 쓰면 무엇을 하고 있는지가 더 분명해진다.
즉 두 집단의 편차제곱합을 한데 모아 전체 자유도로 나눈 것이다. 자유도가 \(n_1 + n_2 - 2\)인 이유는 두 평균을 각각 추정하는 데 하나씩 썼기 때문이다.
정리 1. 합동 t 통계량의 표본분포
두 표본이 독립이고 각각 \(N(\mu_1,\sigma^2)\), \(N(\mu_2,\sigma^2)\)에서 나왔으면
이고, 이는 \(\bar X_1 - \bar X_2\)와 독립이다. 따라서
이다.
증명
5.6절의 정리에 의해 각 표본에서
이고 두 표본이 독립이므로 두 카이제곱도 독립이다. 독립인 카이제곱의 합은 자유도가 더해진 카이제곱이므로
이다. 여기서 등분산 가정이 쓰였다. 두 분산이 다르면 두 항을 같은 \(\sigma^2\)으로 나눌 수 없어 이 합이 카이제곱이 되지 않는다.
독립성은 다음과 같이 확인한다. 5.6절에서 각 표본 안의 \(\bar X_i\)와 \(S_i^2\)이 독립이고, 두 표본은 서로 독립이다. 따라서 네 통계량 \(\bar X_1, S_1^2, \bar X_2, S_2^2\)이 모두 독립이며, 앞의 둘로 만든 \(\bar X_1 - \bar X_2\)와 뒤의 둘로 만든 \(S_p^2\)도 독립이다.
이제
로 두면 \(Z\)와 \(W\)가 독립이고
인데, \(\sigma\)가 분자와 분모에서 약분되어 \(T\)가 앞의 식과 같아진다. \(t\) 분포의 정의에 의해 \(T \sim t_{n_1+n_2-2}\)이다. \(\square\)
\(\sigma\)가 약분되어 사라졌다는 점이 결정적이다. \(T\)의 분포에 모르는 모수가 하나도 남지 않으므로 관측값만으로 추론을 할 수 있다. 추축량(pivotal quantity)이 하는 일이다.
왜 z가 아니고 t인가
\(n_1 = n_2 = 15\)이면 자유도가 \(28\)이다. \(t_{28}\)은 표준정규와 꽤 비슷해 보이지만 꼬리가 더 무겁다.
임계값이 4.5% 더 크다. 이 차이를 무시하고 \(z\)를 쓰면 구간이 좁아져 포함률이 떨어진다. 실제로
이므로 명목 5% 검정이 실제로는 6% 검정이 된다. 보기 2에서 포함률로 확인한다.
모의실험
보기 1. 차와 \(t\) 통계량의 표집분포. \(N(0,1)\)과 \(N(0.5,1)\)에서 \(n_1 = n_2 = 15\)씩 뽑아 \(\bar X_1 - \bar X_2\)와 합동 \(t\) 통계량을 10만 번 계산한다.
(1) 두 통계량이 각각 어느 분포를 정확히 따르는지 유도하고, 차의 표준오차를 수로 구하시오.
(2) \(t_{28}\) 밀도와 \(N(0,1)\) 밀도가 어디서 얼마나 갈리는지 미리 계산한 뒤, 모의실험이 (1)을 재현하는지 보이시오.
풀이
(1) 해석적으로. \(\bar X_1\)과 \(\bar X_2\)는 각각 정규표본의 평균이므로 정확히 정규이고
이다. 두 표본이 독립이므로 두 평균도 독립이고, 독립인 정규확률변수의 차는 정규다. 평균은 빼고 분산은 더하므로
분산을 더한다는 것이 요점이다. 두 집단의 불확실성은 상쇄되지 않고 쌓인다. 한 집단을 \(n = 15\)로 재는 일보다 두 집단의 차를 재는 일이 \(\sqrt{2} = 1.41\)배 어렵다.
여기서 \(\sigma = 1\)을 \(S_p\)로 바꾸면 정리 1에 따라
이 정확히 성립한다. 자유도 \(28 = 15+15-2\)는 두 집단 평균을 각각 추정하는 데 하나씩 쓴 몫을 뺀 것이다. 두 분포 모두 근사가 아니라 등식이다.
(2) 두 밀도가 갈리는 자리. \(t_{28}\)은 표준정규와 "꽤 비슷해 보인다"는 말로 넘기면 안 된다. 어디서 얼마나 다른지 미리 재어 두면 그림에서 무엇을 보아야 할지 정해진다.
from scipy import stats

# t_28 과 N(0,1) 의 밀도비를 가운데서부터 꼬리까지 훑는다.
# 검정이 일어나는 자리는 |x| 가 2 를 넘는 구간이다.
print(f"{'x':>5}{'t28 밀도':>12}{'N(0,1) 밀도':>13}{'비':>8}")
for x in (0, 1, 2, 2.5, 3, 3.5):
    print(f"{x:>5}{stats.t(28).pdf(x):>12.5f}{stats.norm.pdf(x):>13.5f}"
          f"{stats.t(28).pdf(x) / stats.norm.pdf(x):>8.3f}")

print(f"\nP(|t28| > 1.96) = {2 * stats.t(28).sf(1.96):.4f}   (명목은 0.0500)")
print(f"P(|t28| > 3)    = {2 * stats.t(28).sf(3):.5f}   vs  P(|Z| > 3) = {2 * stats.norm.sf(3):.5f}")
출력:
    x      t28 밀도    N(0,1) 밀도       비
    0     0.39540      0.39894   0.991
    1     0.23771      0.24197   0.982
    2     0.05704      0.05399   1.056
  2.5     0.02129      0.01753   1.215
    3     0.00695      0.00443   1.568
  3.5     0.00205      0.00087   2.349

P(|t28| > 1.96) = 0.0600   (명목은 0.0500)
P(|t28| > 3)    = 0.00562   vs  P(|Z| > 3) = 0.00270
가운데서는 \(t_{28}\)의 밀도가 오히려 조금 낮다. \(x = 0\)에서 밀도비가 \(0.991\), \(x = 1\)에서 \(0.982\)다. 두 밀도가 모두 전체 적분이 \(1\)이므로 꼬리로 보낸 확률만큼 가운데를 비워야 하기 때문이다. \(|x| = 2\)를 지나면서 비가 \(1\)을 넘고, \(x = 3\)에서 \(1.57\)배, \(x = 3.5\)에서 \(2.35\)배로 벌어진다. 꼬리확률로 적으면 \(|T| > 3\)일 확률이 \(0.00562\) 대 \(0.00270\), 곧 두 배가 넘는다.
그림에서 볼 것이 이것으로 정해졌다. 가운데 봉우리에서는 두 곡선을 눈으로 구별할 수 없고, 구별이 되는 자리는 \(|x| > 2\)의 꼬리뿐이며, 바로 거기가 기각 여부가 갈리는 자리다.
이제 모의실험.
import matplotlib.pyplot as plt
import numpy as np
from scipy import stats

rng = np.random.default_rng(1)

n1 = n2 = 15
mu1, mu2, sigma = 0.0, 0.5, 1.0
B = 100_000

x1 = rng.normal(mu1, sigma, size=(B, n1))
x2 = rng.normal(mu2, sigma, size=(B, n2))

d = x1.mean(axis=1) - x2.mean(axis=1)
v1 = x1.var(axis=1, ddof=1)
v2 = x2.var(axis=1, ddof=1)
sp2 = ((n1 - 1) * v1 + (n2 - 1) * v2) / (n1 + n2 - 2)
t = (d - (mu1 - mu2)) / np.sqrt(sp2 * (1 / n1 + 1 / n2))

fig, axes = plt.subplots(1, 2, figsize=(12, 4))

# 왼쪽: 차 자체의 표집분포. 이론 정규밀도를 겹쳐 그린다.
se = sigma * np.sqrt(1 / n1 + 1 / n2)
g = np.linspace(d.min(), d.max(), 400)
axes[0].hist(d, bins=70, density=True, alpha=0.5, edgecolor="white",
             label=r"simulated $\bar X_1-\bar X_2$")
axes[0].plot(g, stats.norm(mu1 - mu2, se).pdf(g), "--r", lw=2,
             label=r"$N(-0.5,\ \sigma^2(1/n_1+1/n_2))$")
axes[0].axvline(mu1 - mu2, color="gray", lw=1)
axes[0].set_title(r"Difference of sample means  ($n_1=n_2=15$)")
axes[0].set_xlabel(r"$\bar X_1-\bar X_2$")
axes[0].set_ylabel("Density")
axes[0].legend(fontsize=8)

# 오른쪽: sigma 를 Sp 로 바꾼 t 통계량. t(28)과 N(0,1)을 함께 겹친다.
df = n1 + n2 - 2
g = np.linspace(-5, 5, 400)
axes[1].hist(t, bins=100, range=(-5, 5), density=True, alpha=0.5,
             edgecolor="white", label=r"simulated $T$")
axes[1].plot(g, stats.t(df).pdf(g), "-r", lw=2, label=r"$t_{28}$ PDF")
axes[1].plot(g, stats.norm.pdf(g), ":k", lw=2, label=r"$N(0,1)$ PDF")
axes[1].set_title(r"Pooled $t$ statistic  (df $=n_1+n_2-2=28$)")
axes[1].set_xlabel(r"$T$")
axes[1].set_xlim(-5, 5)
axes[1].legend(fontsize=8, loc="upper left")

# 두 밀도의 차이는 꼬리에서만 보인다. 확대해 둔다.
inset = axes[1].inset_axes([0.60, 0.40, 0.37, 0.40])
g2 = np.linspace(1.6, 4.0, 200)
inset.plot(g2, stats.t(df).pdf(g2), "-r", lw=2)
inset.plot(g2, stats.norm.pdf(g2), ":k", lw=2)
inset.set_title("right tail", fontsize=7)
inset.tick_params(labelsize=6)

plt.tight_layout()
plt.show()
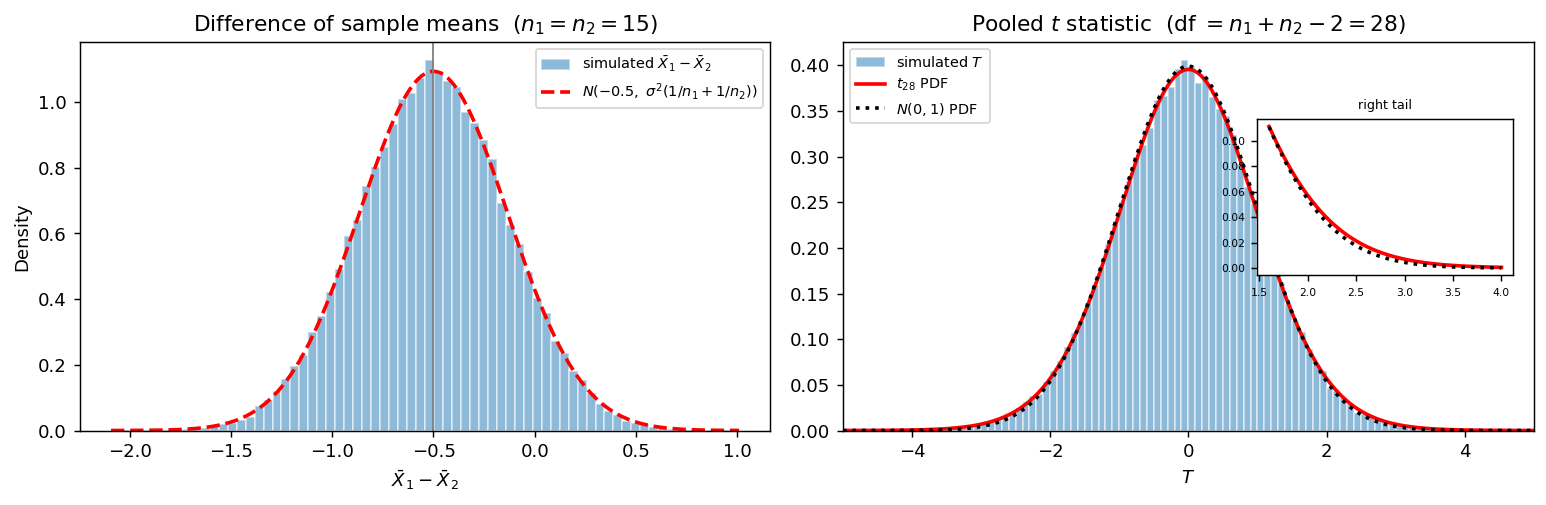
왼쪽에서 히스토그램과 빨간 곡선이 거의 완전히 겹친다. 중심도 폭도 맞는다. 5.6절의 \(S^2\) 페이지들에서 폭이 어긋나던 그림과 대조적이다.
오른쪽에서 히스토그램은 \(t_{28}\) 곡선(실선)에 맞고 표준정규(점선)와는 미세하게 다르다. 가운데 부분만 보면 두 곡선을 구별하기 어렵지만, 확대한 꼬리에서는 \(t_{28}\)이 위에 있다. 기각 여부가 갈리는 자리가 바로 이 꼬리이므로 이 작은 차이를 무시할 수 없다.
눈으로 본 겹침을 수로 바꿔 두자. \(T\)의 표본분위수를 \(t_{28}\)과 \(N(0,1)\)의 분위수에 나란히 놓으면 어느 곡선에 붙는지가 가려진다.
# 보기 1에서 만든 t 를 그대로 쓴다.
print(f"{'꼬리확률':>10}{'모의 분위수':>13}{'t(28)':>10}{'N(0,1)':>10}")
for q in (0.75, 0.90, 0.975, 0.995):
    print(f"{q:>10.3f}{np.quantile(t, q):>13.4f}"
          f"{stats.t(28).ppf(q):>10.4f}{stats.norm.ppf(q):>10.4f}")
출력:
      꼬리확률       모의 분위수     t(28)    N(0,1)
     0.750       0.6782    0.6834    0.6745
     0.900       1.3089    1.3125    1.2816
     0.975       2.0246    2.0484    1.9600
     0.995       2.7217    2.7633    2.5758
위의 두 줄에서는 세 수가 거의 겹치고, 아래 두 줄에서 갈린다. \(0.975\) 분위수에서 모의값 \(2.0246\)은 \(t_{28}\)의 \(2.0484\)에서 \(0.024\) 떨어져 있고 \(N(0,1)\)의 \(1.9600\)에서는 \(0.065\) 떨어져 있다. \(0.995\) 분위수에서는 \(0.042\) 대 \(0.146\)으로 격차가 더 벌어진다. 어느 자리에서나 \(t\) 쪽이 가깝다.
모의값이 \(t_{28}\)보다 조금씩 작게 나온 것은 이 씨앗 탓이다. 10만 개로 잰 \(0.975\) 분위수의 몬테카를로 오차는 \(\sqrt{0.975 \times 0.025/100000}\big/f_{t_{28}}(2.0484) = 0.0087\)이고, 씨앗을 여섯 개 바꿔 다시 재면 \(2.025\)에서 \(2.060\) 사이를 오가며 \(2.0484\)를 둘러싼다. 체계적 어긋남이 아니라 몬테카를로 오차다.
보기 2. 이론값과 포함률을 숫자로 확인. 보기 1의 10만 개 표본을 그대로 쓴다.
(1) \(E[\bar X_1-\bar X_2]\), \(\operatorname{SD}(\bar X_1-\bar X_2)\), \(E[S_p^2]\)의 이론값을 적으시오.
(2) 명목 95% 구간을 \(t_{28}\) 임계값으로 만들 때와 \(z\) 임계값으로 만들 때의 포함률이 각각 얼마가 되어야 하는지 계산하고, 모의실험으로 확인하시오.
풀이
(1) 이론값. 세 값 모두 닫힌 꼴이다.
\(E[S_p^2] = \sigma^2 = 1\)은 연습문제 2가 보이는 불편성이다. 자유도를 가중값으로 쓴 가중평균이고 가중값의 합이 \(1\)이므로 \(E[S_p^2] = \sigma^2\)이다.
(2) 두 포함률의 이론값. \(t\) 임계값 쪽은 정리 1이 곧바로 답을 준다.
\(z\) 임계값 쪽은 다르다. 구간의 폭만 \(1.96\)으로 좁혔을 뿐 \(T\)의 분포는 여전히 \(t_{28}\)이므로, 빗나갈 확률은 표준정규가 아니라 \(t_{28}\)의 꼬리에서 읽어야 한다.
따라서 \(z\) 쪽 포함률은 \(1 - 0.0600 = 0.9400\)이어야 한다. 명목 95%가 실제로는 94%다. 어긋남의 방향도 정해져 있다. \(t_{28}\)이 표준정규보다 꼬리가 무거우므로 \(z\) 임계값은 언제나 너무 짧고, 포함률은 언제나 부족한 쪽으로 틀린다.
이제 모의실험.
# 보기 1에서 만든 d, sp2 를 그대로 쓴다.
se_hat = np.sqrt(sp2 * (1 / n1 + 1 / n2))       # 추정된 표준오차
se_true = sigma * np.sqrt(1 / n1 + 1 / n2)      # 참 표준오차

print(f"E[X1bar - X2bar]  이론 {mu1 - mu2:+.4f}   모의 {d.mean():+.4f}")
print(f"SD[X1bar - X2bar] 이론 {se_true:.4f}   모의 {d.std(ddof=1):.4f}")
print(f"E[Sp^2]           이론 {sigma**2:.4f}   모의 {sp2.mean():.4f}")

df = n1 + n2 - 2
t_crit = stats.t(df).ppf(0.975)
z_crit = stats.norm.ppf(0.975)
lo = d - t_crit * se_hat
hi = d + t_crit * se_hat
print()
print(f"임계값  t(28) = {t_crit:.4f},  z = {z_crit:.4f}")
print(f"명목 95% 구간의 실제 포함률")
print(f"  t(28) 임계값: {np.mean((lo <= mu1 - mu2) & (mu1 - mu2 <= hi)):.4f}")
print(f"  z 임계값:     {np.mean(np.abs(d - (mu1 - mu2)) <= z_crit * se_hat):.4f}")
출력:
E[X1bar - X2bar]  이론 -0.5000   모의 -0.5017
SD[X1bar - X2bar] 이론 0.3651   모의 0.3637
E[Sp^2]           이론 1.0000   모의 0.9991

임계값  t(28) = 2.0484,  z = 1.9600
명목 95% 구간의 실제 포함률
  t(28) 임계값: 0.9513
  z 임계값:     0.9411
평균, 표준편차, \(E[S_p^2]\)이 모두 이론값과 맞는다. 포함률은 \(t\) 임계값으로 0.951, \(z\) 임계값으로 0.941이다. 반복 10만 회에서 포함률 추정의 표준오차가 \(\sqrt{0.95 \times 0.05/100000} = 0.0007\)이므로 0.951은 0.95와 구별되지 않고, 0.941은 분명히 낮다. \(t\)가 맞고 \(z\)는 틀렸다는 것이 숫자로 갈린다.
이론과 모의를 나란히 두면 이렇다. 반복 10만 회에서 포함률 추정의 몬테카를로 오차는 \(\sqrt{0.95 \times 0.05/100000} = 0.0007\)이다.
| 양 | 이론값 | 모의값 | 어긋남 |
|---|---|---|---|
| \(E[\bar X_1-\bar X_2]\) | \(-0.5000\) | \(-0.5017\) | \(-0.0017\) — 몬테카를로 오차 \(0.0012\)의 \(1.5\)배 |
| \(\operatorname{SD}(\bar X_1-\bar X_2)\) | \(0.3651\) | \(0.3637\) | \(-0.0014\) — 몬테카를로 오차 \(0.0008\)의 \(1.7\)배 |
| \(E[S_p^2]\) | \(1.0000\) | \(0.9991\) | \(-0.0009\) — 맞는다 |
| 포함률(\(t\)) | \(0.9500\) | \(0.9513\) | \(+0.0013\) — 오차 \(0.0007\)의 \(1.9\)배 |
| 포함률(\(z\)) | \(0.9400\) | \(0.9411\) | \(+0.0011\) — 오차 \(0.0007\)의 \(1.6\)배 |
다섯 줄이 모두 몬테카를로 오차의 두 배 안에 있다. 이 씨앗이 산포를 조금 작게 뽑은 쪽이어서 둘째 줄과 넷째 줄의 어긋남이 같은 방향으로 섰는데, 씨앗을 여섯 개 바꿔 \(\operatorname{SD}\)를 다시 재면 \(0.3637\)에서 \(0.3657\) 사이를 오가며 이론값 \(0.3651\)을 둘러싼다. 체계적 차이가 아니라 몬테카를로 오차다.
\(t\)와 \(z\)의 갈림이 숫자로 섰다. \(0.9513\)은 \(0.95\)와 구별되지 않고 \(0.9411\)은 \(0.94\)와 구별되지 않는다. 곧 \(t\) 임계값은 맞고 \(z\) 임계값은 1%포인트 모자라며, 그 1%포인트는 어림이 아니라 \(P(|t_{28}|>1.96) = 0.0600\)이라는 미리 계산된 값이다. 임계값을 \(4.5\%\) 줄인 대가가 오류율을 \(5\%\)에서 \(6\%\)로 \(20\%\) 늘리는 것으로 돌아온 셈이다.
보기 3. 표본크기를 바꿔도 포함률은 그대로다. 두 모집단을 \(N(0,1)\)과 \(N(0.5,1)\)로 두고 집단당 \(n = 5, 15, 50\)에서 명목 95% 구간의 포함률과 \(H_0: \mu_1 = \mu_2\)의 기각률을 10만 번씩 재어 본다.
(1) 포함률이 \(n\)에 의존하지 않아야 하는 까닭을 적고, 기각률이 세 \(n\)에서 얼마가 되어야 하는지 비중심 \(t\) 분포로 미리 계산하시오.
(2) 모의실험으로 두 예측을 확인하고, 유효성과 검정력이 어떻게 다른지 말하시오.
풀이
(1) 이론값. 두 물음의 답이 전혀 다른 곳에서 온다.
포함률은 \(n\)과 무관하다. 정리 1이 말하는 것은 \(T \sim t_{n_1+n_2-2}\)가 등식이라는 것이고, 등식에는 "\(n\)이 충분히 크면"이라는 조건이 붙지 않는다. 임계값을 \(t_{0.975,\,2n-2}\)로 잡으면 정의상
이 \(n\)에 관계없이 성립한다. \(n\)이 바뀌면 자유도가 바뀌고 임계값도 함께 바뀌어 꼬리확률이 늘 \(0.05\)로 맞춰지기 때문이다. \(n = 5\)에서는 자유도 8, 임계값 \(2.3060\)이고 \(n = 50\)에서는 자유도 98, 임계값 \(1.9845\)다. 값은 다르지만 그 값이 자르는 확률은 같다.
기각률은 \(n\)에 크게 의존한다. \(\mu_1 \ne \mu_2\)일 때 \(T\)는 중심 \(t\)가 아니라 비중심모수
를 가진 비중심 \(t\) 분포를 따른다. 검정력은 \(P(|T| > t_{0.975,\,2n-2})\)이고 이것은 닫힌 꼴이 아니라 수치적분으로 구한다.
| \(n\) | 자유도 | 임계값 | \(\mathrm{ncp}\) | 검정력(비중심 \(t\)) |
|---|---|---|---|---|
| 5 | 8 | 2.3060 | \(-0.7906\) | 0.1077 |
| 15 | 28 | 2.0484 | \(-1.3693\) | 0.2624 |
| 50 | 98 | 1.9845 | \(-2.5000\) | 0.6969 |
예측은 이렇다. 포함률 열은 세 줄 모두 \(0.95\), 기각률 열은 \(0.11 \to 0.26 \to 0.70\)으로 오른다.
(2) 모의실험.
import numpy as np
from scipy import stats

rng = np.random.default_rng(1)
B = 100_000
delta = -0.5          # 참 차이 mu1 - mu2
sigma = 1.0

print("  n   포함률   검정력(모의)  검정력(비중심 t)")
for n in (5, 15, 50):
    x1 = rng.normal(0.0, sigma, size=(B, n))
    x2 = rng.normal(0.5, sigma, size=(B, n))
    d = x1.mean(axis=1) - x2.mean(axis=1)
    v1, v2 = x1.var(axis=1, ddof=1), x2.var(axis=1, ddof=1)
    sp2 = (v1 + v2) / 2
    se = np.sqrt(sp2 * 2 / n)

    df = 2 * n - 2
    crit = stats.t(df).ppf(0.975)
    cover = np.mean(np.abs(d - delta) <= crit * se)     # 명목 95% 구간
    power = np.mean(np.abs(d / se) > crit)              # H0: mu1 = mu2 기각률

    ncp = delta / (sigma * np.sqrt(2 / n))
    exact = stats.nct(df, ncp).sf(crit) + stats.nct(df, ncp).cdf(-crit)
    print(f"{n:>3}   {cover:.4f}     {power:.4f}       {exact:.4f}")
출력:
  n   포함률   검정력(모의)  검정력(비중심 t)
  5   0.9508     0.1080       0.1077
 15   0.9503     0.2626       0.2624
 50   0.9521     0.6968       0.6969
두 가지를 읽을 수 있다.
첫째, 포함률이 \(n\)에 전혀 의존하지 않는다. \(n = 5\)에서도 0.95다. 정리 1이 근사가 아니라 등식이므로 당연한 결과이며, 표본이 작을 때 정규근사에 기대는 방법들과 결정적으로 다른 점이다.
둘째, 검정력은 \(n\)에 크게 의존한다. 효과크기 \(0.5\)를 집단당 15개로 잡아낼 확률은 0.26밖에 안 된다. 모의실험 값이 비중심 \(t\) 분포로 계산한 이론값과 소수 셋째 자리까지 맞는다. 유효성(포함률)과 검정력은 다른 문제이며, 이 페이지의 "정확함"은 앞의 것만 보장한다.
예측이 그대로 맞았다. 포함률은 \(0.9508,\ 0.9503,\ 0.9521\)로 셋 다 \(0.95\)이고, 반복 10만 회에서 포함률 추정의 몬테카를로 오차가 \(\sqrt{0.95 \times 0.05/100000} = 0.0007\)이므로 가장 멀리 간 \(0.9521\)조차 \(3\) 오차 안이다. 기각률은 \(0.1080,\ 0.2626,\ 0.6968\)로 비중심 \(t\)가 준 \(0.1077,\ 0.2624,\ 0.6969\)와 소수 셋째 자리까지 맞는다.
두 열이 함께 있는 것이 이 보기의 요점이다. 왼쪽 열은 \(n\)을 다섯 개로 줄여도 꿈쩍하지 않고, 오른쪽 열은 \(n\)을 열 배로 늘려야 쓸 만해진다. 유효성은 정리가 보장하고 검정력은 설계가 사는 것이며, 이 쪽이 세 번 말한 "정확히"는 앞의 것만 두고 한 말이다. 구간이 95%를 담는다는 사실과 그 구간이 쓸모 있을 만큼 좁다는 사실은 서로 다른 이야기다.
해석
주요 관찰
- 세 결과가 모두 정확하다. 차는 정확히 정규, 합동 \(t\)는 정확히 \(t_{28}\), 포함률은 정확히 0.95다. 근사가 들어갈 자리가 없다. 이 장에서 이만큼 깔끔한 자리는 드물다.
- \(\sigma\)가 약분된다. \(T\)의 분포에 모르는 모수가 남지 않으므로 \(\sigma\)를 몰라도 추론이 된다. 이 약분은 두 모집단의 분산이 같을 때만 일어난다.
- \(z\)를 쓰면 안 된다. \(t_{28}\)과 \(N(0,1)\)은 가운데서는 거의 같지만 꼬리에서 다르고, 검정은 꼬리에서 이뤄진다. 임계값 4.5%의 차이가 포함률 0.951과 0.941로 나타난다.
- 표본크기가 정확성을 바꾸지 않는다. \(n = 5\)에서도 포함률이 0.95다. 바뀌는 것은 검정력뿐이다.
- 여기서 쓴 가정은 셋이다. 정규성, 등분산, 독립. 다음 쪽에서 등분산을 깨고 그다음 쪽에서 정규성을 깬다. 두 실패의 성격이 전혀 다르다는 것이 5.7절의 결론이다.
이 결과가 기대는 것
세 가정이 각각 어느 단계에서 쓰였는지 증명을 따라가며 짚어 두면, 뒤에서 하나씩 깨뜨릴 때 무엇이 어긋나는지 미리 알 수 있다.
독립성은 두 번 쓰인다. 두 표본이 독립이어야 두 카이제곱이 독립이고 그래야 자유도가 더해진다. 그리고 각 표본 안에서 \(\bar X_i\)와 \(S_i^2\)이 독립이어야 \(Z\)와 \(W\)의 비가 \(t\) 분포의 정의에 맞는다. 독립성이 깨지면 자유도부터 틀리므로 어느 \(t\) 곡선을 그려야 할지조차 정해지지 않는다.
정규성은 두 자리에 쓰인다. \(\bar X_1 - \bar X_2\)가 정확히 정규가 되는 데 한 번, \((n_i-1)S_i^2/\sigma^2\)이 카이제곱이 되는 데 한 번이다. 앞의 쓰임은 \(n\)이 커지면 중심극한정리가 대신해 준다. 뒤의 쓰임에는 중심극한정리가 듣지 않지만, \(S_p^2\)은 \(T\)의 분모에 들어가는 척도일 뿐이고 \(n\)이 커지면 \(\sigma^2\)으로 수렴하므로 그 영향도 함께 사라진다. 그래서 정규성의 실패는 표본이 고쳐 주는 종류의 실패다. 그 과정은 그다음 쪽에서 수치로 본다.
등분산은 오직 한 자리, 두 카이제곱을 합치는 단계에 쓰인다. 두 분산이 다르면 분모에 넣을 공통 \(\sigma^2\)이 없으므로 합이 카이제곱이 아니게 된다. 표본크기의 균형은 이 단계 어디에도 들어가지 않는다는 점이 중요하다. 등분산이 지켜지는 한 \(n_1 \ne n_2\)여도 정리 1은 그대로 정확하다(연습문제 6).
그래서 이 쪽은 어긋남이 0인 자리다. 포함률이 \(n = 5\)에서도 0.95이고 \(E[S_p^2]\)이 정확히 \(\sigma^2\)이다. 뒤에서 재는 모든 어긋남은 이 0을 기준으로 잰 거리이며, 그 기준이 있어야 "명목 5%가 실제로는 29%"라는 말이 의미를 갖는다. 등분산을 깨면 그 어긋남은 표본을 키워도 남고, 정규성을 깨면 표본이 고쳐 준다. 두 실패의 성격이 다르다는 것을 보려면 먼저 아무것도 어긋나지 않은 자리를 알아야 한다.
연습문제
연습문제 1. \(n_1 = n_2 = 15\), \(s_1^2 = 1.10\), \(s_2^2 = 0.86\)인 자료에서 \(S_p^2\)과 추정된 표준오차를 구하고, 참 표준오차 \(0.3651\)과 견주어라. 이 추정값은 표본이 바뀌면 얼마나 흔들리는가?
풀이
자유도가 같으므로 합동분산은 단순평균이다.
추정된 표준오차는
로 참값 \(0.3651\)과 1%밖에 차이 나지 않는다. 그러나 이만큼 가까운 것은 이 표본이 운이 좋았기 때문이다.
흔들림의 크기. 정규모집단에서 \(\text{Var}(S_p^2) = 2\sigma^4/(n_1+n_2-2) = 2/28\)이므로 \(\text{SD}(S_p^2) = 0.2673\)이다. \(\sqrt{\cdot}\)에 델타법을 쓰면 \(\text{SD}(S_p) \approx 0.2673/2 = 0.1336\)이고, 여기에 \(\sqrt{2/15} = 0.3651\)을 곱해
을 얻는다. 참값의 13%다. 모의실험으로 확인하면 \(\widehat{\text{SE}}\)의 표준편차가 \(0.0486\), 가운데 90%가 \([0.284,\ 0.444]\)에 들어간다. 집단당 15개에서는 표준오차 자체가 참값의 0.78배에서 1.22배 사이를 오간다.
이 흔들림이 곧 \(t\) 분포가 필요한 이유다. \(z\)를 쓴다는 것은 분모가 참값 \(0.3651\)로 고정되어 있다고 보는 것인데, 실제로는 분모가 저만큼 흔들린다. 그 흔들림을 셈에 넣어 주는 것이 \(t_{28}\)의 두꺼운 꼬리다.
연습문제 2. \(S_p^2\)이 \(\sigma^2\)의 불편추정량임을 보이고, 왜 \((S_1^2+S_2^2)/2\)이 아니라 자유도로 가중하는지 설명하라.
풀이
\(E[S_i^2] = \sigma^2\)이므로
이다. \(\square\) 사실 가중값의 합이 1이면 어떤 가중평균도 불편이다. 단순평균 \((S_1^2+S_2^2)/2\)도 불편이다.
자유도 가중을 쓰는 이유는 분산이 가장 작아지기 때문이다. 정규모집단에서 \(\text{Var}(S_i^2) = 2\sigma^4/(n_i-1)\)이므로, 가중값 \(w\)와 \(1-w\)를 쓴 추정량의 분산은
이다. \(w\)로 미분해 0으로 두면 \(w = (n_1-1)/(n_1+n_2-2)\)를 얻는다. 분산의 역수에 비례하는 가중값이 최적이라는 일반 원리의 한 경우이며, 여기서 분산의 역수가 자유도에 비례한다.
\(n_1 = n_2\)이면 두 방식이 같아진다. 연습문제 1에서 단순평균으로 계산한 것이 정당했던 이유다.
연습문제 3. 정리 1의 증명에서 등분산 가정과 독립성 가정이 각각 어디에 쓰였는지 짚고, 두 모분산이 다르면 무엇이 깨지는지 설명하라.
풀이
등분산은 카이제곱을 합칠 때 쓰인다. 각 표본에서 얻는 것은
이다. 분산이 같아서 \(\sigma_1^2 = \sigma_2^2 = \sigma^2\)일 때만 두 항을 같은 수로 나눈 것이 되어 합이 \(\chi^2_{n_1+n_2-2}\)가 된다. 분산이 다르면
의 분모에 넣을 "\(\sigma^2\)"이 아예 없다. 서로 다른 척도를 가진 두 카이제곱의 합은 카이제곱이 아니다.
독립성은 두 곳에 쓰인다. 첫째, 두 카이제곱이 독립이어야 자유도가 더해진다. 둘째, \(\bar X_1 - \bar X_2\)와 \(S_p^2\)이 독립이어야 \(Z\)와 \(W\)의 비가 \(t\) 분포가 된다.
분산이 다르면 무엇이 깨지는가. 분자의 참 분산은 \(\sigma_1^2/n_1 + \sigma_2^2/n_2\)인데 분모는 \(S_p^2(1/n_1+1/n_2)\)을 추정한다. 두 양이 일치하지 않으므로 \(T\)는 중심도 폭도 \(t\) 분포와 맞지 않는다. 그 어긋남의 크기와 방향이 다음 쪽의 주제다.
연습문제 4. \(n_1 = n_2 = 15\)인 표본에서 \(s_1^2 = 1.2\), \(s_2^2 = 0.8\)이 나왔다. Welch–Satterthwaite 자유도
를 직접 계산하고 합동 자유도 28과 비교하라. 등분산이 맞는 상황에서 두 방법의 임계값이 얼마나 다른가?
풀이
\(a = s_1^2/n_1\), \(b = s_2^2/n_2\)로 두면
이다. 분자는 \((a+b)^2 = 0.0177778\)이고 분모는
이므로
이다. 합동 자유도 28보다 약간 작다.
임계값은 \(t_{0.975,\,26.92} = 2.0521\)과 \(t_{0.975,\,28} = 2.0484\)로 0.2% 차이에 불과하다. 등분산이 실제로 맞고 표본크기가 같으면 두 방법이 사실상 같은 답을 준다는 뜻이다.
이것이 중요한 관찰이다. 등분산이 맞을 때 Welch를 써서 잃는 것이 거의 없다면, 등분산이 틀렸을 때 잃는 것이 큰 쪽을 피하는 편이 낫다. 다음 쪽에서 그 "잃는 것"의 크기를 잰다.
연습문제 5. \(P(|t_{28}| > 1.96) = 0.0600\)이다. \(z\) 임계값을 써서 얻은 포함률 0.9411을 이 값으로 설명하라. 자유도가 얼마쯤 되면 이 차이를 무시할 수 있는가?
풀이
포함률과 기각률은 동전의 양면이다. \(z\) 임계값으로 만든 구간이 참값을 담지 못할 확률은
이므로 포함률은 \(1 - 0.0600 = 0.9400\)이어야 한다. 모의실험 값 0.9411은 표준오차 0.0007의 두 배 안쪽이다. 이론과 모의가 맞는다.
자유도에 따른 실제 기각률은 다음과 같다.
| 자유도 | \(P(\lvert t_\nu\rvert > 1.96)\) | 포함률 |
|---|---|---|
| 10 | 0.0784 | 0.922 |
| 28 | 0.0600 | 0.940 |
| 60 | 0.0546 | 0.945 |
| 200 | 0.0514 | 0.949 |
| \(\infty\) | 0.0500 | 0.950 |
자유도가 60을 넘으면 어긋남이 0.5%포인트 아래로 떨어지고, 200쯤 되면 실무적으로 구별되지 않는다. 그러나 굳이 근사할 이유가 없다. \(t\) 분위수는 계산기로 바로 나오므로 자유도가 클 때도 \(t\)를 쓰면 된다.
연습문제 6. 이 쪽은 \(n_1 = n_2\)까지 가정했다. 등분산은 그대로 두고 표본크기만 어긋나게 하면 정리 1이 깨지는가? \((n_1,n_2) = (15,15),\ (5,25),\ (10,40),\ (3,50)\)에서 명목 95% 구간의 포함률을 모의실험으로 재어 답하라.
풀이
두 모집단을 모두 \(N(0,1)\)로 두고 합동 \(t\) 구간의 포함률을 20만 번씩 세면 다음과 같다.
| \((n_1, n_2)\) | 포함률 | 명목에서의 어긋남 |
|---|---|---|
| (15, 15) | 0.9499 | \(-0.0001\) |
| (5, 25) | 0.9492 | \(-0.0008\) |
| (10, 40) | 0.9503 | \(+0.0003\) |
| (3, 50) | 0.9503 | \(+0.0003\) |
반복 20만 회에서 포함률 추정의 표준오차가 \(\sqrt{0.95\times0.05/200000} = 0.0005\)이므로 네 값 모두 0.95와 구별되지 않는다. 깨지지 않는다.
왜 그런가. 정리 1의 증명 어디에도 \(n_1 = n_2\)가 쓰이지 않았다. 필요한 것은 두 카이제곱을 같은 \(\sigma^2\)으로 나눌 수 있다는 것뿐이고, 그것은 등분산이 주는 조건이지 표본크기가 주는 조건이 아니다. 자유도가 \(n_1 + n_2 - 2\)로 합쳐지는 것도 표본크기의 균형과 무관하다.
이 관찰이 5.7절 전체의 열쇠다. 불균형만으로는 아무 일도 일어나지 않고, 이분산만으로도 어긋남이 작다. 둘이 겹칠 때만 합동분산의 자유도 가중과 차의 분산의 \(1/n_i\) 가중이 반대 방향으로 어긋나면서 무너진다. 그 결과가 다음 쪽의 주제다.
다만 불균형이 공짜는 아니다. 전체 표본수가 같다면 \(1/n_1 + 1/n_2\)는 \(n_1 = n_2\)에서 최소이므로, \((3,50)\)은 \((26,27)\)보다 훨씬 넓은 구간을 준다. 정확성은 잃지 않지만 정밀도는 잃는다.
연습문제 7. 보기 3에서 집단당 15개일 때 기각률이 0.26이었다. 이 값이 0.80이 되려면 \(n\)이 얼마여야 하는가? \(\sigma\)를 안다고 본 정규근사로 먼저 구한 뒤 비중심 \(t\) 분포로 다시 구하고, 두 값이 다른 이유를 \(T\)의 분포로 설명하라.
풀이
정규근사. \(\sigma\)를 안다고 보고 \(n_1 = n_2 = n\)이라 하면 차의 표준오차가 \(\sigma\sqrt{2/n}\)이므로, 검정통계량의 중심이 임계값보다 \(z_{0.80}\)만큼 더 멀리 있어야 한다.
따라서 집단당 63개다.
비중심 \(t\) 보정. \(\sigma\)를 모르고 \(S_p\)로 추정하면 \(T\)는 \(H_1\) 아래에서 비중심 \(t\) 분포를 따른다. 비중심모수는
이고 검정력은 \(P(|T| > t_{0.975,\,2n-2})\)이다. \(n\)을 하나씩 늘려 계산하면 \(n = 64\)에서 검정력 0.8015가 되어 처음으로 80%를 넘는다. 집단당 64개다.
차이의 이유는 두 가지다. 첫째, 임계값이 \(z_{0.975} = 1.960\)이 아니라 \(t_{0.975,\,126} = 1.979\)로 약간 크다. 둘째, 분모 \(S_p\) 자체가 흔들리므로 검정통계량의 산포가 커진다. 두 효과가 모두 검정력을 깎으므로 표본을 조금 더 써야 한다.
자유도가 126이나 되는 큰 표본이라 보정이 1개에 그쳤다. 자유도가 작으면 차이가 더 커지며, 그래서 소표본 설계에서는 정규근사로 구한 값을 그대로 쓰지 말아야 한다.
덧붙임. 이 계산은 \(\sigma\)를 안다고 가정한다. 실무에서는 예비자료로 \(\sigma\)를 추정하므로 그 불확실성 때문에 여유를 더 두는 것이 안전하다. 또 같은 효과크기를 일표본 검정으로 잡는 데 드는 표본은 같은 정규근사로 \((2.8016)^2/0.5^2 = 31.4\), 즉 32개인데, 두 표본에서는 집단당 그 두 배가 든다. 차의 분산에 두 집단의 몫이 함께 들어가기 때문이다.
연습문제 8. 합동 \(t\) 검정은 회귀분석의 특수한 경우다. 집단 표시 더미변수 \(D_i \in \{0,1\}\)에 대한 단순회귀 \(Y = \beta_0 + \beta_1 D + \varepsilon\)에서 \(\hat\beta_1\)과 그 \(t\) 통계량이 무엇이 되는지 보여라.
풀이
최소제곱 해를 직접 구하면 된다. \(D\)가 \(0\) 또는 \(1\)뿐이므로
이다. 즉
로 기울기가 곧 두 평균의 차다. 절편은 기준집단의 평균이다.
잔차분산도 일치한다. 회귀의 잔차는 각 관측에서 자기 집단 평균을 뺀 것이므로
로 합동분산 그 자체다. 자유도 \(n-2\)도 합동 \(t\)의 \(n_1+n_2-2\)와 같다.
따라서 \(t\) 통계량도 같다. 회귀에서
이므로 \(t = \hat\beta_1/\operatorname{SE}(\hat\beta_1)\)이 합동 \(t\)와 완전히 일치한다. \(\square\)
import numpy as np
from scipy import stats
import statsmodels.api as sm

rng = np.random.default_rng(1)
x, y = rng.normal(0, 1, 12), rng.normal(0.5, 1, 15)
t, p = stats.ttest_ind(y, x, equal_var=True)

Y = np.concatenate([x, y])
D = np.concatenate([np.zeros(len(x)), np.ones(len(y))])
fit = sm.OLS(Y, sm.add_constant(D)).fit()

print(f"  합동 t : t={t:.6f}  p={p:.6f}")
print(f"  회귀   : t={fit.tvalues[1]:.6f}  p={fit.pvalues[1]:.6f}")
print(f"  beta1={fit.params[1]:.6f}   평균 차={y.mean()-x.mean():.6f}")
출력:
  합동 t : t=-0.170781  p=0.865771
  회귀   : t=-0.170781  p=0.865771
  beta1=-0.056424   평균 차=-0.056424
소수점 여섯 자리까지 같다. 기울기 추정값도 두 평균의 차와 정확히 일치한다.
왜 이것이 중요한가.
- 등분산 가정의 정체가 드러난다. 회귀는 오차분산이 설명변수와 무관하다고 가정하는데(등분산성), 집단이 둘뿐인 경우 그것이 곧 \(\sigma_1^2 = \sigma_2^2\)다. 13장에서 다룰 이분산 문제가 여기서는 웰치 문제와 같은 것이다.
- 확장이 자유로워진다. 집단이 셋이면 더미를 둘 쓰고, 공변량을 넣으면 공분산분석(ANCOVA)이 되며, 상호작용을 넣으면 집단별 기울기가 달라진다. \(t\) 검정은 출발점일 뿐이다.
- 같은 자료를 한 틀에서 다룬다. 13장의 회귀, 11장의 분산분석, 이 쪽의 \(t\) 검정이 모두 선형모형의 다른 얼굴이다.
연습문제 9. 집단이 둘일 때 일원배치 분산분석의 \(F\) 통계량과 합동 \(t\) 통계량 사이에 \(F = t^2\)이 성립한다. 이를 보이고, 두 검정의 \(p\)값이 같음을 확인하라. 집단이 셋 이상이면 왜 이 대응이 깨지는가?
풀이
대수적으로 확인한다. \(k=2\), \(n_1+n_2=N\)일 때 집단 간 제곱합은
이고 자유도가 \(1\)이다. 집단 내 제곱합은 \(\text{SSW} = (N-2)S_p^2\)으로 자유도 \(N-2\)다. 따라서
이다(\(\frac{n_1n_2}{N}\)의 역수가 \(\frac1{n_1}+\frac1{n_2}\)임을 쓴다). \(\square\)
분포로도 맞는다. \(t \sim t_{N-2}\)이면 \(t^2 \sim F_{1,N-2}\)이다. 5.2절 \(F\) 분포에서 본 관계이며, \(p\)값이 같은 것이 이 때문이다.
import numpy as np
from scipy import stats

rng = np.random.default_rng(1)
x, y = rng.normal(0, 1, 12), rng.normal(0.5, 1, 12)
t, pt = stats.ttest_ind(x, y)
F, pF = stats.f_oneway(x, y)
print(f"  t={t:.6f}  t^2={t**2:.6f}")
print(f"  F={F:.6f}")
print(f"  p(t)={pt:.6f}  p(F)={pF:.6f}")
출력:
  t=-1.012284  t^2=1.024719
  F=1.024719
  p(t)=0.322407  p(F)=0.322407
소수점 여섯 자리까지 같다.
집단이 셋 이상이면 대응이 깨진다. 이유는 자유도다. \(k\)개 집단이면 \(F\)의 분자 자유도가 \(k-1\)이 되어 \(F_{k-1,N-k}\)인데, \(t^2\)은 언제나 \(F_{1,\cdot}\)이다. \(k=2\)일 때만 \(k-1=1\)이라 일치한다.
개념적으로는 "질문이 하나인가 여럿인가"의 차이다. 집단이 둘이면 물을 수 있는 차이가 하나뿐이지만, 셋이면 \(\mu_1-\mu_2\), \(\mu_1-\mu_3\), \(\mu_2-\mu_3\)의 세 방향이 있다. \(F\)는 그 모두를 한꺼번에 검정하므로 하나의 \(t\)로 환원되지 않는다.
그래서 \(F\)가 유의할 때 "어느 쌍이 다른가"를 따로 물어야 하고, 그것이 11장의 사후비교이며 연습문제 8(대비)이 그 도구다. 다중성 보정이 필요한 것도 이 지점부터다.
연습문제 10. 표준화 효과크기 코헨의 \(d = (\bar X_2-\bar X_1)/S_p\)는 \(\delta = (\mu_2-\mu_1)/\sigma\)의 불편추정량이 아니다. 편향의 방향과 크기를 확인하고, 헤지스의 \(g\) 보정을 적용하라.
풀이
편향의 원인은 분모다. \(S_p\)가 \(\sigma\)를 과소추정하므로(\(E[S_p] = c_4\sigma < \sigma\), 5.2절 카이제곱 연습문제 10) 그 역수인 \(1/S_p\)는 과대추정되고, 결과적으로 \(d\)가 \(\delta\)보다 크게 나온다.
보정계수는
이고 \(g = J\cdot d\)가 근사적으로 불편이다.
import numpy as np

rng = np.random.default_rng(0)
d_true = 0.5
print(f"{'집단당 n':>10}{'E[d]':>10}{'참 d':>8}{'J':>10}{'E[g]':>10}")
for n in (5, 10, 20, 50):
    X = rng.normal(0, 1, (60_000, n))
    Y = rng.normal(d_true, 1, (60_000, n))
    sp = np.sqrt(((n-1)*X.var(1, ddof=1) + (n-1)*Y.var(1, ddof=1)) / (2*n-2))
    d = (Y.mean(1) - X.mean(1)) / sp
    J = 1 - 3 / (4*(2*n-2) - 1)
    print(f"{n:>10}{d.mean():>10.4f}{d_true:>8.1f}{J:>10.4f}{(d*J).mean():>10.4f}")
출력:
     집단당 n      E[d]     참 d         J      E[g]
         5    0.5550     0.5    0.9032    0.5013
        10    0.5232     0.5    0.9577    0.5011
        20    0.5099     0.5    0.9801    0.4998
        50    0.5037     0.5    0.9923    0.4999
\(n=5\)에서 \(d\)가 \(11\%\) 위로 편향되어 있다. 보정 후 \(g = 0.5013\)으로 거의 정확해진다. \(n=50\)이면 편향이 \(0.7\%\)로 줄어 보정이 거의 필요 없다.
왜 이것이 실무에서 문제가 되는가.
- 메타분석. 여러 연구의 효과크기를 합칠 때 표본이 작은 연구가 체계적으로 큰 \(d\)를 보고하면 통합 추정값이 부풀려진다. 메타분석에서 헤지스의 \(g\)를 표준으로 쓰는 이유다.
- 표본크기 설계. 연습문제 9에서 예비연구의 \(d\)로 설계하면 표본을 과소 산정한다고 했는데, 그 한 원인이 이 편향이다. 예비연구는 \(n\)이 작으므로 편향이 크다.
- 출판 편향과 겹친다. 유의한 결과만 보고되면 \(d\)가 한 번 더 위로 치우친다(1장). 두 편향이 같은 방향이라 효과크기 문헌이 전반적으로 과대평가되어 있을 수 있다.
\(J\)의 모양도 읽어 두자. \(\text{df}\)가 크면 \(J \to 1\)이므로 큰 표본에서는 \(d\)와 \(g\)가 사실상 같다. 보정이 중요한 것은 \(\text{df} < 20\), 즉 집단당 \(10\)명 남짓일 때다.
정리하며
- 등분산 정규모집단에서 \(\bar X_1 - \bar X_2\)는 정확히 \(N(\mu_1-\mu_2,\ \sigma^2(1/n_1+1/n_2))\)를 따르고, 표준오차는 \(\sigma\sqrt{1/n_1+1/n_2} = 0.3651\)이다.
- 합동분산 \(S_p^2\)은 두 집단의 편차제곱합을 모아 전체 자유도로 나눈 것이며, \((n_1+n_2-2)S_p^2/\sigma^2 \sim \chi^2_{n_1+n_2-2}\)이다. 이 단계에서 등분산 가정이 쓰인다.
- 분자와 분모가 독립이므로 합동 \(t\) 통계량이 정확히 \(t_{n_1+n_2-2}\)를 따른다. \(\sigma\)가 약분되어 모르는 모수가 남지 않는다.
- 명목 95% 구간의 실제 포함률이 \(n = 5\)에서도 0.95다. \(z\) 임계값을 쓰면 0.940으로 떨어진다.
- 정확성은 표본크기와 무관하지만 검정력은 그렇지 않다. 효과크기 0.5를 집단당 15개로 잡아낼 확률은 0.26뿐이고, 80%를 얻으려면 집단당 64개가 필요하다.
- 등분산이 지켜지면 표본크기가 어긋나도 정리 1은 그대로 정확하다. 잃는 것은 정확성이 아니라 정밀도다.
- 다음 쪽에서 등분산 가정을 깬다. 그 실패는 표본을 키워도 사라지지 않는다.
그래서 이 기준선 다음에는
이 쪽이 답한 것은 여기까지다. 등분산 정규모집단에서 합동 \(t\) 통계량의 표본분포는 정확히 \(t_{n_1+n_2-2}\)이고, 그 정확함은 표본크기에도 표본크기의 균형에도 의존하지 않는다. 표본분포를 묻는 이 장의 일은 그것으로 끝난다.
여기서 잰 0이 잣대가 된다. 이어지는 두 쪽은 이 잣대로 등분산과 정규성이 깨졌을 때의 거리를 재고, 그 분포로 실제 구간을 세우고 판정하는 일은 8.3절 μ₁−μ₂의 신뢰구간과 9.3절 이표본 t 검정(합동과 Welch)이 맡는다.