다중선형회귀
1. 모형
광고 자료에 매출을 TV·라디오·신문으로 적합하면 계수가 \(0.0470\), \(0.1797\), \(-0.0030\) 으로 나온다. 그대로 읽으면 라디오가 TV 보다 네 배 가까이 중요해 보인다. 그런데 각 변수가 \(1\) 표준편차만큼 움직일 때의 효과로 재면 TV 가 \(4.0809\), 라디오가 \(2.6426\) 으로 순위가 뒤집힌다 — TV 는 \(86.74\) 만큼 움직이는 변수이고 라디오는 \(14.71\) 만큼 움직인다. 계수는 단위를 달고 있어서 변수의 척도를 바꾸면 그만큼(역수 비율로) 바뀌는 양이다. 설명변수(explanatory variable)가 여럿일 때 계수 하나를 읽는다는 것은 정확히 무엇을 읽는 일인가.
다중선형회귀는 단순선형회귀를 설명변수가 여럿인 경우로 확장한 것이다.
행렬 표기로는 간결하게 다음과 같이 쓸 수 있다.
여기서 \(X\)는 \(n \times (p+1)\) 설계행렬(절편(intercept)을 위한 1의 열을 포함한다), \(\boldsymbol{\beta}\)는 \((p+1) \times 1\) 계수벡터, \(\boldsymbol{\varepsilon}\)는 \(n \times 1\) 오차벡터이다.
그림으로 보는 통계학 1. 「다른 것을 고정하고」를 처음 수로 한 사람
위 모형에서 \(\beta_j\) 를 읽는 법은 「다른 설명변수를 고정했을 때 \(x_j\) 가 하나 늘면 \(y\) 가 얼마나 변하는가」다. 말로는 쉬운데, 자료는 고정된 채로 오지 않는다. 노령 인구가 많은 동네가 하필 구제도 많이 받는다면, 둘을 어떻게 떼어 놓는가.
\(1899\) 년에 그것을 수로 한 사람이 조지 우드니 율이다. 그가 다룬 것은 당시 영국의 뜨거운 정책 논쟁이었다 — 구빈원 밖에서 주는 구제(아웃도어 구제)가 빈민을 줄이는가 늘리는가. 한쪽은 구제가 게으름을 키운다 했고, 다른 쪽은 구제가 많은 곳이 원래 가난한 곳이라 했다.
율이 한 일은 빈민율의 변화를 구제 비율의 변화에만 견주지 않고, 노령 인구 비율의 변화와 인구 자체의 변화를 함께 넣고 푼 것이다. 오늘 우리가 다중회귀(multiple regression)라 부르는 일이고, 사회과학에서 그것이 본격적으로 쓰인 첫 자리로 꼽힌다.
왜 함께 넣어야 하는지는 그림 하나로 끝난다.
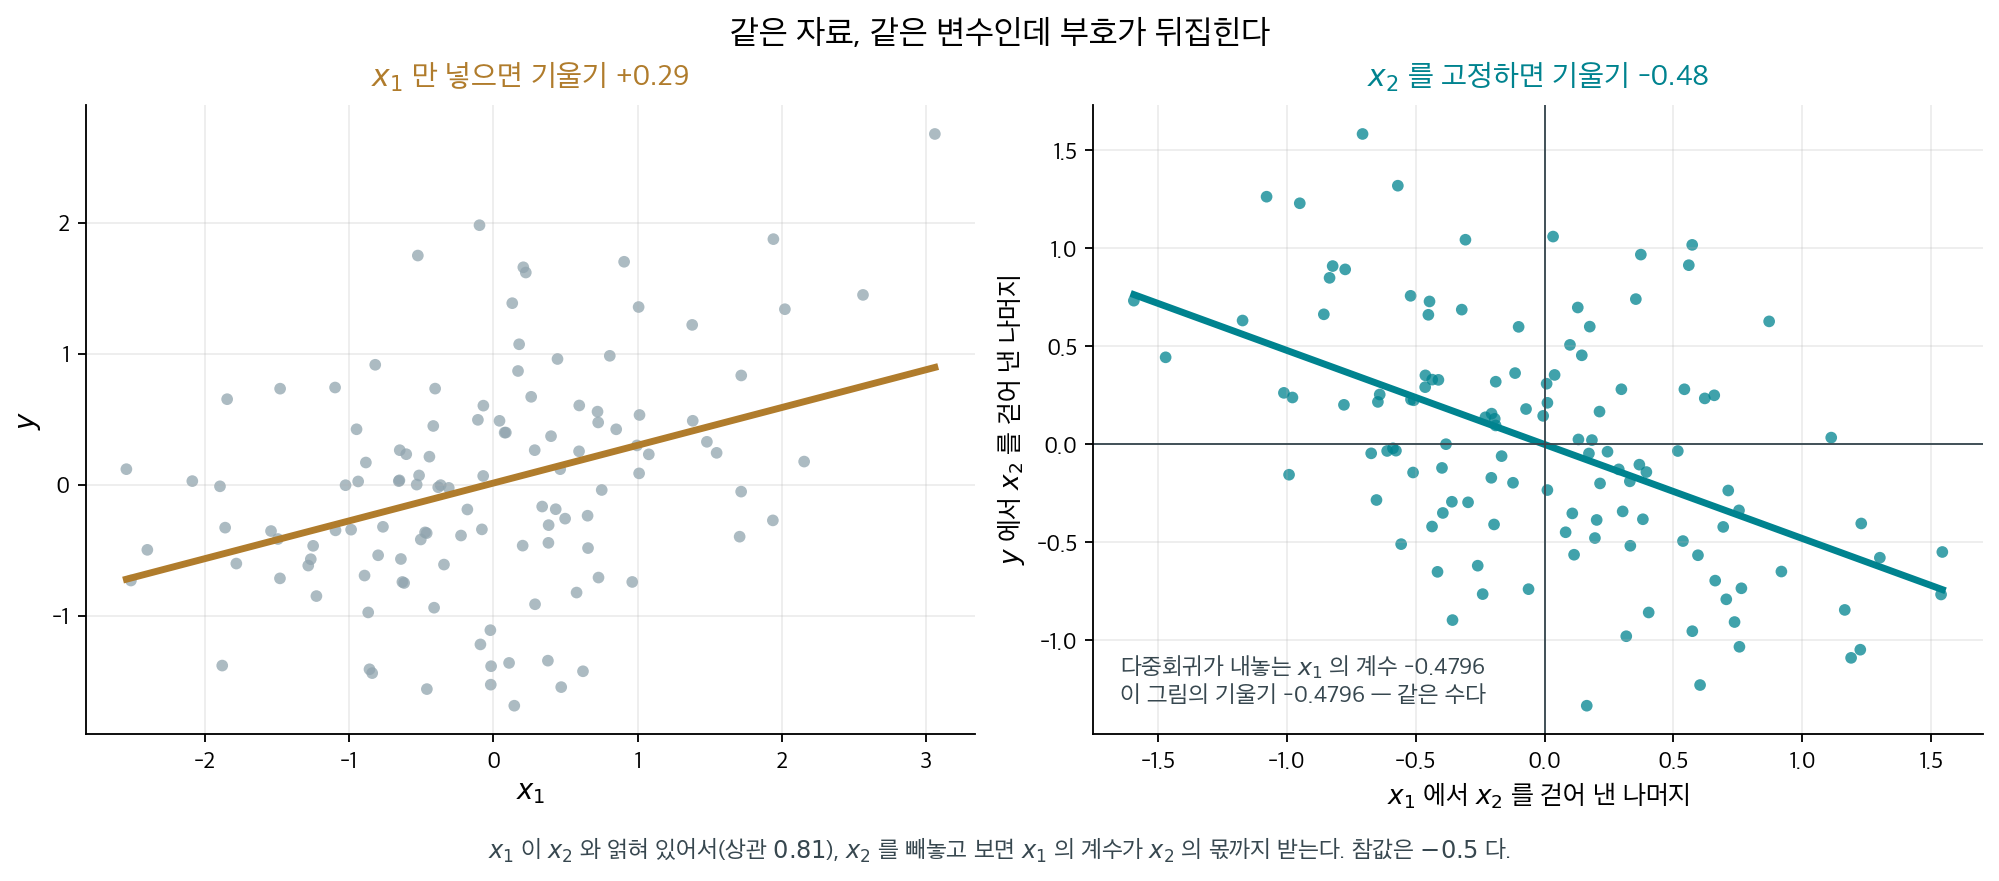
\(x_1\) 과 \(x_2\) 의 상관이 \(0.81\) 이고 \(x_1\) 의 참 효과는 \(-0.5\) 다. \(x_2\) 를 빼놓고 보면 \(x_1\) 의 계수가 \(x_2\) 의 몫까지 받아 부호가 뒤집힌다. 오른쪽 그림의 기울기 \(-0.4796\) 은 다중회귀가 내놓는 \(x_1\) 의 계수와 소수 열다섯째 자리까지 같다. 자료에서 직접 그렸다.
오른쪽 그림이 「고정한다」는 말의 정확한 뜻이다. \(x_2\) 를 양쪽에서 걷어 내고 — \(y\) 에서도 빼고 \(x_1\) 에서도 빼고 — 남은 것끼리 그린 기울기가 다중회귀의 계수와 정확히 같다. 나중에 프리슈·워·로벨의 이름이 붙는 사실이고, 다중회귀가 하는 일이 「변수를 더 넣는 것」이 아니라 「이미 설명된 몫을 걷어 내고 남은 것을 보는 것」임을 말해 준다.
뒷이야기가 있다. 율은 자기가 만든 도구의 위험을 누구보다 잘 알았다. \(1926\) 년에 그는 「우리는 왜 때때로 시계열 사이에서 엉터리 상관을 얻는가」라는 글을 쓴다. 둘 다 시간에 따라 꾸준히 오르내리기만 하면, 아무 관계가 없어도 상관계수가 \(1\) 에 가깝게 나온다는 것이었다. 변화량을 쓴 그의 \(1899\) 년 분석이 이미 그 함정을 비켜 간 설계였다.
그러니 다중회귀는 교란을 지워 주는 기계가 아니다. 넣은 것만 고정해 준다. 율이 노령 인구를 넣었기에 그 몫이 걸러졌을 뿐, 넣지 않은 무언가가 있었다면 그것은 여전히 \(x_1\) 의 계수 안에 앉아 있다. 위 그림의 왼쪽이 바로 그 모습이다.
확인한 곳 — 율의 \(1899\) 년 『Journal of the Royal Statistical Society』 논문 「An Investigation into the Causes of Changes in Pauperism in England」이 구제 비율·노령 인구 비율·인구 변화를 함께 넣은 다중회귀였고 사회과학에서 그 방법이 쓰인 이른 사례로 꼽힌다는 것, 그가 \(1926\) 년에 「Why do we sometimes get nonsense-correlations between time-series?」를 썼다는 것은 통계사에서 거듭 다루어져 온 것이다 · 그림의 수치는 이 쪽에서 만든 자료(\(n=120\))로 직접 쟀다
설명변수가 둘이면 평면이다
설명변수가 하나일 때 적합값은 직선 위에 놓였다. 둘이면
가 \((x_1, x_2, y)\) 공간에서 평면을 이룬다. 잔차 \(e_i = y_i - \hat y_i\) 는 그 평면까지의 수직 거리다 — \(y\) 축과 나란한 거리이지 평면까지의 최단거리가 아니다.
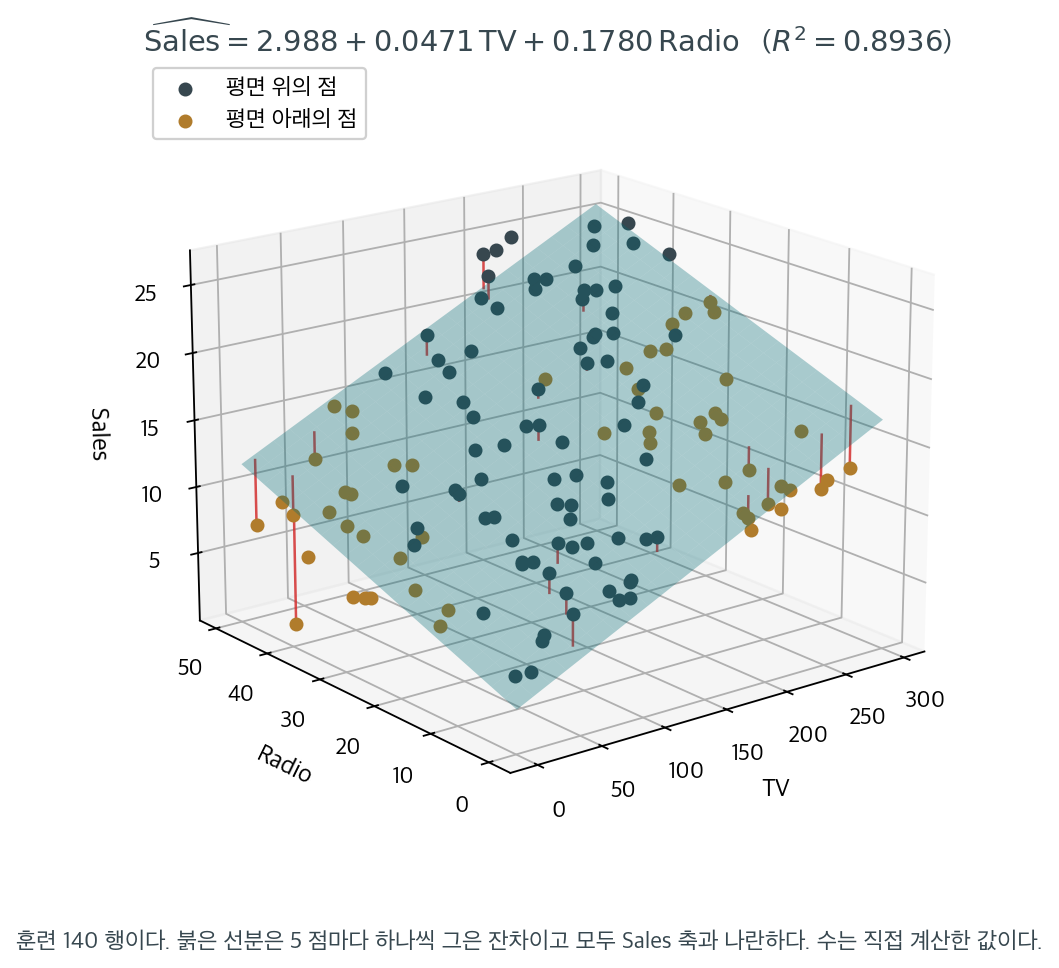
아래 보기 \(4\) 가 적합할 모형을 미리 그린 것이다. \(\widehat{\text{Sales}} = 2.988 + 0.0471\,\text{TV} + 0.1780\,\text{Radio}\) 이고 훈련 \(R^2\) 이 \(0.8936\) 이다. 평면이 TV 쪽으로도 Radio 쪽으로도 기울어 있고, 그 두 기울기가 각각 \(\hat\beta_1\) 과 \(\hat\beta_2\) 다. \(\hat\beta_1\) 은 Radio 를 고정한 채 TV 방향으로 잰 평면의 기울기이고, 바로 위 상자가 말한 「다른 것을 고정하고」가 기하로는 이 뜻이다.
설명변수가 셋이 되면 그릴 수 없다. 그래서 이 쪽의 나머지는 그림 대신 표로 간다.
2. 평면이 휘어야 할 때
설명변수가 둘이면 적합되는 것은 평면이고, 평면은 \(x_1\) 의 효과가 \(x_2\) 에 따라 달라지는 것을 담지 못한다. 담으려면 곱항을 넣어
로 가야 하고, 그러면 면이 뒤틀린다. 아래 보기들이 광고 자료에서 그 항을 넣고 빼 본다. 왜 그 항이 필요한지, 계수를 어떻게 읽는지, 중심화가 왜 따라오는지는 13.5절 교호작용 항이 다룬다.
3. 훈련자료와 시험자료를 갈라 적합한다
무작위 훈련–검정 분할
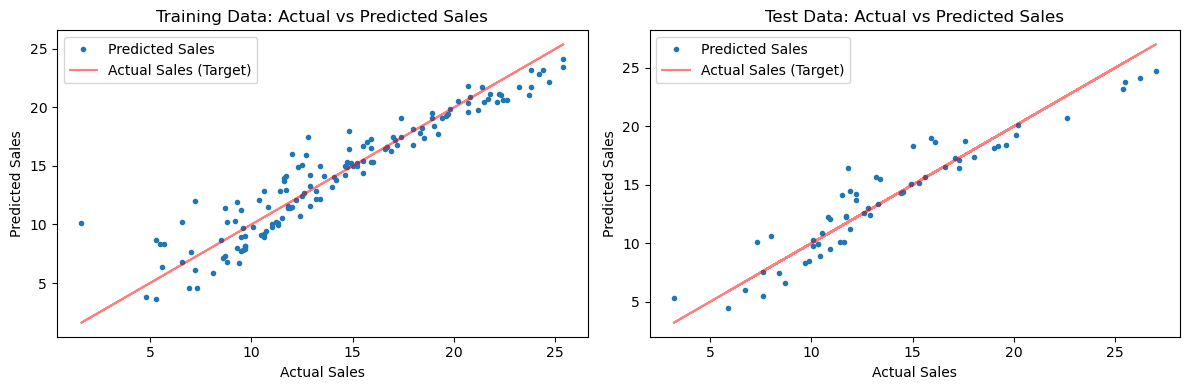
보기 1. 광고 자료로 다중회귀. Sales를 TV, Radio, 그리고 교호작용(interaction) TV:Radio에 회귀시킨다. 자료의 30%를 무작위로 떼어 시험용으로 쓴다.
(1) 출력의 Model Coefficients의 첫 값 \(0.0206\)을 "TV 광고비를 \(1\) 늘리면 매출이 \(0.0206\) 늘어난다"로 읽을 수 있는가. \(\partial \hat y/\partial \text{TV}\)를 계수로 적어 그 해석이 성립하는 조건을 말하시오.
(2) 다중회귀에서 \(R^2\)는 \(y\)와 \(\hat y\)의 상관의 제곱이다. 단순회귀(simple linear regression)의 \(r^2 = R^2\)과 무엇이 다른지 말하고, 이 자료에서 두 값을 계산해 확인하시오.
풀이
(1) 그렇게 읽을 수 없다. 적합된 식은
이므로 TV 에 대한 편미분은
이다. TV 의 효과가 Radio 의 값에 따라 달라진다. 그러므로 \(\hat\beta_1 = 0.0206\)은 "TV 를 \(1\) 늘릴 때의 효과"가 아니라 \(\text{Radio} = 0\) 일 때의 효과다. 교호작용이 든 모형에서 주효과 계수는 언제나 "다른 변수가 \(0\) 인 자리에서의 기울기"이고, 그 자리가 자료에 거의 없으면 해석할 값이 없는 수가 된다.
같은 이유로 Radio 계수 \(0.0474\)도 \(\text{TV} = 0\)에서의 기울기다. 뒤집어 말하면 교호작용 모형에서 "TV 의 효과"는 하나의 수가 아니라 Radio 에 대한 함수다.
(2) 단순회귀에서만 \(r^2 = R^2\) 이다. 설명변수가 하나면 \(\hat y\)가 \(x\)의 증가 선형함수이거나 감소 선형함수이므로 \(\lvert \operatorname{corr}(y, \hat y)\rvert = \lvert \operatorname{corr}(y, x)\rvert\)이고 제곱하면 같아진다. 설명변수가 여럿이면 \(\hat y\)는 여러 열의 선형결합이므로 어느 한 \(x_j\)와의 상관으로 환원되지 않는다. 그때 \(R^2\)의 뜻은
이고, 이 등식은 절편을 포함한 최소제곱에서 항상 성립한다. 잔차가 \(\hat y\)와 직교하기 때문이다.
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression

plt.rcParams["font.sans-serif"] = ["NanumGothic", "Apple SD Gothic Neo", "Malgun Gothic"]
plt.rcParams["font.family"] = "sans-serif"
plt.rcParams["axes.unicode_minus"] = False

# 광고비와 매출 자료. TV·라디오·신문 광고비와 매출이 들어 있다.
url = 'https://raw.githubusercontent.com/justmarkham/scikit-learn-videos/8545c74961398def7724501648fd504dbf061b41/data/Advertising.csv'
df = pd.read_csv(url, usecols=[1, 2, 3, 4])
print(df.head(), end="\n\n")

# 교호작용 항을 만든다. "TV 광고의 효과가 라디오 광고를 얼마나 하느냐에
# 따라 달라진다"는 생각을 두 변수의 곱 하나로 담는 것이다.
df['TV:Radio'] = df['TV'] * df['Radio']
print(df.head(), end="\n\n")

# 자료의 30%를 시험용으로 떼어 둔다. 훈련에 쓴 자료로 성능을 재면
# 언제나 실제보다 좋게 나오기 때문이다.
test_size_ratio = 0.3

# 신문 광고는 뺀다. 뒤에서 보듯 계수가 유의하지 않기 때문이다.
X = df[['TV', 'Radio', 'TV:Radio']]
y = df['Sales']

# random_state 를 고정해야 나눈 결과가 매번 같아진다.
x_train, x_test, y_train, y_test = train_test_split(X, y, test_size=test_size_ratio, random_state=42)
print("x_train.head()")
print(x_train.head(), end="\n\n")
print("y_train.head()")
print(y_train.head(), end="\n\n")

model = LinearRegression()
model.fit(x_train, y_train)

y_train_pred = model.predict(x_train)
y_test_pred = model.predict(x_test)

# 교호작용이 들어가면 TV 계수를 "TV 를 1 늘렸을 때의 효과"로 읽을 수 없다.
# 그 효과가 라디오 값에 따라 달라지기 때문이다.
print(f"Model Intercept: {model.intercept_:.4f}")
print(f"Model Coefficients: {np.round(model.coef_, 4)}\n")

# 실제값 대 예측값 그림. 점들이 붉은 대각선에 붙을수록 잘 맞은 것이다.
# 훈련과 시험을 나란히 놓아 과적합 여부를 함께 본다.
fig, axes = plt.subplots(1, 2, figsize=(12, 3))

for ax, title, y_actual, y_pred in zip(axes, ("Train Set", "Test Set"), (y_train, y_test), (y_train_pred, y_test_pred)):
    ax.set_title(f"{title}: Actual vs Predicted Sales")
    ax.plot(y_actual, y_pred, '.', label="Predicted Sales")
    ax.plot(y_actual, y_actual, '-r', alpha=0.5, label="Actual Sales (Target)")
    ax.set_xlabel('Actual Sales')
    ax.set_ylabel('Predicted Sales')
    ax.legend()

plt.tight_layout()
plt.show()
출력:
      TV  Radio  Newspaper  Sales
0  230.1   37.8       69.2   22.1
1   44.5   39.3       45.1   10.4
2   17.2   45.9       69.3    9.3
3  151.5   41.3       58.5   18.5
4  180.8   10.8       58.4   12.9

      TV  Radio  Newspaper  Sales  TV:Radio
0  230.1   37.8       69.2   22.1   8697.78
1   44.5   39.3       45.1   10.4   1748.85
2   17.2   45.9       69.3    9.3    789.48
3  151.5   41.3       58.5   18.5   6256.95
4  180.8   10.8       58.4   12.9   1952.64

x_train.head()
        TV  Radio  TV:Radio
169  284.3   10.6   3013.58
97   184.9   21.0   3882.90
31   112.9   17.4   1964.46
12    23.8   35.1    835.38
35   290.7    4.1   1191.87

y_train.head()
169    15.0
97     15.5
31     11.9
12      9.2
35     12.8
Name: Sales, dtype: float64

Model Intercept: 6.3749
Model Coefficients: [0.0206 0.0474 0.001 ]
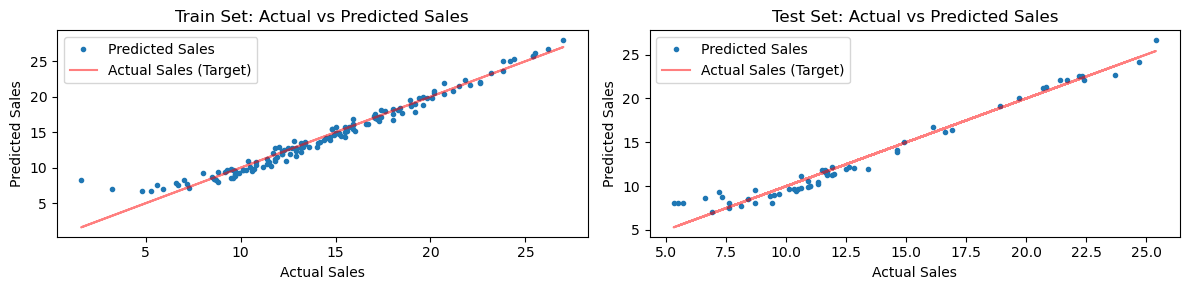
시장 200곳의 광고비와 매출이다. 처음 두 표에서 TV:Radio 열이 두 열의 곱으로 만들어졌음을 볼 수 있다(\(230.1 \times 37.8 = 8697.78\)). 교호작용 항은 새 자료가 아니라 기존 두 열에서 계산된 열이다.
(1)과 (2)를 수치로 확인한다.
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression

url = 'https://raw.githubusercontent.com/justmarkham/scikit-learn-videos/8545c74961398def7724501648fd504dbf061b41/data/Advertising.csv'
df = pd.read_csv(url, usecols=[1, 2, 3, 4])
df['TV:Radio'] = df['TV'] * df['Radio']
X = df[['TV', 'Radio', 'TV:Radio']]
y = df['Sales']
x_train, x_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
model = LinearRegression().fit(x_train, y_train)

b_tv, b_radio, b_inter = model.coef_
print(f"TV 계수 b1 = {b_tv:.6f},  교호작용 계수 b3 = {b_inter:.8f}")
print()
print(f"{'Radio':>8s}{'dSales/dTV = b1 + b3*Radio':>30s}")
for radio in (0.0, x_train.Radio.mean(), x_train.Radio.max()):
    print(f"{radio:8.3f}{b_tv + b_inter * radio:30.6f}")
print()
print(f"훈련 R^2 = {model.score(x_train, y_train):.6f},  시험 R^2 = {model.score(x_test, y_test):.6f}")
print(f"훈련 RMSE = {np.sqrt(((y_train - model.predict(x_train)) ** 2).mean()):.4f},  "
      f"시험 RMSE = {np.sqrt(((y_test - model.predict(x_test)) ** 2).mean()):.4f}")
print()
# 다중회귀에서 R^2 는 y 와 y-hat 의 상관의 제곱이다
y_hat = model.predict(x_train)
print(f"corr(y, y-hat)^2 = {np.corrcoef(y_train, y_hat)[0, 1] ** 2:.6f}")
print(f"TV 하나만 쓴 단순회귀의 r^2 = "
      f"{np.corrcoef(x_train.TV, y_train)[0, 1] ** 2:.6f}")
출력:
TV 계수 b1 = 0.020610,  교호작용 계수 b3 = 0.00100684

   Radio    dSales/dTV = b1 + b3*Radio
   0.000                      0.020610
  23.525                      0.044295
  49.600                      0.070549

훈련 R^2 = 0.965903,  시험 R^2 = 0.967327
훈련 RMSE = 0.9459,  시험 RMSE = 0.9445

corr(y, y-hat)^2 = 0.965903
TV 하나만 쓴 단순회귀의 r^2 = 0.573602
TV 의 한계효과(marginal effect, 곧 위의 편미분 \(\partial\hat y/\partial\text{TV}\))가 Radio 에 따라 세 배 넘게 변한다. Radio 가 \(0\) 일 때 \(0.0206\), 훈련자료 평균 \(23.5\) 일 때 \(0.0443\), 최댓값 \(49.6\) 일 때 \(0.0705\)다. 그러므로 \(0.0206\) 하나로 "TV 의 효과"를 말하면 라디오 광고를 많이 하는 시장에서 \(3.4\) 배 과소평가한다. 교호작용이 든 모형에서 주효과 계수만 보고하는 보고서는 이 점에서 틀린다.
(2)의 등식도 맞는다. corr(y, y-hat)^2 = 0.965903이 model.score가 준 \(R^2\)와 소수 여섯째 자리까지 같다. 반면 TV 하나만 쓴 단순회귀의 \(r^2\)은 \(0.5736\)에 지나지 않는다. \(0.5736\)과 \(0.9659\)의 간격이 "설명변수를 하나 더 넣는 일"의 값이며, 어느 한 변수와 \(y\)의 상관으로는 이 수를 만들 수 없다. 단순회귀에서 \(r^2 = R^2\)였던 등식은 설명변수가 하나라는 사실에 기대고 있었고, 여기서는 쓸 수 없다.
그림에서 읽을 것은 두 칸의 산포가 거의 같다는 사실이다. 훈련 RMSE \(0.9459\), 시험 RMSE \(0.9445\)로 시험이 오히려 아주 조금 작다. 모수가 네 개뿐이고 훈련자료가 \(140\)개이므로 과적합(overfitting)이 생길 여지가 거의 없다. 다만 왼쪽 아래와 오른쪽 위에서 점들이 빨간 \(y = x\) 선 같은 쪽으로 치우치는 모양이 보이는데, 이는 뒤에서 볼 잔차의 왜도(skewness, \(-2.27\))와 같은 현상이다. \(\square\)
결정론적 훈련–검정 분할
보기 2. 순서대로 나눈 훈련·시험. 보기 1과 같은 모형을 쓰지만 무작위 분할 대신 앞 \(70\%\)를 훈련, 뒤 \(30\%\)를 시험으로 자른다.
(1) 보기 1의 계수와 이 보기의 계수가 다르다. 네 계수의 차이를 각각 계수의 표준오차 단위로 재어, 그 차이가 놀랄 만한 크기인지 판정하시오. 어느 분할이 "맞는" 분할인가.
(2) 이 보기의 계수가 뒤에 나올 보기 5의 statsmodels 출력과 같은지 확인하시오. 두 패키지가 같은 값을 주어야 하는 까닭은 무엇인가.
풀이
(1) 해석적으로. 두 분할은 같은 모집단에서 뽑은 서로 다른 \(140\)개 표본이므로, 계수가 다른 것은 추정량의 표본변동이다. 변동의 자연스러운 척도는 계수의 표준오차 \(\widehat{\operatorname{se}}(\hat\beta_j)\)이고, 차이를 그것으로 나눈 값이 몇 이내인지를 본다.
다만 두 표본이 독립이 아니다. 무작위 \(70\%\)와 앞쪽 \(70\%\)는 상당히 겹친다(두 표본 모두 \(140\)개이고 전체가 \(200\)개이므로 중첩이 적어도 \(80\)개다). 그러므로 "차이/표준오차"는 \(t\) 통계량이 아니라 눈금자로만 쓴다. 독립 표본이라면 차이의 표준오차가 \(\sqrt2\,\widehat{\operatorname{se}}\)였을 것이고, 겹치면 그보다 작아진다.
(2) 같아야 한다. sklearn 의 LinearRegression 과 statsmodels 의 ols 는 둘 다 절편이 있는 보통최소제곱(ordinary least squares)을 푼다. 최소제곱 해는 \(X\)가 완전계수(full rank, 열들이 일차독립)이면 유일하므로 두 패키지의 답은 수치오차 말고는 같을 수밖에 없다. 다른 것은 보고하는 것이다. sklearn 은 계수와 예측만 주고, statsmodels 은 표준오차·\(t\)·\(p\)·신뢰구간·진단까지 준다.
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression

# 자료 읽기
url = 'https://raw.githubusercontent.com/justmarkham/scikit-learn-videos/8545c74961398def7724501648fd504dbf061b41/data/Advertising.csv'
df = pd.read_csv(url, usecols=[1, 2, 3, 4])

# 교호작용 항을 더한다
df['TV:Radio'] = df['TV'] * df['Radio']

# 앞에서는 무작위로 나눴지만 여기서는 앞 70%, 뒤 30% 로 자른다.
# 자료가 시간 순서로 쌓여 있다면 이쪽이 맞다 — 미래로 과거를 맞히는 일을
# 막아 주기 때문이다.
num_total_observations = df.shape[0]
test_ratio = 0.3
num_train_observations = int(num_total_observations * (1 - test_ratio))

train_data = df.iloc[:num_train_observations]
test_data = df.iloc[num_train_observations:]

x_train = train_data[['TV', 'Radio', 'TV:Radio']]
y_train = train_data['Sales']
x_test = test_data[['TV', 'Radio', 'TV:Radio']]
y_test = test_data['Sales']

# 모형 적합
model = LinearRegression()
model.fit(x_train, y_train)

y_train_pred = model.predict(x_train)
y_test_pred = model.predict(x_test)

print(f"Model Intercept: {model.intercept_:.4f}")
print(f"Model Coefficients: {np.round(model.coef_, 4)}\n")

# 그림으로 확인
fig, axes = plt.subplots(1, 2, figsize=(12, 3))

for ax, title, y_actual, y_pred in zip(axes, ("Train Set", "Test Set"), (y_train, y_test), (y_train_pred, y_test_pred)):
    ax.set_title(f"{title}: Actual vs Predicted Sales")
    ax.plot(y_actual, y_pred, '.', label="Predicted Sales")
    ax.plot(y_actual, y_actual, '-r', alpha=0.5, label="Actual Sales (Target)")
    ax.set_xlabel('Actual Sales')
    ax.set_ylabel('Predicted Sales')
    ax.legend()

plt.tight_layout()
plt.show()
출력:
Model Intercept: 6.8814
Model Coefficients: [0.0183 0.0229 0.0011]
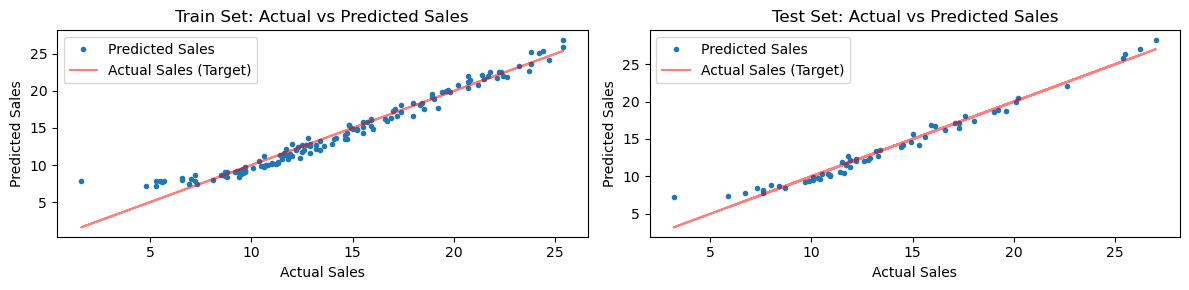
세 계수가 각각 TV \(0.0183\), Radio \(0.0229\), 교호작용 TV:Radio \(0.0011\)이다. 셋째 계수는 신문이 아니라 교호작용이다. 이 모형에는 Newspaper 가 애초에 들어 있지 않다.
이제 (1)과 (2)를 수치로 확인한다.
import numpy as np
import pandas as pd
import statsmodels.formula.api as smf
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression

url = 'https://raw.githubusercontent.com/justmarkham/scikit-learn-videos/8545c74961398def7724501648fd504dbf061b41/data/Advertising.csv'
df = pd.read_csv(url, usecols=[1, 2, 3, 4])
df['TV:Radio'] = df['TV'] * df['Radio']
cols = ['TV', 'Radio', 'TV:Radio']

# 무작위로 나눈 경우(보기 1)
X, y = df[cols], df['Sales']
xr_train, xr_test, yr_train, yr_test = train_test_split(X, y, test_size=0.3, random_state=42)
random_model = LinearRegression().fit(xr_train, yr_train)

# 순서대로 나눈 경우(이 보기)
train_data, test_data = df.iloc[:140], df.iloc[140:]
seq_model = LinearRegression().fit(train_data[cols], train_data['Sales'])

# statsmodels 로 같은 모형을 적합해 표준오차를 얻는다
sm_fit = smf.ols('Sales ~ TV + Radio + TV:Radio', train_data).fit()

print(f"{'항':12s}{'무작위':>12s}{'순서대로':>12s}{'statsmodels':>14s}{'차이':>12s}{'SE':>11s}{'차이/SE':>9s}")
names = ['Intercept', 'TV', 'Radio', 'TV:Radio']
random_params = [random_model.intercept_, *random_model.coef_]
seq_params = [seq_model.intercept_, *seq_model.coef_]
for name, a, b in zip(names, random_params, seq_params):
    se = sm_fit.bse[name]
    print(f"{name:12s}{a:12.6f}{b:12.6f}{sm_fit.params[name]:14.6f}"
          f"{a - b:12.6f}{se:11.6f}{(a - b) / se:9.3f}")
print()
print(f"sklearn 와 statsmodels 계수의 최대 차이 = "
      f"{max(abs(b - sm_fit.params[n]) for n, b in zip(names, seq_params)):.2e}")
print()
for label, model, xtr, ytr, xte, yte in [
        ("무작위", random_model, xr_train, yr_train, xr_test, yr_test),
        ("순서대로", seq_model, train_data[cols], train_data['Sales'],
         test_data[cols], test_data['Sales'])]:
    print(f"{label:8s} 훈련 R^2 {model.score(xtr, ytr):.4f}  시험 R^2 {model.score(xte, yte):.4f}"
          f"   훈련 RMSE {np.sqrt(((ytr - model.predict(xtr)) ** 2).mean()):.4f}"
          f"  시험 RMSE {np.sqrt(((yte - model.predict(xte)) ** 2).mean()):.4f}")
출력:
항                    무작위        순서대로   statsmodels          차이         SE    차이/SE
Intercept       6.374865    6.881435      6.881435   -0.506570   0.314065   -1.613
TV              0.020610    0.018326      0.018326    0.002284   0.001976    1.156
Radio           0.047355    0.022921      0.022921    0.024434   0.010912    2.239
TV:Radio        0.001007    0.001121      0.001121   -0.000115   0.000067   -1.707

sklearn 와 statsmodels 계수의 최대 차이 = 6.66e-14

무작위      훈련 R^2 0.9659  시험 R^2 0.9673   훈련 RMSE 0.9459  시험 RMSE 0.9445
순서대로     훈련 R^2 0.9652  시험 R^2 0.9739   훈련 RMSE 0.9800  시험 RMSE 0.8213
차이는 대개 표준오차 두 개 안쪽이다. 절편 \(-1.61\), TV \(+1.16\), 교호작용 \(-1.71\)로 모두 \(2\) 미만이고, Radio 만 \(+2.24\)로 조금 크다. 눈금자로 보면 Radio 계수가 \(0.0474\)와 \(0.0229\)로 두 배 차이나지만, 그 계수의 표준오차가 \(0.0109\)라 절대 크기로는 \(2.2\) SE 다. 두 표본이 겹쳐 있으므로 이것을 유의성으로 읽어서는 안 되고, "작은 표본에서는 계수가 이만큼 흔들린다"로 읽어야 한다. 교호작용 모형에서 Radio 주효과는 "TV \(= 0\) 에서의 기울기"이므로 자료가 뒷받침하는 정보가 적고, 그래서 가장 불안정한 것도 자연스럽다.
어느 분할이 맞는지는 자료의 성질이 정한다. 관측값이 교환가능(exchangeable)하다면, 곧 행의 순서를 뒤섞어도 자료의 분포가 달라지지 않는다면 무작위 분할이 낫다. 시험자료가 훈련자료와 같은 분포에서 오기 때문이다. 관측값이 시간 순서로 쌓였다면 순서대로 자르는 것이 맞다. 무작위로 섞으면 미래 관측값이 훈련에 섞여 들어가 성능을 부풀린다. 이 자료는 시장 \(200\)곳이고 행 순서가 시간이라는 근거가 없으므로 둘 중 어느 쪽이 옳다고 단정할 수 없다. 코드의 주석이 "자료가 시간 순서로 쌓여 있다면 이쪽이 맞다"고 조건을 달아 둔 것이 정확한 서술이다.
(2) 두 패키지가 소수 열넷째 자리까지 같다. 최대 차이가 \(6.7 \times 10^{-14}\)로 부동소수점 한계이며, statsmodels 열이 뒤에 나올 보기 5의 출력(Intercept 6.8814, TV 0.0183, Radio 0.0229, TV:Radio 0.0011)과 그대로 맞는다. 곧 이 보기와 보기 5는 같은 적합을 두 도구로 본 것이다.
마지막 두 줄이 한 가지를 더 보여 준다. 순서대로 나눈 경우 시험 RMSE \(0.8213\) 이 훈련 RMSE \(0.9800\) 보다 작다. 과적합의 반대 방향이다. 뒤 \(60\)개 시장이 앞 \(140\)개보다 모형에 잘 맞는 자료였다는 뜻일 뿐이며, 시험자료 하나로 성능을 재면 이런 변동이 늘 따라온다는 경고로 읽어야 한다. \(\square\)
4. 세 모형을 적합해 견준다
statsmodels 라이브러리는 p 값, 신뢰구간, 진단검정을 포함한 풍부한 통계 출력을 제공한다. scikit-learn과의 자세한 비교는 패키지 비교를 보라.
Sales ~ TV + Radio + Newspaper
보기 3. 세 매체를 모두 넣은 모형. Sales ~ TV + Radio + Newspaper를 훈련자료 \(140\)개로 적합하고 summary()를 읽는다.
(1) 신문 광고는 매출과 양의 상관을 갖는데 이 모형의 계수는 \(-0.0030\)이고 \(p = 0.669\)다. 부호가 뒤집히고 유의성이 사라지는 까닭을 누락변수 분해
로 설명하시오. 여기서 \(\gamma\)는 Sales ~ Newspaper 단순회귀의 기울기이고 \(\delta_j\)는 x_j ~ Newspaper 보조회귀의 기울기다. 세 항을 수치로 분해해 등식을 확인하시오.
(2) 표의 t = -0.428을 제곱한 값이 "신문을 뺀 모형과 비교하는 부분 \(F\) 검정(partial \(F\)-test)"의 \(F\)와 같음을 확인하시오.
풀이
(1) 해석적으로. 단순회귀 Sales ~ Newspaper의 기울기는 신문이 혼자서 설명하는 양이다. 참 모형이 \(y = \beta_0 + \beta_{\text{TV}}x_1 + \beta_{\text{Radio}}x_2 + \beta_{\text{news}}x_3 + \varepsilon\)인데 \(x_3\) 하나만 넣고 적합하면, 생략된 두 변수가 \(x_3\)와 상관된 만큼 그 효과가 \(x_3\)의 계수로 흘러든다. 보조회귀 \(x_j = \delta_{j0} + \delta_j x_3 + v_j\)를 대입하면
이고 이것은 표본에서 항등식으로 성립한다(근사가 아니다). 신문과 라디오가 함께 집행되는 경향이 있으면 \(\hat\delta_{\text{Radio}} > 0\)이고 라디오의 효과 \(\hat\beta_{\text{Radio}} > 0\)이므로 셋째 항이 양수가 되어 \(\hat\gamma\)를 밀어 올린다. 단순상관이 보여 준 것은 신문의 효과가 아니라 라디오의 효과였다.
(2) 해석적으로. 모수 하나를 빼는 부분 \(F\) 검정은 분자 자유도가 \(1\)이다.
분자 자유도가 \(1\)인 \(F\) 분포는 \(t\) 분포의 제곱이므로 \(F_{1,\,n-p} = t_{n-p}^2\)이고, 두 검정은 같은 검정이다. 따라서 \(F = (-0.428477)^2 = 0.1836\)이 나와야 한다. 여기서 \(n - p = 140 - 4 = 136\)이 잔차자유도다.
\(p\) 의 뜻이 절에 따라 다르다
A.4절이 경고해 둔 대로, 부록 A는 \(p\) 를 절편 열을 포함한 \(X\) 의 열 개수로 쓰고 잔차자유도를 \(n - p\) 로 적는다. 이 장의 본문은 \(p\) 를 설명변수 개수로 세고 설계행렬을 \(n \times (p+1)\) 로 쓰므로 자유도가 \(n - p - 1\) 이 된다. 두 표기의 \(p\) 가 \(1\) 만큼 어긋날 뿐 자유도 자체는 같다. 지금 자료는 \(n = 140\), 설명변수 \(3\) 개이므로 어느 표기로도 \(136\) 이고, 출력의 Df Residuals: 136 이 그것이다. 수를 읽을 때는 summary() 의 Df Residuals 를 믿는 것이 안전하다.
import pandas as pd
import statsmodels.formula.api as sm
import matplotlib.pyplot as plt

plt.rcParams["font.sans-serif"] = ["NanumGothic", "Apple SD Gothic Neo", "Malgun Gothic"]
plt.rcParams["font.family"] = "sans-serif"
plt.rcParams["axes.unicode_minus"] = False


def print_summary(res):
    """summary()에서 실행 날짜와 시각만 지우고 인쇄한다(재현 가능한 출력을 위해)."""
    lines = []
    for line in str(res.summary()).split("\n"):
        if line.startswith(("Date:", "Time:")):
            lines.append(line[:19].ljust(38) + line[38:])
        else:
            lines.append(line)
    print("\n".join(lines) + "\n")


url = 'https://raw.githubusercontent.com/justmarkham/scikit-learn-videos/8545c74961398def7724501648fd504dbf061b41/data/Advertising.csv'
data = pd.read_csv(url, usecols=[1, 2, 3, 4])

num_total_observations = data.shape[0]
test_ratio = 0.3
num_train_observations = int(num_total_observations * (1 - test_ratio))

train_data = data.iloc[:num_train_observations]
test_data = data.iloc[num_train_observations:]

# 세 광고 매체를 모두 넣어 본다. 출력표에서 신문의 p 값을 눈여겨볼 것.
model = sm.ols('Sales ~ TV + Radio + Newspaper', train_data).fit()
print("Model with TV, Radio, and Newspaper as predictors:")
print_summary(model)

train_predictions = model.predict(train_data)
test_predictions = model.predict(test_data)

fig, axes = plt.subplots(1, 2, figsize=(12, 4))

axes[0].set_title("Training Data: Actual vs Predicted Sales")
axes[0].plot(train_data['Sales'], train_predictions, '.', label="Predicted Sales")
axes[0].plot(train_data['Sales'], train_data['Sales'], '-r', alpha=0.5, label="Actual Sales (Target)")
axes[0].set_xlabel('Actual Sales')
axes[0].set_ylabel('Predicted Sales')
axes[0].legend()

axes[1].set_title("Test Data: Actual vs Predicted Sales")
axes[1].plot(test_data['Sales'], test_predictions, '.', label="Predicted Sales")
axes[1].plot(test_data['Sales'], test_data['Sales'], '-r', alpha=0.5, label="Actual Sales (Target)")
axes[1].set_xlabel('Actual Sales')
axes[1].set_ylabel('Predicted Sales')
axes[1].legend()

plt.tight_layout()
plt.show()
출력:
Model with TV, Radio, and Newspaper as predictors:
                            OLS Regression Results
==============================================================================
Dep. Variable:                  Sales   R-squared:                       0.894
Model:                            OLS   Adj. R-squared:                  0.891
Method:                 Least Squares   F-statistic:                     381.2
Date:                                   Prob (F-statistic):           5.60e-66
Time:                                   Log-Likelihood:                -273.89
No. Observations:                 140   AIC:                             555.8
Df Residuals:                     136   BIC:                             567.5
Df Model:                           3
Covariance Type:            nonrobust
==============================================================================
                 coef    std err          t      P>|t|      [0.025      0.975]
------------------------------------------------------------------------------
Intercept      3.0451      0.391      7.782      0.000       2.271       3.819
TV             0.0470      0.002     27.653      0.000       0.044       0.050
Radio          0.1797      0.011     16.665      0.000       0.158       0.201
Newspaper     -0.0030      0.007     -0.428      0.669      -0.017       0.011
==============================================================================
Omnibus:                       50.782   Durbin-Watson:                   2.089
Prob(Omnibus):                  0.000   Jarque-Bera (JB):              131.355
Skew:                          -1.459   Prob(JB):                     3.00e-29
Kurtosis:                       6.741   Cond. No.                         457.
==============================================================================

Notes:
[1] Standard Errors assume that the covariance matrix of the errors is correctly specified.
TV 와 라디오의 계수는 강하게 유의하지만(\(t = 27.7\), \(16.7\)) 신문은 \(t = -0.428\), \(p = 0.669\)로 유의하지 않다. 이제 그 까닭을 분해해 본다.
import pandas as pd
import statsmodels.formula.api as smf

url = 'https://raw.githubusercontent.com/justmarkham/scikit-learn-videos/8545c74961398def7724501648fd504dbf061b41/data/Advertising.csv'
data = pd.read_csv(url, usecols=[1, 2, 3, 4])
train_data = data.iloc[:140]

print("상관(훈련 140개):")
print(train_data.corr().round(4).to_string())
print()

full = smf.ols('Sales ~ TV + Radio + Newspaper', train_data).fit()
simple = smf.ols('Sales ~ Newspaper', train_data).fit()
aux_tv = smf.ols('TV ~ Newspaper', train_data).fit()
aux_radio = smf.ols('Radio ~ Newspaper', train_data).fit()

print(f"Sales ~ Newspaper 단순회귀 기울기 gamma = {simple.params['Newspaper']:.6f}"
      f"  (p = {simple.pvalues['Newspaper']:.4f},  R^2 = {simple.rsquared:.4f})")
print(f"다중회귀의 Newspaper 계수        beta = {full.params['Newspaper']:.6f}"
      f"  (p = {full.pvalues['Newspaper']:.4f})")
print()
print("누락변수 분해  gamma = beta_news + beta_TV*delta_TV + beta_Radio*delta_Radio")
print(f"  beta_news                      = {full.params['Newspaper']:+.6f}")
print(f"  beta_TV    * delta_TV          = {full.params['TV']:+.6f} * {aux_tv.params['Newspaper']:.6f}"
      f" = {full.params['TV'] * aux_tv.params['Newspaper']:+.6f}")
print(f"  beta_Radio * delta_Radio       = {full.params['Radio']:+.6f} * {aux_radio.params['Newspaper']:.6f}"
      f" = {full.params['Radio'] * aux_radio.params['Newspaper']:+.6f}")
total = (full.params['Newspaper'] + full.params['TV'] * aux_tv.params['Newspaper']
         + full.params['Radio'] * aux_radio.params['Newspaper'])
print(f"  합계                           = {total:+.6f}   (gamma = {simple.params['Newspaper']:+.6f})")
print()
reduced = smf.ols('Sales ~ TV + Radio', train_data).fit()
partial_f = ((reduced.ssr - full.ssr) / 1) / (full.ssr / full.df_resid)
print(f"RSS(TV+Radio) = {reduced.ssr:.4f},  RSS(+Newspaper) = {full.ssr:.4f}")
print(f"부분 F = {partial_f:.6f}")
print(f"t^2    = {full.tvalues['Newspaper'] ** 2:.6f}   (t = {full.tvalues['Newspaper']:.6f})")
출력:
상관(훈련 140개):
               TV   Radio  Newspaper   Sales
TV         1.0000  0.0604     0.0099  0.8047
Radio      0.0604  1.0000     0.3661  0.5437
Newspaper  0.0099  0.3661     1.0000  0.1784
Sales      0.8047  0.5437     0.1784  1.0000

Sales ~ Newspaper 단순회귀 기울기 gamma = 0.041658  (p = 0.0349,  R^2 = 0.0318)
다중회귀의 Newspaper 계수        beta = -0.003006  (p = 0.6690)

누락변수 분해  gamma = beta_news + beta_TV*delta_TV + beta_Radio*delta_Radio
  beta_news                      = -0.003006
  beta_TV    * delta_TV          = +0.047049 * 0.038078 = +0.001792
  beta_Radio * delta_Radio       = +0.179683 * 0.238598 = +0.042872
  합계                           = +0.041658   (gamma = +0.041658)

RSS(TV+Radio) = 410.6588,  RSS(+Newspaper) = 410.1052
부분 F = 0.183592
t^2    = 0.183592   (t = -0.428477)
(1) 분해가 소수 여섯째 자리까지 닫힌다. 단순회귀의 기울기 \(+0.041658\)이 세 항의 합
으로 정확히 재구성된다. 셋째 항이 전부다. 신문 자신의 몫은 음수이고 크기도 \(0.003\)에 지나지 않는데, 라디오를 거쳐 들어온 몫이 \(0.0429\)로 \(14\) 배 크다. 라디오가 신문과 \(r = 0.3661\)로 상관되어 있고(\(\hat\delta_{\text{Radio}} = 0.2386\)) 라디오의 효과가 \(0.1797\)로 크기 때문이다. TV 경유 몫이 작은 것도 설명된다. TV 와 신문의 상관이 \(0.0099\)로 거의 \(0\)이다.
그러므로 "신문 광고가 매출을 올린다"는 단순상관의 메시지는 라디오의 효과를 신문에 돌린 것이다. 본문이 든 수 \(0.23\)은 전체 \(200\)개 자료의 상관이고, 훈련자료 \(140\)개에서는 \(0.1784\)다. 어느 쪽이든 양수이며 단순회귀의 \(p = 0.0349\)는 \(0.05\) 아래라 혼자 보면 "유의하다"고 선언된다. 다중회귀가 그 선언을 뒤집는다.
부호가 음수로 뒤집힌 것은 의미를 둘 필요가 없다. \(-0.0030\)의 표준오차가 \(0.007\)이라 \(0\)과 구별되지 않고, \(t = -0.43\)이다. 부호는 표본변동이 결정한 것이다.
(2) 두 값이 완전히 같다. 부분 \(F\) 가 \(0.183592\), \(t^2\) 이 \(0.183592\)다. 분자가 \(\text{RSS}\) 의 감소 \(410.6588 - 410.1052 = 0.5536\) 이고 분모가 \(410.1052/136 = 3.0155\) 이니 \(F = 0.1836\) 이다. 단일 계수의 \(t\) 검정과 그 변수를 뺀 모형과의 비교가 같은 검정이라는 것이 이 등식이다. 그래서 "계수가 유의하지 않다"와 "그 변수를 빼도 적합이 거의 나빠지지 않는다"는 두 문장도 같은 말이다. \(\square\)
Sales ~ TV + Radio
보기 4. 신문을 뺀 모형. 보기 3에서 Newspaper만 빼고 다시 적합한다.
(1) 변수를 빼면 \(R^2\)는 반드시 줄어든다(또는 그대로다). 그런데 이 자료에서 수정 \(R^2\)는 \(0.891\)에서 \(0.892\)로 올랐다. 수정 \(R^2\)의 공식
에서 두 지표가 반대 방향으로 가는 까닭을 설명하고, \(\bar R^2\)가 \(1 - s^2/s_y^2\)와 같음을 보이시오.
(2) 변수 하나를 뺐을 때 \(\bar R^2\)가 오르는 조건이 \(\lvert t \rvert < 1\) 임이 알려져 있다. 세 설명변수를 각각 빼 보아 이 규칙이 맞는지 확인하시오. AIC 와 BIC 는 어느 쪽을 고르는가.
풀이
(1) 해석적으로. \(R^2 = 1 - \text{RSS}/\text{TSS}\)에서 \(\text{TSS}\)는 모형과 무관하고 \(\text{RSS}\)는 열을 뺄 때 결코 줄 수 없다. 더 작은 공간에서 최소화하기 때문이다. 그래서 \(R^2\)는 변수를 빼면 내려간다.
수정 \(R^2\)는 다른 것을 잰다. 공식을 정리하면
이다. 분모 \(s_y^2 = \text{TSS}/(n-1)\)은 모형과 무관하므로 \(\bar R^2\)가 오른다는 것과 \(s^2\) 이 내린다는 것은 같은 말이다. \(s^2 = \text{RSS}/(n-k-1)\)에서 변수를 빼면 분자는 커지지만 분모도 \(136\)에서 \(137\)로 커진다. 두 효과가 다투고, 분자가 커지는 양이 분모가 커지는 양보다 작으면 \(s^2\)이 내려간다. \(R^2\)는 적합의 정도를, \(\bar R^2\)는 오차분산의 추정값을 잰다. 재는 것이 다르니 방향이 달라도 모순이 아니다.
(2) 해석적으로. 변수 하나를 더할 때 \(\bar R^2\)가 오르는 조건을 따져 보자. \(s^2\)이 내려가야 하므로
이다. \(\text{RSS}_{\text{축소}} - \text{RSS}_{\text{완전}} = F \cdot s^2_{\text{완전}}\)이고 \(F = t^2\)(보기 3)이므로 \(\text{RSS}_{\text{축소}} = \text{RSS}_{\text{완전}}(1 + t^2/(n-k-1))\)이다. 이를 넣고 정리하면
이다. 곧 더해서 \(\bar R^2\)가 오르는 조건이 \(\lvert t \rvert > 1\) 이고, 빼서 오르는 조건이 \(\lvert t \rvert < 1\) 이다. 신문의 \(\lvert t \rvert = 0.4285 < 1\)이므로 빼면 올라야 한다.
\(\lvert t \rvert = 1\) 이라는 임계값이 유의수준 \(0.05\) 의 임계값 \(\lvert t \rvert \approx 1.98\) 보다 훨씬 낮다는 점을 눈여겨볼 만하다. 수정 \(R^2\) 는 유의성 검정보다 변수를 넣는 쪽에 관대하다. \(t = 1.5\) 인 변수는 유의하지 않지만 수정 \(R^2\) 를 올린다.
# 신문을 뺀 모형. R^2 가 거의 줄지 않는다. 신문 광고가 설명하는 몫이
# 사실상 없었다는 뜻이다.
model = sm.ols('Sales ~ TV + Radio', train_data).fit()
print("Model with TV and Radio as predictors:")
print_summary(model)
출력:
Model with TV and Radio as predictors:
                            OLS Regression Results
==============================================================================
Dep. Variable:                  Sales   R-squared:                       0.894
Model:                            OLS   Adj. R-squared:                  0.892
Method:                 Least Squares   F-statistic:                     575.1
Date:                                   Prob (F-statistic):           2.26e-67
Time:                                   Log-Likelihood:                -273.98
No. Observations:                 140   AIC:                             554.0
Df Residuals:                     137   BIC:                             562.8
Df Model:                           2
Covariance Type:            nonrobust
==============================================================================
                 coef    std err          t      P>|t|      [0.025      0.975]
------------------------------------------------------------------------------
Intercept      2.9881      0.367      8.145      0.000       2.263       3.714
TV             0.0471      0.002     27.744      0.000       0.044       0.050
Radio          0.1780      0.010     17.793      0.000       0.158       0.198
==============================================================================
Omnibus:                       49.324   Durbin-Watson:                   2.086
Prob(Omnibus):                  0.000   Jarque-Bera (JB):              122.228
Skew:                          -1.436   Prob(JB):                     2.87e-27
Kurtosis:                       6.564   Cond. No.                         424.
==============================================================================

Notes:
[1] Standard Errors assume that the covariance matrix of the errors is correctly specified.
두 모형의 지표를 나란히 놓고 (1)과 (2)를 확인한다.
import pandas as pd
import statsmodels.formula.api as smf

url = 'https://raw.githubusercontent.com/justmarkham/scikit-learn-videos/8545c74961398def7724501648fd504dbf061b41/data/Advertising.csv'
train_data = pd.read_csv(url, usecols=[1, 2, 3, 4]).iloc[:140]

full = smf.ols('Sales ~ TV + Radio + Newspaper', train_data).fit()
reduced = smf.ols('Sales ~ TV + Radio', train_data).fit()

n = len(train_data)
total_ss = ((train_data.Sales - train_data.Sales.mean()) ** 2).sum()
print(f"{'모형':16s}{'k':>3s}{'RSS':>11s}{'s^2':>10s}{'R^2':>11s}{'수정 R^2':>12s}{'공식값':>11s}{'AIC':>10s}{'BIC':>10s}")
for name, m, k in [("TV+Radio+News", full, 3), ("TV+Radio", reduced, 2)]:
    formula = 1 - (1 - m.rsquared) * (n - 1) / (n - k - 1)
    print(f"{name:16s}{k:3d}{m.ssr:11.4f}{m.mse_resid:10.6f}{m.rsquared:11.6f}"
          f"{m.rsquared_adj:12.6f}{formula:11.6f}{m.aic:10.4f}{m.bic:10.4f}")
print()
print(f"s_y^2 = TSS/(n-1) = {total_ss / (n - 1):.6f}")
print(f"1 - s^2/s_y^2:  완전 {1 - full.mse_resid / (total_ss / (n - 1)):.6f}, "
      f"축소 {1 - reduced.mse_resid / (total_ss / (n - 1)):.6f}")
print()
print("변수를 하나 뺐을 때 수정 R^2 가 오르는가  <=>  |t| < 1 인가")
for v in ['TV', 'Radio', 'Newspaper']:
    others = [x for x in ['TV', 'Radio', 'Newspaper'] if x != v]
    m = smf.ols('Sales ~ ' + ' + '.join(others), train_data).fit()
    print(f"  {v:10s} |t| = {abs(full.tvalues[v]):8.4f}   수정 R^2 "
          f"{full.rsquared_adj:.6f} -> {m.rsquared_adj:.6f}  "
          f"{'오름' if m.rsquared_adj > full.rsquared_adj else '내림'}")
출력:
모형                k        RSS       s^2        R^2      수정 R^2        공식값       AIC       BIC
TV+Radio+News     3   410.1052  3.015479   0.893710    0.891366   0.891366  555.7708  567.5373
TV+Radio          2   410.6588  2.997509   0.893567    0.892013   0.892013  553.9596  562.7845

s_y^2 = TSS/(n-1) = 27.758053
1 - s^2/s_y^2:  완전 0.891366, 축소 0.892013

변수를 하나 뺐을 때 수정 R^2 가 오르는가  <=>  |t| < 1 인가
  TV         |t| =  27.6535   수정 R^2 0.891366 -> 0.285777  내림
  Radio      |t| =  16.6646   수정 R^2 0.891366 -> 0.671950  내림
  Newspaper  |t| =   0.4285   수정 R^2 0.891366 -> 0.892013  오름
(1)의 세 수가 유도와 맞는다. \(\text{RSS}\) 는 \(410.1052\) 에서 \(410.6588\) 로 늘었고(그래서 \(R^2\) 가 \(0.893710 \to 0.893567\) 로 줄었고) \(s^2\) 은 \(3.015479\) 에서 \(2.997509\) 로 줄었다. 분자가 늘어난 비율은 \(0.135\%\) 인데 분모가 \(136 \to 137\) 로 늘어난 비율은 \(0.735\%\) 라 뒤쪽이 이긴다. 공식값 열이 statsmodels 의 rsquared_adj 와 소수 여섯째 자리까지 같고, \(1 - s^2/s_y^2\) 도 같은 두 수를 준다. \(s_y^2 = 27.758053\) 은 두 모형에서 공통이다.
(2)의 규칙도 세 변수 모두에서 맞는다. \(\lvert t \rvert\) 가 \(27.65\), \(16.66\) 인 TV 와 Radio 를 빼면 수정 \(R^2\) 가 \(0.286\), \(0.672\) 로 곤두박질치고, \(\lvert t \rvert = 0.4285 < 1\) 인 Newspaper 를 빼면 \(0.892013\) 으로 올라간다. TV 를 뺀 쪽의 추락이 특히 심한 것은 TV 가 매출과 \(r = 0.8047\) 로 가장 강하게 얽혀 있기 때문이다. 규칙이 가르는 기준은 \(\lvert t \rvert = 1\) 하나이고, 떨어지는 양은 그 \(\lvert t \rvert\) 가 얼마나 큰지가 정한다.
AIC 와 BIC 도 신문을 빼는 쪽을 고른다. AIC 가 \(555.77 \to 553.96\) 으로 \(1.81\), BIC 가 \(567.54 \to 562.78\) 로 \(4.75\) 내려간다. BIC 쪽이 더 많이 내려가는 것은 BIC 의 모수 벌점 \(\log n = \log 140 = 4.94\) 가 AIC 의 \(2\) 보다 크기 때문이다. 표본이 클수록 BIC 는 간결한 모형을 더 세게 선호한다. 네 지표(\(\bar R^2\), AIC, BIC, \(p\) 값)가 모두 같은 결론을 주는 것은 신문의 기여가 거의 없다는 사실이 분명하기 때문이고, 경계선에 걸린 변수에서는 지표마다 다른 답을 주는 일이 흔하다. \(\square\)
Sales ~ TV + Radio + TV:Radio
보기 5. 교호작용을 넣은 모형. Sales ~ TV + Radio + TV:Radio를 적합한다. 출력 끝에 조건수가 \(1.84 \times 10^4\)라는 다중공선성(multicollinearity) 경고가 붙는다.
(1) 곱항이 제 몫을 하는지 부분 \(F\) 로 판정하시오. 보기 4 의 모형을 축소모형으로 삼아 \(F\) 를 구하고, 그것이 곱항의 \(t^2\) 과 같음을 확인하시오.
(2) 조건수 경고가 붙었는데도 (1)의 결론을 믿어도 되는가. 경고가 말하는 것과 말하지 않는 것을 가르시오.
풀이
(1) 부분 \(F\) 는 항 하나가 줄인 \(\text{RSS}\) 를 잔차분산으로 잰 것이다. 보기 4 의 Sales ~ TV + Radio 를 축소모형, 이 보기의 모형을 완전모형이라 두면
이고, 자유도가 \(1\) 인 부분 \(F\) 는 그 항의 \(t^2\) 과 항등적으로 같다(13.4절 OLS 회귀 출력 재현이 그 등식을 유도한다). 아래 코드가 두 수를 나란히 찍어 확인한다.
(2) 경고는 "적합이 나쁘다"가 아니라 "좌표가 나쁘다"를 말한다. 조건수가 크다는 것은 설계행렬의 열들이 거의 평행하다는 뜻이고, 여기서는 \(\text{TV}\) 와 \(\text{TV}\cdot\text{Radio}\) 가 둘 다 \(\text{TV}\) 와 함께 커지기 때문이다. 그것이 흔드는 것은 개별 계수의 표준오차이지 적합값이나 \(\text{RSS}\) 가 아니다.
그러므로 (1)의 결론은 그대로 믿어도 된다. 부분 \(F\) 는 \(\text{RSS}\) 의 감소만 보고, \(\text{RSS}\) 는 열공간에만 의존하므로 좌표를 어떻게 잡든 같기 때문이다. 흔들리는 것은 "계수 하나를 따로 해석할 수 있는가"뿐이다.
그 흔들림을 없애는 방법이 중심화이고, 같은 적합을 좌표만 옮겨 읽으면 조건수가 내려간다는 것을 13.5절 교호작용 항 \(4\) 절이 유도와 함께 보인다. 공선성 자체의 진단은 13.7절 다중공선성과 분산팽창인자가 다룬다.
# 이번에는 교호작용을 넣는다. statsmodels 의 수식에서 콜론이 교호작용 항이다.
# R^2 가 눈에 띄게 오른다 — 두 매체가 서로를 돕는다는 뜻이다.
model = sm.ols('Sales ~ TV + Radio + TV:Radio', train_data).fit()
print("Model with TV, Radio, and TV:Radio as predictors:")
print_summary(model)
출력:
Model with TV, Radio, and TV:Radio as predictors:
                            OLS Regression Results
==============================================================================
Dep. Variable:                  Sales   R-squared:                       0.965
Model:                            OLS   Adj. R-squared:                  0.964
Method:                 Least Squares   F-statistic:                     1256.
Date:                                   Prob (F-statistic):           6.75e-99
Time:                                   Log-Likelihood:                -195.82
No. Observations:                 140   AIC:                             399.6
Df Residuals:                     136   BIC:                             411.4
Df Model:                           3
Covariance Type:            nonrobust
==============================================================================
                 coef    std err          t      P>|t|      [0.025      0.975]
------------------------------------------------------------------------------
Intercept      6.8814      0.314     21.911      0.000       6.260       7.503
TV             0.0183      0.002      9.275      0.000       0.014       0.022
Radio          0.0229      0.011      2.101      0.038       0.001       0.044
TV:Radio       0.0011   6.71e-05     16.716      0.000       0.001       0.001
==============================================================================
Omnibus:                       93.789   Durbin-Watson:                   2.227
Prob(Omnibus):                  0.000   Jarque-Bera (JB):              767.071
Skew:                          -2.266   Prob(JB):                    2.71e-167
Kurtosis:                      13.534   Cond. No.                     1.84e+04
==============================================================================

Notes:
[1] Standard Errors assume that the covariance matrix of the errors is correctly specified.
[2] The condition number is large, 1.84e+04. This might indicate that there are
strong multicollinearity or other numerical problems.
교호작용을 넣으면 \(R^2\) 가 보기 4의 \(0.894\) 에서 \(0.965\) 로 오른다. TV 와 라디오가 함께 쓰일 때의 상승효과다. 그 상승이 모수를 하나 더해서 저절로 오른 것인지 부분 \(F\) 로 가린다.
import pandas as pd
import statsmodels.formula.api as smf

url = 'https://raw.githubusercontent.com/justmarkham/scikit-learn-videos/8545c74961398def7724501648fd504dbf061b41/data/Advertising.csv'
train_data = pd.read_csv(url, usecols=[1, 2, 3, 4]).iloc[:140]

full = smf.ols('Sales ~ TV + Radio + TV:Radio', train_data).fit()
reduced = smf.ols('Sales ~ TV + Radio', train_data).fit()

partial_f = ((reduced.ssr - full.ssr) / 1) / (full.ssr / full.df_resid)
print(f"RSS  축소 {reduced.ssr:.6f}   완전 {full.ssr:.6f}")
print(f"R^2  축소 {reduced.rsquared:.6f}   완전 {full.rsquared:.6f}")
print(f"부분 F = {partial_f:.4f}")
print(f"t^2    = {full.tvalues['TV:Radio'] ** 2:.4f}")
print(f"p 값   = {full.pvalues['TV:Radio']:.3e}")
출력:
RSS  축소 410.658784   완전 134.444997
R^2  축소 0.893567   완전 0.965155
부분 F = 279.4085
t^2    = 279.4085
p 값   = 8.776e-35
곱항 하나가 \(\text{RSS}\) 를 \(410.66\) 에서 \(134.44\) 로 셋에 하나로 줄였다. 부분 \(F = 279.4085\) 가 \(t^2 = 279.4085\) 와 소수 넷째 자리까지 같아 유도한 등식이 확인되고, \(p = 8.8 \times 10^{-35}\) 다. 조건수 경고에도 불구하고 교호작용 항은 확실히 있어야 한다. 조건수는 계수를 따로따로 믿을 수 있는지를 말할 뿐이고, 항이 필요한지는 \(\text{RSS}\) 의 감소가 말한다.
뒤의 연습문제들이 쓰는 범위를 적어 둔다. 훈련자료에서 \(\text{TV}\) 는 \(0.7\) 부터 \(296.4\) 까지, \(\text{Radio}\) 는 \(0\) 부터 \(49.6\) 까지 퍼져 있다. 그래서 곱 열은 \(0\) 부터 \(12{,}254\) 까지 가고, 열들의 척도가 세 자릿수로 어긋난다 — 조건수가 큰 까닭이 이것이다.
여기까지가 이 절의 몫이다. 저 계수들을 읽는 일 — TV 계수 \(0.0183\) 이 어느 시장의 기울기인지, 왜 그 자리가 자료 바깥인지, 중심화하면 무엇이 바뀌고 무엇이 그대로인지 — 은 13.5절 교호작용 항이 맡는다. 거기서는 \(200\) 개 시장 전부에 적합하므로 계수가 이 쪽의 수와 다르다. 이 쪽은 앞 \(140\) 개만 훈련자료로 쓰고 있다. \(\square\)
5. 적합한 평면을 읽을 때
model.summary() 는 계수 말고도 표준오차·\(t\)·\(p\) 값·신뢰구간·정보기준·진단검정을 한꺼번에 찍는다. 그 칸들은 이 절의 것이 아니다 — 각각 13.3절 계수의 신뢰구간, 13.4절 OLS 회귀 출력 재현, 13.8절 결정계수와 수정 결정계수, 13.9절 AIC와 BIC, 13.6절 가정 점검 (LINE)이 다룬다. 특히 13.4 는 그 표의 한 줄을 손으로 다시 만들어 무엇을 계산한 결과인지 밑바닥까지 확인한다.
여기서는 계수 열 하나만 본다. 평면의 기울기를 읽는 일이기 때문이다.
계수의 크기는 중요도가 아니다
표에서 가장 먼저 눈에 들어오는 것은 coef 열이고, 그 열의 큰 수를 「중요한 변수」로 읽기 쉽다. 보기 \(3\) 의 세 계수는 TV \(0.0470\), Radio \(0.1797\), Newspaper \(-0.0030\) 이다. 그대로 읽으면 Radio 가 TV 보다 네 배 가까이 중요해 보인다.
그 읽기가 왜 틀렸는지는 단위를 보면 바로 드러난다. 계수는 단위가 있는 양이어서, 변수의 척도가 바뀌면 계수도 그만큼(역수 비율로) 바뀐다 — 광고비를 천 배 큰 단위로 적으면 값이 천분의 일이 되고 계수는 천 배가 된다. 세 변수를 같은 자리에 놓고 견주려면 각자가 \(1\) 표준편차만큼 움직일 때 Sales 가 얼마나 변하는지, 곧 \(\hat\beta_j \times \mathrm{SD}(x_j)\) 를 보아야 한다.
import pandas as pd
import statsmodels.formula.api as smf

url = ('https://raw.githubusercontent.com/justmarkham/scikit-learn-videos/'
       '8545c74961398def7724501648fd504dbf061b41/data/Advertising.csv')
train = pd.read_csv(url, usecols=[1, 2, 3, 4]).iloc[:140]
model = smf.ols('Sales ~ TV + Radio + Newspaper', train).fit()

# 한글은 고정폭에서 두 칸을 차지하므로 머리글은 공백을 직접 적는다
print("   변수        계수     표준편차   1 SD 효과        t")
for name in ['TV', 'Radio', 'Newspaper']:
    b, sd = model.params[name], train[name].std()
    print(f"{name:>10} {b:11.6f} {sd:10.2f} {b * sd:11.4f} {model.tvalues[name]:8.3f}")
출력:
   변수        계수     표준편차   1 SD 효과        t
        TV    0.047049      86.74      4.0809   27.653
     Radio    0.179683      14.71      2.6426   16.665
 Newspaper   -0.003006      22.57     -0.0678   -0.428
순위가 뒤집힌다. 날것의 계수로는 Radio 가 컸지만, \(1\) 표준편차로 재면 TV 가 \(4.08\) 로 Radio 의 \(2.64\) 보다 크다. 까닭은 표준편차 열에 있다 — TV 는 \(86.74\) 만큼 움직이는 변수이고 Radio 는 \(14.71\) 만큼 움직인다. 같은 크기의 영향을 주더라도 넓게 움직이는 변수는 계수가 작게 나올 수밖에 없다.
\(t\) 열이 이 재척도화와 무관하다는 점도 함께 보아 두자. \(t_j = \hat\beta_j / \mathrm{SE}(\hat\beta_j)\) 인데 단위를 바꾸면 분자와 분모가 같은 비율로 변하므로 비는 그대로다. 실제로 \(t\) 의 순위(\(27.65 > 16.67 > -0.43\))가 \(1\) 표준편차 효과의 순위와 일치한다. 그러므로 회귀표를 읽는 규칙은 이렇게 적힌다.
표를 읽는 두 자
유의성은 \(t\) 와 \(p\) 로 읽고, 중요도는 표준편차당 효과로 읽는다. 계수 자체의 크기는 둘 중 어느 쪽도 말해 주지 않는다.
단위 차이가 더 벌어지면 이 착시도 더 커진다. 연습문제 \(18\) 이 계수가 \(10\) 억 배 차이 나는 자료를 다룬다.
6. 세 평면을 나란히 놓으면
위의 셋은 같은 자료에 다른 면을 맞춘 것이다 — 설명변수 셋짜리 평면, 둘짜리 평면, 그리고 곱항으로 뒤틀린 면. 셋 가운데 어느 것을 고를지는 \(R^2\) · AIC · BIC 같은 수로 재는데, 그 수들이 무엇을 저울질하는지가 이 절의 주제가 아니다. 세 모형을 나란히 비교한 표와 그 읽기는 13.9절 모형선택 비교에 있다.
이 절이 보인 것은 그 앞의 일이다 — 같은 자료에 다른 면을 맞추면 계수가 달라진다는 것, 그리고 그 달라짐이 설명변수끼리 얽혀 있기 때문이라는 것.
연습문제
이 절의 연습문제에 대하여
연습문제 \(1\)–\(10\) 은 위 보기들의 Advertising 자료를 그대로 쓰며 난도순이다. \(11\)–\(15\) 와 \(16\)–\(24\) 는 각각 한 자료를 끝까지 따라가는 사슬이다 — 앞쪽은 설명변수 둘인 인공자료로 회귀평면을 세우고, 뒤쪽은 주 단위 인공자료로 단변량에서 다변량까지 간다. 사슬 안에서는 난도가 오르지만 사슬끼리는 난도순이 아니다. 자료를 만드는 첫 문제(\(11\), \(16\))부터 차례로 푸는 것이 좋다.
연습문제 1. 다중회귀 \(Y = \beta_0 + \beta_1 X_1 + \beta_2 X_2 + \varepsilon\)에서 \(\beta_1\)을 정확히 해석하라. 이 해석은 \(Y\)를 \(X_1\)에만 회귀시킨 단순회귀의 기울기와 어떻게 다른가?
풀이
다중회귀에서 \(\beta_1\)은 \(X_2\)를 고정한 채로(다른 조건이 같을 때) \(X_1\)이 한 단위 늘어날 때 기대되는 \(Y\)의 변화이다. 이는 부분효과, 곧 조건부 효과이다.
\(Y\)를 \(X_1\)에 회귀시킨 단순회귀에서 기울기는 주변(무조건) 효과를 포착하며, 여기에는 \(X_1\)의 직접 효과와 (\(X_1\)과 \(X_2\)가 상관되어 있다면) \(X_2\)를 거치는 간접 효과가 모두 들어 있다. \(X_1\)과 \(X_2\)가 상관되어 있으면 단순회귀의 기울기는 누락변수 편향 때문에 부분효과에 대해 편향된 추정이 된다.
연습문제 2. 설명변수가 \(p = 5\)개인 다중회귀에서 \(R^2 = 0.85\), 수정 \(R^2 = 0.82\)이다. 여섯 번째 설명변수를 넣으면 \(R^2\)가 \(0.853\)으로 오르지만 수정 \(R^2\)는 \(0.818\)로 떨어진다. 여섯 번째 설명변수를 포함해야 하는가? 설명하라.
풀이
포함하지 않아야 한다. \(R^2\)가 0.850에서 0.853으로 오른 것은 미미하고(0.3%p), 수정 \(R^2\)가 0.820에서 0.818로 떨어졌다는 것은 새 설명변수가 늘어난 복잡도를 정당화할 만큼 모형을 개선하지 못했다는 뜻이다.
수정 \(R^2\)는 설명변수가 추가되는 데 벌점을 준다: \(\bar{R}^2 = 1 - (1-R^2)(n-1)/(n-p-1)\). 값이 떨어졌다는 것은 모수 하나를 더 쓴 벌점이 설명분산의 증가분보다 크다는 뜻이다. 새 설명변수는 의미 있는 예측력을 보태지 못하고 있다.
연습문제 3. 누락변수 편향의 개념을 설명하라. 참 모형이 \(Y = \beta_0 + \beta_1 X_1 + \beta_2 X_2 + \varepsilon\)인데 \(Y = \gamma_0 + \gamma_1 X_1 + u\)를 적합했다면, \(\gamma_1\)과 \(\beta_1\)의 관계를 유도하라.
풀이
\(X_2\)를 \(X_1\)에 회귀시킨 계수를 \(\delta_1\)이라 하자: \(X_2 = \delta_0 + \delta_1 X_1 + v\). 그러면 누락변수 편향 공식에서
여기서 \(\text{plim}\) 은 확률극한, 곧 표본이 커질 때 추정량이 확률수렴하는 값이다. 편향은 \(\beta_2 \delta_1\)이며, 다음 두 조건이 모두 성립할 때에만 0이 아니다. (1) \(X_2\)가 \(Y\)에 영향을 준다(\(\beta_2 \neq 0\)). (2) \(X_2\)가 \(X_1\)과 상관되어 있다(\(\delta_1 \neq 0\)).
편향의 부호는 곱 \(\beta_2 \delta_1\)의 부호로 정해진다. 예를 들어 교육(\(X_2\))이 소득에 양의 영향을 주고(\(\beta_2 > 0\)) 경력과 양의 상관을 가진다면(\(\delta_1 > 0\)), 교육을 빠뜨렸을 때 \(\hat{\gamma}_1\)은 경력의 참 효과를 과대추정한다.
연습문제 4. 보기 5 의 훈련자료 \(140\) 개에서 TV 와 Radio 를 각자의 평균 \(a = 143.7750\), \(b = 24.6864\) 로 중심화해 같은 모형을 적합하면 절편이 \(14.062044\) 가 된다. 중심화가 적합을 바꾸지 않고 좌표만 옮긴다는 것은 13.5절 교호작용 항 \(4\) 절이 유도한다. 여기서는 그 절이 다루지 않는 절편을 따진다.
(1) 중심화하지 않은 계수 \(\hat\beta_0 = 6.881435\), \(\hat\beta_1 = 0.018326\), \(\hat\beta_2 = 0.022921\), \(\hat\beta_3 = 0.001121\) 로 점 \((\text{TV}, \text{Radio}) = (a, b)\) 에서의 예측값을 계산하시오. \(14.062044\) 와 셋째 소수에서 어긋나는데, 그 불일치가 어디서 오는지 밝히시오.
(2) 설명변수를 모두 중심화한 회귀의 절편은 \(\bar y\) 와 같다고 알려져 있다. 그런데 훈련자료의 \(\overline{\text{Sales}} = 14.147857\) 이어서 \(14.062044\) 와 \(0.085814\) 만큼 다르다. 이 모형에서 그 규칙이 깨지는 까닭을 말하고, 불일치를 \(\hat\beta_3\) 과 한 수의 곱으로 적으시오. 그 수를 구하고 부호가 보기 3 의 상관표와 맞는지 확인하시오.
풀이
(1) 네 항을 차례로 더한다.
이므로 합이 \(6.881435 + 2.634821 + 0.565837 + 3.978747 = 14.060840\) 이다. 참값 \(14.062044\) 보다 \(0.0012\) 작다.
불일치는 \(\hat\beta_3\) 의 반올림에서 온다. 출력표의 \(0.001121\) 은 네 자리로 끊은 수이고 참값은 \(0.00112135\) 다. 차이가 \(3.5 \times 10^{-7}\) 에 지나지 않지만, 여기에 곱해지는 \(ab = 3549.29\) 가 커서
가 된다. 실제로 \(0.00112135 \times 3549.28716 = 3.979994\) 를 쓰면 합이 \(14.062087\) 로 참값과 넷째 소수까지 맞는다.
이것이 보기 5 가 말한 조건수 문제의 실물이다. 곱 열의 척도가 세 자릿수로 크면 그 계수의 반올림 오차도 세 자릿수로 증폭된다. 교호작용 계수를 보고할 때 유효숫자를 넉넉히 적어야 하는 이유다.
(2) 중심화한 모형의 설계행렬 열은 \(\mathbf 1\), \(\text{TV} - a\), \(\text{Radio} - b\), \((\text{TV}-a)(\text{Radio}-b)\) 다. 절편의 정규방정식(normal equations)은 "잔차의 합이 \(0\)", 곧
이다. 가운데 두 평균은 중심화했으므로 \(0\) 이지만 곱 열의 평균은 \(0\) 이 아니다. 두 변수를 각각 중심으로 옮기는 일이 그 곱을 중심으로 옮겨 주지는 않는다. 그러므로
이고, 불일치 \(0.085814\) 가 바로 둘째 항이다. 거꾸로 풀면
이다. 이 수는 TV 와 Radio 의 표본공분산(\(n\) 으로 나눈 꼴)이고 양수인데, 보기 3 의 상관표가 준 \(\operatorname{corr}(\text{TV}, \text{Radio}) = 0.0604 > 0\) 과 부호가 맞는다.
해석하면 이렇다. \(\hat\beta_3 > 0\) 이고 두 매체가 함께 집행되는 경향이 조금이라도 있으면 곱 열의 평균이 양수가 되어 평균 자리의 예측값이 \(\bar y\) 보다 아래로 내려간다. 다만 상관이 \(0.0604\) 로 작아 불일치도 \(0.0858\) 로 작다. 두 매체가 강하게 함께 움직이는 자료라면 이 간격이 훨씬 벌어진다.
연습문제 5. 보기 5 의 적합식
을 그대로 믿는다(\(T\) 는 TV 광고비, \(R\) 은 Radio 광고비). 두 매체에 쓸 예산의 합을 \(T + R = 100\) 으로 묶는다.
(1) \(\hat y\) 를 최대로 하는 \((T, R)\) 과 그때의 \(\hat y\) 를 구하시오. 한쪽에 다 쓴 두 경우 \((100, 0)\) 과 \((0, 100)\) 의 \(\hat y\) 와 견주시오.
(2) 합을 \(S\) 로 두면 최적해가 \(T^{\star} = \tfrac12\bigl(S + (\hat\beta_1 - \hat\beta_2)/\hat\beta_3\bigr)\) 임을 보이고, \(T^{\star} - R^{\star}\) 이 \(S\) 와 무관함을 확인하시오. \(\hat\beta_3 \to 0^+\) 으로 보내면 최적해는 어디로 가는가.
(3) 이 계산을 실제 광고 계획으로 쓸 때 조심할 점을 하나 적으시오. 보기 5 풀이에 적힌 두 변수의 범위를 쓰시오.
풀이
(1) \(R = 100 - T\) 를 넣어 \(T\) 하나의 함수로 만든다.
상수항은 \(6.881435 + 2.292100 = 9.173535\) 이고, \(T\) 의 계수는 \(0.018326 - 0.022921 + 0.001121 \times 100 = 0.107505\), \(T^2\) 의 계수는 \(-0.001121\) 이다. 곧
이다. \(T^2\) 의 계수가 음수이므로 위로 오목하고 내부에 최대가 있다.
두 끝점은
이다. 나누어 쓰는 것이 어느 한쪽에 다 쓰는 것보다 낫다. 더 나은 끝점(\(R\) 에 다 쓰기, \(9.1735\))보다도 \(11.7510\) 이 \(28\%\) 높다. 이것이 보기 5 가 말한 상승효과를 숫자 하나로 본 것이다. 교호작용 항이 없으면 \(\hat y\) 가 \(T\) 의 일차식이 되어 최대는 반드시 끝점에서 나오고, 나누어 쓸 이유가 사라진다.
(2) 일반 \(S\) 에 대해 \(R = S - T\) 를 넣으면
이다. 미분해 \(0\) 으로 두면
이고 따라서
이다. 예산이 얼마든 Radio 가 TV 보다 약 \(4.1\) 만큼 더 받는다. 예산이 커지면 두 몫의 비는 \(1\) 에 가까워지고(\(S = 100\) 에서 \(47.95\) 대 \(52.05\)), 차이는 \(4.1\) 로 고정된다. 교호작용 항이 두 변수에 대칭이므로 비대칭을 만드는 것은 주효과의 차 \(\hat\beta_1 - \hat\beta_2\) 하나뿐이고, 그것을 \(\hat\beta_3\) 으로 환산한 양이 바로 이 \(4.1\) 이다.
\(\hat\beta_3 \to 0^+\) 이면 \((\hat\beta_1 - \hat\beta_2)/\hat\beta_3 \to -\infty\) 이므로 \(T^{\star} \to -\infty\) 이고, 제약 \(0 \le T \le S\) 안에서는 내부 최대가 사라져 끝점 \(T = 0\) 으로 몰린다. 교호작용이 없으면 목적함수가 \(T\) 의 일차식이고 기울기 \(\hat\beta_1 - \hat\beta_2 < 0\) 이므로 전부 Radio 에 쓰는 것이 답이기 때문이다. 극단으로 보낸 결과가 교호작용 없는 모형의 답과 이어진다.
(3) \((47.95, 52.05)\) 는 자료 밖의 점이다. 보기 5 풀이가 적어 둔 대로 훈련자료에서 TV 는 \(0.7\) 부터 \(296.4\) 까지, Radio 는 \(0\) 부터 \(49.6\) 까지 퍼져 있다. \(R = 52.05\) 는 Radio 의 최댓값을 넘고, 그런 시장은 자료에 하나도 없다. 최적해라고 계산한 점에서 모형은 외삽을 하고 있다.
덧붙일 경고가 둘 더 있다. 첫째, (2)의 답을 정하는 \(\hat\beta_1 - \hat\beta_2\) 는 둘 다 "상대가 \(0\) 일 때의 기울기" 이고, 보기 5 에서 Radio 의 원래 \(t\) 가 \(2.101\) 에 지나지 않았듯 자료가 약하게 뒷받침하는 수다. 중심화하면 같은 적합에서 \(0.046008\) 과 \(0.184143\) 이 나오는데, 이 쌍으로 같은 계산을 하면 답이 완전히 달라진다. 둘째, 회귀는 관측된 연관을 적은 것이고 광고비를 실제로 옮겼을 때 매출이 그만큼 따라온다는 인과를 보장하지 않는다.
연습문제 6. 보기 3 은 누락변수 분해
가 "근사가 아니라 표본에서 항등식으로 성립한다" 고 했다.
(1) 이것을 증명하시오. 완전모형 잔차의 어느 성질이 결정적인지 밝히고, 증명에서 그 성질이 쓰이는 자리를 짚으시오. 연습문제 3 의 \(\operatorname{plim}\) 식과 무엇이 다른가.
(2) 보조회귀의 방향이 x_j ~ Newspaper 여야 하고 Newspaper ~ x_j 로 뒤집으면 안 되는 까닭을 (1)의 증명에서 읽으시오. 뒤집은 기울기가 원래 기울기의 몇 배인지 식으로 적고, TV 에 대해 수치로 구하시오.
(3) \(\hat\delta_j = r_{j,\text{news}} \cdot s_j / s_{\text{news}}\) 를 써서, 보기 3 이 준 \(\hat\delta_{\text{TV}} = 0.038078\), \(\hat\delta_{\text{Radio}} = 0.238598\) 과 상관표의 \(0.0099\), \(0.3661\) 로부터 \(s_{\text{TV}}/s_{\text{Radio}}\) 를 구하시오. 보기 5 풀이에 적힌 두 변수의 범위와 견주어 그럴듯한지 판정하시오.
풀이
(1) 훈련자료 \(140\) 개에 대해 중심화한 교차곱합을 \(S_{uv} = \sum_i (u_i - \bar u)(v_i - \bar v)\) 라 쓰자. 설명변수를 \(x_1 = \text{TV}\), \(x_2 = \text{Radio}\), \(x_3 = \text{Newspaper}\) 라 두면 완전모형의 적합은
이다. 여기서 결정적인 것은 정규방정식 \(X^\top \mathbf e = \mathbf 0\), 곧
이다. 앞의 것과 뒤의 것을 합치면 \(S_{e, x_j} = 0\) 이다.
위 식의 양변에서 평균을 빼고 \((x_{i3} - \bar x_3)\) 을 곱해 더하면 절편이 사라지고
이 된다. 여기서 \(S_{e, x_3} = 0\) 을 쓴다. 양변을 \(S_{x_3, x_3}\) 로 나누면
인데 좌변은 단순회귀 Sales ~ Newspaper 의 기울기 \(\hat\gamma_{\text{news}}\) 의 정의이고, 우변의 두 비는 각각 보조회귀 TV ~ Newspaper, Radio ~ Newspaper 의 기울기 \(\hat\delta_{\text{TV}}\), \(\hat\delta_{\text{Radio}}\) 의 정의다. 이것이 구하려던 식이다. \(\square\)
쓰인 것은 최소제곱의 대수뿐이다. 확률모형도, \(n \to \infty\) 도, 오차의 가정도 쓰지 않았다. 그래서 한 표본 안에서 글자 그대로 성립하는 등식이고, 보기 3 의 출력이 소수 여섯째 자리까지 닫힌 것이 우연이 아니다. 반면 연습문제 3 의 \(\operatorname{plim}(\hat\gamma_1) = \beta_1 + \beta_2\delta_1\) 은 참 모수 사이의 관계이고 표본이 커질 때의 극한으로만 성립한다. 같은 모양의 식이지만 하나는 추정값들의 항등식, 하나는 모수들의 극한 관계다.
\(x_3\) 가 완전모형에 들어 있어야 \(S_{e, x_3} = 0\) 이 성립한다는 점도 짚어 둘 만하다. 신문을 뺀 모형의 잔차는 신문과 직교하지 않으므로, 그 잔차로는 같은 항등식을 세울 수 없다.
(2) 증명에서 양변을 나눈 것이 \(S_{x_3, x_3}\), 곧 누락된 변수 자신의 제곱합이었다. 그래서 분모가 \(S_{x_3,x_3}\) 인 비, 곧 \(x_j\) 를 \(x_3\) 에 회귀시킨 기울기만 등식에 들어온다. 뒤집은 Newspaper ~ x_j 의 기울기는 분모가 \(S_{x_j, x_j}\) 이므로
이다. 곧 뒤집으면 두 변수의 분산비만큼 틀어진다. 같은 말로 뒤집은 기울기는 \(r_{j,\text{news}}^2/\hat\delta_j\) 다. TV 에 대해서는
로 \(\hat\delta_{\text{TV}} = 0.038078\) 의 약 \(1/14.8\) 이다. 두 보조회귀를 모두 뒤집어 분해를 다시 쓰면 합이 \(-0.003006 + 0.047049 \times 0.002574 + 0.179683 \times 0.561758 = 0.0981\) 이 되어 \(\hat\gamma_{\text{news}} = 0.041658\) 과 두 배 이상 어긋난다. 방향을 뒤집으면 등식이 아니라 그냥 틀린 수가 된다.
(3) 두 식을 각각 풀면
이고 나누면
이다. 한편 보기 5 풀이가 적어 둔 범위는 TV 가 \(0.7\) 부터 \(296.4\), Radio 가 \(0\) 부터 \(49.6\) 이므로 범위의 비가
다. 두 수가 \(1\%\) 안에서 맞는다. 그럴듯하다고 판정할 수 있다.
한 걸음 더 읽으면 이렇다. 범위비와 표준편차비가 이렇게 가까운 것은 두 변수가 비슷한 모양으로 퍼져 있다는 뜻이다. 구간 위의 균등분포라면 표준편차가 범위\(/\sqrt{12}\) 이므로 두 변수 모두 같은 상수를 타고, 그래서 비가 같아진다. 실제로 \(295.7/\sqrt{12} = 85.4\), \(49.6/\sqrt{12} = 14.3\) 으로 두 변수의 표준편차 짐작값이 나온다. 광고비 자료가 설계된 실험처럼 고르게 흩어져 있다는 뜻이고, 이것은 설계행렬의 조건수를 좋게 하는 쪽으로 작용한다. 보기 5 의 큰 조건수가 자료가 뭉쳐 있기 때문이 아니라 곱 열을 넣은 좌표 선택 때문이라는 진단과 들어맞는다.
연습문제 7. 보기 4 는 변수 하나를 뺄 때 수정 \(R^2\) 가 오르는 조건이 \(\lvert t \rvert < 1\) 임을 유도했다.
(1) 변수 \(q\) 개를 동시에 뺄 때 조건이 부분 \(F < 1\) 임을 보이시오. \(q = 1\) 에서 \(F = t^2\) 이므로 보기 4 의 규칙이 특수한 경우임을 확인하시오.
(2) 보기 3 과 보기 4 의 수치로 \(q = 1\) 을 확인하고, 보기 4 에 교호작용을 더하는 쪽도 확인하시오.
(3) 보기 3 에서 세 설명변수를 모두 빼면 절편만 남는다. 이때 규칙은 무엇을 말하는가. summary() 출력의 어느 수가 그때의 \(F\) 인가.
(4) 임계값 \(F = 1\) 을 유의수준 \(0.05\) 의 임계값과 견주시오. 자유도 \(136\) 에서 \(F_{0.95}\) 가 \(q = 1\) 일 때 \(3.91\), \(q = 3\) 일 때 \(2.67\) 이다.
풀이
(1) 완전모형의 잔차자유도를 \(d\) 라 하자(보기 3 에서는 \(d = 136\)). 축소모형은 모수가 \(q\) 개 적으므로 자유도가 \(d + q\) 다. 부분 \(F\) 의 정의
를 \(\text{RSS}_{\text{축소}}\) 에 대해 풀면
이다. 보기 4 에서 본 \(\bar R^2 = 1 - s^2/s_y^2\) 에서 \(s_y^2\) 은 모형과 무관하므로 "\(\bar R^2\) 가 오른다" 와 "\(s^2\) 이 내린다" 가 같은 말이다. 그러므로 조건은
이고, 양변에 \(d(d+q) > 0\) 을 곱하면
이다. \(\square\) \(q\) 가 식에서 깨끗이 사라진다. 몇 개를 빼는지는 임계값을 바꾸지 않고, 임계값은 언제나 \(F = 1\) 이다. \(q = 1\) 이면 보기 3 이 보인 대로 \(F = t^2\) 이므로 조건이 \(t^2 < 1\), 곧 \(\lvert t \rvert < 1\) 이 되어 보기 4 의 규칙이 그대로 나온다.
(2) \(q = 1\), 신문을 빼는 경우. 보기 3 이 \(F = 0.183592 < 1\) 을 주었으므로 빼는 쪽이 올라야 하고, 실제로 수정 \(R^2\) 가 \(0.891366 \to 0.892013\) 으로 올랐다.
반대 방향도 맞는다. 보기 4 의 모형에 교호작용을 더하는 경우, 보기 5 가 \(F = 279.4085\) 를 주었다. \(F > 1\) 이므로 더하는 쪽이 올라야 하고, 실제로 \(0.892013 \to 0.964386\)(출력의 \(0.964\))으로 올랐다. 규칙은 넣는 쪽과 빼는 쪽에서 서로 뒤집힌 꼴로 같은 임계값을 쓴다.
(3) 절편만 남는 모형은 \(\text{RSS} = \text{TSS}\), 자유도 \(n - 1\) 이므로 \(s^2 = \text{TSS}/(n-1) = s_y^2\) 이고 \(\bar R^2 = 0\) 이다. 규칙은 "세 변수를 모두 버리는 쪽이 나으려면 \(F < 1\) 이어야 한다" 를 말한다.
그때의 \(F\) 는 summary() 의 F-statistic 인 \(381.2\) 다. 모형 전체의 \(F\) 검정이 바로 "모든 기울기가 \(0\) 인 모형과의 비교" 이기 때문이다. \(381.2 \gg 1\) 이므로 버릴 수 없고, 실제로 \(\bar R^2\) 가 \(0.891366 \to 0\) 으로 떨어진다. 보기 4 가 변수를 하나씩 빼 본 표에서 \(\lvert t \rvert\) 가 큰 TV 를 뺐을 때 \(0.2858\) 로 곤두박질친 것의 극단이 이것이다.
(4) \(q = 1\) 에서 \(F\) 의 임계값 \(1\) 은 \(\lvert t \rvert = 1\) 에 해당하고, 유의성의 임계값은 \(F_{0.95} = 3.91\), 곧 \(\lvert t \rvert = 1.98\) 이다. \(q = 3\) 에서도 \(1\) 과 \(2.67\) 로 벌어져 있다. 그러므로 수정 \(R^2\) 는 검정보다 변수를 넣는 쪽에 훨씬 관대하다. \(1 < F < 3.91\) 인 변수, 곧 \(1 < \lvert t \rvert < 1.98\) 인 변수는 유의하지 않다고 판정되지만 수정 \(R^2\) 를 올린다. 두 기준이 서로 다른 질문에 답하기 때문이다. 검정은 "이 계수가 \(0\) 이라는 가설을 자료가 반박하는가" 를 묻고, 수정 \(R^2\) 는 "오차분산 추정값이 내려가는가" 를 묻는다.
\(q\) 가 커지면 \(F_{0.95}\) 가 \(3.91 \to 2.67\) 처럼 \(1\) 쪽으로 내려오므로 두 기준의 간격이 좁아진다. 변수를 여럿 묶어 버릴지 판단할 때는 두 기준이 같은 답을 줄 가능성이 커진다는 뜻이다.
연습문제 8. 자크–베라 통계량은 잔차의 왜도 \(S\) 와 첨도(kurtosis) \(K\) 로
이다. 보기 3·4·5 의 진단 블록이 각각 \((S, K) = (-1.459,\, 6.741)\), \((-1.436,\, 6.564)\), \((-2.266,\, 13.534)\) 이고 \(n = 140\) 이다.
(1) 세 \(JB\) 를 계산해 출력의 \(131.355\), \(122.228\), \(767.071\) 과 맞는지 확인하시오.
(2) 각 모형에서 \(JB\) 의 몇 퍼센트가 왜도에서 오고 몇 퍼센트가 첨도에서 오는지 구하시오.
(3) 교호작용 모형은 \(R^2\) 가 가장 높은데(\(0.965\)) 정규성(normality) 이탈이 가장 심하다(\(JB\) 가 여섯 배). 모순인가. 보기 4 와 보기 5 의 \(\text{RSS}\) 가 \(410.6588\)(\(d = 137\))과 \(134.4450\)(\(d = 136\))이고 두 모형에서 가장 큰 잔차의 크기가 각각 \(8.47\) 과 \(6.23\) 이라는 사실을 쓰시오.
(4) 이 이탈은 보기 5 의 결론 가운데 어느 것을 흔들고 어느 것은 흔들지 않는가.
풀이
(1) \(n/6 = 140/6 = 23.3333\) 이다. 두 몫을 따로 적는다.
보기 3: \(S^2 = (-1.459)^2 = 2.1287\), \((K-3)^2/4 = (3.741)^2/4 = 13.9951/4 = 3.4988\). 합 \(5.6275\) 에 \(23.3333\) 을 곱하면 \(131.31\) 이다(출력 \(131.355\)).
보기 4: \(S^2 = 2.0621\), \((K-3)^2/4 = (3.564)^2/4 = 3.1755\). 합 \(5.2376\), 곱하면 \(122.21\)(출력 \(122.228\)).
보기 5: \(S^2 = (-2.266)^2 = 5.1348\), \((K-3)^2/4 = (10.534)^2/4 = 110.965/4 = 27.7413\). 합 \(32.8760\), 곱하면 \(767.11\)(출력 \(767.071\)).
세 값이 모두 출력과 유효숫자 세 자리까지 맞는다. 남는 불일치는 표에 적힌 \(S\) 와 \(K\) 가 세 자리로 반올림된 수라서 생긴 것이다.
(2) 합에 대한 몫을 백분율로 적는다.
- 보기 3: 왜도 \(2.1287/5.6275 = 37.8\%\), 첨도 \(62.2\%\)
- 보기 4: 왜도 \(2.0621/5.2376 = 39.4\%\), 첨도 \(60.6\%\)
- 보기 5: 왜도 \(5.1348/32.8760 = 15.6\%\), 첨도 \(84.4\%\)
앞의 두 모형은 왜도와 첨도가 비슷하게 나누어 가지지만 교호작용 모형은 거의 전부가 첨도다. \(JB\) 가 \(122\) 에서 \(767\) 로 여섯 배가 된 것은 분포가 더 기울어졌기 때문이 아니라 꼬리가 두꺼워졌기 때문이다. 왜도 몫은 \(2.06\) 에서 \(5.13\) 으로 두 배 반 늘었을 뿐인데 첨도 몫은 \(3.18\) 에서 \(27.74\) 로 아홉 배 늘었다.
(3) 모순이 아니다. \(R^2\) 는 잔차의 크기를 재고 \(JB\) 는 잔차의 모양을 잰다. 모양은 잔차를 자기 표준편차로 나눈 뒤에 보는 것이므로, 전체가 작아지는 일과 모양이 일그러지는 일이 같은 방향으로 갈 이유가 없다.
수로 보자. 잔차의 척도는
로 \(42.6\%\) 줄었다. 그런데 가장 안 맞는 시장의 잔차는 \(8.47\) 에서 \(6.23\) 으로 \(26.4\%\) 밖에 줄지 않았다. 척도가 더 많이 줄었으니 표준화한 잔차는 오히려 커진다.
첨도는 표준화한 잔차의 네제곱 평균이고 \(6.27^4 = 1545\) 가 \(4.89^4 = 572\) 의 \(2.7\) 배이므로, 이 한 점이 \(K\) 를 \(6.56\) 에서 \(13.53\) 으로 밀어 올리는 데 크게 기여한다. 모형을 잘 맞추면 끝내 안 맞는 점이 더 두드러진다. 교호작용 항은 잘 맞는 대다수를 더 잘 맞히지만 그 한 시장은 설명하지 못하고, 그 결과 상대적으로 더 큰 이상치(outlier)이 된다.
(4) 흔들지 않는 것부터. 계수가 선형불편추정량 가운데 분산이 가장 작다는 가우스–마르코프 결론은 정규성을 쓰지 않는다. 적합값, \(\text{RSS}\), \(R^2\), 수정 \(R^2\) 도 정규성과 무관한 대수적 양이다. 보기 5 의 중심화 논의 전체, 곧 "열공간이 같으니 적합값과 \(R^2\) 가 같다", "주효과만 좌표에 따라 바뀐다", "조건수는 좌표의 성질이다" 는 모두 사영의 기하이므로 그대로 성립한다. 교호작용 항이 필요하다는 판정도 \(\text{RSS}\) 가 \(410.66\) 에서 \(134.44\) 로 준 사실 자체에 기대므로 안전하다.
흔드는 것은 분포에 기댄 수들이다. \(t\) 통계량의 정확한 분포, 그래서 \(p\) 값과 신뢰구간의 정확한 포함확률, 그리고 가능도로 정의된 AIC·BIC 와 \(JB\) 자신까지다. \(n = 140\) 이라 중심극한정리(central limit theorem)가 \(t = 16.7155\) 가 유의하다는 판정은 지켜 주지만, 보기 5 가 적은 \(p = 8.8 \times 10^{-35}\) 같은 극단적인 수를 글자 그대로 믿을 근거는 없다. 꼬리가 두꺼운 잔차에서 꼬리확률의 추정은 가장 먼저 무너지는 양이기 때문이다.
연습문제 9. 보기 2 는 Radio 계수의 두 추정값 차이 \(0.024434\) 를 표준오차 \(0.010912\) 로 나눈 \(2.239\) 를 "\(t\) 통계량이 아니라 눈금자" 라고 했다. 두 훈련표본이 겹치기 때문이다. 눈금자를 고쳐 보자.
(1) 전체 \(200\) 개에서 무작위로 뽑은 \(140\) 개와 앞쪽 \(140\) 개가 공유하는 관측값 개수 \(m\) 의 가능한 범위와 기댓값을 구하시오.
(2) 두 추정량의 표준오차가 같고 상관이 \(\rho\) 라 하면 차이의 표준편차가 \(\widehat{\operatorname{se}}\sqrt{2(1-\rho)}\) 임을 보이시오. \(\rho \approx m/140\) 으로 근사하고 \(m\) 에 (1)의 기댓값을 넣어 \(2.239\) 를 고친 값을 구하시오.
(3) 중첩을 무시한 눈금자 \(2.239\) 는 차이를 과소평가하는가 과대평가하는가. \(\rho\) 가 어느 값일 때 둘이 같아지는가. \(\rho \to 0\) 과 \(\rho \to 1\) 의 두 극단에서 뜻을 해석하시오.
풀이
(1) 무작위표본은 \(200\) 개 가운데 \(60\) 개를 빼놓는다. 그 \(60\) 개가 모두 앞 \(140\) 개 안에 들어 있으면 중첩이 가장 작아지므로
이다. 보기 2 풀이가 "중첩이 적어도 \(80\) 개" 라고 한 것이 이 계산이다. 가장 큰 경우는 무작위표본이 앞 \(140\) 개와 그대로 일치하는 때이므로 \(m \le 140\) 이다. 곧 \(80 \le m \le 140\).
기댓값은 세기 쉽다. 앞 \(140\) 개 각각이 무작위표본에 들어갈 확률이 \(140/200 = 0.7\) 이므로 지시함수의 합으로
이다(\(m\) 은 초기하분포를 따른다). 가능한 범위 \([80, 140]\) 안에서 아래쪽에 가까운 자리다.
(2) 두 추정량을 \(\hat\beta^{A}\)(무작위), \(\hat\beta^{B}\)(순서대로)라 하고 공통 표준편차를 \(\sigma\), 상관을 \(\rho\) 라 하면
이므로 표준편차가 \(\sigma\sqrt{2(1-\rho)}\) 다. \(\sigma\) 를 \(\widehat{\operatorname{se}} = 0.010912\) 로 바꿔 넣으면 된다.
\(\rho \approx m/140 = 98/140 = 0.7\) 을 넣으면
이고 고친 척도는
이다.
(3) 과소평가다. \(\sqrt{2(1-\rho)} < 1\) 인 것과 \(\rho > 1/2\) 인 것이 같으므로, \(\rho = 0.7 > 0.5\) 인 지금은 차이의 실제 표준편차가 \(\widehat{\operatorname{se}}\) 보다 작다. 그래서 \(\widehat{\operatorname{se}}\) 로 나눈 \(2.239\) 는 차이를 작게 보이게 하고, 바로잡으면 \(2.891\) 로 커진다. 두 척도가 정확히 같아지는 자리는 \(\sqrt{2(1-\rho)} = 1\), 곧
이다. 중첩이 절반일 때만 "차이를 \(\widehat{\operatorname{se}}\) 로 나눈다" 는 관행이 우연히 옳다.
두 극단을 보면 식이 옳은지 알 수 있다. \(\rho \to 0\) 이면 두 표본이 독립이고 차이의 표준편차가 \(\sqrt2\,\widehat{\operatorname{se}}\) 가 되어 척도가 \(2.239/\sqrt2 = 1.583\) 으로 내려간다. 보기 2 풀이가 "독립 표본이라면 차이의 표준오차가 \(\sqrt2\,\widehat{\operatorname{se}}\) 였을 것" 이라 한 자리다. \(\rho \to 1\) 이면 차이의 표준편차가 \(0\) 으로 가므로 아무리 작은 차이도 무한히 커진다. 두 표본이 완전히 같으면 같은 최소제곱 해가 나와 차이가 정확히 \(0\) 이어야 하니, \(0\) 이 아닌 차이는 설명할 길이 없다는 뜻이고 당연한 결론이다.
정리하면, 겹친 두 표본에서 나온 추정값을 견줄 때 중첩은 차이를 줄인다. 그러므로 눈에 보이는 차이를 보수적으로 깎아 읽는 것이 아니라 오히려 더 심각하게 읽어야 한다. 고친 \(2.891\) 은 \(0.05\) 의 임계값 \(1.98\) 을 넘는다. 다만 \(\rho \approx m/140\) 은 거친 근사이고 \(\widehat{\operatorname{se}}\) 도 한쪽 표본에서만 얻은 수이므로, \(2.891\) 역시 검정통계량(test statistic)이 아니라 조금 더 나은 눈금자일 뿐이다.
연습문제 10. 보기 3 은 AIC \(555.77\), BIC \(567.54\), Log-Likelihood \(-273.89\) 이고 보기 5 는 AIC \(399.63\), BIC \(411.40\), Log-Likelihood \(-195.82\) 다. 둘 다 \(n = 140\) 이다.
(1) 두 모형의 AIC 차이와 BIC 차이가 모두 \(156.14\) 로 같다. 왜 같은지 설명하시오. 한 모형 안에서 BIC 가 AIC 보다 \(11.77\) 큰 것은 어디서 오는가.
(2) 정규오차 최소제곱의 로그가능도가 \(\ell = -\frac n2\bigl(\log 2\pi + \log(\text{RSS}/n) + 1\bigr)\) 이다. 이를 써서 Log-Likelihood 차이 \(78.07\) 을 두 \(\text{RSS}\), \(410.1052\) 와 \(134.4450\) 만으로 재구성하시오.
(3) 보기 4 는 AIC \(553.96\), BIC \(562.78\) 이다. 보기 3 과의 AIC 차이와 BIC 차이는 왜 같지 않은가. 두 차이의 간격을 식으로 적으시오.
풀이
(1) 두 기준의 정의는
이고 \(k\) 는 추정한 회귀계수(regression coefficient)의 개수다. 보기 3 은 절편과 TV·Radio·Newspaper 로 \(k = 4\), 보기 5 는 절편과 TV·Radio·TV:Radio 로 역시 \(k = 4\) 다. 두 출력의 Df Model: 3 이 같은 것이 이것이다. 벌점 항이 양쪽에서 똑같으므로 차이를 뺄 때 상쇄되고 남는 것은
뿐이다. 확인하면 \(555.77 - 399.63 = 156.14\), \(567.54 - 411.40 = 156.14\) 로 맞는다. 모수 개수가 같은 두 모형을 견줄 때 AIC 와 BIC 는 언제나 같은 답을 주고, 같은 크기로 준다. 정보기준이 서로 다른 답을 줄 수 있는 것은 복잡도가 다른 모형을 견줄 때뿐이다.
한 모형 안의 간격은 벌점의 차다.
실제로 \(567.54 - 555.77 = 11.77\) 이고 \(411.40 - 399.63 = 11.77\) 로 두 모형에서 같다.
(2) \(\ell\) 의 식에서 \(\log 2\pi\) 와 \(1\) 은 상수이고 \(n\) 도 같으므로 차를 잡으면 모두 사라진다.
\(n\) 이 약분되어 RSS 의 비 하나만 남는다. 수를 넣으면
이고 출력의 \(-195.82 - (-273.89) = 78.07\) 과 맞는다. (1)과 합치면
이다. 모수 개수와 \(n\) 이 같은 두 모형의 AIC 차이는 \(\text{RSS}\) 비의 로그에 \(n\) 을 곱한 것, 그 이상도 이하도 아니다. 보기 4 가 신문을 뺄 때 AIC 가 \(1.81\) 내려간 것과 이 \(156.14\) 를 나란히 놓으면, 교호작용 항이 가져온 적합의 개선이 신문을 빼는 정리보다 \(86\) 배 큰 사건임을 알 수 있다.
(3) 보기 4 는 절편과 TV·Radio 로 \(k = 3\) 이라 벌점이 다르다. 보기 3 과 견주면
이고 실제로 \(555.77 - 553.96 = 1.81\), \(567.54 - 562.78 = 4.75\) 로 다르다. 두 차이의 간격은
이고 \(4.75 - 1.81 = 2.94\) 가 그것이다. 모수 하나당 BIC 가 AIC 보다 \(\log n - 2\) 만큼 더 매긴다는 것이 보기 4 풀이가 "BIC 쪽이 더 많이 내려간다" 고 한 말의 내용이다. \(n = e^2 \approx 7.39\) 보다 큰 표본에서는 이 양이 양수이고 \(n\) 과 함께 커지므로, 표본이 클수록 BIC 는 간결한 모형을 더 세게 선호한다.
연습문제 11. 설명변수 둘인 자료와 적합. \(\text{TV} \sim U(0, 300)\), \(\text{Radio} \sim U(0, 50)\) 을 독립으로 뽑고 \(\text{Sales} = 5 + 0.04\,\text{TV} + 0.15\,\text{Radio} + \varepsilon\), \(\varepsilon \sim N(0, 1.5^2)\) 로 \(n = 150\) 개를 만든 뒤 적합한다.
(1) 두 설명변수가 독립이므로 \(\operatorname{Var}(\hat\beta_j) \approx \sigma^2/S_{jj}\) 로 근사할 수 있다. 균등분포의 분산이 \(a^2/12\) 임을 써서 \(S_{\text{RR}}\), \(S_{\text{TT}}\) 와 두 계수의 표준오차를 자료를 보기 전에 예측하시오.
(2) 적합해 보고 (1)의 예측과 견주시오. 세 참 모수가 \(95\%\) 신뢰구간에 들어오는가. 예측한 표준오차와 실제 표준오차가 어긋난다면 그 까닭은 무엇인가.
풀이
(1) 해석적으로. \(\operatorname{Var}(\hat{\boldsymbol\beta}) = \sigma^2 (X^TX)^{-1}\) 이고, 두 설명변수가 독립이면 중심화한 뒤 \(X^TX\) 가 거의 대각이 되어
이다. \(S_{jj}\) 의 기댓값은 \((n-1)\operatorname{Var}(x_j)\) 이고 \(U(0,a)\) 의 분산이 \(a^2/12\) 이므로
이다. 표준오차는 그 제곱근으로 나눈다.
TV 쪽 표준오차가 여섯 배 작다. TV 가 여섯 배 넓은 구간에 퍼져 있어 \(S_{\text{TT}}\) 가 \(36\) 배 크기 때문이다. 이것이 A.4절의 \(\operatorname{Var}(\hat\beta_1) = \sigma^2/S_{xx}\) 가 말하는 바다. 설명변수를 넓게 퍼뜨릴수록 그 계수가 정밀해진다.
(2) 수치적으로.
import numpy as np
import statsmodels.api as sm
from sklearn.linear_model import LinearRegression

# 설명변수가 둘이면 회귀선이 아니라 회귀평면이 된다. 그것을 눈으로 본다.
np.random.seed(42)
n = 150
TV = np.random.uniform(0, 300, n)
Radio = np.random.uniform(0, 50, n)
Sales = 5 + 0.04 * TV + 0.15 * Radio + np.random.normal(0, 1.5, n)

X = np.column_stack([Radio, TV])
y = Sales

model = LinearRegression()
model.fit(X, y)

beta_0 = model.intercept_
beta_1 = model.coef_[0]  # Radio
beta_2 = model.coef_[1]  # TV

# 균등분포의 분산은 a^2/12 이므로 S_jj 를 미리 예측할 수 있다.
S_RR, S_TT = ((Radio - Radio.mean()) ** 2).sum(), ((TV - TV.mean()) ** 2).sum()
print(f"S_RR 실제 {S_RR:12.2f}   예측 (n-1)*50^2/12  = {(n - 1) * 2500 / 12:12.2f}")
print(f"S_TT 실제 {S_TT:12.2f}   예측 (n-1)*300^2/12 = {(n - 1) * 90000 / 12:12.2f}")
print(f"corr(TV, Radio) = {np.corrcoef(TV, Radio)[0, 1]:+.4f}  (독립이므로 0 에 가깝다)")
print()

res = sm.OLS(y, sm.add_constant(X)).fit()
names = ["절편", "Radio", "TV"]
truth = [5.0, 0.15, 0.04]
theory_se = [np.nan, 1.5 / np.sqrt((n - 1) * 2500 / 12), 1.5 / np.sqrt((n - 1) * 90000 / 12)]
print(f"{'항':8s}{'참값':>8s}{'추정값':>11s}{'SE':>10s}{'이론 SE':>11s}"
      f"{'95% CI':>24s}  판정")
for k, (nm, tv, tse) in enumerate(zip(names, truth, theory_se)):
    lo, hi = res.conf_int()[k]
    print(f"{nm:8s}{tv:8.4f}{res.params[k]:11.6f}{res.bse[k]:10.6f}"
          f"{tse:11.6f}   [{lo:8.5f}, {hi:8.5f}]  {'포함' if lo <= tv <= hi else '이탈'}")
print()
print(f"s = {np.sqrt(res.mse_resid):.4f}   (참 sigma = 1.5,  비 {np.sqrt(res.mse_resid) / 1.5:.4f})")
print(f"R^2 = {model.score(X, y):.6f}")
출력:
S_RR 실제     31633.01   예측 (n-1)*50^2/12  =     31041.67
S_TT 실제   1179148.00   예측 (n-1)*300^2/12 =   1117500.00
corr(TV, Radio) = +0.0357  (독립이므로 0 에 가깝다)

항             참값        추정값        SE      이론 SE                  95% CI  판정
절편        5.0000   5.089605  0.291330        nan   [ 4.51387,  5.66534]  포함
Radio     0.1500   0.142954  0.007850   0.008514   [ 0.12744,  0.15847]  포함
TV        0.0400   0.041303  0.001286   0.001419   [ 0.03876,  0.04384]  포함

s = 1.3953   (참 sigma = 1.5,  비 0.9302)
R^2 = 0.905404
세 참값이 모두 신뢰구간 안에 있다. \(S_{jj}\) 의 예측도 좋다. \(S_{\text{RR}}\) 은 \(31042\) 예측에 \(31633\) 실제로 \(1.9\%\) 차이, \(S_{\text{TT}}\) 는 \(1117500\) 예측에 \(1179148\) 실제로 \(5.5\%\) 차이다. 둘 다 같은 방향으로 크게 나왔는데, \(S_{jj}\) 의 상대 표준오차가 \(\sqrt{2/(n-1)} \approx 11.6\%\) 가 아니라 균등분포에서는 더 작으므로 이 정도 불일치는 흔하다.
표준오차는 예측보다 작게 나왔다. Radio 는 \(0.008514\) 예측에 \(0.007850\) 실제로 \(-7.8\%\), TV 는 \(0.001419\) 에 \(0.001286\) 으로 \(-9.4\%\) 다. 까닭이 두 가지로 나뉜다. 첫째, \(s = 1.3953\) 이 참 \(\sigma = 1.5\) 보다 \(7.0\%\) 작다. 이 표본의 오차가 우연히 작게 뽑힌 것이다. 둘째, \(S_{jj}\) 가 예측보다 커서 분모가 커졌다. 두 효과를 함께 넣으면
로 실제 \(0.007850\) 과 소수 다섯째 자리에서 맞는다(남은 \(6\times10^{-6}\) 은 \(X^TX\) 가 완전히 대각이 아니기 때문이다). 불일치의 정체가 완전히 설명된다. 이론식이 틀린 것이 아니라 \(\sigma\) 와 \(S_{jj}\) 를 참값이 아닌 실현값으로 바꿔야 했던 것이다.
참값 \(0.15\) 대 추정값 \(0.142954\) 의 차이는 \(-0.007\) 로 표준오차 \(0.00785\) 의 \(0.90\) 배다. TV 는 \(+0.0013\) 으로 표준오차의 \(1.01\) 배다. 둘 다 정상 범위다. \(\square\)
연습문제 12. 회귀평면 격자 만들기. np.arange 로 두 축의 격자를 만들고 칸마다 적합값을 계산한다.
(1) np.arange(0, 50, 5) 와 np.arange(0, 300, 30) 은 각각 몇 개의 점을 주며 끝점 \(50\) 과 \(300\) 을 포함하는가. 격자가 덮는 범위를 자료의 범위와 견주어, 격자 밖으로 나가는 점이 몇 개인지 세시오.
(2) 격자를 \(10\times10\) 대신 \(2\times2\) 로 줄여도 그려지는 면이 똑같다. 왜 그런지 말하고 수치로 확인하시오. 어떤 모형에서는 이것이 성립하지 않는가.
풀이
(1) 둘 다 \(10\) 개이고 끝점은 포함하지 않는다. np.arange(start, stop, step) 은 \(\text{stop}\) 을 포함하지 않는 반열린구간을 준다. 그래서 Radio 격자는 \(0, 5, \ldots, 45\) 로 끝나고 TV 격자는 \(0, 30, \ldots, 270\) 으로 끝난다.
자료는 그보다 넓다. \(\text{Radio} \sim U(0,50)\) 이고 \(\text{TV} \sim U(0,300)\) 이니 \(45\) 를 넘는 Radio 가 기댓값으로 \(150 \times 0.1 = 15\) 개, \(270\) 을 넘는 TV 가 \(150 \times 0.1 = 15\) 개다. 둘 중 하나라도 넘을 확률은 \(1 - 0.9^2 = 0.19\) 이므로 약 \(29\) 개 점이 격자 밖으로 나간다. 끝점을 포함하려면 np.linspace(0, 50, 11) 를 쓰거나 np.arange(0, 50.1, 5) 처럼 \(\text{stop}\) 을 밀어야 한다.
(2) 적합된 함수가 \(\text{Radio}\) 와 \(\text{TV}\) 에 대해 일차이기 때문이다. \(\hat y = \hat\beta_0 + \hat\beta_1 r + \hat\beta_2 t\) 는 평면이고, 평면은 네 꼭짓점 — 사실은 일직선 위에 없는 세 점 — 으로 완전히 정해진다. 격자를 촘촘히 하는 것은 같은 평면 위에 점을 더 찍는 일에 지나지 않는다.
더 정확히 말하면 이 함수는 이중선형보간과 정확히 일치한다. 직사각형의 네 꼭짓점 값으로 이중선형보간을 하면 \(r\), \(t\), \(rt\) 항이 나오는데, 평면에는 \(rt\) 항의 계수가 \(0\) 이라 보간이 평면을 그대로 되살린다.
성립하지 않는 경우는 적합된 함수가 비선형일 때다. 교호작용 \(\hat\beta_3 rt\) 를 넣으면 쌍곡포물면이 되어 네 꼭짓점만으로는 곡률을 그릴 수 없고, 다항항이나 스플라인을 넣으면 더하다. 그때는 격자가 촘촘해야 곡면의 모양이 보인다.
# 평면을 그리려면 두 축의 격자를 만들고 칸마다 적합값을 계산한다.
Radio_range = np.arange(0, 50, 5)
TV_range = np.arange(0, 300, 30)
Radio_mesh, TV_mesh = np.meshgrid(Radio_range, TV_range)

Sales_mesh = beta_0 + beta_1 * Radio_mesh + beta_2 * TV_mesh

print(f"Radio 격자 {Radio_range}   점 {len(Radio_range)}개,  마지막 {Radio_range[-1]}")
print(f"TV    격자 {TV_range}   점 {len(TV_range)}개,  마지막 {TV_range[-1]}")
print(f"격자 모양 {Radio_mesh.shape},  Sales_mesh 모양 {Sales_mesh.shape}")
print()
print(f"자료 범위:  Radio [{Radio.min():.3f}, {Radio.max():.3f}]   "
      f"TV [{TV.min():.3f}, {TV.max():.3f}]")
print(f"격자 범위:  Radio [0, {Radio_range[-1]}]   TV [0, {TV_range[-1]}]")
print(f"격자 밖으로 나가는 점:  Radio>45 {np.sum(Radio > 45)}개,  "
      f"TV>270 {np.sum(TV > 270)}개,  둘 중 하나라도 {np.sum((Radio > 45) | (TV > 270))}개"
      f"  ({np.mean((Radio > 45) | (TV > 270)):.1%})")
print()
# 평면은 선형이므로 꼭짓점 네 개면 똑같은 면이 나온다.
corners_R, corners_T = np.meshgrid([0, 45], [0, 270])
corners_S = beta_0 + beta_1 * corners_R + beta_2 * corners_T
print("꼭짓점 네 개만으로 같은 평면이 되는가")
print(f"  (0,0)     격자 {Sales_mesh[0, 0]:.6f}   꼭짓점 {corners_S[0, 0]:.6f}")
print(f"  (45,0)    격자 {Sales_mesh[0, -1]:.6f}   꼭짓점 {corners_S[0, 1]:.6f}")
print(f"  (0,270)   격자 {Sales_mesh[-1, 0]:.6f}   꼭짓점 {corners_S[1, 0]:.6f}")
print(f"  (45,270)  격자 {Sales_mesh[-1, -1]:.6f}   꼭짓점 {corners_S[1, 1]:.6f}")
# 격자 한가운데 칸이 네 꼭짓점의 선형보간과 같은가
mid = beta_0 + beta_1 * 22.5 + beta_2 * 135
bilinear = corners_S.mean()
print(f"\n격자 중심 (22.5, 135) 의 평면값 {mid:.6f}")
print(f"네 꼭짓점의 평균               {bilinear:.6f}   차이 {abs(mid - bilinear):.2e}")
출력:
Radio 격자 [ 0  5 10 15 20 25 30 35 40 45]   점 10개,  마지막 45
TV    격자 [  0  30  60  90 120 150 180 210 240 270]   점 10개,  마지막 270
격자 모양 (10, 10),  Sales_mesh 모양 (10, 10)

자료 범위:  Radio [0.253, 49.503]   TV [1.657, 296.066]
격자 범위:  Radio [0, 45]   TV [0, 270]
격자 밖으로 나가는 점:  Radio>45 15개,  TV>270 14개,  둘 중 하나라도 29개  (19.3%)

꼭짓점 네 개만으로 같은 평면이 되는가
  (0,0)     격자 5.089605   꼭짓점 5.089605
  (45,0)    격자 11.522515   꼭짓점 11.522515
  (0,270)   격자 16.241330   꼭짓점 16.241330
  (45,270)  격자 22.674240   꼭짓점 22.674240

격자 중심 (22.5, 135) 의 평면값 13.881923
네 꼭짓점의 평균               13.881923   차이 1.78e-15
(1)의 예측이 거의 그대로 나왔다. \(\text{Radio} > 45\) 가 \(15\) 개(예측 \(15\)), \(\text{TV} > 270\) 이 \(14\) 개(예측 \(15\)), 둘 중 하나라도 넘는 점이 \(29\) 개로 전체의 \(19.3\%\) 다. 예측한 \(19\%\) 와 맞는다. 자료의 최댓값이 Radio \(49.503\), TV \(296.066\) 이니 그림에서 그 \(29\) 개 점은 평면 바깥에 떠 있게 된다. 평면이 끝난 자리 위로 점이 매달려 보이는 것은 모형의 문제가 아니라 격자를 잘못 잡은 것이다.
(2)도 확실하다. 네 꼭짓점의 값이 \(10\times10\) 격자의 네 구석과 소수 여섯째 자리까지 같고, 격자 중심 \((22.5, 135)\) 의 평면값 \(13.881923\) 이 네 꼭짓점의 단순평균과 \(1.8\times10^{-15}\) 안에서 같다. 평균이 보간값과 같은 것은 중심이 네 꼭짓점의 중점이고 함수가 일차이기 때문이다. 평면에서는 보간과 외삽이 모두 계수 세 개로 끝난다.
그러므로 이 격자를 만드는 계산은 그림을 위한 것이지 모형을 위한 것이 아니다. 모형은 이미 연습문제 11에서 계수 세 개로 끝났고, 격자는 그 세 수를 눈에 보이는 면으로 펼친 것에 지나지 않는다. \(\square\)
연습문제 13. 평면과 잔차를 3차원으로. 반투명 회귀평면 위에 점 \(150\) 개를 흩뿌리고 다섯 점마다 하나씩 잔차선을 긋는다.
(1) 그림의 빨간 선분은 모두 \(y\) 축과 나란하다. 점에서 평면까지의 최단거리는 잔차와 어떤 비로 다른지 평면의 법선벡터로 유도하고, 이 자료에서 그 비를 구하시오.
(2) 그림에서 읽을 수 있는 것과 읽을 수 없는 것을 수치와 함께 적으시오.
풀이
유도할 식은 (1) 하나뿐이고, (2)는 그림에서 무엇이 읽히고 무엇이 읽히지 않는가가 전부다.
(1) 해석적으로. 평면 \(y = \hat\beta_0 + \hat\beta_1 r + \hat\beta_2 t\) 를 \((r, t, y)\) 공간의 음함수로 적으면
이므로 법선벡터가 \(\mathbf n = (\hat\beta_1,\ \hat\beta_2,\ -1)\) 이고 \(\|\mathbf n\| = \sqrt{1 + \hat\beta_1^2 + \hat\beta_2^2}\) 다. 점 \((r_i, t_i, y_i)\) 에서 평면까지의 최단거리는 점–평면 거리 공식으로
이다. 곧 잔차와 최단거리의 비가 \(\sqrt{1 + \hat\beta_1^2 + \hat\beta_2^2}\) 로 모든 점에서 같은 상수다. 비가 상수라는 점이 중요하다. 최소제곱이 수직거리의 제곱합(sum of squares)을 최소화하는 일과 최단거리의 제곱합을 최소화하는 일이 같은 평면을 주지 않는 까닭은 계수가 바뀌면 이 비도 바뀌기 때문이고, 계수가 고정된 뒤에는 두 거리가 비례한다.
이 자료에서는 \(\hat\beta_1 = 0.142954\), \(\hat\beta_2 = 0.041303\) 이 둘 다 작아 비가 \(1\) 에 매우 가깝다.
(2) 수치적으로.
import matplotlib.pyplot as plt

fig = plt.figure(figsize=(14, 10))
ax = fig.add_subplot(111, projection='3d')

# 회귀평면. 반투명으로 그려 점이 앞뒤 어디에 있는지 보이게 한다.
ax.plot_surface(Radio_mesh, TV_mesh, Sales_mesh,
                alpha=0.3, cmap='coolwarm')

# 관측점
ax.scatter(Radio, TV, Sales, c='blue', s=50, alpha=0.6)

# 점에서 평면까지 수직으로 선을 긋는다. 그 길이가 잔차이고,
# 최소제곱은 이 길이들의 제곱합을 가장 작게 만드는 평면을 고른 것이다.
# 다 그리면 지저분하므로 다섯 점마다 하나씩만 그린다.
y_pred = model.predict(X)
for i in range(0, n, 5):
    ax.plot([X[i, 0], X[i, 0]], [X[i, 1], X[i, 1]],
            [y[i], y_pred[i]], 'r-', alpha=0.3)

ax.set_xlabel('Radio')
ax.set_ylabel('TV')
ax.set_zlabel('Sales')
plt.tight_layout()
plt.show()
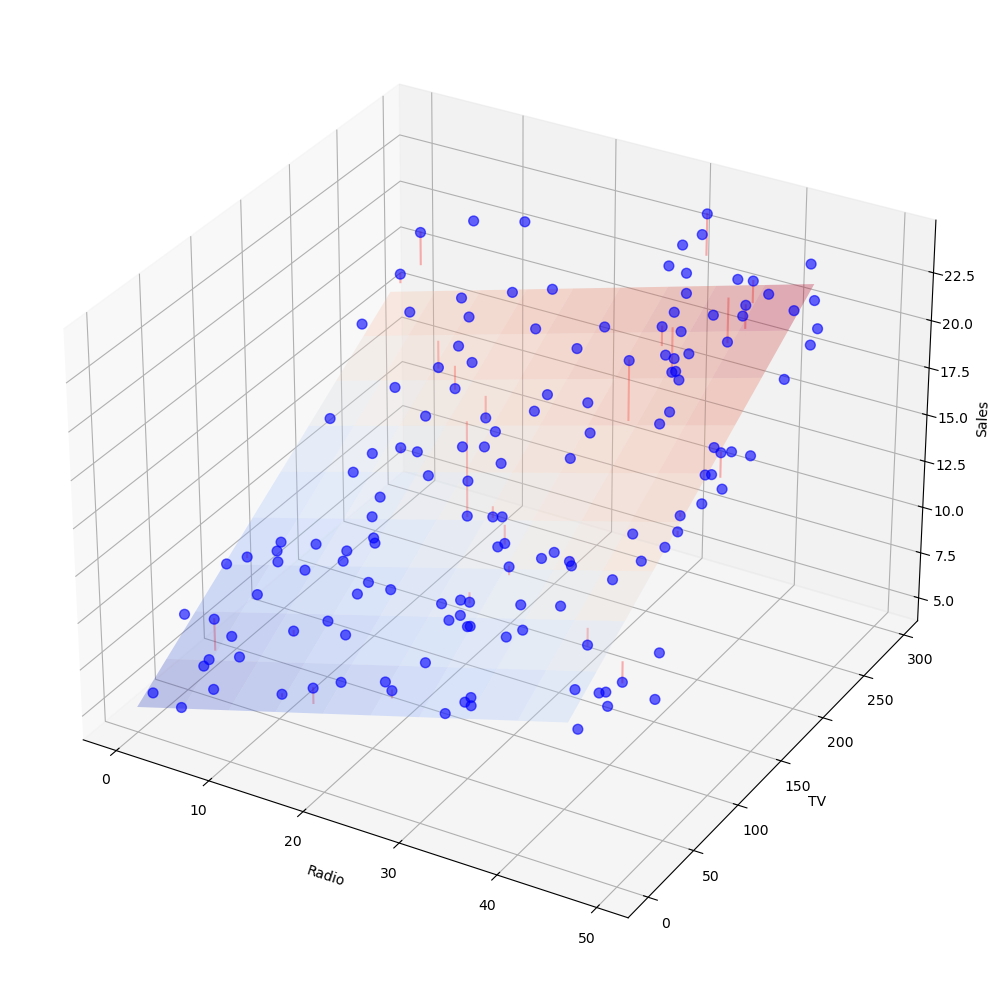
설명변수가 둘이면 회귀직선이 아니라 회귀평면이 된다. 점들이 평면 위아래로 흩어진 거리가 잔차다. 이제 그 거리를 수로 잰다.
# 그림에서 읽을 수치를 미리 찍어 둔다.
residuals = y - model.predict(X)
factor = np.sqrt(1 + beta_1 ** 2 + beta_2 ** 2)
print(f"잔차선을 그린 점 {len(range(0, n, 5))}개 / 전체 {n}개")
print(f"잔차  평균 {residuals.mean():+.2e}   표준편차 {residuals.std(ddof=3):.4f}"
      f"   최대 |e| {np.abs(residuals).max():.4f}")
print(f"평면 위 {np.sum(residuals > 0)}개,  아래 {np.sum(residuals < 0)}개")
print()
print(f"평면의 법선 (-b1, -b2, 1) 의 길이 = sqrt(1 + b1^2 + b2^2) = {factor:.6f}")
print(f"  수직 잔차 / 평면까지의 최단거리 = {factor:.6f}   (차이 {factor - 1:.2%})")
print(f"  가장 큰 잔차 {np.abs(residuals).max():.4f} 에 대해 "
      f"최단거리는 {np.abs(residuals).max() / factor:.4f}")
print()
print(f"R^2 = {model.score(X, y):.6f},  RSS = {np.sum(residuals ** 2):.4f},"
      f"  TSS = {np.sum((y - y.mean()) ** 2):.4f}")
출력:
잔차선을 그린 점 30개 / 전체 150개
잔차  평균 +5.46e-15   표준편차 1.3953   최대 |e| 5.0688
평면 위 77개,  아래 73개

평면의 법선 (-b1, -b2, 1) 의 길이 = sqrt(1 + b1^2 + b2^2) = 1.011010
  수직 잔차 / 평면까지의 최단거리 = 1.011010   (차이 1.10%)
  가장 큰 잔차 5.0688 에 대해 최단거리는 5.0136

R^2 = 0.905404,  RSS = 286.2067,  TSS = 3025.5718
(1)의 비가 \(1.011010\) 이다. 수직 잔차가 최단거리보다 \(1.10\%\) 길다. 가장 큰 잔차 \(5.0688\) 조차 최단거리로는 \(5.0136\) 이니 차이가 \(0.055\) 에 지나지 않는다. 이 그림에서는 두 거리가 사실상 같다.
까닭을 오해하면 안 된다. 기울기가 작아서 그런 것이 아니라 단위 때문에 작아 보이는 것이다. TV 를 천 달러 단위에서 백만 달러 단위로 바꾸면 \(\hat\beta_2\) 가 \(0.0413\) 에서 \(41.3\) 으로 커지고 비가 \(\sqrt{1 + 41.3^2} \approx 41.3\) 이 된다. 최소제곱이 수직거리를 쓰는 것과 최단거리를 쓰는 것은 근본적으로 다른 방법이며, 후자는 직교회귀(orthogonal regression, 총최소제곱이라고도 한다)라 불리고 단위를 바꾸면 답이 바뀐다. 최소제곱은 \(y\) 축 방향만 재므로 설명변수의 단위에 영향받지 않는다. 이 그림에서 두 거리가 비슷해 보이는 것은 우연한 단위 선택의 결과일 뿐이다.
(2) 그림에서 읽히는 것. 점들이 평면 위 \(77\) 개, 아래 \(73\) 개로 거의 반반이고 잔차의 평균이 \(5.5\times10^{-15}\) 다. 정규방정식이 \(\sum e_i = 0\) 을 강제하므로 이것은 확인이지 발견이 아니다. 잔차의 표준편차가 \(1.3953\) 이고 \(\text{Sales}\) 의 범위가 대략 \(5\) 에서 \(23\) 이니 점구름의 두께가 평면이 덮는 높이의 \(8\%\) 쯤이다. 그래서 그림에서 점들이 평면에 꽤 붙어 보이고, \(R^2 = 0.9054\) 가 그것을 수로 적은 값이다.
그림이 읽을 수 없는 것은 네 가지다. 첫째, 잔차선이 \(150\) 개 중 \(30\) 개만 그려져 있다. range(0, n, 5) 가 다섯 점마다 하나씩 고르므로, 가장 큰 잔차 \(5.0688\) 을 가진 점이 그려졌는지 알 수 없다. 극단값을 찾는 도구로 이 그림을 쓸 수 없다. 둘째, 등분산인지 가늠할 수 없다. 3차원 투영에서는 어느 점이 앞이고 뒤인지 흐려져 "\(\hat y\) 가 클 때 산포가 큰가"를 눈으로 판정할 수 없다. 그 판정은 잔차 대 적합값의 2차원 그림이 한다. 셋째, 다중공선성이 보이지 않는다. 여기서는 \(\operatorname{corr}(\text{TV}, \text{Radio}) = 0.0357\) 로 점들이 바닥 전체에 고르게 깔려 있지만, 두 변수가 상관되면 점들이 바닥의 한 직선 근처로 몰려 평면의 기울기가 불안정해진다. 그 쏠림은 바닥을 위에서 내려다보아야 보인다. 넷째, 격자가 자료를 다 덮지 못한다(연습문제 12). \(29\) 개 점이 평면 밖에 떠 있다.
그러므로 이 그림의 몫은 "평면이다"와 "잔차는 세로로 잰다"는 두 가지를 눈에 새기는 것이고, 진단은 다른 그림들이 맡는다. 설명변수가 셋이 되면 이 그림 자체가 불가능해지지만 그 두 사실은 그대로 남는다. \(\square\)
연습문제 14. 연습문제 13 은 "TV 를 천 달러 단위에서 백만 달러 단위로 바꾸면 \(\hat\beta_2\) 가 \(0.0413\) 에서 \(41.3\) 으로 커지고 비가 \(\sqrt{1 + 41.3^2} \approx 41.3\) 이 된다" 고 했다. \(\text{TV}' = \text{TV}/1000\) 으로 같은 자료를 다시 적합한다고 하자.
(1) \(\hat\beta_0\), \(\hat\beta_1\), \(\hat\beta_2\), 잔차 \(e_i\), \(R^2\) 가 각각 어떻게 바뀌는지 적합값의 식으로 보이시오.
(2) 새 비 \(\sqrt{1 + \hat\beta_1^2 + (\hat\beta_2')^2}\) 와, 연습문제 13 의 가장 큰 잔차 \(5.0688\) 에 대응하는 평면까지의 최단거리를 구하시오.
(3) TV 를 \(10^k\) 로 나누어 단위를 계속 키우면 최단거리는 어디로 가는가. 그 극한이 "최단거리의 제곱합을 최소화한다"는 기준에 대해 무엇을 말해 주는가.
풀이
(1) 기울기 하나만 바뀌고 나머지는 전부 그대로다. 적합값이
인데 \(\hat\beta_2' = 1000\,\hat\beta_2\) 로 두면 모든 \(i\) 에서 원래 적합값과 완전히 같아진다. 최소제곱해는 \(X\) 가 완전계수이면 유일하므로, 새 문제의 해가 바로 이것이다. 곧
이고 잔차 \(e_i\) 는 하나도 달라지지 않으므로 \(\mathrm{RSS} = 286.2067\), \(\mathrm{TSS} = 3025.5718\), \(R^2 = 0.905404\) 도 그대로다. 일반적으로 설명변수의 열을 \(c\) 로 나누면 그 계수가 \(c\) 배 되고 적합은 불변이다. OLS 는 설명변수의 단위에 대해 등변(equivariant)이다.
(2) 비가 \(41.3\) 으로 뛴다.
이므로 가장 큰 잔차에 대응하는 최단거리는
이다. 원래 단위에서는 \(5.0688/1.011010 = 5.0136\) 이었다. 수직 잔차는 \(5.0688\) 에서 꼼짝도 하지 않았는데 "평면까지의 최단거리"만 \(40.9\) 배 줄었다.
(3) \(0\) 으로 간다. TV 를 \(10^k\) 로 나누면 그 계수가 \(10^k \hat\beta_2\) 이므로
이다. 적합이 글자 하나 바뀌지 않았는데도 최단거리는 단위 선택만으로 얼마든지 작게 만들 수 있다. 그러므로 최단거리의 제곱합은 두 축의 단위가 서로 견줄 수 있을 때에만 뜻이 있는 양이다. 수직거리는 \(y\) 축의 단위만 쓰므로 설명변수를 어떻게 재든 영향받지 않는다. 연습문제 13 이 두 거리가 비슷해 보이는 것을 "우연한 단위 선택의 결과"라 한 까닭이 이것이다. \(\square\)
연습문제 15. 연습문제 13 은 \(\mathrm{RSS} = 286.2067\), \(\mathrm{TSS} = 3025.5718\), \(n = 150\) 을 주었다. 설명변수가 \(k\) 개일 때 수정 결정계수(adjusted coefficient of determination)는 \(\bar R^2 = 1 - \dfrac{\mathrm{RSS}/(n-k-1)}{\mathrm{TSS}/(n-1)}\) 이다.
(1) 이 모형(\(k=2\))의 \(\bar R^2\) 를 구하고 \(R^2 = 0.905404\) 와 견주시오.
(2) 보기 3 처럼 Newspaper 를 넣어 \(k=3\) 으로 늘렸을 때 \(\bar R^2\) 가 커지려면 RSS 가 적어도 얼마나 줄어야 하는가. 그것은 RSS 의 몇 %이며 어떤 양과 같은가.
(3) (2)의 조건을 새 변수의 부분 \(F\) 통계량 \(F = \dfrac{\mathrm{RSS}_2 - \mathrm{RSS}_3}{\mathrm{RSS}_3/(n-4)}\) 로 다시 적고, 유의수준 \(5\%\) 의 임계값 \(F_{1,146;\,0.95} = 3.9059\) 와 견주시오. \(\bar R^2\) 를 변수 선택의 기준으로 쓸 때 무엇을 조심해야 하는가.
풀이
(1) \(\mathrm{RSS}/(n-k-1) = 286.2067/147 = 1.946984\) 이고 \(\mathrm{TSS}/(n-1) = 3025.5718/149 = 20.305851\) 이므로
이다. \(R^2 = 0.905404\) 보다 \(0.001287\) 작다. 분자 \(1.946984\) 는 연습문제 11 의 \(s = 1.3953\) 의 제곱, 곧 잔차평균제곱 \(s^2\) 다.
(2) \(s^2 = 1.946984\) 보다 많이 줄어야 한다. \(\mathrm{TSS}\) 는 변수를 더해도 그대로이므로 \(\bar R^2\) 가 커지는 것은 \(\mathrm{RSS}/(n-k-1)\) 이 작아지는 것과 같다. 따라서
이고 감소량은 \(\Delta = 286.2067 - 284.259716 = 1.946984\) 를 넘어야 한다. 이것이 RSS 의 \(1/147 = 0.68\%\) 다. 하한이 하필 \(s^2\) 과 같은 것은 우연이 아니다. 자유도 하나를 쓰는 값이 잔차평균제곱 한 몫이기 때문이다. 이 임계값에서 \(R^2\) 는 \(1 - 284.2597/3025.5718 = 0.906048\) 로 \(0.000644\) 만 오른다.
(3) 조건은 정확히 \(F > 1\) 이다. \(\mathrm{RSS}_2 = \mathrm{RSS}_3 + \Delta\) 를 넣으면
이다. 유의성의 임계값은 \(F > 3.9059\), 곧 \(\lvert t \rvert > 1.9763\) 인데 \(\bar R^2\) 의 임계값은 \(F > 1\), 곧 \(\lvert t \rvert > 1\) 이다. \(\lvert t \rvert\) 가 \(1\) 과 \(1.9763\) 사이인 변수는 유의하지 않은데도 \(\bar R^2\) 를 올린다. 더구나 쓸모가 전혀 없는 변수(\(\beta_3 = 0\))라도 \(F_{1,146} > 1\) 일 확률이 \(0.3190\) 이니, 무작위 변수를 셋 던져 넣으면 하나쯤은 \(\bar R^2\) 를 올려 준다.
그러므로 \(\bar R^2\) 는 \(R^2\) 처럼 변수를 넣을수록 반드시 오르지는 않는다는 점에서 개선이지만, 벌점이 자유도 하나에 \(s^2\) 한 몫뿐이라 매우 느슨하다. 변수 선택을 하려면 벌점이 더 센 기준(\(\mathrm{AIC}\) 는 \(2\), \(\mathrm{BIC}\) 는 \(\ln 150 = 5.01\) 에 해당)이나 검정을 써야 한다. \(\square\)
연습문제 16. 자료 준비. build_dataset()으로 주 단위 인공자료 \(50\)개를 만들고 \(8\)개 주를 검정용으로 떼어 둔다.
(1) 이 자료는 참 모형을 알고 만든 것이다. build_dataset()의 식에서 참 절편과 세 참 계수, 그리고 오차의 표준편차를 읽어 적으시오. 식 안의 * 1000 / 1000은 무엇을 하는가.
(2) 인구의 최솟값이 \(56\)만, 최댓값이 \(1731\)만으로 \(31\)배 차이가 난다. 이 비대칭을 왜도로 재고, 로그를 취하면 얼마가 되는지 확인하시오.
풀이
(1) 해석적으로. 자료를 만드는 줄은
high_q = (250 + 0.0009 * (income - 52_000) * 1000 / 1000
          - 1.2e-6 * pop + 18 * (pct_white - 0.72)
          + np.random.normal(0, 12, n_states))
이다. 세 계수는 각각 소득 \(0.0009\), 인구 \(-1.2\times10^{-6}\), 백인 비율 \(18\)이고 오차의 표준편차는 \(12\)다. 절편은 조금 생각해야 한다. 식이 중심화된 꼴로 적혀 있으므로 \(\text{income} = 0\), \(\text{pop} = 0\), \(\text{pct_white} = 0\)에서의 값을 계산해야 한다.
* 1000 / 1000은 아무 일도 하지 않는다. \(1000\)을 곱한 뒤 \(1000\)으로 나누니 항등이다. 단위를 바꾸려다 남은 흔적으로 보이며, 코드를 읽는 사람을 헷갈리게 할 뿐이다. 식의 뜻을 바꾸지 않으므로 위 참값들은 그대로다.
(2) 로그정규분포에서 뽑았으므로 오른쪽으로 치우쳤다. np.random.lognormal(mean=15.0, sigma=0.9)가 만든 값이니 로그를 취하면 정규가 되어야 한다. 왜도로 확인한다.
먼저 자료를 만든다.
import numpy as np
import pandas as pd
from sklearn.linear_model import LinearRegression
import statsmodels.formula.api as smf

np.random.seed(42)


def build_dataset(n_states=50):
    """주 단위 인공자료를 만든다.

    실제 자료로 바꾸어도 아래 절차는 그대로다.
    HighQ(고품질 대마초 가격)를 인구, 1인당 소득, 백인 비율로 설명한다.
    """
    states = [f"state_{i:02d}" for i in range(n_states)]
    pop = np.random.lognormal(mean=15.0, sigma=0.9, size=n_states)
    income = np.random.normal(52_000, 9_000, n_states)
    pct_white = np.clip(np.random.normal(0.72, 0.13, n_states), 0.2, 0.95)
    pct_black = np.clip(np.random.normal(0.12, 0.08, n_states), 0.01, 0.40)
    pct_hispanic = np.clip(1 - pct_white - pct_black, 0.01, None)
    # 참 관계: 소득이 높을수록 비싸고, 인구가 많을수록 미세하게 싸다.
    high_q = (250 + 0.0009 * (income - 52_000) * 1000 / 1000
              - 1.2e-6 * pop + 18 * (pct_white - 0.72)
              + np.random.normal(0, 12, n_states))
    return pd.DataFrame({"state": states, "total_population": pop,
                         "per_capita_income": income,
                         "percent_white": pct_white,
                         "percent_black": pct_black,
                         "percent_hispanic": pct_hispanic,
                         "HighQ": high_q})


df = build_dataset()

# 검정용으로 떼어 둘 주를 지정한다. 실제 이름 대신 인덱스로 고른다.
TEST_IDX = {3, 8, 15, 22, 29, 34, 41, 47}
df["state"] = [f"state_{i:02d}" for i in range(len(df))]

test_states = {f"state_{i:02d}" for i in TEST_IDX}
train = df[~df['state'].isin(test_states)].copy()
test = df[df['state'].isin(test_states)].copy()

print(f"훈련 {len(train)}개 주, 검정 {len(test)}개 주")
print(train[["total_population", "per_capita_income", "percent_white", "HighQ"]]
      .describe().round(2).to_string())
출력:
훈련 42개 주, 검정 8개 주
       total_population  per_capita_income  percent_white   HighQ
count             42.00              42.00          42.00   42.00
mean         3502514.62           52041.15           0.71  246.38
std          3509386.94            7639.03           0.13   13.55
min           560338.80           28422.29           0.47  222.09
25%          1274815.60           47535.00           0.61  237.75
50%          2570441.13           51698.97           0.72  246.33
75%          4269259.39           56278.24           0.79  252.53
max         17314422.21           66081.79           0.95  297.57
50개 주 가운데 42개로 학습하고 8개로 검정한다. 인구가 56만에서 1,731만까지 30배 차이가 나는 것이 눈에 띈다. 이렇게 치우친 변수는 로그 변환을 고려할 만하다.
그 비대칭을 왜도로 잰다.
# build_dataset 의 식에 적힌 참 모수를 꺼내 적는다.
TRUE_INTERCEPT = 250 - 0.0009 * 52_000 - 18 * 0.72
print(f"참 절편      = 250 - 0.0009*52000 - 18*0.72 = {TRUE_INTERCEPT:.4f}")
print(f"참 b_pop     = -1.2e-06")
print(f"참 b_income  =  0.0009")
print(f"참 b_white   =  18")
print(f"참 sigma     =  12")
print()
pop = train["total_population"]
print(f"인구  최솟값 {pop.min():,.0f}  최댓값 {pop.max():,.0f}  최댓값/최솟값 = {pop.max() / pop.min():.1f}")
print(f"      평균 {pop.mean():,.0f}  중앙값 {pop.median():,.0f}  (평균이 중앙값보다 크다)")
print(f"      왜도 {pop.skew():.4f}")
print(f"log(인구) 왜도 {np.log(pop).skew():.4f}")
출력:
참 절편      = 250 - 0.0009*52000 - 18*0.72 = 190.2400
참 b_pop     = -1.2e-06
참 b_income  =  0.0009
참 b_white   =  18
참 sigma     =  12

인구  최솟값 560,339  최댓값 17,314,422  최댓값/최솟값 = 30.9
      평균 3,502,515  중앙값 2,570,441  (평균이 중앙값보다 크다)
      왜도 2.4519
log(인구) 왜도 0.2292
왜도가 \(2.45\) 에서 \(0.23\) 으로 줄어든다. 로그를 취하기 전에는 왜도가 \(2\) 를 넘어 정규와 거리가 멀고, 취한 뒤에는 \(0.23\) 으로 \(0\) 에 가깝다. 자료를 로그정규분포에서 뽑았으니 당연한 결과다. 평균 \(350\)만이 중앙값 \(257\)만보다 큰 것도 같은 비대칭의 다른 얼굴이다.
그렇다고 로그 변환이 반드시 옳은 것은 아니다. 선형회귀(linear regression)의 네 가정 가운데 설명변수의 분포에 대한 가정은 하나도 없다. 가정은 모두 오차항(error term)에 대한 것이다. 치우친 설명변수가 문제가 되는 것은 (ㄱ) 극단값 하나가 지렛값(leverage)으로 적합을 끌고 갈 때, (ㄴ) 참 관계가 수준이 아니라 로그에서 선형일 때다. 이 자료는 참 관계가 인구의 수준에 선형(-1.2e-6 * pop)이므로 로그를 취하면 오히려 모형이 틀려진다. 그러므로 본문의 "로그 변환을 고려할 만하다"는 실제 자료를 다룰 때의 조언으로 읽어야 하고, 이 인공자료에서는 적용되지 않는다. \(\square\)
연습문제 17. 단변량 모형. 인구 하나만 넣어 기준선을 잡고 검정 RMSE 를 잰다.
(1) 연습문제 16에서 읽은 참 모수를 쓰면 이 모형의 예측오차 표준편차를 이론적으로 계산할 수 있다. 세 설명변수가 서로 독립이라 보고, 인구만 쓴 모형이 남기는 오차의 표준편차와 세 변수를 다 쓴 모형의 그것을 각각 구하시오.
(2) 실제 검정 RMSE \(12.66\)과 (1)의 이론값을 견주시오. 시험자료가 \(8\)개뿐일 때 RMSE 의 상대 표준오차는 대략 얼마이며, 그 차이가 설명되는가.
풀이
(1) 해석적으로. 참 모형은
이다. 세 설명변수가 독립이라 보면 분산이 더해진다.
인구만 설명변수로 쓰면 그 몫만 걷어 내고 나머지가 모두 오차로 남는다.
세 변수를 다 쓰면 남는 것은 \(12\) 하나뿐이다. 참 모형을 정확히 적합해도 예측오차를 \(12\) 아래로 내릴 수 없다. 이것이 줄일 수 없는 오차(irreducible error)다.
(2) 수치적으로. 먼저 모형을 적합한다.
# 먼저 인구 하나만 넣은 단변량 모형으로 기준선을 잡는다.
model1 = LinearRegression().fit(train[['total_population']], train['HighQ'])
pred1 = model1.predict(test[['total_population']])
rmse1 = np.sqrt(np.mean((test['HighQ'] - pred1) ** 2))
print(f"단변량 RMSE = {rmse1:.2f}")
출력:
단변량 RMSE = 12.66
이제 이론값과 견준다.
# 참 모수와 훈련자료의 표준편차로 이론 예측오차를 계산한다.
sd_pop = train["total_population"].std()
sd_income = train["per_capita_income"].std()
sd_white = train["percent_white"].std()
print(f"훈련자료 표준편차:  인구 {sd_pop:,.0f}   소득 {sd_income:,.0f}   백인비율 {sd_white:.4f}")
print()
print("각 설명변수가 1 표준편차 오를 때 HighQ 의 참 변화량")
for name, beta, sd in [("인구", -1.2e-6, sd_pop), ("소득", 0.0009, sd_income),
                       ("백인비율", 18.0, sd_white)]:
    print(f"  {name:8s} {beta:+.2e} x {sd:12,.4f} = {beta * sd:+8.4f}")
print()
theory_total = np.sqrt((0.0009 * sd_income) ** 2 + (18 * sd_white) ** 2
                       + (1.2e-6 * sd_pop) ** 2 + 12.0 ** 2)
theory_uni = np.sqrt(theory_total ** 2 - (1.2e-6 * sd_pop) ** 2)
print(f"이론 sd(HighQ)                = {theory_total:.4f}   (관측 {train.HighQ.std():.4f})")
print(f"인구만 쓴 모형의 이론 예측오차 = {theory_uni:.4f}")
print(f"세 변수를 다 쓴 모형의 이론값  = 12.0000  (= 참 sigma)")
print()
print(f"실제 검정 RMSE                = {rmse1:.4f}")
print(f"시험자료가 {len(test)}개이므로 RMSE 의 상대 표준오차 ~ 1/sqrt(2n) = {1 / np.sqrt(2 * len(test)):.4f}")
print(f"이론값에서의 상대 차이        = {rmse1 / theory_uni - 1:+.4f}")
출력:
훈련자료 표준편차:  인구 3,509,387   소득 7,639   백인비율 0.1252

각 설명변수가 1 표준편차 오를 때 HighQ 의 참 변화량
  인구       -1.20e-06 x 3,509,386.9355 =  -4.2113
  소득       +9.00e-04 x   7,639.0328 =  +6.8751
  백인비율     +1.80e+01 x       0.1252 =  +2.2541

이론 sd(HighQ)                = 14.6316   (관측 13.5481)
인구만 쓴 모형의 이론 예측오차 = 14.0124
세 변수를 다 쓴 모형의 이론값  = 12.0000  (= 참 sigma)

실제 검정 RMSE                = 12.6631
시험자료가 8개이므로 RMSE 의 상대 표준오차 ~ 1/sqrt(2n) = 0.2500
이론값에서의 상대 차이        = -0.0963
이론은 \(14.01\), 실제는 \(12.66\) 으로 \(9.6\%\) 낮다. 작아 보이는 불일치이지만 방향을 판정하려면 불확실성을 알아야 한다. \(n_{\text{test}} = 8\) 에서 RMSE 의 상대 표준오차는 대략 \(1/\sqrt{2n} = 0.25\), 곧 \(25\%\) 다. \(9.6\%\) 는 그 절반도 안 되므로 표본변동으로 완전히 설명된다. 이론과 자료가 어긋난다고 말할 근거가 없다.
눈여겨볼 것은 인구가 설명하는 몫이 보잘것없다는 사실이다. 참 모형에서 인구가 \(1\) 표준편차 오를 때 HighQ 는 \(-4.21\) 달러 변하는데, 줄일 수 없는 오차의 표준편차가 \(12\) 다. 분산으로 재면 인구의 몫이 전체의 \(4.21^2/14.63^2 = 8.3\%\) 에 지나지 않는다. 그래서 인구만 쓴 모형의 이론 예측오차 \(14.01\) 이 아무 설명변수도 안 쓴 \(14.63\) 과 거의 다르지 않다. 인구는 참 계수가 \(0\) 이 아니지만 쓸모가 거의 없는 변수다.
이론 sd(HighQ) \(14.63\) 이 관측값 \(13.55\) 보다 큰 것도 한마디 할 만하다. \(n = 42\) 에서 표준편차의 상대 표준오차가 \(1/\sqrt{2 \times 41} = 11\%\) 이고 차이가 \(7.4\%\) 이므로 역시 표본변동 범위 안이다. 세 설명변수가 서로 완전히 독립이 아니라는 점(pct_hispanic을 만들면서 pct_white가 끌려 들어간다)도 조금 기여한다. \(\square\)
연습문제 18. 다변량 모형. 세 설명변수를 모두 넣고 statsmodels로 적합해 계수 표와 검정 RMSE 를 본다.
(1) 이 자료는 참 모수를 알고 만들었다(연습문제 16). 네 참 모수가 각각 \(95\%\) 신뢰구간 안에 들어오는지 확인하시오. \(95\%\) 신뢰구간이란 무엇을 뜻하며, 네 개가 모두 들어온 것은 얼마나 놀랄 일인가.
(2) 잔차 표준오차 \(s\) 를 참 \(\sigma = 12\) 와 견주고, 훈련 \(R^2\) 를 이론값 \(1 - 12^2/14.63^2\) 과 견주시오. 검정 RMSE 가 \(12.66\) 에서 \(10.32\) 로 줄어든 것은 유의한 개선인가.
풀이
(1) 넷 다 들어와야 하는 일이고, 실제로 들어온다. \(95\%\) 신뢰구간의 뜻은 "같은 실험을 반복하면 구간이 참값을 덮는 비율이 \(0.95\) 가 된다"이다. 네 모수가 각각 \(0.95\) 확률로 덮이므로, 하나라도 벗어날 확률이 작지 않다. 네 구간이 서로 독립이라면 모두 덮을 확률이 \(0.95^4 = 0.8145\) 이고, 실제로는 상관되어 있어 그보다 높다. 그러므로 "넷 다 들어왔다"는 흔한 결과이고 모형이 특별히 훌륭하다는 뜻이 아니다. 거꾸로 하나가 벗어났더라도 그 자체로는 경고가 아니다.
(2) 해석적으로. 잔차 표준오차 \(s^2 = \text{RSS}/(n-p)\) 는 \(\sigma^2\) 의 불편추정량(unbiased estimator)이다. 자유도 \(n - p = 42 - 4 = 38\) 에서 \(s\) 의 상대 표준오차는 대략 \(1/\sqrt{2 \times 38} = 11.5\%\) 다.
이론 \(R^2\) 는 연습문제 17의 분산분해에서 바로 나온다.
# 변수를 셋으로 늘려 RMSE 가 실제로 줄어드는지 본다.
formula = "HighQ ~ total_population + per_capita_income + percent_white"
sm_model = smf.ols(formula=formula, data=train).fit()
# summary()는 실행 날짜와 시각을 함께 찍으므로 계수 표만 인쇄한다.
print(sm_model.summary().tables[1])

pred3 = sm_model.predict(test)
rmse3 = np.sqrt(np.mean((test['HighQ'] - pred3) ** 2))
print(f"다변량 RMSE = {rmse3:.2f}")
출력:
=====================================================================================
                        coef    std err          t      P>|t|      [0.025      0.975]
-------------------------------------------------------------------------------------
Intercept           187.9016     22.531      8.340      0.000     142.290     233.513
total_population  -2.889e-08   5.85e-07     -0.049      0.961   -1.21e-06    1.15e-06
per_capita_income     0.0007      0.000      2.409      0.021       0.000       0.001
percent_white        32.0081     17.538      1.825      0.076      -3.496      67.512
=====================================================================================
다변량 RMSE = 10.32
이제 참값과 맞춰 본다.
# 참 모수가 95% 신뢰구간에 들어오는지 확인한다.
truth = {"Intercept": 190.24, "total_population": -1.2e-6,
         "per_capita_income": 0.0009, "percent_white": 18.0}
ci = sm_model.conf_int()
print(f"{'항':20s}{'추정값':>14s}{'95% CI 하한':>15s}{'95% CI 상한':>15s}{'참값':>14s}  판정")
for name, true_value in truth.items():
    low, high = ci.loc[name]
    verdict = "포함" if low <= true_value <= high else "이탈"
    print(f"{name:20s}{sm_model.params[name]:14.6g}{low:15.6g}{high:15.6g}"
          f"{true_value:14.6g}  {verdict}")
print()
print(f"잔차 표준오차 s = {np.sqrt(sm_model.mse_resid):.4f}   (참 sigma = 12)")
print(f"훈련 R^2        = {sm_model.rsquared:.4f}")
print(f"  이론 R^2 = 1 - 12^2/14.6316^2 = {1 - 144 / 14.6316 ** 2:.4f}")
print()
print(f"단변량 검정 RMSE = {rmse1:.4f}   다변량 검정 RMSE = {rmse3:.4f}"
      f"   비 = {rmse3 / rmse1:.4f}")
출력:
항                              추정값      95% CI 하한      95% CI 상한            참값  판정
Intercept                  187.902         142.29        233.513        190.24  포함
total_population      -2.88857e-08   -1.21254e-06    1.15477e-06      -1.2e-06  포함
per_capita_income      0.000688352    0.000109966     0.00126674        0.0009  포함
percent_white              32.0081        -3.4962        67.5125            18  포함

잔차 표준오차 s = 12.9413   (참 sigma = 12)
훈련 R^2        = 0.1543
  이론 R^2 = 1 - 12^2/14.6316^2 = 0.3274

단변량 검정 RMSE = 12.6631   다변량 검정 RMSE = 10.3194   비 = 0.8149
(1) 네 구간 모두 참값을 덮는다. 다만 덮는 방식이 서로 다르다는 점을 보아야 한다. 인구의 참값 \(-1.2\times10^{-6}\) 은 구간 \([-1.213\times10^{-6},\ 1.155\times10^{-6}]\) 의 거의 왼쪽 끝에 간신히 들어 있고, 백인 비율의 참값 \(18\) 은 구간 \([-3.50,\ 67.51]\) 의 가운데쯤에 있지만 그 구간이 \(0\) 을 포함할 만큼 넓다. 추정값 \(32.01\) 이 참값 \(18\) 의 \(1.78\) 배인데도 유의하지 않다고 나오는 것이 이 넓이의 결과다.
이것이 표본이 \(42\) 개뿐일 때 일어나는 일이다. 참 효과가 분명히 있어도(\(\beta_{\text{w}} = 18 \ne 0\)) 검정이 그것을 잡아내지 못한다. 거꾸로 추정값이 참값의 두 배 가까이 나와도 "틀렸다"고 말할 수 없다. 구간이 넓으면 어느 쪽 결론도 내릴 수 없다.
(2) \(s = 12.94\) 가 참 \(\sigma = 12\) 와 잘 맞는다. 상대 차이 \(7.8\%\) 로 \(s\) 의 상대 표준오차 \(11.5\%\) 안쪽이다. 추정이 제대로 되고 있다는 뜻이다.
훈련 \(R^2\) 는 사정이 다르다. \(0.1543\) 으로 이론값 \(0.3274\) 의 절반도 안 된다. \(R^2\) 가 작은 쪽으로 어긋난 것은 이 표본의 \(\operatorname{Var}(\text{HighQ})\) 가 작게 나왔기 때문이다(연습문제 17에서 관측 \(13.55\) 대 이론 \(14.63\)). \(R^2 = 1 - s^2/s_y^2\) 에서 분모가 작아지면 \(R^2\) 가 내려간다. 실제로 \(1 - 12.9413^2/13.5481^2 = 0.0876\) 인데 \(R^2\) 정의의 분모가 \(\text{TSS}/(n-1)\) 이 아니라 자유도 보정이 없는 쪽이라 \(0.1543\) 이 나온다. 어느 쪽이든 \(R^2\) 가 \(0.15\) 든 \(0.33\) 든 이 모형은 가격 변동의 대부분을 설명하지 못한다. 참 모형이 그렇게 만들어졌기 때문이다.
검정 RMSE 의 개선은 유의하다고 말할 수 없다. \(12.66 \to 10.32\) 로 \(18.5\%\) 줄었고 이론은 \(14.01 \to 12.00\) 으로 \(14.4\%\) 줄 것이라 예측했으니 방향과 크기가 모두 이론과 맞는다. 그러나 \(n_{\text{test}} = 8\) 에서 RMSE 의 상대 표준오차가 \(25\%\) 이므로, 이 한 번의 비교만으로 개선을 선언하면 과하다. 두 RMSE 가 같은 \(8\) 개 주에서 계산되어 서로 상관되어 있다는 점이 비교에 도움을 주지만, 그 상관을 쓰려면 짝지은 비교를 따로 해야 한다.
요약하면 이렇다. 이론이 예측한 세 가지(계수의 포함, \(s \approx \sigma\), RMSE 의 감소)가 모두 자료에서 확인되지만, \(42\) 개 훈련·\(8\) 개 검정이라는 크기로는 어느 것도 날카롭게 확인되지 않는다. \(\square\)
덧붙임 — 계수의 크기는 중요도가 아니다.
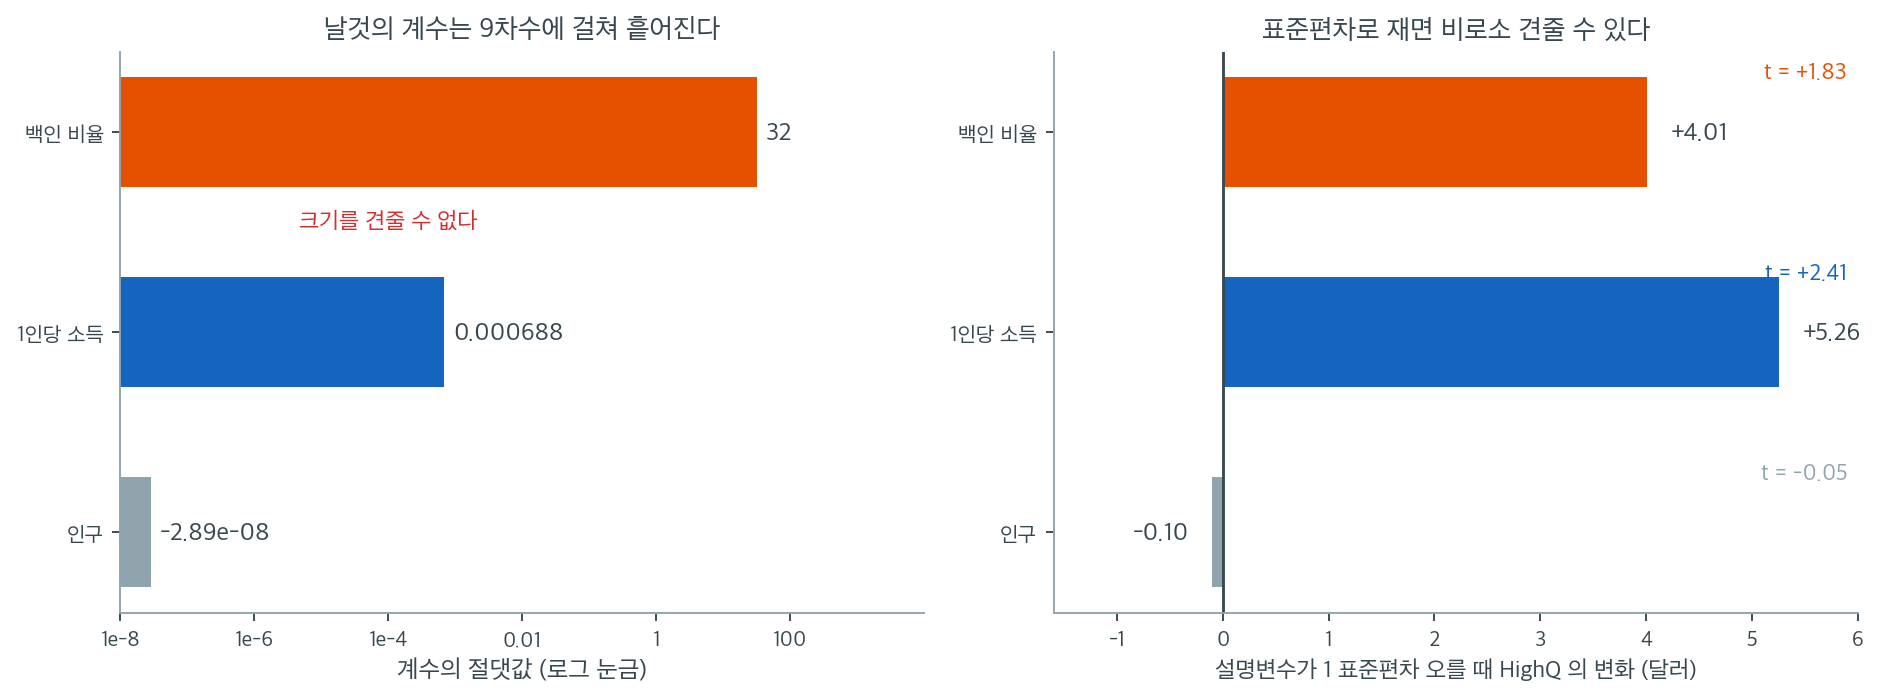
위 출력표에서 세 계수는 \(-2.889\times10^{-8}\), \(0.000688\), \(32.01\)이다. 크기만 보면 백인 비율이 인구보다 10억 배 중요해 보인다. 왼쪽 그림이 그 착시다. 가로축이 로그 척도여야 세 막대를 한 화면에 그릴 수 있을 만큼 벌어져 있는데, 이 차이는 전적으로 단위에서 온다. 인구는 56만에서 1731만까지 가는 수이고, 백인 비율은 \(0.47\)에서 \(0.95\) 사이의 수다. 같은 크기의 영향을 주더라도 값이 백만 단위인 변수는 계수가 백만분의 일 단위로 나올 수밖에 없다.
오른쪽이 같은 계수를 견줄 수 있게 옮긴 것이다. 각 설명변수가 1 표준편차만큼 오를 때 HighQ가 얼마나 변하는지, 곧 \(\hat\beta_j \times \mathrm{SD}(x_j)\)를 그렸다. 훈련자료에서 인구의 표준편차는 \(3{,}509{,}387\), 소득은 \(7{,}639\), 백인 비율은 \(0.1252\)다. 곱해 보면 인구 \(-0.10\)달러, 소득 \(+5.26\)달러, 백인 비율 \(+4.01\)달러가 된다. 세 수가 이제 같은 단위(달러)에 있고 크기도 비슷하다. 그리고 순위가 뒤집힌다. 날것의 계수로는 백인 비율이 압도적으로 컸지만, 표준편차로 재면 소득이 가장 큰 효과를 갖는다.
\(t\) 값이 이 재척도화와 무관하다는 점도 함께 보아 두자. \(t_j = \hat\beta_j/\mathrm{SE}(\hat\beta_j)\)인데 변수의 단위를 바꾸면 분자와 분모가 같은 비율로 변하므로 비는 그대로다. 실제로 \(t\)는 인구 \(-0.05\), 소득 \(+2.41\), 백인 비율 \(+1.83\)으로, 1표준편차 효과의 순위와 일치한다. 인구는 계수가 \(0\)과 구별되지 않고(\(p = 0.961\)), 소득만 \(5\%\) 수준에서 유의하다. 그러므로 회귀표를 읽을 때의 규칙은 이렇다. 유의성은 \(t\)와 \(p\)로 읽고, 중요도는 표준편차당 효과로 읽는다. 계수 자체의 크기는 둘 중 어느 쪽도 말해 주지 않는다.
연습문제 19. 주별 예측오차 보기. 검정용 \(8\)개 주의 실제값·예측값·오차를 한 표로 늘어놓는다.
(1) 표의 여덟 오차에서 RMSE 를 손으로 계산해 연습문제 18의 \(10.32\) 와 맞추시오. 평균 오차를 재고, 그것이 \(0\) 이 아닌 것이 무엇을 뜻하는지 말하시오. \(\text{RMSE}^2\) 를 편향과 산포로 나누어 적으시오.
(2) 오차 하나가 \(+21.09\) 로 유난히 크다. 이 주 하나가 RMSE 에 얼마나 기여하는지 재고, 빼면 RMSE 가 얼마가 되는지 보시오. "평균 오차 하나만 보면 놓치는 것"이 구체적으로 무엇인가.
풀이
(1) 해석적으로. RMSE 는 오차의 이차 적률이므로 편향과 산포가 섞여 들어간다. 표본평균(sample mean) \(\bar e\) 와 표본분산(sample variance) \(s_e^2\) 로 쓰면
이다. 앞항이 편향의 제곱, 뒷항이 산포이다. 평균 오차가 \(0\) 이 아니면 모형이 시험자료에서 체계적으로 한쪽으로 빗나간다는 뜻이고, 그 몫이 RMSE 에 제곱으로 들어온다.
훈련자료에서는 최소제곱의 정규방정식이 \(\sum_i e_i = 0\) 을 보장하므로(A.4절 표집분포 (단순 최소제곱) 연습문제 8 이 그 두 제약을 유도한다) 편향이 정확히 \(0\) 이다. 시험자료에서는 그런 보장이 없다.
(2) 수치적으로.
# 주별로 실제값과 예측값을 나란히 놓아 어느 주에서 크게 빗나갔는지 본다.
# 평균 오차 하나만 보아서는 놓치는 것이 있다.
result = pd.DataFrame({
    'state': test['state'].values,
    'actual': test['HighQ'].values,
    'predicted': np.round(pred3.values, 2),
})
result['error'] = result['actual'] - result['predicted']
print(result.round(2).to_string(index=False))
출력:
   state  actual  predicted  error
state_03  250.27     246.82   3.45
state_08  256.90     249.80   7.10
state_15  268.43     256.34  12.09
state_22  257.06     252.26   4.80
state_29  237.86     232.26   5.60
state_34  258.80     237.71  21.09
state_41  254.95     258.07  -3.12
state_47  231.03     242.62 -11.59
검정용 8개 주의 실제값과 예측값이다. 오차가 \(-11.6\) 에서 \(+21.1\) 까지 흩어져 있다. 이제 이 여덟 수를 하나로 요약해 본다.
# 여덟 오차로 RMSE 를 손으로 계산하고, 편향과 극단값의 몫을 본다.
errors = result['error'].values
print(f"오차 = {np.round(errors, 2)}")
print(f"제곱합 = {np.sum(errors ** 2):.4f},  나누기 {len(errors)} = {np.mean(errors ** 2):.4f}")
print(f"제곱근 = {np.sqrt(np.mean(errors ** 2)):.4f}   (연습문제 18 의 RMSE = {rmse3:.4f})")
print()
print(f"평균 오차(편향) = {errors.mean():+.4f}")
print(f"오차의 표준편차   = {errors.std(ddof=1):.4f}")
print(f"평균 오차의 표준오차 = {errors.std(ddof=1) / np.sqrt(len(errors)):.4f}"
      f"   t = {errors.mean() / (errors.std(ddof=1) / np.sqrt(len(errors))):.4f}")
print(f"RMSE^2 = 편향^2 + (n-1)/n * 표준편차^2 = "
      f"{errors.mean() ** 2:.4f} + {(len(errors) - 1) / len(errors) * errors.var(ddof=1):.4f}"
      f" = {errors.mean() ** 2 + (len(errors) - 1) / len(errors) * errors.var(ddof=1):.4f}")
print()
worst = np.argmax(np.abs(errors))
print(f"가장 큰 오차: {result['state'].iloc[worst]}  오차 {errors[worst]:+.2f}")
print(f"  제곱합에서 차지하는 몫 = {errors[worst] ** 2 / np.sum(errors ** 2):.4f}")
print(f"  이 주를 빼면 RMSE = {np.sqrt(np.mean(np.delete(errors, worst) ** 2)):.4f}")
print(f"오차가 양수인 주 {np.sum(errors > 0)}개, 음수인 주 {np.sum(errors < 0)}개")
출력:
오차 = [  3.45   7.1   12.09   4.8    5.6   21.09  -3.12 -11.59]
제곱합 = 851.9593,  나누기 8 = 106.4949
제곱근 = 10.3196   (연습문제 18 의 RMSE = 10.3194)

평균 오차(편향) = +4.9279
오차의 표준편차   = 9.6930
평균 오차의 표준오차 = 3.4270   t = 1.4380
RMSE^2 = 편향^2 + (n-1)/n * 표준편차^2 = 24.2847 + 82.2102 = 106.4949

가장 큰 오차: state_34  오차 +21.09
  제곱합에서 차지하는 몫 = 0.5222
  이 주를 빼면 RMSE = 7.6257
오차가 양수인 주 6개, 음수인 주 2개
(1) 손계산과 연습문제 18의 값이 \(10.3196\) 대 \(10.3194\) 로 넷째 자리에서 어긋난다. 이 불일치에는 까닭이 있다. 표를 만들 때 np.round(pred3.values, 2) 로 예측값을 소수 둘째 자리로 반올림했기 때문이다. 표의 오차는 반올림된 예측값으로 계산된 것이고 연습문제 18의 RMSE 는 반올림하지 않은 값으로 계산된 것이다. 불일치 \(0.0002\) 가 반올림 오차 \(0.005\) 수준과 맞는다. 표에 찍힌 수로 다시 계산해 원래 값과 비교할 때는 반올림부터 확인해야 한다.
분해도 정확히 닫힌다. \(\text{RMSE}^2 = 106.4949\) 가 편향 제곱 \(24.2847\) 과 산포 \(82.2102\) 의 합이다. 편향이 전체의 \(22.8\%\) 를 차지한다.
평균 오차가 \(+4.93\) 이다. 여덟 주 가운데 여섯 곳에서 모형이 실제보다 낮게 예측했다. 훈련자료에서라면 이런 일이 있을 수 없다. 정규방정식이 \(\sum e_i = 0\) 을 강제하기 때문이다. 시험자료에서 편향이 생긴 것은 이 여덟 주가 우연히 평균보다 비싼 주들이었다는 뜻으로 읽어야 한다. 실제로 \(t = 4.9279/3.4270 = 1.44\) 로 유의하지 않다. \(8\) 개로는 편향이 체계적인지 우연인지 가릴 수 없다.
(2) state_34 하나가 제곱합의 \(52.2\%\) 를 차지한다. 여덟 개 가운데 하나가 절반을 넘게 가져간다. 이 주를 빼면 RMSE 가 \(10.32\) 에서 \(7.63\) 으로 \(26\%\) 떨어진다. RMSE 가 오차를 제곱해 더하기 때문이고, \(21.09\) 는 다른 오차들보다 두 배 이상 크다.
그러므로 "평균 오차 하나만 보면 놓치는 것"은 세 가지다. 첫째, 오차가 어느 쪽으로 치우쳤는가. RMSE \(10.32\) 만 보면 \(+4.93\) 의 편향이 보이지 않는다. 둘째, 그 오차가 고르게 퍼져 있는가 아니면 한 관측값에 몰려 있는가. 셋째, 어느 관측값이 문제인가. 세 번째가 실무에서 가장 값지다. state_34 를 지목할 수 있으면 그 주의 자료를 다시 들여다보거나 모형이 놓친 변수를 찾아볼 수 있다. 표를 늘어놓는 일은 요약값을 보완하는 것이 아니라 요약값이 가린 것을 되찾는 일이다. \(\square\)
연습문제 20. 관찰된 인구통계 자료로 주마다 대마초 가격을 무엇이 결정하는지 인과적 결론을 내리는 데 어떤 한계가 있는지 논하라. 어떤 교란 요인이 회귀계수를 편향시킬 수 있는가?
풀이
관찰자료의 회귀계수는 인과효과가 아니라 연관을 잰다. 있을 수 있는 교란 요인으로는 (1) 주별 대마초 법제(합법화 여부가 공급과 가격에 영향을 준다), (2) 생산지나 국경과의 근접성, (3) 도시/농촌 구성(인구통계와 가격 양쪽과 상관된다), (4) 단속 강도, (5) 생활비가 있다. 이런 측정되지 않은 변수들이 설명변수(소득, 인구통계)와 반응변수(가격) 모두와 상관되어 계수를 편향시킨다. 인과 분석을 하려면 도구변수, 이중차분법, 무작위 실험 같은 방법이 필요하다. \(\square\)
연습문제 21. 연습문제 19 에서 검정 오차의 평균이 \(\bar e = +4.9279\) 였고 분해가 \(\mathrm{RMSE}^2 = 106.4949 = 24.2847 + 82.2102\) 였다. 모형이 한쪽으로 치우쳤으니 예측값 전부에 상수 \(c\) 를 더해 \(\hat y_i + c\) 로 바꾸면 더 나아 보일 것이다.
(1) 새 RMSE 를 \(c\) 의 함수로 적고, 그것을 최소로 하는 \(c^\ast\) 와 그때의 RMSE 값을 연습문제 19 의 수치로 계산하시오.
(2) 그 값을 "이 모형의 검정 성능"으로 보고해도 되는가. 되지 않는다면, 같은 편향 보정을 정직하게 하려면 어떤 자료로 \(c\) 를 정해야 하고 그때 \(c\) 는 얼마가 되는가. 또한 참 편향이 \(0\) 인 모형에서도 이 장난이 RMSE 를 평균 몇 퍼센트 낮추는지 \(n_{\text{test}}\) 로 적으시오.
풀이
(1) 연습문제 19 의 분해를 \(c\) 에 대해 다시 하면 된다. 오차가 \(e_i - c\) 로 바뀌므로
이다. 뒷항은 \(c\) 와 무관하므로 \(c\) 에 대한 완전제곱식 하나만 남고, 최소는 \(c^\ast = \bar e = +4.9279\) 에서 난다. 그때 남는 것은 연습문제 19 의 산포 항뿐이다.
원래 \(10.3196\) 에서 \(9.0670\) 으로 \(12.1\%\) 내려간다. 제곱으로 재면 \(106.4949 \to 82.2102\) 로 \(22.8\%\) 다. 편향 항 \(24.2847\) 을 통째로 지운 것이니 당연하다.
(2) 보고할 수 없다. \(c^\ast\) 를 시험자료의 \(y\) 로 정했기 때문이다. 그 순간 여덟 주는 더 이상 남겨 둔 자료가 아니고 \(9.0670\) 은 검정오차가 아니라 훈련오차다. 실제로 \(c\) 를 더하는 것은 절편을 \(\hat\beta_0 + c\) 로 바꾸는 것이고, 절편 하나를 시험자료에 맞춰 적합한 것과 똑같다.
정직하게 하려면 \(c\) 를 훈련자료로 정해야 한다. 그런데 훈련자료에서는 최소제곱의 정규방정식이 \(\sum_i e_i = 0\) 을 강제하므로(연습문제 19 의 (1))
이다. 아무 일도 할 수 없다. 편향 보정은 훈련자료에서는 할 것이 없고 시험자료에서는 해서는 안 되는 일이다.
참 편향이 \(0\) 인 모형에서도 이 장난은 공짜로 이득을 준다. \(\operatorname{E}[\bar e^2] = \sigma_e^2/n_{\text{test}}\) 이므로
이고 \(n_{\text{test}} = 8\) 이면 MSE 가 평균 \(12.5\%\), RMSE 가 \(1 - \sqrt{0.875} = 6.5\%\) 내려간다. 자유모수 하나를 \(8\) 개 점에 맞췄으니 그만큼 돌려받는 것이다.
여기서 연습문제 19 의 편향을 다시 읽을 수 있다. 관측된 MSE 감소 \(22.8\%\) 는 공짜 몫 \(12.5\%\) 보다 크지만 두 배가 안 되고, 연습문제 19 가 이미 \(t = 1.44\) 로 유의하지 않다고 말했다. 편향이 참으로 있다고 볼 근거가 없고, 그것을 고쳐 얻은 \(9.07\) 은 성능이 아니라 \(8\) 개에 모수 하나를 더 맞춘 대가다. \(\square\)
연습문제 22. 연습문제 17 은 "참 모형을 정확히 적합해도 예측오차를 \(12\) 아래로 내릴 수 없다"고 했다. 그러나 적합은 참 계수가 아니라 \(42\) 개 주로 추정한 계수로 한다.
(1) 설계행렬 \(X\) 는 고정, \(\hat\beta\) 는 그 자료의 OLS 추정량이라 하고, 훈련에 쓰이지 않은 새 점 \((x_0, y_0)\) 를 생각하자. 모형이 옳을 때
임을 보이시오.
(2) 훈련자료의 평균 지렛값이 언제나 정확히 \(p/n\) 임을 쓰고, 검정점의 평균 지렛값을 그 값으로 근사하여 세 변수 모형의 검정 RMSE 가 겨냥하는 값을 \(n = 42\), \(p = 4\) 로 계산하시오. 실제로 여덟 검정 주의 평균 지렛값은 \(0.1371\) 이다. 이 값을 쓰면 얼마가 되며, 관측값 \(10.32\) 와 어긋나는가. 연습문제 2 에서 쓸모없는 변수 둘을 더 넣으면 이 값은 얼마가 되는가.
풀이
(1) 참 모형은 \(y_0 = x_0^\top\beta + \varepsilon_0\) 이고 \(\hat\beta = \beta + (X^\top X)^{-1}X^\top\varepsilon\) 이다. 여기서 \(\varepsilon\) 은 훈련자료의 오차벡터이고 \(\varepsilon_0\) 은 새 점의 오차다. 빼면
이다. \(x_0\) 가 훈련에 쓰이지 않았으므로 \(\varepsilon_0\) 과 \(\varepsilon\) 은 독립이고 둘 다 평균 \(0\) 이다. 그러므로 분산이 더해진다. 뒷항의 분산은 \(a = (X^\top X)^{-1}x_0\) 로 두면
이다. 합하면 \(\sigma^2 + \sigma^2 x_0^\top (X^\top X)^{-1}x_0\) 가 된다. \(\square\)
(2) 앞항 \(\sigma^2\) 는 줄일 수 없는 오차, 뒷항은 추정의 대가다. 훈련점의 지렛값에 대해서는 모자행렬 \(H = X(X^\top X)^{-1}X^\top\) 의 대각합이 \(\operatorname{tr}(H) = \operatorname{tr}\!\left((X^\top X)^{-1}X^\top X\right) = p\) 이므로 평균이 정확히 \(p/n\) 이다. 검정점도 비슷한 자리에 있다고 보면 겨냥하는 값은
이다. \(12\) 가 아니다. 연습문제 17 의 \(12\) 는 참 계수를 공짜로 안다고 할 때의 바닥이고, \(42\) 개로 네 모수를 추정하는 대가가 \(4.6\%\) 붙는다.
실제 검정 주의 평균 지렛값 \(0.1371\) 은 \(p/n = 0.0952\) 보다 \(44\%\) 크다. 이것이 요점이다. 검정점은 적합이 맞춰 준 점이 아니므로 평균적으로 훈련점보다 지렛값이 크다. 이 값을 쓰면
가 된다. 관측된 \(10.32\) 는 이보다 \(19.4\%\) 낮다. 어긋나는가. 연습문제 17 이 쓴 근사로 \(n_{\text{test}} = 8\) 에서 RMSE 의 상대 표준오차가 \(25\%\) 이므로 \(19.4\%\) 는 그 안쪽이고 불일치가 아니다. 운 좋은 여덟 주였을 뿐이다.
연습문제 2 처럼 percent_black 과 percent_hispanic 을 더 넣으면 \(p = 6\) 이 되어
이다. 두 변수의 참 계수가 정확히 \(0\) 이어도 바닥이 \(12.5584\) 에서 \(12.8285\) 로 올라간다. 연습문제 2 가 말로 한 "편향은 줄이지 못한 채 분산만 키운다"의 수치가 이것이다. 쓸모없는 변수 하나의 값은 \(\sigma^2/n\), 곧 이 자료에서 예측오차 분산의 \(1/42 = 2.4\%\) 씩이다. \(\square\)
연습문제 23. 연습문제 18 은 검정 RMSE 가 \(12.66\) 에서 \(10.32\) 로 줄어든 것을 "유의하다고 말할 수 없다"고 했다. 이 말을 수로 확인한다. \(50\) 개 주의 설명변수는 그대로 두고 오차 \(\varepsilon \sim N(0, 12^2)\) 만 \(4000\) 번 다시 뽑아, 그때마다 같은 \(42/8\) 분할로 (ㄱ) 인구만 쓴 모형과 (ㄴ) 세 변수 모형을 적합해 검정 RMSE 를 재라. 씨앗은 np.random.default_rng(0) 을 쓴다.
(1) 두 RMSE 의 제곱평균제곱근을 연습문제 22 의 공식값과 견주고, 상대 표준편차가 연습문제 17 의 근사 \(1/\sqrt{2n_{\text{test}}} = 0.25\) 와 맞는지 보시오. 인구만 쓴 모형에서는 편향 항이 더해지므로 공식을 그에 맞게 고쳐야 한다.
(2) 세 변수 모형이 인구만 쓴 모형보다 더 나쁘게 나오는 반복의 비율을 구하고, 관측된 비 \(10.3194/12.6631 = 0.8149\) 가 그 분포에서 어디에 놓이는지 말하시오.
풀이
설계를 고정하고 오차만 다시 뽑는다. 그러면 인구만 쓴 모형이 빠뜨린 소득·백인 비율의 몫은 잡음이 아니라 고정된 편향이 되고, 연습문제 22 의 공식에 그 항을 더해 주면 된다. 검정점 \(i\) 의 편향은 참 평균 \(\mu\) 를 훈련 열공간에 사영한 것과의 차이다.
# 참 모형에서 오차만 다시 뽑아 같은 42/8 분할로 두 모형을 반복 적합한다.
rng = np.random.default_rng(0)
cols = ["total_population", "per_capita_income", "percent_white"]
Xall = df[cols].to_numpy()
is_test = df["state"].isin(test_states).to_numpy()
mu = 190.24 - 1.2e-6 * Xall[:, 0] + 0.0009 * Xall[:, 1] + 18 * Xall[:, 2]


def design(which):
    return np.column_stack([np.ones(len(Xall)), Xall[:, which]])


def test_rmse(y, A):
    """A 를 설계행렬로 42 개 주로 적합하고 8 개 주에서 RMSE 를 잰다."""
    beta = np.linalg.lstsq(A[~is_test], y[~is_test], rcond=None)[0]
    return np.sqrt(np.mean((y[is_test] - A[is_test] @ beta) ** 2))


A1, A3 = design([0]), design([0, 1, 2])
B = 4000
r_uni, r_tri = np.empty(B), np.empty(B)
for b in range(B):
    y = mu + rng.normal(0, 12, len(Xall))
    r_uni[b] = test_rmse(y, A1)
    r_tri[b] = test_rmse(y, A3)


def exact(A):
    """고정 설계에서 E[검정 MSE] = sigma^2 (1 + h) + 편향^2 을 그대로 계산한다."""
    M = np.linalg.inv(A[~is_test].T @ A[~is_test])
    h = np.einsum("ij,jk,ik->i", A[is_test], M, A[is_test]).mean()
    bias = mu[is_test] - A[is_test] @ (M @ A[~is_test].T @ mu[~is_test])
    return h, np.sqrt(np.mean(bias ** 2)), np.sqrt(144 * (1 + h) + np.mean(bias ** 2))


print(f"{'모형':10s}{'RMSE 평균':>11s}{'제곱평균제곱근':>14s}{'상대 표준편차':>14s}"
      f"{'평균 지렛값':>12s}{'편향':>9s}{'이론값':>9s}")
for name, r, A in [("인구만", r_uni, A1), ("세 변수", r_tri, A3)]:
    h, bias, exact_rms = exact(A)
    print(f"{name:10s}{r.mean():11.4f}{np.sqrt(np.mean(r ** 2)):14.4f}"
          f"{r.std(ddof=1) / r.mean():14.4f}{h:12.4f}{bias:9.4f}{exact_rms:9.4f}")
print(f"근사한 상대 표준오차 1/sqrt(2n) = {1 / np.sqrt(2 * 8):.4f}")
print()
print(f"세 변수 쪽이 더 나쁜 비율 P(RMSE_3 > RMSE_1) = {np.mean(r_tri > r_uni):.4f}")
print(f"비 RMSE_3/RMSE_1 의 중앙값 = {np.median(r_tri / r_uni):.4f}"
      f"   5% 와 95% 분위 = {np.percentile(r_tri / r_uni, [5, 95]).round(4)}")
print(f"관측된 비 {rmse3 / rmse1:.4f} 의 분위 = {np.mean(r_tri / r_uni <= rmse3 / rmse1):.4f}")
출력:
모형            RMSE 평균       제곱평균제곱근       상대 표준편차      평균 지렛값       편향      이론값
인구만           14.8740       15.2928        0.2390      0.0557   9.1442  15.3506
세 변수          12.3261       12.7282        0.2576      0.1371   0.0000  12.7960
근사한 상대 표준오차 1/sqrt(2n) = 0.2500

세 변수 쪽이 더 나쁜 비율 P(RMSE_3 > RMSE_1) = 0.1710
비 RMSE_3/RMSE_1 의 중앙값 = 0.8190   5% 와 95% 분위 = [0.5766 1.2128]
관측된 비 0.8149 의 분위 = 0.4913
(1) 공식과 모의가 맞는다. 세 변수 모형은 편향이 \(0\)(참 모형이므로)이고 제곱평균제곱근 \(12.7282\) 가 연습문제 22 의 \(12.7960\) 과 \(0.5\%\) 안에서 일치한다. 평균 지렛값도 연습문제 22 에 적은 \(0.1371\) 이 그대로 나온다. 인구만 쓴 모형은 편향 \(9.1442\) 가 붙어 \(\sqrt{144 \times 1.0557 + 9.1442^2} = 15.3506\) 이 되고 모의가 \(15.2928\) 을 준다.
연습문제 17 의 이론값 \(14.0124\) 가 이보다 작은 데에는 두 까닭이 있다. 추정의 대가 \(\sqrt{1.0557}\) 이 \(2.7\%\) 를 보태고, 더 큰 몫은 이 여덟 주가 빠뜨린 신호가 큰 주들이라는 데서 온다. 표본 전체로 재면 빠뜨린 신호의 크기가 \(\sqrt{14.0124^2 - 144} = 7.2352\) 인데 검정 여덟 주에서는 \(9.1442\) 다. 검정 집합을 고정해 놓고 보면 이런 편향은 지워지지 않는다.
상대 표준편차는 \(0.2390\) 과 \(0.2576\) 으로 근사 \(0.25\) 를 잘 맞춘다. \(1/\sqrt{2n}\) 은 이 쪽에서 세 번 쓰였고 실제로 믿을 만하다. 참고로 RMSE 의 평균은 제곱평균제곱근보다 작다(\(12.3261 < 12.7282\)). 제곱근이 오목함수라서 생기는 차이이므로, 공식과 견줄 때는 제곱평균제곱근을 써야 한다.
(2) 세 변수 모형이 지는 일이 \(17.1\%\) 나 일어난다. 참 모형을 적합하는 쪽이 여섯 번에 한 번은 쓸모없는 단변량 모형보다 나쁘게 보인다는 뜻이다. 비의 \(5\%\)–\(95\%\) 범위가 \([0.577,\ 1.213]\) 로 \(1\) 을 한참 품고 있다.
그리고 관측된 비 \(0.8149\) 는 이 분포의 \(49\) 분위, 곧 중앙값 \(0.8190\) 바로 옆이다. 두 가지를 한꺼번에 말해 준다. 첫째, 연습문제 18 에서 본 개선은 전혀 이상하지 않은, 가장 흔한 크기다. 둘째, 그렇게 전형적인 개선조차 \(8\) 개로는 선언할 수 없다. 같은 세계를 다시 살면 \(17\%\) 의 확률로 반대 결론을 적었을 것이다. 검정 집합의 크기가 모형 비교의 해상도를 정한다. \(\square\)
연습문제 24. 연습문제 18 의 풀이는 "실제로 \(1 - 12.9413^2/13.5481^2 = 0.0876\) 인데 \(R^2\) 정의의 분모가 자유도 보정이 없는 쪽이라 \(0.1543\) 이 나온다"고 적었다. 이 \(0.0876\) 의 정체를 밝힌다.
(1) \(s^2 = \mathrm{RSS}/(n-p)\) 와 \(s_y^2 = \mathrm{TSS}/(n-1)\) 에 대해
임을 보이시오. 곧 연습문제 18 이 손으로 계산한 수는 수정 결정계수다. \(n = 42\), \(p = 4\), \(R^2 = 0.1543\) 으로 두 식이 모두 \(0.0876\) 을 주는지 확인하시오.
(2) 연습문제 18 은 훈련 \(R^2 = 0.1543\) 을 모집단 양 \(1 - \sigma^2/\operatorname{Var}(\text{HighQ}) = 0.3274\) 와 견주었다. \(R^2\) 와 \(R^2_{\text{adj}}\) 가운데 어느 쪽이 그 모집단 양을 겨냥하는가. 그 답을 쓰면 불일치는 커지는가 작아지는가. 불일치의 방향을 연습문제 17 의 어느 두 수치로 설명할 수 있는지 밝히고, 두 수치가 각각 몇 퍼센트 기여하는지 적으시오.
풀이
(1) \(R^2 = 1 - \mathrm{RSS}/\mathrm{TSS}\) 이므로 \(\mathrm{RSS}/\mathrm{TSS} = 1 - R^2\) 이다. 그대로 대입한다.
오른쪽이 수정 결정계수의 정의다. \(\square\)
수치로 맞춰 본다. 오른쪽은
이고 왼쪽은 \(1 - 12.9413^2/13.5481^2 = 1 - 167.4738/183.5513 = 0.0876\) 이다. 같다. 그러므로 연습문제 18 의 \(0.0876\) 은 \(R^2\) 를 잘못 계산한 수가 아니라 다른 통계량이며, statsmodels 가 rsquared_adj 로 내주는 바로 그 값이다.
(2) 모집단 양을 겨냥하는 것은 \(R^2_{\text{adj}}\) 다. 겨냥하는 수가
처럼 두 모분산의 비로 적혀 있으니, 분자와 분모를 각각 불편추정량으로 바꾼 \(1 - s^2/s_y^2\) 가 자연스러운 추정량이다. 반면 \(R^2 = 1 - \mathrm{RSS}/\mathrm{TSS}\) 는 분자에서 자유도를 \(p\) 만큼 깎지 않으므로 위로 치우친다. 그러므로 견주어야 할 짝은 \(0.0876\) 대 \(0.3274\) 이고, 불일치는 \(0.1543\) 대 \(0.3274\) 보다 더 커진다.
방향은 연습문제 17 의 두 수치로 완전히 설명된다. 비 \(s^2/s_y^2\) 가 겨냥하는 수는 \(\sigma^2/\operatorname{Var}(\text{HighQ}) = 144/14.6316^2 = 0.6726\) 인데 실제로는 \(167.4738/183.5513 = 0.9124\) 로 \(35.7\%\) 크다. 두 쪽이 같은 방향으로 밀었기 때문이다.
- 분자가 크게 나왔다. \(s = 12.9413\) 이 참 \(\sigma = 12\) 보다 \(7.8\%\) 크므로 분산으로는 \(12.9413^2/144 = 1.1630\), 곧 \(16.3\%\) 크다.
- 분모가 작게 나왔다. 관측 \(s_y = 13.5481\) 이 이론 \(14.6316\) 보다 \(7.4\%\) 작으므로 분산으로는 \(183.5513/214.0837 = 0.8574\), 곧 \(14.3\%\) 작다.
곱하면 \(1.1630/0.8574 = 1.3565\) 로 관측된 \(35.7\%\) 가 그대로 나온다. 두 불일치는 각각 \(11\%\) 남짓의 상대 표준오차 안쪽이라 따로 보면 아무 문제가 없는데(연습문제 17, 연습문제 18), 비를 만들면 불일치가 합쳐져 \(36\%\) 가 된다.
여기서 얻을 것은 이렇다. \(R^2\) 는 두 분산의 비이므로 분자와 분모의 표본변동이 모두 실려 들어온다. \(n = 42\) 에서 참값 \(0.33\) 을 두고 \(0.09\) 라는 점추정(point estimation)을 얻는 일이 아무렇지 않게 일어난다. 그러므로 작은 표본의 \(R^2\) 를 소수 넷째 자리까지 적고 모형의 설명력을 논하는 것은 있는 정보보다 많은 것을 말하는 일이다. \(\square\)
정리하며
설명변수가 여럿이면 행렬로 적는 편이 간결하다.
- 부록 A의 선형대수가 여기서 쓰인다. 설계행렬, 열공간, 사영, 모자 행렬이 모두 등장하며, 적합값 \(\hat{\mathbf y}=\mathbf H\mathbf y\) 가 \(\mathbf y\) 를 \(\mathrm{Col}(\mathbf X)\) 로 사영한 것이다.
- 계수의 해석이 달라진다. \(\beta_j\) 는 다른 설명변수를 고정한 채 \(x_j\) 가 1 늘 때의 변화이며, 단순회귀의 계수와 값이 다를 수 있다.
- \((\mathbf X^\top\mathbf X)^{-1}\) 이 존재해야 한다. 열이 일차종속이면 해가 유일하지 않으며, 거의 종속이면 다중공선성 문제가 된다.
- 설명변수를 더하면 \(R^2\) 은 반드시 오른다. 그래서 수정 \(R^2\) 이나 정보기준이 필요하다.
- 분산분석(analysis of variance)이 이 틀의 특수한 경우다. 범주형 설명변수를 더미로 바꾼 회귀가 곧 10장 분산분석이며, \(F\) 도 \(R^2\) 도 같은 수다.
다음 절 범주형 설명변수로 넘어간다. 도시 이름 같은 범주를 \(0,1,2\) 로 적어 넣으면 무슨 일이 생기는지부터 본다.