분석의 자유는 곱해진다
개요
들어가는 이야기 — 효과가 \(0\) 인데 셋에 둘이 유의하다
분석을 하다 보면 자료를 보고 나서 정하게 되는 것들이 있다. 결과변수를 둘 재어 두고 맞는 쪽을 쓰기, 유의하지 않으면 자료를 좀 더 모으기, 공변량을 넣었다 뺐다 하기, 조건 셋 가운데 둘만 보고하기. 어느 것도 고의로 나쁜 짓이 아니고, 자료를 조작하는 일은 더더욱 아니다.
그 자유가 얼마를 부풀리는지는 참 효과를 \(0\) 으로 못 박고 세어 보면 된다. 두 집단을 모두 같은 \(N(0,1)\) 에서 뽑아 \(t\) 검정을 한 번만 하면 유의하다고 나오는 비율이 \(0.0503\) 이다. 약속한 \(\alpha\) 그대로다. 같은 자료를 열 명씩 늘려 가며 스무 번 들여다보다가 \(p < 0.05\) 가 되는 순간 멈추면 그 비율이 \(0.2492\) 가 되고, 결과변수를 스무 개 재어 두고 가장 작은 \(p\) 하나만 보고하면 \(0.6580\) 까지 오른다.
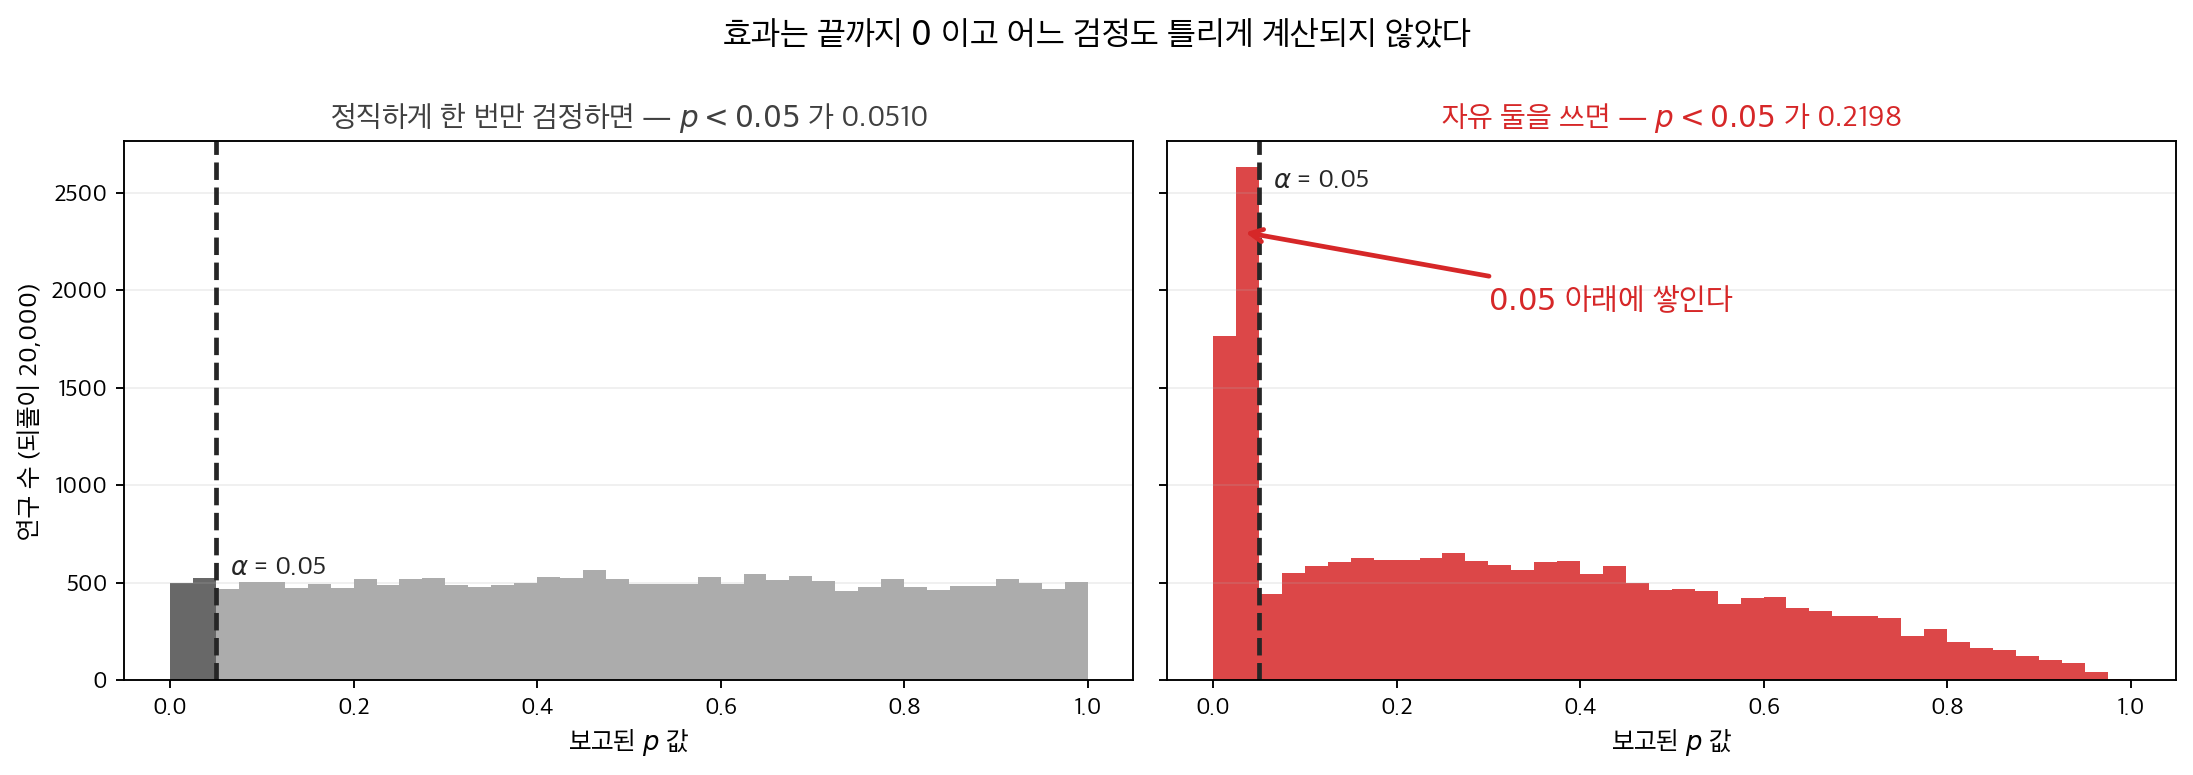
두 그림 모두 효과가 \(0\) 인 자료다. 왼쪽은 정직하게 한 번만 검정한 것으로 \(p\) 가 \([0,\ 1]\) 에 고르게 떨어지고 \(p < 0.05\) 가 \(0.0510\) — 약속한 그대로다. 오른쪽은 결과변수를 둘 재어 두고 열 명씩 늘려 가며 다섯 번 들여다보다 \(p < 0.05\) 가 되는 순간 멈춘 것인데, 그 비율이 \(0.2198\) 로 넷에 하나를 넘는다. 자유를 둘만 썼는데도 그렇다. 보고되는 \(p\) 값의 모양 자체가 달라진다는 것이 요점이다.
효과는 끝까지 \(0\) 이고, 검정 하나하나는 흠잡을 데가 없고, 버린 자료도 없다. \(p\) 값을 계산하는 방식은 아무것도 바뀌지 않았는데, 그러면 부풀어 오른 것은 무엇인가. 자료를 보고 나서 결정을 내릴 수 있도록 열려 있다는 것만으로 저만큼이 부푼다. 이 쪽은 그 팽창을 모의실험으로 재고, 어디서 보장이 깨지는지를 짚는다. 이 네 가지 자유만으로 음악을 들으면 어려진다는 결과를 학술지에 실어 보인 연구가 있다 — 아래 상자가 그 일을 따라간다.
p-해킹(p-hacking)은 연구자가 자료 수집과 분석의 유연성을 이용해, 실제로는 아무 효과가 없는 자료에서 통계적으로 유의한 결과를 얻어내는 일이다. 흔한 형태로는 여러 결과변수를 검정하고 유의한 것만 보고하기, \(p < 0.05\)가 되는 즉시 자료 수집을 멈추기, 부분집단이나 분석 방법을 골라 쓰기가 있다. 이 쪽에서는 이런 관행을 각각 모의실험하여 거짓 양성 비율이 명목 \(\alpha = 0.05\) 위로 얼마나 극적으로 부푸는지 보인다.
1.2절 자료 수집을 설계하라가 이것을 체리피킹이라 부르며 관찰연구의 함정으로 적어 두었다. 같은 것이다. 다만 여기서는 수로 본다.
앞 두 쪽과 뒤 세 쪽은 다른 일을 한다
9.6절 뒤의 가족단위 오류율·본페로니와 홀름 보정과 9.7절 ★ 거짓발견율 (Benjamini-Hochberg)은 \(m\) 을 알 때 쓰는 보정이다. 결과변수를 스무 개 미리 정해 두고 하나도 숨기지 않아도 거짓 양성은 생기고, 그때는 \(\alpha\) 를 나누면 된다.
이 쪽과 다음 쪽이 다루는 것은 \(m\) 을 모르는 경우다. 몇 번 시도했는지 보고되지 않으므로 나눌 분모가 없다. 그래서 처방이 통계가 아니라 사전등록이다 — 무엇을 몇 개 검정할지 자료를 보기 전에 적어 두는 것. 8.1절 해석과 흔한 오해 \(\S 2\) 의 「갈림길의 정원」이 같은 이야기를 구간 쪽에서 한다.
1. 정직한 검정, 귀무가설 아래에서
\(H_0\)이 참이고 수준 \(\alpha\)에서 검정하면 정확히 \(\alpha\)의 비율만 기각된다. p 값은 \(\text{Uniform}(0,1)\) 분포를 따른다.
보기 1. 정직한 검정의 기준선. 두 집단을 모두 같은 \(N(0,1)\)에서 30개씩 뽑아 이표본 \(t\) 검정을 하는 실험을 10,000번 반복한다. \(H_0\)이 참인 상황이다.
(1) \(H_0\) 아래에서 \(p\) 값의 분포를 쓰고, 유의하다고 나오는 실험의 개수가 따르는 분포와 그 기댓값·표준편차를 구하시오.
(2) 모의실험 결과가 (1)의 예측에서 몇 표준편차 떨어져 있는지 확인하시오. \(p\) 값의 사분위수(quartile)도 이론값과 견주시오.
풀이
(1) 해석적으로. \(p\) 값의 정의가 \(p = P(T \text{ 가 관측값만큼 또는 그보다 더 극단적} \mid H_0)\)이므로, \(T\)의 분포가 연속이면 \(H_0\) 아래에서
이다. 곧 \(p \sim \text{Uniform}(0,1)\)이다. 따라서 한 실험이 "유의"할 확률은 정확히 \(\alpha = 0.05\)이고, 실험이 독립이므로 유의한 개수 \(Y\)는
를 따른다. 비율로 보면 \(\text{SE} = 21.794/10000 = 0.002179\)다.
균등분포이므로 사분위수도 바로 나온다. \(Q_1 = 0.25\), 중앙값 \(= 0.50\), \(Q_3 = 0.75\)다.
(2) 수치적으로.
import numpy as np
from scipy import stats

np.random.seed(42)

n_experiments = 10_000
n_per_group = 30
pvals = np.zeros(n_experiments)

for i in range(n_experiments):
    a = np.random.normal(0, 1, n_per_group)
    b = np.random.normal(0, 1, n_per_group)
    _, pvals[i] = stats.ttest_ind(a, b)

# 두 집단 모두 같은 N(0,1)에서 뽑았으니 H0가 참인 상황이다.
# 그런데도 5%는 기각된다. 그것이 alpha의 정의다.
false_pos_rate = np.mean(pvals < 0.05)
print(f"False positive rate: {false_pos_rate:.4f}  (expected: 0.05)")

# (1) 의 예측과 견준다.
count = int(np.sum(pvals < 0.05))
mean_y = n_experiments * 0.05
sd_y = np.sqrt(n_experiments * 0.05 * 0.95)
print(f"유의한 개수 {count}  예측 {mean_y:.0f} +- {sd_y:.3f}"
      f"   거리 {(count - mean_y) / sd_y:+.3f} SD")

# p 값이 정말 균등한가.
print(f"\n사분위수  관측 {np.percentile(pvals, [25, 50, 75]).round(4)}"
      f"   이론 [0.25 0.5  0.75]")
print(f"평균 {pvals.mean():.4f} (이론 0.5)"
      f"   표준편차 {pvals.std(ddof=1):.4f} (이론 {1 / np.sqrt(12):.4f})")
ks = stats.kstest(pvals, "uniform")
print(f"균등성 KS 검정: D = {ks.statistic:.4f}, p = {ks.pvalue:.4f}")
출력:
False positive rate: 0.0508  (expected: 0.05)
유의한 개수 508  예측 500 +- 21.794   거리 +0.367 SD

사분위수  관측 [0.2527 0.5023 0.7477]   이론 [0.25 0.5  0.75]
평균 0.4996 (이론 0.5)   표준편차 0.2878 (이론 0.2887)
균등성 KS 검정: D = 0.0058, p = 0.8898
(1)의 예측이 전부 맞는다. 유의한 실험이 \(508\)개로 예측 \(500 \pm 21.8\)에서 0.37 표준편차밖에 떨어져 있지 않다. 사분위수는 소수점 둘째 자리까지 이론값과 같고, 표준편차도 균등분포의 \(1/\sqrt{12} = 0.2887\)을 재현한다. 균등성 콜모고로프–스미르노프(Kolmogorov–Smirnov, 출력의 KS) 검정의 \(p\) 값이 \(0.89\)라 균등성을 의심할 근거가 전혀 없다.
10,000번 중 508번이 "유의하다"고 나왔다. 정직하게 한 번만 검정하면 거짓 양성은 정확히 명목 수준에 머문다. 아래에서 무너지는 것은 이 전제다.
균등성이 왜 중요한가. \(p\) 값이 균등하다는 것은 "\(\alpha\)를 고르면 거짓 양성률이 정확히 \(\alpha\)"라는 약속의 내용 그 자체다. 아래 두 보기는 \(p\) 값의 계산을 바꾸지 않는다. 바꾸는 것은 어느 \(p\) 값을 보고할지 고르는 규칙이고, 그 순간 보고되는 값은 더 이상 균등하지 않다.
2. 여러 결과변수 중 골라 쓰기
연구자가 독립인 결과변수 \(k\)개를 검정하고 가장 작은 p 값만 보고하면, \(H_0\) 아래에서 "유의한" 결과를 적어도 하나 찾을 확률은
\(k = 20\) 이고 \(\alpha = 0.05\) 이면 이렇게 된다.
거짓 양성 비율이 5%에서 64%로 뛴다.
보기 2. 결과변수를 여러 개 재기. 효과가 전혀 없는 결과변수 \(k = 20\)개를 각각 검정하고 가장 작은 \(p\) 값 하나만 보고한다.
(1) 보고되는 \(\min(p_1,\dots,p_k)\)가 따르는 분포를 쓰고, 그 기댓값·중앙값과 \(P(\min < 0.05)\)를 구하시오.
(2) 1,000번 모의실험한 결과가 (1)의 예측에서 몇 표준편차 떨어져 있는지 확인하시오.
풀이
(1) 해석적으로. 보기 1에서 보았듯 \(H_0\) 아래에서 \(p_i \sim \text{Uniform}(0,1)\)이고 20개가 독립이다. 최솟값의 분포는 여집합으로 구한다.
이것이 \(\text{Beta}(1, k)\)의 누적분포함수다. 따라서
이고 중앙값은 \(1-(1-u)^k = 1/2\)에서
이다. 보고되는 \(p\) 값의 중앙값이 \(0.034\)다. 균등분포라면 \(0.5\)였을 자리다. 그리고
다. 1,000번 반복하면 유의하다고 나오는 횟수는 \(\text{Bin}(1000,\ 0.641514)\)를 따르고
이다.
(2) 수치적으로.
n_outcomes = 20
min_pvals = np.zeros(1000)

for i in range(1000):
    ps = []
    for _ in range(n_outcomes):
        a = np.random.normal(0, 1, 30)
        b = np.random.normal(0, 1, 30)
        _, p = stats.ttest_ind(a, b)
        ps.append(p)
    min_pvals[i] = min(ps)

# 20개를 검정하고 그중 **가장 작은** p 값만 보고하는 상황을 흉내 낸다.
phack_rate = np.mean(min_pvals < 0.05)
print(f"Cherry-pick rate: {phack_rate:.4f}  (theoretical: 0.6415)")

# (1) 의 예측과 견준다.
k = n_outcomes
theory = 1 - 0.95 ** k
cnt = int(np.sum(min_pvals < 0.05))
sd = np.sqrt(1000 * theory * (1 - theory))
print(f"유의한 횟수 {cnt}  예측 {1000 * theory:.1f} +- {sd:.3f}"
      f"   거리 {(cnt - 1000 * theory) / sd:+.3f} SD")
print(f"min p 의 평균   {min_pvals.mean():.6f}  이론 1/(k+1) = {1 / (k + 1):.6f}")
print(f"min p 의 중앙값 {np.median(min_pvals):.6f}"
      f"  이론 1-2^(-1/k) = {1 - 2 ** (-1 / k):.6f}")
출력:
Cherry-pick rate: 0.6580  (theoretical: 0.6415)
유의한 횟수 658  예측 641.5 +- 15.165   거리 +1.087 SD
min p 의 평균   0.045322  이론 1/(k+1) = 0.047619
min p 의 중앙값 0.033638  이론 1-2^(-1/k) = 0.034064
(1)의 세 예측이 모두 확인된다. 유의한 횟수 \(658\)이 예측 \(641.5 \pm 15.2\)에서 1.09 표준편차이고, 최솟값의 평균 \(0.045322\)와 중앙값 \(0.033638\)이 이론값 \(0.047619\), \(0.034064\)와 소수점 둘째 자리까지 맞는다.
거짓 양성 비율이 \(5\%\)에서 \(66\%\)로 뛴다. 실제로 아무 효과도 없는데 세 번에 두 번은 "유의한 결과"를 손에 쥔다는 뜻이다. 모의실험이 1,000회뿐이라 표준오차가 \(1.5\)%p 정도이므로 \(0.658\)은 이론값 \(0.6415\)와 어긋나지 않는다.
여기서 결정적인 것은 20개를 검정했다는 사실 자체가 아니라 그중 하나만 보고한다는 점이다. 20개를 모두 보고하고 보정했다면 문제가 없다. 보고되는 수의 분포가 \(\text{Uniform}(0,1)\)에서 \(\text{Beta}(1,20)\)으로 바뀌었는데도 독자는 여전히 균등분포를 가정하고 읽는 것, 그것이 \(p\)-해킹의 정체다.
3. 임의 중단
또 다른 형태의 p-해킹은 자료를 모으는 동안 반복해서 들여다보다가 \(p < 0.05\)가 되는 즉시 멈추는 것이다. 이것을 임의 중단(optional stopping)이라 한다. 각각의 들여다보기가 타당한 검정을 쓰더라도 순차적인 엿보기가 전체 거짓 양성 비율을 부풀린다.
보기 3. 임의 중단. 집단당 10명씩 자료를 늘려 가며 200명이 될 때까지 스무 번 \(p\) 값을 들여다보고, \(p < 0.05\)가 되는 즉시 멈춘다. 두 집단은 여전히 같은 분포에서 나온다.
(1) 이 절차의 거짓 양성률이 어느 범위에 있어야 하는지 위아래 한계를 말하시오. 왜 독립인 검정 20개의 값에 못 미치는가.
(2) 1,000번 모의실험한 \(0.2380\)이 믿을 만한 값인가. 반복 횟수를 크게 늘려 더 정확한 기준값을 구하고, 엿본 횟수에 따라 어떻게 오르는지 보시오.
풀이
(1) 해석적으로. 닫힌 꼴이 없는 문제다. 그러나 두 한계는 분명하다.
아래 한계는 \(\alpha = 0.05\)다. 거짓 양성률은 적어도 첫 번째 엿보기에서 기각할 확률만큼은 되고, 그것이 \(0.05\)다. 엿보기를 더 하는 것이 기각 사건을 줄일 수는 없으므로 전체 확률은 \(0.05\) 이상이다.
위 한계는 \(1-(1-\alpha)^{20} = 0.6415\)다. 적어도 한 번 기각할 확률은 합집합 한계(부울 부등식)에 의해 개별 확률의 합 \(20 \times 0.05 = 1\) 이하인데, 이것은 아무 내용이 없는 한계다. 더 날카로운 기준은 스무 번이 독립일 때의 값 \(0.6415\)이고, 엿보기들이 서로 양의 상관을 가지므로 실제 값은 이보다 작다.
왜 작은가. 연이은 엿보기는 앞의 자료를 그대로 포함한다. \(n = 10\)에서 쓴 10명이 \(n = 20\)의 자료 안에 다 들어 있으므로 두 검정통계량(test statistic)은 강하게 양의 상관을 갖는다. 서로 비슷한 검정을 스무 번 하는 것은 서로 다른 검정을 스무 번 하는 것보다 새로운 기회를 훨씬 적게 준다. 극단적으로 상관이 1이면 스무 번이 한 번과 같아 \(0.05\)에 머물 것이다. 실제는 그 사이 어딘가다.
그러므로 답은 \(0.05\)와 \(0.6415\) 사이이고, 정확한 값은 수치로 구할 수밖에 없다.
(2) 수치적으로. 1,000번은 적다. 관측값 \(0.2380\)의 표준오차는 \(\sqrt{0.238 \times 0.762/1000} = 0.0135\)이므로 95% 구간이 \((0.211,\ 0.265)\)로 폭이 \(5\)%p를 넘는다. 반복을 100,000번으로 늘려 기준값을 다시 잡는다. 느린 이중 반복문 대신 누적합으로 통계량을 한꺼번에 계산한다.
n_experiments = 1000
n_max = 200
check_interval = 10

stopped_pvals = []
for _ in range(n_experiments):
    a, b = [], []
    for n in range(check_interval, n_max + 1, check_interval):
        a.extend(np.random.normal(0, 1, check_interval).tolist())
        b.extend(np.random.normal(0, 1, check_interval).tolist())
        _, p = stats.ttest_ind(a, b)
        if p < 0.05:
            stopped_pvals.append(p)
            break
    else:
        stopped_pvals.append(p)

# for-else 구문이다. break 없이 반복이 끝나면 else가 실행된다.
# 즉 20번을 다 엿봐도 유의하지 않았던 경우에는 마지막 p 값을 기록한다.
stop_rate = np.mean(np.array(stopped_pvals) < 0.05)
print(f"Optional stopping rate: {stop_rate:.4f}")

# 반복을 10만 번으로 늘려 기준값을 다시 잡는다.
# 반복문 대신 누적합으로 모든 엿보기의 t 통계량을 한꺼번에 만든다.
def stopping_rate(B, n_looks, step=10, alpha=0.05, seed=0):
    """step 명씩 n_looks 번 엿볼 때 '한 번이라도 기각'할 비율."""
    rng = np.random.default_rng(seed)
    n_max = step * n_looks
    a = rng.normal(0, 1, (B, n_max))
    b = rng.normal(0, 1, (B, n_max))
    ca, cb = np.cumsum(a, 1), np.cumsum(b, 1)
    ca2, cb2 = np.cumsum(a * a, 1), np.cumsum(b * b, 1)
    rejected = np.zeros(B, dtype=bool)
    for n in range(step, n_max + 1, step):
        i = n - 1
        ma, mb = ca[:, i] / n, cb[:, i] / n
        va = (ca2[:, i] - n * ma ** 2) / (n - 1)
        vb = (cb2[:, i] - n * mb ** 2) / (n - 1)
        t = (ma - mb) / np.sqrt((va + vb) / 2 * 2 / n)
        rejected |= 2 * stats.t.sf(np.abs(t), 2 * n - 2) < alpha
    return rejected.mean()

B = 100_000
print(f"\n{'엿본 횟수':>8} {'거짓 양성률':>11} {'SE':>8} {'독립이라면':>10}")
for L in (1, 2, 5, 10, 20):
    r = stopping_rate(B, L)
    print(f"{L:>8} {r:>11.4f} {np.sqrt(r * (1 - r) / B):>8.4f}"
          f" {1 - 0.95 ** L:>10.4f}")
출력:
Optional stopping rate: 0.2380

   엿본 횟수      거짓 양성률       SE      독립이라면
       1      0.0503   0.0007     0.0500
       2      0.0841   0.0009     0.0975
       5      0.1426   0.0011     0.2262
      10      0.1944   0.0013     0.4013
      20      0.2492   0.0014     0.6415
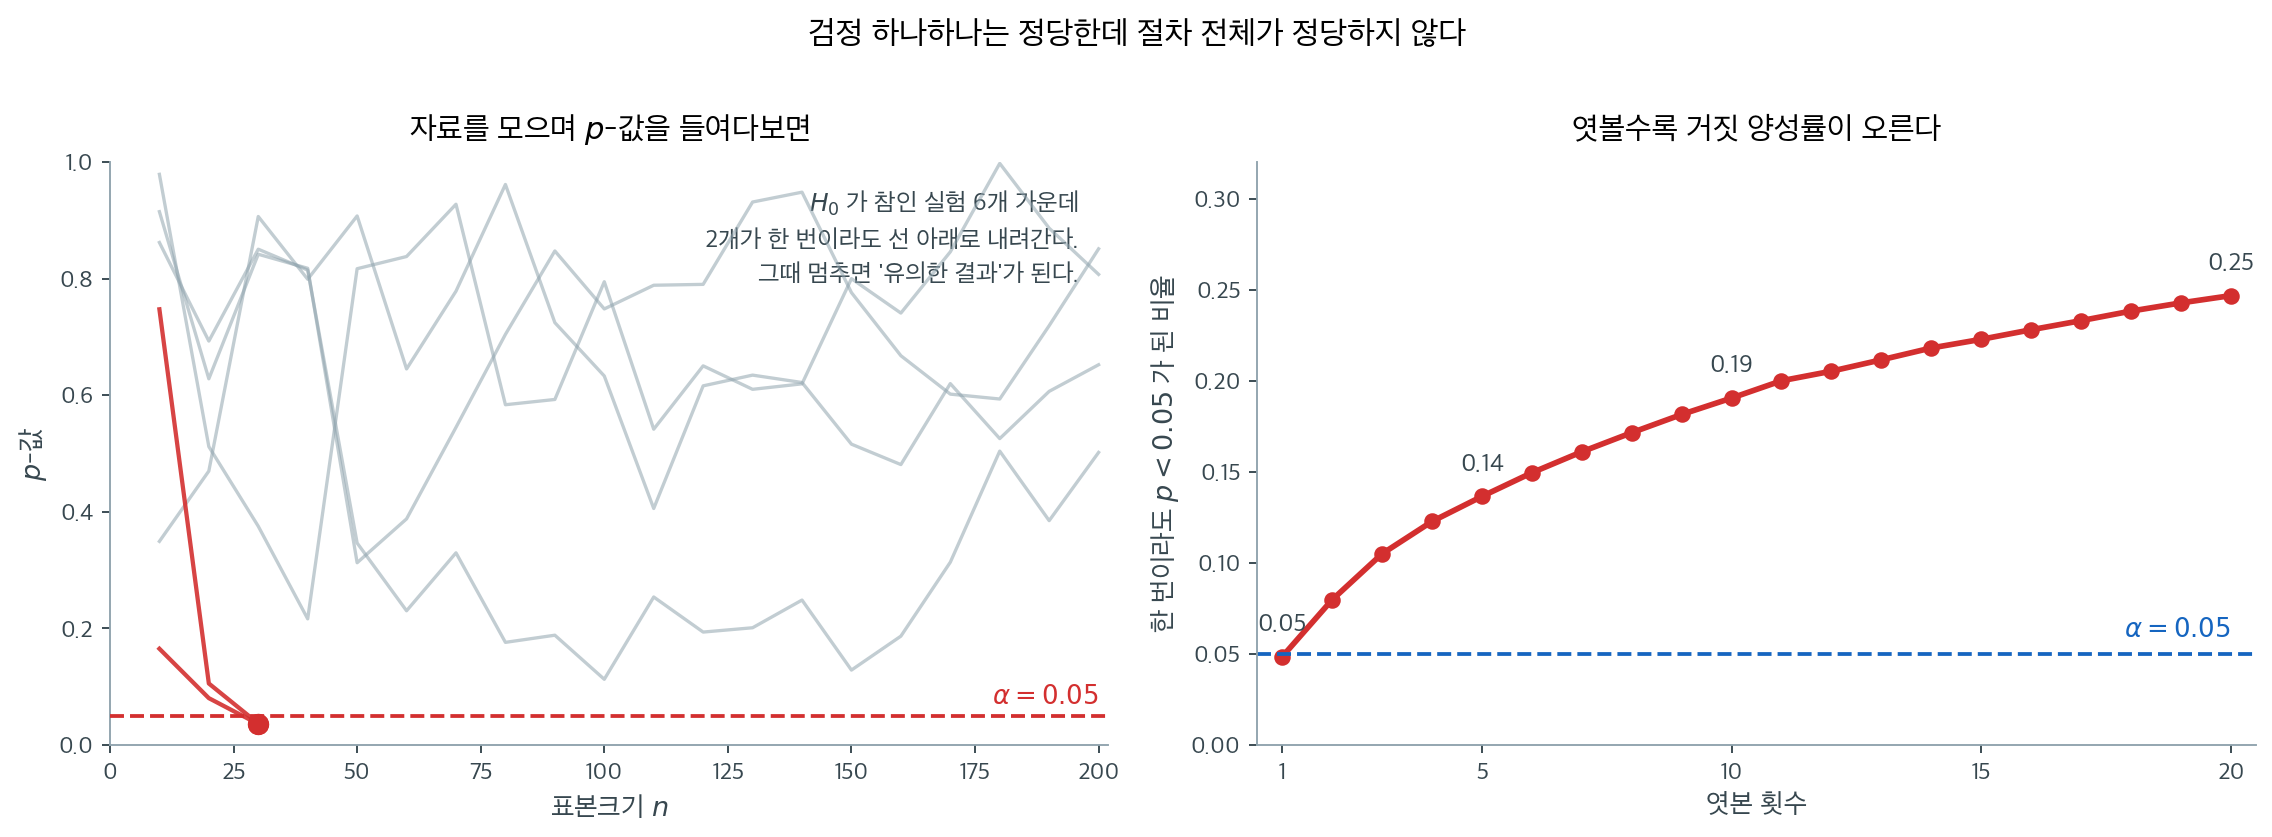
(1)의 두 한계가 지켜진다. 스무 번 엿본 거짓 양성률이 \(0.2492 \pm 0.0014\)로 아래 한계 \(0.05\)보다 훨씬 크고 위 한계 \(0.6415\)보다 훨씬 작다. 한 번만 엿보는 경우는 \(0.0503\)으로 명목 \(\alpha\)를 그대로 재현하므로 이 구현이 맞다는 것도 확인된다.
1,000번으로 얻은 \(0.2380\)은 기준값 \(0.2492\)에서 \(0.83\) 표준오차 떨어져 있다. 어긋난 것이 아니라 거칠었던 것이고, 10만 번으로 늘리자 표준오차가 \(0.0135\)에서 \(0.0014\)로 열 배 줄었다.
역시 두 집단이 같은 분포에서 나온 자료인데 4분의 1이 "유의하다"고 나온다. 각각의 검정은 완전히 정당했고 어떤 자료도 버리지 않았다는 점이 이 보기를 불편하게 만든다. 문제는 오직 언제 멈출지를 자료를 보고 정했다는 데 있다. 임상시험에서 중간분석을 할 때 알파 소비 함수(alpha spending function) 같은 형식적 절차를 반드시 쓰는 이유가 이것이다.
그림의 왼쪽은 \(H_0\)이 참인 실험 여섯 개의 \(p\) 값이 자료를 모으는 동안 어떻게 움직이는지 그린 것이다. \(p\) 값은 \(n\)이 커질수록 작아지는 양이 아니다. 효과가 없으면 위아래로 떠다닐 뿐이며, 그러다 보면 어느 순간 우연히 \(0.05\) 아래를 지나간다. 붉은 점이 그 순간이고, 거기서 멈추면 "유의한 결과"가 손에 들어온다.
오른쪽이 그 대가이며 위 표의 거짓 양성률 열을 그린 것이다. 한 번만 보면 \(0.05\)이지만 열 번 엿보면 \(0.19\), 스무 번이면 \(0.25\)가 된다. 각각의 \(t\) 검정은 흠잡을 데가 없고 자료를 버리지도 않았다. 부풀린 것은 검정이 아니라 멈추는 규칙이다.
독립이라면 열과 견주면 (1)에서 말한 상관의 효과가 수로 보인다. 엿보기가 독립이라면 스무 번에 \(0.6415\)여야 하는데 실제는 \(0.2492\)로 절반도 안 된다. 연이은 엿보기가 앞의 자료를 그대로 포함해 강하게 상관되어 있기 때문이다. 그래도 \(0.05\)의 다섯 배다. 상관이 있다고 해서 부풀려지는 것을 막지는 못한다는 점이 요점이다.
4. 보정이 무엇을 되돌리는가
앞 절이 자유를 쓰면 거짓 양성이 어디까지 불어나는지 세었다. 보정은 그것을 되돌리는 일이고, 되돌리려는 값이 얼마인지부터 알아야 한다. 아래 표가 셋을 나란히 놓는다.
| 방법 | 기대 거짓 양성 비율 |
|---|---|
| 정직한 단일 검정 | \(\alpha = 0.05\) |
| 결과변수 20개 중 선택하기 | \(\approx 0.64\) |
| 임의 중단 (20번 엿보기) | \(0.2492\) |
핵심 교훈은 \(\alpha = 0.05\)가 제1종 오류율을 통제하는 것은 자료를 보기 전에 분석 계획이 고정되어 있을 때뿐이라는 점이다. 결과변수, 중단 규칙, 부분집단을 사후에 고르는 어떤 유연성도 참 오류율을 부풀리며, 때로는 극적으로 그렇다.
해법으로는 분석 계획의 사전등록, 다중비교(multiple comparisons) 보정(본페로니와 홀름 보정·거짓발견율), 중간분석을 형식적으로 반영하는 순차검정 방법(알파 소비 함수)이 있다. 보정이 무엇을 통제하는지 — 적어도 하나를 잘못 기각할 확률인가, 기각한 것 가운데 틀린 비율인가 — 를 가르는 것은 가족단위 오류율이다.
그림으로 보는 통계학 1. 비틀스를 들으면 어려진다
위 표의 두 줄은 모두 극단적인 보기다. 결과변수를 스무 개 재어 두거나 스무 번 엿보는 것은 누가 보아도 과하다. 그래서 읽고 나서 「나는 저렇게까지는 안 한다」고 생각하기 쉽다.
시먼스·넬슨·시몬손이 2011 년에 『거짓양성 심리학』에서 보인 것이 바로 그 안심이 틀렸다는 것이다. 그들은 논문의 첫 실험에서 비틀스의 「When I'm Sixty-Four」를 들은 사람들이 대조군보다 한 살 반 어려졌다고 보고했다. \(p = 0.04\) 였다. 사람이 음악을 듣고 어려질 수 없으므로 이것은 거짓양성이고, 그들은 그것이 거짓양성임을 알면서 그렇게 썼다.
자료를 조작하지는 않았다. 그때 누구나 쓰던 분석의 자유를 네 가지 썼을 뿐이다.
- A --- 결과변수를 둘 재어 두고 맞는 쪽을 보고한다
- B --- 유의하지 않으면 자료를 좀 더 모아 다시 본다
- C --- 성별을 공변량으로 넣었다 뺐다 한다
- D --- 조건 셋 중 둘만 보고한다
하나하나는 작다. 논문 심사에서 지적받지도 않던 것들이다. 그래서 네 가지를 각각, 그리고 함께 썼을 때 어떻게 되는지를 직접 재 보았다. 참 효과는 \(0\) 으로 두었다.
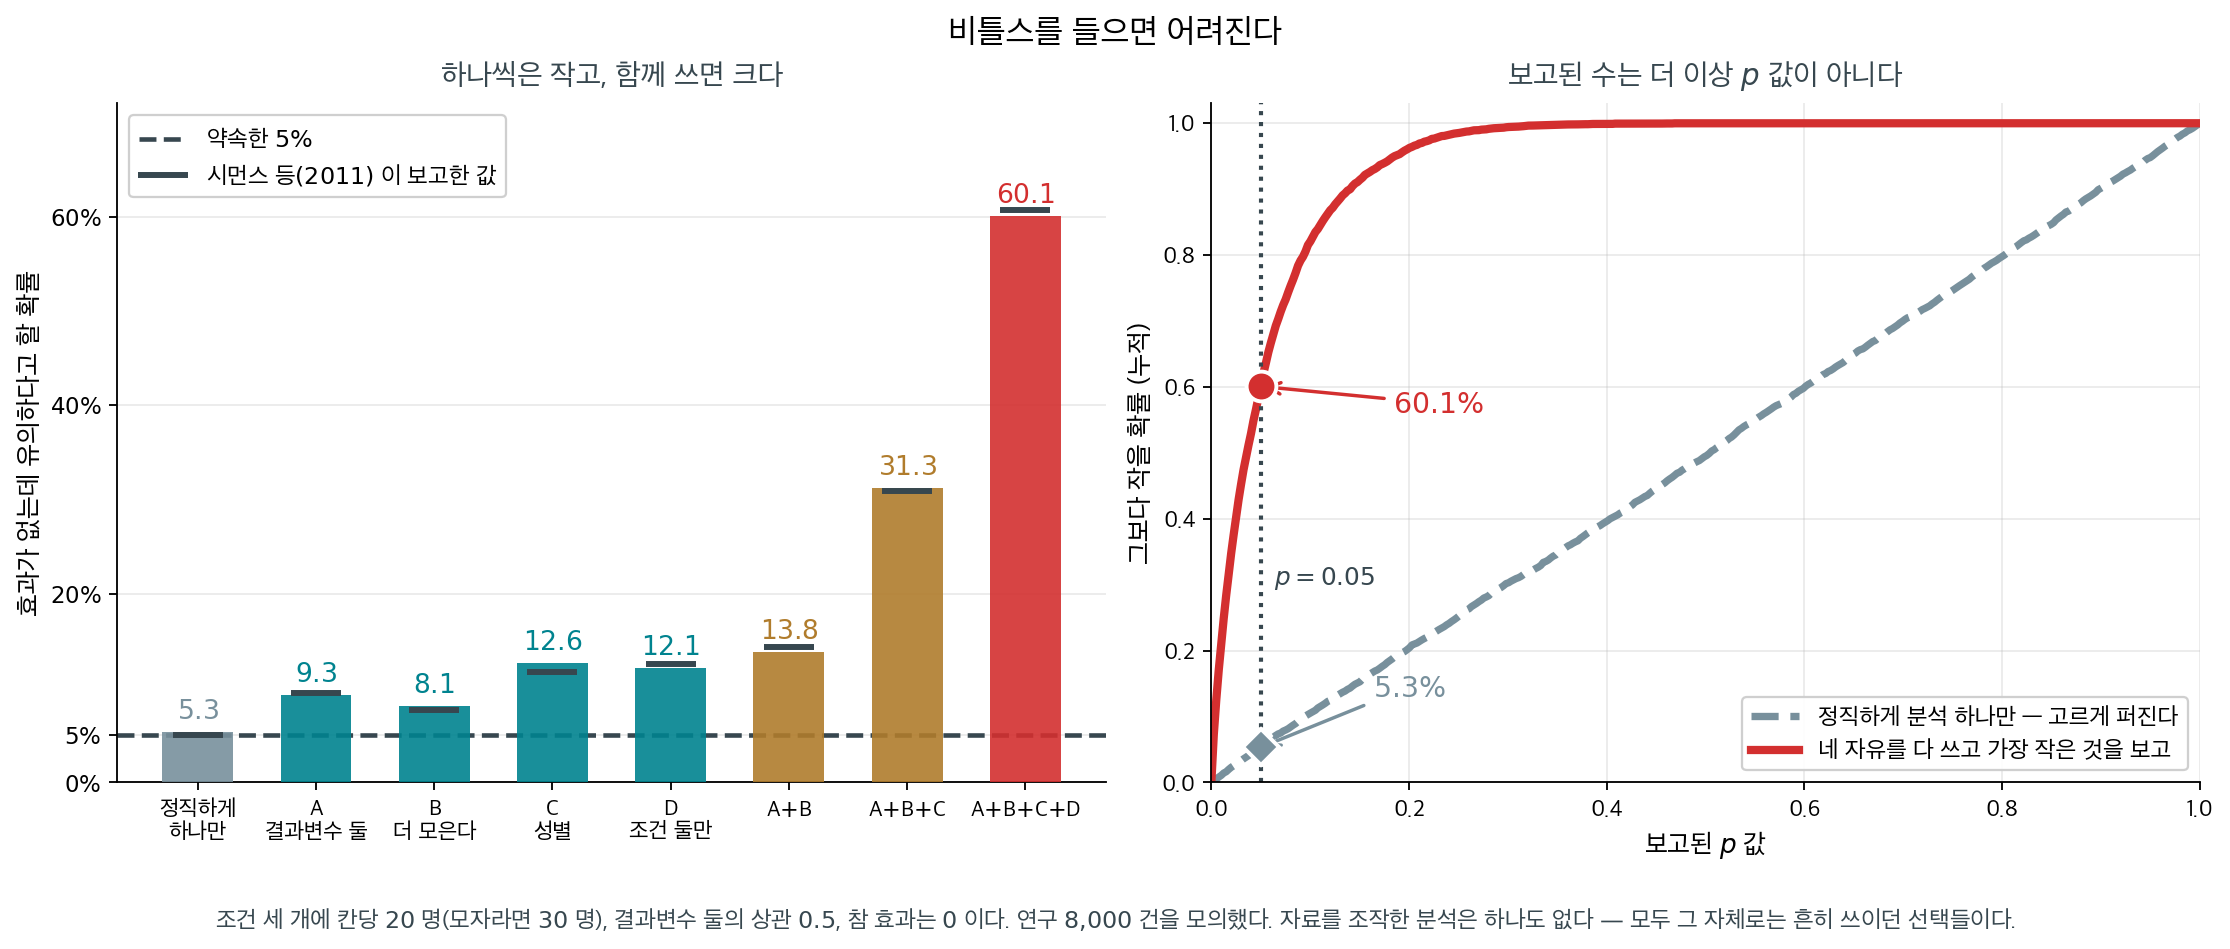
연구 \(8{,}000\) 건을 모의했다. 가로의 검은 짧은 선이 시먼스 등\((2011)\) 이 보고한 값이다.
| 분석의 자유 | 이 쪽의 모의 | 시먼스 등\((2011)\) |
|---|---|---|
| 정직하게 하나만 | \(0.053\) | \(0.050\) |
| A 결과변수 둘 | \(0.093\) | \(0.095\) |
| B 모자라면 더 모은다 | \(0.081\) | \(0.077\) |
| C 성별을 넣었다 뺐다 | \(0.126\) | \(0.117\) |
| D 조건 셋 중 둘만 | \(0.121\) | \(0.126\) |
| A\(+\)B | \(0.138\) | \(0.144\) |
| A\(+\)B\(+\)C | \(0.313\) | \(0.309\) |
| A\(+\)B\(+\)C\(+\)D | \(\mathbf{0.601}\) | \(\mathbf{0.607}\) |
따로따로는 \(8\%\) 에서 \(13\%\) 사이다. \(5\%\) 보다 크긴 해도 놀랄 만한 수는 아니다. 그런데 넷을 함께 쓰면 \(0.601\) 이다. 스무 번에 한 번이 아니라 열 번에 여섯 번이다.
더해지는 것이 아니라 곱해지기 때문이다. 결과변수 둘에, 표본 크기 둘에, 공변량 쓰는 법 다섯에, 조건 짝 셋이면 고를 수 있는 분석이 \(60\) 가지다. 그중 가장 작은 \(p\) 를 보고하는 순간, 보고된 수는 \(p\) 값이기를 그만둔다. 오른쪽 그림이 그것이다. 정직한 \(p\) 는 \(0\) 과 \(1\) 사이에 고르게 퍼져 대각선을 그리지만, 골라 낸 쪽은 \(0\) 근처로 짜부라져 있다.
이 논문이 바꾼 것은 결론이 아니라 관행이다. 「연구자의 자유도」와 「\(p\)-해킹」이라는 말이 여기서 퍼졌고, 사전등록이 표준이 되기 시작했다. 그리고 요점은 사람이 아니다 — 위 네 가지 가운데 고의로 나쁜 짓을 하는 것은 하나도 없다. 자료를 보고 나서 결정을 내릴 수 있도록 열려 있다는 것, 그것만으로 \(5\%\) 가 \(60\%\) 가 된다.
확인한 곳 — 시먼스·넬슨·시몬손의 「False-Positive Psychology」(『Psychological Science』, \(2011\))와 그 첫 실험 — 「When I'm Sixty-Four」를 들은 쪽이 「Kalimba」를 들은 쪽보다 생년월일 기준으로 한 해 반 가까이 젊게 나왔고(\(20.1\) 세 대 \(21.5\) 세) \(F_{1,17} = 4.92\), \(p = .040\) 이었다는 것. 네 가지 자유도의 거짓양성률은 모두 직접 모의실험한 값이다
연습문제
연습문제 1. \(\alpha = 0.05\)에서 \(H_0\) 아래 "유의한" 결과를 적어도 하나 찾을 확률이 90%를 넘으려면 연구자가 독립인 결과변수를 몇 개나 두고 골라야 하는가?
풀이
\(1 - 0.95^k > 0.90\), 즉 \(0.95^k < 0.10\)이어야 한다. 로그를 취하면 이렇게 된다.
따라서 \(k \geq 45\)개면 충분하다. 귀무가설(null hypothesis) 아래에서 독립인 변수 45개를 검정하면 \(\alpha = 0.05\)에서 거짓 양성이 적어도 하나 나올 확률이 90%를 넘는다. \(\square\)
연습문제 2. \(H_0\) 아래 독립인 p 값에 대해 공식 \(P(\min(p_1, \ldots, p_k) < \alpha) = 1 - (1 - \alpha)^k\)을 유도하라. 어떤 가정이 결정적인가?
풀이
\(H_0\) 아래에서 각 \(p_i \sim \text{Uniform}(0,1)\)이다. 최솟값이 \(\alpha\)를 넘으려면 모든 p 값이 \(\alpha\)를 넘어야 한다.
여집합을 취하면,
결정적인 가정은 p 값의 독립성(independence)이다. 결과변수들이 상관되어 있으면(예: 측정이 겹치면) 실제 확률이 이 공식이 예측하는 것보다 낮을 수 있다. \(\square\)
연습문제 3. 연속인 검정통계량에서 \(H_0\) 아래 p 값 분포가 \(\text{Uniform}(0,1)\)인 이유를 설명하라. 검정통계량이 이산이면 어떻게 되는가?
풀이
\(H_0\) 아래 누적분포함수(cumulative distribution function)가 \(F_0\)인 연속 검정통계량 \(T\)에서 p 값은 \(p = 1 - F_0(T)\)(양측검정(two-sided test)이면 \(2\min(F_0(T), 1-F_0(T))\))이다. \(F_0\)이 참 누적분포함수이면 확률적분변환(probability integral transform, 연속 확률변수를 자기 누적분포함수에 넣으면 균등분포가 된다는 사실)에 의해 \(F_0(T) \sim \text{Uniform}(0,1)\)이므로 \(p \sim \text{Uniform}(0,1)\)이다.
이산 검정통계량에서는 누적분포함수가 계단함수이므로 \(F_0(T)\)가 유한개의 값만 취한다. 그러면 p 값 분포가 \(\text{Uniform}(0,1)\)보다 확률적으로 크다(큰 값 쪽으로 몰려 있다). 곧 모든 \(\alpha\)에 대해
이고, 대부분의 값에서 부등호가 엄격하다. 그래서 이산검정이 보수적이 된다. \(\square\)
연습문제 4. 연구자가 (10개마다가 아니라) 새 관측값이 하나 생길 때마다 확인하도록 임의 중단 모의실험을 고쳐라. 거짓 양성 비율에 어떤 영향을 주는가?
풀이
stopped = []
for _ in range(1000):
    a, b = [], []
    for n in range(2, 201):  # need at least 2 per group
        a.append(np.random.normal(0, 1))
        b.append(np.random.normal(0, 1))
        if len(a) >= 2:
            _, p = stats.ttest_ind(a, b)
            if p < 0.05:
                stopped.append(p)
                break
    else:
        stopped.append(p)
rate = np.mean(np.array(stopped) < 0.05)
print(f"Rate with every-observation peeking: {rate:.4f}")
출력:
Rate with every-observation peeking: 0.4350
관측값마다 확인하면 엿보기 횟수가 최대가 되어 거짓 양성 비율도 가장 높아진다. 10개마다 엿보던 24%가 매 관측값마다 엿보자 44%로 오른다. 명목 5%의 아홉 배다.
이론적으로는 표본을 무한정 늘릴 수 있다면 이 비율이 1에 다가간다. 계속 엿보다 보면 언젠가는 \(p < 0.05\)인 순간이 반드시 오기 때문이다. 여기서 44%에 그친 것은 200개에서 멈추기 때문이다. \(\square\)
연습문제 5. 임의 중단에 대한 보정을 제안하라. 자료 수집 중 \(K\)번 엿볼 계획이라면 전체 제1종 오류율 0.05를 유지하려면 각 중간분석에서 \(\alpha\)를 어떻게 조정해야 하는가? (힌트: 본페로니가 한 가지 선택지이고 알파 소비가 또 다른 선택지이다.)
풀이
본페로니 접근: 매번 엿볼 때 수준 \(\alpha/K\)에서 검정한다. \(K = 20\)번이면 각각 \(\alpha = 0.05/20 = 0.0025\)를 쓴다. 단순하지만 보수적이다.
포콕(Pocock) 경계: 전체 제1종 오류(type I error)가 0.05가 되도록 고른 같은 조정 유의수준 \(\alpha^*\)을 매번 쓴다. \(K = 20\)이면 \(\alpha^* \approx 0.0075\)로 본페로니의 \(0.0025\)보다 세 배 느슨하다(모의실험이나 순차분석 표로 계산한다. 연습문제 6의 코드가 \(K = 10\)에서 \(0.0105\)를 주고, 같은 방법으로 \(K = 20\)을 돌리면 이 값이 나온다).
오브라이언·플레밍(O'Brien–Fleming) 경계: 초기 엿보기에는 아주 엄격한 임계값을 쓰고 자료가 쌓일수록 완화한다. \(K\)번 중 \(k\)번째 엿보기에서 임계 \(z\)-값은 대략 \(z_{1-\alpha/2}/\sqrt{k/K}\)이다. 초기에 알파를 거의 쓰지 않아 최종 분석의 검정력을 보존한다.
알파 소비 함수 (Lan-DeMets): 정보 비율 \(t \in [0,1]\)까지 전체 \(\alpha = 0.05\) 중 얼마를 "쓸지" 함수 \(\alpha^*(t)\)로 지정하는 유연한 틀이다. 포콕과 오브라이언·플레밍을 일반화하며 엿보는 시점을 정확히 미리 정할 필요가 없다. \(\square\)
연습문제 6. 엿보는 간격을 바꾸며 임의 중단의 거짓양성률을 재고, 표본이 무한정 늘 때 어떻게 되는지 논하라.
풀이
import numpy as np
from scipy import stats

rng = np.random.default_rng(2024)

def peek(rng, step, nmax=100, nmin=10):
    x = rng.normal(0, 1, nmax)
    for n in range(nmin, nmax + 1, step):
        s = x[:n]
        t = s.mean() / (s.std(ddof=1) / np.sqrt(n))
        if 2 * stats.t.sf(abs(t), n - 1) < 0.05:
            return True
    return False

for step in [1, 5, 10, 50]:
    c = sum(peek(rng, step) for _ in range(5_000))
    print(f"{step:3d}개마다 확인: 거짓양성률 {c / 5_000:.4f}  "
          f"(확인 횟수 {len(range(10, 101, step))})")
  1개마다 확인: 거짓양성률 0.2998  (확인 횟수 91)
  5개마다 확인: 거짓양성률 0.2316  (확인 횟수 19)
 10개마다 확인: 거짓양성률 0.1968  (확인 횟수 10)
 50개마다 확인: 거짓양성률 0.0922  (확인 횟수 2)
확인을 자주 할수록 오류율이 오른다. 매 관측마다 보면 30.0%, 50개마다 보면 9.2%다.
그런데 증가가 로그에 가깝다. 확인 횟수가 2에서 91로 45배 늘었는데 오류율은 9.2%에서 30.0%로 3배만 늘었다. 연속된 확인들이 강하게 상관되어 있기 때문이다.
\(n\to\infty\)이면 확률 1로 기각한다. 반복로그법칙(law of the iterated logarithm)에 따르면 확률 \(1\) 로
이므로 \(|\bar X_n|\sqrt n/\sigma\)가 \(\sqrt{2\log\log n}\) 규모로 무한히 자주 커진다. 고정 임계값 1.96을 언젠가 반드시 넘는다.
\(\log\log n\)이 아주 느리게 자란다는 점이 위안이 되지 않는다. \(n=10^6\)에서 \(\sqrt{2\log\log 10^6}=2.29\)이므로, 1.96을 넘는 것은 어렵지 않다.
대처 — 세 갈래.
-
표본크기를 미리 고정. 가장 단순하다.
-
군순차(group sequential) 경계. 확인 횟수를 미리 정하고 임계값을 조정한다. 포콕 경계는 모든 시점에 같은 임계값을 쓴다.
rng = np.random.default_rng(7)
M = 200_000
for K in [1, 2, 3, 5, 10]:
    inc = rng.standard_normal((M, K)) / np.sqrt(K)
    z = np.cumsum(inc, axis=1) / np.sqrt(np.arange(1, K + 1) / K)
    c = np.percentile(np.abs(z).max(1), 95)
    print(f"확인 {K:2d}회: 포콕 임계값 {c:.3f}  각 시점의 명목 α "
          f"{2 * stats.norm.sf(c):.4f}")
확인  1회: 포콕 임계값 1.963  각 시점의 명목 α 0.0497
확인  2회: 포콕 임계값 2.176  각 시점의 명목 α 0.0296
확인  3회: 포콕 임계값 2.286  각 시점의 명목 α 0.0223
확인  5회: 포콕 임계값 2.415  각 시점의 명목 α 0.0157
확인 10회: 포콕 임계값 2.560  각 시점의 명목 α 0.0105
확인 10회에 각 시점의 \(\alpha\)가 0.0105면 된다. 본페로니라면 \(0.05/10=0.005\)인데, 상관을 반영하면 두 배 느슨하다.
- 언제나 타당한 방법. 신뢰수열(confidence sequence)이나 e-값을 쓰면 몇 번을 보든 보장이 유지된다. 폭이 조금 넓어지는 대가를 치른다.
연습문제 7. \(p\)-곡선으로 문헌의 \(p\)-해킹을 탐지하는 원리를 설명하고, 한계를 밝혀라.
풀이
원리. 유의한 \(p\) 값들(\(p<0.05\))의 분포를 본다.
| 상황 | 곡선의 모양 |
|---|---|
| 참 효과가 있고 검정력이 높음 | 오른쪽 왜도(right skew — 작은 \(p\)가 많고 꼬리가 오른쪽으로 길다) |
| 참 효과가 없음 | 평평함(균등분포) |
| \(p\)-해킹 | 왼쪽 왜도(left skew — 0.05 바로 아래에 몰림) |
import numpy as np
from scipy import stats

rng = np.random.default_rng(11)
M = 200_000
za = stats.norm.ppf(0.975)
bins = np.array([0.01, 0.02, 0.03, 0.04, 0.05])

print(f"{'상황':>16s} " + " ".join(f"{f'~{b:.2f}':>8s}" for b in bins))

# ① 효과 없음
p = rng.random(M)
sig = p[p < 0.05]
h = np.histogram(sig, bins=np.r_[0, bins])[0] / len(sig)
print(f"{'효과 없음':>16s} " + " ".join(f"{v:8.3f}" for v in h))

# ② 효과 있음(검정력 0.5, 0.8)
for pw in [0.50, 0.80]:
    nc = za + stats.norm.ppf(pw)
    p = 2 * stats.norm.sf(np.abs(rng.normal(nc, 1, M)))
    sig = p[p < 0.05]
    h = np.histogram(sig, bins=np.r_[0, bins])[0] / len(sig)
    print(f"{f'효과 있음(검정력 {pw:.0%})':>16s} "
          + " ".join(f"{v:8.3f}" for v in h))
              상황    ~0.01    ~0.02    ~0.03    ~0.04    ~0.05
           효과 없음    0.202    0.199    0.196    0.205    0.198
  효과 있음(검정력 50%)    0.537    0.176    0.121    0.092    0.075
  효과 있음(검정력 80%)    0.737    0.116    0.066    0.046    0.034
효과가 없으면 균등하다(각 구간 0.20). 효과가 있으면 작은 \(p\)에 몰린다(검정력 80%에서 첫 구간이 0.737, 마지막 구간이 0.034).
\(p\)-해킹의 서명. 연구자가 "\(p<0.05\)가 될 때까지" 시도하면, 0.05 바로 아래에 부자연스럽게 몰린다. 위 표의 어떤 정상적 상황에서도 마지막 구간이 첫 구간보다 크지 않은데, \(p\)-해킹된 문헌에서는 그런 일이 나타난다.
검정 방법. 유의한 \(p\) 값들에 대해
- 오른쪽 왜도 검정: "효과가 있는가"를 본다(피셔 결합 등).
- 왼쪽 왜도 검정: "\(p\)-해킹이 있는가"를 본다.
- 33% 검정: 검정력이 33% 이상인지 검정. 낮으면 증거가 약하다.
한계 다섯.
-
개별 논문에 쓸 수 없다. \(p\) 값이 여러 개 필요하며, 보통 수십 개 이상이어야 한다.
-
이질성에 취약하다. 효과크기(effect size)가 연구마다 다르면 곡선이 섞여 해석이 어렵다.
-
\(p\)-해킹의 형태에 의존한다. "유의해질 때까지 표본 추가"는 잡아내지만, "여러 결과변수 중 선택"은 곡선을 크게 왜곡하지 않을 수 있다.
-
\(p\) 값 선택이 자의적이다. 한 논문에서 어느 \(p\) 값을 뽑을지에 따라 결과가 달라진다. 규칙을 미리 정해야 한다.
-
반올림과 보고 관행. "\(p<0.05\)"로만 적힌 값은 쓸 수 없다. 소수점 처리가 곡선을 왜곡할 수 있다.
관련 도구. \(z\)-곡선(검정력 추정), 깔때기 그림(출판 편향), 정수 검정(보고된 통계량의 일관성 검사) 등이 함께 쓰인다.
연습문제 8. 표본 분할(탐색용/확증용)이 \(p\)-해킹을 어떻게 막는지 보이고, 대가를 계산하라.
풀이
원리. 자료를 둘로 나누어
- 탐색 표본에서 자유롭게 분석하고 가설을 고른다.
- 확증 표본에서 그 가설 하나만 검정한다.
확증 단계의 자료는 선택에 쓰이지 않았으므로 \(\alpha\)가 온전히 유지된다.
import numpy as np
from scipy import stats

rng = np.random.default_rng(303)
M, n, k = 20_000, 60, 10        # 결과변수 10개, 총 n명

def one_trial(rng, split=True, effect=0.0):
    g = np.repeat([0, 1], n // 2)
    y = rng.normal(0, 1, (n, k))
    y[g == 1, 0] += effect                      # 첫 변수에만 참 효과
    if not split:                               # 전체로 고르고 전체로 검정
        ps = [stats.ttest_ind(y[g == 0, j], y[g == 1, j]).pvalue
              for j in range(k)]
        return min(ps) < 0.05
    h = n // 2
    idx = rng.permutation(n)
    a, b = idx[:h], idx[h:]                     # 탐색 / 확증
    ps = [stats.ttest_ind(y[np.intersect1d(a, np.where(g == 0)[0]), j],
                          y[np.intersect1d(a, np.where(g == 1)[0]), j]).pvalue
          for j in range(k)]
    j = int(np.argmin(ps))                      # 탐색에서 고른 변수
    return stats.ttest_ind(y[np.intersect1d(b, np.where(g == 0)[0]), j],
                           y[np.intersect1d(b, np.where(g == 1)[0]), j]).pvalue < 0.05

for eff, name in [(0.0, "효과 없음(제1종 오류)"), (0.8, "첫 변수에 효과(검정력)")]:
    a = np.mean([one_trial(rng, False, eff) for _ in range(M // 10)])
    b = np.mean([one_trial(rng, True, eff) for _ in range(M // 10)])
    print(f"{name:24s} 분할 없음 {a:.4f}   분할 {b:.4f}")
효과 없음(제1종 오류)            분할 없음 0.4040   분할 0.0460
첫 변수에 효과(검정력)            분할 없음 0.9125   분할 0.3450
분할이 제1종 오류를 0.404에서 0.046으로 되돌린다. 명목 수준이 회복된다.
대가 — 검정력. 참 효과가 있을 때 0.913에서 0.345로 떨어진다. 두 가지가 겹친다.
- 확증 표본이 절반이라 \(\sqrt2\)만큼 손해.
- 탐색 단계가 잘못된 변수를 고를 수 있다.
다만 "분할 없음 0.913"은 부풀려진 값이다. 그중 상당 부분이 거짓양성이므로, 공정한 비교가 아니다. 본페로니 보정을 한 전체 표본과 비교하는 것이 옳다.
분할 비율. 흔히 50:50을 쓰지만, 탐색이 쉬우면 확증에 더 많이 배분하는 것이 낫다. 70:30(확증 70)이 권장되기도 한다.
교차검증(cross-validation)과의 차이. 기계학습의 교차검증은 예측 성능 추정이 목적이고, 여기서의 분할은 추론의 타당성이 목적이다. 교차검증처럼 여러 번 나누어 평균 내면 확증의 독립성이 깨진다.
현대적 대안 — 선택 후 추론. 표본을 버리지 않고, 선택 사건에 조건화한 분포로 추론한다. 라쏘 등에서 이론이 발전해 있다. 효율적이지만 계산과 이론이 복잡하다.
연습문제 9. \(p\)-해킹을 막는 제도적·개인적 장치를 정리하고, 각각의 효과와 한계를 적어라.
풀이
| 장치 | 무엇을 막는가 | 한계 |
|---|---|---|
| 사전등록 | 거의 모든 자유도 | 지키는지 검증이 어렵다 |
| 등록보고서 | 사전등록 + 출판 편향 | 학술지 수가 제한적 |
| 자료·코드 공개 | 사후 검증 가능 | 검증할 사람이 있어야 |
| 다중우주 분석 | 경로 선택 | 결론이 모호해질 수 있다 |
| 표본 분할 | 선택 후 추론 | 검정력 손실 |
| 다중비교 보정 | 명시적 다중성 | 숨은 자유도는 못 막음 |
| 재현 연구 | 모든 것 | 비용, 유인 부족 |
| 효과크기·구간 보고 | 이분법적 사고 | 관행 변화 필요 |
| \(p\)-곡선·\(z\)-곡선 | 문헌 수준 진단 | 개별 연구에는 무력 |
가장 효과적인 것 — 사전등록. 다른 모든 장치보다 앞선다. 임상시험 등록 의무화 이후 "긍정적 결과"의 비율이 크게 떨어졌다는 분석이 이를 뒷받침한다.
개인이 할 수 있는 것.
-
분석 계획을 자료 수집 전에 글로 적는다. 공개 등록이 부담되면 최소한 연구실 내부 문서로라도 남긴다.
-
결과를 보기 전에 코드를 완성한다. 모의 자료로 파이프라인을 먼저 돌려 본다.
-
모든 분석을 기록한다. 시도했다가 버린 것도 남긴다. 논문에 "보충자료"로 실을 수 있다.
-
"이 분석을 결과가 반대였어도 했을까"를 자문한다. 가장 단순하고 효과적인 점검이다.
-
효과크기와 구간을 중심으로 보고한다. \(p<0.05\)를 목표로 삼지 않으면 해킹할 동기가 줄어든다.
구조적 문제. \(p\)-해킹의 근본 원인은 유인 구조다.
- 유의한 결과만 게재된다 → 연구자가 유의성을 추구한다.
- 게재 수로 평가받는다 → 빠른 결과를 원한다.
- 재현 연구는 인정받지 못한다 → 아무도 하지 않는다.
따라서 개인의 윤리만으로는 해결되지 않는다. 학술지 정책, 연구비 배분, 평가 제도가 함께 바뀌어야 한다.
낙관적 신호. 등록보고서 제도의 확산, 자료 공개 의무화, 다중우주 분석의 보급, 통계 교육의 변화가 실제로 진행 중이다. 이 절에서 본 도구들이 그 변화의 일부다.
연습문제 10. 여러 연구자 자유도를 조합하면 거짓양성률이 얼마나 오르는지 모의실험으로 보여라.
풀이
설정. 참 효과가 전혀 없는 세계에서, 연구자가 다음 자유도를 쓴다.
- 결과변수 3종(두 개의 측정과 그 평균),
- 공변량 보정 여부 2가지.
총 6가지 분석 중 유의한 것을 골라 보고한다.
import numpy as np
from scipy import stats

rng = np.random.default_rng(2024)
n, M = 30, 2_000

def study(rng):
    g = np.repeat([0, 1], n)
    y1 = rng.normal(0, 1, 2 * n)
    y2 = rng.normal(0, 1, 2 * n)
    cov = rng.normal(0, 1, 2 * n)
    ps = []
    for y in (y1, y2, (y1 + y2) / 2):
        ps.append(stats.ttest_ind(y[g == 0], y[g == 1]).pvalue)
        X = np.column_stack([np.ones(2 * n), g, cov])
        b, *_ = np.linalg.lstsq(X, y, rcond=None)
        r = y - X @ b
        df = 2 * n - 3
        se = np.sqrt((r @ r / df) * np.linalg.inv(X.T @ X)[1, 1])
        ps.append(2 * stats.t.sf(abs(b[1] / se), df))
    return min(ps)

cnt = sum(study(rng) < 0.05 for _ in range(M))
print(f"6가지 분석 중 최소 p < 0.05 인 비율: {cnt / M:.4f}")
6가지 분석 중 최소 p < 0.05 인 비율: 0.1345
명목 5%가 13.5%로 2.7배가 된다. 이것도 아주 온건한 자유도 조합이다.
실제 연구에서 가능한 자유도는 훨씬 많다.
| 자유도 | 가짓수 |
|---|---|
| 결과변수 선택 | 3~10 |
| 공변량 조합 | \(2^k\) |
| 이상치 기준 | 3~5 |
| 변환 여부 | 2~4 |
| 하위집단 | 4~10 |
| 표본 중단 시점 | 여러 |
| 단측/양측 | 2 |
이들을 곱하면 수백~수천 가지 분석 경로가 된다. 모의실험 연구들은 몇 가지만 조합해도 실제 오류율이 60%를 넘을 수 있다고 보고한다.
"고의가 아니어도" 일어난다. 연구자는 각 단계에서 "더 적절한" 선택을 했다고 믿는다. 문제는 그 판단이 결과를 본 뒤에 이루어진다는 것이다. 이를 갈림길의 정원(garden of forking paths) 이라 부른다. 실제로 하나의 경로만 걸었더라도, 다른 자료였다면 다른 경로를 걸었을 것이므로 오류율이 부풀려진다.
대처.
- 사전등록. 경로를 미리 하나로 고정한다.
- 다중우주 분석(multiverse). 가능한 모든 경로의 결과를 전부 보고한다. 결론이 경로에 얼마나 민감한지 드러난다.
- 명세곡선 분석(specification curve). 수백 개 분석의 효과크기를 정렬해 그린다.
- 표본 분할. 절반으로 탐색하고 나머지 절반으로 확증한다.
정리하며
\(p\)-해킹은 분석의 자유도를 거짓 양성으로 바꾸는 일이다.
- 정직한 검정에서 \(p\) 값은 균등분포다. \(H_0\) 아래에서 \(P(p\le t)=t\) 이므로 \(\alpha=0.05\) 로 검정하면 정확히 \(5\%\) 만 기각된다. 이 성질이 무너지는 것이 곧 해킹의 정의다.
- 세 가지 흔한 형태가 모두 같은 결과를 낳는다. 여러 결과변수 중 유의한 것만 보고하기, 유의해질 때까지 자료를 더 모으기(임의 중단), 부분집단이나 분석 방법을 골라 쓰기. 모의실험에서 거짓 양성률이 명목 \(5\%\) 를 크게 웃돈다.
- 임의 중단이 특히 위험하다. 들여다보며 계속 모으면 \(H_0\) 이 참이어도 언젠가는 거의 반드시 유의해진다. A/B 검정 플랫폼에서 실제로 벌어지는 일이다.
- 의도가 없어도 일어난다. "자료를 더 보자", "이 이상치(outlier)는 빼자" 같은 합리적으로 보이는 판단들이 쌓이면 같은 효과가 난다. 연구자가 부정직할 필요가 없다.
- 처방은 사전등록이다. 가설·결과변수·표본크기·분석 계획을 자료 수집 전에 고정하면 자유도 자체가 사라진다.
다음 절 절단점을 고르면으로 넘어간다. 2.2절 사례 연구 — 절단점 하나가 결론을 바꾼다가 절단점 \(64\) 개를 훑어 놓고 남겨 둔 물음에 답하는데, 거기서 이 쪽의 공식이 깨진다. 위의 \(1-(1-\alpha)^k\) 는 후보 \(k\) 개가 독립일 때의 값이고, 이웃한 절단점끼리는 상관이 \(0.88\) 이어서 \(64\) 개를 시도해도 독립인 \(14\) 개 값만 치른다. 게다가 \(2\times2\) 표가 이산이라 개별 검정의 실제 수준이 \(0.05\) 에서 벗어나 있어, 후보가 둘일 때는 거짓 양성률이 명목 수준으로 셈한 독립 예측 \(1-0.95^2 = 0.0975\) 보다 오히려 크다. 검정을 여러 번 하는 것 자체를 형식화하는 일은 그 뒤의 가족단위 오류율이 맡는다.