σ₁² / σ₂²의 신뢰구간¶
1. 두 분산의 비에 대한 신뢰구간¶
들어가는 이야기 — 평균이 같은 두 시스템
응답시간이 평균 \(10\) 밀리초인 서비스가 둘 있다. 평균이 같으니 쓰는 느낌도 같을까. 그렇지 않다. 한쪽은 거의 언제나 \(10\) 밀리초 언저리에서 답하고, 다른 쪽은 대개 더 빠른 대신 가끔 \(1\) 초씩 걸린다. 사람이 기억하는 것은 평균이 아니라 그 가끔이다. 평균을 견주는 검정은 이 둘을 구별하지 못한다.
그러니 물어야 할 것이 평균이 아니라 산포가 되는 자리가 있다. 느린 꼬리가 왜 그렇게까지 값비싼지 — 서버 한 대의 드문 지연이 수백 대를 거치며 어떻게 불어나는지 — 는 아래 상자가 실제 사례의 수로 따라간다.
산포를 견주는 양이 분산의 비 \(\theta = \sigma_1^2/\sigma_2^2\) 다. 그런데 이 양은 흐리게 짚인다. \(\sigma_1 = 1.0\), \(\sigma_2 = 1.5\) 인 두 정규모집단에서 \(n_1 = 15\), \(n_2 = 12\) 개를 뽑았다. 참 분산비는 \(0.4444\) 로 두 배 넘게 다른데, \(95\%\) 구간은 \((0.2396,\ 2.4903)\) 으로 참값을 담으면서 \(1\) 도 함께 담는다 — 「두 분산이 같다」를 배제하지 못한 것이다.
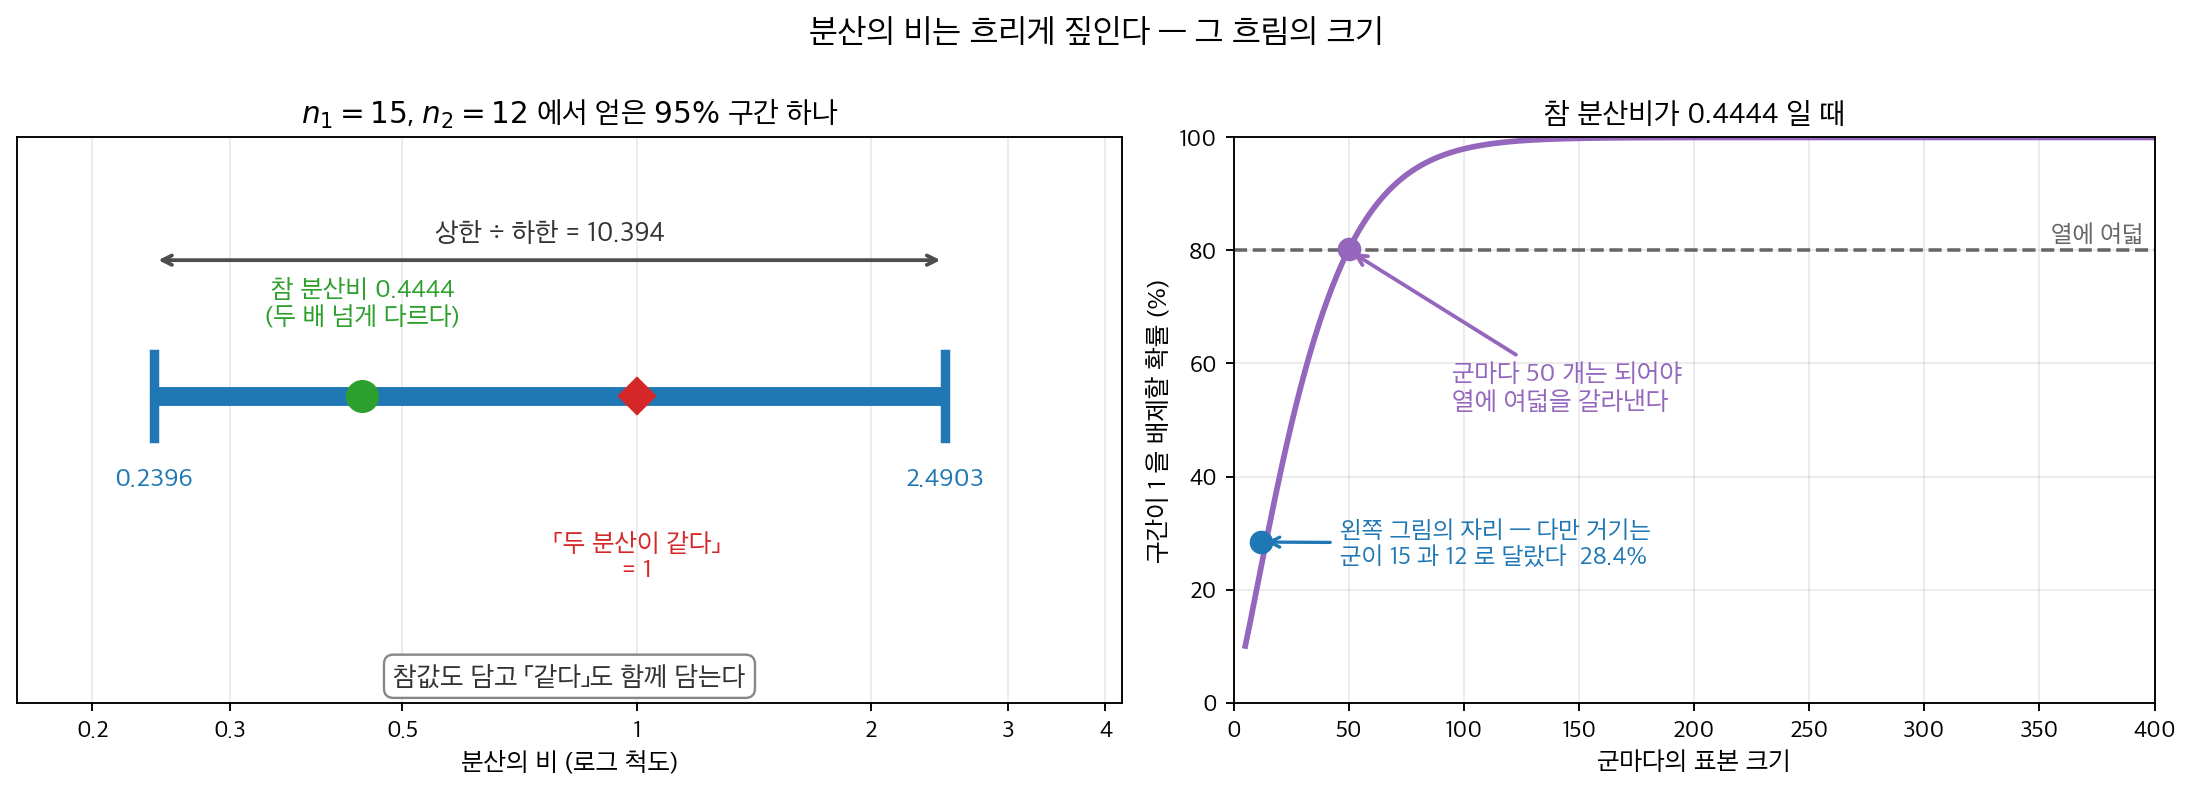
왼쪽. 구간 하나가 참 분산비 \(0.4444\) 도 담고 「두 분산이 같다」를 뜻하는 \(1\) 도 함께 담는다. 상한이 하한의 \(10.394\) 배인 것은 자유도 쌍 \((14,\ 11)\) 이 정한 값이어서 자료를 보기 전에 이미 정해져 있다. 오른쪽. 그러면 이 참값을 \(1\) 에서 갈라내려면 얼마가 드는가. 왼쪽 자리에서 그 확률은 \(28.4\%\) 뿐이고, 군마다 \(50\) 개는 되어야 열에 여덟을 갈라낸다. 분산은 평균보다 훨씬 비싸게 짚인다 — 오른쪽 곡선과 \(50\) 이라는 수는 이 책이 따져 본 값이다.
구간이 틀린 것은 아니다. 이 자유도 쌍에서는 상한이 하한의 \(10.39414\) 배인 구간밖에 나올 수 없고, 그 비는 자료를 보기 전에 이미 정해져 있다. 분산의 비는 왜 이렇게 흐리게 짚이고, 그 흐림을 가진 구간이 그래도 무엇을 말해 주는가. 이 쪽이 그 구간을 세우고 그 물음에 답한다.
두 집단을 견줄 때 늘 평균만 묻는 것은 아니다. 어느 쪽이 더 고르게 나오는가가 물음일 때가 있다 — 두 생산라인의 산포, 두 측정기의 잡음, 두 서버의 응답시간 변동. 그때 재는 것은 차가 아니라 비 \(\theta = \sigma_1^2/\sigma_2^2\) 다.
차가 아니라 비를 쓰는 데는 까닭이 있다. 분산은 음수가 될 수 없고 척도가 바뀌면 함께 바뀌는 양이므로, 차 \(\sigma_1^2 - \sigma_2^2\) 는 단위에 매여 읽기 어렵다. 비는 단위가 약분되어 「몇 배」로 읽히고, 등분산이라는 가설이 \(\theta = 1\) 이라는 깔끔한 꼴이 된다.
8.2절 σ²의 신뢰구간에서 한 집단의 분산을 다룰 때 쓴 사실을 두 번 쓰면 된다. 두 모집단이 모두 정규이고 서로 독립이면 각각 \((n_i-1)S_i^2/\sigma_i^2 \sim \chi^2_{n_i-1}\) 이고, 독립인 두 카이제곱을 자유도로 나누어 비를 취한 것이 \(F\) 분포의 정의다. 그러므로
이 정확히 성립한다. 이 양에는 모르는 값이 \(\theta\) 하나로 묶여 들어가고 그 분포에는 모수가 남지 않으니 추축량이다. 가운데를 \(1-\alpha\) 확률로 가두고 \(\theta\) 에 대해 풀면 구간이 나온다.
\(s_1^2\) 과 \(s_2^2\) 은 베셀 수정을 한 표본분산(sample variance)이고, 두 임계값은 자유도 \((n_1-1,\;n_2-1)\) 인 \(F\) 분포의 아래쪽·위쪽 값이다. 여기서도 임계값이 뒤집혀 들어간다 — \(\theta\) 가 추축량의 분모에 있어 부등호가 돌아가므로 큰 임계값이 아래끝의 분모로 간다. 분산 하나를 다룰 때 본 것과 같은 구조이고, 보기 1 이 그 뒤집힘을 유도까지 따라간다.
구간이 \(1\) 을 담는지가 등분산 판정이다. 담으면 두 분산이 다르다는 증거가 없고, 담지 않으면 어느 쪽이 더 흔들리는지까지 읽힌다. 그리고 \(F\) 분포가 비대칭이므로 구간도 점추정값 \(s_1^2/s_2^2\) 을 중심으로 대칭이 아니다.
이 구간이 서는 조건은 하나로 모인다. 두 모집단이 모두 정규여야 한다. 분산 하나를 다룰 때와 같은 이유이고, 정규성(normality)이 가정이 아니라 전제라는 사정도 같다 — 중심극한정리(central limit theorem)가 평균을 구제해 주던 일이 여기서는 일어나지 않는다. 오히려 요구가 두 배로 붙는다는 점이 다르다. 한쪽만 치우쳐 있어도 \(F\) 비의 분포가 어긋난다. 유한모집단이면 각 집단에서 \(n_i \le 0.1N_i\) 가 독립 근사를 받쳐 준다.
정규성 요구
카이제곱 분산 신뢰구간과 마찬가지로 F-구간도 정규성 아래에서만 정확하다. 정규가 아닌 자료(치우쳤거나 꼬리가 두껍거나 이상치(outlier)이 있는 자료)에서는 포함확률이 심각하게 어긋날 수 있다. 정규가 아닌 자료에는 부트스트랩(bootstrap)이나 로버스트한 대안을 고려하라.
보기 1. 분산비의 신뢰구간 계산. 정규모집단 둘에서 \(n_1 = 15\), \(n_2 = 12\) 인 표본을 뽑는다. 참값은 \(\sigma_1 = 1.0\), \(\sigma_2 = 1.5\) 이므로 \(\theta = \sigma_1^2/\sigma_2^2 = 1/2.25 = 0.4444\) 다.
(1) 추축량에서 \(\theta\) 의 \(95\%\) 구간을 유도하시오. 큰 \(F\) 임계값이 아래끝의 분모로 가는 까닭을 밝히고, 상한과 하한의 비가 자료와 무관한 상수임을 보이시오.
(2) 표본 하나로 구간을 만들어 확인하시오. 두 자유도의 순서를 뒤바꾸면 무슨 일이 일어나는가.
풀이
(1) 추축량을 뒤집는다. 두 모집단이 정규이고 독립이면
이고 이 분포는 \(\sigma_1\), \(\sigma_2\) 에 의존하지 않는다. \(F_{\text{lo}} = F_{0.025,\,14,\,11}\), \(F_{\text{hi}} = F_{0.975,\,14,\,11}\) 로 두면
이다. 안쪽을 \(\theta\) 에 대해 푼다. 세 양이 모두 양수이므로 역수를 취할 수 있고 부등호가 뒤집힌다.
그래서 큰 임계값이 아래끝의 분모로 간다. \(\theta\) 가 추축량의 분모에 있다는 것이 유일한 까닭이며, 분산의 카이제곱 구간에서 본 것과 같은 구조다.
비가 상수다. 상한을 하한으로 나누면 \(R\) 이 약분된다.
자료를 보기도 전에 정해진다. 두 자유도만의 함수이며, \(n_1 = 15\), \(n_2 = 12\) 로 분산비를 추정하면 상한이 하한의 열 배를 넘는 구간밖에 얻을 수 없다는 뜻이다.
(2) 표본 하나. 뒤의 코드가 \(s_1^2 = 0.84576\), \(s_2^2 = 1.05097\), \(R = 0.80474\) 를 주므로
이다. 참값 \(0.4444\) 를 담는다. 그러나 \(1\) 도 담는다. 실제로는 \(\sigma_2\) 가 \(\sigma_1\) 의 \(1.5\)배인데도 "두 분산이 같다"는 값을 배제하지 못한다.
자유도를 뒤바꾸면 조용히 틀린다. \(F\) 분포는 분자 자유도와 분모 자유도의 순서가 중요하다. \((14, 11)\) 대신 \((11, 14)\) 를 쓰면 임계값이 \(0.29772\) 와 \(3.09459\) 가 되어 구간이
이 된다. 폭의 비는 \(10.39414\) 로 똑같은데(두 자유도를 맞바꿔도 \(F_{\text{hi}}/F_{\text{lo}}\) 는 변하지 않는다) 구간 전체가 \(1.085\) 배 오른쪽으로 밀린다. 참값을 여전히 담으므로 오류가 드러나지 않는다. 두 표본의 크기가 같으면 아예 차이가 없고, 크기 차이가 클수록 구간이 밀리는 정도가 커진다. 오류 메시지가 나지 않는 종류의 실수라 더 위험하다.
(3) 확인.
import numpy as np
from scipy.stats import f

n1, n2 = 15, 12
alpha = 0.05

# 참 분산비는 1/1.5² = 0.444다. 답을 알고 있는 상태에서 구간을 본다.
rng = np.random.default_rng(42)
x = rng.normal(loc=0, scale=1.0, size=n1)
y = rng.normal(loc=0, scale=1.5, size=n2)

s1_sq = x.var(ddof=1)
s2_sq = y.var(ddof=1)
rhat = s1_sq / s2_sq

# F분포는 두 자유도의 **순서**가 중요하다. dfn이 분자, dfd가 분모다.
# 두 표본의 크기가 다르므로 여기서 뒤바꾸면 조용히 틀린 답이 나온다.
df1, df2 = n1 - 1, n2 - 1
F_lo = f(dfn=df1, dfd=df2).ppf(alpha / 2.0)
F_hi = f(dfn=df1, dfd=df2).ppf(1 - alpha / 2.0)

# 여기서도 큰 임계값이 아래끝의 분모로 간다.
# (s1²/s2²)/(σ1²/σ2²) ~ F 를 σ1²/σ2² 에 대해 풀면 대소가 뒤집히기 때문이다.
ci_lower = rhat / F_hi
ci_upper = rhat / F_lo

print(f"95% CI for σ₁²/σ₂²: ({ci_lower:.4f}, {ci_upper:.4f})")
출력:
95% CI for σ₁²/σ₂²: (0.2396, 2.4903)
(1)·(2)와 맞는다. 구간 \((0.2396,\ 2.4903)\) 이고 상한/하한이 \(2.4903/0.2396 = 10.394\) 로 \(F_{\text{hi}}/F_{\text{lo}}\) 와 같다.
참값 0.444를 담기는 하지만 위끝이 아래끝의 열 배다. 구간이 1을 넉넉히 담고 있으므로 "두 분산이 같다"는 가설조차 배제하지 못한다. 실제로는 \(\sigma_2\)가 \(\sigma_1\)의 1.5배인데도 그렇다. 분산 하나를 추정하는 것도 어려운데 그 비를 추정하는 일은 훨씬 더 어렵다.
2. 정규라면 포함확률이 정확히 맞는다¶
§1 의 추축 결과가 근사가 아니므로 포함확률도 근사가 아니다. 두 모집단이 정규이기만 하면 \(n_1\) 과 \(n_2\) 가 얼마든 명목값이 그대로 나온다. 아래 보기가 그것을 세어 확인하고, 이어서 정규를 벗어났을 때 그 보장이 어디까지 무너지는지 본다.
보기 2. \(F\) 구간의 포함확률. 같은 설정(\(n_1 = 15\), \(n_2 = 12\), \(\sigma_1 = 1\), \(\sigma_2 = 1.5\))에서 \(95\%\) 구간을 \(100\)개 만든다.
(1) 정규모집단에서 이 구간의 포함확률은 얼마인가. 근사인가 정확인가. 그렇다면 이 모의실험으로 잴 것은 무엇인가.
(2) 그림을 그리고, 구간 하나가 유독 길게 뻗는 까닭을 말하시오. \(\log\theta\) 척도에서는 어떻게 보이겠는가.
(3) \(100\)개 가운데 \(1\) 을 담는 구간이 몇 개인가. 그 수가 실무에 주는 경고는 무엇인가.
풀이
(1) 정확히 \(0.95\)다. 구간이 \(\theta\) 를 담는 사건은 보기 1 (1)의 유도에 의해 \(F_{\text{lo}} \le R/\theta \le F_{\text{hi}}\) 와 같은 사건이고, \(R/\theta\) 가 정확히 \(F_{14,11}\) 을 따르며 \(F_{\text{lo}}, F_{\text{hi}}\) 가 그 분포의 \(2.5\)·\(97.5\) 백분위수다. 따라서 확률이 \(0.975 - 0.025 = 0.95\) 다. 근사가 아니고 \(n_1, n_2, \sigma_1, \sigma_2\) 에 의존하지 않는다.
그러므로 잴 것은 포함률이 아니라 폭이다. 그런데 이 구간의 폭에는 특이한 성질이 있다. 앞 보기에서 본 대로 상한/하한이 \(10.39414\) 로 고정이므로
로 \(\log\theta\) 척도에서는 폭이 상수다. 표본마다 달라지는 것은 위치(\(\log R\))뿐이다.
(2) 그림.
#!/usr/bin/env python3
"""두 분산의 비에 대한 F 신뢰구간을 100번 만들어 포함확률을 확인한다.

두 표본분산의 비가 F 분포를 따른다는 사실에서 구간이 나온다. 이 방법은
정규성에 특히 민감해서, 모집단이 정규가 아니면 포함확률이 크게 어긋난다.
"""

import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import f

plt.rcParams["font.sans-serif"] = ["NanumGothic", "Apple SD Gothic Neo", "Malgun Gothic"]
plt.rcParams["font.family"] = "sans-serif"
plt.rcParams["axes.unicode_minus"] = False

rng_seed = 42        # 아래 그림을 재현하려면 고정한다
n_simulations = 100
n1, n2 = 15, 12
mu1, mu2 = 0.0, 0.0
sigma1, sigma2 = 1.0, 1.5
alpha = 0.05


def main():
    if rng_seed is not None:
        np.random.seed(rng_seed)

    theta_true = (sigma1**2) / (sigma2**2)
    df1, df2 = n1 - 1, n2 - 1

    lowers = np.empty(n_simulations)
    uppers = np.empty(n_simulations)
    centers = np.empty(n_simulations)

    F_lo = f(dfn=df1, dfd=df2).ppf(alpha / 2.0)
    F_hi = f(dfn=df1, dfd=df2).ppf(1 - alpha / 2.0)

    for i in range(n_simulations):
        x = np.random.normal(loc=mu1, scale=sigma1, size=n1)
        y = np.random.normal(loc=mu2, scale=sigma2, size=n2)
        s1_sq = x.var(ddof=1)
        s2_sq = y.var(ddof=1)
        rhat = s1_sq / s2_sq
        lowers[i] = rhat / F_hi
        uppers[i] = rhat / F_lo
        centers[i] = rhat

    covered = (lowers <= theta_true) & (theta_true <= uppers)
    n_fail = (~covered).sum()
    coverage_pct = 100.0 * covered.mean()

    fig, ax = plt.subplots(figsize=(12, 12))
    for i in range(n_simulations):
        color = "k" if covered[i] else "r"
        ax.plot([lowers[i], uppers[i]], [i, i], lw=2, color=color)
        ax.plot(centers[i], i, marker="o", ms=3, color=color)

    ax.axvline(theta_true, linestyle="--", linewidth=1.5, color="r")
    ax.set_title(
        f"{n_simulations} F-intervals for σ₁²/σ₂² | n1={n1}, n2={n2}, "
        f"df=({df1},{df2}), CL={int((1 - alpha) * 100)}% | "
        f"Fail={n_fail} (Coverage ≈ {coverage_pct:.1f}%)")
    ax.set_yticks([])
    for sp in ["left", "right", "top"]:
        ax.spines[sp].set_visible(False)
    ax.set_xlabel("θ = σ₁² / σ₂²")
    plt.tight_layout()
    plt.show()


if __name__ == "__main__":
    main()
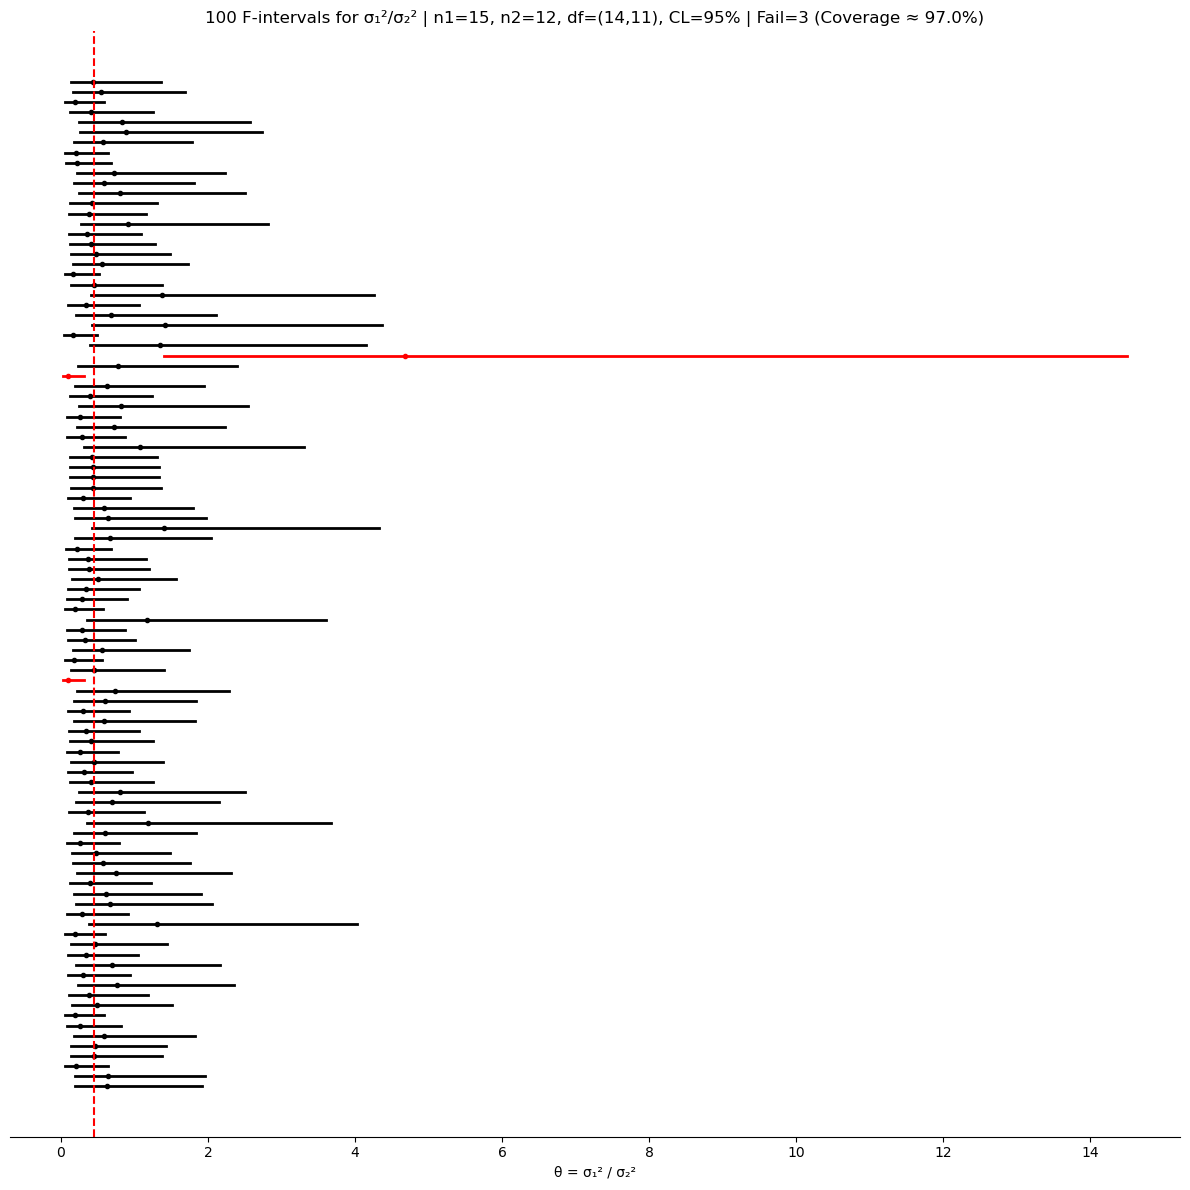
실패가 셋이다. (1)의 \(0.95\) 에서 기대 실패가 다섯인데 셋이 나왔고, \(100\)회의 표준오차 \(0.0218\) 안이다. 재확인일 뿐 새로 알게 되는 것은 없다.
한 구간이 유독 길다. \(100\)개의 폭이 최소 \(0.2817\), 중앙값 \(1.2452\), 최대 \(13.1024\) 로 최대가 최소의 \(46\)배다. 그런데 (1)에서 본 대로 상한/하한은 모두 \(10.394\) 로 같다. 모순이 아니다. 폭은
로 \(R = s_1^2/s_2^2\) 에 정비례하므로, 어떤 표본에서 \(R\) 이 우연히 크게 나오면 구간이 통째로 오른쪽으로 밀리는 동시에 길어진다. 가장 긴 구간은 그 \(R\) 이 중앙값의 \(10\)배쯤 되었다는 뜻이다.
\(\log\theta\) 척도에서는 이 왜곡이 사라진다. 로그를 취하면
로 \(100\)개 모두 길이가 같은 막대가 되고, 움직이는 것은 중심 \(\log R\) 뿐이다. 그림이 훨씬 읽기 쉬워진다. \(\theta\) 가 비율이라 아래로는 \(0\) 이라는 벽에 눌리고 위로는 열려 있는데, 로그가 그 비대칭을 없앤다.
(3) \(100\)개 중 \(74\)개가 \(1\) 을 담는다. 참 비율이 \(0.444\), 곧 표준편차로 \(1.5\)배 차이인데도 네 번 중 세 번은 등분산을 배제하지 못한다.
실무에 주는 경고는 분명하다. "먼저 등분산 검정을 하고 그 결과로 스튜던트 \(t\) 와 웰치 중에 고른다"는 절차가 여기서 무너진다. \(n_1 = 15\), \(n_2 = 12\) 쯤의 표본에서 등분산 검정이 기각하지 못했다는 것은
- "분산이 같다"는 뜻이 아니라
- "표본이 작아 \(1.5\)배 차이도 못 가린다"는 뜻일 때가 많다.
그런데 그 "기각하지 못함"을 근거로 스튜던트 \(t\) 를 고르면, 분산이 실제로 다를 때 포함률이 무너진다. 검정을 거쳐 방법을 고르지 말고 처음부터 웰치를 쓰는 것이 간단하고 안전하다. 웰치가 치르는 값은 자유도 약간뿐이다.
포함확률 97.0%로 명목값을 달성한다. 그런데 구간의 모양이 눈에 띈다. 대부분은 0 근처에서 2 언저리까지 뻗지만, 하나는 오른쪽 끝이 14를 넘는다. 그 표본에서 우연히 \(s_1^2/s_2^2\)이 크게 나오자 구간이 통째로 오른쪽으로 밀리며 길이까지 폭발한 것이다.
\(\theta\)의 척도가 비율이라 이런 일이 생긴다. 아래쪽으로는 0이라는 벽이 있어 눌리고 위쪽으로는 열려 있다. \(\log \theta\)로 보면 훨씬 대칭적인 그림이 된다.
100개 중 74개가 1을 담고 있다. 참 비율이 0.444, 즉 표준편차로 1.5배 차이인데도 \(n_1 = 15\), \(n_2 = 12\)로는 네 번 중 세 번 등분산을 배제하지 못한다. 등분산 검정으로 웰치를 쓸지 스튜던트 \(t\)를 쓸지 정하려는 시도가 위험한 이유가 여기 있다. 검정이 등분산을 기각하지 못했다는 것은 분산이 같다는 뜻이 아니라 표본이 작다는 뜻일 때가 많다.
3. 정규가 아니면 쓸 수 없다¶
§1 의 조건이 실무에서 가장 자주 걸리는 자리다. 정규가 아닌 자료에서는 포함확률이 명목값에서 심하게 벗어나므로, \(\sigma\) 의 비를 부트스트랩으로 재거나 15장의 로버스트 분산검정으로 돌아서는 편이 낫다. 아래 상자는 그 판단이 평균을 묻는 일보다 중요해지는 자리를 하나 보여 준다.
AI로 보는 통계학 1. 평균은 같은데 쓸 수 없는 시스템
분산의 비를 묻는 일이 평균을 묻는 일보다 더 중요해지는 자리가 있다.
\(2013\) 년 구글의 제프리 딘과 루이스 안드레 바로소가 『Communications of the ACM』에 「규모에서의 꼬리(The Tail at Scale)」를 실었다. 요청 하나가 서버 수백 대에 퍼져 나가고 그 답이 모두 모여야 응답이 되는 시스템에서, 느린 꼬리가 어떻게 커지는지를 다룬 글이다. 핵심 보기가 이것이다.
「서버 하나가 보통 \(10\)ms 에 답하지만 \(99\) 분위 지연이 \(1\) 초인 시스템을 생각해 보자. 사용자 요청이 그런 서버 하나에서 처리된다면 \(100\) 개 가운데 하나가 느릴 것이다. … 사용자 요청이 그런 서버 \(100\) 개에서 병렬로 답을 모아야 한다면 사용자 요청의 \(63\%\) 가 \(1\) 초를 넘을 것이다.」
\(1 - 0.99^{100} = 0.6340\) 이다. 서버 하나가 \(10{,}000\) 번에 한 번만 느려도 서버가 \(2{,}000\) 개면 \(1 - 0.9999^{2000} = 0.1813\) 으로 다섯에 하나 가까이가 느려진다. 그들이 실제 구글 서비스에서 잰 수도 함께 적어 두었다. 잎 서버 하나가 끝나는 시간의 \(99\) 분위는 \(10\)ms 인데 모든 요청이 끝나는 시간의 \(99\) 분위는 \(140\)ms 다.
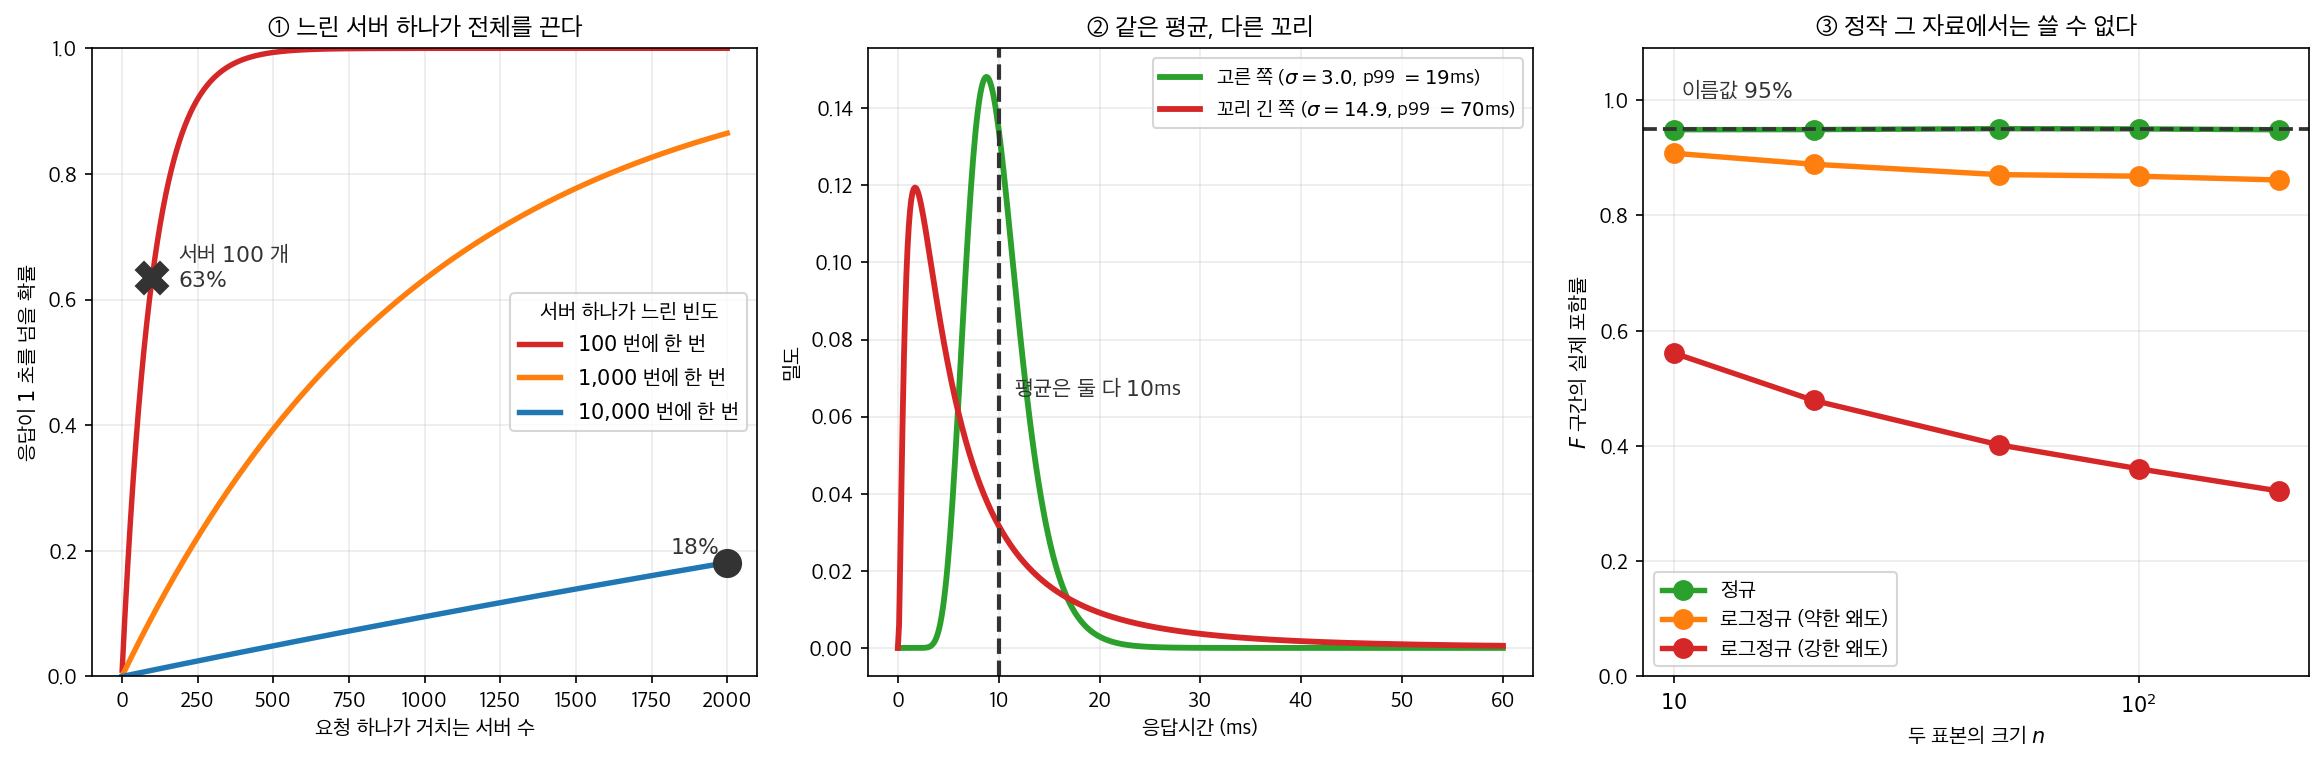
- ① 논문의 그림을 다시 계산한 것이다. 빨간 곡선이 \(100\) 번에 한 번 느린 서버인데 \(100\) 개만 모여도 \(63\%\) 로 올라간다. 평균 응답시간은 이 그림 어디에도 들어오지 않는다. 들어오는 것은 꼬리의 빈도뿐이다.
- ② 그래서 두 시스템을 견줄 때 평균은 답이 되지 못한다. 여기 평균이 똑같이 \(10\)ms 인 두 분포가 있다. 왼쪽은 표준편차 \(3.0\) 에 \(99\) 분위가 \(19\)ms 이고, 오른쪽은 표준편차 \(14.9\) 에 \(99\) 분위가 \(70\)ms 다. \(100\) ms 를 「느리다」로 놓고 서버 \(100\) 개에 퍼뜨리면 느려질 확률이 \(0.0000\) 대 \(0.3180\) 이다. 평균을 견주는 검정은 이 둘을 구별하지 못한다. \(\sigma_1^2/\sigma_2^2\) 를 묻는 이 절의 구간이 묻는 바로 그 차이다.
- ③ 그런데 이 절의 \(F\) 구간을 정작 그 자료에 쓸 수는 없다. \(\S 1\) 이 「두 모집단이 모두 정규일 것을 요구한다」고 적어 둔 것을 수로 보면 이렇다. 참 분산비가 \(1\) 일 때 정규 자료에서는 포함률이 \(0.95\) 로 정확하지만, 치우친 로그정규 자료에서는 \(n = 10\) 에서 \(0.561\), \(n = 200\) 에서 \(0.322\) 다. 약한 왜도에서도 \(0.86\) 에 머문다. \(n\) 을 키울수록 나빠진다 — 명목값이 기대는 것이 표본 수가 아니라 분포의 모양이기 때문이다.
읽을 것은 둘이다. 첫째, 무엇을 견줄지는 쓰임새가 정한다. 사용자가 느끼는 것이 꼬리라면 견주어야 할 것은 평균이 아니라 산포다. 둘째, 옳은 양을 골랐다고 도구까지 따라오지는 않는다. 지연시간은 정규와 거리가 멀고, 그 자료에서 \(F\) 구간은 명목값의 \(3\) 분의 \(1\) 만 지킨다. \(\S 1\) 의 마지막 줄이 부트스트랩을 가리키는 까닭이 여기 있다.
확인한 곳 — J. Dean, L. A. Barroso (2013) The Tail at Scale, 『Communications of the ACM』 \(56\) 권 \(2\) 호 \(74\)–\(80\) 쪽. 인용한 문장, 서버 \(100\) 개에서 \(63\%\) 라는 수, \(10{,}000\) 번에 한 번 느린 서버 \(2{,}000\) 개에서 「거의 다섯에 하나」라는 서술, 그리고 Table 1 둘레의 「잎 하나가 끝나는 \(99\) 분위 \(10\)ms, 모든 요청이 끝나는 \(99\) 분위 \(140\)ms」가 모두 거기 있다. 그림과 표의 수는 모두 직접 계산한 값이며 구글의 측정값이 아니다
연습문제¶
연습문제 1. 정규모집단에서 뽑은 독립인 두 표본에서 \(s_1^2 = 25\) (\(n_1 = 16\)), \(s_2^2 = 10\) (\(n_2 = 21\))을 얻었다. \(\sigma_1^2/\sigma_2^2\)의 점추정값을 계산하고 \(F_{15,20,0.025} = 0.3629\), \(F_{15,20,0.975} = 2.573\)을 써서 95% 신뢰구간을 구성하라.
풀이
점추정값은 이렇게 된다.
95% 신뢰구간은 이렇게 된다.
구간이 1을 포함하므로 5% 수준에서 두 분산이 다르다고 결론지을 충분한 증거가 없다.
연습문제 2. \(\sigma_1^2/\sigma_2^2\)의 신뢰구간이 \((1.5, 4.2)\)이라면 두 모분산의 관계에 대해 무엇을 알 수 있는가?
풀이
구간 전체가 1보다 위에 있으므로 주어진 신뢰수준(confidence level)에서 \(\sigma_1^2 > \sigma_2^2\)이라고 결론지을 수 있다. 구체적으로 첫 번째 모집단의 분산이 두 번째 모집단 분산의 1.5배에서 4.2배 사이라고 신뢰한다. 예를 들어 (등분산을 가정하는) 스튜던트 \(t\) 검정을 쓸지 웰치 \(t\) 검정을 쓸지 결정할 때 이런 정보가 유용하다.
연습문제 3. F에 기반한 신뢰구간이 점추정값을 중심으로 비대칭인 이유를 설명하라. 연습문제 1의 구간으로 예시하라.
풀이
F-분포는 오른쪽으로 치우쳐 있으므로(양수에서만 정의되고 오른쪽 꼬리가 더 길다) 임계값 \(F_{\alpha/2}\)와 \(F_{1-\alpha/2}\)가 1에서 같은 거리에 있지 않다. 연습문제 1에서 점추정값은 2.5이다. 신뢰구간의 하한은 \(2.5/2.573 = 0.972\)로 추정값보다 1.528 아래이고, 상한은 \(2.5/0.3629 = 6.890\)으로 추정값보다 4.390 위이다. 구간이 왼쪽보다 오른쪽으로 훨씬 멀리 뻗는데, 이는 F-분포의 왜도(skewness)를 반영한다.
연습문제 4. 등분산에 대한 F-검정은 비정규성에 매우 민감한 것으로 알려져 있다. 이유를 설명하고 대안을 하나 들라.
풀이
F-분포의 유도는 두 모집단이 정확히 정규라고 가정한다. 정규성에서 조금만 벗어나도(약간의 왜도나 두꺼운 꼬리만으로도) \(S_1^2/S_2^2\)의 분포가 F-분포에서 크게 벗어난다. 모집단의 첨도(kurtosis)가 \(S^2\)의 분산에 직접 영향을 주므로, 꼬리가 두꺼운 모집단에서는 이 비가 F 이론이 예측하는 것보다 훨씬 넓게 퍼지고 제1종 오류율이 부풀려진다.
대안으로 레빈 검정이 있다. 절대편차 \(|X_{ij} - \bar{X}_j|\)(브라운–포사이드에서는 중앙값으로부터의 편차)에 일원분산분석을 적용하여 분산의 동일성을 검정한다. 이 방법은 비정규성에 훨씬 로버스트하다. 분산비에 대한 부트스트랩 신뢰구간도 또 다른 비모수적 대안이다.
연습문제 5. \(\sigma_1^2/\sigma_2^2\)의 구간에서 \(\sigma_1/\sigma_2\)의 구간을 얻는 법을 보이고, 역수 대칭성을 확인하라.
풀이
import numpy as np
from scipy import stats

s1sq, n1 = 25.0, 16
s2sq, n2 = 10.0, 21
r = s1sq / s2sq
lo = r / stats.f.ppf(0.975, n1 - 1, n2 - 1)
hi = r / stats.f.ppf(0.025, n1 - 1, n2 - 1)
print(f"분산비 {r:.4f}      구간 ({lo:.4f}, {hi:.4f})")
print(f"표준편차비 {np.sqrt(r):.4f}  구간 ({np.sqrt(lo):.4f}, {np.sqrt(hi):.4f})")

# 순서를 바꾸면
r2 = s2sq / s1sq
lo2 = r2 / stats.f.ppf(0.975, n2 - 1, n1 - 1)
hi2 = r2 / stats.f.ppf(0.025, n2 - 1, n1 - 1)
print(f"\n역순 분산비 {r2:.4f}  구간 ({lo2:.4f}, {hi2:.4f})")
print(f"원 구간의 역수      ({1 / hi:.4f}, {1 / lo:.4f})")
분산비 2.5000      구간 (0.9716, 6.8898)
표준편차비 1.5811  구간 (0.9857, 2.6248)

역순 분산비 0.4000  구간 (0.1451, 1.0292)
원 구간의 역수      (0.1451, 1.0292)
두 가지가 확인된다.
-
제곱근 변환. \(g(t)=\sqrt t\)가 순증가이므로 양끝에 제곱근을 취하면 \(\sigma_1/\sigma_2\)의 구간이 되고 신뢰수준이 보존된다.
-
역수 대칭. 집단의 순서를 바꿔 계산한 구간이 원 구간의 역수와 정확히 같다. \(F_{\nu_2,\nu_1,\alpha}=1/F_{\nu_1,\nu_2,1-\alpha}\)라는 \(F\) 분포의 항등식 덕이다.
왜 역수 대칭이 중요한가. "집단 1이 집단 2보다 분산이 크다"와 "집단 2가 집단 1보다 분산이 작다"는 같은 주장이다. 절차가 어느 집단을 분자에 두느냐에 따라 다른 답을 주면 안 된다.
이 자료의 해석. 분산비 구간 \((0.97,\ 6.89)\)가 1을 간신히 담는다. 하한이 0.9716이므로 아슬아슬하게 등분산을 기각하지 못한다. 표준편차 척도로는 \((0.99,\ 2.62)\)다.
비대칭이 극심하다. 점추정값 2.5에서 하한까지 1.53, 상한까지 4.39로 상한 쪽이 세 배 멀다. 로그 척도에서 보면
으로 중심에서 \(-0.945\)와 \(+1.014\)다. 여전히 대칭이 아닌데, 이는 두 자유도(\(15\)와 \(20\))가 다르기 때문이다. \(n_1=n_2\)이면 로그 척도에서 정확히 대칭이 된다.
보고 권고. 분산보다 표준편차 비로 보고하는 것이 읽기 쉽다. "집단 1의 표준편차가 집단 2의 1.58배(95% CI 0.99~2.62)"가 직관적이다.
연습문제 6. 분산비 구간을 목표 정밀도로 만들려면 표본이 얼마나 필요한가? 평균 비교와 비교하라.
풀이
import numpy as np
from scipy import stats

print(f"{'n(양군)':>8s} {'하한/r':>9s} {'상한/r':>9s} {'상한/하한':>10s}")
for n in [10, 20, 30, 50, 100, 200, 500]:
    lo = 1 / stats.f.ppf(0.975, n - 1, n - 1)
    hi = 1 / stats.f.ppf(0.025, n - 1, n - 1)
    print(f"{n:8d} {lo:9.4f} {hi:9.4f} {hi / lo:10.2f}")

print()
for target in [10, 4, 2, 1.5]:
    n = next(m for m in range(5, 5000)
             if (1 / stats.f.ppf(0.025, m - 1, m - 1))
             / (1 / stats.f.ppf(0.975, m - 1, m - 1)) <= target)
    print(f"상한/하한 {target}배 이하 → 집단당 n = {n}")
   n(양군)      하한/r      상한/r      상한/하한
      10    0.2484    4.0260      16.21
      20    0.3958    2.5265       6.38
      30    0.4760    2.1010       4.41
      50    0.5675    1.7622       3.11
     100    0.6728    1.4862       2.21
     200    0.7568    1.3214       1.75
     500    0.8389    1.1921       1.42

상한/하한 10배 이하 → 집단당 n = 14
상한/하한 4배 이하 → 집단당 n = 35
상한/하한 2배 이하 → 집단당 n = 131
상한/하한 1.5배 이하 → 집단당 n = 376
분산비는 매우 부정확하게 추정된다. 집단당 30명이면 구간의 상한이 하한의 4.4배다. "분산비가 0.48배에서 2.1배 사이"라는 것은 사실상 아무 말도 하지 않는 것에 가깝다.
평균 비교와의 대비.
| 목표 | 분산비 | 평균 차이(\(\sigma\) 단위로 \(\pm0.5\)) |
|---|---|---|
| 집단당 \(n\) | 131(2배 이내) | 32 |
같은 수준의 "쓸 만한" 정밀도를 얻는 데 분산이 네 배쯤 더 든다.
왜 그런가. \(\log(S^2)\)의 표준오차가 \(\sqrt{2/(n-1)}\)로 \(\bar X\)의 \(\sigma/\sqrt n\)보다 본질적으로 크고, 게다가 분산비는 두 추정값의 불확실성을 모두 안는다.
실무적 함의.
-
등분산 검정이 소표본에서 무력한 이유가 여기 있다. \(n=20\)에서 참 분산비가 2여도 구간이 \((0.79,\ 5.05)\)라 1을 담는다.
-
분산을 비교하는 것이 주 목적이면 표본을 크게 잡아야 한다. 부수적인 진단으로 쓰는 것과는 요구가 다르다.
-
웰치를 기본으로 쓰는 또 하나의 근거. 등분산 여부를 확인할 힘이 없으므로, 확인에 의존하지 않는 절차를 쓰는 것이 합리적이다.
연습문제 7. 분산비가 그 자체로 관심사인 실무 상황을 셋 들고, 각각에서 무엇을 보고해야 하는지 적어라.
풀이
상황 1 — 측정 시스템 분석. 두 측정기기나 두 검사자의 재현성을 비교한다.
- 같은 시료를 반복 측정해 각 기기의 반복성 분산을 구하고 비를 본다.
- 보고: 표준편차 비와 구간. "새 기기의 측정 표준편차가 기존의 0.72배(95% CI 0.55~0.94)"
- 주의: 측정값의 분포가 정규인지 확인한다. 아니면 부트스트랩.
상황 2 — 공정 개선의 검증. 개선 전후의 변동을 비교한다.
- 평균이 아니라 산포를 줄이는 것이 목표인 경우가 많다. 규격 중심에 맞추는 것보다 변동을 줄이는 것이 어렵다.
- 보고: 분산비와 함께 공정능력지수의 변화. \(C_p=(\text{USL}-\text{LSL})/(6\sigma)\)이므로 \(\sigma\)가 0.72배면 \(C_p\)가 1.39배다.
- 주의: 개선 전후로 다른 요인이 바뀌지 않았는지.
상황 3 — 개체 내 변동과 개체 간 변동. 급내상관계수(ICC)가 분산비의 함수다.
for lam in [0.5, 1, 2, 4, 9, 19]:
    print(f"σ_b²/σ_w² = {lam:4.1f}  →  ICC = {lam / (1 + lam):.3f}")
σ_b²/σ_w² =  0.5  →  ICC = 0.333
σ_b²/σ_w² =  1.0  →  ICC = 0.500
σ_b²/σ_w² =  2.0  →  ICC = 0.667
σ_b²/σ_w² =  4.0  →  ICC = 0.800
σ_b²/σ_w² =  9.0  →  ICC = 0.900
σ_b²/σ_w² = 19.0  →  ICC = 0.950
- ICC 0.9를 넘으려면 분산비가 9 이상이어야 한다. 신뢰도 기준이 왜 그렇게 엄격한지 보여 준다.
- 보고: ICC와 그 구간. \(\lambda\)의 구간에 \(\lambda/(1+\lambda)\)를 적용하면 되며, 단조증가 변환이라 신뢰수준이 보존된다.
- 주의: ICC는 모집단의 이질성에 의존한다. 동질적인 집단에서 잰 ICC는 낮게 나오며, 이것이 측정이 나쁘다는 뜻은 아니다.
공통 권고.
- 표준편차 척도로 보고한다. 분산은 단위가 제곱이라 읽기 어렵다.
- 구간을 반드시 함께 적는다. 앞 문제에서 보았듯 점추정값만으로는 거의 정보가 없다.
- 정규성을 확인하거나 로버스트한 방법을 쓴다.
- 실무적 임계값과 비교한다. "분산비가 유의하게 1과 다르다"보다 "규격을 만족할 만큼 줄었는가"가 중요하다.
연습문제 8. 등분산 검정의 여러 방법(\(F\), 바틀렛, 레빈, 브라운–포사이드)을 비교하고, 실무 권고를 정리하라.
풀이
네 방법의 구조.
| 방법 | 통계량의 바탕 | 정규성 의존 |
|---|---|---|
| \(F\) | \(S_1^2/S_2^2\) | 극도로 높음 |
| 바틀렛 | 로그 분산의 가중합(\(k\)개 집단) | 극도로 높음 |
| 레빈 | \(\lvert x_{ij}-\bar x_i\rvert\)의 분산분석 | 중간 |
| 브라운–포사이드 | \(\lvert x_{ij}-\text{med}_i\rvert\)의 분산분석 | 낮음 |
핵심 착안. 레빈과 브라운–포사이드는 절대편차를 새 자료로 보고 평균 비교 문제로 바꾼다. 평균 비교는 중심극한정리의 보호를 받으므로 훨씬 로버스트해진다. 브라운–포사이드가 중앙값을 쓰는 것은 절대편차 자체의 왜도를 줄이기 위해서다.
import numpy as np
from scipy import stats

rng = np.random.default_rng(404)
n, M = 30, 3_000
print(f"{'분포':>6s} {'F':>8s} {'바틀렛':>8s} {'레빈':>8s} {'BF':>8s}")
for name, gen in [("정규", lambda s: rng.normal(0, 1, s)),
                  ("t(5)", lambda s: rng.standard_t(5, s)),
                  ("지수", lambda s: rng.exponential(1, s))]:
    rej = np.zeros(4)
    for _ in range(M):
        x, y = gen(n), gen(n)
        f = x.var(ddof=1) / y.var(ddof=1)
        pf = 2 * min(stats.f.cdf(f, n - 1, n - 1), stats.f.sf(f, n - 1, n - 1))
        pb = stats.bartlett(x, y).pvalue
        pl = stats.levene(x, y, center="mean").pvalue
        pv = stats.levene(x, y, center="median").pvalue
        rej += np.array([pf, pb, pl, pv]) < 0.05
    print(f"{name:>6s} " + " ".join(f"{v / M:8.4f}" for v in rej))
    분포        F      바틀렛       레빈       BF
    정규   0.0527   0.0527   0.0517   0.0440
  t(5)   0.1667   0.1667   0.0470   0.0370
    지수   0.2790   0.2790   0.1330   0.0577
\(H_0\)가 참인데도 \(F\)와 바틀렛이 지수분포(exponential distribution)에서 28% 기각한다. 명목 5%의 다섯 배가 넘는다. 두 집단일 때 \(F\)와 바틀렛은 사실상 같은 검정이라 값이 일치한다.
브라운–포사이드가 가장 로버스트하다. 지수분포에서도 5.8%로 명목에 가깝고, \(t_5\)에서는 오히려 보수적이다(3.7%). 레빈(평균 기준)은 지수분포에서 13.3%로 중간이다.
실무 권고.
-
등분산 검정 자체를 하지 않는 것이 첫째 권고다. μ₁−μ₂의 신뢰구간에서 본 대로, 두 집단 평균 비교에는 웰치를 그냥 쓰면 된다.
-
꼭 해야 한다면 브라운–포사이드.
scipy.stats.levene(..., center="median")이 이것이다. \(F\)와 바틀렛은 정규성이 확실한 경우에만 쓴다. -
분산 자체가 관심사라면 검정이 아니라 구간을 보고한다. "등분산을 기각하지 못했다"는 진술은 정보가 거의 없다.
-
\(k>2\) 집단이면 브라운–포사이드나 웰치의 분산분석(analysis of variance,
oneway.anova계열)을 쓴다.
더 근본적으로. 이분산이 있다는 것은 모형이 불완전하다는 신호일 수 있다. 분산이 평균에 따라 변한다면(계수형 자료, 비율 자료), 그 구조를 반영하는 일반화선형모형(generalized linear model)이 이분산을 "고치는" 것이 아니라 애초에 옳게 모형화하는 길이다.
연습문제 9. \(F\) 기반 분산비 구간이 비정규성에 얼마나 취약한지 모의실험으로 재고, \(n\)을 키우면 회복되는지 확인하라.
풀이
import numpy as np
from scipy import stats

rng = np.random.default_rng(23)
M = 20_000
cases = [("정규", lambda s: rng.normal(0, 1, s)),
         ("균등", lambda s: rng.uniform(-1.732, 1.732, s)),
         ("t(10)", lambda s: rng.standard_t(10, s)),
         ("t(5)", lambda s: rng.standard_t(5, s)),
         ("지수", lambda s: rng.exponential(1, s))]
print(f"{'분포':>7s} {'n=20':>9s} {'n=50':>9s}")
for name, gen in cases:
    row = []
    for n in [20, 50]:
        x, y = gen((M, n)), gen((M, n))
        r = x.var(1, ddof=1) / y.var(1, ddof=1)
        lo = r / stats.f.ppf(0.975, n - 1, n - 1)
        hi = r / stats.f.ppf(0.025, n - 1, n - 1)
        row.append(np.mean((lo <= 1) & (1 <= hi)))
    print(f"{name:>7s} {row[0]:9.4f} {row[1]:9.4f}")
     분포      n=20      n=50
     정규    0.9473    0.9504
     균등    0.9944    0.9967
  t(10)    0.9075    0.9000
   t(5)    0.8373    0.8025
     지수    0.7323    0.7046
\(n\)을 키워도 회복되지 않는다. 오히려 나빠진다. \(t_5\)에서 0.837 → 0.803, 지수에서 0.732 → 0.705.
8.2절 σ²의 신뢰구간에서 본 단일 분산 구간과 같은 구조다. \(\log(S_1^2/S_2^2)\)의 점근분산이
로 초과첨도 \(\gamma_2\)에 비례하는데, \(F\) 분포는 \(\gamma_2=0\)을 가정한다. 지수분포(\(\gamma_2=6\))에서는 참 분산이 네 배라 구간이 절반 폭밖에 안 된다.
꼬리가 얇으면 반대다. 균등분포(\(\gamma_2=-1.2\))에서 0.994로 지나치게 보수적이다.
\(t_{10}\)조차 0.90이다. 초과첨도가 1.0에 불과한, 정규에 꽤 가까운 분포인데도 5%포인트가 어긋난다. \(F\) 검정과 \(F\) 구간이 "정규성에 극도로 민감하다"는 평판은 과장이 아니다.
함의. μ₁−μ₂의 신뢰구간에서 보았듯 등분산 사전검정에 \(F\) 검정을 쓰면, 그 검정이 기각하는 이유가 분산 차이인지 첨도인지 구별되지 않는다. 이것이 사전검정을 권하지 않는 또 하나의 이유다.
연습문제 10. 분산비 구간의 로버스트한 대안 두 가지 — 로그 척도 부트스트랩과 첨도 보정 — 을 구현하고 \(F\) 구간과 비교하라.
풀이
import numpy as np
from scipy import stats

rng = np.random.default_rng(77)
n1 = n2 = 30
M, B = 2_000, 999
z = stats.norm.ppf(0.975)

cases = [("정규", lambda s: rng.normal(0, 1, s)),
         ("t(5)", lambda s: rng.standard_t(5, s)),
         ("지수", lambda s: rng.exponential(1, s))]
for name, gen in cases:
    hf = hb = hk = 0
    for _ in range(M):
        x, y = gen(n1), gen(n2)
        r = x.var(ddof=1) / y.var(ddof=1)

        lo = r / stats.f.ppf(0.975, n1 - 1, n2 - 1)
        hi = r / stats.f.ppf(0.025, n1 - 1, n2 - 1)
        hf += (lo <= 1 <= hi)

        bx = x[rng.integers(0, n1, (B, n1))]
        by = y[rng.integers(0, n2, (B, n2))]
        br = np.log(bx.var(1, ddof=1) / by.var(1, ddof=1))
        l, h = np.percentile(br, [2.5, 97.5])
        hb += (l <= 0 <= h)

        kk = (stats.kurtosis(x, bias=False) + stats.kurtosis(y, bias=False)) / 2
        sd = np.sqrt((kk + 2) * (1 / (n1 - 1) + 1 / (n2 - 1)))
        hk += (abs(np.log(r)) <= z * sd)

    print(f"{name:5s} F {hf / M:.4f}   부트스트랩(로그) {hb / M:.4f}   "
          f"첨도 보정 {hk / M:.4f}")
정규    F 0.9485   부트스트랩(로그) 0.9340   첨도 보정 0.9400
t(5)  F 0.8100   부트스트랩(로그) 0.9110   첨도 보정 0.9015
지수    F 0.7065   부트스트랩(로그) 0.9040   첨도 보정 0.8710
두 대안 모두 크게 낫다. 지수분포에서 \(F\)는 0.707이지만 부트스트랩은 0.904, 첨도 보정은 0.871이다.
정규에서는 약간 손해다. 0.949 → 0.934, 0.940. 모형을 덜 가정하는 대가이며, 1~1.5%포인트에 불과하다.
부트스트랩이 조금 더 낫다. 첨도를 명시적으로 추정하지 않고 재표본 분포가 스스로 말하게 하기 때문이다. 첨도 보정은 \(\hat\gamma_2\)의 추정오차가 크다는 약점을 그대로 안고 있다.
여전히 0.95에 못 미친다. \(n=30\)에서 지수분포처럼 극단적인 경우에는 어떤 방법도 완전하지 않다. BCa를 쓰면 조금 더 개선되며, \(n\)이 커지면 부트스트랩은 제대로 수렴한다(\(F\)와 달리).
로그 척도를 쓴 이유.
- 분포가 대칭에 가까워진다. \(S_1^2/S_2^2\)의 분포는 1에서 심하게 비대칭이다.
- 경계를 지킨다. 지수를 취해 되돌리면 항상 양수다.
- 역수 대칭. 두 집단의 순서를 바꾸면 \(\log r\)의 부호만 바뀐다. 구간도 부호를 뒤집은 것이 되어 일관성이 있다.
권고. 분산비가 주 관심사라면 정규성을 진단하고, 의심되면 부트스트랩을 쓴다. \(F\) 구간은 정규성이 뒷받침될 때만 보고한다.
정리하며¶
두 분산은 차가 아니라 비로 비교한다.
- 비를 쓰는 이유는 추축량이 만들어지기 때문이다. \(\frac{s_1^2/\sigma_1^2}{s_2^2/\sigma_2^2}\sim F_{n_1-1,n_2-1}\) 이며, 이 양의 분포가 미지 모수에 의존하지 않는다. 차에는 이런 성질이 없다.
- 분모의 임계값이 뒤바뀐다. 분산 구간과 마찬가지로 큰 분위수(quantile)가 하한에, 작은 분위수가 상한에 들어간다.
- \(1\) 을 포함하는지가 관심사다. 포함하면 두 분산이 같다는 가설을 기각하지 못한다. 분산에서 \(1\) 은 평균에서의 \(0\) 에 해당한다.
- \(F\) 분포의 뒤집기 성질이 유용하다. \(F_{1-\alpha/2,d_1,d_2}=1/F_{\alpha/2,d_2,d_1}\) 이므로 표 한쪽만 있으면 된다.
- 정규성에 매우 민감하다. 일표본 분산 구간보다도 더 취약하며, 두 모집단 모두 정규여야 한다. 실무에서는 레빈 검정이나 부트스트랩 쪽이 안전하다(15장).
다음 절 μ_D (차이의 평균)의 신뢰구간부터 8.4절은 대응표본(paired samples)으로 넘어간다. 같은 대상을 두 번 재면 두 측정이 종속이어서, 여기까지 쓴 독립 설계의 표준오차를 그대로 쓸 수 없다.