일표본 평균 신뢰구간의 계산
개요
이 페이지에서는 모평균 \(\mu\)에 대한 일표본 신뢰구간을 실제로 계산하는 방법을 다룬다. 두 가지 방법을 다룬다: 모표준편차 \(\sigma\)를 아는 경우의 \(z\)-구간과, \(\sigma\)를 모르고 표본표준편차 \(s\)로 추정하는 경우의 \(t\)-구간. Python 구현은 원자료와 요약통계량 어느 쪽이든 받는다.
z-구간 (분산을 아는 경우)
\(\sigma\)를 알 때 \(\mu\)의 \((1-\alpha)100\%\) 신뢰구간은
표준오차는 \(\text{SE} = \sigma / \sqrt{n}\)이고 오차한계는 \(\text{MOE} = z_{\alpha/2} \cdot \text{SE}\)이다.
t-구간 (분산을 모르는 경우)
\(\sigma\)를 모르면 \(s\)로 바꾸고 자유도 \(\text{df} = n - 1\)인 \(t\)-분포를 쓴다:
\(t\)-분포는 표준정규보다 꼬리가 두꺼우므로 모든 유한한 \(n\)에서 \(t_{\alpha/2,\,n-1} > z_{\alpha/2}\)이고, 그 결과 \(\sigma\) 추정의 불확실성을 반영한 더 넓은 구간이 나온다.
CSV에서 자료 읽기
보기 1. CSV에서 자료 읽기. 한 CSV 파일에 값이 12, 15, 14 로 한 줄에 하나씩 적힌 뒤 빈 줄이 하나 있고, 그다음 줄에 10,13,16 이 쉼표로 묶여 적혀 있다. 이 파일 전체를 표본 하나로 본다.
(1) 표본크기 \(n\)과 표본평균 \(\bar x\)를 구하시오.
(2) 줄을 어떻게 나누었든 같은 표본을 돌려주는 읽기 함수를 만들어 (1)을 확인하시오. 빈 칸을 건너뛰어야 하는 까닭과, 수치가 하나도 없을 때 함수가 무엇을 해야 하는지 밝히시오.
풀이
(1) 줄 구조는 표본이 아니다. 값은 여섯 개이므로 \(n = 6\)이고
이다. 줄바꿈과 쉼표는 파일의 서식일 뿐 표본의 구조가 아니다. 그러므로 읽기 함수가 지켜야 할 성질은 하나다. 값의 다중집합만 보존하고 줄 구조는 버린다.
(2) 구현과 확인.
import csv
import numpy as np

def load_data(csv_path):
    """CSV에서 수치값을 모두 읽어 1차원 배열로 돌려준다.

    행 하나에 값이 하나든 여럿이든 상관없이 모두 같은 표본으로 본다.
    빈 칸을 건너뛰는 것은 CSV 끝의 빈 줄이나 후행 쉼표 때문이다.
    """
    arr = []
    with open(csv_path, "r", newline="") as f:
        reader = csv.reader(f)
        for row in reader:
            for item in row:
                item = item.strip()
                if item:
                    arr.append(float(item))
    if len(arr) == 0:
        # 빈 배열을 그냥 돌려주면 평균이 nan이 되어 원인을 찾기 어렵다.
        # 읽는 쪽에서 바로 알아채도록 여기서 끊는다.
        raise ValueError("No numeric values found in CSV.")
    return np.array(arr, dtype=float)


# 임시 파일로 동작을 확인한다. 값 배치가 달라도 결과는 같다.
import tempfile, os
with tempfile.TemporaryDirectory() as d:
    path = os.path.join(d, "data.csv")
    with open(path, "w") as f:
        f.write("12\n15\n14\n\n10,13,16\n")     # 한 줄에 하나, 빈 줄, 한 줄에 셋
    x = load_data(path)
print(x, x.mean())
출력:
[12. 15. 14. 10. 13. 16.] 13.333333333333334
(1)과 맞는다. 배열의 길이가 \(6\)이고 평균이 \(13.333333333333334\)로, \(40/3\)을 배정도 부동소수점으로 가장 가깝게 적은 수다(\(40/3\)은 이진법으로 유한소수가 아니므로 마지막 자리에 \(4\)가 남는다).
빈 칸을 건너뛰는 까닭. csv.reader 는 파일 끝의 빈 줄이나 후행 쉼표를 빈 문자열 '' 로 넘겨준다. 걸러 내지 않으면 float('') 이 ValueError 를 던져 자료가 아니라 서식 때문에 읽기가 실패한다. 이 보기의 입력에 빈 줄을 일부러 넣은 것이 그 확인이다.
수치가 하나도 없으면 끊어야 한다. 빈 배열을 그대로 돌려주면 arr.mean() 이 nan 을 주고 그 nan 이 표준오차를 거쳐 구간의 양 끝까지 번진다. 끝에 가서는 (nan, nan) 만 보일 뿐 원인이 "파일을 잘못 지정했다"였는지 "열 이름이 달랐다"였는지 알 수 없다. 실패는 번지기 전에 끊는다.
신뢰구간의 계산
보기 2. 평균 신뢰구간 계산기. 어떤 표본에서 요약통계량 \(n = 25\), \(\bar x = 3.2\), \(s = 1.1\) 을 얻었다. 비교를 위해, 같은 자리에서 모표준편차가 \(\sigma = 1.0\) 으로 알려져 있었다면 어떠했을지도 함께 본다.
(1) \(95\%\) \(t\)-구간과 \(95\%\) \(z\)-구간을 손으로 계산하시오. 두 오차한계의 차이를 임계값 몫과 산포 몫으로 쪼개고, 그 쪼개기가 순서에 의존하는지 밝히시오.
(2) 원자료가 아니라 요약통계량만 받는 함수를 만들어 (1)을 확인하시오.
풀이
(1) 구조는 하나다. 두 구간 모두 "추정값 \(\pm\) 임계값 \(\times\) 표준오차" 꼴이고, 다른 것은 임계값과 산포 둘뿐이다.
\(z\)-구간은 \(z_{0.025} = 1.95996\), \(\text{SE} = \sigma/\sqrt n = 1.0/5 = 0.2\) 이므로
\(t\)-구간은 자유도 \(n - 1 = 24\), \(t_{0.025,\,24} = 2.06390\), \(\text{SE} = s/\sqrt n = 1.1/5 = 0.22\) 이므로
차이를 쪼갠다. 전체 증가분은 \(0.45406 - 0.39199 = 0.06206\) 이다. 한 번에 하나씩만 바꾼다.
산포 몫이 전체의 \(66.5\%\) 다. "\(t\)-분포를 썼으니 넓어졌다"는 설명이 절반도 안 된다는 뜻이다. 임계값의 비는 \(t/z = 1.05303\) 로 \(5.3\%\) 에 불과하다.
쪼개기는 순서에 의존한다. 산포를 먼저 바꾸면 산포 몫이 \(1.95996 \times 0.02 = 0.03920\), 임계값 몫이 \(0.02287\) 이 되어 두 몫의 크기가 뒤바뀐다. 합만 \(0.06206\) 으로 같다. 오차한계가 두 인자의 곱이기 때문이고, 그래서 순서에 무관한 쪼개기는 곱으로 적는 것이다.
이 꼴에서는 임계값 인자 \(1.053\) 과 산포 인자 \(1.100\) 을 어느 쪽부터 읽어도 같다.
(2) 요약통계량만 받는 계산기.
import math
from scipy.stats import norm, t

def ci_mean(n, xbar, s=None, known_sigma=None, method="t", cl=0.95):
    """모평균에 대한 일표본 신뢰구간.

    원자료가 아니라 **요약통계량만** 받는다. 신뢰구간을 만드는 데
    필요한 것은 n, xbar, 그리고 산포 하나뿐이기 때문이다.
    논문에 실린 표만 있어도 구간을 다시 만들 수 있다는 뜻이다.

    n : 표본크기
    xbar : 표본평균
    s : 표본표준편차 (t-구간에 필요)
    known_sigma : 알고 있는 모표준편차 (z-구간에 필요)
    method : 't' 또는 'z'
    cl : 신뢰수준 (기본 0.95)
    """
    alpha = 1 - cl

    if method == "z":
        se = known_sigma / math.sqrt(n)
        z_star = norm.ppf(1 - alpha / 2)
        moe = z_star * se
    else:
        se = s / math.sqrt(n)
        df = n - 1                              # xbar를 쓰느라 하나를 잃는다
        t_star = t.ppf(1 - alpha / 2, df=df)
        moe = t_star * se

    # 두 갈래가 다른 것은 임계값과 산포뿐이다.
    # 구조는 언제나 "추정값 ± 임계값 × 표준오차"로 같다.
    return xbar - moe, xbar + moe

# 요약통계량에서 바로 t-구간
lo, hi = ci_mean(n=25, xbar=3.2, s=1.1, method="t", cl=0.95)
print(f"95% t-interval: ({lo:.4f}, {hi:.4f})")

# sigma를 아는 경우의 z-구간. 비교를 위해 s보다 작은 sigma=1.0을 넣었다.
lo, hi = ci_mean(n=25, xbar=3.2, known_sigma=1.0, method="z", cl=0.95)
print(f"95% z-interval: ({lo:.4f}, {hi:.4f})")
출력:
95% t-interval: (2.7459, 3.6541)
95% z-interval: (2.8080, 3.5920)
(1)의 손 계산과 맞는다. \(t\)-구간 \((2.7459,\ 3.6541)\), \(z\)-구간 \((2.8080,\ 3.5920)\) 으로 소수 넷째 자리까지 같다. 쪼갠 두 몫 \(0.0208 + 0.0413 = 0.0621\) 도 전체 증가분과 같다.
함수가 known_sigma 와 s 를 다른 인자로 받는 까닭. 두 값은 단위도 같고 크기도 비슷해 하나의 인자로 받고 method 로만 갈라도 코드는 돈다. 그러나 \(\sigma\) 는 자료 밖에서 주어진 상수이고 \(s\) 는 이 표본에서 계산된 통계량이다. 구간을 고르는 기준은 두 구간의 폭이 아니라 그 하나, \(\sigma\) 를 정말로 아는가다. 인자를 나누어 둔 것은 그 구별을 호출하는 쪽에서 매번 선언하게 만들기 위한 것이다.
두 구간의 너비 차이(\(\pm 0.454\) 대 \(\pm 0.392\))는 두 원인이 겹친 결과다. 임계값이 \(t_{0.025,\,24} = 2.064\) 대 \(z_{0.025} = 1.960\)으로 다르고, 산포도 \(s = 1.1\) 대 \(\sigma = 1.0\)으로 다르다. 임계값만 놓고 보면 차이는 5% 남짓이다.
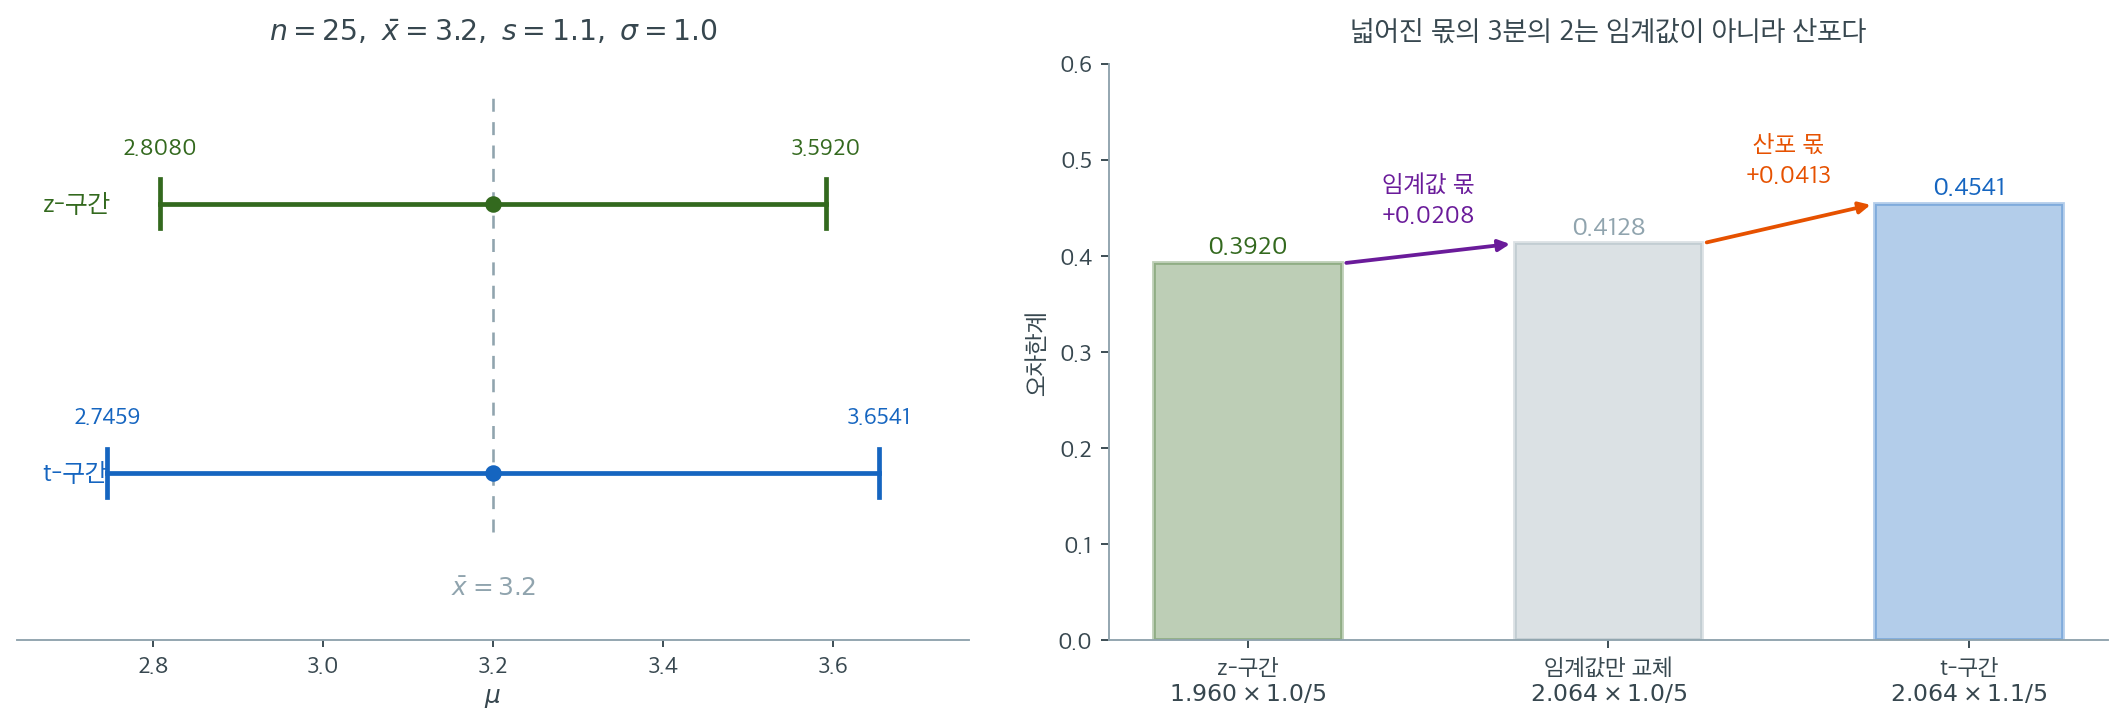
두 구간이 얼마나 다른지는 왼쪽 그림에서 바로 읽힌다. \(z\)-구간이 \((2.8080,\ 3.5920)\), \(t\)-구간이 \((2.7459,\ 3.6541)\)로 양쪽 모두 \(t\) 쪽이 조금씩 더 뻗어 있다. 중심 \(\bar x = 3.2\)는 같고 뻗어 나간 길이만 다르다.
문제는 "왜 더 뻗었는가"다. 흔히 "\(t\)-분포를 썼으니까"라고 답하지만, 오른쪽 막대를 보면 그것은 절반도 안 되는 설명이다. 오차한계를 한 번에 하나씩만 바꿔 가며 계산해 보자. 출발점은 \(z\)-구간의 \(1.960 \times 1.0/5 = 0.3920\)이다. 여기서 임계값만 \(t_{0.025,\,24} = 2.064\)로 바꾸면 \(0.4128\)이 되어 \(+0.0208\) 늘어난다. 이어서 산포를 \(\sigma = 1.0\)에서 \(s = 1.1\)로 바꾸면 \(0.4541\)이 되어 \(+0.0413\) 더 늘어난다. 전체 증가분 \(0.0621\) 중 산포 몫이 \(0.0413\)으로 3분의 2를 차지한다.
이 예에서 산포 몫이 큰 것은 \(s = 1.1\)이 \(\sigma = 1.0\)보다 10% 컸기 때문이고, 그 10%는 우연일 수도 있고 \(\sigma\)에 대한 우리의 믿음이 틀렸다는 신호일 수도 있다. 여기서 구별해야 할 것은, 임계값의 차이는 \(n\)만 알면 미리 계산되는 확정된 비용인 반면 산포의 차이는 표본마다 달라지는 우연한 양이라는 점이다. \(s\)가 \(\sigma\)보다 작게 나온 표본에서는 \(t\)-구간이 오히려 \(z\)-구간보다 좁아질 수도 있다.
그러니 두 구간의 너비를 비교해 방법을 고르려 해서는 안 된다. 고르는 기준은 오직 하나, \(\sigma\)를 정말로 아는가이다. 알면 \(z\), 모르면 \(t\)다. 이 페이지의 ci_mean이 known_sigma와 s를 아예 다른 인자로 받는 것도 그 구별을 코드에 새겨 두기 위해서다.
명령줄 사용법
함께 제공되는 스크립트 ci_mean_calc.py는 명령줄 인자를 지원한다:
# CSV 파일로부터 t 구간
python ci_mean_calc.py --csv data.csv

# 요약통계로부터 z 구간
python ci_mean_calc.py --n 25 --mean 3.2 --sd 1.1 --known-sigma 1.0 --method z

# 신뢰수준 99%
python ci_mean_calc.py --csv data.csv --cl 0.99
해석
- 신뢰수준 \(1 - \alpha\)는 절차의 장기적 성공률을 기술한다: 연구를 여러 번 반복하며 매번 신뢰구간을 만들면 그중 약 \((1-\alpha)100\%\)가 \(\mu\)를 담는다.
- 구간이 넓다는 것은 불확실성이 크다는 뜻이다. \(n\)이 줄거나, \(s\)(또는 \(\sigma\))가 커지거나, 신뢰수준이 올라가면 너비가 늘어난다.
- \(t\)-구간은 언제나 대응하는 \(z\)-구간 이상으로 넓다. \(n \ge 30\)이면 \(t_{\alpha/2,\,n-1} \approx z_{\alpha/2}\)이므로 차이가 작다.
- 자료가 강하게 비정규이고 \(n\)이 작으면 \(t\)-구간이 명목 포함확률을 달성하지 못할 수 있다. 이럴 때는 비모수 붓스트랩 신뢰구간을 고려하라.
연습문제
연습문제 1. 정규모집단에서 뽑은 관측값 \(n = 16\)개에서 \(\bar{x} = 50\), \(s = 8\)을 얻었다. \(\mu\)의 95%와 99% \(t\)-신뢰구간을 계산하라. 너비는 어떻게 변하는가?
풀이
\(\text{df} = 15\)일 때:
95% 신뢰구간: \(t_{0.025,15} = 2.131\). \(\text{MOE} = 2.131 \times 8/\sqrt{16} = 2.131 \times 2 = 4.262\). 신뢰구간: \((45.74, 54.26)\). 너비 = 8.524.
99% 신뢰구간: \(t_{0.005,15} = 2.947\). \(\text{MOE} = 2.947 \times 2 = 5.894\). 신뢰구간: \((44.11, 55.89)\). 너비 = 11.788.
99% 구간은 95% 구간의 \(11.788/8.524 = 1.38\)배 넓다. 더 높은 확신을 위해서는 더 넓은 범위의 그럴듯한 값을 받아들여야 한다. \(\square\)
연습문제 2. \(z\)-구간의 오차한계가 \(n\)의 감소함수임을 보이고 감소 속도를 구하라.
풀이
오차한계는 \(\text{MOE} = z_{\alpha/2} \cdot \sigma / \sqrt{n}\)이다. \(z_{\alpha/2}\)와 \(\sigma\)가 상수이므로:
따라서 오차한계는 \(n\)에 대해 순감소한다. 감소 속도는 \(O(n^{-1/2})\)이다: \(n\)을 두 배로 하면 오차한계가 \(1/\sqrt{2} \approx 0.707\)배가 되어 약 29% 줄어든다. 오차한계를 절반으로 줄이려면 표본크기를 네 배로 해야 한다. \(\square\)
연습문제 3. 어떤 연구자가 \(n = 100\), \(s = 10\)일 때 \(\mu\)의 95% \(t\)-구간과 \(z\)-구간이 "사실상 같다"고 주장한다. 수치로 확인하라.
풀이
\(n = 100\)이면 \(\text{df} = 99\)이고:
- \(z_{0.025} = 1.960\)
- \(t_{0.025,99} = 1.984\)
표준오차는 \(s/\sqrt{n} = 10/10 = 1\)이다.
- \(z\)-오차한계 \(= 1.960 \times 1 = 1.960\)
- \(t\)-오차한계 \(= 1.984 \times 1 = 1.984\)
차이는 \(1.984 - 1.960 = 0.024\)로 \(z\)-오차한계의 1.3% 미만이다. 표본평균이 예컨대 50이라면 \(z\)-구간은 \((48.040, 51.960)\), \(t\)-구간은 \((48.016, 51.984)\)이다. 연구자의 주장이 옳다: 양쪽 끝에서 0.024 단위만 다르다. \(\square\)
연습문제 4. \(\nu \to \infty\)일 때 \(t_{\alpha/2,\,\nu} \to z_{\alpha/2}\)임을 증명하라.
풀이
\(T \sim t_\nu\)이면 \(T = Z / \sqrt{V/\nu}\)이며 여기서 \(Z \sim N(0,1)\)과 \(V \sim \chi^2_\nu\)는 독립이다. 대수의법칙에 의해 \(\nu \to \infty\)일 때 \(V/\nu \xrightarrow{P} 1\)이다. 따라서 Slutsky 정리에 의해
이다. \(t_\nu\)의 누적분포함수가 표준정규 누적분포함수로 점별 수렴하므로 분위수도 수렴한다:
\(\square\)
연습문제 5. 원자료 \(\{12, 15, 14, 10, 13, 16, 11, 14, 13, 12\}\)에 대해 \(\mu\)의 90% \(t\)-구간을 손으로 계산하고 코드로 확인하라.
풀이
손으로: \(n = 10\), \(\bar{x} = (12+15+14+10+13+16+11+14+13+12)/10 = 130/10 = 13.0\).
\(\text{df} = 9\), \(\alpha = 0.10\), \(t_{0.05,9} = 1.833\)이므로:
90% 신뢰구간은 \((11.94, 14.06)\)이다.
확인:
import numpy as np
from scipy.stats import t
data = np.array([12, 15, 14, 10, 13, 16, 11, 14, 13, 12])
n = len(data)
xbar, s = data.mean(), data.std(ddof=1)
t_crit = t.ppf(0.95, df=n-1)     # 90% 구간이므로 한쪽 꼬리에 5%
moe = t_crit * s / np.sqrt(n)
print(f"({xbar - moe:.2f}, {xbar + moe:.2f})")
출력:
(11.94, 14.06)
\(\square\)
연습문제 6. \(n=16\)인 자료에서 90%, 95%, 99% \(t\)-구간의 폭을 비교하라. 신뢰수준을 95%에서 99%로 올리면 폭이 몇 배가 되는가?
풀이
자유도 15의 \(t\) 임계값을 쓴다. 폭은 \(2t_{15,1-\alpha/2}\,s/\sqrt n\)으로 임계값에 비례하므로, 폭의 비가 곧 임계값의 비다.
from scipy import stats

nu = 15
base = stats.t.ppf(0.975, nu)
for lv in [0.80, 0.90, 0.95, 0.99, 0.999]:
    t = stats.t.ppf(0.5 + lv / 2, nu)
    print(f"{lv:5.1%}  t = {t:.4f}   95% 대비 폭 {t / base:.3f}배")
80.0%  t = 1.3406   95% 대비 폭 0.629배
90.0%  t = 1.7531   95% 대비 폭 0.822배
95.0%  t = 2.1314   95% 대비 폭 1.000배
99.0%  t = 2.9467   95% 대비 폭 1.382배
99.9%  t = 4.0728   95% 대비 폭 1.911배
95% → 99%는 폭이 1.38배다. 신뢰수준 4%포인트를 더 사는 데 폭을 38% 넓혀야 한다.
같은 폭을 유지하며 99%로 올리려면 표본을 몇 배 늘려야 하는가? 폭이 \(1/\sqrt n\)에 비례하므로
약 두 배다. 자유도가 함께 바뀌므로 정확히는 \(n\)을 하나씩 키우며 확인해야 하는데, \(n=28\)에서 처음으로 99% 구간이 원래의 95% 구간보다 좁아진다.
수확체감. 99.9%로 가면 폭이 1.91배, 같은 폭을 위한 표본은 3.65배다. 신뢰수준을 높이는 비용이 가속적으로 커진다. 95%가 관행이 된 데는 이런 균형이 있다.
연습문제 7. \(n=16\), \(\bar x=50\), \(s=8\)인 자료에서 단측 95% 하한과 상한을 각각 구하고, 양측 구간과 비교하라.
풀이
임계값이 다르다. 양측은 \(t_{15,0.975}\), 단측은 \(t_{15,0.95}\)를 쓴다.
import numpy as np
from scipy import stats

n, xbar, s = 16, 50.0, 8.0
se = s / np.sqrt(n)
t2 = stats.t.ppf(0.975, n - 1)
t1 = stats.t.ppf(0.950, n - 1)
print(f"SE = {se:.3f}")
print(f"양측 95%      ({xbar - t2 * se:.3f}, {xbar + t2 * se:.3f})   t = {t2:.4f}")
print(f"단측 95% 하한  ({xbar - t1 * se:.3f}, ∞)          t = {t1:.4f}")
print(f"단측 95% 상한  (-∞, {xbar + t1 * se:.3f})")
SE = 2.000
양측 95%      (45.737, 54.263)   t = 2.1314
단측 95% 하한  (46.494, ∞)          t = 1.7531
단측 95% 상한  (-∞, 53.506)
읽기.
| 하한 | 상한 | |
|---|---|---|
| 양측 95% | 45.74 | 54.26 |
| 단측 95% 하한 | 46.49 | — |
| 단측 95% 상한 | — | 53.51 |
단측 하한이 양측 하한보다 높다. 한쪽에 \(\alpha\) 전부를 몰아주는 대신 다른 쪽을 포기했기 때문이다. 방향을 미리 정했다면 같은 신뢰수준에서 더 강한 진술을 얻는다.
주의 두 가지.
- 방향을 자료를 본 뒤에 정하면 안 된다. \(\bar x\)가 크게 나온 것을 보고 하한만 보고하면 실제 수준은 95%가 아니다.
- 단측 95% 하한은 양측 90% 구간의 하한과 같다. 두 단측 구간을 모두 보고하면 그것은 90% 양측 구간이지 95%가 아니다.
언제 단측인가. 오염물질 농도의 상한, 재료 강도의 하한, 약의 비열등성처럼 한 방향만 실무적 의미가 있을 때다.
연습문제 8. \(t\)-구간이 아핀변환에 불변임을 보이고, 섭씨 자료의 구간을 화씨로 바꾸는 예로 확인하라.
풀이
주장. \(Y_i=a+bX_i\)(\(b>0\))이면 \(\mu_Y\)의 구간은 \(\mu_X\) 구간에 같은 변환을 한 것이다.
증명. \(\bar Y=a+b\bar X\)이고
이므로 \(S_Y=|b|S_X=bS_X\)다. 따라서
\(b<0\)이면 양끝이 뒤바뀔 뿐 같은 집합이다.
수치 확인.
import numpy as np
from scipy import stats

c = np.array([21.3, 22.1, 20.8, 23.4, 21.9, 22.7, 20.5, 23.1])
f = 32 + 1.8 * c                       # 화씨로 변환

def ci(x, lv=0.95):
    n = len(x)
    t = stats.t.ppf(0.5 + lv / 2, n - 1)
    h = t * x.std(ddof=1) / np.sqrt(n)
    return x.mean() - h, x.mean() + h

lo_c, hi_c = ci(c)
lo_f, hi_f = ci(f)
print(f"섭씨 구간        ({lo_c:.4f}, {hi_c:.4f})")
print(f"화씨 구간        ({lo_f:.4f}, {hi_f:.4f})")
print(f"섭씨 구간을 변환  ({32 + 1.8 * lo_c:.4f}, {32 + 1.8 * hi_c:.4f})")
섭씨 구간        (21.0894, 22.8606)
화씨 구간        (69.9609, 73.1491)
섭씨 구간을 변환  (69.9609, 73.1491)
정확히 같다.
비선형 변환에서는 성립하지 않는다. \(\mu\)의 구간에 \(\exp\)를 취한 것은 \(E[e^X]\)의 구간이 아니다. 앞서 본 대로 \(E[e^X]\ne e^{E[X]}\)이기 때문이다. 그것은 기하평균에 대한 구간이다.
실무적 의미. 단위를 바꿔도 결론이 바뀌지 않는다는 것은 절차의 최소 요건이다. 왈드 구간이 비율이나 오즈비에서 척도에 따라 달라지는 것과 대비된다.
연습문제 9. 세 공장에서 각각 \((n,\bar x,s)\)가 \((20, 48.5, 6.0)\), \((35, 51.2, 7.5)\), \((15, 49.8, 5.5)\)였다. 전체 평균의 95% 구간을 구하라. 합동분산을 쓰는 방식과 가중평균 방식을 비교하라.
풀이
가정. 세 공장이 같은 모평균 \(\mu\)와 같은 모분산 \(\sigma^2\)을 가진다고 보자(등분산 가정).
합동분산.
자유도는 \(\sum(n_i-1)=67\)이다.
import numpy as np
from scipy import stats

n = np.array([20, 35, 15])
xb = np.array([48.5, 51.2, 49.8])
s = np.array([6.0, 7.5, 5.5])

N = n.sum()
grand = (n * xb).sum() / N
sp2 = ((n - 1) * s**2).sum() / (n - 1).sum()
df = (n - 1).sum()
se = np.sqrt(sp2 / N)
t = stats.t.ppf(0.975, df)
print(f"전체 평균 {grand:.4f}   합동분산 {sp2:.4f}   자유도 {df}")
print(f"SE {se:.4f}   95% 구간 ({grand - t * se:.3f}, {grand + t * se:.3f})")

# 등분산을 가정하지 않는 방식: 각 평균의 분산으로 역분산 가중
w = n / s**2
mu_w = (w * xb).sum() / w.sum()
se_w = np.sqrt(1 / w.sum())
z = stats.norm.ppf(0.975)
print(f"가중평균 {mu_w:.4f}   SE {se_w:.4f}   "
      f"95% 구간 ({mu_w - z * se_w:.3f}, {mu_w + z * se_w:.3f})")
전체 평균 50.1286   합동분산 45.0746   자유도 67
SE 0.8024   95% 구간 (48.527, 51.730)
가중평균 49.8890   SE 0.7730   95% 구간 (48.374, 51.404)
두 결과가 비슷하다. 분산이 크게 다르지 않기 때문이다.
어느 것을 쓰는가.
- 등분산이 그럴듯하면 합동분산 방식이 자유도를 모두 쓰므로 효율적이다.
- 분산이 다르면 역분산 가중이 낫다. 정밀한 공장에 더 큰 가중치를 준다.
- 다만 가중치를 추정된 분산으로 정하면 소표본에서 편향이 생긴다. \(n_i\)가 작으면 주의한다.
더 중요한 질문. 세 공장의 평균이 정말 같은가? 그렇지 않다면 "전체 평균"이 무엇을 뜻하는지 불분명하다. 앞서 본 심프슨의 역설처럼, 집단을 뭉개면 해석이 왜곡될 수 있다. 분산분석으로 먼저 확인하는 것이 순서다.
연습문제 10. 어떤 연구자가 자료를 모으면서 \(n\)을 하나씩 늘릴 때마다 구간을 다시 계산하고, 구간이 0을 벗어나는 순간 멈춘다. 이 절차의 문제를 모의실험으로 보여라.
풀이
문제의 이름. 선택적 중지(optional stopping) 다. 참 평균이 0인데도 언젠가는 구간이 0을 벗어난다.
import numpy as np
from scipy import stats

rng = np.random.default_rng(11)
M, nmax = 5_000, 200
stopped = 0
for _ in range(M):
    x = rng.normal(0, 1, nmax)
    cs = np.cumsum(x)
    for n in range(5, nmax + 1):
        xb = cs[n - 1] / n
        sd = x[:n].std(ddof=1)
        h = stats.t.ppf(0.975, n - 1) * sd / np.sqrt(n)
        if abs(xb) > h:                  # 구간이 0을 벗어남
            stopped += 1
            break
print(f"참 평균이 0인데 '유의'로 멈춘 비율: {stopped / M:.3f}")
참 평균이 0인데 '유의'로 멈춘 비율: 0.379
명목 5%가 실제로는 38%다. \(n=5\)부터 200까지 196번 들여다보았기 때문이다.
왜 그런가. 각 시점의 구간은 개별적으로 95%를 만족하지만, "어느 한 시점에서라도 벗어날 확률" 은 훨씬 크다. 이것은 다중비교와 같은 구조이며, 반복측정이 강하게 상관되어 있어 \(196\times0.05\)만큼 크지는 않지만 여전히 심각하다.
\(n\to\infty\)이면 확률 1로 멈춘다. 반복로그법칙에 따르면 \(\bar X_n\)의 변동이 \(\sqrt{2\log\log n/n}\) 규모로 무한히 많이 진동하므로, 고정 임계값 \(1.96/\sqrt n\)은 언젠가 반드시 넘어선다. 충분히 오래 보면 무엇이든 "유의"해진다.
대처.
- 표본크기를 미리 정하고 지킨다. 가장 단순하고 확실하다.
- 군순차 설계. 오브라이언-플레밍이나 폴록의 경계를 쓴다. 중간분석 횟수와 시점을 미리 정하고, 전체 수준이 5%가 되도록 각 시점의 임계값을 조정한다.
- 언제나 타당한 구간(anytime-valid). 신뢰순차(confidence sequence)를 쓰면 모든 \(n\)에서 동시에 포함확률을 보장한다. 폭이 \(\sqrt{\log\log n}\)만큼 넓어지는 대가를 치른다.
- 베이즈 사후분포. 사후분포 자체는 중지규칙에 영향받지 않는다(가능도원리). 다만 빈도주의 성질은 여전히 무너진다.
보고할 것. 중간분석을 했다면 몇 번, 언제 했는지 반드시 밝힌다. 이것을 숨기는 것이 재현성 위기의 주요 원인 중 하나다.
정리하며
평균의 신뢰구간을 실제로 계산하는 절차를 정리했다.
- \(\sigma\) 를 아는가로 갈린다. 알면 \(z\) 임계값, 모르면 \(t_{\alpha/2,n-1}\) 이다. 실무에서는 거의 언제나 후자다.
- 입력이 원자료든 요약통계량이든 같다. \(\bar x\), \(s\), \(n\) 세 수만 있으면 구간이 나오므로, 논문에 보고된 요약만으로도 구간을 재구성할 수 있다.
- 자유도를 빠뜨리지 말 것.
stats.t.ppf(0.975, df=n-1)에서df를 잘못 주면 조용히 틀린 구간이 나온다. \(n\) 이 작을수록 오차가 크다. - 구간은 \(\bar x\) 에 대해 대칭이다. 평균의 구간에서만 그렇고, 분산이나 비율에서는 그렇지 않다.
- 보고 형식. 점추정값·구간·신뢰수준·표본크기를 함께 적는 것이 관례다. 구간만 적으면 어떤 수준인지 알 수 없다.
다음 절 일표본 비율 신뢰구간의 계산으로 넘어간다.