A/B 검정과 실험 설계
개요
실무에서 연구자와 분석가는 서로 다른 처치의 효과를 비교해야 하는 경우가 많다. 제약회사가 두 가지 약 제형을 시험하고, 기술기업이 세 가지 웹사이트 배치를 평가하며, 경제학자가 지역별 정책 개입을 비교한다. 이런 비교에는 오류율을 통제하면서 분명한 판정 규칙을 주는 원리적인 통계 틀이 필요하다. A/B 검정은 실험 설계 원리와 가설검정을 결합하여 이 과정을 형식화하며, 처치군이 셋 이상이면 분석은 이 장 앞부분에서 전개한 일원배치 분산분석의 틀로 귀착된다.
이 절에서는 A/B 검정의 통계적 토대를 세우고, 분산분석 F-검정과의 연결을 명시적으로 짓고, 표본크기 결정과 다중비교라는 실무적 고려사항을 다룬다.
설계 원리
잘 설계된 A/B 검정은 세 가지 기본 원리에 기대며, 각각은 직접적인 통계적 정당화를 갖는다.
무작위화. 대상을 무작위 기제(예: 의사난수 생성기)로 처치군에 배정한다. 무작위화는 관측되든 관측되지 않든 모든 잠재적 교란변수와 처치 배정이 독립임을 보장한다. 무작위화가 없으면 집단 사이에서 관측된 차이가 참된 처치 효과가 아니라 사전에 존재하던 차이를 반영할 수 있다.
통제. 모든 실험은 처치를 받지 않거나 현재 표준을 적용받는 기준 집단(대조군)을 포함한다. 대조군은 처치 효과를 재는 기준을 제공한다. 분산분석 모형에서 대조군의 평균은 기준 \(\mu_1\)의 역할을 한다(처치 효과를 편차 \(\alpha_i\)로 모수화하면 절편 \(\mu\)가 그 역할을 한다).
반복. 각 처치군은 실질적으로 의미 있는 효과를 충분한 검정력으로 탐지할 만큼의 독립인 관측값을 담아야 한다. 반복은 집단 내 분산 추정값을 줄이고 처치 차이의 신뢰구간을 좁힌다. 다음 소절에서 표본크기 요건을 형식화한다.
이 원리들은 그 결과 얻어지는 자료가 분산분석 F-검정이 요구하는 독립성과 동일분포 가정을 만족하도록 보장한다.
분산분석과의 연결
두 집단인 경우
A/B 검정이 정확히 두 집단(대조 대 처치)을 비교하면 분석가는
를 검정한다. 여기서 \(\mu_1\)과 \(\mu_2\)는 각각 대조군과 처치군의 모평균이다. 등분산 가정 아래에서 검정통계량은 이표본 \(t\)-통계량
이며 \(s_p\)는 합동 표준편차, \(n_1, n_2\)는 집단 크기이다. 이 \(t\)-통계량은 \(H_0\) 아래에서 자유도 \(n_1 + n_2 - 2\)인 \(t\)-분포를 따른다.
여러 집단인 경우
실험에 (대조군을 포함하여) \(k \geq 2\)개의 처치군이 있으면 가설검정은 다음으로 일반화된다:
이것이 바로 일원배치 분산분석의 가설이다. 모형
아래에서(여기서 \(i = 1, \ldots, k\)는 집단, \(j = 1, \ldots, n_i\)는 집단 \(i\) 안의 관측값을 나타내고 \(\mu\)는 전체 평균, \(\alpha_i\)는 처치 \(i\)의 효과이며 식별을 위해 \(\sum_{i=1}^k n_i \alpha_i = 0\)을 둔다) 검정통계량은 F-비
이다. \(N = \sum_{i=1}^k n_i\)는 전체 표본크기, SSB는 집단 간 제곱합, SSW는 집단 내 제곱합이다. \(H_0\) 아래에서 이 통계량은 \(F(k-1, \, N-k)\) 분포를 따른다. \(F > F_{\alpha, \, k-1, \, N-k}\)이면 유의수준 \(\alpha\)에서 귀무가설을 기각한다.
두 집단은 분산분석의 특수한 경우
\(k = 2\)일 때 F-통계량은 \(t^2\)과 같다. 여기서 \(t\)는 이표본 \(t\)-통계량이다. 두 집단의 일원배치 분산분석과 이표본 \(t\)-검정은 언제나 같은 \(p\)-값을 준다.
사후비교
F-검정이 유의하다는 것은 적어도 한 집단의 평균이 다르다는 뜻이지만 어느 쌍이 다른지는 알려주지 않는다. 어떤 처치가 대조군(또는 서로)보다 나은지 판정하려면 사후 쌍별 비교 방법이 필요하다. 이 방법들은 여러 비교에 걸쳐 제1종 오류율이 부풀려지지 않도록 가족단위 오류율(FWER)을 통제한다. 흔한 선택은 모든 쌍별 비교에 대한 Tukey HSD와, 각 처치를 하나의 대조군과 비교할 때의 Dunnett 검정이다. 이 방법들의 전체 논의는 사후비교를 보라.
표본크기 결정
A/B 검정을 시작하기 전에 분석가는 의미 있는 효과를 탐지하는 데 집단당 관측값이 몇 개 필요한지 정해야 한다. 필요한 표본크기는 유의수준 \(\alpha\), 원하는 검정력 \(1 - \beta\), 최소 탐지 효과크기의 세 가지에 달려 있다.
집단 크기가 같은 두 집단의 경우, 유의수준 \(\alpha\)에서 검정력 \(1 - \beta\)로 효과크기 \(\delta = \mu_1 - \mu_2\)를 탐지하는 데 필요한 집단당 표본크기는 근사적으로
이다. 여기서 \(z_{\alpha/2}\)와 \(z_\beta\)는 각각 양측 유의수준과 원하는 검정력에 대응하는 표준정규 임계값이고 \(\sigma^2\)은 공통 집단 내 분산이다.
표본크기 계산
어떤 웹사이트 A/B 검정이 전환율에서 \(\delta = 0.5\)퍼센트포인트의 차이(확률 척도로는 \(\delta = 0.005\))를, 기저 전환율 \(p = 0.05\)이어서 \(\sigma^2 \approx p(1-p) = 0.0475\)인 상황에서 \(\alpha = 0.05\), 검정력 \(1 - \beta = 0.80\)으로 탐지하려 한다고 하자. 임계값은 \(z_{0.025} = 1.96\), \(z_{0.20} = 0.84\)이다. 그러면
각 집단에 약 30,000명의 사용자가 필요하다. 작은 효과를 탐지하려면 큰 표본이 필요하다는 점을 새삼 일깨운다.
여러 집단 설계에서는 검정력 분석이 F-검정 틀로 확장되며, 효과크기는 보통 Cohen의 \(f\)로 표현한다:
여기서 \(\sigma_\alpha = \sqrt{\frac{1}{k}\sum_{i=1}^k \alpha_i^2}\)는 처치 효과의 표준편차를 잰다. 관례적인 기준은 \(f = 0.10\)(작음), \(f = 0.25\)(중간), \(f = 0.40\)(큼)이다.
흔한 함정
엿보기와 조기 중단
A/B 검정에서 자주 저지르는 실수는 자료를 모으는 동안 결과를 반복해서 확인하다가 유의한 결과가 나오는 즉시 실험을 멈추는 것이다. 이 관행은 중간에 들여다볼 때마다 가설검정을 하나 더 하는 셈이어서 제1종 오류율을 명목 \(\alpha\)보다 크게 부풀린다. 순차검정 방법(예: 그룹 순차 설계나 항상 타당한 \(p\)-값)은 전체 오류율을 통제하면서 조기 중단을 허용하는 원리적인 대안이다.
"부풀린다"가 얼마인지는 재어 보아야 감이 온다. 두 팔이 완전히 같은 분포에서 나오는 A/B 검정을 4,000번 모의실험하고, 팔당 \(5{,}000\)명까지 자료를 모으는 동안 결과를 \(K\)번 확인하면서 한 번이라도 \(p < 0.05\)가 나오면 멈추는 규칙을 적용했다.
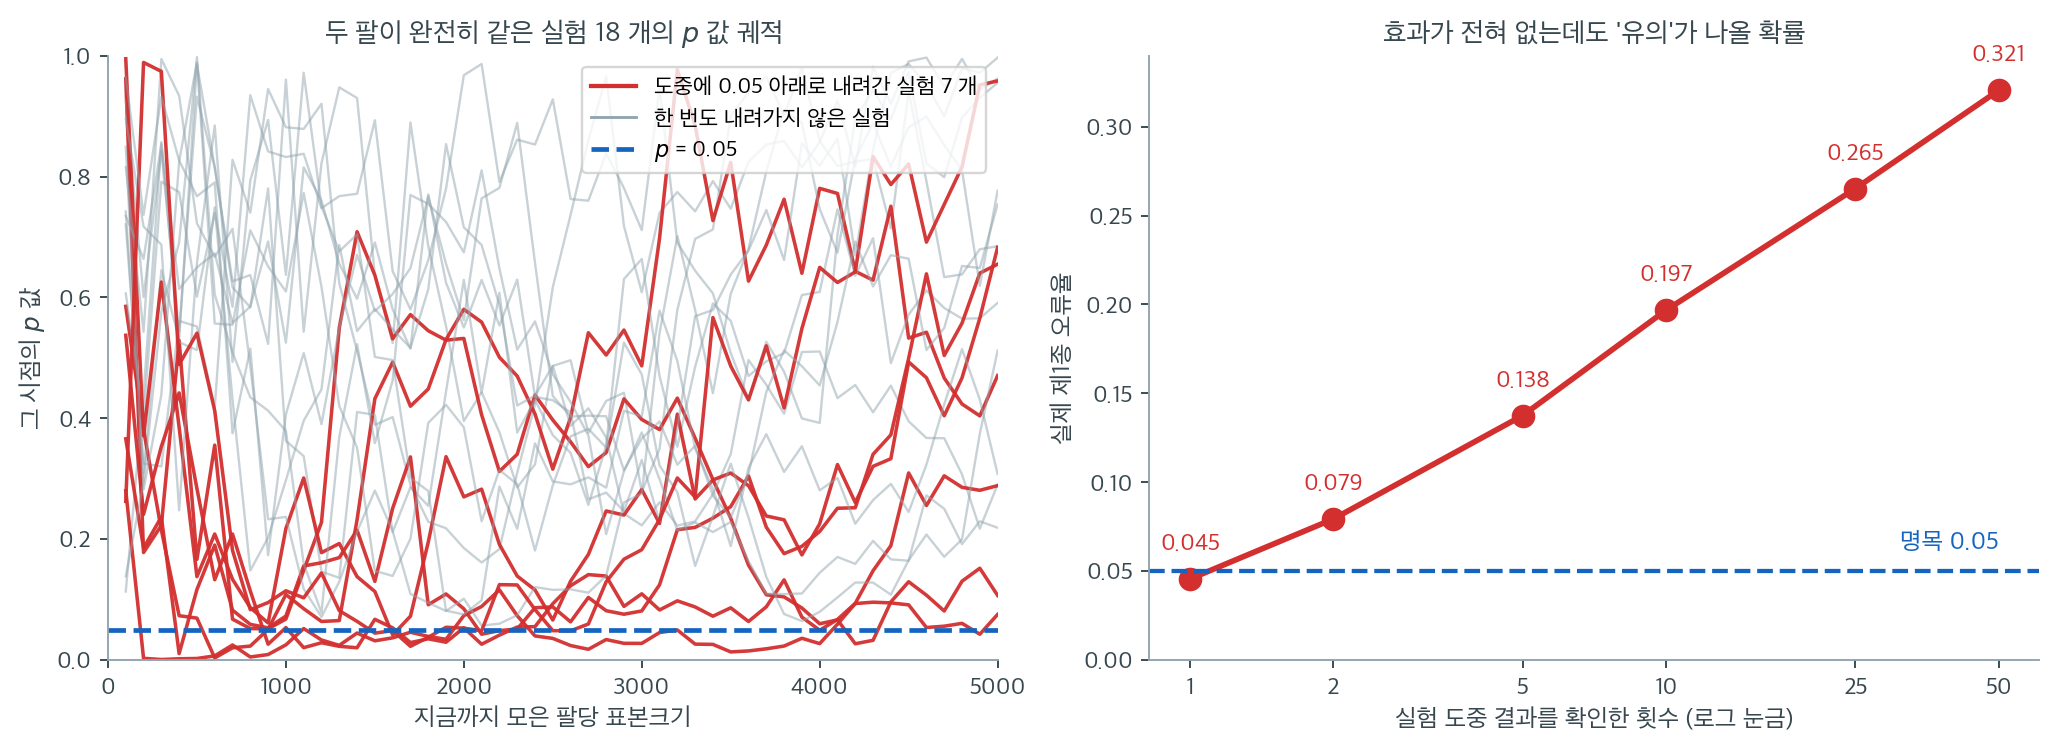
왼쪽이 \(p\) 값 궤적 18개다. 참 효과가 정확히 \(0\)인데도 선들이 쉴 새 없이 오르내린다. \(p\) 값은 표본이 쌓일수록 어떤 값으로 수렴하는 양이 아니다. \(H_0\)이 참이면 매 시점의 \(p\)가 \([0, 1]\) 위에서 균등분포를 따르므로, 시간이 지나도 계속 새로 주사위를 굴리는 것과 같다. 그래서 18개 중 7개가 어느 시점에선가 \(0.05\) 아래로 내려간다. 그중 상당수는 조금 더 기다리면 다시 위로 올라간다. 그 순간에 실험을 멈춘 사람은 존재하지 않는 효과를 발견했다고 믿게 된다.
오른쪽이 그 결과다. 끝까지 모으고 한 번만 보면 기각률이 \(0.045\)로 정확하다. 중간에 한 번 더 보면(총 2회) \(0.079\), 다섯 번이면 \(0.138\), 열 번이면 \(0.197\), 대시보드를 매일 들여다보듯 50번이면 \(0.321\)이다. \(\alpha = 0.05\)로 설계한 실험이 실제로는 \(\alpha \approx 0.32\)로 돌아가고 있는 셈이다.
여기서 흔한 오해를 짚어 둘 필요가 있다. "표본을 더 모으면 정확해지니 괜찮다"가 아니다. 문제는 표본크기가 아니라 멈추는 시점을 결과에 따라 고른다는 데 있다. 정지 규칙이 자료에 의존하면 검정통계량의 귀무분포가 더 이상 우리가 쓰는 \(t\)나 \(F\) 분포가 아니다. 위 그림의 \(0.321\)은 "최솟값의 분포"에서 나온 수치이며, 본질적으로 앞 절의 다중비교 문제와 같은 구조다. 다만 여기서는 비교가 집단 쌍이 아니라 시점이라는 점이 다를 뿐이다.
처방도 다중비교와 같은 논리를 따른다. 확인 횟수를 미리 정하고 각 시점의 유의수준을 낮추거나(오브라이언–플레밍 같은 그룹 순차 경계), 언제 멈추어도 타당한 \(p\) 값·신뢰수열을 쓴다. 가장 값싼 처방은 "표본크기를 미리 정하고 그때까지 보지 않는 것"이다. 위 표본크기 계산이 실험 시작 전에 이루어져야 하는 이유가 이것이다.
보정 없는 다중비교
집단이 \(k\)개면 쌍별 비교의 수는 \(\binom{k}{2}\)이다. 보정 없이 각각을 수준 \(\alpha\)에서 수행하면 가족단위 오류율이 \(1 - (1 - \alpha)^{\binom{k}{2}}\)까지 부풀 수 있어 상당히 커진다. 예를 들어 \(k = 5\)이고 \(\alpha = 0.05\)이면 FWER이 약 \(0.40\)에 이른다. Bonferroni나 Tukey HSD 같은 다중비교 보정을 반드시 적용하라.
연습문제
연습문제 1. 어떤 웹사이트가 결제 버튼에 대해 세 가지 변형(A, B, C)으로 A/B 검정을 수행했다. 2주 뒤 전환율은 A = 5.2%(\(n_A = 3000\)), B = 6.1%(\(n_B = 3000\)), C = 5.8%(\(n_C = 3000\))이다. 각 쌍을 z-검정으로 단순 비교하는 것이 왜 충분하지 않은가?
풀이
세 쌍(A 대 B, A 대 C, B 대 C)을 모두 비교하면 가설검정이 3개가 되어 가족단위 오류율이 부풀려진다. 검정당 \(\alpha = 0.05\)이면 전역 귀무가설 아래에서 FWER이 \(1 - 0.95^3 \approx 0.143\)으로 의도한 수준의 거의 세 배가 된다.
대신 다음 중 하나를 해야 한다:
- 분산분석(또는 비율에 대한 카이제곱 검정)을 전체검정으로 먼저 수행한다. 기각하면 다중검정 보정(Bonferroni, Tukey, 대조군과 비교한다면 Dunnett)을 적용한 쌍별 비교로 이어간다.
- 하나의 주요 비교를 미리 지정한다(예: 최선의 변형 대 대조). 그 비교에 대해서만 조정한다.
- Bonferroni를 적용한다. 각 쌍별 비교에 \(\alpha/3 = 0.0167\)을 쓴다.
연습문제 2. 어떤 A/B 검정이 3일 만에 처치군에서 "유의한" 개선이 보인다는 이유로 조기 중단되었다. 미리 정한 중단 규칙 없이 조기 중단할 때의 통계적 문제를 설명하라.
풀이
규칙을 미리 정하지 않은 조기 중단은 임의 중단(엿보기라고도 한다)을 통해 제1종 오류율을 부풀린다. 여러 시점에서 유의성을 확인하다가 \(p < 0.05\)가 되는 즉시 멈추면, 쌓여 가는 자료에 대해 사실상 여러 번 검정하는 셈이다.
자주 엿볼수록 귀무가설 아래에서 우연히 \(p < 0.05\)를 관측할 확률이 높아진다. 모의실험에 따르면 명목 \(\alpha = 0.05\)에서도 연속적인 모니터링은 실제 제1종 오류율을 20–30%까지 부풀릴 수 있다.
올바른 접근은 다음과 같다:
- 순차검정(그룹 순차 설계): 중간분석의 횟수를 미리 정하고 조정된 유의성 경계(예: O'Brien-Fleming, Pocock)를 쓴다.
- 항상 타당한 p-값이나 연속 모니터링에서도 제1종 오류를 통제하는 신뢰수열.
- 고정 지평 검정: 표본크기를 미리 정하고 마지막에만 분석한다.
연습문제 3. 어떤 회사가 1주일간 A/B 검정을 수행하여 p-값 0.04와 전환율 0.3% 증가 추정값을 얻었다. CEO가 새 기능을 즉시 출시하라고 한다. 데이터 과학자는 어떤 추가 고려사항을 제기해야 하는가?
풀이
-
실질적 유의성: 0.3% 증가는 통계적으로 유의해도 경제적으로는 무시할 만할 수 있다. 신뢰구간을 살펴야 한다. 구간이 의미 없을 만큼 작은 효과를 포함한다면 구현 비용을 정당화하지 못할 수 있다.
-
기간: 1주일로는 주간 주기, 계절 효과, 신기 효과를 담지 못할 수 있다. 개선이 사라질 수도 있다(새 기능에 처음 호기심을 보이던 사용자가 원래 행동으로 돌아간다).
-
표본 비율 불일치: 무작위화가 균형 잡혔는지 확인하라. 처치군과 대조군의 크기가 예상과 다르게 차이가 나면 실험이 오염되었을 수 있다.
-
여러 지표: 주요 지표는 개선되었지만 부차 지표(사용자당 매출, 유지율)가 나빠졌다면 순효과가 음수일 수 있다.
-
세그먼트 효과: 집계 수준의 개선이 이질성을 감출 수 있다. 어떤 사용자 집단에는 도움이 되고 다른 집단에는 해가 될 수 있다.
연습문제 4. 전환율에 대한 A/B/C 검정에서 분산분석과 카이제곱 검정을 쓰는 것의 차이를 설명하라. 각각은 언제 적절한가?
풀이
카이제곱 독립성 검정: 결과가 범주형일 때(예: 전환 대 비전환) 쓴다. 집단 × 결과의 분할표를 만들어 전환율이 집단마다 다른지 검정한다. 이진이거나 여러 범주인 결과에 적절하다.
분산분석: 결과가 연속형일 때(예: 사용자당 매출, 페이지 체류시간) 쓴다. 집단 평균이 다른지 검정한다. 근사적 정규성과 등분산을 요구한다(또는 Welch 분산분석을 쓴다).
전환율(이진 결과)에는 자료가 정규가 아니라 베르누이분포를 따르므로 카이제곱 검정이나 로지스틱 회귀가 더 적절하다. 표본이 크면 분산분석이 카이제곱 검정을 근사할 수 있지만(이진 자료에서 둘은 점근적으로 동등하다), 카이제곱 검정이 자연스러운 선택이다.
연속형 지표(매출, 참여 시간)에는 분산분석이 적절하다. 자료가 심하게 치우쳐 있으면(0이 많은 매출 자료에서 흔하다) 변환, 비모수 검정, 또는 붓스트랩 접근을 고려하라.
연습문제 5. 연습문제 2의 조기 중단(peeking)이 얼마나 위험한지 재라. 중간 확인 횟수에 따라 오류율이 어떻게 변하는가?
풀이
import warnings
warnings.filterwarnings("ignore")

import numpy as np

rng = np.random.default_rng(16001)
B = 4_000
p0, N = 0.05, 6_000      # 두 군의 참 전환율이 같고, 군당 최대 표본 6000
checks = {
    "1회 (끝에만)": [N],
    "5회": [N // 5 * i for i in range(1, 6)],
    "20회": [N // 20 * i for i in range(1, 21)],
    "매일(14회)": [N // 14 * i for i in range(1, 15)],
}
print("A 와 B 의 참 전환율이 같을 때, '유의하면 중단'의 실제 오류율")
print(f"{'중간 확인 횟수':>16s} {'오류율':>8s}")
for lab, cs in checks.items():
    hit = 0
    for _ in range(B):
        a = rng.binomial(1, p0, N)
        b = rng.binomial(1, p0, N)
        for c in cs:
            x1, x2 = a[:c].sum(), b[:c].sum()
            ph = (x1 + x2) / (2 * c)
            se = np.sqrt(2 * ph * (1 - ph) / c) if ph > 0 else 1
            z = (x1 - x2) / c / se if se > 0 else 0
            if abs(z) > 1.96:
                hit += 1
                break
    print(f"{lab:>16s} {hit / B:8.4f}")
A 와 B 의 참 전환율이 같을 때, '유의하면 중단'의 실제 오류율
        중간 확인 횟수      오류율
        1회 (끝에만)   0.0483
              5회   0.1330
             20회   0.2495
         매일(14회)   0.2067
20번 훔쳐보면 오류율이 0.25다. 명목의 다섯 배다.
| 확인 횟수 | 오류율 | 명목 대비 |
|---|---|---|
| 1(끝에만) | 0.048 | 1.0배 |
| 5 | 0.133 | 2.7배 |
| 매일(14) | 0.207 | 4.1배 |
| 20 | 0.250 | 5.0배 |
매일 확인하는 2주짜리 실험은 오류율이 0.21이다. 실무에서 흔한 관행이다.
왜 그런가. 각 확인이 독립적인 기회를 준다. \(z\) 통계량이 시간에 따라 무작위 보행하듯 움직이므로, 오래 보면 언젠가 \(\pm1.96\)을 넘는다.
무한히 보면 반드시 "유의"해진다. 이것이 "무한 peeking의 정리"다.
올바른 대응 넷.
| 방법 | 내용 |
|---|---|
| 고정 표본 | 표본 크기를 정하고 끝까지 본다(가장 단순) |
| 군집 순차 설계 | 오브라이언-플레밍 등으로 \(\alpha\)를 시점에 배분 |
| 알파 소모 함수 | 중간 분석마다 \(\alpha\)를 조금씩 쓴다 |
| 언제나 유효한 추론 | 신뢰순차(confidence sequence), \(e\)-값 |
군집 순차의 예(오브라이언-플레밍, 5회 확인).
| 확인 시점 | 명목 \(\alpha\) |
|---|---|
| 20% | 0.000001 |
| 40% | 0.0013 |
| 60% | 0.0084 |
| 80% | 0.0225 |
| 100% | 0.0413 |
초기에는 거의 기각하지 않고, 마지막에 대부분의 \(\alpha\)를 쓴다. 전체 FWER이 0.05로 통제된다.
네 번째가 최근 실무의 흐름이다. 신뢰순차는 언제 멈춰도 유효한 구간을 준다. 다만 고정 표본보다 넓은 구간이 대가다.
연습문제 2의 답. "3일 만에 유의했다"는 것은 20번 확인 중 한 번 걸린 것일 수 있다. 사전에 중단 규칙이 없었다면 그 \(p\)-값은 해석할 수 없다. 실험을 계획한 표본까지 계속하거나, 새 실험으로 재현해야 한다.
연습문제 6. A/B 검정의 표본 크기를 기준 전환율과 목표 개선폭에 따라 계산하라. 왜 실무에서 표본이 그렇게 큰가?
풀이
두 비율 비교의 표본 크기 공식.
import numpy as np
from scipy import stats

def n_prop(p1, lift, alpha=0.05, power=0.8):
    """상대 개선 lift 를 탐지하는 데 필요한 군당 표본."""
    p2 = p1 * (1 + lift)
    z1 = stats.norm.ppf(1 - alpha / 2)
    z2 = stats.norm.ppf(power)
    pbar = (p1 + p2) / 2
    num = (z1 * np.sqrt(2 * pbar * (1 - pbar))
           + z2 * np.sqrt(p1 * (1 - p1) + p2 * (1 - p2)))**2
    return int(np.ceil(num / (p2 - p1)**2))

lifts = [0.05, 0.10, 0.20, 0.50]
print("군당 필요한 표본 (α=0.05 양측, 검정력 0.80)")
print(f"{'기준 전환율':>10s} "
      + " ".join(f"{'+' + str(int(l * 100)) + '%':>10s}" for l in lifts))
for p1 in [0.01, 0.02, 0.05, 0.10, 0.20]:
    print(f"{p1:10.2%} " + " ".join(f"{n_prop(p1, l):10,d}" for l in lifts))
군당 필요한 표본 (α=0.05 양측, 검정력 0.80)
    기준 전환율        +5%       +10%       +20%       +50%
     1.00%    637,010    163,095     42,693      7,750
     2.00%    315,206     80,682     21,109      3,826
     5.00%    122,124     31,234      8,158      1,471
    10.00%     57,763     14,751      3,841        686
    20.00%     25,583      6,510      1,683        294
전환율 1%에서 상대 5% 개선을 잡으려면 군당 63만 7천 명이 필요하다.
| 기준 전환율 | \(+5\%\) | \(+20\%\) |
|---|---|---|
| 1% | 637,010 | 42,693 |
| 5% | 122,124 | 8,158 |
| 20% | 25,583 | 1,683 |
두 가지 규칙이 보인다.
- 기준 전환율이 낮을수록 표본이 많이 필요하다. 1%에서 20%로 가면 25배 줄어든다.
- 개선폭이 절반이면 표본이 네 배다. \(+10\%\)에서 \(+5\%\)로 가면 163,095에서 637,010으로 3.9배다.
왜 낮은 전환율이 불리한가. 상대 개선 \(r\)을 절대 차이로 바꾸면 \(p_1r\)이고, 분산은 \(p_1(1-p_1)\approx p_1\)이다.
\(p_1\)에 반비례한다. 전환율이 20배 낮으면 표본이 20배 필요하다(표에서 25,583 대 637,010으로 24.9배).
실무의 현실.
| 서비스 규모 | 월 방문 | \(+5\%\) 탐지 가능? |
|---|---|---|
| 소규모(1만/월) | 10,000 | 불가능(전환 5%면 12개월) |
| 중규모(50만/월) | 500,000 | 약 2주 |
| 대규모(1000만/월) | 10,000,000 | 하루 |
소규모 서비스에서 5% 개선을 검정하는 것은 사실상 불가능하다. 그래서
| 전략 | 내용 |
|---|---|
| 큰 변화만 시험 | \(+20\%\) 이상을 노리는 실험 |
| 선행 지표 사용 | 전환 대신 클릭·체류시간(분산이 작다) |
| 베이즈 방법 | 사전분포로 정보를 보강 |
| 실험을 길게 | 계절성·신규성 효과에 주의 |
두 번째가 실무적 해법이다. 전환율 2%보다 클릭률 30%가 훨씬 적은 표본으로 검정된다.
주의 — 표본이 크면 사소한 차이도 유의해진다. \(n=100\)만이면 \(+0.5\%\)도 유의하다. 실질적 유의성(수익 영향)을 반드시 함께 본다.
연습문제 7. 연습문제 4의 답을 수치로 확인하라. 전환율 자료에서 분산분석 \(F\)와 카이제곱은 정말 다른가?
풀이
import warnings
warnings.filterwarnings("ignore")

import numpy as np
from scipy import stats

def chi2_p(xs, ns):
    obs = np.array([xs, np.array(ns) - np.array(xs)], float)
    if (obs.sum(1) == 0).any():
        return 1.0
    return stats.chi2_contingency(obs)[1]

rng = np.random.default_rng(16002)
B = 6_000
print("0/1 자료에 두 검정을 적용한 기각률 (명목 0.05)")
print(f"{'상황':>28s} {'분산분석 F':>10s} {'카이제곱':>9s}")
for lab, ps, ns in [("귀무 p=5%, n=3000 씩", [0.05] * 3, [3000] * 3),
                    ("귀무 p=1%, n=1000 씩", [0.01] * 3, [1000] * 3),
                    ("귀무 p=0.2%, n=500 씩", [0.002] * 3, [500] * 3),
                    ("대립 p=(5.0,5.8,6.1)%", [0.050, 0.058, 0.061],
                     [3000] * 3)]:
    a = b = 0
    for _ in range(B):
        xs = [rng.binomial(n, p) for n, p in zip(ns, ps)]
        gs = [np.concatenate([np.ones(x), np.zeros(n - x)])
              for x, n in zip(xs, ns)]
        a += stats.f_oneway(*gs).pvalue < 0.05
        b += chi2_p(xs, ns) < 0.05
    print(f"{lab:>28s} {a / B:10.4f} {b / B:9.4f}")
0/1 자료에 두 검정을 적용한 기각률 (명목 0.05)
                          상황     분산분석 F      카이제곱
           귀무 p=5%, n=3000 씩     0.0488    0.0488
           귀무 p=1%, n=1000 씩     0.0462    0.0462
          귀무 p=0.2%, n=500 씩     0.0377    0.0377
         대립 p=(5.0,5.8,6.1)%     0.3778    0.3778
네 상황 모두에서 기각률이 소수점 넷째 자리까지 같다. 두 검정의 판정이 모든 반복에서 일치한다.
우연이 아니다. 두 통계량은 단조 관계다.
한쪽이 크면 다른 쪽도 크다. 임계값도 서로 대응하므로 같은 판정을 내린다.
rng = np.random.default_rng(5)
ns = [3000, 3000, 3000]
xs = [rng.binomial(n, p) for n, p in zip(ns, [0.050, 0.058, 0.061])]
gs = [np.concatenate([np.ones(x), np.zeros(n - x)]) for x, n in zip(xs, ns)]
r = stats.f_oneway(*gs)
c = stats.chi2_contingency(np.array([xs, np.array(ns) - np.array(xs)], float),
                           correction=False)
N, k = sum(ns), 3
print(f"전환 수 = {xs},  n = {ns}")
print(f"분산분석  F = {r.statistic:.6f},  p = {r.pvalue:.6f}")
print(f"카이제곱  X² = {c[0]:.6f},  p = {c[1]:.6f}")
print(f"관계식 (N-1)(k-1)F / [(N-k)+(k-1)F] = "
      f"{(N - 1) * (k - 1) * r.statistic / ((N - k) + (k - 1) * r.statistic):.6f}")
전환 수 = [162, 167, 198],  n = [3000, 3000, 3000]
분산분석  F = 2.300157,  p = 0.100302
카이제곱  X² = 4.599497,  p = 0.100284
관계식 (N-1)(k-1)F / [(N-k)+(k-1)F] = 4.598986
\(p\)-값이 0.100302와 0.100284로 소수점 넷째 자리까지 같다.
그럼 연습문제 4의 답은 무엇인가. "둘이 다르다"가 아니라 "거의 같지만 다른 근거 위에 서 있다"가 정확하다.
| 분산분석 \(F\) | 카이제곱 | |
|---|---|---|
| 모형 | \(y_{ij}=\mu_i+\varepsilon\), 정규 가정 | 다항분포, 정확한 이산 모형 |
| 기준분포 | \(F(k-1,N-k)\) | \(\chi^2(k-1)\) |
| 소표본 | 정규 근사에 의존 | 기대도수 \(\geq5\) 필요 |
| 확장 | 공변량·요인 추가 쉬움 | 분할표 구조에 한정 |
\(p=0.2\%\), \(n=500\)에서 둘 다 0.0377로 보수적이다. 기대 전환 수가 1개뿐이라 근사가 깨진다. 이때는 피셔의 정확검정이나 로지스틱 회귀가 맞다.
실무 권고.
| 상황 | 권장 |
|---|---|
| 전환율이 충분히 크고(\(np\geq10\)) 군만 비교 | 카이제곱(관례) |
| 공변량 조정이 필요(기기, 지역, 신규/기존) | 로지스틱 회귀 |
| 전환 수가 아주 적음 | 피셔 정확검정 |
| 사후비교가 필요 | 로지스틱 + 더넷/튜키 |
두 번째가 현대 A/B 검정의 표준이다. 무작위 배정이 되어도 공변량을 넣으면 분산이 줄어 검정력이 올라간다(CUPED 등).
연습문제 8. 연습문제 3의 CEO에게 할 말을 수치로 뒷받침하라. 승자의 저주가 얼마나 큰가?
풀이
승자의 저주. 유의한 결과만 보고하면 효과크기가 체계적으로 과대추정된다. 검정력이 낮을수록 심하다.
import numpy as np

rng = np.random.default_rng(16003)
B = 20_000
print("참 전환율 A=5.00%, B=5.25% (참 상대 개선 +5.0%)")
print(f"{'군당 n':>8s} {'검정력':>8s} {'유의한 것만의 평균 개선':>20s} "
      f"{'과대추정 배수':>12s}")
for n in [2_000, 5_000, 10_000, 30_000, 100_000]:
    lifts, cnt = [], 0
    for _ in range(B):
        xa = rng.binomial(n, 0.0500)
        xb = rng.binomial(n, 0.0525)
        pa, pb = xa / n, xb / n
        ph = (xa + xb) / (2 * n)
        se = np.sqrt(2 * ph * (1 - ph) / n)
        if se > 0 and abs(pb - pa) / se > 1.96:
            cnt += 1
            if pa > 0:
                lifts.append((pb - pa) / pa)
    m = np.mean(lifts) if lifts else float("nan")
    print(f"{n:8,d} {cnt / B:8.4f} {m:20.2%} {m / 0.05:12.2f}")
참 전환율 A=5.00%, B=5.25% (참 상대 개선 +5.0%)
    군당 n      검정력        유의한 것만의 평균 개선      과대추정 배수
   2,000   0.0639               28.41%         5.68
   5,000   0.0874               20.12%         4.02
  10,000   0.1257               15.39%         3.08
  30,000   0.2861                9.49%         1.90
 100,000   0.7145                5.97%         1.19
\(n=2{,}000\)에서 유의한 결과의 평균 개선이 28.4%다. 참값은 5%다. 5.7배 과대추정이다.
| 군당 \(n\) | 검정력 | 보고되는 개선 | 과대추정 |
|---|---|---|---|
| 2,000 | 0.064 | 28.4% | 5.7배 |
| 10,000 | 0.126 | 15.4% | 3.1배 |
| 30,000 | 0.286 | 9.5% | 1.9배 |
| 100,000 | 0.715 | 6.0% | 1.2배 |
검정력이 0.8 근처면 과대추정이 20%로 줄어든다. 검정력이 낮을수록 저주가 심하다.
왜 그런가. 유의하려면 \(|\hat\delta|>1.96\,\text{SE}\)여야 한다. 참 효과가 작으면 우연히 크게 나온 표본만 통과한다.
연습문제 3의 CEO에게 할 말.
검정 결과: p = 0.04,  추정 개선 +0.3%p

제기해야 할 고려사항 여섯

1. 효과크기의 과대추정
   이 실험의 검정력이 낮다면 실제 개선은 0.3%p 보다 작을 가능성이
   높습니다. 신뢰구간을 보아야 합니다.

2. 신뢰구간
   p=0.04 는 구간의 한쪽 끝이 0 에 매우 가깝다는 뜻입니다.
   "개선이 0 에 가까울 수도 있다"를 배제하지 못합니다.

3. 1주일이라는 기간
   요일 효과, 신규성 효과(novelty effect)가 섞여 있을 수 있습니다.
   최소 2주(완전한 주 단위)를 권합니다.

4. 중간에 몇 번 확인했는가
   사전에 정한 표본까지 기다렸다면 p=0.04 가 유효합니다.
   매일 확인했다면 실제 오류율이 0.2 수준입니다.

5. 다른 지표의 변화
   전환율이 올라도 객단가·재방문·이탈이 나빠졌을 수 있습니다.

6. 구현·운영 비용
   0.3%p 개선의 연간 수익 증가와 유지보수 비용을 비교해야 합니다.
1번과 2번이 통계적 핵심이다. \(p\)가 0.05에 가까우면 효과크기 추정은 거의 정보가 없다.
실무 대응 넷.
| 방법 | 내용 |
|---|---|
| 신뢰구간을 보고 | \(p\) 대신 구간으로 의사결정 |
| 축소 추정 | 사전분포로 효과를 0 쪽으로 당긴다(경험적 베이즈) |
| 재현 실험 | 유의한 결과를 새 자료로 확인 |
| 단계적 출시 | 10%에 먼저 출시해 실제 효과를 관측 |
네 번째가 실무에서 가장 유용하다. 출시 자체를 추가 실험으로 삼는다.
연습문제 9. 본문의 "흔한 함정" 외에 A/B 검정에서 자료 자체를 의심해야 할 신호를 정리하고, 그중 하나를 검정으로 구현하라.
풀이
표본 비율 불일치(SRM, Sample Ratio Mismatch). 50:50으로 배정했는데 실제 관측 수가 크게 다르면 배정 시스템에 문제가 있다는 신호다.
import numpy as np
from scipy import stats

def srm_check(counts, expected_ratio=None):
    """표본 비율 불일치 검정 (카이제곱 적합도)."""
    counts = np.asarray(counts, float)
    k = len(counts)
    if expected_ratio is None:
        expected_ratio = np.ones(k) / k
    exp = counts.sum() * np.asarray(expected_ratio)
    chi2 = ((counts - exp)**2 / exp).sum()
    return chi2, stats.chi2.sf(chi2, k - 1)

cases = [
    ("정상 (50.1:49.9)", [50_100, 49_900]),
    ("약간 어긋남 (50.5:49.5)", [50_500, 49_500]),
    ("SRM 의심 (51:49)", [51_000, 49_000]),
    ("3군 (33.4:33.3:33.3)", [33_400, 33_300, 33_300]),
    ("3군 SRM (34.5:33:32.5)", [34_500, 33_000, 32_500]),
]
print(f"{'상황':>26s} {'관측 수':>26s} {'χ²':>9s} {'p':>10s} {'판정':>6s}")
for lab, c in cases:
    chi2, p = srm_check(c)
    print(f"{lab:>26s} {str(c):>26s} {chi2:9.3f} {p:10.6f} "
          f"{'이상' if p < 0.0005 else '정상':>6s}")
                        상황                       관측 수        χ²          p     판정
            정상 (50.1:49.9)             [50100, 49900]     0.400   0.527089     정상
        약간 어긋남 (50.5:49.5)             [50500, 49500]    10.000   0.001565     정상
            SRM 의심 (51:49)             [51000, 49000]    40.000   0.000000     이상
       3군 (33.4:33.3:33.3)      [33400, 33300, 33300]     0.200   0.904837     정상
     3군 SRM (34.5:33:32.5)      [34500, 33000, 32500]    65.000   0.000000     이상
51:49만 되어도 \(p<10^{-9}\)다. 10만 명 규모에서는 1%포인트의 불균형도 우연이 아니다.
| 배정 비 | \(\chi^2\) | \(p\) | 판정 |
|---|---|---|---|
| 50.1:49.9 | 0.40 | 0.527 | 정상 |
| 50.5:49.5 | 10.00 | 0.0016 | 경계 |
| 51:49 | 40.00 | \(<10^{-9}\) | 이상 |
문턱을 \(p<0.0005\)로 잡는 것이 관례다. 일반적인 0.05보다 훨씬 엄격하게 두어, 정상 실험을 불필요하게 의심하지 않으면서 진짜 문제를 잡는다.
SRM이 나타나는 원인 다섯.
| 원인 | 설명 |
|---|---|
| 배정 버그 | 해시 함수의 편향, 조건문 오류 |
| 차등 이탈 | 한 군에서 페이지가 느려 이탈 |
| 봇 필터링 | 군마다 다르게 걸러짐 |
| 로깅 실패 | 한 군의 이벤트가 덜 기록됨 |
| 리다이렉트 | 처치군만 추가 리다이렉트를 거침 |
두 번째와 다섯 번째가 특히 교묘하다. 처치군의 페이지가 0.5초 느리면 참을성 없는 사용자가 먼저 이탈한다. 남은 사용자는 선택된 집단이므로 비교가 무효다.
SRM이 발견되면 실험 결과를 버린다. 보정할 방법이 없다. 원인을 찾아 고치고 다시 실험해야 한다.
의심해야 할 다른 신호 다섯.
| 신호 | 의미 |
|---|---|
| A/A 검정이 유의 | 배정·측정 시스템의 문제 |
| 처치 전 지표가 다름 | 무작위화 실패 |
| 효과가 첫날에만 큼 | 신규성 효과 |
| 세그먼트별로 방향이 반대 | 심슨의 역설 또는 교호작용 |
| 이상하게 큰 효과 | 버그, 로깅 오류 |
A/A 검정이 가장 강력한 점검이다. 같은 것을 두 군에 보여 주고 유의하지 않은지 확인한다. 여러 번 하면 유의 비율이 5%여야 한다.
점검 순서.
1. SRM 검정          →  이상이면 여기서 중단
2. 처치 전 지표 비교   →  무작위화가 작동했는가
3. 세그먼트별 일관성   →  방향이 뒤집히는 곳이 있는가
4. 시간에 따른 추이   →  첫날 효과인가 지속되는가
5. 그 다음에야 결과 해석
연습문제 10. A/B 검정의 전체 점검표를 만들어라.
풀이
핵심 수치 다섯.
| 사실 | 값 |
|---|---|
| 20회 훔쳐보기의 오류율 | 0.250 |
| 전환율 1%, \(+5\%\) 탐지에 필요한 군당 \(n\) | 637,010 |
| 검정력 0.06일 때 효과 과대추정 | 5.7배 |
| 분산분석 \(F\)와 카이제곱의 일치 | 소수점 4자리 |
| SRM 검정의 관례적 문턱 | \(p<0.0005\) |
설계 단계.
□ 주요 평가지표를 하나 정한다 (여러 개면 다중성 보정)
□ 최소 관심 효과크기(MDE)를 정한다  — 비즈니스 기준
□ 표본 크기를 계산한다 (연습문제 6)
□ 실험 기간을 정한다 (최소 완전한 1~2주)
□ 중단 규칙을 정한다 (고정 표본 또는 군집 순차)
□ 분석 계획을 문서화한다 (사전 등록)
실행 중.
□ SRM 검정 (매일)
□ 시스템 오류 모니터링
□ 결과를 보지 않는다 (사전 규칙이 없다면)
분석 단계.
□ SRM 최종 확인
□ 처치 전 지표의 균형 확인
□ 주요 지표 분석 (카이제곱 또는 로지스틱 회귀)
□ 신뢰구간을 계산 — p 만 보지 않는다
□ 여러 변형이면 다중비교 보정 (더넷 또는 튜키)
□ 보조 지표와 방어 지표(guardrail) 확인
□ 세그먼트별 일관성 확인 (교호작용)
보고 단계.
□ 효과크기와 구간을 함께
□ 검정력이 낮았다면 과대추정 가능성을 명시
□ 실질적 유의성(수익 영향)을 계산
□ 구현·운영 비용과 비교
□ 단계적 출시 계획
흔한 함정과 대응.
| 함정 | 대응 |
|---|---|
| 훔쳐보기 | 고정 표본 또는 군집 순차 |
| 다중 지표 | 주요 지표 하나 + 나머지는 탐색적 |
| 여러 변형 | 더넷(대조 비교) 또는 튜키 |
| 승자의 저주 | 구간 보고, 재현, 축소 추정 |
| SRM | 발견 즉시 중단, 원인 규명 |
| 신규성 효과 | 기간을 늘리고 시간 추이를 본다 |
| 세그먼트 쇼핑 | 사전에 세그먼트를 정한다 |
의사결정 틀.
구간이 0 을 포함하지 않고, 하한도 MDE 를 넘는가?
    │
    ├─ 예 ──────────→ 출시
    │
    ├─ 구간이 0 을 포함하지만 폭이 좁고
    │  전 구간이 무시할 수준인가?
    │      └─→ "차이 없음"으로 결론, 더 단순한 쪽을 선택
    │
    └─ 구간이 넓어 판단 불가
           └─→ 실험을 계속하거나 표본을 늘린다
"유의하지 않음"을 "차이 없음"으로 읽지 않는 것이 핵심이다. 구간의 폭을 보고 "결정 불가"인지 "실질적으로 같음"인지 구분한다.
한 문장. A/B 검정의 어려움은 통계가 아니라 규율에 있다 — 표본을 미리 정하고, 훔쳐보지 않고, 구간으로 판단하는 것.
정리하며
A/B 검정은 실험 설계와 가설검정을 결합한 것이며, 처치가 셋 이상이면 곧 일원배치 분산분석이다.
- 세 원리가 근간이다. 무작위화(교란과의 독립 보장), 반복(변동 추정), 그리고 통제(비교 기준).
- 무작위화가 인과 해석을 가능하게 한다. 1장에서 본 대로, 관측되지 않은 교란까지 평균적으로 균형을 맞추는 유일한 일반적 장치다.
- 처치가 둘이면 \(t\) 검정, 셋 이상이면 \(F\) 검정이며, 후자가 기각하면 사후비교로 어느 쌍이 다른지 찾는다. 처치마다 따로 \(t\) 검정을 돌리면 오류율이 부푼다.
- 표본크기를 사전에 정한다. 9장의 검정력 분석이 그대로 적용되며, 유의해질 때까지 들여다보는 것이 가장 흔한 실무의 함정이다.
- 대조군과의 비교만 필요하다면 더넷이 낫다. 불필요한 보호를 걷어내면 검정력이 오른다.
다음 절 분산분석의 금융 응용으로 넘어간다.