선형대수 표기와 관례
개요
두 열 \(\mathbf{a}_1 = (2,\, 1)\) 과 \(\mathbf{a}_2 = (1,\, 3)\) 을 섞으면 평면의 어느 점에든 닿을 수 있다. 그런데 둘째 열이 첫째 열의 두 배여서 \(\mathbf{a}_2 = 2\mathbf{a}_1\) 이 되면 닿을 수 있는 점이 직선 하나로 쪼그라들고, 목표에 가장 가까운 점에 이르는 배합비가 무한히 많아진다. 사영은 유일한데 그것을 만드는 계수는 유일하지 않다 — 적합값은 멀쩡한데 계수를 해석할 수 없는 다중공선성(multicollinearity)이 이 한 줄이다.
선형대수는 다변량 통계의 언어다. 회귀, 다변량 분석, 차원축소, 그리고 현대 추정 이론에 등장하는 거의 모든 양이 벡터나 행렬 표현이다. 이 절은 책 전체에서 쓰는 표기를 정하고, 가장 자주 반복되는 연산과 항등식을 복습한다.
1. 벡터, 행렬, 부분공간
정의 1. 벡터와 행렬
벡터는 열벡터 \(\mathbf{x} \in \mathbb{R}^n\)이며 굵은 소문자로 쓴다. 행렬은 \(\mathbf{A} \in \mathbb{R}^{m \times n}\)이며 굵은 대문자로 쓴다. 전치는 \(\mathbf{A}^\top\), 역행렬은(존재할 때) \(\mathbf{A}^{-1}\)로 나타낸다. 단위행렬은 \(\mathbf{I}_n\), 영행렬은 \(\mathbf{0}\)이다.
정의 2. 핵심 연산
\(\mathbf{x}, \mathbf{y} \in \mathbb{R}^n\)의 내적과 노름, 그리고 행렬 곱은 다음과 같다.
내적은 따로 기호를 두지 않고 언제나 \(\mathbf{x}^\top \mathbf{y}\)로 쓰며, 노름은 따로 말하지 않는 한 유클리드 노름(\(L^2\) 노름)이다. 두 벡터가 직교한다는 것은 \(\mathbf{x}^\top\mathbf{y} = 0\)이라는 뜻이고, 이를 \(\mathbf{x} \perp \mathbf{y}\)로 쓴다.
외적 \(\mathbf{x} \mathbf{y}^\top \in \mathbb{R}^{n \times m}\)(\(\mathbf{x} \in \mathbb{R}^n\), \(\mathbf{y} \in \mathbb{R}^m\))은 계수(rank)가 많아야 1이다. 대각합은 \(\operatorname{tr}(\mathbf{A}) = \sum_i a_{ii}\)이다. 행렬식 \(\det(\mathbf{A})\)는 부호를 가진 부피 배율을 나타내며, \(\mathbf{A}\)가 가역일 때에 한해 0이 아니다.
그림으로 보는 통계학 1. 내적이 처음 인쇄된 쪽에는 가운뎃점이 없다
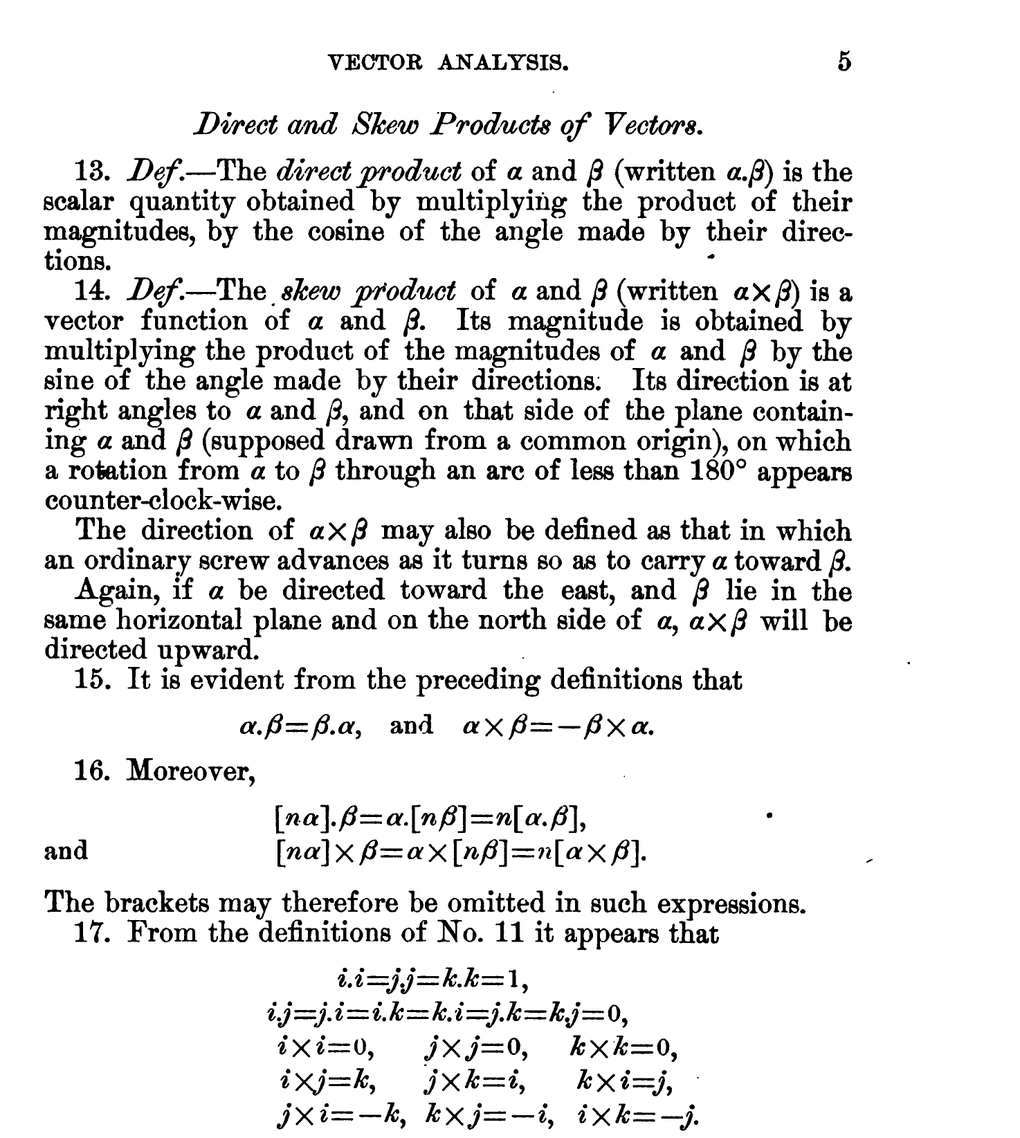
기브스 『Elements of Vector Analysis』의 인쇄 쪽 \(5\). 머리글에 쪽 번호가 찍혀 있고, 절 제목이 「\(Direct\ and\ Skew\ Products\ of\ Vectors\)」다. \(13\) 번이 내적, \(14\) 번이 외적, \(17\) 번이 \(i.i=j.j=k.k=1\) 과 \(i.j=\dots=0\) 이다. (Internet Archive 스캔, \(1881\)–\(84\) 간행이라 PD)
정의 2 는 내적을 성분으로 곧바로 세운다 — \(\mathbf{x}^\top\mathbf{y}=\sum_i x_iy_i\). 들어오는 길이 하나 더 있다. 크기와 각으로 \(\lVert\mathbf{x}\rVert\,\lVert\mathbf{y}\rVert\cos\theta\) 라 세우는 길이다. 두 길이 같은 수에 닿는다는 것이 처음 한 쪽에 나란히 인쇄된 자리가 사진이다.
\(13\) 번이 기하 쪽 정의다. 「\(\alpha\) 와 \(\beta\) 의 direct product(\(\alpha.\beta\) 라 쓴다)는 두 크기의 곱에 두 방향이 이루는 각의 코사인을 곱해 얻는 스칼라다.」 \(17\) 번이 성분 공식의 바탕이다 — \(i.i=j.j=k.k=1\) 이고 \(i.j\) 꼴은 모두 \(0\) 이니(정의 2 가 \(\mathbf{x}\perp\mathbf{y}\) 라 적는 그 조건이다), 여기에 분배법칙을 쓰면 곧바로 정의 2 의 \(\sum_i x_iy_i\) 가 나온다.
그런데 지금과 다른 것이 셋 있다. 이름이 다르다 — \(dot\) 도 \(cross\) 도 아니고 \(direct\ product\) 와 \(skew\ product\) 다. 글자가 다르다 — 벡터를 굵은 라틴 문자가 아니라 그리스 문자 \(\alpha\), \(\beta\) 로 적었다. 그리고 가장 눈에 띄는 것, 점의 높이가 다르다. \(\alpha.\beta\) 의 점은 기준선에 내려앉은 마침표다. 같은 줄의 \(\alpha\times\beta\) 에서 곱셈 십자는 가운데 높이에 떠 있으니, 활자가 없어서가 아니라 그렇게 짠 것이다. 우리가 쓰는 가운뎃점 \(\mathbf{x}\cdot\mathbf{y}\) 는 뒤에 올라간 것이다.
이 소책자는 출판된 적이 없다. 기브스가 \(1881\) 년과 \(1884\) 년에 예일 학생들에게 나누어 주려고 뉴헤이븐에서 사쇄한 소책자다. 그는 출판을 꺼렸는데, 남들이 이미 한 말이라 새로울 것이 없다고 여겼기 때문이다 — 실제로 이 소책자는 그라스만과 클리퍼드에게 빚을 졌다고 밝히고 있다. \(1888\) 년에 헤비사이드는 이 소책자가 「널리 알려질 만하다」고 쓰면서도 「처음 배우는 사람에게는 너무 압축되어 있다」고 덧붙였다. 결국 제자 윌슨이 이것을 바탕으로 \(1901\) 년에 두꺼운 『Vector Analysis』를 냈고, 그 책을 거쳐 오늘의 교과서가 되었다.
\(13\) 번의 문장은 백사십 년 전의 것이지만 뜻은 지금과 사실상 같다. 바뀐 것은 이름과 글자와 점의 높이뿐이고, 이 책은 거기서 한 걸음 더 가 가운뎃점마저 버리고 \(\mathbf{x}^\top\mathbf{y}\) 로 적는다 — 내적을 행렬 곱의 한 경우로 보아야 정의 3 의 설계행렬부터 \(\mathbf{X}^\top\mathbf{X}\) 까지가 한 기호로 이어지기 때문이다. 수학이 굳는 일과 기호가 굳는 일은 같은 속도로 일어나지 않는다.
확인한 곳 — 머리글의 쪽 번호 \(5\), 절 제목 「Direct and Skew Products of Vectors」, \(13\) 번의 정의 문장, \(14\) 번의 skew product, \(15\) 번의 \(\alpha.\beta=\beta.\alpha\), \(17\) 번의 \(i.i=j.j=k.k=1\) 과 \(i.j=j.i=\dots=0\), 그리고 점이 기준선에 앉아 있고 \(\times\) 는 가운데 높이에 떠 있다는 것은 모두 위 사진에서 직접 읽었다(낱자를 네 배로 키워 확인했다) · 스캔은 Internet Archive: elementsvectora00gibbgoog · \(1881\) 년과 \(1884\) 년에 학생을 위해 사쇄했다는 것, 새로울 것이 없다고 여겨 출판을 꺼렸다는 것, 제자 윌슨이 이를 바탕으로 \(1901\) 년 『Vector Analysis』를 냈다는 것은 ProofWiki 「Elements of Vector Analysis — Historical Note」 · 소책자가 그라스만과 클리퍼드를 밝힌다는 것과 \(1888\) 년 헤비사이드의 평(「처음 배우는 사람에게는 너무 압축되어 있다」)은 Wikipedia 「Vector Analysis」 · 어느 쪽이 \(1881\) 년에 찍히고 어느 쪽이 \(1884\) 년에 찍혔는지는 확인하지 못해 적지 않았다
정의 3. 설계행렬
설계행렬(design matrix) \(\mathbf{X} \in \mathbb{R}^{n \times p}\)는 \(n\)개의 관측을 행 방향으로 쌓은 것이다. \(i\)번째 행에는 관측 \(i\)의 설명변수(explanatory variable) 값이 들어 있다. \(\mathbf{X}\)의 열공간은 \(p\)개 열의 모든 선형결합으로 이루어진 집합, 즉 최소제곱으로 도달할 수 있는 적합값의 공간이다.
\(p\)의 셈법을 분명히 해 두자. 이 책의 부록 A에서 \(p\)는 절편(intercept) 열을 포함한 열의 개수다. 절편이 있는 모형이면 첫 열이 \(\mathbf{1} = (1, \ldots, 1)^\top\)이고 나머지 \(p-1\)개가 설명변수다. 그래서 뒤에 나오는 \(\operatorname{tr}(\mathbf{H}) = p\)와 잔차 자유도 \(n - p\)가 그대로 성립한다. 13장에서는 설명변수의 개수를 \(p\)로 세고 절편을 따로 더해 설계행렬을 \(n \times (p+1)\)로 쓰므로, 그쪽의 \(p\)와 여기의 \(p\)가 \(1\)만큼 어긋난다는 점에 주의하라.
정의 4. 계수, 영공간, 네 가지 기본 부분공간
\(\mathbf{A} \in \mathbb{R}^{m \times n}\)의 계수 \(\operatorname{rank}(\mathbf{A})\) 는 선형독립인 열의 최대 개수, 곧 열공간의 차원이다. 영공간 \(\ker(\mathbf{A}) = \{\mathbf{x} : \mathbf{A}\mathbf{x} = \mathbf{0}\}\) 과 함께 네 가지 기본 부분공간은
- \(\operatorname{col}(\mathbf{A}) \subseteq \mathbb{R}^m\) (열공간)
- \(\ker(\mathbf{A}) \subseteq \mathbb{R}^n\) (우영공간)
- \(\operatorname{col}(\mathbf{A}^\top) \subseteq \mathbb{R}^n\) (행공간)
- \(\ker(\mathbf{A}^\top) \subseteq \mathbb{R}^m\) (좌영공간)
이고, \(\operatorname{rank}(\mathbf{A}) + \dim \ker(\mathbf{A}) = n\)(계수–퇴화차수 정리)이며 \(\operatorname{col}(\mathbf{A}^\top) \perp \ker(\mathbf{A})\)이다. 열공간을 \(\operatorname{col}(\cdot)\)로, 영공간을 \(\ker(\cdot)\)로 쓰는 것이 이 책의 표기이며 A.3절에서 그대로 이어진다.
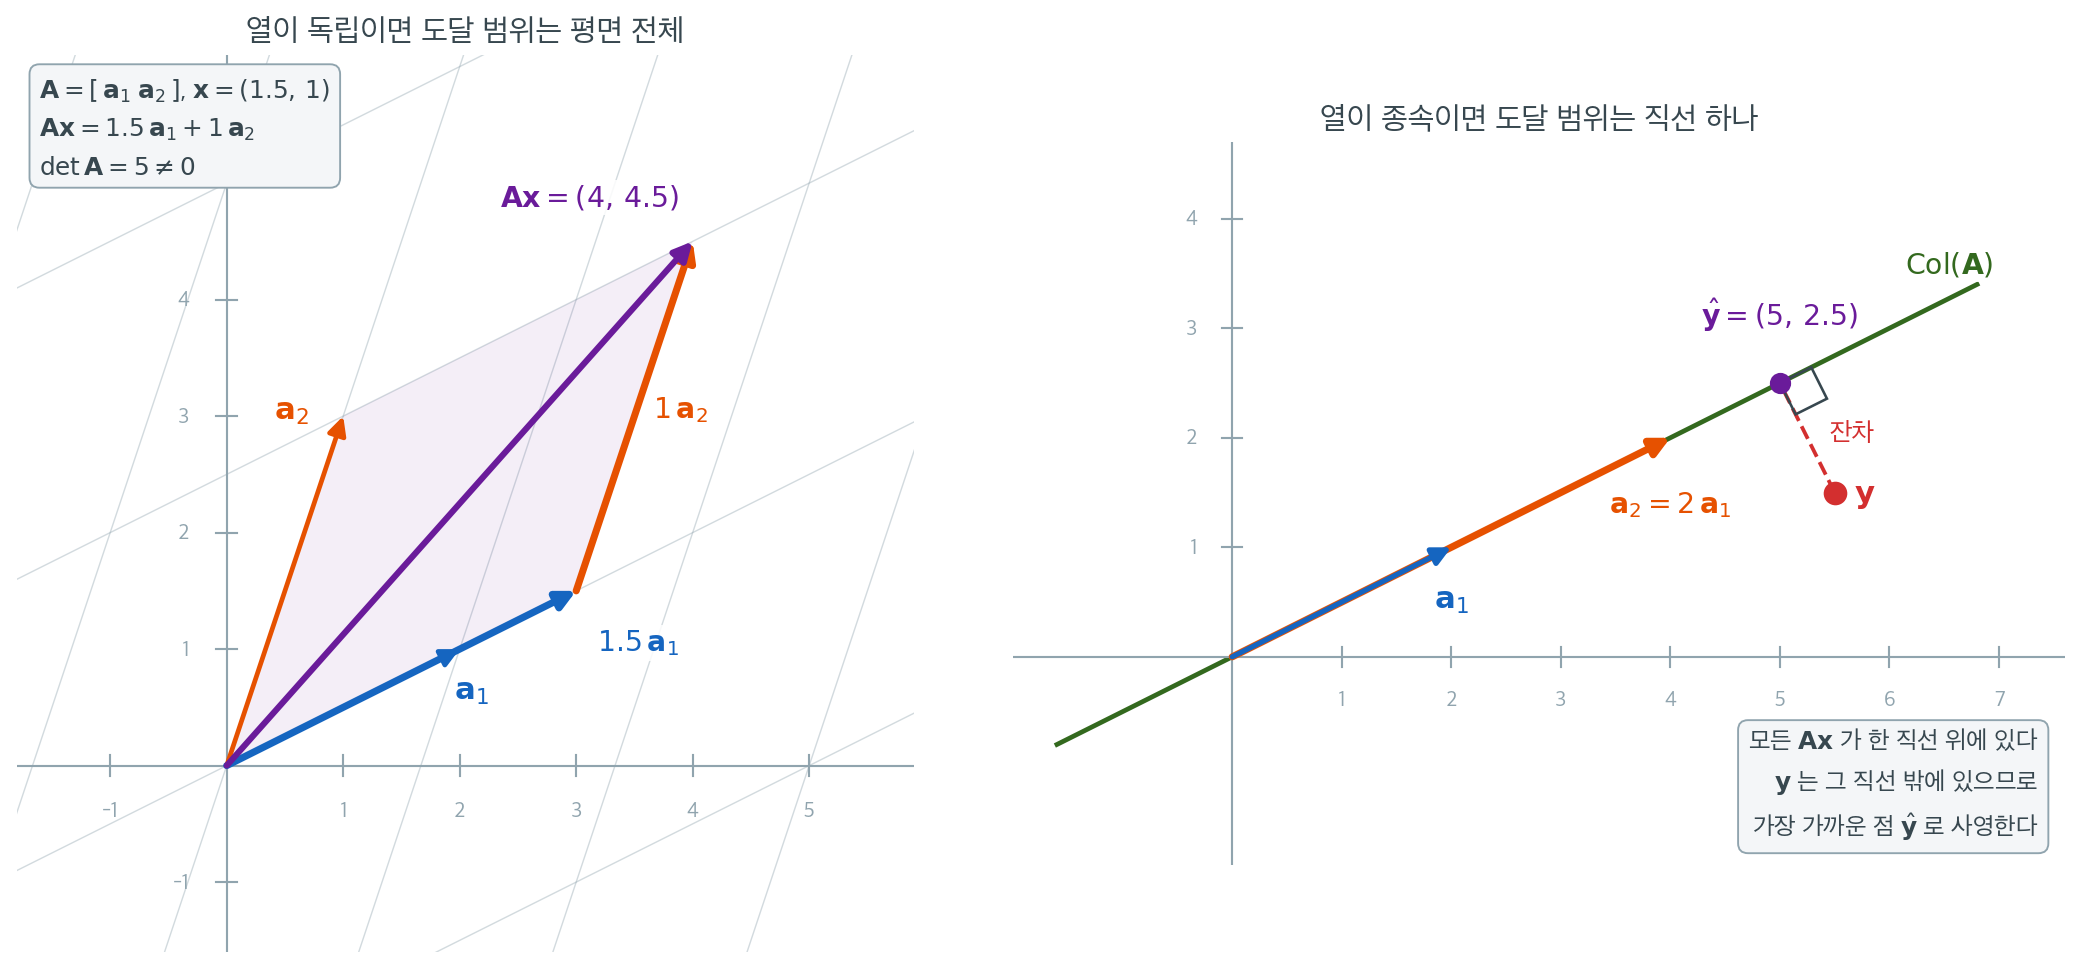
행렬–벡터 곱을 행별 내적으로 계산하는 데 익숙하겠지만, 통계에서 쓸모 있는 읽기는 열 쪽이다. \(\mathbf{A} = [\,\mathbf{a}_1\;\mathbf{a}_2\,]\)라 쓰면
이므로, \(\mathbf{x}\)는 열들을 얼마씩 섞을지 정하는 배합비다. 왼쪽 그림이 이 계산을 그대로 그린 것이다. \(\mathbf{a}_1 = (2,1)\), \(\mathbf{a}_2 = (1,3)\)에 \(\mathbf{x} = (1.5,\,1)\)을 곱하면 \(\mathbf{a}_1\) 방향으로 \(1.5\)만큼 간 뒤 그 끝에서 \(\mathbf{a}_2\)를 한 번 더 가는 것과 같고, 도착점이 \(\mathbf{A}\mathbf{x} = (4,\,4.5)\)이다. 연한 격자는 두 열이 만드는 좌표 눈금이다. \(\det \mathbf{A} = 5 \ne 0\)이므로 이 격자는 평면을 빈틈없이 덮고, \(\operatorname{col}(\mathbf{A})\)는 \(\mathbb{R}^2\) 전체가 된다.
오른쪽 그림은 한 열이 다른 열의 배수일 때, 곧 \(\mathbf{a}_2 = 2\mathbf{a}_1\)일 때 무슨 일이 생기는지를 보여 준다. 어떤 배합비를 고르더라도 \(x_1\mathbf{a}_1 + x_2\mathbf{a}_2 = (x_1 + 2x_2)\mathbf{a}_1\)이므로 도달할 수 있는 점 전체가 직선 하나로 쪼그라든다. \(\operatorname{rank}(\mathbf{A}) = 1\)이고 \(\det \mathbf{A} = 0\)이다. 목표 \(\mathbf{y} = (5.5,\,1.5)\)는 그 직선 위에 없으므로 어떤 \(\mathbf{x}\)로도 정확히 맞힐 수 없고, 할 수 있는 최선은 직선 위에서 가장 가까운 점을 잡는 것이다. 그 점이 \(\hat{\mathbf{y}} = (5,\,2.5)\)이며 잔차는 \(\mathbf{y} - \hat{\mathbf{y}} = (0.5,\,-1)\), 길이 \(1.118034\)다. 잔차와 \(\mathbf{a}_1\)의 내적이 \(0.5 \cdot 2 + (-1)\cdot 1 = 0\)이라는 것, 즉 잔차가 열공간에 수직이라는 것이 최소제곱을 규정하는 조건이며, 그림의 직각 표시가 바로 그 사실이다.
이 두 그림 사이의 차이가 회귀에서 무엇이 식별되고 무엇이 식별되지 않는지를 가른다. 오른쪽에서 \(\hat{\mathbf{y}} = 2.5\,\mathbf{a}_1\)에 도달하는 배합비는 \(x_1 + 2x_2 = 2.5\)를 만족하는 모든 쌍, 곧 \((2.5,\,0)\), \((0.5,\,1)\), \((-1.5,\,2)\) 등 무한히 많다. 사영 \(\hat{\mathbf{y}}\)는 유일하지만 그것을 만드는 계수는 유일하지 않다. 적합값은 멀쩡한데 계수의 부호와 크기는 해석할 수 없는 다중공선성의 상황이 이 한 문장이다(연습문제 6과 7). 뒤에 나오는 모자 행렬 \(\mathbf{H} = \mathbf{X}(\mathbf{X}^\top\mathbf{X})^{-1}\mathbf{X}^\top\)는 오른쪽 그림의 사영을 \(\mathbb{R}^n\)에서 일반적으로 수행하는 장치이고, \((\mathbf{X}^\top\mathbf{X})^{-1}\)이 존재한다는 조건은 왼쪽 그림처럼 열들이 서로 겹치지 않는다는 조건이다.
2. 이 책에서 끊임없이 쓰이는 항등식
정리 1. 전치·역행렬과 확률벡터의 항등식
이고, \(\mathbf{X}\) 가 평균 \(\boldsymbol\mu\), 공분산 \(\boldsymbol\Sigma\) 인 확률벡터이면
이다.
증명
전치. 성분으로 적으면 \(\bigl[(\mathbf{AB})^\top\bigr]_{ij} = [\mathbf{AB}]_{ji} = \sum_k A_{jk}B_{ki}\) 이고, 한편 \([\mathbf{B}^\top\mathbf{A}^\top]_{ij} = \sum_k B_{ki}A_{jk}\) 다. 같은 합이다. 순서가 뒤집히는 까닭은 첨자가 뒤집히기 때문이다.
역행렬. \((\mathbf{AB})(\mathbf{B}^{-1}\mathbf{A}^{-1}) = \mathbf{A}(\mathbf{B}\mathbf{B}^{-1})\mathbf{A}^{-1} = \mathbf{I}\) 이고 반대쪽도 같다. 역행렬은 유일하므로 그것이 \((\mathbf{AB})^{-1}\) 이다.
공분산. \(E[\mathbf{AX}] = \mathbf{A}\boldsymbol\mu\) 이므로
다. 전치 규칙으로 \((\mathbf{A}\mathbf{v})^\top = \mathbf{v}^\top\mathbf{A}^\top\) 를 쓰고 상수행렬을 기댓값 밖으로 뺐다. \(\mathbf{A}\) 가 양쪽에 붙고 한쪽은 전치된다는 것이 요점이다.
이차형식의 기댓값. \(\mathbf{Z} = \mathbf{X}-\boldsymbol\mu\) 로 두고 전개하면
이고 가운데 두 항은 \(E[\mathbf{Z}] = \mathbf{0}\) 이라 사라진다. 첫 항은 스칼라이므로 대각합을 씌워도 같고, 대각합의 순환 성질(대각합과 고윳값 정리 1)을 쓰면
다. 대각합과 기댓값이 둘 다 선형이라 자리를 바꿀 수 있다. \(\square\)
마지막 항등식이 5장과 13장에서 반복 쓰인다. 잔차제곱합의 기댓값을 구할 때 \(\mathbf{A}\) 자리에 사영행렬을 넣으면 \(\operatorname{tr}\) 이 자유도를 세어 주고, 그것이 \(s^2\) 의 비편향성과 \(n-p\) 라는 분모의 근거다.
나머지 항등식은 전용 쪽에서 증명한다.
- \(\operatorname{tr}(\mathbf{A}\mathbf{B}) = \operatorname{tr}(\mathbf{B}\mathbf{A})\) (순환 성질) — 대각합과 고윳값 정리 1
- \(\operatorname{tr}(\mathbf{A}) = \sum_i \lambda_i\), \(\det(\mathbf{A}) = \prod_i \lambda_i\) — 같은 쪽 정리 2 와 정리 3
3. 고윳값과 스펙트럼 정리
이 절의 주장은 대칭행렬 정리 1(스펙트럼 정리)에서 증명한다.
\(\mathbf{A} \in \mathbb{R}^{n \times n}\)에 대해 \(\mathbf{A}\mathbf{v} = \lambda \mathbf{v}\)가 고윳값–고유벡터 쌍을 정의한다. 대칭 \(\mathbf{A}\)(모든 공분산행렬, 모든 \(\mathbf{X}^\top \mathbf{X}\), 모든 모자 행렬이 여기 해당한다)에 대해 스펙트럼 정리는
을 보장한다. 여기서 \(\mathbf{Q}\)는 직교행렬(\(\mathbf{Q}^\top \mathbf{Q} = \mathbf{I}\))이고 \(\boldsymbol{\Lambda}\)는 실수 고윳값으로 이루어진 대각행렬이다. 이것이 주성분분석(principal component analysis), 다변량 정규 이론, 이차형식의 카이제곱분포(chi-squared distribution)를 떠받치는 원동력이다. 증명과 자세한 논의는 A.3절 대칭행렬에 있다.
4. 양(반)정치성
동치 조건과 촐레스키 분해는 양정치행렬 정리 1·2 에서 증명한다.
대칭행렬 \(\mathbf{A}\) 가 모든 \(\mathbf{x}\)에 대해 \(\mathbf{x}^\top \mathbf{A} \mathbf{x} \ge 0\)이면 양반정치(positive semidefinite) 라 하고(\(\mathbf{A} \succeq 0\)), 이는 모든 고윳값이 \(\ge 0\)인 것과 동치다. 양정치(positive definite) (\(\mathbf{A} \succ 0\))는 모든 \(\mathbf{x} \neq \mathbf{0}\) 에 대해 \(\mathbf{x}^\top\mathbf{A}\mathbf{x} > 0\) 인 것이고, 고윳값이 모두 \(> 0\) 인 것과 동치다. 대칭성이 빠지면 고윳값과의 동치가 깨진다 — \(\bigl(\begin{smallmatrix}1 & -2\\ 2 & 1\end{smallmatrix}\bigr)\) 은 모든 \(\mathbf x\) 에서 \(x_1^2 + x_2^2 \ge 0\) 인데 고윳값이 \(1 \pm 2i\) 다. 공분산행렬은 언제나 양반정치이며, 어떤 변수도 다른 변수들의 결정론적 선형결합이 아닐 때 양정치가 된다. 양정치성은 \((\mathbf{X}^\top \mathbf{X})^{-1}\)이 존재하고 최소제곱해가 유일하게 정해지기 위해 필요한 바로 그 조건이다. 이차형식에 의한 특성화와 고윳값에 의한 특성화가 왜 동치인지는 A.3절 양정치행렬에서 증명한다.
5. 사영과 모자 행렬
아래 네 성질은 멱등행렬 정리 1·2·3 과 직교사영 정리 1·2 에서 증명한다.
최소제곱의 모자 행렬(hat matrix)
은 \(\mathbf{y} \in \mathbb{R}^n\)을 \(\mathbf{X}\)의 열공간 위로 직교사영한다. 이 행렬을 규정하는 성질은 다음과 같다.
- 대칭성: \(\mathbf{H}^\top = \mathbf{H}\).
- 멱등성: \(\mathbf{H}^2 = \mathbf{H}\).
- 대각합 = 계수: \(\operatorname{tr}(\mathbf{H}) = p\) (모형의 자유도).
- 고윳값은 0 또는 1: 1이 \(p\)개(열공간), 0이 \(n - p\)개(잔차공간).
나머지를 맡는 사영행렬 \(\mathbf{M} = \mathbf{I} - \mathbf{H}\)는 열공간의 직교여공간(orthogonal complement)인 잔차공간 위로 사영하며 \(\operatorname{tr}(\mathbf{M}) = n - p\)이다. 이것이 모든 \(t\)-검정과 \(F\)-검정에 등장하는 잔차 자유도 \(d = n - p\)다(이 책은 자유도를 \(\nu\)가 아니라 \(d\)로 쓴다. 4.2절 카이제곱분포 참조). 사영행렬 일반과 직교사영으로의 특수화는 A.3절 사영행렬·직교사영행렬에서, 이 \(d\)가 카이제곱분포의 자유도로 이어지는 과정은 A.4절 카이제곱분포와 이차형식에서 다룬다.
6. 최소제곱을 위한 행렬 미적분
\(\|\mathbf{y} - \mathbf{X}\boldsymbol{\beta}\|^2 = (\mathbf{y} - \mathbf{X}\boldsymbol{\beta})^\top(\mathbf{y} - \mathbf{X}\boldsymbol{\beta})\)을 최소화하기 위해 기울기를 0으로 두면 정규방정식(normal equations) \(\mathbf{X}^\top \mathbf{X} \boldsymbol{\beta} = \mathbf{X}^\top \mathbf{y}\)를 얻고, 따라서
이다. 이 하나의 공식과 그 뒤에 있는 사영 해석이 13장 선형회귀(linear regression) 전체의 바탕이 되며, A.4절에서는 여기에 정규분포 가정을 얹어 \(\hat{\boldsymbol{\beta}}\)의 정확한 표집분포(sampling distribution)를 구한다.
보기 1. 모자 행렬의 네 가지 성질. \(\mathbf{X} \in \mathbb{R}^{n \times p}\)의 열이 선형독립이라 하고 \(\mathbf{H} = \mathbf{X}(\mathbf{X}^\top\mathbf{X})^{-1}\mathbf{X}^\top\)라 두자.
(1) \(\mathbf{H}\)가 대칭이고 멱등임을 보이고, \(\operatorname{tr}(\mathbf{H}) = p\)를 유도하시오. 이어서 \(\mathbf{H}\)의 고윳값이 \(0\) 또는 \(1\)뿐이며 \(1\)이 정확히 \(p\)개임을 보이시오.
(2) \(n = 50\), \(p = 3\)인 모의자료로 (1)의 네 성질을 모두 확인하고, 최소제곱 추정값이 참값에서 벗어난 폭이 표준오차로 설명되는지 보시오.
풀이
(1) 해석적으로. 네 성질이 모두 \((\mathbf{X}^\top\mathbf{X})^{-1}\)의 존재 하나에서 나온다.
대칭성. \(\mathbf{X}^\top\mathbf{X}\)가 대칭이므로 그 역행렬도 대칭이고, \((\mathbf{A}\mathbf{B})^\top = \mathbf{B}^\top\mathbf{A}^\top\)를 두 번 쓰면
이다.
멱등성. 가운데에서 \((\mathbf{X}^\top\mathbf{X})^{-1}(\mathbf{X}^\top\mathbf{X}) = \mathbf{I}_p\)가 지워진다.
대각합. 순환 성질 \(\operatorname{tr}(\mathbf{A}\mathbf{B}) = \operatorname{tr}(\mathbf{B}\mathbf{A})\)를 \(\mathbf{A} = \mathbf{X}\), \(\mathbf{B} = (\mathbf{X}^\top\mathbf{X})^{-1}\mathbf{X}^\top\)로 쓰면
이다. \(n \times n\) 행렬의 대각합이 \(n\)에 무관하게 \(p\)로 정해지는 것이 요점이다.
고윳값. \(\mathbf{H}\mathbf{v} = \lambda\mathbf{v}\)이고 \(\mathbf{v} \ne \mathbf{0}\)이면 멱등성에서 \(\lambda\mathbf{v} = \mathbf{H}\mathbf{v} = \mathbf{H}^2\mathbf{v} = \lambda^2\mathbf{v}\)이므로 \(\lambda^2 = \lambda\), 곧 \(\lambda \in \{0, 1\}\)이다. \(\mathbf{H}\)가 대칭이므로 스펙트럼 정리가 실수 고윳값 \(n\)개를 보장하고, 대각합이 고윳값의 합이라는 사실에서 \(1\)의 개수가 \(\operatorname{tr}(\mathbf{H}) = p\)개, 나머지 \(n - p\)개가 \(0\)이다. 이 \(n - p\)가 잔차 자유도 \(d\)다.
(2) 수치적으로. \(\sigma = 0.5\)인 잡음을 얹은 자료로 네 성질을 확인한다.
import numpy as np

rng = np.random.default_rng(42)
n, p = 50, 3
X = np.column_stack([np.ones(n), rng.standard_normal((n, p - 1))])
beta_true = np.array([2.0, -1.0, 0.5])
sigma = 0.5
y = X @ beta_true + rng.standard_normal(n) * sigma

# === 정규방정식으로 최소제곱 풀기 ===
beta_hat = np.linalg.solve(X.T @ X, X.T @ y)
print("참값   beta:", beta_true)
print("최소제곱 beta:", beta_hat.round(4))

# 추정값이 참값에서 얼마나 벗어났는지를 표준오차 단위로 재어 본다.
se = sigma * np.sqrt(np.diag(np.linalg.inv(X.T @ X)))
print("표준오차      :", se.round(4))
print("(추정-참)/SE  :", ((beta_hat - beta_true) / se).round(2))

# === 모자 행렬의 성질 ===
H = X @ np.linalg.inv(X.T @ X) @ X.T
print(f"대칭:   {np.allclose(H, H.T)}")
print(f"멱등:   {np.allclose(H @ H, H)}")
print(f"tr(H) = {np.trace(H):.1f}  (p = {p} 와 같아야 한다)")

# 고윳값은 1 이 p 개, 0 이 n-p 개여야 한다.
eig_H = np.linalg.eigvalsh(H)
print(f"H 의 고윳값 중 1 에 가까운 것: {np.sum(np.isclose(eig_H, 1))} 개")
print(f"H 의 고윳값 중 0 에 가까운 것: {np.sum(np.isclose(eig_H, 0))} 개")

# === X'X 의 스펙트럼 분해 (대칭이고 여기서는 양정치다) ===
eigvals, eigvecs = np.linalg.eigh(X.T @ X)
print(f"고윳값: {eigvals.round(2)}")
print(f"고윳값의 합 {eigvals.sum():.2f} = tr(X'X) {np.trace(X.T @ X):.2f}")
print(f"조건수: {eigvals.max() / eigvals.min():.2f}")
reconstruction = eigvecs @ np.diag(eigvals) @ eigvecs.T
print(f"스펙트럼 복원이 X'X 와 일치: {np.allclose(reconstruction, X.T @ X)}")
출력:
참값   beta: [ 2.  -1.   0.5]
최소제곱 beta: [ 1.9711 -0.95    0.4159]
표준오차      : [0.071  0.0882 0.1041]
(추정-참)/SE  : [-0.41  0.57 -0.81]
대칭:   True
멱등:   True
tr(H) = 3.0  (p = 3 와 같아야 한다)
H 의 고윳값 중 1 에 가까운 것: 3 개
H 의 고윳값 중 0 에 가까운 것: 47 개
고윳값: [20.34 38.64 51.  ]
고윳값의 합 109.97 = tr(X'X) 109.97
조건수: 2.51
스펙트럼 복원이 X'X 와 일치: True
네 성질이 모두 맞는다. \(\operatorname{tr}(\mathbf{H}) = 3.0\)이 \(p = 3\)과 같고, \(50 \times 50\) 행렬인 \(\mathbf{H}\)의 고윳값은 \(1\)이 \(3\)개, \(0\)이 \(47 = n - p\)개다. 유도한 대로 \(\mathbf{H}\)는 \(\mathbb{R}^{50}\)을 3차원 열공간과 47차원 잔차공간으로 쪼개며, \(n\)이 아무리 커져도 열공간의 차원은 \(p\)에 묶여 있다.
추정값 \((1.9711, -0.9500, 0.4159)\)는 참값 \((2, -1, 0.5)\)과 다르다. 유도가 틀린 것이 아니라 자료에 잡음이 있어서다. \(\operatorname{Cov}(\hat{\boldsymbol\beta}) = \sigma^2(\mathbf{X}^\top\mathbf{X})^{-1}\)이 주는 표준오차가 \((0.0710, 0.0882, 0.1041)\)인데, 실제 벗어난 폭을 그것으로 나누면 \((-0.41, 0.57, -0.81)\)로 셋 다 1 표준오차 안이다. 이만큼 벗어나는 것이 정상이라는 뜻이다.
\(\mathbf{X}^\top\mathbf{X}\) 쪽에서는 고윳값의 합 \(109.97\)이 대각합과 정확히 같다는 것, 그리고 조건수가 \(2.51\)로 작다는 것을 볼 수 있다. 조건수가 작으니 열들이 서로 충분히 갈라져 있어 \((\mathbf{X}^\top\mathbf{X})^{-1}\)을 안심하고 쓸 수 있다. 앞에서 본 오른쪽 그림처럼 한 열이 다른 열의 배수에 가까워지면 가장 작은 고윳값이 \(0\)으로 내려가고 조건수가 터져, 같은 공식이 수치적으로 못 쓰게 된다.
연습문제
연습문제 1. 다음 설계행렬에 대해
(a) \(\mathbf{X}^\top \mathbf{X}\)와 \(\mathbf{X}^\top \mathbf{y}\)를 계산하라. (b) 정규방정식을 풀어 \(\hat{\boldsymbol{\beta}}\)를 구하라. (c) 적합값 \(\hat{\mathbf{y}} = \mathbf{X}\hat{\boldsymbol{\beta}}\)와 잔차를 계산하라.
풀이
(a) \(\mathbf{X}^\top \mathbf{X} = \begin{pmatrix} 3 & 12 \\ 12 & 56 \end{pmatrix}\), \(\mathbf{X}^\top \mathbf{y} = \begin{pmatrix} 27 \\ 124 \end{pmatrix}\).
(b) \(\det(\mathbf{X}^\top \mathbf{X}) = 168 - 144 = 24\)이므로
(c) \(\hat{\mathbf{y}} = (5, 9, 13)^\top = \mathbf{y}\)이고 잔차는 모두 0이다. 세 점이 한 직선 위에 있으므로 적합이 정확하다.
연습문제 2. 대각합의 순환 성질을 증명하라: \(\mathbf{A} \in \mathbb{R}^{m \times n}\), \(\mathbf{B} \in \mathbb{R}^{n \times m}\)에 대해 \(\operatorname{tr}(\mathbf{A}\mathbf{B}) = \operatorname{tr}(\mathbf{B}\mathbf{A})\).
풀이
직접 계산한다.
순서를 바꾸는 데에는 합이 유한하다는 사실만 쓰였다. \(\square\)
연습문제 3. \(\mathbf{X} \in \mathbb{R}^{n \times p}\)가 완전 열계수를 갖는다고 하자(\(\operatorname{rank}(\mathbf{X}) = p \le n\)). \(\mathbf{H} = \mathbf{X}(\mathbf{X}^\top \mathbf{X})^{-1} \mathbf{X}^\top\)가 대칭이고 멱등이며 대각합이 \(p\)임을 증명하라.
풀이
대칭성: \((\mathbf{X}^\top \mathbf{X})^{-1}\)은 대칭이므로(대칭행렬의 역행렬)
멱등성을 확인한다.
대각합: 순환 성질에 의해
\(\square\)
연습문제 4. \(\mathbf{A} \in \mathbb{R}^{n \times n}\)이 대칭이고 스펙트럼 분해가 \(\mathbf{A} = \mathbf{Q} \boldsymbol{\Lambda} \mathbf{Q}^\top\)라 하자. \(\operatorname{tr}(\mathbf{A}) = \sum_i \lambda_i\)이고 \(\det(\mathbf{A}) = \prod_i \lambda_i\)임을 증명하라.
풀이
순환 성질과 \(\mathbf{Q}^\top \mathbf{Q} = \mathbf{I}\)를 쓰면
이다. 행렬식의 경우, \(\det\)는 곱셈적이고 직교행렬 \(\mathbf{Q}\)에 대해 \(\det(\mathbf{Q}) = \pm 1\)이므로
이다. \(\square\)
연습문제 5. \(\mathbf{X}\)가 평균 \(\boldsymbol{\mu}\), 공분산 \(\boldsymbol{\Sigma}\)인 확률벡터라 하자. 대칭행렬 \(\mathbf{A}\)에 대해
임을 보여라.
풀이
\(\mathbb{E}[\mathbf{Z}] = 0\)이고 \(\operatorname{Cov}(\mathbf{Z}) = \boldsymbol{\Sigma}\)인 \(\mathbf{Z}\)를 써서 \(\mathbf{X} = \boldsymbol{\mu} + \mathbf{Z}\)로 놓자. 전개하면(\(\mathbf{A}\)의 대칭성을 이용한다)
이다. 기댓값을 취하면 \(\mathbb{E}[\mathbf{Z}] = 0\)이므로 가운데 항이 사라진다. 마지막 항의 경우 \(\mathbf{Z}^\top \mathbf{A} \mathbf{Z}\)가 스칼라이므로 자기 자신의 대각합과 같고,
이다. 여기에 결정론적인 항을 더하면 결과를 얻는다. \(\square\)
연습문제 6. \(\mathbf{X}^\top \mathbf{X}\)가 특이행렬이면(즉 \(\mathbf{X}\)가 완전 열계수를 갖지 않으면) 최소제곱추정량 \(\hat{\boldsymbol{\beta}}\)이 유일하게 정해지지 않는 이유를 서로 보완적인 두 방식으로 설명하라. (a) 대수적으로, (b) 기하적으로.
풀이
(a) 대수적으로: 특이성은 \(\det(\mathbf{X}^\top \mathbf{X}) = 0\)을 뜻하므로 \((\mathbf{X}^\top \mathbf{X})^{-1}\)이 존재하지 않는다. 정규방정식 \(\mathbf{X}^\top \mathbf{X} \boldsymbol{\beta} = \mathbf{X}^\top \mathbf{y}\)은 (우변이 \(\mathbf{X}^\top \mathbf{X}\)의 열공간 안에 있으므로) 해를 갖지만 무한히 많다. \(\boldsymbol{\beta}^*\)가 해이고 \(\mathbf{v} \in \ker(\mathbf{X})\)이면 \(\mathbf{X}\mathbf{v} = \mathbf{0}\)이므로 \(\boldsymbol{\beta}^* + \mathbf{v}\)도 이 방정식을 만족한다.
(b) 기하적으로: \(\hat{\mathbf{y}} = \mathbf{H}\mathbf{y}\)는 여전히 \(\mathbf{y}\)를 \(\operatorname{col}(\mathbf{X})\) 위로 직교사영한 유일한 벡터다. 그러나 \(\mathbf{X}\)의 열들이 선형종속이면 그 사영을 열들의 선형결합으로 나타내는 방법이 무한히 많고, 각각이 타당한 \(\hat{\boldsymbol{\beta}}\)을 준다. 적합값은 식별되지만 계수는 식별되지 않는다. 해결책은 종속인 열을 제거하거나, 능형회귀(ridge regression, \(\mathbf{X}^\top \mathbf{X}\)에 \(\lambda \mathbf{I}\)를 더해 가역성을 회복한다), 또는 유사역행렬(pseudoinverse, 최소 노름 해를 준다)을 쓰는 것이다. \(\square\)
연습문제 7. 설계행렬
에 대해 네 가지 기본 부분공간의 차원을 구하고, 계수–퇴화차수 정리와 \(\operatorname{col}(\mathbf{X}^\top) \perp \ker(\mathbf{X})\)을 확인하라. 이 자료로 회귀를 돌리면 어떤 일이 일어나는가?
풀이
셋째 열이 첫째와 둘째 열의 합이므로 \(\operatorname{rank}(\mathbf{X}) = 2\)이다.
| 부분공간 | 차원 | 사는 곳 |
|---|---|---|
| \(\operatorname{col}(\mathbf{X})\) | \(2\) | \(\mathbb{R}^4\) |
| \(\ker(\mathbf{X})\) | \(3 - 2 = 1\) | \(\mathbb{R}^3\) |
| \(\operatorname{col}(\mathbf{X}^\top)\) (행공간) | \(2\) | \(\mathbb{R}^3\) |
| \(\ker(\mathbf{X}^\top)\) | \(4 - 2 = 2\) | \(\mathbb{R}^4\) |
import numpy as np

X = np.array([[1., 2., 3.],
              [1., 3., 4.],
              [1., 4., 5.],
              [1., 5., 6.]])          # 3열 = 1열 + 2열

r = np.linalg.matrix_rank(X)
U, s, Vt = np.linalg.svd(X)
print(f"rank = {r},  특잇값 = {s.round(6)}")

null_basis = Vt[r:]                    # 0 특잇값에 딸린 오른쪽 특이벡터
row_basis = Vt[:r]
print(f"영공간 기저: {null_basis.round(4)}")
print(f"X v = {(X @ null_basis.T).ravel().round(12)}")
print(f"rank + nullity = {r} + {null_basis.shape[0]} = {r + null_basis.shape[0]} = 열 개수")
print(f"행공간 ⟂ 영공간: {np.allclose(row_basis @ null_basis.T, 0)}")
출력:
rank = 2,  특잇값 = [11.982576  0.646436  0.      ]
영공간 기저: [[-0.5774 -0.5774  0.5774]]
X v = [0. 0. 0. 0.]
rank + nullity = 2 + 1 = 3 = 열 개수
행공간 ⟂ 영공간: True
세 번째 특잇값이 정확히 \(0\)이라는 것이 계수 결손의 신호다. 영공간 기저 \(\propto (1, 1, -1)\)은 "첫째 열 더하기 둘째 열 빼기 셋째 열 = 0"이라는 종속관계를 그대로 읽어 준다.
회귀를 돌리면. \(\mathbf{X}^\top\mathbf{X}\)가 특이행렬이라 \(\hat{\boldsymbol{\beta}}\)이 유일하지 않다(연습문제 6). \(\boldsymbol{\beta}^*\)가 해이면 임의의 \(c\)에 대해 \(\boldsymbol{\beta}^* + c(1,1,-1)^\top\)도 해이며, 이 해들이 모두 똑같은 적합값을 준다. np.linalg.lstsq는 오류를 내지 않고 최소 노름 해 하나를 조용히 돌려주므로 더 위험하다. 계수의 부호나 크기를 해석하려 들면 아무 의미 없는 수를 해석하게 된다.
실무에서 이 상황은 완전한 다중공선성으로 나타난다. 가장 흔한 원인은 범주형 변수를 원–핫 인코딩하면서 기준 범주를 빼지 않은 것이다(더미변수 함정). \(\square\)
연습문제 8. \(\operatorname{Cov}(\mathbf{A}\mathbf{X}) = \mathbf{A}\,\operatorname{Cov}(\mathbf{X})\,\mathbf{A}^\top\)를 증명하고, 이로부터 공분산행렬이 항상 양반정치임을 보여라. 세 자산 포트폴리오에 적용해 분산투자 효과를 확인하라.
풀이
\(\boldsymbol{\mu} = \mathbb{E}[\mathbf{X}]\)라 하면 \(\mathbb{E}[\mathbf{A}\mathbf{X}] = \mathbf{A}\boldsymbol{\mu}\)이므로
이다. \(\mathbf{A}\)가 상수라 기댓값 밖으로 빠져나온 것이 전부다.
양반정치성. \(\mathbf{A}\) 자리에 행벡터 \(\mathbf{c}^\top\)를 넣으면 좌변이 스칼라 확률변수의 분산이므로
이고, 이것이 모든 \(\mathbf{c}\)에 대해 성립한다. 즉 공분산행렬의 양반정치성은 "분산은 음수가 될 수 없다"를 행렬로 옮겨 적은 것일 뿐이다. 등호는 \(\mathbf{c}^\top\mathbf{X}\)가 상수일 때, 곧 변수들 사이에 완전한 선형관계가 있을 때만 성립한다. \(\square\)
import numpy as np

Sigma = np.array([[0.04,  0.006,  0.000],
                  [0.006, 0.09,  -0.012],
                  [0.000, -0.012, 0.16]])

w = np.full(3, 1 / 3)
print(f"개별 표준편차:        {np.sqrt(np.diag(Sigma)).round(3)}")
print(f"개별 표준편차의 평균: {np.sqrt(np.diag(Sigma)).mean():.4f}")
print(f"동일가중 포트폴리오:   분산 {w @ Sigma @ w:.6f}, 표준편차 {np.sqrt(w @ Sigma @ w):.4f}")

Si = np.linalg.inv(Sigma)
one = np.ones(3)
w_mv = Si @ one / (one @ Si @ one)          # 최소분산 포트폴리오
print(f"\n최소분산 가중치: {w_mv.round(4)}")
print(f"최소분산 표준편차: {np.sqrt(w_mv @ Sigma @ w_mv):.4f}")
출력:
개별 표준편차:        [0.2 0.3 0.4]
개별 표준편차의 평균: 0.3000
동일가중 포트폴리오:   분산 0.030889, 표준편차 0.1758

최소분산 가중치: [0.5721 0.2561 0.1718]
최소분산 표준편차: 0.1563
동일가중 포트폴리오의 표준편차 \(0.1758\)은 개별 표준편차의 평균 \(0.3\)보다 훨씬 작다. 이것이 분산투자다. 비대각 성분이 작거나 음수라서 \(\mathbf{w}^\top\boldsymbol{\Sigma}\mathbf{w}\)가 대각 성분의 가중평균보다 작아지는 것이다.
최소분산 포트폴리오는 여기서 더 나아가 \(0.1563\)까지 낮추는데, 변동성이 가장 낮은 첫 자산에 가장 큰 비중(\(0.57\))을 준다. 상관이 완전하다면(\(\rho = 1\)) 비대각 성분이 커져 이런 이득이 사라진다. 위기 때 상관이 \(1\)로 몰리면서 분산투자 효과가 증발하는 현상이 바로 이 계산에 들어 있다.
연습문제 9. 행렬 미적분으로 정규방정식을 유도하라. 필요한 기울기 규칙 \(\nabla_{\mathbf{x}}(\mathbf{a}^\top\mathbf{x}) = \mathbf{a}\)와 \(\nabla_{\mathbf{x}}(\mathbf{x}^\top\mathbf{A}\mathbf{x}) = 2\mathbf{A}\mathbf{x}\)(\(\mathbf{A}\) 대칭)를 먼저 증명하고, 헤세행렬을 확인해 얻은 점이 정말 최소점임을 보여라.
풀이
기울기 규칙. \(\mathbf{a}^\top\mathbf{x} = \sum_j a_j x_j\)이므로 \(\partial/\partial x_k = a_k\), 곧 \(\nabla = \mathbf{a}\)이다. 이차형식은 \(\mathbf{x}^\top\mathbf{A}\mathbf{x} = \sum_{i,j}a_{ij}x_ix_j\)이므로
이고, \(\mathbf{A}\)가 대칭이면 \(2\mathbf{A}\mathbf{x}\)가 된다.
유도. 목적함수를 전개하면
이다(\(\mathbf{y}^\top\mathbf{X}\boldsymbol{\beta}\)가 스칼라라 전치와 같으므로 두 교차항이 합쳐졌다). 위의 두 규칙을 쓰면
최소점 확인. 헤세행렬은 \(\nabla^2 S = 2\mathbf{X}^\top\mathbf{X}\)이고, 임의의 \(\mathbf{v} \ne \mathbf{0}\)에 대해
이다. \(\mathbf{X}\)가 완전 열계수이면 \(\mathbf{X}\mathbf{v} \ne \mathbf{0}\)이라 헤세행렬이 양정치가 되어 \(S\)가 순볼록(strictly convex)이고, 기울기가 \(\mathbf{0}\) 인 점인 정류점(stationary point)은 유일한 전역 최소점이다. \(\square\)
import numpy as np

rng = np.random.default_rng(1)
n, p = 40, 3
X = np.column_stack([np.ones(n), rng.normal(size=(n, p - 1))])
y = X @ np.array([1., 2., -1.]) + rng.normal(size=n)

beta = np.array([0.3, -0.7, 1.1])          # 아무 점에서나
S = lambda b: ((y - X @ b) ** 2).sum()

grad_analytic = -2 * X.T @ y + 2 * X.T @ X @ beta
h = 1e-6
grad_numeric = np.array([(S(beta + h * e) - S(beta - h * e)) / (2 * h)
                         for e in np.eye(p)])
print("해석적 기울기:", grad_analytic.round(6))
print("수치적 기울기:", grad_numeric.round(6))

hess = 2 * X.T @ X
print(f"\n헤세행렬 고윳값: {np.linalg.eigvalsh(hess).round(3)}  (모두 > 0)")
print(f"정류점 = OLS 해: "
      f"{np.allclose(np.linalg.solve(X.T @ X, X.T @ y), np.linalg.lstsq(X, y, rcond=None)[0])}")
출력:
해석적 기울기: [ -69.943347 -130.877197   77.167931]
수치적 기울기: [ -69.943347 -130.877197   77.167931]

헤세행렬 고윳값: [44.717 64.702 84.593]  (모두 > 0)
정류점 = OLS 해: True
수치미분이 해석적 기울기와 소수점 여섯째 자리까지 맞는다. 새 손실함수를 유도했을 때 이런 대조는 언제나 해 볼 만한 값싼 점검이다.
연습문제 10. (하나 빼기 항등식) 관측 \(i\)를 빼고 적합한 회귀의 예측오차가
임이 알려져 있다. 여기서 \(e_i\)는 통상 잔차이고 \(h_{ii}\)는 지렛값(leverage)이다. 이 공식을 수치로 확인하고, \(h_{ii}\)가 \(1\)에 가까우면 어떤 일이 벌어지는지 설명하라.
풀이
import numpy as np

rng = np.random.default_rng(7)
n, p = 12, 3
X = np.column_stack([np.ones(n), rng.normal(size=(n, p - 1))])
y = rng.normal(size=n)

XtXi = np.linalg.inv(X.T @ X)
H = X @ XtXi @ X.T
e = y - X @ (XtXi @ X.T @ y)
h = np.diag(H)

loo = np.empty(n)                       # 무식하게: n 번 다시 적합
for i in range(n):
    keep = np.ones(n, bool)
    keep[i] = False
    loo[i] = y[i] - X[i] @ np.linalg.lstsq(X[keep], y[keep], rcond=None)[0]

print(f"공식과 실제 재적합의 최대 차이: {np.abs(loo - e / (1 - h)).max():.2e}")
print(f"지렛값 합 = {h.sum():.4f}  (= p = {p})")
print(f"\nSSE   = {(e ** 2).sum():.4f}   (같은 자료로 평가)")
print(f"PRESS = {(loo ** 2).sum():.4f}   (빼놓은 자료로 평가)")
출력:
공식과 실제 재적합의 최대 차이: 4.55e-15
지렛값 합 = 3.0000  (= p = 3)

SSE   = 7.3015   (같은 자료로 평가)
PRESS = 13.1653   (빼놓은 자료로 평가)
왜 중요한가. \(n\)번 다시 적합하는 대신 한 번의 적합에서 나온 \(e_i\)와 \(h_{ii}\)만으로 하나 빼기 교차검증(cross-validation)을 끝낼 수 있다. 회귀에서 LOOCV가 사실상 공짜인 이유다.
\(h_{ii} \to 1\)일 때. 분모가 \(0\)으로 가면서 예측오차가 폭발한다. 뜻은 이렇다. 관측 \(i\)가 설명변수의 공간에서 워낙 외따로 떨어져 있어 그 점을 빼면 그 위치를 짚어 줄 다른 관측이 없다. 실제로 \(h_{ii} = 1\)이면 회귀선이 그 점을 정확히 통과해 \(e_i = 0\)이 되고, 모형은 그 점에 대해 아무것도 검증하지 못한다.
이 때문에 \(h_{ii} > 2p/n\)인 관측을 높은 지렛점으로 보아 따로 살핀다. 쿡의 거리도 \(e_i\)와 \(h_{ii}\)를 같은 방식으로 결합해 만든다.
위 출력에서 PRESS가 SSE의 두 배쯤 된다는 점도 눈여겨보라. 같은 자료로 적합하고 같은 자료로 평가하면 성능이 낙관적으로 나온다는 사실이 한 줄로 드러난다. \(\square\)
정리하며
이 절은 관측 \(n\) 개와 설명변수 열 \(p\) 개를 하나의 식으로 적는 표기를 세웠다.
- 설계행렬 \(\mathbf{X}\). 행이 관측, 열이 설명변수다(절편 열 포함). \(\operatorname{col}(\mathbf{X})\) 가 최소제곱으로 도달할 수 있는 적합값 전체이며, 회귀란 \(\mathbf{y}\) 를 이 공간으로 사영하는 일이다.
- 네 가지 기본 부분공간과 계수–퇴화차수 정리. 자유도가 어디서 오는지를 세는 장치다. 잔차가 \(p\) 개의 제약을 받아 자유도가 \(n-p\) 로 줄어든다는 사실이 여기서 나온다.
- 스펙트럼 정리. 대칭행렬은 \(\mathbf{Q}\boldsymbol\Lambda\mathbf{Q}^\top\) 로 분해된다. 공분산행렬, \(\mathbf{X}^\top\mathbf{X}\), 모자 행렬이 모두 대칭이므로 이 정리가 주성분분석·다변량 정규·이차형식의 카이제곱분포를 한꺼번에 떠받친다.
- 양(반)정치성. 공분산행렬은 언제나 \(\succeq 0\) 이고, \(\succ 0\) 인 것이 곧 \((\mathbf{X}^\top\mathbf{X})^{-1}\) 이 존재해 최소제곱해가 유일해지는 조건이다.
- 모자 행렬 \(\mathbf{H}=\mathbf{X}(\mathbf{X}^\top\mathbf{X})^{-1}\mathbf{X}^\top\). 대칭이고 멱등이다. 오차가 정규분포를 따르면 이 두 성질만으로 잔차제곱합의 분포가 정해진다.
두 항등식이 특히 자주 쓰인다. \(\operatorname{Cov}(\mathbf{A}\mathbf{X}) = \mathbf{A}\,\operatorname{Cov}(\mathbf{X})\,\mathbf{A}^\top\) 가 선형변환의 분산을 주고, \(\mathbb{E}[\mathbf{X}^\top\mathbf{A}\mathbf{X}] = \operatorname{tr}(\mathbf{A}\,\operatorname{Cov}(\mathbf{X})) + \boldsymbol\mu^\top\mathbf{A}\boldsymbol\mu\) 가 이차형식의 기댓값을 준다. 뒤에서 \(\mathbb{E}[\text{SSE}]\) 를 계산할 때 쓰는 것이 두 번째 식이다.
다음 절부터는 계산 도구로 넘어간다. 파이썬·NumPy·pandas·Matplotlib 으로 여기 적은 연산을 실제로 수행하고, 자료를 눈으로 확인하는 법을 익힌다.