비율 신뢰구간의 포함확률 모의실험
개요
이 페이지에서는 모비율 \(p\)의 신뢰구간을 만드는 네 가지 방법 — Wald, Wilson score, Agresti–Coull, Clopper–Pearson(정확) 구간 — 의 포함 성능을 살펴본다. 몬테카를로 모의실험으로 베르누이 표본을 반복 생성하고 각 방법으로 신뢰구간을 만든 뒤 그 구간이 참 \(p\)를 잡아내는지 기록한다. 그 결과는 \(n\)이 작거나 \(p\)가 극단적일 때 Wald 구간을 믿을 수 없는 이유를 부각한다.
네 가지 구간 방법
Wald 구간
단순하지만 \(n\)이 작거나 \(p\)가 0이나 1에 가까우면 포함확률이 심하게 부족할 수 있다.
Wilson score 구간
중심을 \(\hat{p}\)에서 옮겨 놓으며 중간 크기의 \(n\)에서도 좋은 포함확률을 준다. 권장되는 기본값이다.
Agresti–Coull 구간
가상의 성공 \(z^2/2\)개와 가상의 실패 \(z^2/2\)개를 더해 보정된 개수를 만든다:
그다음 \((\tilde{p}, \tilde{n})\)에 Wald 공식을 적용한다:
포함확률이 Wilson과 매우 가깝고 계산은 더 간단하다.
Clopper–Pearson (정확) 구간
베타 분위수를 써서 이항검정을 뒤집는다:
보수적이다: 실제 포함확률이 적어도 \((1-\alpha)100\%\)이지만 구간이 넓어지는 경향이 있다.
보기 1. 비율 신뢰구간 모의실험. \(n = 20\), 참값 \(p = 0.2\), 명목 \(95\%\)에서 네 방법을 비교한다. 되풀이는 \(100\)회다.
(1) 네 방법의 포함률을 모의실험 없이 정확히 구하시오. 그리고 왈드와 윌슨의 차이가 어느 \(k\)에서 생기는지 밝히시오.
(2) 되풀이 \(100\)회의 모의 포함률을 (1)과 나란히 두고, 차이가 몬테카를로 오차로 설명되는지 확인하시오.
풀이
(1) 포함률은 유한합이다. \(n = 20\)이면 \(k\)가 가질 수 있는 값은 \(0, 1, \ldots, 20\)의 스물한 가지뿐이고, 구간은 \(k\)의 함수다. 그러므로 각 방법에 대해 \(p = 0.2\)를 담는 \(k\)의 집합 \(S\)를 구하고 그 점질량을 더하면 끝이다.
네 집합을 실제로 구하면 다음과 같다.
| 방법 | \(p = 0.2\)를 담는 \(k\) | 포함률 |
|---|---|---|
| 왈드 | \(\{2, 3, \ldots, 8\}\) | \(0.92084\) |
| 윌슨 | \(\{1, 2, \ldots, 7\}\) | \(0.95633\) |
| 아그레스티–쿨 | \(\{1, 2, \ldots, 7\}\) | \(0.95633\) |
| 클로퍼–피어슨 | \(\{1, 2, \ldots, 8\}\) | \(0.97849\) |
왈드와 윌슨의 차이는 두 개의 \(k\)에서 나온다. 집합을 비교하면 왈드는 \(k = 1\)을 잃고 \(k = 8\)을 얻는다. 그 두 점질량이
이므로
로 정확히 맞아떨어진다. \(k = 1\)에서 왈드 구간은 \((0,\ 0.1455)\) 로 \(0.2\)에 닿지 못하는데, 윌슨은 중심이 \(1/2\) 쪽으로 당겨져 \((0.0089,\ 0.2361)\) 이 되어 담는다. 잃는 쪽이 얻는 쪽보다 \(2.6\)배 무거워 왈드가 진다.
클로퍼–피어슨은 윌슨에 \(k = 8\)만 더한 것이다. \(0.95633 + 0.02216 = 0.97849\) 다. 명목 \(0.95\)를 위로 \(2.8\)퍼센트포인트 넘는데, 이것이 "보수적"이라는 말의 정확한 뜻이다.
윌슨과 아그레스티–쿨은 포함률이 같다. 두 구간은 중심이 같고 폭만 아그레스티–쿨이 조금 넓은데, 이 자리에서는 그 추가 폭이 새로운 \(k\)를 하나도 들여오지 못했다. 포함률이 \(k\) 단위로만 움직이므로 폭의 차이가 집합을 바꾸지 못하면 포함률도 바뀌지 않는다. 이산성이 두 방법을 똑같이 만든 것이고, \(n\)이나 \(p\)가 조금만 달라져도 갈라진다.
(2) 모의실험.
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import norm, beta

np.random.seed(42)          # 아래 출력과 그림을 재현하려면 고정한다

n_simulations = 100
n = 20
p_true = 0.20
alpha = 0.05
method = "wilson"  # 'wald' | 'wilson' | 'ac' | 'cp'

# 표본을 만들 필요가 없다. 필요한 것은 성공 횟수 k 하나뿐이므로
# 0/1을 n개 뽑는 대신 이항분포에서 k를 바로 뽑는다.
k = np.random.binomial(n=n, p=p_true, size=n_simulations)
phat = k / n
z = norm.ppf(1 - alpha / 2)

lower = np.empty(n_simulations)
upper = np.empty(n_simulations)

for i, ki in enumerate(k):
    p = ki / n
    if method == "wald":
        se = np.sqrt(p * (1 - p) / n)
        lo, hi = p - z * se, p + z * se
    elif method == "wilson":
        denom = 1 + z**2 / n
        center = (p + z**2 / (2 * n)) / denom
        half = z * np.sqrt(p * (1 - p) / n + z**2 / (4 * n**2)) / denom
        lo, hi = center - half, center + half
    elif method == "ac":
        n_tilde = n + z**2
        p_tilde = (ki + 0.5 * z**2) / n_tilde
        se_tilde = np.sqrt(p_tilde * (1 - p_tilde) / n_tilde)
        lo, hi = p_tilde - z * se_tilde, p_tilde + z * se_tilde
    else:  # cp
        lo = 0.0 if ki == 0 else beta.ppf(alpha / 2, ki, n - ki + 1)
        hi = 1.0 if ki == n else beta.ppf(1 - alpha / 2, ki + 1, n - ki)

    lower[i] = max(0.0, lo)
    upper[i] = min(1.0, hi)

covered = (lower <= p_true) & (p_true <= upper)
coverage_pct = 100.0 * covered.mean()
print(f"{method} coverage: {coverage_pct:.1f}%")


# (1) 포함률은 유한합이다. k 가 21가지뿐이므로 담는 k 를 모아 더하면 끝이다.
from scipy.stats import binom


def interval(ki, which):
    """성공 횟수 ki 하나에서 네 방법의 구간 끝점을 돌려준다."""
    p = ki / n
    if which == "wald":
        se = np.sqrt(p * (1 - p) / n)
        lo, hi = p - z * se, p + z * se
    elif which == "wilson":
        denom = 1 + z**2 / n
        center = (p + z**2 / (2 * n)) / denom
        half = z * np.sqrt(p * (1 - p) / n + z**2 / (4 * n**2)) / denom
        lo, hi = center - half, center + half
    elif which == "ac":
        n_tilde = n + z**2
        p_tilde = (ki + 0.5 * z**2) / n_tilde
        se_tilde = np.sqrt(p_tilde * (1 - p_tilde) / n_tilde)
        lo, hi = p_tilde - z * se_tilde, p_tilde + z * se_tilde
    else:
        lo = 0.0 if ki == 0 else beta.ppf(alpha / 2, ki, n - ki + 1)
        hi = 1.0 if ki == n else beta.ppf(1 - alpha / 2, ki + 1, n - ki)
    return max(0.0, lo), min(1.0, hi)


def covers(ki, which):
    lo, hi = interval(ki, which)
    return lo <= p_true <= hi


print()
print(f"{'방법':<8}{'담는 k':<12}{'정확':>9}{'모의':>8}{'차이/MC오차':>10}")
for m in ("wald", "wilson", "ac", "cp"):
    S = [ki for ki in range(n + 1) if covers(ki, m)]
    exact = sum(binom.pmf(ki, n, p_true) for ki in S)
    sim = np.mean([covers(ki, m) for ki in k])
    se_mc = np.sqrt(exact * (1 - exact) / n_simulations)
    print(f"{m:<8}{f'{S[0]}..{S[-1]}':<12}{exact:>9.5f}{sim:>8.2f}{abs(sim - exact) / se_mc:>10.2f}")
출력:
wilson coverage: 96.0%

방법      담는 k               정확      모의   차이/MC오차
wald    2..8          0.92084    0.91      0.40
wilson  1..7          0.95633    0.96      0.18
ac      1..7          0.95633    0.96      0.18
cp      1..8          0.97849    0.99      0.79
네 정확값이 (1)의 표와 같다. 담는 \(k\)의 범위도 \(2..8\), \(1..7\), \(1..7\), \(1..8\) 로 손으로 구한 집합과 같다.
모의와 정확이 모두 몬테카를로 오차 안에서 맞는다. 마지막 열이 \(|\text{모의} - \text{정확}|\) 을 그 자리의 몬테카를로 표준오차로 나눈 값인데, 네 방법 모두 \(0.79\) 이하다. \(1\) 표준오차를 넘는 것이 하나도 없다.
그러나 \(100\)회로 읽을 수 있는 것은 순서뿐이다. 모의가 준 \(0.91 / 0.96 / 0.96 / 0.99\) 는 정확값 \(0.9208 / 0.9563 / 0.9563 / 0.9785\) 의 차례는 바르게 재현했지만 자릿수는 믿을 수 없다. \(0.95\) 근처에서 되풀이 \(100\)회의 표준오차가 \(0.02\)라서 소수 둘째 자리가 통째로 흔들린다. 포함률을 값으로 말하려면 정확 계산을 하거나 되풀이를 만 번 단위로 올려야 한다.
윌슨과 아그레스티–쿨은 모의에서도 한 글자도 다르지 않다. 둘이 같은 \(k\) 집합을 담으므로 같은 표본에서는 언제나 같이 맞고 같이 틀린다. 모의실험을 아무리 늘려도 이 자리에서는 두 방법이 갈라지지 않는다.
같은 자료(같은 시드)에 method만 바꿔 세어 보면 Wald 91.0%, Agresti–Coull 96.0%, Clopper–Pearson 99.0%가 된다. Wald만 명목값 아래로 내려가고, Clopper–Pearson은 보수적인 만큼 위로 넘친다.
구간의 시각화
보기 2. 구간 100개를 한 그림에. 앞 보기에서 만든 윌슨 구간 \(100\)개를 가로선 하나씩으로 그리고, 참값을 놓친 것만 빨갛게 칠한다.
(1) 그림을 그리고 무엇이 읽히는지 수와 함께 말하시오. 선이 몇 자리에만 나타나는 까닭을 밝히시오.
(2) 이 그림에서 왈드 구간의 실패를 읽을 수 있는가. 그 밖에 이 그림이 가리는 것은 무엇인가.
풀이
(1) 그림.
# 구간 하나를 가로선 하나로 그린다. 참값을 담은 구간은 검정, 놓친 구간은
# 빨강이다. 세로 점선이 참값이고, 빨간 선이 몇 개인지 세는 것이 곧 포함확률을
# 재는 일이다. 구간마다 길이가 다른 까닭은 표본마다 s 가 다르기 때문이다.
fig, ax = plt.subplots(figsize=(12, 12))
for i in range(n_simulations):
    color = "k" if covered[i] else "r"
    ax.plot([lower[i], upper[i]], [i, i], lw=2, color=color)
    ax.plot(phat[i], i, marker="o", ms=3, color=color)

ax.axvline(p_true, linestyle="--", linewidth=1.5)
ax.set_title(f"{n_simulations} {method.upper()} CIs | n={n}, p={p_true}, CL=95%")
ax.set_yticks([])
ax.set_xlabel("Proportion value")
plt.tight_layout()
plt.show()
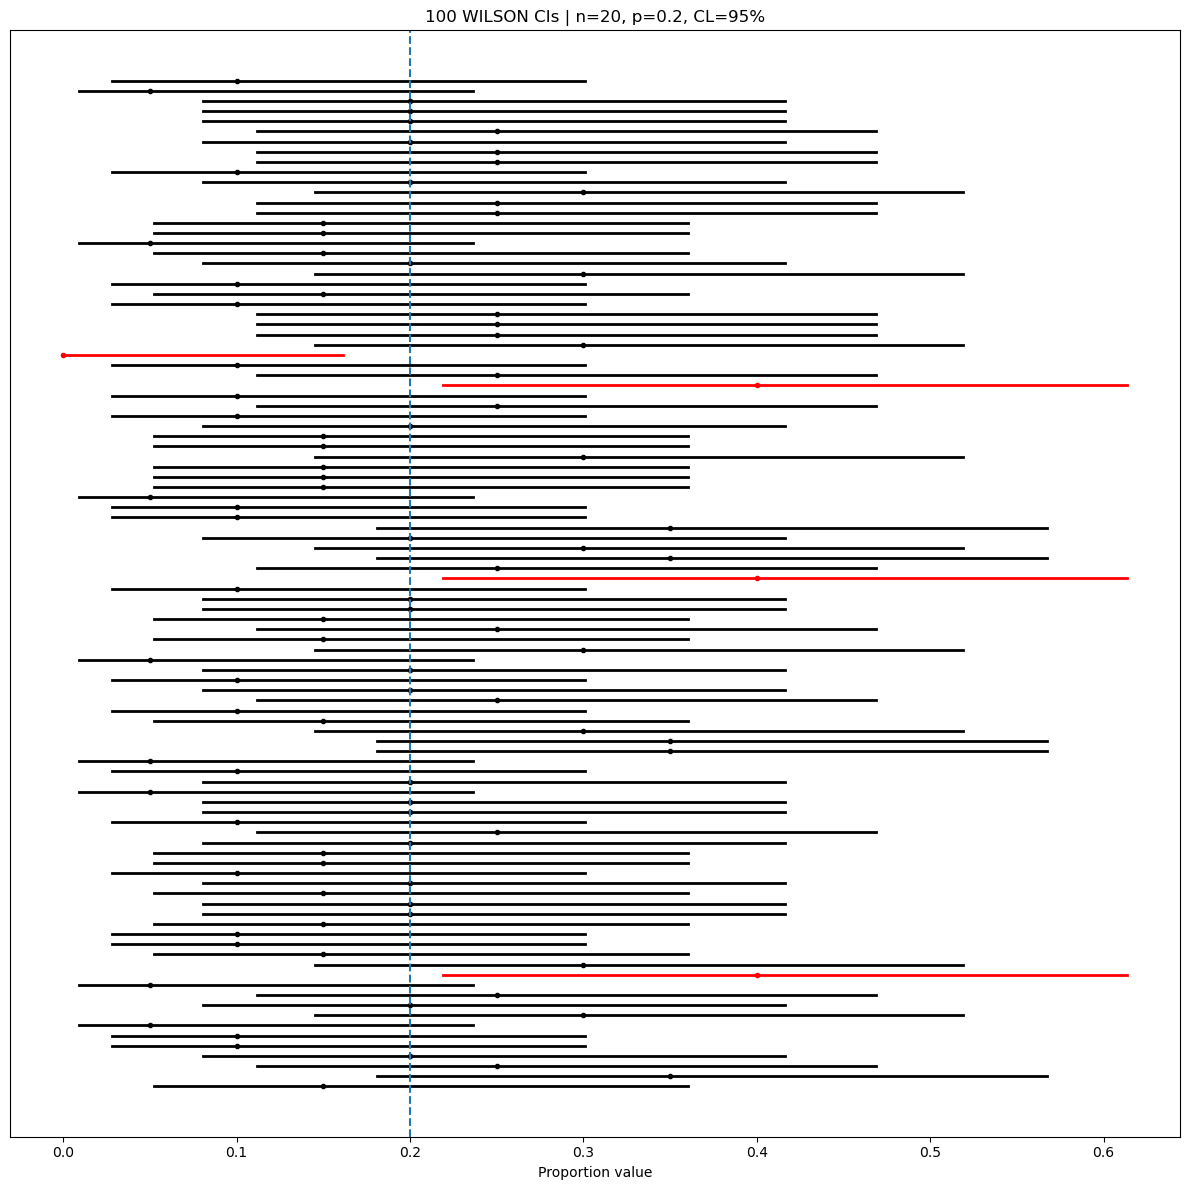
읽히는 것 하나 — 선이 아홉 자리에만 있다. \(k\)가 정수이므로 \(\hat p = k/n\)이 \(0,\ 0.05,\ 0.10,\ \ldots\) 의 스물한 가지 값만 가질 수 있고, 구간은 \(k\)의 함수이므로 같은 \(k\)가 나온 표본은 완전히 같은 구간을 만든다. 이 \(100\)개 표본에 실제로 나온 \(k\)는 아홉 가지뿐이다.
| \(k\) | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
|---|---|---|---|---|---|---|---|---|---|
| 표본 수 | 1 | 8 | 19 | 18 | 21 | 16 | 9 | 5 | 3 |
그림에 선이 \(100\)개 그려져 있지만 서로 다른 선은 아홉 개다. 나머지는 겹쳐 그린 것이다.
읽히는 것 둘 — 빨간 선이 넷이고, 그 정체가 분명하다. 맨 왼쪽의 짧은 빨간 선 하나가 \(k = 0\)의 구간 \((0,\ 0.1611)\) 이고, \(0.219\) 에서 시작하는 긴 빨간 선 셋이 \(k = 8\)의 구간 \((0.2188,\ 0.6134)\) 다. 앞 보기에서 구한 "윌슨이 담는 \(k\)는 \(\{1, \ldots, 7\}\)" 과 정확히 맞는다. \(k = 0\)은 위에서 못 미치고 \(k = 8\)은 아래에서 넘어선다.
읽히는 것 셋 — 폭이 \(k\)와 함께 넓어진다. 윌슨 구간의 폭은
로 \(\hat p\)이 \(1/2\)에 가까울수록 넓다. \(\hat p(1-\hat p)\)가 \(1/2\)에서 최대이기 때문이다. \(k = 0\)에서도 폭이 \(0.1611\) 로 남아 있다는 점이 중요하다. 같은 자리에서 왈드 구간은 \((0,\ 0)\) 한 점으로 무너진다.
(2) 왈드의 실패는 이 그림에 없다. 그려진 것은 윌슨 구간이므로, 왈드가 \(k = 1\)의 여덟 표본에서 실패한다는 사실은 이 그림의 어디에도 나타나지 않는다. 다만 \(k\)별 도수를 셀 수는 있으므로, 앞 보기에서 구한 "왈드가 담는 \(k\)는 \(\{2,\ldots,8\}\)" 과 맞추면 왈드의 실패가 \(1 + 8 = 9\)개임을 계산해 낼 수는 있다. 그림이 보여 주는 것이 아니라 그림에서 센 수와 다른 계산을 합쳐야 나오는 값이다.
그 밖에 가리는 것 셋.
- 포함률의 참값. 빨간 선이 넷이라고 해서 포함률이 \(0.96\)인 것이 아니다. 참값은 \(0.95633\)이고, 그것은 이 그림이 아니라 유한합이 준다.
- 표본의 다양성. 선이 \(100\)개 그려져 있어 \(100\)가지 결과처럼 보이지만 실제로는 아홉 가지다. 그림이 자료의 풍부함을 과장한다.
- 색칠에 필요한 정보. 검정인지 빨강인지는 참값 \(p = 0.2\)를 알아야 정할 수 있다. 실제 자료에서는 그 선이 어느 색인지 알 길이 없다.
구간이 몇 가지 위치에만 나타나는 것은 \(k\)가 정수여서 \(\hat p\)가 \(0, 0.05, 0.10, \ldots\) 스물한 가지 값밖에 갖지 못하기 때문이다. 같은 \(k\)가 나온 표본들은 완전히 같은 구간을 만든다.
Wald가 91%로 떨어지는 이유는 \(k\)별로 따져 보면 분명하다. 이 100개 표본 중 \(k = 1\)인 것이 8개인데, 그 경우 Wald 구간은 \((0, 0.146)\)으로 참값 0.2에 닿지 못한다. 반면 Wilson 구간은 중심이 0.5 쪽으로 당겨져 \((0.009, 0.236)\)이 되어 참값을 담는다. 여기에 \(k = 0\)인 표본 하나를 더해 Wald는 9번 실패한다. \(k = 0\)에서는 Wald 구간이 \(\hat p = 0\) 때문에 표준오차가 0이 되어 점 하나로 무너진다.
Wilson의 실패 4번은 \(k = 0\) 하나와 \(k = 8\) 셋이다. 즉 두 방법의 차이는 "\(\hat p\)가 작은 쪽에서 구간이 0 쪽으로 쏠리는가"에서 갈린다.
해석
- Wald 구간은 \(n\)이 작거나 \(p\)가 경계 0 또는 1에 가까우면 포함확률이 극적으로 낮아질 수 있다. 구간에 쓰는 보수적 기준은 \(n\hat{p} \ge 10\)이고 \(n(1-\hat{p}) \ge 10\)일 것을 요구하지만, 이것만으로 늘 충분하지는 않다. 4장에서 보았듯 문턱값을 10으로 올려도 왈드 구간의 실제 포함확률은 명목 95%에 정확히 앉지 않는다. 문턱값을 높이는 것으로 왈드 구간의 결함이 사라지지는 않으며, 구간이 중요하면 애초에 더 나은 구간을 쓰는 편이 낫다.
- Wilson과 Agresti–Coull 구간은 중심을 \(1/2\) 쪽으로 옮기고 구간을 약간 넓혀, 넓은 범위의 \(n\)과 \(p\)에서 훨씬 믿을 만한 포함확률을 준다.
- Clopper–Pearson은 구성상 적어도 명목 포함확률을 보장하지만 (필요보다 넓게) 보수적이며 특히 \(n\)이 작을 때 그렇다.
- 크기 \(N\)인 유한모집단에서 비복원으로 표본을 뽑을 때 이항 모형은 \(n \le 0.10 N\)일 때 타당한 근사이다. 표본추출 비율이 더 크면 초기하분포에 기반한 구간이 더 적절하다.
연습문제
연습문제 1. \(n = 20\), \(p_{\text{true}} = 0.05\), \(n_{\text{sim}} = 10{,}000\)으로 Wald 구간의 모의실험을 돌려라. 경험적 포함확률을 보고하고 95%에서 벗어나는 이유를 설명하라.
풀이
\(p_{\text{true}} = 0.05\), \(n = 20\)이면 \(np = 1.0\)으로 구간에 요구되는 보수적 기준 \(np \ge 10\)을 크게 위반한다. 모양만 보는 느슨한 기준 \(np \ge 5\)에도 못 미치는 자리다. 모의실험을 돌리면 포함확률이 약 64%로 나온다.
이 경우는 모의실험 없이 정확히 계산할 수도 있다. \(k\)가 취할 수 있는 값이 21가지뿐이므로 각 \(k\)에 대해 구간이 0.05를 담는지 확인하고 이항확률로 가중하면 된다.
import numpy as np
from scipy.stats import norm, binom

n, p, alpha = 20, 0.05, 0.05
z = norm.ppf(1 - alpha / 2)
coverage = 0.0
for k in range(n + 1):
    phat = k / n
    se = np.sqrt(phat * (1 - phat) / n)
    lo, hi = max(0.0, phat - z * se), min(1.0, phat + z * se)
    if lo <= p <= hi:
        coverage += binom.pmf(k, n, p)
print(f"exact Wald coverage: {100 * coverage:.1f}%")
출력:
exact Wald coverage: 63.9%
실패는 거의 전부 \(k = 0\)에서 온다. \(P(k = 0) = 0.95^{20} = 0.358\)인데, 이때 \(\hat p = 0\)이라 표준오차가 0이 되어 구간이 \([0, 0]\) 한 점으로 무너진다. 세 번에 한 번 이상 "불량률은 정확히 0이다"라고 말하는 셈이다. \(1 - 0.358 = 0.642\)가 위에서 얻은 0.639와 거의 같다는 점이 이를 확인해 준다.
Wilson이나 Clopper–Pearson으로 바꾸면 \(k = 0\)일 때도 위쪽으로 폭이 있는 구간이 나오므로 이 실패 방식이 사라진다. \(\square\)
연습문제 2. \(Z = (\hat{p} - p)/\sqrt{p(1-p)/n}\)일 때 부등식 \(|Z| \le z_{\alpha/2}\)에서 출발하여 Wilson score 구간을 유도하라.
풀이
검정 뒤집기 방식은 다음을 만족하는 모든 \(p\)를 구한다:
양변을 제곱하면:
전개하고 \(p\)에 대해 정리하면:
\(p\)에 대한 이차식이다. 근의 공식을 적용하면
이며 이것이 정리되어 Wilson 구간의 끝점이 된다. \(\square\)
연습문제 3. 95% 수준의 Agresti–Coull 구간이 자료에 가상의 성공 약 2개와 가상의 실패 약 2개를 더하는 것임을 보여라.
풀이
95% 신뢰수준에서 \(\alpha = 0.05\)이고 \(z_{\alpha/2} = z_{0.025} \approx 1.96\)이다. Agresti–Coull 방법은 가상의 성공 \(z^2/2\)개와 가상의 실패 \(z^2/2\)개를 더하므로 관측값이 모두 \(z^2\)개 늘어난다. 계산하면:
따라서 가상의 성공과 실패를 각각 약 2개씩 더하는 셈이고, 보정된 표본크기는 \(\tilde{n} = n + z^2 \approx n + 4\)이다. 이 "성공 2개와 실패 2개를 더하기" 규칙 때문에 Agresti–Coull 방법을 "plus-four" 구간이라고 부르기도 한다. \(\square\)
연습문제 4. 어떤 의학 연구에서 환자 200명 중 3명에게 이상반응이 관찰되었다. Wald, Wilson, Clopper–Pearson 95% 구간을 계산하고 차이를 논하라.
풀이
여기서 \(k = 3\), \(n = 200\), \(\hat{p} = 0.015\), \(z = 1.96\)이다.
Wald: \(\text{SE} = \sqrt{0.015 \times 0.985 / 200} = 0.00860\). 신뢰구간: \(0.015 \pm 1.96 \times 0.00860 = (-0.0019, 0.0319)\). \((0, 0.0319)\)로 잘린다.
Wilson: 중심: \((0.015 + 3.8416/400)/(1 + 3.8416/200) = 0.02461/1.01921 \approx 0.02414\). 반너비 \(\approx 0.01903\). 신뢰구간 \(\approx (0.0051, 0.0432)\).
Clopper–Pearson: 하한 \(= \text{Beta}(0.025;\, 3,\, 198) \approx 0.00311\). 상한 \(= \text{Beta}(0.975;\, 4,\, 197) \approx 0.0433\). 신뢰구간 \(\approx (0.0031, 0.0433)\).
Wald 구간은 (비율에서는 불가능한) 음수를 포함하며 더 좁다. Wilson과 Clopper–Pearson은 서로 비슷하고 더 합리적인 구간을 준다. Clopper–Pearson의 하한이 약간 더 작은데, 이는 그 보수성을 반영한다. \(\square\)
연습문제 5. Clopper–Pearson 구간의 포함확률이 모든 \(p \in (0,1)\)에서 적어도 \((1-\alpha)\)임을 증명하라.
풀이
Clopper–Pearson 구간 \([L(k), U(k)]\)은 두 개의 단측 이항검정을 뒤집어 정의한다. 구체적으로 \(L(k)\)는 다음을 만족하는 \(p\)이다:
그리고 \(U(k)\)는 다음을 만족하는 \(p\)이다:
임의의 참 \(p\)에 대해 사건 \(p \notin [L(K), U(K)]\)은 \(p < L(K)\)이거나 \(p > U(K)\)임을 뜻한다. 구성상 \(p < L(K)\)는 주어진 \(p\)에 비해 \(K\)가 "너무 크다"는 뜻이고 이 꼬리 확률은 최대 \(\alpha/2\)이다. 마찬가지로 \(p > U(K)\)는 \(K\)가 "너무 작다"는 뜻이며 꼬리 확률이 최대 \(\alpha/2\)이다. 이항 누적분포함수가 계단함수이므로 어떤 \(p\)에서는 꼬리 확률이 \(\alpha/2\)보다 엄격히 작을 수 있지만 결코 크지는 않다. 따라서
이고 모든 \(p \in (0,1)\)에서 포함확률 \(P(p \in [L(K), U(K)]) \ge 1 - \alpha\)이다. \(\square\)
연습문제 6. \(n=40\)에서 다섯 방법의 기대 폭을 \(p\)별로 정확히 계산하고, 포함확률과 함께 놓고 판단하라.
풀이
기대 폭도 이산분포이므로 정확히 계산된다.
import numpy as np
from scipy import stats

n, alpha = 40, 0.05
z = stats.norm.ppf(1 - alpha / 2)
k = np.arange(n + 1)
ph = k / n

def bounds(m):
    if m == "wald":
        se = np.sqrt(ph * (1 - ph) / n)
        return ph - z * se, ph + z * se
    if m == "wilson":
        d = 1 + z**2 / n
        c = (ph + z**2 / (2 * n)) / d
        h = z / d * np.sqrt(ph * (1 - ph) / n + z**2 / (4 * n**2))
        return c - h, c + h
    if m == "ac":
        nt = n + z**2
        pt = (k + z**2 / 2) / nt
        se = np.sqrt(pt * (1 - pt) / nt)
        return pt - z * se, pt + z * se
    if m == "jeffreys":
        return (stats.beta.ppf(alpha / 2, k + 0.5, n - k + 0.5),
                stats.beta.ppf(1 - alpha / 2, k + 0.5, n - k + 0.5))
    if m == "cp":
        return (np.where(k == 0, 0.0, stats.beta.ppf(alpha / 2, k, n - k + 1)),
                np.where(k == n, 1.0, stats.beta.ppf(1 - alpha / 2, k + 1, n - k)))

methods = ["wald", "wilson", "ac", "jeffreys", "cp"]
names = ["왈드", "윌슨", "AC", "제프리스", "CP"]
for p in [0.05, 0.15, 0.30, 0.50]:
    w = stats.binom.pmf(k, n, p)
    out = []
    for m in methods:
        lo, hi = bounds(m)
        cov = w[(lo <= p) & (p <= hi)].sum()
        wid = ((hi - lo) * w).sum()
        out.append(f"{cov:.3f}/{wid:.3f}")
    print(f"p={p:.2f}  " + "  ".join(f"{nm} {o}" for nm, o in zip(names, out)))
p=0.05  왈드 0.868/0.121  윌슨 0.952/0.146  AC 0.986/0.166  제프리스 0.986/0.133  CP 0.986/0.157
p=0.15  왈드 0.939/0.215  윌슨 0.958/0.216  AC 0.958/0.224  제프리스 0.958/0.213  CP 0.976/0.236
p=0.30  왈드 0.930/0.280  윌슨 0.944/0.270  AC 0.944/0.272  제프리스 0.944/0.273  CP 0.961/0.296
p=0.50  왈드 0.919/0.306  윌슨 0.962/0.293  AC 0.962/0.293  제프리스 0.962/0.297  CP 0.962/0.320
함께 놓고 읽기.
| 방법 | 포함확률 | 폭 | 평가 |
|---|---|---|---|
| 왈드 | 0.87~0.94 | 좁음 | 부족한 포함확률을 좁은 폭으로 산 것 |
| 윌슨 | 0.94~0.96 | 가장 좁음(유효한 것 중) | 가장 균형 잡힘 |
| AC | 0.94~0.99 | 약간 넓음 | 안전하지만 경계에서 보수적 |
| 제프리스 | 0.94~0.99 | 좁음 | 윌슨과 우열 가리기 어려움 |
| CP | 0.96~0.99 | 가장 넓음 | 보장은 있으나 대가가 큼 |
핵심. 왈드가 좁은 것은 장점이 아니다. 포함확률이 0.87인 구간과 0.95인 구간의 폭을 비교하는 것은 의미가 없다. 왈드를 87% 수준으로 맞춰 비교하면 이점이 사라진다. 실제로 \(p=0.30\)과 \(p=0.50\)에서는 왈드가 윌슨보다 넓으면서도 포함확률이 낮다 — 좁다는 이점조차 없다.
제프리스가 경계에서 좋다. \(p=0.05\)에서 포함확률 0.986을 CP와 같이 달성하면서 폭은 0.133으로 CP(0.157)보다 15% 짧다. 이 영역에서는 제프리스가 가장 효율적이다.
CP의 대가. \(p=0.05\)에서 윌슨보다 8% 넓고, \(p=0.50\)에서 9% 넓다. 그 대가로 얻는 것은 모든 \(p\)에서 \(\ge0.95\)라는 보장이다. 규제 환경에서는 값어치가 있고, 탐색적 분석에서는 낭비다.
연습문제 7. 최소 포함확률을 \(p\) 격자에서 계산하여 방법들을 비교하라. \(n\)이 커지면 최소 포함확률이 어떻게 변하는가?
풀이
import numpy as np
from scipy import stats

def min_cov(n, method, alpha=0.05, grid=2001):
    z = stats.norm.ppf(1 - alpha / 2)
    k = np.arange(n + 1)
    ph = k / n
    if method == "wald":
        se = np.sqrt(ph * (1 - ph) / n)
        lo, hi = ph - z * se, ph + z * se
    elif method == "wilson":
        d = 1 + z**2 / n
        c = (ph + z**2 / (2 * n)) / d
        h = z / d * np.sqrt(ph * (1 - ph) / n + z**2 / (4 * n**2))
        lo, hi = c - h, c + h
    elif method == "jeffreys":
        lo = stats.beta.ppf(alpha / 2, k + 0.5, n - k + 0.5)
        hi = stats.beta.ppf(1 - alpha / 2, k + 0.5, n - k + 0.5)
    elif method == "cp":
        lo = np.where(k == 0, 0.0, stats.beta.ppf(alpha / 2, k, n - k + 1))
        hi = np.where(k == n, 1.0, stats.beta.ppf(1 - alpha / 2, k + 1, n - k))
    ps = np.linspace(0.001, 0.999, grid)
    pmf = stats.binom.pmf(k[:, None], n, ps[None, :])
    inside = (lo[:, None] <= ps[None, :]) & (ps[None, :] <= hi[:, None])
    return (pmf * inside).sum(axis=0).min()

print(f"{'n':>5s} {'왈드':>8s} {'윌슨':>8s} {'제프리스':>9s} {'CP':>8s}")
for n in [10, 25, 50, 100, 200]:
    vals = [min_cov(n, m) for m in ["wald", "wilson", "jeffreys", "cp"]]
    print(f"{n:5d} " + " ".join(f"{v:8.4f}" for v in vals))
    n       왈드       윌슨      제프리스       CP
   10   0.0100   0.8384   0.8682   0.9611
   25   0.0247   0.8392   0.8906   0.9505
   50   0.0488   0.8394   0.8840   0.9509
  100   0.0952   0.8607   0.8805   0.9503
  200   0.1813   0.9102   0.8781   0.9504
관찰 1 — 왈드의 최소 포함확률이 처참하다. \(n=10\)에서 0.010이다. 격자의 왼쪽 끝 \(p=0.001\)에서 \(K=0\)이 거의 확실한데, 그때 왈드 구간은 폭이 0인 점 \(\{0\}\)이라 참값을 담지 못한다. 최소 포함확률은 사실상
이고, \(n=200\)에서도 \(1-0.999^{200}=0.181\)에 지나지 않는다. \(n\)을 늘려도 회복되지 않는다 — 격자를 더 촘촘히 하면 다시 0으로 내려간다.
관찰 2 — CP만이 보장을 준다. 모든 \(n\)에서 0.95를 넘는다. 이것이 "정확 구간"의 뜻이다.
관찰 3 — 윌슨과 제프리스는 0.88 언저리에 머문다. \(n\)을 100배 늘려도 0.84에서 0.91로 조금 오를 뿐이다. 평균 포함확률은 0.95에 가깝지만 최악의 \(p\)에서는 계속 부족하다.
관찰 4 — 최소 포함확률은 0.95로 수렴하지 않는다. 이산성 때문에 어떤 \(n\)에서도 \(p\)를 잘 고르면 포함확률을 떨어뜨릴 수 있다. 정확 방법이 아닌 한 보장은 영원히 없다.
어떻게 판단할 것인가.
- 최악을 걱정해야 하면 CP.
- \(p\)가 대략 어디쯤인지 알면 그 근방의 포함확률만 보면 된다. \(p\approx0.3\)이라면 윌슨으로 충분하다.
- 왈드는 어떤 경우에도 권하지 않는다.
연습문제 8. 희귀사건(\(np<5\))에서 포아송 근사 구간이 쓸 만한지 확인하라. \(n=1000\), \(p=0.002\)에서 이항 기반 구간과 비교하라.
풀이
착안. \(n\)이 크고 \(p\)가 작으면 \(K\approx\text{Poisson}(\lambda=np)\)다. 포아송의 정확 구간은 카이제곱으로 주어진다.
을 \(\lambda\)의 구간으로 삼고 \(n\)으로 나눈다.
import numpy as np
from scipy import stats

n, p_true, alpha = 1000, 0.002, 0.05
k = np.arange(0, 25)

# 포아송 정확 구간 (λ 척도 → p = λ/n)
lam_lo = np.where(k == 0, 0.0, stats.chi2.ppf(alpha / 2, 2 * k) / 2)
lam_hi = stats.chi2.ppf(1 - alpha / 2, 2 * k + 2) / 2
po_lo, po_hi = lam_lo / n, lam_hi / n

# 클로퍼-피어슨
cp_lo = np.where(k == 0, 0.0, stats.beta.ppf(alpha / 2, k, n - k + 1))
cp_hi = stats.beta.ppf(1 - alpha / 2, k + 1, n - k)

print(f"{'k':>3s} {'포아송 구간':>24s} {'클로퍼-피어슨':>24s}")
for i in [0, 1, 2, 5]:
    print(f"{i:3d}  ({po_lo[i]:.6f}, {po_hi[i]:.6f})   "
          f"({cp_lo[i]:.6f}, {cp_hi[i]:.6f})")

kk = np.arange(n + 1)
for name, lo, hi in [("포아송", po_lo, po_hi), ("CP", cp_lo, cp_hi)]:
    full_lo = np.concatenate([lo, np.full(n + 1 - len(lo), 1.0)])
    full_hi = np.concatenate([hi, np.full(n + 1 - len(hi), 1.0)])
    inside = (full_lo <= p_true) & (p_true <= full_hi)
    print(f"{name} 포함확률 {stats.binom.pmf(kk, n, p_true)[inside].sum():.4f}")
  k                   포아송 구간                  클로퍼-피어슨
  0  (0.000000, 0.003689)   (0.000000, 0.003682)
  1  (0.000025, 0.005572)   (0.000025, 0.005559)
  2  (0.000242, 0.007225)   (0.000242, 0.007206)
  5  (0.001623, 0.011668)   (0.001625, 0.011629)
포아송 포함확률 0.9835
CP 포함확률 0.9835
거의 같다. 소수 셋째 자리까지 일치한다. 포함확률도 동일하다.
왜 그런가. \(p=0.002\)에서 \(\binom nk p^k(1-p)^{n-k}\)와 \(e^{-\lambda}\lambda^k/k!\)의 총변동거리가 \(O(p)=0.002\)에 불과하다(르캄 부등식에 따르면 \(\le np^2=0.004\)).
포아송 구간이 유용한 상황.
- \(n\)을 모를 때. 발생건수만 알고 위험노출 인원이 불명확한 경우. 역학의 발생률, 보험의 사고건수.
- \(n\)이 매우 클 때. \(n=10^7\)이면 베타 분위수 계산이 무겁지만 카이제곱은 가볍다.
- 인시(person-time) 자료. "1000인년당 몇 건"처럼 분모가 시간인 경우 이항 자체가 부적절하고 포아송이 맞다.
주의. 두 구간 모두 0.984로 지나치게 보수적이다. 사건 수가 두 건 정도인 영역에서는 이산성 때문에 어쩔 수 없다. 덜 보수적인 것을 원하면 중간-\(p\) 방법이나 제프리스를 쓴다.
3의 법칙 확인. \(k=0\)일 때 상한이 \(3.689/1000=0.00369\)로, "\(3/n=0.003\)"이라는 어림이 양측 구간에는 조금 낮다. 3의 법칙은 단측 95% 상한에 대한 것이다(\(\chi^2_{2,0.95}/2=2.996\)).
연습문제 9. 이항비율에 부트스트랩 백분위 구간을 적용하면 어떤 일이 벌어지는지 여러 \(p\)에서 확인하고, 왜 그런지 설명하라.
풀이
문제의 핵심. 0/1 자료를 재표본하면 부트스트랩 분포가
로 \(\hat p\)를 참값으로 놓은 이항분포일 뿐이다. 새 정보가 없고, \(\hat p\)의 추정오차를 반영하지 못한다.
import numpy as np
from scipy import stats

rng = np.random.default_rng(77)
n, M, B = 30, 4_000, 999
z = stats.norm.ppf(0.975)

print(f"{'p':>5s} {'백분위':>8s} {'왈드':>8s} {'윌슨':>8s} {'퇴화':>7s}")
for p_true in [0.03, 0.05, 0.10, 0.20, 0.40]:
    hb = hw = hs = degenerate = 0
    for _ in range(M):
        k = rng.binomial(n, p_true)
        ph = k / n
        star = rng.binomial(n, ph, B) / n          # 비모수 부트스트랩과 동치
        lo, hi = np.percentile(star, [2.5, 97.5])
        hb += (lo <= p_true <= hi)
        degenerate += (hi - lo == 0)
        se = np.sqrt(ph * (1 - ph) / n)
        hw += (ph - z * se <= p_true <= ph + z * se)
        d = 1 + z**2 / n
        c = (ph + z**2 / (2 * n)) / d
        h = z / d * np.sqrt(ph * (1 - ph) / n + z**2 / (4 * n**2))
        hs += (c - h <= p_true <= c + h)
    print(f"{p_true:5.2f} {hb / M:8.4f} {hw / M:8.4f} "
          f"{hs / M:8.4f} {degenerate / M:7.4f}")
    p      백분위       왈드       윌슨      퇴화
 0.03   0.5965   0.6062   0.9345  0.3927
 0.05   0.7792   0.7823   0.9433  0.2152
 0.10   0.9555   0.8100   0.9742  0.0395
 0.20   0.9440   0.9440   0.9627  0.0013
 0.40   0.9547   0.9265   0.9560  0.0000
읽기.
-
\(p\)가 작으면 완전히 무너진다. \(p=0.03\)에서 포함확률 0.597이다. 왈드(0.606)와 거의 같다 — 부트스트랩이 왈드의 결함을 그대로 물려받았다.
-
구간이 한 점으로 퇴화한다. \(p=0.03\)에서 39%의 경우에 \(k=0\)이고, 그러면 모든 재표본이 0이라 구간이 \(\{0\}\)이다. \(P(K=0)=0.97^{30}=0.401\)과 잘 맞는다. 폭이 0인 "신뢰구간" 이 나오는 것이다.
-
\(p\)가 중간이면 쓸 만하다. \(p\ge0.10\)에서는 0.94~0.96으로 왈드보다 낫다. 재표본 분포의 비대칭을 어느 정도 반영하기 때문이다.
-
그래도 윌슨이 언제나 낫다. 모든 \(p\)에서 윌슨의 포함확률이 더 높고, 계산은 비교할 수 없이 가볍다.
이론적 진단. 부트스트랩은 경험분포가 참 분포를 잘 근사한다는 전제 위에 선다. 0/1 자료에서 경험분포는 \(\hat p\) 하나로 결정되므로, 부트스트랩이 하는 일은 \(\hat p\)를 참값으로 가정한 모수적 계산과 같다. \(\hat p=0\)이면 "참값이 0"이라고 단정하는 셈이고, 그래서 퇴화가 일어난다.
교훈. 부트스트랩이 만능이 아니다. 잘 작동하지 않는 대표적 상황이
- 이산자료의 모수가 경계 근처일 때,
- 극값 통계량(최댓값, 최솟값),
- 표본크기가 아주 작을 때,
- 모수가 모수공간의 경계에 있을 때
다. 비율에는 윌슨이나 제프리스처럼 문제에 맞춘 방법이 훨씬 낫다.
연습문제 10. 포함확률 모의실험을 설계할 때 정확한 계산이 가능한지 먼저 확인해야 하는 이유를 설명하고, 이 절의 모의실험을 정확 계산으로 바꿔라.
풀이
이항에서는 모의실험이 필요 없다. 표본공간이 \(\{0,1,\dots,n\}\)으로 유한하므로, 모든 결과에 대해 구간을 만들고 확률을 더하면 오차 없는 답이 나온다.
import numpy as np
from scipy import stats

def exact_coverage(n, p, alpha=0.05):
    z = stats.norm.ppf(1 - alpha / 2)
    k = np.arange(n + 1)
    ph = k / n
    se = np.sqrt(ph * (1 - ph) / n)
    inside = (ph - z * se <= p) & (p <= ph + z * se)
    return stats.binom.pmf(k, n, p)[inside].sum()

def mc_coverage(n, p, M, seed, alpha=0.05):
    rng = np.random.default_rng(seed)
    z = stats.norm.ppf(1 - alpha / 2)
    ph = rng.binomial(n, p, M) / n
    se = np.sqrt(ph * (1 - ph) / n)
    return np.mean((ph - z * se <= p) & (p <= ph + z * se))

n, p = 20, 0.05
exact = exact_coverage(n, p)
print(f"정확 계산      {exact:.6f}")
for M in [1_000, 10_000, 100_000]:
    est = mc_coverage(n, p, M, 1)
    print(f"모의실험 M={M:>7,d}  {est:.6f}   오차 {est - exact:+.6f}   "
          f"MCSE {np.sqrt(exact * (1 - exact) / M):.6f}")
정확 계산      0.638940
모의실험 M=  1,000  0.636000   오차 -0.002940   MCSE 0.015189
모의실험 M= 10,000  0.643000   오차 +0.004060   MCSE 0.004803
모의실험 M=100,000  0.637680   오차 -0.001260   MCSE 0.001519
정확 계산이 나은 이유.
- 오차가 0이다. 10만 번 돌려도 0.0013의 오차가 남는데, 정확 계산은 순간이다.
- 훨씬 빠르다. \(n+1\)개 항을 더하는 것이 10만 번 난수 생성보다 수천 배 빠르다.
- 재현성이 완벽하다. 씨앗이나 난수 생성기에 의존하지 않는다.
- 미세한 차이를 본다. 방법 간 0.001의 차이도 확실히 구별된다. 모의실험으로 하려면 \(M\approx10^6\)이 필요하다.
정확 계산이 가능한 조건.
| 상황 | 가능? |
|---|---|
| 이항, 포아송(절단), 초기하 | 가능(유한 또는 빠르게 수렴하는 합) |
| 정규 평균의 \(t\) 구간 | 가능(포함확률이 정확히 \(1-\alpha\)) |
| 정규가 아닌 모집단의 \(t\) 구간 | 불가(다중적분) |
| 부트스트랩 구간 | 불가(재표본 자체가 확률적) |
| 복잡한 모형의 우도비 구간 | 대개 불가 |
실무 지침.
- 먼저 정확 계산을 시도한다. 이산 표본공간이거나 추축량이 있으면 대개 가능하다.
- 반만이라도 정확히. 일부는 해석적으로, 일부는 수치적분으로 처리하면 모의실험 오차가 크게 준다(라오-블랙웰화).
- 모의실험이 불가피하면 \(M\)과 MCSE를 반드시 보고한다.
- 정확 계산으로 모의실험 코드를 검증한다. 정확한 답을 아는 경우에 코드를 돌려 보아 일치하면, 그 코드를 정확 계산이 불가능한 경우로 확장할 수 있다. 이것이 모의실험 코드의 단위검사다.
정리하며
비율 구간 네 가지를 포함확률로 견주었다.
| 방법 | 성격 | 평가 |
|---|---|---|
| 왈드 | 가장 단순 | 소표본·극단 \(p\) 에서 명목값 크게 미달 |
| 윌슨 점수 | \(p\) 기준으로 풀이 | 대체로 우수, 기본값으로 권장 |
| 아그레스티–쿨 | 성공·실패에 2 씩 더함 | 윌슨에 가깝고 계산이 쉬움 |
| 클로퍼–피어슨 | 이항분포로 정확 계산 | 보수적 — 포함확률이 명목값 이상 |
- 왈드의 실패가 이 절의 핵심이다. \(p\) 가 \(0\) 이나 \(1\) 에 가까우면 포함확률이 크게 떨어지고, \(\hat p=0\) 이면 구간이 한 점으로 붕괴한다.
- 포함확률이 \(n\) 에 따라 톱니처럼 오르내린다. 이항분포가 이산이라 \(n\) 을 하나 늘릴 때마다 달성 가능한 \(\hat p\) 값들이 바뀌기 때문이며, 매끄럽게 좋아지지 않는다.
- "정확"이 "최선"은 아니다. 클로퍼–피어슨은 포함확률이 명목값 아래로 내려가지 않음을 보장하지만, 그 대가로 구간이 필요 이상으로 넓다.
- 실무 권고는 윌슨이다. 계산이 조금 복잡할 뿐 경계에서도 합리적이고 평균 포함확률이 명목값에 가깝다.
다음 절 분산 신뢰구간의 포함확률 모의실험으로 넘어간다.