붓스트랩 신뢰구간 방법의 비교
동기
앞의 절들에서 백분위수, BCa, 붓스트랩-\(t\)의 세 가지 붓스트랩 신뢰구간 방법을 소개했다. 각각 이론적 성질, 계산 요구사항, 실무적 강점이 다르다. 그중에서 고르려면 이 맞교환을 이해해야 한다. 이 절은 실무자의 판단을 돕기 위한 체계적 비교를 제공한다.
요약표
| 성질 | 백분위수 | BCa | 붓스트랩-\(t\) |
|---|---|---|---|
| 포함확률 정확도 | 1차 \(O(n^{-1/2})\) | 2차 \(O(n^{-1})\) | 2차 \(O(n^{-1})\) |
| 편향보정 | 없음 | 있음 (\(\hat{z}_0\)) | 암묵적 (추축량을 통해) |
| 치우침 조정 | 없음 | 있음 (\(\hat{a}\)) | \(t^*\) 분포를 통해 |
| 변환 불변 | 예 | 예 (근사적) | 아니오 |
| 모수 경계 존중 | 예 | 예 | 보장 안 됨 |
| SE 공식 필요 | 아니오 | 아니오 | 예 (또는 중첩 붓스트랩) |
| 잭나이프 필요 | 아니오 | 예 (\(n\)번 계산) | 아니오 (SE 공식이 있으면) |
| 필요한 붓스트랩 복제 수 | \(B \ge 5{,}000\) | \(B \ge 5{,}000\) | \(B \ge 5{,}000\) |
| 계산비용 | 낮음 | 중간 | 낮음--높음 |
| 구현 난이도 | 매우 간단 | 중간 | 간단--복잡 |
포함확률 정확도
가장 중요한 구별은 정확도의 차수이다. 명목 \(100(1-\alpha)\%\) 구간의 실제 포함확률은 다음을 만족한다.
- 백분위수: \(P(\theta \in \text{CI}) = 1 - \alpha + O(n^{-1/2})\)
- BCa: \(P(\theta \in \text{CI}) = 1 - \alpha + O(n^{-1})\)
- 붓스트랩-\(t\): \(P(\theta \in \text{CI}) = 1 - \alpha + O(n^{-1})\)
\(n = 20\)인 95% 구간에서 1차 오차는 수 퍼센트포인트(실제 포함확률 90--93%)일 수 있는 반면, 2차 오차는 보통 1퍼센트포인트 미만(실제 94--96%)이다.
정확도 차수가 언제 중요한가
표본이 크면(\(n > 100\)) 세 방법이 대체로 비슷한 포함확률을 준다. 차이는 중간 정도의 표본크기(\(n = 15\)에서 \(50\))와 표본분포가 치우쳤거나 꼬리가 두꺼운 통계량에서 가장 두드러진다.
변환 불변성
백분위수 구간과 BCa 구간은 변환 불변이다. \([L, U]\)가 \(\theta\)의 구간이면 임의의 단조증가 \(m\)에 대해 \([m(L), m(U)]\)가 \(\phi = m(\theta)\)의 구간이다. 붓스트랩-\(t\) 구간은 이 성질을 갖지 않는다.
변환 불변성이 중요한 경우는 다음과 같다.
- 모수에 자연스러운 경계가 있을 때(예: \(\sigma^2 > 0\), \(0 < p < 1\))
- 추론에 "옳은" 척도가 무엇인지 분명하지 않을 때
- 분석자가 변환된 척도로 결과를 보고할 수 있을 때(예: 확률 대신 로그 오즈)
계산 요구사항
백분위수: \(\hat{\theta}\)의 붓스트랩 복제값 \(B\)개만 있으면 된다. 가장 싸다.
BCa: 붓스트랩 복제값 \(B\)개에 더해 가속 \(\hat{a}\)를 위한 \(n\)번의 잭나이프 계산이 필요하다. 총 \(B + n\)번.
붓스트랩-\(t\): 각 붓스트랩 표본마다 \(\hat{\theta}^{*(b)}\)와 \(\hat{\text{se}}^{*(b)}\)를 모두 계산해야 한다. \(\hat{\text{se}}\)의 닫힌 공식이 있으면 비용이 백분위수와 비슷하다. 각 복제마다 잭나이프나 중첩 붓스트랩으로 표준오차를 추정해야 하면 비용이 \(B \times n\)(잭나이프) 또는 \(B \times B_2\)(중첩 붓스트랩)이다.
비용 비교
표본평균에서는 \(\hat{\text{se}}^{*(b)} = s^{*(b)}/\sqrt{n}\)이라는 간단한 공식이 있으므로 붓스트랩-\(t\)가 거의 공짜이다. 중앙값이나 이분산 오차가 있는 회귀계수에서는 붓스트랩 안의 잭나이프 때문에 붓스트랩-\(t\)가 BCa보다 10--50배 비싸질 수 있다.
각 방법을 언제 쓰는가
백분위수법
- 빠르고 근사적인 구간으로 충분할 때
- 표본크기가 클 때(\(n > 100\))
- 통계량의 표본분포가 거의 대칭임이 알려져 있을 때
- 계산자원이나 구현 복잡도에 제약이 있을 때
BCa 방법
- 2차 정확도가 필요할 때(중간 \(n\), 치우친 통계량)
- 변환 불변성이 필요할 때
- 통계량에 간단한 표준오차 공식이 없을 때
- 잭나이프가 계산상 가능할 때(즉 \(n\)이 지나치게 크지 않을 때)
붓스트랩-t 방법
- 닫힌 형태의 표준오차 공식이 있을 때(예: 평균)
- 추축량 \((\hat{\theta} - \theta)/\hat{\text{se}}\)의 분포가 \(\theta\)에 거의 무관할 때
- 변환 불변성이 필요 없을 때
- \(\hat{\text{se}}^*\)의 분포가 안정적일 때(\(0\)에 가까운 값이 없을 때)
실무 권고
입문 통계학의 대부분 응용에서 다음 결정 규칙이 합리적이다.
- 기본 선택: BCa --- 2차 정확도, 변환 불변, 폭넓게 적용 가능
- BCa를 쓸 수 없을 때: 백분위수 --- 단순하고 로버스트하며 큰 \(n\)에 충분
- 표본평균의 경우: 붓스트랩-\(t\) --- 추가 비용이 거의 없이 2차 정확도
- 계산이 매우 비싼 통계량: 백분위수 --- BCa의 잭나이프 부담을 피한다
보편적으로 최선인 방법은 없다
모든 붓스트랩 신뢰구간은 매끄럽지 않은 통계량(예: 동점이 있는 중앙값), 극단 분위수, 매우 작은 표본크기에서 실패할 수 있다. 어떤 구간이든 믿기 전에 붓스트랩 분포를 눈으로 확인해야 한다. 대략 종 모양인가? 극단적인 이상치가 있는가?
모의실험 보기 1: 잘 작동하는 경우
\(\chi^2_3\) 분포(오른쪽으로 치우쳐 있고 참 평균이 \(3\))에서 \(n = 100\)인 표본의 평균을 추정한다. 2000회 반복, \(B = 2000\).
| 방법 | 포함확률 | 평균 폭 |
|---|---|---|
| 정규 | 0.940 | 0.9494 |
| 백분위수 | 0.942 | 0.9458 |
| 기본 (추축) | 0.934 | 0.9458 |
| BCa | 0.946 | 0.9573 |
| 붓스트랩-\(t\) | 0.947 | 0.9856 |
\(n = 100\)이고 통계량이 평균이므로 다섯 방법이 사실상 구별되지 않는다. 포함확률이 \(0.934\)--\(0.947\), 폭이 \(0.946\)--\(0.986\) 범위에 모여 있다.
이 상황에서는 가장 싸고 간단한 백분위수법을 쓰면 된다. BCa의 잭나이프 \(100\)번이나 붓스트랩-\(t\)의 추가 계산이 아무 이득도 주지 않는다.
모의실험 보기 2: 무너지는 경우
이제 어려운 문제로 바꾼다. \(\text{Exp}(1)\) 자료에서 \(n = 15\)로 모분산 \(\sigma^2 = 1\)을 추정한다. \(s^2\)의 표본분포는 오른쪽으로 심하게 치우쳐 있다.
3000회 반복, \(B = 1500\):
| 방법 | 포함확률 | 평균 폭 |
|---|---|---|
| 백분위수 | 0.677 | 1.59 |
| BCa | 0.736 | 1.88 |
| 붓스트랩-\(t\) | 0.878 | 14.15 |
세 방법 모두 명목 \(0.95\)에 크게 못 미친다. 어떤 붓스트랩 방법도 이 문제를 풀지 못한다.
붓스트랩-\(t\)의 폭 14.15를 어떻게 읽을 것인가
붓스트랩-\(t\)가 포함확률 \(0.878\)로 가장 높지만, 그 대가로 평균 구간 폭이 \(14.15\)이다. 참값이 \(1\)인데 구간의 폭이 \(14\)이면 사실상 아무것도 말해 주지 않는다.
원인은 붓스트랩-\(t\) 연습문제 2에서 본 꼬리 불안정성이다. \(n = 15\)에서 \(\hat{\text{se}}^{*}\)가 이따금 \(0\)에 가까워져 \(t^*\)의 극단 분위수가 폭발한다.
높은 포함확률이 좋은 구간을 뜻하지는 않는다. \((-\infty, \infty)\)는 포함확률 \(1\)이지만 쓸모가 없다. 포함확률과 폭을 반드시 함께 보아야 한다.
두 모의실험을 하나의 평면에 올려 놓으면 방법 선택이 언제 문제가 되는지가 한눈에 들어온다. 가로축에 평균 폭을, 세로축에 실제 포함확률을 두고 각 방법을 점 하나로 찍었다.
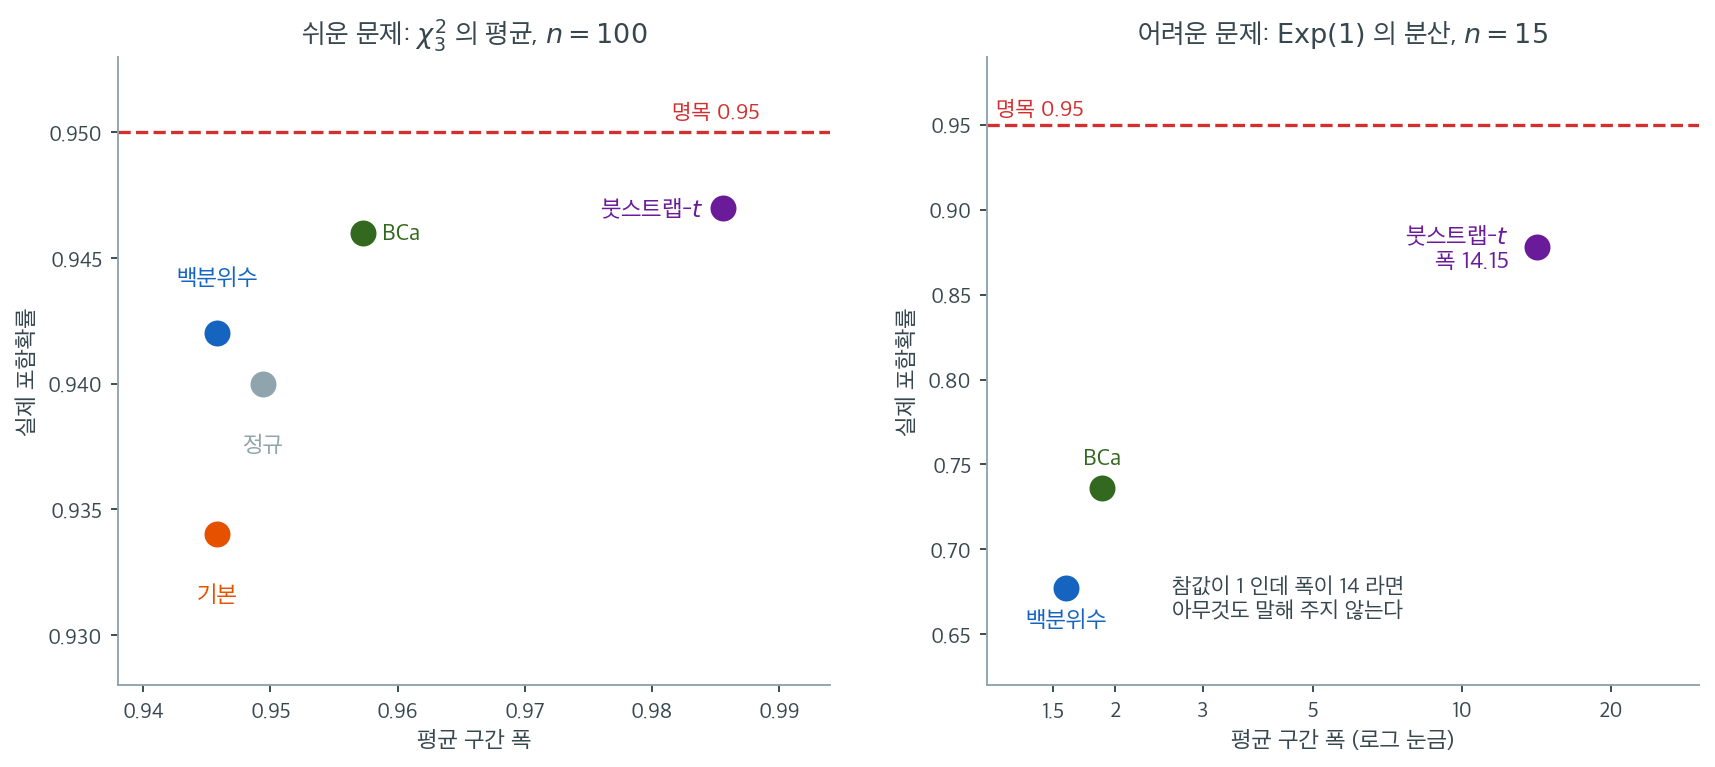
왼쪽이 쉬운 문제다. 다섯 점이 포함확률 \(0.934\)--\(0.947\), 폭 \(0.946\)--\(0.986\)의 좁은 구역에 모여 있다. 가로축의 눈금이 \(0.94\)에서 \(0.99\)까지라는 점에 주의하라. 점들이 흩어져 보이지만 실제 차이는 폭에서 \(4\%\), 포함확률에서 \(1.3\)%p에 지나지 않으며, 2000회 반복의 몬테카를로 표준오차 \(0.005\)의 두세 배 수준이다. 이 구역에서는 가장 싼 백분위수법을 쓰고 계산을 아끼는 것이 옳다.
오른쪽이 어려운 문제다. 가로축이 로그 눈금으로 바뀌었다는 사실 자체가 상황을 말해 준다. 백분위수 \((1.59,\ 0.677)\)에서 BCa \((1.88,\ 0.736)\)로 가는 이동은 폭을 \(18\%\) 늘려 포함확률을 \(6\)%p 사는 정직한 거래다. 그러나 붓스트랩-\(t\) \((14.15,\ 0.878)\)는 다르다. 포함확률이 가장 높지만 폭이 \(14\)이고, 참값이 \(1\)인 문제에서 폭 \(14\)짜리 구간은 아무것도 말해 주지 않는다. 세로축만 보면 승자이고, 두 축을 함께 보면 탈락이다.
그리고 오른쪽 그림에서 정작 눈에 띄는 것은 세 점이 모두 붉은 명목선 \(0.95\) 아래에 한참 떨어져 있다는 사실이다. 방법을 바꾸어 점을 옮기는 일은 이 그림 안에서의 이동일 뿐, 그림 전체를 위로 올리지는 못한다. 연습문제 2에서 확인하듯 통계량의 어려움이 표본크기보다 결정적이며, \(\text{Exp}(1)\)의 분산을 \(n = 15\)로 추정한다는 설정 자체가 명목수준을 포기하게 만든다.
이런 자료에서는 어떻게 해야 하는가.
- 변환한다. \(\log s^2\)의 척도에서 구간을 만들고 되돌리면 치우침이 크게 줄어든다.
- 모수적 방법을 쓴다. 지수분포임을 안다면 \(\sigma^2 = 1/\lambda^2\)의 정확 구간을 쓸 수 있다.
- 표본을 늘린다. \(n = 15\)로 4차 적률에 의존하는 양을 추정하는 것 자체가 무리이다.
그 밖의 방법
문헌에 등장하는 다른 두 방법이 있다.
정규구간 (\(\hat{\theta} \pm z_{\alpha/2} \cdot \widehat{\text{SE}}_{\text{boot}}\)): 1차 정확도이며 표본분포의 대칭성을 가정한다. 백분위수법보다 간단하지만 변환 불변이 아니고 모수 경계를 존중하지 않는다.
기본(추축) 구간 (\([2\hat{\theta} - \hat{\theta}^*_{(1-\alpha/2)}, \; 2\hat{\theta} - \hat{\theta}^*_{(\alpha/2)}]\)): 붓스트랩 분포의 위치 편향을 보정하지만 여전히 1차 정확도이다. 변환 불변이 아니다.
이들은 덜 권장되지만 특정 맥락에서 유용할 수 있다.
연습문제
연습문제 1. \(\chi^2_3\) 분포(오른쪽으로 치우쳐 있고 참 평균이 \(3\))에서 관측값 100개를 생성하라.
(a) \(B = 10{,}000\)으로 네 방법(정규, 백분위수, 기본, BCa)의 평균에 대한 95% 붓스트랩 신뢰구간을 계산하라.
(b) 표준 \(t\) 구간과 비교하라.
(c) 어느 구간이 \(\bar{X}\)를 중심으로 대칭인가? 어느 것이 아닌가?
(d) 2000회 반복하여 각 방법의 포함확률을 추정하라.
풀이
(a)--(c) 한 표본에 대한 결과이다.
import numpy as np
from scipy import stats
rng = np.random.default_rng(7)
n, B = 100, 10000
x = rng.chisquare(3, n)
th = x.mean(); se = x.std(ddof=1) / np.sqrt(n)

idx = rng.integers(0, n, (B, n)); xb = x[idx]
bs = xb.mean(axis=1)

lo_p, hi_p = np.percentile(bs, [2.5, 97.5])
ci = {
    "normal":  (th - 1.96*bs.std(ddof=1), th + 1.96*bs.std(ddof=1)),
    "pct":     (lo_p, hi_p),
    "basic":   (2*th - hi_p, 2*th - lo_p),
    "t-int":   (th - stats.t.ppf(0.975, n-1)*se, th + stats.t.ppf(0.975, n-1)*se),
}
for k, (lo, hi) in ci.items():
    print(f"{k:7s} [{lo:.4f}, {hi:.4f}]  중심에서 {th-lo:.4f} / {hi-th:.4f}")
출력:
normal  [2.1442, 2.9287]  중심에서 0.3923 / 0.3923
pct     [2.1522, 2.9388]  중심에서 0.3842 / 0.4023
basic   [2.1341, 2.9207]  중심에서 0.4023 / 0.3842
t-int   [2.1373, 2.9356]  중심에서 0.3991 / 0.3991
| 방법 | 하한까지 거리 | 상한까지 거리 | 대칭인가 |
|---|---|---|---|
| 정규 (붓스트랩 SE) | \(d\) | \(d\) | 대칭 |
| 표준 \(t\) 구간 | \(d'\) | \(d'\) | 대칭 |
| 백분위수 | \(d_1\) | \(d_2 > d_1\) | 비대칭 (오른쪽으로 김) |
| 기본 (추축) | \(d_2\) | \(d_1\) | 비대칭 (왼쪽으로 김) |
| BCa | --- | --- | 비대칭 |
구조를 보면 명확하다.
- 정규 구간과 \(t\) 구간은 \(\hat\theta \pm (\text{상수}) \times \text{SE}\) 꼴이므로 정의상 대칭이다.
- 백분위수 구간은 붓스트랩 분포의 치우침을 그대로 물려받는다. \(\chi^2_3\)이 오른쪽으로 치우쳤으므로 구간도 오른쪽으로 길다.
- 기본 구간은 그것을 반사하므로 정확히 거울상이다. 백분위수 구간의 두 거리 \((d_1, d_2)\)가 기본 구간에서 \((d_2, d_1)\)이 된다.
- BCa는 \(\hat z_0\)과 \(\hat a\)가 결정하는 방식으로 비대칭이다.
\(n = 100\)에서는 비대칭이 미미하다
\(\chi^2_3\)의 왜도가 \(\sqrt{8/3} = 1.63\)으로 상당히 크지만, \(\bar X\)의 왜도는 중심극한정리에 의해 \(1.63/\sqrt{100} = 0.163\)으로 줄어든다. 따라서 이 보기에서 네 구간의 실제 수치 차이는 소수점 셋째 자리 수준이다.
(d) 2000회 반복(\(B = 2000\))한 포함확률:
| 방법 | 포함확률 | 평균 폭 |
|---|---|---|
| 정규 | 0.940 | 0.9494 |
| 백분위수 | 0.942 | 0.9458 |
| 기본 (추축) | 0.934 | 0.9458 |
| BCa | 0.946 | 0.9573 |
| 붓스트랩-\(t\) | 0.947 | 0.9856 |
다섯 방법이 사실상 같다. 포함확률 차이가 \(0.013\)이고, 이는 2000회 반복의 몬테카를로 표준오차 \(\sqrt{0.95 \times 0.05/2000} = 0.0049\)의 2--3배 수준이다.
결론: \(n = 100\)이고 통계량이 평균이면 어떤 방법을 써도 무방하다. 이 문제에서 BCa나 붓스트랩-\(t\)를 쓰는 것은 계산을 낭비하는 것이다. 방법의 선택이 중요해지는 것은 \(n\)이 작거나 통계량이 어려울 때이다.
연습문제 2. 본문의 두 모의실험에서 방법 간 차이가 극적으로 달랐다. 어떤 요인이 그 차이를 만드는가? 표본크기와 통계량을 각각 바꾸어 확인하라.
풀이
두 요인을 분리해서 보자.
import numpy as np
from scipy import stats
rng = np.random.default_rng(21)

def coverage(gen, stat, target, n, M=800, B=600):
    cp = cb = 0
    for _ in range(M):
        x = gen(n); th = stat(x)
        idx = rng.integers(0, n, (B, n))
        bs = np.array([stat(x[i]) for i in idx])
        lo, hi = np.percentile(bs, [2.5, 97.5])
        cp += lo <= target <= hi
        z0 = stats.norm.ppf(np.clip((bs < th).mean(), 1e-6, 1-1e-6))
        jk = np.array([stat(np.delete(x, i)) for i in range(n)])
        d = jk.mean() - jk
        den = ((d**2).sum())**1.5
        a = (d**3).sum()/(6*den) if den > 0 else 0.0
        zl, zu = -1.959964, 1.959964
        a1 = stats.norm.cdf(z0 + (z0+zl)/(1 - a*(z0+zl)))
        a2 = stats.norm.cdf(z0 + (z0+zu)/(1 - a*(z0+zu)))
        lo, hi = np.percentile(bs, [100*a1, 100*a2])
        cb += lo <= target <= hi
    return cp/M, cb/M

ex = lambda n: rng.exponential(1, n)
for n in (15, 50, 200):
    print("mean", n, coverage(ex, np.mean, 1.0, n))
    print("var ", n, coverage(ex, lambda v: v.var(ddof=1), 1.0, n))
출력:
mean 15 (0.90375, 0.91125)
var  15 (0.6625, 0.7075)
mean 50 (0.93125, 0.9375)
var  50 (0.81, 0.85)
mean 200 (0.9475, 0.94625)
var  200 (0.87875, 0.9075)
| 통계량 | \(n\) | 백분위수 | BCa | BCa의 이득 |
|---|---|---|---|---|
| 평균 | 15 | 0.904 | 0.911 | \(+0.007\) |
| 평균 | 50 | 0.931 | 0.938 | \(+0.007\) |
| 평균 | 200 | 0.948 | 0.946 | \(-0.002\) |
| 분산 | 15 | 0.662 | 0.708 | \(+0.046\) |
| 분산 | 50 | 0.810 | 0.850 | \(+0.040\) |
| 분산 | 200 | 0.879 | 0.908 | \(+0.029\) |
두 요인이 각각 작용하지만 통계량의 어려움이 압도적으로 중요하다.
-
통계량의 어려움. 같은 \(n\)에서 분산이 평균보다 훨씬 나쁘다. \(n = 200\)의 분산(\(0.879\))이 \(n = 15\)의 평균(\(0.904\))보다도 낮다. 즉 분산을 추정하는 것은 평균을 추정하는 것보다 \(13\)배 넘게 큰 표본을 요구한다. 그리고 BCa의 이득도 분산에서만 뚜렷하다(\(+0.03\)--\(+0.05\) 대 \(+0.007\)).
-
표본크기. 평균에서는 \(n = 200\)에서 두 방법이 사실상 같아진다(\(-0.002\), 몬테카를로 오차 범위). 분산에서는 \(n = 200\)에서도 \(+0.029\)가 남는데, 두 방법 모두 아직 명목수준에서 멀기 때문이다.
(각 칸은 800회 반복이므로 몬테카를로 표준오차가 약 \(0.01\)이다. \(\pm 0.02\) 이내의 차이는 잡음으로 보아야 한다.)
왜 분산이 어려운가. \(s^2\)의 표본분포는 모집단의 4차 적률에 의존하는데, 4차 적률은 2차 적률보다 훨씬 추정하기 어렵다. 지수분포의 초과첨도가 \(6\)이므로 이 문제가 증폭된다.
실무 지침: "언제 BCa가 필요한가"를 묻기 전에 "이 통계량이 이 표본크기에서 애초에 추정 가능한가"를 물어야 한다. 포함확률이 \(0.68\)인 상황에서 \(0.73\)으로 올리는 것은 근본적 해결이 아니다.
연습문제 3. 붓스트랩-\(t\)가 본문 보기 2에서 폭 \(14.15\)를 낸 이유를 진단하라. 극단적인 \(t^*\)를 절사하면 문제가 해결되는가?
풀이
먼저 평균 폭과 중앙값 폭을 나누어 보자.
import numpy as np
rng = np.random.default_rng(31)

def run(n, M=1200, B=1200, trim=None):
    c, w = 0, []
    for _ in range(M):
        x = rng.exponential(1, n)
        xb = x[rng.integers(0, n, (B, n))]
        cc = xb - xb.mean(axis=1, keepdims=True)
        m2 = (cc**2).mean(axis=1); m4 = (cc**4).mean(axis=1)
        bs = xb.var(axis=1, ddof=1)
        seb = np.sqrt(np.maximum((m4 - m2**2)/n, 1e-12))
        co = x - x.mean(); th = x.var(ddof=1)
        se = np.sqrt(max(((co**4).mean() - ((co**2).mean())**2)/n, 1e-12))
        t = (bs - th) / seb
        if trim is not None:
            t = t[np.abs(t) < np.percentile(np.abs(t), 100 - trim)]
        tl, tu = np.percentile(t, [2.5, 97.5])
        lo, hi = th - tu*se, th - tl*se
        c += lo <= 1 <= hi; w.append(hi - lo)
    return round(c/M, 3), round(np.mean(w), 2), round(np.median(w), 2)

for n in (15, 50, 200):
    print(n, run(n))
print("trim 1%", run(15, trim=1))
print("trim 5%", run(15, trim=5))
출력:
15 (0.895, 14.83, 4.14)
50 (0.911, 2.74, 1.67)
200 (0.933, 0.96, 0.83)
trim 1% (0.84, 9.34, 2.93)
trim 5% (0.798, 8.25, 2.11)
| 설정 | 포함확률 | 평균 폭 | 중앙값 폭 |
|---|---|---|---|
| \(n = 15\) | 0.895 | 14.83 | 4.14 |
| \(n = 50\) | 0.911 | 2.74 | 1.67 |
| \(n = 200\) | 0.933 | 0.96 | 0.83 |
| \(n = 15\), 상위 1% 절사 | 0.840 | 9.34 | 2.93 |
| \(n = 15\), 상위 5% 절사 | 0.798 | 8.25 | 2.11 |
진단 1: 평균 폭이 중앙값 폭의 3.6배이다. \(14.83\)과 \(4.14\)의 차이가 문제의 성격을 말해 준다. 대부분의 표본에서는 구간이 \(4\) 정도로 (여전히 넓지만) 쓸 만하고, 소수의 표본에서 폭이 수백까지 폭발하여 평균을 끌어올린다. \(14.83\)이라는 값은 "전형적인 구간"이 아니라 소수의 재앙적 사례가 만든 것이다.
진단 2: 절사는 해결책이 아니다. 상위 1%를 절사하면 폭이 \(14.83 \to 9.34\)로 줄지만 포함확률이 \(0.895 \to 0.840\)으로 떨어진다. 5%를 절사하면 \(0.798\)까지 내려간다.
이는 당연한 결과이다. \(t^*\)의 극단 꼬리가 잡음이자 동시에 신호이기 때문이다. 절사하면 잡음과 함께 참 꼬리 정보도 잘려 나가 구간이 지나치게 좁아진다.
진단 3: 유일한 근본적 해결책은 \(n\)을 키우는 것이다. \(n = 200\)에서 평균 폭이 \(0.96\), 중앙값 폭이 \(0.83\)으로 둘의 차이가 사라진다. 폭발 사례가 없어졌다는 뜻이다.
왜 폭발하는가. \(s^2\)의 표준오차 추정에 4차 적률이 들어간다.
\(n = 15\)인 붓스트랩 표본이 우연히 큰 값을 하나도 뽑지 못하면 \(\hat\mu_4\)가 매우 작아지고 \(\widehat{\text{se}}^*\)가 \(0\)에 가까워진다. 그러면 \(t^*\)가 폭발한다. 지수분포처럼 꼬리가 있는 분포에서 \(n = 15\)면 이런 일이 드물지 않다.
실무 결론: 붓스트랩-\(t\)의 결과를 보고할 때는 평균 폭이 아니라 중앙값 폭과 폭의 분위수를 함께 확인하라. 평균 폭만 보면 방법이 완전히 쓸모없어 보이지만, 실제로는 소수 사례의 문제일 수 있다. 반대로 중앙값 폭만 보면 재앙적 사례를 놓친다.
연습문제 4. 본문의 요약표는 BCa를 "기본 선택"으로 권한다. 이 권고가 항상 옳은가? BCa를 쓰지 말아야 할 상황을 세 가지 들어라.
풀이
1. 통계량이 매끄럽지 않을 때.
BCa 연습문제 3에서 보았듯, 중앙값의 잭나이프 가속은 참값과 무관하게 언제나 \(\hat a \approx 0\)이 된다. 잭나이프를 \(n\)번 계산하는 비용을 치르고도 아무 조정을 얻지 못한다. 분위수, 최댓값, 절사평균의 절사 경계 근처 값들도 마찬가지이다.
→ 백분위수 구간을 쓴다.
2. \(n\)이 매우 클 때.
BCa는 \(n\)번의 잭나이프 계산을 요구한다. \(n = 10^6\)이고 통계량이 회귀계수라면 잭나이프만으로 백만 번의 회귀 적합이 필요하다.
동시에 \(n\)이 크면 BCa의 이득이 사라진다. 연습문제 2에서 \(n = 200\)일 때 이득이 \(+0.005\)--\(+0.014\)였다.
→ 백분위수 구간을 쓴다. 또는 잭나이프 대신 영향함수로 \(\hat a\)를 근사하는 방법도 있다.
3. 붓스트랩 자체가 실패하는 상황.
BCa는 붓스트랩 복제값에서 분위수를 읽는 방법이므로, 붓스트랩 분포 자체가 참 표본분포를 흉내 내지 못하면 조정을 아무리 정교하게 해도 소용이 없다.
→ 붓스트랩이 아니라 다른 접근(모수적 방법, \(m\)-out-of-\(n\) 붓스트랩, subsampling)을 쓴다.
권고를 다시 쓰면
"BCa를 기본으로 쓰라"보다 정확한 지침은 이렇다.
- 먼저 붓스트랩 분포를 그려 본다. 종 모양이 아니거나 이산적이면 방법 선택 이전에 문제가 있다.
- \(\hat z_0\)과 \(\hat a\)를 계산한다. 둘 다 \(0.05\) 아래면 백분위수로 충분하다.
- 둘 중 하나라도 크면 BCa를 쓴다.
- 표준오차 공식이 있고 분산안정화 변환도 알면 그 척도에서 붓스트랩-\(t\)가 최선이다.
정리하며
백분위수, BCa, 붓스트랩-\(t\) 방법은 정교함이 커지는 위계를 이룬다. 백분위수법은 가장 단순하지만 1차 정확도에 그친다. BCa와 붓스트랩-\(t\)는 서로 다른 방식으로 2차 정확도를 달성한다. BCa는 편향과 가속 보정으로 분위수 수준을 조정하고, 붓스트랩-\(t\)는 통계량을 스튜던트화하여 근사 추축량을 만든다. 일반적인 용도로는 BCa가 권장 기본값이고, 표준오차 공식을 바로 쓸 수 있으면 붓스트랩-\(t\)가 낫다.