로지스틱 회귀의 가능도
모형이 「확률 \(0.20\)」이라고 말했는데 정답이 \(1\) 이면 제곱오차는 \(0.640\), 로그손실은 \(1.609\) 다. 여기까지는 크기의 차원이 다르지 않다. 그런데 모형이 더 확신에 차서 「확률 \(0.01\)」을 내놓으면 제곱오차는 \(0.980\) 에서 멈추는 반면 로그손실은 \(4.605\) 로 치솟는다. 제곱오차에는 아무리 틀려도 넘지 못하는 상한이 있고 로그손실에는 없다. 그 차이가 어디서 오는지는 손실함수를 베르누이 가능도에서 유도해 보면 드러난다.
1. 기호를 먼저 묶어 둔다
\(y^{(i)}\in\{0,1\}\)이고 \(A\)가 \(n\times(p+1)\) 설계행렬(절편(intercept)을 위한 1의 열을 포함)일 때, 관측치 \((A[i,:],\; y^{(i)})\) \(n\)개가 주어졌다고 하자. 관측치 \(i\)의 예측확률은
이다.
2. 베르누이 가능도
각 이름표 \(y^{(i)}\)는 성공확률이 \(\sigma^{(i)}\)인 베르누이 확률변수로 모형화된다. 전체 자료의 가능도는
이다.
3. 교차엔트로피 손실(음의 로그가능도)
음의 로그를 취하면 교차엔트로피 손실(로그손실이라고도 한다)을 얻는다.
\(\boldsymbol{\theta}\)에 대해 \(\ell\)을 최소화하는 것은 \(\mathcal{L}\)을 최대화하는 것과 같다.
왜 교차엔트로피인가
교차엔트로피 손실은 분류에서 제곱오차 같은 대안보다 선호되는 두 가지 중요한 성질을 갖는다.
- 볼록성. \(\ell\)은 \(\boldsymbol{\theta}\)에 대해 볼록이므로 모든 국소최솟값이 전역최솟값이다.
- 정보이론적 동기. 참 분포 \(y\)와 모형 분포 \(\hat{y}=\sigma\) 사이의 교차엔트로피는, 참 분포 대신 모형 분포로 이름표를 부호화할 때 추가로 필요한 비트 수를 잰다.
극단에서의 행동
\(y^{(i)}=1\)인데 \(\sigma^{(i)}\to 0\)이면 항 \(-\log\sigma^{(i)}\to+\infty\)가 되어, 확신에 찬 오답에 큰 벌칙을 준다. \(y^{(i)}=0\)이고 \(\sigma^{(i)}\to 1\)인 경우도 대칭적으로 마찬가지다. 바로 이 비대칭적 벌칙이 모형을 잘 보정된 확률로 이끈다.
손실함수의 모양
앞의 두 성질 — 무한히 커지는 벌칙과 볼록성 — 은 식만 보아서는 실감이 잘 나지 않는다. 그림으로 보면 한눈에 들어온다. 왼쪽은 참값이 \(y=1\)인 관측치 하나의 손실을 예측확률 \(\sigma\)의 함수로 그린 것이고, 오른쪽은 절편만 있는 모형(\(n=10\), 그중 성공 3개)의 전체 손실을 \(\theta_0\)의 함수로 그린 것이다.
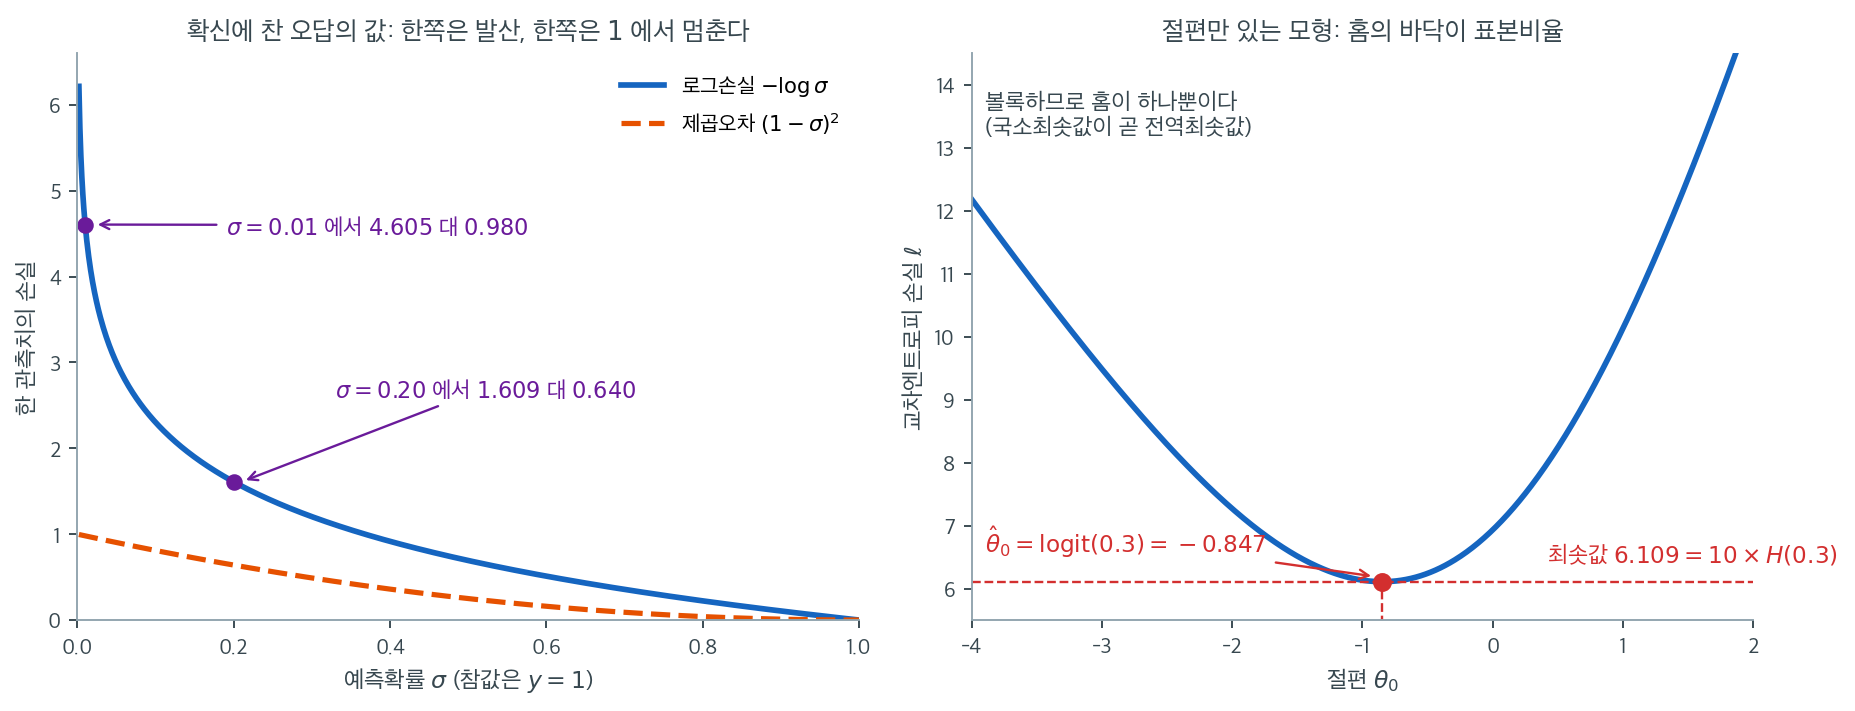
왼쪽에서 모형이 \(\sigma = 0.20\)이라고 말했는데 정답이 1이면 로그손실은 \(1.609\)다. 여기까지는 제곱오차 \(0.640\)과 크기의 차원이 다르지 않다. 그런데 모형이 더 확신에 차서 \(\sigma = 0.01\)을 내놓으면 로그손실은 \(4.605\)로 치솟는 반면 제곱오차는 \(0.980\)에서 멈춘다. 제곱오차는 아무리 틀려도 1을 넘지 못한다. 확신에 찬 오답에 줄 수 있는 벌칙의 상한이 \(1\)인 것이다. 로그손실에는 그런 상한이 없고, \(\sigma \to 0\)이면 손실이 발산한다. 모형이 "확률 0.01"이라고 말할 때 그 말에 정말 책임을 지우는 것은 왼쪽의 파란 곡선뿐이다.
오른쪽은 볼록성이 무엇을 뜻하는지 보여준다. 홈이 하나뿐이므로 어느 방향에서 내려가든 같은 바닥에 도착한다. 경사하강법이든 뉴턴법이든 시작점을 걱정할 필요가 없는 이유다. 바닥의 위치는 \(\hat\theta_0 = \operatorname{logit}(0.3) = -0.847\)이고 그때의 손실은 \(6.109\)인데, 이 값은 \(10 \times H(0.3)\), 즉 표본크기 곱하기 베르누이(0.3)의 엔트로피와 정확히 같다(연습문제 3).
이 두 그림을 겹쳐 읽으면 교차엔트로피를 쓰는 이유가 분명해진다. 제곱오차는 벌칙이 유계(bounded)라 확신에 찬 오답을 방치하고, \(\sigma\)를 거치면서 로지스틱 회귀에서는 볼록성마저 잃는다. 로그손실은 벌칙이 무계(unbounded, 상한이 없음)라 모형을 정직한 확률 쪽으로 밀고, 동시에 볼록이라 그 최적점을 실제로 찾을 수 있게 해 준다. 두 성질이 함께 붙어 있다는 것이 이 손실함수의 진짜 미덕이다.
AI로 보는 통계학 1. 무한한 벌칙을 일부러 무디게 만드는 쪽
바로 위에서 「벌칙이 무계라 모형을 정직한 확률 쪽으로 민다」고 적었다. 이 절의 손실은 오늘 학습되는 거의 모든 분류기가 쓰는 바로 그 식이다 — 사진에 이름표를 붙이는 그물도, 다음 낱말을 고르는 그물도, 마지막 층에서 이 식을 최소화한다. 그런데 실제로 학습할 때는 목표를 \(1\) 과 \(0\) 그대로 두지 않는 일이 흔하다. 위의 「무계」가 그 까닭이다.
목표가 \(1\) 인 항의 손실은 \(-\log\sigma\) 다. 이것은 \(\sigma<1\) 인 한 절대로 \(0\) 이 되지 않으므로, 줄일 길이 남아 있는 동안 기울기는 계속 같은 방향을 가리킨다. 자료가 분리되어 있으면 그 방향에 끝이 없다. 로짓을 키우는 만큼 손실이 줄어드니 최적점이 없고 가중치가 발산한다. 19.2절 최대가능도 추정 보기 1이 「이 자료는 분리되기 직전이다」라고 말하는 그 자리다.
그래서 쓰는 손질이 목표를 \(1\) 대신 \(1-\varepsilon\) 로, \(0\) 대신 \(\varepsilon\) 로 두는 것이다. 그러면 최소점이 \(\sigma = 1-\varepsilon\) 로 유한한 자리에 생긴다.
import numpy as np

def smoothed(eps):
    """목표를 1 대신 1-eps 로 두었을 때의 최적 로짓과 손실의 바닥."""
    q = 1 - eps
    logit = np.log(q / (1 - q))                          # 최적은 확률이 q 가 되는 자리
    floor = -(q * np.log(q) + (1 - q) * np.log(1 - q))   # 거기서의 교차엔트로피
    return logit, floor

print("  목표     최적 로짓   최적 확률   손실의 바닥")
for eps in (0.20, 0.10, 0.05, 0.01):
    lg, fl = smoothed(eps)
    print(f"  {1-eps:.2f}   {lg:8.4f}    {1/(1+np.exp(-lg)):.4f}      {fl:.4f}")

print("\n  목표를 1 그대로 두면 (분리된 자료)")
for t in (2, 5, 10, 20, 40):
    print(f"    로짓 {t:2d} → 확률 {1/(1+np.exp(-t)):.10f},  손실 {np.log1p(np.exp(-t)):.3e}")
출력:
  목표     최적 로짓   최적 확률   손실의 바닥
  0.80     1.3863    0.8000      0.5004
  0.90     2.1972    0.9000      0.3251
  0.95     2.9444    0.9500      0.1985
  0.99     4.5951    0.9900      0.0560

  목표를 1 그대로 두면 (분리된 자료)
    로짓  2 → 확률 0.8807970780,  손실 1.269e-01
    로짓  5 → 확률 0.9933071491,  손실 6.715e-03
    로짓 10 → 확률 0.9999546021,  손실 4.540e-05
    로짓 20 → 확률 0.9999999979,  손실 2.061e-09
    로짓 40 → 확률 1.0000000000,  손실 4.248e-18
아래쪽이 발산의 모습이다. 로짓을 \(40\) 까지 밀어도 손실이 \(0\) 이 아니라 \(4\times10^{-18}\) 이므로 아직 줄일 것이 남아 있고, 기울기는 계속 같은 쪽을 가리킨다. 확률은 이미 \(1\) 과 구별되지 않는데도 그렇다. 위쪽은 목표를 \(0.1\) 만큼 무디게 했을 때인데, 최적 로짓이 \(2.1972\) 에 멈춘다. 대신 손실이 \(0\) 으로 내려가지 않고 \(0.3251\) 에서 바닥을 친다. 그 바닥은 목표 분포 자신의 엔트로피이고, 무디게 만든 값을 치른 삯이다.
여기서 읽을 것은 둘이다. 하나, 학습 곡선이 \(0\) 으로 가지 않는 것이 반드시 덜 배운 탓은 아니다 — 목표를 무디게 두었으면 바닥이 원래 \(0\) 이 아니다. 둘, 이 손질은 확률을 일부러 틀리게 만든다. 참으로 \(1\) 인 것을 \(0.9\) 라고 말하게 하는 것이므로, 모형이 내놓는 수를 확률로 읽을 생각이라면 그만큼을 되돌려 놓아야 한다. \(19.3\)절 보정과 브라이어 점수가 그 되돌리는 일을 다룬다.
4. 정보이론과의 관계
\(q\)를 모형 분포, \(p\)를 경험(참) 분포라 하면 교차엔트로피는
이다. 교차엔트로피는 \(H(p,q) = H(p) + D_{\mathrm{KL}}(p\|q)\)로 분해되며, 여기서 \(H(p)\)는 참 분포의 엔트로피이고 \(D_{\mathrm{KL}}\)은 쿨백–라이블러 발산이다. \(H(p)\)는 \(\boldsymbol{\theta}\)와 무관한 상수이므로, 교차엔트로피를 최소화하는 것은 KL 발산을 최소화하는 것과 같다.
5. 수치적 안정성
실무에서는 \(\log 0\)을 피하기 위해 로그 안에 작은 상수 \(\varepsilon\)(예: \(10^{-6}\))을 더한다.
또는 많은 프레임워크는 수치적으로 안정한 항등식
를 이용해 로짓 \(z^{(i)}\)에서 곧바로 손실을 계산한다.
연습문제
연습문제 1. 교차엔트로피 손실의 기울기가 \(\nabla_{\boldsymbol{\theta}}\,\ell = A^\top(\boldsymbol{\sigma} - \mathbf{y})\) 임을 유도하라. 여기서 \(\boldsymbol{\sigma} = (\sigma^{(1)}, \dots, \sigma^{(n)})^\top\)이다.
풀이
한 관측치의 기여를 \(\ell_i = -[y^{(i)}\log\sigma^{(i)} + (1-y^{(i)})\log(1-\sigma^{(i)})]\) 라 하고 \(z^{(i)}\)로 미분한다. 연쇄법칙과 \(\dfrac{d\sigma}{dz} = \sigma(1-\sigma)\)를 쓰면
이고, 괄호를 정리하면
이다. \(z^{(i)} = A[i,:]\boldsymbol{\theta}\)이므로 \(\partial z^{(i)}/\partial \boldsymbol{\theta} = A[i,:]^\top\)이고, 모든 \(i\)에 대해 더하면
를 얻는다. 최소제곱의 정규방정식(normal equations) \(A^\top(A\hat\beta - y) = 0\)과 형태가 같다는 점이 인상적이다. 차이는 \(\boldsymbol{\sigma}\)가 \(\boldsymbol{\theta}\)의 비선형함수라는 것이며, 바로 그 때문에 닫힌 형태의 해가 없다. \(\square\)
연습문제 2. \(\ell\)의 헤세행렬이 \(H = A^\top W A\)(\(W = \operatorname{diag}(\sigma^{(i)}(1-\sigma^{(i)}))\)) 임을 보이고, 이로부터 \(\ell\)이 볼록임을 결론지어라. 언제 강볼록이 되는가?
풀이
연습문제 1에서 \(\partial \ell/\partial z^{(i)} = \sigma^{(i)} - y^{(i)}\)이므로 한 번 더 미분하면 \(\partial^2 \ell/\partial (z^{(i)})^2 = \sigma^{(i)}(1-\sigma^{(i)})\)이다. 서로 다른 관측치는 교차항을 만들지 않으므로
이다. 임의의 \(v\)에 대해 \(v^\top H v = \sum_i w_i (A[i,:]v)^2 \ge 0\)이고 \(w_i = \sigma^{(i)}(1-\sigma^{(i)}) > 0\)이므로 \(H\)는 양반정치이고 \(\ell\)은 볼록이다.
\(A\)가 완전 열계수(full column rank)이면 \(Av = 0 \Rightarrow v = 0\)이므로 \(v^\top H v > 0\)이 되어 \(H\)가 양정치, 즉 \(\ell\)이 강볼록이 된다. 그러나 이는 주어진 \(\boldsymbol{\theta}\)에서의 이야기다. 자료가 완전히 분리 가능하면 \(\|\boldsymbol{\theta}\|\to\infty\)에 따라 \(w_i \to 0\)이 되어 \(H \to 0\)이고, 하한은 도달되지 않는다(연습문제 5). \(\square\)
연습문제 3. 절편만 있는 모형(\(z^{(i)} = \theta_0\))을 생각하자. MLE가 \(\hat\sigma = \bar{y}\)임을 보여라. \(n = 10\)이고 그중 3개가 1일 때 \(\hat\theta_0\)과 최소 교차엔트로피 손실을 계산하라.
풀이
\(z^{(i)} = \theta_0\)이면 모든 \(\sigma^{(i)}\)가 같은 값 \(\sigma\)이다. 연습문제 1의 결과에서 \(A\)가 1의 열 하나뿐이므로 기울기는
이고, 0으로 놓으면 \(\hat\sigma = \frac{1}{n}\sum_i y^{(i)} = \bar{y}\)이다. 즉 절편만 있는 로지스틱 회귀(logistic regression)는 표본비율을 되돌려 준다.
\(n = 10\), \(\sum y^{(i)} = 3\)이면 \(\hat\sigma = 0.3\)이고
이다. 최소 손실은
이다. 대괄호 안의 값 \(0.61086\)이 바로 베르누이(0.3)의 엔트로피(내트 단위)이므로, \(\ell_{\min} = n\,H(\bar{y})\)이다. 즉 설명변수(explanatory variable)가 없는 모형의 손실은 결과 자체의 엔트로피이며, 이것이 모든 로지스틱 모형이 넘어서야 할 기준선(영이탈도)이다. \(\square\)
연습문제 4. 위의 \(\varepsilon\) 보정이 왜 편향을 만드는지 수치로 보이고, softplus 방식이 왜 더 나은지 설명하라.
풀이
\(\varepsilon = 10^{-6}\)일 때 항 \(-\log(\sigma + \varepsilon)\)을 보자.
| \(\sigma\) | \(-\log\sigma\) | \(-\log(\sigma+10^{-6})\) | 차이 |
|---|---|---|---|
| \(10^{-3}\) | \(6.9078\) | \(6.9068\) | \(0.0010\) |
| \(10^{-6}\) | \(13.8155\) | \(13.1224\) | \(0.6931\) |
\(\sigma\)가 \(\varepsilon\) 수준으로 작아지면 보정이 손실을 \(\log 2 = 0.6931\)만큼 깎아낸다. 즉 확신에 찬 오답에 대한 벌칙이 인위적으로 \(-\log\varepsilon\) 근처에서 잘린다. 이는 수치적 무한대는 막아 주지만 목적함수 자체를 바꾸는 것이며, 특히 극단적으로 잘못된 예측이 있을 때 최적해를 이동시킨다.
softplus 방식은 \(\sigma\)를 거치지 않고 로짓에서 직접 계산한다.
예를 들어 \(z = -800\)이면 \(\sigma(z)\)는 배정도 부동소수점에서 0으로 반올림되어
\(-\log\sigma\)가 inf가 되지만, \(\operatorname{softplus}(800) = 800.0\)은 정확히 계산된다
(np.logaddexp(0, 800)). 근사가 전혀 개입하지 않으므로 목적함수가 왜곡되지 않는다.
\(\square\)
연습문제 5. 자료가 완전히 분리 가능하다고 하자. 즉 모든 \(i\)에 대해 \((2y^{(i)} - 1)\,A[i,:]\boldsymbol{\theta}^* > 0\) 이 되는 \(\boldsymbol{\theta}^*\) 가 존재한다고 하자 (양성과 음성을 오차 없이 가르는 초평면이 있다는 뜻이다). 이때 MLE가 존재하지 않음을 보여라.
풀이
분리 초평면을 주는 \(\boldsymbol{\theta}^*\)를 잡고 \(c > 0\)에 대해 \(\boldsymbol{\theta} = c\,\boldsymbol{\theta}^*\)를 생각하자. 분리 가능성에 의해 \(y^{(i)} = 1\)인 모든 \(i\)에서 \(z^{(i)} = c\,A[i,:]\boldsymbol{\theta}^* > 0\)이고, \(y^{(i)} = 0\)인 모든 \(i\)에서 \(z^{(i)} < 0\)이다.
\(c \to \infty\)이면 \(y^{(i)}=1\)인 관측치에서 \(\sigma^{(i)} \to 1\), \(y^{(i)}=0\)인 관측치에서 \(\sigma^{(i)} \to 0\)이므로 모든 항이 0으로 가고 \(\ell(c\,\boldsymbol{\theta}^*) \to 0\)이다. 그런데 \(\ell > 0\)은 항상 성립하므로 하한 0은 어떤 유한한 \(\boldsymbol{\theta}\)에서도 도달되지 않는다. 따라서 최소점이 존재하지 않고, MLE는 정의되지 않는다.
실무에서 나타나는 증상: 계수와 그 표준오차가 반복이 진행될수록 함께 발산한다.
statsmodels는 "Perfect separation detected" 경고를 내고, sklearn은 기본으로 벌점을 주기
때문에(기본 C=1.0) 유한한 답을 돌려주지만 그 답은 MLE가 아니다. 해결책은 벌점을 명시적으로
넣거나(L2 정칙화, 19.4절 로지스틱 회귀의 L1·L2 정칙화 참조) 파스 보정(Firth's correction)을 쓰거나, 결과를 완벽히
예측하는 변수를 모형에서 빼는 것이다. \(\square\)
정리하며
로지스틱 회귀의 가능도는 베르누이 곱이다.
여기서 \(p_i=\sigma^{(i)}\) 이고, 이 \(\ell(\boldsymbol\theta)\) 는 베르누이 곱에 로그를 취한 로그가능도다. 본문에서 \(\ell\) 로 적은 손실과는 부호가 반대다.
- 교차엔트로피 손실의 음수와 같다. 통계학의 로그가능도 최대화와 기계학습의 손실 최소화가 같은 계산이며, 이름만 다르다.
- 닫힌 형태 해가 없다. 지수함수 때문에 점수방정식이 비선형이라 수치 최적화가 필요하다.
- 로그가능도가 오목하다. 그래서 국소 최적이 곧 전역 최적이며, 최적화가 안정적이다. 이것이 로지스틱 회귀의 큰 장점이다.
- 완전분리가 있으면 최대가 존재하지 않는다. 어떤 선형결합이 두 부류를 완벽히 가르면 계수가 무한대로 발산하며, 정칙화가 그 처방이다.
- 6장의 최대가능도와 7장의 점근 이론이 그대로 적용된다. 일치성·점근정규성·피셔 정보량 모두 여기서 쓰인다.
다음 절 로지스틱 회귀 실습으로 넘어간다.