교란변수
교란변수는 노출(또는 설명변수)과 결과 모두에 영향을 주어 둘 사이에 허위 연관을 만드는 변수이다. 인과가 아닌 관계를 인과처럼 보이게 하거나 진짜 인과효과를 가릴 수 있으므로, 교란은 통계학과 역학에서 가장 중요한 개념 중 하나이다. 교란요인을 올바르게 식별하고 통제하는 일은 관찰자료에서 타당한 결론을 이끌어내는 데 필수적이다.
정의 1. 교란요인
변수 \(Z\)가 \(X\)(노출)와 \(Y\)(결과) 사이 관계의 교란요인이 되려면 다음 세 조건이 모두 성립해야 한다:
- \(Z\)가 \(X\)(노출)와 연관되어 있다.
- \(X\)를 조건으로 했을 때 \(Z\)가 \(Y\)(결과)와 연관되어 있다.
- \(Z\)가 \(X\)에서 \(Y\)로 가는 인과 경로 위에 있지 않다(즉 \(Z\)가 매개자가 아니다).
교란요인이 있으면 관측된 \(X\)–\(Y\) 연관은 (있다면) 직접적인 관계와 \(Z\)를 통한 간접 경로를 함께 반영한다. \(Z\)를 반영하지 않으면 \(X\)–\(Y\) 관계의 추정이 교란된다.
교란의 구조
교란의 바탕이 되는 인과 구조는 \(Z\)에서 \(X\)와 \(Y\) 모두로 화살표가 향하는 그림으로 나타낼 수 있다:
이 "공통원인" 구조는 \(X\)와 \(Y\) 사이에 직접적인 인과 연결이 없어도 둘이 연관됨을 뜻한다. 연관은 전적으로 뒷문 경로 \(X \leftarrow Z \rightarrow Y\)를 통해 생긴다.
고전적인 예: 커피와 암
초기 관찰연구들은 커피 소비(\(X\))와 폐암(\(Y\)) 사이에 양의 연관을 발견했다. 그러나 커피를 마시는 사람은 담배도 피울 가능성이 높았다(\(Z\)). 흡연은 커피 소비와 폐암 모두와 연관되어 있다. 흡연을 통제하자 커피–암 연관은 대부분 사라졌다. 흡연이 교란요인이었다.
양의 교란과 음의 교란
교란은 참 효과를 부풀릴 수도 가릴 수도 있다:
- 양의 교란: 교란요인이 양의 연관을 만들거나 부풀린다. 조정하지 않은 연관이 참 효과를 과대추정한다.
- 음의 교란: 교란요인이 참 연관을 가리거나 줄인다. 조정하지 않은 연관이 참 효과를 과소추정한다.
교란의 방향은 \(Z\)와 \(X\)의 관계, \(Z\)와 \(Y\)의 관계가 갖는 부호에 달려 있다.
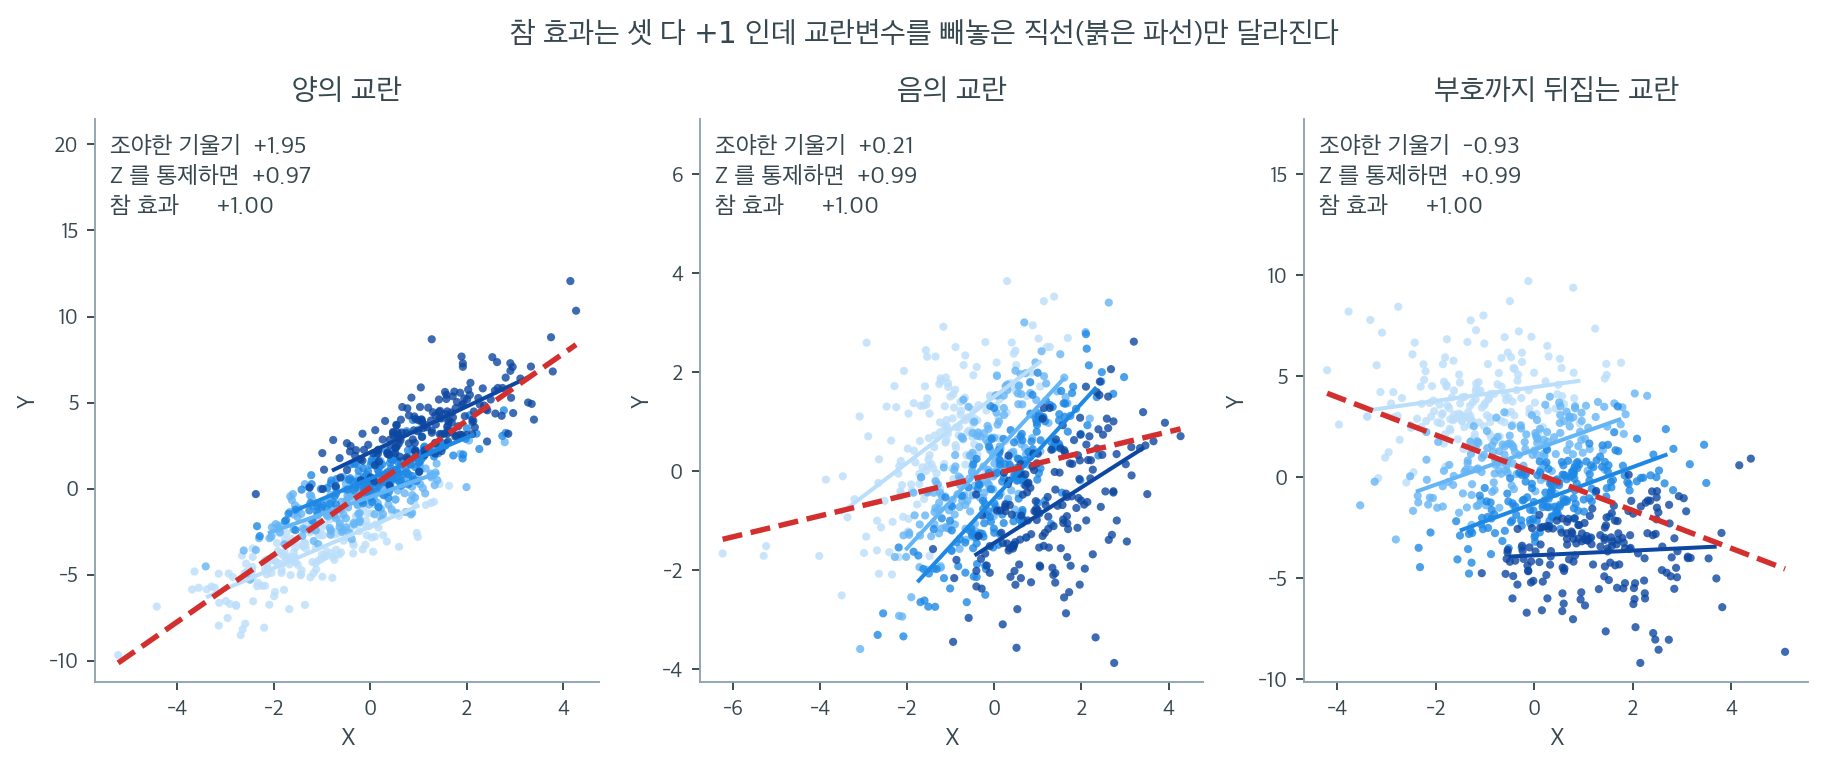
세 자료는 모두 같은 방식으로 만들었다. \(Z \to X\)의 관계도 같고, \(X\)가 \(Y\)에 미치는 참 효과도 셋 다 \(+1\)로 똑같다. 다른 것은 \(Z\)가 \(Y\)에 미치는 효과의 부호와 크기뿐이다. 그런데 교란변수를 빼고 \(Y\)를 \(X\)에만 회귀시킨 붉은 파선의 기울기는 차례로 \(+1.95\), \(+0.21\), \(-0.93\)이 나온다. 같은 효과를 두 배로 부풀리기도 하고, 5분의 1로 줄여 없는 것처럼 보이게도 하고, 아예 반대 방향으로 뒤집어 놓기도 한 것이다.
반면 \(Z\)를 모형에 넣은 기울기는 \(+0.97\), \(+0.99\), \(+0.99\)로 세 자료 모두 참값 \(+1\) 위에 정확히 내려앉는다. 그림에서 각 층의 옅은 파랑부터 진한 파랑까지 짧은 직선들이 그 조정된 기울기에 해당하며, 세 판 모두 같은 방향으로 완만하게 올라간다. 층 안의 기울기는 한 번도 변하지 않았고 층의 위치만 달라졌다는 것이 교란의 정확한 정체다.
여기서 실무적으로 중요한 결론이 나온다. "교란이 있으면 효과가 과대추정된다"는 말은 절반만 맞다. 가운데 판은 참으로 존재하는 효과가 교란 때문에 거의 사라져 보이는 경우이고, 이럴 때 연구자는 "유의하지 않으니 효과가 없다"고 잘못 결론짓기 쉽다. 교란의 존재를 아는 것만으로는 부족하고, \(Z\)가 \(X\)와 \(Y\) 각각에 어느 부호로 작용하는지까지 따져야 편향의 방향을 짐작할 수 있다. 아래의 "추정값 변화" 기준이 차이의 크기만이 아니라 방향까지 보라고 요구하는 이유다.
교란을 탐지하는 방법
실무에서는 조정하지 않은(조야한) 연관과 조정한 연관을 비교하여 교란을 탐지한다:
- (\(Z\)를 무시하고) \(X\)와 \(Y\) 사이의 조야한 연관을 계산한다.
- \(Z\)를 통제한 조정 연관을 계산한다.
- 두 추정값이 의미 있게 다르면(보통 10% 이상 차이 나면) \(Z\)가 교란요인이다.
이를 "추정값 변화" 기준이라 부르기도 한다. 형식적인 통계 검정이 아니라 실용적인 발견법이다.
교란요인을 통제하는 방법
설계 단계에서
-
무작위화. 노출을 무작위로 배정하면 \(X\)와 \(Z\)의 연관이 끊어져 교란이 제거된다. 무작위 대조 시험이 인과추론의 표준인 이유이다. 실험과 인과를 보라.
-
제한. 연구를 \(Z\)의 값이 같은 개인들로 한정한다. 예를 들어 비흡연자만 연구하여 흡연을 교란요인에서 제거한다.
-
짝짓기. 노출된 개인마다 \(Z\) 값이 같은(또는 비슷한) 비노출 개인을 고른다.
분석 단계에서
-
층화. \(Z\)의 각 수준 안에서 자료를 따로 분석한 뒤 Mantel-Haenszel 추정량 같은 방법으로 합친다.
-
회귀 조정. \(Y\)를 \(X\)에 회귀하는 모형에 \(Z\)를 공변량으로 넣는다. 그러면 \(X\)의 계수가 \(Z\)를 고정한 채의 \(X\) 효과를 추정한다.
-
성향점수 방법. \(Z\)가 주어졌을 때 노출될 확률을 추정한 뒤, 이 성향점수를 짝짓기·층화·가중에 쓴다.
보기 1. 운동, 식습관, 심장질환. 규칙적으로 운동하는 사람(\(X = 1\))의 심장질환(\(Y\)) 발생률이 낮다고 관측했다고 하자. 그런데 규칙적으로 운동하는 사람은 더 건강한 식습관(\(Z\))을 갖는 경향도 있다. 식습관은 다음 이유로 교란요인이다:
- 식습관이 운동과 연관되어 있다(\(r_{XZ} > 0\)).
- 운동 여부를 주었을 때 식습관이 심장질환과 연관되어 있다(\(r_{YZ} \neq 0\)).
- 식습관이 운동에서 심장질환으로 가는 인과 경로 위에 있지 않다(이 맥락에서 운동이 식습관을 일으키지는 않는다).
풀이
식습관을 통제하지 않으면 관측된 운동의 이득 중 일부가 운동 자체가 아니라 운동하는 사람들의 건강한 식습관에 기인한 것일 수 있다.
식습관을 조정한 뒤:
- 운동–심장질환 연관이 유지되면 운동에 독립적인 보호 효과가 있다.
- 연관이 사라지면 겉보기 이득은 식습관 때문이었다(교란).
- 연관이 약해지지만 남으면 운동에 독립적인 효과가 있으나 조정 전 크기는 식습관으로 교란되어 있었다.
교란, 매개, 충돌자 편향
교란을 관련되지만 다른 두 현상과 구별하는 일이 결정적이다:
| 구조 | 도식 | \(Z\)를 통제할 때의 효과 |
|---|---|---|
| 교란 | \(X \leftarrow Z \rightarrow Y\) | 편향을 제거하고 참 \(X \to Y\) 효과를 드러낸다 |
| 매개 | \(X \rightarrow Z \rightarrow Y\) | 간접효과를 제거하고 직접효과만 남긴다 |
| 충돌자 | \(X \rightarrow Z \leftarrow Y\) | 편향을 만든다. 허위 연관을 생성한다 |
매개자를 통제하는 것이 반드시 틀린 것은 아니지만 다른 질문(총효과가 아니라 직접효과)에 답하게 된다. 충돌자를 통제하는 것은 언제나 해롭다. 없던 편향을 만들어내기 때문이다. 이런 구별은 방향성 비순환 그래프로 형식화된다.
연습문제
연습문제 1. 다음 각 상관에 대해 그럴듯한 교란변수를 적어도 하나씩 밝혀라:
- 1인당 초콜릿 소비가 많은 나라일수록 노벨상 수상자가 많다.
- 아침을 먹는 학생이 시험을 더 잘 본다.
- 경찰관이 많은 도시일수록 범죄율이 높다.
- 책을 많이 가진 사람일수록 소득이 높은 경향이 있다.
풀이
-
국가의 부(1인당 GDP)가 초콜릿 소비와 노벨상 모두를 교란한다. 부유한 나라는 초콜릿도 더 살 수 있고 교육과 연구 기반시설에도 더 투자한다.
-
사회경제적 지위가 아침 식사와 시험 성적을 교란한다. 소득이 높은 가정의 학생은 아침을 규칙적으로 먹을 가능성이 크고 더 나은 교육 자원, 과외, 학습 환경도 갖는다.
-
도시 규모와 인구밀도가 경찰관 수와 범죄율을 교란한다. 큰 도시는 경찰관을 더 많이 고용하고 인구밀도, 빈곤 집중 등 도시적 요인 때문에 범죄율도 높다.
-
학력이 책 소유와 소득을 교란한다. 학력이 높은 사람은 책을 더 사고 소득도 더 높은 경향이 있다. 부모의 학력과 사회경제적 배경도 두 변수를 교란할 수 있다.
연습문제 2. 캘리포니아 주택 자료를 써서:
- 전체 상관행렬을 계산하라
median_house_value와 가장 강하게 상관된 변수를 찾아라median_income과median_house_value의 관계에서 있을 수 있는 교란요인을 논하라- 가장 강하게 상관된 네 변수에 대해 산점도 행렬을 그려라
import os, tarfile, urllib.request
import pandas as pd

DOWNLOAD_ROOT = "https://raw.githubusercontent.com/ageron/handson-ml2/7b7e23e7267356f8355580877eff98c43cda1bd0/"
HOUSING_PATH = os.path.join("datasets", "housing")
HOUSING_URL = DOWNLOAD_ROOT + "datasets/housing/housing.tgz"

def fetch_housing_data():
    if not os.path.isdir(HOUSING_PATH):
        os.makedirs(HOUSING_PATH)
    tgz_path = os.path.join(HOUSING_PATH, "housing.tgz")
    urllib.request.urlretrieve(HOUSING_URL, tgz_path)
    with tarfile.open(tgz_path) as f:
        f.extractall(path=HOUSING_PATH)

def load_housing_data():
    return pd.read_csv(os.path.join(HOUSING_PATH, "housing.csv"))

fetch_housing_data()
df = load_housing_data()

# numeric_only=True가 없으면 문자열 열(ocean_proximity) 때문에 예외가 난다.
corr = df.corr(numeric_only=True)["median_house_value"].sort_values(ascending=False)
print(corr.round(4).to_string())
출력:
median_house_value    1.0000
median_income         0.6881
total_rooms           0.1342
housing_median_age    0.1056
households            0.0658
total_bedrooms        0.0497
population           -0.0246
longitude            -0.0460
latitude             -0.1442
풀이
median_house_value와 가장 강하게 상관된 변수는 median_income이다. 이 관계에서 있을 수 있는 교란요인으로는 지리적 위치(해안 근접성, 도시 대 농촌), 주택 연식, 지역 편의시설(학군, 일자리)이 있다. 이 변수들은 (거주자의 분화를 통해) 중위소득에도, (수요를 통해) 주택 가격에도 영향을 준다. 상위 네 변수의 산점도 행렬을 그리면 많은 관계가 비선형이고, 이상점(예: $500,000에서 잘린 주택 가격)이 상관 추정을 왜곡할 수 있음이 드러난다.
정리하며
교란변수는 노출과 결과의 공통원인으로서 둘 사이의 관측된 연관을 왜곡한다. 교란은 참 효과를 부풀리거나 줄이거나 뒤집을 수 있다. 연구 설계(무작위화, 제한, 짝짓기)나 분석(층화, 회귀, 성향점수)으로 다룰 수 있다. 교란을 올바르게 다루는 열쇠는 바탕에 있는 인과 구조를 이해하는 것이며, 그것이 교란요인을 매개자·충돌자와 구별해 준다.