두 평균에 대한 붓스트랩 검정
동기
이표본 \(t\) 검정은 자료가 정규분포를 따르거나(또는 중심극한정리가 통할 만큼 표본이 크다는) 가정 아래 독립인 두 집단의 평균을 비교한다. 이 조건이 깨지면 --- 예를 들어 치우쳤거나 꼬리가 두꺼운 분포에서 작은 표본을 얻으면 --- 붓스트랩이 대안이 된다.
이표본 상황의 핵심 난점은 귀무가설 \(H_0: \mu_X = \mu_Y\)를 반영하는 붓스트랩 표본을 생성하는 일이다. 주된 전략이 둘 있다. 합치기(pooling)와 중심화(centering)이다.
가설
독립인 두 표본을 관측한다.
- 집단 X: \(x_1, \ldots, x_m\), 표본평균 \(\bar{x}\), 표본표준편차 \(s_x\)
- 집단 Y: \(y_1, \ldots, y_n\), 표본평균 \(\bar{y}\), 표본표준편차 \(s_y\)
검정은
이다. 관측 검정통계량은 스튜던트화하지 않으면
스튜던트화하면
이다.
방법 1: 합친 붓스트랩
\(H_0\) 아래에서 두 집단이 같은 분포에서 온다. 합친 붓스트랩은 모든 관측값을 합치고 그 합친 표본에서 재표집하여 이를 강제한다.
알고리즘:
- \(t_{\text{obs}}\)를 계산한다.
- 모든 관측값을 합친다: \(z_1, \ldots, z_{m+n} = x_1, \ldots, x_m, y_1, \ldots, y_n\).
- \(b = 1, \ldots, B\)에 대해:
- 합친 표본에서 복원추출로 \(m\)개를 뽑아 "집단 X" 붓스트랩 표본을 만든다.
- 합친 표본에서 복원추출로 \(n\)개를 뽑아 "집단 Y" 붓스트랩 표본을 만든다.
- 같은 검정통계량 공식으로 \(t^{*(b)}\)를 계산한다.
- 양측 \(p\)값은
합치기가 적절한 경우
합친 붓스트랩은 \(H_0\) 아래에서 두 집단이 같은 분포를 갖는다고 가정한다. 평균만 같고 분산이나 모양이 다르면 합치기가 오도할 수 있다. 그런 경우에는 중심화 접근(방법 2)이 낫다.
방법 2: 중심화 붓스트랩
중심화 붓스트랩은 분포가 같다고 가정하지 않고 \(\mu_X = \mu_Y\)만 강제한다. 각 집단을 평균 \(0\)(또는 임의의 공통값)이 되도록 이동한다.
알고리즘:
- \(t_{\text{obs}}\)를 계산한다.
- 각 집단을 중심화한다: \(\tilde{x}_i = x_i - \bar{x}\), \(\tilde{y}_j = y_j - \bar{y}\).
- \(b = 1, \ldots, B\)에 대해:
- \(\{\tilde{x}_1, \ldots, \tilde{x}_m\}\)에서 복원추출로 \(m\)개를 뽑는다.
- \(\{\tilde{y}_1, \ldots, \tilde{y}_n\}\)에서 복원추출로 \(n\)개를 뽑는다.
- 같은 검정통계량 공식으로 \(t^{*(b)}\)를 계산한다.
- 위와 같이 \(p\)값을 계산한다.
중심화 접근은 두 집단이 서로 다른 분산과 모양을 갖는 것을 허용하고, 평균이 같다는 귀무가설만 부과한다(중심화 후 둘 다 \(0\)).
합치기와 중심화 중 무엇을 고를까
\(H_0\) 아래에서 두 집단의 분포가 비슷하다고 믿으면 합치기를 쓴다(합동 \(t\) 검정에 대응). 분산이나 모양이 다를 수 있으면 중심화를 쓴다(Welch \(t\) 검정에 대응). 확신이 없으면 더 로버스트한 중심화를 쓴다.
두 방법이 실제로 얼마나 다른지는 분산이 다르고 표본크기가 불균형할 때 드러난다. \(m = 30\)(\(s_x \approx 1\))과 \(n = 10\)(\(s_y \approx 3\))에서 같은 자료로 두 귀무분포를 만들어 보았다.
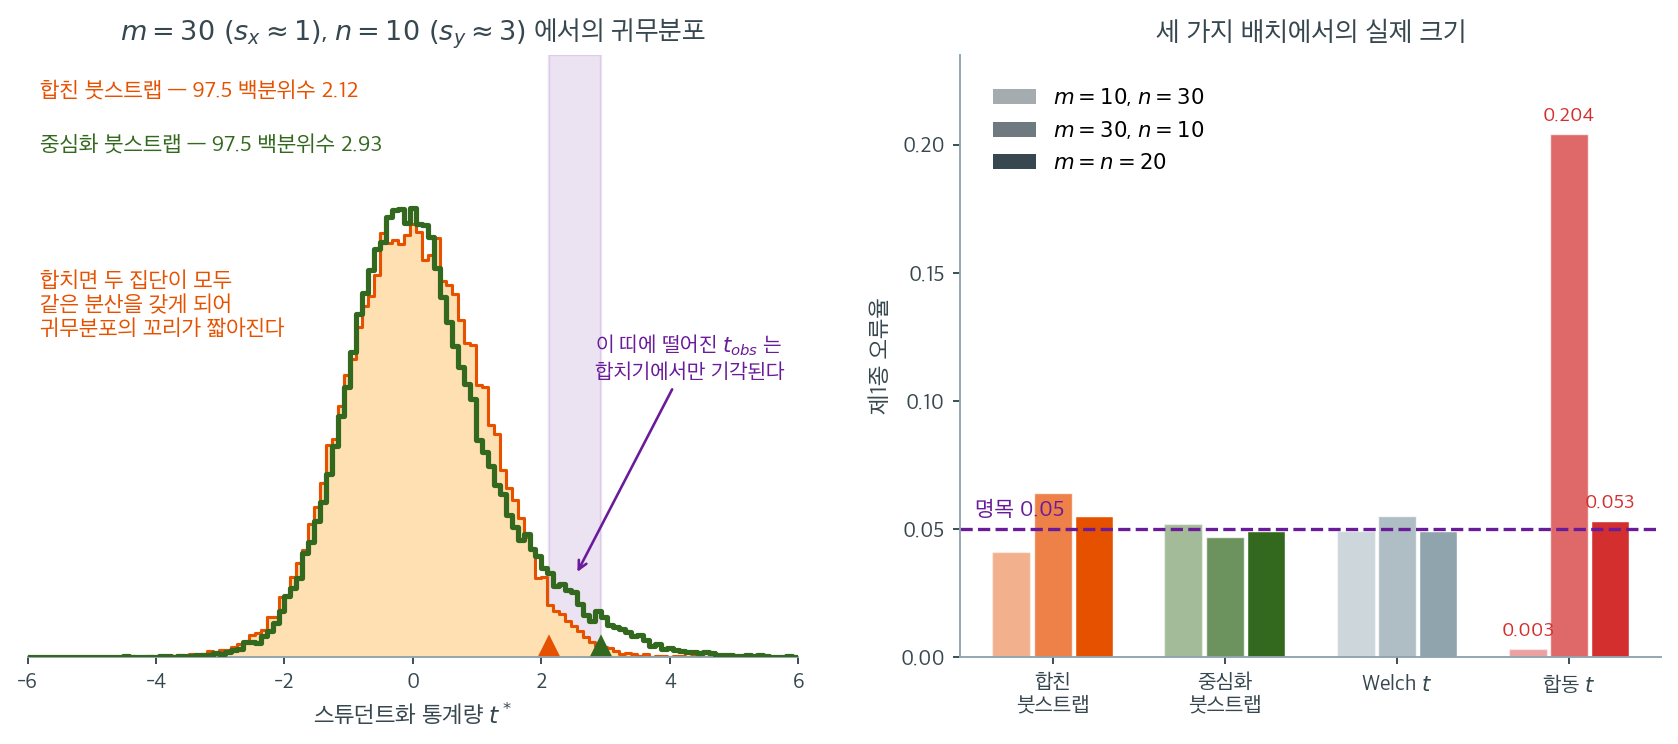
왼쪽에서 두 분포의 가운데는 거의 같지만 꼬리가 다르다. 합친 붓스트랩의 \(97.5\) 백분위수가 \(2.12\)인 데 반해 중심화 붓스트랩은 \(2.93\)이다. 이유는 합치는 순간 두 붓스트랩 집단이 모두 합동분산 \(\approx (30 \times 1 + 10 \times 9)/40 = 3\)에서 값을 받기 때문이다. 즉 작은 집단의 분산이 실제 \(9\)에서 \(3\)으로 줄어들고, 작은 집단이 지배하던 \(\widehat{\text{se}}\)가 작아져 \(t^*\)의 꼬리가 짧아진다. 반면 관측된 \(t_{\text{obs}}\)는 실제 분산 \(s_x^2 \approx 1\)과 \(s_y^2 \approx 9\)로 계산된 값이다. 귀무분포와 관측 통계량이 서로 다른 분산 구조를 전제하는 셈이며, 보라색 띠에 떨어진 통계량은 합치기에서만 기각된다.
오른쪽이 그 결과다. \(m = 30\), \(n = 10\) 배치에서 합친 붓스트랩의 제1종 오류율이 \(0.064\)로 \(28\%\) 부풀고, 중심화 붓스트랩은 \(0.047\)로 명목값을 지킨다. 세 배치 전체에서 중심화는 \(0.047\)--\(0.052\) 범위를 벗어나지 않으며 Welch \(t\) 검정과 사실상 동등하다.
가장 극적인 것은 합동 \(t\) 검정이다. 같은 배치에서 \(0.204\)로 명목값의 네 배이고, 표본크기를 뒤집으면 \(0.003\)으로 지나치게 보수적이 된다. 작은 집단의 분산이 클 때 합동분산이 그것을 과소평가하고, 반대 배치에서는 과대평가하기 때문이다. Behrens-Fisher 문제의 전형적 증상이며, 스튜던트화 통계량을 쓴 중심화 붓스트랩은 사실상 비모수 Welch 검정으로서 이 함정을 피한다.
스튜던트화와 비스튜던트화
일표본과 마찬가지로 스튜던트화 판본이 대체로 낫다.
| 판본 | 검정통계량 | 성질 |
|---|---|---|
| 비스튜던트화 | \(d^{*(b)} = \bar{x}^{*(b)} - \bar{y}^{*(b)}\) | 단순하지만 분산 차이에 민감 |
| 스튜던트화 | \(t^{*(b)} = \dfrac{\bar{x}^{*(b)} - \bar{y}^{*(b)}}{\sqrt{s_x^{2*(b)}/m + s_y^{2*(b)}/n}}\) | 더 로버스트, 제1종 오류 통제가 좋음 |
스튜던트화 판본은 각 붓스트랩 표본의 변동에 적응하므로, 특히 두 집단의 분산이 다를 때 더 정확한 \(p\)값을 준다.
순열검정과의 관계
합친 붓스트랩은 두 평균에 대한 순열검정과 밀접하다. 둘 다 \(H_0\) 아래에서 자료를 합치지만 귀무표본을 만드는 방식이 다르다.
- 순열검정: 집단 라벨을 비복원으로 섞는다(원래 관측값을 정확히 보존한다).
- 합친 붓스트랩: 복원추출로 재표집한다(새로운 조합을 만든다).
순열검정은 관측된 자료에 조건부이며 (순열 개수까지) 정확한 \(p\)값을 준다. 붓스트랩은 관측값의 중복을 허용하고 표본분포를 더 넓게 근사한다. \(H_0: \mu_X = \mu_Y\)를 검정하는 데 두 접근 모두 타당하며, \(H_0\) 아래에서 분포가 동일하다고 가정할 수 있으면 순열검정이 흔히 선호된다.
보기 1. 처치군과 대조군의 평균 비교. 한 임상시험이 처치군(\(m = 18\), \(\bar{x} = 5.8\), \(s_x = 3.2\))과 대조군(\(n = 22\), \(\bar{y} = 4.1\), \(s_y = 2.5\))을 비교한다.
관측 검정통계량 (Welch형):
풀이
중심화 붓스트랩 (분산이 다르므로):
- 중심화: \(\tilde{x}_i = x_i - 5.8\), \(\tilde{y}_j = y_j - 4.1\)
- \(t^*\)의 붓스트랩 복제값 \(B = 10{,}000\)개를 생성한다.
- \(10{,}000\)개 중 \(712\)개가 \(|t^{*(b)}| \ge 1.841\)을 만족했다고 하자.
붓스트랩 \(p\)값은 \(712/10{,}000 = 0.071\)이다.
비교를 위해 Welch \(t\) 검정은 \(p = 0.075\)를 준다(Welch 자유도 \(31.8\)). 두 값이 가까운 것은 이 상황에서 정규근사가 적절함을 시사하며, 붓스트랩은 그 가정에 기대지 않고 같은 결론을 확인해 준다.
등분산 가정
합친 붓스트랩을 썼는데 참 분산이 다르면 제1종 오류율이 부풀려질 수 있다. 스튜던트화 통계량을 쓰는 중심화 붓스트랩이 이분산에 더 로버스트하므로, 분산의 동일성이 불확실하면 이것을 기본으로 삼아야 한다.
연습문제
연습문제 1. 합친 붓스트랩과 중심화 붓스트랩의 제1종 오류율을 분산이 다른 상황에서 비교하라. 표본크기가 불균형할 때 어떤 일이 일어나는가?
풀이
두 집단의 평균이 모두 \(0\)이고 표준편차가 \(1\)과 \(3\)으로 다른 상황이다.
import numpy as np
from scipy import stats
rng = np.random.default_rng(0)

for (m, n, s1, s2) in [(10, 30, 1, 3), (30, 10, 1, 3), (20, 20, 1, 3)]:
    M, B = 1500, 999
    c_pool = c_cent = c_welch = c_pooled_t = 0
    for _ in range(M):
        x = rng.normal(0, s1, m); y = rng.normal(0, s2, n)
        c_welch    += stats.ttest_ind(x, y, equal_var=False).pvalue < 0.05
        c_pooled_t += stats.ttest_ind(x, y, equal_var=True).pvalue < 0.05

        se = np.sqrt(x.var(ddof=1)/m + y.var(ddof=1)/n)
        tobs = (x.mean() - y.mean()) / se

        # 합친 붓스트랩
        z = np.concatenate([x, y]); N = m + n
        xb = z[rng.integers(0, N, (B, m))]; yb = z[rng.integers(0, N, (B, n))]
        tb = (xb.mean(axis=1) - yb.mean(axis=1)) / np.sqrt(
             xb.var(axis=1, ddof=1)/m + yb.var(axis=1, ddof=1)/n)
        c_pool += (np.abs(tb) >= abs(tobs)).mean() < 0.05

        # 중심화 붓스트랩
        xc, yc = x - x.mean(), y - y.mean()
        xb2 = xc[rng.integers(0, m, (B, m))]; yb2 = yc[rng.integers(0, n, (B, n))]
        tb2 = (xb2.mean(axis=1) - yb2.mean(axis=1)) / np.sqrt(
              xb2.var(axis=1, ddof=1)/m + yb2.var(axis=1, ddof=1)/n)
        c_cent += (np.abs(tb2) >= abs(tobs)).mean() < 0.05
    print(m, n, round(c_pool/M,3), round(c_cent/M,3),
          round(c_welch/M,3), round(c_pooled_t/M,3))
출력:
10 30 0.041 0.052 0.049 0.003
30 10 0.064 0.047 0.055 0.204
20 20 0.055 0.049 0.049 0.053
| \(m\) | \(n\) | 합친 붓스트랩 | 중심화 붓스트랩 | Welch \(t\) | 합동 \(t\) |
|---|---|---|---|---|---|
| 10 | 30 | 0.041 | 0.052 | 0.049 | 0.003 |
| 30 | 10 | 0.064 | 0.047 | 0.055 | 0.204 |
| 20 | 20 | 0.055 | 0.049 | 0.049 | 0.053 |
합동 \(t\) 검정이 재앙적으로 실패한다. 작은 집단의 분산이 클 때(\(m=30\), \(n=10\), \(s_2=3\)) 제1종 오류율이 \(0.204\)로 명목값의 네 배이다. 반대 배치(\(m=10\), \(n=30\))에서는 \(0.003\)으로 지나치게 보수적이다. 이것이 Behrens-Fisher 문제의 전형적 증상이다.
중심화 붓스트랩은 세 배치 모두에서 명목값을 지킨다(\(0.047\)--\(0.052\)). Welch \(t\) 검정과 사실상 동등하다.
합친 붓스트랩은 불균형에 취약하다. \(m=30\), \(n=10\)에서 \(0.064\)로 28% 부풀려진다. 스튜던트화 통계량을 썼는데도 그렇다.
왜 그런가. 합친 붓스트랩은 두 붓스트랩 집단을 같은 합친 풀에서 뽑으므로, 두 집단의 분산이 모두 합친 분산 \(\approx (m s_1^2 + n s_2^2)/(m+n)\)이 된다. 그러나 관측된 \(t_{\text{obs}}\)는 실제 분산 \(s_1^2 = 1\)과 \(s_2^2 = 9\)로 계산되었다. 귀무분포와 관측 통계량이 서로 다른 분산 구조를 전제하는 것이다.
권고: 등분산을 확신할 수 없으면 중심화 붓스트랩 + 스튜던트화 통계량을 쓴다. 이는 사실상 비모수 Welch 검정이다.
연습문제 2. 합친 붓스트랩과 순열검정이 어떻게 다른지 수치로 확인하라. 두 방법의 \(p\)값이 얼마나 가까운가?
풀이
import numpy as np
from scipy import stats
rng = np.random.default_rng(4)
m, n, B = 12, 15, 20000
x = rng.normal(0.6, 1, m)
y = rng.normal(0.0, 1, n)

se = np.sqrt(x.var(ddof=1)/m + y.var(ddof=1)/n)
tobs = (x.mean() - y.mean()) / se
z = np.concatenate([x, y]); N = m + n

# 합친 붓스트랩 (복원)
xb = z[rng.integers(0, N, (B, m))]; yb = z[rng.integers(0, N, (B, n))]
tb = (xb.mean(axis=1) - yb.mean(axis=1)) / np.sqrt(
     xb.var(axis=1, ddof=1)/m + yb.var(axis=1, ddof=1)/n)
p_boot = (np.abs(tb) >= abs(tobs)).mean()

# 순열검정 (비복원)
tp = np.empty(B)
for b in range(B):
    perm = rng.permutation(z)
    a, c = perm[:m], perm[m:]
    tp[b] = (a.mean() - c.mean()) / np.sqrt(a.var(ddof=1)/m + c.var(ddof=1)/n)
p_perm = (np.abs(tp) >= abs(tobs)).mean()

print("t_obs = %.4f" % tobs)
print("합친 붓스트랩 p = %.4f" % p_boot)
print("순열검정      p = %.4f" % p_perm)
print("Welch t       p = %.4f" % stats.ttest_ind(x, y, equal_var=False).pvalue)
출력:
t_obs = 1.6474
합친 붓스트랩 p = 0.1093
순열검정      p = 0.1147
Welch t       p = 0.1121
| 방법 | \(p\)값 |
|---|---|
| 합친 붓스트랩 | 0.1093 |
| 순열검정 | 0.1147 |
| Welch \(t\) | 0.1121 |
세 값이 \(0.005\) 이내로 모여 있다. 이 자료(\(t_{\text{obs}} = 1.647\))에서는 실질적 차이가 없다.
구조적 차이는 있다.
- 순열검정의 귀무분포는 관측된 \(27\)개 값의 재배열만으로 이루어진다. 각 순열에서 두 집단의 값이 정확히 원자료의 다중집합이다.
- 합친 붓스트랩은 복원추출이므로 어떤 값이 여러 번 나타나고 어떤 값은 빠진다.
# 귀무분포의 표준편차 비교
print(round(tp.std(), 4), round(tb.std(), 4))   # 1.0522  1.0394
출력:
1.0522 1.0394
두 귀무분포의 표준편차가 \(1.05\)와 \(1.04\)로 거의 같다. 스튜던트화 통계량을 썼기 때문이다. 스튜던트화하지 않은 \(\bar{x}^* - \bar{y}^*\)를 비교하면 붓스트랩 쪽이 뚜렷이 넓어진다. 복원추출이 추가적인 변동을 들여오기 때문이다.
어느 쪽을 쓸 것인가. \(H_0\) 아래에서 두 분포가 동일하다고 가정할 수 있으면 순열검정이 낫다. 정확한 \(p\)값을 주고(교환가능성만 필요하다) 귀무분포가 더 좁아 검정력이 약간 높다.
평균만 같고 분산이나 모양이 다를 수 있으면 두 방법 모두 부적절하며, 중심화 붓스트랩을 써야 한다.
연습문제 3. 스튜던트화하지 않은 붓스트랩 검정이 분산 차이에 취약하다는 주장을 확인하라.
풀이
중심화 붓스트랩에서 통계량만 바꾸어 비교한다.
import numpy as np
rng = np.random.default_rng(9)

for (m, n, s1, s2) in [(20, 20, 1, 1), (20, 20, 1, 4), (10, 40, 1, 4)]:
    M, B = 1200, 999
    c_stud = c_unstud = 0
    for _ in range(M):
        x = rng.normal(0, s1, m); y = rng.normal(0, s2, n)
        xc, yc = x - x.mean(), y - y.mean()
        xb = xc[rng.integers(0, m, (B, m))]
        yb = yc[rng.integers(0, n, (B, n))]

        dobs = x.mean() - y.mean()
        db = xb.mean(axis=1) - yb.mean(axis=1)
        c_unstud += (np.abs(db) >= abs(dobs)).mean() < 0.05

        se = np.sqrt(x.var(ddof=1)/m + y.var(ddof=1)/n)
        tobs = dobs / se
        tb = db / np.sqrt(xb.var(axis=1, ddof=1)/m + yb.var(axis=1, ddof=1)/n)
        c_stud += (np.abs(tb) >= abs(tobs)).mean() < 0.05
    print(m, n, s1, s2, round(c_stud/M, 3), round(c_unstud/M, 3))
출력:
20 20 1 1 0.052 0.068
20 20 1 4 0.048 0.068
10 40 1 4 0.058 0.068
| \(m\) | \(n\) | \(\sigma_1\) | \(\sigma_2\) | 스튜던트화 | 비스튜던트화 |
|---|---|---|---|---|---|
| 20 | 20 | 1 | 1 | 0.052 | 0.068 |
| 20 | 20 | 1 | 4 | 0.048 | 0.068 |
| 10 | 40 | 1 | 4 | 0.058 | 0.068 |
스튜던트화 판본이 세 경우 모두 명목값 근처를 지킨다(\(0.048\)--\(0.058\)). 비스튜던트화 판본은 세 경우 모두 \(0.068\)로 일관되게 \(36\%\) 부풀려진다.
흥미로운 점: 부풀림이 분산비와 무관하다. 등분산(\(1,1\))일 때도 \(0.068\)이고 분산비가 \(16\)배일 때도 \(0.068\)이다. 즉 이 부풀림의 원인은 분산 차이가 아니라 관측 통계량과 귀무분포의 척도가 어긋나는 것 자체이다.
중심화 붓스트랩은 각 집단에서 따로 재표집하므로 분산 구조를 보존한다. 그래서 분산비가 커져도 더 나빠지지는 않는다. 합친 붓스트랩에서 비스튜던트화를 쓰면 분산비에 따라 훨씬 나빠진다.
합친 붓스트랩에서 비스튜던트화를 쓰면 훨씬 나빠진다. 그 경우 분산 구조가 완전히 뭉개지기 때문이다.
그럼에도 스튜던트화를 쓰는 이유. \(0.068\)이 작아 보이지만 명목수준의 \(36\%\) 초과이다. 계산 비용이 거의 같으므로 스튜던트화하지 않을 이유가 없다.
연습문제 4. \(H_0\) 아래에서 두 집단의 모양이 다르면(분산은 같고 왜도가 다르면) 세 방법이 어떻게 반응하는가?
풀이
평균과 분산이 모두 같지만 한 집단은 오른쪽, 다른 집단은 왼쪽으로 치우친 상황을 만든다.
import numpy as np
from scipy import stats
rng = np.random.default_rng(23)
M, B, m, n = 1200, 999, 25, 25

c_pool = c_cent = c_welch = 0
for _ in range(M):
    x = rng.exponential(1, m) - 1.0        # 오른쪽 치우침, 평균 0, 분산 1
    y = -(rng.exponential(1, n) - 1.0)     # 왼쪽 치우침, 평균 0, 분산 1
    c_welch += stats.ttest_ind(x, y, equal_var=False).pvalue < 0.05

    se = np.sqrt(x.var(ddof=1)/m + y.var(ddof=1)/n)
    tobs = (x.mean() - y.mean()) / se

    z = np.concatenate([x, y]); N = m + n
    xb = z[rng.integers(0, N, (B, m))]; yb = z[rng.integers(0, N, (B, n))]
    tb = (xb.mean(axis=1) - yb.mean(axis=1)) / np.sqrt(
         xb.var(axis=1, ddof=1)/m + yb.var(axis=1, ddof=1)/n)
    c_pool += (np.abs(tb) >= abs(tobs)).mean() < 0.05

    xc, yc = x - x.mean(), y - y.mean()
    xb2 = xc[rng.integers(0, m, (B, m))]; yb2 = yc[rng.integers(0, n, (B, n))]
    tb2 = (xb2.mean(axis=1) - yb2.mean(axis=1)) / np.sqrt(
          xb2.var(axis=1, ddof=1)/m + yb2.var(axis=1, ddof=1)/n)
    c_cent += (np.abs(tb2) >= abs(tobs)).mean() < 0.05

print(round(c_pool/M,3), round(c_cent/M,3), round(c_welch/M,3))
출력:
0.067 0.058 0.065
| 방법 | 제1종 오류율 |
|---|---|
| 합친 붓스트랩 | 0.067 |
| 중심화 붓스트랩 | 0.058 |
| Welch \(t\) | 0.065 |
세 방법 모두 명목값을 다소 넘지만 재앙적이지는 않다. 모양이 정반대인데도 \(0.058\)--\(0.067\)에 머문다. 중심화 붓스트랩이 가장 낫다.
남는 부풀림(\(0.058\)--\(0.067\))의 원인은 왜도 자체이다. \(\bar X\)는 오른쪽으로, \(\bar Y\)는 왼쪽으로 치우쳐 있으므로 \(\bar X - \bar Y\)의 왜도가 두 왜도의 차이로 누적되어 \(2\gamma_1/\sqrt{n}\) 규모가 된다. 같은 방향으로 치우쳐 있었다면 상쇄되었을 것이다.
비교: 분산이 다를 때(연습문제 1)와의 대비.
| 위반 유형 | 합친 붓스트랩 | 중심화 붓스트랩 |
|---|---|---|
| 분산 불일치 + 불균형 표본 (\(m{=}30\), \(n{=}10\)) | 0.064 | 0.047 |
| 모양(왜도) 불일치, 균형 표본 | 0.067 | 0.058 |
중심화 붓스트랩이 두 위반 유형 모두에서 합친 붓스트랩보다 낫다. 다만 왜도 불일치에서는 중심화도 완전히 고치지 못한다. 중심화는 각 집단의 분산과 모양을 보존하지만, 그 모양이 만들어 내는 \(\bar X - \bar Y\)의 왜도까지 귀무분포에 정확히 반영하지는 못하기 때문이다.
실무적 판단: 왜도가 크게 다르다면 평균 비교 자체를 재고해야 한다. 두 분포의 모양이 근본적으로 다르면 "평균 차이"라는 요약이 무엇을 뜻하는지부터 불분명하다. Mann-Whitney 검정처럼 확률적 순서를 검정하거나, 분위수별 비교를 하는 편이 더 정보를 준다.
정리하며
부트스트랩 검정의 핵심은 귀무가설을 자료에 부과하는 것이다.
- 그냥 재표집하면 안 된다. 원자료를 그대로 재표집하면 대립가설 아래의 분포를 얻게 되며, \(p\) 값이 뜻을 잃는다.
- 두 전략이 있다. 합치기는 두 표본을 합쳐 하나의 모집단에서 뽑고, 중심화는 각 표본에서 자기 평균을 빼 평균을 맞춘 뒤 따로 뽑는다.
- 중심화가 더 안전하다. 합치기는 두 분포의 모양과 분산이 같다고 암묵적으로 가정하지만, 중심화는 각 집단의 형태를 보존한다.
- 치우치거나 꼬리가 두꺼운 소표본에서 가치가 있다. \(t\) 검정의 근사가 무너지는 바로 그 영역이다.
- 순열검정과 비교해 볼 만하다. 순열은 교환가능성을 가정하고 부트스트랩은 그렇지 않으며, 이 장 마지막에서 정리한다.
다음 절 붓스트랩 검정 (코드) 로 넘어간다.