범주형 설명변수¶
들어가는 이야기 — 이름을 수로 바꾸는 한 번의 선택
지역·등급·부서처럼 이름뿐인 변수를 회귀에 넣어야 할 때가 많다. 회귀식은 설명변수(explanatory variable)에 수를 곱하므로 이름을 수로 바꿔 넣게 되는데, 그 한 번의 선택이 모형의 내용을 바꾼다.
서울·부산·대구의 임금을 견주려고 서울 \(=0\), 부산 \(=1\), 대구 \(=2\) 로 바꿔 넣어 보자. 자료를 옮겨 적는 일처럼 보이지만, 그렇게 하면 예측값이 \(11.6630\), \(12.5389\), \(13.4148\) 로 등간격이 된다. 간격이 둘 다 \(0.8759\) 인 것이 우연이 아니다 — 예측이 \(0\cdot\hat\beta\), \(1\cdot\hat\beta\), \(2\cdot\hat\beta\) 이니 간격이 같을 수밖에 없다.
세 집단의 실제 평균은 \(9.9962\), \(15.8841\), \(11.9519\) 로 부산이 가장 높고 서울이 가장 낮다. 등간격 직선으로는 가운데가 가장 높은 모양을 그릴 수 없으니, 정수 코딩은 자료에 없는 순서와 간격을 강요한 셈이다. 대가는 \(R^2\) 에 찍힌다 — 집단평균 모형이 \(0.6022\) 를 설명하는 자료에서 \(0.0547\) 에 멈추고, \((0.6022-0.0547)/0.6022 = 0.91\) 이니 설명할 수 있었던 것의 \(91\%\) 를 버렸다.
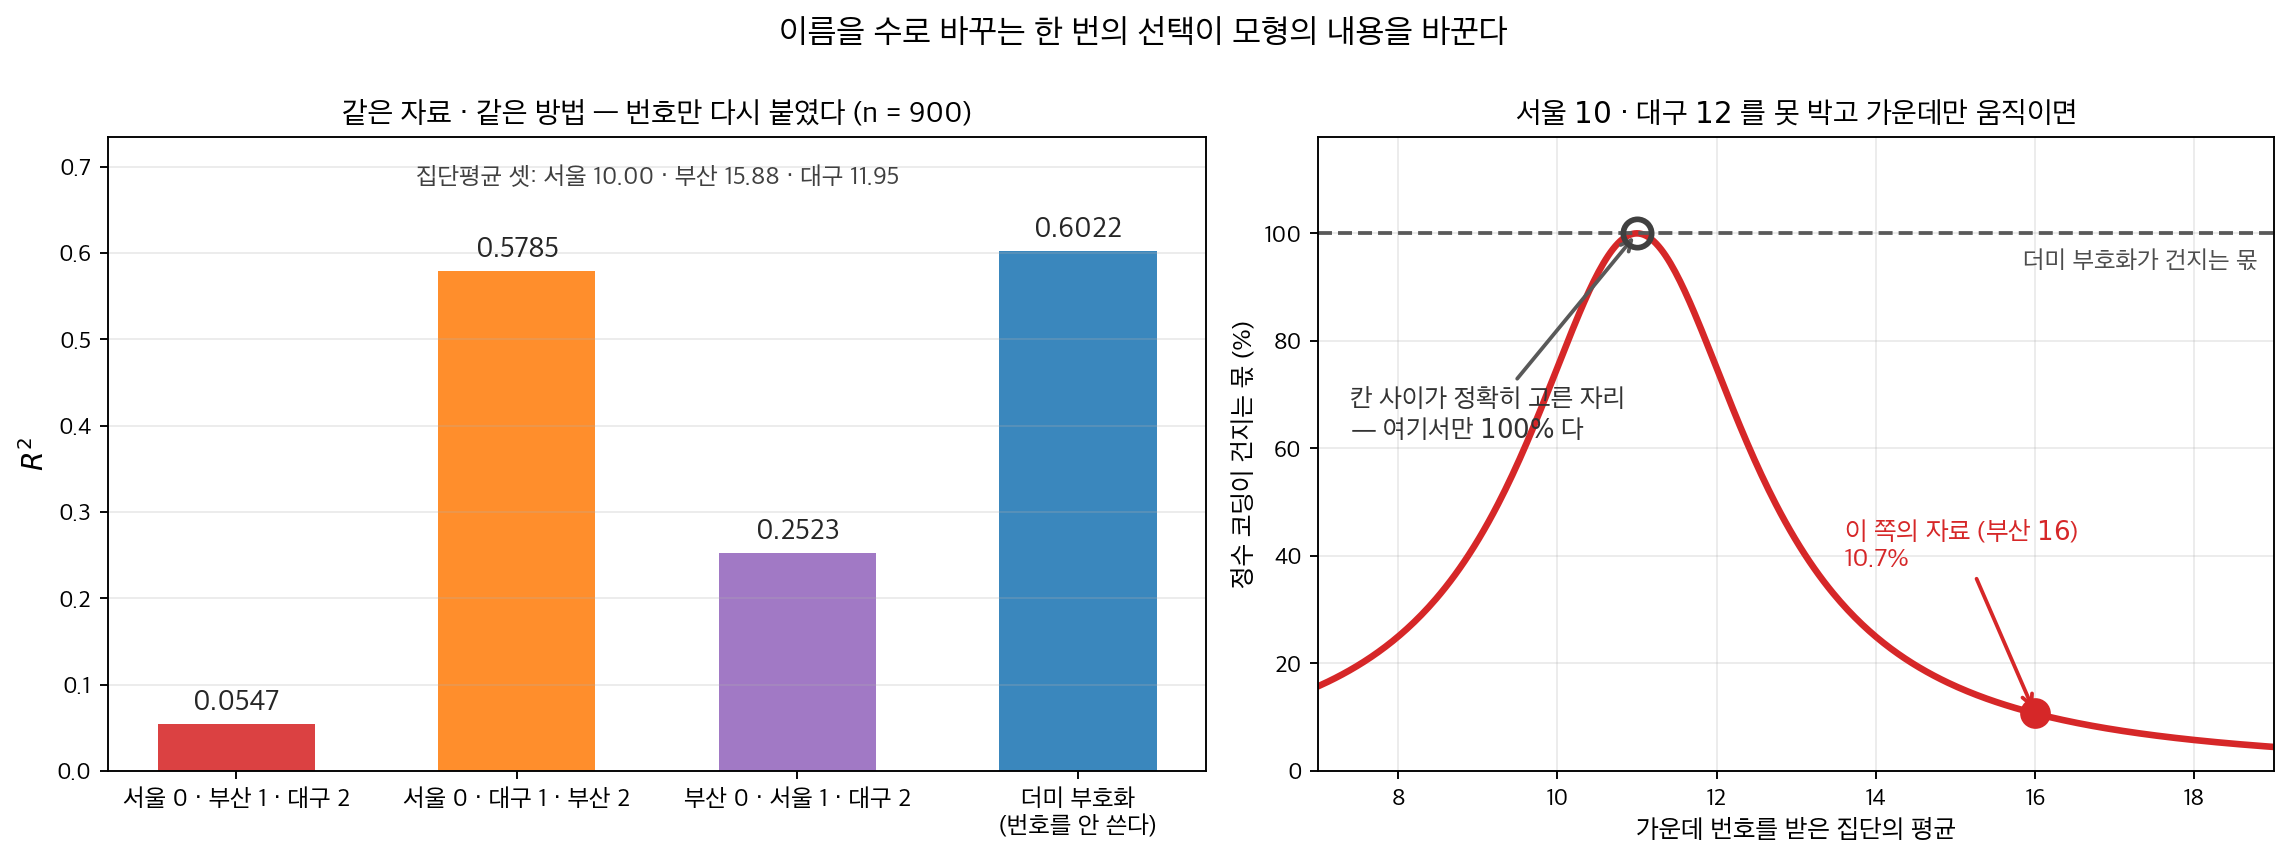
왼쪽. 같은 자료에 번호만 다시 붙였다. 서울·부산·대구에 \(0,1,2\) 를 주면 \(R^2 = 0.0547\) 인데, 순서를 바꿔 서울·대구·부산으로 주면 \(0.5785\) 다 — 자료도 방법도 그대로이고 이름표만 바뀌었다. 더미 부호화는 번호를 아예 쓰지 않으므로 어떻게 붙이든 \(0.6022\) 다. 오른쪽. 정수 코딩이 건지는 몫은 집단평균의 배치로 정확히 정해진다. 서울 \(10\) 과 대구 \(12\) 를 못 박고 가운데 집단의 평균만 움직이면, 칸 사이가 정확히 고른 \(11\) 에서만 \(100\%\) 이고 거기서 멀어질수록 떨어진다. 이 쪽의 자료는 가운데가 \(16\) 이라 \(10.7\%\) 다.
순서가 있는 범주라면 괜찮다고 생각하기 쉬운데 그것도 조심해야 한다. 순서가 있다는 것과 칸 사이의 간격이 같다는 것은 다른 말이고, 정수 코딩은 뒤쪽까지 가정한다. 이름을 수로 바꾸는 방법이 어떻게 모형의 내용을 바꾸는가. 아래 상자는 기준범주를 어떻게 골라도 무해한 자리와 그렇지 않은 자리를 가른다.
확인한 곳 — 이 쪽 「기준범주는 최소제곱에서만 무해하다」 상자와 그 출처 줄
회귀식은 설명변수에 수를 곱한다.
그런데 현실의 설명변수에는 도시, 직업, 혈액형, 학력처럼 수가 아닌 것이 흔하다. 이런 변수를 회귀에 넣으려면 먼저 수로 바꿔야 하고, 어떻게 바꾸느냐가 모형의 의미를 바꾼다.
이 절은 그 변환을 다룬다. 결론을 먼저 말하면 이렇다.
명목형에 정수를 매기면 안 된다. 자료에 없는 순서와 간격을 모형에 집어넣게 된다.
1. 정수를 그대로 쓰면 무슨 일이 생기는가¶
세 도시의 임금을 비교한다고 하자. 서울 \(=0\), 부산 \(=1\), 대구 \(=2\)로 두고 그대로 회귀에 넣으면 어떻게 되는가.
보기 1. 명목형에 정수를 매기면. 서울 \(=0\), 부산 \(=1\), 대구 \(=2\)로 코딩해 그대로 단순회귀(simple linear regression)에 넣는다.
(1) 정수 코딩의 최소제곱 기울기를 집단평균 \(\bar y_k\) 와 집단크기 \(n_k\) 만으로 나타내고 수치를 구하시오. 이 모형의 \(R^2\) 가 \(\operatorname{corr}(x, y)^2\) 과 같은 까닭은 무엇인가.
(2) 각 집단에 그 집단의 평균을 예측값으로 주는 모형의 잔차제곱합은 집단내 제곱합(sum of squares) \(\text{WSS}\) 다. 정수 코딩의 RSS 와 견주어 등간격 제약이 낸 손실을 수로 적으시오.
풀이
(1) 해석적으로. 설명변수가 하나뿐이므로 \(\hat\beta_1 = S_{xy}/S_{xx}\) 다. \(x\) 가 \(\{0, 1, 2\}\) 세 값만 가지므로 합을 집단별로 묶을 수 있다.
둘째 식이 성립하는 까닭은 각 집단 안에서 \(x_i - \bar x\) 가 상수 \(k - \bar x\) 라서 집단 안의 합이 \(\sum_{i \in k}(y_i - \bar y) = n_k(\bar y_k - \bar y)\) 로 줄기 때문이다. 그러므로 정수 코딩의 기울기는 세 집단평균과 세 집단크기만 알면 계산된다. 개별 관측값은 필요 없다.
\(R^2 = \operatorname{corr}(x, y)^2\) 인 것은 설명변수가 하나이기 때문이다. 단순회귀에서만 성립하는 등식이고, 더미를 두 개 쓰는 보기 2에서는 쓸 수 없다.
(2) 해석적으로. 집단별로 상수를 자유롭게 고르는 모형은 각 집단에서 \(\sum_{i\in k}(y_i - c_k)^2\) 을 최소화하므로 \(c_k = \bar y_k\) 이고, 그 RSS 가 정의상 \(\text{WSS} = \sum_k \sum_{i \in k}(y_i - \bar y_k)^2\) 다. 정수 코딩 모형은 그 세 상수를 \(\hat\beta_0, \hat\beta_0 + \hat\beta_1, \hat\beta_0 + 2\hat\beta_1\) 로 등간격이 되도록 묶은 축소모형이므로
이고, 차이 \(\text{RSS}_{\text{정수}} - \text{WSS}\) 가 등간격 제약 때문에 설명하지 못하게 된 몫이다.
import numpy as np
import pandas as pd
from sklearn.linear_model import LinearRegression

rng = np.random.default_rng(0)
n = 900

# 세 도시. 효과에 순서가 없다: 부산이 가장 높고 서울이 가장 낮다.
city = rng.integers(0, 3, n)
CITY = ["서울", "부산", "대구"]
true = np.array([10.0, 16.0, 12.0])
y = true[city] + rng.normal(0, 2, n)

print("집단별 표본평균")
for k, name in enumerate(CITY):
    print(f"  {name}  n={np.sum(city == k):3d}  평균 {y[city == k].mean():7.4f}"
          f"   (참값 {true[k]:.1f})")

# 정수 코딩: 도시 이름을 0, 1, 2 로 바꿔 넣는다.
X_int = city.reshape(-1, 1).astype(float)
m_int = LinearRegression().fit(X_int, y)
print(f"\n정수 코딩 (서울=0, 부산=1, 대구=2)")
print(f"  기울기 {m_int.coef_[0]:+.4f}, 절편 {m_int.intercept_:.4f}, "
      f"R^2 {m_int.score(X_int, y):.4f}")
print(f"  예측값: 서울 {m_int.predict([[0]])[0]:.4f}, "
      f"부산 {m_int.predict([[1]])[0]:.4f}, "
      f"대구 {m_int.predict([[2]])[0]:.4f}")
출력:
집단별 표본평균
  서울  n=287  평균  9.9962   (참값 10.0)
  부산  n=286  평균 15.8841   (참값 16.0)
  대구  n=327  평균 11.9519   (참값 12.0)

정수 코딩 (서울=0, 부산=1, 대구=2)
  기울기 +0.8759, 절편 11.6630, R^2 0.0547
  예측값: 서울 11.6630, 부산 12.5389, 대구 13.4148
세 집단의 참 평균은 10, 16, 12다. 순서로 보면 서울 \(<\) 대구 \(<\) 부산이다.
정수 코딩은 서울 \(<\) 부산 \(<\) 대구 순으로 일정하게 오르는 직선을 강요한다. 기울기 \(0.8759\) 하나로 세 집단을 표현해야 하므로, 예측값이 \(11.66,\ 12.54,\ 13.41\)로 등간격으로 늘어선다. 실제 평균 \(10.0,\ 15.9,\ 12.0\)과 전혀 맞지 않는다.
\(R^2\)가 \(0.055\)다. 도시가 임금 분산의 60%를 설명하는 자료인데도(아래에서 확인한다) 5%밖에 잡지 못했다.
정수 코딩이 강요하는 두 가지 가정.
- 순서: \(0<1<2\)이므로 서울, 부산, 대구에 순서가 있다고 선언한 셈이다.
- 등간격: 서울\(\to\)부산의 효과와 부산\(\to\)대구의 효과가 같다고 선언한 셈이다.
둘 다 자료에 없는 정보다. 도시 이름을 붙이는 순서를 바꾸면 결과가 달라진다는 것이 그 증거다.
이제 (1)과 (2)의 유도를 수로 확인한다.
# 집단평균과 집단크기만으로 정수 코딩의 기울기를 계산한다.
counts = np.array([np.sum(city == k) for k in range(3)])
means = np.array([y[city == k].mean() for k in range(3)])
codes = np.arange(3.0)
x_bar, y_bar = (codes * counts).sum() / n, y.mean()
S_xy = (counts * (codes - x_bar) * (means - y_bar)).sum()
S_xx = (counts * (codes - x_bar) ** 2).sum()
print(f"x-bar = {x_bar:.6f},  y-bar = {y_bar:.4f}")
print(f"S_xy = {S_xy:.4f},  S_xx = {S_xx:.4f}")
print(f"S_xy / S_xx     = {S_xy / S_xx:.6f}   (sklearn 기울기 {m_int.coef_[0]:.6f})")
print(f"y-bar - b*x-bar = {y_bar - S_xy / S_xx * x_bar:.6f}   (sklearn 절편 {m_int.intercept_:.6f})")
print()
print(f"R^2          = {m_int.score(X_int, y):.6f}")
print(f"corr(x, y)^2 = {np.corrcoef(city, y)[0, 1] ** 2:.6f}")
print()
total_ss = ((y - y_bar) ** 2).sum()
within_ss = sum(((y[city == k] - means[k]) ** 2).sum() for k in range(3))
between_ss = (counts * (means - y_bar) ** 2).sum()
rss_int = ((y - m_int.predict(X_int)) ** 2).sum()
print(f"총 제곱합 TSS        = {total_ss:.4f}")
print(f"집단간 BSS           = {between_ss:.4f}   BSS/TSS = {between_ss / total_ss:.6f}")
print(f"집단내 WSS           = {within_ss:.4f}   (집단평균 모형의 RSS)")
print(f"정수 코딩의 RSS      = {rss_int:.4f}")
print(f"등간격 제약이 낸 손실 = {rss_int - within_ss:.4f}  "
      f"(= TSS 의 {(rss_int - within_ss) / total_ss:.4f})")
출력:
x-bar = 1.044444,  y-bar = 12.5778
S_xy = 536.2542,  S_xx = 612.2222
S_xy / S_xx     = 0.875914   (sklearn 기울기 0.875914)
y-bar - b*x-bar = 11.662986   (sklearn 절편 11.662986)

R^2          = 0.054742
corr(x, y)^2 = 0.054742

총 제곱합 TSS        = 8580.4087
집단간 BSS           = 5167.1933   BSS/TSS = 0.602208
집단내 WSS           = 3413.2155   (집단평균 모형의 RSS)
정수 코딩의 RSS      = 8110.6959
등간격 제약이 낸 손실 = 4697.4805  (= TSS 의 0.5475)
(1)의 유도가 소수 여섯째 자리까지 맞는다. 집단평균 세 개와 집단크기 세 개, 모두 여섯 개의 수로 계산한 \(S_{xy}/S_{xx} = 0.875914\) 가 sklearn 이 \(900\) 개 관측값으로 구한 기울기와 같고, 절편(intercept)도 \(11.662986\) 으로 같다. \(R^2\) 와 \(\operatorname{corr}(x,y)^2\) 도 \(0.054742\) 로 같다.
기울기가 양수로 나온 까닭도 이 식에서 읽힌다. \(\bar x = 1.0444\) 이므로 \(k - \bar x\) 는 서울 \(-1.044\), 부산 \(-0.044\), 대구 \(+0.956\) 이다. 집단평균의 편차는 서울 \(-2.58\), 부산 \(+3.31\), 대구 \(-0.63\) 이다. 곱해 더하면 서울 항이 \(287 \times (-1.0444) \times (-2.5816) = +773.8\) 로 크게 양수가 되고, 이것이 부산 항의 작은 음수(\(-42.0\))와 대구 항의 음수(\(-195.6\))를 압도해 합이 \(+536.25\) 가 된다. 곧 "서울이 코드도 작고 임금도 낮다"는 사실 하나가 기울기의 부호를 정했다. 부산이 가장 높다는 정보는 \(k - \bar x \approx 0\) 때문에 거의 반영되지 않는다. 코딩 순서를 바꾸면 이 계산이 전부 달라진다.
(2)의 손실이 \(4697.48\) 이다. 총 제곱합 \(8580.41\) 의 \(54.75\%\) 다. 집단평균 모형은 RSS 를 \(3413.22\) 까지 내리는데 정수 코딩은 \(8110.70\) 에서 멈추므로, 등간격 제약 하나가 자료의 변동 절반 이상을 설명 못 하게 만든다. 이것이 \(R^2\) 가 \(0.6022\) 에서 \(0.0547\) 로 떨어진 내용이다. 실제로 \(0.602208 - 0.054742 = 0.547466\) 이 위 비율과 같다.
요점을 바꿔 말하면 이렇다. 정수 코딩은 자료를 적게 쓴 것이 아니라 틀린 모양을 강요한 것이다. 자유도를 하나 아낀 대가가 아니고(집단평균 모형은 모수가 셋, 정수 코딩은 둘이니 하나 차이다), 그 하나를 잘못된 방향으로 묶은 결과다. \(\square\)
2. 더미 부호화와 기준범주¶
올바른 방법은 각 수준에 0/1 지시변수를 하나씩 주는 것이다. 이것을 더미변수(dummy variable) 또는 지시변수(indicator variable)라 한다.
수준이 \(k\)개면 더미를 \(k-1\)개 만들고, 빠진 하나를 기준범주(reference category)로 삼는다.
여기서 \(D_{\text{부산}}\)은 부산이면 1, 아니면 0이다. 서울은 두 더미가 모두 0인 경우로 표현되며, 이것이 기준범주다.
보기 2. 더미 계수는 기준범주와의 차이다. 서울을 기준범주로 삼고 부산·대구 더미 두 개를 넣는다.
(1) 절편과 더미 \(k-1\) 개만 있는 모형의 최소제곱 적합값이 각 집단의 표본평균(sample mean)임을 보이고, 따라서 \(\hat\beta_0 = \bar y_{\text{서울}}\), \(\hat\beta_j = \bar y_j - \bar y_{\text{서울}}\) 임을 보이시오.
(2) 이 모형의 \(R^2\) 가 \(\text{BSS}/\text{TSS}\) 와 같음을 보이고 \(0.6022\) 를 확인하시오. 같은 분해로 일원배치 \(F\) 통계량도 계산하시오.
풀이
(1) 해석적으로. 설계행렬의 열이 \(\mathbf 1,\ D_{\text{부산}},\ D_{\text{대구}}\) 세 개다. 어떤 관측값 \(i\) 의 적합값은
인데, \(i\) 가 서울이면 두 더미가 모두 \(0\) 이라 \(\hat y_i = \hat\beta_0\), 부산이면 \(\hat\beta_0 + \hat\beta_1\), 대구면 \(\hat\beta_0 + \hat\beta_2\) 다. 곧 적합값은 집단 안에서 상수이고, 세 상수 \((c_0, c_1, c_2) = (\hat\beta_0,\ \hat\beta_0+\hat\beta_1,\ \hat\beta_0+\hat\beta_2)\) 는 세 모수와 일대일 대응이므로 서로 독립적으로 아무 값이나 가질 수 있다.
따라서 최소화 문제가 집단별로 쪼개진다.
각 항은 \(c_k\) 하나에만 의존하고, \(\sum_{i\in k}(y_i - c)^2\) 는 \(c = \bar y_k\) 에서 최소다(미분해 \(2\sum_{i\in k}(c - y_i) = 0\)). 그러므로 \(c_k = \bar y_k\) 이고 되돌리면
이다. 더미 부호화는 집단평균을 다시 좌표만 바꿔 적은 것이다.
(2) 해석적으로. (1)에서 적합값이 \(\bar y_k\) 이므로
이고, 분산분석의 제곱합 분해 \(\text{TSS} = \text{BSS} + \text{WSS}\) 를 쓰면
이다. 같은 두 제곱합을 각자의 자유도로 나누어 비를 만들면 일원배치 \(F\) 다.
# 첫 열(서울)을 빼서 서울을 기준범주로 삼는다.
D = np.eye(3)[city][:, 1:]
m_d = LinearRegression().fit(D, y)

print(f"더미 부호화 (기준 = 서울)")
print(f"  절편 {m_d.intercept_:.4f}  = 서울 평균")
for k, name in enumerate(CITY[1:], 1):
    print(f"  {name} 더미 계수 {m_d.coef_[k - 1]:+.4f}"
          f"  = {name} 평균 - 서울 평균 "
          f"= {y[city == k].mean() - y[city == 0].mean():+.4f}")
print(f"  R^2 {m_d.score(D, y):.4f}")
출력:
더미 부호화 (기준 = 서울)
  절편 9.9962  = 서울 평균
  부산 더미 계수 +5.8878  = 부산 평균 - 서울 평균 = +5.8878
  대구 더미 계수 +1.9557  = 대구 평균 - 서울 평균 = +1.9557
  R^2 0.6022
\(R^2\)가 \(0.055\)에서 \(0.602\)로 올랐다. 같은 자료, 같은 변수인데 부호화만 바꾼 결과다.
계수의 뜻이 아주 단순하다.
| 항 | 값 | 뜻 |
|---|---|---|
| 절편 \(\beta_0\) | 9.9962 | 기준범주(서울)의 평균 |
| \(\beta_{\text{부산}}\) | \(+5.8878\) | 부산 평균 \(-\) 서울 평균 |
| \(\beta_{\text{대구}}\) | \(+1.9557\) | 대구 평균 \(-\) 서울 평균 |
더미만 있는 회귀는 집단평균을 그대로 되살린다. 절편이 기준집단의 평균이고, 각 계수가 기준과의 차이다. 예측값은 \(9.9962,\ 15.8841,\ 11.9519\)로 표본평균과 정확히 같다.
분산분석과 같은 모형이다
범주형 설명변수 하나만 넣은 회귀는 일원배치 분산분석(one-way analysis of variance)과 완전히 같은 모형이다. \(F\) 통계량도 같다. 10장 분산분석이 같은 모형을 분산분석의 언어로 먼저 적어 두었다 — 거기서 쓰던 이름들(집단간·집단내 제곱합, \(\eta^2\))이 이제 선형모형의 어느 자리에 해당하는지 여기서 드러난다.
계수에 붙는 \(p\) 값이 묻는 것도 달라진다. \(\beta_{\text{부산}}\)의 \(p\) 값은 "부산과 서울이 다른가"를 묻지, "부산이 전체 평균과 다른가"를 묻지 않는다. 기준범주가 무엇인지 모르면 계수를 읽을 수 없다.
(1)과 (2)의 유도를 수로 확인한다.
# 더미 모형의 예측값이 집단평균인지, R^2 가 BSS/TSS 인지 확인한다.
from scipy import stats

fitted = m_d.predict(D)
print("예측값이 집단평균과 같은가")
for k, name in enumerate(CITY):
    print(f"  {name}  예측 {fitted[city == k][0]:.6f}   평균 {y[city == k].mean():.6f}"
          f"   차이 {abs(fitted[city == k][0] - y[city == k].mean()):.2e}")
print(f"  예측값이 집단 안에서 모두 같은가? "
      f"{all(np.ptp(fitted[city == k]) < 1e-12 for k in range(3))}")
print()
rss_dummy = ((y - fitted) ** 2).sum()
print(f"더미 모형의 RSS = {rss_dummy:.4f}   WSS = {within_ss:.4f}"
      f"   차이 {abs(rss_dummy - within_ss):.2e}")
print(f"R^2 = 1 - RSS/TSS = {1 - rss_dummy / total_ss:.6f}")
print(f"      BSS/TSS     = {between_ss / total_ss:.6f}")
print()
F = (between_ss / 2) / (within_ss / (n - 3))
print(f"일원배치 F = (BSS/2) / (WSS/(n-3)) = {F:.4f}")
print(f"  p 값 = {stats.f.sf(F, 2, n - 3):.4g}   (자유도 2, {n - 3})")
출력:
예측값이 집단평균과 같은가
  서울  예측 9.996228   평균 9.996228   차이 1.60e-14
  부산  예측 15.884073   평균 15.884073   차이 4.62e-14
  대구  예측 11.951942   평균 11.951942   차이 2.66e-14
  예측값이 집단 안에서 모두 같은가? True

더미 모형의 RSS = 3413.2155   WSS = 3413.2155   차이 4.55e-13
R^2 = 1 - RSS/TSS = 0.602208
      BSS/TSS     = 0.602208

일원배치 F = (BSS/2) / (WSS/(n-3)) = 678.9745
  p 값 = 2.79e-180   (자유도 2, 897)
(1)이 그대로 확인된다. 세 집단의 예측값이 집단평균과 \(10^{-14}\) 안에서 같고, 집단 안에서는 예측값이 모두 같은 하나의 수다(True). 적합값이 집단평균이라는 것은 근사가 아니라 대수적 항등식이며, 불일치는 부동소수점 한계다.
(2)도 닫힌다. 더미 모형의 RSS 가 \(3413.2155\) 로 보기 1에서 센 WSS 와 같고, \(1 - \text{RSS}/\text{TSS}\) 와 \(\text{BSS}/\text{TSS}\) 가 모두 \(0.602208\) 이다. \(F = 678.97\) 에 \(p = 2.8\times10^{-180}\) 이니 세 도시의 평균이 같다는 가설은 압도적으로 기각된다. 이 \(F\) 는 10장의 일원배치 분산분석이 같은 자료에 주는 값과 같은 수다. 분자자유도가 \(k - 1 = 2\), 분모자유도가 \(n - k = 897\) 인 것도 두 틀에서 같다.
유의성이 이토록 강한 것은 집단이 큰 덕이다. 집단마다 \(300\) 명쯤 있고 집단간 차이가 \(5.89\) 인데 집단내 표준편차는 \(\sqrt{3413.2155/897} = 1.95\) 다. 효과크기(effect size)가 표준편차의 세 배이니 \(900\) 개로 못 잡을 수가 없다. 보기 1의 정수 코딩이 이 신호를 \(R^2 = 0.055\) 로 뭉갰다는 것이 그만큼 더 뼈아프다. 신호는 자료에 있었고, 부호화가 그것을 버린 것이다. \(\square\)
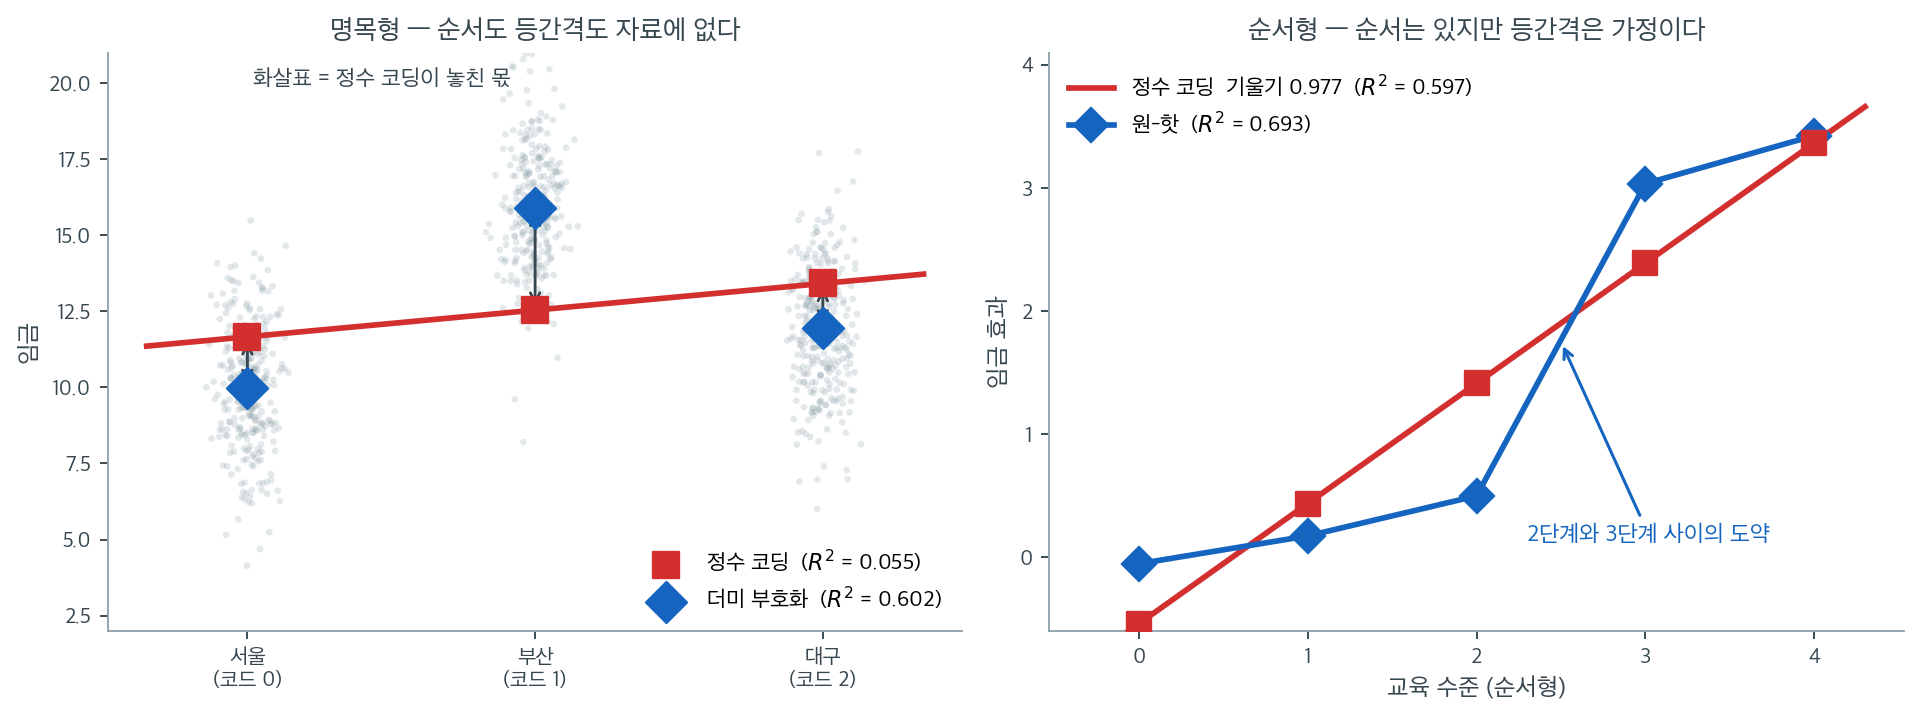
왼쪽이 보기 1과 보기 2를 한 장에 겹친 것이다. 회색 점 구름이 세 도시의 임금이고, 붉은 정사각형이 정수 코딩의 예측값, 파란 마름모가 더미 부호화의 예측값이다. 파란 마름모는 각 구름의 한가운데에 정확히 앉는다. 더미 부호화가 집단평균 \(9.9962\), \(15.8841\), \(11.9519\)를 그대로 되살리기 때문이다. 반면 붉은 정사각형은 직선 위에 등간격으로 늘어서서 \(11.663\), \(12.539\), \(13.415\)가 된다. 부산 구름의 한가운데는 \(15.88\)인데 예측은 \(12.54\)이고, 서울 구름의 한가운데는 \(9.996\)인데 예측은 \(11.66\)이다. 각 도시마다 그어 놓은 검은 화살표의 길이가 정수 코딩이 놓친 몫이며, 그 길이들이 모여 \(R^2\)을 \(0.602\)에서 \(0.055\)로 끌어내린다.
왜 이런 일이 일어나는지도 그림에 그대로 있다. 붉은 점 세 개는 한 직선 위에 있어야만 한다. 기울기 하나로 세 집단을 표현하기로 한 순간, 세 예측값은 \(\hat\beta_0,\ \hat\beta_0+\hat\beta_1,\ \hat\beta_0+2\hat\beta_1\)로 등간격이 될 수밖에 없다. 참 평균 \(10, 16, 12\)는 등간격도 아니고 코드 순서대로 오르지도 않으므로, 이 직선은 애초에 자료를 표현할 수 없는 모양이다. 더미 부호화는 계수를 두 개 쓰는 대신 세 점을 어디에든 놓을 수 있다.
오른쪽은 뒤에서 다룰 순서형의 경우를 미리 보인 것이다. 교육 수준 다섯 단계의 참 효과는 \(0,\ 0.2,\ 0.5,\ 3.0,\ 3.4\)로 \(2\)단계와 \(3\)단계 사이에서 크게 도약한다. 파란 꺾은선(원–핫)은 그 도약을 그대로 따라가 \(0.226,\ 0.552,\ 3.090,\ 3.480\)을 되찾지만, 붉은 직선(정수 코딩)은 기울기 \(0.977\) 하나로 도약을 평평하게 뭉갠다. \(R^2\)이 \(0.693\) 대 \(0.598\)로 갈린다. 다만 여기서는 명목형과 달리 정수 코딩도 방향은 맞힌다. 순서가 실제로 있기 때문이다. 깨지는 것은 등간격 가정뿐이며, 그래서 손해도 \(0.055\) 대 \(0.602\)만큼 크지는 않다. 순서형에서 정수 코딩이 여전히 선택지로 남아 있는 이유가 이 차이에 있다.
3. 더미변수 함정¶
더미를 \(k-1\)개가 아니라 \(k\)개 전부 넣으면 어떻게 되는가. 직관적으로는 더 많은 정보를 주는 것 같지만, 실제로는 모형이 망가진다.
보기 3. 더미를 전부 넣으면 해가 유일하지 않다. 절편과 더미 \(3\)개를 모두 넣은 설계행렬의 계수와 해를 살펴본다.
(1) 벡터 \(\mathbf v = (1, -1, -1, -1)^\top\) 가 \(X\) 의 영공간(null space, \(X\mathbf u = \mathbf 0\) 인 벡터 \(\mathbf u\) 전체)에 있음을 보이고, 영공간의 차원이 \(1\) 임을 보이시오. 따라서 모든 최소제곱해가 \(\hat b + t\,\mathbf v\) 꼴임을 보이시오.
(2) np.linalg.lstsq 가 돌려주는 해는 그 직선 위의 어느 점인가. 식별되지 않는 것이 개별 계수라면, 식별되는 것은 무엇인가.
풀이
(1) 해석적으로. \(X\) 의 네 열은 \(\mathbf 1,\ D_{\text{서울}},\ D_{\text{부산}},\ D_{\text{대구}}\) 다. \(i\) 번째 행에서 세 더미 가운데 정확히 하나가 \(1\) 이므로
이다. 모든 \(i\) 에서 \(0\) 이니 \(X\mathbf v = \mathbf 0\), 곧 \(\mathbf v \in \mathcal N(X)\) 다. 이것이 바로 아래에 적을 등식 \(D_{\text{서울}} + D_{\text{부산}} + D_{\text{대구}} = \mathbf 1\) 을 영벡터 쪽으로 옮겨 적은 것이다.
차원을 세려면 계수를 보아야 한다. 세 집단이 모두 비어 있지 않으면 세 더미 열은 서로 직교하는 영 아닌 벡터이므로 일차독립이고, \(\mathbf 1\) 이 그 합이므로 \(\operatorname{rank}(X) = 3\) 이다. 계수–퇴화차수 정리(rank–nullity theorem, 계수와 영공간의 차원을 더하면 열의 개수가 된다)에서
이고, 영공간이 \(\mathbf v\) 하나로 생성된다. 최소제곱해는 정규방정식(normal equations) \(X^TX\,b = X^Ty\) 의 해이고, 해집합은 특수해 하나에 영공간을 더한 아핀 집합이다. 따라서 모든 해가 \(\hat b + t\,\mathbf v\) 꼴이다. 해가 하나가 아니라 직선 하나만큼 있다.
(2) 해석적으로. lstsq 는 특이값분해(singular value decomposition)에 기반한 유사역행렬(pseudoinverse)을 쓰므로 최소노름해(minimum-norm solution), 곧 해 가운데 길이가 가장 짧은 것을 돌려준다. 곧 \(\|\hat b + t\mathbf v\|\) 를 최소로 하는 \(t\) 를 고른 것이고, 그 조건은 미분해서
이므로 돌려주는 해는 \(\mathbf v\) 와 직교한다(\(\hat b\cdot\mathbf v = 0\)). 여기서는 \(\beta_0 - \beta_{\text{서울}} - \beta_{\text{부산}} - \beta_{\text{대구}} = 0\) 이라는 제약이 분석자가 고르지도 않았는데 걸리는 셈이다.
식별되는 것은 적합값이 결정하는 선형결합뿐이다. 적합값은 \(\beta_0 + \beta_k\) 이므로 세 합 \(\beta_0 + \beta_{\text{서울}}\), \(\beta_0 + \beta_{\text{부산}}\), \(\beta_0 + \beta_{\text{대구}}\) 가 식별되고, 그 차 \(\beta_{\text{부산}} - \beta_{\text{서울}}\) 등도 식별된다. 기준범주 부호화가 보고하는 양이 바로 이 차들이다. 그래서 기준범주를 빼는 것이 임의의 선택이면서도 해를 잃지 않는 선택이다.
full = np.eye(3)[city]                        # 더미 3개 전부
X_bad = np.column_stack([np.ones(n), full])   # 절편 + 더미 3개
X_ok = np.column_stack([np.ones(n), full[:, 1:]])

print(f"절편 + 더미 3개 : 열 {X_bad.shape[1]}개, 계수(rank) "
      f"{np.linalg.matrix_rank(X_bad)}")
print(f"절편 + 더미 2개 : 열 {X_ok.shape[1]}개, 계수(rank) "
      f"{np.linalg.matrix_rank(X_ok)}")
print(f"\n더미 3개의 합이 절편 열과 같은가?  "
      f"{np.allclose(full.sum(axis=1), 1.0)}")

# 해가 유일하지 않다는 것을 직접 보인다.
b1, *_ = np.linalg.lstsq(X_bad, y, rcond=None)
shift = np.array([1.0, -1.0, -1.0, -1.0])     # 절편 +1, 더미 전부 -1
b2 = b1 + shift

print(f"\n해 1: {np.round(b1, 4)}")
print(f"해 2: {np.round(b2, 4)}")
print(f"두 해의 예측이 같은가? {np.allclose(X_bad @ b1, X_bad @ b2)}")
print(f"잔차제곱합  해1 {np.sum((y - X_bad @ b1) ** 2):.4f}   "
      f"해2 {np.sum((y - X_bad @ b2) ** 2):.4f}")
출력:
절편 + 더미 3개 : 열 4개, 계수(rank) 3
절편 + 더미 2개 : 열 3개, 계수(rank) 3

더미 3개의 합이 절편 열과 같은가?  True

해 1: [9.4581 0.5382 6.426  2.4939]
해 2: [10.4581 -0.4618  5.426   1.4939]
두 해의 예측이 같은가? True
잔차제곱합  해1 3413.2155   해2 3413.2155
열이 4개인데 계수가 3이다. 설계행렬이 완전공선(perfect collinearity)이며, 원인은 한 줄로 말할 수 있다.
세 더미를 더하면 절편 열이 그대로 나온다. 절편이 이미 담고 있는 정보를 더미들이 한 번 더 담는 것이다.
결과는 해의 비유일성이다. 위 출력에서 계수가 전혀 다른 두 벡터가 똑같은 예측과 똑같은 잔차제곱합을 준다. 절편을 1 올리고 더미 계수를 모두 1 내리면 예측이 변하지 않기 때문이다.
이것이 더미변수 함정(dummy variable trap)이다. \(\beta\)를 해석할 수 없게 된다 — 어떤 수를 보고해야 할지 정할 방법이 없다.
대처는 셋 중 하나다.
| 방법 | 내용 |
|---|---|
| 기준범주 빼기 | 더미를 \(k-1\)개만 넣는다. 가장 흔한 방법 |
| 절편 빼기 | 더미 \(k\)개를 다 넣되 절편을 없앤다. 계수가 각 집단의 평균이 된다 |
| 제약 걸기 | 효과 부호화처럼 계수의 합을 0으로 고정한다(연습문제 3) |
소프트웨어는 대개 알아서 처리한다. statsmodels 의 C(city) 나 pandas.get_dummies(drop_first=True) 가 기준범주를 빼 준다. 다만 직접 설계행렬을 만들 때는 반드시 확인해야 한다. numpy.linalg.lstsq 는 경고 없이 최소노름해를 돌려주므로 문제를 눈치채지 못할 수 있다.
(1)과 (2)를 수로 확인한다.
# 영공간을 확인하고, lstsq 가 어느 해를 고르는지 본다.
print(f"X_bad @ shift 의 절대값 최댓값 = {np.abs(X_bad @ shift).max():.2e}"
      f"   (0 이면 shift 가 영공간에 있다)")
print(f"영공간의 차원 = 열 {X_bad.shape[1]}개 - rank {np.linalg.matrix_rank(X_bad)} = "
      f"{X_bad.shape[1] - np.linalg.matrix_rank(X_bad)}")
print()
print(f"해 1 의 노름 = {np.linalg.norm(b1):.6f}")
print(f"해 2 의 노름 = {np.linalg.norm(b2):.6f}")
print(f"해 1 과 shift 의 내적 = {b1 @ shift:.2e}   (0 이면 최소노름해다)")
norms = [(t, np.linalg.norm(b1 + t * shift)) for t in np.linspace(-2, 2, 401)]
t_best = min(norms, key=lambda p: p[1])[0]
print(f"노름을 최소로 하는 t = {t_best:.4f}")
print()
print("식별되지 않는 것: 개별 계수.  식별되는 것: 절편 + 더미 계수의 합")
for k, name in enumerate(CITY):
    print(f"  {name}  해1 {b1[0] + b1[k + 1]:.6f}   해2 {b2[0] + b2[k + 1]:.6f}"
          f"   집단평균 {y[city == k].mean():.6f}")
print()
print("차이도 식별된다 (기준범주 부호화가 쓰는 양)")
print(f"  부산 - 서울  해1 {b1[2] - b1[1]:+.6f}   해2 {b2[2] - b2[1]:+.6f}")
print(f"  대구 - 서울  해1 {b1[3] - b1[1]:+.6f}   해2 {b2[3] - b2[1]:+.6f}")
출력:
X_bad @ shift 의 절대값 최댓값 = 0.00e+00   (0 이면 shift 가 영공간에 있다)
영공간의 차원 = 열 4개 - rank 3 = 1

해 1 의 노름 = 11.715699
해 2 의 노름 = 11.885185
해 1 과 shift 의 내적 = 1.55e-14   (0 이면 최소노름해다)
노름을 최소로 하는 t = 0.0000

식별되지 않는 것: 개별 계수.  식별되는 것: 절편 + 더미 계수의 합
  서울  해1 9.996228   해2 9.996228   집단평균 9.996228
  부산  해1 15.884073   해2 15.884073   집단평균 15.884073
  대구  해1 11.951942   해2 11.951942   집단평균 11.951942

차이도 식별된다 (기준범주 부호화가 쓰는 양)
  부산 - 서울  해1 +5.887845   해2 +5.887845
  대구 - 서울  해1 +1.955714   해2 +1.955714
(1)이 정확히 확인된다. \(X\mathbf v\) 의 절댓값 최댓값이 \(0\) 이니 반올림조차 없이 영벡터다(세 더미의 합이 정확히 \(1\) 이고 모두 \(0\) 또는 \(1\) 이므로 부동소수점 오차가 생기지 않는다). 영공간의 차원도 \(4 - 3 = 1\) 이다.
(2) lstsq 가 돌려준 해가 최소노름해다. 내적 \(\hat b\cdot\mathbf v\) 가 \(1.55\times10^{-14}\) 로 \(0\) 이고, \(t\) 를 격자로 훑어 노름을 재면 최소가 \(t = 0\) 에서 잡힌다. 실제로 해 1 의 노름 \(11.715699\) 가 해 2 의 \(11.885185\) 보다 작다. 곧 lstsq 는 아무 해나 주는 것이 아니라 원점에 가장 가까운 해를 주는데, 이 선택에는 통계적 근거가 없다. 다른 소프트웨어는 다른 해를 줄 수 있고, 그래서 보고된 계수를 비교할 수가 없다.
식별되는 양은 두 해에서 소수 여섯째 자리까지 같다. 절편과 더미 계수의 합이 세 집단평균 \(9.996228\), \(15.884073\), \(11.951942\) 와 정확히 같고, 차이 \(+5.887845\), \(+1.955714\) 도 양쪽에서 같다. 이 두 수가 보기 2에서 기준범주 부호화가 보고한 바로 그 계수다.
그러므로 더미변수 함정의 정체는 "정보를 잃는 것"이 아니라 "좌표를 정하지 못하는 것" 이다. 예측도 잔차제곱합도 \(R^2\) 도 멀쩡하다. 망가지는 것은 계수의 해석뿐이고, 기준범주를 빼는 일은 그 해석할 좌표를 하나 정해 주는 일이다. \(\square\)
그림으로 보는 통계학 1. 기준범주는 최소제곱에서만 무해하다
§\(2\) 가 기준범주를 정하는 법을 다루고 연습문제 \(1\) 이 그 결론을 못박았다 — 기준을 바꾸면 계수는 바뀌지만 모형은 바뀌지 않는다. 적합값도 \(R^2\) 도 그대로다. 그래서 어느 범주를 기준으로 삼을지는 읽기 편한 쪽으로 고르면 되는, 취향의 문제처럼 보인다.
그 말에 조건이 하나 붙어 있다는 것이 이 상자의 내용이다. 최소제곱일 때만 그렇다.
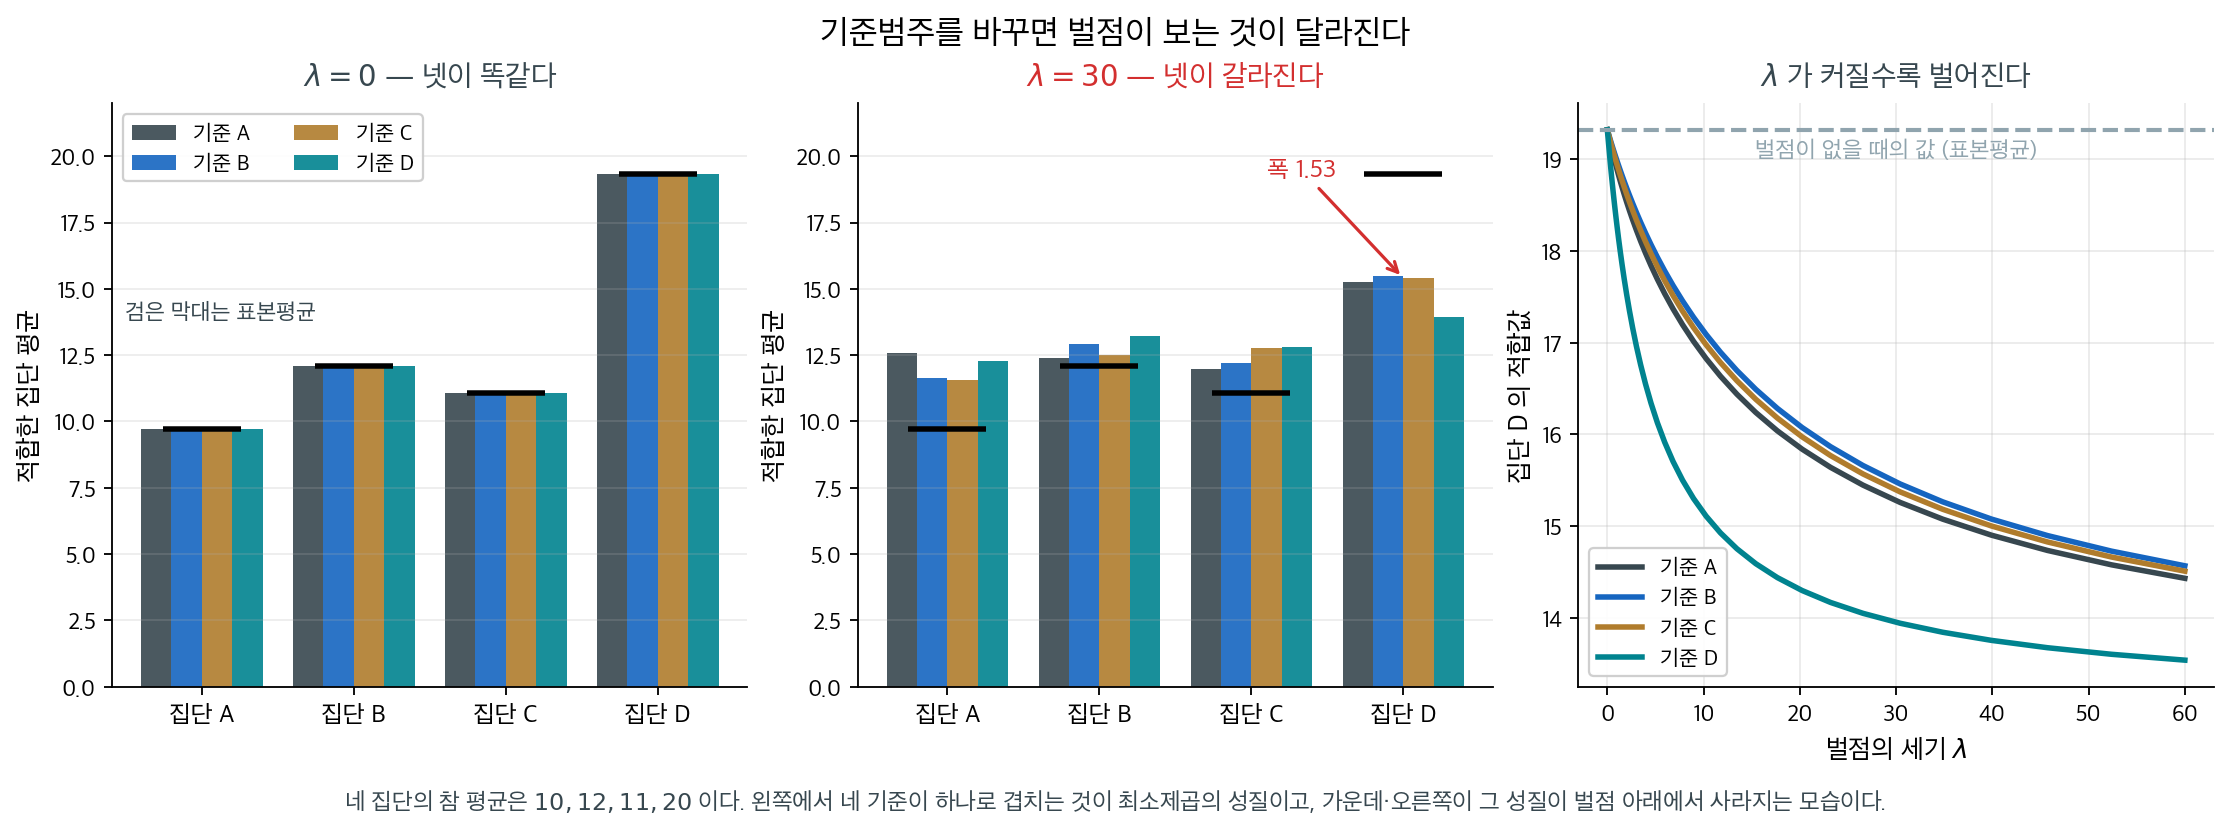
네 집단의 참 평균을 \(10, 12, 11, 20\) 으로 두었다. 왼쪽에서 네 막대가 하나로 겹치는 것이 §\(2\) 가 말한 성질이고, 가운데가 그 성질이 벌점 아래에서 사라지는 모습이다. 자료에서 직접 그렸다.
까닭은 벌점이 무엇을 보는지에 있다. 능형이나 라쏘는 계수벡터의 크기를 벌하는데, 기준을 바꾸면 같은 모형이 다른 크기의 계수벡터로 적힌다. 위 자료에서 벌점항 \(\sum_{j\ne 0}\hat\beta_j^2\) 을 재어 보면 이렇다.
| 기준범주 | 나머지 셋의 계수 | 벌점항 (\(\lambda = 0\)) |
|---|---|---|
| A (표본평균 \(9.74\)) | \(+2.37,\ +1.35,\ +9.58\) | \(99.3\) |
| B (표본평균 \(12.10\)) | \(-2.37,\ -1.02,\ +7.22\) | \(58.7\) |
| C (표본평균 \(11.08\)) | \(-1.35,\ +1.02,\ +8.24\) | \(70.7\) |
| D (표본평균 \(19.32\)) | \(-9.58,\ -7.22,\ -8.24\) | \(211.8\) |
같은 모형인데 벌점이 \(58.7\) 에서 \(211.8\) 까지 네 배 가까이 차이가 난다. 기준을 가장 동떨어진 집단 D 로 잡으면 나머지 셋이 모두 큰 음수가 되어 벌점이 가장 커지고, 그래서 그렇게 적어 놓은 쪽이 가장 세게 눌린다. 가운데 그림에서 기준 D 의 막대(청록)가 집단 D 에서 혼자 낮게 주저앉은 것이 그 자국이다. \(\lambda = 30\) 에서 집단 D 의 적합값이 기준에 따라 \(13.95\) 에서 \(15.48\) 까지 \(1.53\) 만큼 벌어진다.
그러니 「기준은 아무거나」는 벌점이 붙는 순간 틀린 말이 된다. \(18\) 장의 능형·라쏘를 범주형 변수에 쓸 때 이것이 실제 문제가 되고, 대처하는 길이 알려져 있다.
- 범주 전체를 묶어서 벌한다 — 한 변수의 더미들을 한 덩어리로 넣고 빼는 그룹 라쏘가 그것이다. 묶어 놓으면 기준을 어떻게 잡든 결과가 같아진다.
- 기준을 두지 않는 부호화를 쓴다 — 효과 부호화(합이 \(0\) 이 되게 적는 법)는 특정 범주를 특별 취급하지 않아 대칭이다.
- 그것도 저것도 아니면 적어도 기준이 무엇이었는지 보고한다. 재현하려는 사람이 같은 \(\lambda\) 로 다른 답을 얻게 되기 때문이다.
같은 이야기가 한 줄 더 있다. 표준화도 마찬가지다. 더미변수를 표준화하면 드문 범주의 더미가 크게 부풀어 벌점을 덜 받게 되는데, 이것 역시 최소제곱에서는 생기지 않던 일이다. 벌점은 계수를 보는 것이 아니라 계수가 적힌 방식을 본다.
확인한 곳 — 최소제곱의 적합값이 기준범주 선택에 불변이라는 것은 같은 열공간을 다른 기저로 적은 것뿐이기 때문이고, 벌점항은 기저에 의존하므로 능형·라쏘에서는 그 불변성이 깨진다 · 범주형 변수를 묶어 벌하는 그룹 라쏘와 효과 부호화가 그 대처로 쓰인다는 것도 표준적이다 · 표의 벌점항과 그림의 수치는 집단마다 \(20\) 개씩 만든 자료로 이 쪽이 직접 쟀다
4. 순서형은 어떻게 할 것인가¶
명목형에 정수를 매기면 안 된다는 것은 분명하다. 그런데 순서형은 사정이 다르다. "불만족 \(<\) 보통 \(<\) 만족 \(<\) 매우 만족"에는 순서가 실제로 있다.
그렇다면 정수 코딩이 괜찮은가. 순서는 맞지만 등간격은 여전히 가정이라는 것이 답이다. 정수 \(0,1,2,3\)을 쓰면 "불만족\(\to\)보통"의 효과와 "만족\(\to\)매우 만족"의 효과가 같다고 선언하게 된다.
어느 쪽을 택할지는 절충이다.
| 정수 코딩 | 원–핫(더미) | |
|---|---|---|
| 모수 개수 | 1개 | \(k-1\)개 |
| 순서 정보 | 쓴다 | 버린다 |
| 등간격 가정 | 강제 | 없음 |
| 수준이 많을 때 | 유리 | 자유도를 많이 쓴다 |
원–핫 모형은 "매우 만족"이 "만족"보다 높다는 사실조차 모른다. 순서를 버리는 대신 어떤 모양이든 표현할 수 있다.
등간격 가정이 깨졌을 때 정수 코딩이 무엇을 놓치는지는 연습문제 2에서 수치로 확인한다.
연습문제¶
연습문제 1. 보기 2에서 서울을 기준범주로 삼았다. 기준범주를 바꾸면 계수가 어떻게 달라지는가? 모형의 무엇이 바뀌고 무엇이 바뀌지 않는지 확인하라.
풀이
print("기준범주를 바꾸면")
for ref in range(3):
    keep = [k for k in range(3) if k != ref]
    D = np.eye(3)[city][:, keep]
    m = LinearRegression().fit(D, y)
    parts = ", ".join(f"{CITY[k]} {c:+.4f}" for k, c in zip(keep, m.coef_))
    print(f"  기준={CITY[ref]:3s} 절편 {m.intercept_:8.4f} | {parts} "
          f"| R^2 {m.score(D, y):.4f}")

print("\n어느 기준을 쓰든 예측 집단평균은 같다")
for ref in range(3):
    keep = [k for k in range(3) if k != ref]
    D = np.eye(3)[city][:, keep]
    m = LinearRegression().fit(D, y)
    mu = {ref: m.intercept_}
    for k, c in zip(keep, m.coef_):
        mu[k] = m.intercept_ + c
    print(f"  기준={CITY[ref]:3s} " +
          ", ".join(f"{CITY[k]} {mu[k]:.4f}" for k in range(3)))
기준범주를 바꾸면
  기준=서울  절편   9.9962 | 부산 +5.8878, 대구 +1.9557 | R^2 0.6022
  기준=부산  절편  15.8841 | 서울 -5.8878, 대구 -3.9321 | R^2 0.6022
  기준=대구  절편  11.9519 | 서울 -1.9557, 부산 +3.9321 | R^2 0.6022

어느 기준을 쓰든 예측 집단평균은 같다
  기준=서울  서울 9.9962, 부산 15.8841, 대구 11.9519
  기준=부산  서울 9.9962, 부산 15.8841, 대구 11.9519
  기준=대구  서울 9.9962, 부산 15.8841, 대구 11.9519
바뀌는 것: 절편과 계수의 값·부호. 기준이 서울일 때 부산 계수는 \(+5.89\)인데, 기준이 부산이면 서울 계수가 \(-5.89\)다.
바뀌지 않는 것: 적합값, 잔차, \(R^2\). 세 경우 모두 \(R^2=0.6022\)이고 예측 집단평균이 동일하다.
같은 모형을 다른 좌표로 적은 것이기 때문이다. 기준범주를 고르는 것은 어느 집단을 원점으로 둘지 정하는 일이며, 모형이 설명하는 내용 자체는 달라지지 않는다.
그래서 기준범주는 해석의 편의로 고른다.
- 대조군, 표준 처리, 가장 흔한 범주를 기준으로 두면 계수가 "표준 대비 효과"로 읽힌다.
- 표본이 아주 적은 범주는 기준으로 쓰지 않는다. 모든 계수가 그 범주의 잡음을 함께 짊어지게 된다.
주의. 계수의 \(p\) 값도 기준범주에 따라 달라진다. "부산이 유의하다"는 말은 "서울과 비교해 유의하다"는 뜻이지 부산이 특별하다는 뜻이 아니다. 모든 쌍을 비교하려면 다중검정 보정이 필요하다. \(\square\)
연습문제 2. 순서형 변수를 회귀에 넣을 때 정수 코드를 그대로 쓰는 것과 원–핫으로 푸는 것이 어떻게 다른가? 효과가 등간격이 아닐 때 무슨 일이 일어나는지 수치로 보여라.
풀이
import numpy as np
from sklearn.linear_model import LinearRegression

rng = np.random.default_rng(1)
n_edu = 6000
level = rng.integers(0, 5, n_edu)                 # 교육수준 5단계
true_edu = np.array([0.0, 0.2, 0.5, 3.0, 3.4])    # 임금 효과 — 등간격이 아니다
y_edu = true_edu[level] + rng.normal(0, 1, n_edu)

X_int = level.reshape(-1, 1).astype(float)        # 정수 인코딩
X_hot = np.eye(5)[level][:, 1:]                   # 원-핫 (기준 범주 제외)

for name, X in [("정수 인코딩", X_int), ("원-핫 인코딩", X_hot)]:
    m = LinearRegression().fit(X, y_edu)
    print(f"{name:>14}: R^2 {m.score(X, y_edu):.4f}"
          f"   계수 {np.round(m.coef_, 3)}")
print(f"{'참 효과':>14}: (기준 대비) {np.round(true_edu - true_edu[0], 3)}")
        정수 인코딩: R^2 0.5975   계수 [0.977]
       원-핫 인코딩: R^2 0.6933   계수 [0.226 0.552 3.09  3.48 ]
          참 효과: (기준 대비) [0.  0.2 0.5 3.  3.4]
정수 코딩은 계수 하나만 준다(\(0.977\)). "한 단계 오를 때마다 임금이 \(0.98\)씩 오른다"는 뜻인데, 참 효과는 \(0.2, 0.5, 3.0, 3.4\)로 \(2\)단계와 \(3\)단계 사이에서 크게 도약한다. 이 구조가 평균 기울기 하나로 뭉개졌다.
원–핫은 각 수준을 따로 추정해 참 효과를 그대로 되찾는다(\(0.226, 0.552, 3.09, 3.48\)). \(R^2\)도 \(0.598\)에서 \(0.693\)으로 오른다.
정수 코딩이 강제하는 가정은 두 가지다.
- 등간격: 인접한 두 수준의 차이가 모두 같다.
- 단조성과 선형성: 효과가 수준에 대해 직선으로 변한다.
보기 1에서 본 가정이 여기서는 회귀계수(regression coefficient)의 형태로 나타난다.
그렇다고 원–핫이 언제나 옳은 것은 아니다.
| 상황 | 권장 |
|---|---|
| 수준이 적고 자료가 충분하다 | 원–핫 |
| 수준이 많고(예: \(10\)단계) 자료가 적다 | 정수 또는 소수의 그룹 |
| 효과가 정말 단조·선형이라고 믿을 근거가 있다 | 정수 (모수가 적어 유리) |
| 순서를 보존하면서 유연하게 | 단조 제약 회귀, 스플라인 |
원–핫의 대가는 자유도다. 수준이 \(k\)개면 \(k-1\)개의 계수를 추정해야 하고, 순서 정보를 버린다. 원–핫 모형은 "매우 만족"이 "만족"보다 높다는 사실조차 모른다.
진단하는 법. 정수 코딩으로 적합한 뒤 잔차를 수준별로 평균 내 보라. 체계적인 패턴이 남아 있으면 등간격 가정이 깨진 것이다. 위 예에서는 \(3\)단계 이상에서 잔차가 크게 양수로 나온다. \(\square\)
연습문제 3. 더미변수 함정을 피하는 또 다른 방법이 효과 부호화(effect coding)다. 기준범주를 \(-1\)로 두어 계수의 합이 \(0\)이 되게 한다. 이때 절편과 계수가 무엇을 뜻하는지 확인하라.
풀이
# 효과 부호화: 부산 -> (1,0), 대구 -> (0,1), 서울(기준) -> (-1,-1)
E = np.zeros((n, 2))
E[city == 1, 0] = 1
E[city == 2, 1] = 1
E[city == 0, :] = -1

m = LinearRegression().fit(E, y)
group_means = [y[city == k].mean() for k in range(3)]

print(f"절편 {m.intercept_:.4f}")
print(f"  세 집단 평균의 평균 {np.mean(group_means):.4f}")
print(f"계수 {np.round(m.coef_, 4)}   (부산, 대구)")
print(f"  서울 효과 = -(계수의 합) = {-m.coef_.sum():+.4f}")
print(f"\n각 집단 평균 - 전체(집단평균의 평균)")
for k, name in enumerate(CITY):
    print(f"  {name} {group_means[k] - np.mean(group_means):+.4f}")
절편 12.6107
  세 집단 평균의 평균 12.6107
계수 [ 3.2733 -0.6588]   (부산, 대구)
  서울 효과 = -(계수의 합) = -2.6145

각 집단 평균 - 전체(집단평균의 평균)
  서울 -2.6145
  부산 +3.2733
  대구 -0.6588
절편이 집단평균들의 평균(\(12.6107\))이다. 더미 부호화에서 절편이 기준집단의 평균이었던 것과 다르다.
각 계수는 "전체 평균으로부터의 이탈"이다. 부산이 \(+3.27\), 대구가 \(-0.66\)이고, 빠진 서울의 효과는 계수 합의 음수로 복원된다(\(-2.61\)).
이 제약이 함정을 푸는 방식이다. 더미 \(k\)개를 다 쓰지 않고, 합이 0이라는 제약을 걸어 자유도 하나를 줄인다.
어느 쪽을 쓸 것인가.
| 더미 부호화 | 효과 부호화 | |
|---|---|---|
| 절편의 뜻 | 기준집단 평균 | 전체(집단평균의 평균) |
| 계수의 뜻 | 기준과의 차이 | 전체와의 차이 |
| 어울리는 상황 | 대조군이 뚜렷할 때 | 대등한 집단들을 비교할 때 |
효과 부호화는 분산분석의 전통적 모수화(\(y_{ij}=\mu+\alpha_i+\varepsilon_{ij}\), \(\sum\alpha_i=0\))와 정확히 일치한다. 10장 분산분석이 쓰던 그 제약이 여기서는 설계행렬의 부호로 나타난 것이다.
적합값과 \(R^2\)은 더미 부호화와 완전히 같다. 같은 모형의 다른 표현이기 때문이다. \(\square\)
연습문제 4. 수준이 아주 많은 범주형 변수(우편번호, 상품 코드처럼 수백 개)를 원–핫으로 풀면 무슨 문제가 생기는가? 수준당 관측값 수를 줄여 가며 확인하고, 대처법을 제시하라.
풀이
import numpy as np
from sklearn.linear_model import LinearRegression

rng = np.random.default_rng(3)
N = 2000
SIGMA = 3.0

# 참 효과가 전부 0 이므로, 계수의 제곱평균제곱근이 곧 '0 에서 벗어난 정도'다.
print(f"관측 {N}개를 K개 수준에 고르게 나눈다 (참 효과는 전부 0)")
print(f"{'K':>5s}{'수준당 n':>10s}{'빈 수준':>8s}{'모수':>6s}"
      f"{'훈련 R^2':>10s}{'계수 RMS':>10s}")
for K in [2, 5, 20, 100, 400]:
    g = rng.integers(0, K, N)
    y0 = rng.normal(0, SIGMA, N)          # 집단 효과가 전혀 없는 자료
    # 관측된 수준만으로 열을 만든다. 빈 수준에 열을 만들면 그 열이 모두 0 이라
    # 설계행렬의 계수가 떨어지고, 계수가 유일하지 않아 수가 터진다.
    seen = np.unique(g)
    D = (g[:, None] == seen[None, 1:]).astype(float)
    m = LinearRegression().fit(D, y0)
    rms = np.sqrt((m.coef_ ** 2).mean())
    print(f"{K:>5d}{N / K:>10.1f}{K - len(seen):>8d}{len(seen):>6d}"
          f"{m.score(D, y0):>10.4f}{rms:>10.4f}")
관측 2000개를 K개 수준에 고르게 나눈다 (참 효과는 전부 0)
    K     수준당 n    빈 수준    모수    훈련 R^2    계수 RMS
    2    1000.0       0     2    0.0002    0.0913
    5     400.0       0     5    0.0007    0.1731
   20     100.0       0    20    0.0091    0.3379
  100      20.0       0   100    0.0518    0.7033
  400       5.0       1   399    0.2049    1.5431
"빈 수준" 열을 눈여겨보라. \(K = 400\) 이면 수준 하나가 2000 개 관측에서 한 번도 뽑히지 않았다. 기대 개수가 \(400(1 - 1/400)^{2000} \approx 2.7\) 개이므로 드문 일이 아니다. 그 수준에 열을 만들면 그 열이 모두 0 이라 설계행렬의 계수가 떨어지고 계수가 유일하지 않게 된다. 그러면 라이브러리가 돌려주는 수는 최소노름해일 뿐이고 판본에 따라 달라진다 — 위 코드가 관측된 수준만으로 열을 만드는 까닭이다. 아래 "문제가 셋이다"의 세 번째가 바로 이 일이 예측 시점에 일어나는 경우다.
참 효과가 전부 0인 자료인데 훈련 \(R^2\)이 \(K\)와 함께 커진다. \(K=400\)에서 \(0.205\)다. 순전히 과적합(overfitting)이며, 모수가 400개면 2000개 관측을 그만큼 잘 맞출 수 있기 때문이다.
추정된 계수의 크기도 커진다. 참값이 전부 0이므로 계수 RMS 는 곧 0에서 벗어난 정도인데, 수준당 관측이 5개뿐이면 \(1.54\)까지 커진다. 잡음을 집단 효과로 오인한 것이다.
| \(K\) | 수준당 \(n\) | 훈련 \(R^2\) | 계수 RMS |
|---|---|---|---|
| 5 | 400 | 0.001 | 0.17 |
| 100 | 20 | 0.052 | 0.70 |
| 400 | 5 | 0.205 | 1.54 |
문제가 셋이다.
- 과적합: 모수가 많아 훈련자료를 외운다.
- 불안정한 계수: 수준당 표본이 적어 추정값이 튄다.
- 새 수준: 예측 시점에 훈련자료에 없던 우편번호가 나오면 아예 처리할 수 없다.
대처법 넷.
| 방법 | 내용 |
|---|---|
| 범주 묶기 | 드문 수준을 "기타"로 합친다. 가장 간단하고 흔하다 |
| 의미 있는 상위 범주로 | 우편번호 \(\to\) 시도, 상품코드 \(\to\) 대분류 |
| 정칙화 | 능형회귀로 계수를 0쪽으로 당긴다(18장) |
| 혼합모형·목표 부호화 | 수준별 효과를 임의효과(random effect)로 두거나, 범주를 그 수준의 반응변수 평균으로 바꿔 넣는다(target encoding) |
훈련 \(R^2\)을 믿으면 안 된다는 것이 핵심 교훈이다. 수준이 많은 범주형을 넣으면 \(R^2\)은 언제나 오른다. 교차검증(cross-validation)으로 평가해야 과적합이 드러난다(모형 선택 절). \(\square\)
연습문제 5. 보기 1 (2) 는 등간격 제약이 낸 손실을 \(\text{RSS}_{\text{정수}} - \text{WSS} = 4697.4805\) 라고 수로만 셌다. 수준이 셋이고 코드가 \(0, 1, 2\) 일 때 이 손실이 집단평균의 둘째 차분 대비 하나로 닫힌 꼴이 됨을 보이시오.
이어서 (ㄱ) 보기 1 의 수치로 이 등식을 확인하고, (ㄴ) 이 식에서 손실이 \(0\) 이 되는 경우가 정확히 무엇인지 말하고 그런 자료를 직접 만들어 확인하시오.
풀이
1단계. 손실은 집단평균에 직선을 맞춘 가중 잔차제곱합이다. 정수 코딩의 적합값은 집단 안에서 상수 \(a + bk\) 이므로, 집단마다 상수 \(c\) 에 대한 항등식 \(\sum_{i\in k}(y_i - c)^2 = \sum_{i\in k}(y_i - \bar y_k)^2 + n_k(\bar y_k - c)^2\) 을 쓰면
이다. 첫 항은 \(a, b\) 와 무관하므로 최소화는 둘째 항에서만 일어나고
이다. 곧 점 세 개 \((k, \bar y_k)\) 에 가중치 \(n_k\) 로 직선을 맞춘 잔차제곱합이다.
2단계. 잔차의 방향은 하나뿐이다. 점이 셋, 모수가 둘이니 잔차가 놓일 공간은 \(1\) 차원이다. 가중 내적 \(\langle u, v\rangle = \sum_k n_k u_k v_k\) 에서 잔차는 두 열 \((1,1,1)\) 과 \((0,1,2)\) 에 직교해야 한다. \(c = (1, -2, 1)\) 에 대해 \(w_k = c_k / n_k\) 로 두면
이므로 \(w\) 가 바로 그 방향이다. 따라서 잔차는 \(r_k = t\,c_k/n_k\) 꼴이다.
3단계. \(t\) 를 대비로 읽는다. 대비 \(c\) 는 어떤 직선도 지운다(\(\sum_k c_k(a + bk) = a\cdot 0 + b \cdot 0 = 0\)). 그러므로 \(\bar y_k = (a + bk) + r_k\) 에 \(c\) 를 걸면 직선 부분이 사라지고
이다. 손실에 넣으면
이 되어 주장한 식이다. \(\square\)
(ㄴ) 손실이 \(0\) 인 경우. 분자만 \(0\) 이 될 수 있으므로 손실이 \(0\) 인 것은 \(L = 0\), 곧
집단평균 셋이 정확히 등간격일 때뿐이다. 참값이 등간격인 것으로는 모자라고 표본평균이 등간격이어야 한다.
Xc = city.reshape(-1, 1).astype(float)      # 보기 1 의 정수 코딩 설계행렬

c = np.array([1.0, -2.0, 1.0])              # 둘째 차분 대비
contrast = (c * means).sum()
denom = (c ** 2 / counts).sum()
loss = contrast ** 2 / denom
print(f"둘째 차분 대비  y0 - 2 y1 + y2 = {contrast:+.6f}")
print(f"분모  1/n0 + 4/n1 + 1/n2       = {denom:.8f}")
print(f"공식의 손실  = {loss:.6f}")
print(f"직접 센 손실 = {rss_int - within_ss:.6f}")
print(f"차이         = {abs(loss - (rss_int - within_ss)):.2e}")

# 대비가 0 이면 손실도 0 인가: 부산 집단만 평행이동해 평균을 등간격으로 만든다.
y_eq = y.copy()
y_eq[city == 1] += (means[0] + means[2]) / 2 - means[1]
means_eq = np.array([y_eq[city == k].mean() for k in range(3)])
m_eq = LinearRegression().fit(Xc, y_eq)
wss_eq = sum(((y_eq[city == k] - means_eq[k]) ** 2).sum() for k in range(3))
rss_eq = ((y_eq - m_eq.predict(Xc)) ** 2).sum()
tss_eq = ((y_eq - y_eq.mean()) ** 2).sum()
print()
print(f"부산만 평행이동한 뒤의 집단평균 {np.round(means_eq, 6)}")
print(f"  둘째 차분 대비 = {(c * means_eq).sum():+.2e}")
print(f"  RSS - WSS      = {rss_eq - wss_eq:+.2e}")
print(f"  정수 코딩의 R^2     = {m_eq.score(Xc, y_eq):.6f}")
print(f"  집단평균 모형의 R^2 = {1 - wss_eq / tss_eq:.6f}")
출력:
둘째 차분 대비  y0 - 2 y1 + y2 = -9.819977
분모  1/n0 + 4/n1 + 1/n2       = 0.02052844
공식의 손실  = 4697.480479
직접 센 손실 = 4697.480479
차이         = 8.19e-12

부산만 평행이동한 뒤의 집단평균 [ 9.996228 10.974085 11.951942]
  둘째 차분 대비 = -7.11e-15
  RSS - WSS      = +0.00e+00
  정수 코딩의 R^2     = 0.146403
  집단평균 모형의 R^2 = 0.146403
(ㄱ) 공식이 소수 여섯째 자리까지 맞는다. \(L = -9.819977\), 분모 \(0.02052844\) 로 \(L^2/0.02052844 = 4697.480479\) 이고, 보기 1 에서 \(900\) 개 관측값으로 직접 센 \(\text{RSS}_{\text{정수}} - \text{WSS}\) 와 \(10^{-11}\) 안에서 같다.
(ㄴ)도 확인된다. 부산 집단만 \(-4.91\) 만큼 평행이동해 평균을 \(9.9962,\ 10.9741,\ 11.9519\) 로 등간격으로 만들면 대비가 \(-7\times10^{-15}\) 로 사라지고, 그 순간 \(\text{RSS} - \text{WSS}\) 가 정확히 \(0\) 이 되어 정수 코딩의 \(R^2\) 가 집단평균 모형의 \(R^2\) 와 같은 \(0.146403\) 이 된다. 집단내 변동은 전혀 건드리지 않았는데도 그렇다.
해석. 세 수준에서 정수 코딩이 버리는 것은 딱 한 숫자, 둘째 차분 대비 \(\bar y_0 - 2\bar y_1 + \bar y_2\) 다. 집단평균이 담은 정보는 세 개이고 직선이 둘을 쓰니, 남는 하나가 그것이다. 분모도 뜻이 있다. \(\sum c_k^2/n_k\) 는 \(\widehat L\) 의 분산을 \(\sigma^2\) 으로 나눈 값이라 가운데 집단에 가중치 \(4\) 가 걸린다. 가운데 집단이 크면 대비가 정밀하게 재어져 같은 \(L\) 이 더 큰 손실로 나타난다. 곧 "곡률을 잘 잴 수 있는 설계일수록 곡률을 무시한 벌이 크다."
연습문제 6. 보기 1 은 서울 \(=0\), 부산 \(=1\), 대구 \(=2\) 로 코딩했다. 세 도시에 \(0, 1, 2\) 를 매기는 방법은 \(3! = 6\) 가지다. 연습문제 5 의 공식만 써서 다음에 답하시오. 쓸 수치는 보기 1 의 것이다: \(\bar y = (9.996228,\ 15.884073,\ 11.951942)\), \(n = (287,\ 286,\ 327)\), \(\text{TSS} = 8580.4087\), 더미 부호화의 \(R^2 = 0.602208\).
(ㄱ) 여섯 가지 코딩이 \(R^2\) 로는 세 값밖에 주지 않음을 보이시오.
(ㄴ) 그 세 값을 구하시오.
(ㄷ) 가장 좋은 코딩조차 \(0.602208\) 에 못 미치는 까닭을 말하고, 그 "가장 좋은 코딩"을 실제 자료 분석에서 골라 쓰면 무엇이 문제인지 말하시오.
풀이
(ㄱ) 코딩은 \(R^2\) 에 두 단계로만 들어간다. \(\text{TSS}\) 와 \(\text{WSS}\) 는 집단을 어떻게 이름 붙이든 같은 수다. 연습문제 5 에서 \(\text{RSS}_{\text{정수}} = \text{WSS} + \text{손실}\) 이므로
이고, \(R^2\) 는 손실만의 (감소)함수다. 손실은 코드 \(0, 1, 2\) 를 받는 세 도시를 \((A, B, C)\) 라 할 때
인데 이 식은 \(A\) 와 \(C\) 를 맞바꾸어도 분자와 분모가 모두 그대로다. 곧 코드를 거꾸로 매기는 것(\(k \mapsto 2-k\))은 손실을 바꾸지 않는다. 기울기의 부호만 뒤집히고 적합값은 같기 때문이다. 그러므로 손실은 가운데 코드 \(1\) 을 받는 도시가 누구인가로만 정해지고, 여섯 코딩이 둘씩 짝지어 세 값으로 모인다.
(ㄴ) 세 값을 계산한다. 분모를 먼저 적으면 \(1/287 = 0.00348432\), \(1/286 = 0.00349650\), \(1/327 = 0.00305810\) 이다.
가운데가 부산일 때(보기 1 의 코딩):
이므로 손실 \(= 96.4319/0.02052844 = 4697.4805\), \(R^2 = 0.602208 - 0.547466 = 0.054742\).
가운데가 대구일 때(서울 \(=0\), 대구 \(=1\), 부산 \(=2\)):
이므로 손실 \(= 3.9062/0.01921324 = 203.3090\), \(R^2 = 0.602208 - 0.023695 = 0.578513\).
가운데가 서울일 때(부산 \(=0\), 서울 \(=1\), 대구 \(=2\)):
이므로 손실 \(= 61.5214/0.02049188 = 3002.2322\), \(R^2 = 0.602208 - 0.349894 = 0.252314\).
| 가운데 코드를 받는 도시 | 대비 \(L\) | 손실 | \(R^2_{\text{정수}}\) |
|---|---|---|---|
| 대구 (평균 순서대로) | \(+1.9764\) | 203.31 | 0.578513 |
| 서울 | \(+7.8436\) | 3002.23 | 0.252314 |
| 부산 (보기 1) | \(-9.8200\) | 4697.48 | 0.054742 |
평균이 가운데인 도시(대구)를 가운데 코드에 두는 것이 가장 좋고, 평균이 가장 높은 도시(부산)를 가운데에 두는 것이 가장 나쁘다. 가운데 자리가 대비에서 가중치 \(-2\) 를 받으므로 가장 튀는 집단을 가운데 놓으면 대비가 최대가 된다.
(ㄷ) 왜 \(0.602208\) 에 못 미치는가. 등호가 되려면 손실이 \(0\), 곧 연습문제 5 에서 본 대로 집단평균이 정확히 등간격이어야 한다. 평균 순서대로 늘어놓은 \(9.9962,\ 11.9519,\ 15.8841\) 의 간격은 \(1.9557\) 과 \(3.9321\) 로 두 배 차이가 난다. 코딩 순서를 고쳐서 바로잡을 수 있는 것은 단조성뿐이고 등간격은 바로잡을 수 없다. 남는 \(203.31\) 이 그 몫이다.
실제 분석에서 이 코딩을 고르면 안 된다. \(R^2\) 를 가장 크게 하는 코딩을 찾는 일은 \(y\) 를 들여다보고 설명변수를 만드는 일, 곧 자료 엿보기(data snooping)다. 여섯 중 최선을 고르는 것은 자유도를 몰래 쓰는 것이므로 보고된 \(0.5785\) 와 그 \(p\) 값은 더 이상 공정하지 않다. 게다가 명목형에서는 그렇게 얻은 순서에 뜻이 없다. 더미 부호화는 순서를 고르지 않고도 \(0.602208\) 을 주며, 쓰는 자유도는 단 하나 더 많다.
연습문제 7.
보기 3 에서 np.linalg.lstsq 가 돌려준 해는 \(\hat b = (9.4581,\ 0.5382,\ 6.4260,\ 2.4939)\) 였고, 최소노름해라는 조건은 \(\beta_0 = \beta_{\text{서울}} + \beta_{\text{부산}} + \beta_{\text{대구}}\) 로 적힌다.
(ㄱ) 이 해를 집단평균 \(\bar y_k\) 만으로 닫힌 꼴로 적으시오. 수준이 \(K\) 개인 일반형까지 구하시오.
(ㄴ) 그 꼴로 보기 3 의 네 수를 재현하시오.
(ㄷ) 모든 \(y_i\) 에 \(100\) 을 더하면(가령 임금에 일률 상여를 얹으면) 네 계수는 각각 얼마씩 변하는가. 이 답이 "최소노름해에는 통계적 뜻이 없다"는 말의 증거가 되는 까닭을 말하시오.
풀이
(ㄱ) 두 조건을 연립한다. 첫째, 절편과 더미 \(K\) 개를 다 넣은 모형은 포화모형(saturated model, 집단마다 적합값을 따로 줄 수 있는 모형)이므로 보기 2 (1) 에 의해 적합값이 집단평균이다.
둘째, 최소노름해는 영공간 벡터 \(\mathbf v = (1, -1, \dots, -1)^\top\) 에 직교하므로
이다. 첫 식에서 \(\beta_k = \bar y_k - \beta_0\) 를 얻어 둘째 식에 넣으면, \(S = \sum_k \bar y_k\) 라 할 때
이므로
이다. \(\square\)
(ㄴ) 수치. \(S = 9.996228 + 15.884073 + 11.951942 = 37.832243\) 이고 \(K = 3\) 이므로
이고 \(\beta_{\text{서울}} = 9.996228 - 9.458061 = 0.538167\), \(\beta_{\text{부산}} = 15.884073 - 9.458061 = 6.426012\), \(\beta_{\text{대구}} = 11.951942 - 9.458061 = 2.493881\) 이다. 보기 3 의 출력 [9.4581 0.5382 6.426 2.4939] 와 자리마다 같다.
(ㄷ) \(y\) 를 \(100\) 올리면. 집단평균이 모두 \(100\) 오르니 \(S \mapsto S + 300\) 이고
이다. 일반형으로는 \(y\) 에 \(c\) 를 더할 때 절편이 \(\dfrac{Kc}{K+1}\), 더미 계수가 각각 \(\dfrac{c}{K+1}\) 만큼 오른다. 실제로 보기 3 의 자료에 \(100\) 을 더해 lstsq 를 돌리면 해가 \((84.458061,\ 25.538167,\ 31.426012,\ 27.493881)\) 로 나와 절편은 \(+75\), 나머지는 \(+25\) 다.
왜 이것이 "뜻이 없다"는 증거인가. 셋을 함께 보아야 한다.
- 쪼개는 비율이 자료와 무관하다. 집단 간의 차이는 전혀 변하지 않았는데도 세 더미 계수가 모두 \(25\) 씩 올랐다. 올림의 \(75\%\) 를 절편에, \(25\%\) 를 집단효과에 나눠 주는 규칙을 누가 정했는가. \(\|\beta\|\) 를 최소로 한다는 대수적 편의가 정했다.
- 비율이 수준 개수에 달려 있다. \(K = 3\) 이면 \(75 : 25\) 지만 \(K = 99\) 면 \(99\% : 1\%\) 다. 도시를 몇 개 조사했는지가 "서울 효과"의 값을 바꾼다.
- 대조적으로 기준범주 부호화는 올림을 절편이 모두 받는다. 더미 \(K-1\) 개 모형에서는 \(\hat\beta_0 = \bar y_{\text{서울}} \mapsto \bar y_{\text{서울}} + 100\) 이고 나머지 계수는 하나도 변하지 않는다(차이로 정의되었으니 당연하다).
식별되는 양은 세 방식 모두에서 같다. \(\beta_0 + \beta_k\) 는 \(\bar y_k + 100\) 이고 계수의 차는 그대로다. 변하는 것은 좌표를 고르는 임의의 규칙뿐이며, 최소노름 규칙은 그 규칙이 측정 단위의 원점에도 수준 개수에도 흔들린다는 점에서 보고할 수 없는 좌표다. 보기 3 의 결론을 한 번 더 적으면, 함정의 정체는 정보를 잃는 것이 아니라 좌표를 정하지 못하는 것이다.
연습문제 8. 연습문제 3 의 효과 부호화는 절편이 \(12.6107\) 로 집단평균의 평균이었다. 보기 1 의 전체평균은 \(\bar y = 12.5778\) 이니 둘이 다르다.
(ㄱ) 두 수가 어긋나는 까닭을 집단크기 \(n = (287, 286, 327)\) 로 설명하고, 불일치가 사라지는 조건을 말하시오.
(ㄴ) 절편이 정확히 \(\bar y\) 가 되도록 효과 부호화를 고치시오. 기준(서울) 행의 \(-1, -1\) 을 \(-n_{\text{부산}}/n_{\text{서울}}\), \(-n_{\text{대구}}/n_{\text{서울}}\) 로 바꾸면 된다. 이 부호화가 거는 제약이 \(\sum_k n_k\alpha_k = 0\) 임을 보이고 수치로 확인하시오. 어느 쪽을 쓸지는 무엇으로 정하는가.
풀이
(ㄱ) 제약이 다르면 절편이 다르다. 효과 부호화도 모수가 셋(절편과 계수 둘)이고 집단이 셋이니 포화모형이다. 따라서 적합값이 집단평균이고
이다. 세 식을 그냥 더하면 \(3\beta_0 + 0 = \sum_k \bar y_k\) 이므로
곧 가중하지 않은 집단평균의 평균이다. 한편 전체평균은 집단크기로 가중한 평균이다.
두 수가 어긋나는 것은 \(n_k\) 가 서로 다르기 때문이고, \(n_0 = n_1 = n_2\) 이면 가중평균과 단순평균이 같아져 불일치가 사라진다. 방향도 읽힌다. 가장 큰 집단인 대구(\(n = 327\))의 평균 \(11.95\) 가 세 평균의 평균보다 낮으므로 가중하면 평균이 \(12.6107 \to 12.5778\) 로 \(0.0329\) 내려간다. 제약 \(\sum_k \alpha_k = 0\) 이 세 도시를 대등하게 센다는 선언이기 때문에 생기는 차이다.
(ㄴ) 가중 효과 부호화. 기준 행을 \((-n_1/n_0,\ -n_2/n_0)\) 로 두면 집단별 효과가
이므로
이다. 이 모형도 포화모형이라 \(\beta_0 + \alpha_k = \bar y_k\) 인데, 이번에는 세 식에 \(n_k\) 를 곱해 더한다.
# 가중 효과 부호화: 기준(서울) 행에 -n_부산/n_서울, -n_대구/n_서울 를 넣는다.
W = np.zeros((n, 2))
W[city == 1, 0] = 1.0
W[city == 2, 1] = 1.0
W[city == 0, 0] = -counts[1] / counts[0]
W[city == 0, 1] = -counts[2] / counts[0]

m_w = LinearRegression().fit(W, y)
a = np.array([-(counts[1] * m_w.coef_[0] + counts[2] * m_w.coef_[1]) / counts[0],
              m_w.coef_[0], m_w.coef_[1]])

print(f"가중 효과 부호화의 절편 {m_w.intercept_:.6f}")
print(f"  전체평균 y-bar        {y.mean():.6f}")
print(f"  집단평균의 평균       {means.mean():.6f}   (연습문제 3 의 절편)")
print()
for k, name in enumerate(CITY):
    print(f"  {name} 효과 {a[k]:+.6f}   평균 - y-bar = {means[k] - y.mean():+.6f}")
print(f"  가중합 sum n_k a_k = {(counts * a).sum():+.2e}   (0 이어야 한다)")
print(f"  단순합 sum a_k     = {a.sum():+.6f}   (0 이 아니다)")
print()
print(f"적합값   {np.round([m_w.predict(W)[city == k][0] for k in range(3)], 6)}")
print(f"집단평균 {np.round(means, 6)}")
print(f"R^2 {m_w.score(W, y):.6f}")
출력:
가중 효과 부호화의 절편 12.577830
  전체평균 y-bar        12.577830
  집단평균의 평균       12.610747   (연습문제 3 의 절편)

  서울 효과 -2.581602   평균 - y-bar = -2.581602
  부산 효과 +3.306243   평균 - y-bar = +3.306243
  대구 효과 -0.625889   평균 - y-bar = -0.625889
  가중합 sum n_k a_k = -2.84e-14   (0 이어야 한다)
  단순합 sum a_k     = +0.098752   (0 이 아니다)

적합값   [ 9.996228 15.884073 11.951942]
집단평균 [ 9.996228 15.884073 11.951942]
R^2 0.602208
절편이 \(\bar y\) 와 소수 여섯째 자리까지 같다. 효과도 \(\bar y_k - \bar y\) 와 자리마다 같아, 이제 계수가 전체평균으로부터의 이탈이라는 말이 글자 그대로 맞다. 연습문제 3 의 부호화에서는 "전체"가 집단평균의 평균이었다.
제약이 바뀐 것이 눈에 보인다. 가중합 \(\sum_k n_k\alpha_k\) 가 \(-2.8\times10^{-14}\) 로 \(0\) 인데, 단순합 \(\sum_k \alpha_k\) 는 \(+0.098752\) 로 \(0\) 이 아니다. 연습문제 3 에서는 정확히 반대였다. 두 부호화는 같은 모형의 다른 좌표이므로 적합값은 집단평균이고 \(R^2\) 도 \(0.602208\) 로 같다. 바뀌는 것은 "\(0\) 으로 묶을 합을 무엇으로 잡는가"뿐이다.
어느 쪽을 쓰는가는 집단크기가 무엇을 뜻하느냐로 정한다.
| \(n_k\) 의 정체 | 쓸 부호화 | 절편의 뜻 |
|---|---|---|
| 설계가 정한 것(각 도시에서 받은 설문 수) | 단순 효과 부호화 \(\sum\alpha_k = 0\) | 세 도시를 대등하게 센 평균 |
| 모집단 구성비를 반영한 것(무작위표본) | 가중 효과 부호화 \(\sum n_k\alpha_k = 0\) | 모집단 전체의 평균 |
표본이 모집단을 그대로 닮았다면 가중 쪽의 절편이 "임금의 전국 평균"이라는 뜻을 가지지만, 집단크기가 조사 편의로 정해진 수라면 그 가중은 뜻 없는 가중이다. 분산분석이 전통적으로 \(\sum\alpha_i = 0\) 을 쓰는 까닭은 실험에서 집단크기가 실험자가 정한 수이기 때문이다.
연습문제 9. 연습문제 2 의 풀이는 마지막에 "정수 코딩으로 적합한 뒤 잔차를 수준별로 평균 내 보라"고만 했다. 그 진단을 실제로 수행하고 다음을 보이시오. 자료는 연습문제 2 의 교육수준 자료(\(n = 6000\), 참 효과 \(0,\ 0.2,\ 0.5,\ 3.0,\ 3.4\), \(\sigma = 1\))다.
(ㄱ) 수준별 잔차평균이 정확히 \(\bar y_k - (\hat a + \hat b k)\) 이고, 따라서 (잡음을 빼면) 참 효과에 직선을 맞춘 잔차와 같다. 곧 그 패턴은 우연이 아니라 편향이다. 패턴이 잡음인지 편향인지 가르는 기준도 수로 적으시오.
(ㄴ) 연습문제 5 의 손실 등식이 수준 \(K\) 개로 일반화된다.
그리고 이 값을 \(\text{TSS}\) 로 나눈 것이 정확히 \(R^2_{\text{원핫}} - R^2_{\text{정수}}\) 임을 보이고 수로 확인하시오.
풀이
(ㄱ) 잔차평균은 집단평균의 잔차다. 정수 코딩의 적합값은 수준 안에서 상수 \(\hat a + \hat b k\) 이므로
이고, 이것은 집단평균 \(\bar y_k\) 에 직선을 맞춘 잔차다(연습문제 5 의 1단계). \(n_k\) 가 커지면 \(\bar y_k \to\) 참 효과이고 \((\hat a, \hat b) \to\) 참 효과에 맞춘 직선이므로, 잔차평균은 참 효과의 직선 잔차로 수렴한다. 참 효과 \(0,\ 0.2,\ 0.5,\ 3.0,\ 3.4\) 에 (가중 없이) 직선을 맞추면 \(\hat a = -0.5\), \(\hat b = 0.96\) 이고 잔차는 \(0.5,\ -0.26,\ -0.92,\ 0.62,\ 0.06\) 이다.
(ㄴ) 등식. 연습문제 5 의 1단계는 수준 개수를 쓰지 않았으므로 그대로 \(K\) 개로 간다.
에 \((\hat a, \hat b)\) 를 넣으면 주장한 등식이다. 또 원–핫 모형의 RSS 는 보기 2 (1) 에 의해 \(\text{WSS}\) 이므로
이다. 두 \(R^2\) 의 차는 집단평균 곡선에서 직선이 놓친 부분의 몫이다.
# 연습문제 2 의 교육수준 자료. X_int 는 그 정수 코딩, X_hot 은 원-핫이다.
m_lin = LinearRegression().fit(X_int, y_edu)
res = y_edu - m_lin.predict(X_int)
nk = np.array([np.sum(level == k) for k in range(5)])
mk = np.array([y_edu[level == k].mean() for k in range(5)])
fit_k = m_lin.intercept_ + m_lin.coef_[0] * np.arange(5.0)

# 참 효과에 (가중 없이) 직선을 맞춘 잔차
A = np.column_stack([np.ones(5), np.arange(5.0)])
tl = np.linalg.lstsq(A, true_edu, rcond=None)[0]

print("수준   n     집단평균    직선      잔차평균   참값-참직선")
for k in range(5):
    print(f"  {k}  {nk[k]:5d}  {mk[k]:9.4f} {fit_k[k]:9.4f} "
          f"{res[level == k].mean():+10.4f} {true_edu[k] - tl[0] - tl[1] * k:+10.4f}")

loss9 = (nk * (mk - fit_k) ** 2).sum()
wss9 = sum(((y_edu[level == k] - mk[k]) ** 2).sum() for k in range(5))
rss9 = (res ** 2).sum()
tss9 = ((y_edu - y_edu.mean()) ** 2).sum()
m_hot = LinearRegression().fit(X_hot, y_edu)
print()
print(f"sum n_k (y_k - 직선)^2 = {loss9:.4f}")
print(f"RSS - WSS              = {rss9 - wss9:.4f}")
print(f"손실 / TSS             = {loss9 / tss9:.6f}")
print(f"R^2(원-핫) - R^2(정수) = "
      f"{m_hot.score(X_hot, y_edu) - m_lin.score(X_int, y_edu):.6f}")
출력:
수준   n     집단평균    직선      잔차평균   참값-참직선
  0   1228    -0.0544   -0.5423    +0.4879    +0.5000
  1   1179     0.1717    0.4350    -0.2633    -0.2600
  2   1206     0.4972    1.4123    -0.9151    -0.9200
  3   1149     3.0351    2.3896    +0.6456    +0.6200
  4   1238     3.4259    3.3669    +0.0590    +0.0600

sum n_k (y_k - 직선)^2 = 1867.2378
RSS - WSS              = 1867.2378
손실 / TSS             = 0.095802
R^2(원-핫) - R^2(정수) = 0.095802
(ㄱ)이 확인된다. 잔차평균 \(+0.4879,\ -0.2633,\ -0.9151,\ +0.6456,\ +0.0590\) 이 참 효과의 직선 잔차 \(+0.50,\ -0.26,\ -0.92,\ +0.62,\ +0.06\) 과 둘째 자리까지 맞는다. 패턴의 모양도 뜻대로다. 낮은 세 수준에서 음으로 처지고(\(-0.92\) 가 바닥) \(3\) 단계에서 양으로 솟는다. 직선이 도약 앞은 과대평가, 도약 직후는 과소평가하는 것이다.
편향인지 잡음인지 가르는 기준. 수준별 잔차평균의 표준오차는 \(\sigma/\sqrt{n_k} \approx 1/\sqrt{1200} = 0.029\) 다. 관측된 패턴의 크기는 \(0.9\) 로 표준오차의 \(30\) 배이므로 잡음일 수 없다. 거꾸로 수준마다 \(10\) 개밖에 없었다면 표준오차가 \(0.32\) 라 \(0.9\) 도 세 배에 못 미쳐, 같은 패턴을 보고도 쉽게 단정할 수 없다. 진단은 잔차평균의 모양이 아니라 모양 나누기 표준오차로 읽어야 한다.
(ㄴ)도 닫힌다. \(\sum_k n_k(\bar y_k - \hat a - \hat b k)^2 = 1867.2378\) 이 \(\text{RSS} - \text{WSS}\) 와 같고, \(\text{TSS}\) 로 나눈 \(0.095802\) 가 연습문제 2 에서 본 \(R^2\) 격차 \(0.6933 - 0.5975\) 와 소수 여섯째 자리까지 같다. 곧 원–핫이 더 가져간 \(R^2\) 는 어디 다른 데서 온 설명력이 아니라 직선이 버린 잔차평균의 가중제곱합 그 자체다. 정수 코딩이 자료를 적게 쓴 것이 아니라 틀린 모양을 강요했다는 보기 1 의 결론이, 수준 다섯 개에서도 같은 등식으로 되돌아온다.
연습문제 10. 연습문제 4 는 참 효과가 전부 \(0\) 인 자료(\(n = 2000\), \(\sigma = 3\))에서 훈련 \(R^2\) 이 수준 개수 \(K\) 와 함께 커지는 것을 보았다. \(K = 2, 5, 20, 100\) 에서 \(0.0002,\ 0.0007,\ 0.0091,\ 0.0518\) 이었다. 이 네 수를 설명하는 분포를 적으시오.
(ㄱ) 오차가 정규이고 참 효과가 전부 \(0\) 일 때, 수준이 \(K\) 개인 원–핫 모형의 훈련 \(R^2\) 이
임을 보이시오. 답에 \(\sigma\) 가 들어가지 않는 까닭도 말하시오.
(ㄴ) 네 수를 이 예측과 견주시오. 표준편차는 \(\sqrt{ab/\bigl((a+b)^2(a+b+1)\bigr)}\) 를 쓰라.
(ㄷ) 훈련 \(R^2\) 의 기댓값이 \(0.5\) 를 넘으려면 수준이 몇 개 있어야 하는가. 또 수정 결정계수(adjusted \(R^2\)) \(R^2_{\text{adj}} = 1 - (1 - R^2)\dfrac{n-1}{n-K}\) 의 기댓값이 정확히 \(0\) 임을 보이고, 그래도 교차검증이 필요한 까닭을 말하시오.
풀이
(ㄱ) 제곱합 두 개의 비다. 보기 2 (1) 에서 절편과 더미 \(K-1\) 개인 모형의 적합값은 집단평균이므로 \(\text{RSS} = \text{WSS}\) 이고, 분해 \(\text{TSS} = \text{BSS} + \text{WSS}\) 에서
이다. 귀무가설(null hypothesis, 모든 집단평균이 같다)에서 \(y_i \overset{iid}{\sim} N(\mu, \sigma^2)\) 이고, 10.1절 일원배치 분산분석에서 본 대로 \(\text{BSS}\) 와 \(\text{WSS}\) 는 서로 직교하는 두 부분공간(차원 \(K-1\) 과 \(n-K\))으로의 사영의 길이제곱이므로
이다. 독립인 두 카이제곱 \(U \sim \chi^2_{2a}\), \(V \sim \chi^2_{2b}\) 에 대해 \(U/(U+V) \sim \text{Beta}(a, b)\) 이므로
이고, 베타분포의 평균 \(a/(a+b)\) 에서
이다. \(\square\)
\(\sigma\) 가 사라지는 까닭은 위 식에서 보인다. \(R^2\) 는 두 제곱합의 비이고 \(\sigma^2\) 은 분자와 분모를 똑같이 늘리므로 약분된다. 잡음이 커도 작아도 "\(K\) 개 수준이 공짜로 가져가는 \(R^2\)"는 같다. 그래서 연습문제 4 의 \(\sigma = 3\) 은 결과에 아무 영향이 없었고, 그 표의 수들은 자료가 아니라 자유도만의 함수다.
(ㄴ) 네 수와의 비교. \(n = 2000\), \(a = (K-1)/2\), \(b = (n-K)/2\) 다.
| \(K\) | \(\mathbb E[R^2] = \frac{K-1}{1999}\) | 표준편차 | 연습문제 4 의 값 | 표준편차 몇 배 |
|---|---|---|---|---|
| 2 | 0.000500 | 0.000707 | 0.0002 | \(-0.42\) |
| 5 | 0.002001 | 0.001413 | 0.0007 | \(-0.92\) |
| 20 | 0.009505 | 0.003068 | 0.0091 | \(-0.13\) |
| 100 | 0.049525 | 0.006859 | 0.0518 | \(+0.33\) |
네 값 모두 예측에서 표준편차 한 배 안이다. 한 번씩 뽑은 결과이니 이보다 더 맞을 수는 없다. "\(R^2\) 이 \(K\) 와 함께 커진다"는 말이 \(\mathbb E[R^2] = (K-1)/(n-1)\) 이라는 직선 관계로 정확해졌다. \(K\) 가 \(20\) 에서 \(100\) 으로 다섯 배가 되자 \(R^2\) 도 \(0.0095\) 에서 \(0.0495\) 로 다섯 배가 된 것이 그 직선이다.
\(K = 400\) 행은 바로 견주기 어렵다. 공식은 \(399/1999 = 0.1996\) 을 주지만, 수준당 평균 \(5\) 개뿐이면 빈 수준이 생긴다. 비어 있을 기대 개수가 \(400\,(1 - 1/400)^{2000} \approx 2.7\) 이다. 빈 수준의 더미 열은 영벡터라 설계행렬의 계수가 그만큼 떨어지므로 실효 수준 수가 \(400\) 보다 작고, 그 열의 계수는 식별되지 않는다(보기 3 의 함정이 훈련자료 안에서 되살아난 것이다). 풀이 도구에 따라 \(0\) 을 주기도 하고 터무니없이 큰 수를 주기도 하므로, 그 행의 계수 RMS 는 믿을 수 없다. 연습문제 4 가 셋째로 꼽은 "새 수준" 문제가 예측 시점만의 일이 아니라는 뜻이다.
(ㄷ) 절반을 넘기려면. \((K-1)/(n-1) > 1/2\), 곧
이므로 \(n = 2000\) 에서 수준이 \(1001\) 개면 충분하다. 수준당 관측값이 평균 두 개인 범주형 변수 하나를 넣으면, 신호가 전혀 없는데도 훈련 \(R^2\) 의 기댓값이 \(0.5\) 다. 우편번호를 그대로 넣는다는 것이 이런 일이다.
수정 결정계수는 기댓값이 정확히 \(0\) 이다. 베타분포에서 \(\mathbb E[1 - R^2] = b/(a+b) = (n-K)/(n-1)\) 이므로
이다. 근사가 아니라 등식이고, \(K\) 에도 \(\sigma\) 에도 의존하지 않는다. 교정항 \(\frac{n-1}{n-K}\) 가 자유도만큼의 공짜 설명을 정확히 되돌려 놓는다.
그래도 교차검증이 필요하다. 기댓값이 \(0\) 이라는 것은 편향만 없앴다는 뜻이고, 산포는 그대로 \(K\) 와 함께 커진다. \(R^2_{\text{adj}}\) 는 귀무가설에서 절반쯤 음수가 되고 절반쯤 양수가 되는데, 양수 쪽을 보고 "설명력이 있다"고 읽으면 과적합을 다시 들이는 셈이다. 게다가 \(R^2_{\text{adj}}\) 의 교정은 모수 개수를 \(K\) 로 세었을 때만 맞고, 앞에서 본 빈 수준이나 자료를 보고 고른 그룹·부호화(연습문제 6)에는 세어지지 않는 자유도가 숨는다. 교차검증은 모수를 세는 대신 보지 않은 자료에 재므로 그 숨은 자유도까지 함께 벌한다.
정리하며¶
범주형 설명변수는 수로 바꿔야 회귀에 들어가고, 바꾸는 방식이 모형의 가정을 정한다.
- 명목형에 정수를 매기면 안 된다. 자료에 없는 순서와 등간격을 선언하게 된다. 보기 1에서 \(R^2\)이 0.055 대 0.602로 갈렸다.
- 더미 부호화가 표준이다. 수준 \(k\)개에 더미 \(k-1\)개를 두고 하나를 기준범주로 삼는다. 절편은 기준집단의 평균, 각 계수는 기준과의 차이다.
- 더미를 \(k\)개 다 넣으면 완전공선이 되어 해가 유일하지 않다. 보기 3에서 계수가 다른 두 해가 같은 예측과 같은 잔차제곱합을 주었다.
- 기준범주를 바꾸면 계수는 바뀌지만 모형은 바뀌지 않는다. 적합값과 \(R^2\)이 같다. 계수의 \(p\) 값은 기준과의 비교를 묻는다는 점에 주의한다.
- 순서형은 순서가 실재하지만 등간격은 여전히 가정이다. 정수 코딩은 모수를 아끼고, 원–핫은 어떤 모양이든 표현하는 대신 순서를 버린다.
- 수준이 많으면 원–핫이 과적합을 부른다. 묶기, 상위 범주화, 정칙화로 대처한다.
범주형 설명변수와 연속형 설명변수가 상호작용하면 집단마다 기울기가 달라진다. 이는 교호작용 항 절에서 다룬다.
다음 절부터 최소제곱 추정으로 넘어간다. 13.1절이 모형의 꼴을 세웠다면, 13.2절은 그 모형의 계수를 어떻게 고르는가를 셋으로 유도한다 — 최소제곱 기준, 정규오차 아래의 최대가능도, 그리고 벡터 미적분의 정규방정식이다.