계수의 p값과 신뢰구간 이해하기
선형회귀 분석에서 p값과 신뢰구간을 이해하는 일은 회귀계수의 유의성과 정밀도를 해석하는 데 필수적이다. 이 통계량들은 설명변수가 종속변수에 얼마나 강하게 영향을 주는지, 그리고 추정된 효과에 어느 정도 불확실성이 따르는지를 알려준다.
선형회귀의 p값
p값은 귀무가설이 참이라고 가정했을 때, 설명변수와 종속변수 사이에서 관측된 관계가 우연으로 나타날 확률이다.
가설은 다음과 같다.
- 귀무가설 (\(H_0\)): \(\beta_i = 0\) — 설명변수 \(X_i\)는 결과 \(Y\)에 효과가 없다.
- 대립가설 (\(H_1\)): \(\beta_i \neq 0\) — 설명변수 \(X_i\)는 \(Y\)에 유의한 효과가 있다.
각 계수에 대해 t-검정을 수행하면 \(\hat{\beta}_i\)와 그 표준오차로 계산한 t 통계량에서 p값이 나오고, 이 p값이 통계적 유의성을 판정한다.
- 작은 p값 (< 0.05): \(H_0\)을 기각한다. 그 설명변수는 통계적으로 유의하며 종속변수의 변동을 설명하는 데 기여한다.
- 큰 p값 (\(\geq\) 0.05): \(H_0\)을 기각하지 못한다. 그 설명변수는 통계적으로 유의하지 않으며 모형에 크게 기여하지 않을 수 있다.
보기 1. p값의 해석. 침실 수, 대지 면적, 주택 연식으로 집값을 예측하는 회귀모형을 생각하자.
풀이
| 설명변수 | p값 | 결론 |
|---|---|---|
| 주택 연식 | 0.02 | 0.05 수준에서 유의 — 연식은 집값의 유의한 설명변수이다 |
| 대지 면적 | 0.25 | 0.05 수준에서 유의하지 않음 — 이 모형에서 대지 면적은 집값에 큰 영향을 주지 않을 수 있다 |
계수의 신뢰구간
신뢰구간은 표본자료에 근거하여 참 모집단 계수가 놓일 것으로 기대되는 값의 범위를 제공한다. p값이 이분법적 판정을 준다면, 신뢰구간은 추정의 정밀도를 전달한다.
95% 신뢰구간은, 서로 다른 표본 100개를 뽑아 신뢰구간 100개를 만들면 그 가운데 약 95개가 참 계수값을 포함한다는 뜻이다.
95% 신뢰구간의 공식은
여기서
- \(\hat{\beta}_i\)는 추정된 회귀계수,
- \(SE(\hat{\beta}_i)\)는 추정값의 표준오차,
- \(t_{\alpha/2}\)는 95% 신뢰수준에서 t 분포의 임계값이다.
해석의 핵심 규칙:
- 신뢰구간이 0을 포함하면 그 설명변수는 0과 유의하게 다르지 않을 수 있다. 효과가 불확실하다.
- 신뢰구간이 0을 배제하면 그 설명변수는 결과에 유의한 효과를 가질 가능성이 높다.
보기 2. 신뢰구간의 해석. 연봉을 예측하는 회귀모형을 생각하자.
풀이
| 설명변수 | \(\hat{\beta}\) | 95% 신뢰구간 | 해석 |
|---|---|---|---|
| 교육 연수 | 2.5 | (1.2, 3.8) | 유의함 — 구간이 0을 배제한다. 참 효과는 1.2와 3.8 사이에 있다. |
| 업계 경력 | 0.55 | (−0.4, 1.5) | 불확실함 — 구간이 0을 포함한다. 중요한 설명변수가 아닐 수 있다. |
p값과 신뢰구간의 관계
p값과 신뢰구간은 밀접하게 관련되어 있고 일반적으로 같은 결론에 이른다.
- p값 < 0.05이면 대응하는 95% 신뢰구간은 0을 배제한다 — 그 설명변수는 유의하다.
- p값 \(\geq\) 0.05이면 95% 신뢰구간은 0을 포함한다 — 그 설명변수는 유의하지 않다.
두 척도를 함께 써야 통계적 유의성뿐 아니라 설명변수 효과의 실질적 유의성과 불확실성까지 이해할 수 있다.
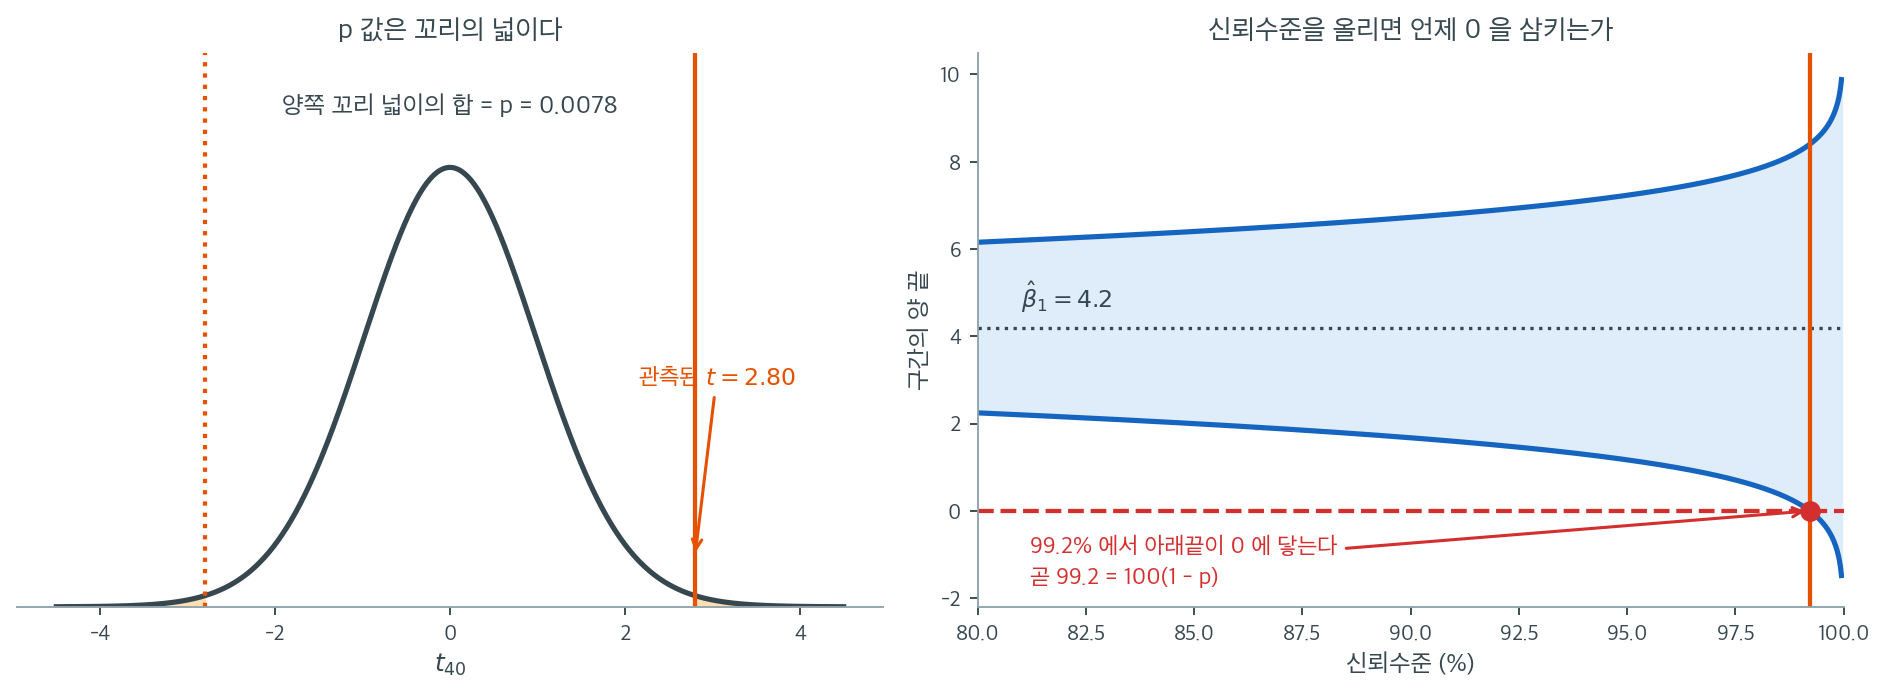
두 척도가 "같은 결론에 이른다"는 말은 사실 너무 약하다. 둘은 같은 계산을 다른 각도에서 읽은 것이다. 위 그림이 그 사실을 보인다. \(\hat{\beta}_1 = 4.2\), \(\mathrm{SE} = 1.5\), 자유도 \(40\)인 회귀 출력을 가지고 왔다.
왼쪽이 \(p\)값의 정의다. \(t = 4.2/1.5 = 2.80\)을 계산하고 \(t_{40}\) 분포에서 \(|T| > 2.80\)인 두 꼬리의 넓이를 잰다. 그 합이 \(0.0078\)이며 이것이 \(p\)값이다. 그림에서 칠해진 두 조각이 워낙 얇아 눈에 잘 띄지 않는데, 그 얇음이 곧 "\(H_0\) 아래에서는 이런 값이 좀처럼 나오지 않는다"는 뜻이다.
오른쪽은 신뢰수준을 \(80\%\)에서 \(99.95\%\)까지 연속적으로 움직이며 구간의 두 끝을 그린 것이다. 중심은 언제나 \(4.2\)로 고정되어 있고 폭만 벌어진다. \(90\%\) 구간은 \((1.674,\ 6.726)\), \(95\%\)는 \((1.168,\ 7.232)\), \(99\%\)는 \((0.143,\ 8.257)\)로 모두 \(0\)을 배제한다. 그런데 신뢰수준을 계속 올리면 아래끝이 결국 \(0\)에 닿는다. 그 지점이 정확히 \(99.217\%\)이고, \(99.5\%\) 구간은 \((-0.257,\ 8.657)\)로 이미 \(0\)을 품는다.
\(99.217\)이라는 수가 어디서 왔는지 보라. \(100(1 - p) = 100(1 - 0.00783) = 99.217\)이다. 우연이 아니다. \(p\)값이란 신뢰구간이 귀무값을 끝점으로 갖게 만드는 신뢰수준의 여집합이며, 이것이 두 양이 "같은 정보"인 정확한 의미다. 이 관계를 붙잡고 있으면 실무에서 유용한 어림이 따라온다. 어떤 논문이 \(p = 0.03\)이라고만 보고했다면, 그 자료의 \(97\%\) 신뢰구간이 \(0\)에 걸쳐 있다는 뜻이다. 반대로 \(95\%\) 구간의 한쪽 끝이 \(0\)에 거의 붙어 있다면 \(p\)가 \(0.05\) 언저리라는 뜻이다. 다만 방향은 한쪽으로만 유용하다. 구간은 \(p\)값을 복원해 주지만 \(p\)값만으로는 효과의 크기를 복원할 수 없다.
권장 실무
p값과 신뢰구간을 모두 보고하라. p값은 효과가 존재하는지를 알려주고, 신뢰구간은 그 효과가 얼마나 큰지와 얼마나 정밀하게 추정되었는지를 알려준다.
실전 해석
"광고 예산"이라는 설명변수에 대해 회귀 출력이 다음을 준다고 하자.
| 지표 | 값 |
|---|---|
| 계수 | 2.4 |
| p값 | 0.001 |
| 95% 신뢰구간 | (1.9, 2.9) |
해석: 광고 예산은 매출에 유의한 양의 영향을 준다. 관측된 효과가 우연 때문일 확률은 0.001로 매우 낮다. 광고 예산이 한 단위 늘어날 때 매출에 미치는 참 효과가 1.9와 2.9 단위 사이에 있다고 95% 신뢰한다.
연습문제
연습문제 1. 어떤 회귀계수가 \(\hat{\beta}_1 = 4.2\), \(\text{SE} = 1.5\), (양측) \(p = 0.008\)이다. 99% 신뢰구간을 구성하고, p값과 신뢰구간이 같은 정보를 전달하는 이유를 설명하라.
풀이
\(t = \hat{\beta}_1 / \text{SE} = 4.2/1.5 = 2.8\)이다. 양측 \(p = 0.008\)이 되려면 자유도가 대략 \(df = 40\)이어야 한다(\(2 \times P(T_{40} > 2.8) = 0.0078\)).
\(t_{0.005, 40} = 2.7045\)를 쓰면
구간이 0을 아슬아슬하게 배제한다. 이는 \(p = 0.008 < 0.01\)과 반드시 일치해야 하는 결과이다. \(p\)값이 0.01보다 작으면 99% 신뢰구간은 언제나 0을 배제한다. 둘은 같은 검정을 다르게 표현한 것일 뿐이기 때문이다.
더 정확히 말하면, \(p\)값은 \((1-\alpha)\) 신뢰구간이 0을 배제하게 되는 가장 작은 \(\alpha\)이다. \(p = 0.008\)이므로 신뢰수준 \(1 - 0.008 = 99.2\%\)의 신뢰구간이 0을 끝점으로 갖는, 곧 0을 배제하는 가장 넓은 구간이다. 그보다 신뢰수준이 높은 구간은 0을 포함하고, 낮은 구간은 배제한다.
연습문제 2. 어떤 논문이 "처치의 효과는 통계적으로 유의했다(\(p = 0.04\))"라고만 보고하고 계수 추정값이나 신뢰구간은 보고하지 않았다. 이런 보고가 왜 불완전한지, 어떤 정보가 더 필요한지 설명하라.
풀이
p값만으로는 효과가 정확히 0일 가능성이 낮다는 것밖에 알 수 없다. 효과의 크기나 실질적 유의성에 대해서는 아무것도 말해 주지 않는다. 표본이 크면 통계적으로 유의한 효과가 실질적으로는 무시할 만큼 작을 수 있다.
보고에는 다음이 포함되어야 한다. (1) 효과의 크기를 수량화하는 계수 추정값 \(\hat{\beta}\), (2) 추정값과 그 정밀도를 함께 전달하는 신뢰구간, (3) 그 효과 크기가 실질적으로 의미 있는지에 대한 맥락. 예를 들어 "\(\hat{\beta} = 0.3\), 95% 신뢰구간 \((0.01, 0.59)\)"라고 쓰면 효과가 유의하긴 하지만 구간이 넓어 참 크기에 상당한 불확실성이 있음이 드러난다.
정리하며
회귀계수의 p값과 신뢰구간을 이해하는 일은 근거 있는 의사결정에 결정적이다. p값은 설명변수가 통계적으로 유의한지를 판정하고, 신뢰구간은 정밀도와 불확실성의 척도를 제공한다. 이 둘을 함께 쓸 때 모형이 내놓은 발견의 강도와 신뢰성을 제대로 평가할 수 있다.