거짓발견율과 재표본추출 다중검정
개요
여러 가설을 동시에 검정하면 거짓 양성이 적어도 하나 나올 확률이 빠르게 커진다. 이 페이지에서는 다중검정의 오류를 통제하는 세 가지 전략을 보인다: 가족단위 오류율(FWER) 통제를 위한 Bonferroni와 Holm 보정, 거짓발견율(FDR) 통제를 위한 Benjamini-Hochberg(BH) 절차, 그리고 분포 가정 없이 FDR을 추정하는 재표본추출(순열) 접근.
가족단위 오류율의 증가
독립인 검정 \(m\)개를 각각 수준 \(\alpha\)에서 수행하면 제1종 오류를 적어도 한 번 범할 확률은
\(\alpha = 0.05\)이고 \(m = 100\)이면 이 값이 0.99를 넘어 거짓 양성이 사실상 확실하다.
보정 방법
Bonferroni 보정
\(p_i < \alpha / m\)일 때에만 \(i\)번째 가설을 기각한다. FWER을 수준 \(\alpha\)로 통제하지만 보수적이어서 \(m\)이 커지면 검정력이 떨어진다.
Holm 단계적 하강 절차
\(p\)-값을 \(p_{(1)} \leq p_{(2)} \leq \cdots \leq p_{(m)}\)으로 정렬한다. 모든 \(j = 1, \ldots, k\)에 대해
이면 \(H_{(k)}\)를 기각한다. Holm은 Bonferroni처럼 FWER을 통제하면서 균일하게 더 강력하다.
Benjamini-Hochberg 절차
FDR은 전체 기각 중 거짓 발견의 기대 비율로 정의된다:
여기서 \(V\)는 거짓 양성의 수, \(R\)은 전체 기각 수이다. BH 절차는 다음을 만족하는 가장 큰 \(k\)를 찾아
\(H_{(1)}, \ldots, H_{(k)}\)를 모두 기각한다. 독립일 때 이 절차는 FDR을 수준 \(\alpha\)로 통제한다.
FWER 증가 곡선
보기 1. 검정 수에 따른 FWER. 독립인 검정 \(m = 100\)개를 각각 수준 \(\alpha\)에서 수행하고, 모든 귀무가설이 참이라고 하자.
(1) \(\alpha = 0.05,\ 0.01,\ 0.001\)에서 FWER을 구하시오.
(2) \(m = 100\)에서 FWER을 정확히 \(0.05\)로 맞추는 \(\alpha\)를 구하고, 본페로니의 \(\alpha/m\)과 견주시오. 어느 쪽이 더 보수적인가.
풀이
(1) 해석적으로. 검정 \(i\)가 잘못 기각하지 않을 확률이 \(1-\alpha\)이고 \(m\)개가 독립이므로, 하나도 잘못 기각하지 않을 확률은 \((1-\alpha)^m\)이다. 적어도 하나를 잘못 기각할 확률은 그 여집합이다.
\(m = 100\)에 세 값을 넣는다.
(2) 해석적으로. \(1 - (1-\alpha)^{100} = 0.05\)를 \(\alpha\)에 대해 푼다.
이것이 시닥(Šidák) 보정이다. 본페로니는 \(\alpha/m = 0.05/100 = 0.00050000\)을 쓴다.
본페로니 쪽이 더 작으므로 더 보수적이다. 비가 \(0.00051280/0.00050000 = 1.0256\)이니 약 \(2.6\%\) 차이다. 두 값이 가까운 까닭은 \(\alpha\)가 작을 때 \(1-(1-\alpha)^m \approx m\alpha\)이기 때문이고, 실제로 \(\ln(1-x) \approx -x\)를 쓰면
로 본페로니의 \(0.05/m\)과 분자만 \(2.6\%\) 다르다. 시닥이 조금 덜 보수적이지만 그 이득은 미미하고, 대신 독립성을 가정해야 한다. 본페로니는 종속성이 어떻든 성립한다.
수치적으로.
import numpy as np

# 검정 m 개가 모두 참 귀무가설이고 서로 독립이라면, 하나도 잘못 기각하지
# 않을 확률이 (1-a)^m 이다. 적어도 하나를 잘못 기각할 확률이 그 나머지다.
# m=100, a=0.05 면 0.994 — 거의 확실하게 거짓 양성이 하나는 나온다.
m_vals = np.arange(1, 501)
alphas = [0.05, 0.01, 0.001]
for a in alphas:
    fwer = 1 - (1 - a) ** m_vals
    print(f"alpha={a}, m=100: FWER={1 - (1-a)**100:.4f}")

# (2) FWER 을 0.05 로 맞추는 alpha.
m = 100
sidak = 1 - 0.95 ** (1 / m)
bonf = 0.05 / m
print(f"\n시닥   alpha = {sidak:.8f}   확인 FWER = {1 - (1 - sidak) ** m:.6f}")
print(f"본페로니 alpha = {bonf:.8f}   확인 FWER = {1 - (1 - bonf) ** m:.6f}")
print(f"비 시닥/본페로니 = {sidak / bonf:.4f}")
출력:
alpha=0.05, m=100: FWER=0.9941
alpha=0.01, m=100: FWER=0.6340
alpha=0.001, m=100: FWER=0.0952

시닥   alpha = 0.00051280   확인 FWER = 0.050000
본페로니 alpha = 0.00050000   확인 FWER = 0.048782
비 시닥/본페로니 = 1.0256
(1)과 (2)의 값이 모두 그대로 나왔다. 시닥의 \(\alpha\)를 넣으면 FWER이 정확히 \(0.050000\)이고, 본페로니는 \(0.048782\)로 목표보다 낮다. 보수적이라는 말의 뜻이 이것이다.
검정 100개를 \(\alpha = 0.05\)로 하면 거짓 양성이 하나도 없을 확률이 \(0.6\%\)에 불과하다. \(\alpha\)를 \(0.001\)까지 낮춰야 FWER이 \(10\%\) 아래로 내려온다. 이것이 Bonferroni가 하는 일이고, 동시에 Bonferroni가 검정력을 잃는 이유이기도 하다.
네 방법을 같은 자료에 적용하면
아래 모의실험을 돌리기 전에 결과가 어떤 모습인지 먼저 보자. 가설 100개 중 20개에 실제 효과가 있는 자료를 3천 번 만들어 네 방법을 모두 적용했다.
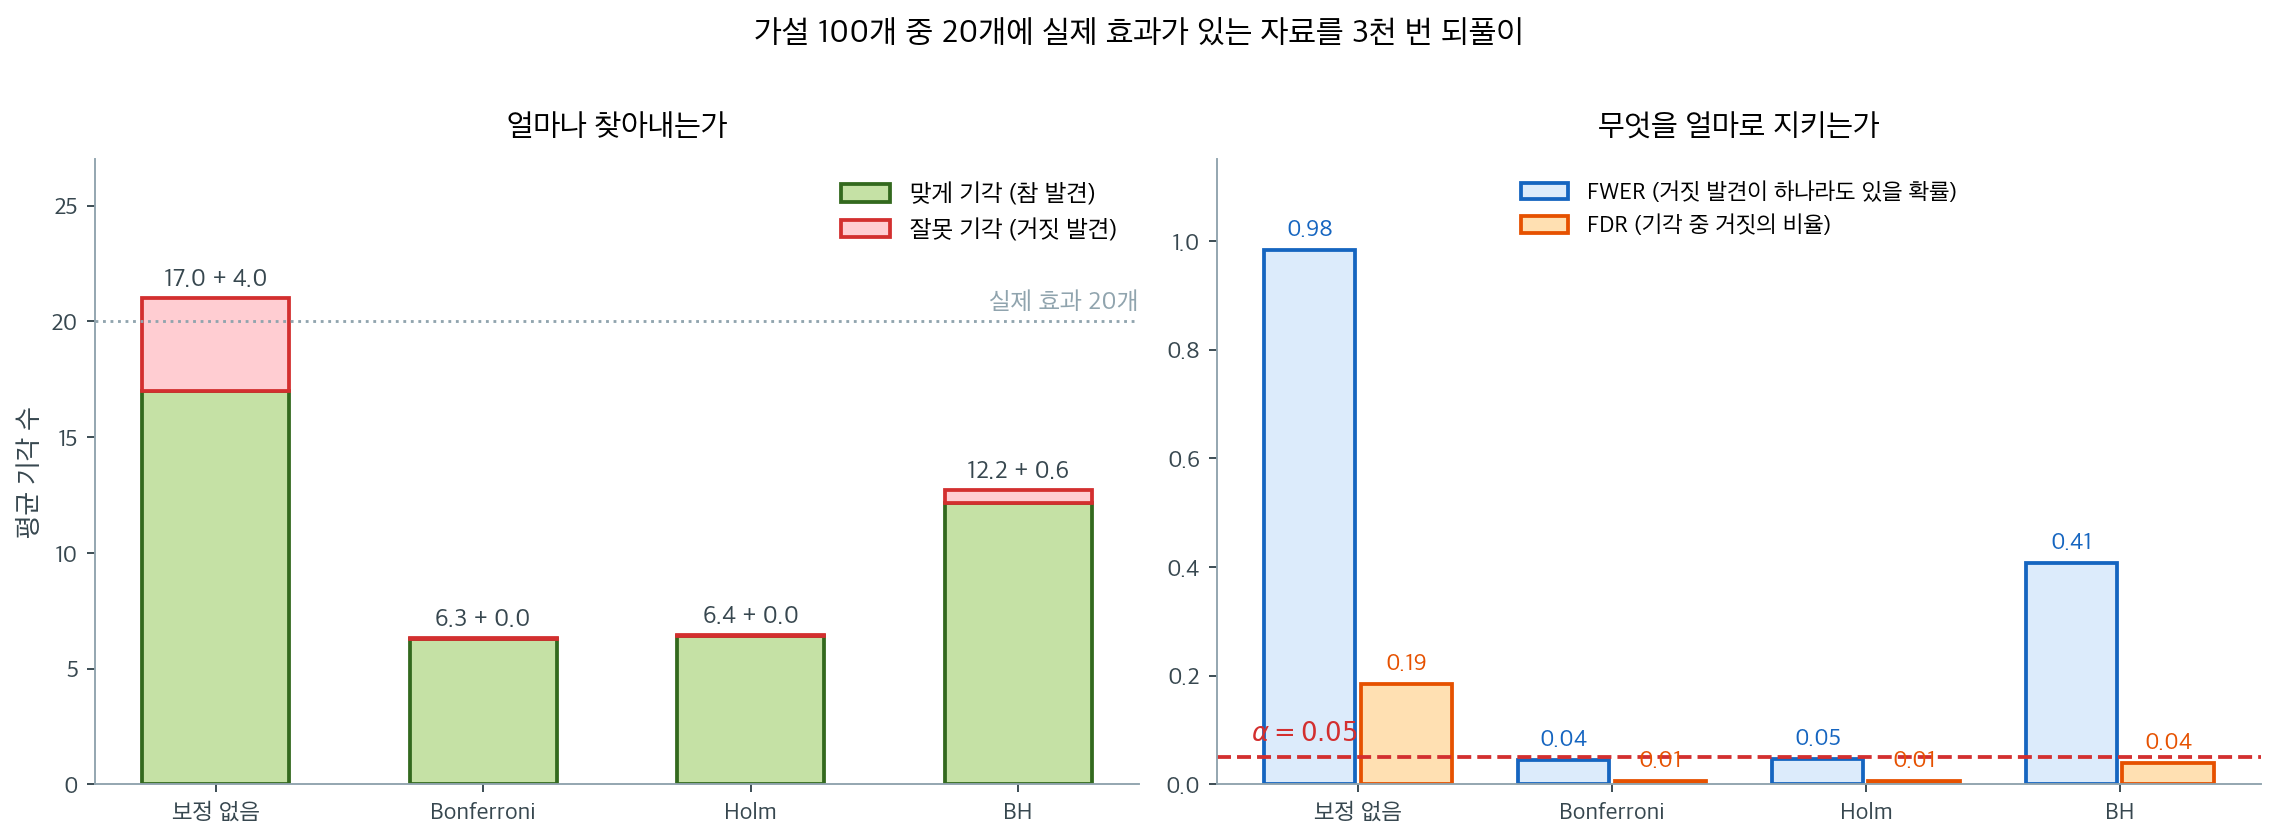
왼쪽에서 보정 없음은 평균 21개를 기각하는데 그중 4개가 거짓이다. 실제 효과가 20개뿐이므로 기각 다섯 중 하나가 헛것인 셈이다. 오른쪽에서 보듯 FWER이 \(0.98\)이다. 거의 매번 거짓 발견이 적어도 하나 섞인다.
Bonferroni와 Holm은 FWER을 각각 \(0.04\)와 \(0.05\)로 지켜 낸다. 대가는 왼쪽 막대에 있다. 실제 효과 20개 중 6개 남짓밖에 찾지 못한다. 거짓을 하나도 허용하지 않겠다는 요구가 이만큼 비싸다.
BH가 그 사이에 선다. FDR이 정확히 \(0.05\)로 맞춰지고 발견은 12.8개로 Bonferroni의 두 배다. FWER은 \(0.41\)까지 오르지만, 그것이 BH가 통제하기로 한 양이 아니다. "거짓이 하나도 없어야 한다"에서 "거짓의 비율이 5%를 넘지 않으면 된다"로 요구를 바꾼 대가로 검정력을 되찾은 것이며, 어느 쪽이 옳은 요구인지는 통계학이 아니라 문제가 정한다.
보정을 적용한 다중검정 모의실험
보기 2. 보정을 적용한 다중검정. 가설 \(m = 2000\)개 가운데 앞의 \(200\)개만 참 신호(\(d = 0.5\), \(n = 50\)인 일표본 \(t\) 검정)이고 나머지 \(1800\)개는 귀무가 참이다. \(\alpha = 0.05\)에서 세 보정을 적용한다.
(1) 본페로니의 원 \(p\)-값 문턱을 구하고, 그 문턱에서 참 신호 하나가 기각될 확률(비중심 \(t\))을 계산해 기대 TP와 기대 FP를 구하시오.
(2) 코드의 결과와 맞추시오. BH가 기각한 개수 \(R\)을 알고 나면 BH의 유효 문턱이 정해지는데, 그 문턱으로 TP와 FP를 다시 예측해 보시오.
풀이
(1) 해석적으로. 본페로니는 보정 \(p\)-값 \(\min(1,\ m p)\)를 \(\alpha\)와 견주므로 원 \(p\)-값 문턱이
다. 귀무가 참인 검정이 이 문턱을 넘을 확률은 정의상 \(2.5\times10^{-5}\)이므로
이다. 거짓 양성이 하나라도 나올 확률은 \(1-(1-2.5\times10^{-5})^{1800} = 0.0440\), 곧 22번에 한 번쯤이다.
참 신호 쪽은 비중심 \(t\)를 쓴다. \(d = 0.5\), \(n = 50\)이므로 비중심모수가 \(\lambda = d\sqrt n = 0.5\sqrt{50} = 3.5355\)이고 자유도는 \(49\)다. 임계값은 \(t_{49}\)의 상위 \(1.25\times10^{-5}\) 분위수이고, 검정력은
이다. 따라서
다.
(2) 수치적으로.
from scipy import stats
from statsmodels.stats.multitest import multipletests

np.random.seed(42)

n_tests = 2000
n_true_alt = 200
n_obs = 50
effect_size = 0.5

p_values = np.zeros(n_tests)
truth = np.zeros(n_tests, dtype=int)
truth[:n_true_alt] = 1      # 앞의 200개만 참 신호, 나머지 1800개는 귀무

for i in range(n_tests):
    # 모의실험이라 정답을 알고 있다. 그래서 TP와 FP를 직접 셀 수 있다.
    # 실제 자료에서는 이 정보가 없으므로 FDR을 추정해야 한다.
    mu = effect_size if i < n_true_alt else 0.0
    data = np.random.normal(mu, 1.0, n_obs)
    _, p_values[i] = stats.ttest_1samp(data, 0)

# 세 보정 방법을 같은 p-값 묶음에 적용한다.
_, p_bonf, _, _ = multipletests(p_values, method="bonferroni")
_, p_holm, _, _ = multipletests(p_values, method="holm")
_, p_bh, _, _   = multipletests(p_values, method="fdr_bh")

alpha = 0.05
for name, adj_p in [("Bonferroni", p_bonf), ("Holm", p_holm), ("BH", p_bh)]:
    rejected = adj_p < alpha
    tp = np.sum(rejected & (truth == 1))
    fp = np.sum(rejected & (truth == 0))
    fdr = fp / max(np.sum(rejected), 1)
    power = tp / np.sum(truth == 1)
    print(f"{name:12s}: TP={tp}, FP={fp}, FDR={fdr:.3f}, Power={power:.3f}")
출력:
Bonferroni  : TP=28, FP=1, FDR=0.034, Power=0.140
Holm        : TP=28, FP=1, FDR=0.034, Power=0.140
BH          : TP=133, FP=9, FDR=0.063, Power=0.665
BH가 참 신호 200개 중 133개를 찾아내는 동안 Bonferroni는 28개만 찾는다. 검정력이 0.14 대 0.67로 다섯 배 가까이 차이가 난다.
그 대가는 거짓 양성 9개다. 기각한 142개 중 6.3%가 헛것이라는 뜻이며, 목표로 삼은 \(\alpha = 0.05\) 근처다(BH는 FDR의 기댓값을 통제하므로 한 번의 실현에서는 이보다 크거나 작을 수 있다).
거짓 양성 9개를 받아들이고 진짜 신호 105개를 더 얻는 거래다. 후속 실험으로 검증할 후보를 추리는 상황이라면 분명히 남는 장사다. 반면 규제 승인처럼 거짓 양성 하나가 치명적인 상황이라면 Bonferroni가 맞다.
Holm이 Bonferroni와 결과가 같다는 점도 눈에 띈다. Holm은 이론적으로 언제나 Bonferroni 이상으로 강력하지만, 신호가 아주 강한 몇 개뿐일 때는 실질적인 차이가 나타나지 않는다.
재표본추출 기반 FDR 추정
보기 3. 재표본으로 FDR 추정하기. 아래 함수는 집단 이름을 뒤섞어 귀무분포를 만들고, 가능한 모든 문턱 \(t\)에서
를 돌려준다. 여기서 \(R(t) = \#\{j : \lvert T_j \rvert \ge t\}\)는 실제 기각 수다.
(1) \(\hat V(t)\)가 무엇을 추정하는지 적고, 특징 \(m\)개 가운데 \(m_0\)개가 귀무일 때 이 추정량이 참 FDR의 몇 배로 치우치는지 구하시오.
(2) 특징 \(m = 200\)개(앞의 40개만 참 신호, \(\delta = 1\), 각 집단 25명)를 만들어 그 치우침을 수로 확인하시오.
풀이
(1) 해석적으로. 집단 이름을 뒤섞으면 두 집단의 차이가 모든 특징에서 지워진다. 신호가 있던 특징도 마찬가지다. 그러므로 순열 통계량 \(T^{(b)}_j\)는 \(j\)가 참 신호인지와 무관하게 귀무분포에서 나온 값처럼 행동하고,
이다. 여기서 \(p(t)\)는 귀무분포의 양측 꼬리확률이다.
그런데 실제로 거짓 양성을 낼 수 있는 특징은 귀무인 \(m_0\)개뿐이다. 참 신호가 기각되는 것은 거짓 양성이 아니다. 그러므로 참값은
이고, 두 식을 나누면 치우침이 바로 나온다.
이 추정량은 참 FDR을 정확히 \(1/\pi_0\)배로 과대평가한다. \(t\)에 의존하지 않는 상수배라는 점이 중요하다. 꼬리확률 \(p(t)\)가 분자와 분모에서 그대로 약분되기 때문이다.
방향이 보수적이라는 것도 함께 읽어야 한다. 과대평가이므로 이 추정값으로 문턱을 정하면 실제 FDR은 목표보다 낮다. 참 신호가 드문 상황(\(\pi_0 \approx 1\))에서는 치우침이 거의 없고, 신호가 많을 때만 손해가 커진다. 고차원 자료에서 \(\pi_0\)이 보통 0.9를 넘기 때문에 실무에서 이 추정량이 그대로 쓰이는 것이다. 바로잡고 싶으면 \(\hat\pi_0\)을 곱하면 되는데(스토리의 보정), 그 \(\hat\pi_0\)을 추정하는 일이 또 다른 문제를 만든다.
대신 이 방법이 사는 것은 분포 가정이 전혀 없다는 점이다. \(t\) 분포도 정규성도 쓰지 않고, 특징끼리 상관되어 있어도 순열이 그 상관을 고스란히 보존한 채로 귀무분포를 만든다.
(2) 수치적으로. 먼저 함수다. \(t\) 분포도 정규성 가정도 쓰지 않는다는 것이 요점이다.
def resampling_fdr(X_group1, X_group2, n_permutations=500):
    n1, n2 = X_group1.shape[0], X_group2.shape[0]
    n_features = X_group1.shape[1]
    X_combined = np.vstack([X_group1, X_group2])

    # 관측된 검정통계량
    t_obs = np.array([
        stats.ttest_ind(X_group1[:, j], X_group2[:, j]).statistic
        for j in range(n_features)
    ])

    # 집단 이름을 뒤섞어 만든 귀무분포. 모형을 가정하지 않는다.
    t_perm = np.zeros((n_permutations, n_features))
    for b in range(n_permutations):
        idx = np.random.permutation(n1 + n2)
        for j in range(n_features):
            t_perm[b, j] = stats.ttest_ind(
                X_combined[idx[:n1], j],
                X_combined[idx[n1:], j]
            ).statistic

    # 문턱마다 FDR을 추정한다.
    Rs, FDRs = [], []
    for thresh in np.sort(np.abs(t_obs)):
        R = np.sum(np.abs(t_obs) >= thresh)       # 실제 기각 수
        # 순열 자료에서 문턱을 넘은 총 개수를 순열 횟수로 나눈다.
        # 이것이 "H0가 참일 때 기대되는 기각 수", 즉 E[V]의 추정이다.
        V = np.sum(np.abs(t_perm) >= thresh) / n_permutations
        Rs.append(R)
        FDRs.append(V / max(R, 1))
    return np.array(Rs), np.array(FDRs)
이제 정답을 아는 자료를 만들어 (1)의 예측과 맞춘다. \(m = 200\), \(m_0 = 160\)이므로 치우침은 \(m/m_0 = 1.25\)배로 예측된다.
np.random.seed(0)

m, m1, n1, n2, delta = 200, 40, 25, 25, 1.0
m0 = m - m1
truth = np.zeros(m, dtype=int)
truth[:m1] = 1                      # 앞의 40개 특징만 참 신호

X1 = np.random.normal(0.0, 1.0, (n1, m))
X2 = np.random.normal(0.0, 1.0, (n2, m))
X2[:, :m1] += delta                 # 신호는 집단 2 의 평균을 delta 만큼 옮긴다

t_obs = np.array([stats.ttest_ind(X1[:, j], X2[:, j]).statistic
                  for j in range(m)])
Rs, FDRs = resampling_fdr(X1, X2, n_permutations=200)

df = n1 + n2 - 2
print(f"m = {m},  m0 = {m0},  m/m0 = {m / m0:.4f},  자유도 = {df}")

print("\n순열 귀무분포가 t_48 과 맞는가")
print("    t     순열 P(|T|>=t)    2*sf(t, 48)")
# resampling_fdr 안에서 쓴 것과 같은 순열을 다시 만들 수는 없으므로
# 같은 방식으로 새로 200 번 섞어 비교한다.
Xc = np.vstack([X1, X2])
cnt = np.zeros(4)
grid = np.array([1.0, 2.0, 2.5, 3.0])
B = 200
for b in range(B):
    idx = np.random.permutation(n1 + n2)
    tp = np.array([stats.ttest_ind(Xc[idx[:n1], j], Xc[idx[n1:], j]).statistic
                   for j in range(m)])
    cnt += [(np.abs(tp) >= g).sum() for g in grid]
for g, c in zip(grid, cnt):
    print(f"{g:5.1f}      {c / (B * m):11.6f}    {2 * stats.t.sf(g, df):11.6f}")

print("\n   R    문턱    FDR 추정   m*p(t)/R   m0*p(t)/R   비   실현 FDP")
thr = np.sort(np.abs(t_obs))
for k in range(len(thr)):
    R = Rs[k]
    if R not in (200, 100, 60, 50, 40, 30, 20):
        continue
    t = thr[k]
    p_t = 2 * stats.t.sf(t, df)
    sel = np.abs(t_obs) >= t
    fdp = np.sum(sel & (truth == 0)) / max(sel.sum(), 1)
    print(f"{R:4d} {t:7.4f}  {FDRs[k]:9.4f}  {m * p_t / R:9.4f}"
          f"   {m0 * p_t / R:9.4f}  {m * p_t / (m0 * p_t):5.2f}  {fdp:9.4f}")
출력:
m = 200,  m0 = 160,  m/m0 = 1.2500,  자유도 = 48

순열 귀무분포가 t_48 과 맞는가
    t     순열 P(|T|>=t)    2*sf(t, 48)
  1.0         0.322125       0.322325
  2.0         0.052850       0.051176
  2.5         0.016450       0.015890
  3.0         0.004375       0.004272

   R    문턱    FDR 추정   m*p(t)/R   m0*p(t)/R   비   실현 FDP
 200  0.0249     0.9807     0.9802      0.7842   1.25     0.8000
 100  0.9308     0.7107     0.7133      0.5706   1.25     0.6000
  60  1.5739     0.3944     0.4069      0.3255   1.25     0.3500
  50  1.8511     0.2711     0.2813      0.2250   1.25     0.2200
  40  2.1825     0.1635     0.1700      0.1360   1.25     0.0500
  30  2.9122     0.0350     0.0362      0.0290   1.25     0.0000
  20  3.5186     0.0065     0.0096      0.0077   1.25     0.0000
순열 귀무분포가 \(t_{48}\)과 맞는다. \(t = 2.0\)에서 \(0.0529\) 대 \(0.0512\), \(t = 2.5\)에서 \(0.0165\) 대 \(0.0159\)로 몬테카를로 오차(\(B \times m = 40{,}000\)개 추출이지만 같은 순열 안의 특징들이 함께 움직이므로 유효 표본은 그보다 작다) 안에서 일치한다. 정규자료라 당연한 결과이지만, 이 일치가 순열이 올바른 귀무분포를 만들고 있다는 점검이 된다.
치우침이 유도한 그대로다. 셋째 열(함수가 준 FDR 추정)과 넷째 열(\(m\,p(t)/R\), 곧 (1)이 예측한 극한)이 거의 겹친다. \(R = 200\)에서 \(0.9807\) 대 \(0.9802\), \(R = 100\)에서 \(0.7107\) 대 \(0.7133\), \(R = 50\)에서 \(0.2711\) 대 \(0.2813\)이다. 그리고 넷째 열은 다섯째 열(\(m_0\,p(t)/R\), 참값)의 정확히 \(1.25\)배다. 추정량이 참 FDR이 아니라 그것의 \(1/\pi_0\)배를 재고 있다는 것이 수로 확인된다.
마지막 열의 실현 FDP는 또 다른 것이다. \(R = 40\)에서 추정값은 \(0.1635\)인데 실제로 섞여 들어온 거짓 양성은 2개뿐이어서 \(0.05\)이고, \(R = 30\)과 \(R = 20\)에서는 \(0\)이다. FDR은 FDP의 기댓값이므로 한 번의 실현이 기댓값보다 크거나 작은 것은 이상한 일이 아니다. 특히 기각 수가 적을 때는 FDP가 \(0\) 아니면 \(1/R\) 꼴로 뚝뚝 끊기므로 한 번의 실현으로 추정값을 반박할 수 없다. 문턱을 고르는 데 쓰는 것은 추정 FDR 곡선이고, 실현 FDP는 모의실험에서만 볼 수 있는 값이다.
해석
- 가설 2,000개에 대해 \(\alpha = 0.05\)에서 보정 없이 검정하면 귀무가설 1,800개 중 약 \(0.05 \times 1800 = 90\)개가 잘못 기각될 것으로 기대되어 거짓 양성이 많이 나온다.
- Bonferroni는 거짓 양성을 거의 없애지만 검정력을 희생하여 참 효과를 많이 놓친다.
- Holm은 Bonferroni와 같은 FWER 통제를 제공하면서 검정력이 조금 낫다.
- BH (FDR)는 통제된 작은 비율의 거짓 발견을 감수하는 대신 검정력을 크게 높여, 유전체학 같은 고차원 상황에서 선호되는 방법이다.
- 재표본추출 FDR은 분포 가정을 아예 피하며 기각 수 대비 추정 FDR의 매끄러운 곡선을 준다. 검정통계량의 귀무분포를 모르거나 비표준적일 때 특히 유용하다.
연습문제
연습문제 1. \(m\)개 검정이 독립일 때 가족단위 오류율이 \(\text{FWER} = 1 - (1 - \alpha)^m\)을 만족함을 증명하라. 검정이 양의 상관을 가지면 어떻게 되는가?
풀이
독립일 때 \(m\)개 검정이 모두 올바르게 기각하지 않을 확률은 \((1-\alpha)^m\)이다. 여집합 법칙에 의해,
검정이 양의 상관을 가지면 아무것도 기각하지 않을 결합확률이 \((1-\alpha)^m\)보다 커지므로 실제 FWER은 독립 공식이 예측하는 것보다 작다. 이 경우 독립 가정이 FWER의 상한을 준다. \(\square\)
연습문제 2. 검정 2,000개 중 참 대립가설이 200개인 모의실험에서 보정 없이 검정할 때와 Bonferroni를 적용할 때 거짓 양성 수의 기댓값을 계산하라. 모의실험 출력과 대조해 확인하라.
풀이
\(\alpha = 0.05\)에서 보정 없이 검정하면 귀무가설 1,800개에서 나오는 거짓 양성의 기댓값은
Bonferroni에서는 각 검정을 \(\alpha/m = 0.05/2000 = 0.000025\)와 비교한다. 귀무가설(평균 0, \(n=50\))에서 일표본 \(t\)-통계량이 Bonferroni 문턱을 넘을 확률은 극도로 작으므로 \(E[V] \approx 1800 \times 0.000025 = 0.045\), 즉 평균적으로 거짓 양성이 거의 없다. 모의실험 결과가 이 기댓값에 가깝게 나올 것이다. \(\square\)
연습문제 3. BH 절차를 단계별로 설명하라. p-값을 정렬해 \(p_{(k)}\)를 \(k\alpha/m\)과 비교하는 것이 왜 FDR을 수준 \(\alpha\)로 통제하는가?
풀이
- \(m\)개 p-값을 오름차순으로 정렬한다: \(p_{(1)} \leq \cdots \leq p_{(m)}\).
- \(p_{(k)} \leq k\alpha/m\)을 만족하는 가장 큰 지표 \(k\)를 찾는다.
- 가설 \(H_{(1)}, \ldots, H_{(k)}\)를 모두 기각한다.
직관은 이렇다: 귀무가설 아래에서 p-값이 균등분포를 따르므로 \(k\)번째로 작은 p-값의 기댓값은 \(k/(m+1)\)이다. 문턱 \(k\alpha/m\)은 이 기대 간격의 \(\alpha\)배에 해당한다. Benjamini와 Hochberg(1995)는 검정통계량이 독립이면 이 절차가
를 보장함을 증명했다. 여기서 \(m_0\)은 참인 귀무가설의 개수이다. \(\square\)
연습문제 4. 재표본추출 FDR 절차에서 순열 기반 기각 수를 순열 횟수로 나누는 이유는 무엇인가? 순열이 너무 적으면 어떻게 되는가?
풀이
각 순열은 \(H_0\) 아래 검정통계량의 실현값 하나를 준다. 문턱을 넘는 순열 통계량의 평균 개수가 거짓 발견 수의 기댓값 \(E[V]\)를 추정한다. n_permutations로 나누는 것이 개수를 이 평균으로 바꾸는 일이다:
순열이 너무 적으면 \(\hat{V}\)에 잡음이 많아 FDR 추정을 믿을 수 없다. 특히 \(V\)가 작은 엄격한 문턱에서는 \(B\)가 작으면 참 기대 거짓 발견이 양수인데도 \(\hat{V} = 0\)이 나와 FDR을 과소추정할 수 있다. 실무적인 최소값은 \(B \geq 200\)이다. \(\square\)
연습문제 5. \(\alpha = 0.05\)와 \(\alpha = 0.10\)에서 BH를 비교하도록 모의실험을 고쳐라. 기각 수, FDR, 검정력은 어떻게 달라지는가? 맞바꿈을 설명하라.
풀이
for alpha in [0.05, 0.10]:
    _, p_bh, _, _ = multipletests(p_values, alpha=alpha, method="fdr_bh")
    rejected = p_bh < alpha
    tp = np.sum(rejected & (truth == 1))
    fp = np.sum(rejected & (truth == 0))
    fdr = fp / max(np.sum(rejected), 1)
    power = tp / np.sum(truth == 1)
    print(f"alpha={alpha}: Rejections={np.sum(rejected)}, "
          f"FDR={fdr:.3f}, Power={power:.3f}")
출력:
alpha=0.05: Rejections=142, FDR=0.063, Power=0.665
alpha=0.1: Rejections=179, FDR=0.128, Power=0.780
\(\alpha\)를 두 배로 올리면 기각이 142개에서 179개로 늘고 검정력이 0.665에서 0.780으로 오른다. 대신 FDR이 0.063에서 0.128로 함께 오른다.
늘어난 기각 37개의 내역을 보면 참 신호가 23개, 거짓 양성이 14개다. 즉 문턱을 늦출수록 새로 걸리는 것 중 헛것의 비율이 높아진다. 신호가 강한 것부터 먼저 걸리기 때문이다.
맞바꿈은 발견율과 신뢰성 사이에 있다. 후속 검증이 싸다면 \(\alpha = 0.10\)이, 비싸다면 0.05나 그보다 낮은 값이 맞다. \(\square\)
연습문제 6. 순열 기반 FDR 절차를 구현하라. 귀무분포를 순열로 추정하는 것이 이론적 분포를 쓰는 것보다 나은 경우는 언제인가?
풀이
절차(투시어·팁시라니·처의 SAM 계열).
- 관측 통계량 \(|t_1|,\dots,|t_m|\)을 계산한다.
- 표지를 \(B\)번 섞어 귀무 통계량 \(|t^*_{jb}|\)를 만든다.
- 문턱 \(c\)에 대해
- 관측 기각 수 \(R(c)=\#\{j:|t_j|>c\}\),
- 기대 거짓 수 \(\widehat V(c)=\dfrac1B\sum_b\#\{j:|t^*_{jb}|>c\}\).
- \(\widehat{\text{FDR}}(c)=\widehat V(c)/R(c)\)가 목표 이하가 되는 가장 작은 \(c\)를 고른다.
import numpy as np
from scipy import stats

rng = np.random.default_rng(202)
n, m, m1, B = 40, 500, 50, 500

rho = 0.6                                   # 결과변수 간 상관
S = rho * np.ones((m, m)) + (1 - rho) * np.eye(m)
L = np.linalg.cholesky(S)
g = np.repeat([0, 1], n // 2)
y = rng.standard_normal((n, m)) @ L.T
y[g == 1, :m1] += 1.0

def tstat(y, g):
    a, b = y[g == 0], y[g == 1]
    se = np.sqrt(a.var(0, ddof=1) / len(a) + b.var(0, ddof=1) / len(b))
    return np.abs(b.mean(0) - a.mean(0)) / se

t_obs = tstat(y, g)
null = np.empty((B, m))
for b in range(B):
    null[b] = tstat(y, rng.permutation(g))

grid = np.linspace(1.0, 6.0, 200)
best = None
for c in grid:
    R = (t_obs > c).sum()
    if R == 0:
        continue
    V = (null > c).sum() / B
    if V / R <= 0.05:
        best = (c, R, V / R)
        break
c, R, fdr_hat = best
true_V = (t_obs[m1:] > c).sum()
print(f"순열 FDR: 문턱 {c:.3f}, 기각 {R}개, 추정 FDR {fdr_hat:.4f}, "
      f"실제 거짓 {true_V}개 (실제 비율 {true_V / R:.4f})")

# 비교: 이론적 p-값 + BH
p = 2 * stats.t.sf(t_obs, n - 2)
o = np.argsort(p)
ok = np.where(p[o] <= 0.05 * np.arange(1, m + 1) / m)[0]
R2 = ok.max() + 1 if len(ok) else 0
V2 = (o[:R2] >= m1).sum()
print(f"이론 p + BH: 기각 {R2}개, 실제 거짓 {V2}개 "
      f"(실제 비율 {V2 / max(R2, 1):.4f})")
순열 FDR: 문턱 3.337, 기각 23개, 추정 FDR 0.0483, 실제 거짓 0개 (실제 비율 0.0000)
이론 p + BH: 기각 26개, 실제 거짓 0개 (실제 비율 0.0000)
두 방법이 비슷한 규모로 기각한다(23개 대 26개). 이 설정에서는 자료가 정규이고 상관이 양이라 이론적 방법도 잘 작동한다.
순열이 나은 경우 넷.
-
분포가정이 의심스러울 때. 자료가 치우쳤거나 꼬리가 두꺼우면 \(t\) 분포가 부정확하다. 순열은 그런 가정이 없다.
-
표본이 작을 때. 점근이론이 믿을 수 없는 영역.
-
상관 구조가 강하고 복잡할 때. 순열이 상관을 자동으로 보존한다. 이론적 방법은 독립이나 PRDS를 가정한다.
-
통계량이 비표준일 때. 사용자 정의 점수, 순위 기반 통계량 등.
순열의 한계 넷.
-
교환가능성이 필요하다. 무작위 배정이 아니면 근거가 약하다. 공변량이 있으면 층 내 순열 등으로 보완한다.
-
계산이 무겁다. \(B\times m\)번의 계산.
-
\(B\)가 해상도를 제한한다. 최소 추정 FDR이 \(1/(BR)\) 수준이다.
-
귀무분포가 오염된다. 참 신호가 많으면 순열 분포에 신호가 섞여 들어가 보수적이 된다. \(\pi_1\)이 크면 문제가 된다.
연습문제 7. 국소 FDR을 정의하고 전체 FDR과 어떻게 다른지 설명하라.
풀이
두 이혼합모형. 통계량 \(z\)의 주변밀도가
라 하자. \(f_0\)는 귀무분포, \(f_1\)은 대립분포다.
국소 FDR.
꼬리 FDR(=통상의 FDR).
import numpy as np
from scipy import stats

pi0 = 0.90
mu1, s1 = 3.0, 1.0                 # 대립분포 N(3,1)

def f0(z):
    return stats.norm.pdf(z)

def f1(z):
    return stats.norm.pdf(z, mu1, s1)

def fdr_local(z):
    return pi0 * f0(z) / (pi0 * f0(z) + (1 - pi0) * f1(z))

def fdr_tail(z):
    return (pi0 * stats.norm.sf(z)
            / (pi0 * stats.norm.sf(z) + (1 - pi0) * stats.norm.sf(z, mu1, s1)))

print(f"{'z':>5s} {'국소 fdr':>10s} {'꼬리 Fdr':>10s}")
for z in [1.5, 2.0, 2.5, 3.0, 3.5, 4.0, 5.0]:
    print(f"{z:5.1f} {fdr_local(z):10.4f} {fdr_tail(z):10.4f}")
    z    국소 fdr    꼬리 Fdr
  1.5     0.8438     0.7239
  2.0     0.7326     0.5688
  2.5     0.5786     0.3999
  3.0     0.4000     0.2519
  3.5     0.2338     0.1418
  4.0     0.1177     0.0714
  5.0     0.0184     0.0116
국소 fdr이 언제나 꼬리 Fdr보다 크다. \(z=3.0\)에서 0.400 대 0.252다.
왜 그런가. 꼬리 FDR은 \(z\)보다 더 극단적인 것들까지 평균한 값이다. 그중에는 거의 확실히 참인 신호가 섞여 있어 비율이 낮아진다. 국소 fdr은 딱 그 지점의 확률이다.
실무적 함의 — 중요하다.
"BH로 \(q=0.05\)에서 200개를 기각했다"면, 목록 전체의 거짓 비율이 5%라는 뜻이다. 그런데 경계 근처의 개별 발견은 훨씬 불확실하다. 위 표를 보면 \(\text{Fdr}=0.05\)가 되는 지점 근처에서 국소 fdr은 0.08~0.12다.
따라서 "목록의 맨 끝에 있는 발견"을 개별적으로 신뢰하면 안 된다. 순위가 낮을수록 개별 신뢰도가 낮다.
국소 fdr의 추정. \(f(z)\)는 관측된 통계량들의 밀도로 추정할 수 있고(커널이나 스플라인), \(f_0\)는 이론적 귀무분포나 경험적 귀무분포로 잡는다. 에프론의 locfdr 계열 방법이 표준이다.
경험적 귀무분포. 실제 자료에서 귀무분포가 \(N(0,1)\)이 아닌 경우가 흔하다(측정 배치 효과, 미조정 공변량). 중앙 부분에 정규분포를 적합해 \(\hat f_0\)를 추정하면 훨씬 정확한 fdr이 나온다.
언제 국소 fdr을 쓰는가.
- 개별 발견의 신뢰도를 보고해야 할 때.
- 순위를 매겨 상위 몇 개를 검증할 때. 국소 fdr이 그 판단에 직접 쓰인다.
- 베이즈 해석이 자연스러운 맥락.
연습문제 8. 재표본추출 횟수 \(B\)가 결과에 미치는 영향을 정량화하고, 몇 번이 적당한지 정하라.
풀이
\(B\)가 제한하는 것 셋.
1 — \(p\)-값의 해상도. 최소 가능한 \(p\)-값이 \(1/(B+1)\)이다.
다중검정에서 이것이 결정적이다. \(m=1000\)이고 본페로니 문턱이 \(5\times10^{-5}\)라면, \(B\ge20{,}000\)이어야 그 문턱에 도달할 수 있다.
2 — 몬테카를로 오차. 참 \(p\)-값이 \(p\)일 때
import numpy as np

print(f"{'B':>8s} {'p=0.05 의 SE':>13s} {'p=0.01 의 SE':>13s} "
      f"{'최소 p':>10s}")
for B in [99, 999, 9_999, 99_999]:
    print(f"{B:8d} {np.sqrt(0.05 * 0.95 / B):13.5f} "
          f"{np.sqrt(0.01 * 0.99 / B):13.5f} {1 / (B + 1):10.2e}")
       B   p=0.05 의 SE   p=0.01 의 SE       최소 p
      99       0.02190       0.00998   1.00e-02
     999       0.00689       0.00315   1.00e-03
    9999       0.00218       0.00099   1.00e-04
   99999       0.00069       0.00031   1.00e-05
\(B=99\)면 \(p=0.05\)의 표준오차가 0.022다. 0.05와 0.10을 구별하기 어렵다.
3 — 결론의 안정성. 같은 자료를 두 번 분석하면 다른 답이 나올 수 있다. 경계 근처에서 특히 그렇다.
권장 \(B\).
| 목적 | 권장 \(B\) |
|---|---|
| 대략적 탐색 | 999 |
| 단일 검정의 \(p\)-값 보고 | 9,999 |
| 다중검정(본페로니) | \(\ge10\,m/\alpha\) |
| FDR 추정 | 1,000~10,000 |
| 신뢰구간의 꼬리 분위수 | 9,999 이상 |
\(10^k-1\) 꼴로 잡는 이유. 앞서 본 대로 \((b+1)/(B+1)\)이 \(\alpha\)를 정확히 맞추기 때문이다.
순차적 절약. 앞서 본 대로 \(p\)가 크다는 것이 일찍 분명해지면 중단한다. 다중검정에서 대부분의 검정이 일찍 끝나므로 전체 계산이 크게 준다.
재현성. \(B\)가 얼마든 씨앗을 고정하고 보고한다. 그러면 남이 정확히 같은 결과를 얻을 수 있다.
연습문제 9. FDR 추정에서 귀무분포를 잘못 잡으면 어떤 일이 생기는지 보이고, 경험적 귀무분포의 필요성을 설명하라.
풀이
문제. 이론적으로 \(Z\sim N(0,1)\)이어야 하는데, 실제 자료에서는
인 경우가 흔하다. 원인은 미조정 공변량, 배치 효과, 관측값 간 숨은 상관, 과대·과소산포다.
import numpy as np
from scipy import stats

rng = np.random.default_rng(404)
m, m1 = 5_000, 250

for sigma0 in [1.0, 1.2, 1.5]:
    z = rng.normal(0, sigma0, m)          # 귀무 통계량이 퍼져 있음
    z[:m1] = rng.normal(3.5, 1.0, m1)     # 참 신호
    p = 2 * stats.norm.sf(np.abs(z))      # N(0,1) 을 가정한 p-값

    o = np.argsort(p)
    ok = np.where(p[o] <= 0.05 * np.arange(1, m + 1) / m)[0]
    R = ok.max() + 1 if len(ok) else 0
    V = (o[:R] >= m1).sum()
    print(f"σ0 = {sigma0}: BH 기각 {R:4d}개, 실제 거짓 {V:4d}개, "
          f"실제 FDR {V / max(R, 1):.4f}")
σ0 = 1.0: BH 기각  163개, 실제 거짓    8개, 실제 FDR 0.0491
σ0 = 1.2: BH 기각  225개, 실제 거짓   46개, 실제 FDR 0.2044
σ0 = 1.5: BH 기각  471개, 실제 거짓  289개, 실제 FDR 0.6136
\(\sigma_0=1.2\)만 되어도 실제 FDR이 0.20으로 목표의 네 배가 된다. \(\sigma_0=1.5\)면 0.61이다. 목표는 0.05였다.
왜 이렇게 파괴적인가. \(p\)-값이 \(N(0,1)\)을 기준으로 계산되는데 실제 분포가 더 넓으면, 귀무 통계량이 작은 \(p\)-값을 대량 생산한다. BH는 그 \(p\)-값들을 신호로 착각한다.
경험적 귀무분포. 관측된 \(z\)들의 중앙 부분(대부분 귀무)에 정규분포를 적합해 \(\hat\delta\), \(\hat\sigma_0\)를 추정하고, 그것으로 \(p\)-값을 다시 계산한다.
from scipy.optimize import curve_fit

rng = np.random.default_rng(404)
z = rng.normal(0, 1.2, m)
z[:m1] = rng.normal(3.5, 1.0, m1)

mid = z[np.abs(z) < 2]                   # 중앙 부분
print(f"경험적 귀무: 중심 {mid.mean():.3f}, 척도 "
      f"{mid.std(ddof=1) / np.sqrt(1 - 2 * 2 * stats.norm.pdf(2)
                                   / (2 * stats.norm.cdf(2) - 1)):.3f}")
경험적 귀무: 중심 0.012, 척도 1.104
척도 1.104가 참값 1.2 쪽으로 크게 움직였다(보정 없이 그냥 표준편차를 쓰면 1.0 근처로 나온다). 절단 구간을 넓히거나 최대가능도로 적합하면 더 정확해진다.
실무 지침.
-
\(z\) 값의 히스토그램을 반드시 그린다. 중앙 부분이 \(N(0,1)\)보다 넓은지 눈으로 확인한다.
-
넓다면 원인을 찾는다. 배치 효과, 누락 공변량, 군집 구조. 원인을 고치는 것이 최선이다.
-
고칠 수 없으면 경험적 귀무분포를 쓴다. 에프론의 방법이 표준이다.
-
순열 귀무분포도 대안이다. 다만 순열이 문제의 상관 구조를 보존하는지 확인해야 한다.
일반 교훈. 다중검정 보정은 개별 \(p\)-값이 타당할 때만 의미가 있다. \(m\)이 클수록 작은 오설정이 크게 증폭되므로, 대규모 검정에서 이 점검이 더욱 중요하다.
연습문제 10. 대규모 다중검정 분석의 점검 목록을 만들어라.
풀이
자료 준비 단계.
- [ ] 배치·기기·날짜 효과를 확인하고 보정했는가.
- [ ] 결측 패턴이 검정 결과와 관련되지 않는가.
- [ ] 이상치와 품질 불량 표본을 사전 정의된 기준으로 처리했는가.
- [ ] 변환·정규화 방법을 사전에 정했는가.
검정 단계.
- [ ] 개별 검정의 가정이 타당한가(분포, 등분산, 독립).
- [ ] 표본이 작은 항목에서 근사가 성립하는가.
- [ ] 이산성이 심한 항목이 있는가.
진단 단계 — 가장 자주 빠뜨린다.
- [ ] \(p\)-값의 히스토그램을 그렸는가. 균등분포 + 0 근처 봉우리 형태인가.
- [ ] \(z\) 통계량의 중앙 부분이 \(N(0,1)\)에 맞는가. 아니면 경험적 귀무분포가 필요하다.
- [ ] \(p\)-값이 1 근처에 몰려 있지 않은가(과도한 보수성의 신호).
- [ ] 검정통계량과 표본크기·평균의 관계에 이상한 추세가 없는가.
보정 단계.
- [ ] \(m\)을 정확히 셌는가(필터링으로 뺀 것 포함 여부를 명시).
- [ ] FWER과 FDR 중 무엇이 목적에 맞는가.
- [ ] 종속 구조를 고려했는가.
- [ ] 적응형 \(\pi_0\) 추정이 적절한가.
해석 단계.
- [ ] 기각 수와 예상 거짓발견 수를 함께 보고했는가.
- [ ] 경계 근처 발견의 개별 신뢰도(국소 fdr)를 고려했는가.
- [ ] 효과크기가 실무적으로 의미 있는가. 통계적 유의성만으로 목록을 만들지 않았는가.
- [ ] 후속 검증 계획이 있는가.
보고 단계.
- [ ] 원 \(p\)-값, 보정 \(p\)-값/\(q\)-값, 효과크기, 표준오차를 모두 제공했는가.
- [ ] 방법, \(m\), \(\alpha\)/\(q\), 소프트웨어 버전, 난수 씨앗을 적었는가.
- [ ] 전체 결과를 보충자료로 공개했는가.
- [ ] 사전 계획과 달라진 점을 밝혔는가.
가장 흔한 세 가지 실패.
- \(p\)-값 히스토그램을 안 그린다. 이 하나만으로 많은 문제가 드러난다.
- 효과크기를 무시한다. \(q<0.05\)지만 변화가 1%인 것들로 목록이 가득 찬다.
- 필터링을 보고하지 않는다. "발현량이 낮은 유전자를 뺐다"면 \(m\)이 달라지고, 필터링 기준이 자료에 의존하면 편향이 생긴다.
한 문장. 대규모 다중검정에서 통계적 보정은 마지막 단계이며, 그 앞의 자료 품질과 진단이 결과를 좌우한다.
정리하며
세 전략을 같은 자료에서 나란히 돌려 보았다.
- 보정하지 않으면 거짓 양성이 쏟아진다. \(m\) 이 커질수록 심해지며, 모의실험이 \(1-(1-\alpha)^m\) 을 그대로 재현한다.
- 본페로니·홀름은 거짓 양성을 거의 없애지만 실제 효과도 함께 놓친다. \(m\) 이 클수록 그 손실이 커진다.
- BH 절차가 중간을 잡는다. 거짓 발견 비율을 \(q\) 근처로 유지하면서 훨씬 많은 실제 효과를 건진다.
- 순열 기반 FDR 은 분포 가정을 쓰지 않는다. 귀무 분포를 자료에서 직접 만들어 내므로, 검정통계량의 이론적 분포가 불확실하거나 검정들이 복잡하게 얽혀 있을 때 유용하다. 대신 계산이 비싸다.
- 어느 방법도 검정력을 공짜로 주지 않는다. 통제 대상을 무엇으로 하느냐가 곧 무엇을 포기하느냐다.
이것으로 9장이 끝난다. 가설검정의 논리에서 시작해 일표본·이표본·대응 검정을 훑고, 두 오류와 검정력을 보았으며, 검정을 여러 번 할 때의 문제와 그 처방까지 다뤘다.
다음 장 카이제곱 검정으로 넘어간다. 지금까지 평균과 비율을 다뤘다면, 이제 범주형 자료의 분포 전체를 검정한다.