소프트맥스 함수와 확률단체¶
모형의 출력은 실수 몇 개일 뿐이어서 그대로는 확률이 아니다. 음수일 수도 있고 합이 \(1\) 이 되지도 않는다. 그것을 확률로 옮기는 함수 하나를 고르고 나면 놀라운 일이 따라온다 — 교차엔트로피를 그 함수와 함께 쓰면 손실의 기울기가 예측에서 정답을 뺀 것으로 끝나고, 이 쪽에서 수치미분으로 재어 보면 \([0.250551,\ 0.012474,\ -0.944094,\ 0.681069]\) 가 소수 여섯째 자리까지 그대로 나온다. 그 간결함은 어디서 오고, 함수를 다르게 골랐다면 무엇이 달라지는가.
1. 소프트맥스 함수와 그 성질¶
정의 1. 소프트맥스 함수¶
소프트맥스 함수(softmax function)는 \(C\)개의 실숫값 로짓으로 이루어진 벡터 \(\mathbf{z}=(z_1,\ldots,z_C)\)를 확률분포로 옮긴다.
AI로 보는 통계학 1. 로그합지수를 미분하면 확률이 나온다
지수함수와 자연로그의 도함수 \((e^{x})'=e^{x}\) 와 \((\ln x)'=\dfrac1x\) 는 서로 역함수인 둘을 미분한 것이라 언뜻 당연해 보인다. 그런데 이 둘을 연달아 쓰면 오늘 기계가 무엇을 고를지 배우는 방식이 통째로 떨어져 나온다.
기계가 네 갈래 가운데 하나를 고르는 일을 배운다고 하자. 모형이 내놓는 것은 확률이 아니라 갈래마다의 점수 \(z_1,\dots,z_C\) 다. 음수일 수도 있고 합이 \(1\) 일 까닭도 없으니, 확률로 바꾸려면 먼저 모두 양수로 만들고 합으로 나눈다 — 바로 위 정의 1 이 그 장치다. 이제 핵심이다. 그 분모의 로그, 곧 로그–합–지수(log-sum-exp)
를 \(z_k\) 로 미분해 보자. \((\ln x)'=\dfrac1x\) 와 \((e^{x})'=e^{x}\) 를 연쇄법칙으로 이으면 바깥에서 \(\dfrac{1}{\sum_j e^{z_j}}\) 가, 안에서 \(e^{z_k}\) 가 나와
다. 로그–합–지수를 미분하면 소프트맥스가 그대로 나온다. 학습에 쓰는 손실은 정답 갈래 \(y\) 의 확률에 로그를 씌워 뒤집은 \(-\ln p_y=L(\mathbf z)-z_y\) 이므로, 그 기울기는
곧 「내가 매긴 확률 빼기 정답」이다. 고쳐야 할 방향이 뺄셈 한 번으로 끝난다.
import numpy as np

z = np.array([2.0, -1.0, 0.5, 3.0])          # 모형이 네 갈래에 매긴 점수
y = 2                                         # 정답은 세 번째 (0 부터 센다)

lse  = lambda z: np.log(np.sum(np.exp(z)))    # 로그–합–지수 L(z)
loss = lambda z: lse(z) - z[y]                # 교차엔트로피 = -ln p_y

p = np.exp(z) / np.sum(np.exp(z))             # 소프트맥스 — 점수를 확률로
e, h = np.eye(len(z)), 1e-6
num = np.array([(loss(z + h*v) - loss(z - h*v)) / (2*h) for v in e])   # 수치미분
                                              # 손으로 얻은 기울기는 p - 정답
hand = p - np.eye(len(z))[y]                  # 두 도함수를 이은 결과

np.set_printoptions(precision=6, suppress=True)
print("소프트맥스 p        ", p)
print("p - 정답            ", hand)
print("수치미분으로 잰 기울기", num)
print("두 줄의 최대 차이    ", "%.2e" % np.max(np.abs(hand - num)))
실행하면 다음이 나온다.
소프트맥스 p         [0.250551 0.012474 0.055906 0.681069]
p - 정답             [ 0.250551  0.012474 -0.944094  0.681069]
수치미분으로 잰 기울기 [ 0.250551  0.012474 -0.944094  0.681069]
두 줄의 최대 차이     2.52e-10
손으로 얻은 \(p-\text{정답}\) 과 기계가 수치미분으로 잰 기울기가 소수점 아래 열 자리까지 같다. 정답 자리만 음수인 것도 읽을 거리다 — 그 갈래는 점수를 올리라는 뜻이고 나머지 셋은 내리라는 뜻이며, 올리고 내리는 크기가 지금 매긴 확률에 그대로 비례한다. 확신에 찬 오답일수록 세게 고쳐진다. 이 기울기를 가중치까지 밀고 내려가는 일이 교차엔트로피 손실에서 하는 일이다.
한 가지가 더 딸려 온다. \(\sum_j e^{z_j}\) 를 적힌 대로 계산하면 점수가 조금만 커져도 \(e^{z}\) 가 넘쳐 버린다. 그래서 가장 큰 점수 \(m\) 을 뽑아내어 \(L(\mathbf z)=m+\ln\sum_j e^{z_j-m}\) 으로 고쳐 쓴다. 이것은 로그의 덧셈 법칙 \(\ln(e^{m}X)=m+\ln X\) 한 줄일 뿐이다.
zz = np.array([1000.0, 1001.0])               # 점수가 조금 큰 경우
m  = zz.max()                                 # 가장 큰 점수를 뽑아낸다

print("큰 점수에서 그대로 셈하면 — z = [1000, 1001]")
print("  그대로       :", np.log(np.sum(np.exp(zz))))          # e^1000 이 넘친다
print("  최댓값을 빼고 :", m + np.log(np.sum(np.exp(zz - m))))  # 지수가 0 과 -1 뿐
실행하면 다음이 나온다.
큰 점수에서 그대로 셈하면 — z = [1000, 1001]
  그대로       : inf
  최댓값을 빼고 : 1001.3132616875182
(첫 줄의 inf 는 \(e^{1000}\) 이 컴퓨터가 담을 수 있는 수를 넘겨 생긴 것이라, 실제로
돌리면 위 출력과 함께 넘침을 알리는 경고 한 줄이 따로 뜬다.)
이 고쳐 쓰기를 떠받치는 것이 바로 아래 성질 4 의 평행이동 불변성이고, 그 이야기를 자세히 다루는 곳이 수치적 안정성이다.
다만 이 식이 말해 주는 것은 어느 쪽으로 고칠지까지다. 얼마나 갈지, 몇 번 갈지는 한 줄로 떨어지지 않아서 지금도 손으로 더듬어 정한다.
양수이고 합이 1 이라 확률로 읽힌다¶
- 비음성: 모든 출력이 엄밀히 양수다.
- 합이 1: \(\sum_c\operatorname{softmax}(\mathbf{z})_c = 1\).
- 단조성: 로짓 \(z_c\)가 클수록 확률도 크다.
- 평행이동 불변성: 임의의 스칼라 \(\alpha\)에 대해 \(\operatorname{softmax}(\mathbf{z}+\alpha\mathbf{1}) = \operatorname{softmax}(\mathbf{z})\).
성질 4는 수치적 안정성에 활용된다. 지수화하기 전에 \(\max_c z_c\)를 뺀다.
그림으로 보는 통계학 1. 이 식의 분모에 이름을 붙인 쪽
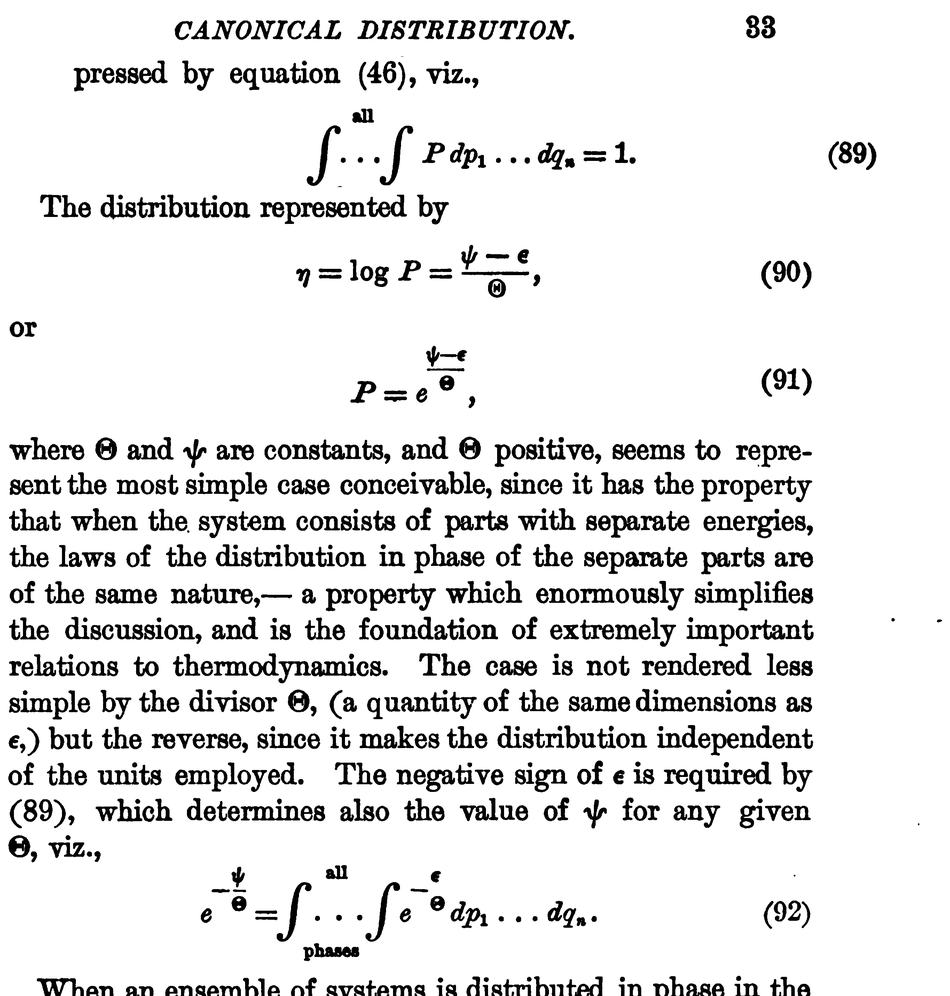
기브스 『통계역학의 기본 원리』(뉴욕, \(1902\)) 인쇄 \(33\) 쪽. 머리글과 식 \((89)\)~\((92)\) 를 잘라 붙였다. \((89)\) 는 「모두 더하면 \(1\)」, \((91)\) 이 \(P=e^{(\psi-\epsilon)/\Theta}\), 그리고 \((92)\) 가 그 \(\psi\) 를 정하는 식으로 모든 상태에 걸쳐 \(e^{-\epsilon/\Theta}\) 를 더한 것이다. (Internet Archive 스캔, PD-old)
정의 1 의 식이 물리학에서 먼저 쓰인 자리다. 사진의 두 식 \((91)\) 과 \((92)\) 를 합치면
이고, \(z_c=-\dfrac{\epsilon_c}{\Theta}\) 로 두면 정의 1 의
와 글자만 다른 같은 식이다. 적분이 합으로 바뀌었을 뿐이다. 기브스는 이 분포에 정준분포라는 이름을 붙이고, 에너지를 나누는 \(\Theta\) 를 다음 쪽에서 「분포의 모듈러스」라 부른다. 물리에서 그 자리에 들어가는 것이 온도다.
식 \((92)\) 가 하는 일을 눈여겨볼 만하다. 그것은 분모를 정하는 식이다. 분자만으로는 확률이 되지 않으니 전부 더해 \(1\) 로 맞추는 것인데, 정의 1 이 분모에 \(\sum_{c'}e^{z_{c'}}\) 을 놓는 까닭과 똑같다. 물리에서는 이 분모에 따로 이름이 붙어 있다 — 분배함수다.
위의 성질 4, 곧 모든 \(z_c\) 에 같은 수를 더해도 확률이 그대로라는 평행이동 불변성도 여기서 보면 당연한 말이 된다. \(\epsilon_c\) 를 모두 같은 만큼 올리는 것은 에너지를 어디서부터 재느냐를 바꾸는 일일 뿐이고, 그것으로 계의 분포가 달라질 리 없다. 식 \((91)\) 의 \(\psi\) 가 바로 그 기준점을 흡수해 주는 자리다.
이 식은 오늘 기계가 여러 후보 가운데 하나를 고를 때 그대로 쓰인다. 후보마다 점수 \(z_c\) 를 매기고 지수 비율로 바꾸어 확률처럼 다루는데, 그때 점수를 나누는 수를 지금도 온도라 부른다 — \(4\) 절의 \(\tau\) 가 그것이고, 이름이 사진의 \(\Theta\) 에서 건너온 것이다.
확인한 곳 — 머리글 「CANONICAL DISTRIBUTION. \(33\)」과 식 \((89)\)·\((90)\)·\((91)\)·\((92)\) 는 Internet Archive: elementaryprinc00gibbgoog (기브스 『Elementary Principles in Statistical Mechanics』, \(1902\))의 낱장 n\(59\) 에서 사진으로 직접 읽었다 · 「canonically distributed」와 「the modulus of distribution」이라는 이름은 다음 낱장 n\(60\)(인쇄 \(34\) 쪽)에서 읽었다 · 같은 쪽의 「the difference \(\psi-\epsilon\) will represent a perfectly definite amount of energy, which is entirely independent of the zero of energy which we may choose to adopt」가 평행이동 불변성을 기브스 자신의 말로 적은 대목이다 · 발행지와 간행년은 같은 스캔의 표제지(낱장 n\(11\))에서 「NEW YORK: CHARLES SCRIBNER'S SONS · LONDON: EDWARD ARNOLD · \(1902\)」로 읽었다 · 분모를 분배함수라 부르는 것과, 기계학습에서 같은 자리를 온도라 부르는 것은 Wikipedia 「Softmax function」
2. 확률단체¶
소프트맥스의 출력은 확률단체
위에 놓인다. \(C=3\)이면 3차원 공간 안의 삼각형이고, \(C=10\)(MNIST)이면 9차원 단체다.
3. 시그모이드의 일반화로서의 소프트맥스¶
\(C=2\)이고 로짓이 \((z_1,z_2)\)일 때,
이다. 즉 이항 소프트맥스는 두 로짓의 차에 시그모이드를 적용한 것과 정확히 같다.
4. 온도 척도화¶
흔히 쓰는 변형으로 온도 모수 \(\tau>0\)를 도입한다.
\(\tau\to 0\)이면 분포가 \(\arg\max_c z_c\)에 집중된 점질량으로 수렴하고(확정적 결정), \(\tau\to\infty\)이면 균등분포에 가까워진다. 온도 척도화는 모형 보정(calibration, 예측확률을 실제 빈도에 맞추는 일)과 생성모형(예: 언어모형의 "창의성" 조절)에 쓰인다.
5. 단체 위에서 보기¶
\(C = 3\)이면 확률단체가 평면 위의 정삼각형이므로 그림으로 그릴 수 있다. 꼭짓점은 각각 \((1,0,0)\), \((0,1,0)\), \((0,0,1)\)이고, 삼각형 안의 한 점이 확률벡터 하나다.
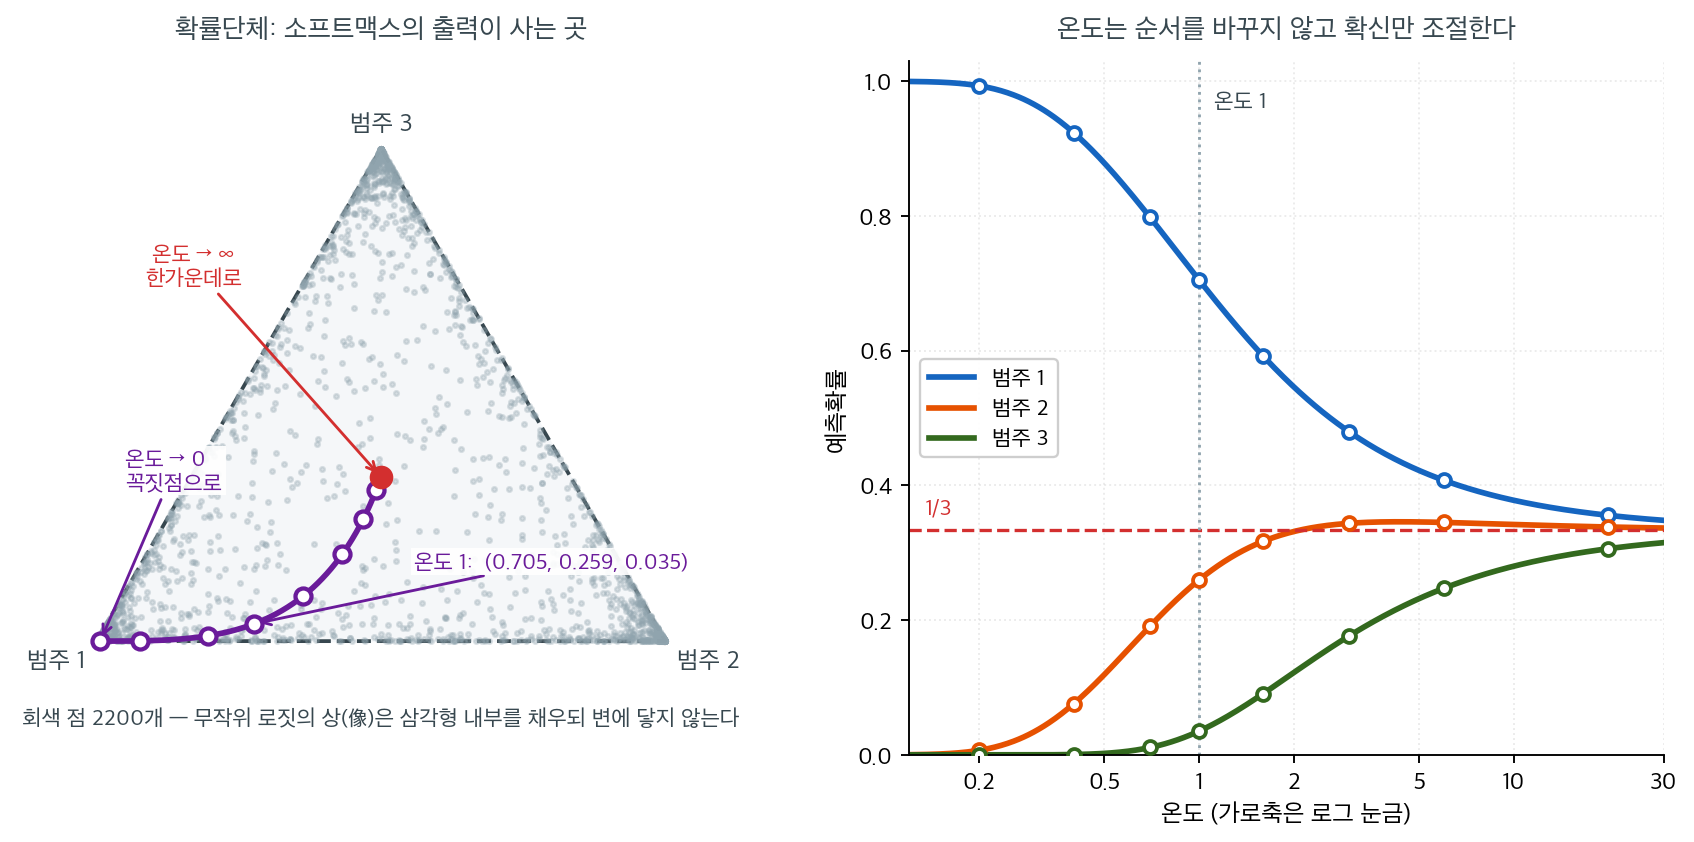
왼쪽 그림의 회색 점 \(2200\)개는 \([-5, 5]^3\)에서 무작위로 뽑은 로짓을 소프트맥스로 보낸 상이다. 삼각형 내부를 고르게 채우지만 변이나 꼭짓점에는 한 점도 닿지 않는다. 실제로 이 \(2200\)개 확률벡터의 성분 중 가장 작은 값이 \(4.3 \times 10^{-5}\)로, 작지만 엄밀히 양수다. 앞의 성질 1이 "비음성"이 아니라 "엄밀히 양수"였던 이유가 여기에 있다. \(e^{z_c} > 0\)이므로 확률이 정확히 \(0\)이 되려면 \(z_c = -\infty\)여야 하고, 유한한 가중치로는 도달할 수 없다. 소프트맥스의 상은 닫힌 단체 \(\Delta^{2}\)가 아니라 그 내부다. 이것이 분리 가능한 자료에서 가중치가 발산하는 현상의 기하학적 뿌리이기도 하다.
보라색 경로는 연습문제 1의 로짓 \(\mathbf{z} = (2, 1, -1)\)을 온도만 바꿔 가며 보낸 자취다. 온도 \(1\)에서는 \((0.705,\ 0.259,\ 0.035)\)로 범주 1 쪽에 치우친 점이고, 온도를 \(0.2\)까지 낮추면 \((0.9933,\ 0.0067,\ 0.0000)\)으로 꼭짓점에 거의 붙는다. 반대로 온도를 \(20\)까지 올리면 \((0.3556,\ 0.3383,\ 0.3061)\)로 빨간 점, 즉 중심 \((1/3, 1/3, 1/3)\)에 다가간다. 온도는 이 경로 위에서 점을 앞뒤로 밀 뿐이다.
오른쪽 그림은 같은 이야기를 좌표별로 풀어 쓴 것이다. 세 곡선은 온도가 아무리 바뀌어도 서로
교차하지 않는다. 항상 범주 1 > 범주 2 > 범주 3이다. 로짓의 순서는 \(\tau > 0\)으로 나누어도
보존되기 때문이다. 그래서 온도를 바꾸어도 argmax가 고르는 답, 즉 예측 이름표는 결코 달라지지
않는다. 달라지는 것은 오직 확신의 정도다. 온도 척도화가 정확도는 건드리지 않으면서 보정만
고치는 도구로 쓰이는 이유가 바로 이것이다.
6. 넘침을 피하려면 최댓값을 먼저 뺀다¶
보기 1. 소프트맥스 구현. 성질 4를 써서 넘침에 견디는 소프트맥스를 만든다.
(1) 최댓값을 빼지 않은 소박한 구현은 배정도에서 정확히 어느 로짓 값부터 망가지는가. 그 임계값을 구하고, 망가질 때 나오는 값이 무엇인지 미리 말하시오.
(2) \(\mathbf{z} = (710, 0, -710)\)과 \(\mathbf{z} = (2, 1, -1)\)을 두 구현에 넣어 (1)을 확인하시오. 최댓값을 뺀 뒤에도 남는 언더플로(underflow)는 왜 해롭지 않은가.
풀이
(1) 임계값을 먼저 계산한다. 배정도 부동소수점이 담을 수 있는 가장 큰 유한수는
이므로 \(e^z\)가 넘치지 않을 조건은 \(z \le \log(1.7977 \times 10^{308}) = 709.7827\)이다. 곧 \(z = 709\)까지는 \(e^{709} = 8.2184 \times 10^{307}\)로 멀쩡하고, \(z = 710\)에서 inf가 된다. 임계값은 \(709.78\)이다.
넘치면 무슨 값이 나오는가. \(\mathbf{z} = (710, 0, -710)\)을 소박한 식에 넣으면 분자가 \(e^{710} = \infty\), 분모도 \(\infty + 1 + 0 = \infty\)이므로 첫 성분이 $\infty/\infty = $ nan이다. 둘째 성분은 \(1/\infty = 0\), 셋째도 \(0\)이다. 그래서 \((\texttt{nan}, 0, 0)\)이 나온다. 확률벡터이기를 그치는 것은 물론이고 합조차 nan이다.
참값은 무엇인가. 성질 4로 \(\mathbf{z}\)에서 \(\max_c z_c = 710\)을 빼면 \((0, -710, -1420)\)이고
이다. \(e^{-710} = 4.4763 \times 10^{-309}\)이고 \(e^{-1420} \approx 10^{-617}\)이므로 분모는 \(1\)과 \(10^{-309}\) 차이밖에 없다. 배정도의 기계 입실론이 \(2.2 \times 10^{-16}\)이니 분모는 정확히 \(1.0\)으로 반올림된다. 따라서 바르게 반올림된 답은
이다. 셋째 성분의 참값 \(e^{-1420}\)은 배정도의 최소 양수 \(4.9407 \times 10^{-324}\)보다도 작아 \(0\)이 가장 가까운 표현 가능한 수다.
(2) 수치적으로.
import numpy as np

# 이 쪽 §1 의 블록이 켜 둔 suppress=True 를 끈다. 이 블록이 보이려는 것이
# 4.4763e-309 라는 **비정규수**인데, 켜 둔 채로는 그 수가 0. 으로 찍혀
# 교훈이 사라진다. 출력 설정은 블록을 넘어 살아 있다.
np.set_printoptions(precision=8, suppress=False)

def softmax(z):
    """수치적으로 안정한 소프트맥스.

    가장 큰 값을 빼고 나서 exp 를 씌운다. 지수가 커지면 exp 가 넘쳐
    inf 가 되는데, 모든 항에서 같은 값을 빼면 분자와 분모에서 약분되어
    결과는 그대로이면서 넘침만 막을 수 있다.
    """
    z_shifted = z - np.max(z, axis=1, keepdims=True)
    exp_z = np.exp(z_shifted)
    return exp_z / np.sum(exp_z, axis=1, keepdims=True)

def softmax_naive(z):
    """최댓값을 빼지 않은 꼴. 견주어 보려고만 둔다."""
    exp_z = np.exp(z)
    return exp_z / np.sum(exp_z, axis=1, keepdims=True)

# 넘침과 언더플로의 임계값을 수로 확인한다.
big = np.finfo(np.float64).max
tiny = np.finfo(np.float64).smallest_subnormal
print(f"배정도 최대 유한수  {big:.4e}   log = {np.log(big):.4f}")
print(f"배정도 최소 양수    {tiny:.4e}   log = {np.log(tiny):.4f}")

with np.errstate(over="ignore"):
    for z in (709.0, 710.0):
        print(f"  exp({z:7.1f}) = {np.exp(z):.4e}")
for z in (-745.0, -746.0):
    print(f"  exp({z:7.1f}) = {np.exp(z):.4e}")

# 같은 로짓을 두 구현에 넣는다. 둘째 줄은 작아서 둘 다 잘 돈다.
Z = np.array([[710.0, 0.0, -710.0],
              [  2.0, 1.0,   -1.0]])
with np.errstate(over="ignore", invalid="ignore"):
    naive = softmax_naive(Z)
stable = softmax(Z)

print(f"\n안정한 꼴  z=(710,0,-710) -> {stable[0]}")
print(f"소박한 꼴  z=(710,0,-710) -> {naive[0]}")
print(f"안정한 꼴  z=(2,1,-1)     -> {np.round(stable[1], 6)}")
print(f"소박한 꼴  z=(2,1,-1)     -> {np.round(naive[1], 6)}")
print(f"행별 합 (안정한 꼴) {stable.sum(axis=1)}")
print(f"e^-710 = {np.exp(-710.0):.4e}  <- p2 의 참값")
출력:
배정도 최대 유한수  1.7977e+308   log = 709.7827
배정도 최소 양수    4.9407e-324   log = -744.4401
  exp(  709.0) = 8.2184e+307
  exp(  710.0) = inf
  exp( -745.0) = 4.9407e-324
  exp( -746.0) = 0.0000e+00

안정한 꼴  z=(710,0,-710) -> [1.00000000e+000 4.47628623e-309 0.00000000e+000]
소박한 꼴  z=(710,0,-710) -> [nan  0.  0.]
안정한 꼴  z=(2,1,-1)     -> [0.705385 0.259496 0.035119]
소박한 꼴  z=(2,1,-1)     -> [0.705385 0.259496 0.035119]
행별 합 (안정한 꼴) [1. 1.]
e^-710 = 4.4763e-309  <- p2 의 참값
(1)의 예고가 모두 맞는다. 임계값은 \(709.7827\)이고 \(e^{709}\)는 유한하지만 \(e^{710}\)은 inf다. 소박한 구현은 첫째 줄에서 \((\texttt{nan}, 0, 0)\)을 내놓고, 안정한 구현은 \((1.0,\ 4.47628623\times 10^{-309},\ 0)\)으로 손계산한 답과 마지막 자리까지 같다. 둘째 줄처럼 로짓이 \(\lvert z \rvert \le 2\) 정도로 작으면 두 구현의 값이 완전히 일치하니, 최댓값을 빼는 것이 답을 바꾸는 일은 없다. 평행이동 불변성이 보장하는 바다.
언더플로는 왜 해롭지 않은가. 최댓값을 뺀 뒤 지수는 모두 \(z_c - \max_c z_c \le 0\)이므로 \(e^{\cdot} \le 1\)이고, 넘침은 원리적으로 불가능하다. 대신 \(z_c - \max_c z_c < \log(4.9407\times10^{-324}) = -744.44\)인 항은 \(0\)으로 가라앉는다. 출력이 보이듯 \(e^{-745}\)는 비정규수(subnormal number, 정규 범위 아래에서 유효숫자를 잃어 가며 표현되는 수)로 겨우 살아남고 \(e^{-746}\)은 \(0\)이 된다.
그런데 가라앉은 항의 참값은 \(e^{-744}\)보다 작으니 어떤 확률과 견주어도 무시할 만하고, 더 중요한 것은 분모가 절대 \(0\)이 되지 않는다는 점이다. 최댓값에 해당하는 항이 정확히 \(e^0 = 1\)이므로 분모는 늘
사이에 있다. 그래서 \(0/0\)이 날 길이 없다. 최댓값을 빼는 한 줄이 치명적인 nan을 무해한 반올림으로 바꾼다. 이것이 다음 절에서 다룰 로그–합–지수 기법의 전부이기도 하다.
연습문제¶
연습문제 1. 소프트맥스 함수 계산
로짓 벡터가 \(\mathbf{z} = (2, 1, -1)^\top\)인 3범주 분류 문제를 생각하자.
(a) 다음 식으로 소프트맥스 확률 \(\hat{p}_k = \text{softmax}(\mathbf{z})_k\) (\(k = 1, 2, 3\))를 계산하라.
(b) 확률의 합이 1이고 각각이 비음수임을 확인하라.
(c) 소프트맥스가 평행이동 불변임을 보여라. 즉 임의의 상수 \(c\)에 대해 \(\text{softmax}(\mathbf{z} + c\mathbf{1}) = \text{softmax}(\mathbf{z})\)임을 보이고, 이 성질이 수치적 안정성에 왜 중요한지 설명하라.
풀이
(a) 먼저 지수를 계산한다.
정규화 상수는
이고, 소프트맥스 확률은
이다.
(b) \(\hat{p}_1 + \hat{p}_2 + \hat{p}_3 = 0.705 + 0.259 + 0.035 \approx 1.0\)이고, 지수는 항상 양수이므로 각 확률도 양수다. 소프트맥스가 임의의 실숫값 로짓 벡터를 단체 위의 유효한 확률분포로 옮긴다는 것을 확인해 준다.
(c) 임의의 상수 \(c\)에 대해
로 \(e^c\) 인자가 소거된다. 이 성질이 로그–합–지수 기법의 핵심이다. \(c = -\max_k z_k\)로 두면 가장 큰 지수가 \(e^0 = 1\)이 되어 로짓이 커도 수치적 오버플로를 막을 수 있다.
연습문제 2. 소프트맥스 회귀의 가중행렬
범주 \(C = 3\)개, 입력 특성 \(d = 2\)개(그리고 편향)인 소프트맥스 회귀에서 모형은
를 계산한다. 여기서 \(\mathbf{W} \in \mathbb{R}^{3 \times 2}\)이고 \(\mathbf{b} \in \mathbb{R}^3\) 이다.
(a) 학습된 모수가
일 때, 입력 \(\mathbf{x} = (1, 1)^\top\)에 대한 로짓과 예측 범주를 구하라.
(b) 가중행렬의 기하학적 의미를 설명하라. \(\mathbf{W}\)의 각 행은 어떻게 선형 분류기를 정의하는가?
(c) 이 모형은 모수화가 중복되어 있다. 임의의 벡터 \(\mathbf{v}\)와 스칼라 \(v_b\)에 대해 \(\mathbf{w}_k' = \mathbf{w}_k - \mathbf{v}\), \(b_k' = b_k - v_b\)로 둔 모수가 같은 소프트맥스 출력을 낸다. 이를 이용해 마지막 범주의 로짓이 항상 0이 되도록 만들어 자유 모수를 줄여라.
풀이
(a) 로짓을 계산하면
이다. 세 로짓이 모두 같으므로 \(\text{softmax}(\mathbf{z}) = (1/3, 1/3, 1/3)^\top\)이다. 어느 범주도 선호되지 않으며 모형이 이 입력에 대해 최대로 불확실하다. 어느 범주를 예측해도 무방하다(관례상 첫 번째 범주).
(b) \(\mathbf{W}\)의 각 행 \(\mathbf{w}_k^\top\)은 선형 점수함수 \(z_k = \mathbf{w}_k^\top \mathbf{x} + b_k\)를 정의한다. 기하학적으로 \(\mathbf{w}_k\)는 특성 공간에서 범주 \(k\)의 점수가 증가하는 방향이다. 범주 \(i\)와 \(j\) 사이의 결정경계는 \(z_i = z_j\)인 초평면, 즉 \((\mathbf{w}_i - \mathbf{w}_j)^\top \mathbf{x} + (b_i - b_j) = 0\)이며, 가중벡터 \(\mathbf{w}_i - \mathbf{w}_j\)가 이 초평면의 법선이다.
(c) 마지막 범주를 기준으로 삼는다. \(\mathbf{v} = \mathbf{w}_3 = (0, 0)^\top\), \(v_b = b_3 = 1\)로 두면
이 된다. 이제 \(\mathbf{w}_3' = \mathbf{0}\), \(b_3' = 0\)이므로 세 번째 범주의 로짓이 항상 0인 기준범주가 된다. 평행이동 불변성에 의해 소프트맥스 출력은 전혀 바뀌지 않는다. 자유 모수는 \(3 \times 2 + 3 = 9\)개에서 \(2 \times 2 + 2 = 6\)개로 줄고, 모수화가 식별 가능해진다.
실무에서는 중복 모수화를 그대로 두는 경우가 많다
기준범주를 고정하면 식별 가능해지지만, 신경망 구현에서는 대개 \(C\)개 행을 모두 유지한다. 이유는 두 가지다. 첫째, 구현이 대칭적이어서 단순하다. 둘째, 정칙화가 있으면 중복이 사라진다. \(L_2\) 벌점 \(\frac{\lambda}{2}\|\mathbf{W}\|_F^2\)을 걸면 같은 예측을 주는 모수 중 노름이 최소인 것이 유일하게 선택되므로 식별성이 회복된다. 벌점 없이 소프트맥스 회귀를 적합하면 계수 자체는 유일하지 않으며, 계수를 해석할 때 이 점을 반드시 기억해야 한다. 예측확률은 언제나 유일하다.
정리하며¶
소프트맥스는 로짓 벡터를 확률분포로 옮긴다.
- 출력이 양수이고 합이 1 이다. 그래서 확률로 읽을 수 있다.
- 평행이동에 불변이다. \(\mathbf z\) 에 상수를 더해도 결과가 같으며, 이 성질이 수치적 안정성의 열쇠다. 최댓값을 빼고 계산하면 지수 폭주를 막는다.
- \(C=2\) 면 시그모이드가 된다. 두 로짓의 차이로 정리하면 확인된다.
- "소프트" 최댓값이다. 가장 큰 로짓에 확률이 몰리지만 다른 것도 \(0\) 이 아니며, 로짓들의 격차가 클수록 하드맥스에 가까워진다.
- 온도 모수를 넣으면 날카로움을 조절할 수 있으며, 지식 증류나 보정에서 쓰인다.
다음 절 수치적 안정성으로 넘어간다. 소프트맥스를 적힌 대로 계산하면 \(e^z\) 가 넘치거나 사라져 inf 와 0/0 이 나온다.