두 분산 비교를 위한 F 검정
두 분산을 비교하는 F 검정은 독립인 두 표본의 분산이 유의하게 다른지 판정하는 통계검정이다. 표본분산의 비에 기반하며 두 표본 모두 정규분포를 따르는 모집단에서 왔다고 가정한다. F 검정은 분산분석 같은 방법에서 결정적인 가정인 분산의 동질성을 평가하는 데 특히 유용하다.
가설
귀무가설 (\(H_0\)): 두 모분산이 같다.
대립가설 (\(H_1\)): 두 모분산이 같지 않다.
- 양측검정 (분산이 단지 다르다):
- 단측검정 (한 분산이 다른 분산보다 크거나 작다):
단측과 양측 중 어느 것을 쓸지는 연구 질문에 달려 있다. 어느 분산이 더 클지에 대한 사전 기대가 없을 때는 양측을 쓰는 경우가 많다.
가정
F 검정은 다음의 핵심 가정에 기댄다.
- 정규성: 표본이 추출된 모집단이 정규분포를 따라야 한다. F 검정은 정규성 이탈에 매우 민감하다.
- 독립성: 두 표본이 서로 독립이어야 한다.
- 확률표집: 두 표본 모두 각자의 모집단을 대표하는 확률표본이어야 한다.
이 가정들, 특히 정규성이 위배되면 F 검정이 잘못된 결론으로 이어질 수 있다. 그런 경우에는 Levene 검정이나 Brown-Forsythe 검정 같은 대안이 더 적절하다.
검정통계량
F 검정통계량은 두 표본분산의 비에 기반한다. 모분산이 \(\sigma_1^2\), \(\sigma_2^2\)인 모집단에서 나온 독립인 두 표본의 표본분산이 \(s_1^2\), \(s_2^2\)일 때, \(\sigma := \sigma_1 = \sigma_2\)인 \(H_0\) 아래에서
표본분산은 다음과 같이 계산한다.
여기서 \(X_{1i}\)와 \(X_{2i}\)는 각 표본의 개별 관측값, \(\bar{X}_1\)과 \(\bar{X}_2\)는 표본평균, \(n_1\)과 \(n_2\)는 표본크기이다.
비의 유의성은 자유도 \(n_1 - 1\)과 \(n_2 - 1\)인 F 분포로 평가한다.
\(F \geq 1\)이 되도록 큰 분산을 분자에 두는 관례
수기 계산 시대의 표는 상단 임계값만 실려 있었으므로, 항상 큰 표본분산을 분자에 두어 \(F \geq 1\)이 되게 하고 상단 임계값 하나만 참조하는 관례가 있었다. 이때 양측검정의 \(p\)값은 상단 꼬리확률의 두 배이다.
이 페이지와 아래의 Python 구현은 그 관례를 따르지 않고 첫 번째 집단을 분자에 고정한다. 그러면 \(F < 1\)일 수 있으므로 양쪽 임계값을 모두 확인해야 한다. 두 방식은 동등하지만 섞어 쓰면 안 된다. 큰 분산을 분자에 두었다면 반드시 상단 꼬리만 보고 \(p\)값을 두 배 해야 하고, 집단 순서를 고정했다면 양쪽 임계값을 써야 한다.
기각역과 판정규칙
두 표본분산의 차이가 통계적으로 유의한지 판정하려면 계산된 F 통계량을 F 분포의 임계값과 비교한다.
- 분자 자유도: \(df_1 = n_1 - 1\)
- 분모 자유도: \(df_2 = n_2 - 1\)
양측검정:
- \(F < F_{\alpha/2}\) 또는 \(F > F_{1-\alpha/2}\)이면 \(H_0\)을 기각한다.
- \(F_{\alpha/2} < F < F_{1-\alpha/2}\)이면 \(H_0\)을 기각하지 못한다.
단측검정:
- \(H_1: \sigma_1^2 > \sigma_2^2\)을 검정한다면 \(F > F_{1-\alpha}\)일 때 기각한다.
- \(H_1: \sigma_1^2 < \sigma_2^2\)을 검정한다면 \(F < F_{\alpha}\)일 때 기각한다.
F 분포의 유용한 성질로 \(F_{\alpha}(df_1, df_2) = 1/F_{1-\alpha}(df_2, df_1)\)이 성립한다. 상단 분위수 표만 있어도 하단 분위수를 얻을 수 있다.
아래 보기의 설정(\(n_1 = 15\), \(n_2 = 20\), 곧 자유도 14와 19)으로 기각역을 그려 보자.
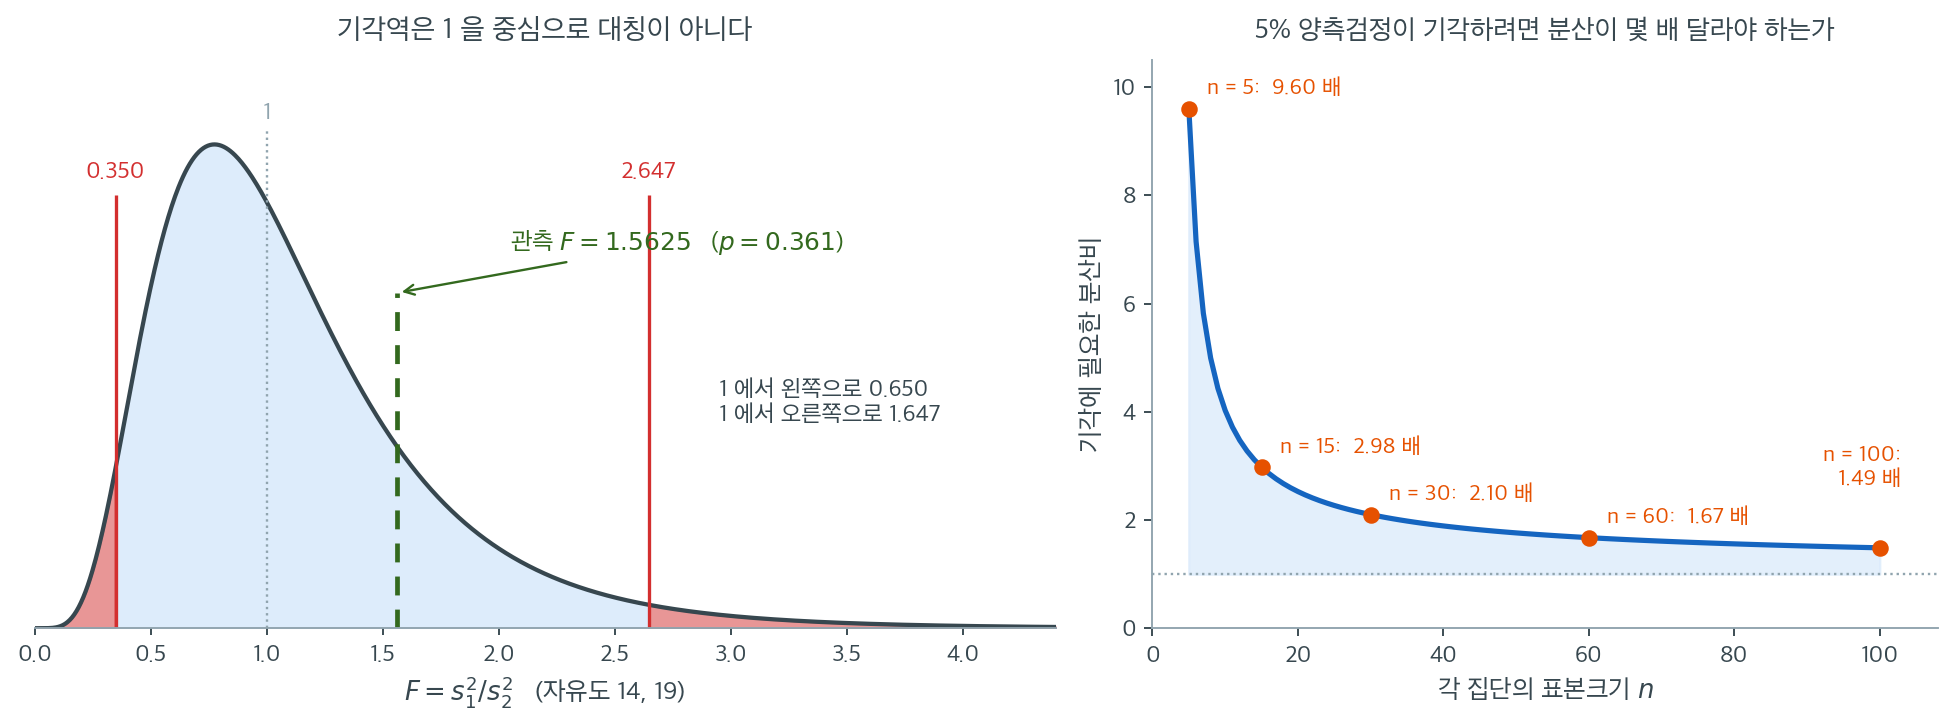
왼쪽에서 눈에 먼저 들어와야 할 것은 기각역이 1을 중심으로 대칭이 아니라는 점이다. 하단 임계값은 \(0.350\), 상단은 \(2.647\)이다. 1에서 왼쪽으로는 \(0.650\)밖에 못 가는데 오른쪽으로는 \(1.647\)까지 간다. 두 꼬리의 넓이는 각각 2.5%로 같은데 거리는 2.5배 차이가 난다. 분산의 비를 다루기 때문이다. "두 배 크다"와 "두 배 작다"는 비의 세계에서 \(2\)와 \(0.5\)인데, 이 둘은 1에서 같은 거리에 있지 않다. \(\log F\)로 보면 대칭이 회복된다.
녹색 점선이 보기의 관측값 \(F = 25/16 = 1.5625\)이다. 분산이 56% 크다는 뜻인데도 채택역 한가운데에 있고 \(p = 0.361\)이다. 직관과 어긋난다면 오른쪽 그림을 보라. \(n_1 = 15\), \(n_2 = 20\) 규모에서 5% 양측검정이 기각하려면 표본분산의 비가 약 3배는 되어야 한다.
오른쪽은 두 집단의 크기가 같을 때 기각에 필요한 분산비를 표본크기의 함수로 그린 것이다. \(n = 5\)면 \(9.60\)배, \(n = 15\)면 \(2.98\)배, \(n = 30\)이면 \(2.10\)배, \(n = 100\)이라야 \(1.49\)배까지 내려온다. 곡선이 처음에 절벽처럼 떨어지다가 곧 평평해지는 모양에 주목하라. 작은 표본에서 분산 검정은 사실상 극단적인 차이만 잡아낸다. 표본이 20 남짓인 연구에서 "분산에 유의한 차이가 없었다"는 문장은 대개 "차이가 없다"가 아니라 "이 표본으로는 알 수 없다"는 뜻이다.
보기 1. 시험점수 변동성 비교 — 비대칭 기각역. 어떤 연구자가 두 학생 집단의 시험점수 변동성을 비교하려 한다. 집단 1은 표본크기 15, 표본분산 \(s_1^2 = 25\) 이고 집단 2는 표본크기 20, 표본분산 \(s_2^2 = 16\) 이다.
(1) 유의수준 \(5\%\) 에서 두 집단의 분산이 유의하게 다른지 임계값으로 판정하고 양측 \(p\) 값을 구하시오.
(2) 같은 자유도에서 기각하려면 표본분산의 비가 얼마나 되어야 하는가. 집단 1 이 더 퍼져 있을 때와 집단 2 가 더 퍼져 있을 때의 문턱이 다르다 — 두 값을 모두 구하고 왜 다른지 밝히시오.
풀이
(1) 단계를 밟는다.
1단계 — 가설 설정.
- \(H_0: \sigma_1^2 = \sigma_2^2\)
- \(H_1: \sigma_1^2 \neq \sigma_2^2\) (양측검정)
2단계 — 검정통계량.
3단계 — 임계값. \(df_1 = 14\), \(df_2 = 19\), \(\alpha = 0.05\)(양측)일 때
- 하단 임계값: \(F_{0.025}(14, 19) = 0.3496\)
- 상단 임계값: \(F_{0.975}(14, 19) = 2.6469\)
4단계 — 판정. \(0.3496 < 1.5625 < 2.6469\) 이므로 \(H_0\) 을 기각하지 못한다. 양측 \(p\) 값은
이다.
5단계 — 결론. 유의수준 \(5\%\) 에서 두 집단의 분산이 유의하게 다르다고 할 증거가 충분하지 않다. 표본분산의 비가 \(25/16 = 1.56\) 으로 꽤 커 보이지만 이 표본크기에서는 우연으로 충분히 설명된다.
(2) 문턱이 방향마다 다르다. 기각역이 \(F < 0.3496\) 또는 \(F > 2.6469\) 인데, 두 경계는 서로 역수가 아니다. \(1/0.3496 = 2.8607\) 이지 \(2.6469\) 가 아니기 때문이다. 그러므로
- 집단 1 이 더 퍼져 있어야 할 때: \(s_1^2/s_2^2 > 2.6469\), 곧 \(2.65\) 배
- 집단 2 가 더 퍼져 있어야 할 때: \(s_2^2/s_1^2 > 1/0.3496 = 2.8607\), 곧 \(2.86\) 배
로 같은 자료라도 어느 쪽이 큰가에 따라 요구되는 배수가 다르다. 까닭은 자유도가 \(14\) 와 \(19\) 로 다르기 때문이다. \(F(14,19)\) 와 \(F(19,14)\) 는 서로 다른 분포이고, 역수 성질은 \(F_{0.025}(14,19) = 1/F_{0.975}(19,14)\) 이지 \(1/F_{0.975}(14,19)\) 가 아니다. 자유도가 작은 쪽(집단 1)이 분모로 갈 때 비가 더 흔들리므로 더 큰 배수를 요구한다.
\(d_1 = d_2\) 이면 두 문턱이 같아진다. 그때는 \(F_{0.025}(d,d) = 1/F_{0.975}(d,d)\) 가 성립하기 때문이다.
from scipy.stats import f

df1, df2, alpha = 14, 19, 0.05
print(f"lower = {f.ppf(alpha / 2, df1, df2):.4f}")
print(f"upper = {f.ppf(1 - alpha / 2, df1, df2):.4f}")

# 관측값과 양측 p 값
lo, hi = f.ppf(alpha / 2, df1, df2), f.ppf(1 - alpha / 2, df1, df2)
F = 25 / 16
p = 2 * min(f.cdf(F, df1, df2), f.sf(F, df1, df2))
print(f"F = 25/16 = {F:.4f}   ->  {'기각' if (F < lo or F > hi) else '기각 못함'},  p = {p:.4f}")

# 기각하려면 분산비가 얼마나 되어야 하는가. 두 방향이 다르다.
print(f"\n집단 1 이 더 퍼져 있어야 할 때:  s1^2/s2^2 > {hi:.4f}")
print(f"집단 2 가 더 퍼져 있어야 할 때:  s2^2/s1^2 > {1 / lo:.4f}")

# 두 집단이 같은 크기 n 일 때의 문턱
print("\n두 집단이 모두 크기 n 일 때 기각에 필요한 분산비")
for n in (5, 15, 30, 100):
    print(f"  n = {n:>3}  ->  {f.ppf(0.975, n - 1, n - 1):.4f} 배")
출력:
lower = 0.3496
upper = 2.6469
F = 25/16 = 1.5625   ->  기각 못함,  p = 0.3607

집단 1 이 더 퍼져 있어야 할 때:  s1^2/s2^2 > 2.6469
집단 2 가 더 퍼져 있어야 할 때:  s2^2/s1^2 > 2.8607

두 집단이 모두 크기 n 일 때 기각에 필요한 분산비
  n =   5  ->  9.6045 배
  n =  15  ->  2.9786 배
  n =  30  ->  2.1010 배
  n = 100  ->  1.4862 배
유도한 값과 코드가 맞는다. 임계값 \(0.3496\) 과 \(2.6469\), 판정 "기각 못함", \(p = 0.3607\) 이 모두 위와 같다. 두 문턱 \(2.6469\) 와 \(2.8607\) 의 차이도 확인되었다.
마지막 표가 앞 그림의 오른쪽 패널이 그린 곡선의 다섯 점이다. \(n = 5\) 면 분산이 \(9.6\) 배는 되어야 기각한다. \(n = 15\) 에서 \(2.98\) 배, \(n = 30\) 에서 \(2.10\) 배로 급히 내려오다가 \(n = 100\) 에서도 \(1.49\) 배에 머문다. 이 보기의 \(1.5625\) 배는 \(n = 100\) 짜리 두 집단이라야 겨우 잡히는 크기다.
"유의한 차이가 없었다"를 "차이가 없다"로 읽으면 안 된다. 집단당 \(15\)–\(20\) 개짜리 연구에서 그 문장은 거의 언제나 "이 표본으로는 알 수 없다"는 뜻이다.
보기 2. 두 분산의 F 검정. 집단당 8 개짜리 두 표본을 코드로 처리한다. \(F = 0.4732 < 1\) 이라 작은 쪽 꼬리가 왼쪽이다.
(1) 아래 세 절차의 실제 제1종오류율을 \(\alpha\) 의 식으로 구하시오.
- (가) 방향을 자료를 보기 전에 정하고 \(p = F_F(F_{\text{obs}})\) 로 판정한다.
- (나) 자료를 보고 작은 쪽 꼬리를 골라 그 값을 그대로 \(p\) 로 쓴다.
- (다) 등꼬리 양측 \(p = 2\min(\cdot,\cdot)\) 으로 판정한다.
(2) 모의실험으로 확인하고, 이 자료에서 (나)와 (다)가 각각 어떤 수를 주는지 적으시오.
풀이
(1) 세 절차의 크기는 \(\alpha\), \(2\alpha\), \(\alpha\) 다. \(H_0\) 이 참이면 \(F_{\text{obs}} \sim F(d_1,d_2)\) 이고 이 분포가 연속이므로 확률적분변환에 의해
이다(15.3절 F 검정 보기 1 에서 쓴 것과 같은 사실이다). 세 절차를 \(U\) 의 말로 옮긴다.
(가) 기각 조건이 \(U < \alpha\) 이므로
로 정확하다. 다만 이것은 \(H_1: \sigma_1^2 < \sigma_2^2\) 한 방향만 보는 검정이어서, 반대 방향의 차이는 아무리 커도 잡지 못한다.
(나) 작은 쪽 꼬리는 \(\min(U, 1-U)\) 이고 기각 조건이 \(\min(U, 1-U) < \alpha\) 다. 두 사건 \(U < \alpha\) 와 \(U > 1-\alpha\) 는 \(\alpha < 1/2\) 이면 배반이므로
로 명목값의 두 배다. 틀린 곳은 꼬리를 고른 것이 아니라 자료를 보고 골랐다는 데 있다. 방향을 미리 정한 (가)는 멀쩡한데, 관측된 \(F\) 가 1 보다 작은 것을 보고 나서 왼쪽을 고르면 사실상 두 꼬리를 모두 열어 둔 셈이 된다.
(다) 기각 조건이 \(2\min(U, 1-U) < \alpha\), 곧 \(\min(U,1-U) < \alpha/2\) 이므로 (나)의 계산에 \(\alpha/2\) 를 넣어
로 되돌아온다. 두 배 하는 것이 두 꼬리를 연 대가를 정확히 갚는다.
(2) 재어 본다.
import numpy as np
from scipy.stats import f

sample1 = [12, 15, 14, 10, 13, 14, 12, 11]
sample2 = [22, 25, 20, 18, 24, 23, 19, 21]

# ddof=1 로 표본분산을 쓴다. F 검정의 이론이 그렇게 세워져 있다.
var1 = np.var(sample1, ddof=1)
var2 = np.var(sample2, ddof=1)

# 두 표본분산의 비. 귀무가설이 참이면 이 값이 1 근처에 놓인다.
f_statistic = var1 / var2

# 자유도
df1 = len(sample1) - 1
df2 = len(sample2) - 1

# F 분포는 대칭이 아니므로 작은 쪽 꼬리를 두 배 한다.
p_value = 2 * min(f.cdf(f_statistic, df1, df2),
                  f.sf(f_statistic, df1, df2))

print(f"Sample variances: {var1:.4f}, {var2:.4f}")
print(f"F-statistic: {f_statistic:.4f}")
print(f"Degrees of freedom: {df1}, {df2}")
print(f"Two-sided p-value: {p_value:.4f}")

# 결과 해석
alpha = 0.05
if p_value < alpha:
    print("Reject H0: variances are significantly different.")
else:
    print("Fail to reject H0: no significant difference in variances.")

# 세 절차의 실제 1종오류율을 잰다. H0 가 참이면 cdf(F) 는 U(0,1) 이므로
# F 를 직접 뽑지 않고 귀무분포에서 바로 뽑아도 같다.
rng = np.random.default_rng(11)
M, a = 400_000, 0.05
d = f(14, 19)                      # 보기 1 의 자유도로 잰다
U = d.cdf(d.rvs(M, random_state=rng))

print(f"\n명목 alpha = {a} 일 때 실제 1종오류율 (반복 {M:,}회, 자유도 14, 19)")
print(f"  (가) 방향을 미리 정한 단측  p = cdf(F)        : {np.mean(U < a):.4f}")
print(f"  (나) 자료를 보고 작은 꼬리  p = min(cdf, sf)  : {np.mean(np.minimum(U, 1 - U) < a):.4f}")
print(f"  (다) 등꼬리 양측           p = 2*min(cdf, sf): {np.mean(2 * np.minimum(U, 1 - U) < a):.4f}")
출력:
Sample variances: 2.8393, 6.0000
F-statistic: 0.4732
Degrees of freedom: 7, 7
Two-sided p-value: 0.3448
Fail to reject H0: no significant difference in variances.

명목 alpha = 0.05 일 때 실제 1종오류율 (반복 400,000회, 자유도 14, 19)
  (가) 방향을 미리 정한 단측  p = cdf(F)        : 0.0497
  (나) 자료를 보고 작은 꼬리  p = min(cdf, sf)  : 0.1001
  (다) 등꼬리 양측           p = 2*min(cdf, sf): 0.0498
유도한 \(\alpha,\ 2\alpha,\ \alpha\) 와 잰 값 \(0.0497,\ 0.1001,\ 0.0498\) 이 맞는다. 몬테카를로 표준오차가 \(\sqrt{0.05 \cdot 0.95/400000} \approx 0.0003\) 이므로 \(0.0497\) 과 \(0.0498\) 은 \(0.05\) 와 구별되지 않고, \(0.1001\) 은 \(0.10\) 과 맞는다.
이 자료에서는 (나)가 \(0.1724\), (다)가 \(0.3448\) 을 준다. \(F = 0.4732 < 1\) 이라 작은 쪽 꼬리가 왼쪽이고 그 넓이가 \(0.1724\) 인데, 이것은 \(H_1: \sigma_1^2 < \sigma_2^2\) 에 대한 단측 \(p\) 값이지 "분산이 다르다"에 대한 값이 아니다. 두 수 모두 \(0.05\) 를 넘어 이 자료에서는 결론이 갈리지 않지만, \(p\) 가 \(0.03\) 쯤인 자료였다면 (나)로는 기각하고 (다)로는 기각하지 못하는 일이 생긴다. 그런 보고가 쌓이면 실제 거짓 양성률이 \(10\%\) 다.
단측 \(p\)값과 양측 판정을 섞지 말라
이 구현에서 \(F = 0.4732 < 1\)이다. 여기서 f.cdf(f_statistic, df1, df2)만 계산하면 하단 단측 \(p\)값 \(0.1724\)를 얻는데, 이는 \(H_1: \sigma_1^2 < \sigma_2^2\)에 대한 값이지 "분산이 다르다"에 대한 값이 아니다.
"분산이 유의하게 다르다"는 결론을 내리려면 반드시 양측 \(p\)값 \(2 \times 0.1724 = 0.3448\)를 써야 한다. 단측 \(p\)값에 양측 해석을 붙이면 제1종 오류율이 명목값의 두 배가 된다.
연습문제
연습문제 1. 두 생산라인이 비슷한 제품을 만드는데, 제품 중량의 변동성이 두 라인 사이에 다를 것으로 의심된다. 다음 표본자료(그램)가 주어졌다.
- 생산라인 1: \([14.2, 13.8, 15.1, 14.7, 14.5, 14.6, 15.0, 14.8]\)
- 생산라인 2: \([15.2, 14.8, 15.6, 15.0, 14.9, 15.3, 15.5, 14.9]\)
F 검정으로 유의수준 5%에서 두 생산라인의 분산이 유의하게 다른지 판정하라.
풀이
가설:
- 귀무가설 (\(H_0\)): 분산이 같다. 곧 \(\sigma_1^2 = \sigma_2^2\).
- 대립가설 (\(H_1\)): 분산이 같지 않다. 곧 \(\sigma_1^2 \neq \sigma_2^2\).
Python 구현:
import numpy as np
from scipy.stats import f

line1 = np.array([14.2, 13.8, 15.1, 14.7, 14.5, 14.6, 15.0, 14.8])
line2 = np.array([15.2, 14.8, 15.6, 15.0, 14.9, 15.3, 15.5, 14.9])

var1 = np.var(line1, ddof=1)
var2 = np.var(line2, ddof=1)
F_stat = var1 / var2
df1, df2 = len(line1) - 1, len(line2) - 1

alpha = 0.05
lower = f.ppf(alpha / 2, df1, df2)
upper = f.ppf(1 - alpha / 2, df1, df2)
p = 2 * min(f.cdf(F_stat, df1, df2), f.sf(F_stat, df1, df2))

print(f"variances: {var1:.5f}, {var2:.5f}")
print(f"F = {F_stat:.4f}, df = ({df1}, {df2})")
print(f"critical values: [{lower:.4f}, {upper:.4f}]")
print(f"two-sided p = {p:.4f}")
출력:
variances: 0.18125, 0.08857
F = 2.0464, df = (7, 7)
critical values: [0.2002, 4.9949]
two-sided p = 0.3655
판정. \(F = 2.046\)이 \([0.2002,\, 4.9949]\) 안에 있으므로 \(H_0\)을 기각하지 못한다(\(p = 0.366\)).
해석. 라인 1의 표본분산이 라인 2의 두 배가 넘는데도 유의하지 않다. 각 집단 \(n = 8\)이면 F 검정의 검정력이 매우 낮기 때문이다. 임계값 범위가 \(0.20\)에서 \(4.99\)까지, 곧 25배에 이른다는 사실이 이를 잘 보여준다. 분산비가 5배는 되어야 탐지할 수 있다.
실무적 결론: 이 자료로는 두 라인의 변동성이 같다고도 다르다고도 말할 수 없다. 결론을 내리려면 표본을 크게 늘려야 한다. \(\square\)
연습문제 2. \(F_{\alpha}(df_1, df_2) = 1/F_{1-\alpha}(df_2, df_1)\)임을 증명하고, 이 관계가 왜 F 분포표를 절반으로 줄여 주는지 설명하라.
풀이
\(F \sim F_{d_1, d_2}\)이면 정의상 \(F = (U/d_1)/(V/d_2)\)이고 \(U \sim \chi^2_{d_1}\), \(V \sim \chi^2_{d_2}\)가 독립이다. 그러면
이다. 곧 F 확률변수의 역수는 자유도를 뒤바꾼 F 확률변수이다.
이제 \(F_{\alpha}(d_1,d_2)\)를 \(P(F_{d_1,d_2} \leq F_\alpha) = \alpha\)로 정의된 하단 \(\alpha\) 분위수라 하자.
따라서 \(1/F_\alpha(d_1,d_2)\)는 \(F_{d_2,d_1}\)의 상단 \(\alpha\) 지점, 곧 하단 \(1-\alpha\) 분위수이다.
검증. 앞의 보기에서 \(F_{0.025}(14,19) = 0.3496\)이고 \(F_{0.975}(19,14) = 2.8607\)이다. \(1/2.8607 = 0.3496\) ✓.
표를 절반으로 줄이는 이유. 인쇄된 F 분포표는 보통 상단 분위수(\(1-\alpha = 0.95, 0.975, 0.99\))만 싣는다. 하단 분위수가 필요하면 자유도를 뒤바꾼 상단 분위수의 역수를 취하면 되기 때문이다. 표의 크기가 절반이 된다. 컴퓨터로 계산하는 오늘날에는 실용적 의미가 줄었지만, 왜 옛 교과서의 F 표에 하단 분위수가 없는지 이해하는 데 도움이 된다. \(\square\)
연습문제 3. \(n_1 = n_2 = n\)인 균형 설계에서 \(\alpha = 0.05\) 양측 F 검정이 탐지할 수 있는 최소 분산비를 \(n \in \{5, 10, 20, 50, 100\}\)에 대해 계산하라(임계값 기준). 결과가 실무에 주는 함의를 논하라.
풀이
양측검정의 상단 임계값 \(F_{0.975}(n-1, n-1)\)이 곧 "표본분산비가 이보다 커야 기각한다"는 문턱이다.
from scipy.stats import f

print(f"{'n':>5} {'F_upper':>10} {'sd ratio':>10}")
for n in [5, 10, 20, 50, 100]:
    up = f.ppf(0.975, n - 1, n - 1)
    print(f"{n:>5} {up:>10.3f} {up**0.5:>10.3f}")
출력:
    n    F_upper   sd ratio
    5      9.605      3.099
   10      4.026      2.006
   20      2.526      1.589
   50      1.762      1.327
  100      1.486      1.219
| \(n\) | 필요한 분산비 | 필요한 표준편차비 |
|---|---|---|
| 5 | 9.6 | 3.1 |
| 10 | 4.0 | 2.0 |
| 20 | 2.5 | 1.6 |
| 50 | 1.8 | 1.3 |
| 100 | 1.5 | 1.2 |
함의.
- 작은 표본에서 F 검정은 사실상 무력하다. \(n = 5\)이면 표본표준편차가 3배 이상 차이 나야 기각한다. \(n = 10\)에서도 2배가 필요하다.
- 이 표는 임계값 기준이므로 검정력 관점에서는 더 나쁘다. 참 분산비가 정확히 임계값과 같다면 검정력은 50%에 불과하다. 80% 검정력을 얻으려면 참 비율이 이보다 훨씬 커야 한다.
- 분산분석 사전검정으로서의 함의가 특히 중요하다. 집단당 \(n = 10\)인 실험에서 사전검정이 기각하지 못했다고 등분산성이 확인된 것이 아니다. 분산이 3배 달라도 놓칠 가능성이 크다. 이것이 사전검정 대신 처음부터 Welch 절차를 권하는 이유 가운데 하나이다. \(\square\)
연습문제 4. F 검정이 두꺼운 꼬리에 얼마나 취약한지 모의실험으로 확인하라. 두 집단 모두 \(n = 30\)이고 분산이 같은 상황에서 정규, \(t_{10}\), \(t_5\), 지수분포에 대해 \(\alpha = 0.05\) F 검정의 경험적 크기를 추정하라.
풀이
import numpy as np
from scipy import stats

rng = np.random.default_rng(0)
n, R, alpha = 30, 5000, 0.05

cases = [
    ("Normal",      lambda: rng.normal(0, 1, n)),
    ("t(10)",       lambda: rng.standard_t(10, n)),
    ("t(5)",        lambda: rng.standard_t(5, n)),
    ("Exponential", lambda: rng.exponential(1, n)),
]

for name, gen in cases:
    rej = 0
    for _ in range(R):
        F = gen().var(ddof=1) / gen().var(ddof=1)
        p = 2 * min(stats.f.cdf(F, n - 1, n - 1),
                    stats.f.sf(F, n - 1, n - 1))
        rej += (p < alpha)
    print(f"{name:>12}: empirical size = {rej / R:.4f}")
출력:
      Normal: empirical size = 0.0482
       t(10): empirical size = 0.0970
        t(5): empirical size = 0.1714
 Exponential: empirical size = 0.2768
| 분포 | \(\gamma_2\) | 경험적 크기 | 명목값의 배수 |
|---|---|---|---|
| \(\mathcal{N}(0,1)\) | 0 | 0.048 | 1.0 |
| \(t_{10}\) | 1 | 0.097 | 2.0 |
| \(t_5\) | 6 | 0.171 | 3.6 |
| \(\text{Exponential}\) | 6 | 0.277 | 5.8 |
정규 자료에서만 크기가 올바르다. \(t_{10}\)처럼 정규에서 아주 조금 벗어난 분포(초과첨도 1, 육안으로는 정규와 거의 구별되지 않는다)에서도 크기가 이미 두 배로 뛴다.
지수분포에서는 27.7%이다. 명목상 5% 검정이 실제로는 여섯 번에 한 번 이상 잘못 기각한다.
핵심 교훈. F 검정의 문제는 극단적 비정규성이 아니라 경미한 비정규성에서도 이미 심각하다는 점이다. 실무 자료가 완벽히 정규인 경우는 거의 없으므로, 두 분산을 비교하는 F 검정은 사실상 쓸 곳이 매우 제한적이다. 15.5절의 로버스트 검정을 기본값으로 삼아야 한다. \(\square\)
정리하며
두 분산 비교의 고전적 검정이다.
- 비를 쓰는 이유는 추축량이 되기 때문이다. 차에는 이런 성질이 없다.
- 큰 분산을 분자에 두는 관례가 있으며, 그러면 오른쪽 꼬리만 보면 되고 양측 \(p\) 값은 두 배 한다.
- \(1\) 이 기준값이다. 분산에서 \(1\) 은 평균 비교에서의 \(0\) 에 해당한다.
- 정규성 의존이 이 장에서 가장 심한 축에 든다. 다음 절에서 그 이유를 정면으로 다룬다.
- 분산분석의 사전 확인으로 쓰지 말 것. 11장에서 논한 2단계 절차의 문제에 더해, 이 검정 자체를 믿기 어렵다.
다음 절 \(F\) 분포 상세로 넘어간다.