모형선택 비교
개요
들어가는 이야기 — 적합은 변수를 더할수록 좋아지기만 한다
변수를 몇 개까지 넣을지는 적합을 보고 정할 수 없다. 적합은 변수를 더할수록 좋아지기만 하기 때문이다. 그래서 멈출 자리를 정해 주는 기준이 따로 필요하고, 그 기준이 셋 있다.
설명변수(explanatory variable) 여덟 가운데 앞의 셋만 계수가 \(0\) 이 아닌 자료 \(200\) 개에 전진선택(forward selection) — 들어올 변수를 한 번에 하나씩 고르는 길 — 을 돌리면 들어오는 순서가 참 변수 셋으로 시작한다. 남은 다섯은 반응과 아무 상관이 없게 만든 열이다. 그 잡음 변수를 다섯 개까지 더 넣어도 잔차제곱합이 \(712.3828\) 에서 \(705.0384\) 로 계속 줄어든다. 적합만 보면 끝까지 가게 되고, 멈출 자리를 수로 적어 주는 것이 세 기준이다.
세 기준이 그 걸음에 값을 매긴다. 크기 \(3\) 에서 \(4\) 로 갈 때 적합항이 \(1.39\) 줄어드는데, 벌점은 AIC 가 모수당 \(2\), BIC 가 모수당 \(\ln 200 = 5.30\) 이다. 그래서 같은 걸음에 AIC 는 \(-1.39 + 2 = 0.61\) 만 오르고 BIC 는 \(-1.39 + 5.30 = 3.91\) 오른다 — 여섯 배 차이가 벌점의 차이 그대로다. 그런데도 AIC·BIC·교차검증 셋 모두 크기 \(3\) 에서 최소다.
셋이 한자리를 가리켰다는 것은 이 자료에서 신호가 또렷하다는 뜻이지 세 기준이 같은 기준이라는 뜻이 아니다. 신호가 약하면 벌점의 차이가 그대로 답의 차이로 나타나고, 그때는 어느 기준을 썼는지 적어 두어야 한다. 셋을 함께 돌려 어긋나는 자리가 곧 자료가 애매한 자리다.
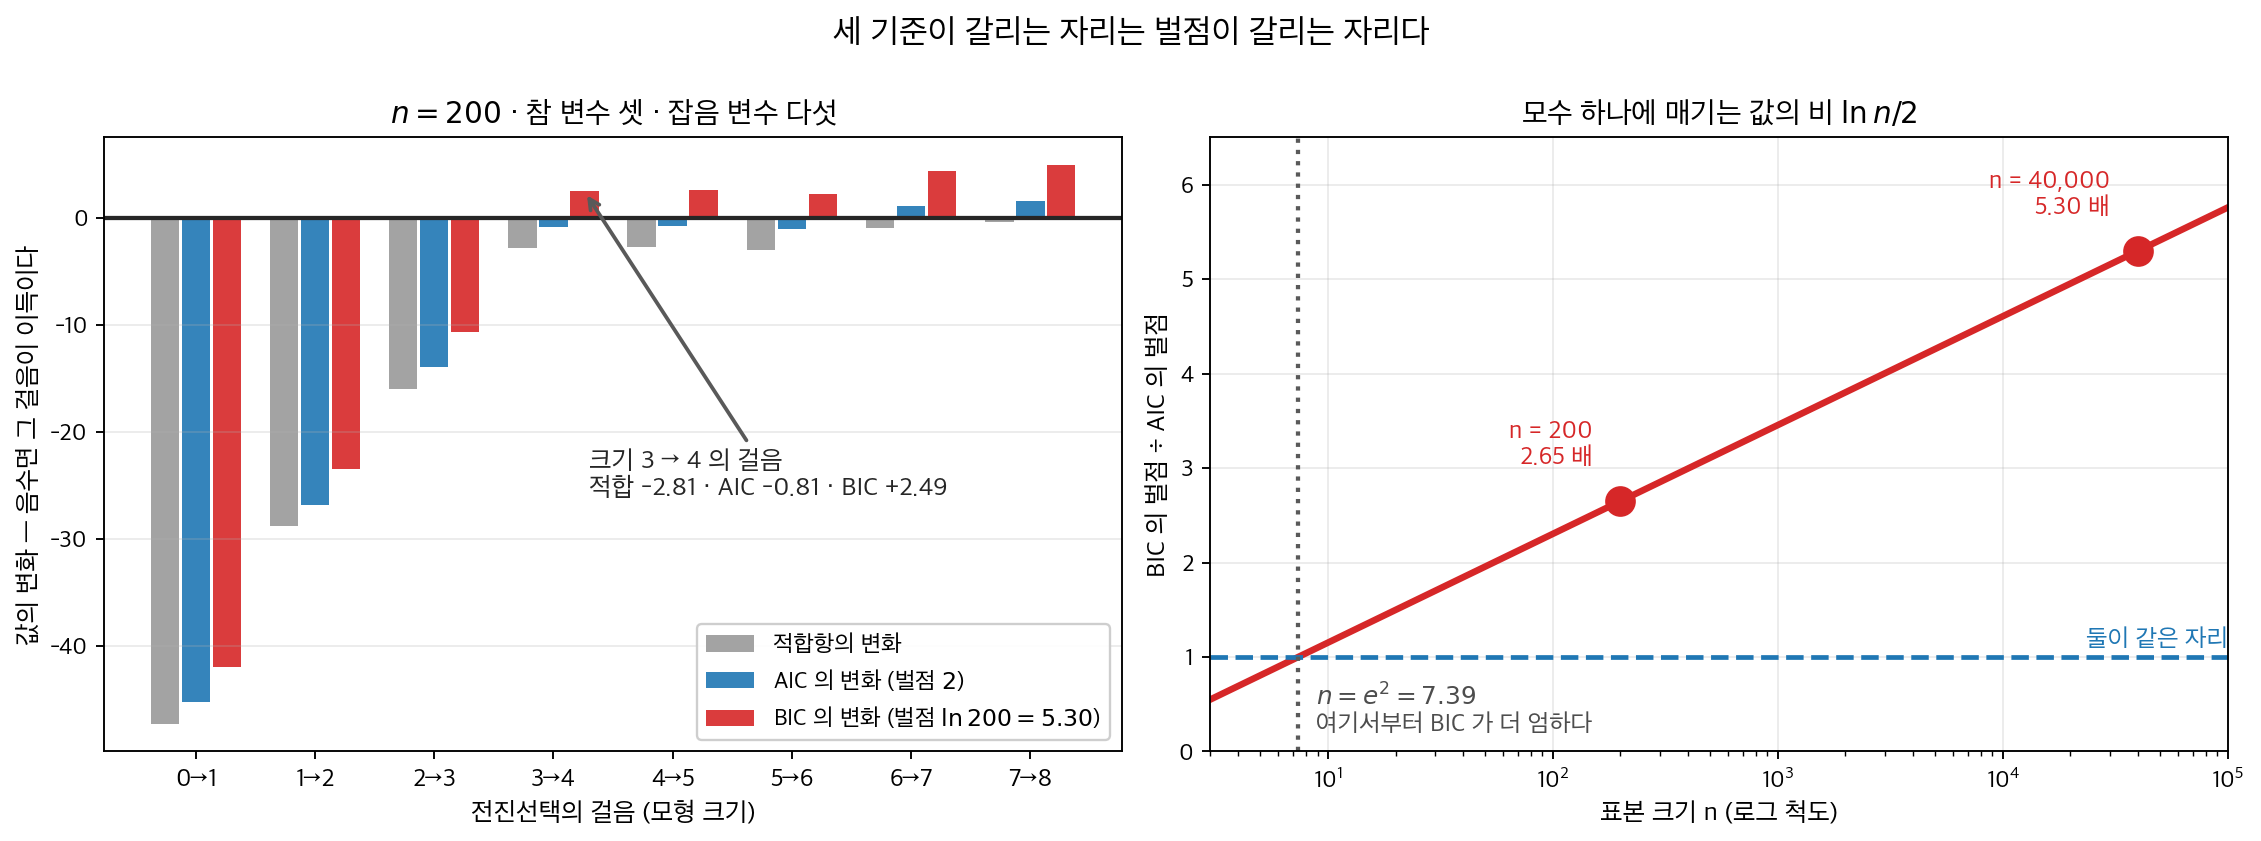
왼쪽. 같은 조건에서 자료를 다시 한 번 뽑았다. 걸음마다 세 막대를 나란히 두면 적합항은 끝까지 내려가는데(회색) 벌점이 붙은 둘은 어디서 멈출지가 다르다 — 크기 \(3 \to 4\) 의 걸음에서 적합이 \(-2.81\) 줄어들 때 AIC 는 \(-0.81\) 로 아직 이득이고 BIC 는 \(+2.49\) 로 손해다. 그래서 이 자료에서는 AIC 가 크기 \(6\), BIC 가 크기 \(3\) 에서 멈춘다. 셋이 한자리를 가리키는 일이 늘 일어나지는 않는다는 뜻이다. 오른쪽. 갈리는 크기는 벌점의 비 \(\ln n / 2\) 가 정한다 — \(n = e^2 = 7.39\) 부터 BIC 가 더 엄해지고 \(n = 200\) 에서 \(2.65\) 배, \(n = 40{,}000\) 에서 \(5.30\) 배다.
출발점이 전혀 다른 세 기준이 같은 자리를 가리켰다는 사실은 무엇의 증거인가. 아래 상자가 그 일치가 얼마나 흔한지를 세어 본다.
확인한 곳 — 이 쪽 「한 번의 일치는 얼마나 흔한 일인가」 상자와 그 출처 줄
이 쪽은 세 가지 기준 — Akaike 정보기준(AIC), 베이즈 정보기준(BIC), 교차검증(CV) — 을 이용한 모형선택을 보인다. 설명변수 8개 중 3개만 실제로 관련 있는 인공자료로 전진선택을 수행하고, 각 기준이 어떤 모형 크기를 최적으로 판정하는지 비교한다.
1. 수학적 배경 — 이 쪽이 쓰는 AIC·BIC 와 교차검증
두 정보기준
이 쪽이 쓰는 꼴만 적는다. 어디서 나온 식인지와 둘의 차이는 AIC와 BIC: 모형선택 기준에 있다.
\(k\) 는 절편(intercept)을 포함한 추정 모수의 개수다. \(n > e^2 \approx 7.39\) 이면 \(\ln n > 2\) 이므로 BIC 의 벌점이 더 엄하고, 그래서 더 단순한 모형을 고른다.
교차검증 추정값
예측오차의 \(K\)-겹 교차검증 추정값은
여기서 \(\hat{y}_i^{(-k)}\)는 겹 \(k\) 없이 훈련한 모형이 내놓은 관측값 \(i\)의 예측값이다.
정보기준 함수
보기 1. AIC와 BIC 구현. 쪽머리의 두 식을 함수로 옮긴다.
(1) 정규 선형모형의 로그가능도에서 출발해 \(\mathrm{AIC} = n\ln(\mathrm{RSS}/n) + 2k\) 를 유도하시오. 버려진 항이 무엇이며 버려도 되는 까닭은 무엇인가.
(2) 그 버린 항의 크기를 \(n = 200\) 에서 계산하고, statsmodels 의 aic 와 이 함수의 값이 그만큼 차이 나는지 확인하시오. 그리고 "\(n > 7\) 부터 BIC 의 벌점이 더 무겁다" 는 주석의 근거를 적으시오.
풀이
(1) 해석적으로. 오차가 \(\varepsilon_i \sim N(0, \sigma^2)\) 로 독립이면 로그가능도는
이다. \(\sigma^2\) 의 최대가능도추정값은 \(\hat\sigma^2 = \mathrm{RSS}/n\) 이므로 그것을 넣으면 마지막 항이 \(-n/2\) 로 떨어지고
이 된다. 따라서
이고, 여기에 벌점 \(2k\) 를 더한 것이 AIC 다. 구현한 함수는 둘째 항을 버렸다.
버려도 되는 까닭은 그것이 \(n\) 에만 의존하고 모형에는 의존하지 않는다는 것이다. AIC 로 하는 일은 같은 자료 위의 여러 모형을 견주는 것이므로 모든 후보에 같은 상수가 더해지면 순서가 바뀌지 않고 차이도 바뀌지 않는다. 바뀌는 것은 AIC 의 절대값뿐이다.
그러므로 다른 소프트웨어가 찍은 AIC 와 이 함수의 값을 섞어 쓰면 안 된다. 같은 규약 안에서 비교해야 한다.
(2) 상수의 크기와 벌점의 비. \(n = 200\) 이면
이다. statsmodels 의 aic 에서 이 함수의 값을 빼면 정확히 이 수가 나와야 한다. BIC 도 같은 상수를 공유하므로 차이가 같아야 한다.
벌점의 비교는 간단하다. \(k\) 를 하나 늘릴 때 AIC 는 \(2\), BIC 는 \(\log n\) 만큼 커지므로
이다. \(n = 200\) 이면 \(\log 200 = 5.2983\) 이므로 BIC 의 벌점이 AIC 의 \(2.65\) 배다.
import numpy as np

def aic(n, rss, k):
    """AIC. 모수 하나당 벌점이 2 다."""
    return n * np.log(rss / n) + 2 * k

def bic(n, rss, k):
    """BIC. 벌점이 log(n) 이라 n>7 부터 AIC 보다 무겁다.

    그래서 BIC 는 대개 더 작은 모형을 고른다. AIC 는 예측을 잘하는 모형을,
    BIC 는 참 모형을 찾는 것을 겨냥한다고 흔히 말한다.
    """
    return n * np.log(rss / n) + k * np.log(n)
import statsmodels.api as sm

rng = np.random.RandomState(0)          # 전역 난수 상태를 건드리지 않는다
n_demo = 200
X_demo = np.column_stack([np.ones(n_demo), rng.randn(n_demo, 3)])
y_demo = X_demo @ np.array([1.0, 2.0, -1.0, 0.5]) + rng.randn(n_demo)
res = sm.OLS(y_demo, X_demo).fit()
rss_demo = (res.resid ** 2).sum()
k_demo = X_demo.shape[1]

print(f"쪽의 aic()      = {aic(n_demo, rss_demo, k_demo):.4f}")
print(f"statsmodels aic = {res.aic:.4f}")
print(f"차이            = {res.aic - aic(n_demo, rss_demo, k_demo):.4f}")
print(f"n(1 + ln 2pi)   = {n_demo * (1 + np.log(2 * np.pi)):.4f}")
print(f"bic 쪽의 차이   = {res.bic - bic(n_demo, rss_demo, k_demo):.4f}")
print(f"ln n = {np.log(n_demo):.4f},  2 와의 비 = {np.log(n_demo) / 2:.4f},  e^2 = {np.e ** 2:.4f}")
출력:
쪽의 aic()      = -8.9125
statsmodels aic = 558.6629
차이            = 567.5754
n(1 + ln 2pi)   = 567.5754
bic 쪽의 차이   = 567.5754
ln n = 5.2983,  2 와의 비 = 2.6492,  e^2 = 7.3891
유도한 상수가 정확히 나왔다. 차이가 \(567.5754\) 이고 \(n(1 + \log 2\pi) = 567.5754\) 다. BIC 쪽의 차이도 같은 \(567.5754\) 다. 유도대로 두 기준이 같은 상수를 공유한다.
눈에 띄는 것은 이 함수가 음수를 준다는 점이다(\(-8.9125\)). 잡음의 표준편차를 \(1\) 로 두었으므로 \(\mathrm{RSS}/n \approx 1\) 이고 \(n\log(\mathrm{RSS}/n) \approx 0\) 이어서 벌점 \(2k = 8\) 만 남을 것 같은데, 실제로는 \(\mathrm{RSS}/n\) 이 \(1\) 보다 조금 작아 첫 항이 \(-17\) 쯤 된다. AIC 의 부호에는 뜻이 없다. 비교만 뜻을 가진다.
벌점의 비도 유도한 대로다. \(\log 200 / 2 = 2.6492\) 이고 \(e^2 = 7.3891\) 이다. 그러므로 관측값이 여덟 개만 되어도 BIC 가 더 엄격한 기준이며, 이 쪽의 \(n = 200\) 에서는 모수 하나를 더하는 값이 AIC 에서 \(2\), BIC 에서 \(5.30\) 이다. 그 차이가 보기 3 의 표에서 눈으로 보인다.
교차검증 MSE
보기 2. 교차검증 구현. 섞은 색인을 토막으로 끊어 \(K\) 겹 교차검증 MSE 를 계산한다.
(1) fold_size = n // folds 때문에 검증에 한 번도 쓰이지 않는 관측값이 생길 수 있다. \(n = 200\) 일 때 folds 값마다 몇 개인지 세시오.
(2) 이 함수는 씨앗을 받지 않는다. 같은 입력으로 반복해 불러 값의 산포를 재고, 아래 결과표에서 크기 \(3\) 과 크기 \(4\) 의 CV 차이 \(0.029\) 와 견주시오. 그 차이로 모형을 고를 수 있는가.
풀이
(1) 나머지가 버려진다. fold_size = n // folds 는 내림 나눗셈이므로 겹 하나의 크기가 \(\lfloor n/K \rfloor\) 다. 검증에 쓰이는 관측값은 모두
개이고, 따라서 \(n \bmod K\) 개가 어느 겹에도 들어가지 않는다. 섞은 색인의 뒤쪽 꼬리에 남아 매번 훈련에만 쓰인다.
\(n = 200\) 이면 \(K = 5\) 나 \(K = 10\) 처럼 \(200\) 을 나누는 수에서는 나머지가 \(0\) 이라 문제가 없다. \(K = 7\) 이면 \(200 = 7 \times 28 + 4\) 이므로 \(4\) 개가 버려지고, \(K = 30\) 이면 \(200 = 30 \times 6 + 20\) 이므로 \(20\) 개, 곧 \(10\%\) 가 버려진다. 겹을 많이 쪼갤수록 나빠진다.
제대로 하려면 np.array_split 처럼 크기가 하나씩 다른 토막으로 나누어야 한다. sklearn 의 KFold 가 그렇게 한다.
(2) 씨앗이 없으면 값이 매번 달라진다. np.random.shuffle 은 전역 난수 상태를 쓰므로, 같은 X, y 로 두 번 불러도 다른 분할이 되고 다른 수가 나온다. 재현되지 않는다는 것이 첫째 문제이고, 그 변동이 비교하려는 차이보다 크면 비교 자체가 무의미해진다는 것이 둘째 문제다.
결과표에서 크기 \(3\) 의 CV 가 \(3.7603\), 크기 \(4\) 가 \(3.7891\) 로 차이가 \(0.0288\) 이다. 한 번 부른 값의 표준편차가 그보다 크면 순위가 분할마다 뒤집힐 것이다. 재 본다.
def cv_mse(X, y, folds=5):
    """k겹 교차검증으로 예측오차를 추정한다.

    AIC·BIC 가 공식으로 벌점을 매긴다면, 교차검증은 실제로 떼어 놓은
    자료에서 재 본다. 가정이 적은 대신 계산이 많이 든다.
    """
    n = len(y)
    indices = np.arange(n)
    np.random.shuffle(indices)
    fold_size = n // folds
    mses = []
    for k in range(folds):
        val_idx = indices[k * fold_size:(k + 1) * fold_size]
        train_idx = np.setdiff1d(indices, val_idx)
        X_tr, y_tr = X[train_idx], y[train_idx]
        X_va, y_va = X[val_idx], y[val_idx]
        beta = np.linalg.lstsq(X_tr, y_tr, rcond=None)[0]
        pred = X_va @ beta
        mses.append(np.mean((y_va - pred) ** 2))
    return np.mean(mses)
n_demo = 200
for f in [5, 6, 7, 9, 30]:
    used = f * (n_demo // f)
    print(f"  folds={f:2d}: fold_size={n_demo // f:3d},  검증에 쓰이는 관측값 {used}개,  한 번도 안 쓰이는 것 {n_demo - used}개")

# 아래 보기 3 과 같은 자료를 RandomState 로 만든다(전역 상태를 건드리지 않는다).
rng2 = np.random.RandomState(42)
p_demo = 8
Xd = rng2.randn(n_demo, p_demo)
yd = Xd @ np.array([3.0, -2.0, 1.5, 0, 0, 0, 0, 0]) + rng2.randn(n_demo) * 2
order = [0, 1, 2, 4, 7, 3, 5, 6]          # 보기 3 이 고르게 되는 순서
designs = [np.column_stack([np.ones(n_demo), Xd[:, order[:s]]]) for s in range(1, 9)]

np.random.seed(0)
col3 = np.array([cv_mse(designs[2], yd) for _ in range(20)])
print(f"크기 3 모형에 cv_mse 를 20번: 평균 {col3.mean():.4f}  표준편차 {col3.std(ddof=1):.4f}  "
      f"최소 {col3.min():.4f}  최대 {col3.max():.4f}")

# 여덟 크기의 CV 열을 500 번 다시 만들어, 최솟값이 어디에 떨어지는지 센다.
import collections
np.random.seed(0)
cnt = collections.Counter(); diff = []
for _ in range(500):
    col = [cv_mse(D, yd) for D in designs]
    cnt[int(np.argmin(col)) + 1] += 1
    diff.append(col[2] - col[3])
diff = np.array(diff)
print("최솟값이 나온 모형 크기의 빈도(500회):", dict(sorted(cnt.items())))
print(f"크기3 - 크기4: 평균 {diff.mean():+.4f}  표준편차 {diff.std(ddof=1):.4f}  "
      f"(평균의 몬테카를로 오차 {diff.std(ddof=1) / np.sqrt(500):.4f})")
print(f"크기 3 이 크기 4 보다 작게 나온 비율 = {(diff < 0).mean():.3f}")
출력:
  folds= 5: fold_size= 40,  검증에 쓰이는 관측값 200개,  한 번도 안 쓰이는 것 0개
  folds= 6: fold_size= 33,  검증에 쓰이는 관측값 198개,  한 번도 안 쓰이는 것 2개
  folds= 7: fold_size= 28,  검증에 쓰이는 관측값 196개,  한 번도 안 쓰이는 것 4개
  folds= 9: fold_size= 22,  검증에 쓰이는 관측값 198개,  한 번도 안 쓰이는 것 2개
  folds=30: fold_size=  6,  검증에 쓰이는 관측값 180개,  한 번도 안 쓰이는 것 20개
크기 3 모형에 cv_mse 를 20번: 평균 3.7151  표준편차 0.0527  최소 3.6409  최대 3.8332
최솟값이 나온 모형 크기의 빈도(500회): {3: 217, 4: 154, 5: 85, 6: 35, 7: 7, 8: 2}
크기3 - 크기4: 평균 -0.0164  표준편차 0.0771  (평균의 몬테카를로 오차 0.0034)
크기 3 이 크기 4 보다 작게 나온 비율 = 0.570
(1)의 셈이 맞는다. \(200 \bmod K\) 가 그대로 "안 쓰이는 것" 의 개수다. \(K = 5\) 는 \(0\), \(K = 7\) 은 \(4\), \(K = 30\) 은 \(20\) 이다.
(2) 그 차이로는 모형을 고를 수 없다.
크기 \(3\) 모형에 같은 함수를 \(20\) 번 불렀더니 값이 \(3.6409\) 에서 \(3.8332\) 까지 흔들렸고 표준편차가 \(0.0527\) 이다. 그런데 표에서 크기 \(3\) 과 크기 \(4\) 의 차이는 \(0.0288\) 로 그 표준편차의 절반이다. 곧 표에 적힌 \(3.7603\) 과 \(3.7891\) 이라는 두 수는 소수 넷째 자리까지 적혀 있지만, 실은 둘째 자리부터 분할에 따라 달라지는 수다.
\(500\) 번 다시 재어 보면 결론이 분명해진다. CV 의 최솟값이 크기 \(3\) 에 떨어지는 것은 \(500\) 번 가운데 \(217\) 번, \(43\%\) 뿐이다. 크기 \(4\) 가 \(154\) 번(\(31\%\)), 크기 \(5\) 가 \(85\) 번(\(17\%\))이고, 심지어 크기 \(8\) 이 뽑힌 적도 두 번 있다. 크기 \(3\) 이 크기 \(4\) 보다 작게 나온 비율도 \(0.570\) 으로 동전 던지기에 가깝다.
평균으로 보면 크기 \(3\) 이 크기 \(4\) 보다 \(0.0164\) 작고, 그 평균의 몬테카를로(Monte Carlo) 오차가 \(0.0034\) 이니 평균 차이 자체는 실재한다(\(0.0164 / 0.0034 \approx 4.8\) 배). 다만 그것을 보려면 분할을 수백 번 반복해야 한다. 한 번 부른 값으로는 알 수 없다.
그러므로 쪽 아래 결과표의 CV 열은 AIC·BIC 열과 성격이 다르다. AIC 와 BIC 는 자료가 정해지면 유일하게 정해지는 수이고, CV 는 분할이라는 또 하나의 난수에 매달린 수다. 표의 세 열이 모두 크기 \(3\) 에서 최소라는 사실 가운데 앞의 둘은 재현되고 셋째는 운이었다.
고치는 길은 세 가지다. 씨앗을 인자로 받게 하는 것, 반복 교차검증(RepeatedKFold)으로 여러 분할을 평균하는 것, 그리고 CV 값과 함께 분할에 따른 변동을 함께 보고하는 것이다. 쪽 끝의 "겹 나누기에 따라 결과가 달라지므로 여러 번 반복해 평균을 보는 것이 좋다" 가 바로 이 이야기다.
전진 선택
보기 3. 전진선택으로 변수 선택하기. 설명변수 여덟 개 가운데 앞의 셋만 계수가 \(0\) 이 아닌 자료에서 AIC 를 낮추는 변수를 하나씩 더해 간다.
(1) 모형에 변수를 하나 더할 때 AIC 와 BIC 가 얼마나 바뀌는지 \(\mathrm{RSS}\) 로 적으시오. 크기 \(3 \to 4\) 에서 그 식이 표의 차이 \(0.61\) 과 \(3.91\) 을 주는지 확인하시오.
(2) 쓸모없는 변수를 하나 더할 때 AIC 가 그것을 받아들일 확률을 근사하고, BIC 의 경우와 견주시오. "AIC 가 조금 큰 모형을 고르는 경향" 을 수로 적는 셈이다.
풀이
(1) 한 걸음의 차이. 변수를 하나 더하면 모수가 \(k\) 에서 \(k+1\) 로 늘고 \(\mathrm{RSS}\) 가 \(\mathrm{RSS}_k\) 에서 \(\mathrm{RSS}_{k+1}\) 로 줄어든다. 쪽머리의 식에서
이고 BIC 는 마지막 \(2\) 가 \(\log n\) 으로 바뀐다.
앞의 항은 두 기준에서 똑같다. 그러므로 두 \(\Delta\) 의 차이는 언제나 \(\log n - 2\) 로 상수이고, \(n = 200\) 에서 \(3.2983\) 이다. 표의 차이 \(3.91 - 0.61 = 3.30\) 이 그것이어야 한다.
변수를 받아들이는 조건은 \(\Delta < 0\) 이므로
다. 왼쪽의 양을 적합이 좋아진 몫이라 부르자.
(2) 그 몫의 분포. 변수가 쓸모없으면(\(\beta = 0\)) 그 변수를 더해 줄어드는 \(\mathrm{RSS}\) 는 자유도 \(1\) 의 카이제곱 몫이다. 정확히는 부분 \(F\) 통계량이
이고 \(n\) 이 크면 \(F \approx \chi^2_1\) 이다. 한편 \(\log(1+x) \approx x\) 를 쓰면
이다(마지막에서 \(n/(n-k-1) \approx 1\) 을 썼다). 그러므로 적합이 좋아진 몫은 대략 \(\chi^2_1\) 변량이고, 쓸모없는 변수를 받아들일 확률은
다. \(n = 200\) 에서 두 값을 계산해 보면 된다. 중요한 것은 AIC 쪽은 \(n\) 과 무관한 상수이고 BIC 쪽은 \(n \to \infty\) 에서 \(0\) 으로 간다는 점이다. 연습문제 4 가 말하는 일치성이 이 한 줄이다.
# 여덟 변수 중 앞의 셋만 실제로 쓰이고 나머지 다섯은 계수가 0 이다.
# 전진선택이 그 셋을 먼저 집어내는지 보는 것이 이 실험의 목적이다.
np.random.seed(42)
n, p_total = 200, 8
X_raw = np.random.randn(n, p_total)
beta_true = np.array([3.0, -2.0, 1.5, 0, 0, 0, 0, 0])
y = X_raw @ beta_true + np.random.randn(n) * 2

remaining = list(range(p_total))
selected = []
aic_history, bic_history = [], []

# 전진선택: 매 단계에서 AIC 를 가장 많이 낮추는 변수를 하나씩 더한다.
# 모든 부분집합을 따지면 2^8 개지만, 이렇게 하면 훨씬 적게 본다.
# 대신 최적 부분집합을 놓칠 수 있다.
for step in range(p_total):
    best_score, best_j = np.inf, None
    for j in remaining:
        cols = selected + [j]
        X_cand = np.column_stack([np.ones(n), X_raw[:, cols]])
        beta = np.linalg.lstsq(X_cand, y, rcond=None)[0]
        rss = np.sum((y - X_cand @ beta) ** 2)
        score = aic(n, rss, len(cols) + 1)
        if score < best_score:
            best_score, best_j = score, j
    selected.append(best_j)
    remaining.remove(best_j)

    X_sel = np.column_stack([np.ones(n), X_raw[:, selected]])
    beta = np.linalg.lstsq(X_sel, y, rcond=None)[0]
    rss = np.sum((y - X_sel @ beta) ** 2)
    k = len(selected) + 1
    aic_history.append(aic(n, rss, k))
    bic_history.append(bic(n, rss, k))
from scipy import stats

def rss_of(s):
    Xs = np.column_stack([np.ones(n), X_raw[:, selected[:s]]])
    return np.sum((y - Xs @ np.linalg.lstsq(Xs, y, rcond=None)[0]) ** 2)

print("선택 순서:", selected)
print("크기   RSS        AIC       BIC")
for s in range(1, p_total + 1):
    print(f" {s}   {rss_of(s):9.4f}  {aic_history[s - 1]:8.2f}  {bic_history[s - 1]:8.2f}")

rss3, rss4 = rss_of(3), rss_of(4)
print(f"n ln(RSS4/RSS3) = {n * np.log(rss4 / rss3):.4f}")
print(f"AIC 차 = 그것 + 2    = {n * np.log(rss4 / rss3) + 2:.4f}   (표의 차 {aic_history[3] - aic_history[2]:.4f})")
print(f"BIC 차 = 그것 + ln n = {n * np.log(rss4 / rss3) + np.log(n):.4f}   (표의 차 {bic_history[3] - bic_history[2]:.4f})")
print(f"네 번째 변수의 부분 F = {(rss3 - rss4) / (rss4 / (n - 5)):.4f}")
print(f"P(chi2_1 > 2) = {stats.chi2.sf(2, 1):.4f},  P(chi2_1 > ln 200) = {stats.chi2.sf(np.log(n), 1):.4f}")
print(f"RSS3/n = {rss3 / n:.4f},  RSS3/(n-4) = {rss3 / (n - 4):.4f}  (참 sigma^2 = 4)")
출력:
선택 순서: [0, 1, 2, 4, 7, 3, 5, 6]
크기   RSS        AIC       BIC
 1   2002.7003    464.79    471.38
 2   1243.9264    371.54    381.44
 3    712.3828    262.06    275.25
 4    707.4385    262.67    279.16
 5    705.3433    264.07    283.86
 6    705.1412    266.02    289.10
 7    705.0570    267.99    294.38
 8    705.0384    269.99    299.67
n ln(RSS4/RSS3) = -1.3929
AIC 차 = 그것 + 2    = 0.6071   (표의 차 0.6071)
BIC 차 = 그것 + ln n = 3.9054   (표의 차 3.9054)
네 번째 변수의 부분 F = 1.3628
P(chi2_1 > 2) = 0.1573,  P(chi2_1 > ln 200) = 0.0213
RSS3/n = 3.5619,  RSS3/(n-4) = 3.6346  (참 sigma^2 = 4)
(1) 한 걸음의 식이 정확히 맞는다. \(n\log(\mathrm{RSS}_4/\mathrm{RSS}_3) = -1.3929\) 이고, 거기에 \(2\) 를 더한 \(0.6071\) 이 AIC 표의 차이와 소수 넷째 자리까지 같다. \(\log 200 = 5.2983\) 을 더한 \(3.9054\) 도 BIC 표의 차이와 같다. 두 차이의 간격 \(3.9054 - 0.6071 = 3.2983\) 이 유도한 \(\log n - 2\) 다.
선택 순서 [0, 1, 2, 4, 7, 3, 5, 6] 도 재현되었다. 참으로 관련 있는 \(0, 1, 2\) 가 정확히 앞자리 셋을 차지했다. 뒤의 다섯은 모두 계수가 \(0\) 이므로 순서에 뜻이 없다.
(2) AIC 는 쓸모없는 변수를 \(16\%\) 확률로 받아들인다. \(P(\chi^2_1 > 2) = 0.1573\) 이다. BIC 는 \(P(\chi^2_1 > \log 200) = 0.0213\) 으로 \(2\%\) 다. 일곱 배 차이다.
이 쪽의 네 번째 변수가 바로 그 경계에 있다. 부분 \(F = 1.3628\) 로 임계값 \(2\) 에 못 미쳐 AIC 가 거부했지만, \(2\) 를 넘을 확률이 \(16\%\) 였으니 다른 표본에서는 받아들여졌을 것이다. 쪽 본문이 "네 번째 설명변수가 우연히 조금만 더 큰 적합 개선을 냈다면 AIC 는 그것을 골랐을 수 있다" 고 적은 것의 정확한 크기가 \(0.1573\) 이다.
쓸모없는 변수가 다섯 개이므로, 그 가운데 적어도 하나를 AIC 가 받아들일 확률은 근사로 \(1 - 0.8427^5 = 0.575\) 다. 절반이 넘는다(전진선택이라 독립이 아니므로 근사값이다). BIC 는 \(1 - 0.9787^5 = 0.102\) 다. AIC 로 변수를 고르면 잡음 변수 한두 개가 섞여 들어오는 것이 정상이라는 뜻이고, 그것이 "예측을 겨냥해 약간의 과적합(overfitting)을 감수한다" 는 말의 실체다.
마지막으로 바닥을 확인하자. 크기 \(3\) 모형의 \(\mathrm{RSS}/n = 3.5619\), 불편추정값 \(\mathrm{RSS}/(n-4) = 3.6346\) 이다. 참 \(\sigma^2 = 4\) 보다 조금 작다. 이 표본에서 실현된 잡음이 참값보다 작았기 때문이며, 어떤 모형도 \(\sigma^2\) 아래로 내려갈 수 없다는 사실과 어긋나지 않는다. 크기 \(4\) 부터 \(8\) 까지 \(\mathrm{RSS}\) 가 \(707.44 \to 705.04\) 로 \(0.3\%\) 밖에 줄지 않는 것도 같은 이야기다. 이미 바닥에 닿았으므로 더 보탤 것이 없다.
관련 있는 셋이 먼저 뽑혔다
선택 순서(0부터 시작하는 색인)는 [0, 1, 2, 4, 7, 3, 5, 6]으로, 참으로 관련 있는 세 설명변수 0, 1, 2가 정확히 먼저 뽑혔다.
| 모형 크기 | AIC | BIC | 5-겹 CV MSE |
|---|---|---|---|
| 1 | 464.79 | 471.38 | 10.1104 |
| 2 | 371.54 | 381.44 | 6.3024 |
| 3 | 262.06 | 275.25 | 3.7603 |
| 4 | 262.67 | 279.16 | 3.7891 |
| 5 | 264.07 | 283.86 | 3.8011 |
| 6 | 266.02 | 289.10 | 3.8225 |
| 7 | 267.99 | 294.38 | 3.8682 |
| 8 | 269.99 | 299.67 | 3.8933 |
세 기준 모두 크기 3에서 최솟값을 갖는다. 잡음 설명변수 다섯 개가 올바르게 배제되었다.
크기 3과 크기 4의 AIC 차이가 \(0.61\)에 지나지 않는다는 점에 주목하라. AIC 벌점이 상대적으로 약하기 때문에, 네 번째 설명변수가 우연히 조금만 더 큰 적합 개선을 냈다면 AIC는 그것을 골랐을 수 있다. 반면 BIC 차이는 \(3.91\)로 훨씬 뚜렷하다. AIC보다 BIC가 절약적인 모형을 더 확실하게 선호한다는 사실을 그대로 보여준다.
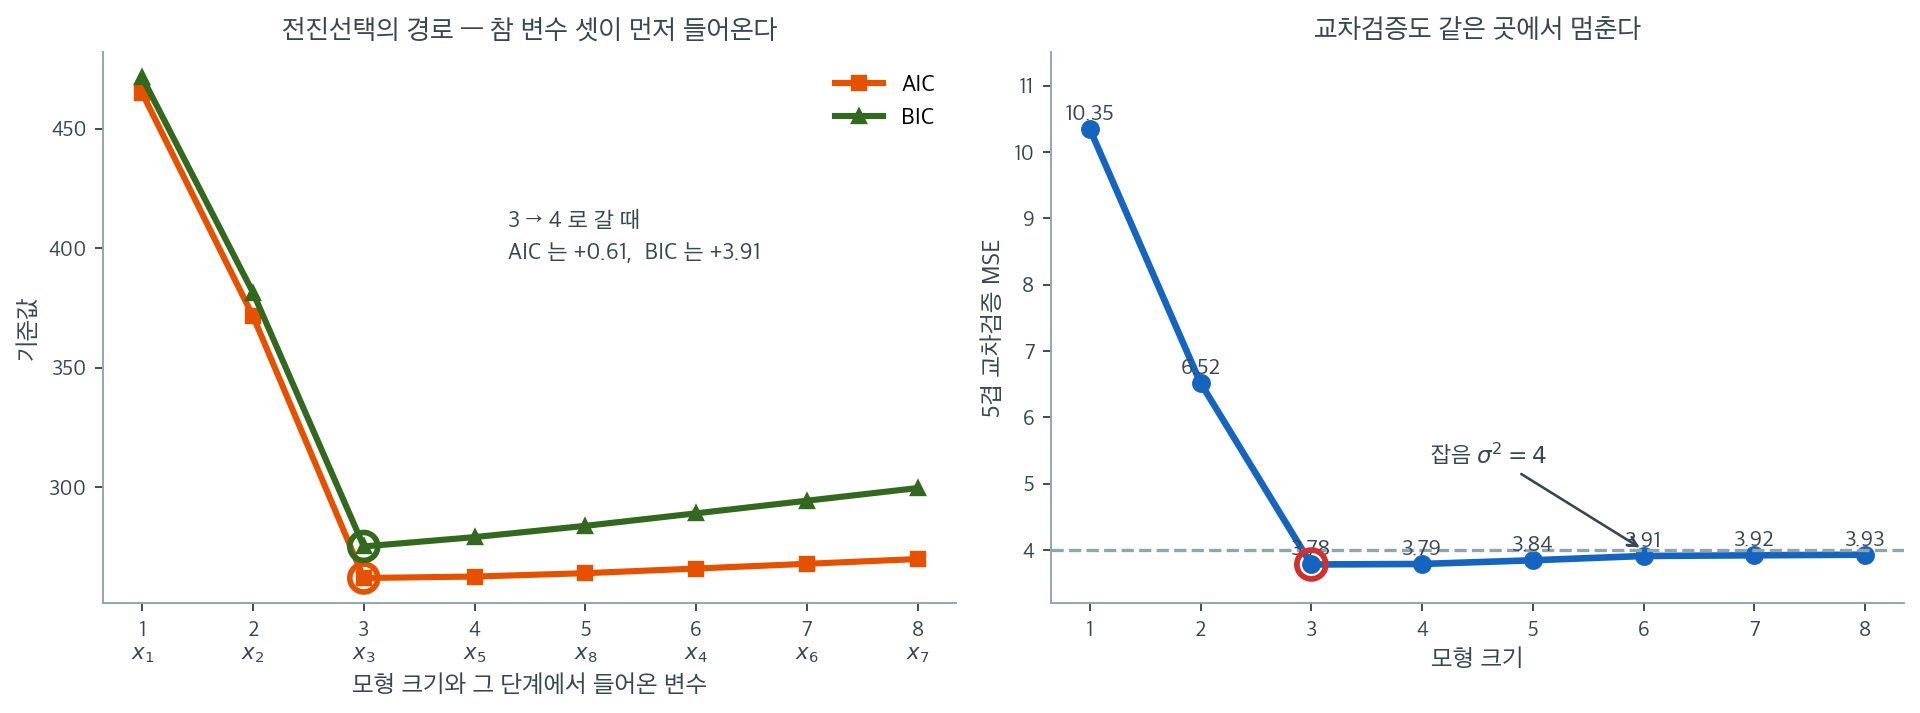
위 표를 그림으로 옮겼다. 왼쪽 가로축은 모형의 크기이고, 그 아래에 그 단계에서 새로 들어온 변수를 적었다. 순서가 \(x_1, x_2, x_3\)으로 시작한다는 것이 이 실험의 첫 결과다. 참으로 관련 있는 셋이 잡음 다섯 개보다 먼저, 그것도 정확히 앞자리에 들어왔다. 네 번째 자리부터는 \(x_5, x_8, x_4, \ldots\)로 순서가 뒤죽박죽인데, 계수가 모두 \(0\)인 변수들 사이에서는 순서에 의미가 없으니 당연한 일이다.
두 기준선 모두 크기 \(3\)을 지나면서 바닥을 치고 올라간다. 여기서 눈여겨볼 것은 올라가는 속도다. 크기 \(3\)에서 \(4\)로 갈 때 AIC는 \(262.06\)에서 \(262.67\)로 \(+0.61\)만 오르는 반면 BIC는 \(275.25\)에서 \(279.16\)으로 \(+3.91\) 오른다. AIC의 곡선이 바닥 근처에서 훨씬 평평하다는 뜻이고, 이는 네 번째 변수가 우연히 조금만 더 잘 맞았다면 AIC가 그것을 데려갔으리라는 뜻이다. 보기 3 의 (2)가 수로 적은 "AIC가 조금 큰 모형을 고르는 경향"이 이 평평함이다.
오른쪽은 \(5\)겹 교차검증 MSE다. 점근이론도 가능도도 쓰지 않고 표본 밖 오차를 직접 재는 방법인데, 결론은 같다. 크기 \(3\)에서 \(3.78\)로 최소이고 그 뒤로는 \(3.79,\ 3.84,\ 3.91, \ldots\)로 서서히 오른다. 그리고 그 최솟값이 잡음의 분산 \(\sigma^2 = 4\) 바로 아래에 붙어 있다는 점이 결정적이다. \(4\)가 어떤 모형도 넘어설 수 없는 바닥이고, 크기 \(3\) 모형이 이미 거기에 닿았으므로 더 보탤 것이 없다. 서로 전혀 다른 출발점에서 온 세 기준이 같은 자리를 가리킨다는 사실이 이 선택에 대한 가장 강한 근거다.
2. 벌점의 세기가 모형의 크기를 정한다
- AIC는 벌점(\(2k\))이 비교적 약해 조금 더 큰 모형을 고르는 경향이 있다. 예측 정확도를 겨냥한다.
- BIC는 \(k \ln(n)\)이 표본크기와 함께 커지므로 더 작은 모형을 고르는 경향이 있다. 일치성을 가져 (참 모형이 후보에 있다면) \(n \to \infty\)일 때 참 모형을 고른다.
- 교차검증은 점근이론에 기대지 않고 표본 밖 예측오차를 직접 추정한다. 계산 비용이 크지만 분포 가정을 덜 요구한다.
- 이 예에서는 참으로 관련 있는 설명변수가 3개이며, 세 방법 모두 크기 3의 모형을 찾아내어 잡음 설명변수가 올바르게 배제됨을 확인해 준다.
그림으로 보는 통계학 1. 한 번의 일치는 얼마나 흔한 일인가
\(1\) 절의 결과 풀이(「관련 있는 셋이 먼저 뽑혔다」)는 이렇게 닫혔다 — 「서로 전혀 다른 출발점에서 온 세 기준이 같은 자리를 가리킨다는 사실이 이 선택에 대한 가장 강한 근거다.」 그 자료에서는 맞는 말이다. 그런데 그 문장을 근거로 쓰려면 한 가지를 더 알아야 한다. 자료를 다시 뽑으면 얼마나 자주 그렇게 되는가.
같은 설정으로 \(1000\) 번 반복했다 — 관측 \(200\) 개, 설명변수 여덟 개, 참 계수 \((3,\ -2,\ 1.5,\ 0, \ldots, 0)\), 잡음의 표준편차 \(2\). 그때마다 전진선택을 돌리고 세 기준이 각각 어느 크기에서 멈추는지 센다.
먼저 좋은 소식이다.
| 비율 | |
|---|---|
| 먼저 들어온 셋이 참 변수 집합 \(\{x_1, x_2, x_3\}\) 인 경우 | \(\mathbf{1.000}\) |
| 들어온 순서까지 \(x_1, x_2, x_3\) 인 경우 | \(0.978\) |
\(1000\) 번 모두 참 변수 셋이 먼저 들어왔다. 신호가 세기 때문이고(\(t\) 로 치면 \(21\), \(14\), \(11\) 쯤이다), 「참으로 관련 있는 셋이 정확히 앞자리에 들어왔다」는 그 결과 풀이의 첫 관찰은 운이 아니었다.
나쁜 소식은 어디서 멈추는가다.
| 기준 | 크기 \(3\) 을 고른 비율 | 고른 크기의 평균 |
|---|---|---|
| AIC | \(0.408\) | \(3.84\) |
| BIC | \(0.880\) | \(3.13\) |
| \(5\) 겹 교차검증 | \(0.422\) | \(3.90\) |
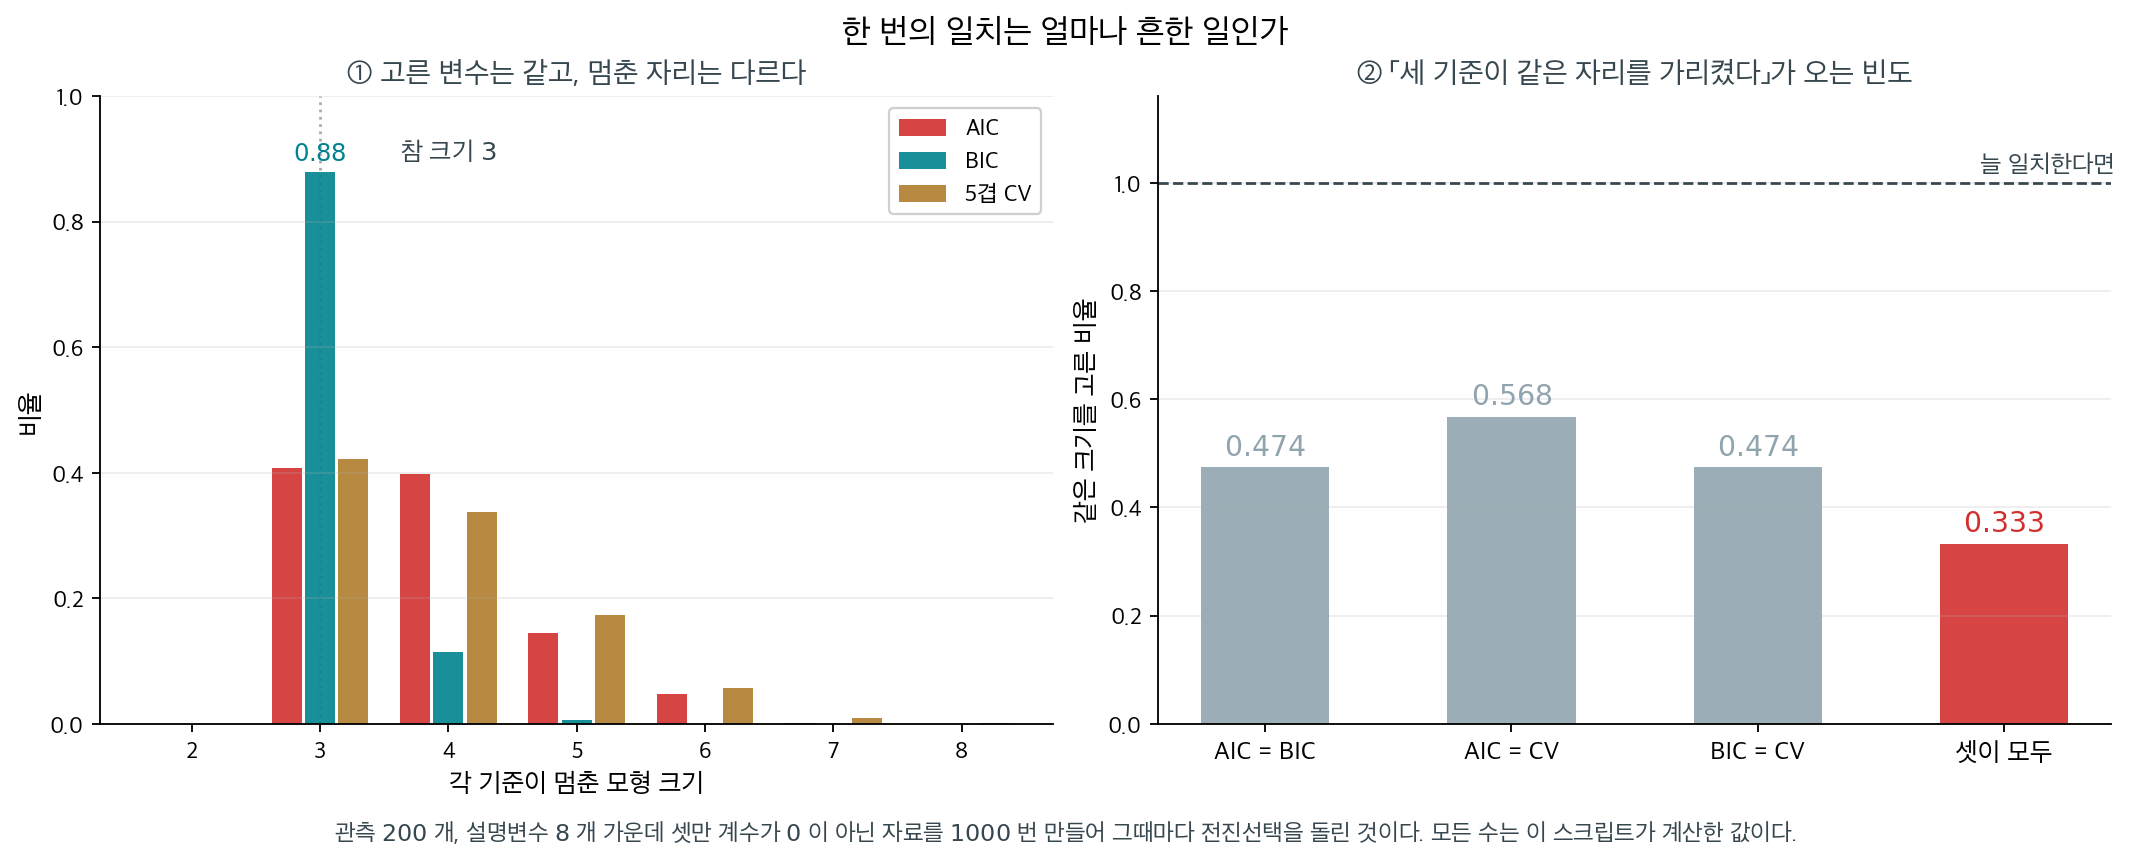
AIC 와 교차검증은 열 번 가운데 네 번만 크기 \(3\) 에서 멈춘다. 나머지는 잡음 변수를 하나나 둘 더 데려간다. 보기 3 의 (2)가 근사한 「AIC 가 쓸모없는 변수를 받아들일 확률」이 여기서는 분포의 모양으로 나타난다. 고르는 변수는 흔들리지 않는데 멈추는 자리가 흔들리는 것이다.
그러면 처음의 문장은 어떻게 되는가. 세 기준이 모두 같은 크기를 고른 경우는 \(1000\) 번 가운데 \(333\) 번, 곧 \(0.333\) 이다. 둘씩만 보아도 AIC–BIC 가 \(0.474\), AIC–교차검증이 \(0.568\), BIC–교차검증이 \(0.474\) 다. 「세 기준이 같은 자리를 가리켰다」는 말은 증거이되, 세 번에 한 번 오는 증거다.
BIC 가 유난히 안정적인 것도 그냥 읽으면 안 된다. 이 실험은 참 모형이 후보 안에 있는 설정이고, 그것이 13.9절 베이즈 정보기준의 상자가 말한 BIC 의 일치성이 사는 자리다. 참이 후보 밖에 있는 자료에서는 순위가 그대로 뒤집힌다.
그러니 그 결과 풀이의 마지막 문장은 이렇게 고쳐 읽는 편이 낫다. 세 기준이 일치한 것은 좋은 신호이지만, 그 신호가 얼마나 자주 오는지를 함께 재어야 신호의 크기를 안다. 한 번의 자료에서 본 일치는 「크기 \(3\) 이 옳다」가 아니라 「크기 \(3\) 이 세 기준 모두에게 가장 그럴듯했다」는 말이고, 그 둘의 거리가 위 표의 \(0.333\) 이다.
3. 광고 자료에서 세 모형을 견준다
\(1\)–\(2\) 절이 세운 자를 실제 자료에 대어 본다. 13.1절 다중선형회귀가 Advertising 자료에 세 모형을 적합했다 — 설명변수 셋, 둘, 그리고 곱항을 넣은 것. 처음 \(140\) 개를 훈련자료로 쓴 결과가 이렇다.
| 지표 | TV, Radio, Newspaper | TV, Radio | TV, Radio, TV:Radio |
|---|---|---|---|
| R-squared | 0.894 | 0.894 | 0.965 |
| Adj. R-squared | 0.891 | 0.892 | 0.964 |
| F-statistic | 381.2 | 575.1 | 1256 |
| AIC | 555.8 | 554.0 | 399.6 |
| BIC | 567.5 | 562.8 | 411.4 |
| 유의한 설명변수 | TV, Radio | TV, Radio | TV, Radio, TV:Radio |
| Condition Number | 457 | 424 | 1.84e+04 |
읽을 것이 넷이다.
- \(R^2\) 는 Newspaper 를 빼도 줄지 않는데 AIC·BIC 는 오히려 좋아진다. \(R^2\) 가 변수를 더하면 결코 줄지 않는 양이라 고르는 자로 쓸 수 없다는 것(\(1\) 절)이 여기서 눈에 보인다. 벌점이 붙은 셋 — 수정 \(R^2\) · AIC · BIC — 만 「빼는 편이 낫다」고 말한다. 그 계수의 \(p\) 값은 \(0.669\) 다.
- 교호작용(interaction) 항을 넣으면 크게 좋아진다. \(R^2\) 가 \(0.894\) 에서 \(0.965\) 로 오르고 AIC 가 \(554.0\) 에서 \(399.6\) 으로 내린다. \(154\) 라는 차이는 \(2\) 절의 척도로 읽으면 압도적이다 — 모수 하나를 더하는 값이 AIC 에서 \(2\) 이므로.
- 그런데 조건수가 \(1.84\times10^4\) 로 튄다. 곱항이 원래 항과 거의 같은 방향을 가리키기 때문이고, 예측은 멀쩡해도 계수 하나하나의 해석은 흔들린다. 중심화하면 사라지는 증상이다 — 13.7절 다중공선성과 분산팽창인자가 그 자리를 다룬다.
- 세 모형 모두 잔차의 정규성(normality)을 위배하고 교호작용 모형이 가장 심하다(자크–베라 \(131.4\) · \(122.2\) · \(767.1\), 첨도(kurtosis) \(6.74\) · \(6.56\) · \(13.53\)). AIC 가 가장 낮은 모형이 가정을 가장 많이 어긴다는 것이 이 표의 가장 불편한 줄이고, 정보기준이 적합도(goodness of fit)만 보고 가정은 보지 않는다는 사실을 그대로 드러낸다.
그래서 답이 하나가 아니다. 예측이 목적이면 교호작용 모형이고, 계수를 읽어 의사결정에 쓸 것이면 TV·Radio 모형이 낫다. 자가 둘 이상이면 고르는 일은 수가 아니라 목적이 한다.
연습문제
연습문제 1. 각 단계에서 다음 설명변수를 정할 때 AIC 대신 BIC를 써서 전진선택 절차를 수행하라. 선택되는 설명변수의 순서가 달라지는가?
풀이
안쪽 반복문의 score = aic(n, rss, len(cols) + 1)을 score = bic(n, rss, len(cols) + 1)로 바꾼다.
선택 순서는 바뀌지 않는다. 한 단계 안에서 후보들은 모두 같은 \(k\)를 가지므로 AIC든 BIC든 벌점항이 상수이고, 결국 RSS를 가장 크게 줄이는 변수를 고르게 되어 두 기준이 동일한 선택을 한다. 달라지는 것은 멈추는 지점이다. BIC는 벌점이 더 강해 더 적은 설명변수에서 멈춘다. 위 표에서도 크기 4 이후 BIC의 증가폭이 AIC보다 훨씬 가파르다. \(\square\)
연습문제 2. 잡음 수준을 \(\sigma = 2\)에서 \(\sigma = 5\)로 키워라. 각 기준이 고르는 최적 모형 크기는 어떻게 달라지는가?
풀이
잡음이 커지면 신호 대 잡음비가 낮아진다. 참 설명변수를 넣고 뺄 때의 RSS 차이가 전체 RSS에 비해 작아진다. AIC와 BIC가 더 적은 설명변수를 고를 수 있고(3개 대신 1–2개), 교차검증 MSE 곡선은 평평해져 최솟값이 덜 뚜렷해진다. 잡음 설명변수와 참 설명변수를 구별하기 어려워진다. \(\square\)
연습문제 3. 10-겹 교차검증을 구현하여 5-겹과 비교하라. \(K\)의 선택에서 편향–분산 절충을 논하라.
풀이
cv5 = [cv_mse(np.column_stack([np.ones(n), X_raw[:, selected[:s]]]), y, folds=5)
       for s in range(1, p_total + 1)]
cv10 = [cv_mse(np.column_stack([np.ones(n), X_raw[:, selected[:s]]]), y, folds=10)
        for s in range(1, p_total + 1)]
\(K\)가 커지면 각 훈련집합의 크기가 \(n\)에 가까워져 편향이 줄지만, 훈련집합들이 서로 더 많이 겹쳐(겹마다 적합한 모형이 비슷해져 평균해도 변동이 덜 상쇄된다) 분산이 커진다. \(K = 5\)는 편향이 조금 크지만 분산이 작고, \(K = 10\)은 편향이 작지만 분산이 크다. 극단인 \(K = n\)(LOOCV)은 거의 불편이지만 분산이 클 수 있다. \(\square\)
연습문제 4. 참 모형에 관련 설명변수가 3개 있다고 하자. \(n \to \infty\)일 때 \(P(\text{BIC가 참 모형을 고른다}) \to 1\)이지만 AIC는 그렇지 않음을 증명하라.
풀이
AIC에서 모수 하나를 더할 때의 벌점은 \(n\)과 무관하게 \(2\)이다. \(n \to \infty\)일 때 무관한 설명변수를 넣어 얻는 \(n\ln(\mathrm{RSS}/n)\)의 감소량은 \(\chi^2_1\) 확률변수(평균 1)로 수렴하므로 2를 넘을 확률이 0이 아니다. 따라서 AIC는 점근적으로 과적합한다.
BIC에서는 벌점이 \(\ln(n) \to \infty\)인 반면, 무관한 설명변수를 넣어 얻는 개선은 여전히 유계이다(\(\chi^2_1\)로 수렴한다). 따라서 \(n\)이 충분히 크면 벌점이 지배하여 무관한 설명변수가 확률 1로 배제된다. 이것이 BIC의 일치성이다. \(\square\)
연습문제 5. 베이즈 모형비교의 관점에서 BIC 벌점 \(k\ln(n)\)을 유도하라. 왜 벌점이 \(n\)에 의존하는가?
풀이
베이즈 모형선택에서는 모수공간에 대해 적분하여 주변가능도 \(p(\mathbf{y} \mid M)\)을 계산한다. 이 적분에 라플라스 근사(Laplace approximation) — 피적분함수의 로그를 최댓값 \(\hat{\boldsymbol{\theta}}\) 둘레에서 이차식으로 펴서 적분을 정규분포 꼴로 계산하는 방법 — 를 쓰면
양변에 \(-2\)를 곱하면 \(\mathrm{BIC} = -2\ln L + k\ln(n)\)을 얻는다. 벌점이 \(n\)에 의존하는 것은, 자료가 많아질수록 사후분포(posterior distribution)가 더 좁게 집중되어 모수 추가에 드는 "부피" 비용이 \(n\)에 대해 로그로 커지기 때문이다. \(\square\)
연습문제 6. 보기 3 의 (2) 는 변수를 받아들이는 조건을 \(\chi^2_1 > 2\) 로 근사했다. 근사를 쓰지 않고 정확한 임계값을 부분 \(F\) 로 적는다.
(1) \(\Delta\mathrm{AIC} < 0\) 이 부분 \(F\) 에 대한 조건으로 정확히 어떻게 쓰이는지 보이시오. 크기 \(3 \to 4\) 단계(\(n = 200\), 분모 자유도 \(195\))에서 AIC 와 BIC 의 임계값을 수로 적고, 그것을 \(t\) 통계량의 임계값으로도 옮기시오.
(2) AIC 의 정확한 임계값은 \(2\) 보다 큰가 작은가. 두 가지 보정이 서로 반대 방향으로 작용하는데 어느 쪽이 이기는지 밝히시오. 그리고 경험 법칙 "\(F > 2\)" 와 정확한 규칙이 서로 다른 답을 주는 \(F\) 의 구간을 적고, 이 쪽의 네 번째 변수(\(F = 1.3628\))가 그 구간에 드는지 확인하시오.
풀이
(1) 정확한 임계값. 보기 3 의 (1) 에서 \(\Delta\mathrm{AIC} = n\log(\mathrm{RSS}_{k+1}/\mathrm{RSS}_k) + 2\) 였다. 근사 없이 그대로 풀면
이다. 여기에 부분 \(F\) 의 정의
을 넣으면 로그도 근사도 없는 정확한 조건
을 얻는다(BIC 는 \(2\) 자리에 \(\log n\) 이 들어가고 \(e^{\log n / n} = n^{1/n}\) 이다). \(n = 200\), \(k = 4\), \(n-k-1 = 195\) 에서
다. 부분 \(F\) 는 \(t\) 통계량의 제곱이므로(분자 자유도가 \(1\) 이라) 같은 규칙이
가 된다. AIC 로 전진선택하는 것은 사실상 "\(t\) 값이 \(1.4\) 를 넘으면 넣는다" 는 규칙이다(\(n \to \infty\) 에서 임계값은 \(\sqrt 2 = 1.4142\) 로 간다). 유의수준 \(5\%\) 의 \(1.96\) 보다 훨씬 느슨하다. BIC 의 \(2.2880\) 은 반대로 \(1.96\) 보다 엄격하다.
(2) 정확한 임계값은 \(2\) 보다 작다. 두 보정을 떼어 보면
이다. 분모 자유도가 \(n\) 보다 작다는 것이 임계값을 \(2.5\%\) 내리고, \(e^x - 1 > x\) 가 \(0.5\%\) 올린다. 자유도 보정이 이긴다. 그러므로 정확한 AIC 는 \(\chi^2_1 > 2\) 근사보다 조금 더 헤프고, 쓸모없는 변수를 받아들일 확률도 \(0.1573\) 보다 커야 한다(연습문제 9 에서 재 본다).
두 규칙이 어긋나는 것은 \(F \in [1.9598,\, 2)\) 일 때다. 이 구간에 떨어질 확률은 \(P(F_{1,195} > 1.9598) - P(F_{1,195} > 2) = 0.1631 - 0.1589 = 0.0042\) 로 \(240\) 개 변수에 하나쯤이다. 네 번째 변수는 \(F = 1.3628\), 곧 \(\lvert t \rvert = 1.1674\) 이므로 두 임계값 \(1.9598\) 과 \(2\) 보다 한참 아래다. 어느 규칙을 쓰든 AIC 가 거부하며, 보기 3 의 결론은 근사 때문에 생긴 것이 아니다. \(\square\)
연습문제 7. 연습문제 1 은 전진선택이 고르는 순서가 AIC 와 BIC 에서 같다고 했다. 그 논증은 "한 단계의 후보들이 모두 같은 \(k\) 를 가진다" 는 데 기대고 있다. 후보의 모수 개수가 서로 다르면(네 수준 범주형 변수는 가변수 셋을 한꺼번에 넣는다) 결론이 깨진다. 반례를 만든다.
(1) 크기 \(3\) 모형(\(\mathrm{RSS}_0 = 712.3828\), \(k = 4\))에서 후보 A 는 연속변수 하나(\(\Delta k = 1\)), 후보 B 는 네 수준 범주형 변수 하나(\(\Delta k = 3\))라 하자. AIC 와 BIC 가 서로 다른 후보를 고르는 것은 \(n\log(\mathrm{RSS}_B/\mathrm{RSS}_A)\) 가 어떤 구간에 들 때인가. \(n = 200\) 에서 그 구간과 길이를 적으시오.
(2) \(\mathrm{RSS}_A = 707.4385\) (쪽 표의 크기 \(4\) 값)로 두고 그 구간 안의 값을 하나 집어 \(\mathrm{RSS}_B\) 를 정하시오. \(\mathrm{AIC}(A), \mathrm{AIC}(B), \mathrm{BIC}(A), \mathrm{BIC}(B)\) 네 값을 계산해 뒤집힘을 보이고, 두 기준이 그 단계에서 실제로 하는 일이 어떻게 갈리는지 적으시오. 구간의 길이는 \(n \to \infty\) 에서 어떻게 되는가.
풀이
(1) 어긋나는 구간. 두 후보의 모수 개수가 \(k+1\) 과 \(k+3\) 이므로
이다. \(k\) 가 같을 때와 달리 벌점이 상쇄되지 않는다. \(L = n\log(\mathrm{RSS}_B/\mathrm{RSS}_A)\) 라 두면 AIC 가 B 를 고르는 조건은 \(L < -4\), BIC 가 A 를 고르는 조건은 \(L > -2\log n = -10.5966\) 이므로 둘이 갈리는 것은
일 때이고 길이는 \((\Delta k_B - \Delta k_A)(\log n - 2) = 2 \times 3.2983 = 6.5966\) 이다. 반대 방향의 불일치(BIC 가 B, AIC 가 A)는 없다 — BIC 가 B 를 고르는 \(L < -10.5966\) 에서는 AIC 도 B 를 고른다. 벌점이 무거운 BIC 는 언제나 모수가 적은 쪽으로 기울기 때문이다.
(2) 반례. 구간 안의 깔끔한 값 \(L = -7\) 을 집는다. 그러면
이다(범주형 변수가 연속변수보다 \(\mathrm{RSS}\) 를 \(3.4\%\) 더 줄인 셈이니 무리한 수가 아니다). 네 값은
| 모형 | \(k\) | RSS | AIC | BIC |
|---|---|---|---|---|
| 크기 3 (바탕) | 4 | 712.3828 | 262.0596 | 275.2529 |
| + 후보 A | 5 | 707.4385 | 262.6667 | 279.1583 |
| + 후보 B | 7 | 683.1064 | 259.6667 | 282.7549 |
이다. AIC 는 B 를 고르고(\(259.67 < 262.67\)) BIC 는 A 를 고른다(\(279.16 < 282.75\)). 차이도 유도한 대로 \(-3.0000\) 과 \(+3.5966\) 이고 그 간격이 \(6.5966\) 이다.
두 기준이 하는 일은 한 걸음 더 갈린다. AIC 에게 B 는 바탕보다도 좋으므로(\(259.67 < 262.06\)) 범주형 변수를 데리고 다음 단계로 간다. BIC 가 고른 A 는 바탕보다 나쁘므로(\(279.16 > 275.25\)) BIC 는 거기서 멈춘다. 순서만 달라지는 것이 아니라 최종 모형이 달라진다.
구간의 길이 \((\Delta k_B - \Delta k_A)(\log n - 2)\) 는 \(n \to \infty\) 에서 무한히 커진다. 그러므로 표본이 커질수록 두 기준은 더 자주 갈린다. \(F\) 로 보면 쓸모없는 세 자유도 블록을 AIC 가 받아들일 확률은 \(P(\chi^2_3 > 6) = 0.1116\) 으로 \(n\) 과 무관한데, BIC 쪽은 \(P(\chi^2_3 > 3\log 200) = 0.0012\) 이고 \(n \to \infty\) 에서 \(0\) 으로 간다. 연습문제 4 의 일치성이 블록 단위에서도 그대로다.
실무에서 중요한 교훈은 범주형 변수와 연속변수를 같은 단계에서 겨루게 하면 기준에 따라 답이 갈린다는 것이다. 연습문제 1 의 "순서는 안 바뀐다" 는 모든 후보가 자유도 하나일 때만 참이다. \(\square\)
연습문제 8. \(5\) 겹 교차검증에서 훈련 표본의 크기는 \(m = n - n/5 = 160\) 이다. 설계행렬이 정규난수이고 참 변수 셋이 모형에 모두 들어 있으면, 새 관측값에 대한 기대 예측오차가 모수 \(k\) 개의 모형에서 대략
이다. 이 식으로 결과표의 CV 열을 예측해 본다.
(1) \(\sigma^2\) 자리에 크기 \(3\) 모형의 불편추정값 \(\mathrm{RSS}_3/(n-4) = 3.6346\) 을 넣어 크기 \(3\) 부터 \(8\) 까지 CV 값을 예측하고 표의 값과 견주시오. 변수 하나를 더할 때 예측되는 상승폭은 얼마이며 실제 표의 평균 상승폭은 얼마인가.
(2) 그 상승폭을 보기 2 가 재어 놓은 분할 잡음(크기 \(3\) 과 \(4\) 의 차이의 표준편차 \(0.0771\))과 견주시오. 교차검증으로 변수 하나의 유무를 가리려면 분할을 몇 번쯤 반복해야 하는가.
(3) 표본 안 오차의 기댓값은 \(\mathrm{E}[\mathrm{RSS}/n] = \sigma^2(1 - k/n)\) 이다. 표본 밖 오차 \(\sigma^2(1 + k/n)\) 과의 차이에 \(n/\sigma^2\) 를 곱하면 무엇이 나오는가.
풀이
(1) 예측과 실제. \(\sigma^2 \leftarrow 3.6346\), \(m = 160\), \(k = s + 1\) 을 넣는다.
| 크기 \(s\) | \(k\) | 예측 \(\sigma^2(1 + k/m)\) | 표의 CV | 차 |
|---|---|---|---|---|
| 3 | 4 | 3.7255 | 3.7603 | +0.035 |
| 4 | 5 | 3.7482 | 3.7891 | +0.041 |
| 5 | 6 | 3.7709 | 3.8011 | +0.030 |
| 6 | 7 | 3.7936 | 3.8225 | +0.029 |
| 7 | 8 | 3.8163 | 3.8682 | +0.052 |
| 8 | 9 | 3.8391 | 3.8933 | +0.054 |
수준도 기울기도 맞는다. 예측되는 상승폭은 모수 하나당
이고(정규설계의 정확한 값 \(\sigma^2(1 + k/(m-k-1))\) 을 쓰면 \(0.0236\) 으로 넷째 자리만 달라진다), 표의 실제 상승폭은 \(+0.0288,\, +0.0120,\, +0.0214,\, +0.0457,\, +0.0251\) 로 평균 \((3.8933 - 3.7603)/5 = 0.0266\) 이다. 하나씩 보면 \(0.0120\) 부터 \(0.0457\) 까지 네 배나 들쭉날쭉한데, 평균은 예측값에 붙어 있다. 편향 \(+0.03 \sim +0.05\) 는 \(\sigma^2\) 을 전체 \(n = 200\) 에서 추정해 쓴 탓과 분할 잡음이 섞인 탓이다.
여기서 CV 곡선이 올라가는 까닭이 드러난다. 쓸모없는 변수는 \(\mathrm{RSS}\) 를 거의 줄이지 못하는 대신 추정해야 할 모수를 하나 늘려 예측분산을 \(\sigma^2/m\) 만큼 키운다. 교차검증은 벌점을 손으로 물리지 않는데도 벌점이 생기는 것이고, 그 크기가 \(\sigma^2/m\) 이다.
(2) 신호가 잡음의 \(3\) 분의 \(1\) 이다. 가리려는 상승폭은 \(0.0227\) 인데 보기 2 가 잰 분할 간 표준편차는 \(0.0771\) 이다. 잡음이 신호의 \(3.4\) 배다. 한 번의 \(5\) 겹 교차검증으로는 변수 하나의 유무를 가릴 수 없다는 뜻이고, 보기 2 에서 최솟값이 크기 \(3\) 에 떨어진 것이 \(43\%\) 뿐이었던 이유가 이 한 줄이다.
분할을 \(R\) 번 반복해 평균하면 표준오차가 \(0.0771/\sqrt R\) 이다. 상승폭을 \(3\) 표준오차로 보려면
이므로 \(100\) 번쯤 반복해야 한다. 보기 2 가 \(500\) 번 반복해 평균 차이 \(0.0164\) 를 몬테카를로 오차 \(0.0034\) 로, 곧 \(4.8\) 표준오차로 잡아낸 것과 앞뒤가 맞는다.
(3) AIC 의 \(2k\) 가 바로 그 차이다.
이다. 표본 안 오차가 표본 밖 오차보다 작게 나오는 몫(낙관)이 \(2k\sigma^2/n\) 이고, 그것을 \(\mathrm{RSS}\) 의 척도로 바꾼 것이 정확히 AIC 의 벌점 \(2k\) 다. 실제로 \(n\log(\mathrm{RSS}/n) \approx n\log\sigma^2 + \mathrm{RSS}/\sigma^2 - n\) 으로 펴면
이고, 마지막 항은 모형과 무관하므로 AIC 를 최소화하는 것은 \(\mathrm{RSS}/n + 2k\sigma^2/n\), 곧 표본 밖 오차의 추정값을 최소화하는 것이다. 그래서 표의 AIC 열과 CV 열이 같은 자리를 가리킨다. 둘은 서로 다른 방법이 아니라 같은 양을 재는 두 가지 방법이고, 하나는 공식으로 하나는 자료를 떼어 재는 것뿐이다. 차이는 정확도다. AIC 는 변동 없이 \(0.61\) 이라는 수를 주고, CV 는 같은 양을 \(\pm 0.077\) 의 잡음과 함께 준다. \(\square\)
연습문제 9. 연습문제 6 은 AIC 의 정확한 임계값이 \(F > 1.9598\) 이고 보기 3 의 근사 \(P(\chi^2_1 > 2) = 0.1573\) 이 조금 작다고 했다. 모의실험으로 가린다.
참 변수 셋만 담은 올바른 모형(\(k = 4\))에 순수한 잡음 변수 하나를 더하는 실험을 \(20{,}000\) 번 반복해, AIC 와 BIC 가 그것을 받아들이는 비율을 재시오. 자료는 이 쪽과 같게 \(n = 200\), \(\boldsymbol\beta = (3, -2, 1.5)\), \(\sigma = 2\) 로 하고 씨앗을 고정하시오. 잰 비율이 \(P(F_{1,195} > \text{임계값})\) 에 맞는지 \(P(\chi^2_1 > 2)\) 에 맞는지 밝히고, 그 차이가 보기 3 의 "잡음 다섯 개 가운데 적어도 하나를 받아들일 확률 \(0.575\)" 를 얼마나 바꾸는지 적으시오.
풀이
받아들이는 조건은 \(\Delta\mathrm{AIC} < 0\), 곧 \(n\log(\mathrm{RSS}_4/\mathrm{RSS}_3) + 2 < 0\) 을 그대로 쓴다(근사를 검증하려는 것이므로 근사를 쓰면 안 된다).
import numpy as np
from scipy import stats

rng = np.random.default_rng(0)
n_sim, reps = 200, 20000
beta3 = np.array([3.0, -2.0, 1.5])
df_den = n_sim - 5                       # 크기 4 모형의 잔차 자유도
thr_aic = df_den * (np.exp(2 / n_sim) - 1)
thr_bic = df_den * (np.exp(np.log(n_sim) / n_sim) - 1)

hit_aic = hit_bic = 0
Fs = np.empty(reps)
for r in range(reps):
    Z = rng.standard_normal((n_sim, 4))          # 앞 셋은 참, 넷째는 잡음
    yr = Z[:, :3] @ beta3 + rng.standard_normal(n_sim) * 2
    X3 = np.column_stack([np.ones(n_sim), Z[:, :3]])
    X4 = np.column_stack([X3, Z[:, 3]])
    r3 = yr - X3 @ np.linalg.lstsq(X3, yr, rcond=None)[0]
    r4 = yr - X4 @ np.linalg.lstsq(X4, yr, rcond=None)[0]
    rss3, rss4 = r3 @ r3, r4 @ r4
    Fs[r] = (rss3 - rss4) / (rss4 / df_den)
    hit_aic += n_sim * np.log(rss4 / rss3) + 2 < 0
    hit_bic += n_sim * np.log(rss4 / rss3) + np.log(n_sim) < 0

print(f"정확한 임계값:  F > {thr_aic:.4f} (AIC),  F > {thr_bic:.4f} (BIC)")
print(f"t 로 고치면:  |t| > {np.sqrt(thr_aic):.4f} (AIC),  |t| > {np.sqrt(thr_bic):.4f} (BIC)")
print(f"모의 채택률:  AIC {hit_aic / reps:.4f},  BIC {hit_bic / reps:.4f}")
print(f"F 분포로:     AIC {stats.f.sf(thr_aic, 1, df_den):.4f},  BIC {stats.f.sf(thr_bic, 1, df_den):.4f}")
print(f"쪽의 근사:    AIC {stats.chi2.sf(2, 1):.4f},  BIC {stats.chi2.sf(np.log(n_sim), 1):.4f}")
print(f"잡음 다섯 중 하나라도:  근사 {1 - (1 - stats.chi2.sf(2, 1)) ** 5:.4f}   "
      f"정확 {1 - (1 - stats.f.sf(thr_aic, 1, df_den)) ** 5:.4f}")
print(f"모의 F 의 평균 {Fs.mean():.4f} (F(1,195) 의 평균 {df_den / (df_den - 2):.4f})")
출력:
정확한 임계값:  F > 1.9598 (AIC),  F > 5.2349 (BIC)
t 로 고치면:  |t| > 1.3999 (AIC),  |t| > 2.2880 (BIC)
모의 채택률:  AIC 0.1646,  BIC 0.0218
F 분포로:     AIC 0.1631,  BIC 0.0232
쪽의 근사:    AIC 0.1573,  BIC 0.0213
잡음 다섯 중 하나라도:  근사 0.5750   정확 0.5895
모의 F 의 평균 1.0095 (F(1,195) 의 평균 1.0104)
모의값은 \(F\) 분포 쪽에 맞는다. AIC 의 채택률이 \(0.1646\) 이고 정확한 값 \(P(F_{1,195} > 1.9598) = 0.1631\) 과의 차이는 \(0.0015\) 다. \(20{,}000\) 번의 표준오차가 \(\sqrt{0.163 \times 0.837 / 20000} = 0.0026\) 이므로 \(0.6\) 표준오차, 곧 맞는다. 근사값 \(0.1573\) 과는 \(0.0073\), 곧 \(2.8\) 표준오차 떨어져 있어 근사가 유의하게 작다. 연습문제 6 에서 자유도 보정이 임계값을 \(2\) 아래로 내린 것과 \(F\) 의 꼬리가 \(\chi^2\) 보다 두꺼운 것이 같은 방향으로 작용한 결과다. BIC 도 모의 \(0.0218\), 정확 \(0.0232\), 근사 \(0.0213\) 으로 모양이 같다.
셈이 제대로 된 것인지 보려면 마지막 줄을 보면 된다. 모의한 부분 \(F\) 의 평균이 \(1.0095\) 이고 \(F_{1,195}\) 의 평균 \(195/193 = 1.0104\) 와 같다. 쓸모없는 변수의 적합 개선은 평균 \(1\) 쯤이고, AIC 는 임계값을 \(2\) 로, BIC 는 \(5.23\) 으로 둔 것이다.
다섯 개 가운데 적어도 하나는 근사로 \(0.5750\), 정확하게는 \(0.5895\) 다. \(1.5\) 포인트 올랐을 뿐이어서 보기 3 의 결론("절반이 넘는다")은 그대로다. 근사가 틀린 방향은 하필 AIC 의 과적합을 과소평가하는 쪽이라는 점만 기억하면 된다. 실제 AIC 는 근사보다 조금 더 헤프다. \(\square\)
연습문제 10. 보기 1 에서 \(\mathrm{AIC} = -2\log\hat L + 2k + n(1 + \log 2\pi)\) 였고, 상수는 모형을 견줄 때 사라졌다. 그러므로 두 모형의 AIC 차이는 벌점을 물린 가능도비(likelihood ratio)의 로그다. 결과표의 두 열을 확률 척도로 옮긴다.
(1) \(\Delta_s\) 를 그 열의 최솟값과의 차라 할 때 \(w_s \propto \exp(-\Delta_s/2)\) 가 왜 자연스러운 척도인지 AIC 쪽은 보기 1 로, BIC 쪽은 연습문제 5 로 근거를 대시오. 그리고 결과표의 여덟 모형에 대해 AIC 가중값과 BIC 사후확률을 계산하시오.
(2) "세 기준이 모두 크기 \(3\) 을 골랐다" 는 결론을 그 수들로 다시 쓰시오. 보기 2 가 \(500\) 번 재어 얻은 "CV 의 최솟값이 크기 \(3\) 에 떨어진 비율 \(43\%\)" 와 AIC 가중값을 나란히 놓으면 무엇이 눈에 띄는가. 이 수들을 그대로 믿으면 안 되는 까닭도 하나 적으시오.
풀이
(1) 두 가지 근거. AIC 쪽은 보기 1 의 유도에서 바로 나온다. 모형 \(M_s\) 와 최적모형의 차는
이므로 \(e^{-\Delta_s/2}\) 는 모수 하나당 \(e^{-1}\) 로 깎은 가능도비다. 보기 1 의 상수 \(n(1+\log 2\pi) = 567.5754\) 는 차에서 지워지므로, AIC 자체에는 뜻이 없어도 이 비는 뜻이 있다. BIC 쪽은 연습문제 5 가 \(\log p(\mathbf y \mid M) \approx -\mathrm{BIC}/2\) 를 주므로 \(e^{-\Delta_s/2}\) 가 주변가능도의 비, 곧 베이즈 인자(Bayes factor)이고, 여덟 모형에 같은 사전확률을 주고 정규화하면 근사 사후확률이 된다.
결과표의 열에 넣으면 \(\Delta^{\mathrm{AIC}} = (202.73,\ 109.48,\ 0,\ 0.61,\ 2.01,\ 3.96,\ 5.93,\ 7.93)\) 이고 \(\Delta^{\mathrm{BIC}} = (196.13,\ 106.19,\ 0,\ 3.91,\ 8.61,\ 13.85,\ 19.13,\ 24.42)\) 이다. 정규화한 값은
| 크기 | 3 | 4 | 5 | 6 | 7 | 8 |
|---|---|---|---|---|---|---|
| AIC 가중값 | 0.4326 | 0.3189 | 0.1583 | 0.0597 | 0.0223 | 0.0082 |
| BIC 사후확률 | 0.8650 | 0.1224 | 0.0117 | 0.0009 | 0.0001 | 0.0000 |
다(크기 \(1\), \(2\) 는 \(10^{-23}\) 보다 작아 셈에 들지 않는다). 검산은 쉽다. 크기 \(3\) 대 크기 \(4\) 의 비가 AIC 에서 \(e^{0.6071/2} = 1.3547\), BIC 에서 \(e^{3.9054/2} = 7.0477\) 이고, 표의 몫 \(0.4326/0.3189 = 1.357\), \(0.8650/0.1224 = 7.07\) 과 같다.
(2) "골랐다" 는 말이 두 기준에서 뜻이 다르다.
BIC 는 크기 \(3\) 에 사후확률 \(0.865\) 를 준다. 나머지 일곱을 다 합쳐도 \(0.135\) 이니 골랐다고 말할 만하다. AIC 는 그렇지 않다. 크기 \(3\) 의 가중값이 \(0.4326\) 으로 절반이 안 되고, 크기 \(4\) 가 \(0.3189\) 로 바로 뒤에 붙어 있다. 둘의 증거비는 \(1.35\) 대 \(1\), 곧 거의 호각이다. 크기 \(3\) 부터 \(5\) 까지 셋을 모으면 \(0.910\) 이 되므로, AIC 가 정직하게 말할 수 있는 것은 "크기 \(3\) 이다" 가 아니라 "크기는 \(3\) 에서 \(5\) 사이다" 다. 쪽 끝의 "최선의 모형 하나를 고집하기보다 여러 기준이 지지하는 후보들을 제시하는 편이 정직하다" 가 이 수다.
나란히 놓고 보면 눈에 띄는 것이 있다. AIC 가중값 \(0.4326\) 과 보기 2 가 \(500\) 번 재어 얻은 \(217/500 = 0.434\) 가 거의 같다. 두 수는 서로 다른 것을 세고 있으므로(앞은 자료가 정해진 뒤의 가중값, 뒤는 분할에 대한 비율) 같아야 할 까닭은 없다. 그래도 가까운 것이 우연만은 아니다. AIC 는 LOOCV 와 점근적으로 같은 양을 추정하며(연습문제 8 의 (3) 이 그 다리다), 그래서 "AIC 가 크기 \(3\) 에 주는 무게" 와 "교차검증이 크기 \(3\) 을 집는 빈도" 가 같은 불확실성을 다른 말로 적은 것이 된다. 어느 쪽으로 세어도 크기 \(3\) 은 유일한 답이 아니라 \(10\) 분의 \(4\) 쯤인 후보다.
믿지 말아야 할 까닭은 이 여덟 모형이 같은 자료로 전진선택해 뽑은 것이라는 데 있다. 가중값 공식은 후보 목록이 자료를 보기 전에 정해졌다고 가정한다. 자료가 이미 승자를 고르는 데 쓰였으므로 이긴 모형의 \(\mathrm{RSS}\) 는 아래로 치우쳐 있고, 따라서 표의 가중값은 크기 \(3\) 쪽으로 낙관적이다. 게다가 여덟 개는 \(2^8 = 256\) 개 부분집합의 일부일 뿐이어서 분모도 온전하지 않다. 수를 절대값으로 읽지 말고 열 사이의 비교로만 읽어야 한다. \(\square\)
정리하며
세 기준을 같은 자료에서 비교했다.
- 설명변수 8개 중 3개만 실제로 관련 있는 자료로 전진선택을 돌리면 세 기준이 모두 크기 \(3\) 을 고른다. 갈리는 것은 자료를 \(1000\) 번 새로 뽑았을 때이고, 상자가 그것을 센다.
- BIC 가 가장 작은 모형을 고른다. 벌점이 무거워 참 모형 크기에 가장 가깝게 간다.
- AIC 는 조금 큰 모형을 고르는 경향이 있다. 예측을 겨냥하므로 약간의 과적합을 감수한다.
- 교차검증은 AIC 쪽에 가깝고 변동이 크다. 상자의 \(1000\) 회에서 고른 크기의 평균이 AIC \(3.84\), 교차검증 \(3.90\), BIC \(3.13\) 으로 둘 사이가 아니라 AIC 보다도 무르다. 겹 나누기에 따라 결과가 달라지므로 여러 번 반복해 평균을 보는 것이 좋다.
- 세 기준이 일치하면 안심할 수 있고 갈리면 그 사실을 보고한다. "최선의 모형" 하나를 고집하기보다 여러 기준이 지지하는 후보들을 제시하는 편이 정직하다.
다음 절 다항 모형선택 교차검증으로 넘어간다.