큰수의 법칙
개요
\(\text{Exp}(1)\) 에서 표본 다섯 개의 평균이 참값에서 \(0.2\) 이상 떨어져 있을 확률은 \(0.6562\) 다. 표본을 쉰 개로 늘려도 그 확률이 \(0.1547\) 이어서, 일곱 번에 한 번은 여전히 띠 밖에 있다. 같은 자리에서 체비쇼프 부등식이 주는 상한은 \(5.000\) 과 \(0.500\) 으로, 작은 \(n\) 에서는 \(1\) 을 넘어 아무 말도 하지 못한다. 「많이 모으면 참값에 가까워진다」는 믿음은 이렇게 느리게, 그리고 서로 세기가 다른 두 가지 뜻으로 성립한다. 그 믿음을 정확히 적으면 무엇이 되고, 여기서 「많이」는 얼마인가.
앞의 네 절에서 도구를 갖추었다. 이제 통계학이 실제로 던지는 물음을 물을 차례다. 관측을 많이 모으면 무슨 일이 벌어지는가?
동전을 100번 던지면 앞면 비율이 0.5에 가까워지리라 기대한다. 여론조사에서 사람을 많이 물을수록 결과가 정확해지리라 믿는다. 이 믿음이 옳은가, 그리고 어떤 의미에서 옳은가를 정확히 말해 주는 것이 큰수의 법칙이다.
이 절은 세 개의 정리로 이루어진다. 왜 표본평균(sample mean)이 참값 주위로 모여드는지(정리 1), 그 수렴을 확률로 말하는 형태(정리 2), 그리고 표본경로 자체가 수렴한다는 더 강한 형태(정리 3)이다.
1. 표본을 늘리면 산포가 줄어든다
큰수의 법칙의 뿌리는 이미 3.4절 분산과 공분산에 있다. 표본평균의 분산이 \(n\)에 반비례한다는 사실이다.
정리 1. 표본평균의 분산 — 표본이 커지면 산포가 0으로 간다
평균 \(\mu\), 분산 \(\sigma^2\)인 i.i.d. 확률변수 \(X_1, \ldots, X_n\)에 대해
이다. 따라서 \(n \to \infty\)일 때 \(\text{Var}(\bar X) \to 0\)이다.
증명
앞 절의 결과를 그대로 쓴 것이다. 기댓값은 선형성(3.4절 기댓값과 선형성 정리 2)에서, 분산은 독립이면 합의 분산이 분산의 합이라는 성질(3.4절 분산과 공분산 정리 3)에서 나온다.
여기에 체비쇼프 부등식을 적용하면 큰수의 법칙이 거의 곧바로 나온다.
\(\square\)
중심은 그대로이고 산포만 줄어든다. 이것이 큰수의 법칙의 전부이며, 나머지는 "수렴"의 뜻을 얼마나 강하게 요구하느냐의 문제다.
2. 벗어날 확률이 0으로 간다
수렴을 말하는 첫 번째 방식은 각 \(n\)에서 "크게 벗어날 확률"을 재는 것이다.
정리 2. 약한 큰수의 법칙 — 확률수렴
평균 \(\mu\)가 유한한 i.i.d. 확률변수 \(X_1, X_2, \ldots\)에 대해 표본평균은 \(\mu\)로 확률수렴한다.
즉 고정된 임의의 \(\varepsilon > 0\)에 대해
이다.
증명 (분산이 유한한 경우)
분산 \(\sigma^2 < \infty\) 를 덧붙이면 체비쇼프 부등식 한 줄로 끝난다. 정리 1 에서 \(\bar X\) 의 평균이 \(\mu\), 분산이 \(\sigma^2/n\) 이므로 임의로 고정한 \(\varepsilon > 0\) 에 대해
다. \(\varepsilon\) 이 고정이고 \(\sigma^2\) 가 유한하므로 오른쪽은 \(n \to \infty\) 에서 0 으로 간다. 왼쪽이 음이 아니므로 함께 0 으로 간다. \(\square\)
정리 1 이 곧 증명이다. 산포가 0 으로 간다는 것과 벗어날 확률이 0 으로 간다는 것을 잇는 다리가 체비쇼프 부등식이고, 그 다리가 \(1/\varepsilon^2\) 이라는 값을 받는다. \(\varepsilon\) 을 작게 잡으면 상한이 커지지만, \(n\) 을 키우는 쪽이 언제나 이긴다.
분산이 무한해도(평균만 유한하면) 정리가 성립한다는 것은 이 증명으로는 나오지 않는다. 체비쇼프 부등식이 분산을 요구하기 때문이다. 일반적인 경우는 특성함수(characteristic function) \(E[e^{itX}]\) 나 절단 논법 — 큰 값을 잘라 내어 분산이 유한한 몫과 드물게 나오는 나머지로 나누어 다루는 방법 — 이 필요하다.
읽는 법이 중요하다. "\(n\)을 충분히 크게 잡으면 표본평균이 \(\mu\)에서 \(\varepsilon\) 이상 벗어날 확률을 원하는 만큼 작게 만들 수 있다"는 뜻이다. 확률이 작아진다는 것이지 0이 된다는 것은 아니다.
정리 1에서 분산을 가정했지만, 실제로는 평균만 유한하면 약한 큰수의 법칙이 성립한다(분산이 무한해도 된다). 증명은 더 정교한 도구가 필요하다.
그림으로 보는 통계학 1. 금 같은 정리
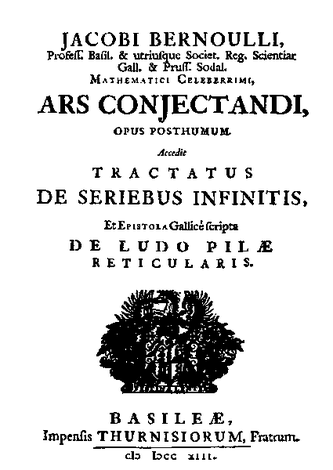
야코프 베르누이 『추측술』 표제지, 바젤 \(1713\). 제목 바로 아래 OPUS POSTHUMUM(유고)이라 적혀 있다. (Wikimedia Commons, PD-old-100)
정리 2 는 「표본을 늘리면 상대도수가 참값에 몰린다」고 말한다. 누구나 그렇게 느끼지만 느낌과 증명은 다른 것이고, 이것을 처음 증명한 사람이 야코프 베르누이(\(1655\)–\(1705\))다.
그는 이 정리를 스스로 「금 같은 정리」라 불렀고 이십 년 가까이 매달렸다. 그러고도 끝내 발표하지 못한 채 죽었다. 사진의 『추측술』은 그가 죽고 여덟 해가 지난 \(1713\) 년에 조카가 원고를 모아 펴낸 것이고, 「큰 수의 법칙」이라는 이름은 한참 뒤에 푸아송이 붙였다.
무엇이 그를 붙들어 두었을까. 그가 매달린 물음은 정리 2 를 실제로 쓸 때 언제나 따라오는 것과 똑같다 — 몇 번을 해 보아야 믿어도 되는가. 그는 「도덕적 확실성」이라는 기준을 세웠다. 틀릴 확률이 천분의 일 아래로 내려가면 그쯤은 확실하다고 치자는 것이다.
그러고는 계산했다. 참값이 \(\dfrac35\) 인 일에서 관측한 비율이 참값과 \(\dfrac1{50}\) 안에 들어오려면 몇 번이 필요한가. 답은 \(2\) 만 \(5000\) 번이 넘었다. 그때 바젤 인구보다 많은 수였다. 그는 이 수를 좀처럼 받아들이지 못했고, 그것이 원고를 묶지 못하고 머뭇거린 까닭의 하나로 꼽힌다.
지금 보면 그 머뭇거림이 오히려 정직하다. 정리 2 의 증명이 주는 상한은 그보다도 훨씬 헐겁다. 베르누이의 설정을 그대로 넣으면 \(\sigma^2=0.6\times0.4=0.24\), \(\varepsilon=\frac1{50}\) 이므로 상한이 \(\dfrac{\sigma^2}{n\varepsilon^2}=\dfrac{600}{n}\) 이고, \(n=100\) 에서는 \(6\) — 확률이 \(1\) 을 넘으니 아무 말도 하지 못한다. 천분의 일 아래로 내리려면 \(n\) 이 \(60\) 만을 넘어야 한다. 베르누이가 \(2\) 만 \(5000\) 으로 끝낼 수 있었던 것은 체비쇼프 부등식이 아니라 이항분포(binomial distribution)의 꼬리를 직접 셈했기 때문이다(그 부등식은 백오십 해 뒤에 나온다).
「많이 하면 된다」와 「몇 번이면 되는가」는 전혀 다른 물음이고, 뒤쪽 물음에 제대로 답하려면 중심극한정리까지 가야 한다.
확인한 곳 — Britannica 「Jakob Bernoulli」 · Seneta 「A Tricentenary history of the Law of Large Numbers」 · Wikipedia 「Ars Conjectandi」 · 상한 \(600/n\) 과 \(n>60\) 만은 이 쪽에서 직접 셈해 보았다
그림으로 보는 통계학 2. 부등식 하나로 밀어붙인 사람
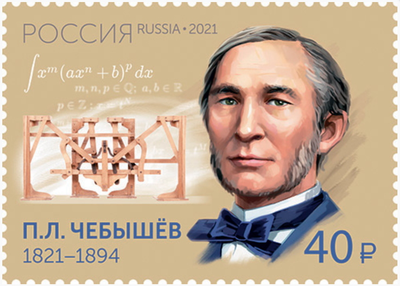
러시아 \(2021\) 년, 액면 \(40\) 루블. 탄생 \(200\) 주년 기념. (Wikimedia Commons, PD)
정리 2 의 증명은 체비쇼프 부등식 한 줄에 기대고 있다. 분포의 모양을 하나도 모르는 채로, 평균과 분산만 가지고 「평균에서 멀리 떨어질 확률」을 위에서 눌러 버리는 부등식이다. 그 덕에 「표본을 늘리면 표본평균이 모평균에 몰린다」는 경험이 증명이 된다.
그런데 \(2021\) 년 러시아가 그의 탄생 \(200\) 주년에 찍은 이 우표에는 부등식이 없다. 대신 두 가지가 실려 있다.
하나는 적분 공식이다.
이 적분이 초등함수로 적히는 경우가 정확히 언제인가를 밝힌 것이 그의 정리다. 아무리 애써도 안 되는 경우가 있다는 것을 못 박았다는 점에서 아벨의 일과 닮았다.
다른 하나는 왼쪽의 기계다. 그는 회전운동을 거의 직선운동으로 바꾸는 연결장치를 설계했고, 그것으로 걷는 기계를 만들었다. 부등식을 세운 손과 기계를 깎은 손이 같은 사람의 것이다.
우표를 만든 쪽은 이 사람을 「확률의 사람」으로만 두지 않았다. 한 사람이 한 가지만 하지는 않는다는 것을, 도안 하나로 말한 셈이다.
확인한 곳 — 러시아 우정 카탈로그 「200th Birth Anniversary of P. Chebyshev」 · Encyclopedia of Mathematics 「Chebyshev theorem on the integration of binomial differentials」 · Mathematical Etudes 「Plantigrade machine」 — 우표 왼쪽의 기계가 그 걷는 기계다
정리 2가 말하는 것은 경로가 아니라 분포임을 새겨 두자. 각 \(n\)마다 "크기 \(n\)인 표본을 새로 뽑는 일"을 수없이 반복했을 때 \(\bar X_n\)이 어떻게 흩어지는가, 그리고 그 산포에서 \(\mu \pm \varepsilon\) 밖에 떨어지는 몫이 얼마나 되는가를 말한다. 그러므로 확인하려면 표본을 여러 번 뽑아 \(\bar X_n\)의 분포를 보아야 한다.
보기 1. 확률이 0으로 가는 모습. \(\text{Exp}(1)\)에서 크기 \(n\)인 표본을 1만 번씩 뽑아 \(\bar X_n\)의 분포를 열 개의 \(n\)에 대해 그린다. \(\varepsilon = 0.2\sigma = 0.2\)로 둔다.
(1) 정리 2가 "0으로 간다"고 말하는 확률 \(P(|\bar X_n - \mu| > \varepsilon)\)의 정확한 값을 적으시오. 정리 1의 증명에 나온 체비쇼프 상한과도 견주시오.
(2) 모의실험이 (1)을 재현하는지 확인하시오.
풀이
(1) 정확한 값이 있다. \(\text{Exp}(1)\)은 \(\mu = \sigma = 1\)이고, 독립인 지수확률변수 \(n\)개의 합은 \(\text{Gamma}(n, 1)\)을 따른다. 따라서 \(n\bar X_n \sim \text{Gamma}(n,1)\)이고 벗어날 확률이 닫힌 꼴로 적힌다.
견줄 수 둘도 함께 적어 둔다. 정리 1의 증명에 나온 체비쇼프 상한은
이고, 중심극한정리(central limit theorem)를 미리 써서 정규근사를 하면 \(2\big(1 - \Phi(0.2\sqrt n)\big)\)이다. 세 수가 \(n = 5\)와 \(n = 50\)에서 이렇게 갈린다.
| \(n\) | 정확(감마) | 정규근사 | 체비쇼프 상한 |
|---|---|---|---|
| 5 | 0.6562 | 0.6547 | 5.000 |
| 50 | 0.1547 | 0.1573 | 0.500 |
체비쇼프 상한은 \(n = 25\)까지 \(1\) 이상이어서 아무것도 말해 주지 않고, \(n = 50\)에서도 참값의 \(3.2\)배다. 평균과 분산만 쓰고 분포를 보지 않은 대가다. 반면 정규근사는 \(n = 5\)에서도 소수 둘째 자리까지 맞는다.
(2) 모의실험.
import numpy as np
import matplotlib.pyplot as plt

plt.rcParams["font.sans-serif"] = ["NanumGothic", "Apple SD Gothic Neo", "Malgun Gothic"]
plt.rcParams["font.family"] = "sans-serif"
plt.rcParams["axes.unicode_minus"] = False

N_LIST = [5, 10, 15, 20, 25, 30, 35, 40, 45, 50]
M = 10_000                    # 반복 횟수
EPS = 0.2                     # ε (σ 단위)

rng = np.random.default_rng(2026)
mu, sigma = 1.0, 1.0          # Exponential(1) 의 평균과 표준편차
eps = EPS * sigma

# 가장 큰 n 으로 한 번만 뽑고 앞쪽 n 개 열을 각 칸에 쓴다.
# 표본이 중첩되므로 칸끼리 다른 것은 오직 n 뿐이다.
X = rng.exponential(1.0, (M, max(N_LIST)))

lo, hi = np.percentile(X[:, :min(N_LIST)].mean(axis=1), [0.5, 99.5])
pad = 0.1 * (hi - lo)
bins = np.linspace(lo - pad, hi + pad, 60)

probs = []
fig, axes = plt.subplots(1, 10, figsize=(22, 4), constrained_layout=True)
for ax, n in zip(axes, N_LIST):
    xbar = X[:, :n].mean(axis=1)          # 크기 n 인 표본 M 개의 평균
    ax.hist(xbar, bins=bins, density=True, color="tab:blue", alpha=0.6,
            edgecolor="white", linewidth=0.3)
    ax.axvline(mu, color="red", lw=2, label=r"$\mu$")
    ax.axvspan(mu - eps, mu + eps, color="orange", alpha=0.18,
               label=r"$\mu\pm\varepsilon$")

    # 정리 2가 "0으로 간다"고 말하는 바로 그 확률을 세어 본다.
    p_out = np.mean(np.abs(xbar - mu) > eps)
    probs.append(p_out)
    ax.set_title(f"n = {n}\n"
                 rf"$\hat P(|\bar X_n-\mu|>\varepsilon)$ = {p_out:.3f}",
                 fontsize=11)
    ax.set_xlim(bins[0], bins[-1])
    ax.set_xlabel(r"$\bar X_n$")
axes[0].set_ylabel("density of $\\bar X_n$")
axes[0].legend(fontsize=9, loc="upper right")
plt.show()

# 정리 2가 0으로 간다고 말하는 그 확률만 따로 모아 본다.
for i in range(5):
    print(f"n = {N_LIST[i]:>2} : {probs[i]:.3f}      "
          f"n = {N_LIST[i + 5]:>2} : {probs[i + 5]:.3f}")
출력:
n =  5 : 0.661      n = 30 : 0.269
n = 10 : 0.522      n = 35 : 0.229
n = 15 : 0.434      n = 40 : 0.198
n = 20 : 0.370      n = 45 : 0.169
n = 25 : 0.312      n = 50 : 0.147
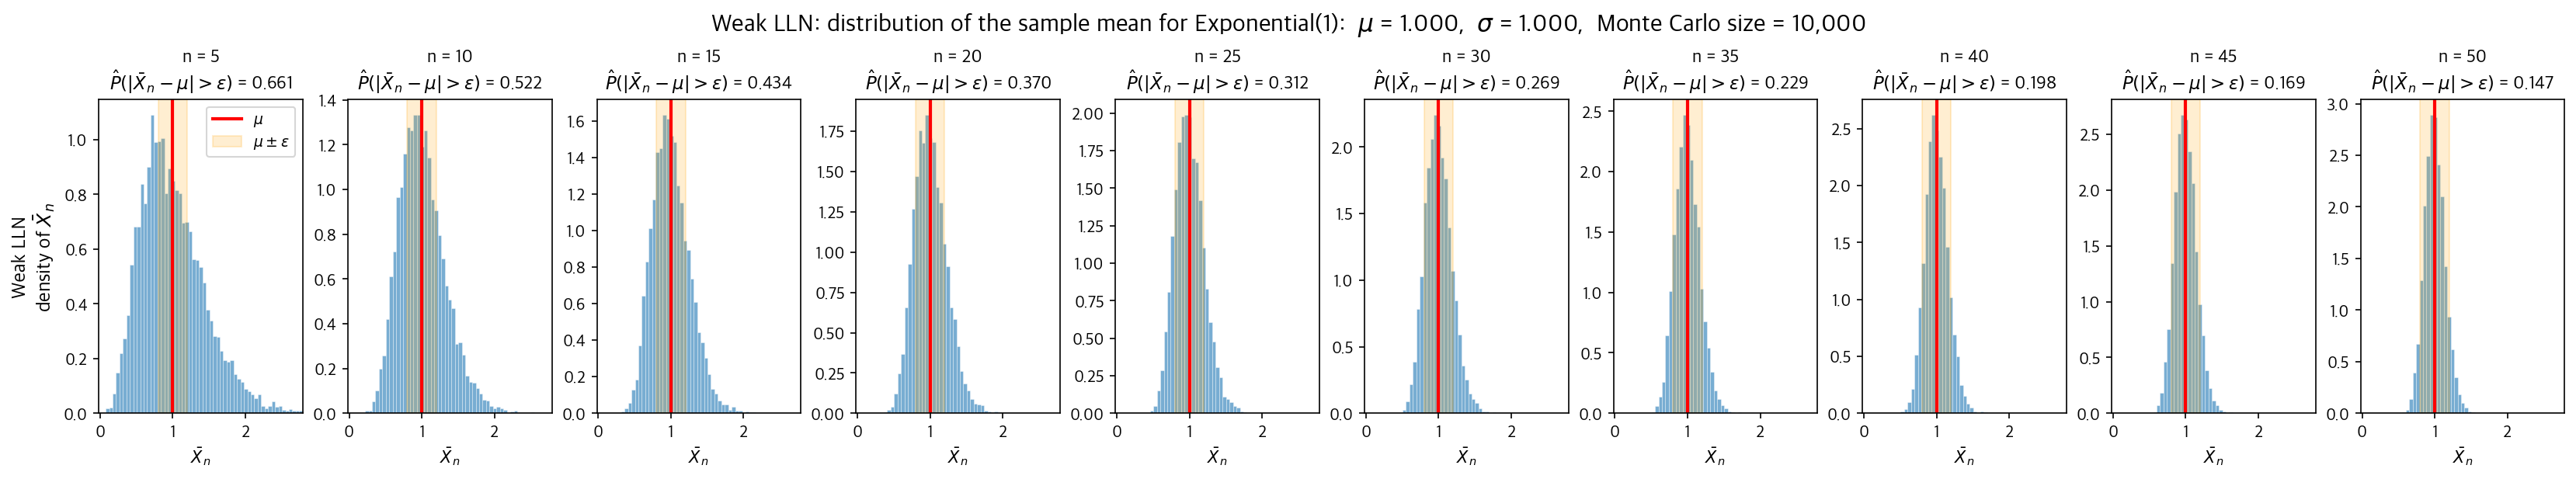
칸마다 파란 히스토그램이 좁아지고, 주황 띠(\(\mu \pm \varepsilon\)) 밖으로 나가는 몫이 \(0.661\)에서 \(0.147\)로 줄어든다. 이 수열이 0으로 간다는 것이 정리 2의 전부다.
(1)의 세 수와 나란히 놓아 본다. 위 코드의 probs를 그대로 이어받는다.
from scipy import stats

print(" n   정확(감마)  정규근사  체비쇼프   모의     차이/se")
for n, p in zip(N_LIST, probs):
    exact = (stats.gamma.cdf((mu - eps) * n, n)
             + stats.gamma.sf((mu + eps) * n, n))
    se = np.sqrt(exact * (1 - exact) / M)      # 모의값의 몬테카를로 오차
    print(f"{n:3d}    {exact:.4f}     {2 * stats.norm.sf(eps * np.sqrt(n)):.4f}"
          f"   {sigma**2 / (n * eps**2):7.3f}   {p:.3f}   {(p - exact) / se:+5.2f}")
출력:
 n   정확(감마)  정규근사  체비쇼프   모의     차이/se
  5    0.6562     0.6547     5.000   0.661   +1.03
 10    0.5258     0.5271     2.500   0.522   -0.77
 15    0.4361     0.4386     1.667   0.434   -0.45
 20    0.3680     0.3711     1.250   0.370   +0.41
 25    0.3140     0.3173     1.000   0.312   -0.39
 30    0.2700     0.2733     0.833   0.269   -0.18
 35    0.2335     0.2367     0.714   0.229   -1.19
 40    0.2029     0.2059     0.625   0.198   -1.11
 45    0.1769     0.1797     0.556   0.169   -2.10
 50    0.1547     0.1573     0.500   0.147   -2.17
열 칸 모두 맞는다. 모의값이 정확값에서 최대 \(2.2\) 표준오차 떨어져 있다. 다만 마지막 두 줄이 한쪽으로 쏠린 것은 우연이 아니다. 이 모의실험은 1만 × 50 행렬 하나를 뽑아 앞쪽 \(n\)개 열만 잘라 쓰므로 열 칸이 같은 난수를 공유하고, 그래서 오차들이 서로 독립이 아니라 강하게 상관되어 있다. 한 칸이 아래로 쏠리면 옆 칸도 따라 쏠린다. 칸마다 표본을 새로 뽑으면 이 쏠림이 사라진다.
두 가지를 짚어 두자. 첫째, \(n = 50\)에서도 그 확률이 \(0.147\)이다. 여전히 일곱 번에 한 번꼴로 \(\varepsilon\) 밖에 떨어진다. 정리는 극한을 말할 뿐 "충분히 큰 \(n\)"이 얼마인지는 말해 주지 않으며, \(\varepsilon\)을 좁게 잡을수록 그 \(n\)은 커진다. 둘째, 줄어드는 속도가 느리다. \(n\)을 10배로 키우는 동안 확률은 4.5배밖에 줄지 않았는데, 이는 \(\bar X_n\)의 산포가 \(1/\sqrt n\)로만 줄기 때문이다.
둘째 관찰은 이 절을 넘어간다. 히스토그램이 오그라드는 속도가 \(1/\sqrt n\)으로 정해져 있다면, 척도를 그 속도에 맞추어 \(\sqrt n\)배씩 당겨 가며 보면 어떻게 될까. 오그라드는 것과 당기는 것이 정확히 상쇄되어 무엇인가가 남는다. 그 남는 것이 중심극한정리의 정규분포이며, 그 쪽에서 이 히스토그램에 척도 두 벌을 달아 확인한다. 두 정리는 별개의 사실이 아니라 같은 그림을 다른 자로 읽은 것이다.
도박사의 오류: 큰수의 법칙은 균형을 맞춰 주지 않는다
동전을 100번 던져 앞면이 40번뿐이었다면, 앞으로 앞면이 더 자주 나와 균형을 맞출까?
아니다. 동전에는 기억이 없다. 이후의 던지기는 여전히 50 대 50이다.
그러면 어떻게 비율이 0.5로 수렴하는가? 차이가 메워지는 것이 아니라 희석되는 것이다. 앞면 개수가 기댓값에서 벗어난 양 \(|S_n - n/2|\)는 오히려 \(\sqrt n\)의 속도로 커진다. 다만 그 차이를 \(n\)으로 나눈 비율이 0으로 갈 뿐이다.
부족한 10번은 영영 메워지지 않는다. 10,000번을 더 던지면 그 10번이 전체에서 차지하는 몫이 무시할 만해질 뿐이다. 이 절 뒤의 도박사의 역설 페이지에서 이 구조를 더 파고든다.
3. 표본경로 자체가 수렴한다
약한 법칙은 각 \(n\)마다 확률을 재는 진술이다. 더 강하게 말할 수도 있다. 하나의 실험을 무한히 이어 갈 때 그 수열 자체가 수렴하는가?
정리 3. 강한 큰수의 법칙 — 거의 확실한 수렴
정리 2 와 같은 조건(평균 \(\mu\)가 유한한 i.i.d. 확률변수 \(X_1, X_2, \ldots\))에서 표본평균은 \(\mu\)로 거의 확실하게 수렴한다.
즉
이다.
증명 개요
평균만 유한하다는 조건에서의 완전한 증명(콜모고로프)은 이 책의 범위를 넘는다. 그러나 4차 적률이 유한하다는 조건을 덧붙이면 세 걸음으로 볼 수 있고, 그 세 걸음이 강한 법칙의 뼈대다.
1. 벗어날 확률을 더할 수 있을 만큼 작게 만든다. 체비쇼프 대신 4차 적률에 마르코프 부등식을 쓰면 상한이 \(1/n\) 이 아니라 \(1/n^2\) 이 된다. \(\mu = 0\) 으로 두어도 일반성을 잃지 않으므로
다. \(E[\bar X_n^4]\) 를 전개하면 독립성(independence) 때문에 살아남는 항이 \(n\) 개의 \(E[X_i^4]\) 와 \(\binom n2\) 개의 \(E[X_i^2]E[X_j^2]\) 뿐이고, \(n^4\) 으로 나누므로 \(O(n^{-2})\) 이 된다.
2. 급수가 수렴하므로 보렐–칸텔리를 쓸 수 있다. \(\sum_n n^{-2} < \infty\) 이므로 보렐–칸텔리 보조정리(3.1절 확률의 공리 연습문제 9)에 의해 사건 \(\{|\bar X_n| > \varepsilon\}\) 이 무한히 자주 일어날 확률이 0 이다. 곧 확률 1 로 어느 시점 이후에는 영영 \(\varepsilon\) 안에 머문다.
3. \(\varepsilon\) 을 가산 개만 보면 된다. \(\varepsilon = 1/k\) 로 두고 \(k = 1, 2, \ldots\) 에 대해 2 를 적용한 뒤, 예외집합 가산 개의 합집합이 다시 확률 0 이라는 것(가산가법성)을 쓰면 모든 \(\varepsilon\) 에 대해 동시에 성립한다. 이것이 수렴의 정의다. \(\square\)
약한 법칙과 강한 법칙을 가르는 것이 2 번 걸음이다. 약한 법칙은 각 \(n\) 에서의 확률만 보므로 상한이 \(1/n\) 이어도 충분하지만, "어느 시점 이후 영영"을 말하려면 그 확률들을 더할 수 있어야 한다. \(\sum 1/n\) 은 발산하고 \(\sum 1/n^2\) 은 수렴한다. 그리고 3 번 걸음에서 보듯 가산가법성 공리가 없으면 결론을 모을 수 없다.
두 법칙의 차이. 약한 법칙은 "각 \(n\)에서 벗어나 있을 확률이 작다"고 말한다. 표본경로가 이따금 크게 벗어났다가 돌아오기를 무한히 반복해도 약한 법칙과 모순되지 않는다.
강한 법칙은 그런 일이 (확률 1로) 일어나지 않는다고 말한다. 실험을 한 번 시작해 무한히 이어 가면, 그 하나의 수열이 수학적 의미에서 \(\mu\)로 수렴한다. 어느 시점 이후로는 영영 \(\varepsilon\) 안에 머문다.
"거의 확실하게"라는 단서는 3.1절에서 본 그것이다. 수렴하지 않는 표본경로가 존재할 수는 있지만(예: 언제나 앞면만 나오는 경로) 그 집합의 확률이 0이다. 확률 0은 불가능이 아니다.
강한 법칙이 가산가법성 공리(3.1절 확률의 공리 정리 2)를 필요로 하는 이유도 여기 있다. "수렴한다"는 사건은 가산 개의 사건으로 표현되며, 유한 가법성만으로는 그 확률을 다룰 수 없다.
그림으로 보는 통계학 3. 바늘로 잰 원주율
파리 식물원의 뷔퐁 상. 받침돌에 BUFFON 이 새겨져 있다. 그가 사십 년 넘게 맡아 가꾼 정원이다. (Wikimedia Commons, 촬영 Celette, \(2012\), CC BY-SA 4.0)
원이 하나도 없는데 \(\pi\) 가 나오는 물음이 있다. 나란한 선을 간격 \(d\) 로 긋고 길이 \(L\ (L \le d)\) 인 바늘을 아무렇게나 떨어뜨리면, 바늘이 선에 걸칠 확률이
이다. 평행선 몇 줄과 바늘 하나뿐인데 만날 확률 안에 \(\pi\) 가 들어앉아 있다.
이 물음을 낸 뷔퐁(\(1707\)–\(1788\))은 수학자가 아니라 박물학자였다. 사진의 상이 서 있는 파리 식물원을 사십 년 넘게 맡아 가꾸었고, 평생을 들인 일은 수십 권짜리 『자연사』였다. 바늘 문제는 \(1777\) 년에 펴낸 짧은 글 한 편에 들어 있는데, 그는 그것으로 \(\pi\) 를 재려 한 것이 아니라 내기의 승산을 따지는 물음으로 꺼냈다. \(\pi\) 가 나온 것은 덤이었다.
그 덤을 거꾸로 쓰면 \(\pi\) 를 근사할 수 있다. 바늘을 많이 던져 걸친 비율 \(\hat p\) 만 세고 \(\hat\pi=2L/(\hat p\,d)\) 로 되돌리면 된다. 정리 3 이 보장하는 것이 바로 이것이다 — 한 번 시작한 던지기를 끝없이 이어 가면 그 하나의 수열이 참값으로 수렴한다. 솔깃한 이야기라 사람들이 실제로 던져 보았다.
\(1901\) 년 이탈리아의 라차리니가 바늘을 \(3408\) 번 던져 \(\dfrac{355}{113}=3.1415929\) 를 얻었다고 발표했다. 소수점 아래 여섯 자리까지 맞는 값이다. 너무 잘 맞아서 문제가 된다.
정리 1 로 재어 보면 안다. 근사값의 오차는 던진 횟수의 제곱근에 반비례해서만 줄어들므로, \(3408\) 번이면 오차가 보통 \(\pm0.04\) 쯤이다. 그런데 라차리니가 말한 오차는 \(0.0000003\) 이니 십오만 배나 좋다. 그만한 정확도가 예사가 되려면 던지기를 \(80\) 조 번쯤 해야 한다. 지금은 그가 원하는 값이 나올 때까지 던지다 멈춘 것으로 본다.
그러니 바늘 던지기는 \(\pi\) 를 구하는 방법이 아니다. 거꾸로다 — 이미 아는 \(\pi\) 를 가지고 확률이 정말 그렇게 움직이는지 눈으로 보는 장치다. 아래 보기 2 에서 주사위를 만 번 굴려 누적평균을 따라가 보는 것도 꼭 같은 뜻이다.
확인한 곳 — Wikipedia 「Buffon's needle problem」 · IMUS 「Lazzarini and Buffon's needle」 — 던진 횟수와 정확도의 불일치는 이 쪽에서 직접 계산해 보았다
그림으로 보는 통계학 4. 카드 점을 치다 나온 계산법
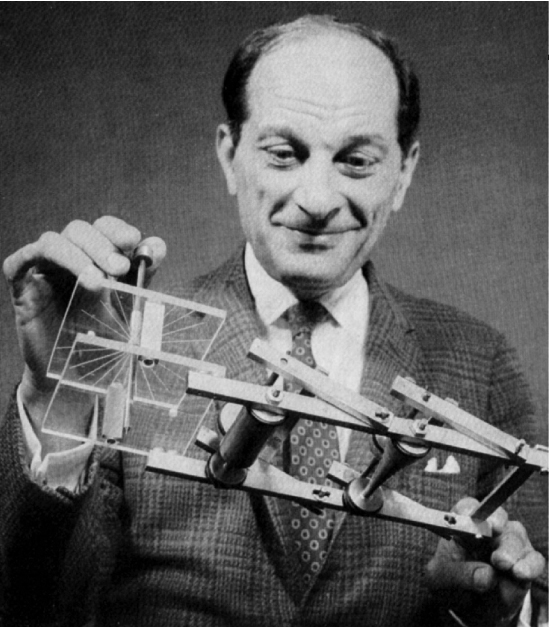
스타니스와프 울람이 페르미악을 들고 있다. 길이 \(30\) 센티미터 남짓한 황동·아크릴 장치로, 전자계산은 하나도 하지 않고 사람이 손으로 밀면 중성자가 지나간 자리를 그려 냈다. (로스앨러모스 국립연구소, Wikimedia Commons, PD-USGov)
정리 3 이 「한 번 돌린 모의실험 하나가 참값으로 수렴한다」고 보장하고, 정리 1 이 \(\operatorname{sd}(\bar X)=\sigma/\sqrt n\) 으로 그 속도를 적어 준다. 이 둘이 오늘날 몬테카를로(Monte Carlo) 방법이라 불리는 계산법의 심장이다. 그리고 그 방법은 카드 점에서 나왔다.
\(1946\) 년, 스타니스와프 울람은 병을 앓고 회복하는 동안 캔필드 솔리테어를 늘어놓고 있었다. 문득 든 생각이 이것이었다 — 「카드 \(52\) 장으로 늘어놓은 이 패가 끝까지 풀릴 확률은 얼마인가.」 조합론으로 따져 보려다 한참 만에 포기하고, 그는 「백 번쯤 직접 늘어놓아 몇 번 풀리는지 세어 보는 편이 낫지 않을까」 하고 적었다. 아래 보기 2 에서 주사위를 만 번 굴려 보는 일과 꼭 같은 생각이다.
이름은 메트로폴리스가 붙였다. 울람의 삼촌이 몬테카를로에서 노름을 하려고 친척들에게 돈을 빌리곤 했다는 데서 따온 것이다. \(1948\) 년 봄에는 폰 노이만과 메트로폴리스가 ENIAC 으로 첫 완전 자동 몬테카를로 계산을 돌렸다. 사진의 장치는 그 사이에 놓인 물건으로, 페르미가 고안하고 L. D. P. King 이 만든 페르미악이다.
앞 상자의 바늘 던지기가 이 방법의 조상이고, 달라진 것은 바늘을 손으로 던지지 않아도 된다는 것뿐이다. 다만 정리 1 이 한계도 함께 말해 준다 — 산포가 \(\sqrt n\) 으로만 줄므로, 자릿수 하나를 더 얻으려면 \(100\) 배를 굴려야 한다.
확인한 곳 — Wikipedia 「Monte Carlo method」 — \(1946\) 년 병중에 캔필드 솔리테어를 하다 떠올렸다는 울람 자신의 회고(「\(52\) 장으로 늘어놓은 캔필드 솔리테어가 성공할 확률은 얼마인가… 순전한 조합 계산으로 가늠해 보려 오래 애쓴 끝에, 백 번쯤 늘어놓아 보는 편이 더 실제적이지 않을까 생각했다」), 삼촌이 몬테카를로에서 노름하려 친척에게 돈을 빌렸다는 이름의 유래, \(1948\) 년 봄 폰 노이만·메트로폴리스의 ENIAC 첫 자동 계산, \(1930\) 년대에 페르미가 중성자 확산에서 먼저 써 보고 발표하지 않았다는 것이 모두 여기 있다 · 장치는 Wikipedia 「FERMIAC」 — \(30\) 센티미터 남짓, 황동과 아크릴, L. D. P. King 제작, 전자계산 없이 손으로 민다
보기 2. 표본경로 하나를 끝까지 따라가면. 공정한 주사위를 1만 번 굴려 매 시점의 누적평균 \(\bar X_n\)을 기록한다.
(1) 참 기댓값과 \(\operatorname{sd}(\bar X_n)\)의 이론값을 \(n = 10, 10^2, 10^3, 10^4\)에서 적으시오.
(2) 경로를 그려 (1)을 확인하시오. 누적평균이 \(3.5\)로 모여드는 동안 누적합의 편차 \(S_n - 3.5n\)은 어떻게 되는가.
풀이
(1) 이론값. 주사위 한 번의 평균과 분산은 손으로 계산된다.
이므로 \(\sigma = \sqrt{35/12} = 1.70783\)이다. 정리 1에 따라 \(\operatorname{sd}(\bar X_n) = \sigma/\sqrt n\)이다.
| \(n\) | 10 | \(10^2\) | \(10^3\) | \(10^4\) |
|---|---|---|---|---|
| \(\operatorname{sd}(\bar X_n)\) | 0.5401 | 0.1708 | 0.0540 | 0.0171 |
(2) 모의실험. 강한 법칙이 말하는 대상은 경로 하나이므로, 확인하는 방법도 보기 1과 다르다. 표본을 여러 번 뽑는 것이 아니라 실험 하나를 길게 이어 가며 그 수열이 어디로 가는지 본다.
import numpy as np
import matplotlib.pyplot as plt

plt.rcParams["font.sans-serif"] = ["NanumGothic", "Apple SD Gothic Neo", "Malgun Gothic"]
plt.rcParams["font.family"] = "sans-serif"
plt.rcParams["axes.unicode_minus"] = False

np.random.seed(42)

# 주사위를 1만 번 굴리고 "여태까지의 평균"을 매 시점 기록한다.
n_rolls = 10_000
rolls = np.random.randint(1, 7, size=n_rolls)

# cumsum(누적합)을 1, 2, 3, ... 로 나누면 각 시점까지의 평균이 된다.
# running_avg[k] = 처음 k+1번의 평균
# 반복문 없이 한 줄로 1만 개의 평균을 얻는 요령이다.
running_avg = np.cumsum(rolls) / np.arange(1, n_rolls + 1)

fig, ax = plt.subplots(figsize=(12, 4))
ax.plot(running_avg, alpha=0.8, label='Running Average')
# 참 기댓값 (1+2+3+4+5+6)/6 = 3.5. 큰수의 법칙은 곡선이 이 선에 붙는다고 말한다.
ax.axhline(y=3.5, color='r', linestyle='--', label='E[X] = 3.5')
ax.set_xlabel('Number of Rolls')
ax.set_ylabel('Sample Mean')
ax.set_title('Law of Large Numbers: Fair Die')
ax.legend()
ax.spines[['top', 'right']].set_visible(False)
plt.show()

# 그림에서 눈으로 재던 것을 수로 적는다.
sigma = np.sqrt(35 / 12)
for k in (10, 100, 1_000, 10_000):
    dev = running_avg[k - 1] - 3.5
    print(f"n = {k:>6,}: 누적평균 {running_avg[k-1]:.4f}  편차 {dev:+.4f}"
          f"  이론 sd {sigma / np.sqrt(k):.4f}  편차/sd {dev / (sigma / np.sqrt(k)):+.2f}")

# 누적합 쪽은 어떻게 되는가. S_n - 3.5n 은 줄지 않는다.
dev_sum = np.cumsum(rolls) - 3.5 * np.arange(1, n_rolls + 1)
k = int(np.abs(dev_sum).argmax())
print(f"|S_n - 3.5n| 의 최댓값 = {abs(dev_sum[k]):.0f}  (n = {k+1:,}),"
      f"  sigma*sqrt(n) = {sigma * np.sqrt(k + 1):.0f}")
out = np.where(np.abs(running_avg - 3.5) > 0.05)[0]
print(f"3.5 +- 0.05 띠를 마지막으로 벗어난 때 n = {out[-1] + 1:,}")
출력:
n =     10: 누적평균 3.8000  편차 +0.3000  이론 sd 0.5401  편차/sd +0.56
n =    100: 누적평균 3.6900  편차 +0.1900  이론 sd 0.1708  편차/sd +1.11
n =  1,000: 누적평균 3.4570  편차 -0.0430  이론 sd 0.0540  편차/sd -0.80
n = 10,000: 누적평균 3.4999  편차 -0.0001  이론 sd 0.0171  편차/sd -0.01
|S_n - 3.5n| 의 최댓값 = 134  (n = 6,730),  sigma*sqrt(n) = 140
3.5 +- 0.05 띠를 마지막으로 벗어난 때 n = 663
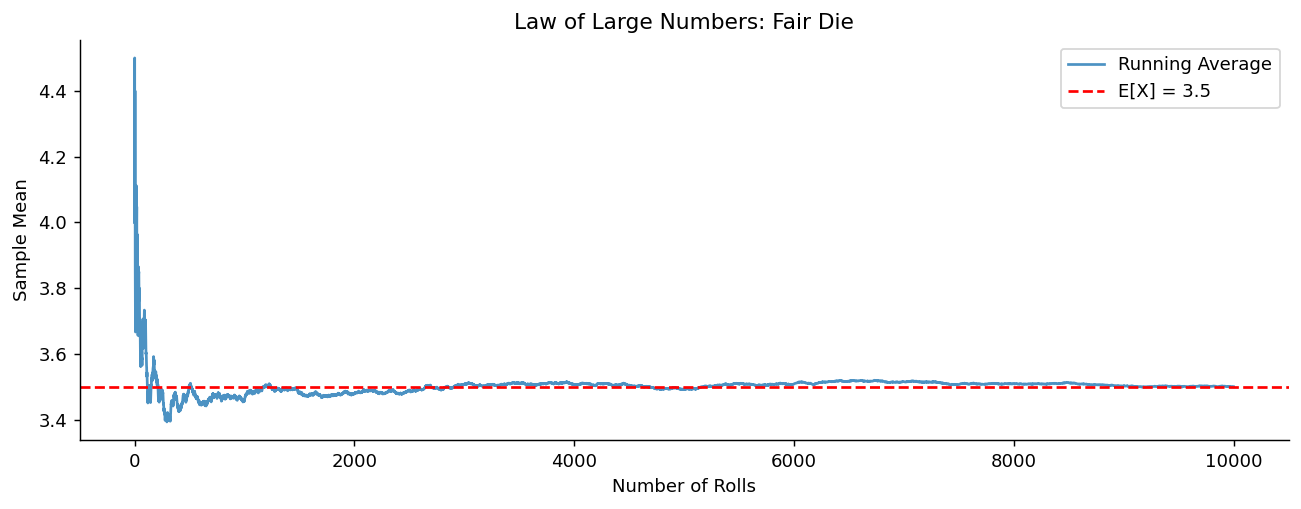
초반에는 크게 출렁이다가 점차 3.5에 붙는다. 출렁임의 폭이 \(1/\sqrt n\)으로 줄어드는 것이 눈에 보이고, 네 시점에서 편차를 이론 표준편차로 나눈 값이 \(+0.56\), \(+1.11\), \(-0.80\), \(-0.01\)로 모두 1 규모 안에 있다. 곡선이 \(3.5\)에 붙는 속도가 정리 1이 약속한 그 속도다. \(n = 663\) 이후로는 \(3.5 \pm 0.05\) 띠를 한 번도 벗어나지 않는데, 강한 법칙이 "어느 시점 이후로는 영영 \(\varepsilon\) 안에 머문다"고 한 것의 모습이다.
그런데 누적합 쪽은 전혀 모여들지 않는다. \(S_n - 3.5n\)의 절댓값이 경로를 따라가며 최대 \(134\)까지 커진다(\(n = 6{,}730\)에서). 그 자리의 \(\sigma\sqrt n = 140\)과 같은 규모이며, 이 양은 \(\sqrt n\)으로 커지는 것이 정상이다. 누적평균이 \(0.0001\)까지 줄어든 것은 그 편차가 메워졌기 때문이 아니라 \(n = 10{,}000\)으로 나누어 희석되었기 때문이다. 절 2 끝의 경고 상자(도박사의 오류)와 이 절 뒤의 도박사의 역설 쪽이 이 구분을 파고든다.
그림 하나로 강한 법칙을 "확인"할 수는 없다는 점도 분명히 해 두자. 이 경로가 3.5에 붙는 것처럼 보이지만, 거의 확실한 수렴은 모든 경로의 집합에 대한 진술이고 그림은 그중 하나를 보여 줄 뿐이다. 유한한 그림으로는 "어느 시점 이후로 영영 \(\varepsilon\) 안에 머문다"를 끝까지 볼 수 없다. \(n = 663\) 이후 1만까지 안에 머물렀다는 것은 그 구간에서 벗어나지 않았다는 사실일 뿐이다.
두 보기가 보는 것이 다르다. 보기 1은 가로축이 \(n\)이 아니라 \(\bar X_n\)이었고, 칸마다 표본을 1만 번씩 새로 뽑아 분포를 그렸다. 여기서는 표본을 한 번만 뽑되 그것을 1만 번까지 이어 간 하나의 수열을 그린다. 약한 법칙은 앞의 그림에서, 강한 법칙은 뒤의 그림에서 읽힌다.
연습문제
연습문제 1. \(X_i \sim \mathrm{Uniform}(0,1)\)이 i.i.d.다. (a) \(\mathbb{E}[X]\), \(\mathrm{Var}(X)\)는? (b) \(\bar X_n\)에 대한 약한 큰수의 법칙을 진술하라. (c) \(P(|\bar X_{100} - 1/2| \ge 0.05)\)에 대한 체비쇼프 상한을 구하라. (d) \(n = 10\,000\)일 때의 상한을 구하라.
풀이
(a) \(\mathbb{E}[X] = 1/2\), \(\mathrm{Var}(X) = 1/12\).
(b) 모든 \(\varepsilon > 0\)에 대해 \(n \to \infty\)일 때 \(P(|\bar X_n - 1/2| \ge \varepsilon) \to 0\)이다.
(c) \(\mathrm{Var}(\bar X_n) = 1/(12n)\)이다. 체비쇼프: \(P(|\bar X_{100} - 1/2| \ge 0.05) \le (1/1200)/(0.05)^2 = (1/1200)/0.0025 = 1/3 \approx 0.333\).
(d) \(n = 10\,000\)이면 상한 \(= (1/120000)/0.0025 = 1/300 \approx 0.00333\)이다. \(n\)이 100배가 되면 상한이 100분의 1로 줄어 \(O(1/n)\) 수렴을 확인해 준다. 실제 확률은 훨씬 작다(체비쇼프는 평균과 분산만 쓰며 균등분포는 최악의 경우와 거리가 멀다). 중심극한정리에 근거한 정규근사가 더 촘촘한 추정을 준다.
연습문제 2. \(\mathbb{E}[X] = \mu\)이고 \(\mathrm{Var}(X) = \sigma^2\)이 유한한 i.i.d. \(X_i\)에 대해 체비쇼프 부등식으로부터 약한 큰수의 법칙을 증명하라.
풀이
체비쇼프: \(P(|\bar X_n - \mu| \ge \varepsilon) \le \mathrm{Var}(\bar X_n)/\varepsilon^2 = \sigma^2/(n\varepsilon^2)\).
고정된 임의의 \(\varepsilon > 0\)에 대해 \(n \to \infty\)이면 우변이 \(\to 0\)이므로 \(\bar X_n \to \mu\)가 확률수렴한다. \(\square\)
이 증명은 콜모고로프의 강한 법칙 조건 전부가 아니라 유한 분산만 요구한다는 점에 유의하라. 약한 법칙은 (특성함수를 쓰는 더 섬세한 증명으로) 1차 적률만 유한해도 성립하도록 강화할 수 있으며, 힌친의 약한 큰수의 법칙이 그렇게 한다.
연습문제 3. 수렴 속도. 평균 \(\mu\), 분산 \(\sigma^2\)인 i.i.d. \(X_i\)에 대해 \(\sqrt n (\bar X_n - \mu) = O_P(1)\)임을 보여라. 이것이 왜 거의 확실한 수렴에는 충분히 빠르지 않은가?
풀이
중심극한정리에 의해 \(\sqrt n (\bar X_n - \mu) \xrightarrow{d} N(0, \sigma^2)\)이므로 이 수열은 확률적으로 유계(긴밀, tight)이며, 이것을 \(O_P(1)\)이라 적는다. 곧 아무리 작은 \(\delta > 0\) 을 주어도 모든 \(n\) 에서 \(P\big(|\sqrt n(\bar X_n - \mu)| > K\big) < \delta\) 가 되는 \(K\) 를 잡을 수 있다는 뜻이다.
\(\bar X_n - \mu\)에 대한 함의: 이는 \(O_P(n^{-1/2})\)로 \(1/\sqrt n\)의 속도로 줄어든다.
\(1/\sqrt n\)이 거의 확실한 수렴에 충분히 빠르지 않은 이유: \(\bar X_n - \mu\)의 무작위 변동은 표준편차가 \(\sigma/\sqrt n\)인 대략 가우시안이다. \(n_0 \le n \le 2 n_0\)에 대한 최댓값은 \(\sqrt{\log n_0}/\sqrt{n_0}\)처럼 커지므로, \(\sqrt n (\bar X_n - \mu)\)이 임의로 큰 값을 무한히 자주 방문한다(반복로그의 법칙: 거의 확실하게 \(\limsup \sqrt n (\bar X_n - \mu) / \sqrt{2\sigma^2 \log\log n} = 1\)).
거의 확실한 수렴은 편차가 확률적으로 작아지는 데 그치지 않고 이후의 모든 \(n\)에 대해 결국 작게 유지되기를 요구한다. 그래서 강한 법칙의 증명에는 분산 계산보다 섬세한 논법이 필요하다(정리 3 의 증명 개요처럼 4차 적률이 유한하다고 두거나, 에테마디의 증명처럼 1차 적률의 유한성만으로).
연습문제 4. 코시분포에서는 큰수의 법칙이 실패한다. 표준 코시분포의 밀도는 \(f(x) = 1/(\pi(1+x^2))\)이다. \(\mathbb{E}[X]\)가 정의되지 않는 이유는 무엇이며, \(n \to \infty\)일 때 \(\bar X_n\)은 어떻게 되는가?
풀이
\(\mathbb{E}[X] = \int x \, f(x) \, dx\)가 정의되려면 적분이 수렴해야 한다. 코시분포에서는 \(\int_0^\infty x/(1+x^2) \, dx = (1/2) \ln(1 + x^2) |_0^\infty = \infty\)이다. 양의 부분과 음의 부분이 모두 발산하므로 \(\mathbb{E}[X]\)가 정의되지 않는다(단지 무한한 것이 아니라 형식적으로도 잘 정의되지 않는다).
\(\bar X_n\)의 행동: 코시분포에서 표본평균 \(\bar X_n\)은 개별 \(X_i\) 하나와 같은 분포를 갖는다. 평균에 대한 코시의 안정성 때문이다(코시 \(n\)개의 합은 코시의 \(n\)배이고 이를 \(n\)으로 나누면 다시 코시가 된다). 따라서 \(n\)이 커져도 \(\bar X_n\)은 집중되지 않으며 모든 \(n\)에 대해 두꺼운 꼬리를 갖는다.
교훈: 큰수의 법칙은 유한한 평균을 요구한다. 꼬리가 두꺼운 분포는 표본평균이 불안정할 수 있으며, 관측값을 아무리 많이 평균 내도 하나를 보는 것보다 나을 게 없다. 실무에서 이는 극단값이 흔한 분야(금융, 네트워크 트래픽)의 추정량에 영향을 주며, 평균이 정의되지 않을 때에도 잘 정의된 모집단 대응물을 갖는 로버스트한 대안(중앙값, 절사평균)을 쓸 동기가 된다.
연습문제 5. 약한 큰수의 법칙은 빈도주의 확률을 정당화한다: \(P(A) = \lim_{n \to \infty} (1/n) \sum_{i=1}^n \mathbf 1(\omega_i \in A)\). 이 극한을 정확히 진술하고, 이것이 왜 확률을 단지 계산하는 것이 아니라 정의하는 것인지 설명하라.
풀이
\(\Omega\)에서 뽑은 i.i.d. 표본에 대해 \(X_i = \mathbf 1(\omega_i \in A)\)라 하자. 그러면 \(\mathbb{E}[X_i] = P(A)\)이고 \(\mathrm{Var}(X_i) = P(A)(1 - P(A)) < \infty\)이다. 약한 큰수의 법칙에 의해
이므로 장기 빈도가 확률로 수렴한다.
왜 계산이 아니라 정의인가: 빈도주의 해석에서 확률은 장기 빈도로 정의된다. 그러면 약한 큰수의 법칙은 동어반복이 된다. \(P\)를 그 극한으로 두었으므로 극한이 존재하는 것이다. 반면 공리적 측도론(콜모고로프)에서 확률은 공리를 만족하는 집합함수이고, 약한 큰수의 법칙은 빈도주의적 직관을 공리와 잇는 정리가 된다.
실용적 쓰임: 그래서 자료에서 표본비율을 계산해 \(P(A)\)를 추정할 수 있다. 약한 큰수의 법칙이 그 추정이 일치성을 가짐을, 즉 \(n\)이 커지면 참값으로 수렴함을 보장한다. 큰수의 법칙이 없으면 빈도주의 통계학에는 형식적 정당화가 없다.
연습문제 6. 큰수의 법칙을 수치적분 방법으로 뒤집어 읽어라. 몬테카를로 적분의 오차가 왜 차원과 무관한지 보이고, 그 주장의 한계도 밝혀라.
풀이
\(I=\int_{[0,1]^d}f(\mathbf{x})\,d\mathbf{x}=\mathbb{E}[f(\mathbf{U})]\)이므로, \(\mathbf{U}_i\)를 뽑아 \(\hat I_n=\frac1n\sum_i f(\mathbf{U}_i)\)로 추정한다. 큰수의 법칙이 \(\hat I_n\to I\)를 보장하고, 오차는
지수 \(-1/2\)에 \(d\)가 들어 있지 않다. 반면 격자를 쓰면 축마다 \(m\)개의 점이 필요해 총 \(m^d\)개, 즉 차원의 저주를 그대로 맞는다.
import numpy as np
from scipy import integrate

rng = np.random.default_rng(0)
c = integrate.quad(lambda t: np.exp(-t ** 2), 0, 1)[0]   # I_d = c^d
print(f"I_d = ∫_[0,1]^d exp(-|x|^2) dx = c^d,   c = {c:.6f}\n")

print(f"{'d':>4}{'참값':>12}{'몬테카를로 n=10^5':>20}{'상대오차':>11}{'격자 점 수':>14}")
for d in (1, 3, 10, 30, 100):
    U = rng.random((100_000, d))
    est = np.exp(-(U ** 2).sum(1)).mean()
    print(f"{d:>4}{c ** d:>12.3e}{est:>20.3e}{abs(est - c ** d) / c ** d:>11.2%}"
          f"{'10^' + str(d):>14}")

print("\n피적분함수의 변동계수 (오차 상수를 결정한다)")
for d in (1, 10, 100):
    v = np.exp(-(rng.random((200_000, d)) ** 2).sum(1))
    print(f"  d={d:>3}: sd/mean = {v.std() / v.mean():>8.4f}")
출력:
I_d = ∫_[0,1]^d exp(-|x|^2) dx = c^d,   c = 0.746824

   d          참값        몬테카를로 n=10^5       상대오차        격자 점 수
   1   7.468e-01           7.471e-01      0.04%          10^1
   3   4.165e-01           4.165e-01      0.00%          10^3
  10   5.397e-02           5.379e-02      0.34%         10^10
  30   1.572e-04           1.579e-04      0.41%         10^30
 100   2.098e-13           1.925e-13      8.23%        10^100

피적분함수의 변동계수 (오차 상수를 결정한다)
  d=  1: sd/mean =   0.2690
  d= 10: sd/mean =   1.0087
  d=100: sd/mean =  21.3544
\(d=30\)까지는 \(10^5\)개의 표본으로 \(0.4\%\) 오차를 낸다. 격자로 축당 \(10\)점만 잡아도 \(10^{30}\)개가 필요하다 — 우주의 나이 동안에도 끝나지 않는다.
그런데 \(d=100\)에서 오차가 \(8.2\%\)로 튄다. 차원과 무관한 것은 지수 \(-1/2\)이지 상수 \(\sigma_f\)가 아니다. 변동계수(coefficient of variation)가 \(d=1\)에서 \(0.27\), \(d=10\)에서 \(1.01\), \(d=100\)에서 \(21.4\)로 커진다.
차원 무관은 절반의 진실이다
수렴 속도는 \(n^{-1/2}\)로 고정이지만, 그 앞의 상수 \(\sigma_f\)는 차원에 따라 얼마든지 커질 수 있다. 고차원에서 \(f\)가 아주 좁은 영역에 집중되면 무작위 점 대부분이 \(f\approx0\)인 곳에 떨어지고, 추정은 몇 개의 운 좋은 점이 좌우한다.
처방이 곧 몬테카를로 방법론의 전부다.
| 기법 | 하는 일 |
|---|---|
| 중요도 표집 | \(f\)가 큰 곳에서 더 많이 뽑아 \(\sigma_f\)를 줄인다 |
| 대조변량 | 참값을 아는 상관된 양을 빼서 분산을 줄인다 |
| 층화 표집 | 영역을 나눠 각 층에서 고르게 뽑는다 |
| 준몬테카를로 | 저불일치 수열로 \(n^{-1}\)에 가깝게 만든다 |
| MCMC | 목표분포에서 직접 뽑는다(고차원 베이즈) |
모두 \(\sigma_f\)를 공격한다. \(n^{-1/2}\)는 큰수의 법칙이 준 것이라 바꿀 수 없기 때문이다. \(\square\)
연습문제 7. 큰수의 법칙은 독립을 가정한다. 관측이 서로 상관되어 있으면 어떻게 되는가? AR(1) 시계열로 확인하라.
풀이
독립이 아니어도 상관이 충분히 빨리 사라지면 큰수의 법칙은 살아남는다(에르고드 정리). 다만 정밀도가 떨어진다.
\(X_t=\phi X_{t-1}+\varepsilon_t\)(\(|\phi|<1\))에서 정상상태의 표본평균 분산은
이다. 독립일 때의 \(\gamma_0/n\)에 \((1+\phi)/(1-\phi)\)라는 벌점이 붙는다. 이를 뒤집으면 유효표본크기
import numpy as np

def ar1(n, phi, rng):
    e = rng.normal(0, 1, n)
    x = np.empty(n)
    x[0] = e[0] / np.sqrt(1 - phi ** 2)          # 정상분포에서 출발
    for i in range(1, n):
        x[i] = phi * x[i - 1] + e[i]
    return x

rng = np.random.default_rng(0)
n = 10_000
print(f"{'phi':>6}{'표본평균 sd':>15}{'독립 가정 sd':>15}{'실제 n_eff':>13}{'이론 n_eff':>13}")
for phi in (0.0, 0.5, 0.9, 0.99):
    m = np.array([ar1(n, phi, rng).mean() for _ in range(300)])
    sd_indep = np.sqrt(1 / (1 - phi ** 2) / n)
    print(f"{phi:>6.2f}{m.std():>15.5f}{sd_indep:>15.5f}"
          f"{n * (sd_indep / m.std()) ** 2:>13.1f}"
          f"{n * (1 - phi) / (1 + phi):>13.1f}")
출력:
   phi        표본평균 sd       독립 가정 sd     실제 n_eff     이론 n_eff
  0.00        0.01011        0.01000       9789.6      10000.0
  0.50        0.01995        0.01155       3350.6       3333.3
  0.90        0.09962        0.02294        530.4        526.3
  0.99        1.03067        0.07089         47.3         50.3
공식이 정확히 맞는다. \(\phi=0.99\)면 관측 \(10\,000\)개가 독립 관측 약 \(50\)개의 값어치밖에 없다. \(200\)배의 낭비다.
큰수의 법칙 자체는 무사하다. \(\phi=0.99\)여도 \(n\to\infty\)면 \(\bar X_n\to0\)이다. 깨지는 것은 속도와 오차 평가다.
위험한 것은 독립을 가정한 오차 계산이다. \(\phi=0.9\)인 자료에 \(s/\sqrt n\)을 그대로 쓰면 표준오차를 \(\sqrt{10000/526}=4.4\)배 과소평가한다. 신뢰구간이 \(4.4\)배 좁아지고, 검정은 있지도 않은 유의성을 남발한다.
어디서 만나는가.
| 상황 | 상관의 출처 |
|---|---|
| 시계열 관측 | 시간적 자기상관 |
| MCMC 표본 | 연쇄의 자기상관 |
| 군집표본(학급·마을) | 집단 내 유사성 |
| 공간 자료 | 가까운 곳끼리 닮음 |
| 반복측정 | 같은 개인의 반복 |
처방. MCMC에서는 유효표본크기를 언제나 함께 보고하고(arviz의 ess), 시계열 회귀에서는 뉴이–웨스트 표준오차를, 군집자료에서는 군집 로버스트 표준오차를 쓴다. 모두 \((1+\phi)/(1-\phi)\)에 해당하는 벌점을 자료에서 추정해 되돌려 놓는 장치다.
\(\phi\to1\)이면 무너진다. \(\phi=1\)은 확률보행이고 정상성이 없어 \(\bar X_n\)이 아무 데도 수렴하지 않는다. 단위근 검정이 중요한 이유다. \(\square\)
연습문제 8. 어느 보험사가 1년짜리 상품을 판다. 가입자 한 사람에 대해 사고가 날 확률은 \(0.02\) 이고, 사고가 나면 \(500\) 만원을 지급한다. 보험료는 사고 여부와 관계없이 \(15\) 만원을 받는다. 가입자 한 사람에 대한 보험사의 손익(단위: 만원)은
이다.
(a) \(E[Y]\), \(\operatorname{Var}(Y)\), \(\operatorname{sd}(Y)\) 를 구하라. 기대이익과 표준편차를 견주어, 가입자를 한 명만 받는다면 이 장사가 어떤 성격인지 한 문장으로 쓰라. (b) 이제 서로 독립인 가입자 \(10{,}000\) 명에게 같은 상품을 판다. 총손익 \(T = Y_1 + \cdots + Y_{10000}\) 의 \(E[T]\) 와 \(\operatorname{sd}(T)\) 를 구하라. 이어서 1인당 손익의 표준편차를 구해 (a) 와 견주고, 보험업이 성립하는 까닭을 밝혀라. (c) 기대이익이 정확히 \(0\) 이 되는 보험료를 순보험료라 한다. 순보험료는 얼마이며, 실제 보험료 \(15\) 만원 가운데 순보험료를 넘는 몫은 몇 퍼센트인가?
풀이
(a) 한 명만 받으면 장사가 아니라 도박이다. \(I\) 가 \(p = 0.02\) 인 베르누이이므로 \(E[I] = 0.02\), \(\operatorname{Var}(I) = 0.02 \times 0.98 = 0.0196\) 이고 \(Y\) 는 \(I\) 의 선형변환이다.
기대이익 \(5\) 만원인데 표준편차가 그 14 배인 \(70\) 만원이다. 실제로 일어나는 일은 \(98\%\) 확률로 \(+15\) 만원, \(2\%\) 확률로 \(-485\) 만원이며 「평균 \(5\) 만원」은 어느 쪽도 아니다. 한 사람에게서는 기댓값이 아무것도 말해 주지 않는다.
(b) 1인당 변동이 \(\sqrt n\) 으로 줄어든다. 독립이므로 기댓값도 분산도 더해진다.
1인당으로 환산하면 평균은 그대로 \(5\) 만원이고 표준편차는 \(7{,}000/10{,}000 = 0.7\) 만원이다 — (a) 의 \(70\) 만원에서 \(100\) 배 줄었고 \(100 = \sqrt{10{,}000}\) 이다. 합의 표준편차가 \(n\) 이 아니라 \(\sqrt n\) 에 비례하므로 1인당으로 나누면 \(1/\sqrt n\) 의 비율로 준다.
이것이 보험업이 성립하는 까닭이다. 보험사는 위험을 없애는 것이 아니라 여러 명에게 잘게 나눈다. 가입자 한 사람에게 \(500\) 만원의 사고는 감당 못 할 충격이지만 보험사에게는 1인당 \(0.7\) 만원의 변동으로 바뀐다. 기대이익 \(5\) 만원이 이제 표준편차의 \(7\) 배이므로 예측 가능한 사업이 된다. 큰수의 법칙이 여기서 장사의 조건으로 나타난다.
(c) 순보험료는 기대지급액이다.
그 \(5\) 만원이 사업비·이윤·그리고 (b) 에서 본 변동을 떠안는 값이다. 보험료를 \(10\) 만원으로 내리면 기대이익이 \(0\) 이 되어 손실이 날 확률이 \(50\%\) 가까운 사업이 된다.
연습문제 9. 확률수렴과 거의 확실한 수렴을 구별하라. \(X_n \to 0\)이 확률수렴하지만 거의 확실하게는 수렴하지 않는 열을 구성하라.
풀이
고전적인 "움직이는 블록" 예다. 균등측도를 갖는 \(\Omega = [0, 1]\) 위에서 다음과 같이 정의한다.
- \(X_1 = \mathbf 1_{[0, 1]}\)
- \(X_2 = \mathbf 1_{[0, 1/2]}\), \(X_3 = \mathbf 1_{[1/2, 1]}\)
- \(X_4 = \mathbf 1_{[0, 1/4]}\), \(X_5 = \mathbf 1_{[1/4, 1/2]}\), \(X_6 = \mathbf 1_{[1/2, 3/4]}\), \(X_7 = \mathbf 1_{[3/4, 1]}\)
- ... (길이 \(1/2^k\)인 구간들이 \([0,1]\)을 덮도록 계속한다)
그러면 $P(X_n \ne 0) = $ 지시구간의 길이 \(\to 0\)이므로 \(X_n \to 0\)이 확률수렴한다.
그러나 모든 \(\omega \in [0, 1]\)에 대해 \(X_n(\omega) = 1\)이 무한히 자주 일어난다(모든 길이 척도가 모든 \(\omega\)를 지나간다). 따라서 어떤 \(\omega\)에서도 \(X_n(\omega) \not\to 0\)이며 거의 확실한 수렴이 모든 점에서 실패한다.
약한 법칙은 확률수렴을, 강한 법칙은 더 강한 거의 확실한 수렴을 준다. 개별 표본 경로에서의 행동이 두 체제에서 다를 수 있다.
연습문제 10. 연습문제 \(2\)의 증명은 유한한 분산을 썼다. 그런데 강한 큰수의 법칙은 \(\mathbb{E}|X|<\infty\)만 요구한다. 분산이 무한한데 평균은 유한한 분포에서 무슨 일이 일어나는지 조사하라.
풀이
콜모고로프의 강한 큰수의 법칙. \(X_i\)가 i.i.d.이고 \(\mathbb{E}|X|<\infty\)이면 \(\bar X_n \to \mu\)가 거의 확실히 성립한다. 분산은 전혀 필요 없다. 체비쇼프 증명은 편했을 뿐 필수가 아니었다.
파레토분포 \(P(X>x)=x^{-\alpha}\)(\(x\ge1\))에서
| \(\alpha\) | 평균 | 분산 |
|---|---|---|
| \(\alpha>2\) | 유한 | 유한 |
| \(1<\alpha\le2\) | 유한 | 무한 |
| \(\alpha\le1\) | 무한 | 무한 |
\(\alpha=1.5\)면 평균은 \(3\)인데 분산이 무한하다. 큰수의 법칙은 성립하지만 얼마나 느린가?
import numpy as np

rng = np.random.default_rng(0)
print("표본평균의 산포 (각 n마다 200회 반복한 사분위범위)")
print(f"{'n':>9}{'파레토 a=1.5':>16}{'지수 (평균 3)':>16}{'배수':>8}")
for n in (10 ** 3, 10 ** 4, 10 ** 5, 10 ** 6):
    pa = np.array([rng.pareto(1.5, n).mean() + 1 for _ in range(200)])
    ex = np.array([rng.exponential(3.0, n).mean() for _ in range(200)])
    iqr = lambda v: np.subtract(*np.percentile(v, [75, 25]))
    print(f"{n:>9}{iqr(pa):>16.5f}{iqr(ex):>16.5f}{iqr(pa)/iqr(ex):>8.1f}")
출력:
표본평균의 산포 (각 n마다 200회 반복한 사분위범위)
        n       파레토 a=1.5       지수 (평균 3)      배수
     1000         0.38012         0.12907     2.9
    10000         0.17643         0.03738     4.7
   100000         0.09132         0.01276     7.2
  1000000         0.03894         0.00396     9.8
둘 다 수렴하지만 속도가 다르다.
| \(n\) 10배 증가 | 파레토의 감소 배수 | 지수의 감소 배수 |
|---|---|---|
| \(10^3\to10^4\) | \(2.15\) | \(3.45\) |
| \(10^4\to10^5\) | \(1.93\) | \(2.93\) |
| \(10^5\to10^6\) | \(2.35\) | \(3.22\) |
지수분포(exponential distribution)는 \(\sqrt{10}=3.16\)배씩, 파레토는 \(10^{1/3}=2.15\)배씩 줄어든다. 이론값과 정확히 맞는다. 일반적으로 \(1<\alpha<2\)인 파레토에서 표본평균의 오차는
이며, \(\alpha=1.5\)면 \(n^{-1/3}\)이다. 연습문제 \(3\) 의 \(n^{-1/2}\) 보다 느리다.
실무적 함의가 크다. \(n=10^6\)에서 파레토의 산포가 지수의 \(9.8\)배다. 지수분포에서 표본을 \(10\)배 늘려 얻는 만큼(\(3.16\)배 개선)을 파레토에서 얻으려면 \(n^{1/3}=3.16\), 곧 표본을 약 \(32\)배 늘려야 한다.
그리고 중심극한정리는 아예 적용되지 않는다. 분산이 무한하므로 \(\sqrt n(\bar X_n-\mu)\)는 정규분포로 가지 않는다(3.5절 중심극한정리 연습문제 17의 안정분포). 평균은 믿을 수 있지만 그 평균의 신뢰구간은 표준 공식으로 만들 수 없다. \(\square\)
연습문제 11. \(\theta\)마다 큰수의 법칙이 성립한다고 하자. 그러면 \(\hat\theta_n=\arg\max_\theta Q_n(\theta)\)도 \(\arg\max_\theta Q(\theta)\)로 수렴하는가? 아니다. 반례를 들고, 무엇이 더 필요한지 밝혀라.
풀이
import numpy as np
from scipy.special import logsumexp

grid = np.linspace(-2, 60, 200_001)
Q = -grid ** 2 / (1 + grid ** 2)                       # 최대는 t=0
print("Q(t) = -t^2/(1+t^2),   Q_n(t) = Q(t) + 3 exp(-4 (t-n)^2)")
for n in (5, 10, 50):
    Qn = Q + 3 * np.exp(-4 * (grid - n) ** 2)
    print(f"  n={n:>3}:  argmax Q_n = {grid[Qn.argmax()]:>6.2f}")
print(f"  참 argmax Q = {grid[Q.argmax()]:.2f}"
      f"   (그런데 고정된 t 마다 Q_n(t) -> Q(t) 이다)")

rng = np.random.default_rng(0)
x = rng.normal(0, 1, 20)

def loglik(mu1, s1, mu2=0.0, s2=1.0, w=0.5):
    lp = np.log(2 * np.pi) / 2
    a = np.log(w) - np.log(s1) - lp - 0.5 * ((x - mu1) / s1) ** 2
    b = np.log(1 - w) - np.log(s2) - lp - 0.5 * ((x - mu2) / s2) ** 2
    return logsumexp(np.vstack([a, b]), axis=0).sum()

print("\n혼합 0.5 N(mu1, s1^2) + 0.5 N(0, 1),  자료 20개 ~ N(0,1)")
print(f"  정직한 해 (mu1=0, s1=1):  로그가능도 {loglik(0.0, 1.0):>9.2f}")
print(f"{'s1':>10}{'로그가능도':>16}   <- mu1 을 자료점 하나에 고정")
for s1 in (1e-1, 1e-3, 1e-6, 1e-10, 1e-20):
    print(f"{s1:>10.0e}{loglik(x[0], s1):>16.2f}")
출력:
Q(t) = -t^2/(1+t^2),   Q_n(t) = Q(t) + 3 exp(-4 (t-n)^2)
  n=  5:  argmax Q_n =   5.00
  n= 10:  argmax Q_n =  10.00
  n= 50:  argmax Q_n =  50.00
  참 argmax Q = 0.00   (그런데 고정된 t 마다 Q_n(t) -> Q(t) 이다)

혼합 0.5 N(mu1, s1^2) + 0.5 N(0, 1),  자료 20개 ~ N(0,1)
  정직한 해 (mu1=0, s1=1):  로그가능도    -25.95
        s1           로그가능도   <- mu1 을 자료점 하나에 고정
     1e-01          -31.94
     1e-03          -32.90
     1e-06          -25.99
     1e-10          -16.78
     1e-20            6.24
첫 반례: 봉우리가 도망간다. 각 \(t\)를 고정하면 \(3e^{-4(t-n)^2}\to0\)이므로 \(Q_n(t)\to Q(t)\)가 모든 \(t\)에서 성립한다. 그런데 \(Q_n\)의 최댓값은 \(t=n\)에 있어 \(\arg\max\)가 \(\infty\)로 달아난다. 점별 수렴은 최댓값의 위치를 통제하지 못한다.
둘째 반례는 실제 통계 문제다. 정규혼합의 가능도는 \(\mu_1\)을 자료점 하나에 고정하고 \(\sigma_1\to0\)으로 보내면 \(+\infty\)로 발산한다. \(\sigma_1=10^{-6}\)에서 이미 정직한 해(\(-25.95\))를 넘어서고, \(10^{-20}\)에서 \(+6.24\)다. 최대가능도추정량이 존재하지 않는다.
무엇이 부족한가. 두 가지를 더 요구해야 한다.
| 조건 | 하는 일 | 위 반례에서 |
|---|---|---|
| 균등수렴 \(\sup_\theta\lvert Q_n-Q\rvert\to0\) | 봉우리가 어디에도 숨지 못하게 | 첫 반례가 위반 |
| 모수공간의 컴팩트성 | \(\arg\max\)가 달아나지 못하게 | 첫 반례가 위반 |
| \(Q\)의 유일한 최대 (식별가능성) | 극한이 하나로 정해지게 | — |
| 가능도의 유계성 | 발산하는 방향을 차단 | 둘째 반례가 위반 |
이 조건들이 갖춰지면 \(\hat\theta_n\xrightarrow{p}\theta_0\)가 따라온다. 이것이 최대가능도추정량의 일치성 정리(7장 ★)의 실제 내용이며, 조건이 붙어 있는 이유가 바로 이 반례들이다.
실무에서는 어떻게 넘어가는가. 혼합모형의 EM 알고리즘은 \(\sigma\ge\epsilon\)이라는 하한을 두거나, 분산에 사전분포(prior distribution)를 주어(베이즈) 특이점을 없앤다. 어느 쪽이든 가능도를 유계로 만드는 것이 요점이다.
교훈. "각 점에서 수렴한다"와 "함수로서 수렴한다"는 다르며, 추정은 후자를 요구한다. 추정량이 \(Q_n\) 전체의 모양에 의존하기 때문이다. \(\square\)
정리하며
큰수의 법칙은 "자료를 많이 모으면 참값에 가까워진다"는 상식에 정확한 형태를 준다.
- 정리 1은 그 이유를 밝혔다. 표본평균의 중심은 그대로이고 산포만 \(\sigma^2/n\)으로 줄어든다.
- 정리 2(약한 법칙)는 각 \(n\)에서 크게 벗어날 확률이 0으로 감을 말한다.
- 정리 3(강한 법칙)은 표본경로 자체가 확률 1로 수렴함을 말한다.
이 정리가 통계학에 주는 것은 일치성이다. 표본평균이 모평균의 믿을 만한 추정량이라는 보장이며, 5장 이후 추정량을 평가하는 첫 번째 기준이 된다.
그런데 큰수의 법칙은 한 가지만 말하고 만다. 어디로 가는지는 말해 주지만 어떻게 가는지는 말해 주지 않는다.
\(n = 100\)에서 표본평균이 \(\mu\)에서 얼마나 떨어져 있을 가능성이 큰가? 그 오차의 분포는 어떤 모양인가? 이 물음에 답할 수 없으면 신뢰구간도 가설검정도 만들 수 없다.
놀랍게도 답은 모집단의 모양과 거의 무관하다. 원래 분포가 무엇이든 표본평균의 오차는 정규분포를 향해 간다. 바로 다음 쪽의 중심극한정리이며, 통계학에서 가장 널리 쓰이는 정리다.