넬슨–알렌 누적위험
생존함수(survival function)를 곧장 추정하는 대신 누적위험(cumulative hazard)을 먼저 추정하고 거기서 생존함수를 되돌리는 길이 있다. 두 길은 같은 자료에서 거의 같은 답을 주지만 똑같지는 않다 — 이 쪽의 보기 1 에서 두 생존 추정치가 \(t = 5\) 에서 \(0.365\) 와 \(0.453\), \(t = 9\) 에서 \(0\) 과 \(0.167\) 로 갈린다. 차이가 작을 때는 아무래도 좋지만 꼬리나 작은 표본에서는 그렇지 않다. 왜 한 번 더 돌아가는 길이 있고, 그 길이 더 나은 자리는 어디인가.
카플란–마이어 추정량은 생존함수 \(S(t)\)를 직접 겨냥한다. 또 다른 비모수적 접근은 대신 누적위험함수 \(H(t)\)를 추정하고 관계식 \(S(t) = \exp(-H(t))\)로 생존곡선을 되찾는다. 이것이 넬슨–알렌 추정량이며 넬슨(Nelson, 1972)과 알렌(Aalen, 1978)이 독립적으로 개발했다.
넬슨–알렌 추정량은 누적위험 자체가 관심 대상일 때 특히 유용하다. 예컨대 위험이 일정한지 평가하거나(누적위험 그림에서 직선인지 확인) 소표본 성질이 더 나은 신뢰구간을 만들 때 그렇다.
정의 1. 넬슨–알렌 추정량
카플란–마이어 절과 같은 표기를 쓴다. \(t_{(1)} < t_{(2)} < \cdots < t_{(K)}\)를 서로 다른 사건시간을 크기순으로 나열한 것이라 하고, 각 사건시간 \(t_{(j)}\)에서
- \(d_j\) = \(t_{(j)}\)에서의 사건 수,
- \(n_j\) = \(t_{(j)}\) 직전에 위험에 있는 대상 수
라 하자. 누적위험(cumulative hazard) \(H(t)\)의 넬슨–알렌 추정량(Nelson–Aalen estimator)은
이다. 각 항 \(d_j / n_j\)는 그 시점까지 생존했다는 조건에서 시점 \(t_{(j)}\)에 사건이 일어날 조건부확률(conditional probability)을 추정하며, 작은 구간에서 \(h(t_{(j)}) \cdot \Delta t\)를 근사한다.
1. 카플란–마이어 추정량과의 관계
카플란–마이어와 넬슨–알렌은 같은 생존함수를 서로 다른 경로로 겨냥한다. 작은 \(x\)에 대한 근사식 \(-\ln(1 - x) \approx x\)를 쓰면
이다. 이 근사는 각 사건시간에서 \(d_j / n_j\)가 작을 때 정확하며, 대표본에서 전형적으로 그렇다. 따라서
이다. 유한표본에서는 둘이 조금 다를 수 있다. 모든 \(x \geq 0\)에 대해 \(\exp(-x) \geq 1 - x\)이므로 넬슨–알렌 기반 생존 추정치 \(\hat{S}_{\text{NA}}(t)\)는 언제나 카플란–마이어 추정치 \(\hat{S}_{\text{KM}}(t)\) 이상이다.
2. 분산 추정
넬슨–알렌 추정량의 분산은 다음으로 추정한다.
이는 각 증분 \(d_j / n_j\)를 근사적으로 독립이고 분산이 \(d_j / n_j^2\)인 양으로 취급한 결과다 (\(n_j\)가 주어졌을 때 \(d_j\)의 이항분산에서 유도된다).
그림으로 보는 통계학 1. 센 것에서 그때그때의 기댓값을 빼면
「근사적으로 독립이고」라는 말을 그냥 넘기지 말자. 독립이 아니다. 한 사람이 죽으면 그 다음 모든 시점의 위험집합이 줄어든다. 절단도 마찬가지다. 그러니 보통의 중심극한정리(central limit theorem)를 그대로 쓸 수 없다.
\(1970\) 년대 중반까지 이 분야는 그 문제를 건건이 풀었다. 카플란–마이어의 점근분포에는 그 상황에 맞는 논증이, 로그순위에는 또 다른 논증이, 콕스의 부분가능도에는 또 다른 논증이 필요했다. 결과는 맞았지만 서로 이어져 있지 않았다.
오드 아알렌이 \(1975\) 년 버클리 박사논문에서 틀을 바꾸었다. 자료를 계수과정(counting process)으로 보는 것이다.
그리고 센 것에서 그때그때의 기댓값을 뺀다.
이것이 마팅게일(martingale)이다. 어느 시점에서 멈추어도 평균이 \(0\) 이고, 그 분산이 빼낸 양의 기댓값과 같다. 빼낸 양 \(\int_0^t Y(s)\,h(s)\,ds\) 를 보상자(compensator)라 부른다.
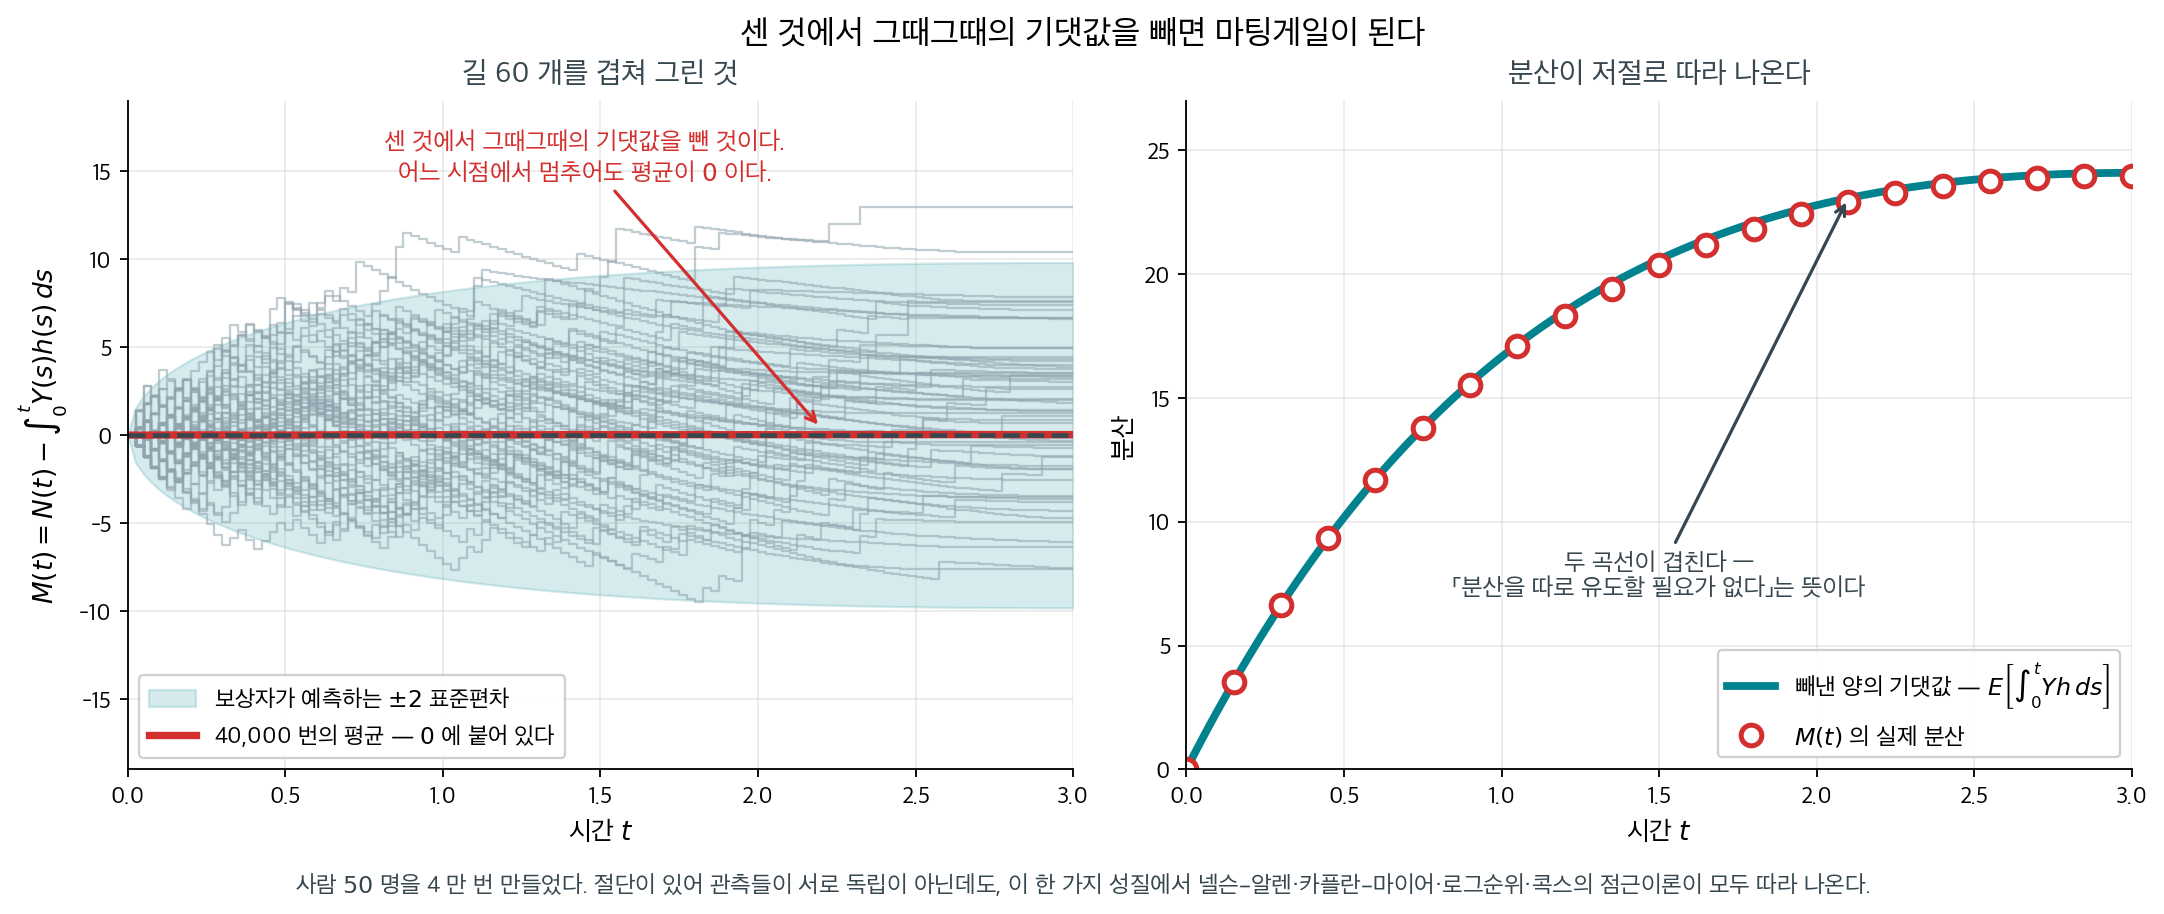
사람 \(50\) 명을 \(4\) 만 번 만들었다. 왼쪽 회색 계단이 길 \(60\) 개, 붉은 선이 \(4\) 만 번의 평균이다.
| \(t\) | \(E[M(t)]\) | 표준오차 | \(\operatorname{Var}[M(t)]\) | 빼낸 양의 기댓값 |
|---|---|---|---|---|
| \(0.5\) | \(0.007\) | \(0.016\) | \(10.149\) | \(10.174\) |
| \(1.5\) | \(0.029\) | \(0.023\) | \(20.382\) | \(20.594\) |
| \(3.0\) | \(0.028\) | \(0.025\) | \(23.968\) | \(24.094\) |
평균은 어느 시점에서나 표준오차 안이고, 분산은 따로 유도하지 않아도 보상자가 알려 준다. 오른쪽 그림에서 두 곡선이 겹치는 것이 그 뜻이다.
위의 \(\sum d_j/n_j^2\) 이 바로 이 보상자의 표본판이다. 「근사적으로 독립」이라는 손놀림이 필요했던 자리를, 마팅게일은 정확한 등식으로 메운다.
이 틀의 진짜 값은 일반성이다. 절단, 지연 진입(delayed entry), 시간에 따라 변하는 공변량, 반복 사건, 경쟁 위험 — 어느 것을 넣어도 바뀌는 것은 \(N(t)\) 와 \(Y(t)\) 의 정의뿐이고, 마팅게일 중심극한정리는 그대로 돈다. 앤더슨과 길이 \(1982\) 년에 콕스 모형까지 같은 방식으로 끝냈고, 그래서 콕스가 세 해를 들여 변호해야 했던 부분가능도가 이 언어에서는 한 줄이 되었다.
확인한 곳 — 오드 아알렌이 \(1975\) 년 버클리 통계학과 박사논문 「Statistical inference for a family of counting processes」로 계수과정 이론을 열었다는 것, 앤더슨·길의 「Cox's Regression Model for Counting Processes: A Large Sample Study」(『Annals of Statistics』, \(1982\) 년 \(12\) 월)가 마팅게일 기법으로 콕스 모형의 점근을 끝냈다는 것. 표의 수는 모두 직접 모의실험한 값이다
\(H(t)\)에 대한 근사적인 \(100(1 - \alpha)\%\) 신뢰구간은
이며 \(z_{1-\alpha/2}\)는 표준정규 분위수다.
로그 변환 신뢰구간
\(H(t) \geq 0\)이므로 위의 선형 신뢰구간은 \(H(t)\)가 작을 때 음수 하한을 낼 수 있다. 로그 변환이 이를 피한다. \(\ln \hat{H}(t)\)에 대한 구간을 만들고 양 끝점을 지수화하면 된다.
보기 1. 넬슨–알렌 누적위험 계산. 카플란–마이어 추정량 보기 1 과 같은 자료를 쓴다.
| \(t_{(j)}\) | \(n_j\) | \(d_j\) | \(d_j / n_j\) | \(\hat{H}(t_{(j)})\) |
|---|---|---|---|---|
| 1 | 8 | 1 | 0.125 | 0.125 |
| 3 | 6 | 1 | 0.167 | 0.292 |
| 5 | 4 | 2 | 0.500 | 0.792 |
| 9 | 1 | 1 | 1.000 | 1.792 |
\(t = 5\)에서 넬슨–알렌 생존 추정치는
풀이
이다. 카플란–마이어 추정치 \(\hat{S}_{\text{KM}}(5) = 0.365\)와 비교하면 차이가 눈에 띈다. \(d_3 / n_3 = 0.500\)이 작지 않아 그 단계에서 근사 \(\exp(-x) \approx 1 - x\)가 나쁘기 때문이다.
\(\hat{H}(5)\)의 추정된 분산은
이고, \(H(5)\)의 95% 신뢰구간은 \(0.792 \pm 1.96\sqrt{0.1684} = (-0.013,\ 1.596)\)이다. 하한이 음수이므로 0에서 잘라 \((0.000,\ 1.596)\)으로 보고한다. 위의 "로그 변환 신뢰구간" 상자가 지적한 바로 그 상황이다.
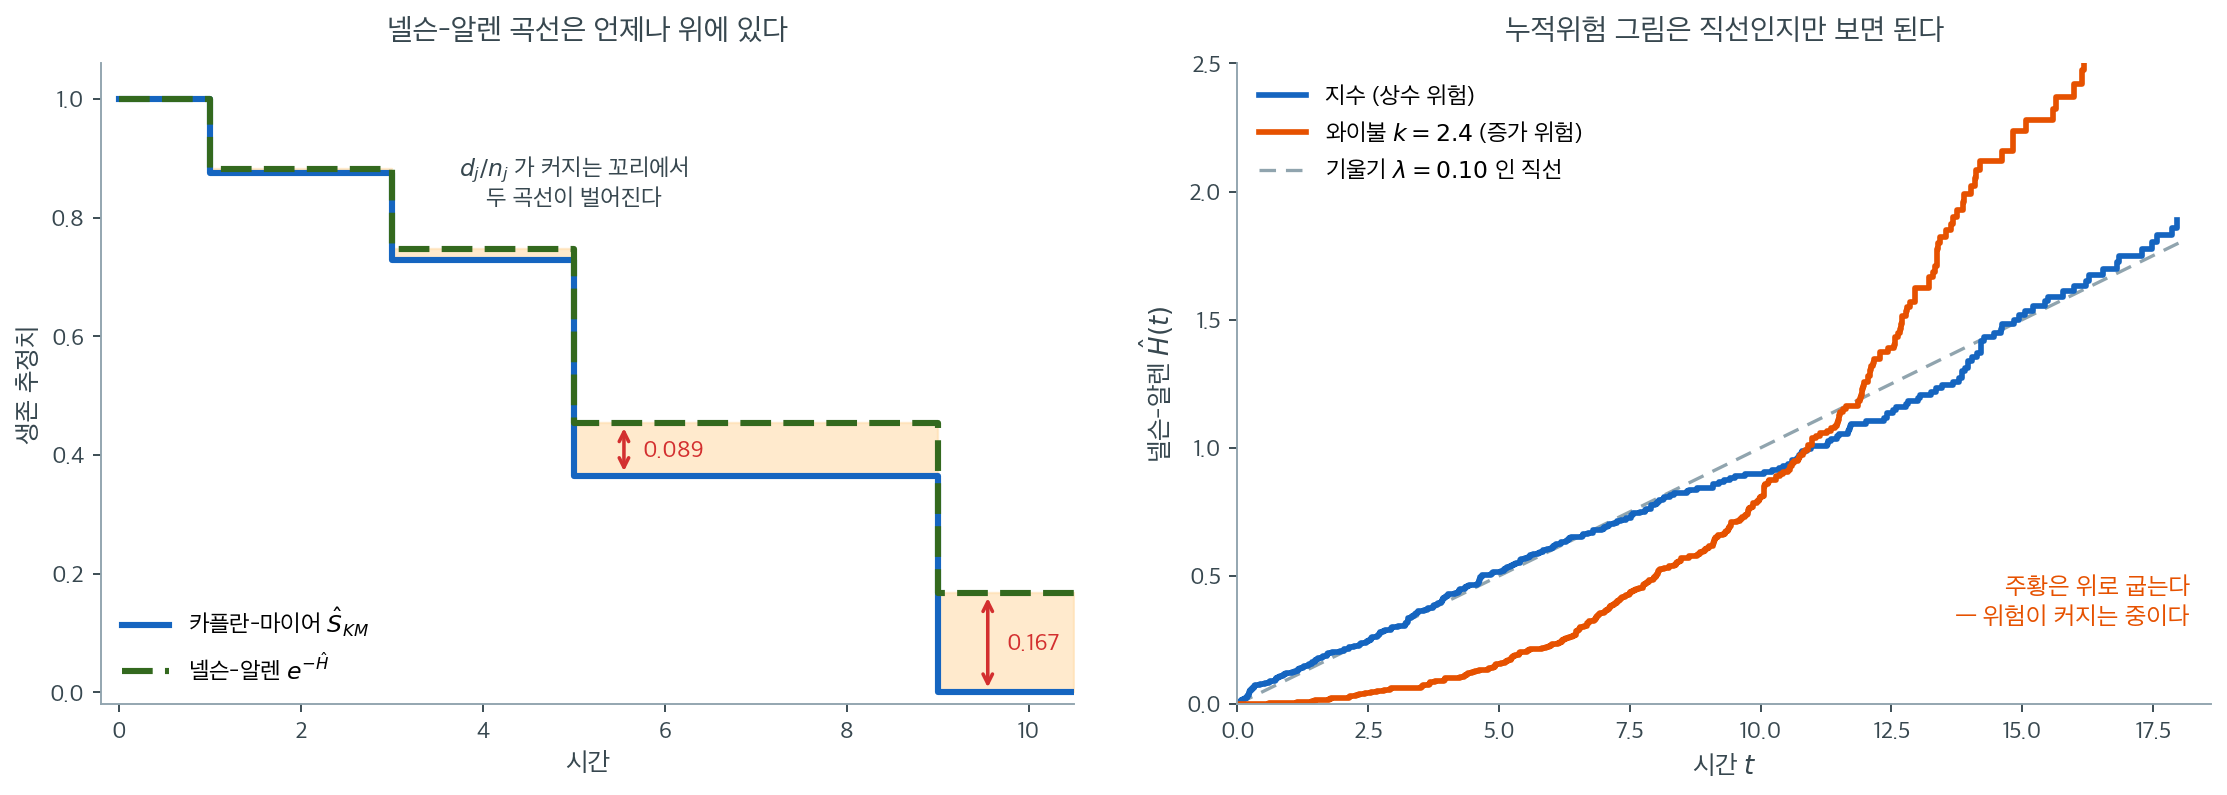
왼쪽이 위 보기의 두 곡선이다. 초반 두 계단에서는 두 선이 거의 붙어 있다. \(d_j/n_j\)가 \(0.125\)와 \(0.167\)로 작아 \(e^{-x} \approx 1-x\)가 잘 맞기 때문이다. 그런데 \(t = 5\)에서 \(d_j/n_j = 2/4 = 0.5\)가 되자 카플란–마이어는 \(0.365\), 넬슨–알렌은 \(0.453\)으로 \(0.089\)만큼 벌어진다. \(t = 9\)에서는 \(d_j/n_j = 1/1 = 1\)이라 카플란–마이어가 정확히 0에 닿는 반면 넬슨–알렌은 \(e^{-1.792} = 0.167\)에 머물러 차이가 \(0.167\)까지 커진다.
주황색으로 칠한 두 틈의 크기가 곧 근사오차다. 방향은 항상 같다. \(e^{-x} \ge 1-x\)이므로 넬슨–알렌 곡선이 카플란–마이어 곡선 아래로 내려가는 일은 없다. 그리고 \(x = d_j/n_j\)가 1에 가까워질수록 두 값의 차이가 커지므로, 위험집합이 말라붙는 곡선의 오른쪽 끝에서 틈이 가장 크게 벌어진다. 연습문제 2가 이 부등식을 증명하고, 연습문제 1이 같은 현상을 \(n = 10\) 자료에서 다시 보여 준다.
오른쪽은 이 절이 넬슨–알렌을 권하는 진짜 이유다. 두 집단 각각 \(n = 400\)을 지수분포(exponential distribution)와 와이불 \(k = 2.4\)에서 뽑고 무작위로 절단한 뒤, \(\hat H(t)\)를 시간에 대해 그렸다. 지수 자료는 곧은 직선이고 와이불 자료는 위로 굽는다. 파란 계단에 직선을 맞추면 기울기가 \(0.096\)으로 참값 \(\lambda = 0.10\)을 거의 그대로 회수한다. 같은 자료를 생존곡선으로 그렸다면 둘 다 "오른쪽으로 내려가는 곡선"으로만 보였을 것이다.
직선인지 아닌지는 사람 눈이 가장 잘 판별하는 모양이다. 곡률이나 기울기의 미세한 변화를 읽는 것보다 훨씬 쉽다. \(H(t)\)가 그 판별을 가능한 형태로 만들어 주기 때문에 누적위험 그림이 비형식적 진단의 표준이 되었다. 뒤의 연습문제 3에서 보듯 \(\ln \hat H(t)\) 대 \(\ln t\) 그림으로 한 걸음 더 나가면 와이불의 형상모수 \(k\)까지 기울기로 읽어 낼 수 있다.
3. 넬슨–알렌 추정량을 언제 쓸 것인가
다음 상황에서 카플란–마이어보다 넬슨–알렌이 선호된다.
- 누적위험 그림. \(\hat{H}(t)\)를 \(t\)에 대해 그리면 위험 구조가 드러난다. 직선이면 상수 위험(지수 모형)을, 아래로 볼록하면(위로 휘어 오르면) 증가 위험(와이불 \(k > 1\))을 시사한다.
- 소표본. 소표본에서 넬슨–알렌 추정량의 편향이 카플란–마이어보다 조금 작다.
- 구성 요소. 넬슨–알렌 추정량은 콕스 모형(21.4절)에서 기저 누적위험에 대한 브레슬로 추정량에 등장한다.
그림을 이용한 모형 점검
\(\hat{H}(t)\) 대 \(t\) 그림은 강력한 비형식적 진단이다. 원점을 지나는 직선에 가까우면 지수 모형이 타당하다. \(\ln \hat{H}(t)\) 대 \(\ln t\) 그림이 직선에 가까우면 와이불 모형이 적절하다.
AI로 보는 통계학 1. 누적으로 그려야 꺾이는 자리가 보인다
위 절이 권하는 까닭은 「직선인지 아닌지는 눈이 가장 잘 판별한다」였다. 그 성질이 운영 자료를 지켜보는 자리에서 그대로 쓰인다. 기기의 고장, 요청의 오류, 계정의 이탈을 날마다 세는 대시보드가 답해야 하는 물음은 보통 하나다 — 무엇인가 달라졌는가, 언제부터인가.
흔히 쓰는 수는 「누적 고장 \(\div\) 누적 노출」이다. 그런데 그 수는 처음부터 지금까지를 평균한 값이라 변화를 희석한다. 정의 1 의 \(\hat H(t) = \sum_{t_j \le t} d_j/n_j\) 는 다르다. 그날 위험에 놓인 것으로 그날 사건을 나누어 더하므로, 누적 그림의 기울기가 곧 그 시점의 위험률이 된다. 꺾이면 그 자리가 변화점이다.
import numpy as np

rng = np.random.default_rng(9)
N, WINDOW, CHANGE = 6000, 60.0, 35.0        # 기기 6,000 대를 60 일 동안 본다
RATE1, RATE2 = 0.004, 0.016                 # 35 일째부터 하루 고장률이 네 배가 된다

start = rng.uniform(0, WINDOW * 0.5, N)     # 기기가 들어온 날
u = rng.exponential(1.0, N)                 # 누적위험이 u 에 닿을 때 고장
h1 = np.maximum(0.0, CHANGE - start) * RATE1          # 바뀌기 전까지 쌓인 위험
fail = np.where(u <= h1, start + u / RATE1, CHANGE + (u - h1) / RATE2)
t = np.minimum(fail, WINDOW)
d = fail <= WINDOW

days = np.arange(1, int(WINDOW) + 1)
n_risk = ((t[None, :] >= days[:, None]) & (start[None, :] <= days[:, None])).sum(1)
events = np.bincount(np.ceil(t[d]).astype(int), minlength=len(days) + 1)[1:]
na = np.cumsum(events / np.maximum(n_risk, 1))                 # 넬슨-알렌 누적위험
ratio = np.cumsum(events) / np.maximum(np.cumsum(n_risk), 1)   # 누적 고장 / 누적 노출

print("     날   그날 위험집합   그날 고장   누적위험 (NA)   최근 7 일 기울기   누적 비율")
for day in (10, 20, 30, 34, 40, 50, 60):
    i = day - 1
    print(f"{day:>7}{n_risk[i]:>14}{events[i]:>12}{na[i]:>16.4f}"
          f"{(na[i]-na[i-7])/7:>18.5f}{ratio[i]:>12.5f}")
print(f"\n참 위험: 하루 {RATE1}, {int(CHANGE)} 일째부터 {RATE2}")
출력:
     날   그날 위험집합   그날 고장   누적위험 (NA)   최근 7 일 기울기   누적 비율
     10          1975           6          0.0305           0.00346     0.00318
     20          3871          23          0.0735           0.00426     0.00401
     30          5614          27          0.1193           0.00451     0.00432
     34          5513          22          0.1375           0.00472     0.00437
     40          5050          90          0.2259           0.01320     0.00664
     50          4323          64          0.3826           0.01588     0.00885
     60          3714          45          0.5356           0.01497     0.00998

참 위험: 하루 0.004, 35 일째부터 0.016
기울기가 참값을 따라간다. \(35\) 일 전에는 \(0.0035\)–\(0.0047\) 로 참값 \(0.004\) 근처이고, 그 뒤에는 \(0.013\)–\(0.016\) 으로 참값 \(0.016\) 근처다. 네 배로 뛴 사실이 두 주도 못 되어 드러난다.
누적 비율은 그러지 못한다. 마지막 열은 \(0.0044\) 에서 \(0.0100\) 으로 천천히 오를 뿐, \(60\) 일째에도 현재 위험 \(0.016\) 의 \(62\%\) 밖에 안 된다. 처음 \(35\) 일의 조용한 기간이 분모와 분자에 영원히 남아 있기 때문이다. 경보를 그 수에 걸어 두면 늦게, 그것도 작게 울린다.
셋째 열이 왜 중요한지도 표에 있다. 그날 위험집합이 \(1{,}975\) 에서 \(5{,}614\) 로 늘었다 줄었다 한다 — 기기가 들어오고 고장 나서 빠지기 때문이다. \(\hat H\) 는 그 변화를 날마다 분모에 넣으므로, 「고장 건수가 늘었다」가 기기가 늘어서인지 위험이 올라서인지를 가려 준다. 건수만 세는 그림은 그 둘을 구별하지 못한다.
다만 기울기는 눈으로 읽는 양이다. 꺾임이 참말인지 잡음인지는 이 그림이 답하지 않는다 — 위 절의 분산 추정으로 띠를 둘러 보아야 하고, 변화점을 수로 찾으려면 형식적인 절차가 따로 필요하다.
연습문제
연습문제 1. 넬슨–알렌 추정량
카플란–마이어 절의 연습문제 1에 나온 환자 10명 자료를 이용해 각 사건시간에서 누적위험의 넬슨–알렌 추정치 \(\hat{H}(t)\)를 계산하고, \(\exp(-\hat{H}(12))\)를 \(\hat{S}_{\text{KM}}(12)\)와 비교하라.
풀이
| \(t_{(j)}\) | \(n_j\) | \(d_j\) | \(d_j/n_j\) | \(\hat{H}(t_{(j)})\) |
|---|---|---|---|---|
| 3 | 10 | 1 | 0.100 | 0.100 |
| 7 | 8 | 1 | 0.125 | 0.225 |
| 8 | 7 | 1 | 0.143 | 0.368 |
| 12 | 5 | 1 | 0.200 | 0.568 |
| 15 | 3 | 1 | 0.333 | 0.901 |
| 20 | 1 | 1 | 1.000 | 1.901 |
\(\exp(-\hat{H}(12)) = \exp(-0.568) = 0.567\)이고 \(\hat{S}_{\text{KM}}(12) = 0.540\)이다. 넬슨–알렌 기반 추정치가 예상대로 조금 더 크다.
차이 \(0.567 - 0.540 = 0.027\)이 이 정도로 눈에 띄는 것은 표본이 \(n = 10\)으로 작아 각 \(d_j/n_j\)가 \(0.1\)에서 \(0.333\)까지로 작지 않기 때문이다. \(n\)이 수백이면 각 증분이 \(0.01\) 이하가 되어 두 추정치가 소수점 셋째 자리까지 일치하는 것이 보통이다. \(\square\)
연습문제 2. 모든 \(x \geq 0\)에 대해 \(\exp(-x) \geq 1 - x\)임을 이용하여 \(\hat{S}_{\text{NA}}(t) \geq \hat{S}_{\text{KM}}(t)\)가 항상 성립함을 증명하라.
풀이
\(x_j = d_j/n_j \in [0, 1]\)이라 하자. 부등식 \(e^{-x} \ge 1 - x\)는 \(e^{-x}\)의 볼록성에서 나온다. \(g(x) = e^{-x} - (1-x)\)라 하면 \(g(0) = 0\)이고 \(g'(x) = -e^{-x} + 1 \ge 0\)(\(x \ge 0\))이므로 \(g\)가 비감소이고 따라서 \(g(x) \ge 0\)이다.
이제 각 사건시간에 적용하면
이다. 곱의 각 인자가 음이 아니므로 항별 부등식을 곱해도 방향이 보존된다.
등호 조건. 모든 \(j\)에 대해 \(x_j = 0\)일 때만 등호가 성립한다. 즉 사건이 하나도 없을 때다. 사건이 하나라도 있으면 등호 없는 부등식(\(>\))이 성립한다.
실무적 함의: 넬슨–알렌 기반 생존곡선은 카플란–마이어 곡선보다 항상 위에 있다. 특히 위험집합이 작아지는 꼬리에서 차이가 커진다. 카플란–마이어는 \(d_j = n_j\)일 때 정확히 0에 도달하지만 넬슨–알렌 기반 곡선은 결코 0에 닿지 않는다. 보기 1 에서 \(t = 9\)일 때 \(\hat S_{\text{KM}} = 0\)이지만 \(\hat S_{\text{NA}} = e^{-1.792} = 0.167\)이다. \(\square\)
연습문제 3. 누적위험 그림으로 지수 모형과 와이불 모형을 구별하는 방법을 설명하라. 왜 \(\ln \hat H(t)\) 대 \(\ln t\) 그림이 와이불 진단에 쓰이는가?
풀이
지수 모형. \(h(t) = \lambda\)이면 \(H(t) = \lambda t\)이므로, \(\hat H(t)\)를 \(t\)에 대해 그리면 원점을 지나는 기울기 \(\lambda\)의 직선이 된다. 굽어 있으면 상수 위험 가정이 의심스럽다.
와이불 모형. \(H(t) = (t/\lambda)^k\)이므로 양변에 로그를 취하면
이다. 즉 \(\ln \hat H(t)\) 대 \(\ln t\) 그림이 기울기 \(k\), 절편(intercept) \(-k\ln\lambda\)인 직선이 된다. 이 그림에서 직선성이 와이불 적합도(goodness of fit)의 시각적 검정이 되고, 기울기가 형상모수 \(k\)의 대략적인 추정치를 준다.
| 그림 | 직선이면 | 기울기의 의미 |
|---|---|---|
| \(\hat H(t)\) 대 \(t\) | 지수 | \(\lambda\) |
| \(\ln \hat H(t)\) 대 \(\ln t\) | 와이불 | 형상 \(k\) |
지수는 \(k = 1\)인 와이불이므로, 두 번째 그림의 기울기가 1에 가까우면 지수 모형으로 충분하다.
\(\hat H(t) = 0\)인 구간을 조심하라
첫 사건 이전에는 \(\hat H(t) = 0\)이므로 \(\ln \hat H(t) = -\infty\)가 되어 그릴 수 없다. 또 사건이 한두 건뿐인 초기 구간에서는 \(\hat H\)의 변동이 매우 커서 로그 척도에서 과장되어 보인다. 그림의 왼쪽 끝을 해석하지 말고, 사건이 충분히 누적된 구간에서만 직선성을 판단하라. \(\square\)
연습문제 4. 넬슨–알렌 분산 공식 \(\sum_j d_j/n_j^2\)을 유도하라. 이 공식이 어떤 근사에 의존하는가?
풀이
시점 \(t_{(j)}\)에서 위험집합 \(n_j\)를 조건으로 하면, 사건 수 \(d_j\)는 근사적으로 \(\text{Binomial}(n_j, q_j)\)를 따른다. 여기서 \(q_j\)는 그 시점의 조건부 사건확률이다. 따라서
이다. \(q_j\)를 그 추정치 \(\hat q_j = d_j/n_j\)로 대체하면
이고, \(d_j \ll n_j\)이면 \((n_j - d_j)/n_j \approx 1\)이므로 \(\approx d_j/n_j^2\)이다. 증분들이 근사적으로 독립이라 보고 더하면 본문의 공식을 얻는다.
의존하는 근사 두 가지.
- \(d_j \ll n_j\). 위 마지막 단계에서 쓴 근사다. 꼬리에서 \(d_j\)가 \(n_j\)에 가까워지면 실제 분산보다 과대추정한다. 극단적으로 \(d_j = n_j\)이면 참 분산 기여는 \(d_j(n_j-d_j)/n_j^3 = 0\)인데 공식은 \(1/n_j\)를 준다. 정확한 판본 \(\sum_j d_j(n_j-d_j)/n_j^3\)을 쓰는 구현도 있다.
- 증분의 독립성(independence). 엄밀히는 서로 다른 시점의 증분이 독립이 아니다. 정확한 정당화는 계수과정과 마팅게일 이론에서 나오며, 그 결과 이 분산 추정치가 점근적으로 옳음이 증명된다.
카플란–마이어의 그린우드 공식이 \(\sum_j d_j/[n_j(n_j-d_j)]\)인 것과 대조하라. 두 공식은 \(d_j \ll n_j\)일 때 일치하지만 꼬리에서 갈라지며, 그린우드 쪽이 더 큰 값을 준다. \(\square\)
정리하며
| 성질 | 넬슨–알렌 | 카플란–마이어 |
|---|---|---|
| 추정 대상 | \(H(t)\) | \(S(t)\) |
| 공식 | \(\sum d_j / n_j\) | \(\prod (1 - d_j / n_j)\) |
| 치역 | \([0, \infty)\) | \([0, 1]\) |
| 편향(소표본) | 조금 작음 | 조금 큼 |
| 대표본 동등성 | \(\hat{H} \approx -\ln \hat{S}_{\text{KM}}\) | \(\hat{S}_{\text{KM}} \approx \exp(-\hat{H})\) |
다음 쪽 로그순위 검정으로 넘어간다. 여기까지는 곡선을 추정했고, 거기서는 집단마다 얻은 곡선이 서로 다른지를 검정한다.