다항 로지스틱 회귀
이항에서 다범주로
로지스틱 회귀는 이항 반응변수를 모형화한다. 반응변수가 \(C>2\)개의 범주를 가지면 다항 로지스틱 회귀(소프트맥스 회귀라고도 한다)로 일반화한다. 하나의 가중벡터 \(\boldsymbol{\theta}\) 대신, 각 입력을 범주마다 하나씩 \(C\)개의 실숫값 점수(로짓)로 옮기는 가중행렬 \(\mathbf{W}\)와 편향벡터 \(\mathbf{b}\)를 학습한다.
모형 구조(단층)
관측치 \(n\)개와 특성 \(p\)개를 갖는 자료에 대해 단층 소프트맥스 모형은 다음을 계산한다.
여기서 \(\hat{\mathbf{Y}}\)의 각 행은 \(C\)개 범주에 대한 확률분포다.
이층 모형(은닉층 + 소프트맥스)
로지스틱 활성함수를 갖는 은닉층을 추가하면 얕은 신경망이 된다. 아래 MNIST 보기에서 쓰는 구조다.
로지스틱(시그모이드) 활성함수는
이다.
MNIST 자료
MNIST 자료는 이 모형군의 표준 기준자료다.
각 이미지는 \(28\times 28\) 화소이며 784차원 벡터로 펼친다. 화소값은 \([0,1]\)로 척도화한다.
이항 로지스틱 회귀와의 관계
\(C=2\)이면 다항 로지스틱 회귀는 보통의 로지스틱 회귀로 환원된다. 두 범주 소프트맥스가 시그모이드 모형과 같은 결정경계를 주는 이유는 범주 확률의 로그비가 특성에 대해 일차식이기 때문이다.
모수가 과잉이라는 말의 뜻
위 식에서 자료가 말해 주는 것은 \(\mathbf{w}_1\)도 \(\mathbf{w}_0\)도 아니고 오직 그 차뿐이다. \(C\)가 3 이상일 때도 사정은 같다. 특성이 하나뿐인 3범주 모형으로 직접 확인해 보자.
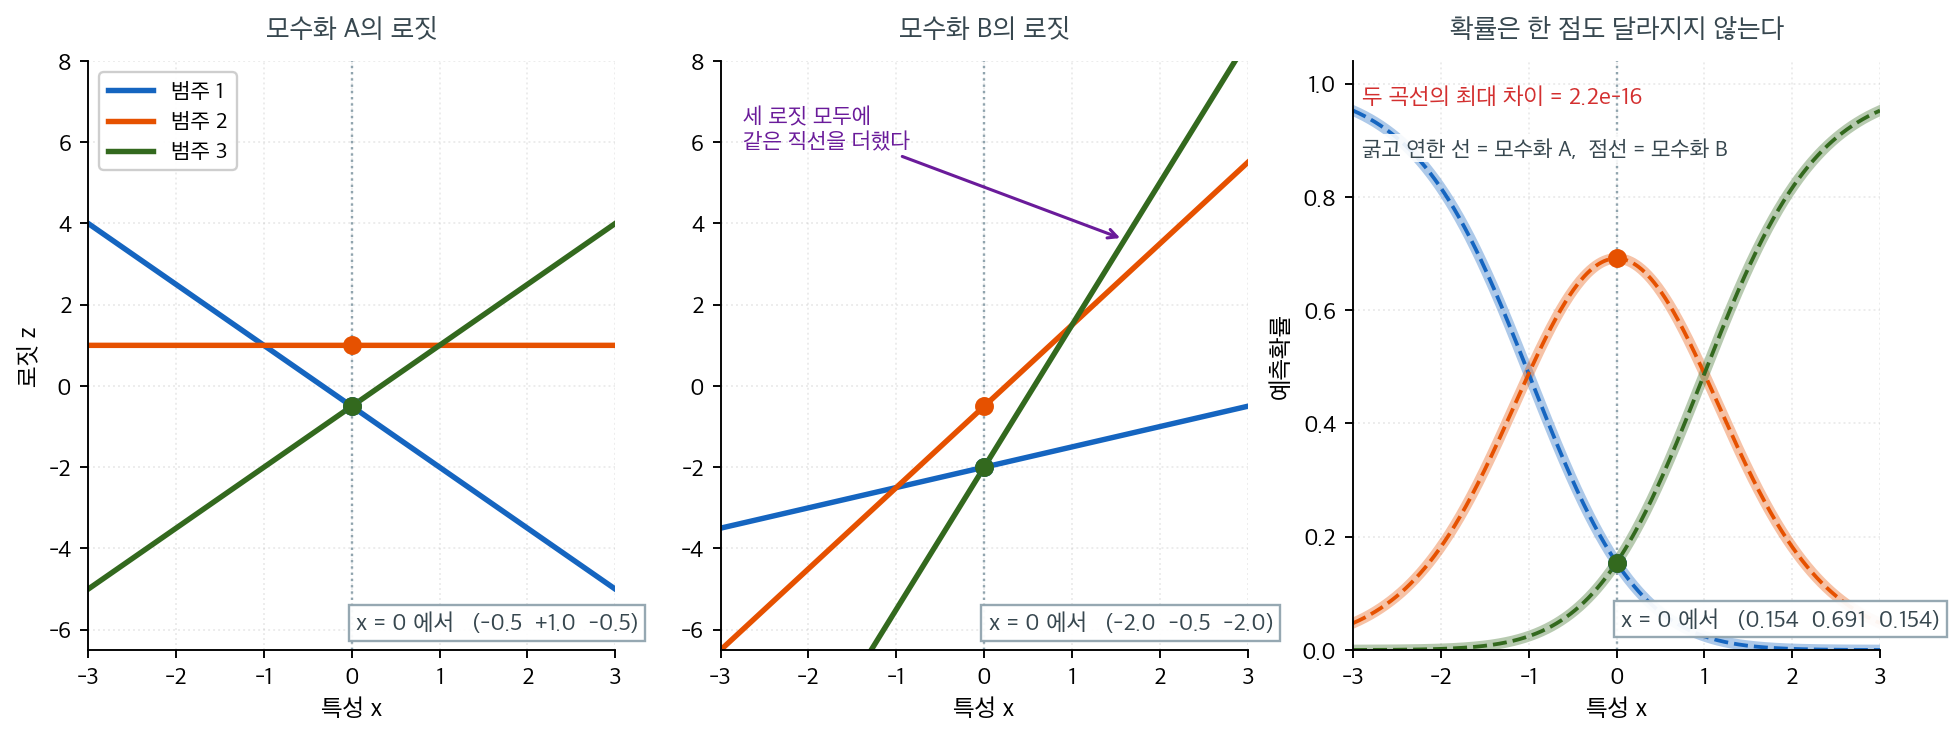
왼쪽은 기울기 \((-1.5,\ 0,\ 1.5)\), 절편 \((-0.5,\ 1.0,\ -0.5)\)인 모수화 A다. 가운데는 세 범주 모두의 기울기에 \(2.0\)을, 절편에 \(-1.5\)를 더한 모수화 B다. 두 그림은 한눈에도 다르다. A에서는 범주 2의 로짓이 수평선이고 범주 1이 우하향하는데, B에서는 세 직선이 모두 우상향한다. \(x = 0\)에서 로짓벡터도 \((-0.5,\ +1.0,\ -0.5)\) 대 \((-2.0,\ -0.5,\ -2.0)\)으로 전혀 다르다.
그런데 오른쪽 그림에는 세 곡선밖에 없다. A의 굵고 연한 선과 B의 점선이 완전히 포개져 있기 때문이다. 두 모수화가 내놓은 확률의 최대 차이는 \(2.2 \times 10^{-16}\)으로, 부동소수점의 반올림 오차 수준이다. \(x = 0\)에서 둘 다 \((0.154,\ 0.691,\ 0.154)\)를 내놓는다. 이유는 소프트맥스의 정의에 이미 들어 있다. 모든 로짓에 같은 양 \(c\)를 더하면
로 \(e^c\)가 분자와 분모에서 약분된다. 여기서 \(c\)는 \(\mathbf{x}\)에 의존해도 된다. 즉 모든 \(\mathbf{w}_k\)에 같은 벡터를, 모든 \(b_k\)에 같은 상수를 더하는 것은 모형을 전혀 건드리지 않는 조작이다.
이것이 모수 과잉이다. \(\mathbf{W} \in \mathbb{R}^{p\times C}\)와 \(\mathbf{b}\in\mathbb{R}^C\)는 \((p+1)C\)개의 수를 담고 있지만, 그중 \(p+1\)개는 자료가 결정할 수 없다. 실질적인 자유도는 \((p+1)(C-1)\)개다. 실무적 귀결이 둘 있다. 첫째, 벌점 없이 최대가능도만 풀면 해가 유일하지 않다. 위 그림의 A와 B는 훈련 손실이 완전히 같은 값을 가지며, 그런 해가 연속적으로 무한히 많다. 둘째, 그래서 한 범주를 기준으로 \(\mathbf{w}_C = \mathbf{0}\)으로 고정하거나(통계학의 관례), L2 벌점을 걸어 노름이 가장 작은 대표를 고르게 한다(기계학습의 관례). 벌점을 걸면 \(\lVert\mathbf{W}\rVert_F^2\)가 이동량에 대해 순볼록이므로 무한히 많은 동치해 중 정확히 하나가 선택된다.
연습문제
연습문제 1. \(C = 2\)인 소프트맥스 회귀가 이항 로지스틱 회귀와 동등함을 보이고, 로지스틱 모형의 계수 \(\boldsymbol\theta\)가 소프트맥스의 \(\mathbf{w}_0\), \(\mathbf{w}_1\)과 어떤 관계인지 밝혀라.
풀이
\(C = 2\)인 소프트맥스에서
이고 \(z_k = \mathbf{w}_k^\top\mathbf{x} + b_k\)이므로
이다. 따라서 소프트맥스는 계수
을 갖는 로지스틱 회귀와 정확히 같다.
중요한 귀결: 자료가 결정하는 것은 오직 차 \(\mathbf{w}_1-\mathbf{w}_0\)뿐이다. \(\mathbf{w}_0\)과 \(\mathbf{w}_1\) 각각은 결정되지 않는다. 같은 벡터를 둘 다에 더해도 차가 변하지 않으므로 예측이 같기 때문이다. 이것이 소프트맥스 모수화의 중복이며, 일반적인 \(C\)에 대해서는 자유도가 \(C\)가 아니라 \(C-1\)임을 뜻한다. \(\square\)
연습문제 2. MNIST(\(p = 784\), \(C = 10\))에서 단층 소프트맥스 모형과 은닉 노드 100개짜리 이층 모형의 모수 개수를 각각 세어라. 두 모형이 실제로 갖는 자유도는 얼마인가?
풀이
단층 모형:
| 성분 | 크기 | 개수 |
|---|---|---|
| \(\mathbf{W}\) | \(784 \times 10\) | \(7{,}840\) |
| \(\mathbf{b}\) | \(10\) | \(10\) |
| 합계 | \(\mathbf{7{,}850}\) |
이층 모형:
| 성분 | 크기 | 개수 |
|---|---|---|
| \(\mathbf{W}^h\) | \(784 \times 100\) | \(78{,}400\) |
| \(\mathbf{b}^h\) | \(100\) | \(100\) |
| \(\mathbf{W}^o\) | \(100 \times 10\) | \(1{,}000\) |
| \(\mathbf{b}^o\) | \(10\) | \(10\) |
| 합계 | \(\mathbf{79{,}510}\) |
이층 모형이 10배 이상 많은 모수를 쓴다.
실제 자유도. 연습문제 1에서 보았듯이 소프트맥스 출력층은 중복되어 있다. 모든 로짓에서 같은 값을 빼도 출력이 같으므로, 출력층에서 \(784 + 1 = 785\)개(단층) 또는 \(100 + 1 = 101\)개(이층)의 자유도가 실제로는 없다. 따라서 유효 자유도는 각각 \(7{,}065\)개와 \(79{,}409\)개다.
MNIST의 훈련표본이 60,000개이므로, 단층 모형은 모수당 관측치가 약 8개인 반면 이층 모형은 1개도 되지 않는다. 이것이 이층 모형에 정칙화나 조기 종료가 특히 필요한 이유다. \(\square\)
연습문제 3. 단층 소프트맥스 모형에서 교차엔트로피 손실의 \(\mathbf{W}\)에 대한 기울기가 \(\nabla_{\mathbf{W}}\mathcal{L} = \mathbf{X}^\top(\hat{\mathbf{Y}} - \mathbf{Y})\) 임을 유도하라.
풀이
관측치 \(i\)에 대한 손실은 \(\mathcal{L}_i = -\sum_c Y_{ic}\log \hat Y_{ic}\)이고 \(\hat Y_{ic} = \operatorname{softmax}(\mathbf{z}_i)_c\)이다. 먼저 소프트맥스의 야코비를 구한다.
(\(\delta_{ck}\)는 크로네커 델타). 연쇄법칙으로
이고, \(\sum_c Y_{ic} = 1\)(원-핫)이므로
를 얻는다. 즉 로짓에 대한 기울기가 단순한 잔차다.
이제 \(z_{ik} = \sum_j X_{ij}W_{jk} + b_k\)이므로 \(\partial z_{ik}/\partial W_{jk} = X_{ij}\)이고, 모든 관측치에 대해 더하면
이다. 편향은 \(\nabla_{\mathbf{b}}\mathcal{L} = \mathbf{1}^\top(\hat{\mathbf{Y}} - \mathbf{Y})\) 이다.
이 결과가 우아한 이유는, 소프트맥스 야코비의 복잡한 항들이 교차엔트로피의 \(1/\hat Y\)와 정확히 소거되기 때문이다. 이는 우연이 아니라 로짓이 다항분포의 정준연결이라는 사실의 귀결이며, 19장에서 로지스틱 회귀의 기울기가 \(A^\top(\boldsymbol\sigma - \mathbf{y})\)였던 것과 같은 이유다. \(\square\)
연습문제 4. 은닉층의 활성함수를 제거하면(즉 \(\mathbf{H} = \mathbf{Z}^h\)로 두면) 이층 모형이 단층 모형과 동등해짐을 보여라. 이것이 비선형 활성함수의 필요성에 대해 무엇을 말해 주는가?
풀이
활성함수 없이 \(\mathbf{H} = \mathbf{Z}^h = \mathbf{X}\mathbf{W}^h + \mathbf{b}^h\)이면,
이다. 즉 \(\mathbf{Z}^o\)는 \(\mathbf{X}\)의 아핀함수이며, 이는 정확히 단층 모형의 형태다. 층을 아무리 쌓아도 마찬가지다. 아핀사상의 합성은 아핀사상이다.
함의: 깊이 자체가 표현력을 주는 것이 아니라 비선형성이 준다. 활성함수가 없으면 79,510개의 모수를 학습하고도 \(784 \times 10 + 10 = 7{,}850\)개짜리 모형의 함수족을 벗어나지 못한다. 모수만 늘고 표현력은 그대로다.
한 가지 더 미묘한 점이 있다. \(\mathbf{W}^{\text{eff}} = \mathbf{W}^h\mathbf{W}^o\)의 계수(rank)는 \(\min(784, 100, 10) = 10\) 이하이므로, 은닉층이 \(C\)보다 좁으면 오히려 단층 모형보다 제약이 생긴다. 이 경우 활성함수 없는 이층 모형은 저계수 제약을 건 소프트맥스 회귀와 같다. \(\square\)
연습문제 5. MNIST 화소값을 \([0, 255]\)가 아니라 \([0,1]\)로 척도화하는 이유는 무엇인가? 척도화하지 않으면 학습에 무슨 일이 일어나는가?
풀이
화소값을 그대로 두면 입력의 크기가 255배 커지고, 그에 따라 로짓과 기울기의 크기도 커진다. 구체적으로 세 가지 문제가 생긴다.
-
로짓 폭발과 포화. \(\mathbf{z} = \mathbf{X}\mathbf{W}\)에서 \(\mathbf{X}\)가 255배 커지면 초기 가중치가 같을 때 로짓도 255배가 된다. 소프트맥스가 곧바로 포화되어 예측확률이 0이나 1이 되고, 기울기 \(\hat{\mathbf{Y}} - \mathbf{Y}\)는 여전히 유한하지만 은닉층의 시그모이드는 도함수 \(\sigma(1-\sigma) \approx 0\)이 되어 학습이 멈춘다.
-
학습률 문제. 19장 연습문제 3에서 보았듯 허용 가능한 학습률의 상한은 \(\lambda_{\max}(\mathbf{X}^\top\mathbf{X})\)에 반비례한다. 입력을 255배 키우면 이 값이 \(255^2 \approx 65{,}000\)배 커지므로 학습률을 그만큼 줄여야 하고, 그러면 수렴이 그만큼 느려진다.
-
정칙화의 의미 변화. 벌점 \(\|\mathbf{W}\|^2\)은 가중치의 절대적 크기를 벌하는데, 입력의 척도가 바뀌면 같은 예측을 내는 가중치의 크기도 바뀐다. 즉 같은 \(\lambda\)가 전혀 다른 강도의 정칙화가 된다.
\([0,1]\) 척도화는 세 문제를 한꺼번에 완화한다. 더 나아가 화소별로 평균 0, 분산 1로 표준화하면 수렴이 더 빨라지지만, MNIST는 화소값 분포가 이미 비슷해 단순한 \(255\)로 나누기만 해도 충분한 경우가 많다. \(\square\)
정리하며
소프트맥스 회귀는 로지스틱 회귀를 \(C>2\) 범주로 확장한 것이다.
- 가중벡터 하나가 가중행렬로 바뀐다. \(\boldsymbol\theta\in\mathbb{R}^p\) 대신 \(\mathbf W\in\mathbb{R}^{p\times C}\) 를 추정한다.
- 모수가 과잉이다. 모든 범주의 가중치에 같은 벡터를 더해도 확률이 변하지 않으므로, 한 범주를 기준으로 고정하거나(식별) 정칙화로 해를 유일하게 만든다.
- \(C=2\) 면 로지스틱 회귀가 된다. 두 로짓의 차이만 의미가 있고, 그 차이가 곧 로짓 하나다. 특수한 경우임을 확인하는 것이 중요하다.
- 범주에 순서가 없다고 가정한다. 순서형 반응에는 누적 로짓 모형 같은 다른 도구가 맞다.
- IIA 가정이 따라온다. 두 범주의 상대 오즈가 다른 범주의 존재와 무관하다는 성질이며, 현실에서 깨질 수 있다.
다음 절 소프트맥스 함수로 넘어간다.