일반화가법모형 (GAM)
개요
들어가는 이야기 — p 값이 큰 행을 보고 변수를 뺄 때
회귀 출력표에서 \(p\) 값이 큰 행을 보고 변수를 빼는 일은 거의 몸에 익은 절차다. GAM 은 변수마다 곡선 하나를 허락하는 모형이고 그 곡선을 스플라인 기저로 만드는데, 거기에 그 습관을 그대로 쓰면 주역을 뺀다.
참 모형에 사인 곡선이 들어 있는 자료에 GAM 을 적합해 보자. 계수표의 그 변수 행은 계수 \(-0.0018\), \(p\) 값 \(0.945\) 로 나온다. 글자대로 읽으면 쓸모없는 변수다. 같은 적합에서 선형으로 넣은 변수의 행은 그대로 읽어도 되니 더 헷갈린다. 그런데 그 변수는 이 자료를 만든 주역이다. 같은 적합이 되찾은 부분함수의 오르내림 폭이 \(2.1074\) 이니 효과를 제대로 되찾기도 했다.
까닭은 한 줄이다. 매끄러운 항은 그 변수 하나를 기저 여러 개로 펼쳐 넣으므로 효과가 그 여러 열에 흩어진다. 기저가 열 개면 그 변수의 효과가 열 줄에 나뉘어 적히고, 표의 한 행은 그 가운데 하나일 뿐이어서 어느 행도 효과를 혼자 담지 못한다. 흩어진 것을 다시 모아 곡선으로 그리면 그 오르내림이 \(2.1074\) 가 되는 것이다.
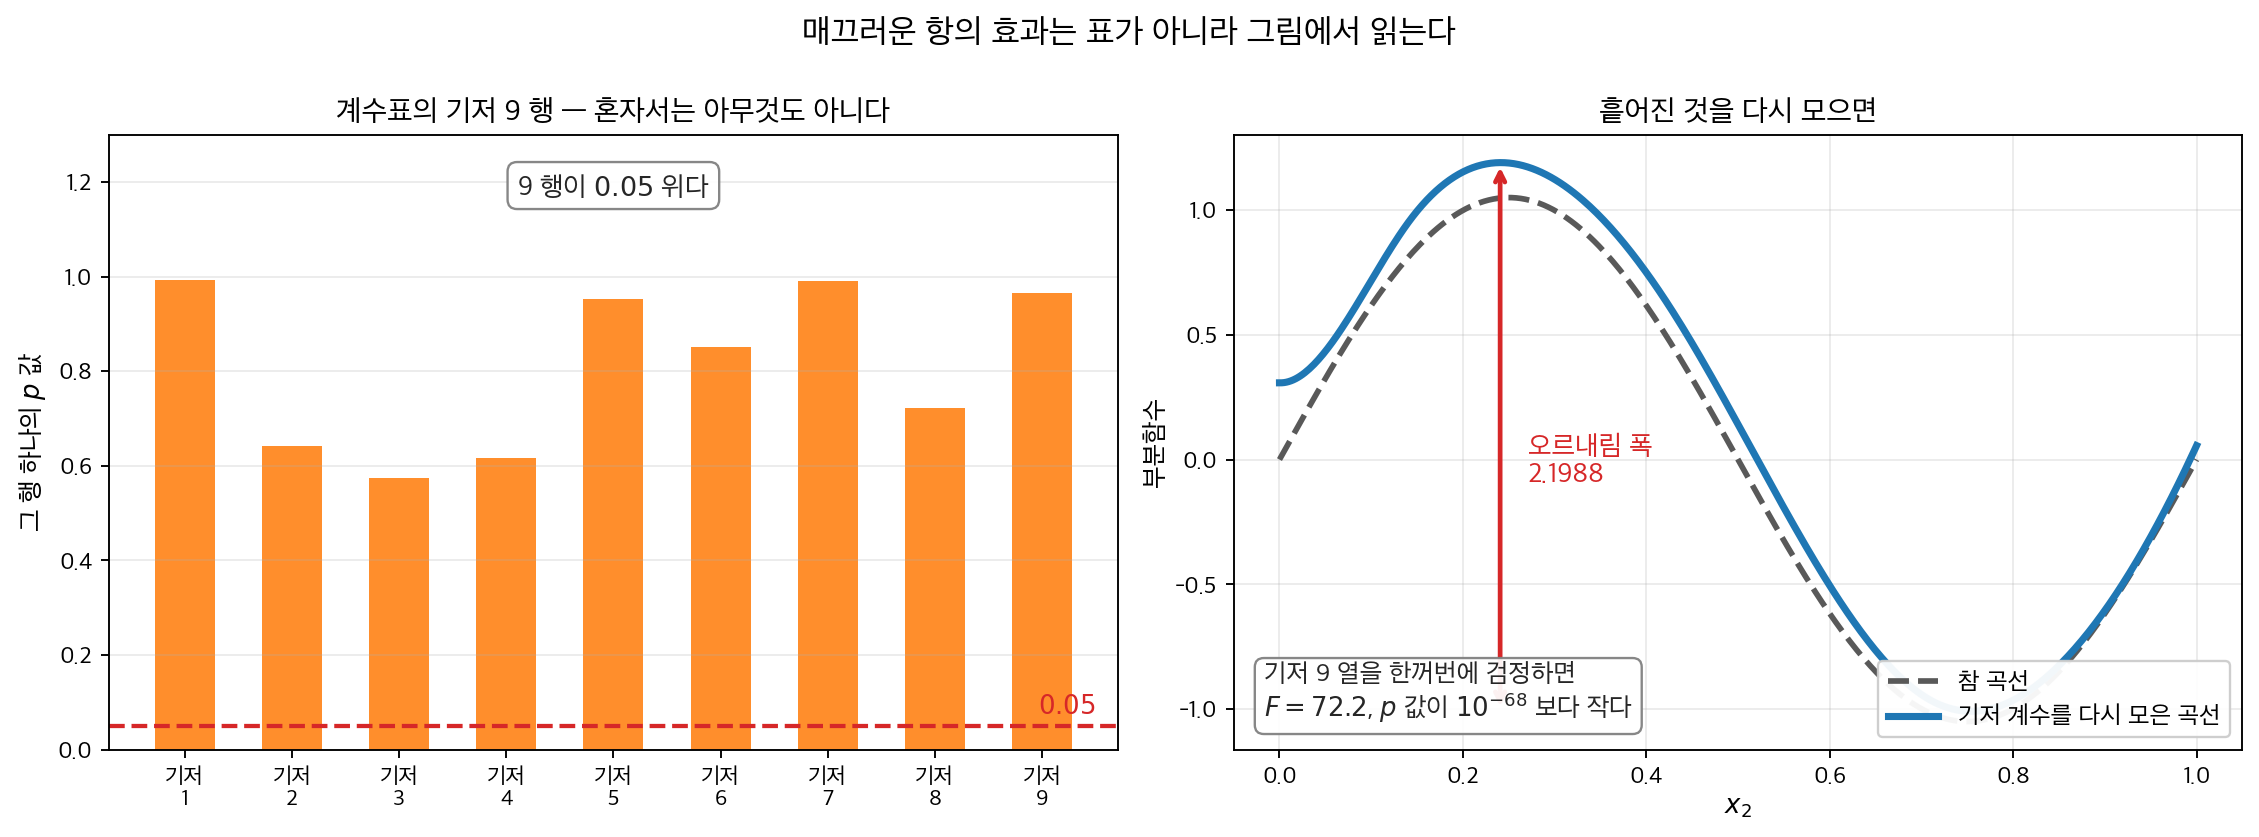
이 책이 만든 자료에서 같은 일이 일어난다. 왼쪽. 매끄러운 항을 기저 아홉 열로 펼쳐 넣으면 계수표의 아홉 행이 모두 \(0.05\) 위다(가장 작은 \(p\) 값이 \(0.57\)). 어느 행도 효과를 혼자 담지 못하기 때문이다. 오른쪽. 그 아홉 계수를 다시 모아 곡선으로 그리면 참 곡선을 되찾고 오르내림 폭이 \(2.1988\) 이다. 같은 아홉 열을 한꺼번에 검정하면 \(F = 72.2\) 로 \(p\) 값이 \(10^{-68}\) 보다 작다. 표의 한 행을 보고 변수를 빼면 주역을 빼는 것이고, 묻고 싶으면 그 변수에 딸린 기저 전체를 함께 물어야 한다.
그래서 매끄러운 항의 효과는 표가 아니라 그림에서 읽는다. GAM 의 출력에서 표보다 그림이 먼저인 까닭이 그것이다. 변수를 훑으며 부분함수를 그려 그 오르내림을 보는 것이고, 유의성을 묻고 싶으면 그 변수에 딸린 기저 전체를 한꺼번에 검정해야 한다. 그러면 GAM 의 계수표는 무엇을 읽는 표이고, 한 변수의 효과는 어디서 읽어야 하는가. 아래 상자 둘이 그 모형을 푸는 셈법과, 같은 생각이 「몇 시에 가장 붐비는가」를 배우는 자리에서 어떻게 쓰이는지를 따라간다.
확인한 곳 — 이 쪽 「돌아가며 푸는 셈법」·「「몇 시에 가장 붐비는가」를 기계가 배우는 법」 상자와 그 출처 줄
일반화가법모형(generalized additive model, GAM)은 선형 관계를 가정하는 대신 설명변수(explanatory variable)의 매끄러운 비모수(nonparametric) 함수를 허용하여 선형회귀(linear regression)를 확장한다. GAM은 경직된 선형모형과 신경망 같은 지나치게 복잡한 블랙박스 방법 사이에서 유연한 중간 지대를 제공한다.
GAM의 핵심 혁신은 해석 가능성을 유지하면서 선형항을 매끄러운 함수로 대체하는 것이다.
선형회귀:
일반화가법모형:
여기서 각 \(f_j\)는 자료에서 학습한 매끄러운 함수(보통 스플라인)이다.
1. 왜 GAM을 쓰는가
GAM은 선형회귀의 여러 한계에 대처한다.
-
비선형 관계 — 현실의 많은 관계는 굽어 있다. GAM은 다항 차수를 손으로 지정하지 않고도 이를 자동으로 포착한다.
-
변수마다 다른 매끄러움 — 각 설명변수가 벌점 모수(람다)로 조절되는 자기만의 평활 정도를 가질 수 있다.
-
해석 가능성 — 신경망과 달리 각 매끄러운 함수 \(f_j(X_j)\)를 개별적으로 시각화하고 해석할 수 있다. 가법 구조 덕분에 기본적으로 효과들이 서로 얽히지 않는다.
-
자동 과적합(overfitting) 통제 — 정칙화가 유연성을 유지하면서도 매끄러운 함수의 허위 요동을 막는다.
-
불확실성 수량화 — 나무 기반 방법과 달리 GAM은 표준오차를 통해 예측 주위의 신뢰대를 제공한다.
2. 수학적 정식화
기본 GAM
연속형 반응변수에 대한 정규 GAM은
스플라인을 이용한 매끄러운 함수
매끄러운 함수 \(f_j\)는 보통 기저함수들의 선형결합으로 표현된다.
여기서
- \(b_{jk}\)는 기저함수(예: B-스플라인, 박판 스플라인(thin plate spline)),
- \(c_{jk}\)는 자료에서 학습한 계수,
- \(K_j\)는 변수 \(j\)의 기저함수 개수이다.
정칙화: 벌점 추정
유연성을 허용하면서 과적합을 피하기 위해 GAM은 거칢 벌점을 쓴다.
여기서
- 첫째 항은 잔차제곱합을 \(n\) 으로 나눈 평균 잔차제곱이고,
- \(\lambda_j\)는 \(j\)번째 함수의 매끄러움을 조절한다. \(\lambda_j\)가 클수록 더 매끄러운(덜 요동치는) 함수가 된다.
- 적분항은 "거칢"(2계 도함수의 제곱)을 잰다.
자유도와 유효 자유도
자유도가 모수의 개수와 같은 선형회귀와 달리, GAM은 매끄러움 벌점을 반영한 유효 자유도(effective degrees of freedom, eDoF)를 갖는다.
여기서 \(S_j\)는 기저와 벌점에 의존하는 행렬로, 관측값 벡터에 곱하면 \(j\) 번째 항의 적합값을 내는 평활자 행렬이다(선형회귀의 모자행렬에 해당하고, \(\text{tr}\) 은 대각합이다). 모형 전체의 복잡도는
이 덕분에 전통적인 모수 개수 대신 eDoF를 써서 선형회귀와 같은 기준(AIC, BIC)으로 모형을 비교할 수 있다.
3. GAM 적합: 역적합 알고리즘
가장 흔한 적합 방법은 반복적 알고리즘인 역적합(backfitting)이다.
-
초기화: 모든 \(j\)에 대해 \(\hat{f}_j^{(0)} = 0\), 그리고 \(\hat{\beta}_0 = \bar{y}\)
-
반복 \(t\)에서 다음을 한다.
-
각 \(j = 1, 2, \ldots, p\)에 대해 차례로 다음을 한다.
- 부분잔차를 계산한다: \(r_{-j} = y - \hat{\beta}_0 - \sum_{k \neq j} \hat{f}_k(X_k)\)
- 벌점 \(\lambda_j\)로 \((X_j, r_{-j})\)에 매끄러운 함수를 적합한다: \(\hat{f}_j^{(t)} = S(r_{-j} | X_j, \lambda_j)\)
-
수렴할 때까지(계수가 안정될 때까지) 반복한다.
이 방법은 적합 문제를 일변량 평활 문제들로 분해하므로, 고차원 비모수 함수를 직접 적합하는 것에 비해 GAM의 계산이 훨씬 가벼워진다.
한 좌표는 한 바퀴에 한 번만 푼다
위 절차를 읽을 때 걸리기 쉬운 자리가 있다. \(j\) 를 고정한 채 그 \(f_j\) 를 여러 번 되풀이해 고치는 것이 아니다. 안쪽 반복은 없다. 고리가 둘이고, 되풀이되는 것은 바깥쪽뿐이다.
되풀이 t = 1, 2, 3, ...                        <- 수렴할 때까지
    각 j = 1 ... p 에 대해                      <- 한 바퀴, 좌표마다 꼭 한 번
        부분잔차 r_{-j} 를 만든다
        f_j <- S(r_{-j} | X_j, lambda_j)        <- 한 번 풀고 넘어간다
수렴 판정: 한 바퀴 전과 견주어 변화가 작으면 멈춘다
까닭은 간단하다. 같은 좌표를 곧바로 다시 풀면 똑같은 답이 나온다. 평활자 \(S\) 가 돌려주는 것은 「\(f_j\) 쪽으로 한 걸음」이 아니라 다른 함수를 고정했을 때의 최소점 그 자체이고, 방금 그 자리에 가 있으므로 \(r_{-j}\) 가 한 치도 바뀌지 않았다. 안쪽 반복은 아무 일도 하지 않는다.
그렇다면 왜 바깥을 또 도는가. \(f_j\) 를 정확히 맞추는 일이 다른 좌표의 최적성을 깨기 때문이다. \(x_1\) 을 고치면 \(x_2\) 가 설명했어야 할 몫까지 가져가고, 다음 차례에 \(x_2\) 를 고치면 그것을 도로 빼앗는다. 좌표들이 서로 직교할 때만 한 바퀴로 끝난다. 아래 상자의 \(\rho\) 표가 그 값을 수로 보인 것이다 — 바퀴 수 \(7\) 과 \(787\) 의 차이는 좌표들이 얼마나 비스듬한가 하나로 정해진다.
경사하강이 아니다
이 꼴에는 이름이 있다. 블록 가우스–자이델, 요즘 말로는 블록 좌표하강이다. 경사하강과는 다음이 다르다.
| 경사하강 | 역적합(좌표하강) | |
|---|---|---|
| 한 번의 갱신 | \(\theta \leftarrow \theta - \eta\nabla L\), 방향으로 조금 간다 | 그 블록에서 정확히 최소화한다 |
| 걸음 크기 | \(\eta\) 를 골라야 한다 | 없다 |
| 수렴 속도를 정하는 것 | 조건수와 \(\eta\) | 좌표들 사이의 기울어짐(상관) |
걸음 크기가 아예 없다는 것이 요점이다. 그래서 고를 것이 없고, 대신 몇 바퀴를 돌지를 자료가 정한다. 같은 꼴을 계수 하나하나에 쓰는 것이 18.3절 좌표하강 알고리즘이다. 거기서는 평활자 자리에 연성 임계화 \(S_\lambda(z_j)\) 가 들어가고 — 그것도 닫힌 꼴이라 한 번에 푼다 — 수렴 성질의 증명(쳉의 정리)과 등고선 위의 계단 경로 그림이 함께 있다.
경사하강에 정말로 가까운 사촌은 따로 있다. 성분별 경사부스팅이 그것이다. 한 바퀴에 성분 하나를 골라 음의 기울기(곧 잔차)에 맞추고, 거기에 \(\nu\) 를 곱해 조금만 더한다. 둘의 차이는 한 낱말이다 — 역적합은 \(f_j\) 를 갈아치우고, 부스팅은 보탠다(그리고 보탠 것을 되가져오지 않는다).
EM 알고리즘과는 어떤 사이인가
역적합과 EM 은 둘 다 「일부를 고정하고 나머지를 고친다」는 꼴이라 닮아 보이지만 원리가 다르다. EM 은 숨은 변수가 있을 때의 최대가능도 셈법이고, 기댓값 단계와 최대화 단계라는 서로 다른 두 일을 번갈아 한다. 역적합에는 숨은 변수도 기댓값 단계도 없다 — 한 목적함수의 좌표를 돌아가며 정확히 최소화할 뿐이다.
다만 한 다리가 있다. 벌점 스플라인은 혼합모형으로 다시 적을 수 있고, 그때 \(f_j\) 의 굽은 부분이 분산 \(\sigma^2/\lambda_j\) 인 확률효과가 된다. 확률효과는 바로 EM 이 겨냥하는 숨은 변수이므로, 그 꼴로 옮겨 놓으면 평활 모수를 EM 으로 추정할 수 있다. 곧 GAM 을 EM 으로 적합할 수는 있지만, 평활 문제를 숨은 변수 문제로 바꾸어 놓은 뒤의 이야기다. 보통의 GAM 적합은 역적합이거나 벌점 IRLS(반복재가중최소제곱, iteratively reweighted least squares)다.
닫힌 꼴이 없어서 도는 것이 아니다
「다항회귀는 닫힌 꼴로 풀리는데 GAM 은 그렇지 않아서 반복한다」고 읽기 쉽다. 절반만 맞는 말이다. 가우스 반응에 기저를 고정하고 \(\lambda_j\) 까지 못 박으면 가법모형에도 닫힌 꼴이 있다. 목적함수가 여전히 이차식이므로
로 한 번에 떨어진다 — 능형회귀(ridge regression)와 같은 꼴이다. 아래 상자가 그 증거를 들고 있다. 항을 모두 일차식으로 두었을 때 역적합이 수렴한 자리가 최소제곱해와 정확히 같다는 것은, 역적합이 닫힌 꼴이 있는 연립방정식을 반복으로 풀고 있다는 말이기 때문이다. 행렬을 뒤집는 대신 가우스–자이델을 돌리는 것과 같다.
닫힌 꼴을 정말로 잃는 자리는 따로 있다.
| 닫힌 꼴 | 까닭 | |
|---|---|---|
| 다항회귀 | 있다 | 모수에 대해 선형이라 \(X, X^2, \ldots, X^d\) 를 열로 쌓으면 그냥 OLS 다 |
| 회귀 스플라인(기저 고정) | 있다 | 기저만 바뀐 같은 이야기다 |
| 가법모형 · 가우스 · \(\lambda\) 고정 | 있다 | 위의 벌점최소제곱 |
| 비정규 반응(로지스틱·포아송) | 없다 | 가능도가 이차식이 아니다 → 벌점 IRLS |
| \(\lambda\) 를 자료에서 고르기 | 없다 | GCV·REML 은 바깥쪽 비선형 최적화다 |
| 연산자로 주어진 평활자 | 없다 | 국소회귀처럼 쌓아서 뒤집을 \(\mathbf X\) 가 아예 없다 |
그러니 다항회귀와 GAM 을 가르는 것은 풀 수 있느냐가 아니라 무엇을 미리 매어 두느냐다. 다항회귀는 차수 \(d\) 짜리 전역 모양 하나에 매인다 — 그 대가가 13.5절 다항회귀의 룽게 그림이고, 차수를 올릴수록 양 끝에서 오차가 터진다. GAM 이 미리 매이는 것은 가법성뿐이고, 각 \(f_j\) 의 모양은 자료가 정한다. 얼마나 굽을 수 있는지를 \(2\) 절의 벌점항 \(\sum_j \lambda_j \int [f_j'']^2\) 이 조인다.
그렇다면 닫힌 꼴이 있는 자리에서도 왜 역적합을 도는가. 값과 너비 때문이다. \(p\) 차원 문제 하나를 일변량 평활 \(p\) 개로 쪼개 한 바퀴를 싸게 만들고, 기저 표현이 아예 없는 평활자에도 그대로 쓸 수 있다. 다만 단서가 붙는다 — 분해는 한 바퀴를 싸게 만들 뿐 몇 바퀴를 돌지는 정해 주지 않고, 그 바퀴 수를 정하는 것은 알고리즘이 아니라 설명변수들끼리의 관계다.
그림으로 보는 통계학 1. 돌아가며 푸는 셈법
위 세 줄짜리 절차에는 이름이 붙어 있고, 그 이름이 붙은 자리에 사람이 있다. \(1986\) 년에 트레버 해스티와 로버트 팁시라니가 『Statistical Science』 창간 이듬해 호에 「Generalized Additive Models」를 실으면서 이 꼴을 정리했다. 그 앞에는 레오 브레이먼과 제롬 프리드먼이 한 해 전 『JASA』에 실은 ACE 가 있었는데, 거기서도 한 번에 한 변수씩 돌아가며 고치는 같은 몸짓이 쓰였다.
셈법 자체는 「한 번에 하나씩」이 전부다. 그런데 그것이 왜 값싼지, 그리고 언제 값이 오르는지는 재어 보아야 보인다. 항을 모두 일차식으로 두면 좋은 시험대가 된다 — 역적합이 수렴한 자리가 최소제곱해와 정확히 같아지므로, 남는 물음이 「몇 바퀴 도는가」 하나로 줄기 때문이다.
관측 \(400\) 개에 항 셋, 설명변수끼리의 상관을 \(\rho\) 로 두고 최대 차이가 \(10^{-10}\) 아래로 갈 때까지 돌렸다.
| \(\rho\) | 바퀴 수 | 처음 세 바퀴의 최대 차이 |
|---|---|---|
| \(0\) | \(\mathbf{7}\) | \(1.4\times10^{-1}\), \(4.2\times10^{-3}\), \(1.2\times10^{-4}\) |
| \(0.3\) | \(14\) | \(2.6\times10^{-1}\), \(8.8\times10^{-2}\), \(1.7\times10^{-2}\) |
| \(0.6\) | \(32\) | \(5.5\times10^{-1}\), \(2.6\times10^{-1}\), \(1.6\times10^{-1}\) |
| \(0.9\) | \(151\) | \(9.2\times10^{-1}\), \(8.0\times10^{-1}\), \(6.9\times10^{-1}\) |
| \(0.98\) | \(\mathbf{787}\) | \(1.08\), \(1.05\), \(1.03\) |
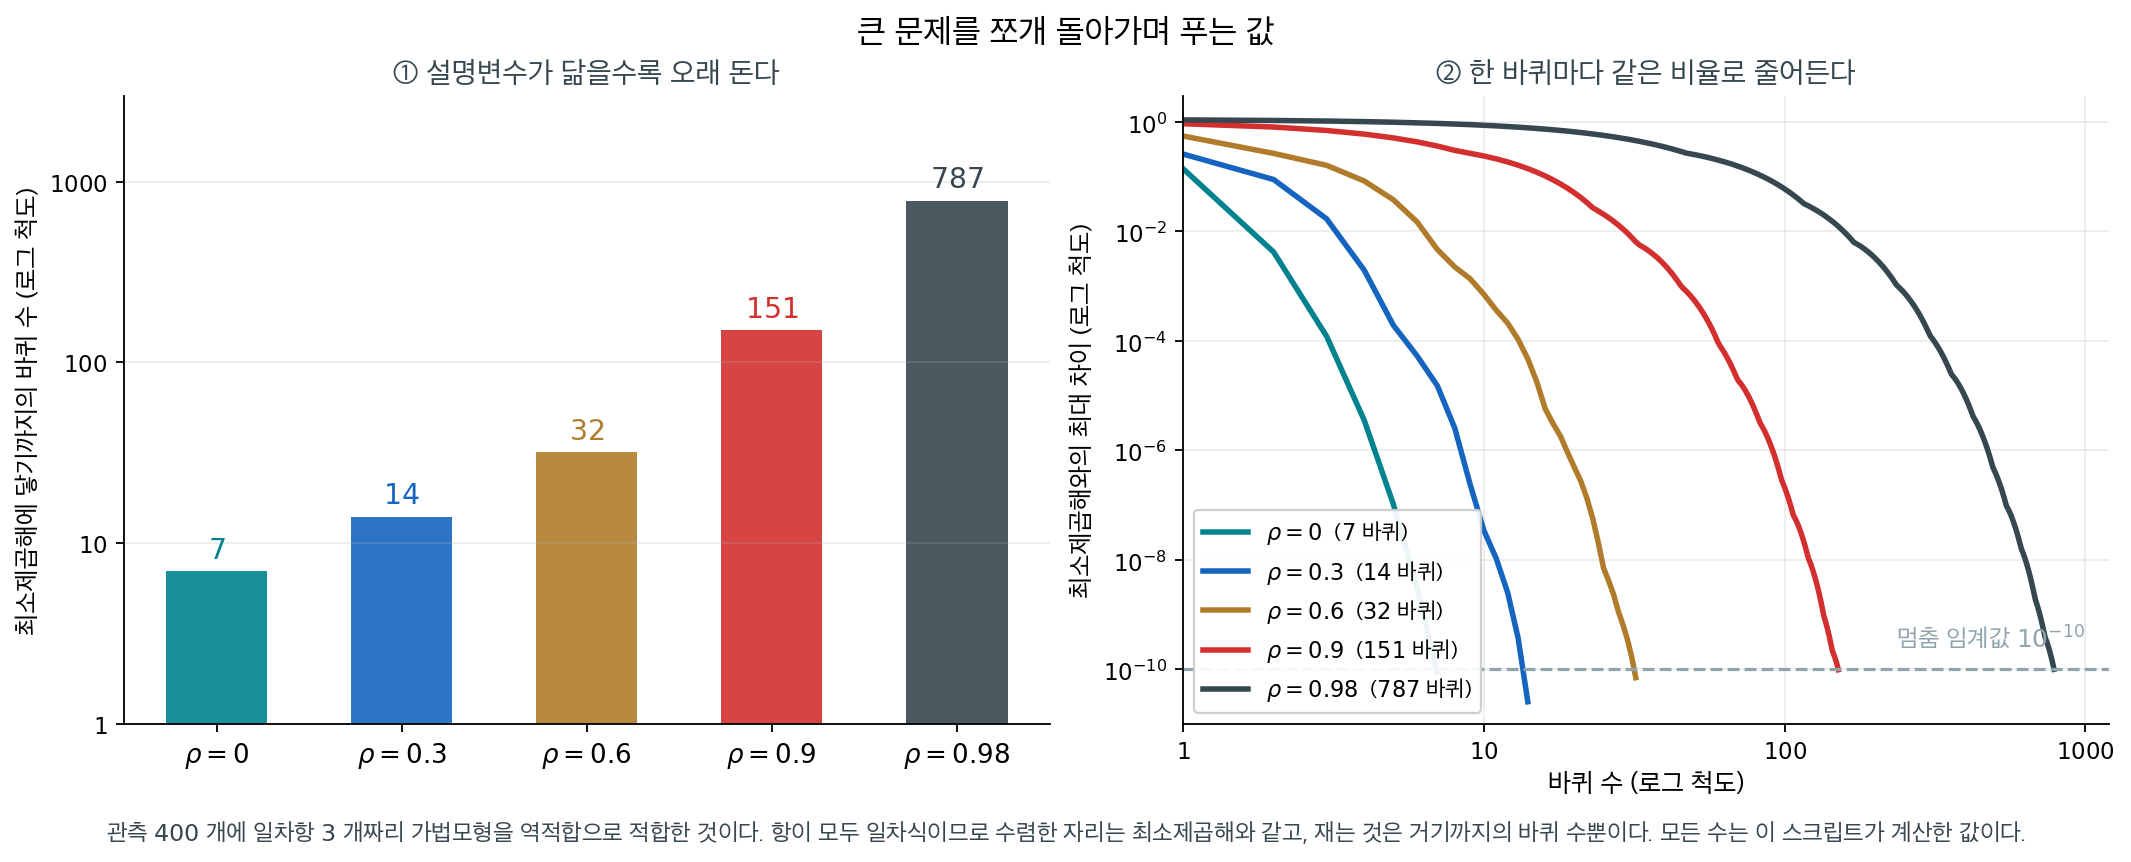
설명변수가 서로 무관하면 일곱 바퀴면 끝난다. 한 바퀴마다 오차가 \(30\) 분의 \(1\) 쯤으로 줄기 때문이다. 상관이 \(0.98\) 이면 같은 답에 닿는 데 \(787\) 바퀴가 든다 — 한 바퀴가 지우는 몫이 \(3\%\) 밖에 안 된다. 오른쪽 판에서 다섯 곡선의 기울기가 다르다는 것이 그 이야기다.
까닭은 13.7절 다중공선성에서 본 그 사정이다. \(x_1\) 을 고칠 때 쓰는 부분잔차에는 \(x_2\) 가 설명했어야 할 몫이 섞여 있고, 다음 차례에 \(x_2\) 를 고치면 방금 \(x_1\) 이 가져간 것을 도로 빼앗는다. 둘이 닮을수록 그 주고받기가 길어진다. 가법모형에서는 이것을 공선성의 비선형 판본이라는 뜻으로 따로 부르기도 한다.
그러니 「적합 문제를 일변량 평활 문제들로 분해한다」는 윗 문장에는 값표가 붙어 있다. 분해는 한 바퀴를 싸게 만들지만 몇 바퀴를 돌지는 정해 주지 않고, 그 바퀴 수를 정하는 것은 알고리즘이 아니라 설명변수들끼리의 관계다.
확인한 곳 — 트레버 해스티·로버트 팁시라니, 「Generalized Additive Models」, 『Statistical Science』 \(1\) 권 \(3\) 호(\(1986\) 년 \(8\) 월) \(297\)–\(310\) 쪽과 레오 브레이먼·제롬 H. 프리드먼, 「Estimating Optimal Transformations for Multiple Regression and Correlation」, 『Journal of the American Statistical Association』 \(80\) 권 \(391\) 호(\(1985\) 년 \(9\) 월) \(580\)–\(598\) 쪽의 서지는 Crossref 의 기록에서 확인했다. 두 논문의 본문은 읽지 못했으므로 누가 무엇을 먼저 했는지는 적지 않는다 · 위 표와 그림의 수는 모두 직접 계산한 값이다
4. 매끄러운 항의 종류
선형항
선형항은 다음과 같이 포함된다.
매끄러움 벌점이 없으며, 관계가 정말로 선형일 때 유용하다.
스플라인 항 (s)
기저함수로 표현하고 목적함수에 매끄러움 벌점을 더한다. 기저를 어떻게 세우는지는 앞 절 Patsy를 이용한 스플라인이 B-스플라인과 자연 스플라인으로 세웠다. 여기서는 그 기저를 설명변수마다 하나씩 쓰는 것이 달라진 점이다.
함수 자체는 기저함수의 선형결합이고 벌점은 함수의 일부가 아니라 목적함수에 더해지는 항이라는 점에 유의하라.
흔한 선택은 이렇다.
- 삼차 B-스플라인: 매끄럽고 국소 지지를 가지며 계산이 효율적이다.
- 박판 스플라인: 매끄러움의 의미에서 최적이지만 계산 비용이 크다.
df(자유도) 인자가 유연성을 조절한다. df가 클수록 더 많은 요동을 허용한다.
순환 스플라인
주기적 자료(예: 하루 중 시각, 요일)에는 순환 스플라인이 \(f(0) = f(1)\)(또는 적절한 경계 조건)을 강제한다.
AI로 보는 통계학 1. 「몇 시에 가장 붐비는가」를 기계가 배우는 법
삼각함수의 합성 공식은 \(a\sin x+b\cos x\) 가 언제나 하나의 사인이고 그 진폭이 \(\sqrt{a^{2}+b^{2}}\) 라고 말한다. 순환 스플라인을 쓰기 전에 가장 먼저 떠올리는 가장 작은 순환 기저가 이 공식 위에 서 있다.
가게의 손님 수를 시각으로 예측한다고 하자. 「몇 시」를 그냥 \(0\) 부터 \(23\) 까지의 수로 넣으면 탈이 난다. \(23\) 시와 \(0\) 시는 한 시간 차이인데 수로는 가장 멀리 떨어져 버리기 때문이다. 그래서 시각 \(h\) 를 각 \(\theta=\dfrac{2\pi h}{24}\) 로 바꾼 뒤 두 수의 짝 \((\sin\theta,\ \cos\theta)\) 로 적어 넣는다. 이러면 \(23\) 시와 \(0\) 시가 원 위에서 이웃이 된다. 위의 \(f(0)=f(1)\) 을 기저 두 개로 공짜로 얻는 셈이다.
그런데 짝으로 넣는 데에는 더 중요한 까닭이 있다. 모델이 그다음에 하는 일은 이 두 수에 무게 \(a\), \(b\) 를 곱해 더하는 것뿐인데, 합성 공식에 따르면 그 결과가
이므로 \(a\) 와 \(b\) 두 개만 고르면 진폭과 봉우리의 자리를 마음대로 정할 수 있다. 「오후 세 시에 가장 붐빈다」든 「새벽 네 시에 가장 한산하다」든, 두 수를 조절하는 것만으로 모두 표현된다. \(\sin\) 하나만 넣었다면 봉우리가 한 자리에 못박혀 아무것도 못 맞춘다.
오후 세 시가 가장 붐비는 가게의 자료를 주고, 모델이 그것을 알아내는지 보자.
import numpy as np

# 하루 24 시간을 각으로 바꾸어 (sin, cos) 두 수로 적는다
h = np.arange(24)
ang = 2 * np.pi * h / 24
X = np.c_[np.sin(ang), np.cos(ang)]              # 각 시각의 두 성분

# 「오후 3 시에 가장 붐빈다」는 실제 수요 (진폭 40, 바탕 100)
peak = 15
y = 100 + 40 * np.cos(ang - 2 * np.pi * peak / 24)

w, *_ = np.linalg.lstsq(np.c_[X, np.ones(24)], y, rcond=None)   # 일차결합으로 맞추기
a, b, c0 = w

r = np.hypot(a, b)                               # 합성 공식의 r = √(a²+b²)
phi = np.arctan2(b, a)                           # 합성 공식의 φ
best = ((np.pi / 2 - phi) % (2 * np.pi)) / (2 * np.pi) * 24   # sin(x+φ)=1 인 자리

print(f"맞춘 계수 a, b        : {a:.3f}, {b:.3f}")
print(f"진폭 r = √(a²+b²)     : {r:.3f}   (참값 40)")
print(f"가장 큰 값이 되는 시각 : {best:.2f} 시   (참값 {peak} 시)")
print(f"최대·최소            : {c0 + r:.1f} / {c0 - r:.1f}")
실행하면 다음이 나온다.
맞춘 계수 a, b        : -28.284, -28.284
진폭 r = √(a²+b²)     : 40.000   (참값 40)
가장 큰 값이 되는 시각 : 15.00 시   (참값 15 시)
최대·최소            : 140.0 / 60.0
모델이 배운 것은 \(a=b=-28.284\) 라는 수 두 개뿐이다. 그런데 합성 공식으로 읽으면 그 둘이 진폭 \(40\) 과 봉우리 \(15\) 시를 그대로 담고 있다. \(\sqrt{a^{2}+b^{2}}\) 가 진폭이고, \(\sin(\theta+\varphi)=1\) 이 되는 자리가 봉우리다. 넷째 줄의 최대·최소 \(140\) 과 \(60\) 도 바탕 \(100\) 에 \(\pm\sqrt{a^{2}+b^{2}}\) 를 한 것이니, 합성 공식 그대로다.
다만 이 짝 하나로 표현할 수 있는 것은 봉우리가 하루에 하나뿐인 모양이다. 점심과 저녁에 두 번 붐비는 가게라면 \(\sin\theta\), \(\cos\theta\) 만으로는 어떻게 해도 맞출 수 없다. 그럴 때는 \(\sin2\theta\), \(\cos2\theta\) 처럼 각이 두 배인 짝을 더 넣어야 하는데, 각이 다른 항은 합성 공식으로 합쳐지지 않으므로 봉우리가 둘인 곡선이 비로소 만들어진다. 「각의 계수가 같아야 합성할 수 있다」가 여기서는 표현할 수 있는 모양의 한계로 나타나는 셈이다. 짝을 몇 개까지 넣어야 하는지를 손으로 정하지 않고 자유도 하나로 맡기는 것이 바로 위의 순환 스플라인이다.
5. 아는 답으로 맞춰 보기
참 모형이 \(y = \sin(x_0) + 0.5\,x_1 + \varepsilon\) 이고 \(x_2\) 는 무관한 인공자료를 쓴다. 답을 알고 만든 자료이므로 GAM 이 그 답을 되찾아 오는지를 직접 잴 수 있다. 같은 자료를 두 번 적합하는데, 한 번은 계수표를 읽기 위해서이고 한 번은 부분의존도 곡선을 보기 위해서다.
계수표를 읽기
statsmodels.gam 모듈이 GAM 적합을 제공한다.
보기 1. statsmodels로 GAM 적합. 참 모형이 \(y = \sin(x_0) + 0.5\,x_1 + \varepsilon\) 이고 \(x_2\) 는 무관한 인공자료에 GAM 을 적합한다. 답을 아는 자료이므로 복원 능력을 직접 재 볼 수 있다.
(1) df=[10, 3, 3]이 만드는 기저 열의 개수와 계수표의 행 개수를 세시오. 그 가운데 개별적으로 식별되지 않는 행은 몇 개인가.
(2) 세 부분함수 \(f_0, f_1, f_2\) 를 계수표에서 복원하여 참 함수 \(\sin(x_0)\), \(0.5\,x_1\), \(0\) 과 견주시오. 계수 하나하나를 읽는 것과 합쳐서 읽는 것이 어떻게 다른지 수로 보이시오.
풀이
(1) 해석적으로. BSplines 는 변수마다 df\(_j\) 개의 기저함수를 만든 뒤 절편(intercept)과 겹치지 않게 한 열을 버린다. 그러므로
열이다. 식 y ~ x0 + x1 + x2 가 절편 \(1\) 개와 선형항 \(3\) 개를 더 놓으므로 계수표의 행은
개다.
그런데 선형항 세 개는 식별되지 않는다. 변수 \(j\) 의 기저 \(\mathrm{df}_j - 1\) 열에 절편을 돌려주면 그 변수의 기저 전체가 치는 공간(기저의 선형결합 전체, 곧 생성공간)이 복원되고, 차수 \(d \ge 1\) 인 B-스플라인 기저는 일차함수를 품는다. 곧 \(x_j\) 열이 이미 그 공간 안에 있다. 따라서
이고, Df Model 은 \(14 - 1 = 13\) 으로 보고될 것이다.
실질적인 결론은 이렇다. x0, x1, x2 행의 계수는 그 자체로 아무 뜻이 없다. 같은 적합값을 주는 계수 조합이 무한히 많고, 소프트웨어가 그 가운데 하나(최소노름 해)를 골라 보여 줄 뿐이다. 뜻을 갖는 것은 선형 행과 기저 행을 합친 부분함수다.
(2) 부분함수를 복원한다. 변수 \(j\) 의 부분함수는
이다. 가법모형이므로 각 \(f_j\) 는 상수만큼 자유롭다(\(f_1\) 에 \(c\) 를 더하고 절편에서 \(c\) 를 빼면 같은 모형이다). 그러므로 참 함수와 견줄 때는 중심을 맞추고 비교해야 한다.
import numpy as np
import pandas as pd
from statsmodels.gam.api import GLMGam, BSplines
import matplotlib.pyplot as plt

# 참 모형은 x0 에 대해 sin, x1 에 대해 선형, x2 는 무관하다.
# GAM 이 이 구조를 그대로 찾아내는지 보는 것이 목표다.
n = 500
np.random.seed(42)
X = np.random.uniform(0, 10, (n, 3))
y = (np.sin(X[:, 0]) + 0.5 * X[:, 1] + np.random.normal(0, 0.5, n))

df = pd.DataFrame({
    'y': y,
    'x0': X[:, 0],
    'x1': X[:, 1],
    'x2': X[:, 2]
})

# 변수마다 기저의 자유도를 달리 준다. 굽은 관계가 있으리라 보는 x0 에만
# 자유도 10 을 주고 나머지는 3 으로 묶었다. 자유도가 클수록 유연하지만
# 그만큼 잡음까지 따라갈 위험이 커진다.
x_spline = df[['x0', 'x1', 'x2']]
bs = BSplines(x_spline, df=[10, 3, 3], degree=[3, 2, 2])

formula = 'y ~ x0 + x1 + x2'
gam = GLMGam.from_formula(formula, data=df, smoother=bs)
results = gam.fit()

# summary()는 실행 날짜와 시각을 함께 찍으므로 계수 표만 인쇄한다.
print(results.summary().tables[1])
출력:
==============================================================================
                 coef    std err          z      P>|z|      [0.025      0.975]
------------------------------------------------------------------------------
Intercept      0.2502      0.214      1.167      0.243      -0.170       0.670
x0            -0.0018      0.027     -0.069      0.945      -0.054       0.051
x1             0.4849      0.009     51.797      0.000       0.467       0.503
x2            -0.0111      0.010     -1.169      0.242      -0.030       0.008
x0_s0          0.4820      0.363      1.327      0.185      -0.230       1.194
x0_s1          1.6651      0.201      8.277      0.000       1.271       2.059
x0_s2         -0.2072      0.211     -0.983      0.325      -0.620       0.206
x0_s3         -1.3892      0.162     -8.567      0.000      -1.707      -1.071
x0_s4         -0.5957      0.148     -4.031      0.000      -0.885      -0.306
x0_s5          0.9795      0.150      6.533      0.000       0.686       1.273
x0_s6          1.1175      0.199      5.607      0.000       0.727       1.508
x0_s7         -0.4096      0.226     -1.813      0.070      -0.852       0.033
x0_s8         -0.5315      0.168     -3.165      0.002      -0.861      -0.202
x1_s0          0.0208      0.120      0.174      0.862      -0.214       0.255
x1_s1          0.0372      0.059      0.630      0.529      -0.079       0.153
x2_s0         -0.2041      0.119     -1.722      0.085      -0.436       0.028
x2_s1          0.0997      0.059      1.704      0.088      -0.015       0.214
==============================================================================
이제 (1)의 셈을 확인하고 부분함수를 복원한다.
print("변수별 기저 열 =", [sm_.basis.shape[1] for sm_ in bs.smoothers], " 합", bs.basis.shape[1])
X_all = np.asarray(gam.exog)
print(f"설계행렬 열 {X_all.shape[1]},  rank {np.linalg.matrix_rank(X_all)}")
print(f"Df Model = {results.df_model:.2f},  계수표의 행 = {len(results.params)}")

p = results.params

def partial(j, name, n_basis):
    """선형 행 하나와 기저 행 몇 개를 합쳐 부분함수를 복원한다."""
    grid = np.linspace(df[name].min(), df[name].max(), 300)
    B = bs.smoothers[j].transform(grid)
    coefs = np.array([p[f'{name}_s{k}'] for k in range(n_basis)])
    return grid, p[name] * grid + B @ coefs

g1, f1 = partial(1, 'x1', 2)
slope, icpt = np.polyfit(g1, f1, 1)
print(f"f1 의 기울기 = {slope:.4f}  (참값 0.5),  직선에서 벗어난 최대량 = {np.abs(f1 - (slope * g1 + icpt)).max():.4f}")
print(f"x1 행의 계수만 = {p['x1']:.4f},  95% 신뢰구간 = {results.conf_int().loc['x1'].round(4).tolist()}")

g0, f0 = partial(0, 'x0', 9)
c = (f0 - np.sin(g0)).mean()
print(f"f0 를 sin 과 견주면: 중심차 {c:.4f},  중심 맞춘 뒤 최대 오차 {np.abs(f0 - np.sin(g0) - c).max():.4f}")
print(f"x0 행의 계수만 = {p['x0']:.4f}")

g2, f2 = partial(2, 'x2', 2)
print(f"오르내림의 폭:  f0 {f0.max() - f0.min():.4f}   f1 {f1.max() - f1.min():.4f}   "
      f"f2 {f2.max() - f2.min():.4f}  (f2 의 참값은 0)")
출력:
변수별 기저 열 = [9, 2, 2]  합 13
설계행렬 열 17,  rank 14
Df Model = 13.00,  계수표의 행 = 17
f1 의 기울기 = 0.4886  (참값 0.5),  직선에서 벗어난 최대량 = 0.0007
x1 행의 계수만 = 0.4849,  95% 신뢰구간 = [0.4665, 0.5032]
f0 를 sin 과 견주면: 중심차 -0.0788,  중심 맞춘 뒤 최대 오차 0.1215
x0 행의 계수만 = -0.0018
오르내림의 폭:  f0 2.1074   f1 4.8522   f2 0.1321  (f2 의 참값은 0)
(1)의 네 수가 모두 맞는다. 기저 열이 변수별로 \(9, 2, 2\) 로 합이 \(13\) 이고, 계수표의 행이 \(17\) 이며, 설계행렬 \(17\) 열의 rank 가 \(14\) 다. 식별되지 않는 행이 유도한 대로 \(3\) 개다. Df Model 도 \(13.00\) 이다.
(2) 부분함수는 참 함수를 잘 되찾았다.
- \(f_1\) 의 기울기가 \(0.4886\) 으로 참값 \(0.5\) 에 가깝다. 직선에서 벗어난 최대량이 \(0.0007\) 이니 곡률을 쓸 수 있었는데도 거의 쓰지 않았다. 자유도 \(3\) 의 이차 스플라인을 주었지만 자료가 직선을 가리켰다는 뜻이다.
- \(f_0\) 는 \(\sin\) 과 중심을 맞춘 뒤 최대 오차가 \(0.1215\) 다. 잡음의 표준편차 \(0.5\) 의 사분의 일이다. 사인 곡선이라고 알려 주지 않았는데 모양이 자료에서 나왔다.
- \(f_2\) 는 참값이 상수인데 오르내림의 폭이 \(0.1321\) 이다. \(0\) 은 아니지만, \(f_1\) 의 폭 \(4.8522\) 와 견주면 \(2.7\%\) 다. 무관한 변수에 자유도를 준 대가로 생긴 잡음이며, 크기로 보아 무해하다.
계수 하나하나를 읽으면 엉뚱해진다. 가장 분명한 자리가 x0 행이다. 계수가 \(-0.0018\), \(p\) 값 \(0.945\) 로 "\(x_0\) 는 쓸모없다" 처럼 보인다. 그러나 \(x_0\) 는 참 모형의 주역이고, 그 효과는 \(f_0\) 의 폭 \(2.1074\) 로 또렷하다. 효과가 x0_s0 부터 x0_s8 까지 아홉 행에 흩어져 있을 뿐이다.
x1 행은 반대로 운이 좋은 경우다. 계수 \(0.4849\) 가 참값 \(0.5\) 에 가깝고 신뢰구간 \([0.4665, 0.5032]\) 가 \(0.5\) 를 덮는다. 그러나 이것을 믿을 근거는 없다. 식별되지 않는 모수이므로 그 값은 소프트웨어가 고른 최소노름 해의 성질이고, 합쳐서 구한 기울기 \(0.4886\) 과도 다르다. 다른 구현을 쓰면 \(0.4849\) 가 아니라 \(0\) 이 나올 수도 있다.
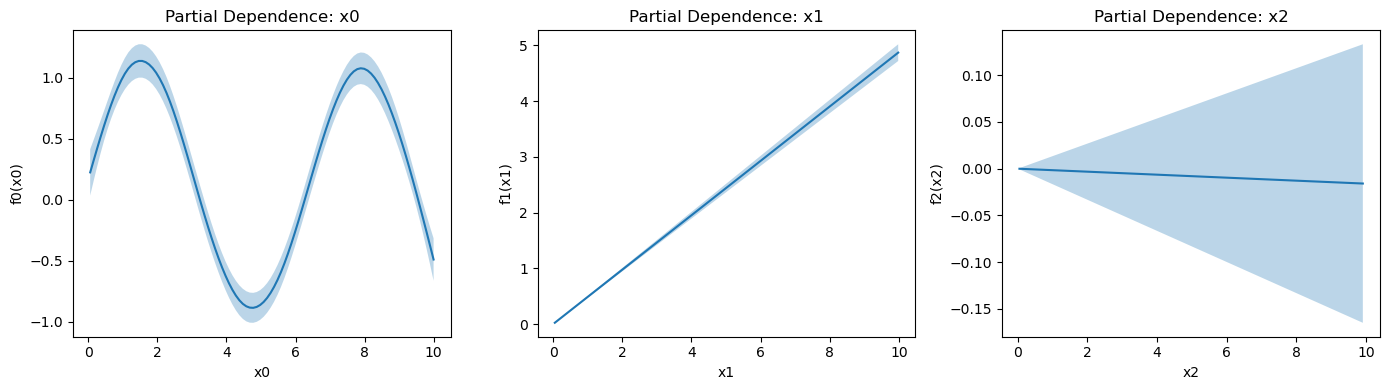
Df Model: 13.00 이 이 GAM 이 쓴 자유도다. 선형 항이었다면 \(1\) 이었을 것이다. 결국 GAM 의 계수는 개별적으로 해석하는 것이 아니라 합쳐서 하나의 곡선으로 읽어야 한다. 보기 2 의 부분의존 그림이 그 읽기를 그림으로 하는 도구다.
부분의존도로 보기
pygam 라이브러리는 격자탐색으로 람다를 자동 선택해 주는 더 친절한 인터페이스를 제공한다.
보기 2. pygam과 부분의존도 그림. 보기 1 과 같은 인공자료에 pygam 으로 GAM 을 적합하고 세 부분의존 곡선을 그린다.
(1) 이 모형의 계수 개수를 세시오. 그리고 참 모형을 안다는 사실만으로 어떤 모형도 넘을 수 없는 \(R^2\) 의 상한을 해석적으로 구하시오.
(2) 요약표의 Pseudo R-Squared와 Scale을 (1)의 상한과 참 모수 \(\sigma = 0.5\) 에 견주시오. 상한을 넘었다면 그것이 왜 모순이 아닌가.
풀이
(1) 계수는 15 개다. s(0, n_splines=12) 가 \(12\) 개, l(1) 과 l(2) 가 각각 \(1\) 개, 절편이 \(1\) 개다.
\(R^2\) 의 상한. 참 모형이
이고 세 변수와 \(\varepsilon\) 이 서로 독립이므로 분산이 그대로 쪼개진다.
둘째 항은 균등분포의 분산이 \((b-a)^2/12\) 이므로
첫째 항은 적분으로 구한다.
이므로
이다. 어떤 모형도 \(\varepsilon\) 을 설명할 수는 없으므로
\(0.9100\) 이 천장이다. 참 함수를 통째로 알고 있어도 이보다 잘 설명할 수 없다.
또 하나 예측할 수 있는 것이 잔차의 산포다. 적합이 참 함수에 가깝다면 잔차는 거의 \(\varepsilon\) 이므로, 잔차표준편차 추정값이 \(\sigma = 0.5\) 근처여야 한다.
(2) 수치적으로.
from pygam import LinearGAM, s, l

plt.rcParams["font.sans-serif"] = ["NanumGothic", "Apple SD Gothic Neo", "Malgun Gothic"]
plt.rcParams["font.family"] = "sans-serif"
plt.rcParams["axes.unicode_minus"] = False

# x0 에만 스플라인을 씌우고 나머지는 선형으로 둔다.
gam = LinearGAM(s(0, n_splines=12) + l(1) + l(2))

# 격자탐색으로 벌점 lambda 를 고른다. 자료가 스스로 매끄러움을 정하는 셈이다.
gam.gridsearch(X, y)

print(gam.summary())

# 부분의존도 그림은 "다른 변수를 고정했을 때 이 변수 하나가 반응에 미치는
# 몫"을 그린다. GAM 은 항이 더해지는 꼴이라 이런 그림이 그대로 뜻을 갖는다.
# x0 의 곡선이 sin 모양으로 나오는지가 볼거리다.
fig, axes = plt.subplots(1, 3, figsize=(14, 4))
for i in range(3):
    XX = gam.generate_X_grid(term=i)
    pdep, confi = gam.partial_dependence(term=i, X=XX, width=0.95)
    ax = axes[i]
    ax.plot(XX[:, i], pdep)
    ax.fill_between(XX[:, i], confi[:, 0], confi[:, 1], alpha=0.3)
    ax.set_xlabel(f'x{i}')
    ax.set_ylabel(f'f{i}(x{i})')
    ax.set_title(f'Partial Dependence: x{i}')

plt.tight_layout()
plt.show()
출력:
LinearGAM
=============================================== ==========================================================
Distribution:                        NormalDist Effective DoF:                                      9.5773
Link Function:                     IdentityLink Log Likelihood:                                  -367.9019
Number of Samples:                          500 AIC:                                              756.9584
                                                AICc:                                             757.4599
                                                GCV:                                                0.2693
                                                Scale:                                              0.5099
                                                Pseudo R-Squared:                                   0.9103
==========================================================================================================
Feature Function                  Lambda               Rank         EDoF         P > x        Sig. Code
================================= ==================== ============ ============ ============ ============
s(0)                              [1.]                 12           7.6          1.11e-16     ***
l(1)                              [1.]                 1            1.0          1.11e-16     ***
l(2)                              [1.]                 1            1.0          8.34e-01
intercept                                              1            0.0          9.56e-01
==========================================================================================================
Significance codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

WARNING: Fitting splines and a linear function to a feature introduces a model identifiability problem
         which can cause p-values to appear significant when they are not.

WARNING: p-values calculated in this manner behave correctly for un-penalized models or models with
         known smoothing parameters, but when smoothing parameters have been estimated, the p-values
         are typically lower than they should be, meaning that the tests reject the null too readily.
None
요약표의 수를 (1)의 예측과 맞춰 본다.
st = gam.statistics_

Vsin = 0.5 - np.sin(20) / 40 - ((1 - np.cos(10)) / 10) ** 2
Vlin = 0.25 * 100 / 12
print(f"Var(sin X0) = {Vsin:.6f},  Var(0.5 X1) = {Vlin:.6f},  Var(eps) = 0.250000")
print(f"모집단 R^2 상한 = {(Vsin + Vlin) / (Vsin + Vlin + 0.25):.6f}")

print(f"계수 개수 = {[t.n_coefs for t in gam.terms]}  합 {len(gam.coef_)}")
print(f"고른 lam = {gam.terms[0].lam[0]:g}  (격자 10^-3 ~ 10^3 의 가운데)")
print(f"Pseudo R-Squared = {st['pseudo_r2']['explained_deviance']:.6f}")

pred = gam.predict(X)
rss = ((y - pred) ** 2).sum()
rss_oracle = ((y - np.sin(X[:, 0]) - 0.5 * X[:, 1]) ** 2).sum()
tss = ((y - y.mean()) ** 2).sum()
print(f"GAM 의 RSS = {rss:.4f},  참 함수를 아는 RSS = {rss_oracle:.4f},  TSS = {tss:.4f}")
print(f"1 - RSS/TSS = {1 - rss / tss:.6f},  1 - RSS(참)/TSS = {1 - rss_oracle / tss:.6f}")
print(f"Scale = {st['scale']:.6f},  sqrt(RSS/(n - edof)) = {np.sqrt(rss / (n - st['edof'])):.6f}")
print(f"Effective DoF = {st['edof']:.4f}  (계수 {len(gam.coef_)}개 가운데)")
출력:
Var(sin X0) = 0.443355,  Var(0.5 X1) = 2.083333,  Var(eps) = 0.250000
모집단 R^2 상한 = 0.909965
계수 개수 = [12, 1, 1, 1]  합 15
고른 lam = 1  (격자 10^-3 ~ 10^3 의 가운데)
Pseudo R-Squared = 0.910264
GAM 의 RSS = 127.5046,  참 함수를 아는 RSS = 129.3726,  TSS = 1420.8819
1 - RSS/TSS = 0.910264,  1 - RSS(참)/TSS = 0.908949
Scale = 0.509891,  sqrt(RSS/(n - edof)) = 0.509891
Effective DoF = 9.5773  (계수 15개 가운데)
계수 개수는 예측대로 \(15\) 개다.
\(R^2\) 는 상한을 넘었다. 요약표의 Pseudo R-Squared \(= 0.9103\) 이고 (1)이 준 천장은 \(0.909965\) 다. 아주 조금이지만 넘었다. 모순이 아니다. 두 가지 까닭이 겹쳐 있다.
첫째, \(0.909965\) 는 모집단의 양이고 요약표의 값은 이 표본 \(500\) 개에서 계산한 것이다. 표본에서는 \(\varepsilon\) 의 실현된 분산이 \(0.25\) 와 다르고, 설명변수의 분포도 균등분포와 조금 다르다.
둘째, 그리고 더 중요하게, 이것은 훈련 \(R^2\) 다. 출력이 그 증거를 바로 보여 준다. GAM 의 \(\mathrm{RSS} = 127.5046\) 인데 참 함수를 그대로 써서 얻는 \(\mathrm{RSS}\) 는 \(129.3726\) 이다. 곧 GAM 이 정답보다 더 잘 맞췄다. 그럴 수 있는 길은 하나뿐이다. 잡음의 일부를 외운 것이다. 차이가 \(1.87\), 비율로 \(1.4\%\) 이니 외운 양이 많지는 않다. 참 함수를 쓴 \(R^2\) 는 \(0.908949\) 로 상한 아래에 있다.
이 셈은 훈련 \(R^2\) 가 천장을 넘는 것이 과적합의 직접적인 증거라는 점을 보여 준다. 참값을 모르는 실제 자료에서는 이 비교를 할 수 없고, 그래서 교차검증이 필요하다.
Scale 은 잔차표준편차다. \(0.509891\) 이 손으로 계산한 \(\sqrt{\mathrm{RSS}/(n - \mathrm{edof})}\) 와 소수 여섯째 자리까지 같다. 분산이 아니라 표준편차라는 점을 기억해 두자. 참값 \(\sigma = 0.5\) 와 \(2\%\) 차이이고, 이 표본에서 실현된 잡음의 표준편차(\(0.5083\))와는 \(0.3\%\) 차이다. 참 모수를 꽤 정확히 되찾았다.
lam 은 \(1 = 10^0\) 으로 격자 \(10^{-3} \sim 10^{3}\) 의 정확히 가운데다. 양 끝에 붙지 않았으니 격자가 충분히 넓었다.
유효 자유도(Effective DoF) \(9.5773\) 은 평활 벌점이 실제로 쓴 자유도다. 계수가 \(15\) 개인데 그 가운데 \(9.58\) 개 몫만 쓴다. 표에서 s(0) 의 Rank 가 \(12\) 인데 EDoF 가 \(7.6\) 이니 스플라인 항에서만 \(4.4\) 를 거두어들였다. 기저함수를 여럿 두어도 벌점이 그중 상당 부분을 누른다는 뜻이다.
이것이 회귀 스플라인과 평활 스플라인의 차이다. 앞의 계단함수나 B-스플라인에서는 자유도를 사람이 골랐지만, 여기서는 벌점의 세기 \(\lambda\) 가 자료로부터 정해진다.
요약표의 두 경고도 읽어 두어야 한다. 첫째 경고는 보기 1 에서 본 식별 문제를 말한다. 스플라인과 선형항을 같은 변수에 함께 주면 모수가 식별되지 않고 \(p\) 값이 부풀 수 있다. 둘째 경고는 \(\lambda\) 를 자료로 고른 뒤 그 \(\lambda\) 에서의 \(p\) 값을 보고하면 귀무가설(null hypothesis)을 너무 쉽게 기각한다고 말한다. 선택 편향이다. 다행히 이 자료에서는 결론이 또렷하다. l(2) 곧 무관한 \(x_2\) 의 \(p\) 값이 \(0.834\) 로 유의하지 않다고 바르게 판정했다.
partial_dependence의 반환값
width(또는 quantiles)를 주면 partial_dependence는 부분의존값과 신뢰구간의 쌍을 돌려준다. 신뢰구간은 모양이 \((n, 2)\)인 배열이므로 위처럼 pdep, confi = ...로 풀어서 confi[:, 0], confi[:, 1]을 쓴다. 반환값을 [1], [2]로 색인하면 IndexError가 난다. 격자를 만드는 generate_X_grid도 별도 함수가 아니라 모형 객체의 메서드이다.
6. GAM의 모형선택
평활 모수 선택
평활 모수 \(\lambda_j\)는 편향–분산 절충을 조절한다.
- \(\lambda_j\)가 크면 → 더 매끄러운 함수(편향 큼, 분산 작음)
- \(\lambda_j\)가 작으면 → 더 요동치는 함수(편향 작음, 분산 큼)
흔한 선택 방법은 이렇다.
- 일반화 교차검증(GCV): 적합과 복잡도의 균형을 맞추며 계산이 효율적이다.
- UBRE(unbiased risk estimator, 불편 위험 추정량): AIC와 비슷하며 정규 반응변수에서 잘 작동한다.
- 자동 격자탐색: pyGAM이 람다 값의 격자를 자동으로 탐색한다.
GAM 비교하기
매끄러운 함수를 추정한 뒤에는 다음으로 모형을 비교한다.
- 이탈도(정규 반응변수에서는 잔차제곱합)
- 유효 자유도(모형 복잡도를 반영)
- 모수 개수 대신 eDoF를 넣은 AIC/BIC:
$\(\text{AIC} = -2 \log L + 2 \cdot \text{eDoF}\)$
모형 복잡도 조절
전체 복잡도는 다음으로 조절한다.
- 항별 자유도(
df인자): 기저함수가 적을수록 더 매끄럽다. - 전역 평활 벌점: 모든 람다에 상수를 곱한다.
- 모형 식: 관련 있는 매끄러운 항만 포함한다.
7. 장점과 단점
비선형을 손으로 지정하지 않아도 된다
- 유연성: 손으로 지정하지 않고도 비선형 관계를 포착한다.
- 해석 가능성: 개별 매끄러운 함수를 시각화하고 이해할 수 있다.
- 자동 매끄러움 선택: 많은 알고리즘이 평활 모수를 자동으로 최적화한다.
- 불확실성 수량화: 신뢰대와 표준오차를 제공한다.
- 효율성: 역적합 덕분에 중간 정도의 차원까지 확장 가능하다.
- 효과의 비교 가능성: 가법 구조가 기본적으로 교호작용(interaction)을 배제하므로 효과들을 나란히 비교할 수 있다.
설명변수가 열다섯을 넘으면 힘을 잃는다
- 차원의 저주: 설명변수가 10–15개를 넘어가면 성능이 떨어진다(가법성을 두지 않는 완전 비모수 방법보다는 효율적이지만).
- 가법성 가정: 교호작용을 명시적으로 넣어야 하며, 고차 교호작용은 더 복잡해진다.
- 평활 모수 선택: 람다의 선택에 민감할 수 있고 격자탐색은 계산량을 늘린다.
- 해석의 절충: 관계가 복잡해질수록 단순한 모수적 형태보다 요약하기 어렵다.
- 소프트웨어 의존성: 구현체마다 결과가 조금씩 다를 수 있다(statsmodels 대 pyGAM 대 R의 mgcv).
8. 실전 보기: 주택 가격
여러 특성으로 집값을 예측한다고 하자. GAM은 설명변수마다 다른 정도의 매끄러움을 허용한다.
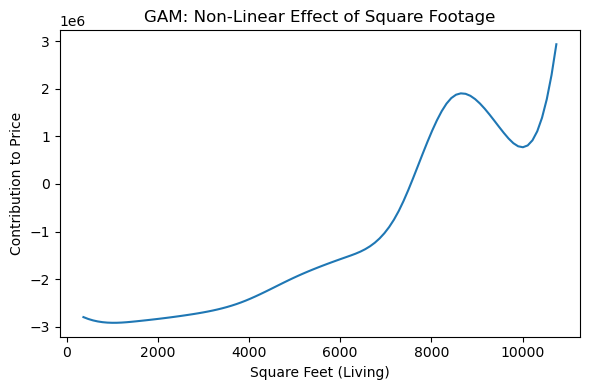
보기 3. 주택 자료에 GAM 적용. King County 전체 22,687 건에 같은 짜임(면적만 s(), 나머지는 l())의 GAM 을 적합한다.
(1) 요약표의 AIC 가 6절에 적힌 \(\text{AIC} = -2\log L + 2\cdot\text{eDoF}\) 와 맞는지 확인하시오. 어긋나면 그 차이가 무엇을 세는 것인가. AICc 의 보정항도 복원하시오.
(2) 고른 Lambda 가 격자의 어디에 놓였는지 보고, 그것이 무엇을 알려 주는 신호인지 말하시오. 같은 설명변수의 선형 OLS 와 견주어 GAM 이 얻은 것과 치른 값을 적으시오.
풀이
(1) 해석적으로. AIC 는 로그가능도에 추정한 모수의 개수만큼 벌점을 준다.
여기서 \(k\) 를 무엇으로 셀 것인가가 요점이다. 벌점이 걸린 GAM 에서는 계수의 개수가 아니라 유효자유도를 쓴다. 그런데 정규 반응변수의 GAM 에는 계수 말고도 추정하는 모수가 하나 더 있다. 잔차분산 \(\sigma^2\) 다. 그것까지 세면
이므로 6절의 식보다 \(2\) 만큼 큰 값이 나올 것이다. 어느 쪽인지는 수로 가린다.
AICc 는 표본이 모수에 비해 작을 때 쓰는 작은표본 보정이다. 표준적인 보정항은
이고, 여기서도 \(k = \text{eDoF} + 1\) 을 쓰는지 확인하면 (1)의 답이 두 번 확인된다.
(2) 수치적으로.
from pygam import LinearGAM, s, l
import pandas as pd

house = pd.read_csv("https://raw.githubusercontent.com/gedeck/"
                    "practical-statistics-for-data-scientists/8a6d3bb6468e979c861d4b37215e1413702dfdfa/data/"
                    "house_sales.csv", sep='\t')

predictors = ['SqFtTotLiving', 'SqFtLot', 'Bathrooms', 'Bedrooms', 'BldgGrade']
X = house[predictors].values
y = house['AdjSalePrice'].values

# 면적만 굽을 수 있다고 보고 나머지는 선형으로 둔다. 이렇게 섞어 쓸 수
# 있다는 것이 GAM 의 실용적인 장점이다.
gam = LinearGAM(
    s(0, n_splines=12) +     # SqFtTotLiving: smooth (likely non-linear)
    l(1) +                   # SqFtLot: linear
    l(2) +                   # Bathrooms: linear
    l(3) +                   # Bedrooms: linear
    l(4)                     # BldgGrade: linear
)

gam.gridsearch(X, y)
print(gam.summary())

# 새 집 하나의 가격을 예측해 본다.
new_house = pd.DataFrame({
    'SqFtTotLiving': [3000],
    'SqFtLot': [10000],
    'Bathrooms': [3.5],
    'Bedrooms': [4],
    'BldgGrade': [10]
})
prediction = gam.predict(new_house[predictors].values)
print(f"Predicted price: ${prediction[0]:,.0f}")

# 면적의 효과가 직선이 아님을 눈으로 확인한다.
fig, ax = plt.subplots(figsize=(6, 4))
XX = gam.generate_X_grid(term=0)
ax.plot(XX[:, 0], gam.partial_dependence(term=0, X=XX))
ax.set_xlabel('Square Feet (Living)')
ax.set_ylabel('Contribution to Price')
ax.set_title('GAM: Non-Linear Effect of Square Footage')
plt.tight_layout()
plt.show()
출력:
LinearGAM
=============================================== ==========================================================
Distribution:                        NormalDist Effective DoF:                                     15.0647
Link Function:                     IdentityLink Log Likelihood:                                -313356.458
Number of Samples:                        22687 AIC:                                           626745.0454
                                                AICc:                                          626745.0696
                                                GCV:                                      58267017203.2869
                                                Scale:                                         241241.3271
                                                Pseudo R-Squared:                                   0.6084
==========================================================================================================
Feature Function                  Lambda               Rank         EDoF         P > x        Sig. Code
================================= ==================== ============ ============ ============ ============
s(0)                              [0.001]              12           11.1         1.11e-16     ***
l(1)                              [0.001]              1            1.0          1.44e-04     ***
l(2)                              [0.001]              1            1.0          1.31e-02     *
l(3)                              [0.001]              1            1.0          3.11e-15     ***
l(4)                              [0.001]              1            1.0          1.11e-16     ***
intercept                                              1            0.0          1.11e-16     ***
==========================================================================================================
Significance codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

WARNING: Fitting splines and a linear function to a feature introduces a model identifiability problem
         which can cause p-values to appear significant when they are not.

WARNING: p-values calculated in this manner behave correctly for un-penalized models or models with
         known smoothing parameters, but when smoothing parameters have been estimated, the p-values
         are typically lower than they should be, meaning that the tests reject the null too readily.
None
Predicted price: $915,154
요약표의 수들을 손으로 복원해 본다.
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score

st = gam.statistics_
n = len(y)

print(f"계수 개수 = {[t.n_coefs for t in gam.terms]}  합 {len(gam.coef_)}")
print(f"고른 lam = {gam.terms[0].lam[0]:g}   격자의 하한 = {np.logspace(-3, 3, 11)[0]:g}")
print(f"Effective DoF = {st['edof']:.4f}")
print(f"AIC: -2logL + 2*edof     = {-2 * st['loglikelihood'] + 2 * st['edof']:.4f}")
print(f"     -2logL + 2*(edof+1) = {-2 * st['loglikelihood'] + 2 * (st['edof'] + 1):.4f}")
print(f"     요약표의 AIC         = {st['AIC']:.4f}")
k = st['edof'] + 1
print(f"AICc = AIC + 2k(k+1)/(n-k-1) = {st['AIC'] + 2 * k * (k + 1) / (n - k - 1):.4f}"
      f"   요약표 {st['AICc']:.4f}")

pred = gam.predict(X)
rss = ((y - pred) ** 2).sum()
print(f"1 - RSS/TSS = {1 - rss / ((y - y.mean()) ** 2).sum():.6f}"
      f"   요약표의 Pseudo R-Squared {st['pseudo_r2']['explained_deviance']:.4f}")
print(f"Scale = {st['scale']:,.4f},  sqrt(RSS/(n-edof)) = {np.sqrt(rss / (n - st['edof'])):,.4f}")

lin = LinearRegression().fit(X, y)
print(f"선형 OLS: 모수 6개  R^2 = {r2_score(y, lin.predict(X)):.6f}")
print(f"새 집 예측: GAM {gam.predict(new_house[predictors].values)[0]:,.0f}"
      f"   선형 {lin.predict(new_house[predictors].values)[0]:,.0f}")
출력:
계수 개수 = [12, 1, 1, 1, 1, 1]  합 17
고른 lam = 0.001   격자의 하한 = 0.001
Effective DoF = 15.0647
AIC: -2logL + 2*edof     = 626743.0454
     -2logL + 2*(edof+1) = 626745.0454
     요약표의 AIC         = 626745.0454
AICc = AIC + 2k(k+1)/(n-k-1) = 626745.0696   요약표 626745.0696
1 - RSS/TSS = 0.608435   요약표의 Pseudo R-Squared 0.6084
Scale = 241,241.3271,  sqrt(RSS/(n-edof)) = 241,241.3271
선형 OLS: 모수 6개  R^2 = 0.540588
새 집 예측: GAM 915,154   선형 965,956
(1) pygam 은 eDoF + 1 을 센다. 6절의 식으로는 \(626743.0454\) 가 나오고 요약표는 \(626745.0454\) 다. 정확히 \(2\) 만큼 크다. 유도한 대로 \(k = \text{eDoF} + 1 = 16.0647\) 을 쓰면 \(626745.0454\) 로 소수 넷째 자리까지 일치한다. 더해진 모수 하나가 잔차분산 \(\sigma^2\) 다.
AICc 도 같은 \(k\) 로 복원된다. 보정항이 \(2k(k+1)/(n-k-1) = 0.0242\) 이고, 그것을 AIC 에 더한 \(626745.0696\) 이 요약표와 소수 넷째 자리까지 같다. 보정이 \(0.02\) 밖에 안 된다는 것도 읽을 거리다. \(n = 22{,}687\) 에 \(k = 16\) 이니 작은표본 보정이 할 일이 없다. AICc 가 뜻을 갖는 것은 \(n/k\) 가 수십 이하일 때다.
Scale 과 Pseudo R-Squared 도 보기 2 에서 본 정의 그대로다. \(\sqrt{\mathrm{RSS}/(n - \text{eDoF})} = 241{,}241.3271\) 이 요약표의 Scale 과 소수 넷째 자리까지 같고, \(1 - \mathrm{RSS}/\mathrm{TSS} = 0.608435\) 가 Pseudo R-Squared \(0.6084\) 와 같다.
(2) Lambda 가 격자의 바닥에 붙었다. 고른 값이 \(0.001\) 이고 그것이 기본 격자 np.logspace(-3, 3, 11) 의 하한이다. 이것은 "최적값을 찾았다" 가 아니라 "격자를 더 낮은 쪽으로 넓혀 보라" 는 신호다. GCV 가 벌점을 더 줄이고 싶어했는데 격자가 막은 것일 수 있다. 보기 2 에서는 \(\lambda = 1\) 로 격자 안쪽이었으니 그때는 걱정할 것이 없었다.
왜 바닥으로 갔는지는 짐작이 된다. 관측값이 \(22{,}687\) 개인데 계수가 \(17\) 개뿐이다. 자료가 모수보다 천 배 넘게 많으면 과적합의 위험이 거의 없으므로 벌점을 걸 이유가 없다. 실제로 s(0) 의 EDoF 가 Rank \(12\) 가운데 \(11.1\) 이니 벌점이 자유도를 거의 깎지 못했다. 보기 2 에서 \(12\) 중 \(7.6\) 만 남았던 것과 대비된다.
선형 OLS 와 견주면. \(R^2\) 가 \(0.5406\) 에서 \(0.6084\) 로 올랐다. \(0.0678\), 비율로 \(12.5\%\) 개선이다. 모수는 \(6\) 개에서 유효 \(15.06\) 개로 늘었다. 면적 하나에 곡선을 허락한 대가로 자유도 아홉 개를 더 쓰고 설명력을 \(7\) 퍼센트포인트 얻었다. 자료가 이만큼 많으면 괜찮은 거래다.
예측에서도 차이가 보인다. 거주면적 \(3{,}000\) 평방피트짜리 예시 주택에 대해 GAM 은 \(915{,}154\) 달러, 선형 모형은 \(965{,}956\) 달러를 준다. \(50{,}802\) 달러, \(5.3\%\) 차이다. 선형 모형이 더 비싸게 부른다는 방향이 중요하다. 면적의 효과가 큰 집에서 꺾여 완만해지는데 직선은 그 꺾임을 모르고 계속 올라가기 때문이다. 부분의존 그림에서 보이는 것이 바로 그 꺾임이다.
이 세 값 모두 훈련자료의 값임을 잊지 말아야 한다. 훈련 \(R^2\) 는 모수를 늘리면 오르기만 한다. AIC 는 벌점을 주므로 모수를 늘리는 쪽을 기계적으로 좋아하지는 않지만, 그 벌점의 크기가 옳다는 보장은 없다. 게다가 \(\lambda\) 를 GCV 로 고른 뒤 같은 자료에서 AIC 를 읽었으므로 선택 편향이 섞여 있다.
부분 의존 그림이 각 설명변수의 기여를 따로 보여준다. GAM 의 강점이 바로 이 해석 가능성이다. 비선형이면서도 변수별 효과를 하나씩 떼어 볼 수 있다.
연습문제
연습문제 1. 설명변수가 세 개인 GAM의 일반형을 쓰고 표준적인 다중선형회귀 모형과 어떻게 다른지 설명하라.
풀이
설명변수가 셋인 GAM은
여기서 \(f_1, f_2, f_3\)은 자료에서 추정한 매끄러운(보통 비모수) 함수이다.
표준적인 다중선형회귀에서는 \(E[Y] = \beta_0 + \beta_1 X_1 + \beta_2 X_2 + \beta_3 X_3\)이며 각 \(f_j\)가 선형으로 제약된다(\(f_j(X_j) = \beta_j X_j\)). GAM은 이 제약을 풀어 각 설명변수가 \(Y\)와 유연한 비선형 관계를 갖도록 허용하되 가법 구조(매끄러운 함수들 사이의 교호작용 없음)는 유지한다.
연습문제 2. GAM에서 평활 모수의 역할을 설명하라. 너무 크게 또는 너무 작게 설정하면 어떻게 되는가?
풀이
평활 모수 \(\lambda\)는 자료에 가깝게 적합하는 것과 함수를 매끄럽게 유지하는 것 사이의 절충을 조절한다.
- \(\lambda\)가 너무 작으면: 매끄러운 함수가 자료를 과적합하여 잡음까지 포착하고 분산이 큰 요동치는 곡선이 나온다.
- \(\lambda\)가 너무 크면: 함수가 과도하게 평활되어 직선에 가까워진다. 실제 비선형 패턴을 놓쳐 편향이 생기지만 분산은 줄어든다.
실무에서 \(\lambda\)는 편향과 분산의 균형을 맞추도록 교차검증(예: 일반화 교차검증, GCV)으로 고른다.
연습문제 3. 비선형 관계를 모형화할 때 다항회귀와 비교한 GAM의 장점 하나와 한계 하나를 기술하라.
풀이
장점: GAM은 자료 기반 평활로 각 설명변수의 유연성 정도를 자동으로 맞춘다. 반면 다항회귀는 차수를 미리 정해야 한다. GAM은 고차 다항식을 괴롭히는 룽게 현상(경계에서의 격렬한 진동)을 피한다.
한계: GAM은 가법 구조(\(f_1(X_1) + f_2(X_2)\))를 가정하며 설명변수 사이의 교호작용을 기본적으로 포착하지 못한다. 다항회귀는 교호작용 항(\(X_1 X_2\), \(X_1^2 X_2\))을 직접 넣을 수 있다. GAM에서 교호작용을 모형화하려면 텐서곱 평활이나 명시적 교호작용 항을 추가해야 하며 복잡도가 늘어난다.
연습문제 4.
보기 1 과 같은 자료와 같은 식 y ~ x0 + x1 + x2 에 기저만 BSplines(x_spline, df=[6, 6, 6], degree=[3, 3, 3]) 로 바꾸어 준다고 하자.
(1) 기저 열의 개수, 계수표의 행 개수, 설계행렬의 rank, 그리고 보고될 Df Model 을 구하시오.
(2) 기저는 그대로 두고 식만 y ~ 1 로 바꾸어 선형항 셋을 빼면 (1) 의 네 수가 각각 어떻게 바뀌는가. 적합값과 잔차제곱합은 바뀌는가.
풀이
(1) BSplines 는 변수마다 \(\mathrm{df}_j\) 개의 기저함수를 만든 뒤 절편과 겹치지 않게 한 열을 버리므로 기저 열은
개다. 식이 절편 \(1\) 개와 선형항 \(3\) 개를 더 놓으므로 계수표의 행은 \(1 + 3 + 15 = 19\) 개다.
rank 는 보기 1 과 같은 이유로 깎인다. 변수 \(j\) 의 축소기저(한 열을 버리고 남은 기저) \(5\) 열에 절편을 돌려주면 그 변수의 기저 전체가 치는 공간이 복원되고, 차수 \(d = 3 \ge 1\) 인 B-스플라인 기저는 일차함수를 품는다. 곧 \(x_j\) 열이 이미 그 공간 안에 있다. 세 변수 모두 그러므로
이고 Df Model 은 \(16 - 1 = 15\) 로 보고된다.
(2) 기저 열은 \(15\) 로 그대로다. 계수표의 행은 \(1 + 15 = 16\) 으로 줄고, rank 는 \(16\) 그대로여서 이제 완전계수가 된다. Df Model 도 \(15\) 로 바뀌지 않는다.
적합값과 잔차제곱합은 바뀌지 않는다. \(x_j\) 열이 절편과 변수 \(j\) 의 축소기저가 함께 치는 공간 안에 있었으므로 그 열을 빼도 설계행렬의 열공간이 그대로다. 열공간이 같으면 최소제곱 사영이 같고, 따라서 적합값·잔차·로그가능도·AIC·Scale·\(R^2\) 가 모두 같다. 달라지는 것은 계수표의 길이뿐이다.
정리하면, 선형항을 같은 변수의 스플라인과 함께 넣는 것은 적합에 아무것도 더하지 않고 계수표의 세 행만 해석할 수 없게 만든다. 보기 1 에서 x0 행이 계수 \(-0.0018\), \(p\) 값 \(0.945\) 로 "\(x_0\) 는 쓸모없다" 처럼 보였던 것이 그 대가다. pygam 요약표의 첫째 경고가 말하는 식별 문제도 같은 자리를 가리킨다.
연습문제 5. 보기 2 는 참 모형 \(y = \sin X_0 + 0.5\,X_1 + \varepsilon\), \(X_j \sim U(0, 10)\), \(\varepsilon \sim N(0, 0.5^2)\) 에서 모집단 \(R^2\) 의 상한이 \(0.909965\) 임을 보였다. 참 모형과 잡음은 그대로 두고 설계만 \(X_j \sim U(0, b)\) 로 바꾼다.
(1) \(b = 2\pi\) 일 때의 상한을 소수 여섯째 자리까지 구하시오.
(2) \(b \to \infty\) 와 \(b \to 0\) 에서 상한의 극한을 각각 구하시오. 이로부터 \(R^2\) 의 값을 모형의 좋음으로 읽을 때 무엇을 조심해야 하는가.
풀이
일반적인 \(b\) 에 대해 보기 2 의 셈을 그대로 따라간다. \(X_0, X_1, \varepsilon\) 이 독립이므로
이고, \(U(0,b)\) 에서
이므로
\(b = 10\) 을 넣으면 보기 2 의 \(V_s = 0.443355\), \(V_\ell = 25/12 = 2.083333\), \(R^2_{\max} = 0.909965\) 가 그대로 나온다.
(1) \(b = 2\pi\) 는 사인의 온 주기다. 그래서 \(\sin 2b = \sin 4\pi = 0\) 이고 \(\cos b = \cos 2\pi = 1\) 이어서 두 보정항이 함께 사라진다.
참 함수도 잡음도 손대지 않았는데 천장이 \(0.909965\) 에서 \(0.841014\) 로 \(0.069\) 내려갔다.
(2) \(\lvert \sin \rvert \le 1\) 이므로 \(0 \le V_s(b) \le 1\) 로 유계다. 반면 \(V_\ell(b) = b^2/48\) 는 갇히지 않는다.
\(b \to \infty\): 분자와 분모가 함께 발산하고 그 차가 \(0.25\) 로 고정되므로
\(b \to 0\): \(\sin x = x + O(x^3)\) 이므로 \(V_s(b) \approx b^2/12 \to 0\) 이고 \(V_\ell(b) \to 0\) 이다. 분자가 \(0\) 으로 가고 분모는 \(0.25\) 로 가므로 \(R^2_{\max} \to 0\).
수치로 확인하면 \(b = 100\) 에서 \(0.998804\), \(b = 0.1\) 에서 \(0.004139\) 다.
조심할 것은 이것이다. \(R^2\) 는 모형의 성질이 아니라 모형과 설명변수 분포가 함께 만드는 양이다. 분모에 \(\operatorname{Var}(y)\) 가 있으므로 설명변수의 범위를 넓히면 같은 참 모형에서도 천장이 \(1\) 로 올라가고, 좁히면 \(0\) 으로 내려간다. 그러므로 서로 다른 자료에서 얻은 \(R^2\) 를 가로질러 견주는 것은 뜻이 없고, 보기 2 처럼 같은 자료 안에서 계산한 천장과 견주는 것만이 모형의 좋음을 말해 준다.
연습문제 6.
이 쪽의 2 절은 모형 전체의 복잡도를 \(\text{eDoF}_{\text{total}} = 1 + \sum_j \text{eDoF}_j\) 로 적었다. 이 식을 보기 2 와 보기 3 의 요약표에 적용하여 표의 Effective DoF 와 견주어 보자.
(1) 두 보기에서 식의 값, 표의 값, 그리고 그 차이를 각각 구하시오. 차이가 두 보기에서 같은가.
(2) 표의 어느 행이 그 차이를 설명하는가. 그 행의 EDoF 가 왜 그 값인지를 보기 1 에서 본 식별 문제로 설명하시오.
풀이
(1) 보기 2 의 표는 s(0) 에 \(7.6\), l(1) 과 l(2) 에 각각 \(1.0\) 을 준다. 설명변수 셋에 대해 식을 쓰면
인데 표의 Effective DoF 는 \(9.5773\) 이다. 차이가 \(10.6 - 9.5773 = 1.0227\) 이다.
보기 3 의 표는 s(0) 에 \(11.1\), l(1)–l(4) 에 각각 \(1.0\) 을 준다.
인데 표의 값은 \(15.0647\) 이다. 차이가 \(16.1 - 15.0647 = 1.0353\) 이다.
두 보기에서 차이가 같다. 표의 EDoF 열이 소수 첫째 자리까지만 적혀 있어 항마다 최대 \(0.05\) 의 반올림이 섞이는데, 그 폭을 빼면 두 차이는 모두 정확히 \(1\) 로 보아야 한다.
(2) intercept 행이다. 표에는 절편이 따로 한 행으로 있고 그 EDoF 가 \(0.0\) 이다. 절편 행까지 넣어 모든 행을 더해 보면
로 두 보기 모두 표의 Effective DoF 와 반올림 안에서 맞는다. 곧 표의 값은 절편 행을 포함한 모든 행의 합이다. 2절의 식에 있는 "\(+1\)" 은 절편을 한 몫으로 따로 세는 항이므로, 이미 절편 행이 들어 있는 표에 그 식을 그대로 쓰면 절편을 두 번 세게 된다. 그래서 불일치가 항의 개수나 자료의 크기와 무관하게 늘 \(1\) 이다.
절편의 EDoF 가 왜 \(0.0\) 인가. B-스플라인 기저는 그 변수의 구간 위에서 합이 \(1\) 이므로 상수함수를 품는다. 그래서 s(0) 의 \(12\) 열이 이미 절편 방향을 치고 있고, 절편 열은 그 공간 안에 있다. 보기 1 에서 "축소기저에 절편을 돌려주면 일차함수가 나오므로 x0 열이 남는 정보가 없다" 고 했던 것과 똑같은 종류의 중복이다. 유효자유도는 모자행렬의 대각합을 계수 블록별로 나눈 것이고, 중복된 방향의 몫은 이미 스플라인 블록의 \(7.6\)(보기 3 에서는 \(11.1\)) 안에 들어가 있다. 절편 행에 돌아갈 몫이 남지 않는다.
2절의 식은 매끄러운 항들이 중심화되어 상수를 품지 않는 경우의 식이다(R 의 mgcv 가 그렇게 한다). 그때는 절편이 어느 항과도 겹치지 않으므로 \(+1\) 이 옳다. 구현이 기저를 중심화하지 않으면 그 가정이 깨지므로, eDoF 는 식으로 더하지 말고 표에서 읽어야 한다.
연습문제 7.
보기 3 의 요약표에는 잔차제곱합이 없다. 표의 Scale \(= 241{,}241.3271\), Pseudo R-Squared \(= 0.608435\), Effective DoF \(= 15.0647\), 표본 수 \(n = 22{,}687\), 그리고 풀이에 적힌 선형 OLS 의 \(R^2 = 0.540588\) 만 쓰시오.
(1) GAM 의 잔차제곱합, 총제곱합, 선형 OLS 의 잔차제곱합을 구하시오.
(2) 반응변수의 표준편차와 두 모형의 잔차표준편차를 구하고, GAM 이 선형 모형에 비해 잔차제곱합을 몇 퍼센트 줄였는지 구하시오.
풀이
(1) Scale 은 잔차표준편차이고 \(\text{Scale} = \sqrt{\mathrm{RSS}/(n - \text{eDoF})}\) 이므로 거꾸로 풀면
Pseudo R-Squared 가 \(1 - \mathrm{RSS}/\mathrm{TSS}\) 이므로
TSS 는 \(y\) 만으로 정해지는 양이므로 같은 자료의 OLS 에도 같은 값을 쓴다. 따라서
(2) 반응변수의 표준편차는
로 약 \(38.5\) 만 달러다. GAM 의 잔차표준편차는 Scale 그대로 \(241{,}241.3\) 달러이고, OLS 는 모수가 \(6\) 개이므로
달러다. 잔차제곱합의 감소는
로 \(14.77\%\) 이고, 잔차표준편차로는 \(261{,}254.7 \to 241{,}241.3\) 으로 \(7.66\%\) 줄었다.
같은 사실을 세 가지 척도로 읽으면 느낌이 다르다. 보기 3 은 \(R^2\) 가 \(0.5406\) 에서 \(0.6084\) 로 "비율로 \(12.5\%\) 개선" 이라고 적었다. 설명되지 않은 제곱합(sum of squares)으로 보면 \(14.77\%\) 가 줄었고, 실제 예측오차의 크기로 보면 \(7.66\%\), 곧 집 한 채의 오차가 평균 \(26.1\) 만 달러에서 \(24.1\) 만 달러로 \(2\) 만 달러쯤 줄었다. 요약표가 제곱합을 찍어 주지 않아도 Scale 과 Pseudo R-Squared 가 정의를 통해 그것을 품고 있다.
연습문제 8. 보기 2 에서 GAM 의 잔차제곱합이 \(127.5046\) 이고 참 함수를 그대로 쓴 잔차제곱합이 \(129.3726\) 이었다. 풀이는 이것을 과적합의 증거로 읽었다. 그 크기가 얼마여야 하는지를 재 보자. \(n = 500\), \(\text{eDoF} = 9.5773\), 참 \(\sigma^2 = 0.25\), \(\mathrm{TSS} = 1420.8819\) 이다.
(1) 적합이 편향 없는 선형평활이라면 \(E[\mathrm{RSS}_{\text{GAM}}] = (n - \text{eDoF})\sigma^2\) 이고 참 함수의 \(E[\mathrm{RSS}] = n\sigma^2\) 이다. 이로부터 두 제곱합의 차가 얼마쯤이어야 하는지 예측하고 실제 차와 견주시오.
(2) 두 제곱합을 각자 알맞은 자유도로 나누어 \(\sigma^2\) 추정값을 구해 서로 견주시오. 또 (1) 의 식이 예측하는 훈련 \(R^2\) 를 구해 실제 \(0.910264\) 와 견주시오. 이 GAM 은 예측보다 더 과적합인가, 덜 과적합인가.
풀이
(1) 두 기댓값을 빼면 차는 자유도 하나에 \(\sigma^2\) 씩이다.
이 표본에서 실현된 잡음 분산 \(\hat\sigma^2 = 129.3726/500 = 0.258745\) 를 쓰면 \(9.5773 \times 0.258745 = 2.4781\) 이다. 실제로 관측된 차는
이고 예측의 \(1.8680/2.3943 = 78.0\%\)(실현 분산 기준으로는 \(75.4\%\)) 다.
부호와 크기가 모두 자유도 셈으로 설명된다. GAM 이 정답을 이기는 것은 신기한 일이 아니다. 자유도 \(9.58\) 을 쓰는 어떤 적합이라도 훈련 제곱합은 평균적으로 \(\text{eDoF} \cdot \sigma^2\) 만큼 내려가고, 참 함수는 자료를 보지 않으므로 그 할인을 못 받는다.
(2) 알맞은 분모는 GAM 에는 \(n - \text{eDoF}\), 참 함수에는 \(n\) 이다.
첫째 값은 보기 2 의 Scale 을 제곱한 \(0.509891^2\) 과 같다. 두 추정값의 차이는 \(0.48\%\) 에 그친다. 분모를 바로잡으면 두 적합이 보는 잡음의 크기가 사실상 같아진다.
예측되는 훈련 \(R^2\) 는
이고 실현 분산 \(0.258745\) 를 쓰면 \(0.910693\) 이다. 실제 값 \(0.910264\) 는 두 예측보다 낮다.
그러므로 이 GAM 은 예측보다 덜 과적합이다. 편향 없는 자유도 \(9.58\) 짜리 적합이라면 자동으로 얻었을 만큼도 맞추지 못했는데, 벌점이 걸려 있어 약간의 편향이 남아 있기 때문이다. 보기 2 에서 \(f_0\) 가 \(\sin\) 과 중심을 맞춘 뒤에도 최대 \(0.1215\) 어긋났던 것이 그 편향이다.
한 줄로 하면, "훈련 RSS 가 정답의 RSS 보다 작다" 는 과적합의 방향을 바로 보여 주지만 양을 말해 주지는 않는다. 양을 재려면 \(\text{eDoF} \cdot \sigma^2\) 라는 척도가 있어야 하고, 그 척도로 보면 보기 2 의 \(1.87\) 은 걱정할 크기가 아니다.
연습문제 9.
보기 1 의 BSplines 는 변수마다 기저 열 하나를 버려 \(13\) 열을 만들었고, 설계행렬 \(17\) 열의 rank 가 \(14\) 였다. 만일 열을 버리지 않고 \(\mathrm{df}_j\) 개를 모두 썼다면 어떻게 되는가. B-스플라인 기저가 그 변수의 구간 위에서 합이 \(1\) 이고 차수 \(d \ge 1\) 이면 일차함수를 품는다는 사실을 쓰고, 세 변수가 서로 독립임을 쓰시오.
(1) 설계행렬의 열 개수와 rank, 그리고 계수 결손(열 개수 \(-\) rank)을 구하시오.
(2) 결손을 서로 다른 중복 방향으로 쪼개어 각각 몇 개인지 세시오. 그리고 열 하나씩 버리는 처리가 결손을 그 값에서 \(3\) 으로 줄이면서도 적합값은 바꾸지 않는 까닭을 말하시오.
풀이
(1) 열은 절편 \(1\) 개, 선형항 \(3\) 개, 그리고 버리지 않은 기저 \(10 + 3 + 3 = 16\) 개를 합쳐
개다.
rank 를 세려면 열공간이 무엇인지를 보면 된다. 변수 \(j\) 의 완전기저를 \(\mathcal{B}_j = \operatorname{span}(B_{j1}, \ldots, B_{j,\mathrm{df}_j})\) 라 하자. 기저의 합이 \(1\) 이므로 상수함수가 \(\mathcal{B}_j\) 에 있고, 차수가 \(1\) 이상이므로 \(x_j\) 도 \(\mathcal{B}_j\) 에 있다. 따라서 절편 열과 선형 열은 모두 \(\mathcal{B}_0 + \mathcal{B}_1 + \mathcal{B}_2\) 안에 있고
이다. \(\dim \mathcal{B}_j = \mathrm{df}_j\) 이고, 서로 다른 변수만의 함수가 동시에 될 수 있는 것은 상수뿐이므로 \(\mathcal{B}_i \cap \mathcal{B}_j\) 는 상수 한 방향이다. 상수 방향이 세 번 세어졌으니 두 번을 덜어
이다. 결손은 \(20 - 14 = 6\) 이다.
(2) 중복을 쪼개면 이렇다.
- 절편 열이 \(\mathcal{B}_0\) 가 품은 상수와 겹치는 것: \(1\) 개
- \(\mathcal{B}_1\) 과 \(\mathcal{B}_2\) 가 각자 또 상수를 품는 것: \(2\) 개
- 선형 열 \(x_0, x_1, x_2\) 가 각자의 기저 안에 있는 것: \(3\) 개
합이 \(1 + 2 + 3 = 6\) 으로 (1) 과 맞는다. 상수 한 방향을 네 군데(절편과 기저 셋)가 나르므로 거기서만 결손 \(3\) 이 나온다는 점이 핵심이다.
변수마다 한 열을 버리면 각 기저가 더 이상 상수를 품지 않으므로 상수를 나르는 열은 절편뿐이 되고, 상수에서 온 결손 \(3\) 이 통째로 사라진다. 남는 것은 선형 열에서 온 \(3\) 개이고, 그것이 보기 1 의 결손이다. 수로 적으면 열은 \(20 \to 17\), rank 는 \(14 \to 14\), 결손은 \(6 \to 3\) 이다.
적합값이 바뀌지 않는 까닭. 버린 열이 치던 방향은 남은 열들이 되살린다. 변수 \(j\) 의 축소기저에 절편을 보태면 \(\mathcal{B}_j\) 전체가 복원되므로 두 설계행렬의 열공간이 같다. 열공간이 같으면 최소제곱 사영이 같으므로 적합값·잔차제곱합·로그가능도·Df Model(\(= \text{rank} - 1 = 13\)) 이 모두 같다.
정리하면, 소프트웨어가 열을 버리는 것은 모형을 바꾸는 것이 아니라 같은 모형을 덜 결손된 좌표로 적는 일이다. 다만 그 처리로 지울 수 있는 것은 상수에서 온 결손 \(3\) 까지이고, 선형항에서 온 결손 \(3\) 은 사용자가 식을 고쳐야(연습문제 4) 없앨 수 있다.
연습문제 10.
보기 3 은 GAM 의 AIC \(= 626{,}745.0454\) 를 \(k = \text{eDoF} + 1\) 로 복원했지만 선형 OLS 의 AIC 는 적지 않았다. 요약표가 OLS 의 로그가능도를 주지 않기 때문이다. 정규모형에서 최대가능도로 \(\sigma^2\) 를 추정하면
이다. 연습문제 7 에서 구한 두 잔차제곱합과 pygam 의 셈법 \(k = \text{eDoF} + 1\) 을 두 모형에 똑같이 쓰시오. 선형 OLS 의 eDoF 는 모수 개수 \(6\) 이다.
(1) \(\text{AIC}_{\text{OLS}} - \text{AIC}_{\text{GAM}}\) 을 적합항과 벌점항으로 나누어 구하시오. 상수 \(n(1 + \log 2\pi)\) 를 몰라도 되는 까닭을 말하시오.
(2) 두 항의 크기를 견주고, 그 비가 보기 3 에서 람다가 격자의 바닥으로 간 것과 어떻게 이어지는지 설명하시오.
풀이
(1) 두 AIC 를 빼면
이다. 상수 \(n(1 + \log 2\pi)\) 는 두 모형에서 \(n\) 이 같으므로 그대로 상쇄된다. 로그 안의 \(1/n\) 도 뺄셈에서 지워지므로 필요한 것은 두 제곱합의 비뿐이다. AIC 의 절대값은 가능도의 상수 규약에 따라 달라지지만 차는 규약과 무관하다는 뜻이다.
적합항은 연습문제 7 의 값으로
벌점항은 \(k_{\text{OLS}} = 6 + 1 = 7\), \(k_{\text{GAM}} = 15.0647 + 1 = 16.0647\) 이므로
합하면
OLS 의 AIC 가 \(3607\) 만큼 크므로 AIC 는 GAM 을 압도적으로 고른다.
규약이 맞는지도 확인된다. 위 식에 \(\mathrm{RSS}_{\text{GAM}} = 1.319447 \times 10^{15}\) 를 넣으면 \(-2\log L = 626{,}712.92\) 이고, 요약표의 Log Likelihood \(= -313{,}356.458\) 을 두 배 한 \(626{,}712.916\) 과 소수 둘째 자리까지 같다. pygam 도 같은 정규 가능도를 쓴다.
(2) 벌점항 \(18.13\) 은 적합항 \(3625.29\) 의 \(0.50\%\) 다. 곧 이 자료에서 AIC 는 사실상 "제곱합이 작은 쪽" 을 고르는 규칙으로 쪼그라들었다. 까닭은 \(n\) 이다. 적합항은 \(n \log(\text{비})\) 로 표본 수에 비례해 커지는데 벌점항은 \(2\,\Delta k\) 로 \(n\) 과 무관하다. \(n = 22{,}687\) 이면 제곱합이 \(0.1\%\) 만 줄어도
이므로 자유도 \(11\) 개를 더 쓰는 값을 치르고도 남는다.
람다가 격자의 바닥으로 간 것이 같은 이야기다. 보기 3 에서 GCV 가 고른 \(\lambda = 0.001\) 이 격자의 하한이었고 s(0) 의 EDoF 가 rank \(12\) 가운데 \(11.1\) 이었다. 관측값이 \(22{,}687\) 개인데 계수가 \(17\) 개뿐이니 자유도 한 몫의 값이 거의 공짜다. 복잡도에 벌점을 주는 기준이라면 GCV 든 AIC 든 모두 유연한 쪽으로 밀린다. 보기 2 는 \(n = 500\) 에 계수 \(15\) 개여서 \(\lambda = 1\) 로 격자 안쪽에 멈췄다. 같은 기준이 자료 크기에 따라 다르게 행동한 것이다.
한 줄 해석: AIC 의 벌점은 \(n\) 에 대해 상대적으로 사라진다. 큰 자료에서 AIC 가 복잡한 모형을 고르는 것은 그 모형이 꼭 좋아서가 아닐 수 있다. 그래서 보기 3 의 마지막 단락이 훈련자료의 값임을 되짚고 교차검증을 말하는 것이다.
정리하며
일반화가법모형은 비선형 회귀에 대한 강력하고 해석 가능한 접근을 제공한다.
- 유연한 매끄러운 함수가 가법성을 유지하면서 경직된 선형항을 대체한다.
- 정칙화를 통한 자동 평활이 과적합을 막는다.
- 각 효과의 개별 시각화가 해석을 돕는다.
- 실용적인 도구(statsmodels, pyGAM)가 GAM을 실제 응용에서 쓸 수 있게 해 준다.
- 유연성과 해석 가능성 사이의 절충 덕분에 중간 정도의 비선형성이 예상될 때 GAM이 이상적이다.
자료가 비선형 관계를 시사하고 해석이 중요할 때, GAM은 선형회귀의 단순함과 완전 비모수 방법의 유연함 사이에서 훌륭한 균형을 제공한다.
다음 쪽 GAM 주택 분석으로 넘어간다. King County 집값 자료에 선형·다항·GAM 셋을 걸어 견주고, 부분의존 그림으로 변수마다의 곡률을 눈으로 본다.