평균 차이에 대한 이표본 Z-검정
1. 모분산을 아는 경우
들어가는 이야기 — 표본을 늘려도 내려가지 않는 \(p\) 값
두 집단을 견줄 때 쓰는 손이 하나 있다. 표본을 늘린다. 차이가 정말 있다면 \(p\) 값은 표본과 함께 내려가게 마련이니, 아쉬운 결과를 받아 든 자리에서 가장 먼저 떠오르는 수다. 그런데 한쪽만 늘릴 수 있는 자리에서는 그 손이 통하지 않는다.
A 학군 학생 \(50\) 명의 평균이 \(78\) 점, B 학군 \(60\) 명이 \(74\) 점이다. 네 점 차이에 양측 \(p = 0.120\) 이라 기각하지 못하고, 그러면 표본을 늘리자는 말이 나온다. A 학군은 더 조사할 수 없어 B 학군만 늘린다고 하자 — \(p\) 는 \(0.018422\) 에서 멈춘다. 백만 명을 조사해도 그 아래로 내려가지 않는다.
알려진 두 분산이 표준오차에 바닥을 깔아 두는데, 그 바닥은 어디서 오고 무엇이 그 높이를 정하는가. 표본을 늘려 메울 수 있는 것과 아무리 늘려도 메울 수 없는 것이 갈리는 자리다. 이 쪽이 두 평균의 차에 대한 \(z\) 검정을 세우고 그 바닥을 짚는다.
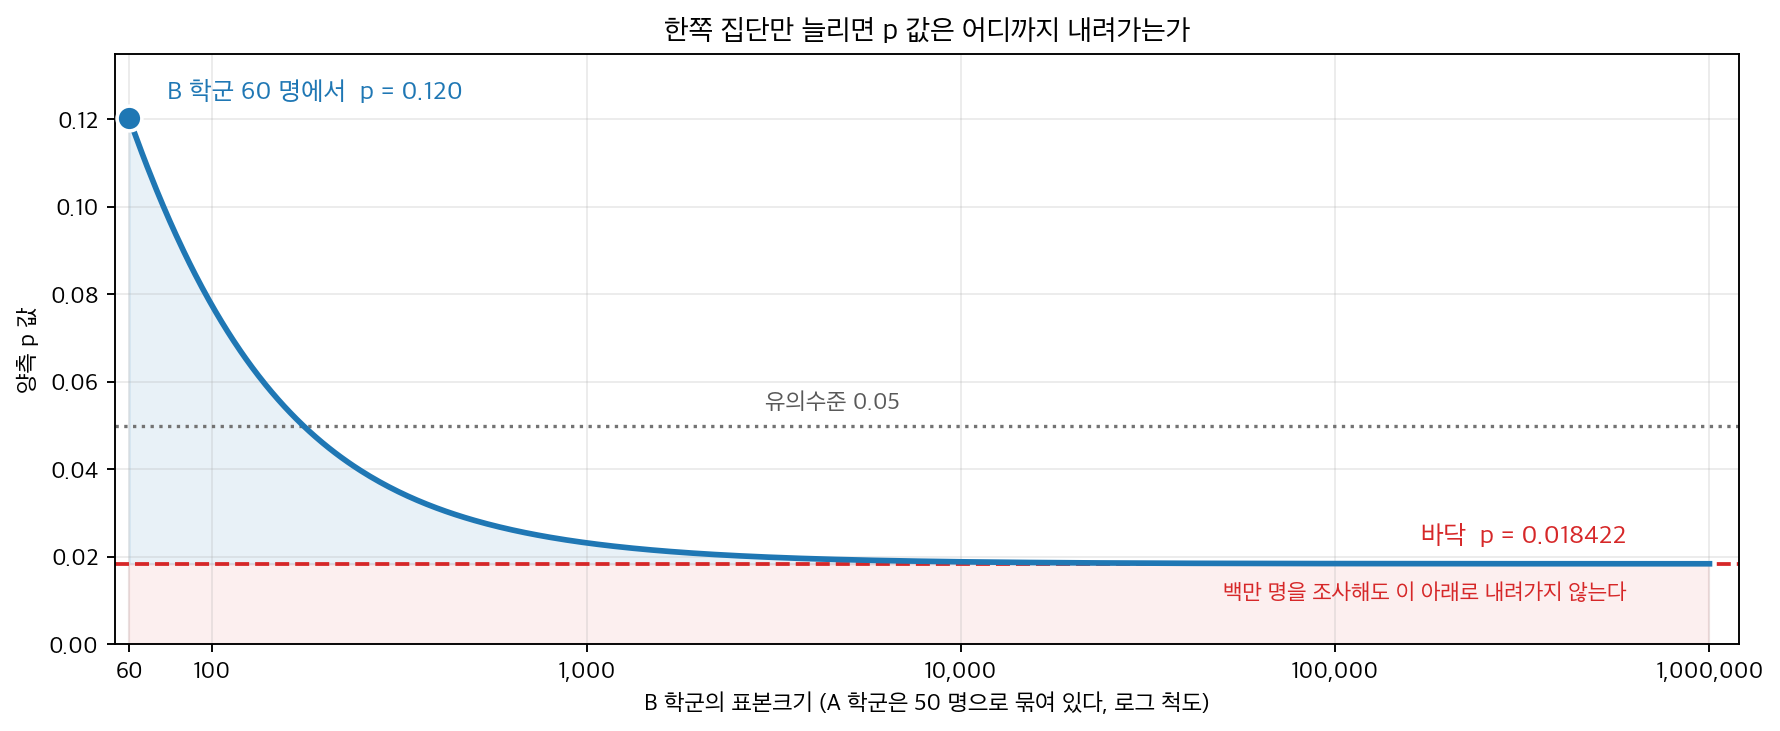
A 학군이 \(50\) 명으로 묶여 있으면 표준오차가 \(\sigma_1/\sqrt{n_1} = 12/\sqrt{50} = 1.697\) 아래로 내려갈 수 없고, 그 바닥이 \(p\) 값의 바닥을 정한다. 붉은 띠는 어떤 표본크기로도 닿을 수 없는 영역이다. 표본을 늘려 메울 수 있는 것과 아무리 늘려도 메울 수 없는 것이 여기서 갈린다 — 늘리는 쪽의 분산은 \(0\) 으로 보낼 수 있지만 묶인 쪽의 분산은 그대로 남는다. \(\S 4\) 의 보기 \(2\) 가 이 곡선을 수로 따진다.
평균을 비교하는 대부분의 이표본 문제는 모분산 \(\sigma_1^2\)과 \(\sigma_2^2\)을 아는 경우가 드물기 때문에 t-검정을 쓴다. 그러나 방대한 과거 자료나 측정기기의 물리적 특성 등으로 이 분산들을 아는 경우에는, 이표본 z-검정이 자유도 조정 없이 표준정규분포에 기반한 정확한 검정을 제공한다. 분산을 모를 때에도 z-검정은 이표본 t-검정의 개념적 토대가 되므로 출발점으로 삼기에 유용하다.
2. 물음 — 두 평균의 차가 δ₀ 인가
독립인 두 확률표본을 관측한다.
- 표본 1: 평균이 \(\mu_1\)이고 분산 \(\sigma_1^2\)을 아는 모집단에서 뽑은 \(X_1, X_2, \ldots, X_{n_1}\)
- 표본 2: 평균이 \(\mu_2\)이고 분산 \(\sigma_2^2\)을 아는 모집단에서 뽑은 \(Y_1, Y_2, \ldots, Y_{n_2}\)
표본평균(sample mean)은 \(\bar{X} = \frac{1}{n_1}\sum_{i=1}^{n_1} X_i\)와 \(\bar{Y} = \frac{1}{n_2}\sum_{j=1}^{n_2} Y_j\)이다. 차이 \(\mu_1 - \mu_2\)가 가설의 값 \(\delta_0\)(흔히 \(\delta_0 = 0\))과 같은지 검정하고자 한다.
귀무가설(null hypothesis)은 다음과 같다.
대립가설(alternative hypothesis)은 연구 질문에 따라 다음 세 형태 중 하나이다.
| 이름 | 대립가설 \(H_a\) | 기각하는 경우 |
|---|---|---|
| 양측 | \(\mu_1 - \mu_2 \neq \delta_0\) | \(\lvert Z \rvert\)가 클 때 |
| 좌측 | \(\mu_1 - \mu_2 < \delta_0\) | \(Z\)가 매우 작을 때(음수) |
| 우측 | \(\mu_1 - \mu_2 > \delta_0\) | \(Z\)가 매우 클 때 |
대부분의 응용에서 \(\delta_0 = 0\)이므로 검정은 두 모평균이 같은지를 묻는다.
3. 통계량 — 차의 분산은 빼지지 않고 더해진다
귀무가설 아래에서 표본평균의 차이 \(\bar{X} - \bar{Y}\)가 \(\delta_0\)을 추정한다. 두 표본이 독립이므로 \(\bar{X} - \bar{Y}\)의 분산은 각 분산의 합이다.
두 모집단이 모두 정규이거나 \(n_1\)과 \(n_2\)가 중심극한정리(central limit theorem)를 적용할 만큼 크면 \(\bar{X} - \bar{Y}\)는 근사적으로 정규이다. \(H_0\) 아래에서 표준화하면 검정통계량(test statistic)을 얻는다.
\(H_0\) 아래에서 이 통계량은 표준정규분포를 따른다: \(Z \sim N(0, 1)\).
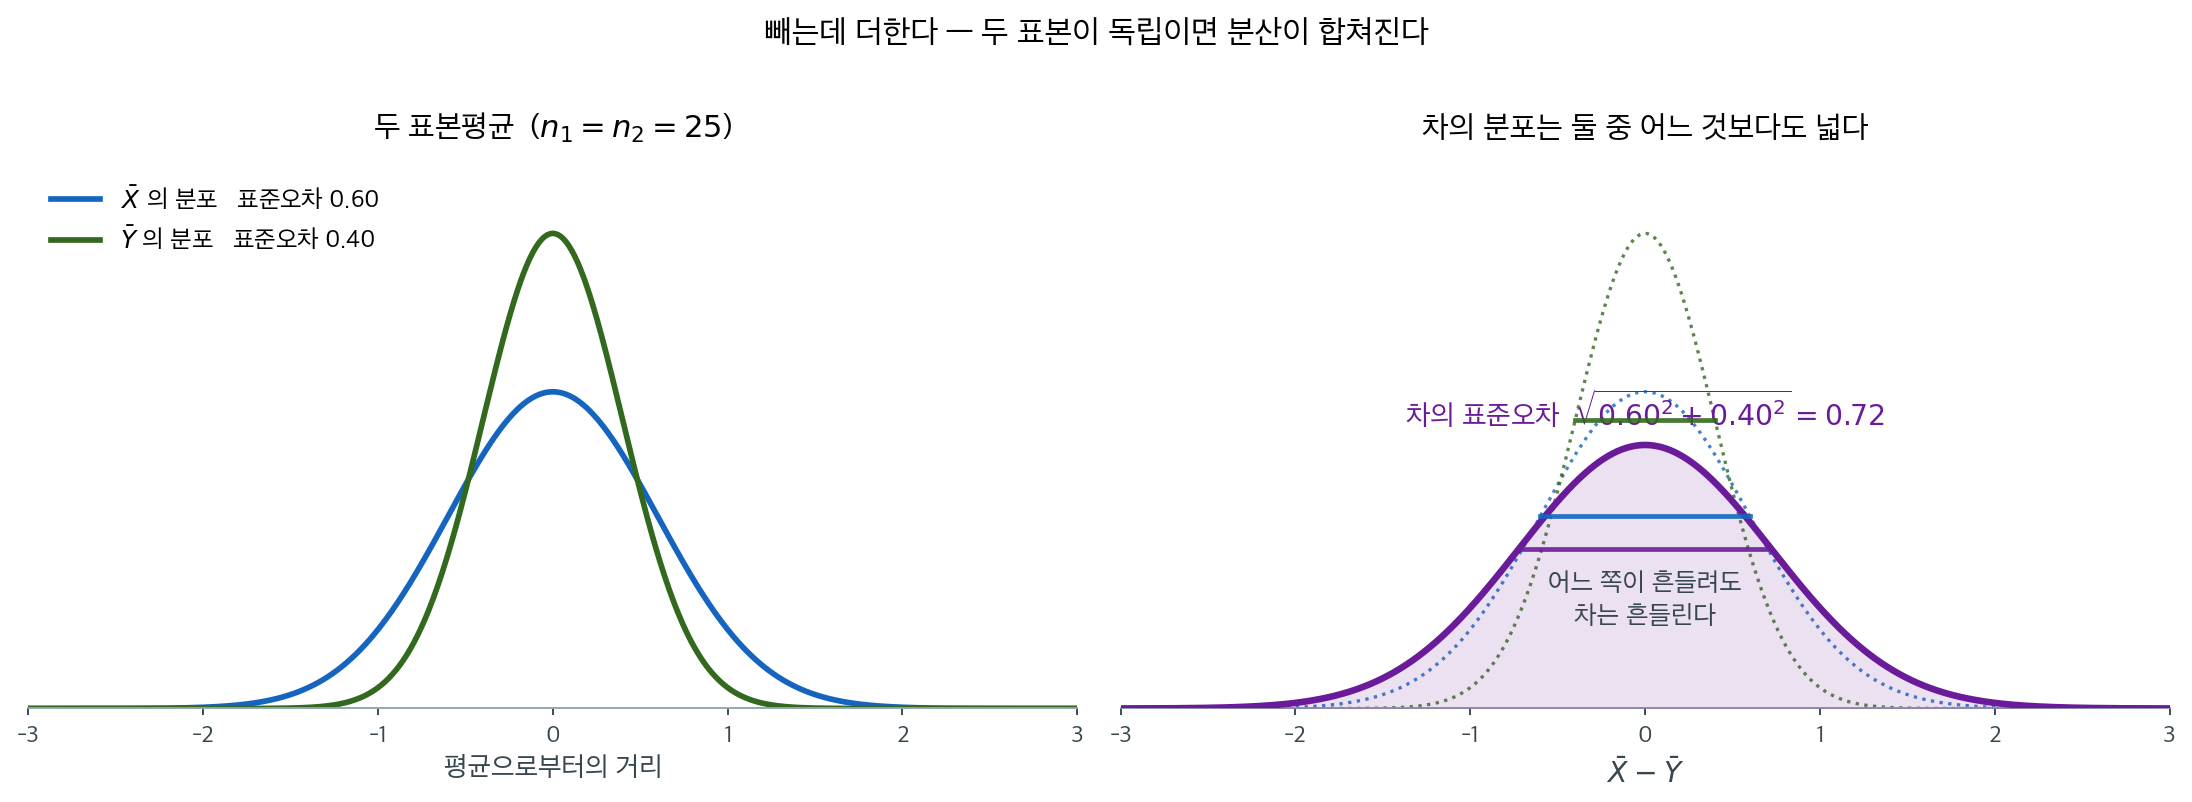
분모가 왜 저런 모양인지를 그림으로 보아 두자. 왼쪽은 두 표본평균이 각자 얼마나 흔들리는지이고, 오른쪽이 그 차의 분포다. 차를 구하는데 분산은 빼지지 않고 더해지므로, 차의 분포가 두 분포 어느 것보다도 넓다.
뺄셈이 불확실성까지 지워 주지는 않는다. \(\bar X\)가 우연히 높게 나와도, \(\bar Y\)가 우연히 낮게 나와도 차는 커진다. 두 방향의 요동이 모두 차에 실리므로 합쳐지는 것이다.
여기서 실무적인 귀결이 하나 나온다. 한쪽 집단만 크게 늘려도 차의 표준오차는 크게 줄지 않는다. 합 안의 두 항 가운데 큰 쪽이 전체를 지배하기 때문이다. 한쪽을 아무리 늘려도 그쪽 항만 \(0\) 으로 갈 뿐 다른 항은 그대로 남는다. 관측값 하나를 더 보탤 때 \(\sigma_i^2/n_i\) 가 줄어드는 양은 대략 \(\sigma_i^2/n_i^2\) 이므로 이 값이 큰 집단을 늘리는 편이 효과적이고, 두 표준편차가 같다면 그것은 언제나 작은 집단이다.
정확한 정규성과 근사적 정규성
두 모집단이 정확히 정규이면 표본크기와 무관하게 \(Z\)가 정확히 \(N(0, 1)\)을 따른다. 모집단이 정규가 아니면 중심극한정리에 의해 \(n_1\)과 \(n_2\)가 충분히 클 때 \(Z\)가 근사적으로 \(N(0, 1)\)이다. 흔한 지침은 \(n_1 \geq 30\)이고 \(n_2 \geq 30\)이지만, 이 기준은 모집단 분포가 정규에서 얼마나 벗어나 있는지에 달려 있다.
4. 검정 — 기각역과 p 값
\(z_{1-\alpha}\)를 누적확률 \(1-\alpha\) 의 표준정규 분위수(quantile, 곧 상위 꼬리 넓이가 \(\alpha\) 인 점), \(z_{\text{obs}}\)를 검정통계량의 관측값이라 하자.
양측검정 (Hₐ: μ₁ - μ₂ ≠ δ₀)
기각역(rejection region): \(|z_{\text{obs}}| > z_{1-\alpha/2}\)이면 \(H_0\)을 기각한다.
p 값:
여기서 \(\Phi\)는 표준정규 누적분포함수(cumulative distribution function)이다.
좌측검정 (Hₐ: μ₁ - μ₂ < δ₀)
기각역: \(z_{\text{obs}} < -z_{1-\alpha}\)이면 \(H_0\)을 기각한다.
p 값:
우측검정 (Hₐ: μ₁ - μ₂ > δ₀)
기각역: \(z_{\text{obs}} > z_{1-\alpha}\)이면 \(H_0\)을 기각한다.
p 값:
보기 1. 표준화 시험 점수의 비교. 두 학군이 서로 다른 수학 교육과정을 채택했다. 과거 시험 자료에서 점수의 모표준편차가 \(\sigma_1 = 12\)(A 학군), \(\sigma_2 = 15\)(B 학군)로 알려져 있다. A 학군 학생 \(n_1 = 50\)명의 확률표본에서 평균 점수 \(\bar{x} = 78\)을, B 학군 학생 \(n_2 = 60\)명의 확률표본에서 평균 점수 \(\bar{y} = 74\)를 얻었다. \(\alpha = 0.05\)에서 두 학군의 평균 점수가 다른지 검정하라.
풀이
1단계: 가설을 세운다.
2단계: 표준오차를 계산한다.
3단계: 검정통계량을 계산한다.
4단계: p 값을 계산한다.
5단계: 판정한다. \(p \approx 0.120 > 0.05 = \alpha\)이므로 \(H_0\)을 기각하지 못한다. 5% 유의수준에서 두 학군의 평균 수학 점수가 다르다고 결론지을 증거가 부족하다.
보기 2. 두 평균의 z 검정 구현 — 표본을 늘리면 어디까지 갈 수 있는가. 보기 1의 자료(\(\bar x - \bar y = 4\), \(\sigma_1 = 12\), \(\sigma_2 = 15\), \(n_1 = 50\), \(n_2 = 60\))에서 양측 \(p = 0.120\)이었다. 관측된 차이 4점은 그대로 둔 채 표본만 늘린다.
(1) 두 표본크기를 같은 배수 \(k\)로 늘리면 \(z\)가 어떻게 변하는지 식으로 쓰고, \(p < 0.05\)가 되는 가장 작은 정수 \(k\)를 구하시오.
(2) A 학군은 더 조사할 수 없어 \(n_1 = 50\)에 묶여 있다. B 학군만 늘릴 때 \(z\)가 올라갈 수 있는 상한과 \(p\)의 하한을 구하고, \(p < 0.05\)에 필요한 \(n_2\)를 구하시오.
풀이
(1) 해석적으로. 표준오차 안의 두 항이 모두 \(n_i\)에 반비례하므로 \(n_1 \to kn_1\), \(n_2 \to kn_2\)로 바꾸면
이고, 분자인 관측된 차이는 그대로이므로
\(z\)는 \(\sqrt{k}\)로만 자란다. \(z(1) = 4/2.574879 = 1.553471\)이므로
이고 가장 작은 정수는 \(k = 2\)다. 곧 \(n_1 = 100\), \(n_2 = 120\)이면 된다.
(2) 한쪽만 늘릴 때. \(n_1 = 50\)이 고정이면 \(\sigma_1^2/n_1 = 144/50 = 2.88\)은 줄지 않는다. \(n_2 \to \infty\)에서 둘째 항만 사라지므로
이고 \(p\)의 하한은 \(2\bigl[1 - \Phi(2.357023)\bigr] = 0.018422\)다. B 학군을 백만 명 조사해도 \(p\)를 \(0.0184\) 아래로 내릴 수 없다. 고정된 항이 표준오차의 바닥을 만들기 때문이다. \(\S 3\) 에서 "합 안의 큰 쪽이 전체를 지배한다"고 한 말이 이 바닥이다 — \(n_2\) 가 커지면 줄지 않는 \(2.88\) 이 합의 큰 쪽이 된다.
\(p < 0.05\)에 필요한 \(n_2\)는 \(\text{SE} < 4/1.959964 = 2.040852\)에서
이므로 \(n_2 = 176\)이다. 총 관측값은 \(50 + 176 = 226\)개로, (1)의 비례 확장 \(100 + 120 = 220\)개보다 오히려 많다. 그러고도 \(p\) 는 \(0.0498\) 로 \(0.05\) 를 겨우 밑도는데 비례 확장은 \(0.028\) 까지 내려간다. 한쪽만 늘리는 길이 둘을 함께 늘리는 길보다 비효율적이라는 것이 수로 확인된다.
수치적으로. 먼저 검정 함수를 만든다.
import numpy as np
from scipy import stats

def two_sample_z_test(x_bar, y_bar, sigma1, sigma2, n1, n2,
                      delta0=0, alternative="two-sided"):
    """두 평균의 차이에 대한 이표본 z 검정.

    Parameters
    ----------
    x_bar, y_bar : float
        Sample means.
    sigma1, sigma2 : float
        Known population standard deviations.
    n1, n2 : int
        Sample sizes.
    delta0 : float
        Hypothesized difference (default 0).
    alternative : str
        'two-sided', 'less', or 'greater'.

    Returns
    -------
    z_stat : float
        Test statistic.
    p_value : float
        P-value.
    """
    # sigma를 알고 있으므로 표본에서 추정하지 않는다.
    # 그래서 자유도라는 개념이 없고 표준정규를 그대로 쓴다.
    se = np.sqrt(sigma1**2 / n1 + sigma2**2 / n2)
    z_stat = ((x_bar - y_bar) - delta0) / se

    if alternative == "two-sided":
        p_value = 2 * (1 - stats.norm.cdf(abs(z_stat)))
    elif alternative == "less":
        p_value = stats.norm.cdf(z_stat)
    elif alternative == "greater":
        p_value = 1 - stats.norm.cdf(z_stat)
    else:
        raise ValueError("alternative must be 'two-sided', 'less', or 'greater'")

    return z_stat, p_value


# 보기 1 의 자료
z, p = two_sample_z_test(78, 74, 12, 15, 50, 60, alternative="two-sided")
print(f"z = {z:.3f}, p-value = {p:.3f}")
출력:
z = 1.553, p-value = 0.120
이제 (1)과 (2)의 식을 확인한다.
z95 = stats.norm.ppf(0.975)
sigma1, sigma2, n1, n2, diff = 12.0, 15.0, 50, 60, 4.0

# (1) 두 표본을 같은 배수 k 로 늘린다.
print("   k    n1    n2       SE        z         p")
for k in (1, 2, 3, 4):
    se = np.sqrt(sigma1**2 / (n1 * k) + sigma2**2 / (n2 * k))
    z = diff / se
    print(f"{k:4d} {n1 * k:5d} {n2 * k:5d} {se:8.4f} {z:8.4f}"
          f"  {2 * stats.norm.sf(z):.6f}")
z1 = diff / np.sqrt(sigma1**2 / n1 + sigma2**2 / n2)
print(f"\np < 0.05 가 되는 k 의 임계값 = (z_0.975/z_1)^2 = {(z95 / z1)**2:.6f}"
      f"  →  k = 2")

# (2) B 학군만 늘린다. n1 은 50 에 묶여 있다.
print("\n      n2       SE        z         p")
for m in (60, 176, 1000, 10**6):
    se = np.sqrt(sigma1**2 / n1 + sigma2**2 / m)
    z = diff / se
    print(f"{m:8d} {se:8.4f} {z:8.4f}  {2 * stats.norm.sf(z):.6f}")
se_inf = sigma1 / np.sqrt(n1)
print(f"{'무한':>8} {se_inf:8.4f} {diff / se_inf:8.4f}  "
      f"{2 * stats.norm.sf(diff / se_inf):.6f}   ← 하한")

need = sigma2**2 / ((diff / z95)**2 - sigma1**2 / n1)
print(f"\np < 0.05 에 필요한 n2 > {need:.4f}  →  n2 = {int(np.ceil(need))}")
출력:
   k    n1    n2       SE        z         p
   1    50    60   2.5749   1.5535  0.120311
   2   100   120   1.8207   2.1969  0.028025
   3   150   180   1.4866   2.6907  0.007130
   4   200   240   1.2874   3.1069  0.001890

p < 0.05 가 되는 k 의 임계값 = (z_0.975/z_1)^2 = 1.591804  →  k = 2

      n2       SE        z         p
      60   2.5749   1.5535  0.120311
     176   2.0392   1.9615  0.049816
    1000   1.7621   2.2700  0.023207
 1000000   1.6971   2.3569  0.018427
      무한   1.6971   2.3570  0.018422   ← 하한

p < 0.05 에 필요한 n2 > 175.0858  →  n2 = 176
(1)이 그대로 맞는다. \(k = 4\)에서 \(z = 3.1069\)로 \(k = 1\)의 \(1.5535\)의 정확히 두 배이고, \(k = 2\)에서 \(p = 0.028 < 0.05\), \(k = 1\)에서는 \(0.120\)이다. 임계값 \(1.5918\)을 넘는 첫 정수가 2라는 것과 맞는다.
(2)도 맞는다. \(n_2 = 176\)에서 \(p = 0.049816\)으로 겨우 \(0.05\)를 밑돌고, \(n_2 = 175\)에서는 \(0.050017\)로 넘는다. \(n_2 = 10^6\)의 \(p = 0.018427\)은 해석적 하한 \(0.018422\)와 소수 다섯째 자리에서야 갈라진다.
같은 4점 차이를 놓고 \(p\)가 \(0.120\)에서 \(0.0019\)까지 움직인다. p 값이 말해 주는 것은 효과의 크기가 아니라 "이 표본크기에서 이만한 차이를 우연으로 보기 어려운가"다. 네 경우의 효과크기(effect size)는 완전히 같다. 그리고 \(n_2\)만 늘리는 길에서는 \(p\)가 아무리 가도 \(0.0184\)에 걸려 멈춘다. 표본을 늘려서 얻을 수 있는 유의성에는 설계가 정하는 천장이 있다.
5. 가정 — 분산을 안다는 것이 첫째다
이표본 z-검정에는 네 가지 조건이 필요하다.
- 분산을 안다: 모분산 \(\sigma_1^2\)과 \(\sigma_2^2\)이 자료에서 추정한 값이 아니라 알려진 값이다. 추정해야 한다면 이표본 t-검정을 쓴다.
- 표본 간 독립성(independence): 두 표본이 서로 독립적으로 뽑혔다. 한 표본의 관측값이 다른 표본의 관측값에 영향을 주거나 짝지어져 있지 않다.
- 표본 내 독립성: 각 표본 안의 관측값이 독립이다(예: 단순확률표본추출).
- 정규성(normality) 또는 큰 표본: 각 모집단이 정규분포를 따르거나, 표본크기가 중심극한정리로 충분한 정규근사를 얻을 만큼 크다(\(n_1 \geq 30\), \(n_2 \geq 30\)).
분산을 아는 경우는 현실적이지 않다
실무에서 모분산을 확실히 아는 경우는 거의 없다. 따라서 이표본 z-검정은 일상적인 분석 도구라기보다 이론적인 디딤돌에 가깝다. 분산을 모를 때 평균을 비교하는 표준 절차는 이표본 t-검정이다.
보기 3. 표본표준편차를 \(\sigma\) 자리에 넣는 \(z\) 검정. 프랑스와 스위스의 여성 각 100명을 뽑아 낳은 아이 수를 세었더니 평균이 1.85명과 1.65명, 표준편차가 1.3명과 1.2명이었다. 모분산은 모르지만 표본이 커서 \(\sigma_i\) 자리에 \(s_i\)를 넣는다.
(1) \(z\) 통계량과 양측 \(p\) 값을 손으로 계산하고, \(\alpha = 0.05\)에서 기각하려면 두 표본평균의 차가 얼마 이상이어야 하는지 구하시오.
(2) 코드로 (1)을 확인하고, 참 차이가 0.2명일 때 그것을 80% 확률로 잡아내려면 집단당 몇 명을 뽑아야 하는지 구하시오.
풀이
(1) 해석적으로. 분모는 두 집단의 분산을 합친 것이다.
따라서
이다. 기각 경계는 \(\lvert \bar x_1 - \bar x_2 \rvert > z_{0.975}\,\mathrm{SE} = 1.95996 \times 0.176918 = 0.3468\)이므로, 관측된 차 0.2는 필요한 0.3468의 58%밖에 되지 않는다. 0.2라는 차가 작아서가 아니라 개인차(표준편차 1.3과 1.2)가 그 차보다 여섯 배 크기 때문이다.
(2) 수치적으로.
import numpy as np
from scipy import stats

n_f, n_s = 100, 100
x_bar_f, x_bar_s = 1.85, 1.65
s_f, s_s = 1.3, 1.2

# n이 각각 100이라 크므로 sigma 자리에 표본표준편차를 넣고 z를 쓴다.
statistic = (x_bar_f - x_bar_s) / np.sqrt(s_f**2/n_f + s_s**2/n_s)
p_value = stats.norm().sf(abs(statistic)) * 2

print(f"statistic : {statistic:.4f}")
print(f"p value   : {p_value:.4f}")
출력:
statistic : 1.1305
p value   : 0.2583
\(1.1305\)와 \(0.2583\)이 손으로 낸 값과 소수 넷째 자리까지 같다.
필요한 표본크기는 양측 \(\alpha\)와 검정력 \(1-\beta\)에 대한 표준 공식
에서 나온다. 올림하면 집단당 615명이다.
import numpy as np
from scipy import stats

se = np.sqrt(1.3**2 / 100 + 1.2**2 / 100)
z_crit = stats.norm.ppf(0.975)
print(f"SE             = {se:.6f}")
print(f"기각 경계 차이 = {z_crit * se:.6f}")

# 0.2 의 차를 양측 5% 검정으로 80% 확률로 잡아내려면 집단당 몇 명인가.
n_formula = (z_crit + stats.norm.ppf(0.8)) ** 2 * (1.3**2 + 1.2**2) / 0.2**2
print(f"공식이 주는 n  = {n_formula:.2f}")
for n in (613, 614, 615):
    s = np.sqrt(3.13 / n)
    power = stats.norm.sf(z_crit - 0.2 / s) + stats.norm.cdf(-z_crit - 0.2 / s)
    print(f"  n = {n}: 검정력 {power:.4f}")
출력:
SE             = 0.176918
기각 경계 차이 = 0.346753
공식이 주는 n  = 614.17
  n = 613: 검정력 0.7992
  n = 614: 검정력 0.7999
  n = 615: 검정력 0.8005
공식의 \(614.17\)이 정확한 검정력 계산과 맞는다. \(n = 614\)에서 검정력이 \(0.7999\)로 \(0.80\)에 간발의 차로 못 미치고 \(615\)에서 \(0.8005\)로 넘어선다.
읽어야 할 것은 100 대 615라는 격차다. 관측된 차 0.2가 참값이라 해도 집단당 100명으로는 그것을 잡아낼 확률이
밖에 안 된다(\(0.8295 = z_{0.975} - 0.2/0.176918\), 뒤의 항은 반대쪽 꼬리다). 이 설계는 애초에 다섯 번 중 한 번만 성공하도록 되어 있었다. 기각하지 못한 것은 "차이가 없다"는 증거가 아니라 표본이 모자랐다는 증거다.
6. 이표본 t-검정과의 관계
이표본 z-검정과 이표본 t-검정은 구조가 같다. 차이는 분모뿐이다: z-검정은 알려진 분산 \(\sigma_1^2\)과 \(\sigma_2^2\)을 쓰고, t-검정은 이를 표본분산(sample variance) \(S_1^2\)과 \(S_2^2\)으로 바꾼다. 이 대체가 추가적인 불확실성을 낳으므로 t-검정은 표준정규가 아니라 (꼬리가 더 두꺼운) \(t\)-분포를 쓴다. 표본크기가 커지면 \(t\)-분포가 표준정규에 가까워져 두 검정이 같아진다.
그림으로 보는 통계학 1. 유의한 것과 유의하지 않은 것의 차이
이 쪽이 하는 일은 두 평균의 차이를 하나의 검정으로 재는 것이다. 당연해 보이는데, 실제 논문에서 가장 흔히 건너뛰는 단계가 바로 이것이다. 연구 둘을 나란히 놓고 각각 따로 검정한 뒤 그 결과를 견주는 일 말이다.
\(2006\) 년 『The American Statistician』 \(60\) 권 \(328\)–\(331\) 쪽에 앤드루 겔먼(Andrew Gelman)과 핼 스턴(Hal Stern)이 쓴 네 쪽짜리 글의 제목이 그 습관을 그대로 가리킨다 — 「「유의하다」와 「유의하지 않다」의 차이는 그 자체로 통계적으로 유의하지 않다」.
그들이 든 보기는 산수만으로 끝난다. 독립인 두 연구의 효과 추정값과 표준오차가 \(25 \pm 10\) 과 \(10 \pm 10\) 이라고 하자.
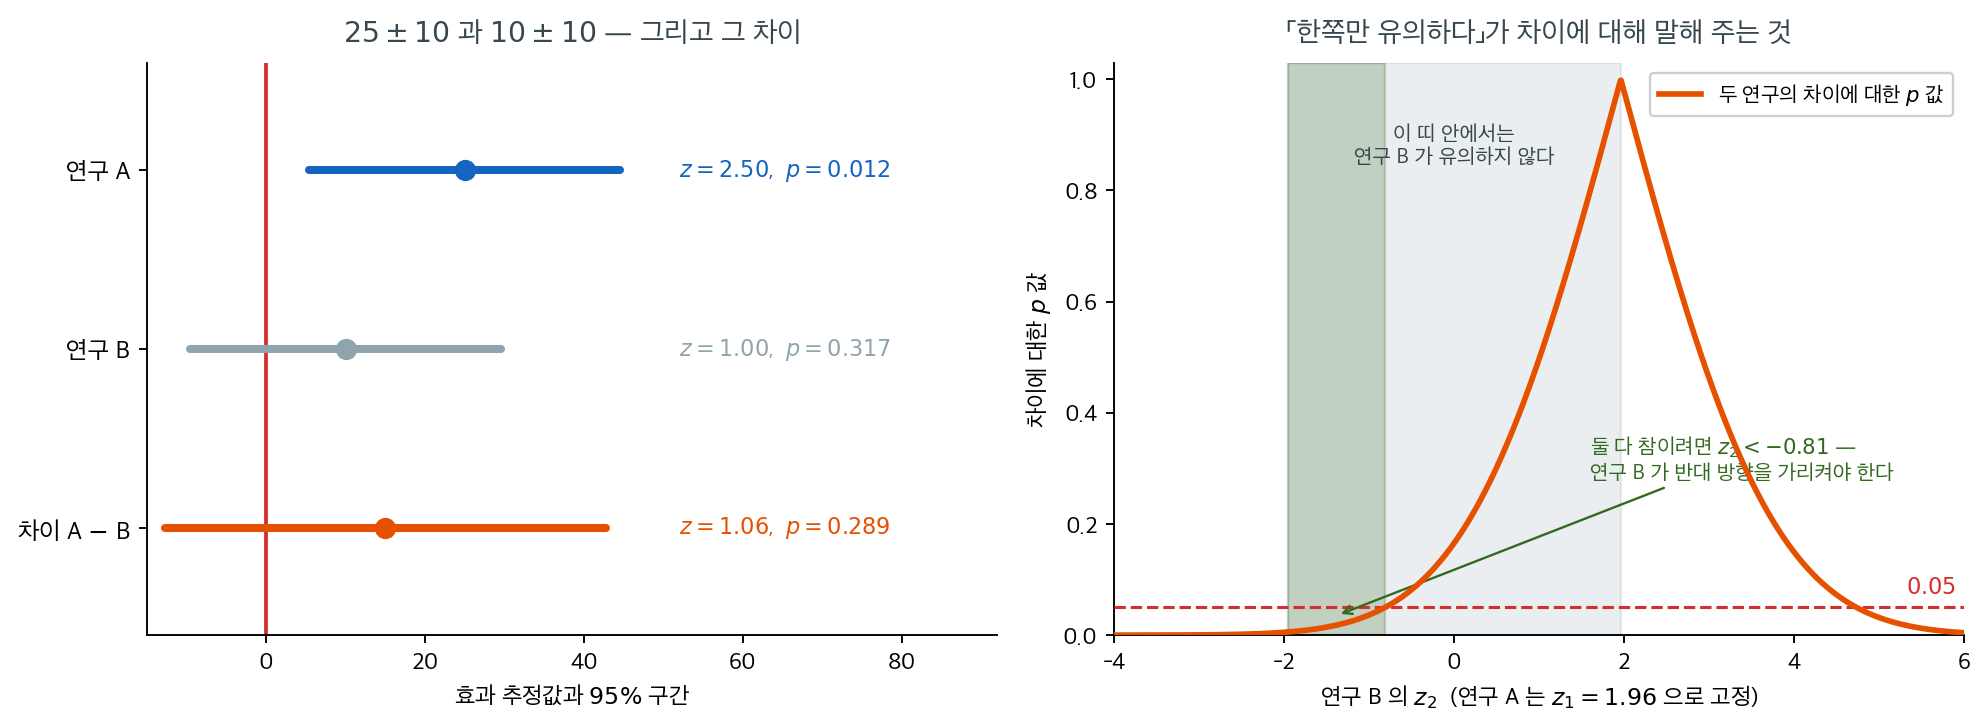
왼쪽 그림대로다. 연구 \(\mathrm A\) 는 \(z = 2.50\), 양측 \(p = 0.012\) 로 뚜렷이 유의하다(논문은 「\(1\%\) 수준에서 유의」라 적는데, 단측으로 세면 \(p = 0.006\) 이다). 연구 \(\mathrm B\) 는 \(z = 1.00\), \(p = 0.317\) 로 \(0\) 에서 겨우 표준오차 하나 떨어져 있어 전혀 유의하지 않다. 그래서 두 연구가 크게 다르다고 말하고 싶어진다. 그런데 차이를 직접 재면
이고 \(z = 1.06\), \(p = 0.289\) 다. 겔먼과 스턴의 표현으로 「유의한 것에 근처도 가지 못한다」. \(95\%\) 구간이 \([-12.7,\ 42.7]\) 로 \(0\) 을 넉넉히 품는다.
오른쪽이 이것이 예외가 아님을 보여 준다. 연구 \(\mathrm A\) 를 딱 경계인 \(z_1 = 1.96\) 에 고정하고 연구 \(\mathrm B\) 의 \(z_2\) 를 훑은 것인데, 차이가 유의하려면
이어야 한다. 회색 띠가 「연구 \(\mathrm B\) 는 유의하지 않다」인데, 그 안에서 차이까지 유의해지는 구간은 왼쪽 끝 초록 조각 \((-1.96,\ -0.81)\) 뿐이다. 연구 \(\mathrm B\) 가 반대 방향을 가리킬 때뿐이라는 뜻이다. 두 연구가 같은 방향을 보고 있는 한, 한쪽만 유의하다는 사실은 둘이 다르다는 증거가 거의 되지 못한다.
까닭은 이 쪽의 \(\S 3\) 이 이미 적은 그대로다. 차이의 표준오차는 둘을 더해서 커진다(\(\sqrt 2\) 배). 각각을 \(0\) 과 견주는 일과 서로를 견주는 일은 분모가 다른 서로 다른 검정이고, 앞의 둘을 아무리 들여다보아도 뒤의 하나가 나오지 않는다. 비교하고 싶으면 비교를 검정해야 한다.
확인한 곳 — 논문이 Andrew Gelman 과 Hal Stern 의 「The Difference Between "Significant" and "Not Significant" is not Itself Statistically Significant」이고 『The American Statistician』 \(60\) 권 \(328\)–\(331\) 쪽(\(2006\))이라는 것, 그리고 보기의 설정과 서술(「독립인 두 연구의 효과 추정값과 표준오차가 \(25 \pm 10\) 과 \(10 \pm 10\)」·「첫 연구는 \(1\%\) 수준에서 유의하고 둘째는 \(0\) 에서 표준오차 하나 떨어져 전혀 유의하지 않다」·「두 연구에 큰 차이가 있다고 결론짓고 싶어지지만 실은 그 차이가 유의한 것에 근처도 가지 못한다」·추정된 차이 \(15\) 와 표준오차 \(\sqrt{10^2+10^2}=14\))는 그 논문 에서 직접 읽었다. \(z\) 값과 \(p\) 값, \(95\%\) 구간, 그리고 오른쪽 그림의 경계 \(-0.81\) 과 \(4.73\) 은 모두 직접 계산한 값이다
7. 관련 주제
- 이표본 t-검정 (스튜던트와 웰치): 모분산을 모를 때의 표준 검정
- p₁−p₂에 대한 이표본 Z-검정: 두 모비율(population proportion)의 비교
- σ₁²/σ₂²에 대한 F-검정: 모분산의 동일성 검정
연습문제
연습문제 1. 독립인 두 표본: \(\bar{x}_1 = 82\), \(\sigma_1 = 10\), \(n_1 = 50\)이고 \(\bar{x}_2 = 78\), \(\sigma_2 = 12\), \(n_2 = 60\). 양측 z-검정으로 \(\alpha = 0.05\)에서 \(H_0: \mu_1 - \mu_2 = 0\)을 검정하라.
풀이
검정통계량은 이렇게 된다.
양측검정(two-sided test)의 임계값은 \(z_{0.975} = 1.96\)이다. \(|Z| = 1.907 < 1.96\)이므로 \(H_0\)을 기각하지 못한다.
p 값은 \(2P(Z > 1.907) = 2(0.02827) = 0.0565\)이다. \(\alpha = 0.05\)에서 증거가 시사적이기는 하지만 통계적으로 유의하지는 않다.
연습문제 2. 연습문제 1의 자료로 \(\mu_1 - \mu_2\)의 95% 신뢰구간을 구성하라. 이 구간이 0을 포함하는가?
풀이
\(\mu_1 - \mu_2\)의 95% 신뢰구간은 이렇게 된다.
구간이 0을 포함하며, 연습문제 1에서 \(H_0\)을 기각하지 못한 것과 일관된다. 참고: 신뢰구간은 가설검정보다 많은 정보를 준다 — 참 차이가 작은 음수에서 약 8단위까지 걸쳐 있을 수 있음을 보여준다.
연습문제 3. 연습문제 5가 다룬 \(z\)와 \(t\)의 관계를 수치로 확인하라. \(n\)이 얼마나 커야 \(z\) 근사를 써도 되는가?
풀이
from scipy import stats

z95 = stats.norm.ppf(0.975)
print(f"{'자유도':>7s} {'t 임계값':>10s} {'z 임계값':>10s} "
      f"{'z 를 쓸 때 실제 수준':>21s}")
for df in [5, 10, 20, 30, 50, 100, 200, 1000]:
    print(f"{df:7d} {stats.t.ppf(0.975, df):10.4f} {z95:10.4f} "
          f"{2 * stats.t.sf(z95, df):21.4f}")
    자유도      t 임계값      z 임계값         z 를 쓸 때 실제 수준
      5     2.5706     1.9600                0.1073
     10     2.2281     1.9600                0.0784
     20     2.0860     1.9600                0.0641
     30     2.0423     1.9600                0.0593
     50     2.0086     1.9600                0.0556
    100     1.9840     1.9600                0.0528
    200     1.9719     1.9600                0.0514
   1000     1.9623     1.9600                0.0503
\(\sigma\)를 모르면서 \(z\)를 쓰면 항상 과대기각한다. \(t\) 분포의 꼬리가 정규보다 두꺼운데 정규의 임계값을 쓰기 때문이다.
| 자유도 | 실제 수준 | 명목 대비 |
|---|---|---|
| 5 | 0.107 | 2.1배 |
| 20 | 0.064 | 1.3배 |
| 30 | 0.059 | 1.2배 |
| 100 | 0.053 | 1.06배 |
| 1000 | 0.050 | 1.01배 |
흔히 쓰는 "\(n\ge30\)이면 \(z\)" 규칙은 실제 수준 0.059를 허용하는 셈이다. 명목의 19% 초과다. 엄밀함이 필요하면 부족한 기준이다.
더 나은 규칙 — 그냥 \(t\)를 쓴다.
- 소프트웨어가 다 해 준다. 손으로 표를 찾던 시절의 규칙을 따를 이유가 없다.
- \(n\)이 크면 \(t\)와 \(z\)가 어차피 같다. 자유도 1000에서 임계값이 1.9623 대 1.9600으로 0.1% 차이다. \(t\)를 써서 잃는 것이 없다.
- \(n\)이 작으면 \(t\)가 옳다. 그러니 어느 경우에도 \(t\)가 낫다.
\(z\) 검정을 배우는 이유는 여전히 있다.
- 개념적 토대: 검정통계량 \(=\) (추정값 \(-\) 가설값)/표준오차라는 구조를 가장 깨끗하게 보여 준다.
- 표본크기 설계: 설계 단계에서는 \(\sigma\)를 어차피 가정하므로 \(z\) 기반 공식이 자연스럽다(연습문제 7).
- 대표본 이론: 최대가능도 추정량의 점근정규성, 비율 검정, 회귀계수(regression coefficient)의 왈드(Wald) 검정이 모두 \(z\)의 형태다.
- \(\sigma\)를 실제로 아는 드문 경우: 공정관리, 계측기 명세 등.
주의 — 자유도 조정이 만능은 아니다. \(t\)를 쓰면 "\(\sigma\)를 추정한 탓의 불확실성"은 해결되지만, 정규성과 독립성 위반은 여전히 남는다. \(t\)가 \(z\)보다 안전한 것은 딱 한 가지 측면에서다.
연습문제 4. 이표본 \(z\) 검정의 사용 조건과 보고 양식을 정리하라.
풀이
언제 쓰는가 — 셋 중 하나여야 한다.
| 상황 | 예 |
|---|---|
| \(\sigma\)를 정말 안다 | 오랜 이력의 제조 공정, 계측기 명세 |
| \(n\)이 매우 크다 | \(n\ge1000\) 정도면 \(t\)와 실질적으로 같다 |
| 점근이론의 \(z\) | 비율 검정, 최대가능도 왈드 검정, 회귀계수 |
첫 줄은 드물고, 둘째 줄이면 \(t\)를 써도 되며, 셋째 줄이 실제로 가장 흔한 용도다.
가정 점검.
- [ ] 두 표본이 독립인가 (가장 중요하고 가장 확인하기 어렵다)
- [ ] 각 표본이 확률표본인가
- [ ] \(\sigma_1,\sigma_2\)의 근거가 무엇인가 — 출처를 밝힌다
- [ ] 그 \(\sigma\)가 여전히 유효한가 (공정 변경, 장비 교체)
- [ ] 모집단이 정규이거나 \(n\)이 충분히 큰가
- [ ] 이상치(outlier)이 평균을 지배하지 않는가
보고 양식.
집단 1(\(n_1=50\))의 평균은 82.0, 집단 2(\(n_2=60\))는 78.0이었다. 두 모표준편차는 과거 자료에서 각각 \(\sigma_1=10\), \(\sigma_2=12\)로 알려져 있다. 평균 차이는 4.0(95% CI \(-0.11\)~\(8.11\)), \(z=1.91\), 양측 \(p=0.057\)로 5% 수준에서 유의하지 않았다. 다만 이 설계의 검정력은 참 차이가 4일 때 0.48에 불과하므로, 이 결과를 "차이가 없다"는 근거로 삼을 수 없다. 한편 비열등성 검정에서는 집단 1이 집단 2보다 2 이상 낮지 않음을 보일 수 있었다(\(p=0.002\)).
이 보고문이 담은 것.
- 두 집단의 \(n\), 평균, 그리고 \(\sigma\)의 출처
- 차이의 추정값과 신뢰구간 — \(p\)보다 먼저
- 검정통계량과 \(p\)
- 검정력 — "유의하지 않음"을 오독하지 않도록
- 할 수 있는 주장(비열등성)을 적극적으로
자주 하는 실수 다섯.
- \(s\)를 \(\sigma\)처럼 쓰기. \(n\)이 작으면 수준이 두 배까지 부풀 수 있다(연습문제 3).
- \(\sigma\)를 작게 잡기. 표본을 키워도 고쳐지지 않는다(연습문제 10).
- 자료를 보고 단측으로 바꾸기. 수준이 두 배(연습문제 8).
- \(p>0.05\)를 "차이 없음"으로 읽기. 검정력 0.48짜리 설계였다(연습문제 7).
- 독립성을 확인하지 않기. 다른 모든 가정을 합친 것보다 치명적이다.
한 문장. \(z\) 검정은 배우기 위한 검정이고, 실제로 쓸 일은 생각보다 적다. 그 구조를 이해하면 \(t\) 검정, 비율 검정, 왈드 검정이 모두 같은 틀의 변주임이 보인다.
연습문제 5. 이표본 z-검정과 이표본 t-검정이 각각 언제 적절한지 설명하라. 모분산에 대한 어떤 가정이 결정적인가?
풀이
이표본 z-검정은 모분산 \(\sigma_1^2\)과 \(\sigma_2^2\)을 알 때 적절하다. 이때 검정통계량 \(Z = (\bar{X}_1 - \bar{X}_2)/\sqrt{\sigma_1^2/n_1 + \sigma_2^2/n_2}\)은 \(H_0\) 아래에서 두 모집단이 정규이면 정확히, 표본이 크면 근사적으로 표준정규분포를 따른다.
이표본 t-검정은 모분산을 모르고 자료에서 추정해야 할 때 쓴다. 분산을 표본분산 \(s_1^2, s_2^2\)으로 바꾸며, 검정통계량은 (분산이 다를 때는 웰치(Welch) 근사로) 근사적인 t-분포를 따르거나 (\(\sigma_1^2 = \sigma_2^2\)일 때 합동분산(pooled variance)으로) 정확한 t-분포를 따른다.
실무에서 모분산을 아는 경우는 거의 없으므로 t-검정이 훨씬 흔하다. z-검정은 주로 교육적인 디딤돌 역할을 하며, 표본이 아주 커서 \(\sigma\)와 \(s\)의 구분이 무시할 만할 때 적용할 수 있다.
연습문제 6. "추정값 빼기 가설값을 표준오차로 나눈다"는 일반 원리에서 이표본 z-검정통계량을 유도할 수 있음을 보여라. \(\bar{X}_1 - \bar{X}_2\)의 표준오차는 무엇인가?
풀이
일반적인 검정통계량의 구조는 이렇게 된다.
\(\bar{X}_1\)과 \(\bar{X}_2\)가 독립이므로 이렇게 된다.
\(H_0: \mu_1 - \mu_2 = \delta_0\)(보통 \(\delta_0 = 0\)) 아래에서 중심극한정리 또는 자료의 정확한 정규성에 의해 \(Z \sim N(0, 1)\)이다. 이 유도는 단일 평균에 대한 z-검정, 비율에 대한 z-검정, 이표본 z-검정을 하나의 틀로 통합한다.
연습문제 7. 연습문제 1의 설계가 갖는 검정력을 계산하라. 참 차이를 바꿔 가며 필요한 표본크기도 구하고, 주어진 총 표본을 어떻게 나누는 것이 최적인지 확인하라.
풀이
검정력 공식. \(\sigma\)를 알면 비중심 \(t\)가 필요 없다. \(\bar X_1-\bar X_2\sim N(\delta,\ \text{SE}^2)\)이므로
import numpy as np
from scipy import stats

x1, s1, n1 = 82.0, 10.0, 50
x2, s2, n2 = 78.0, 12.0, 60
se = np.sqrt(s1**2 / n1 + s2**2 / n2)
z = (x1 - x2) / se
print(f"관측: SE={se:.4f}  z={z:.4f}  p={2 * stats.norm.sf(abs(z)):.4f}")

def power_z(n1, n2, delta, s1, s2, alpha=0.05):
    se = np.sqrt(s1**2 / n1 + s2**2 / n2)
    za = stats.norm.ppf(1 - alpha / 2)
    return (stats.norm.sf(za - delta / se)
            + stats.norm.cdf(-za - delta / se))

def n_z(delta, s1, s2, power=0.80, alpha=0.05, ratio=1.0):
    """n2 = ratio * n1 로 두었을 때 필요한 (n1, n2)."""
    za, zb = stats.norm.ppf(1 - alpha / 2), stats.norm.ppf(power)
    m = ((za + zb) / delta)**2 * (s1**2 + s2**2 / ratio)
    return int(np.ceil(m)), int(np.ceil(ratio * np.ceil(m)))

print(f"\n{'참 차이':>7s} {'현 설계 검정력':>14s} {'필요 n1':>8s} {'필요 n2':>8s}")
for d in [2, 3, 4, 5, 6]:
    a, b = n_z(d, s1, s2, ratio=1.2)
    print(f"{d:7.1f} {power_z(n1, n2, d, s1, s2):14.4f} {a:8d} {b:8d}")

print(f"\n총 {n1 + n2}명을 어떻게 나눌까 (참 차이 4)")
for a in [40, 45, 50, 55, 60]:
    b = n1 + n2 - a
    print(f"  n1={a:3d}, n2={b:3d}:  SE={np.sqrt(s1**2 / a + s2**2 / b):.4f}  "
          f"검정력 {power_z(a, b, 4.0, s1, s2):.4f}")
tot = n1 + n2
print(f"  네이만 최적 배분 σ1:σ2 = {s1:.0f}:{s2:.0f} → "
      f"n1={tot * s1 / (s1 + s2):.1f}, n2={tot * s2 / (s1 + s2):.1f}")
관측: SE=2.0976  z=1.9069  p=0.0565

   참 차이       현 설계 검정력    필요 n1    필요 n2
    2.0         0.1589      432      519
    3.0         0.2985      192      231
    4.0         0.4789      108      130
    5.0         0.6641       70       84
    6.0         0.8161       48       58

총 110명을 어떻게 나눌까 (참 차이 4)
  n1= 40, n2= 70:  SE=2.1347  검정력 0.4657
  n1= 45, n2= 65:  SE=2.1066  검정력 0.4757
  n1= 50, n2= 60:  SE=2.0976  검정력 0.4789
  n1= 55, n2= 55:  SE=2.1063  검정력 0.4758
  n1= 60, n2= 50:  SE=2.1323  검정력 0.4666
  네이만 최적 배분 σ1:σ2 = 10:12 → n1=50.0, n2=60.0
1 — 이 설계는 검정력이 낮다. 관측된 차이 4가 참값이라 해도 검정력이 0.479다. 절반 이상의 확률로 놓친다. \(p=0.0565\)로 아슬아슬하게 기각하지 못한 것이 우연이 아니다.
2 — 80% 검정력을 원했다면 차이 4에 대해 \(n_1=108\), \(n_2=130\)이 필요했다. 실제 표본의 2배가 넘는다.
3 — 우연히도 실제 배분(50:60)이 정확히 최적이다. 네이만(Neyman) 배분은 표준편차에 비례하므로 \(\sigma_1{:}\sigma_2=10{:}12=50{:}60\)이다.
4 — 배분이 어긋나도 손해가 작다. 40:70과 60:50에서도 검정력이 0.466~0.467로, 최적(0.479)보다 1%포인트 남짓 낮을 뿐이다. 최적 배분은 얻을 것이 적고 잘못 쓰면 잃을 것이 있는 조정이므로, \(\sigma\) 비를 확신할 수 없으면 균등 배분이 무난하다.
표본크기가 \(\delta^2\)에 반비례한다. 차이 2를 잡으려면 432명, 차이 6이면 48명으로 9배 차이난다. 표본크기 계산에서 "탐지하고 싶은 최소 효과"를 얼마로 잡느냐가 모든 것을 좌우한다.
연습문제 8. 연습문제 1은 양측검정으로 \(p=0.0565\)였다. 단측검정으로 바꾸면 어떻게 되는가? 자료를 본 뒤 방향을 정하면 무슨 일이 생기는지 모의실험으로 보여라.
풀이
import numpy as np
from scipy import stats

x1, s1, n1 = 82.0, 10.0, 50
x2, s2, n2 = 78.0, 12.0, 60
se = np.sqrt(s1**2 / n1 + s2**2 / n2)
z = (x1 - x2) / se
print(f"z = {z:.4f}")
print(f"  양측        p = {2 * stats.norm.sf(abs(z)):.4f}  "
      f"→ {'기각' if 2 * stats.norm.sf(abs(z)) < 0.05 else '기각 못 함'}")
print(f"  단측 (μ1>μ2) p = {stats.norm.sf(z):.4f}  "
      f"→ {'기각' if stats.norm.sf(z) < 0.05 else '기각 못 함'}")
print(f"  단측 (μ1<μ2) p = {stats.norm.cdf(z):.4f}  "
      f"→ {'기각' if stats.norm.cdf(z) < 0.05 else '기각 못 함'}")

rng = np.random.default_rng(64)
M = 200_000
zz = rng.standard_normal(M)                 # H0 가 참일 때의 z
c = stats.norm.ppf(0.95)
print(f"\n사전에 방향을 지정한 단측검정: 제1종 오류율 {np.mean(zz > c):.4f}")
print(f"자료를 보고 방향을 고른 경우:   제1종 오류율 {np.mean(np.abs(zz) > c):.4f}")
z = 1.9069
  양측        p = 0.0565  → 기각 못 함
  단측 (μ1>μ2) p = 0.0283  → 기각
  단측 (μ1<μ2) p = 0.9717  → 기각 못 함

사전에 방향을 지정한 단측검정: 제1종 오류율 0.0506
자료를 보고 방향을 고른 경우:   제1종 오류율 0.1001
방향을 자료에서 고르면 수준이 정확히 두 배(0.100)가 된다. \(|Z|>z_{0.95}\)를 기각 조건으로 쓰는 셈이기 때문이다.
이 문제가 위험한 이유. 양측 \(p=0.0565\)로 아슬아슬하게 실패했는데, 단측으로 바꾸면 \(p=0.0283\)으로 통과한다. 자료를 본 뒤 이렇게 바꾸고 싶은 유혹이 가장 큰 상황이다.
단측검정이 정당한 경우.
- 반대 방향이 과학적으로 불가능하거나 무의미하다. 예: 새 촉매가 반응속도를 늦출 수는 없다.
- 반대 방향이 나와도 결정이 같다. 예: 신약이 위약보다 나빠도 "채택하지 않음"이고, 차이 없어도 "채택하지 않음"이다.
- 사전등록에 방향을 명시했다.
단측검정이 부당한 경우.
- 양측으로 유의하지 않아서 바꾼 경우 — 명백한 \(p\)-해킹.
- "이 방향일 것 같아서" 정도의 근거 — 예상이 틀릴 수 있다는 것이 연구의 전제다.
- 반대 방향의 결과도 보고할 생각이라면 그것은 이미 양측검정이다.
실무 권고 넷.
- 기본은 양측이다. 의심스러우면 양측.
- 단측을 쓰려면 자료 수집 전에 정하고 기록한다.
- 단측검정에서 반대 방향의 큰 효과가 나오면 "유의하지 않음"이 아니라 "예상과 반대 방향의 신호"로 보고한다. 결코 조용히 방향을 바꾸지 않는다.
- \(p=0.0565\)를 그대로 보고하는 것이 가장 정직하다. 0.05를 절대 기준으로 삼기보다, 구간 \((-0.11,\ 8.11)\)과 함께 "증거가 시사적이지만 결정적이지 않다"고 쓴다.
연습문제 9. \(\delta_0\neq0\)인 검정과 신뢰구간의 동치성을 확인하고, 이를 이용해 비열등성·동등성 주장을 하라.
풀이
동치성의 내용. \(\delta_0\)에 대한 양측 \(z\) 검정을 \(\alpha\) 수준에서 기각하지 않을 조건은
\(100(1-\alpha)\%\) 신뢰구간은 "기각되지 않는 \(\delta_0\)의 모임"이다.
import numpy as np
from scipy import stats

x1, s1, n1 = 82.0, 10.0, 50
x2, s2, n2 = 78.0, 12.0, 60
diff = x1 - x2
se = np.sqrt(s1**2 / n1 + s2**2 / n2)
z95 = stats.norm.ppf(0.975)
lo, hi = diff - z95 * se, diff + z95 * se
print(f"차이 {diff:.1f},  SE {se:.4f},  95% CI ({lo:.4f}, {hi:.4f})\n")

for d0 in [0, 2, 4, 6, 8, 9]:
    zs = (diff - d0) / se
    p = 2 * stats.norm.sf(abs(zs))
    inside = lo <= d0 <= hi
    print(f"δ0={d0:2d}:  z={zs:7.4f}  p={p:.4f}  "
          f"{'기각 못 함' if p >= 0.05 else '기각':10s} "
          f"구간 안? {inside}")

print(f"\n비열등성 (Δ=2, '집단 1이 집단 2보다 2 이상 나쁘지는 않다')")
z_ni = (diff + 2) / se
print(f"  z={z_ni:.4f},  단측 p={stats.norm.sf(z_ni):.6f}  → 비열등 인정")

z90 = stats.norm.ppf(0.95)
lo90, hi90 = diff - z90 * se, diff + z90 * se
for D in [6.0, 8.0]:
    p_lo = stats.norm.sf((diff + D) / se)
    p_hi = stats.norm.cdf((diff - D) / se)
    tost = max(p_lo, p_hi)
    print(f"\n동등성 TOST (Δ={D:.0f}):  p = {tost:.4f}  "
          f"→ {'동등 인정' if tost < 0.05 else '동등 미인정'}")
    print(f"  90% CI ({lo90:.4f}, {hi90:.4f}) ⊂ (-{D:.0f}, {D:.0f})?  "
          f"{-D < lo90 and hi90 < D}")
차이 4.0,  SE 2.0976,  95% CI (-0.1113, 8.1113)

δ0= 0:  z= 1.9069  p=0.0565  기각 못 함     구간 안? True
δ0= 2:  z= 0.9535  p=0.3404  기각 못 함     구간 안? True
δ0= 4:  z= 0.0000  p=1.0000  기각 못 함     구간 안? True
δ0= 6:  z=-0.9535  p=0.3404  기각 못 함     구간 안? True
δ0= 8:  z=-1.9069  p=0.0565  기각 못 함     구간 안? True
δ0= 9:  z=-2.3837  p=0.0171  기각         구간 안? False

비열등성 (Δ=2, '집단 1이 집단 2보다 2 이상 나쁘지는 않다')
  z=2.8604,  단측 p=0.002116  → 비열등 인정

동등성 TOST (Δ=6):  p = 0.1702  → 동등 미인정
  90% CI (0.5497, 7.4503) ⊂ (-6, 6)?  False

동등성 TOST (Δ=8):  p = 0.0283  → 동등 인정
  90% CI (0.5497, 7.4503) ⊂ (-8, 8)?  True
동치성이 완벽하게 성립한다. "기각 못 함"과 "구간 안"이 여섯 줄 모두에서 일치한다.
\(\delta_0=0\)과 \(\delta_0=8\)의 \(p\)가 똑같이 0.0565인 것도 자연스럽다. 둘 다 추정값 4에서 정확히 4만큼 떨어져 있다. 구간의 두 끝점은 대칭이다.
동등성 검정도 구간으로 읽힌다. TOST(two one-sided tests, 두 단측검정)는 「차이가 \(-\Delta\) 이하다」와 「차이가 \(\Delta\) 이상이다」라는 두 귀무가설을 각각 단측으로 검정해 둘 다 기각될 때 동등하다고 인정하는 절차이고, 그래서 \(p\) 값은 두 단측 \(p\) 값 가운데 큰 쪽이다. \(\alpha=0.05\)의 TOST는 90% 구간이 \((-\Delta,\Delta)\)에 완전히 들어가는 것과 동치다. 여기서 90% 구간이 \((0.55,\ 7.45)\)이므로
- \(\Delta=8\): \((0.55,7.45)\subset(-8,8)\) → 동등 인정(\(p=0.0283\))
- \(\Delta=6\): 상한 7.45가 6을 넘음 → 동등 미인정(\(p=0.1702\))
95%가 아니라 90%라는 점이 자주 틀리는 대목이다. 각 단측검정이 \(\alpha\)이므로 구간은 \(100(1-2\alpha)\%\)가 된다.
세 결론이 동시에 성립한다.
| 질문 | 답 |
|---|---|
| 차이가 0인가 | 모른다(\(p=0.057\)) |
| 차이가 8보다 작은가 | 그렇다(TOST \(p=0.028\)) |
| 집단 1이 2 이상 낮은가 | 아니다(\(p=0.002\)) |
"유의하지 않다"는 한 줄이 감추고 있던 정보다.
비열등성의 실용성. \(\Delta=2\)에서 \(p=0.002\)로 "집단 1이 2 이상 나쁘지는 않다"를 강하게 주장할 수 있다. 차이가 있는지는 결론 내지 못했지만(양측 \(p=0.057\)), "많이 나쁘지는 않다"는 단언할 수 있다. 이것이 신뢰구간을 보는 습관의 힘이다.
연습문제 10. \(z\) 검정의 전제인 "\(\sigma\)를 안다"가 틀렸을 때 구간의 포함률이 어떻게 되는지 해석적으로 구하라.
풀이
유도. 참 표준오차가 \(\text{SE}_{\text{true}}\)인데 \(\text{SE}_{\text{used}}\)를 썼다고 하자. 구간은
이고 \(\bar x_1-\bar x_2\sim N(\delta,\text{SE}_{\text{true}}^2)\)이므로 포함률은
\(\text{SE}\propto\sigma\)이므로 \(r\)은 곧 "가정한 \(\sigma\) / 참 \(\sigma\)"다.
import numpy as np
from scipy import stats

z95 = stats.norm.ppf(0.975)
print(f"{'가정 σ / 참 σ':>14s} {'구간 포함률':>12s} {'실제 α':>10s}")
for r in [0.6, 0.8, 0.9, 1.0, 1.1, 1.25, 1.5, 2.0]:
    cov = 2 * stats.norm.cdf(z95 * r) - 1
    print(f"{r:14.2f} {cov:12.4f} {1 - cov:10.4f}")
    가정 σ / 참 σ       구간 포함률       실제 α
          0.60       0.7604     0.2396
          0.80       0.8831     0.1169
          0.90       0.9223     0.0777
          1.00       0.9500     0.0500
          1.10       0.9689     0.0311
          1.25       0.9857     0.0143
          1.50       0.9967     0.0033
          2.00       0.9999     0.0001
비대칭이 결정적이다.
| 오차 방향 | 결과 |
|---|---|
| \(\sigma\)를 작게 잡음(\(r<1\)) | 과대기각 — 20% 과소평가에 \(\alpha=0.117\) |
| \(\sigma\)를 크게 잡음(\(r>1\)) | 보수적 — 25% 과대평가에 \(\alpha=0.014\) |
\(\sigma\)를 10%만 작게 잡아도 실제 수준이 0.078로 명목의 1.55배다. 40% 작게 잡으면 0.24로 거의 5배다.
표본을 키워도 고쳐지지 않는다. \(r\)은 \(n\)에 의존하지 않으므로, \(n\)을 아무리 늘려도 실제 수준은 그대로다. 이것이 \(t\) 검정과의 근본적 차이다 — \(t\)는 \(\sigma\)를 자료에서 추정하므로 \(n\)이 커지면 저절로 정확해진다.
실무 규칙 셋.
- \(\sigma\)를 안다고 확신할 수 없으면 \(t\)(또는 웰치)를 쓴다. 자유도를 조금 잃는 대가로 이 위험이 사라진다.
- \(\sigma\)를 쓸 수밖에 없다면 보수적으로(크게) 잡는다. 위 표의 비대칭이 그 근거다.
- 가정한 \(\sigma\)를 자료로 점검한다. \(\chi^2\) 검정으로 \(H_0\colon\sigma=\sigma_0\)을 확인하거나, 적어도 \(s\)와 \(\sigma_0\)을 나란히 보고한다.
\(\sigma\)를 정말 아는 경우. 오랜 이력의 제조 공정, 명세가 확정된 계측기, 잘 확립된 유전적 변이 등이다. 이때도 "여전히 그 값인가"를 확인해야 한다. 장비가 노후하거나 공정이 바뀌면 \(\sigma\)도 바뀐다.
정리하며
두 모분산을 알 때의 평균 차 검정이다.
- 분산이 더해진다. 두 표본이 독립이므로 차의 분산이 분산의 합이다. 표준오차끼리 더하는 것이 아니다.
- 자유도 조정이 없다. \(\sigma\) 를 알고 있으므로 \(t\) 도 새터스웨이트(Satterthwaite) 근사도 필요 없고, 분포가 정확히 \(N(0,1)\) 이다.
- \(\delta_0\) 이 반드시 \(0\) 일 필요는 없다. "차이가 5 이상인가" 같은 가설도 같은 틀로 검정한다. 동등성 검정이 그런 형태다.
- 쓸 수 있는 경우가 드물다. 방대한 과거 자료나 기기의 물리적 특성으로 분산이 확립된 상황뿐이며, 주된 가치는 다음 절 \(t\) 검정의 골격이라는 점이다.
다음 절 이표본 \(t\) 검정으로 넘어간다. 분산을 모를 때 합동과 웰치 중 무엇을 쓸지가 주제다.