사전분포, 가능도, 사후분포
개요
\(1904\) 년 프랑스 최고법원이 세 수학자에게 숫자 하나를 검토하게 했다. 필적 감정가가 내놓은 것은 \((0.2)^4 = 0.0016\) 이었고, 보고서는 물어야 할 확률이 실은 \(400\) 배 크다고 적었다. 그런데 보고서가 더 깊이 짚은 것은 자릿수가 아니라 \(\pi(\theta)\) 였다 — 베이즈 정리(Bayes' theorem)의 분자와 분모에 빠짐없이 곱해져 있는 그 항을 적을 수 없으면 계산이 아예 돌지 않는다(아래 상자가 그 사건을 끝까지 따라간다). 사전분포(prior distribution)·가능도·사후분포(posterior distribution)는 각각 무엇이고, 그 가운데 하나가 비면 무슨 일이 생기는가.
빈도주의 통계학에서 모수 \(\theta\)는 고정되어 있지만 미지인 상수로 다루어지며, 추론은 전적으로 자료의 표집분포(sampling distribution)에 의존한다. 베이즈 추론은 근본적으로 다른 접근을 취한다. \(\theta\)를 고유한 분포를 갖는 확률변수로 다루는 것이다. 자료를 관측하기 전에 \(\theta\)에 대한 믿음은 사전분포에 담긴다. 자료를 관측한 뒤에는 베이즈 정리가 이 믿음을 사후분포로 갱신하는 일관된 규칙을 준다. 이 절에서는 베이즈 추론의 세 가지 핵심 요소와 그것들이 결합되는 방식을 소개한다.
1. 베이즈 정리
관측된 자료 \(\mathbf{x} = (x_1, \ldots, x_n)\)이 주어졌을 때 \(\theta\)의 사후분포는 베이즈 정리로 주어진다.
오른쪽의 비례 관계는 \(\theta\)에 의존하지 않는 분모 \(f(\mathbf{x})\)를 떨어뜨린 것이다. \(\theta\)에 의존하는 항만으로 사후분포의 분포족을 알아낼 수 있으므로 이 비례 형태만으로 충분한 경우가 많다.
2. 구성 요소
사전분포 \(\pi(\theta)\): 자료를 보기 전 \(\theta\)에 대한 믿음을 담는다. 실제 분야 지식을 반영할 수도 있고(정보가 있는 사전분포) 의도적으로 판단을 유보할 수도 있다(무정보 사전분포(noninformative prior) 또는 약정보 사전분포(weakly informative prior)). 사전분포의 선택은 베이즈 추론을 구별짓는 특징이자 자주 제기되는 비판 지점이기도 하다.
그림으로 보는 통계학 1. 사전확률을 적지 못한 채 돌린 계산
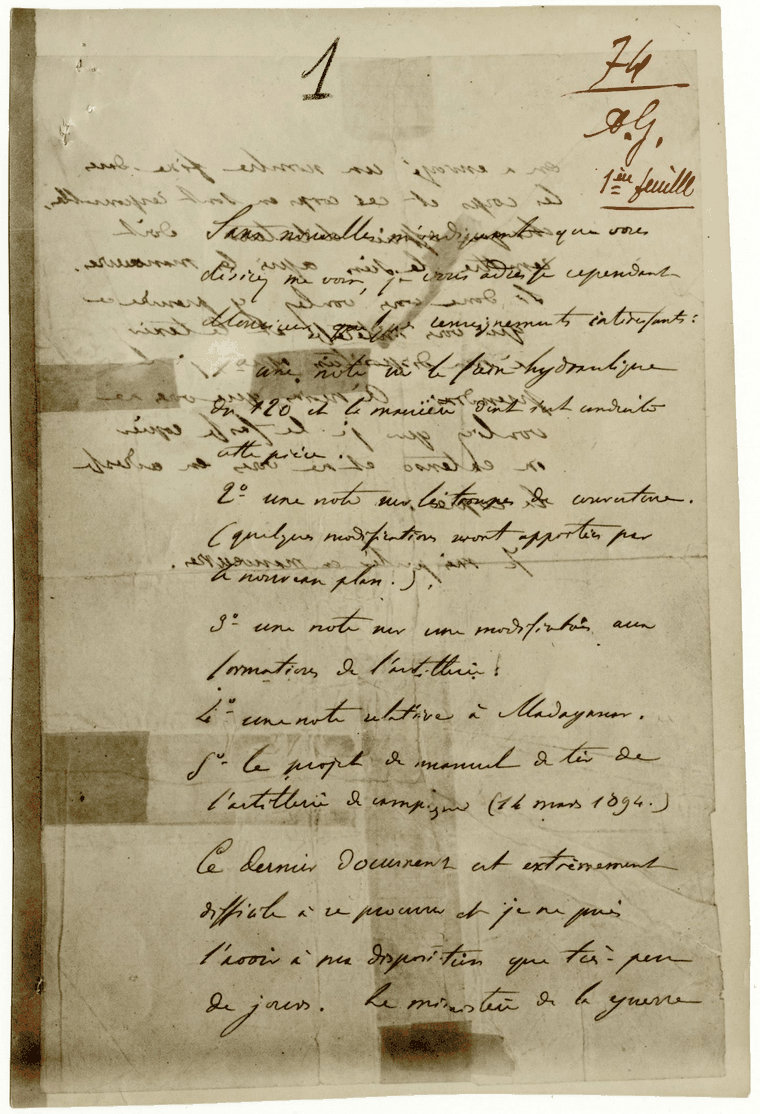
\(1894\) 년 \(9\) 월 파리의 독일 대사관에서 나온 서명 없는 쪽지 「명세서」(\(bordereau\)). 찢긴 것을 맞붙인 자국과 뒷면 글씨가 비쳐 보인다. 다섯 항목 가운데 「\(\dots\) à Madagascar」 와 「\((\)14 mars 1894.\()\)」 를 읽을 수 있다. 베르티용이 「우연의 일치」를 센 것이 이 필적이다. (프랑스 국방사료원 소장, Wikimedia Commons, PD-old-70)
사전분포를 고르는 일이 비판을 받는다면, 아예 고를 수 없을 때는 어떻게 되는가. 이 물음을 \(1904\) 년에 프랑스 최고법원이 세 수학자에게 물은 적이 있다. 사람 하나가 이미 십 년째 그 계산 위에 놓여 있었다.
사진의 쪽지 하나로 \(1894\) 년 \(12\) 월 포병 대위 알프레드 드레퓌스가 종신 유배형을 받고 기아나의 악마섬으로 갔다. 필적을 감정한 사람은 알퐁스 베르티용(\(1853\)–\(1914\)) 으로, 사람의 몸을 재어 범인을 가리는 인체측정법을 만든 파리 경찰의 식별 전문가였다. 다만 필적 감정가는 아니었다. 그가 내놓은 것은 「자기위조」 — 드레퓌스가 남이 자기 글씨를 흉내 낸 것처럼 보이도록 자기 글씨를 스스로 흉내 냈다는 주장이었고, 거기에 확률 계산을 붙였다. 반복되는 다음절 낱말의 처음과 끝 \(26\) 군데에서 중첩을 \(4\) 개 찾았고, 한 번 겹칠 확률을 \(0.2\) 로 보아
이니 우연일 리 없다고 했다.
\(1904\) 년 파기원은 다르부 · 아펠 · 푸앵카레 세 사람에게 이 계산을 검토하게 했다. 보고서는 푸앵카레가 썼고, 머리글이 「원인의 확률에 관한 개념」(Notions sur la probabilité des causes) — 곧 이 쪽이 사후분포라 부르는 것이다. 설명에 쓴 예는 이렇다. 겉모양이 같은 항아리 둘, 하나에는 흰 공 \(90\) 개와 검은 공 \(10\) 개, 다른 하나는 그 반대. 공 하나를 꺼냈더니 희다. 어느 항아리였을까.
베르티용의 틀린 곳은 둘이다. 첫째, \(0.0016\) 은 「\(4\) 번 중 \(4\) 번」의 확률이다. 물어야 할 것은 \(26\) 번 중 \(4\) 번 이상이고, 보고서는 그 값을 \(0.7\) — 곧 \(400\) 배 크다고 적었다. (이항분포(binomial distribution)로 다시 세어 보면 \(0.79\) 로 \(500\) 배에 가깝다. 어느 쪽이든 자릿수가 다르다.) 보고서의 비유는 이렇다. 「복권에서 \(25\) 번이 나왔다면 그 확률은 사전에 아주 작았지만, 그렇다고 추첨이 부정했다는 뜻은 아니다. 어떤 번호든 하나는 나와야 했으니까.」
둘째가 더 깊다. 절 \(1\) 의 식에는 분자와 분모에 \(\pi(\theta)\) 가 빠짐없이 곱해져 있다. 결과에서 원인으로 가려면 그 원인의 사전확률을 먼저 알아야 한다. 보고서는 항아리가 둘일 때와 열하나 중 열이 같은 쪽일 때 답이 완전히 달라짐을 보인 뒤, 자기위조의 사전확률은 「계산을 절대적으로 벗어나는 정신적 요소」로만 이루어져 있어 적을 수가 없고, 적을 수 없으면 계산이 돌지 않는다고 못 박는다. 그리고 한 문장으로 닫는다 — 「확률 계산은 사람들이 믿는 듯한 것과 달리, 학자에게 상식을 면제해 주는 놀라운 과학이 아니다.」
보고서가 베르티용의 방법을 요약한 자리가 가장 날카롭다. 베르티용 자신의 말이 「찾으면 언제나 나온다」였고, 보고서는 이렇게 받는다. 「중첩이 나오면 결정적인 증거이고, 중첩이 없으면 더 결정적인 증거다. 글쓴이가 의심을 돌리려 애썼다는 뜻이 되므로.」 이것은 수학으로 적을 수 있다. 어떤 \(\theta\) 에서나 그 자료가 똑같이 잘 나온다면, 곧 가능도 \(f(\mathbf{x}\mid\theta)\) 가 \(\theta\) 에 대해 평평하면 비례식에서 그 값이 약분되어
가 된다. 아래 그림의 초록 파선이 납작해진 경우이고, 그러면 곱해도 주황 곡선이 그대로 남는다. 증거를 보기 전과 본 뒤가 같다는 말이고, 그 증거는 아무 일도 하지 않았다는 말이다. 세 사람은 이 체계가 「어떤 과학적 값어치도 전혀 없다」고 적고 서명했다. 드레퓌스는 \(1906\) 년에 무죄가 되었다.
확인한 곳 — \(1904\) 년 \(8\) 월 \(2\) 일 보고서의 전문(프랑스어 원문과 영역)은 에든버러 대학에 올라 있는 사본 — 머리글 「NOTIONS SUR LA PROBABILITÉ DES CAUSES」, \(26\) 군데 중 \(4\) 개의 중첩과 \((0.2)^4=0.0016\), 「\(4\) 번 중 \(4\) 번」이라는 지적과 \(0.7\) · \(400\) 배, 복권 \(25\) 번 비유, 흰 공 \(90\) 대 검은 공 \(10\) 의 두 항아리와 항아리가 열하나일 때의 비교, 「une science merveilleuse qui dispense le savant d'avoir du bon sens」, 베르티용의 「quand on cherche, on trouve toujours」와 그 뒤 두 문장, 끝의 「absolument dépourvus de toute valeur scientifique」와 서명 「POINCARÉ, DARBOUX, APPELL」이 모두 여기 있다 · 베르티용이 인체측정법을 만들었으나 「필적 전문가가 아니었다」는 것은 Wikipedia 「Alphonse Bertillon」 · \(1894\) 년 \(12\) 월 \(22\) 일 유죄와 악마섬, \(1906\) 년 파기원의 무죄, 명세서가 \(1894\) 년 \(9\) 월에 찢긴 쪽지로 발견되었다는 것은 Wikipedia 「Dreyfus affair」 · 그림의 맞붙인 자국과 「Madagascar」 · 「14 mars 1894」 는 사진에서 직접 읽었고, \(26\) 번 중 \(4\) 번 이상의 확률 \(0.79\) 는 이 쪽에서 직접 계산해 보았다
가능도 \(f(\mathbf{x} \mid \theta)\): 관측된 표본의 확률밀도(이산 자료에서는 확률질량)를 \(\theta\)의 함수로 본 것이다. \(f(\mathbf{x} \mid \theta)\)가 \(\mathbf{x}\)에 대한 밀도와 같은 표기를 쓰지만, 베이즈 맥락에서는 \(\theta\)에 대한 의존을 강조한다. 가능도는 각 후보 모수값이 자료를 얼마나 잘 설명하는지 알려 준다.
사후분포 \(\pi(\theta \mid \mathbf{x})\): 자료를 반영한 뒤의 \(\theta\)의 갱신된 분포이다. 사전분포와 가능도를 결합하며 베이즈 추론의 중심 대상이다. 모든 결론(점추정(point estimation), 구간, 예측)이 사후분포에서 흘러나온다.
주변가능도 \(f(\mathbf{x})\): 사후분포의 적분이 1이 되도록 하는 정규화 상수이다.
이 적분은 사전분포로 가중하여 가능한 모든 모수값에 걸쳐 가능도를 평균한다. 이 적분을 계산하기 어려운 경우가 많으며, 그래서 (닫힌 형태의 사후분포를 주는) 켤레 사전분포와 (MCMC 같은) 계산 방법이 베이즈 실무의 필수 도구가 된다.
세 요소를 한 축에 그리면 갱신이 무엇을 하는 일인지 곧바로 보인다.
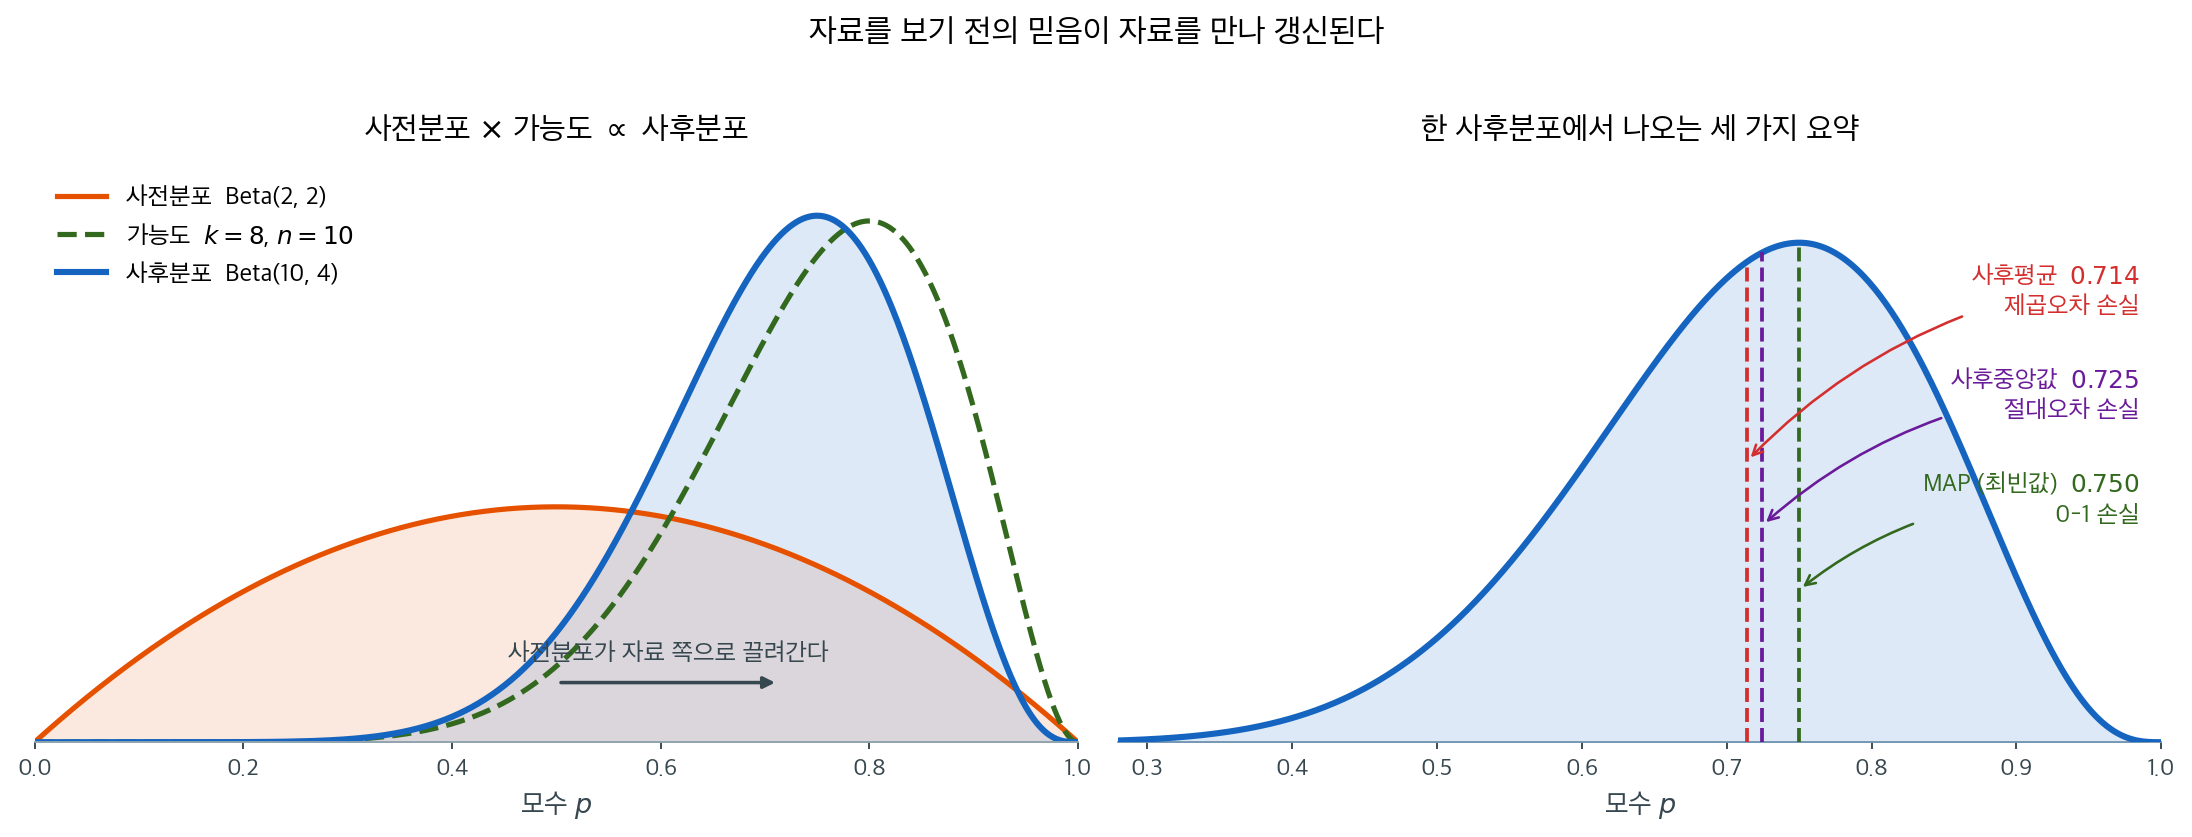
왼쪽에서 주황 곡선이 자료를 보기 전의 믿음이고, 초록 파선이 자료가 말하는 바이며, 파란 곡선이 둘을 곱해 얻은 사후분포다. 사후분포의 봉우리가 두 봉우리 사이에 놓인다. 곱셈이 하는 일이 이것이다. 어느 한쪽이 0에 가까운 값을 주는 구간은 사후분포에서도 0에 가까워지므로, 두 정보원이 모두 지지하는 영역만 살아남는다.
사후분포의 폭이 두 곡선 어느 쪽보다도 좁다는 점도 눈여겨볼 만하다. 정보를 더했으므로 불확실성이 줄어든 것이다.
한 가지 표기상의 주의가 있다. 가능도는 \(p\)에 대한 밀도가 아니므로 곡선 아래 넓이가 1일 이유가 없다. 위 그림에서는 세 곡선을 같은 축에 얹기 위해 가능도의 척도만 맞추어 그렸다. 비례상수는 사후분포의 모양을 바꾸지 않으므로 이렇게 해도 무방하다.
3. 베이즈 점추정
완전한 사후분포가 추론 문제에 대한 온전한 베이즈적 답이다. 다만 실무자는 사후분포를 요약하는 하나의 수가 필요한 경우가 많다. 흔히 쓰는 각 점추정값은 서로 다른 손실함수를 최소화하는 것에 대응한다.
| 추정값 | 정의 | 최소화하는 손실 |
|---|---|---|
| 사후평균 | \(E[\theta \mid \mathbf{x}]\) | 제곱오차 손실 |
| 사후중앙값 | \(\pi(\theta \mid \mathbf{x})\)의 중앙값 | 절대오차 손실 |
| MAP | \(\pi(\theta \mid \mathbf{x})\)의 최빈값 | (극한의 의미에서) 0-1 손실 |
위 그림의 오른쪽이 이 표를 그린 것이다. 같은 사후분포에서 세 값이 서로 다른 자리에 놓인다. 사후분포가 왼쪽으로 치우쳐 있으므로 평균이 가장 왼쪽, 최빈값이 가장 오른쪽에 오고 중앙값이 그 사이에 있다. 어느 것을 고를지는 자료가 아니라 어떤 손실을 치르기로 했는가가 정한다.
사후분포가 대칭이고 단봉이면 셋이 한 점에서 만나므로 이 선택이 문제가 되지 않는다. 아래 정규 사전분포의 예가 그런 경우다.
정규 사전분포와 정규 가능도
\(\sigma^2\)이 알려진 \(X_1, \ldots, X_n \overset{iid}{\sim} N(\theta, \sigma^2)\)이고 사전분포가 \(\theta \sim N(\mu_0, \sigma_0^2)\)이라 하자. 베이즈 정리를 적용하고 완전제곱식을 만들면 사후분포는
사후평균은 사전평균 \(\mu_0\)과 표본평균(sample mean) \(\bar{x}\)의 가중평균이며, 가중은 각각의 상대적 정밀도(분산의 역수)로 결정된다. \(n\)이 커지면 자료가 지배하여 사전분포와 무관하게 사후분포가 \(\bar{x}\) 주위로 모인다. 사후분포가 대칭이고 단봉이므로 이 경우 평균, 중앙값, MAP가 모두 일치한다.
연습문제
연습문제 1. 자료 \(\mathbf{x}\)가 주어졌을 때 모수 \(\theta\)에 대한 베이즈 정리를 서술하라. 각 구성 요소(사전분포, 가능도, 사후분포, 주변가능도)를 찾아 이름을 붙여라.
풀이
베이즈 정리는 다음과 같다.
- 사전분포 \(\pi(\theta)\): 자료를 보기 전 \(\theta\)의 분포로 사전 믿음을 담는다.
- 가능도 \(L(\mathbf{x} \mid \theta)\): \(\theta\)가 주어졌을 때 관측된 자료의 확률이다.
- 주변가능도 \(m(\mathbf{x}) = \int L(\mathbf{x} \mid \theta)\pi(\theta)\,d\theta\): 사후분포의 적분이 1이 되게 하는 정규화 상수이다.
- 사후분포 \(\pi(\theta \mid \mathbf{x})\): 자료를 관측한 뒤의 갱신된 \(\theta\)의 분포이다.
연습문제 2. 동전의 앞면 확률에 대한 사전분포가 \(p \sim \text{Uniform}(0, 1)\)이라 하자. 동전을 한 번 던져 앞면을 관측했다. 사후분포 \(\pi(p \mid H)\)를 계산하라.
풀이
사전분포는 \(p \in (0, 1)\)에서 \(\pi(p) = 1\)이다(\(\text{Beta}(1, 1)\)과 같다). 앞면 한 번에 대한 가능도는 \(L(H \mid p) = p\)이다.
베이즈 정리에 의해 이렇게 된다.
이는 \(\text{Beta}(2, 1)\)의 밀도이다. 사후평균은 \(E[p \mid H] = 2/3\)으로 사전평균 \(1/2\)에서 위로 이동했으며, 앞면을 관측했다는 증거를 반영한다.
연습문제 3. 사전분포 \(\pi(\theta)\)가 \(\theta = 0\)에 확률 0.7을, \(\theta = 1\)에 0.3을 부여한다. 가능도는 \(P(X = 1 \mid \theta = 0) = 0.2\), \(P(X = 1 \mid \theta = 1) = 0.9\)를 만족한다. \(X = 1\)을 관측한 뒤 사후확률 \(P(\theta = 0 \mid X = 1)\)과 \(P(\theta = 1 \mid X = 1)\)을 계산하라.
풀이
이산 \(\theta\)에 대한 베이즈 정리에 의해 이렇게 된다.
먼저 주변확률을 계산한다.
그러면 이렇게 된다.
\(X = 1\)이 \(\theta = 1\) 아래에서 훨씬 더 그럴듯하므로, 이 관측이 사후분포를 \(\theta = 1\) 쪽으로(사전 0.3에서 사후 0.659로) 이동시켰다.
연습문제 4. 사후최빈값(MAP 추정값)과 MLE의 관계를 설명하라. 어떤 조건에서 MAP 추정값이 MLE와 같아지는가?
풀이
MAP(최대사후확률) 추정값은 사후분포를 최대화한다.
MLE는 가능도만 최대화한다: \(\hat{\theta}_{\text{MLE}} = \arg\max_\theta L(\mathbf{x} \mid \theta)\).
사전분포가 평평하면(균등/무정보), 즉 \(\pi(\theta) \propto c\)(상수)이면 \(\log \pi(\theta)\)가 최적화에 영향을 주지 않는 상수가 되므로 MAP가 MLE와 같아진다. 또한 \(n \to \infty\)일 때 큰 표본에서는 가능도가 사전분포를 압도하므로 MAP가 MLE에 가까워진다.
연습문제 5. 주변가능도(marginal likelihood, 「증거(evidence)」라고도 한다) \(m(x) = \int f(x\mid\theta)\pi(\theta)\,d\theta\)의 세 가지 역할을 설명하라. 계산이 왜 어려운가?
풀이
역할 1 — 정규화 상수. 사후분포를 확률분포로 만든다.
점추정이나 MCMC에는 이 값이 필요 없다. \(\theta\)에 무관하기 때문이다. 그래서 "비례한다"로 끝내는 경우가 많다.
역할 2 — 모형 비교. 두 모형의 주변가능도 비가 베이즈 인자(Bayes factor)다.
여기서는 \(m(x)\)가 주인공이다. 모형이 자료에 얼마나 잘 맞는지를 모수 불확실성까지 고려해 요약한 값이다.
역할 3 — 사전 예측분포. \(m(x)\)는 자료를 보기 전 자료에 대한 예측분포다. 사전분포에서 모수를 뽑고 그 모수로 자료를 생성했을 때 실제 관측값이 나올 가능성이다. 사전분포가 합리적인지 점검하는 데 쓴다. 관측된 자료의 \(m(x)\)가 극도로 작으면 사전분포가 자료와 어긋난다는 뜻이다.
계산이 어려운 이유.
- 고차원 적분이다. 모수가 \(d\)개면 \(d\)차원 적분이며, 격자법은 \(d\ge5\)쯤에서 무너진다.
- MCMC가 직접 주지 않는다. MCMC는 사후분포에서 표집하지만 정규화 상수를 알려 주지 않는다. 바로 그 상수를 몰라도 되도록 설계된 알고리즘이기 때문이다.
- 꼬리에 민감하다. 적분값이 사후분포가 아니라 사전분포의 넓은 영역에 의존하므로, 사후분포를 잘 탐색해도 \(m(x)\)를 정확히 얻기 어렵다.
계산 방법. 라플라스 근사(BIC가 그 거친 판본), 중요도추출, 다리표집(bridge sampling), 열역학적 적분(thermodynamic integration), 중첩표집(nested sampling)이 쓰인다. 어느 것도 간단하지 않으며, 베이즈 인자를 보고할 때는 계산 방법과 그 오차를 함께 밝혀야 한다.
연습문제 6. 사전분포가 부적절(improper, 적분이 발산해 확률분포가 아닌 것)해도 사후분포는 적절(proper, 적분이 유한해 확률분포로 정규화되는 것)할 수 있다. 조건을 밝히고, 적절한 사후분포를 주는 예와 그렇지 않은 예를 각각 들어라.
풀이
조건. 사후분포가 적절하려면
이면 된다. 사전분포 자체가 적분 가능할 필요는 없고, 가능도와의 곱이 적분 가능하면 충분하다.
적절해지는 예. \(X_i\sim N(\mu,\sigma^2)\)(\(\sigma\) 기지)에 \(\pi(\mu)\propto1\)을 쓰면
이므로 사후분포가 \(N(\bar x,\sigma^2/n)\)으로 적절하다. 가능도 자체가 \(\mu\)에 대해 적분 가능하기 때문이다.
적절해지지 않는 예 1. 이항 모형에 홀데인 사전분포 \(\pi(p)\propto p^{-1}(1-p)^{-1}\)(\(\text{Beta}(0,0)\))을 쓰고 \(k=0\)을 관측하면
로 발산한다. \(k=0\)이나 \(k=n\)이면 사후분포가 부적절하다.
적절해지지 않는 예 2. 계층모형의 집단 간 분산 \(\tau^2\)에 \(\pi(\tau^2)\propto1/\tau^2\)을 쓰면, 집단 수가 적을 때 \(\tau\to0\) 근처에서 사후분포가 발산하는 경우가 있다. 이 때문에 젤먼은 \(\tau\)에 반코시(half-Cauchy) 사전분포를 권한다.
위험.
- 조용히 실패한다. MCMC는 부적절한 사후분포에서도 돌아가며, 겉보기에 정상적인 표본을 내놓는다. 추적 그림이 서서히 흘러가거나 \(\hat R\)이 1에서 멀어지는 것이 유일한 단서인데, 알아채기 어렵다.
- 베이즈 인자를 쓸 수 없다. 부적절 사전분포는 상수가 임의적이라 주변가능도가 정의되지 않는다.
권고. 부적절 사전분포를 쓰려면 사후분포가 적절한지를 해석적으로 확인해야 한다. 확인이 어렵거나 모형이 복잡하면, 아주 퍼진 적절한 사전분포(예: \(N(0, 100^2)\), 반코시)를 쓰는 편이 안전하다.
연습문제 7. 사전분포를 순차적으로 갱신하는 것과 자료를 한꺼번에 쓰는 것이 같은 결과를 준다. 이를 보이고, 이 성질이 어디에 쓰이는지 적어라.
풀이
증명. 자료를 \(x_1\)과 \(x_2\)로 나누고 조건부 독립이라 하자.
한꺼번에:
순차적으로: 먼저 \(x_1\)로 갱신하면 \(\pi(\theta\mid x_1)\propto f(x_1\mid\theta)\pi(\theta)\)이고, 이를 사전분포로 삼아 \(x_2\)로 갱신하면
같다. \(\square\)
순서에도 의존하지 않는다. \(x_2\)를 먼저 써도 결과가 같다.
쓰임.
- 온라인 학습. 자료가 흘러 들어올 때마다 사후분포를 갱신하면 되고, 과거 자료를 저장할 필요가 없다. 켤레 구조라면 몇 개의 수만 유지하면 된다.
- 칼만 필터. 정규–정규 켤레의 순차 갱신이 곧 칼만 필터의 갱신식이다. 예측 단계와 갱신 단계로 이루어진 구조가 베이즈 규칙의 반복 적용이다.
- 적응적 실험 설계. 중간 결과로 사후분포를 갱신하고 다음 실험을 설계한다. 다중 슬롯머신 문제의 톰슨 표집이 그 예다.
- 메타분석. 연구 하나씩 순차적으로 결합해도 한꺼번에 결합한 것과 같다.
주의. 조건부 독립이 전제다. 자료에 의존구조가 있으면 \(f(x_1,x_2\mid\theta)\ne f(x_1\mid\theta)f(x_2\mid\theta)\)이므로 순차 갱신이 틀린다. 시계열이나 군집자료에서는 의존구조를 모형에 넣어야 한다.
빈도주의와의 대비. 빈도주의에서는 "중간에 들여다보는 것"이 오류율을 망가뜨리지만, 베이즈에서는 사후분포가 언제 멈추든 같은 값이다. 앞서 본 가능도 원리와 옵셔널 스토핑의 논의가 여기에 닿는다.
연습문제 8. 사후분포가 사전분포와 크게 어긋나는 사전–자료 충돌을 어떻게 진단하고 대처하는지 설명하라.
풀이
진단 방법.
- 사전 예측 점검. 사전분포에서 모수를 뽑아 가상 자료를 생성하고, 실제 관측값이 그 분포의 어디에 있는지 본다. 관측값이 사전 예측분포의 극단 꼬리에 있으면 충돌이다.
$$ p_{\text{prior}} = P\left(T(\tilde X) \ge T(x_{\text{obs}})\right), \qquad \tilde X \sim m(\cdot) $$
-
사전분포와 사후분포를 겹쳐 그린다. 사후분포가 사전분포의 꼬리로 옮겨 갔으면 자료가 사전분포를 강하게 반박한 것이다.
-
사전분포를 뺀 결과와 비교한다. 무정보 사전분포로 얻은 사후분포(사실상 가능도)와 원래 사후분포가 크게 다르면, 사전분포가 결론을 만들고 있다.
왜 문제인가. 켤레 사전분포처럼 꼬리가 얇으면 충돌이 조용히 타협된다. 정규–정규 켤레에서 사후평균이 언제나 사전평균과 표본평균의 가중평균이므로, 둘이 아무리 멀어도 그 중간 어딘가가 나온다. 어느 쪽도 지지하지 않는 값이다.
대처.
- 꼬리가 두꺼운 사전분포. \(t\) 분포나 코시 사전분포를 쓰면 자료가 강하게 말할 때 사전분포가 물러난다. \(|\bar x-\mu_0|\)이 크면 사후분포가 사전분포를 거의 무시하고 자료 쪽으로 간다. 이를 사전분포의 로버스트성이라 하며, 오헤이건의 결과가 이 거동을 정확히 특징짓는다.
- 혼합 사전분포. 정보적 성분과 평평한 성분을 섞어 두면 자동으로 전환된다(켤레 사전분포 연습문제 9).
- 사전분포를 재검토한다. 충돌이 사전분포가 틀렸다는 신호일 수 있다. 전문가에게 다시 묻거나 과거 자료의 적합성을 재검토한다.
- 모형을 재검토한다. 충돌이 사전분포가 아니라 가능도의 문제일 수도 있다. 모형이 자료를 제대로 담지 못하면 모수가 엉뚱한 곳으로 밀린다.
보고할 때. 충돌이 있었다면 그 사실과 대처를 밝힌다. 사전분포를 자료 본 뒤에 바꾸는 것은 원리적으로 문제가 있으므로, 바꿨다면 반드시 그 사실을 적고 원래 사전분포의 결과도 함께 보인다.
연습문제 9. 사후 예측 점검의 절차를 적고, 빈도주의 적합도 검정(goodness-of-fit test)과 무엇이 다른지 밝혀라.
풀이
절차.
- 사후분포에서 모수를 뽑는다. \(\theta^{(s)}\sim\pi(\theta\mid x)\), \(s=1,\dots,S\).
- 각 \(\theta^{(s)}\)로 자료를 생성한다. \(x^{\text{rep},(s)}\sim f(\cdot\mid\theta^{(s)})\).
- 관심 있는 요약통계량 \(T\)를 관측자료와 생성자료 모두에서 계산한다.
- 그림으로 비교하거나 사후 예측 \(p\) 값을 계산한다.
$$ p_B = \frac1S\sum_s \mathbb{1}\left{T(x^{\text{rep},(s)}) \ge T(x)\right} $$
\(p_B\)가 0이나 1에 가까우면 모형이 자료의 그 측면을 재현하지 못한다는 뜻이다.
\(T\)를 무엇으로 고르는가. 모형이 잡아내지 못할 법한 측면을 겨냥한다. 최댓값·최솟값, 0의 개수, 분산 대 평균 비, 자기상관, 특정 분위수(quantile) 등. 모형이 직접 맞춘 양(예: 평균)을 쓰면 당연히 잘 맞으므로 정보가 없다.
빈도주의 적합도 검정과의 차이.
| 사후 예측 점검 | 빈도주의 적합도 검정 | |
|---|---|---|
| 모수 | 사후분포로 적분 | 추정값 대입 또는 조건화 |
| 귀무분포 | 모수 불확실성 포함 | 자유도 조정으로 근사 |
| \(p\) 값 분포 | \(H_0\) 아래에서도 균등이 아님 | 근사적으로 균등 |
| 목적 | 모형 비판 | 가설 검정 |
핵심 차이. 사후 예측 \(p\) 값은 자료를 두 번 쓴다. 같은 자료로 사후분포를 얻고 그 사후분포로 자료를 평가하므로 보수적이 되며, 귀무가설(null hypothesis) 아래에서도 균등분포를 따르지 않는다. 따라서 0.05 같은 임계값으로 판정하면 안 된다.
그래도 유용한 이유는 목적이 다르기 때문이다. 사후 예측 점검은 "모형을 기각할 것인가"가 아니라 "모형이 자료의 어떤 측면을 놓치고 있는가"를 묻는 진단 도구다. 그림으로 보는 것이 \(p\) 값보다 훨씬 유익하며, 놓친 부분을 발견하면 모형을 개선하는 것이 자연스러운 다음 단계다.
연습문제 10. 사전분포와 사후분포의 관계를 정보 이득으로 정량화할 수 있다. 쿨백–라이블러 발산을 이용한 측도를 정의하고 해석하라.
풀이
정의. 자료 \(x\)를 본 뒤의 정보 이득을
로 정의한다. 사후분포가 사전분포에서 얼마나 멀어졌는지를 잰다.
기대 정보 이득. 자료를 보기 전에 평균하면
로 모수와 자료의 상호정보량(mutual information)이 된다. 여기서 \(E_{m(x)}\) 는 자료의 주변분포 \(m(x)\) 로 평균한다는 뜻이다.
해석.
- 0이면 자료가 아무 정보도 주지 않았다는 뜻이다. 사후분포 = 사전분포.
- 클수록 자료가 많은 것을 말해 주었다. 단위는 내트(자연로그) 또는 비트(\(\log_2\))다.
- 정규–정규 켤레에서 계산하면
$$ \text{EIG} = \frac12\ln\left(1+\frac{n\tau^2}{\sigma^2}\right) $$
로, \(n\)에 대해 로그로만 증가한다. 자료를 두 배로 늘려도 정보가 두 배가 되지 않는다. 수확 체감이 정보 이론적으로도 나타난다.
쓰임.
- 베이즈 최적 실험 설계. 여러 설계 중 EIG가 가장 큰 것을 고른다. 어느 실험이 가장 많이 배울 수 있는지를 묻는 원리적인 기준이며, 피셔 정보행렬의 행렬식을 최대로 하는 \(D\)-최적 설계가 정규 근사 아래에서의 특수한 경우다.
- 능동 학습. 다음에 어느 관측값의 표지를 얻을지 고를 때 EIG가 큰 것을 고른다.
- 사전분포의 영향 진단. \(\text{KL}(x)\)가 작으면 자료가 사전분포를 거의 바꾸지 못한 것이다. 결론이 사전분포에서 나왔다는 신호다.
- 참조 사전분포의 정의. 버나도의 참조 사전분포는 EIG를 최대로 하는 사전분포로 정의된다. "자료가 최대한 말하게 하는" 사전분포라는 점에서 무정보 사전분포의 원리적인 구성이며, 일모수 문제에서는 제프리스 사전분포와 일치한다.
정리하며
베이즈 추론은 \(\theta\) 를 확률변수로 다룬다. 빈도주의와 갈리는 지점이 바로 여기다.
- 세 요소. 사전분포 \(\pi(\theta)\) 가 자료를 보기 전의 믿음, 가능도 \(f(\mathbf x\mid\theta)\) 가 자료가 말하는 바, 사후분포 \(\pi(\theta\mid\mathbf x)\) 가 둘을 결합한 결과다.
- 비례 형태로 충분한 경우가 많다. 분모 \(f(\mathbf x)\) 는 \(\theta\) 에 의존하지 않으므로, \(\theta\) 에 의존하는 항만 보고 사후분포의 족을 알아낼 수 있다.
- 해석이 다르다. 빈도주의 신뢰구간은 "이 절차를 반복하면 \(95\%\) 가 참값을 덮는다"이고, 베이즈 신용구간은 "참값이 이 구간에 있을 확률이 \(95\%\) "다. 후자가 사람들이 원래 원했던 진술이며, 그 대가로 사전분포를 정해야 한다.
- 자료가 쌓이면 사전분포의 영향이 줄어든다. 가능도가 점점 지배하며, 온건한 사전분포라면 결론이 수렴한다. 그러나 자료가 적으면 사전분포가 결과를 좌우한다.
다음 절 켤레 사전분포로 넘어간다. 적분 없이 사후분포를 닫힌 형태로 얻는 지름길이다.