Mann-Whitney U 검정
Mann-Whitney U 검정은 Wilcoxon 순위합검정의 다른 표현으로, 수학적으로 동치이면서 종종 더 직관적인 해석을 제공한다. 순위합검정이 한 집단의 순위합에 주목한다면, Mann-Whitney 검정은 한 집단의 관측값이 다른 집단의 관측값을 넘어서는 횟수를 센다. 이 개수, 즉 \(U\) 통계량은 확률 \(P(X > Y)\)를 직접 추정하므로 검정에 분명한 확률적 의미를 부여한다.
순위합검정과의 관계
\(W\)가 집단 1(표본크기 \(n_1\))의 Wilcoxon 순위합통계량이면
이고
이다. Mann-Whitney \(U\) 통계량은 \(U = \min(U_1, U_2)\)이다. 순위합검정과 Mann-Whitney 검정은 언제나 같은 \(p\)값을 낸다.
직관: 쌍별 승수 세기
각 집단에서 하나씩 뽑아 만든 \(n_1 \times n_2\)개의 쌍 \((X_i, Y_j)\)를 모두 생각하자. 다음을 정의한다.
이는 집단 1의 관측값이 집단 2의 관측값을 넘어서는 쌍의 개수이다. 반대로
이다. 동점이 없으면 \(U_1 + U_2 = n_1 n_2\)이다.
비율 \(U_1 / (n_1 n_2)\)는 확률 \(P(X > Y)\)를 추정한다. \(H_0\)(분포가 동일)에서 \(P(X > Y) = 0.5\)이므로 \(U_1 \approx n_1 n_2 / 2\)이다.
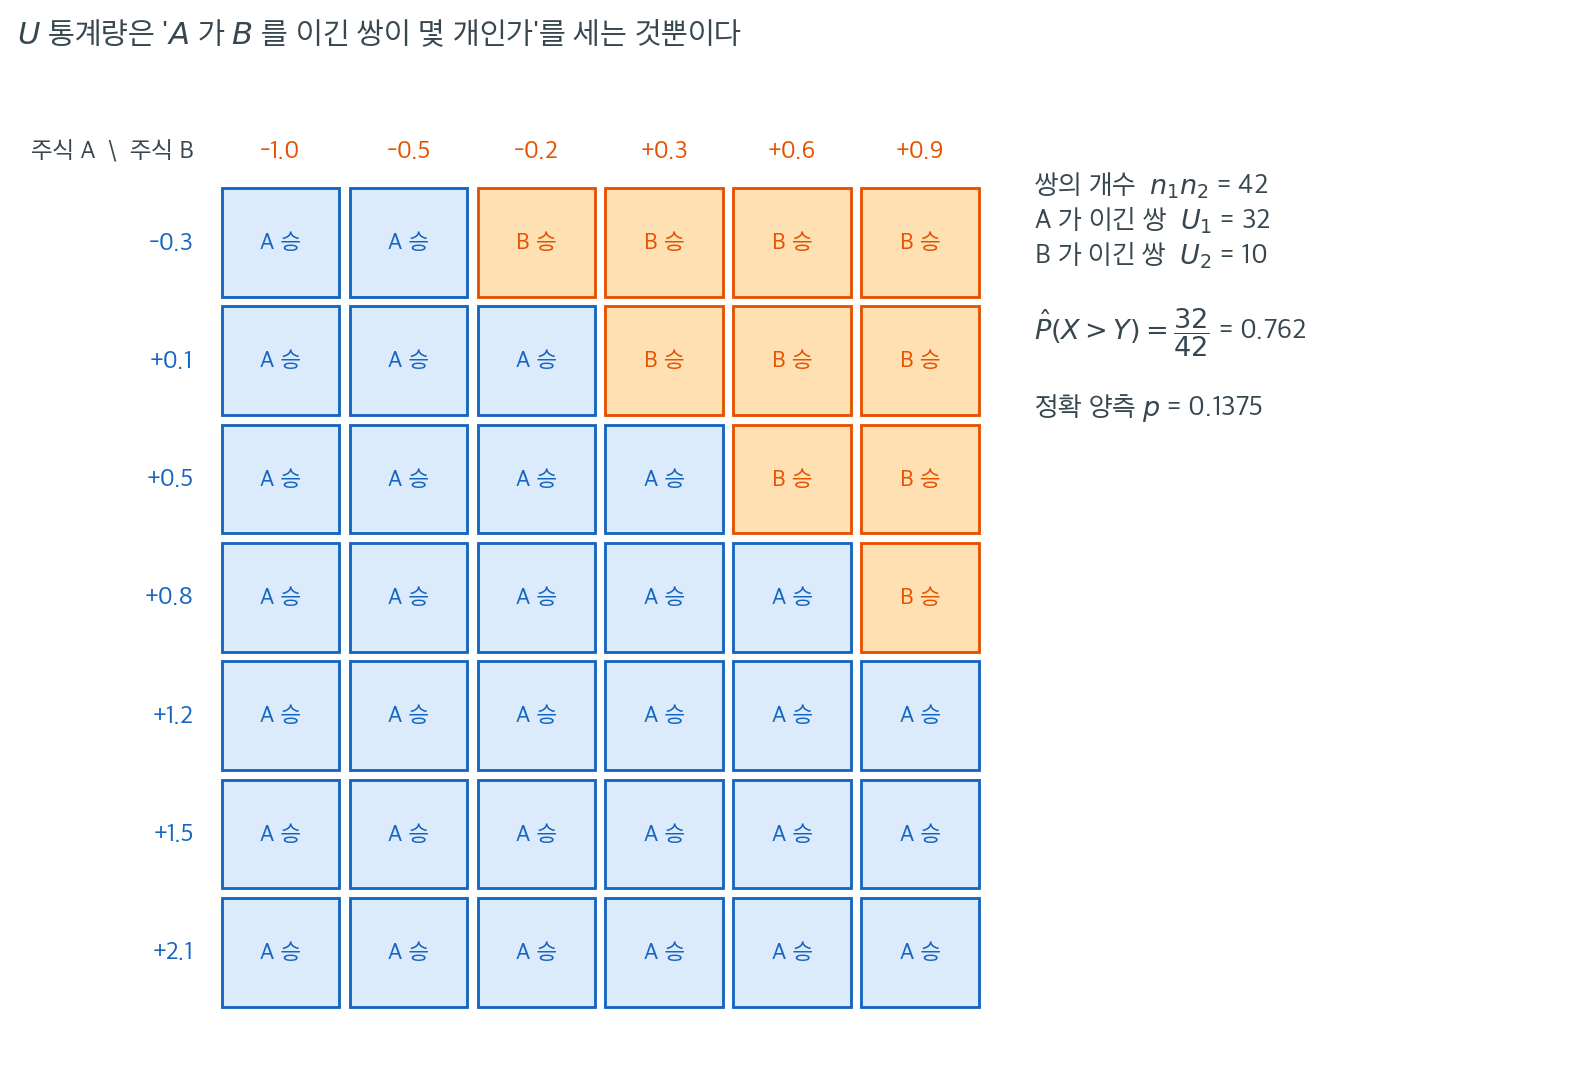
\(U\)가 하는 일은 문자 그대로 이것뿐이다. 보기 1의 자료로 격자를 채워 보자. 세로축이 주식 A의 수익률 \(7\)개, 가로축이 주식 B의 수익률 \(6\)개이고, 각 칸은 그 둘을 맞붙였을 때 누가 이겼는지를 나타낸다. 칸의 개수가 곧 \(n_1 n_2 = 42\)이다.
파란 칸(A 승)을 세면 \(U_1 = 32\), 주황 칸(B 승)을 세면 \(U_2 = 10\)이다. 물론 \(32 + 10 = 42\)로 전체 칸수와 맞는다. 이 그림에서 \(U\)는 순위합의 별명이 아니라 그 자체로 뜻이 있는 양이라는 점이 드러난다. \(\hat{P}(X > Y) = 32/42 = 0.762\)는 "두 주식에서 무작위로 하루씩 골라 비교하면 A가 이길 확률이 약 \(76\%\)"라는 문장으로 바로 번역된다. 평균차나 \(t\) 통계량에는 이런 번역이 없다.
격자의 모양도 정보를 준다. 아래 세 줄(\(+1.2\), \(+1.5\), \(+2.1\))은 전부 파랑이다. A의 상위 세 값이 B의 모든 값보다 크다는 뜻이다. 맨 윗줄(\(-0.3\))은 두 칸만 파랑이다. 계단 모양의 경계선이 오른쪽 아래로 내려갈수록 두 집단이 잘 분리된 것이고, 경계가 뒤엉킬수록 \(U_1\)이 \(21\)(\(= n_1 n_2 / 2\))에 가까워진다.
그런데 \(76\%\)라는 큰 효과에도 정확 양측 \(p\)값은 \(0.1375\)로 유의하지 않다. \(42\)개 칸이 독립인 \(42\)번의 관측이 아니라 \(13\)개 관측값에서 파생된 것이기 때문이다. \(U\)의 귀무 표준편차 \(\sigma_U = \sqrt{7 \cdot 6 \cdot 14 / 12} = 7\)이 그 종속성을 이미 반영하고 있으며, \(U_1 = 32\)는 기댓값 \(21\)에서 겨우 \(1.57\) 표준편차 떨어져 있을 뿐이다. 효과크기가 커도 표본이 작으면 유의해지지 않는다는 흔한 교훈이 여기서도 그대로다.
가설
단측 대립가설: \(H_a \colon P(X > Y) > 0.5\)(집단 1이 큰 경향) 또는 \(P(X > Y) < 0.5\).
검정통계량
검정통계량은
이다. \(U\)가 작으면 두 집단의 차이가 크다는 뜻이다.
귀무분포
\(H_0\) 아래에서 \(U_1\)의 평균과 분산은
이다. 합친 표본(크기 \(N = n_1 + n_2\))에 크기 \(t_1, \ldots, t_g\)인 동점 집단이 \(g\)개 있을 때의 동점 보정은
이다.
정규근사
\(n_1, n_2 \ge 10\)이면
이 \(H_0\) 아래 근사적으로 \(\mathcal{N}(0, 1)\)을 따른다.
보기 1. 두 주식의 일별 수익률 비교. 한 투자자가 두 주식의 일별 수익률(%)을 각각 7거래일과 6거래일에 걸쳐 비교한다.
주식 A (\(n_1 = 7\)): 1.2, 0.5, \(-0.3\), 2.1, 0.8, 1.5, 0.1
주식 B (\(n_2 = 6\)): \(-0.5\), 0.3, \(-1.0\), 0.6, \(-0.2\), 0.9
풀이
1단계. \(7 \times 6 = 42\)개의 쌍을 만들어 주식 A의 수익률이 주식 B의 수익률을 넘어서는 횟수를 센다.
정렬한 주식 A: \(-0.3, 0.1, 0.5, 0.8, 1.2, 1.5, 2.1\)
정렬한 주식 B: \(-1.0, -0.5, -0.2, 0.3, 0.6, 0.9\)
주식 A의 각 값에 대해 그보다 작은 주식 B 값의 개수를 센다.
| 주식 A | 넘어선 주식 B 값 | 개수 |
|---|---|---|
| \(-0.3\) | \(-1.0, -0.5\) | 2 |
| 0.1 | \(-1.0, -0.5, -0.2\) | 3 |
| 0.5 | \(-1.0, -0.5, -0.2, 0.3\) | 4 |
| 0.8 | \(-1.0, -0.5, -0.2, 0.3, 0.6\) | 5 |
| 1.2 | \(-1.0, -0.5, -0.2, 0.3, 0.6, 0.9\) | 6 |
| 1.5 | 6개 모두 | 6 |
| 2.1 | 6개 모두 | 6 |
2단계. 확률 추정: \(\hat{P}(X > Y) = 32/42 \approx 0.762\).
3단계. 정규근사:
\(\alpha = 0.05\)에서 \(H_0\)을 기각하지 못한다. 주식 A의 수익률이 높은 경향이 있지만(쌍별 비교의 76.2%), 표본이 작아 5% 수준에서 충분한 증거가 되지 못한다.
정확 \(p\)값
\(n_1 = 7\), \(n_2 = 6\)에서 정확 양측 \(p\)값은 \(0.1375\)로 정규근사값 \(0.1161\)보다 18% 크다. 참고로 이표본 \(t\) 검정은 \(p = 0.0829\)를 준다.
from scipy import stats
A = [1.2, 0.5, -0.3, 2.1, 0.8, 1.5, 0.1]
B = [-0.5, 0.3, -1.0, 0.6, -0.2, 0.9]
print(stats.mannwhitneyu(A, B, method='exact').pvalue)   # 0.13753
print(stats.ttest_ind(A, B).pvalue)                      # 0.08286
출력:
0.13752913752913754
0.08286060062100548
세 값 모두 \(\alpha = 0.05\)에서 기각하지 않으므로 결론은 같다.
동점 처리
두 집단 사이에 동점 관측값이 있으면 각 동점이 쌍별 비교 개수에 0이나 1이 아니라 0.5를 기여한다.
이때 정규근사에는 위에서 제시한 동점 보정 분산 공식을 써야 한다.
효과크기
공통언어 효과크기(common language effect size)는 곧 확률 추정값이다.
\(0.5\)에 가까우면 효과가 없다는 뜻이고, \(0\)이나 \(1\)에 가까우면 강한 확률적 우월을 뜻한다.
연습문제
연습문제 1. 한 연구자가 독립인 두 집단의 반응시간(밀리초)을 비교한다.
- 집단 A (카페인): 210, 230, 215, 240, 225
- 집단 B (위약): 250, 260, 235, 270, 245, 255
(a) 두 집단을 합쳐 모든 관측값에 작은 값부터 순위를 매겨라.
(b) 집단 A의 순위합 \(R_A\)를 계산하고, 이어서 집단 A의 Mann-Whitney \(U\) 통계량을 계산하라.
(c) \(E[U] = n_A n_B / 2\), \(\text{Var}(U) = n_A n_B (n_A + n_B + 1)/12\)인 정규근사로 \(z\) 통계량과 양측 \(p\)값을 계산하라.
(d) 연구 맥락에서 결과를 해석하라.
풀이
(a) 합쳐서 정렬하면
| 값 | 집단 | 순위 |
|---|---|---|
| 210 | A | 1 |
| 215 | A | 2 |
| 225 | A | 3 |
| 230 | A | 4 |
| 235 | B | 5 |
| 240 | A | 6 |
| 245 | B | 7 |
| 250 | B | 8 |
| 255 | B | 9 |
| 260 | B | 10 |
| 270 | B | 11 |
(b) \(n_A = 5\), \(n_B = 6\)이고 \(R_A = 1 + 2 + 3 + 4 + 6 = 16\)이다.
\(U_A\)가 작다는 것은 집단 A의 관측값이 낮은 순위(빠른 반응시간)에 몰려 있다는 뜻이다.
(c)
양측 \(p\)값은
정확 \(p\)값은 \(0.00866\)으로 근사값보다 조금 작다.
from scipy import stats
a = [210, 230, 215, 240, 225]; b = [250, 260, 235, 270, 245, 255]
print(stats.mannwhitneyu(a, b, method='exact').pvalue)   # 0.008658
print(stats.ttest_ind(a, b).pvalue)                      # 0.003593
출력:
0.008658008658008658
0.0035925372674007546
(d) \(p \approx 0.009 < 0.05\)이므로 5% 수준에서 \(H_0\)을 기각한다. 카페인군과 위약군의 반응시간 분포가 다르다는 통계적으로 유의한 증거가 있다. 카페인군의 반응시간이 더 빠른 경향을 보이며 이는 카페인의 각성 효과와 일관된다.
다만 \(U_A = 1\)이라는 것은 \(30\)개의 쌍별 비교 중 단 하나에서만 A가 B보다 느렸다는 뜻이다(\(240 > 235\)). 거의 완전한 분리이며, 이런 자료에서는 \(n = 5, 6\)이라는 작은 표본으로도 유의성에 도달한다. \(U_A = 0\)(완전 분리)이면 정확 \(p\)값이 \(2/462 = 0.0043\)으로 이 표본크기의 최솟값이 된다.
연습문제 2. \(U_1 = W_A - n_A(n_A+1)/2\)가 왜 \(X_i > Y_j\)인 쌍의 개수와 같은지 증명하라.
풀이
집단 A의 관측값 \(X_{(1)} < X_{(2)} < \cdots < X_{(n_1)}\)을 정렬했다고 하자(동점 없음 가정). 합친 표본에서 \(X_{(k)}\)의 순위 \(R_{(k)}\)는 \(X_{(k)}\)보다 작거나 같은 관측값의 개수이다. 이 개수는 두 부분으로 나뉜다.
- 집단 A 안에서 \(X_{(k)}\) 이하인 것: 정확히 \(k\)개(자신 포함).
- 집단 B 안에서 \(X_{(k)}\)보다 작은 것: 이를 \(c_k\)라 하자.
따라서 \(R_{(k)} = k + c_k\)이고
이다. 그런데 \(\sum_k c_k\)는 정확히 \(X_i > Y_j\)인 쌍 \((i, j)\)의 개수이다. 각 \(X_{(k)}\)에 대해 그보다 작은 \(Y_j\)를 모두 센 뒤 더한 것이기 때문이다. 그러므로
본문 보기로 확인해 보자. 표에서 "넘어선 개수" 열이 바로 \(c_k = (2, 3, 4, 5, 6, 6, 6)\)이고 합이 \(32\)이다. 한편 정렬한 주식 A의 순위는 \((3, 5, 7, 9, 11, 12, 13)\)이고 \(W_A = 60\)이며, \(60 - 7 \times 8/2 = 60 - 28 = 32\)로 일치한다.
이 항등식이 \(\sum_k k = n_1(n_1+1)/2\)라는 "집단 A가 자기 자신에게 이긴 횟수"를 빼는 조작임에 주목하라. 순위합에는 A 내부의 순서 정보가 섞여 있는데, 그것은 두 집단 비교와 무관하므로 제거하는 것이다.
연습문제 3. \(\hat{P}(X > Y) = U_1/(n_1 n_2)\)를 효과크기로 쓸 때의 장점과 함정을 논하라. Cohen의 \(d\)와 비교하라.
풀이
장점. \(\hat{P}(X > Y)\)는 단위가 없고 해석이 직관적이다. "무작위로 고른 A가 무작위로 고른 B보다 클 확률"이라는 문장은 통계 훈련이 없는 사람에게도 통한다. 또 순위 기반이므로 이상치에 로버스트하고 임의의 단조변환에 불변이다.
함정 1: 분포가 다르면 오도할 수 있다. \(P(X > Y) = 0.5\)가 "두 분포가 같다"를 뜻하지는 않는다.
import numpy as np
rng = np.random.default_rng(0)
x = rng.normal(0, 1, 200000)
y = rng.normal(0, 5, 200000)
print((x > y).mean())      # 0.5006  ← 분산이 25배 다른데도 0.5
출력:
0.499485
함정 2: Cohen의 \(d\)와 단조 대응하지 않는다. 두 분포가 정규이고 등분산이면
라는 정확한 대응이 있다.
| Cohen \(d\) | \(P(X > Y)\) |
|---|---|
| 0.2 (작음) | 0.556 |
| 0.5 (중간) | 0.638 |
| 0.8 (큼) | 0.714 |
| 1.2 | 0.802 |
그러나 이 대응은 정규성과 등분산성에 의존한다. 분포가 다르면 같은 \(d\)가 전혀 다른 \(P(X > Y)\)에 대응한다.
함정 3: 비추이성. \(P(X > Y) > 0.5\)이고 \(P(Y > Z) > 0.5\)여도 \(P(X > Z) > 0.5\)가 보장되지 않는다. 이는 세 집단 이상을 쌍별로 비교할 때 순환적 결론이 나올 수 있음을 뜻한다(비이행적 주사위 현상).
권고: \(\hat{P}(X > Y)\)를 보고하되 반드시 두 집단의 상자그림이나 ECDF를 함께 제시한다. 효과크기 하나가 분포의 차이를 요약할 수 있다는 생각 자체가 위험하다.
연습문제 4. Mann-Whitney 검정을 역전시켜 위치이동 모수 \(\Delta\)의 신뢰구간을 만들 수 있다(Hodges-Lehmann 구간). 보기의 주식 자료로 95% 신뢰구간을 구하라.
풀이
구간은 모든 쌍별 차이 \(X_i - Y_j\)(\(n_1 n_2 = 42\)개)에 기반한다. 정렬한 뒤 양 끝에서 \(k\)개씩 잘라내며, \(k\)는 정확 Mann-Whitney 임계값이다.
import numpy as np
from scipy import stats
A = np.array([1.2, 0.5, -0.3, 2.1, 0.8, 1.5, 0.1])
B = np.array([-0.5, 0.3, -1.0, 0.6, -0.2, 0.9])
n1, n2 = len(A), len(B)

diffs = np.sort((A[:, None] - B[None, :]).ravel())
print(len(diffs), np.median(diffs))        # 42, 0.80

# U 의 정확 귀무분포를 열거로 구한다
import itertools
ranks = np.arange(1, n1 + n2 + 1)
Us = np.array([ranks[list(c)].sum() - n1 * (n1 + 1) / 2
               for c in itertools.combinations(range(n1 + n2), n1)])
k = max(c for c in range(20) if (Us <= c - 1).mean() <= 0.025)
print(k, (Us <= k - 1).mean(), diffs[k - 1], diffs[-k])
# 7  0.01748  -0.2  1.8
출력:
42 0.7999999999999999
7 0.017482517482517484 -0.19999999999999998 1.8
| 양 | 값 |
|---|---|
| 쌍별 차이 개수 | \(42\) |
| Hodges-Lehmann 추정값 (쌍별 차이의 중앙값) | \(0.80\) |
| 95% 신뢰구간 | \((-0.20, \; 1.80)\) |
| 실제 포함확률 | \(1 - 2(0.0175) = 0.965\) |
| 표본평균 차이 | \(0.826\) |
구간이 \(0\)을 포함하므로 앞의 검정 결과(\(p = 0.1375\), 기각 못 함)와 일관된다.
Hodges-Lehmann 추정값 \(0.80\)은 "\(X - Y\)의 전형적인 값"이며, 위치이동 모형 \(F_Y(x) = F_X(x - \Delta)\)의 \(\Delta\)에 대한 로버스트 추정이다. 표본평균 차이 \(0.826\)과 매우 가까운데, 이 자료에는 극단적인 이상치가 없어 두 추정량이 크게 갈리지 않기 때문이다.
구간의 폭이 \(2.0\)으로 매우 넓다는 점에 주목하라. \(n_1 = 7\), \(n_2 = 6\)에서는 쌍별 차이가 42개뿐이라 양 끝에서 \(k\)개씩 잘라내는 해상도가 거칠고, 실제 포함확률도 \(0.965\)로 명목값을 넘어 보수적이다. 표본이 커지면 구간이 빠르게 좁아진다.
정리하며
Mann-Whitney \(U\) 검정은 독립인 두 집단 사이의 쌍별 승수를 세어 한 집단이 체계적으로 큰 값을 내는지 검정한다. \(U\) 통계량이 Wilcoxon 순위합통계량의 선형함수이므로 두 검정은 동치이다. Mann-Whitney 표현의 주된 장점은 해석 가능성이다. \(U_1 / (n_1 n_2)\)가 \(P(X > Y)\)를 직접 추정하므로 가설검정과 함께 자연스러운 효과크기 측도를 제공한다.