베이즈 정리
앞 절에서 확률나무를 위에서 아래로 따라 내려왔다. 원인을 알면 결과의 확률을 계산할 수 있었다. 병이 있으면 검사가 양성일 확률, 기계 A가 만들었으면 불량일 확률처럼.
그런데 현실에서 우리가 보는 것은 대개 반대다. 관측되는 것은 결과이고 알고 싶은 것은 원인이다. 검사가 양성이라는 사실을 보았을 때 병이 있을 확률은 얼마인가? 이메일에 "free"가 있을 때 그것이 스팸일 확률은?
베이즈 정리는 이 방향 전환을 해 주는 식이다. 확률나무를 아래에서 위로 거슬러 올라간다.
이 절은 세 개의 정리로 이루어진다. 방향을 뒤집는 식(정리 1), 원인이 여럿일 때의 일반형(정리 2), 그리고 이 식이 왜 그렇게 자주 직관을 배신하는가(정리 3)이다.
1. 나무를 거꾸로 거슬러 올라가기
조건부확률의 정의를 두 번 쓰면 곧바로 나온다. \(P(A \cap B)\)를 두 가지 방식으로 쪼갤 수 있다는 사실이 전부다.
정리 1. 역방향 조건부확률 — 경로 확률의 비
\(P(B) > 0\)인 사건 \(A\)와 \(B\)에 대해
이다. 네 항에는 각각 이름이 붙어 있다.
증명
조건부확률의 정의에서
이다. 가운데 등식이 앞 절의 곱셈 규칙 \(P(A \cap B) = P(B \mid A)\,P(A)\)다. \(\square\)
분모는 전확률의 법칙으로 전개하는 것이 보통이다.
그러면 실제로 계산할 때 쓰는 형태가 된다.
이 식은 경로 확률의 비다. 분자는 \(A\)를 거쳐 \(B\)에 닿는 경로의 확률이고, 분모는 \(B\)에 닿는 모든 경로의 확률의 합이다. 즉 "\(B\)에 도달한 전체 무게 가운데 \(A\)를 거쳐 온 몫은 얼마인가"를 묻는다.
2. 원인이 여럿일 때
원인이 둘(\(A\)와 \(A^c\))뿐일 이유는 없다. 항아리가 셋일 수도, 질병 후보가 다섯일 수도 있다. 분모에 경로를 더 넣으면 그만이다.
정리 2. 베이즈 정리의 일반형 — 분할 위에서의 갱신
\(A_1, A_2, \ldots, A_n\)이 표본공간 \(\Omega\)의 분할을 이루면, 각 \(i\)에 대해
이다.
증명
정리 1을 \(A = A_i\), \(B = B\)에 그대로 적용하면
이다. 남은 일은 분모를 전개하는 것뿐이다. \(A_1, \ldots, A_n\)이 \(\Omega\)의 분할이므로 앞 절 정리 3의 전확률의 법칙이
를 주고, 이를 대입하면 주장한 식이 된다. \(\square\)
\(n = 2\)이고 \(A_1 = A\), \(A_2 = A^c\)이면 정리 1 바로 뒤의 계산용 형태로 돌아온다.
분모는 \(i\)에 의존하지 않는다. 그래서 실무에서는 분자만 계산해 두고 마지막에 합이 1이 되도록 나누는 방식을 흔히 쓴다. 사후확률 \(\propto\) 가능도 \(\times\) 사전확률이라는 표현이 이 뜻이다.
보기 1. 항아리에서 공 뽑기. A 항아리에 빨간 공 3개와 파란 공 7개, B 항아리에 빨간 공 8개와 파란 공 2개가 있다. 항아리를 50 대 50으로 골라 빨간 공을 뽑았다. 그것이 B에서 나왔을 확률은?
풀이
사전확률은 50%였지만 빨간 공을 보고 나서 73%로 올랐다. B가 빨간 공을 더 잘 내놓기 때문이다.
보기 2. 스팸 필터링. 이메일의 40%가 스팸이고, "free"라는 단어가 스팸의 80%, 정상 메일의 10%에 나타난다면
풀이
이다. 단어 하나로 40%에서 84%로 올라간다. 실제 스팸 필터는 이 갱신을 단어마다 반복한다.
3. 드문 일에는 기저율이 이긴다
베이즈 정리가 유명한 것은 식이 어려워서가 아니다. 답이 자주 직관을 배신하기 때문이다.
정리 3. 기저율의 지배 — 사후확률은 사전확률에 붙들린다
사건 \(A\)가 드물면(\(P(A)\)가 작으면) \(P(B \mid A)\)가 아무리 커도 \(P(A \mid B)\)는 작게 남는다. 분자 \(P(B \mid A)P(A)\)가 작은 \(P(A)\)에 묶여 있는 반면, 분모의 거짓양성 항 \(P(B \mid A^c)P(A^c)\)는 큰 \(P(A^c)\)를 갖기 때문이다. 거짓양성률 \(\beta = P(B \mid A^c) > 0\)을 고정하고 \(\varepsilon = P(A)\)라 하면
이므로, 가능도 \(P(B \mid A)\)를 \(1\)까지 끌어올려도 사후확률은 이 상한을 넘지 못한다. 등호는 \(P(B \mid A) = 1\)일 때 성립하므로 이 상한은 더 줄일 수 없다.
증명
\(\alpha = P(B \mid A)\), \(\beta = P(B \mid A^c)\), \(\varepsilon = P(A)\)라 두면 정리 1의 계산용 형태가
이다. 분자와 분모를 \(\alpha \varepsilon\)으로 나누면
이고, 분모의 분수는 \(\alpha\)에 대해 감소하므로 \(P(A \mid B)\)는 \(\alpha\)에 대해 증가한다. 따라서 \(\alpha \leq 1\)에서 최댓값은 \(\alpha = 1\)에서 나오고
이다. 오른쪽 변은 \(\alpha\)에 전혀 의존하지 않으며 \(\varepsilon \to 0\)일 때 \(0\)으로 간다. \(\square\)
읽는 법. \(\beta\)가 고정된 채 \(\varepsilon\)이 작아지면 분모에서 \(\varepsilon\)이 무시할 만해지므로 상한이 \(\varepsilon / \beta\) 정도로 줄어든다. 아래 보기 3에서 \(\varepsilon = 0.01\), \(\beta = 0.1\)이므로 상한이 \(0.01/(0.01 + 0.1 \times 0.99) \approx 0.0917\)이고, 실제 값 \(0.0876\)이 그 아래에 있다. 이 상한은 \(\alpha = 1\)에서 달성되므로, 민감도가 완벽한 검사를 가져와도 \(8.8\%\)가 \(9.2\%\)로 오르는 것이 전부다. 사후확률을 끌어올리는 길은 가능도를 키우는 것(\(\alpha \to 1\))이 아니라 \(\varepsilon\)을 키우거나 \(\beta\)를 줄이는 것뿐이다.
보기 3. 의학 진단. 어떤 질병이 인구의 1%에 발생한다. 검사의 민감도는 95%, 특이도는 90%다. 양성 판정을 받은 사람이 실제로 병에 걸렸을 확률은?
풀이
8.8%다. 민감도 95%짜리 검사에서 양성이 나왔는데도 병에 걸렸을 확률이 10분의 1에 못 미친다.
숫자가 아니라 사람 수로 세어 보라
인구 10,000명을 생각하자.
- 병에 걸린 사람 100명 중 95명이 양성 (참양성)
- 건강한 사람 9,900명 중 990명이 양성 (거짓양성)
양성은 총 1,085명이고 그중 병이 있는 사람은 95명이다. \(95/1085 \approx 8.8\%\).
거짓양성이 참양성의 10배인 이유는 검사가 나빠서가 아니라 건강한 사람이 99배 많기 때문이다. 10%의 거짓양성률이라도 99배 큰 집단에 곱해지면 압도한다.
실무적 함의: 드문 질병에 대한 대규모 선별검사는 양성자 대부분이 건강한 사람이 되도록 만든다. 그래서 확진검사를 두 단계로 나누고, 위험군에만 검사하여 사전확률 \(P(A)\)를 올린다.
이 10,000명을 그림으로 옮기면 8.8%가 어디서 나온 수인지 한눈에 보인다.
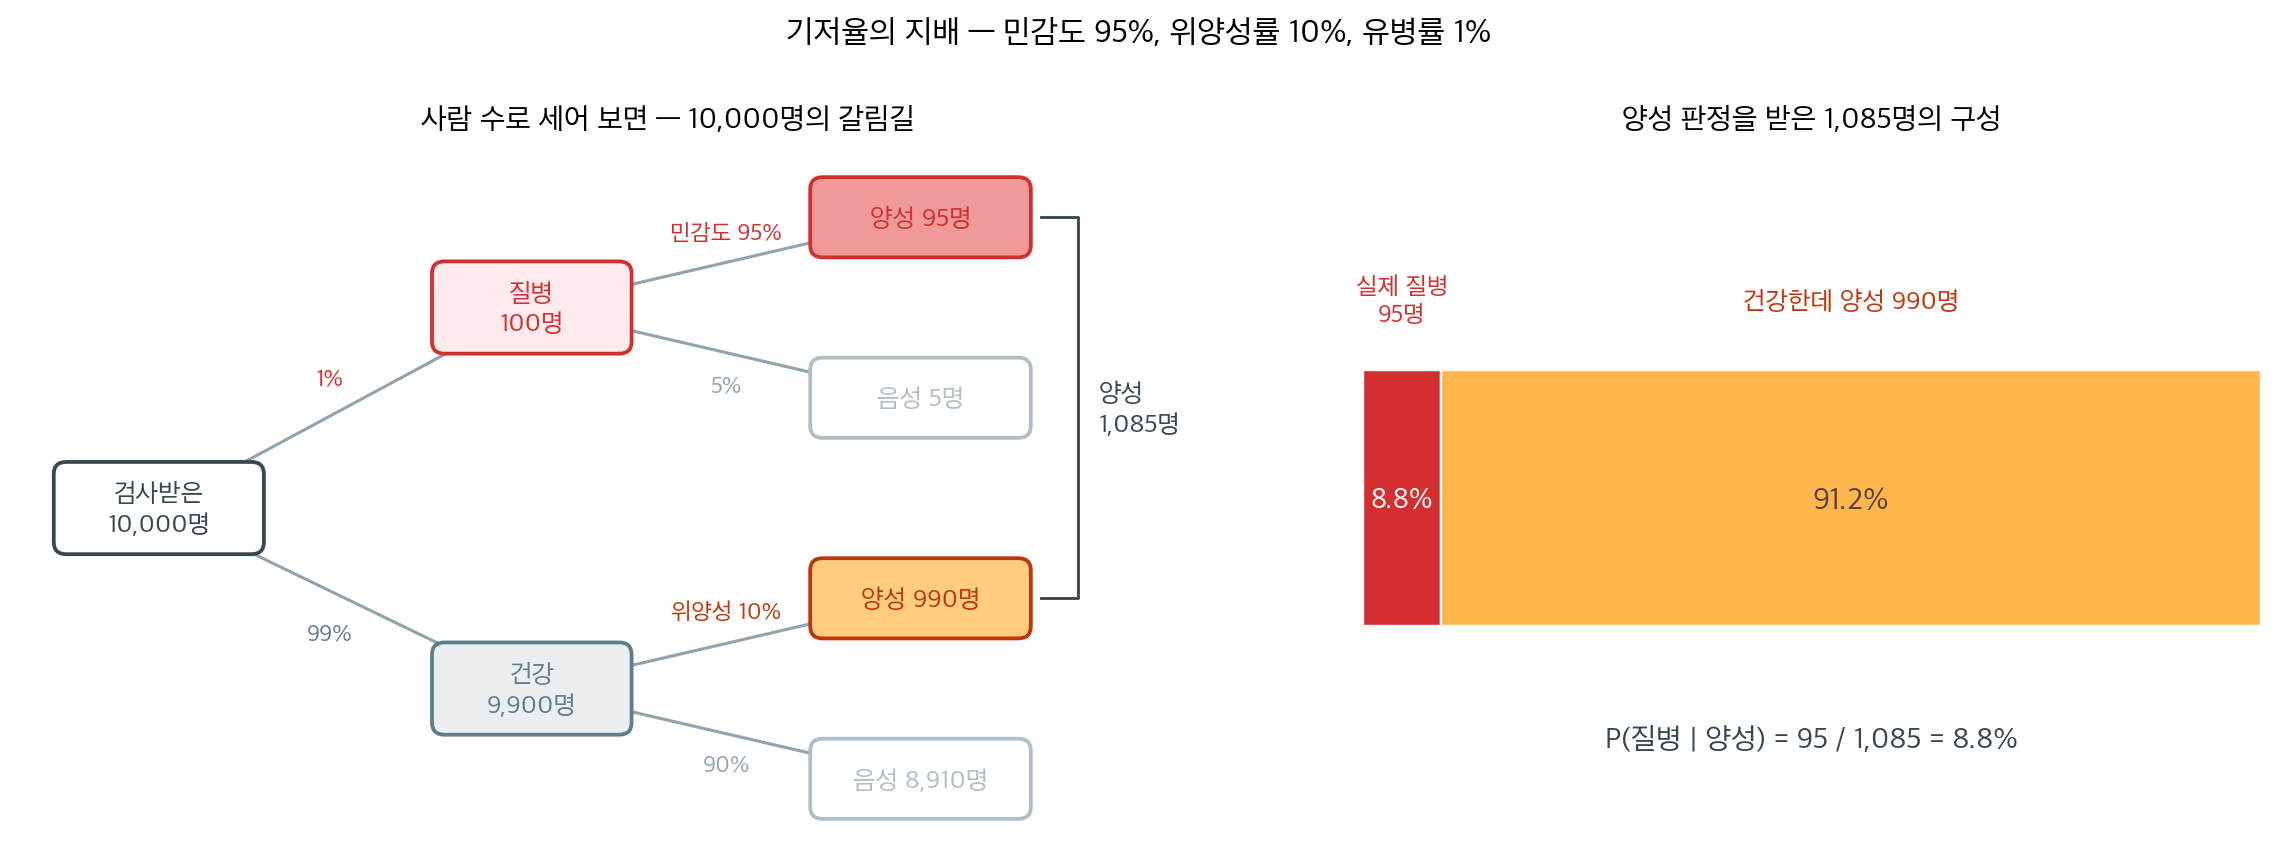
왼쪽 나무의 두 갈래는 밑변의 크기가 100배 다르다. 위쪽 가지는 100명에 95%를 곱해 95명을 내놓고, 아래쪽 가지는 9,900명에 10%를 곱해 990명을 내놓는다. 곱하는 비율은 위쪽이 아홉 배 이상 크지만 밑변이 99배 작아서 결과가 뒤집힌다. 오른쪽 막대가 그 결과인 1,085명의 구성이며, 베이즈 정리의 분수 \(95/1{,}085\)가 바로 이 막대에서 붉은 부분이 차지하는 비율이다.
사전확률이 하는 일이 이 밑변을 정하는 것이다. 가능도(민감도)는 비율일 뿐이어서, 곱해질 밑변이 작으면 아무리 커도 큰 수를 만들지 못한다.
유병률이 달라지면 사후확률이 어떻게 움직이는지 그려 보자.
보기 4. 베이즈 정리로 사후확률 구하기. 보기 3과 같은 설정이다. 유병률 \(1\%\), 민감도 \(95\%\), 특이도 \(90\%\).
(1) 사후확률을 오즈와 가능도비로 다시 유도해 보기 3의 \(0.0876\)과 같은 값이 나오는지 보이시오.
(2) 민감도를 \(100\%\)까지 올리면 사후확률이 얼마가 되는가. 정리 3의 상한과 견주시오.
풀이
(1) 오즈로 다시 쓰기. 베이즈 정리의 분자와 분모를 \(P(+ \mid D^c)P(D^c)\)로 나누면 분모의 둘째 항이 \(1\)이 되고 식이 셋의 곱으로 갈라진다. \(D\) = 질병, \(+\) = 양성이라 두고
를 얻는다. 사후오즈 = 사전오즈 × 가능도비다. 수를 넣으면
이므로 사후오즈가 \(9.5/99 = 0.095960\)이고, 오즈를 확률로 되돌리면
이다. 보기 3에서 분수 \(0.0095/0.1085\)로 구한 값과 같다.
이 꼴이 기저율의 지배를 한눈에 설명한다. 검사가 가져오는 정보는 가능도비 \(9.5\) 한 개뿐이고, 그것은 오즈를 곱셈으로 9.5배 올린다. 그런데 사전오즈가 \(1/99\)로 워낙 작아서 9.5배를 해도 \(1\)에 미치지 못한다. 사후확률이 \(50\%\)를 넘으려면 사후오즈가 \(1\)을 넘어야 하고, 그러려면 사전오즈가 \(1/9.5\)보다 커야 한다.
(2) 민감도를 올려도. 가능도비를 가장 크게 만드는 것은 \(P(+ \mid D) = 1\)인 완벽한 검사이고, 그때 \(\text{LR} = 1/0.10 = 10\)이다. 사후오즈는 \(10/99 = 0.101010\), 사후확률은
이다. 정리 3의 상한 \(\varepsilon/(\varepsilon + \beta(1-\varepsilon)) = 0.01/(0.01 + 0.1 \times 0.99) = 0.091743\)과 정확히 같다. 그 상한이 \(\alpha = 1\)에서 달성된다고 한 것이 이것이다. 민감도를 \(95\%\)에서 \(100\%\)로 끌어올려 얻는 것은 \(8.76\%\)에서 \(9.17\%\)로, \(0.4\)퍼센트포인트뿐이다.
import numpy as np

def bayes_theorem(prior, likelihood, evidence):
    """베이즈 정리:  사후 = (가능도 x 사전) / 증거

    P(H|E) = P(E|H) P(H) / P(E)
    """
    posterior = (likelihood * prior) / evidence
    return posterior

# 의학 진단 보기
prior_disease = 0.01         # 사전확률 P(질병) = 유병률 1%
sensitivity = 0.95           # 가능도 P(양성|질병) = 95%
specificity = 0.90           # 특이도 P(음성|건강) = 90%
false_positive_rate = 1 - specificity     # P(양성|건강) = 10%

# 분모(증거) P(양성)은 전확률의 법칙으로 구한다.
# 두 경로 — 질병이면서 양성, 건강하면서 양성 — 를 더한다.
p_positive = sensitivity * prior_disease + false_positive_rate * (1 - prior_disease)

# 이 분모가 베이즈 정리의 핵심이다. 건강한 사람이 99%나 되므로
# 위양성 10%가 만들어 내는 양성자 수가 진짜 환자보다 훨씬 많아진다.
posterior = bayes_theorem(prior_disease, sensitivity, p_positive)

print(f"P(disease | positive) = {posterior:.4f}")
print(f"Despite a 95% sensitive test, only {posterior*100:.1f}% of positives truly have the disease.")

# (1) 오즈 꼴로 다시 계산해 같은 값이 나오는지 본다.
prior_odds = prior_disease / (1 - prior_disease)
lr = sensitivity / false_positive_rate          # 가능도비
post_odds = prior_odds * lr
print(f"prior odds = {prior_odds:.6f},  LR = {lr:.2f},  post odds = {post_odds:.6f}")
print(f"posterior from odds = {post_odds / (1 + post_odds):.6f}")

# (2) 민감도를 1 로 올리면 가능도비가 10 이 된다. 정리 3의 상한이다.
best_odds = prior_odds * (1.0 / false_positive_rate)
print(f"sensitivity -> 1.0 : LR = {1.0/false_positive_rate:.2f},"
      f"  posterior = {best_odds / (1 + best_odds):.6f}")
출력:
P(disease | positive) = 0.0876
Despite a 95% sensitive test, only 8.8% of positives truly have the disease.
prior odds = 0.010101,  LR = 9.50,  post odds = 0.095960
posterior from odds = 0.087558
sensitivity -> 1.0 : LR = 10.00,  posterior = 0.091743
오즈로 돌아 나온 \(0.087558\)이 분수로 바로 구한 \(0.0876\)과 같고, 완벽한 검사의 \(0.091743\)이 정리 3의 상한과 소수 여섯째 자리까지 같다. 세 길이 모두 맞는다.
보기 5. 유병률이 사후확률을 지배한다. 검사 성능은 민감도 \(95\%\), 특이도 \(90\%\)로 고정하고 유병률만 \(0.1\%\)에서 \(50\%\)까지 바꾸며 사후확률을 그린다.
(1) 곡선이 \(50\%\) 선을 넘는 유병률을 해석적으로 구하시오.
(2) 유병률이 \(0\)에 가까울 때 곡선의 기울기는 얼마인가. 그려서 (1)과 (2)를 확인하시오.
풀이
(1) 임계 유병률. 유병률을 \(\pi\), 민감도를 \(\alpha\), 위양성률을 \(\beta = 1 - \text{특이도}\)라 두면
이다. 이 값이 \(1/2\)이 되는 것은 분자가 분모의 절반일 때, 곧 두 경로의 무게가 같을 때다.
수를 넣으면
이다. 유병률이 \(9.52\%\)를 넘어야 비로소 "양성이면 아플 가능성이 더 크다"고 말할 수 있다. 보기 4의 오즈 꼴로 보면 같은 조건이 더 짧게 적힌다. 사후오즈가 \(1\)을 넘으려면 사전오즈가 \(1/\text{LR} = 1/9.5\)보다 커야 하고, \(\pi/(1-\pi) = 1/9.5\)에서 \(\pi = 1/10.5 = 0.095238\)이 나온다.
(2) 원점에서의 기울기는 가능도비다. \(\pi \to 0\)이면 분모의 \(\alpha\pi\)가 \(\beta\)에 비해 무시할 만해지므로
이다. 곧 드문 병에서는 사후확률이 유병률의 가능도비 배다. 유병률 \(1\%\)를 넣으면 \(0.095\)가 나오는데 정확한 값은 \(0.0876\)이다. 분모에서 빼먹은 \(\alpha\pi = 0.0095\) 때문에 어림이 \(8\%\)쯤 크게 나온 것이고, \(\pi\)가 작아질수록 이 차이는 사라진다.
import numpy as np
import matplotlib.pyplot as plt

def bayes_update_visualization():
    """검사 성능은 그대로 두고 **유병률만** 바꿔 가며 사후확률을 그린다.

    "같은 검사, 같은 양성 결과인데 사후확률이 왜 달라지는가"에 답하는 그림이다.
    답은 분모에 있다. 유병률이 낮을수록 건강한 사람이 만들어 내는
    위양성이 분모를 지배해 사후확률을 끌어내린다.
    """
    prevalences = np.linspace(0.001, 0.5, 200)   # 0.1%부터 50%까지
    sensitivity = 0.95      # 검사 성능은 끝까지 고정
    specificity = 0.90

    posteriors = []
    for prev in prevalences:
        # 분모: 전확률의 법칙
        p_pos = sensitivity * prev + (1 - specificity) * (1 - prev)
        # 분자: 질병이면서 양성
        post = (sensitivity * prev) / p_pos
        posteriors.append(post)
    posteriors = np.array(posteriors)

    # 곡선이 50% 선을 넘는 첫 격자점과 (1)의 해석적 임계값을 견준다.
    i = int(np.argmax(posteriors >= 0.5))
    print(f"격자가 50%를 넘는 첫 유병률 = {prevalences[i]:.5f}"
          f"  (사후확률 {posteriors[i]:.4f})")
    print(f"해석적 임계 유병률         = "
          f"{(1 - specificity) / (sensitivity + 1 - specificity):.5f}")
    print(f"격자 간격                  = {prevalences[1] - prevalences[0]:.5f}")

    # (2) 원점 근처의 기울기. 어림은 LR x 유병률 이다.
    exact_1pct = sensitivity * 0.01 / (sensitivity * 0.01 + (1 - specificity) * 0.99)
    print(f"유병률 1%: 정확 {exact_1pct:.5f},  어림 9.5 x 0.01 = "
          f"{sensitivity / (1 - specificity) * 0.01:.5f}")

    fig, ax = plt.subplots(figsize=(12, 4))
    ax.plot(prevalences * 100, np.array(posteriors) * 100, lw=2)
    ax.set_xlabel('Prevalence (%)')
    ax.set_ylabel('P(Disease | Positive) (%)')
    ax.set_title("Bayes' Theorem: Posterior vs. Prevalence")
    # 50% 기준선. 이 선을 넘어야 "양성이면 아플 가능성이 더 크다"고 말할 수 있다.
    ax.axhline(y=50, color='r', linestyle='--', alpha=0.5, label='50% threshold')
    ax.legend()
    ax.spines[['top', 'right']].set_visible(False)
    plt.tight_layout()
    plt.show()

bayes_update_visualization()
출력:
격자가 50%를 넘는 첫 유병률 = 0.09629  (사후확률 0.5030)
해석적 임계 유병률         = 0.09524
격자 간격                  = 0.00251
유병률 1%: 정확 0.08756,  어림 9.5 x 0.01 = 0.09500
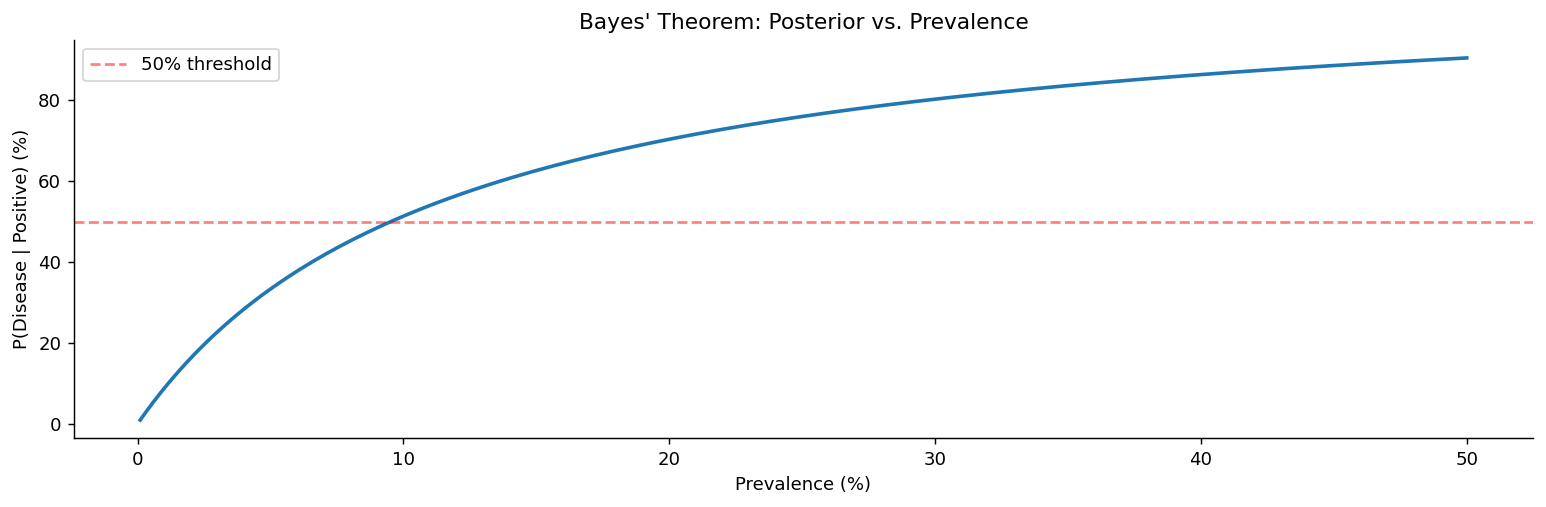
곡선이 처음에 가파르게 오르는 것이 (2)의 기울기 \(9.5\)다. 왼쪽 끝에서 유병률 \(1\%\)에 사후확률 \(8.76\%\)이니 거의 열 배로 올라가 있고, 어림값 \(9.50\%\)와의 차이도 그 자리에서 읽힌다.
빨간 \(50\%\) 선과 곡선이 만나는 자리가 (1)의 \(9.52\%\)다. 격자가 고른 첫 교차점은 \(0.09629\)인데 해석적 답은 \(0.09524\)다. 격자 간격이 \(0.00251\)이라 \(0.09524\)가 후보에 아예 없기 때문이며, 해석적으로 푼 답은 정확하고 격자 탐색은 격자만큼만 정확하다.
그림의 모양에서 읽을 실무적 결론은 이것이다. 가로축 왼쪽 \(10\%\) 구간에서 곡선이 \(0\)에서 \(50\%\)까지 치솟고 나머지 \(40\%\) 구간은 완만하다. 검사 성능을 올리는 것보다 검사 대상을 좁히는 것이 효과적인 이유가 여기 있다. 보기 4에서 보았듯 민감도를 \(100\%\)로 올려도 유병률 \(1\%\)에서는 \(9.17\%\)가 한계인데, 위험군을 골라 유병률을 \(10\%\)로 만들면 같은 검사가 \(51\%\)를 준다.
연습문제
연습문제 1. 어떤 희귀질환 검사의 유병률이 \(P(D) = 0.001\), 민감도가 \(P(+ \mid D) = 0.99\), 특이도가 \(P(- \mid D^c) = 0.95\)다. (a) \(P(D \mid +)\)를 계산하라. (b) 왜 그렇게 낮은지 설명하라. (c) 유병률이 0.05일 때 다시 계산하라.
풀이
(a) \(P(+) = 0.99 \cdot 0.001 + 0.05 \cdot 0.999 = 0.00099 + 0.04995 = 0.05094\)이므로 \(P(D \mid +) = 0.00099/0.05094 \approx 0.019\)(약 1.9%)이다.
(b) 질병이 드물다. 1000명 중 건강한 999명에게 5%의 거짓양성 비율이 적용되면 거짓양성이 \(\approx 50\)명 생기는데, 이는 참양성 \(\approx 1\)명보다 훨씬 많다. 양성 집단이 거짓양성으로 뒤덮인다.
(c) 유병률이 0.05이면 \(P(+) = 0.99 \cdot 0.05 + 0.05 \cdot 0.95 = 0.097\)이고 \(P(D \mid +) = 0.0495/0.097 \approx 0.510\)이다. 사후확률이 2%에서 51%로 뛴다. 가능도비가 같아도 사전확률이 사후확률을 얼마나 강하게 좌우하는지 극명하게 보여준다.
연습문제 2. 어떤 공장에 기계 세 대가 있어 생산량의 50%, 30%, 20%를 만들고 불량률은 각각 2%, 3%, 5%다. (a) 전체 불량률을 계산하라. (b) 불량품 하나가 주어졌을 때 그것이 3번 기계에서 나왔을 확률은 얼마인가?
풀이
(a) \(P(D) = 0.02 \cdot 0.50 + 0.03 \cdot 0.30 + 0.05 \cdot 0.20 = 0.010 + 0.009 + 0.010 = 0.029\)이다. 전체 불량률은 2.9%다.
(b) \(P(M_3 \mid D) = (0.05 \cdot 0.20)/0.029 = 0.010/0.029 \approx 0.345\)이다. 3번 기계는 생산량의 20%만 만들지만 불량의 34.5%를 낸다. 불량률 5%가 전체 평균 2.9%의 약 1.7배이고, \(0.345/0.20 = 1.72\)가 정확히 그 비이기 때문이다.
연습문제 3. 조건부확률의 정의에서 베이즈 정리를 증명하라. 그런 다음 승산 형태를 진술하라: \(P(H \mid E)/P(H^c \mid E) = [P(E \mid H)/P(E \mid H^c)] \cdot [P(H)/P(H^c)]\).
풀이
조건부확률로부터 \(P(A \mid B) = P(A \cap B)/P(B)\)이고 \(P(B \mid A) = P(A \cap B)/P(A)\)이다. 따라서 \(P(A \cap B) = P(A \mid B) P(B) = P(B \mid A) P(A)\)이고
를 얻는다.
승산 형태: 같은 \(E\)에 대해 \(H\)의 베이즈 식을 \(H^c\)의 베이즈 식으로 나누면
이다.
사후승산 = 가능도비 × 사전승산. 이 형태는 \(P(E)\)를 계산할 필요가 없어 베이즈 추론, 법정에서의 증거 평가, 의학적 의사결정의 일꾼이 된다.
연습문제 4. 어떤 동전은 공정하거나(\(P = 0.5\)) 아니면 앞면 확률이 \(P = 0.7\)로 치우쳐 있다. 사전확률은 같다. 10번 던져 앞면이 8번 나오는 것을 관측했다. 이 동전이 치우쳐 있을 사후확률을 계산하라.
풀이
\(B\) = 치우침, \(F\) = 공정, \(E\) = 10번 중 앞면 8번 관측이라 하자.
가능도: \(P(E \mid F) = \binom{10}{8} 0.5^8 \cdot 0.5^2 = 45 \cdot (0.5)^{10} \approx 0.0439\).
\(P(E \mid B) = \binom{10}{8} 0.7^8 \cdot 0.3^2 = 45 \cdot 0.0576 \cdot 0.09 \approx 0.2335\).
베이즈(또는 승산 형태)에 의해
이다. 동전이 치우쳐 있을 사후확률이 약 84%다.
승산 형태로도 같은 결과를 바로 얻는다. 사전승산 1:1, 가능도비 \(0.2335/0.0439 \approx 5.32\), 사후승산 5.32:1, 사후확률 \(5.32/(5.32 + 1) \approx 0.842\).
연습문제 5. 순차적 갱신. \(E_1\) 다음에 새로운 증거 \(E_2\)가 도착한다. \(E_1\)을 관측한 뒤 \(E_2\)를 관측하는 베이즈 갱신이 (가설이 주어졌을 때 조건부 독립으로 다룰 때) 결합 가능도로 한 번에 갱신하는 것과 수학적으로 동등함을 보여라.
풀이
\(E_1\) 이후의 사후확률: \(P(H \mid E_1) \propto P(E_1 \mid H) P(H)\).
\(E_2\)를 관측한 뒤에는 \(E_1\) 이후의 사후확률을 새로운 사전확률로 삼는다.
조건부 독립 \(P(E_2 \mid H, E_1) = P(E_2 \mid H)\)를 가정하면
인데, 이것이 바로 결합 가능도에 베이즈를 적용한 것이다. 따라서 순차적 갱신과 일괄 갱신이 같은 사후확률을 준다. 조건부 독립 아래에서 베이즈 틀은 내적으로 일관적이다.
이것이 온라인 갱신을 정당화한다. 관측값을 하나씩 처리하면 되고 처음부터 다시 계산할 필요가 없다. 갱신 후의 사후확률이 충분한 정보다.
연습문제 6. 기저율 무시. 피고인의 오류는 이렇게 주장한다. "검찰의 DNA가 피고인의 것과 일치했다. 무작위로 일치할 확률은 100만분의 1이다. 따라서 피고인은 합리적 의심을 넘어 유죄다." 이 논증이 왜 잘못되었으며 베이즈 정리는 그 오류를 어떻게 드러내는가?
풀이
이 논증은 \(P(\text{일치} \mid \text{무죄})\)(100만분의 1)를 정작 중요한 역방향 조건인 \(P(\text{무죄} \mid \text{일치})\)와 혼동한다.
베이즈 정리가 그 간극을 드러낸다. \(G\) = 유죄, \(M\) = DNA 일치라 하자. 용의자가 \(10^6\)명 규모의 데이터베이스에서 특정되었다고 하자(동등하게, 피고인이 \(10^6\)명의 후보 중 하나라는 사전확률 \(P(G) = 10^{-6}\)). 그러면 \(P(M \mid G^c) = 10^{-6}\), \(P(M \mid G) \approx 1\)이다. 베이즈에 의해
이다. 유죄일 확률이 약 50%에 불과하여 "합리적 의심을 넘어"와는 거리가 멀다. 100만분의 1이라는 수치는 사전승산을 무시한다. 사전승산을 반영하고 나면 사후확률은 훨씬 약해진다. 확신에 찬 평결에 이르려면 DNA 일치 외의 추가 증거가 필요하다.
이는 희귀질환 보기와 같은 오류 유형이다. 기저율을 잊는 것이다. 현실의 배심원과 정책결정자가 이 오류를 일상적으로 범한다. 베이즈 틀이 그 교정을 제공한다.
연습문제 7. 연습문제 3의 승산 형태를 써서 증거가 쌓이는 과정을 추적하라. 베이즈 인자란 무엇이며, 확신에 이르려면 자료가 얼마나 필요한가?
풀이
승산 형태를 로그로 취하면 갱신이 덧셈이 된다.
독립인 관측이 쌓이면 로그 베이즈 인자가 더해진다. 이것이 증거 누적의 가장 깔끔한 표현이다.
import numpy as np

p0, p1 = 0.5, 0.7                                # 공정한 동전 vs 치우친 동전

def log_bf(k, n):
    return k * np.log(p1 / p0) + (n - k) * np.log((1 - p1) / (1 - p0))

print("앞면 비율이 계속 0.7 로 관측될 때 (사전확률 0.5)")
print(f"{'n':>6}{'앞면':>6}{'로그 베이즈 인자':>18}{'사후확률':>14}")
for n in (10, 20, 50, 100, 200):
    k = int(round(0.7 * n))
    lbf = log_bf(k, n)
    print(f"{n:>6}{k:>6}{lbf:>18.4f}{1 / (1 + np.exp(-lbf)):>14.6f}")

print()
for target in (0.95, 0.99, 0.999):
    for n in range(1, 500):
        k = int(round(0.7 * n))
        if 1 / (1 + np.exp(-log_bf(k, n))) >= target:
            print(f"  사후확률 {target}에 이르려면 n = {n}")
            break
출력:
앞면 비율이 계속 0.7 로 관측될 때 (사전확률 0.5)
     n    앞면         로그 베이즈 인자          사후확률
    10     7            0.8228      0.694836
    20    14            1.6457      0.838303
    50    35            4.1141      0.983923
   100    70            8.2283      0.999733
   200   140           16.4566      1.000000

  사후확률 0.95에 이르려면 n = 34
  사후확률 0.99에 이르려면 n = 54
  사후확률 0.999에 이르려면 n = 81
로그 베이즈 인자가 \(n\)에 거의 비례해 자란다(\(0.82 \to 16.46\)). 증거가 선형으로 쌓이므로 사후 승산은 지수적으로 커진다.
| 목표 사후확률 | 필요한 \(n\) |
|---|---|
| \(0.95\) | \(34\) |
| \(0.99\) | \(54\) |
| \(0.999\) | \(81\) |
확신을 한 자릿수 올리는 데 드는 자료가 거의 일정하다. \(0.95 \to 0.99\)에 \(20\)번, \(0.99 \to 0.999\)에 \(27\)번이 더 필요하다. 로그 승산이 선형으로 자라기 때문이며, \(\sqrt{n}\)로 줄어드는 표준오차와는 다른 종류의 축적이다.
베이즈 인자 해석의 관례(제프리스).
| \(\text{BF}\) | 증거의 강도 |
|---|---|
| \(1\)–\(3\) | 언급할 가치 없음 |
| \(3\)–\(10\) | 상당함 |
| \(10\)–\(30\) | 강함 |
| \(30\)–\(100\) | 매우 강함 |
| \(> 100\) | 결정적 |
한 가지 중요한 성질. 베이즈 인자는 사전확률과 무관하다. 자료가 두 가설을 얼마나 차별하는지만 잰다. 그래서 서로 다른 사전을 가진 사람들이 같은 베이즈 인자에 동의할 수 있고, 각자 자기 사전에 그것을 곱하면 된다. 이것이 승산 형태의 실무적 가치다. \(\square\)
연습문제 8. 정리 \(3\)의 "사후확률은 사전확률에 붙들린다"는 언제 풀리는가? 사전이 언제까지 중요한지 수치로 보여라.
풀이
import numpy as np

p0, p1 = 0.5, 0.7
log_bf = lambda k, n: k * np.log(p1 / p0) + (n - k) * np.log((1 - p1) / (1 - p0))

print("앞면 비율 0.7 이 관측될 때, 사전확률별 사후확률")
print(f"{'사전':>8}" + "".join(f"{'n=' + str(n):>13}" for n in (10, 30, 100, 300)))
for prior in (0.01, 0.10, 0.50, 0.90):
    row = f"{prior:>8.2f}"
    for n in (10, 30, 100, 300):
        k = int(round(0.7 * n))
        odds = prior / (1 - prior) * np.exp(log_bf(k, n))
        row += f"{odds / (1 + odds):>13.6f}"
    print(row)
출력:
앞면 비율 0.7 이 관측될 때, 사전확률별 사후확률
      사전         n=10         n=30        n=100        n=300
    0.01     0.022482     0.106535     0.974248     1.000000
    0.10     0.201911     0.567403     0.997603     1.000000
    0.50     0.694836     0.921903     0.999733     1.000000
    0.90     0.953472     0.990675     0.999970     1.000000
\(n = 10\)에서는 사전이 지배한다. 사후확률이 \(0.022\)에서 \(0.953\)까지 갈린다. 같은 자료를 보고도 사람마다 전혀 다른 결론에 이른다.
\(n = 100\)에서는 사전이 거의 사라진다. 모두 \(0.97\) 이상으로 수렴한다.
| 사전 | \(n=10\) | \(n=100\) |
|---|---|---|
| \(0.01\) | \(0.022\) | \(0.974\) |
| \(0.90\) | \(0.953\) | \(0.99997\) |
언제 사전이 씻겨 나가는가. 로그 승산으로 보면 명확하다.
사전 항은 고정이고 자료 항은 \(n\)에 비례해 자란다. 그러므로 \(n\)이 충분히 크면 어떤 사전도 압도된다. 사전이 \(0.01\)이면 로그 승산이 \(-4.6\)이고, 관측당 로그 BF가 \(0.082\)이므로 \(n \approx 56\)이면 상쇄된다.
그러나 세 가지 예외가 있다.
- 사전이 \(0\)이면 영원히 \(0\)이다. \(P(H) = 0\)이면 어떤 증거로도 \(P(H\mid E) > 0\)이 되지 않는다. "크롬웰의 규칙" 이라 불리며, 가능성이 조금이라도 있는 가설에 정확한 \(0\)을 주지 말라는 조언이다.
- 정리 \(3\)의 상황. 연습문제 1의 희귀질환처럼 사전이 극단적으로 작으면(\(0.001\)) 강한 증거 하나로는 부족하다. 자료가 더 필요하거나(연습문제 9) 사전을 높이는 다른 정보가 필요하다.
- 모형이 틀렸으면 수렴이 무의미하다. 두 가설 중 어느 것도 참이 아니면, 자료가 쌓일수록 덜 틀린 쪽으로 확신을 갖게 된다. 베이즈 갱신은 고려한 가설 집합 안에서만 작동한다.
실무적 정리. "사전이 결과를 좌우한다"는 베이즈 방법에 대한 흔한 비판인데, \(n\)이 크면 대개 사실이 아니다. 문제가 되는 것은 자료가 적을 때, 사전이 극단적일 때, 그리고 가설 집합 자체가 잘못되었을 때다. \(\square\)
연습문제 9. 연습문제 1의 낮은 \(P(D \mid +)\)를 개선하는 실무적 방법이 재검사다. 얼마나 효과적인지 계산하고, 그 계산이 무엇을 가정하는지 밝혀라.
풀이
import numpy as np

prevalence, sens, spec = 0.001, 0.99, 0.95
ppv = lambda pr, se, sp: se * pr / (se * pr + (1 - sp) * (1 - pr))

p1 = ppv(prevalence, sens, spec)
p2 = ppv(p1, sens, spec)
p3 = ppv(p2, sens, spec)
print("검사를 반복하면 (오류가 서로 독립이라고 가정)")
print(f"  1차 양성 후 {p1:.6f}")
print(f"  2차도 양성  {p2:.6f}")
print(f"  3차도 양성  {p3:.6f}")

print("\n오류가 상관되어 있으면 2차의 조건부 특이도가 낮아진다")
for sp2 in (0.95, 0.70, 0.50, 0.20):
    print(f"  조건부 특이도 {sp2:.2f}: 사후확률 {ppv(p1, sens, sp2):.6f}")

print(f"\n{'유병률':>9}{'PPV':>10}{'NPV':>11}")
for pr in (0.0001, 0.001, 0.01, 0.05, 0.20):
    npv = spec * (1 - pr) / (spec * (1 - pr) + (1 - sens) * pr)
    print(f"{pr:>9.4f}{ppv(pr, sens, spec):>10.5f}{npv:>11.6f}")
출력:
검사를 반복하면 (오류가 서로 독립이라고 가정)
  1차 양성 후 0.019435
  2차도 양성  0.281832
  3차도 양성  0.885977

오류가 상관되어 있으면 2차의 조건부 특이도가 낮아진다
  조건부 특이도 0.95: 사후확률 0.281832
  조건부 특이도 0.70: 사후확률 0.061390
  조건부 특이도 0.50: 사후확률 0.037761
  조건부 특이도 0.20: 사후확률 0.023940

      유병률       PPV        NPV
   0.0001   0.00198   0.999999
   0.0010   0.01943   0.999989
   0.0100   0.16667   0.999894
   0.0500   0.51031   0.999446
   0.2000   0.83193   0.997375
재검사는 극적으로 효과적이다. 사후확률이 \(0.019 \to 0.282 \to 0.886\)으로 오른다. 앞 문제의 승산 형태로 보면 자명한데, 양성 결과 하나가 로그 승산을 \(\log(0.99/0.05) \approx 2.98\)만큼 올리기 때문이다.
그러나 결정적인 가정이 있다. 두 검사의 오류가 서로 독립이라는 것이다.
현실에서는 대개 독립이 아니다. 위양성의 원인이 그 사람의 생리적 특성이라면(\(1\)차에서 위양성이던 사람은 \(2\)차에서도 위양성이기 쉽다), 조건부 특이도가 훨씬 낮아진다. 표에서 보듯 조건부 특이도가 \(0.5\)면 사후확률이 \(0.038\)에 그쳐 재검사가 거의 아무 정보도 주지 않는다.
그래서 실무에서는 다른 원리의 검사를 쓴다. HIV 검사에서 스크리닝은 항체 기반, 확진은 핵산 기반으로 하는 것이 그 이유다. 같은 검사를 반복하는 것보다 독립적인 오류 구조를 가진 검사를 쓰는 것이 훨씬 낫다.
PPV와 NPV의 비대칭도 눈여겨보라. 유병률 \(0.001\)에서 PPV는 \(0.019\)로 형편없지만 NPV는 \(0.99999\)로 거의 완벽하다. 희귀질환 검사에서 음성 결과는 매우 믿을 만하고 양성 결과는 그렇지 않다. 스크리닝 검사의 목적이 "배제"인 이유가 여기 있다. \(\square\)
연습문제 10. 지금까지는 가설이 유한개였다. 모수가 연속이면 어떻게 되는가? 베타–이항 갱신으로 미리 살펴보라.
풀이
동전의 앞면 확률 \(\theta\)가 미지의 연속 모수라고 하자. 베이즈 정리의 연속판은
이다. 사전을 \(\text{Beta}(a,b)\)로 두면 사후가 다시 베타분포가 된다.
import numpy as np
from scipy import stats

a, b = 2.0, 2.0                                  # 약한 사전: 평균 0.5
print(f"사전 Beta({a:.0f}, {b:.0f}): 평균 {a/(a+b):.4f}")
print(f"\n{'자료':>12}{'사후':>18}{'사후 평균':>12}{'95% 구간':>22}")
for k, n in [(7, 10), (70, 100), (700, 1000)]:
    A, B = a + k, b + n - k
    lo, hi = stats.beta.ppf([0.025, 0.975], A, B)
    print(f"{f'{k}/{n}':>12}{f'Beta({A:.0f}, {B:.0f})':>18}"
          f"{A/(A+B):>12.5f}   [{lo:.4f}, {hi:.4f}]")
print(f"\n표본비율은 세 경우 모두 0.700")
출력:
사전 Beta(2, 2): 평균 0.5000

          자료                사후       사후 평균                95% 구간
        7/10        Beta(9, 5)     0.64286   [0.3857, 0.8614]
      70/100      Beta(72, 32)     0.69231   [0.6008, 0.7769]
    700/1000    Beta(702, 302)     0.69920   [0.6705, 0.7272]

표본비율은 세 경우 모두 0.700
사후 평균이 \(0.643 \to 0.692 \to 0.699\)로 표본비율 \(0.7\)에 수렴한다. 사전의 영향이 \(n\)과 함께 사라지는 것이 연습문제 8의 현상 그대로다.
사후 평균의 공식이 이를 명확히 보여 준다.
표본비율과 사전 평균의 가중평균이며, 가중치가 \(n\)과 \(a+b\)의 비다. 그래서 \(a+b\)를 "사전 표본 크기" 로 읽는다. \(\text{Beta}(2,2)\)는 "앞면 \(1\)번, 뒷면 \(1\)번을 미리 본 것"과 같은 무게를 갖는다.
연속 모수에서 달라지는 것.
- 가설이 비가산 무한개다. 각 \(\theta\)의 확률이 \(0\)이므로 앞 절 공리 문서 연습문제 11에서 예고한 문제가 실제로 나타난다. 확률질량 대신 밀도로 다루어야 한다.
- "사후확률"이 아니라 "사후분포"를 얻는다. 하나의 수가 아니라 함수 전체가 답이므로, 요약하려면 사후 평균·중앙값·최빈값(MAP) 중 하나를 골라야 한다.
- 구간 추정이 자연스럽다. 위 출력의 \(95\%\) 구간은 신용구간이며, "\(\theta\)가 이 구간에 있을 확률이 \(0.95\)"라고 직접 말할 수 있다. 빈도주의 신뢰구간과 해석이 다른 지점이다(1장 모수 대 통계량 문서 연습문제 4).
켤레 사전의 편의. 베타–이항처럼 사전과 사후가 같은 족에 속하면 갱신이 모수의 덧셈으로 끝난다. 계산이 폭발하지 않으므로 순차 갱신(연습문제 5)이 특히 쉬워진다. 정규–정규, 감마–포아송도 같은 성질을 갖는다.
이 계산은 뒤에서 베이즈 추론을 본격적으로 다룰 때 다시 만난다. \(\square\)
정리하며
세 정리는 하나의 동작을 말한다. 믿음의 갱신이다.
- 정리 1은 방향을 뒤집는다. 원인에서 결과로 가는 확률을 알면, 결과에서 원인으로 가는 확률을 계산할 수 있다.
- 정리 2는 원인이 여럿일 때로 확장한다. 사후확률은 각 원인의 경로 확률을 전체로 나눈 몫이다.
- 정리 3은 이 계산이 왜 자주 직관을 배신하는지 설명한다. 사전확률이 작으면 사후확률도 작게 남는다.
3.1절 전체를 한 줄로 줄이면 이렇다. 조건부확률로 나무의 가지를 정하고, 곱해서 경로를 만들고, 더해서 전체를 얻고, 나누어 거꾸로 올라간다.
여기서 자연스럽게 다음 물음이 나온다. 지금까지는 한 사건이 다른 사건에 대해 정보를 준다고 가정했다. 그렇다면 아무 정보도 주지 않는 경우는 어떻게 표현할까? \(P(A \mid B) = P(A)\)인 경우, 즉 \(B\)를 알아도 \(A\)에 대한 믿음이 전혀 바뀌지 않는 경우다.
이것이 다음 절의 독립이며, 확률 계산을 극적으로 단순하게 만드는 가정이다. 그리고 통계학이 자료를 다룰 때 거의 언제나 처음에 놓는 가정이기도 하다.