능형회귀의 정식화와 닫힌 형태 해
OLS는 계수의 크기에 아무 제약 없이 잔차제곱합을 최소화한다. 설명변수가 상관되어 있거나 표본크기에 비해 변수가 많으면 이 자유 때문에 OLS 계수가 지나치게 커지고 분산이 부풀려진다. Hoerl과 Kennard(1970)가 도입한 능형회귀는 계수벡터에 이차 벌점을 더해 이 문제를 다루며, 언제나 유일한 닫힌 형태 해를 갖는 추정량을 만든다.
능형 목적함수
능형회귀는 다음 벌점최소제곱 문제를 푼다.
여기서 \(\|\boldsymbol{\beta}\|_2^2 = \sum_{j=1}^p \beta_j^2\)은 L2 노름의 제곱이고 \(\lambda \geq 0\)은 정칙화 모수다. 첫 항은 자료에 대한 적합도를, 둘째 항은 큰 계수를 벌한다.
절편에는 벌점을 주지 않는다
실무에서는 반응변수 \(\mathbf{y}\)를 중심화하고 설명변수를 평균 0, 분산 1로 표준화한다. 절편 \(\beta_0\)은 \(\bar{y}\)로 따로 추정하며 벌점에 포함하지 않는다. 이렇게 해야 원래 측정 척도와 무관하게 벌점이 모든 기울기 계수를 동등하게 다룬다.
닫힌 형태 해의 유도
목적함수 \(L(\boldsymbol{\beta}) = \|\mathbf{y} - \mathbf{X}\boldsymbol{\beta}\|^2 + \lambda\|\boldsymbol{\beta}\|^2\)은 볼록 이차함수다. 기울기를 0으로 두면
정리하면
\(\mathbf{X}^\top\mathbf{X}\)가 양반정치이고 \(\lambda > 0\)에서 \(\lambda\mathbf{I}\)가 양정치이므로 그 합은 양정치이고 따라서 가역이다. 유일한 해는
이다. 이 해는 \(\mathbf{X}^\top\mathbf{X}\)가 특이행렬일 때(\(p > n\)이거나 정확한 선형종속이 있을 때)에도 모든 \(\lambda > 0\)에 대해 존재하고 유일하다.
제약최적화 형태
벌점 형태는 다음 제약최적화 문제와 동등하다.
여기서 \(t = t(\lambda)\)는 계수 크기 제곱합의 예산이다. KKT 조건에 의해 \(\lambda\)와 \(t\)는 일대일로 대응하며, \(\lambda\)가 커지면 \(t\)가 작아져 제약이 조여진다.
SVD 해석
특이값분해 \(\mathbf{X} = \mathbf{U}\mathbf{D}\mathbf{V}^\top\)은 능형회귀가 OLS를 어떻게 바꾸는지 보여준다. OLS 해는
로 쓸 수 있고, 능형 해는 각 항을 축소한 형태다.
인자 \(d_j^2/(d_j^2 + \lambda)\)가 \(j\)번째 주성분의 축소인자다. 0과 1 사이의 값을 가지며, 특이값이 작은 성분(선형종속의 영향을 가장 크게 받는 방향)이 가장 많이 축소된다. 이 선택적 축소가 능형회귀가 가장 불안정한 방향의 분산을 줄이는 기제다.
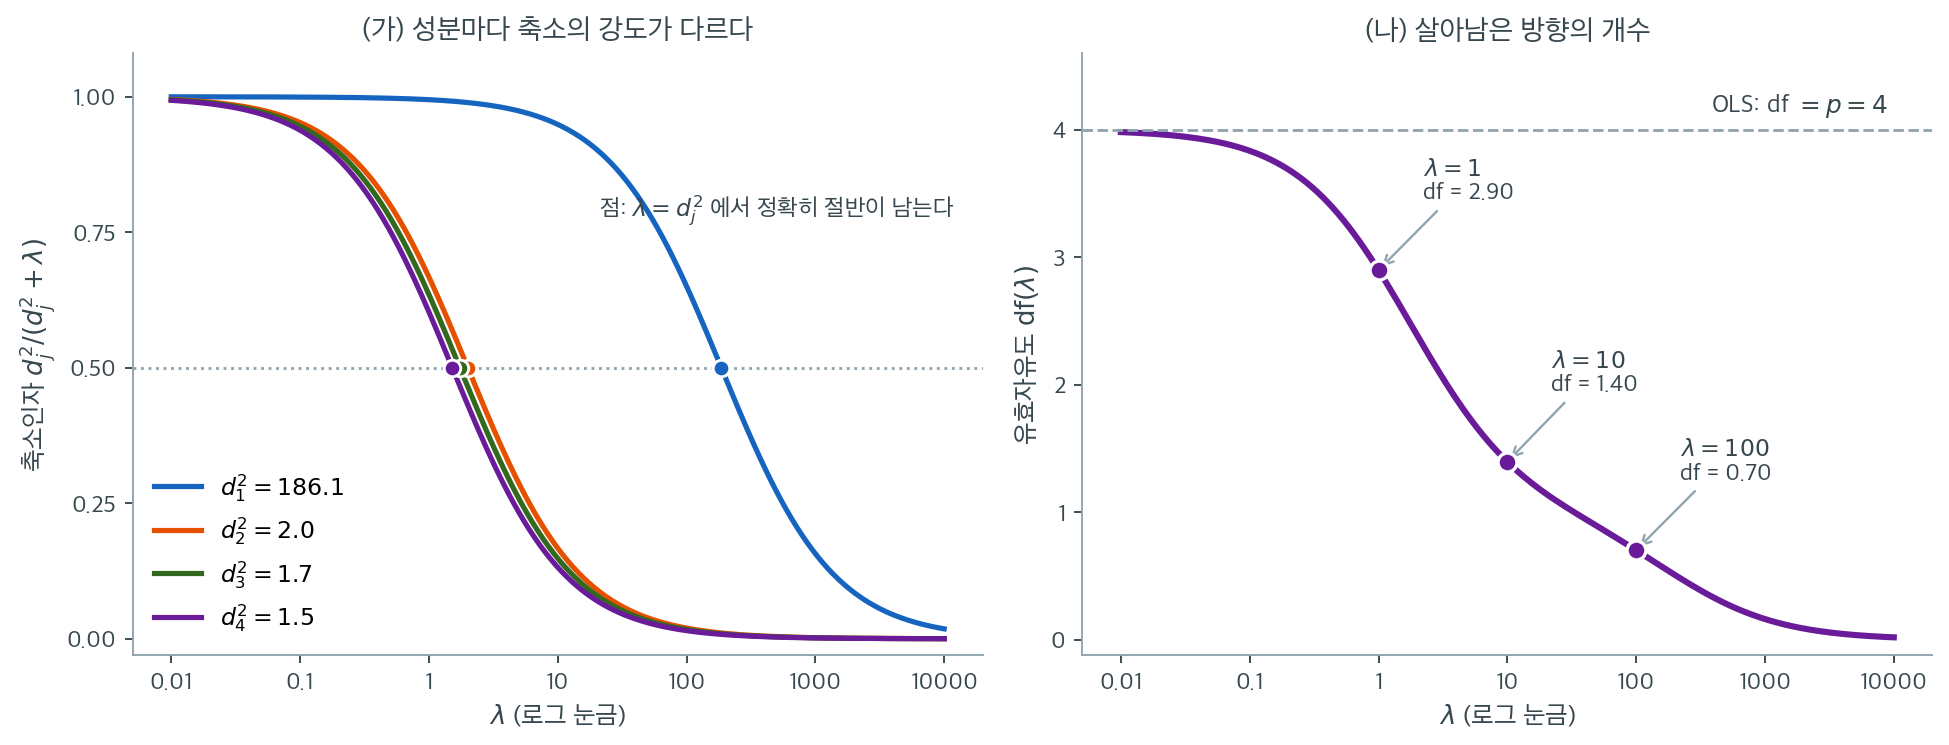
\(\rho = 0.95\)인 등상관 설명변수 4개, \(n = 50\)인 자료에서 실제로 계산한 것이다. \(\mathbf{X}^\top\mathbf{X}\)의 고윳값은 \(186.1,\ 2.01,\ 1.74,\ 1.52\)로, 첫 번째가 나머지의 100배 가까이 크다. 등상관 구조에서 첫 고유벡터는 "네 변수의 평균" 방향이고 나머지 셋은 "변수들 사이의 차이" 방향이다. 자료는 평균을 아주 잘 알고 차이는 거의 모른다.
왼쪽 그림에서 네 곡선은 모양이 같고 위치만 다르다. 축소인자 \(d_j^2/(d_j^2+\lambda)\)는 \(\lambda = d_j^2\)에서 정확히 \(0.5\)가 되므로(그림의 점), 각 곡선은 자기 고윳값에서 반토막이 난다. 따라서 \(\lambda\)를 고른다는 것은 \(\lambda\)보다 작은 고윳값을 가진 방향을 버리겠다고 선언하는 일이다. \(\lambda = 10\)을 보라. 첫 성분은 \(186.1/196.1 = 0.95\)로 95%가 살아남지만, 나머지 세 성분은 \(0.17,\ 0.15,\ 0.13\)으로 85% 이상 잘려 나간다. 같은 \(\lambda\) 하나가 성분마다 전혀 다른 강도로 작동한다.
오른쪽은 이 네 인자를 더한 값, 곧 유효자유도다. \(\lambda = 0\)에서 \(4\)로 시작해 \(\lambda = 1\)에서 \(2.90\), \(\lambda = 10\)에서 \(1.40\), \(\lambda = 100\)에서 \(0.70\)으로 떨어진다. \(\lambda = 10\)에서 \(\text{df} = 1.40\)이라는 말은 "모수를 네 개 썼지만 실질적으로는 한 개 반쯤 추정했다"는 뜻이다. 실제로 그 한 개는 첫 성분, 곧 네 변수의 평균 방향이다.
이 그림이 모형 선택에 쓰이는 방식은 이렇다. 서로 다른 \(\lambda\)의 모형은 모수 개수가 모두 \(p\)개로 같아 보이지만 복잡도는 전혀 다르다. \(\text{df}(\lambda)\)가 그 차이를 하나의 연속적인 눈금으로 환산해 주므로, AIC나 BIC처럼 "모수 개수"를 요구하는 기준을 능형회귀에도 그대로 적용할 수 있다. 다음 절 이후로 \(\lambda\) 대신 \(\text{df}(\lambda)\)를 가로축에 놓는 그림을 자주 보게 되는 이유도 그것이다. \(\lambda = 1\)과 \(\lambda = 10\)의 차이는 감이 오지 않지만, \(\text{df} = 2.9\)와 \(\text{df} = 1.4\)의 차이는 곧바로 와 닿는다.
편향과 분산
능형 추정량은 편향되어 있다. 편향과 공분산은 다음과 같다.
\(\lambda\)가 커지면 편향은 커지고 분산은 작아진다. Hoerl과 Kennard(1970)의 핵심 결과는 능형 추정량의 전체 MSE가 OLS보다 엄격히 작아지는 \(\lambda > 0\)이 언제나 존재한다는 것이다.
유효자유도
OLS는 \(p\)개의 자유도를 쓴다. 능형 추정량은 그보다 적게 쓰며 그 양은
로 주어진다. 이 값은 \(\lambda = 0\)에서 \(p\), \(\lambda \to \infty\)에서 \(0\)까지 단조감소하며, 서로 다른 \(\lambda\)를 비교할 수 있게 하는 연속적인 복잡도 척도를 제공한다.
정보기준과의 연결
유효자유도 덕분에 능형회귀에도 AIC와 BIC를 쓸 수 있다. 보통의 모수 개수를 \(\text{df}(\lambda)\)로 바꾸면 된다. 이 연결은 이 장의 조정 절에서 전개한다.
OLS와의 비교
| 성질 | OLS | 능형 (\(\lambda > 0\)) |
|---|---|---|
| 편향 | 0 | 0이 아니며 \(\lambda\)와 함께 증가 |
| 분산 | \(\sigma^2(\mathbf{X}^\top\mathbf{X})^{-1}\) | 감소, 특히 선형종속 방향에서 |
| 존재성 | \(\text{rank}(\mathbf{X}) = p\) 필요 | 언제나 존재 |
| 유일성 | \(\mathbf{X}^\top\mathbf{X}\) 가역일 때만 | 언제나 유일 |
| 자유도 | \(p\) | \(\text{df}(\lambda) < p\) |
| 변수선택 | 없음 | 없음 |
연습문제
연습문제 1. 능형 추정량 \(\hat{\boldsymbol{\beta}}_{\text{ridge}} = (\mathbf{X}^\top\mathbf{X} + \lambda\mathbf{I})^{-1}\mathbf{X}^\top\mathbf{y}\)를 생각하자.
(a) \(\lambda \to 0\)일 때 \(\hat{\boldsymbol{\beta}}_{\text{ridge}} \to \hat{\boldsymbol{\beta}}_{\text{OLS}}\)임을 보여라.
(b) \(\lambda \to \infty\)일 때 \(\hat{\boldsymbol{\beta}}_{\text{ridge}} \to \mathbf{0}\)임을 보여라.
(c) \(\mathbf{X}^\top\mathbf{X}\)가 특이행렬이더라도 모든 \(\lambda > 0\)에 대해 \(\mathbf{X}^\top\mathbf{X} + \lambda\mathbf{I}\)가 양정치임을 증명하라.
풀이
(a) \(\mathbf{X}^\top\mathbf{X}\)가 가역이면 역행렬은 연속함수이므로 \(\lambda \to 0\)에서
이고 따라서 \(\hat{\boldsymbol{\beta}}_{\text{ridge}} \to \hat{\boldsymbol{\beta}}_{\text{OLS}}\)이다.
\(\mathbf{X}^\top\mathbf{X}\)가 특이행렬이면 극한은 OLS가 아니라 최소노름 최소제곱해(무어-펜로즈 유사역행렬 해)로 간다. SVD로 보면 \(d_j = 0\)인 성분의 축소인자가 \(0/(0+\lambda) = 0\)으로 \(\lambda\)와 무관하게 0이기 때문이다.
(b) SVD 표현에서 각 항의 계수가 \(\dfrac{d_j^2}{d_j^2+\lambda}\cdot\dfrac{1}{d_j} = \dfrac{d_j}{d_j^2+\lambda}\)이고, \(\lambda \to \infty\)에서 이 값이 \(0\)으로 간다. 더 직접적으로는
(c) 임의의 \(\mathbf{v} \neq \mathbf{0}\)에 대해
이다. 첫 항은 항상 0 이상이고 둘째 항은 \(\lambda > 0\), \(\mathbf{v} \neq \mathbf{0}\)에서 엄격히 양수다. \(\mathbf{X}\mathbf{v} = \mathbf{0}\)인 방향(\(\mathbf{X}^\top\mathbf{X}\)의 영공간)이 있어도 \(\lambda\|\mathbf{v}\|^2\)이 남으므로 양정치성이 보장된다. \(\square\)
이것이 \(p > n\)에서도 능형회귀가 작동하는 이유다. \(\mathbf{X}^\top\mathbf{X}\)의 계수는 최대 \(n\)이므로 \(p > n\)이면 반드시 특이행렬이지만, \(\lambda\mathbf{I}\)가 영공간을 메운다.
연습문제 2. 능형회귀의 유효자유도는 \(\text{df}(\lambda) = \sum_{j=1}^p \frac{d_j^2}{d_j^2 + \lambda}\)이며 \(d_j\)는 \(\mathbf{X}\)의 특이값이다.
(a) \(\text{df}(0) = p\)이고 \(\text{df}(\infty) = 0\)임을 보여라.
(b) \(\text{df}(\lambda)\)는 \(\lambda\)에 대해 단조감소하는가?
(c) 라쏘에 대응하는 양은 어떻게 정의하겠는가?
풀이
(a) \(\lambda = 0\)이면 각 항이 \(d_j^2/d_j^2 = 1\)이므로 합은 \(p\)이다(모든 \(d_j > 0\)일 때). \(\lambda \to \infty\)이면 각 항이 0으로 가므로 합도 0이다.
(b) 그렇다. 각 항을 \(\lambda\)로 미분하면
이므로 모든 항이 감소하고 합도 감소한다. 감소는 엄격하다(\(d_j > 0\)인 항이 하나라도 있으면).
(c) 라쏘의 유효자유도는 놀랍도록 단순하다.
즉 0이 아닌 계수의 개수다. Zou, Hastie, Tibshirani(2007)가 이것이 불편추정량임을 증명했다.
이 결과가 놀라운 이유
라쏘는 변수를 자료에서 고른다. 보통 자료 기반 선택을 하면 자유도를 그 이상으로 세야 한다(선택 과정 자체가 자유도를 소모하므로). 단계적 선택에서 이것이 잘 알려진 문제다.
그런데 라쏘에서는 두 효과가 정확히 상쇄된다. 변수를 고르는 데 쓰는 추가 자유도를, 고른 계수를 0 쪽으로 축소하면서 되돌려주기 때문이다. 결과적으로 활성 변수를 세기만 하면 된다.
능형과 대조적이다. 능형은 모든 변수를 남기지만 \(\text{df}(\lambda) < p\)이고, 라쏘는 일부만 남기지만 남긴 개수가 곧 자유도다.
연습문제 3. 능형회귀를 sklearn 없이 직접 구현하라.
(a) \(\mathbf{X}, \mathbf{y}, \lambda\)를 받아 닫힌 형태 공식으로 \(\hat{\boldsymbol{\beta}}_{\text{ridge}}\)를 반환하는 함수를 작성하라.
(b) 사영행렬 지름길을 이용해 하나 남기기 교차검증을 구현하라.
(c) 구현이 sklearn.linear_model.Ridge와 일치하는지 확인하라.
풀이
import numpy as np
from sklearn.linear_model import Ridge

def ridge_fit(X, y, lam):
    """중심화된 X, y를 가정한다. 절편은 벌점하지 않는다."""
    p = X.shape[1]
    return np.linalg.solve(X.T @ X + lam*np.eye(p), X.T @ y)

def ridge_loocv(X, y, lam):
    """모자 행렬 지름길: 재적합 없이 LOOCV 오차를 구한다."""
    n, p = X.shape
    A = np.linalg.inv(X.T @ X + lam*np.eye(p))
    H = X @ A @ X.T                       # 능형 평활행렬
    yhat = H @ y
    h = np.diag(H)
    return np.mean(((y - yhat) / (1 - h))**2)

rng = np.random.default_rng(0)
n, p = 60, 8
X = rng.normal(size=(n, p)); X -= X.mean(0)
y = X @ np.ones(p) + rng.normal(0, 1, n); y -= y.mean()

for lam in (0.1, 1.0, 10.0):
    mine = ridge_fit(X, y, lam)
    theirs = Ridge(alpha=lam, fit_intercept=False).fit(X, y).coef_
    assert np.allclose(mine, theirs), lam
print("일치 확인")

lams = np.logspace(-2, 3, 60)
errs = [ridge_loocv(X, y, l) for l in lams]
print("LOOCV 최적 lambda =", lams[int(np.argmin(errs))])
출력:
일치 확인
LOOCV 최적 lambda = 1.0811807510766078
(c) 주의할 점. sklearn의 Ridge(alpha=lam)은 목적함수를
로 두므로 이 페이지의 \(\lambda\)와 같다. 반면 Lasso(alpha=a)는 \(\frac{1}{2n}\|\cdot\|^2 + a\|\boldsymbol\beta\|_1\)을 쓰므로 배율이 다르다. 두 클래스의 규약이 다르다는 점에 매번 주의해야 한다.
또한 fit_intercept=True(기본값)이면 sklearn이 내부에서 중심화하므로, 직접 중심화한 자료와 비교할 때는 fit_intercept=False로 맞춰야 한다.
(b)의 지름길이 왜 성립하는가. 능형회귀는 선형 평활자다. \(\hat{\mathbf{y}} = \mathbf{H}\mathbf{y}\) 형태이므로 13장 연습문제 1의 OLS 항등식이 그대로 확장된다.
따라서 \(n\)번 재적합할 필요 없이 한 번의 적합으로 LOOCV 오차 전체를 얻는다. 이것이 RidgeCV가 매우 빠른 이유이며, 라쏘에는 이런 지름길이 없다(라쏘는 선형 평활자가 아니다).
정리하며
능형회귀는 OLS 목적함수에 벌점 \(\lambda\|\boldsymbol{\beta}\|_2^2\)을 더해 닫힌 형태 해 \(\hat{\boldsymbol{\beta}}_{\text{ridge}} = (\mathbf{X}^\top\mathbf{X} + \lambda\mathbf{I})^{-1}\mathbf{X}^\top\mathbf{y}\)를 얻는다. 이 해는 \(\lambda > 0\)에서 언제나 존재하고 유일하다. SVD의 관점에서 능형은 가장 불안정한 계수 방향을 겨냥한 차등 축소를 적용하여, 편향을 들여오는 대가로 분산을 줄인다. 유효자유도는 \(\lambda\)와 함께 감소하는 연속적 복잡도 척도를 제공한다.