평균 신뢰구간의 포함확률 모의실험
개요
이 페이지에서는 모평균 \(\mu\)에 대한 일표본 신뢰구간의 포함 성질을 몬테카를로 모의실험으로 살펴본다. 세 가지 방법을 비교한다: \(\sigma\)를 아는 \(z\)-구간, 표본표준편차 \(s\)를 대입한 \(z\)-구간, 그리고 \(t\)-구간. 이 모의실험은 \(\sigma\)를 모를 때, 특히 표본이 작을 때 왜 \(t\)-구간이 올바른 기본값인지 보여준다.
세 가지 구간 방법
분산을 아는 z-구간
모표준편차 \(\sigma\)를 알 때 정확한 \((1-\alpha)100\%\) 신뢰구간은
s를 대입한 z-구간
교육에서 흔히 쓰는 변형은 \(\sigma\)를 표본표준편차 \(s\)로 바꾼 것이다:
이 구간은 \(s\)로 \(\sigma\)를 추정하며 생기는 추가 변동성을 무시하므로 작은 \(n\)에서 포함확률이 부족하다.
t-구간 (실무의 기본)
\(t\)-구간은 \(\sigma\)의 추정을 반영한다:
유한한 \(n\)에서 \(t_{\alpha/2,\,n-1} > z_{\alpha/2}\)이므로 이 구간이 더 넓고 명목 포함확률을 달성한다.
유한모집단 수정
크기 \(N\)인 유한모집단에서 비복원으로 표본을 뽑을 때는 표준오차에 유한모집단 수정(FPC) 인자를 곱한다:
\(n \le 0.10 N\)이면 이 수정은 무시할 만하다.
보기 1. 세 방법으로 만든 평균 신뢰구간. 정규모집단 \(N(\mu, \sigma^2)\)에서 크기 \(n\)인 표본을 뽑아 위의 세 구간을 만든다.
(1) \(t\)-구간의 포함확률을 구하시오. 그 값이 \(n\), \(\mu\), \(\sigma\)에 의존하는가. 이어서 \(s\)를 꽂고 \(z\) 임계값을 쓴 구간의 포함확률을 닫힌 꼴로 적고 \(n = 10\)에서 계산하시오.
(2) \(n = 10\), \(\mu = 0\), \(\sigma = 1\)에서 \(t\)-구간을 \(100\)개 만들어 참값을 담은 개수를 세시오. 그 개수로 (1)의 답을 확인할 수 있는가.
풀이
(1) \(t\)-구간의 포함확률은 정확히 \(0.95\)다. 정규표본에서
이다. 그런데 \(t\)-구간이 \(\mu\)를 담는다는 것은
과 같은 사건이다. 그러므로 포함확률은
이고, 이것은 \(n \ge 2\)인 모든 \(n\)과 모든 \(\mu\), \(\sigma\)에서 성립한다. \(T\)가 추축량(pivotal quantity)이라서 그렇다. 분포에 \(\mu\)도 \(\sigma\)도 남지 않으므로 모르는 값이 들어설 자리가 없다.
따라서 이 쪽에서 \(t\)-구간에 대해 모의실험으로 알아낼 것은 포함확률이 아니다. 포함확률은 이미 정확히 알고, 모의실험이 할 일은 그 값을 재확인하는 것과 폭이 표본마다 얼마나 흔들리는지 보는 것뿐이다.
\(s\)를 꽂은 \(z\)-구간은 다르다. 이 구간이 \(\mu\)를 담는 사건은 \(|T| \le z_{\alpha/2}\)인데, \(T\)는 여전히 \(t_{n-1}\)을 따른다. 그러므로 포함확률은
로 \(n\)에만 의존하는 닫힌 꼴이다. \(n = 10\)이면 \(F_{t_9}\)를 써서
이다. 명목 \(0.95\)인데 \(0.918\)이다. \(n = 5\)에서는 \(0.878\), \(n = 30\)에서도 \(0.940\)이다. 임계값 한 자리를 \(t\)에서 \(z\)로 바꾼 것만으로 모자란 포함확률이 생긴다.
(2) 모의실험.
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import norm, t

def finite_population_correction(n, N):
    """유한모집단 수정 인자. N을 주지 않으면 1.0(수정 없음)."""
    if N is None:
        return 1.0
    return float(np.sqrt((N - n) / (N - 1)))

def compute_intervals(xbar, s, n, alpha, method, sigma_known=None, N=None):
    """z_known, z_plugin, t 세 방법의 구간 끝점을 한꺼번에 계산한다.

    xbar와 s가 배열이면 구간도 배열로 나온다.
    모의실험에서 표본 만 개를 한 번에 처리하려고 이렇게 짰다.
    """
    fpc = finite_population_correction(n, N)
    if method == "z_known":
        z_star = norm.ppf(1 - alpha / 2)
        se = sigma_known / np.sqrt(n) * fpc
        moe = z_star * se
    elif method == "z_plugin":
        z_star = norm.ppf(1 - alpha / 2)
        se = (s / np.sqrt(n)) * fpc
        moe = z_star * se
    else:  # t
        df = n - 1
        t_star = t.ppf(1 - alpha / 2, df=df)
        se = (s / np.sqrt(n)) * fpc
        moe = t_star * se
    # z_plugin과 t의 차이는 임계값 한 자리뿐이다. 표준오차는 완전히 같다.
    return xbar - moe, xbar + moe

# 모의실험 설정. 그림으로 보기 좋게 100회만 돌린다.
# (포함확률을 정확히 재려면 아래 연습문제처럼 10,000회가 필요하다.)
rng = np.random.default_rng(42)
n_sim, n, mu, sigma, alpha = 100, 10, 0.0, 1.0, 0.05

# 행 하나가 표본 하나. axis=1로 요약하면 표본별 통계량이 한 번에 나온다.
X = rng.normal(loc=mu, scale=sigma, size=(n_sim, n))
xbar = X.mean(axis=1)
s = X.std(axis=1, ddof=1)

lower, upper = compute_intervals(xbar, s, n, alpha, method="t")
covered = (lower <= mu) & (mu <= upper)
coverage_pct = 100.0 * covered.mean()

print(f"t-interval coverage: {coverage_pct:.1f}%")
출력:
t-interval coverage: 96.0%
\(100\)개 가운데 \(96\)개가 담았다. (1)의 답은 정확히 \(0.95\)이므로 기대 개수가 \(95\)개인데 하나 더 나왔다.
이 개수로는 (1)을 확인할 수 없다. 담은 개수가 \(\text{Binomial}(100,\ 0.95)\)를 따르므로 비율의 표준오차가
이다. \(0.96\)과 \(0.95\)의 거리가 \(0.01\)로 표준오차의 절반(0.46배) 도 안 된다. 되풀이 \(100\)회는 \(0.95\)와 \(0.96\)을 구별하지 못한다. 거꾸로 \(z\)-구간의 \(0.918\)과는 \(1.5\) 표준오차 떨어져 있으니 그 차이는 \(100\)회로도 겨우 보인다. \(0.95\) 근처의 차이를 재려면 되풀이를 만 번 단위로 올려야 하고, 뒤의 연습문제들이 그렇게 한다.
그러므로 이 모의실험의 쓸모는 포함률을 "재는" 데 있지 않다. 포함률은 추축량이 이미 정확히 주었다. 모의실험이 보여 주는 것은 그 \(95\)개와 \(5\)개가 어떤 모양으로 갈라지는가이고, 그것이 다음 보기의 그림이다.
100회만 돌렸으므로 이 값 자체의 표준오차가 \(\sqrt{0.95 \times 0.05/100} \approx 2.2\)%p다. 96.0%는 95%와 구별되지 않는다.
구간의 시각화
보기 2. 구간 100개를 한 그림에. 앞 보기에서 만든 \(t\)-구간 \(100\)개를 가로선 하나씩으로 그리고, 참값을 놓친 것만 빨갛게 칠한다.
(1) 그림을 그리고 무엇이 읽히는지 수와 함께 말하시오. 구간의 폭이 제각각인 까닭과, 참값을 놓친 구간들의 공통점을 밝히시오.
(2) 이 그림이 가리는 것은 무엇인가.
풀이
(1) 그림.
# 구간 하나를 가로선 하나로 그린다. 참값을 담은 구간은 검정, 놓친 구간은
# 빨강이다. 세로 점선이 참값이고, 빨간 선이 몇 개인지 세는 것이 곧 포함확률을
# 재는 일이다. 구간마다 길이가 다른 까닭은 표본마다 s 가 다르기 때문이다.
fig, ax = plt.subplots(figsize=(12, 12))
for i in range(n_sim):
    color = "k" if covered[i] else "r"
    ax.plot([lower[i], upper[i]], [i, i], lw=2, color=color)
    ax.plot(xbar[i], i, marker="o", ms=3, color=color)

ax.axvline(mu, linestyle="--", linewidth=1.5, color="r")
n_fail = int((~covered).sum())
ax.set_title(f"{n_sim} t CIs | n={n}, CL=95% | Fail={n_fail} (Coverage ~ {coverage_pct:.1f}%)")
ax.set_yticks([])
ax.set_xlabel("Mean value")
plt.tight_layout()
plt.show()
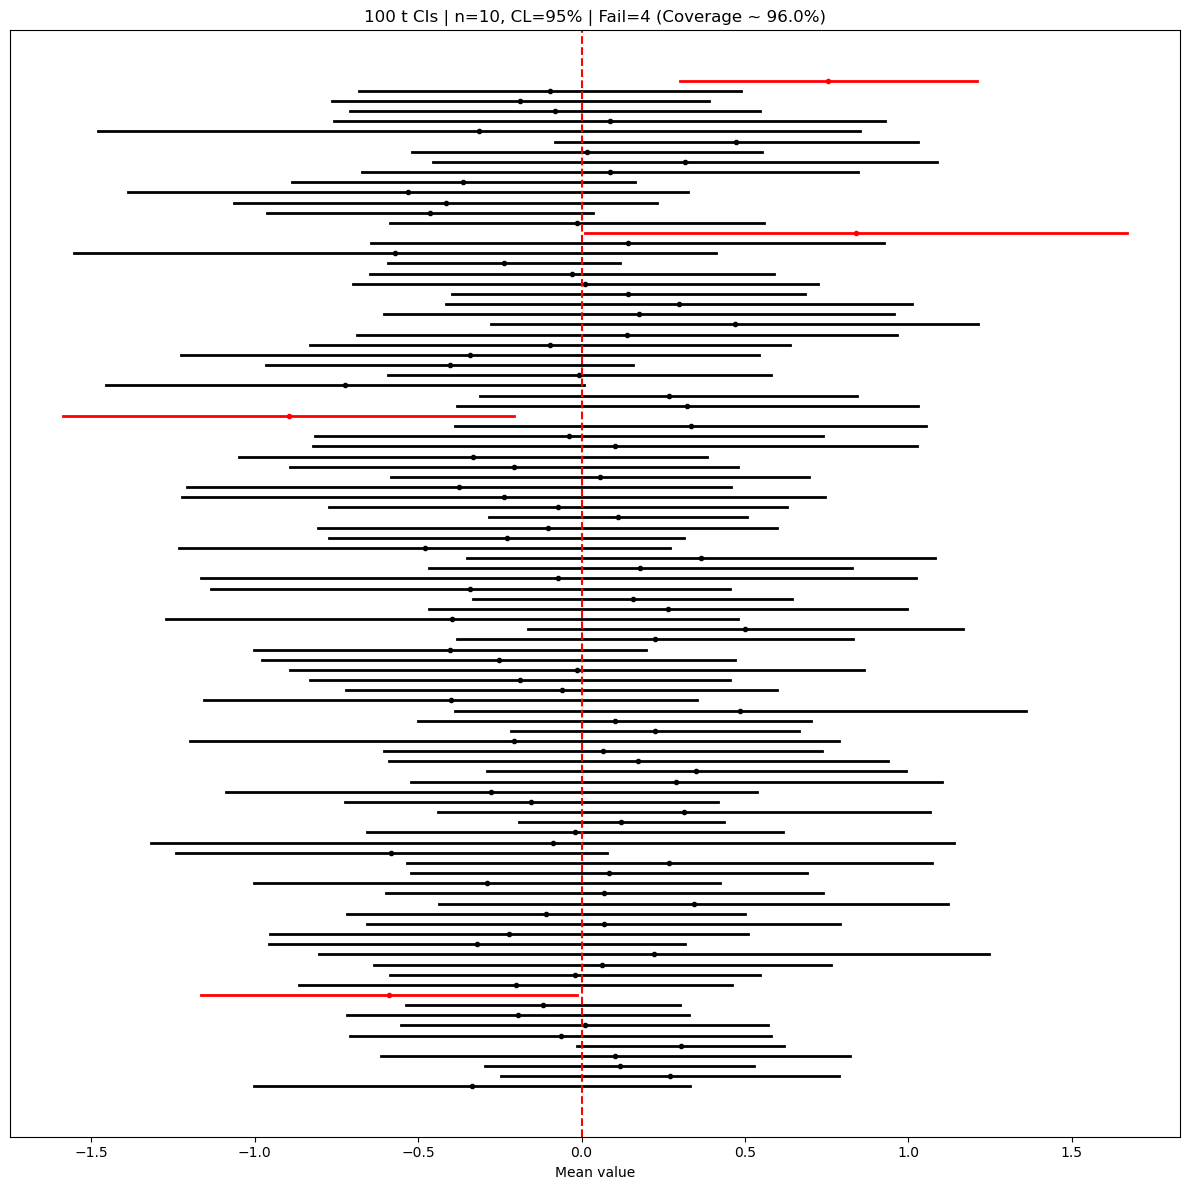
읽히는 것 하나 — 실패가 넷이다. 빨간 선을 세는 일이 곧 포함률을 재는 일이다. 다만 앞 보기에서 보았듯 \(4\)와 \(5\)의 차이는 되풀이 \(100\)회의 잡음 안에 있다.
읽히는 것 둘 — 폭은 중심과 따로 움직인다. 구간의 폭이
로 \(S\) 하나에만 비례한다. \(n = 10\)에서 \(S\)가 크게 흔들리므로 폭도 흔들린다. 실제로 \(100\)개의 폭은 최소 \(0.6292\), 중앙값 \(1.3756\), 최대 \(2.4561\) 로 최대가 최소의 \(3.90\)배다. 평균 폭 \(1.3782\)는 이론값
곧 \(1.3916\)과 \(1\%\) 안에서 맞는다(\(100\)개 평균이므로 이 정도 차이는 몬테카를로 오차다).
읽히는 것 셋 — 실패의 조건은 "\(\bar x\)가 멀다"가 아니다. 구간이 \(\mu\)를 놓치는 것은 \(|T| > 2.26216\) 과 정확히 같은 사건이다(\(T = \bar x/(s/\sqrt{10})\)). 네 실패의 \(T\)는
로 모두 임계값 밖이고, 담은 \(96\)개 가운데 \(|T|\)가 가장 큰 것이 \(2.243\) 으로 임계값 안이다. 빗금 하나로 깔끔히 갈린다.
\(\bar x\) 하나로는 갈리지 않는다. 실패한 네 표본의 \(|\bar x|\)는 \(0.590\)–\(0.896\) 인데, 담은 표본 가운데도 \(|\bar x|\)가 이보다 큰 것이 있다. \(s\) 하나로도 갈리지 않는다. 실패한 네 표본의 \(s\)는 \(0.805,\ 0.964,\ 1.159,\ 0.636\) 으로 셋은 중앙값 \(0.961\)보다 작지만 하나는 더 크다. 갈리는 것은 둘의 비다.
중심과 폭이 독립이라는 것도 그림에서 보인다. 정규표본에서 \(\bar X\)와 \(S\)가 독립이므로 "중심이 멀리 간 구간이 특히 짧다"는 경향이 없어야 한다. \(|\bar x|\)와 폭의 표본상관이 \(0.084\)로 \(0\)과 구별되지 않는다. 긴 선과 짧은 선이 참값 양쪽에 고르게 섞여 있는 것이 그 모습이다.
(2) 이 그림이 가리는 것.
첫째, 색칠은 참값을 알 때만 할 수 있다. 실제 자료에서는 자기 구간이 검정인지 빨강인지 알 길이 없다. 그림의 교육적 힘이 바로 실무에서 쓸 수 없는 정보에서 나온다. "내 구간이 \(95\%\) 확률로 \(\mu\)를 담는다"가 아니라 "이런 구간을 \(100\)번 만들면 \(95\)번쯤 담는다"인 까닭이 여기 있다.
둘째, 포함률의 참값이 보이지 않는다. \(4\)개 실패를 보고 "\(0.96\)이구나" 할 수 없다. 참값은 모의실험이 아니라 (1)의 추축량 논증이 준 \(0.95\)다.
셋째, 정규성 의존이 보이지 않는다. \(t\)-구간의 포함률이 정확히 \(0.95\)인 것은 모집단이 정규라는 가정에서 나왔다. 치우친 모집단에서도 이 그림은 똑같이 그려지며 실패 개수도 비슷하게 나올 수 있는데, 그때 달라지는 것은 실패가 한쪽으로 쏠린다는 점이다. 여기서는 \(T\)가 음수인 실패 둘, 양수인 실패 둘로 균형이 맞아 있다. 그 쏠림은 선의 개수가 아니라 선의 방향을 세어야 보인다.
가로선 하나가 표본 하나의 신뢰구간이고 세로 점선이 참값 \(\mu = 0\)이다. 놓친 넷만 빨간색이다.
너비가 제각각인 것이 \(t\)-구간의 특징이다. 너비는 \(s\)에 비례하는데 \(n = 10\)에서 \(s\)는 표본마다 크게 흔들린다. 실패한 구간들을 보면 \(\bar x\)가 0에서 멀리 떨어져 있을 뿐 아니라 그 표본의 \(s\)가 그 거리를 덮을 만큼 크지 않았던 경우들이다.
해석
- z-known은 표준오차에 추정이 개입하지 않으므로 정확히 \((1-\alpha)100\%\)의 포함확률을 달성한다.
- z-plugin은 \(\sigma\) 자리에 \(s\)를 쓰면서도 정규 임계값을 유지하므로 작은 \(n\)에서 포함확률이 부족하다. \(n < 15\)에서 부족이 가장 두드러진다.
- t-구간은 꼬리가 더 두꺼운 \(t_{n-1}\) 분포를 써서 \(s\)의 추가 불확실성을 보상한다. 모든 표본크기에서 경험적 포함확률이 명목 수준에 가깝게 유지된다.
- \(n\)이 크면 \(t_{\alpha/2,\,n-1} \to z_{\alpha/2}\)이고 \(s \xrightarrow{P} \sigma\)이므로 세 방법이 모두 수렴한다.
연습문제
연습문제 1. \(n = 5\), \(n_{\text{sim}} = 10{,}000\)으로 모의실험을 돌려라. 95% 신뢰수준에서 세 방법 각각의 경험적 포함확률을 보고하라. 어느 방법(들)이 명목 수준을 달성하는가?
풀이
rng = np.random.default_rng(0)
n, n_sim, mu, sigma, alpha = 5, 10_000, 0.0, 1.0, 0.05
X = rng.normal(mu, sigma, (n_sim, n))
xbar = X.mean(axis=1)
s = X.std(axis=1, ddof=1)

for method in ["z_known", "z_plugin", "t"]:
    lo, hi = compute_intervals(xbar, s, n, alpha, method, sigma_known=sigma)
    cov = ((lo <= mu) & (mu <= hi)).mean()
    print(f"{method}: {100*cov:.1f}%")
출력:
z_known: 94.9%
z_plugin: 87.8%
t: 94.7%
\(z\)-known과 \(t\) 구간만 명목 95%를 달성한다(모의실험 오차 약 0.2%p). 대입한 \(z\)-구간은 87.8%로 7%p 넘게 부족하다.
이 값은 우연이 아니라 정확히 계산할 수 있다. \((\bar X - \mu)/(s/\sqrt n) \sim t_4\)이므로 대입한 \(z\)-구간의 포함확률은
이고, 모의실험의 87.8%가 이 값을 재현한 것이다. \(n = 5\)에서 \(s\)의 변동이 워낙 커서 정규 임계값으로는 감당이 안 된다. \(\square\)
연습문제 2. 작은 \(n\)에서 대입한 \(z\)-구간의 포함확률이 부족한 이유를 수학적으로 설명하라. 구체적으로, \(X_1, \ldots, X_n \overset{\text{iid}}{\sim} N(\mu, \sigma^2)\)일 때 추축량 \((\bar{X} - \mu)/(s/\sqrt{n})\)이 \(N(0,1)\)을 따르지 않음을 보여라.
풀이
정규성 아래에서 \(\bar{X} \sim N(\mu, \sigma^2/n)\)이고 \((n-1)s^2/\sigma^2 \sim \chi^2_{n-1}\)이며 둘은 독립이다. 추축량
에서 \(Z \sim N(0,1)\)이다. 정의에 의해 이 비는 \(N(0,1)\)이 아니라 \(t_{n-1}\) 분포를 따른다. \(t_{n-1}\)은 \(N(0,1)\)보다 꼬리가 두꺼우므로, \(t_{\alpha/2,\,n-1}\) 대신 \(z_{\alpha/2}\)를 쓰면 구간이 너무 좁아지고 포함확률이 \(P(\mu \in \text{CI}) < 1 - \alpha\)가 된다. \(\square\)
연습문제 3. \(n\)을 고정하고 \(N \to \infty\)일 때 유한모집단 수정 인자가 \(\text{FPC} \to 1\)을 만족함을 보여라.
풀이
\(n\)을 고정하고 \(N \to \infty\)이면 \(n/N \to 0\), \(1/N \to 0\)이므로
따라서 무한(또는 아주 큰) 모집단에서는 이 수정이 아무 영향도 주지 않는다. \(\square\)
연습문제 4. 참 모집단이 정규가 아니라 비율 \(\lambda = 1\)인 지수분포(따라서 \(\mu = 1\), \(\sigma = 1\))라고 하자. \(n = 10\), \(n_{\text{sim}} = 10{,}000\)으로 모의실험을 설계하여 \(t\)-구간이 여전히 약 95%의 포함확률을 달성하는지 확인하라.
풀이
from scipy.stats import t as t_dist
rng = np.random.default_rng(0)
n, n_sim, mu, alpha = 10, 10_000, 1.0, 0.05
covers = 0
for _ in range(n_sim):
    sample = rng.exponential(scale=1.0, size=n)
    xbar = sample.mean()
    s = sample.std(ddof=1)
    t_crit = t_dist.ppf(1 - alpha / 2, df=n - 1)
    lo = xbar - t_crit * s / np.sqrt(n)
    hi = xbar + t_crit * s / np.sqrt(n)
    if lo <= mu <= hi:
        covers += 1
print(f"Coverage: {100 * covers / n_sim:.1f}%")
출력:
Coverage: 89.9%
95%에 한참 못 미친다. 지수분포는 오른쪽으로 크게 치우쳐 있어 \(n = 10\)에서는 중심극한정리 근사가 아직 멀었다. 같은 코드에서 \(n\)만 바꾸면 30일 때 92.2%, 100일 때 94.3%로 천천히 올라온다. 정규자료에서는 \(n = 5\)에서도 \(t\)-구간이 정확했다는 점과 대비된다. \(t\)-구간이 지켜 주는 것은 \(\sigma\)를 모른다는 사실이지 정규성이 아니다.
실패가 양쪽에 고르게 퍼지지도 않는다. 같은 모의실험에서 실패 1009번 중 972번이 구간이 통째로 참값 왼쪽에 놓인 경우이고, 오른쪽은 37번뿐이다. 지수분포에서는 큰 값이 드물게 나오므로 대부분의 표본에서 \(\bar x\)가 참 평균을 밑돌고, 드물게 큰 값이 걸린 표본에서는 \(s\)까지 함께 커져 구간이 넓어지는 탓에 오른쪽 실패는 잘 생기지 않는다. 명목 95%를 "양쪽에 2.5%씩"이라고 읽으면 곤란한 상황이다. \(\square\)
연습문제 5. 한 품질검사자가 \(N = 400\)개 생산분에서 부품 \(n = 50\)개를 뽑는다. FPC 인자를 계산하고 평균 부품 무게에 대한 신뢰구간 너비에 미치는 실질적 영향을 설명하라.
풀이
표준오차에 0.9366이 곱해져 약 6.3% 줄어든다. 400개 중 50개(12.5%)를 뽑으면 모집단의 무시할 수 없는 부분을 소진하므로, 복원 단순확률표본추출이 시사하는 것보다 남은 단위에 대한 불확실성이 작아져 신뢰구간이 좁아진다. \(n/N = 0.125 > 0.10\)이므로 여기서는 FPC를 무시하면 안 된다. \(\square\)
연습문제 6. 포함확률만 보지 말고 평균 폭도 함께 재어라. \(t\)-구간과 \(z\)-대입 구간을 \(n=5,10,30\)에서 비교하고, 둘의 상충을 설명하라.
풀이
import numpy as np
from scipy import stats

rng = np.random.default_rng(7)
M = 50_000
print(f"{'n':>3s} {'t 포함':>8s} {'t 폭':>8s} {'z 포함':>8s} {'z 폭':>8s}")
for n in [5, 10, 30]:
    x = rng.normal(0, 1, (M, n))
    xb, s = x.mean(1), x.std(1, ddof=1)
    se = s / np.sqrt(n)
    ht = stats.t.ppf(0.975, n - 1) * se       # t 구간
    hz = stats.norm.ppf(0.975) * se           # s를 σ 자리에 대입한 z 구간
    ct, cz = np.mean(np.abs(xb) <= ht), np.mean(np.abs(xb) <= hz)
    print(f"{n:3d} {ct:8.4f} {2 * ht.mean():8.4f} {cz:8.4f} {2 * hz.mean():8.4f}")
  n     t 포함      t 폭     z 포함      z 폭
  5   0.9508   2.3342   0.8808   1.6478
 10   0.9508   1.3913   0.9182   1.2054
 30   0.9497   0.7402   0.9396   0.7093
읽기.
| \(n\) | \(t\) 포함 / 폭 | \(z\) 포함 / 폭 |
|---|---|---|
| 5 | 0.951 / 2.33 | 0.881 / 1.65 |
| 10 | 0.951 / 1.39 | 0.918 / 1.21 |
| 30 | 0.950 / 0.74 | 0.940 / 0.71 |
상충이 분명하다. \(z\) 구간이 언제나 좁지만 포함확률이 부족하다. \(n=5\)에서 폭이 29% 짧은 대신 포함확률이 7%포인트 모자란다.
좁은 것이 좋은 것이 아니다. 폭 비교는 포함확률을 맞춘 뒤에만 의미가 있다. 포함확률이 다른 두 구간의 폭을 비교하는 것은 사과와 배를 견주는 일이다.
\(t\) 구간의 폭이 변동한다. \(n=5\)에서 평균 폭이 2.33이지만, 개별 구간의 폭은 \(S\)에 비례하므로 크게 흔들린다. 표준편차를 함께 재면
n = 5
x = rng.normal(0, 1, (M, n))
w = 2 * stats.t.ppf(0.975, n - 1) * x.std(1, ddof=1) / np.sqrt(n)
print(f"폭 평균 {w.mean():.3f}  표준편차 {w.std():.3f}  "
      f"사분위 ({np.percentile(w, 25):.3f}, {np.percentile(w, 75):.3f})")
폭 평균 2.333 표준편차 0.848 사분위 (1.721, 2.874)
폭이 1.72에서 2.87까지 흔들린다. "평균 폭"만 보고하면 이 변동이 숨는다. 사분위나 백분위를 함께 적는 것이 좋다.
연습문제 7. 로그정규 모집단(\(\mu_{\log}=0\), \(\sigma_{\log}=1\))에서 \(t\)-구간의 포함확률이 \(n\)에 따라 어떻게 회복되는지 조사하라. 얼마나 커야 충분한가?
풀이
참 평균은 \(E[X]=e^{0+1/2}=1.6487\)이다. 왜도가 \((e^1+2)\sqrt{e^1-1}=6.185\)로 매우 크다.
import numpy as np
from scipy import stats

rng = np.random.default_rng(21)
M, mu = 20_000, np.exp(0.5)
print(f"{'n':>5s} {'포함확률':>9s} {'아래 누락':>10s} {'위 누락':>9s}")
for n in [10, 30, 100, 300, 1000, 3000]:
    x = rng.lognormal(0, 1, (M, n))
    xb, s = x.mean(1), x.std(1, ddof=1)
    h = stats.t.ppf(0.975, n - 1) * s / np.sqrt(n)
    lo, hi = xb - h, xb + h
    below = np.mean(hi < mu)              # 구간이 참값보다 아래
    above = np.mean(lo > mu)              # 구간이 참값보다 위
    print(f"{n:5d} {1 - below - above:9.4f} {below:10.4f} {above:9.4f}")
    n      포함확률      아래 누락      위 누락
   10    0.8392     0.1598    0.0009
   30    0.8812     0.1168    0.0020
  100    0.9178     0.0762    0.0060
  300    0.9374     0.0527    0.0100
 1000    0.9440     0.0437    0.0123
 3000    0.9471     0.0350    0.0179
관찰 1 — 회복이 매우 느리다. \(n=100\)에서도 91.8%이고, \(n=1000\)이어야 94.4%다. 중심극한정리는 성립하지만 \(n^{-1/2}\)로 느리게 수렴한다.
관찰 2 — 누락이 한쪽으로 쏠린다. \(n=10\)에서 아래 누락 16%, 위 누락 0.1%다. 오른쪽으로 치우친 분포에서 대부분의 표본이 참 평균보다 작은 \(\bar x\)를 주고, 큰 값이 몇 개 들어온 표본에서는 \(S\)도 함께 커져 구간이 넓어지기 때문이다. 앞서 본 \(\operatorname{Cov}(\bar X,S^2)>0\)의 결과다.
실무적 기준. 흔히 인용되는 \(n\ge30\)은 이 정도 왜도에서 전혀 충분하지 않다. 대략적인 지침으로 \(n\gtrsim25\gamma_1^2\)이 제안되는데, \(\gamma_1=6.19\)이면 \(n\approx960\)이다. 위 표와 잘 맞는다.
g1 = (np.exp(1) + 2) * np.sqrt(np.exp(1) - 1)
print(f"왜도 {g1:.3f}   권장 n ≳ {25 * g1**2:.0f}")
왜도 6.185 권장 n ≳ 956
대처. 로그 척도에서 분석하거나(다만 추정 대상이 바뀐다), 부트스트랩-\(t\), 또는 왜도 보정 구간을 쓴다.
연습문제 8. 공통난수를 써서 여러 구간 방법을 비교하면 왜 효율적인지 설명하고, 수치로 확인하라.
풀이
착안. 두 방법 A, B의 포함확률 차이 \(\Delta=C_A-C_B\)를 추정할 때
다. 같은 표본에 두 방법을 모두 적용하면 공분산이 크게 양수가 되어 분산이 줄어든다. 독립 모의실험을 두 번 돌리면 공분산이 0이라 이 이득을 버린다.
import numpy as np
from scipy import stats

rng = np.random.default_rng(33)
n, M, R = 10, 2_000, 200
zc, tc = stats.norm.ppf(0.975), stats.t.ppf(0.975, n - 1)

d_common, d_indep = [], []
for _ in range(R):
    # 공통난수: 같은 표본에 두 방법 적용
    x = rng.normal(0, 1, (M, n))
    se = x.std(1, ddof=1) / np.sqrt(n)
    xb = x.mean(1)
    d_common.append(np.mean(np.abs(xb) <= tc * se) - np.mean(np.abs(xb) <= zc * se))
    # 독립난수: 방법마다 다른 표본
    x1 = rng.normal(0, 1, (M, n))
    x2 = rng.normal(0, 1, (M, n))
    c1 = np.mean(np.abs(x1.mean(1)) <= tc * x1.std(1, ddof=1) / np.sqrt(n))
    c2 = np.mean(np.abs(x2.mean(1)) <= zc * x2.std(1, ddof=1) / np.sqrt(n))
    d_indep.append(c1 - c2)

sc, si = np.std(d_common), np.std(d_indep)
print(f"공통난수  차이 평균 {np.mean(d_common):.4f}  표준편차 {sc:.5f}")
print(f"독립난수  차이 평균 {np.mean(d_indep):.4f}  표준편차 {si:.5f}")
print(f"분산 감소 {(1 - sc**2 / si**2):.1%}   필요 M 배율 {sc**2 / si**2:.3f}")
공통난수  차이 평균 0.0313  표준편차 0.00413
독립난수  차이 평균 0.0316  표준편차 0.00815
분산 감소 74.3%   필요 M 배율 0.257
분산이 74% 줄었다. 같은 정밀도를 얻는 데 반복 횟수가 4분의 1이면 된다.
왜 이렇게 효과가 큰가. \(t\) 구간과 \(z\) 구간은 같은 \(\bar x\)와 \(s\) 를 쓰고 임계값만 다르다. 포함 여부가 거의 완전히 연동되어 있어 공분산이 매우 크다. 두 방법이 비슷할수록 이득이 크다.
주의.
- 차이의 추정에만 효과가 있다. 개별 포함확률의 정밀도는 그대로다.
- 방법이 자료를 전혀 다르게 쓰면 이득이 작다. 예컨대 부트스트랩 구간과 \(t\) 구간은 연동이 약하다.
- 난수 스트림 관리가 필요하다. 방법마다 다른 수의 난수를 소비하면 동기가 깨진다.
일반 원리. 대조군을 둔 실험에서 같은 개체에 두 처리를 모두 적용하는 쌍체설계와 정확히 같은 논리다.
연습문제 9. 부트스트랩-\(t\) 구간이 치우친 자료에서 \(t\)-구간보다 나은지 모의실험으로 확인하라.
풀이
방법. 각 부트스트랩 재표본에서 스튜던트화 통계량
을 계산하고, 그 경험적 분위수 \(t^*_{\alpha/2}\), \(t^*_{1-\alpha/2}\)로 구간을 만든다.
아래쪽 분위수가 위쪽 끝에 들어간다는 점에 주의한다.
import numpy as np
from scipy import stats

rng = np.random.default_rng(5)
n, M, B, mu = 20, 2_000, 999, 1.0
hit_t = hit_bt = 0
for _ in range(M):
    x = rng.exponential(1.0, n)                 # 참 평균 1
    xb, s = x.mean(), x.std(ddof=1)
    h = stats.t.ppf(0.975, n - 1) * s / np.sqrt(n)
    hit_t += (xb - h <= mu <= xb + h)

    idx = rng.integers(0, n, (B, n))
    xs = x[idx]
    tb = (xs.mean(1) - xb) / (xs.std(1, ddof=1) / np.sqrt(n))
    lo_q, hi_q = np.percentile(tb, [2.5, 97.5])
    lo = xb - hi_q * s / np.sqrt(n)
    hi = xb - lo_q * s / np.sqrt(n)
    hit_bt += (lo <= mu <= hi)
print(f"t 구간         포함확률 {hit_t / M:.4f}")
print(f"부트스트랩-t   포함확률 {hit_bt / M:.4f}")
t 구간         포함확률 0.9200
부트스트랩-t   포함확률 0.9440
부트스트랩-\(t\)가 낫다. 92.0%에서 94.4%로 개선되었다.
왜 나은가. \(t\) 구간은 \(T\)의 분포가 \(t_{n-1}\)이라고 가정한다. 지수분포에서는 실제 분포가 왼쪽으로 치우쳐 있는데, 부트스트랩-\(t\)는 그 비대칭을 자료에서 추정한다. 이론적으로 이차정확(\(O(n^{-1})\) 오차)이며, 일차정확(\(O(n^{-1/2})\))인 백분위 부트스트랩보다도 낫다.
한계.
- \(B\)가 커야 한다. 꼬리 분위수를 추정하므로 \(B\ge999\)가 필요하다.
- \(S^*=0\)이 될 수 있다. 이산자료나 \(n\)이 아주 작을 때 분모가 0이 되어 폭발한다.
- 척도 불변이 아니다. 변환에 따라 결과가 달라진다. BCa는 이 점에서 우월하다.
- 계산이 무겁다. \(M\times B\)번의 재표본이 필요하다.
권고. 평균처럼 표준오차 공식이 있는 통계량에는 부트스트랩-\(t\)가 좋다. 표준오차를 구하기 어려우면 BCa를 쓴다.
연습문제 10. 모의실험으로 포함확률을 비교할 때 저지르기 쉬운 설계상의 잘못을 정리하라.
풀이
1 — 참값을 하나만 본다. \(\mu=0\)에서만 확인하고 "괜찮다"고 결론 내린다. 위치모수라면 불변성 덕에 상관없지만, 비율이나 분산에서는 참값에 따라 결과가 크게 다르다. 앞서 본 이항의 톱니가 그 예다. 모수 격자에서 확인해야 한다.
2 — 반복 횟수를 보고하지 않는다. 0.943과 0.951의 차이가 몬테카를로 오차 안인지 알 수 없다. MCSE를 함께 적는다.
3 — 실패를 조용히 버린다. 수치적으로 수렴하지 않거나 구간이 정의되지 않는 경우를 제외하고 계산하면 포함확률이 낙관적으로 나온다. 실패도 비포함으로 세거나, 최소한 실패율을 보고한다.
4 — 자료생성과정과 분석모형이 같다. 정규자료에서 정규가정 절차를 확인하면 당연히 잘 나온다. 위배 상황을 반드시 포함한다: 치우침, 두꺼운 꼬리, 이상치, 이분산, 종속.
5 — 씨앗을 고르고 나서 결과를 본다. 여러 씨앗으로 돌려 보고 마음에 드는 것을 보고하면 모의실험판 \(p\)-해킹이다. 씨앗을 미리 고정하고 한 번만 돌린다.
6 — 폭을 무시한다. 포함확률만 맞추면 \((-\infty,\infty)\)가 최고다. 폭을 함께 재야 비교가 의미를 갖는다.
7 — 공통난수를 안 쓴다. 방법 비교라면 같은 자료를 쓰는 것이 훨씬 효율적이다.
8 — 표본크기 하나만 본다. \(n=30\)에서 좋다고 \(n=10\)에서도 좋은 것이 아니다. \(n\)의 범위를 훑는다.
9 — 명목 수준 하나만 본다. 95%에서 좋아도 99%에서 무너질 수 있다. 꼬리로 갈수록 근사가 나빠지기 때문이다.
10 — 재현 정보를 남기지 않는다. 난수 생성기 종류, 씨앗, 패키지 버전, 코드. 이것이 없으면 남이 검증할 수 없다.
좋은 모의실험 보고의 요소.
| 항목 | 예 |
|---|---|
| 자료생성 | \(N(0,1)\), \(\text{Exp}(1)\), \(t_3\), 오염 \(0.9N(0,1)+0.1N(0,9)\) |
| 모수 격자 | \(n\in\{5,10,30,100\}\), \(p\in\{0.01,\dots,0.5\}\) |
| 반복 | \(M=10{,}000\), MCSE \(\le0.0022\) |
| 평가 | 포함확률, 평균 폭, 누락의 좌우 균형 |
| 재현 | default_rng(20250908), numpy 1.26.4, scipy 1.13.1 |
정리하며
세 방법의 포함확률을 직접 재어 보면 \(t\) 구간이 기본값이어야 하는 이유가 드러난다.
| 방법 | \(\sigma\) 를 아는가 | 소표본 포함확률 |
|---|---|---|
| \(z\) 구간(\(\sigma\) 기지) | 예 | 명목값 달성 |
| \(z\) 구간에 \(s\) 대입 | 아니오 | 명목값 미달 |
| \(t\) 구간 | 아니오 | 명목값 달성 |
- \(\sigma\) 를 \(s\) 로 바꾸면서 \(z\) 임계값을 그대로 쓰는 것이 잘못이다. \(s\) 가 흔들리는 만큼 구간이 좁아져 참값을 놓치는 비율이 늘어난다. \(t\) 임계값이 그 추가 불확실성을 폭으로 보상해 준다.
- \(n\) 이 커지면 셋이 수렴한다. \(t_{n-1}\to z\) 이므로 \(n\ge30\) 쯤부터 차이가 실무적으로 사라진다. 소표본에서만 갈린다.
- 모의실험이 이 장의 검증 방법이다. 참값을 알고 있는 상태에서 구간을 수만 번 만들어 몇 개가 덮는지 세면, 공식이 약속한 포함확률이 실제로 달성되는지 확인할 수 있다.
다음 절 비율 신뢰구간의 포함확률 모의실험으로 넘어간다. 거기서는 왈드 구간이 왜 문제인지가 수치로 드러난다.