카이제곱 분포
이 주제를 다루는 다른 곳
이 페이지는 등분산성 확인에 필요한 만큼만 카이제곱분포를 다룬다. 분산 검정의 바탕으로서 이 분포를 본격적으로 쓰는 곳은 15.2 분산에 대한 카이제곱 검정이다.
개요
카이제곱 분포는 추론통계에서 가장 기본적인 분포 중 하나로, 분산에 대한 검정, 적합도 검정, 독립성 검정의 바탕이 된다. 표준정규 확률변수의 제곱합의 분포로 자연스럽게 나타난다. 이 페이지에서는 이 분포를 정의하고 핵심 성질을 유도하며, 확률밀도함수와 누적분포함수를 시각화하고, \(\chi^2(d)\)에서 직접 표집한 것과 \(Z^2\)의 합으로 구성한 것이 같은 분포임을 보인다.
정의 1. 카이제곱분포
\(Z_1, Z_2, \dots, Z_d\)가 독립인 표준정규 확률변수 \(Z_i \sim N(0,1)\)이면 그 제곱합은 자유도 \(d\)인 카이제곱 분포를 따른다:
\(x > 0\)에서 확률밀도함수는
이며 \(\Gamma(\cdot)\)는 감마함수이다.
핵심 성질
| 성질 | 값 |
|---|---|
| 평균 | \(d\) |
| 분산 | \(2d\) |
| 최빈값 | \(\max(d - 2,\, 0)\) |
| 왜도 | \(\sqrt{8/d}\) |
| 적률생성함수 | \(t < 1/2\)에서 \((1 - 2t)^{-d/2}\) |
\(d \to \infty\)이면 중심극한정리에 의해 카이제곱 분포가 정규분포에 가까워진다:
가법성
\(Q_1 \sim \chi^2(d_1)\)과 \(Q_2 \sim \chi^2(d_2)\)가 독립이면
이다. 정의에서 곧바로 따라온다. 독립인 표준정규 제곱 \(d_1 + d_2\)개의 합은 자유도 \(d_1 + d_2\)를 갖는다.
확률밀도함수와 누적분포함수의 시각화
성질 표의 최빈값 \(\max(d-2,0)\)은 밀도를 직접 미분해 얻을 수 있다. 그 값이 정말 봉우리에 놓이는지 그려서 보자.
보기 1. 카이제곱 분포의 밀도와 분포함수. 자유도 \(d = 5\)를 쓴다.
(1) 밀도 \(f(x; d) \propto x^{d/2-1}e^{-x/2}\)를 미분해 최빈값이 \(\max(d-2,\,0)\)임을 보이시오. \(d \le 2\)에서 따로 따져야 하는 까닭도 적으시오.
(2) \(d = 5\)의 밀도와 분포함수를 겹쳐 그려 (1)의 답이 봉우리에 놓이는지 확인하고, \(P(Q \le 15)\)와 상위 5% 임계값을 계산하시오.
풀이
(1) 해석적으로. 상수배는 봉우리의 위치를 바꾸지 않으므로 로그를 씌워 미분한다. \(x > 0\)에서
이고
이다. 이것을 \(0\)으로 두면 \(x = d - 2\)를 얻는다. 이 정류점이 최대임은 이계도함수가 보여 준다.
\(d > 2\)에서 \(\log f\)가 \((0,\infty)\)에서 위로 오목하므로 정류점은 하나뿐이고 그것이 최대다.
\(d \le 2\)에서는 사정이 다르다. 계수 \(d/2 - 1 \le 0\)이므로 \(\partial \log f/\partial x < 0\)이 모든 \(x > 0\)에서 성립해 \(f\)가 단조감소한다. 정류점 \(x = d-2\)는 음수여서 정의역 밖이고, 최대는 경계 \(x \to 0^+\)에서 잡힌다. \(d = 1\)이면 \(f\)가 \(0\)에서 발산하고 \(d = 2\)이면 \(f(x) = e^{-x/2}/2\)로 유한한 값 \(1/2\)에서 시작한다. 두 경우를 함께 적으면
이고, \(d = 5\)에서는 \(3\)이다. \(d = 2\)가 모양이 바뀌는 경계라는 것이 요점이다.
(2) 수치적으로. 격자 위에서 밀도의 최대점을 찾고 분포함수의 값을 읽는다.
import numpy as np
import scipy.stats as stats
import matplotlib.pyplot as plt

# 자유도 5 인 카이제곱의 밀도함수와 분포함수를 겹쳐 그린다.
# 값이 0 이상에서만 정의되고 오른쪽으로 길게 늘어진 모양임을 확인한다.
df = 5
x = np.linspace(0, 30, 100)
pdf = stats.chi2(df=df).pdf(x)
cdf = stats.chi2(df=df).cdf(x)

# (1) 에서 유도한 최빈값 d-2 를 격자가 고른 최대점과 견준다.
print(f"해석적 최빈값  d - 2      = {df - 2}")
print(f"격자 최대점              = {x[np.argmax(pdf)]:.4f}  (격자 간격 {x[1] - x[0]:.4f})")
print(f"F(15) = P(Q <= 15)       = {stats.chi2(df=df).cdf(15):.4f}")
print(f"상위 5% 임계값            = {stats.chi2(df=df).ppf(0.95):.4f}")

fig, ax = plt.subplots()
ax.plot(x, pdf, label="PDF")
ax.plot(x, cdf, label="CDF")
ax.legend()
ax.set_title(f"PDF and CDF of chi-squared({df})")
plt.show()
출력:
해석적 최빈값  d - 2      = 3
격자 최대점              = 3.0303  (격자 간격 0.3030)
F(15) = P(Q <= 15)       = 0.9896
상위 5% 임계값            = 11.0705
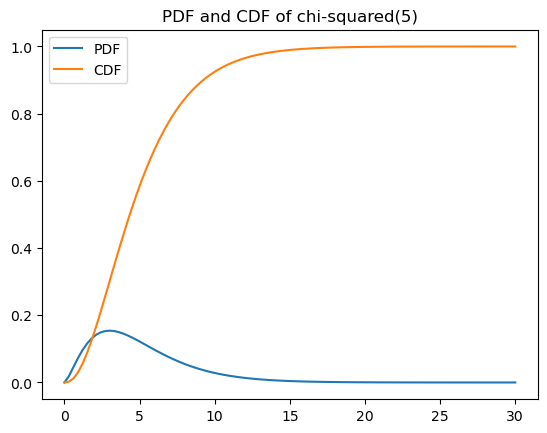
해석적 최빈값 \(3\)과 격자 최대점 \(3.0303\)이 한 칸 차이로 맞는다. 격자 간격이 \(0.3030\)이라 \(x = 3\)이 후보에 아예 없으므로 이 차이는 격자의 몫이지 유도의 흠이 아니다. 해석적으로 푼 답은 정확하고, 격자 탐색은 격자만큼만 정확하다.
분포함수는 \(P(Q \le 15) = 0.9896\)이다. 그림에서 "15 근처에서 이미 1에 가까워진다"고 읽히는 것의 정확한 값이며, 여전히 \(1\%\) 남짓이 오른쪽에 남아 있다. 상위 5% 임계값은 \(11.0705\)로 성질 표 아래의 "약 11.07"과 맞는다. 평균이 \(5\)인데 임계값이 \(11.07\)이니 오른쪽 꼬리가 평균의 두 배 너머까지 뻗는다는 뜻이고, 자유도가 작은 카이제곱 검정이 왜 둔한지의 출발점이다.
\(d\)가 작으면 밀도가 오른쪽으로 치우치고 최빈값이 0 근처에 있다. \(d\)가 커지면 분포가 더 대칭적이 되고 오른쪽으로 이동한다. 왜도 \(\sqrt{8/d}\)가 \(d \to \infty\)에서 \(0\)으로 가는 것이 그 말의 정량적 표현이다.
정규 제곱합으로부터의 구성
정의가 되는 성질은 두 방식을 비교하여 경험적으로 확인할 수 있다:
- 직접 표집: \(\chi^2(d)\)에서 10,000개를 뽑는다.
- 구성: \(N(0,1)\) 값으로 \(d \times 10{,}000\) 행렬을 만들고 각 성분을 제곱한 뒤 열 방향으로 합한다.
보기 2. 정규 제곱합으로 만들어 보기. \(d = 5\)에서 두 방식으로 10,000개씩 얻는다.
(1) \(Q = \sum_{i=1}^d Z_i^2\)의 평균과 분산을 표준정규의 적률로 직접 계산하시오.
(2) 두 방식의 표본평균과 표본분산을 (1)의 이론값과 견주고, 남은 차이가 몬테카를로 오차로 설명되는지 확인하시오.
풀이
(1) 해석적으로. \(Z \sim N(0,1)\)의 짝수 적률은 \(E[Z^{2k}] = (2k-1)!!\)이므로 \(E[Z^2] = 1\), \(E[Z^4] = 3\)이다. 따라서
이다. \(Z_1, \ldots, Z_d\)가 독립이므로 기댓값은 그냥 더해지고 분산도 더해진다.
\(d = 5\)에서 \(E[Q] = 5\), \(\operatorname{Var}(Q) = 10\)이다. 분산의 \(2\)가 어디서 왔는지가 요점이다. \(E[Z^4] = 3\)에서 왔으므로, 정규성이 깨지면 이 \(2\)가 바뀐다. 5.3절에서 분산 추론의 오류율이 첨도로 정해지던 것과 같은 자리다.
같은 계산으로 첨도도 나온다. \(\chi^2(d)\)의 표준화 4차 적률은 \(\beta_2 = 3 + 12/d\)이고, \(d = 5\)에서 \(\beta_2 = 5.4\)다. 아래에서 분산의 몬테카를로 오차를 잴 때 쓴다.
(2) 수치적으로. 정의대로 쌓아 만든 것과 scipy 가 직접 뽑아 준 것을 나란히 둔다.
import numpy as np
import scipy.stats as stats

df, seed = 5, 1
data_direct = stats.chi2(df=df).rvs(10_000, random_state=seed)
# 표준정규를 df개 제곱해서 더한다. 이것이 카이제곱분포의 정의다.
# axis=0으로 합해야 열마다(표본마다) 제곱합이 하나씩 나온다.
data_from_norm = np.sum(
    stats.norm().rvs(size=(df, 10_000), random_state=seed) ** 2,
    axis=0
)

for name, d in [("직접 표집", data_direct), ("제곱합 구성", data_from_norm)]:
    print(f"{name:<12} mean={d.mean():.4f}  var={d.var(ddof=1):.4f}")
print(f"{'이론값':<12} mean={df:.4f}  var={2*df:.4f}")

# 몬테카를로 오차. 평균은 SD/sqrt(N), 분산은 Var * sqrt((beta2-1)/N) 이며
# 카이제곱(d) 의 첨도는 beta2 = 3 + 12/d 다.
N, beta2 = 10_000, 3 + 12 / df
se_mean = np.sqrt(2 * df) / np.sqrt(N)
se_var = 2 * df * np.sqrt((beta2 - 1) / N)
print(f"{'MC 오차':<12} mean={se_mean:.4f}  var={se_var:.4f}")
출력:
직접 표집        mean=4.9953  var=10.0317
제곱합 구성       mean=5.0068  var=9.9999
이론값          mean=5.0000  var=10.0000
MC 오차        mean=0.0316  var=0.2098
두 방식이 모두 이론값 안에 든다. 평균의 어긋남은 \(-0.0047\)과 \(+0.0068\)로 몬테카를로 오차 \(0.0316\)의 \(0.15\)배와 \(0.22\)배다. 분산의 어긋남은 \(+0.0317\)과 \(-0.0001\)로 오차 \(0.2098\)의 \(0.15\)배와 사실상 \(0\)이다. 네 수 모두 \(1\) 표준오차 안에 있으므로 정의 \(\sum Z_i^2 \sim \chi^2(d)\)가 수치로 확인된 셈이다.
분산의 몬테카를로 오차가 평균의 것보다 \(6.6\)배 큰 데에는 이유가 있다. 표본분산의 표준오차는 \(\sigma^2\sqrt{(\beta_2-1)/N}\)이라 첨도가 들어오는데, \(\chi^2(5)\)의 \(\beta_2 = 5.4\)가 정규의 \(3\)보다 크기 때문이다. 2차 적률을 재려면 4차 적률이 필요하다는 것이 여기서도 보인다.
두 표본이 서로 정확히 같지는 않다는 점에 주의하라. random_state가 같아도 뽑는 난수의 개수와 용도가 다르기 때문이다. 직접 표집은 10,000개를 뽑고, 제곱합 구성은 50,000개를 뽑아 다섯 개씩 묶는다. 같은 분포에서 뽑은 서로 다른 두 표본이므로 평균과 분산이 소수점 셋째 자리에서 갈리는 것이 정상이다.
해석
- 자유도 \(d\)가 모양을 결정한다. \(d\)가 작으면 0 근처에 몰린 심하게 치우친 분포가 되고, \(d\)가 크면 \(d\)를 중심으로 하는 거의 대칭인 종 모양이 된다.
- 카이제곱 분포는 제곱합으로 정의되므로 양수 값만 가진다.
- 임계값 \(\chi^2_{1-\alpha}(d)\)는 가설검정에서 널리 쓰인다. 예를 들어 \(\chi^2(5)\)의 상위 5% 임계값은 약 11.07이다.
연습문제
연습문제 1. 위 성질 표를 써서 \(Q \sim \chi^2(10)\)의 \(E[Q]\)와 \(\text{Var}(Q)\)를 계산하고, \(Z \sim N(0,1)\)에 대한 \(E[Z^2]\)과 \(\text{Var}(Z^2)\)으로 확인하라.
풀이
표에서 \(E[Q] = d = 10\), \(\text{Var}(Q) = 2d = 20\)이다.
확인: \(Z \sim N(0,1)\)에서 \(E[Z^2] = 1\)이고 \(\text{Var}(Z^2) = E[Z^4] - (E[Z^2])^2 = 3 - 1 = 2\)이다. \(Q = \sum_{i=1}^{10} Z_i^2\)이고 항들이 독립이므로
이다. 두 방식이 일치한다.
연습문제 2. \(Z \sim N(0,1)\)에 대한 \(Z^2\)의 적률생성함수에서 시작하여 \(\chi^2(d)\)의 적률생성함수가 \(t < 1/2\)에서 \(M_Q(t) = (1 - 2t)^{-d/2}\)임을 보여라.
풀이
\(Z \sim N(0,1)\)에서 \(Z^2\)의 적률생성함수는
이다. 이 적분은 \(1 - 2t > 0\), 즉 \(t < 1/2\)일 때 수렴한다. Gauss 적분을 완성하면 \(M_{Z^2}(t) = (1 - 2t)^{-1/2}\)을 얻는다.
\(Q = \sum_{i=1}^{d} Z_i^2\)이고 \(Z_i\)가 독립이므로 \(Q\)의 적률생성함수는 개별 적률생성함수의 곱이다:
(\(t < 1/2\)). \(\square\)
연습문제 3. \(Q_1 \sim \chi^2(3)\)과 \(Q_2 \sim \chi^2(7)\)이 독립일 때 \(Q_1 + Q_2\)의 분포를 구하고 \(P(Q_1 + Q_2 > 18.31)\)을 계산하라.
풀이
가법성에 의해 \(Q_1 + Q_2 \sim \chi^2(3 + 7) = \chi^2(10)\)이다.
값 18.31은 \(\chi^2(10)\)의 상위 5% 임계값이므로
이다.
연습문제 4. 자유도 \(d = 2\)인 카이제곱 분포가 지수분포인 이유를 설명하라. 비율 모수를 밝혀라.
풀이
확률밀도함수에 \(d = 2\)를 넣으면
이다. 이는 정확히 \(\text{Exponential}(\lambda = 1/2)\) 분포(동등하게 평균이 2인 지수분포)의 확률밀도함수이다. 놀랄 일은 아니다. \(\chi^2(d)\)는 \(\text{Gamma}(d/2, 1/2)\)의 특수한 경우이고 \(\text{Gamma}(1, \lambda) = \text{Exponential}(\lambda)\)이기 때문이다.
연습문제 5. 어떤 연구자가 정규근사 \((Q - d)/\sqrt{2d} \approx N(0,1)\)을 써서 \(\chi^2(50)\)의 상위 5% 임계값을 구하려 한다. 근사 임계값을 계산하고 정확한 값 67.50과 비교하라.
풀이
\(d = 50\)과 \(z_{0.95} = 1.645\)로 근사하면
이다. 정확한 값은 67.50이므로 근사가 약 1.05만큼 과소추정한다(상대오차 약 1.6%). \(d = 50\)에서 근사가 그런대로 쓸 만하고 \(d\)가 커질수록 좋아진다. 더 정확하게 하려면 Wilson-Hilferty의 세제곱근 변환 \(\bigl(\frac{Q}{d}\bigr)^{1/3} \approx N\!\bigl(1 - \frac{2}{9d},\, \frac{2}{9d}\bigr)\)을 흔히 선호한다.
연습문제 6. 정의 1과 가법성을 모의실험으로 검증하라. 성질 표의 평균·분산·왜도가 맞는지도 함께 확인하라.
풀이
import numpy as np
from scipy import stats

rng = np.random.default_rng(303)
print("정의 검증: ΣZ² 와 χ²(d) 가 같은 분포인가")
print(f"{'d':>4s} {'평균(이론 d)':>12s} {'분산(이론 2d)':>13s} "
      f"{'왜도(이론 √(8/d))':>16s} {'KS p':>8s}")
for d in [1, 3, 10, 30]:
    Q = (rng.normal(size=(200_000, d))**2).sum(1)
    ks = stats.kstest(Q[:5_000], "chi2", args=(d,))
    print(f"{d:4d} {Q.mean():12.4f} {Q.var(ddof=1):13.4f} "
          f"{stats.skew(Q):16.4f} {ks.pvalue:8.4f}"
          f"   (이론 {d}, {2 * d}, {np.sqrt(8 / d):.4f})")

print("\n가법성: Q1~χ²(3), Q2~χ²(7) 독립 → Q1+Q2 ~ χ²(10)?")
Q1 = rng.chisquare(3, 200_000)
Q2 = rng.chisquare(7, 200_000)
print(f"  합의 평균 {(Q1 + Q2).mean():.4f} (이론 10),  "
      f"분산 {(Q1 + Q2).var(ddof=1):.4f} (이론 20)")
print(f"  KS 검정 p = "
      f"{stats.kstest((Q1 + Q2)[:5_000], 'chi2', args=(10,)).pvalue:.4f}")
print(f"  P(Q1+Q2 > 18.31) 경험 {np.mean(Q1 + Q2 > 18.31):.4f}, "
      f"이론 {stats.chi2.sf(18.31, 10):.4f}")
정의 검증: ΣZ² 와 χ²(d) 가 같은 분포인가
   d     평균(이론 d)     분산(이론 2d)    왜도(이론 √(8/d))     KS p
   1       0.9956        1.9932           2.8438   0.0451   (이론 1, 2, 2.8284)
   3       2.9999        6.0025           1.6445   0.9745   (이론 3, 6, 1.6330)
  10       9.9882       19.9640           0.9013   0.7920   (이론 10, 20, 0.8944)
  30      30.0207       59.7564           0.5061   0.6276   (이론 30, 60, 0.5164)

가법성: Q1~χ²(3), Q2~χ²(7) 독립 → Q1+Q2 ~ χ²(10)?
  합의 평균 10.0069 (이론 10),  분산 20.0144 (이론 20)
  KS 검정 p = 0.4704
  P(Q1+Q2 > 18.31) 경험 0.0502, 이론 0.0500
세 적률이 모두 이론값과 일치한다.
| \(d\) | 평균 | 분산 | 왜도 |
|---|---|---|---|
| 1 | 0.996 / 1 | 1.993 / 2 | 2.844 / 2.828 |
| 10 | 9.988 / 10 | 19.96 / 20 | 0.901 / 0.894 |
| 30 | 30.02 / 30 | 59.76 / 60 | 0.506 / 0.516 |
왜도가 \(\sqrt{8/d}\)로 줄어드는 것이 눈에 보인다. \(d=1\)에서 2.83, \(d=30\)에서 0.52다. \(d\)가 커질수록 대칭에 가까워진다.
가법성도 정확히 성립한다. 연습문제 3의 \(P(Q_1+Q_2>18.31)=0.0500\)이 경험적으로 0.0502로 재현된다.
\(d=1\)의 KS \(p\)가 0.0451로 낮다. 그러나 이는 검정을 네 번 했기 때문의 우연으로 보는 것이 자연스럽다. 적률이 모두 맞고, 나머지 셋의 \(p\)가 0.63~0.97이다. \(B\)를 바꿔 다시 돌리면 사라지는 종류의 신호다.
KS 검정에 5,000개만 쓴 이유. 20만 개를 다 쓰면 아주 미세한 난수생성기의 결함까지 잡아내 항상 기각한다. 표본이 크면 적합도 검정이 무의미해지는 것은 정규성 검정과 같은 문제다.
모의실험이 확인해 주는 것과 아닌 것.
| 확인됨 | 확인 안 됨 |
|---|---|
| 적률이 이론과 일치 | 왜 그런지(증명은 적률생성함수로) |
| 분포 모양이 일치 | 극단 꼬리(\(p<10^{-5}\) 영역) |
| 가법성 | \(Z_i\)가 독립이 아닐 때 |
마지막 줄이 중요하다. 독립성이 깨지면 \(\sum Z_i^2\)은 카이제곱이 아니다. 정의 1의 "독립"은 장식이 아니다.
연습문제 7. 연습문제 5의 정규근사는 \(d=50\)에서 66.45로 정확값 67.50과 1.6% 차이난다. 더 나은 근사 둘을 소개하고 정확도를 비교하라.
풀이
세 근사.
| 이름 | 식 |
|---|---|
| 정규근사 | \(\chi^2_{p,d}\approx d+z_p\sqrt{2d}\) |
| 피셔 | \(\chi^2_{p,d}\approx\tfrac12\left(z_p+\sqrt{2d-1}\right)^2\) |
| 윌슨-힐퍼티 | \(\chi^2_{p,d}\approx d\left(1-\dfrac{2}{9d}+z_p\sqrt{\dfrac{2}{9d}}\right)^3\) |
피셔의 발상은 \(\sqrt{2Q}\)가 \(\sqrt{2d-1}\)을 중심으로 거의 정규라는 것이고, 윌슨-힐퍼티는 \((Q/d)^{1/3}\)이 거의 정규라는 것이다. 세제곱근 변환이 왜도를 훨씬 잘 제거한다.
import numpy as np
from scipy import stats

z = stats.norm.ppf(0.95)
print("상위 5% 임계값")
print(f"{'d':>5s} {'정확':>9s} {'정규근사':>9s} {'피셔 √2Q':>10s} {'윌슨-힐퍼티':>12s}")
for d in [5, 10, 30, 50, 100, 300]:
    ex = stats.chi2.ppf(0.95, d)
    norm = d + z * np.sqrt(2 * d)
    fisher = 0.5 * (z + np.sqrt(2 * d - 1))**2
    wh = d * (1 - 2 / (9 * d) + z * np.sqrt(2 / (9 * d)))**3
    print(f"{d:5d} {ex:9.4f} {norm:9.4f} {fisher:10.4f} {wh:12.4f}")

print("\n상대오차 (%)")
print(f"{'d':>5s} {'정규근사':>9s} {'피셔':>9s} {'윌슨-힐퍼티':>12s}")
for d in [5, 10, 30, 50, 100, 300]:
    ex = stats.chi2.ppf(0.95, d)
    norm = d + z * np.sqrt(2 * d)
    fisher = 0.5 * (z + np.sqrt(2 * d - 1))**2
    wh = d * (1 - 2 / (9 * d) + z * np.sqrt(2 / (9 * d)))**3
    print(f"{d:5d} {100 * (norm - ex) / ex:9.3f} {100 * (fisher - ex) / ex:9.3f} "
          f"{100 * (wh - ex) / ex:12.3f}")
상위 5% 임계값
    d        정확      정규근사     피셔 √2Q       윌슨-힐퍼티
    5   11.0705   10.2015    10.7873      11.0439
   10   18.3070   17.3560    18.0225      18.2918
   30   43.7730   42.7410    43.4871      43.7666
   50   67.5048   66.4485    67.2189      67.5006
  100  124.3421  123.2617   124.0563     124.3396
  300  341.3951  340.2905   341.1097     341.3940

상대오차 (%)
    d      정규근사        피셔       윌슨-힐퍼티
    5    -7.850    -2.558       -0.240
   10    -5.195    -1.554       -0.083
   30    -2.358    -0.653       -0.014
   50    -1.565    -0.424       -0.006
  100    -0.869    -0.230       -0.002
  300    -0.324    -0.084       -0.000
윌슨-힐퍼티가 압도적이다. \(d=5\)에서도 오차가 0.24%이고, \(d=50\)에서 0.006%다.
| \(d\) | 정규 | 피셔 | 윌슨-힐퍼티 |
|---|---|---|---|
| 5 | \(-7.85\%\) | \(-2.56\%\) | \(-0.24\%\) |
| 50 | \(-1.57\%\) | \(-0.42\%\) | \(-0.006\%\) |
| 300 | \(-0.32\%\) | \(-0.08\%\) | \(-0.000\%\) |
세 근사 모두 과소추정한다(부호가 모두 음수). 카이제곱이 오른쪽으로 치우쳐 있어 정규로 보면 위쪽 꼬리를 짧게 잡기 때문이다.
수렴 속도가 다르다.
| 근사 | 오차의 크기 |
|---|---|
| 정규 | \(O(d^{-1/2})\) |
| 피셔 | \(O(d^{-1})\) |
| 윌슨-힐퍼티 | \(O(d^{-3/2})\) |
\(d\)가 10배 커지면 정규근사의 오차는 3.2배, 피셔는 10배, 윌슨-힐퍼티는 32배 줄어든다. 표에서 \(d=30\to300\)일 때 \(-2.358\to-0.324\)(7.3배), \(-0.653\to-0.084\)(7.8배), \(-0.014\to-0.000\)을 보면 확인된다.
왜 세제곱근인가. 윌슨-힐퍼티(1931)는 \(Q\sim\chi^2(d)\)에 대해
임을 보였다. 세제곱근이 감마족의 왜도를 거의 완전히 없애는 변환이며, 같은 아이디어가 포아송의 안스콤 변환, 분산 안정화에도 나타난다.
실무적 의의. 요즘은 scipy.stats.chi2.ppf로 정확값을 바로 얻으므로 근사가 필요 없다. 그러나
- 공식 안에 카이제곱 분위수를 넣어 미분·최적화할 때
- 표본크기 공식을 닫힌 형태로 쓸 때
- 자유도가 매우 커서 수치적으로 불안정할 때
윌슨-힐퍼티가 여전히 쓰인다.
연습문제 8. 카이제곱 분포가 감마·지수·정규·\(F\)·\(t\)와 어떻게 연결되는지 정리하고, 각각을 수치로 확인하라.
풀이
import numpy as np
from scipy import stats

x = np.linspace(0.5, 15, 5)

print("(가) χ²(d) = Gamma(shape=d/2, scale=2)")
print(f"{'x':>6s} {'chi2.pdf':>12s} {'gamma.pdf':>12s}")
for xi in x:
    print(f"{xi:6.2f} {stats.chi2.pdf(xi, 6):12.8f} "
          f"{stats.gamma.pdf(xi, 3, scale=2):12.8f}")

print("\n(나) χ²(2) = Exp(평균 2)")
for xi in x:
    print(f"{xi:6.2f} {stats.chi2.pdf(xi, 2):12.8f} "
          f"{stats.expon.pdf(xi, scale=2):12.8f}")

print("\n(다) Q~χ²(1) ⟺ Q = Z²")
print(f"  P(χ²(1) ≤ 3.8415) = {stats.chi2.cdf(3.8415, 1):.6f}")
print(f"  P(|Z| ≤ √3.8415)  = {2 * stats.norm.cdf(np.sqrt(3.8415)) - 1:.6f}")

print("\n(라) d2 → ∞ 이면 d1·F(d1, d2) → χ²(d1)")
print(f"  χ²(3) 의 0.95 분위수 = {stats.chi2.ppf(0.95, 3):.4f}")
print(f"{'d2':>8s} {'3·F(3,d2) 의 0.95 분위수':>24s}")
for d2 in [10, 50, 200, 10_000]:
    print(f"{d2:8d} {3 * stats.f.ppf(0.95, 3, d2):24.4f}")

print("\n(마) t(ν)² = F(1, ν),  ν → ∞ 이면 χ²(1)")
print(f"  t(30)² 의 0.95 분위수 = {stats.t.ppf(0.975, 30)**2:.4f},  "
      f"χ²(1) 의 0.95 = {stats.chi2.ppf(0.95, 1):.4f}")
(가) χ²(d) = Gamma(shape=d/2, scale=2)
     x     chi2.pdf    gamma.pdf
  0.50   0.01216876   0.01216876
  4.12   0.13520587   0.13520587
  7.75   0.07790984   0.07790984
 11.38   0.02739889   0.02739889
 15.00   0.00777775   0.00777775

(나) χ²(2) = Exp(평균 2)
  0.50   0.38940039   0.38940039
  4.12   0.06356787   0.06356787
  7.75   0.01037717   0.01037717
 11.38   0.00169403   0.00169403
 15.00   0.00027654   0.00027654

(다) Q~χ²(1) ⟺ Q = Z²
  P(χ²(1) ≤ 3.8415) = 0.950001
  P(|Z| ≤ √3.8415)  = 0.950001

(라) d2 → ∞ 이면 d1·F(d1, d2) → χ²(d1)
  χ²(3) 의 0.95 분위수 = 7.8147
      d2     3·F(3,d2) 의 0.95 분위수
      10                  11.1248
      50                   8.3700
     200                   7.9493
   10000                   7.8174

(마) t(ν)² = F(1, ν),  ν → ∞ 이면 χ²(1)
  t(30)² 의 0.95 분위수 = 4.1709,  χ²(1) 의 0.95 = 3.8415
관계 지도.
| 관계 | 내용 |
|---|---|
| \(\chi^2(d)=\text{Gamma}(d/2,\ \text{척도 }2)\) | 소수점 여덟 자리까지 일치 |
| \(\chi^2(2)=\text{Exp}(\text{평균 }2)\) | 연습문제 4의 답 |
| \(\chi^2(1)=Z^2\) | 정의 1에서 \(d=1\) |
| \(d_1F(d_1,d_2)\to\chi^2(d_1)\) | \(d_2\to\infty\) |
| \(t(\nu)^2=F(1,\nu)\) | \(\nu\to\infty\)면 \(\chi^2(1)\) |
감마가 모두를 포함한다. 카이제곱은 모양모수가 \(d/2\), 척도가 2인 감마의 특수한 경우일 뿐이다. 자유도가 홀수여도 성립하므로 \(\chi^2(1)\)은 \(\text{Gamma}(0.5,2)\)다.
\(F\)와의 관계가 분산분석에서 결정적이다.
분모의 \(\chi^2(d_2)/d_2\)는 \(d_2\to\infty\)에서 1로 수렴한다(큰 수의 법칙). 그러면 \(d_1F\to\chi^2(d_1)\)이다.
표에서 수렴이 보인다. \(d_2=10\)에서 11.12, \(d_2=10{,}000\)에서 7.8174로 \(\chi^2(3)\)의 7.8147에 수렴한다.
이것이 "오차 자유도가 크면 \(F\) 검정과 우도비 검정이 같아진다"의 정확한 의미다. 분산을 안다고 가정할 수 있을 만큼 표본이 크면 \(F\) 대신 \(\chi^2\)을 써도 된다.
\(d_2=10\)에서 11.12 대 7.81의 차이가 크다(42%). 작은 표본에서는 반드시 \(F\)를 써야 한다. 분모의 불확실성을 무시하면 임계값이 너무 작아져 과다 기각한다.
연습문제 9. 카이제곱 분포가 통계학에 나타나는 세 가지 경로를 들고, 각각의 자유도를 모의실험으로 확인하라.
풀이
세 경로.
| 경로 | 통계량 | 자유도 |
|---|---|---|
| 표본분산 | \((n-1)S^2/\sigma^2\) | \(n-1\) |
| 적합도(피어슨) | \(\sum(O_i-E_i)^2/E_i\) | \(k-1\) |
| 우도비(윌크스) | \(2\ln\Lambda\) | 제약의 수 |
import numpy as np
from scipy import stats

rng = np.random.default_rng(404)
B = 40_000

# (1) 표본분산: σ=2, n=8
n = 8
T1 = np.array([(n - 1) * rng.normal(0, 2, n).var(ddof=1) / 4
               for _ in range(B)])

# (2) 피어슨 적합도: 균등한 4칸, N=200
k, N = 4, 200
T2 = []
for _ in range(B // 4):
    obs = rng.multinomial(N, [1 / k] * k)
    E = N / k
    T2.append(((obs - E)**2 / E).sum())
T2 = np.array(T2)

# (3) 우도비: 알려진 분산의 정규 평균 검정 (모수 1개)
T3 = np.array([(rng.normal(0, 1, 20).mean() * np.sqrt(20))**2
               for _ in range(B)])

for lab, T, df in [("(n-1)S²/σ² (n=8)", T1, 7),
                   ("피어슨 X² (k=4)", T2, 3),
                   ("우도비 2ln Λ (모수 1개)", T3, 1)]:
    print(f"  {lab:26s} 평균 {T.mean():7.4f} (이론 {df})  "
          f"분산 {T.var(ddof=1):8.4f} (이론 {2 * df})  "
          f"KS p = {stats.kstest(T[:4_000], 'chi2', args=(df,)).pvalue:.4f}")
  (n-1)S²/σ² (n=8)           평균  7.0215 (이론 7)  분산  14.1117 (이론 14)  KS p = 0.8943
  피어슨 X² (k=4)               평균  3.0222 (이론 3)  분산   5.9384 (이론 6)  KS p = 0.0558
  우도비 2ln Λ (모수 1개)          평균  0.9801 (이론 1)  분산   1.9085 (이론 2)  KS p = 0.1084
세 경로 모두 이론 자유도를 맞힌다.
그런데 셋의 성격이 다르다.
| 경로 | 카이제곱이 되는 이유 | 정확한가 |
|---|---|---|
| 표본분산 | 코크런 정리(제곱합의 분해) | 정확 |
| 피어슨 | 다항분포의 다변량 정규근사 | 근사 |
| 우도비 | 윌크스 정리(점근) | 근사 |
첫 번째만 정확하다. 정규성이 성립하면 \((n-1)S^2/\sigma^2\)은 어떤 \(n\)에서도 정확히 \(\chi^2(n-1)\)이다.
나머지 둘은 근사이며, \(N\)이나 \(n\)이 작으면 어긋난다. 피어슨의 KS \(p\)가 0.056으로 가장 낮은 것이 이를 반영한다(칸당 기대도수 50으로 넉넉한데도 그렇다).
자유도를 세는 방식이 다르다.
| 자유도 | |
|---|---|
| 표본분산 | \(n\)개 관측에서 평균 하나를 추정 → \(n-1\) |
| 피어슨 | \(k\)개 칸에서 합이 \(N\)으로 고정 → \(k-1\) |
| 우도비 | 제약의 수(모수 공간의 차원 차이) |
공통 원리는 "제약 하나당 자유도 하나"다. 이것이 카이제곱 자유도의 보편적 해석이다.
네 번째 경로도 있다 — 이차형식. \(\mathbf X\sim N(\mathbf 0,\mathbf I)\)이고 \(\mathbf A\)가 멱등행렬(\(\mathbf A^2=\mathbf A\))이면
분산분석의 제곱합 분해가 정확히 이 형태다. \(\text{SSB}\)와 \(\text{SSE}\)는 서로 직교하는 멱등 사영이고, 그래서 독립이며 각각 카이제곱이다. \(F\) 비가 성립하는 근거가 여기 있다.
연습문제 10. 카이제곱 분포에 대해 알아야 할 것을 정리하라.
풀이
한 줄 정의. 독립 표준정규의 제곱합이다. 이것만 기억하면 나머지가 따라온다.
정의에서 곧바로 나오는 것.
| 성질 | 유도 |
|---|---|
| \(E[Q]=d\) | \(E[Z^2]=1\)이 \(d\)개 |
| \(\operatorname{Var}(Q)=2d\) | \(\operatorname{Var}(Z^2)=2\)가 \(d\)개 |
| 가법성 | 제곱의 개수를 더한다 |
| \(d\to\infty\)에서 정규 | 중심극한정리 |
| 왜도 \(\sqrt{8/d}\) | 제곱합의 비대칭이 평균됨 |
핵심 수치 넷.
| 사실 | 값 |
|---|---|
| \(\chi^2(50)\)의 상위 5% | 67.50 |
| 정규근사의 오차(\(d=50\)) | \(-1.57\%\) |
| 윌슨-힐퍼티의 오차(\(d=50\)) | \(-0.006\%\) |
| 왜도가 0.5 아래로 내려가는 \(d\) | 32 |
관계 지도.
                Gamma(d/2, 척도 2)
                       │
                    χ²(d)
                 ╱     │     ╲
       d=1 ↙       d=2 ↓       ↘ 비 χ²/χ²
      Z²        Exp(평균 2)        F(d1, d2)
                                      │ d1=1
                                      ↓
                                   t(ν)²
어디에 나타나는가.
| 통계량 | 자유도 | 정확/근사 |
|---|---|---|
| \((n-1)S^2/\sigma^2\) | \(n-1\) | 정확 |
| 분산분석의 \(\text{SSB}\), \(\text{SSE}\) | \(k-1\), \(N-k\) | 정확 |
| 피어슨 적합도 \(X^2\) | \(k-1-p\) | 근사 |
| 우도비 \(2\ln\Lambda\) | 제약의 수 | 근사(점근) |
주의할 점 넷.
- 비대칭이다. 양측 검정에서 \(2\min(\cdot,\cdot)\)을 써야 한다.
- 정규성에 의존한다. \((n-1)S^2/\sigma^2\)이 카이제곱인 것은 자료가 정규일 때뿐이다.
- 독립이 필수다. \(Z_i\)가 상관되면 카이제곱이 아니다.
- 자유도를 잘못 세면 모든 것이 틀린다. 추정한 모수마다 1씩 뺀다.
두 번째가 실무에서 가장 자주 잊힌다. \(\bar X\)는 중심극한정리로 구제되지만 \(S^2\)은 구제되지 않는다. 자세한 것은 분산에 대한 카이제곱 검정의 연습문제 6을 보라.
한 문장. 카이제곱은 "제곱합의 분포"이며, 통계학에서 제곱합이 나오는 곳마다 따라 나온다.
정리하며
카이제곱분포는 제곱합의 분포이며, 이 장의 여러 검정이 여기 기댄다.
- 두 가지 구성이 같은 분포를 준다. \(\chi^2(d)\) 에서 직접 표집한 것과 표준정규 \(d\) 개를 제곱해 더한 것이 일치하며, 모의실험으로 확인할 수 있다.
- 평균 \(d\), 분산 \(2d\) 이고 오른쪽으로 치우쳐 있다. 자유도가 커지면 정규에 가까워지지만 수렴이 느리다(4장).
- 어디에 나오는가. 표본분산의 분포, 분산 검정, 적합도·독립성 검정, 그리고 \(F\) 분포의 분자와 분모가 모두 카이제곱이다.
- \(F=\frac{\chi^2_{d_1}/d_1}{\chi^2_{d_2}/d_2}\) 라는 관계가 분산분석의 \(F\) 통계량이 왜 그 분포를 따르는지 설명해 준다. 0장의 코크런 정리가 제곱합을 독립인 카이제곱들로 쪼개 주는 것이 근거다.
- 정규성이 출발점이다. 이 분포가 나오는 이유가 정규확률변수의 제곱이므로, 정규성이 깨지면 연쇄적으로 모든 것이 흔들린다.
다음 절 등분산에 대한 F-검정으로 넘어간다.