10장: 분산분석
개요
들어가는 이야기 — 한 번에 묻고, 그 다음에 이름을 부른다
두 집단을 비교할 때 검정할 가설은 하나다 — \(H_0 \colon \mu_1 = \mu_2\). 비교할 쌍이 하나뿐이니 이표본 \(t\)-검정을 한 번 수행하면 유의수준 \(\alpha = 0.05\) 가 그대로 지켜진다.
집단이 셋이 되어도 가설은 여전히 하나다 — \(H_0 \colon \mu_1 = \mu_2 = \mu_3\). 그런데 쌍별 비교는 셋이다. 쌍마다 \(t\)-검정을 수행해 하나라도 유의하면 \(H_0\) 을 기각하는 절차는 참인 귀무가설(null hypothesis)을 기각할 기회를 세 번 주는 것과 같고, 비교의 수는 \(m = k(k-1)/2\) 로 늘어난다. 다섯 집단이면 \(m = 10\) 이고, 몬테카를로(Monte Carlo) 모의실험으로 추정한 가족단위 오류율(FWER)이 \(0.2737\) 이다 — 명목수준 \(0.05\) 를 약속한 자리에서 실제로는 네 번에 한 번이 거짓 양성이다. 여덟 집단이면 \(0.4909\) 로 절반에 가깝다.
그래서 쌍별로 나누어 묻는 대신 가설 하나를 한 번에 검정한다. 「\(k\) 개의 모평균이 모두 같은가」를 단일 검정통계량(test statistic)으로 요약한 것이 \(F\) 이고, 이 옴니버스 \(F\)-검정은 집단이 여덟이 되어도 제1종 오류율을 명목 \(0.05\) 에 유지한다.
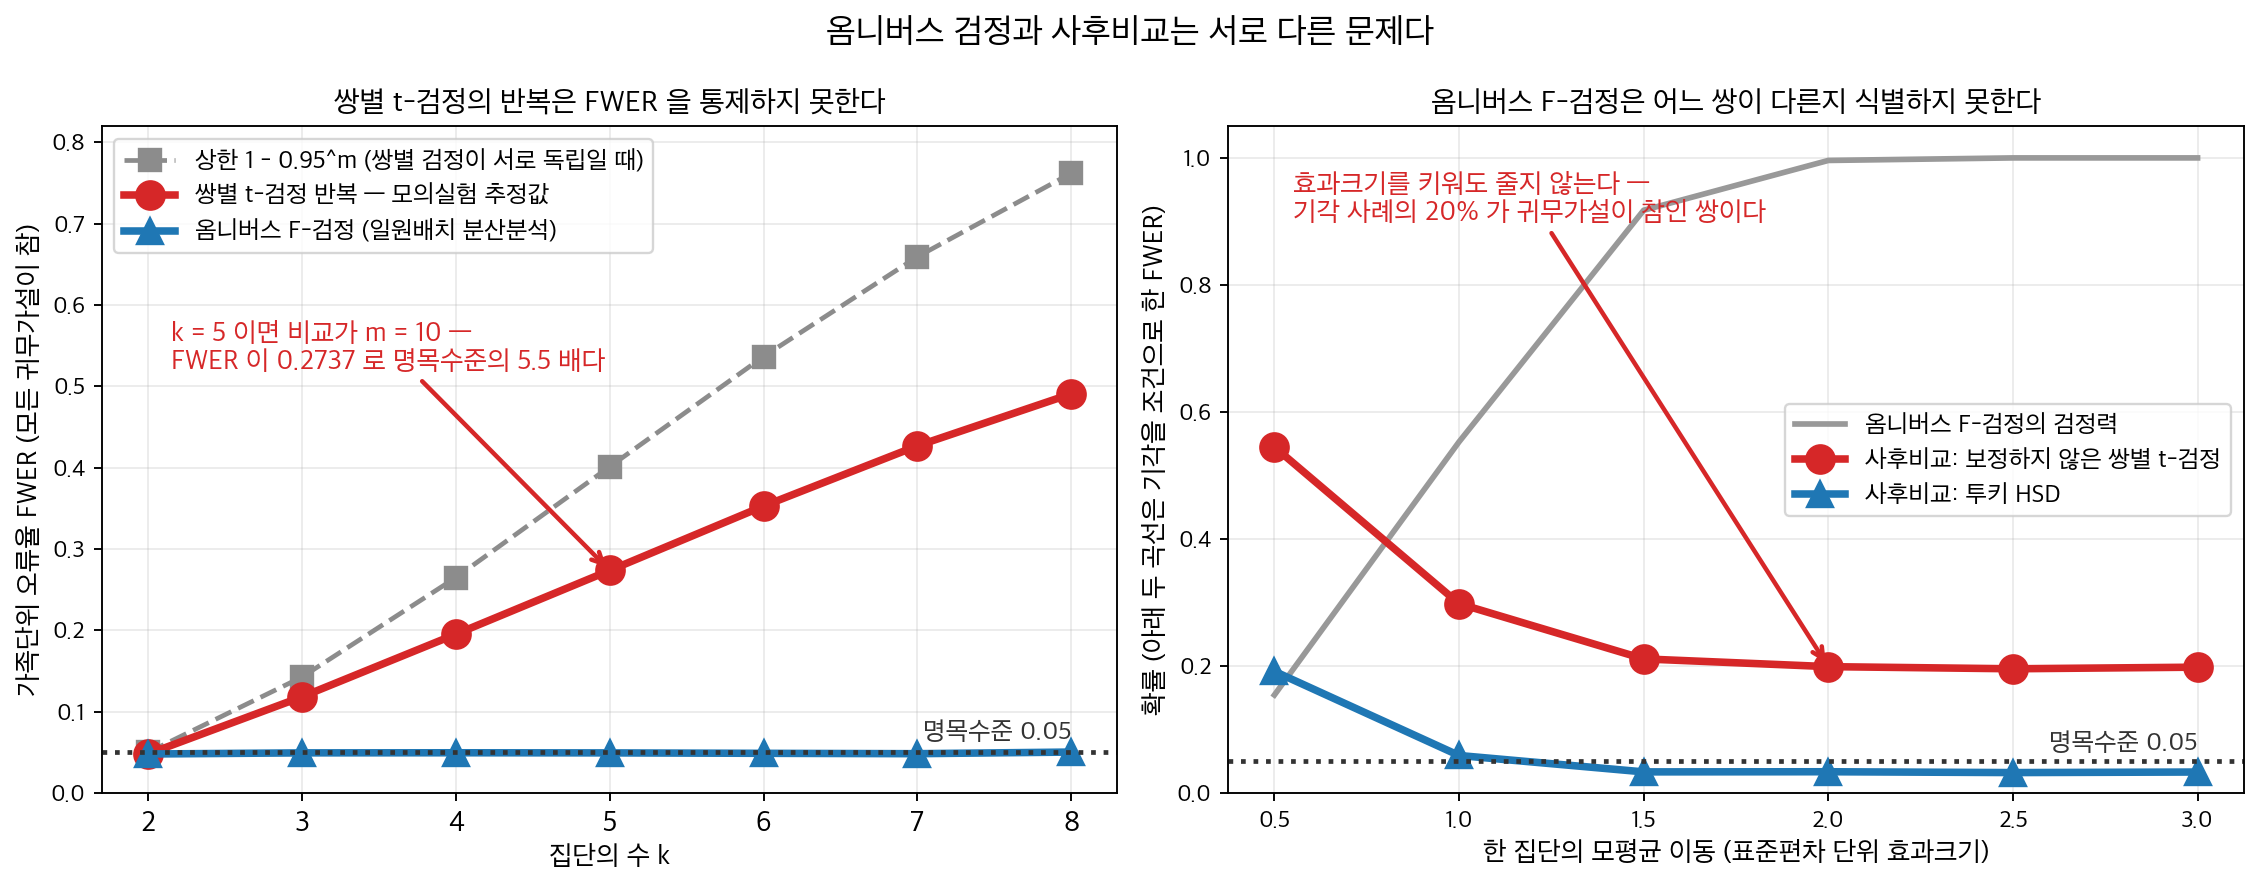
집단마다 \(n = 10\), 반복 \(40{,}000\) 회의 몬테카를로 모의실험이다. 왼쪽. 쌍별 \(t\)-검정을 반복하면 가족단위 오류율이 \(k = 5\) 에서 \(0.2737\), \(k = 8\) 에서 \(0.4909\) 까지 오른다. 옴니버스 \(F\)-검정은 \(k\) 에 관계없이 명목수준 \(0.05\) 를 지킨다. 점선은 이 장이 쓰는 상한 \(1 - 0.95^{m}\) 으로 \(k = 5\) 에서 \(0.4013\) 인데, 이 값은 \(m\) 개의 쌍별 검정이 서로 독립일 때의 상한이다 — 쌍별 비교들은 같은 집단과 합동분산(pooled variance) 추정값(오차평균제곱)을 공유해 양의 상관을 가지므로 실제 FWER 은 그보다 낮다. 낮아도 명목수준의 다섯 배가 넘는다. 오른쪽. 다섯 집단 가운데 하나만 모평균이 다른 자료다. 효과크기(effect size)가 \(2\) 표준편차일 때 \(F\)-검정의 검정력은 \(0.9960\) 이다. 그러나 기각한 뒤 보정하지 않은 쌍별 \(t\)-검정으로 사후비교(post hoc comparison)를 하면 귀무가설이 참인 쌍을 \(0.1990\) 의 비율로 유의하다고 판정하고, 효과크기를 키워도 이 비율은 줄지 않는다. 같은 조건에서 투키 HSD 는 \(0.0335\) 다.
그런데 \(F\)-검정이 기각해도 어느 쌍이 다른지는 아직 밝혀지지 않았다. 옴니버스 \(F\)-검정의 대립가설(alternative hypothesis)은 「적어도 한 쌍의 모평균이 다르다」이기 때문이다. 여기서 보정하지 않은 쌍별 \(t\)-검정을 그대로 꺼내면 조금 전의 다중비교(multiple comparisons) 문제가 그대로 돌아온다 — 다섯 집단 가운데 하나만 모평균이 다른 자료에서 귀무가설이 참인 쌍을 다섯 번에 한 번꼴로 유의하다고 판정한다. 효과크기를 키워도 그 비율은 줄지 않는다. 효과크기와 함께 커지는 것은 \(F\)-검정의 검정력이지 쌍별 비교의 정확도가 아니기 때문이다.
이 장은 그 두 물음을 차례로 푼다 — 모평균이 모두 같은가, 그리고 어느 쌍이 다른가. 앞의 것을 묻는 옴니버스 검정이 10.1절 일원배치 분산분석과 10.2절 이원배치 분산분석의 \(F\)-검정이고, 뒤의 것을 가리는 사후비교가 10.3절 투키 정직유의차를 비롯한 절차들이다. 그래서 사후비교는 이 장의 부록이 아니라 결론이다.
그리고 두 절차가 모두 기대고 있는 가정이 있다. 집단 내 분산이 모두 같다는 등분산성(homoscedasticity), 오차의 정규성(normality), 관측의 독립성(independence)이다. 첫째 가정은 10.4절 웰치의 일원배치 분산분석이 덜어 주고, 셋을 어떻게 확인하는지는 10.5~10.6절이 다룬다. 어느 것도 \(F\)-검정이 스스로 검정해 주지 않는다. 처리 배정이 무작위였는지를 묻지 않아 치른 대가는 10.1절 F-검정 절차의 상자가 \(1930\) 년 스코틀랜드로 데려간다.
분산분석(ANOVA)은 가설검정을 확장하여 셋 이상의 집단 평균을 한꺼번에 비교함으로써, 쌍별 t-검정을 여러 번 수행할 때 부풀려지는 제1종 오류율을 피한다. 이 장에서는 일원배치와 이원배치 분산분석(two-way analysis of variance) 모형, 다양한 사후비교 방법, 이분산 자료를 위한 웰치 분산분석, 가정 확인과 진단 도구, 그리고 A/B 검정과 금융 분석을 포함한 실무 응용을 다룬다.
1. 장의 구성
10.1 일원배치 분산분석
여러 독립 집단의 평균을 비교하는 분산분석의 기본 틀:
- 모형과 가정 --- 일원배치 분산분석(one-way analysis of variance)을 전체 변동을 집단 간 성분과 집단 내 성분으로 분해하는 방법으로 소개하고, F-통계량을 이 두 분산의 비로 정의하며, 정규성·독립성·등분산성 가정을 제시한다.
- F-검정 절차 --- 일원배치 분산분석을 수행하는 단계별 절차를 제공한다: 가설 세우기, 집단 평균 계산, 전체·집단 간·집단 내 제곱합(sum of squares) 계산, 분산분석표 작성, F-통계량과 p 값 해석.
- 분산분석 F-통계량 모의실험 --- 설정 아홉 가지에서 \(F\) 검정을 반복해, 집단 평균의 분리·집단 내 분산·표본크기가 기각률을 어떻게 가르는지 본다. 평균이 모두 같을 때 기각률이 \(5\%\) 근처라는 확인이 설계가 일원배치일 때의 이야기라는 것도 여기 있다.
10.2 이원배치 분산분석
두 요인의 효과를 동시에 살피도록 분산분석의 틀을 확장한다.
- 주효과와 블록화 --- 두 요인이 연속형 결과에 미치는 개별 효과를 평가하는 이원배치 분산분석을 소개하고, 전체 분산을 요인 A, 요인 B, 잔차 오차에 의한 성분으로 분해하며, 성가신 변동을 통제하기 위한 블록화(blocking)의 쓰임을 설명한다.
- 교호작용 효과 --- 교호작용(interaction) 효과를 두 요인의 개별 주효과를 넘어서는 결합 영향으로 정의하고, 교호작용 제곱합과 F-검정의 공식을 제시하며, 교호작용 그림을 이용한 해석을 보인다.
- 교호작용 효과 그림 --- ToothGrowth 자료로 그림을 그리고 읽는다. 선이 평행하면 주효과를 그대로 읽어도 되는 까닭, 그리고 평행한지 아닌지가 측정 척도에 달려 있다는 것까지.
10.3 사후비교
분산분석이 유의하게 나온 뒤 구체적으로 어느 집단 쌍이 다른지 찾는 방법은 이렇다.
건너뛸 수 없는 절이다 — 읽는 순서
10.1~10.2 가 답하는 것은 「적어도 한 집단이 다르다」까지다. 어느 집단인지는 이 절이 답한다. 그래서 사후비교는 이 장의 부록이 아니라 결론이고, 10.1·10.2·10.7 이 모두 여기를 가리킨다.
전제 둘. 투키 HSD 와 본페로니다. 둘 다 9.6절 가족단위 오류율과 본페로니와 홀름 보정 위에 서 있으므로, 「\(m\) 개를 검정하면 적어도 하나가 틀릴 확률이 얼마나 빨리 자라는가」를 먼저 보고 오는 편이 낫다.
뒤로 미뤄도 되는 것 넷. 셰페(가능한 모든 선형대비(linear contrast)에 대해 통제한다 — 자료를 보고 비교를 골라도 되는 대신 보수적이다), 더닛(비교들 사이의 상관을 반영하려 다변량 \(t\) 를 쓴다), 게임스–하월(쌍마다 웰치–새터스웨이트 자유도를 다시 센다), 그리고 방법의 비교와 검정력(비중심 \(t\) 로 「놓친 쌍이 방법이 보수적이어서인지 표본이 작아서인지」를 가른다). 넷 다 이 장 밖에서 아무도 가리키지 않으니, 그 상황을 실제로 만나면 돌아오면 된다.
- 투키 HSD --- 모든 쌍별 비교에 가장 널리 쓰이는 사후검정(post hoc test)으로, 스튜던트화 범위(studentized range) 분포를 이용해 가족단위 오류율을 통제한다.
- 투키 HSD (이원배치) --- 요인이 둘일 때 사후검정을 어디에 걸 것인가. 주효과에 걸기와 칸에 걸기를 가르고, 교호작용이 유의하면 주효과부터 보지 않는다는 순서를 세운다.
- 본페로니와 셰페 방법 --- 본페로니는 비교 횟수로 유의수준을 조정하여(계획된 비교가 적을 때 적합) 통제하고, 셰페는 가능한 모든 선형 대비에 대해 FWER을 통제한다(더 보수적이지만 어떤 비교 집합에도 적용할 수 있다).
- 더닛 검정 (대조군과 비교) --- k − 1개의 처치군 각각을 하나의 대조군과 비교하는 특화된 검정으로, 비교들 사이의 상관을 반영하기 위해 다변량 t-분포를 쓴다.
- 게임스–하월 (분산이 다를 때) --- 등분산이나 동일 표본크기를 가정하지 않고 각 쌍별 비교에 웰치–새터스웨이트 자유도를 쓰는 사후 절차이다.
- 사후비교 방법의 비교와 검정력 --- 네 방법의 임계값을 표준오차 단위로 환산해 집단 수에 따라 그리고, 같은 자료에서 어느 쌍이 어느 방법에 걸리는지 본다. 그리고 놓친 쌍이 방법이 보수적이었기 때문인지 표본이 작았기 때문인지를 비중심 \(t\) 분포로 가른다.
10.4 웰치 분산분석
등분산 가정이 어긋날 때 고전적 분산분석을 대신하는 로버스트한 방법:
- 웰치 일원배치 분산분석 --- 등분산성을 가정하지 않고 가중평균과 자유도를 수정한 F-통계량으로 집단 평균의 동일성을 검정한다.
- 웰치 이원배치 분산분석 --- 웰치 접근을 두 요인 설계로 확장하여, 로버스트(HC3) 표준오차로 이분산 아래에서 주효과와 교호작용을 분석한다.
- 웰치 분산분석의 제1종 오류와 검정력 모의실험 --- 이분산이고 집단 크기가 불균형한 조건에서 웰치가 명목 수준을 지키는지, 그리고 그때의 검정력을 몬테카를로로 잰다.
- 이원배치 웰치 분산분석 (로버스트 HC3) --- 전용 구현 없이 완전요인 OLS 에 HC3 와 왈드 \(F\) 를 붙여 같은 일을 하는 길. 「로버스트」라고 적힌 칸을 선택하기 전에 얼마나, 어디서부터 믿을 만한지를 수로 본다.
10.5 가정 점검
분산분석의 바탕이 되는 네 가지 가정과 각각을 확인하는 방법을 체계적으로 다룬다.
- 가정 개관 --- 네 가지 핵심 가정(정규성, 독립성, 등분산성, 선형성)을 요약하고 각각이 F-검정의 타당성에 왜 중요한지 설명한다.
- 잔차의 정규성 확인 --- 잔차가 근사적으로 정규분포를 따르는지 평가하기 위한 Q-Q 그림과 샤피로–윌크 검정을 설명하고, 표본이 클 때의 로버스트성에 관한 지침을 준다.
- 관측의 독립성 확인 --- 독립성은 무엇보다 올바른 연구 설계(무작위 표집과 무작위 배정)로 확보된다는 점을 강조하고, 계열상관을 탐지하는 더빈–왓슨 검정을 설명한다.
- 등분산성 확인 --- 레빈 검정과 잔차 대 적합값 그림으로 집단 간 분산이 다른지 본다. 다만 그 결과로 검정을 고르지는 않는다 — 분산이 같다고 믿을 근거가 설계에 없으면 처음부터 웰치다. 이분산이 고쳐야 할 것이 아니라 찾던 것인 자리도 같은 쪽에 있다.
- 선형성 확인 --- 분산분석에 연속형 공변량이 들어갈 때 선형성 가정이 왜 중요한지 논의하고, 산점도(scatter plot)와 잔차 그림으로 비선형 패턴을 탐지한다.
10.6 진단
모형의 적절성을 평가하고 문제가 되는 관측값을 찾아내는 도구:
- 잔차 분석 (분산분석) --- 잔차 대 적합값 그림, 표준화 잔차, 잔차 히스토그램을 살펴 이분산성(heteroscedasticity)·비정규성·모형 오설정 같은 가정 위반을 시사하는 패턴을 탐지한다.
- 영향점 --- 쿡의 거리, 지렛값(leverage), DFFITS로 분산분석 결과에 지나치게 큰 영향을 주는 관측값을 찾아내고, 임계값 지침과 시각화를 제시한다.
- 가정 위반의 처리 --- 위반에 대응하는 체계적인 판단 틀을 제공한다. 자료 변환(로그, 제곱근, 박스–콕스), 비모수(nonparametric) 대안(크러스컬–월리스), 로버스트 방법(웰치 분산분석)을 포함한다.
- 분산분석 진단 --- 이 절의 도구를 한 흐름으로 꿴다. 진단은 자료가 아니라 잔차에 한다는 것에서 시작해 네 가정을 차례로 보고, 네 가정을 그림에서 어떻게 읽는지로 닫는다.
10.7 실무 응용
분산분석의 전체 흐름을 보여주는 실제 응용:
- A/B 검정과 실험 설계 --- 실험을 돌리기 전에 못 박아야 하는 것 셋 — 무엇을 비교할지(무작위화(randomization)·통제·반복), 몇을 모을지(표본크기), 어떻게 판정할지(일원배치 F-검정과 사후비교). 그리고 미뤄 두었을 때 치르는 값을 수로 잰다 — 엿보기로 \(0.045\) 가 \(0.321\) 이 되고 보정을 빼면 가족단위 오류율이 \(0.40\) 에 이른다.
- 분산분석의 금융 응용 --- 금융이 더하는 것은 새 검정이 아니라 두 함정이다. 위험한 것은 분포가 아니라 상관임을 수로 보이고(두꺼운 꼬리 \(0.045\) 는 무해, 공통 시장요인은 \(0.001\) 로 검정력을 앗아간다), 평균이 국면 사이의 상쇄를 지우는 것을 이원배치로 쪼갠다. 포트폴리오·섹터·팩터 적용은 그 위에 얹는다.
- 사례 연구 --- 붓꽃·근무형태·매장만족도 세 자료를 Python 으로 끝까지 따라간다. 셋 다 가정 검정을 통과하는데, 그 통과가 무엇을 보증하고 무엇을 보증하지 않는지가 주제다 — 레빈이 실제 위반을 다섯 번에 네 번 통과시키는 동안 고전 \(F\) 의 오류율은 명목의 두 배가 된다.
연습문제 — 쪽마다 끝에 있다
일원배치 분산분석 계산, 가정 확인, 사후검정 선택, 교호작용 해석을 포함한 이원배치 분산분석, 실제 자료에 대한 전체 분석 흐름을 다루는 연습문제.
2. 선행 지식
이 장은 다음 내용 위에 세워진다.
- 5장 (추정량과 표집분포(sampling distribution)) --- 분산분석 F-검정이 쓰는 F-분포.
- 9장 (가설검정) --- 유의수준, p 값, 제1종·제2종 오류(type II error), 검정력을 포함한 일반적인 가설검정의 틀.
- 8장 (신뢰구간) --- 평균에 대한 신뢰구간. 사후비교에서 쌍별 차이의 동시 신뢰구간을 만드는 데 쓰인다.
3. 핵심 요점
- 분산분석은 전체 변동을 집단 간 성분과 집단 내 성분으로 분해하여 집단 평균을 비교한다. F-통계량이 크면 집단 평균의 차이가 우연으로 기대되는 정도보다 크다는 뜻이다.
- 분산분석이 유의하다는 것은 적어도 한 집단의 평균이 다르다는 뜻이지 어느 집단이 다른지를 알려주지는 않는다. 구체적인 쌍별 차이를 짚어내려면 사후검정(투키, 본페로니, 셰페, 더닛, 게임스–하월)이 필요하다.
- 이원배치 분산분석은 두 요인의 효과와 그 교호작용을 동시에 평가한다. 교호작용 효과가 있다는 것은 한 요인의 영향이 다른 요인의 수준에 따라 달라진다는 뜻이다.
- 분산분석의 네 가정(정규성, 독립성, 등분산성, 선형성)은 체계적으로 확인해야 한다. 다만 어느 검정을 쓸지는 그 확인의 결과로 고르지 않는다 — 분산이 같다고 믿을 근거가 설계에 없으면 처음부터 웰치 분산분석을 쓴다. 「레빈으로 확인하고 갈라서는」 두 단계 절차는 두 방법 어느 쪽보다 나쁠 수 있다(사전검정의 역설).
- 잔차 그림, 쿡의 거리, 형식적 검정(샤피로–윌크, 레빈) 같은 진단 도구는 적합한 모형이 무엇을 말하고 있는지 읽기 위한 것이다. 불일치를 찾으면 자료를 다시 보고 설계를 되짚을 일이지, 그 수를 문지기로 삼아 절차를 갈아타는 자리가 아니다.
- 분산분석은 처치가 여럿인 A/B 검정, 금융 포트폴리오 수익 비교 등 셋 이상의 집단을 비교하는 모든 실험 설계에 폭넓게 응용된다.