정밀도, 재현율, F1 점수
정밀도: 양성예측도
정밀도는 양성 예측의 신뢰성을 잰다. 양성으로 예측한 사례 가운데 실제로 양성인 비율은 얼마인가?
정밀도는 양성예측도(PPV)다. "모형이 연체라고 하면 얼마나 믿을 수 있는가?"라는 질문에 답한다.
해석
- 정밀도가 높으면 위양성이 적다.
- 정밀도가 낮으면 허위경보가 많다(실제로는 음성인데 양성으로 예측).
- 정밀도 = 1이면 위양성이 없고, 정밀도 = 0이면 양성 예측이 모두 틀렸다는 뜻이다.
재현율: 민감도와 참양성률
재현율(민감도 또는 참양성률이라고도 한다)은 모형이 양성 사례를 얼마나 잘 찾아내는지 잰다.
재현율은 "실제 연체 가운데 몇 퍼센트를 잡아냈는가?"라는 질문에 답한다.
해석
- 재현율이 높으면 위음성이 적다. 양성 사례를 대부분 잡아낸다.
- 재현율이 낮으면 양성 사례를 많이 놓친다.
- 재현율 = 1이면 위음성이 없고, 재현율 = 0이면 양성 사례를 전부 놓쳤다는 뜻이다.
정밀도-재현율 절충
정밀도와 재현율 사이에는 본질적인 절충이 있다. 분류 문턱 \(\tau\)를 낮추면,
- 더 많은 사례가 양성으로 예측된다.
- 재현율(TP)이 올라가지만 FP도 함께 늘어난다.
- 정밀도는 대체로 내려간다.
반대로 문턱을 높이면,
- 더 적은 사례가 양성으로 예측된다.
- 재현율은 내려가고 정밀도는 대체로 올라간다.
정밀도와 재현율 중 무엇을 우선할지는 응용에 달려 있다.
| 분야 | 우선순위 | 이유 |
|---|---|---|
| 이상거래 탐지 | 높은 재현율 | 이상거래를 놓치면(FN) 손실이 크다. 허위경보(FP)는 어느 정도 감수 가능 |
| 대출 승인 | 높은 정밀도 | 허위경보(우량 대출 거절)는 고객을 잃게 한다. FN은 어느 정도 감수 가능 |
| 의학적 진단 | 높은 재현율 | 질병을 놓치면(FN) 생명이 위험하다. 허위경보(FP)는 추가 검사로 이어질 뿐 |
대출 연체 자료
로지스틱 회귀 모형의 결과에서,
                      Predicted
                   Default  Paid Off
Actual Default       14,336   8,335
Actual Paid Off       8,148  14,523
-
정밀도 \(= 14{,}336 / (14{,}336 + 8{,}148) \approx 0.6376\)
- 연체로 예측한 것 중 약 63.76%가 맞고, 36.24%는 허위경보다.
-
재현율 \(= 14{,}336 / (14{,}336 + 8{,}335) \approx 0.6323\)
- 실제 연체의 약 63.23%를 잡아내고 36.77%를 놓친다.
F1 점수: 조화평균
정밀도와 재현율이 둘 다 중요할 때는 F1 점수가 하나의 요약 지표를 제공한다.
F1 점수는 정밀도와 재현율의 조화평균이며 0에서 1 사이의 값을 갖는다. 다음과 같은 경우에 선호된다.
- 범주가 불균형할 때
- 위양성과 위음성이 모두 비용이 클 때
- 두 관심사를 균형 있게 반영하는 단일 지표가 필요할 때
위 예에서는 \(F_1 = 2 \cdot \frac{0.6376 \cdot 0.6323}{0.6376 + 0.6323} \approx 0.6349\)이다.
다범주 문제의 가중 지표
다범주 분류에서는 정밀도, 재현율, F1을 범주별로 계산한 뒤 평균한다.
- 거시평균: 범주별 값을 단순 산술평균한다(모든 범주를 동등하게 취급).
- 가중평균: 범주별 관측치 수로 가중평균한다(범주 불균형을 반영).
- 미시평균: 모든 범주의 TP, FP, FN을 합산한 뒤 계산한다.
정밀도-재현율 곡선
정밀도-재현율 곡선은 분류 문턱을 변화시키며 재현율에 대한 정밀도를 그린다. 특히 불균형 자료에서 정확도 하나보다 모형의 성능을 훨씬 세밀하게 보여준다.
주요 성질은 다음과 같다.
- 오른쪽 위로 갈수록(정밀도와 재현율이 모두 높을수록) 성능이 좋다.
- 문턱이 아주 높으면 재현율이 0에 가까워진다. 이 왼쪽 끝에서 정밀도는 표본이 극히 적어 매우 불안정하며, 관례상 1로 그리는 구현이 많다.
- 문턱이 0이면 모두를 양성으로 예측하므로 재현율은 1이 되고, 정밀도는 양성의 유병률과 같아진다. 즉 곡선의 오른쪽 끝은 \((1, 0)\)이 아니라 \((1, \pi)\)이며 \(\pi\)는 양성 비율이다.
- 평균정밀도(AP): 정밀도-재현율 곡선 아래의 면적으로 0에서 1 사이의 값을 갖는다.
한 범주가 드물 때는 정밀도-재현율 곡선이 ROC 곡선보다 더 많은 통찰을 주는 경우가 많다. 양성 범주 영역에서의 행동에 집중하기 때문이다.
무작위 분류기의 기준선이 다르다
ROC 곡선에서 무작위 분류기의 기준선은 언제나 대각선이고 AUC는 0.5다. 그러나 PR 곡선에서 무작위 분류기의 기준선은 높이 \(\pi\)인 수평선이고 AP는 \(\pi\)다. 따라서 양성이 1%인 자료에서 AP \(= 0.10\)은 무작위보다 10배 나은 성능이지만, 같은 자료의 AUC \(= 0.10\)은 무작위보다 훨씬 나쁘다는 뜻이다. PR 지표는 유병률 없이는 해석할 수 없다.
곡선 위를 지나는 \(F_1\) 등고선
앞의 세 가지 — 절충, 유병률 기준선, 조화평균 — 을 한 그림에 모아 보면 서로 어떻게 맞물리는지 보인다. 연체율 \(19.1\%\)인 대출자료 1,000건의 결과다.
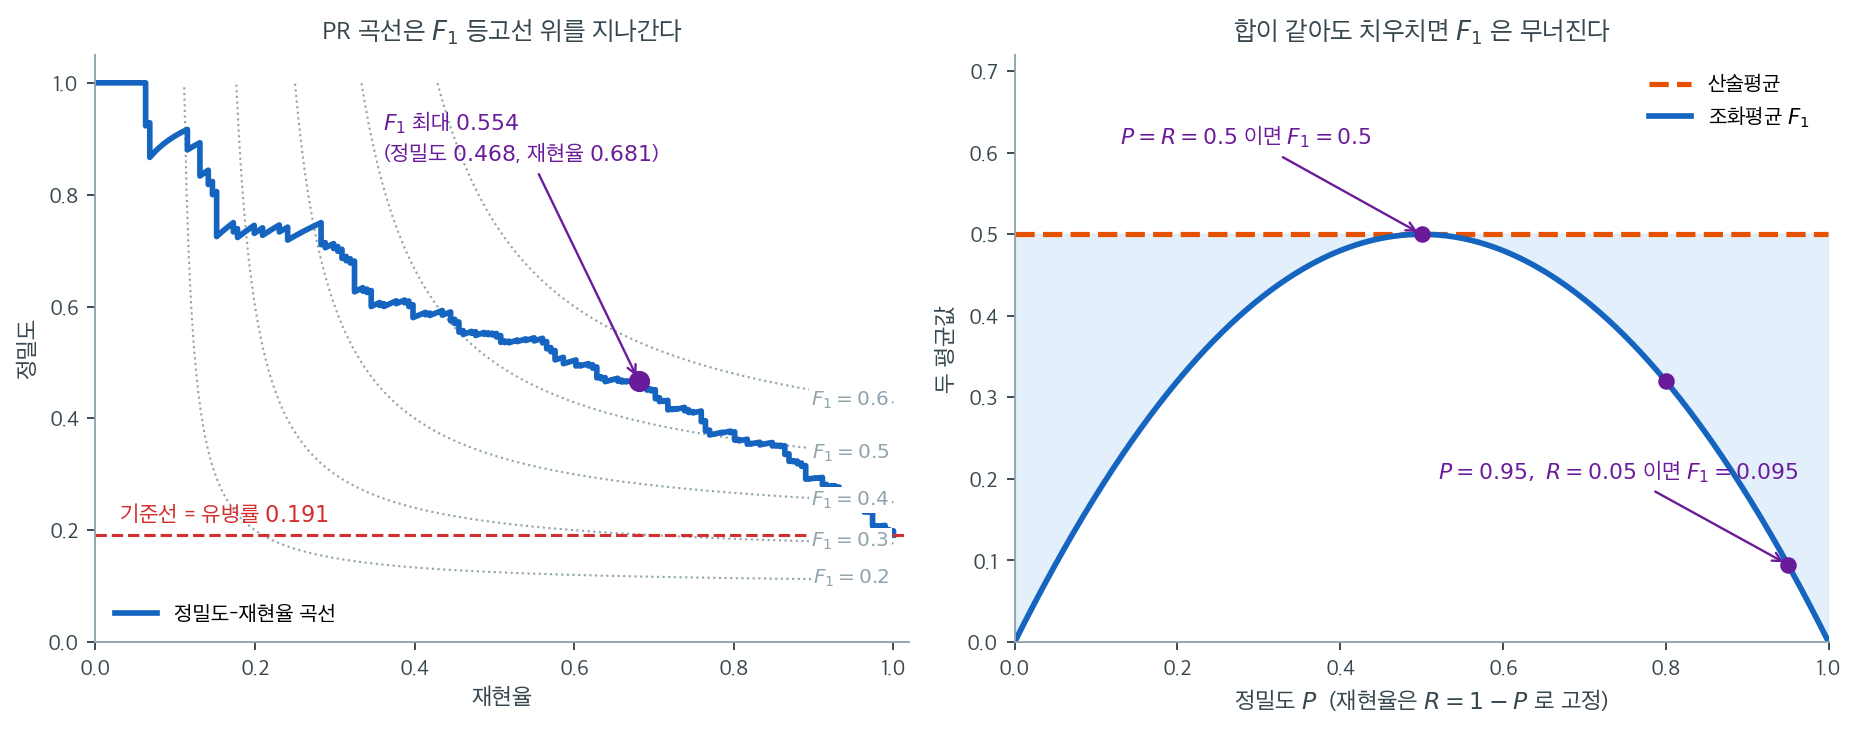
왼쪽에서 파란 곡선이 문턱을 훑으며 지나가는 자취이고, 회색 점선들이 \(F_1\)이 일정한 등고선이다. \(F_1\)을 고른다는 것은 이 곡선이 닿을 수 있는 가장 바깥쪽 등고선을 찾는 일이며, 여기서는 \(F_1 = 0.554\)에서 정밀도 \(0.468\), 재현율 \(0.681\)인 점이다. 등고선이 쌍곡선 모양으로 휘어 있다는 점에 주목하라. 정밀도와 재현율을 바꿔치기해도 같은 등고선 위에 있으므로 \(F_1\)은 둘을 대칭적으로 취급하지만, 어느 한쪽이 0에 가까워지면 등고선이 무한히 멀어져 도달할 수 없게 된다.
빨간 파선이 유병률 \(0.191\)이다. 곡선의 오른쪽 끝은 \((1, 0)\)이 아니라 \((1, 0.191)\)로 착지한다. 모두를 연체라고 예측하면 재현율은 1이지만 정밀도는 유병률 그대로이기 때문이다. ROC 곡선의 대각선과 달리 이 기준선의 높이는 자료마다 다르다. 같은 \(F_1 = 0.554\)라도 유병률 \(0.19\)인 자료에서는 기준선의 세 배 가까운 성과이고, 유병률 \(0.5\)인 자료에서는 기준선에 겨우 붙은 수준이다.
오른쪽은 조화평균이 왜 조화평균인지를 보여준다. 정밀도와 재현율의 합을 1로 고정해 놓고 둘의 배분만 바꿨는데, 산술평균은 언제나 \(0.5\)로 납작한 반면 \(F_1\)은 \(P = R = 0.5\)에서 \(0.5\)로 최대가 되었다가 양 끝으로 갈수록 무너진다. \(P = 0.95\), \(R = 0.05\)이면 산술평균은 여전히 \(0.5\)지만 \(F_1\)은 \(0.095\)다. 열 건 중 한 건만 잡아내면서 그 한 건을 아주 정확히 맞히는 모형은 쓸모가 없는데, \(F_1\)은 그 사실을 반영하고 산술평균은 반영하지 못한다. 이것이 두 지표를 평균할 때 조화평균을 쓰는 이유다.
연습문제
연습문제 1. 조화평균 정의로부터 \(F_1 = \dfrac{2\,TP}{2\,TP + FP + FN}\)를 유도하라.
풀이
\(P = \dfrac{TP}{TP+FP}\), \(R = \dfrac{TP}{TP+FN}\)을 대입한다.
분자와 분모에 \((TP+FP)(TP+FN)\)을 곱하면
를 얻는다.
이 형태는 두 가지를 곧바로 보여준다. 첫째, \(F_1\)은 TN을 전혀 쓰지 않는다. 음성 범주를 아무리 잘 맞혀도 \(F_1\)은 달라지지 않으며, 이것이 불균형 자료에서 정확도보다 나은 이유이자 동시에 한계다. 둘째, 위양성과 위음성을 동등한 무게로 더한다. 두 오류의 비용이 다르면 \(F_\beta\)(연습문제 4)를 써야 한다. \(\square\)
연습문제 2. 정밀도와 재현율의 요약에 산술평균이 아니라 조화평균을 쓰는 이유를 설명하라. \(P = 0.99\), \(R = 0.01\)인 경우로 예를 들라.
풀이
\(P = 0.99\), \(R = 0.01\)일 때,
이다.
이 분류기는 사실상 쓸모가 없다. 양성 사례의 1%만 잡아내기 때문이다. 산술평균 0.5는 "그럭저럭 쓸 만하다"는 인상을 주지만, \(F_1 = 0.02\)는 실상을 정확히 말해 준다.
일반 원리: 조화평균은 작은 쪽에 지배된다. 실제로 \(\min(P,R) \le F_1 \le 2\min(P,R)\)이 항상 성립하므로, 한쪽이 0에 가까우면 \(F_1\)도 0에 가깝다. 산술평균은 반대로 큰 쪽이 작은 쪽을 가려 준다.
이런 성질이 바람직한 이유는, 정밀도나 재현율 어느 한쪽만 극단적으로 높이는 것이 아주 쉽기 때문이다. 모두를 양성으로 예측하면 재현율이 1이 되고, 가장 확신하는 한 건만 양성으로 예측하면 정밀도가 1이 되기 쉽다. 이런 퇴화된 전략에 벌칙을 주는 요약 지표가 필요하다. \(\square\)
연습문제 3. 문턱을 낮추면 재현율은 결코 감소하지 않지만 정밀도는 단조가 아니다. 다음 자료로 이를 확인하라.
| \(\hat p\) | 0.9 | 0.8 | 0.7 | 0.4 | 0.3 | 0.2 |
|---|---|---|---|---|---|---|
| \(y\) | 1 | 0 | 1 | 1 | 0 | 1 |
풀이
각 문턱에서 \(\hat p \ge \tau\)를 양성으로 예측한다.
| \(\tau\) | TP | FP | 정밀도 | 재현율 |
|---|---|---|---|---|
| 0.9 | 1 | 0 | \(1.000\) | \(0.25\) |
| 0.8 | 1 | 1 | \(0.500\) | \(0.25\) |
| 0.7 | 2 | 1 | \(0.667\) | \(0.50\) |
| 0.4 | 3 | 1 | \(0.750\) | \(0.75\) |
| 0.3 | 3 | 2 | \(0.600\) | \(0.75\) |
| 0.2 | 4 | 2 | \(0.667\) | \(1.00\) |
재현율은 \(0.25 \to 0.25 \to 0.50 \to 0.75 \to 0.75 \to 1.00\)으로 결코 줄지 않는다. 문턱을 낮추면 TP는 늘기만 하고 \(TP+FN\)은 고정이기 때문이다.
정밀도는 \(1.000 \to 0.500 \to 0.667 \to 0.750 \to 0.600 \to 0.667\)로 오르내린다. 문턱을 낮출 때 새로 들어오는 사례가 양성이면 정밀도가 오르고 음성이면 내린다. 분자와 분모가 함께 변하므로 방향이 정해져 있지 않다.
그래서 PR 곡선은 ROC 곡선과 달리 톱니 모양이 된다. 마지막 값 \(0.667 = 4/6\)이 정확히 양성의 유병률과 같다는 점도 확인하라. 본문에서 말한 오른쪽 끝점이다. \(\square\)
연습문제 4. \(F_\beta\) 점수는 \(F_\beta = (1+\beta^2)\dfrac{P \cdot R}{\beta^2 P + R}\) 로 정의된다. \(\beta\)의 의미를 설명하고, 위음성이 위양성보다 3배 비쌀 때 어떤 \(\beta\)를 써야 하는지 답하라.
풀이
\(\beta\)는 정밀도 대비 재현율에 주는 가중치다. \(\beta = 1\)이면 \(F_1\)로 돌아가고, \(\beta > 1\)이면 재현율을, \(\beta < 1\)이면 정밀도를 더 중시한다.
\(TP\), \(FP\), \(FN\)으로 다시 쓰면 연습문제 1과 같은 방식으로
을 얻는다. 이 형태가 \(\beta\)의 뜻을 분명히 한다. 위음성 하나가 위양성 하나보다 \(\beta^2\)배 무겁게 계산된다.
따라서 FN이 FP보다 3배 비싸면 \(\beta^2 = 3\), 즉 \(\beta = \sqrt{3} \approx 1.73\)이다.
실무에서는 \(\beta = 2\)(\(F_2\), FN이 4배 무거움)와 \(\beta = 0.5\)(\(F_{0.5}\), FP가 4배 무거움)가 관례적으로 널리 쓰인다. 비용비를 실제로 알고 있다면 \(\beta = \sqrt{c_{FN}/c_{FP}}\)로 두는 편이 낫다. \(\square\)
연습문제 5. 어떤 이상거래 탐지 모형의 AUC가 \(0.95\)인데 평균정밀도는 \(0.12\)다. 유병률은 1%다. 두 값이 모순되는가?
풀이
모순이 아니다. 두 지표는 서로 다른 기준선을 갖는다.
- AUC의 무작위 기준선은 \(0.5\)이므로 \(0.95\)는 매우 좋은 순위 성능이다.
- AP의 무작위 기준선은 유병률 \(\pi = 0.01\)이므로 \(0.12\)는 무작위보다 12배 나은 값이다.
두 값이 함께 나타나는 이유는 유병률이 극단적으로 낮기 때문이다. 양성이 1%, 음성이 99%이면 FPR이 아주 작아도 위양성의 절대 수가 참양성보다 훨씬 많을 수 있다. 예컨대 100만 건 중 양성이 1만 건인 자료에서 TPR \(=0.9\), FPR \(=0.05\)인 작동점을 잡으면,
이 되어 정밀도는 \(9{,}000/58{,}500 = 0.154\)에 불과하다. FPR \(0.05\)는 ROC 곡선에서는 아주 왼쪽이라 훌륭해 보이지만, 경보 6건 중 5건이 헛것이라는 뜻이다.
실무적 결론: 유병률이 낮을 때 AUC는 모형이 순위를 잘 매기는지를 말해 주고, AP와 정밀도는 배치했을 때 조사팀이 감당할 헛수고의 양을 말해 준다. 둘 다 보아야 한다. \(\square\)
정리하며
정밀도와 재현율은 서로 다른 물음에 답한다.
- 정밀도는 "양성이라 했을 때 맞는 비율", 재현율은 "실제 양성 중 잡아낸 비율" 이다. 분모가 다르다.
- 둘은 맞바꿈 관계다. 문턱을 낮추면 재현율이 오르고 정밀도가 떨어진다. 둘 다 높이는 유일한 길은 더 나은 모형이다.
- \(F_1\) 이 조화평균으로 둘을 합친다. 산술평균이 아니라 조화평균인 이유는 한쪽이 아주 낮을 때 벌점을 주기 위해서다.
- 어느 쪽이 중요한지는 문제가 정한다. 암 진단은 재현율(놓치면 안 됨), 스팸 필터는 정밀도(정상 메일을 버리면 안 됨)가 우선이다.
- 불균형 자료에서 ROC 보다 정밀도–재현율 곡선이 유용하다. 음성이 압도적으로 많으면 ROC 가 지나치게 낙관적으로 보인다.
다음 절 ROC 와 AUC로 넘어간다.