2차원 정규 고유분해
개요
이변량 정규의 공분산행렬 \(\boldsymbol{\Sigma}\)는 다음과 같이 분해할 수 있다:
여기서 \(\mathbf{U}\)는 고유벡터(주방향)로 이루어진 행렬이고 \(\mathbf{D} = \text{diag}(\lambda_1, \lambda_2)\)는 고윳값의 대각행렬이다. 고유벡터는 확률타원의 축 방향을 가리키며, \(\sqrt{\lambda_i}\)는 각 주방향의 표준편차를 준다.
기하적 해석
이변량 정규분포의 등밀도 등고선은 다음을 만족한다:
이 타원들은:
- 축 방향이 \(\boldsymbol{\Sigma}\)의 고유벡터와 일치하고
- 축의 반길이가 \(\sqrt{\lambda_i}\)에 비례한다
이는 고유분해의 직접적인 결과이다. \(\mathbf{U}\)가 정의하는 회전된 좌표계에서 공분산행렬은 대각행렬이 되고 타원은 좌표축에 정렬된다.
코드
보기 1. 공분산행렬의 고유분해와 등고선 축. 세 \(\boldsymbol\Sigma\)에 대해 3차원 곡면과 등고선을 그리고 등고선 위에 고유벡터 화살표를 얹는다.
(1) 세 \(\boldsymbol\Sigma\)의 고윳값과 장축이 \(x\)축과 이루는 각도를 구하시오. 각도를 \(\boldsymbol\Sigma\)의 성분으로 주는 식을 유도하고, 그 각도가 상관계수 \(\rho\)만으로 정해지지 않는다는 것을 보이시오.
(2) 코드가 그리는 화살표의 길이는 무엇인가. (1)을 재어 확인하고, \(\sigma_{11} = \sigma_{22}\)일 때 각도가 \(\rho\)와 무관하게 늘 \(45^\circ\)라는 것도 확인하시오.
풀이
(1) 해석적으로. \(\boldsymbol\Sigma = \begin{pmatrix}a & c\\ c& b\end{pmatrix}\)라 두면 특성방정식이
이므로
이다. 근의 공식에서 판별식 \((a+b)^2 - 4(ab-c^2) = (a-b)^2 + 4c^2\)을 정리한 꼴이다. 두 고윳값의 합이 \(a+b = \text{tr}\,\boldsymbol\Sigma\), 곱이 \(ab - c^2 = \det\boldsymbol\Sigma\)라는 것도 식에서 바로 읽힌다.
세 설정에 넣으면
| \(\boldsymbol\Sigma\) | \(\rho\) | \(\text{tr}\) | \(\det\) | \(\lambda_1\) | \(\lambda_2\) |
|---|---|---|---|---|---|
| \(\begin{pmatrix}0.5&0.3\\0.3&0.5\end{pmatrix}\) | \(0.6\) | \(1.0\) | \(0.16\) | \(0.8\) | \(0.2\) |
| \(\begin{pmatrix}1&0\\0&0.3\end{pmatrix}\) | \(0\) | \(1.3\) | \(0.3\) | \(1\) | \(0.3\) |
| \(\begin{pmatrix}0.2&0.14\\0.14&0.8\end{pmatrix}\) | \(0.35\) | \(1.0\) | \(0.1404\) | \(0.83106\) | \(0.16894\) |
이다. 둘째는 이미 대각이므로 고윳값이 대각성분 그 자체다.
각도. 장축 방향을 \((\cos\theta, \sin\theta)^\top\)이라 두고 고유벡터 방정식 \(\boldsymbol\Sigma\mathbf v = \lambda_1 \mathbf v\)의 두 성분을 쓰면
이다. 첫 식에서 \(\lambda_1 - a = c\tan\theta\), 둘째 식에서 \(\lambda_1 - b = c\cot\theta\)를 얻고 두 식을 빼면 \(b - a = c(\tan\theta - \cot\theta)\)다. 여기서 \(\tan\theta - \cot\theta = -2\cot 2\theta\)라는 삼각항등식을 쓰면
이다(사분면을 가리려면 atan2(2c, a-b)를 쓴다). 세 설정에 넣으면
이다.
각도는 \(\rho\)만으로 정해지지 않는다. 첫째와 셋째를 보라. 둘 다 양의 상관인데 \(\rho = 0.6\)인 쪽이 \(45^\circ\)이고 \(\rho = 0.35\)인 쪽이 \(77.49^\circ\)다. 상관이 더 약한 쪽이 더 많이 기울었다. 식이 그 까닭을 말해 준다. 분자에는 \(\sigma_{12}\)가, 분모에는 \(\sigma_{11} - \sigma_{22}\)가 있으므로 각도는 공분산과 두 분산의 차이의 비로 정해진다. 셋째는 \(\sigma_{22} = 0.8\)이 \(\sigma_{11} = 0.2\)의 네 배라 분모가 커서 각도가 수직 쪽으로 밀려났다.
극단적인 경우가 \(\sigma_{11} = \sigma_{22}\)다. 그러면 분모가 \(0\)이라 \(\tan 2\theta = \infty\), 곧 \(2\theta = 90^\circ\)이고
이 \(\rho\)와 무관하게 성립한다. \(\rho = 0.01\)이어도 타원은 정확히 \(45^\circ\)로 기운다. 다만 그때는 \(\lambda_2/\lambda_1 = (1-\rho)/(1+\rho) = 0.98\)로 거의 원이라 기울기가 눈에 보이지 않는다. \(\boldsymbol\Sigma = \sigma^2\begin{pmatrix}1&\rho\\\rho&1\end{pmatrix}\)의 고윳값이 \(\sigma^2(1\pm\rho)\)이기 때문이다.
정리하면 \(\rho\)와 분산비가 역할을 나눈다. \(\rho\)는 타원이 얼마나 납작한지(\(\lambda_2/\lambda_1\))에 주로 작용하고, 기운 각도는 공분산과 분산 차이의 비가 정한다. 본문 개요 절과 "해석" 절이 말하는 두 가지가 바로 이 분업이다.
(2) 수치적으로. 먼저 쪽의 그림을 그린다.
import numpy as np
import matplotlib.pyplot as plt

def bivariate_normal_pdf(X, Y, inv_Sigma, det_Sigma):
    """평균이 0인 이변량 정규분포의 밀도를 정의대로 계산한다.

    지수의 어깨에 있는 것이 이차형식 z' Sigma^{-1} z 이고,
    이를 전개하면 아래처럼 X^2, XY, Y^2 항이 나온다.
    분모의 sqrt(det Sigma) 는 전체 적분을 1로 만드는 정규화 상수다.
    """
    return (np.exp(-(inv_Sigma[0,0]*X**2 + 2*inv_Sigma[0,1]*X*Y
                     + inv_Sigma[1,1]*Y**2) / 2)
            / (2 * np.pi * np.sqrt(det_Sigma)))

# 공분산행렬 셋. 고유분해가 무엇을 알려 주는지 비교하기 위한 것이다.
#   1) 비대각이 0이 아님  -> 타원이 45도로 기운다. 고유벡터도 기운다.
#   2) 대각행렬          -> 타원이 축에 나란하다. 고유벡터가 곧 좌표축이다.
#   3) 비대각도 있고 분산도 다름 -> 기울기와 늘어남이 함께 나타난다.
configs = [
    {"label": "Σ = [[0.5, 0.3], [0.3, 0.5]]",
     "Sigma": np.array([[0.5, 0.3], [0.3, 0.5]])},
    {"label": "Σ = [[1.0, 0.0], [0.0, 0.3]]",
     "Sigma": np.array([[1.0, 0.0], [0.0, 0.3]])},
    {"label": "Σ = [[0.2, 0.14], [0.14, 0.8]]",
     "Sigma": np.array([[0.2, 0.14], [0.14, 0.8]])},
]

x = np.linspace(-2.5, 2.5, 200)
X, Y = np.meshgrid(x, x)

fig, axes = plt.subplots(len(configs), 2, figsize=(12, 5 * len(configs)))

for i, cfg in enumerate(configs):
    Sigma = cfg["Sigma"]
    inv_Sigma = np.linalg.inv(Sigma)
    det_Sigma = np.linalg.det(Sigma)

    # eigh 는 **대칭행렬 전용** 고유분해다. 공분산행렬은 언제나 대칭이므로
    # 일반용 eig 보다 빠르고 수치적으로 안정하며, 고윳값이 실수로 나온다.
    # 결과의 기하학적 의미:
    #   고유벡터 = 타원의 주축 방향
    #   고윳값   = 그 방향의 분산. sqrt(고윳값)이 그 축의 반지름이다.
    eigenvalues, eigenvectors = np.linalg.eigh(Sigma)

    Z = bivariate_normal_pdf(X, Y, inv_Sigma, det_Sigma)

    # eigh는 고윳값을 오름차순으로 준다. 큰 것(장축)이 먼저 오도록 뒤집는다.
    # eigenvectors는 **열**이 고유벡터이므로 [:, idx] 로 열을 재배열한다.
    idx = eigenvalues.argsort()[::-1]
    eigenvalues = eigenvalues[idx]
    eigenvectors = eigenvectors[:, idx]

    # 3차원 곡면
    axes[i, 0].remove()
    ax3d = fig.add_subplot(len(configs), 2, 2*i + 1, projection="3d")
    ax3d.plot_surface(X, Y, Z, cmap="viridis", alpha=0.85, edgecolor="none")
    ax3d.set_title(cfg["label"], fontsize=10)

    # 등고선에 고유벡터를 얹는다
    ax = axes[i, 1]
    ax.contourf(X, Y, Z, levels=20, cmap="Blues", alpha=0.5)
    colors_ev = ["red", "darkgreen"]
    for j in range(2):
        scale = np.sqrt(eigenvalues[j])
        dx = eigenvectors[0, j] * scale
        dy = eigenvectors[1, j] * scale
        ax.annotate("", xy=(dx, dy), xytext=(0, 0),
                    arrowprops=dict(arrowstyle="->", color=colors_ev[j], lw=2.5))
    ax.set_title("Contour + Eigenvectors", fontsize=10)
    ax.set_aspect("equal")

plt.tight_layout()
plt.show()
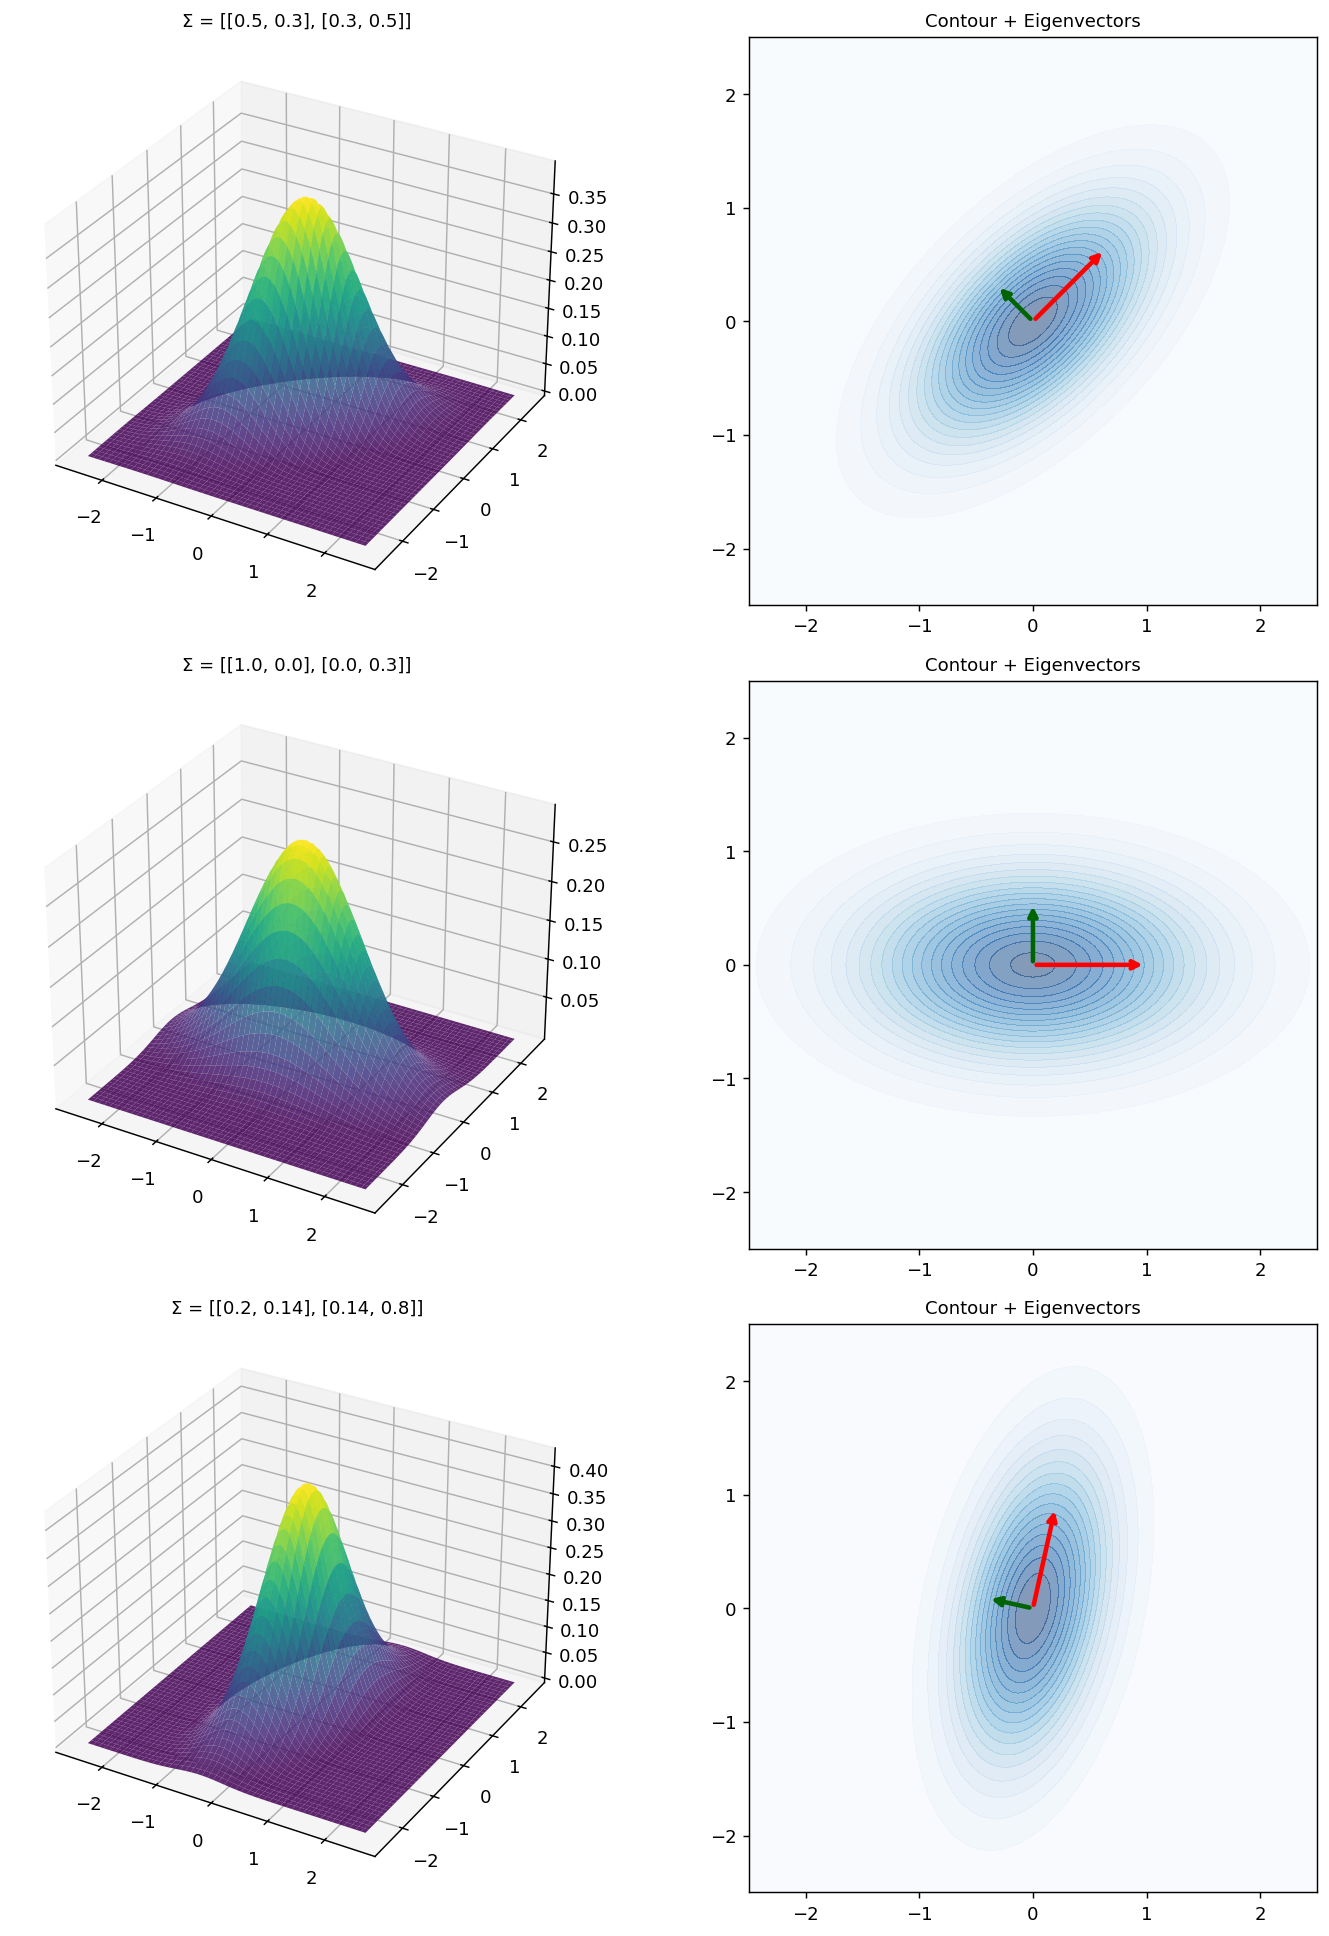
오른쪽 열의 두 화살표가 늘 서로 직각이다. 대칭행렬의 고유벡터가 직교하기 때문이고, 공분산행렬이 언제나 대칭이므로 어떤 \(\boldsymbol\Sigma\)를 넣어도 그렇다. 첫째 칸의 빨간 화살표는 대각선 방향, 둘째 칸은 가로 방향, 셋째 칸은 거의 세로 방향을 가리킨다.
화살표의 길이는 \(\sqrt{\lambda_i}\)다. 코드의 scale = np.sqrt(eigenvalues[j])가 그것이고, 기하적으로는 \(c = 1\)인 등고선 타원의 반길이다. 곧 화살표 끝이 그 방향의 "\(1\) 표준편차" 자리다. 수로 확인한다.
import numpy as np
from math import atan2, degrees, sqrt

configs = [("[[0.5,0.3],[0.3,0.5]]", [[0.5, 0.3], [0.3, 0.5]]),
           ("[[1.0,0.0],[0.0,0.3]]", [[1.0, 0.0], [0.0, 0.3]]),
           ("[[0.2,0.14],[0.14,0.8]]", [[0.2, 0.14], [0.14, 0.8]])]

print(f"{'Sigma':>25}{'rho':>7}{'tr':>7}{'det':>8}{'lam1':>9}{'lam2':>9}"
      f"{'lam2/lam1':>11}{'각도(식)':>11}{'각도(eigh)':>12}{'화살표 길이':>18}")
for label, S in configs:
    S = np.array(S, float)
    a, b, c = S[0, 0], S[1, 1], S[0, 1]
    rho = c / sqrt(a * b)
    lam, V = np.linalg.eigh(S)
    i = lam.argsort()[::-1]
    lam, V = lam[i], V[:, i]
    v1 = V[:, 0]
    th_eigh = degrees(atan2(v1[1], v1[0])) % 180          # 장축 방향
    th_formula = degrees(0.5 * atan2(2 * c, a - b)) % 180  # tan 2theta = 2c/(a-b)
    print(f"{label:>25}{rho:>7.3f}{np.trace(S):>7.2f}{np.linalg.det(S):>8.4f}"
          f"{lam[0]:>9.5f}{lam[1]:>9.5f}{lam[1]/lam[0]:>11.5f}"
          f"{th_formula:>10.2f}도{th_eigh:>11.2f}도{str(np.round(np.sqrt(lam),4)):>18}")

print()
# sigma11 = sigma22 이면 rho 가 무엇이든 각도가 정확히 45 도다.
for rho in (0.1, 0.6, 0.95):
    S = np.array([[0.5, 0.5 * rho], [0.5 * rho, 0.5]])
    lam = np.sort(np.linalg.eigvalsh(S))[::-1]
    th = degrees(0.5 * atan2(2 * S[0, 1], S[0, 0] - S[1, 1])) % 180
    print(f"분산이 같을 때 rho={rho:<5}: 각도 {th:.2f}도,  lam2/lam1 = {lam[1]/lam[0]:.5f}"
          f"   (1-rho)/(1+rho) = {(1-rho)/(1+rho):.5f}")
출력:
                    Sigma    rho     tr     det     lam1     lam2  lam2/lam1      각도(식)    각도(eigh)            화살표 길이
    [[0.5,0.3],[0.3,0.5]]  0.600   1.00  0.1600  0.80000  0.20000    0.25000     45.00도      45.00도   [0.8944 0.4472]
    [[1.0,0.0],[0.0,0.3]]  0.000   1.30  0.3000  1.00000  0.30000    0.30000      0.00도       0.00도   [1.     0.5477]
  [[0.2,0.14],[0.14,0.8]]  0.350   1.00  0.1404  0.83106  0.16894    0.20328     77.49도      77.49도   [0.9116 0.411 ]

분산이 같을 때 rho=0.1  : 각도 45.00도,  lam2/lam1 = 0.81818   (1-rho)/(1+rho) = 0.81818
분산이 같을 때 rho=0.6  : 각도 45.00도,  lam2/lam1 = 0.25000   (1-rho)/(1+rho) = 0.25000
분산이 같을 때 rho=0.95 : 각도 45.00도,  lam2/lam1 = 0.02564   (1-rho)/(1+rho) = 0.02564
(1)이 다 맞는다.
고윳값. \((0.8, 0.2)\), \((1, 0.3)\), \((0.83106, 0.16894)\)가 근의 공식으로 얻은 값과 같다. 아래 "해석" 절이 첫째 설정에 대해 적은 \(\lambda_1 = 0.8\), \(\lambda_2 = 0.2\), \(\sqrt{\lambda_1/\lambda_2} = 2\)도 그대로다(\(\sqrt{0.8/0.2} = 2\)).
각도. 각도(식) 열과 각도(eigh) 열이 소수점 둘째 자리까지 같다. 손으로 유도한 \(\tan 2\theta = 2c/(a-b)\)와 수치 고유분해가 같은 답을 준다는 확인이다. 둘째 설정의 \(0^\circ\)는 이미 축에 나란하다는 뜻이고, 셋째의 \(77.49^\circ\)는 거의 수직이다.
\(\rho\)와 각도가 따로 움직인다. 첫째 줄과 셋째 줄이 \(\text{tr} = 1.00\)으로 같은데, \(\rho\)는 \(0.600\) 대 \(0.350\)이고 각도는 \(45^\circ\) 대 \(77.49^\circ\)다. 상관이 약한 쪽이 더 기울었다. 그런데 납작함 \(\lambda_2/\lambda_1\)은 \(0.25000\) 대 \(0.20328\)로 셋째가 더 납작하다. 셋째에서 납작함을 만드는 것은 상관이 아니라 두 분산의 불균형(\(0.2\) 대 \(0.8\))이다. 상관이 없어도 분산이 다르면 타원은 납작해진다는 것을 둘째 줄이(\(\rho = 0\)인데 \(\lambda_2/\lambda_1 = 0.3\)) 가장 분명히 보인다.
분산이 같을 때. 마지막 세 줄에서 \(\rho\)를 \(0.1\)에서 \(0.95\)까지 바꾸어도 각도가 \(45.00^\circ\)에서 꼼짝하지 않는다. 바뀌는 것은 납작함뿐이고, \(\lambda_2/\lambda_1\)이 \(0.81818 \to 0.25000 \to 0.02564\)로 유도한 \((1-\rho)/(1+\rho)\)와 다섯째 자리까지 일치한다. \(\rho = 0.1\)일 때 \(0.818\)은 거의 원이므로, 타원이 \(45^\circ\)로 기울어 있다는 사실은 눈으로 볼 수 없어도 대수적으로는 참이다. 그림에서 기울기를 읽지 못했다고 상관이 \(0\)이라 결론지으면 안 된다는 뜻이다.
해석
\(\boldsymbol{\Sigma} = \begin{pmatrix}0.5 & 0.3 \\ 0.3 & 0.5\end{pmatrix}\)에 대해:
- 고윳값: \(\lambda_1 = 0.8\), \(\lambda_2 = 0.2\)
- 주된 고유벡터는 \((1, 1)/\sqrt{2}\) 방향(양의 상관 방향)을 가리킨다
- 비 \(\sqrt{\lambda_1/\lambda_2} = 2\)가 타원의 이심 정도를 준다
\(\boldsymbol{\Sigma}\)가 대각행렬이면(상관이 없으면) 고유벡터가 좌표축과 일치하고 등고선은 좌표축에 정렬된 타원(분산이 같으면 원)이 된다.
연습문제
연습문제 1. \(\boldsymbol{\Sigma} = \begin{pmatrix}1 & 0 \\ 0 & 0.3\end{pmatrix}\)의 고윳값과 고유벡터를 계산하고 등고선 모양을 서술하라.
풀이
\(\boldsymbol{\Sigma}\)가 대각행렬이므로 고윳값은 \(\lambda_1 = 1\), \(\lambda_2 = 0.3\)이고 고유벡터는 \(\mathbf{e}_1 = (1, 0)^\top\), \(\mathbf{e}_2 = (0, 1)^\top\)이다. 등고선은 좌표축에 정렬된 타원이며 (\(\lambda_1 > \lambda_2\)이므로) \(x_1\) 축 방향으로 길쭉하다. 축 길이의 비는 \(\sqrt{1/0.3} \approx 1.83\)이다.
연습문제 2. 공분산행렬의 고윳값이 항상 음이 아님을 증명하라.
풀이
공분산행렬 \(\boldsymbol{\Sigma}\)는 양의 준정부호이다. 즉 모든 \(\mathbf{v}\)에 대해 \(\mathbf{v}^\top\boldsymbol{\Sigma}\mathbf{v} \ge 0\)이다. \(\lambda\)가 고유벡터 \(\mathbf{u}\)(\(\|\mathbf{u}\| = 1\))에 대응하는 고윳값이면:
따라서 \(\lambda \ge 0\)이다. \(\square\)
연습문제 3. \(\text{tr}(\boldsymbol{\Sigma}) = \lambda_1 + \lambda_2\)이고 \(|\boldsymbol{\Sigma}| = \lambda_1\lambda_2\)임을 보여라. \(\boldsymbol{\Sigma} = \begin{pmatrix}0.5 & 0.3 \\ 0.3 & 0.5\end{pmatrix}\)에 대해 둘 다 확인하라.
풀이
\(\boldsymbol{\Sigma} = \mathbf{U}\mathbf{D}\mathbf{U}^\top\)이므로:
주어진 행렬에 대해 \(\text{tr} = 0.5 + 0.5 = 1.0\)이고 \(\lambda_1 + \lambda_2 = 0.8 + 0.2 = 1.0\)이다. 또한 \(|\boldsymbol{\Sigma}| = 0.25 - 0.09 = 0.16\)이고 \(\lambda_1\lambda_2 = 0.8 \times 0.2 = 0.16\)이다. 두 항등식 모두 성립한다.
연습문제 4. 점 \(\mathbf{x}\)에서 평균 \(\boldsymbol{\mu}\)까지의 Mahalanobis 거리는 \(d_M = \sqrt{(\mathbf{x}-\boldsymbol{\mu})^\top\boldsymbol{\Sigma}^{-1}(\mathbf{x}-\boldsymbol{\mu})}\)이다. 주성분 좌표계(고유벡터 기저)에서 이것이 각 축을 \(1/\sqrt{\lambda_i}\)로 척도조정한 유클리드 거리로 환원됨을 보여라.
풀이
회전된 좌표 \(\mathbf{z} = \mathbf{U}^\top(\mathbf{x} - \boldsymbol{\mu})\)에서:
이는 각 성분을 \(\sqrt{\lambda_i}\)로 나눈 유클리드 거리의 제곱이다. Mahalanobis 거리는 각 주방향을 그 표준편차로 "표준화"하므로 척도와 상관에 불변이 된다. \(\square\)
연습문제 5. \(\boldsymbol\Sigma^{1/2} = \mathbf{U}\mathbf{D}^{1/2}\mathbf{U}^\top\)로 두면 \(\boldsymbol\Sigma^{1/2}\boldsymbol\Sigma^{1/2} = \boldsymbol\Sigma\)임을 보여라. 이 제곱근과 촐레스키 인자 \(L\)은 어떻게 다른가?
풀이
\(\mathbf{U}\)가 직교행렬이므로 \(\mathbf{U}^\top\mathbf{U} = I\)이고
이다. \(\square\)
촐레스키와의 차이. 둘 다 \(AA^\top = \boldsymbol\Sigma\)를 만족하지만(고유분해의 제곱근은 대칭이라 \(A^\top = A\)), 제곱근은 유일하지 않다. 임의의 직교행렬 \(Q\)에 대해 \(AQ\)도 같은 성질을 가지기 때문이다.
| \(\boldsymbol\Sigma^{1/2}\) (고유분해) | \(L\) (촐레스키) | |
|---|---|---|
| 모양 | 대칭 | 하삼각 |
| 계산량 | \(O(d^3)\), 상수가 큼 | \(O(d^3/3)\), 빠름 |
| 유일성 | 양정부호 제곱근으로 유일 | 대각이 양수인 것으로 유일 |
| 기하 | 회전 없이 각 주축 방향으로만 늘림 | 늘리면서 회전도 섞임 |
난수 생성에는 촐레스키가 낫다. 더 빠르고 어느 쪽을 쓰든 분포는 같기 때문이다.
백색화(whitening)에는 대칭 제곱근이 쓸모 있다. \(\mathbf{Z} = \boldsymbol\Sigma^{-1/2}(\mathbf{X}-\boldsymbol\mu)\)는 성분이 독립인 표준정규가 되는데, 대칭 제곱근을 쓰면 변환된 좌표가 원래 좌표와 최대한 가깝게 유지된다(모든 백색화 변환 중 \(E\|\mathbf{Z}-\mathbf{X}\|^2\)을 최소로 한다). 해석 가능성을 지키고 싶을 때 이 성질이 중요하며, ZCA 백색화라 불린다.
연습문제 6. \(\boldsymbol\Sigma = \begin{pmatrix}0.5&0.3\\0.3&0.5\end{pmatrix}\)에서 첫 주성분이 설명하는 분산 비율을 구하라. 이 값이 상관계수 \(\rho\)와 어떤 관계인가?
풀이
고윳값이 \(\lambda_1 = 0.8\), \(\lambda_2 = 0.2\)이므로
첫 주성분이 전체 분산의 80%를 설명한다.
\(\rho\)와의 관계. 두 변수의 분산이 \(\sigma^2\)로 같고 상관이 \(\rho\)이면 \(\boldsymbol\Sigma = \sigma^2\begin{pmatrix}1&\rho\\\rho&1\end{pmatrix}\)이고, 고윳값이 \(\lambda_{1,2} = \sigma^2(1\pm|\rho|)\)임을 특성방정식에서 바로 얻는다. 따라서
이다. \(\rho = 0.6\)이면 \((1+0.6)/2 = 0.8\)로 확인된다.
이 관계에서 분산이 같은 두 변수의 첫 주성분은 설명비율이 최소 50%임을 알 수 있다(\(\rho=0\)일 때). 상관이 전혀 없어도 절반은 설명한다는 뜻이므로, "첫 주성분이 분산의 절반 이상을 설명한다"는 말 자체에는 정보가 거의 없다. 판단하려면 기준선과 견주어야 한다.
분산이 서로 다르면 사정이 달라진다. 보기 세 번째 행렬 \(\begin{pmatrix}0.2&0.14\\0.14&0.8\end{pmatrix}\)은 \(\rho = 0.14/\sqrt{0.16} = 0.35\)로 상관이 약한데도 첫 주성분이 83%를 설명한다. 상관이 아니라 분산의 불균형이 만든 결과이며, 다음 연습문제에서 이것이 왜 문제가 되는지 본다.
연습문제 7. \(\boldsymbol\Sigma = \begin{pmatrix}\sigma_1^2 & c \\ c & \sigma_2^2\end{pmatrix}\)의 첫 고유벡터가 이루는 각 \(\theta\)가
를 만족함을 보이고, 보기의 세 행렬에 각각 적용하라.
풀이
고유벡터를 \((\cos\theta, \sin\theta)^\top\)로 두고 \(\boldsymbol\Sigma\mathbf{u} = \lambda\mathbf{u}\)의 두 성분을 쓰면
이다. 첫 식에 \(\sin\theta\), 둘째 식에 \(\cos\theta\)를 곱해 빼면 \(\lambda\)가 사라지고
이 된다. 배각공식 \(\sin 2\theta = 2\sin\theta\cos\theta\), \(\cos2\theta = \cos^2\theta-\sin^2\theta\)를 쓰면
이다. \(\square\)
적용.
| \(\boldsymbol\Sigma\) | \(\theta\) | 설명 |
|---|---|---|
| \(\begin{pmatrix}0.5&0.3\\0.3&0.5\end{pmatrix}\) | \(45^\circ\) | 분모가 0이라 \(2\theta = 90^\circ\). 분산이 같으면 언제나 \(\pm45^\circ\)다. |
| \(\begin{pmatrix}1&0\\0&0.3\end{pmatrix}\) | \(0^\circ\) | 분자가 0이므로 회전이 없다. 이미 주축 좌표계다. |
| \(\begin{pmatrix}0.2&0.14\\0.14&0.8\end{pmatrix}\) | \(77.5^\circ\) | 분산이 크게 다르니 장축이 분산이 큰 축 쪽으로 거의 눕는다. |
셋째 경우가 특히 시사적이다. 상관이 있어 타원이 기울기는 하지만, 분산 차이가 압도적이라 장축이 \(y\)축(\(90^\circ\))에서 겨우 \(12.5^\circ\)만 벗어난다. 분산이 크게 다르면 주성분은 사실상 분산이 큰 변수 하나를 골라내는 일에 그친다.
연습문제 8. 연습문제 7의 세 번째 행렬에서 첫 변수의 단위를 바꾸어 값을 100배 하면 \(\boldsymbol\Sigma\)와 고유벡터가 어떻게 바뀌는가? 주성분분석을 공분산행렬로 할지 상관행렬로 할지 어떻게 정해야 하는가?
풀이
\(X_1 \to 100X_1\)이면 분산은 \(100^2\)배, 공분산은 \(100\)배가 되어
이 된다. 이제 \(\tan2\theta = 28/1999.2 \approx 0.014\)로 \(\theta \approx 0.4^\circ\)가 되어, 첫 주성분이 사실상 \(X_1\) 축 그 자체가 된다. 설명비율도 99.96%로 치솟는다.
단위를 바꾼 것뿐인데 결론이 완전히 달라졌다. 주성분분석은 척도에 불변이 아니며, 이것이 이 방법의 가장 큰 함정이다.
어떻게 정하는가.
- 변수들의 단위가 같고 그 크기 차이 자체가 뜻 있는 정보일 때는 공분산행렬을 쓴다. 같은 센서로 잰 여러 지점의 온도, 여러 시점의 같은 화폐 단위 수익률 등이 그렇다.
- 단위가 서로 다르거나 비교 가능하지 않을 때는 상관행렬을 쓴다. 키(cm), 몸무게(kg), 소득(원)을 함께 다루면 소득의 분산이 나머지를 압도하므로 공분산행렬로는 아무것도 알 수 없다. 상관행렬을 쓰는 것은 모든 변수를 표준화한 뒤 공분산행렬로 분석하는 것과 같다.
실무에서는 상관행렬 쪽이 기본값에 가깝다. 다만 표준화가 공짜는 아니다. 분산이 작은 잡음 변수도 분산 1로 부풀려지므로, 의미 없는 변수가 주성분에 끼어들 수 있다. 어느 쪽을 택했는지 반드시 보고해야 하며, 둘 다 해 보고 결과가 크게 다르면 그 이유를 따져 보는 것이 안전하다.
연습문제 9. 마할라노비스 거리로 다변량 이상치를 찾으려 한다. 판정 기준을 세우고, 표본 평균과 표본 공분산을 그대로 쓸 때 생기는 가리기 효과를 설명하라.
풀이
판정 기준. \(\mathbf{X} \sim N_d(\boldsymbol\mu, \boldsymbol\Sigma)\)이면 \(d_M^2 \sim \chi^2_d\)이므로, 유의수준 \(\alpha\)에서
인 관측값을 이상치 후보로 삼는다. \(d=2\), \(\alpha=0.01\)이면 임계값이 \(9.21\)이다. 다중비교를 고려해 \(\alpha/n\)을 쓰기도 한다.
유클리드 거리가 아니라 마할라노비스 거리를 쓰는 이유는 분명하다. 상관이 강한 자료에서는 타원의 장축 방향으로 멀리 있는 점이 정상이고, 단축 방향으로 조금만 벗어난 점이 오히려 이상할 수 있다. 유클리드 거리는 이 차이를 보지 못한다.
가리기 효과. \(\boldsymbol\mu\)와 \(\boldsymbol\Sigma\)를 모르므로 \(\bar{\mathbf{x}}\)와 \(S\)로 대신하는데, 이 추정량들 자체가 이상치에 끌려간다.
- 이상치가 평균을 자기 쪽으로 당겨 이상치와 중심 사이의 거리가 줄어든다.
- 더 심각하게, 이상치가 \(S\)를 부풀린다. 특히 이상치가 놓인 방향의 분산을 키워 그 방향의 거리를 나누는 값을 크게 만든다.
두 효과가 겹쳐 이상치가 자기 자신의 거리를 낮춰 스스로를 숨긴다. 이것이 가리기다. 이상치가 여럿이 무리 지어 있으면 서로를 가려 주어 한 개도 검출되지 않는 일이 흔하다. 반대로 정상값이 이상치로 잘못 찍히는 늪 효과도 함께 일어난다.
해결. 평균과 공분산을 강건하게 추정한다. 대표적인 것이 최소공분산행렬식(MCD) 추정량으로, \(n\)개 중 \(h \approx 0.75n\)개의 부분집합 가운데 공분산행렬식이 가장 작은 것을 골라 그 부분집합으로만 평균과 공분산을 계산한다. 이상치는 어느 밀집된 부분집합에도 들어가지 못하므로 추정에 영향을 주지 못하고, 그 결과 거리가 제대로 커진다. sklearn.covariance.MinCovDet이 이를 구현한다.
강건 추정을 쓰면 \(d_M^2\)의 분포가 정확히 \(\chi^2_d\)는 아니므로 임계값도 보정해야 하지만, 가리기를 방치하는 것보다는 훨씬 낫다.
연습문제 10. \(\boldsymbol\Sigma\)의 조건수를 \(\kappa = \lambda_1/\lambda_2\)로 정의한다. 보기의 세 행렬에 대해 \(\kappa\)를 구하고, \(\kappa\)가 매우 클 때 어떤 계산상의 어려움이 생기는지 설명하라.
풀이
| \(\boldsymbol\Sigma\) | \(\lambda_1\) | \(\lambda_2\) | \(\kappa\) |
|---|---|---|---|
| \(\begin{pmatrix}0.5&0.3\\0.3&0.5\end{pmatrix}\) | 0.8 | 0.2 | 4.0 |
| \(\begin{pmatrix}1&0\\0&0.3\end{pmatrix}\) | 1.0 | 0.3 | 3.3 |
| \(\begin{pmatrix}0.2&0.14\\0.14&0.8\end{pmatrix}\) | 0.831 | 0.169 | 4.9 |
셋 다 5 이하로 문제가 없다.
\(\kappa\)가 클 때의 어려움.
- 역행렬의 불안정. \(\boldsymbol\Sigma^{-1}\)의 고윳값이 \(1/\lambda_i\)이므로 작은 \(\lambda_2\)가 큰 값으로 뒤집힌다. 자료의 미세한 변화가 \(\boldsymbol\Sigma^{-1}\)을 크게 흔들고, 마할라노비스 거리나 회귀계수가 함께 요동친다. 수치적으로도 유효숫자를 \(\log_{10}\kappa\) 자리만큼 잃는다.
- 추정의 불안정. 표본 공분산의 가장 작은 고윳값은 참값보다 작게, 가장 큰 것은 크게 추정되는 편향이 있다. 그래서 표본에서 계산한 \(\kappa\)는 참 \(\kappa\)보다 과장되며, \(d\)가 \(n\)에 가까울수록 심해진다.
- 해석의 불안정. \(\lambda_1\)과 \(\lambda_2\)가 가까우면(즉 \(\kappa \approx 1\)이면) 반대 문제가 생긴다. 고유벡터의 방향이 거의 임의가 되어 표본마다 크게 달라진다. 주성분의 방향을 해석할 때는 고윳값이 충분히 갈라져 있는지 먼저 확인해야 한다.
회귀에서 설명변수 행렬의 조건수가 큰 것이 곧 다중공선성이다. 대처법은 같다. 능형회귀처럼 대각선에 \(\delta I\)를 더해 작은 고윳값을 \(\lambda_2+\delta\)로 밀어 올리거나(축소 추정), 작은 고윳값에 해당하는 방향을 아예 버린다(주성분회귀). 둘 다 약간의 편향을 받아들이는 대신 분산을 크게 줄이는 거래다.
정리하며
공분산행렬을 \(\boldsymbol\Sigma=\mathbf{U}\mathbf{D}\mathbf{U}^\top\) 로 분해하면 확률타원의 기하가 그대로 읽힌다.
- 고유벡터가 축의 방향이고, \(\sqrt{\lambda_i}\) 가 그 방향의 표준편차다. 타원의 긴 축은 가장 큰 고윳값 쪽을 향한다.
- 좌표축은 임의의 선택이다. 고유분해는 자료 자체가 정하는 자연스러운 축을 찾아 주며, 그 축에서는 두 성분이 무상관이 된다.
- \(\sqrt{\det\boldsymbol\Sigma}=\sqrt{\lambda_1\lambda_2}\) 가 타원의 넓이에 비례하고(\(\pi c\sqrt{\lambda_1\lambda_2}\)), \(\lambda_2/\lambda_1\) 이 납작한 정도를 말한다. 상관이 강할수록 작은 고윳값이 0 에 가까워진다.
- 이것이 주성분분석 그 자체다. 2차원에서 눈으로 확인한 것이 고차원에서 차원축소가 되며, 3장에서 본 고차원 표본공분산의 고윳값 퍼짐 문제도 같은 언어로 설명된다.
- 스펙트럼 정리가 이 분해를 보장한다는 점은 0장에서 확인했다. 공분산행렬이 대칭이므로 언제나 가능하다.
이것으로 4장이 끝난다. 이산분포에서 시작해 연속분포를 거쳐 이변량 정규분포까지 왔고, 각 분포가 어떤 상황에서 나오는지를 보았다. 마지막 절에서는 3장의 일반 틀을 이 한 분포에 적용해, 무상관이 곧 독립이 되고 조건부분포가 다시 정규가 되는 특수한 사정을 확인했다.
다음 장 표집분포로 넘어간다. 지금까지는 분포를 주어진 것으로 놓고 성질을 살폈지만, 이제는 표본에서 계산한 통계량 자체가 어떤 분포를 갖는지를 묻는다.