λ 선택을 위한 교차검증
정칙화 모수 \(\lambda\)는 자료 적합과 모형 제약 사이의 절충을 조절한다. 훈련오차는 \(\lambda\)가 작아질수록 언제나 줄어들므로 \(\lambda\) 선택에 쓸 수 없다. 검정오차의 추정값이 필요하며, 교차검증(CV)이 표준적인 접근을 제공한다.
교차검증이 필요한 이유
고정된 \(\lambda\)에서 정칙화 모형의 훈련오차
는 참 검정오차의 편향된 추정값이다. 같은 자료를 적합과 평가에 모두 썼기 때문이다. \(\lambda\)가 줄면 모형이 유연해져 훈련오차는 줄지만 과적합으로 검정오차는 늘 수 있다. 교차검증은 평가용 자료를 떼어 놓아 거의 불편인 검정오차 추정값을 제공한다.
K-겹 교차검증 절차
준비. 후보 \(\lambda_1 > \cdots > \lambda_M\)의 격자와 겹 수 \(K\)(보통 5 또는 10)를 정한다.
- \(n\)개 관측을 크기가 비슷한 \(K\)개 겹 \(F_1, \ldots, F_K\)로 무작위 분할한다.
- 각 겹 \(k\)와 각 \(\lambda_m\)에 대해, 겹 \(k\)를 뺀 자료로 적합하고 겹 \(k\)를 예측하여 \(\text{MSE}_k(\lambda_m)\)를 계산한다.
- 겹에 걸쳐 평균낸다.
- CV 추정값의 표준오차를 계산한다.
λ_min의 선택
가장 단순한 규칙은 CV 오차를 최소화하는 \(\lambda\)를 고르는 것이다.
CV 곡선은 대개 U자 모양이다. 큰 \(\lambda\)에서 높고(과소적합), 최솟값까지 감소했다가, 작은 \(\lambda\)에서 다시 증가한다(과적합).
1-표준오차 규칙
CV 추정값에는 잡음이 있고 \(\lambda_{\min}\)이 필요 이상으로 복잡한 모형에 대응할 수 있다.
최솟값에서 1 표준오차 이내인 것 중 가장 크게 정칙화된 \(\lambda\)다. CV 오차가 1 표준오차 이내인 모형들은 통계적으로 구별되지 않으므로 그중 가장 단순한 것을 택한다는 논리다.
어느 규칙을 쓸 것인가
예측 정확도가 주된 목표면 \(\lambda_{\min}\)을, 해석 가능성·안정성·간결성이 중요하면 \(\lambda_{1\text{SE}}\)를 쓴다. 어떤 변수가 중요한지 이해하는 것이 예측만큼 중요한 과학적 응용에서는 \(\lambda_{1\text{SE}}\)가 선호되는 경우가 많다.
격자의 구성
격자는 \(\lambda_{\max}\)(라쏘에서 모든 계수가 0이 되는 값)에서 그 작은 배수까지 걸쳐야 한다. 라쏘와 엘라스틱넷에서
이며 격자는 보통 로그 간격이다. 흔히 100개 점을 \(\lambda_{\max}\)의 \(10^{-3}\)배에서 \(1\)배까지 잡는다. 능형회귀에서는 희소성 문턱으로 \(\lambda_{\max}\)가 정의되지 않지만, 큰 값에서 작은 값까지의 비슷한 로그 격자가 잘 작동한다.
구현 시 주의점
겹 안에서의 표준화
설명변수는 적합 전에 표준화해야 한다. 결정적으로, 표준화는 훈련 겹에서만 계산해 떼어 둔 겹에 적용해야 한다. 전체 자료로 표준화하면 미묘한 자료 누설이 생겨 CV 오차 추정값이 낙관적으로 편향된다.
경로를 따라가는 온기 시작
라쏘와 엘라스틱넷에서는 좌표하강과 온기 시작으로 전체 \(\lambda\) 격자의 정칙화 경로를 계산한다. 각 겹의 적합이 이전 \(\lambda\)의 해를 활용하므로 전체 CV 절차가 효율적이다.
겹 배정
시계열 자료에서는 시간 순서를 존중하도록 무작위 배정 대신 연속된 블록을 쓴다. 군집 자료(같은 피험자의 반복 측정 등)에서는 같은 군집의 관측을 같은 겹에 배정한다.
흔한 함정: 자료 누설
겹을 나누기 전에 전체 자료로 변수선택, 변수변환, 그 밖의 자료 의존적 전처리를 하지 말라. 모든 전처리는 각 겹의 훈련집합 안에서 수행해야 한다. 이 규칙을 어기면 CV 추정값이 낙관적으로 편향되며, 그 크기는 연습문제 2에서 보듯 결론을 완전히 뒤집을 수 있다.
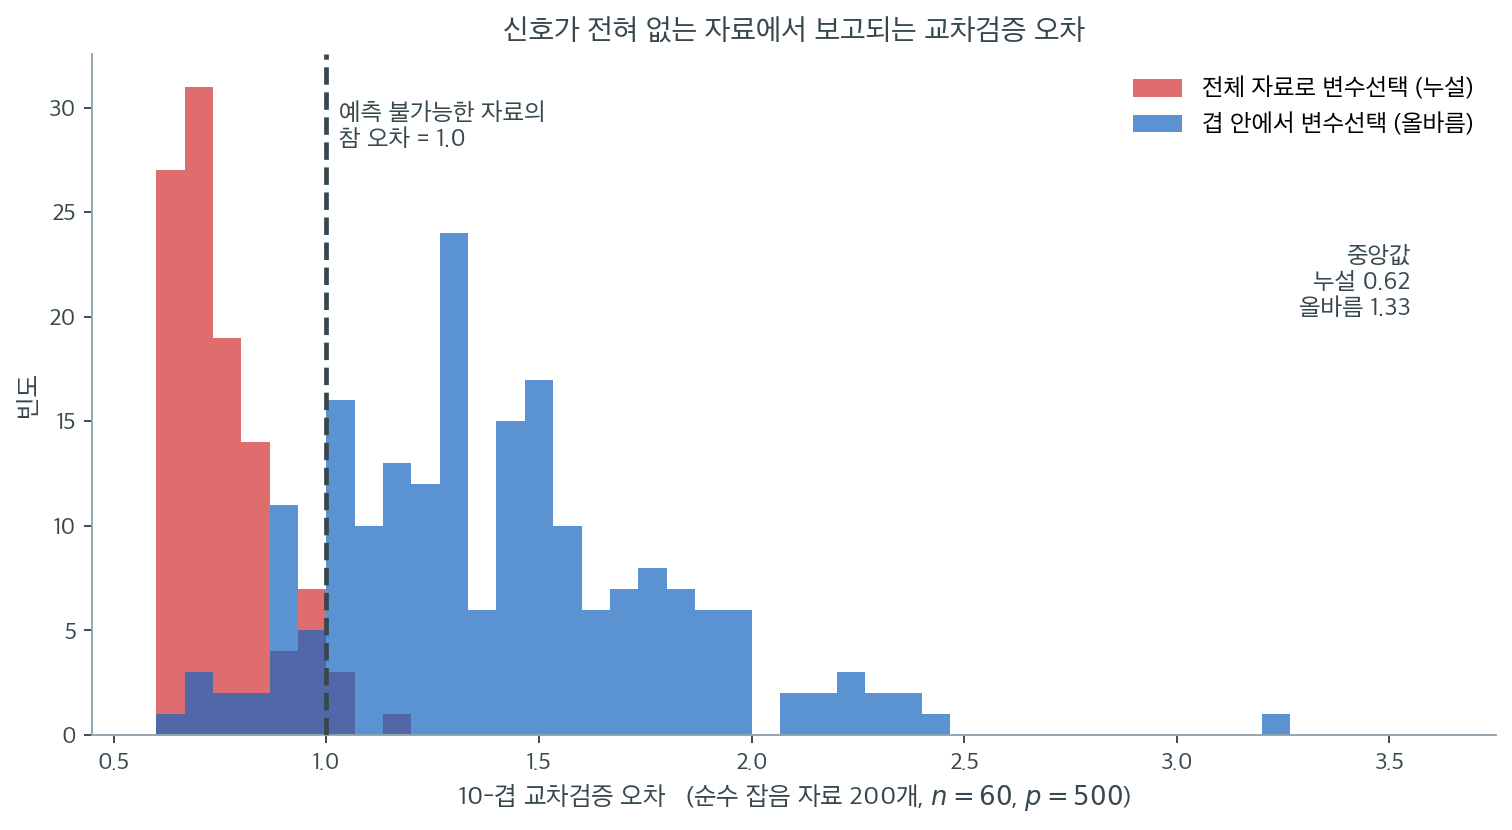
이 경고가 과장인지 확인하는 가장 확실한 방법은 신호가 아예 없는 자료에 두 절차를 돌려 보는 것이다. \(n = 60\), \(p = 500\)인 순수 난수 자료를 200개 만들었다. \(\mathbf{y}\)는 \(\mathbf{X}\)와 아무 관계가 없으므로 어떤 모형도 예측할 수 없고, 정직한 교차검증 오차는 \(\text{Var}(y) = 1\) 근처여야 한다. 검은 점선이 그 기준선이다.
파란 분포가 각 겹 안에서 변수 10개를 고른 올바른 절차다. 중앙값이 \(1.335\)로 기준선보다 크다. 당연한 결과다. 예측할 것이 없는데 모수 10개를 추정했으니 그만큼 손해를 본다. 올바른 교차검증은 "이 모형은 아무것도 안 하는 것보다 나쁘다"고 정확히 보고한다.
빨간 분포는 전체 자료로 변수 10개를 먼저 고른 뒤 교차검증한 결과다. 중앙값 \(0.62\)로 200개 중 196개(98%)가 기준선 아래에 놓인다. 예측이 원리적으로 불가능한 자료에서 "잡음 수준의 60%밖에 안 되는 오차"를 보고하는 것이다. 실제로 이 그림은 두 분포가 거의 겹치지 않는다. 누설된 절차의 최댓값이 \(1.19\)인데 올바른 절차의 최솟값이 \(0.65\)다.
무슨 일이 벌어졌는지는 간단하다. 500개 중 \(\mathbf{y}\)와 우연히 가장 강하게 상관된 10개를 고르는 데 전체 \(\mathbf{y}\)를 썼다. 검정 겹의 \(y\) 값도 그 선택에 참여했으므로, 검정 겹은 더 이상 "본 적 없는 자료"가 아니다. 규칙은 하나다. \(\mathbf{y}\)를 보는 모든 단계가 겹 안에 있어야 한다. 변수선택, 변수변환, 결측값 대체, 이상값 제거, 초모수 조정이 모두 여기 포함된다.
K의 선택
| \(K\) | 편향 | 분산 | 계산 |
|---|---|---|---|
| \(K = 5\) | 중간(비관적) | 낮음 | 빠름 |
| \(K = 10\) | 더 낮음 | 중간 | 중간 |
| \(K = n\) (LOOCV) | 거의 불편 | 클 수 있음 | 비쌈(지름길이 없으면) |
가장 흔한 선택은 \(K = 5\)와 \(K = 10\)이다. 능형회귀에는 LOOCV의 닫힌 형태 지름길이 있지만 라쏘에는 없다.
엘라스틱넷의 2차원 교차검증
- \(\alpha\)의 격자를 고정한다(예: \(\{0.1, 0.25, 0.5, 0.75, 0.9, 1.0\}\)).
- 각 \(\alpha\)에 대해 \(\lambda\) 격자에서 \(K\)-겹 CV를 수행한다.
- CV 오차가 가장 낮은 \((\lambda, \alpha)\) 쌍을 고른다.
또는 영역 지식으로 \(\alpha\)를 고정하고 \(\lambda\)만 최적화한다.
연습문제
연습문제 1. \(\lambda_{\min}\)과 \(\lambda_{1\text{SE}}\)가 고르는 모형의 복잡도를 비교하고, 참 모형과 견주어 보라. 참 변수 5개와 잡음변수 15개가 있는 자료(\(n = 100\))에서 라쏘로 10-겹 교차검증을 하라.
풀이
import numpy as np
from sklearn.linear_model import Lasso, lasso_path
from sklearn.model_selection import KFold
rng = np.random.default_rng(55)

n, p = 100, 20
X = rng.normal(size=(n, p)); X -= X.mean(0); X /= X.std(0)
beta = np.zeros(p); beta[:5] = [3, -2, 1.5, 1, -1]
y = X @ beta + rng.normal(0, 1, n); y -= y.mean()

alphas, coefs, _ = lasso_path(X, y, n_alphas=80)   # alphas는 내림차순
kf = KFold(10, shuffle=True, random_state=0)
mu, se = [], []
for a in alphas:
    e = [((y[te] - X[te] @ Lasso(alpha=a, fit_intercept=False,
          max_iter=50000).fit(X[tr], y[tr]).coef_)**2).mean()
         for tr, te in kf.split(X)]
    mu.append(np.mean(e)); se.append(np.std(e, ddof=1)/np.sqrt(10))
mu, se = np.array(mu), np.array(se)
i = mu.argmin()
j = np.where(mu <= mu[i] + se[i])[0].min()   # 내림차순이므로 최소 인덱스가 최대 lambda
| 규칙 | \(\lambda\) | 선택된 변수 수 | CV 오차 |
|---|---|---|---|
| \(\lambda_{\min}\) | 0.0800 | 12 | 1.216 (SE 0.176) |
| \(\lambda_{1\text{SE}}\) | 0.1757 | 9 | 1.386 |
| 참값 | — | 5 | — |
두 규칙 모두 참 변수 수를 넘게 고른다. \(\lambda_{1\text{SE}}\)가 12개에서 9개로 줄이지만 여전히 5개보다 많다.
이것이 라쏘의 알려진 성질이다. 예측을 최적화하는 \(\lambda\)는 변수선택을 최적화하는 \(\lambda\)보다 작다. 예측 관점에서는 작은 계수를 조금이라도 살려 두는 편이 유리하지만, 그 결과 잡음변수가 딸려 들어온다.
alphas가 내림차순이라는 점에 주의하라. np.where(...)[0].max()를 쓰면 가장 작은 \(\lambda\)를 고르게 되어 1-SE 규칙이 정반대로 작동한다. 실제로 그렇게 하면 \(\lambda = 0.0034\), 변수 20개가 나온다.
표준오차 \(0.176\)이 CV 오차 \(1.216\)의 14%라는 점도 중요하다. CV 추정 자체가 그만큼 불안정하므로 최솟값을 곧이곧대로 믿지 않는 것이 합리적이다.
연습문제 2. 자료 누설이 CV 오차를 얼마나 낙관적으로 만드는지 확인하라. 반응변수가 설명변수와 아무 관계도 없는 순수 잡음 자료(\(n = 60\), \(p = 500\))에서, 변수선택을 (a) 전체 자료로 미리 하는 경우와 (b) 각 겹 안에서 하는 경우를 비교하라.
풀이
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import KFold
rng = np.random.default_rng(1)
X = rng.normal(size=(60, 500))
y = rng.normal(size=60)                    # y 는 X 와 완전히 무관하다

def cv(leak, k=10):
    kf = KFold(10, shuffle=True, random_state=0); errs = []
    if leak:
        s = np.argsort(-np.abs(X.T @ y))[:k]        # 전체 자료로 선택
    for tr, te in kf.split(X):
        idx = s if leak else np.argsort(-np.abs(X[tr].T @ y[tr]))[:k]
        m = LinearRegression().fit(X[tr][:, idx], y[tr])
        errs.append(((y[te] - m.predict(X[te][:, idx]))**2).mean())
    return np.mean(errs)
| 절차 | CV 오차 |
|---|---|
| 전체 자료로 변수선택 후 교차검증 (누설) | 1.053 |
| 각 겹 안에서 변수선택 (올바름) | 2.268 |
| 참 오차(예측 불가능하므로 \(\text{Var}(y) = 1\)) | 1.000 |
누설된 절차는 CV 오차 \(1.05\)를 보고한다. 이는 이론적 최선인 \(1.0\)에 거의 도달한 값으로, "모형이 완벽하게 작동한다"는 결론을 낳는다.
그러나 \(y\)는 \(X\)와 완전히 무관한 난수다. 예측 가능한 신호가 조금도 없다. 올바른 절차는 \(2.27\)을 보고하여, 이 모형이 아무것도 안 하는 것보다 두 배 이상 나쁘다고 정확히 말한다.
무슨 일이 일어났는가. \(p = 500\)개 중 \(y\)와 우연히 가장 강하게 상관된 10개를 전체 자료에서 골랐다. 그 상관은 순전히 우연이지만, 검정 겹의 \(y\)도 그 선택에 이미 쓰였다. 검정 자료가 훈련 과정에 새어 들어간 것이다.
이것이 실무에서 가장 자주 일어나는 치명적 오류다
전형적인 형태는 다음과 같다.
- 전체 자료로 상관이 높은 변수 \(k\)개를 고른다.
- 그 변수들로 교차검증을 한다.
- 훌륭한 CV 성능을 보고한다.
- 새 자료에서 완전히 실패한다.
올바른 규칙은 단순하다. \(y\)를 보는 모든 단계는 겹 안에 있어야 한다. 변수선택, 변수변환, 결측값 대체, 이상값 제거, 초모수 조정이 모두 포함된다.
scikit-learn에서는 Pipeline으로 전처리를 묶고 그 파이프라인 전체를 cross_val_score에 넘기면 이 규칙이 자동으로 지켜진다.
표준화만 누설시키는 경우는 영향이 훨씬 작다(이 자료에서 \(1.224\) 대 \(1.209\)로 차이가 잡음 수준이다). 위험한 것은 \(y\)를 사용하는 단계이며, 표준화는 \(X\)만 쓰므로 상대적으로 무해하다. 그럼에도 원칙을 지키는 편이 안전하다.
정리하며
교차검증은 떼어 둔 겹을 돌아가며 검정오차를 추정하여 \(\lambda\) 선택의 자료 기반 방법을 제공한다. 최소 CV 오차가 \(\lambda_{\min}\)을, 1-표준오차 규칙이 더 간결한 \(\lambda_{1\text{SE}}\)를 정한다. 실무 구현에는 \(\lambda_{\max}\)에서 시작하는 로그 격자, 자료 누설을 피하는 겹 내부 표준화, 계산 효율을 위한 온기 시작이 필요하다.