좌표하강 알고리즘
라쏘 목적함수는 볼록이지만 L1 벌점 \(\lambda\|\boldsymbol{\beta}\|_1\) 때문에 매끄럽지 않다. 표준 경사하강법은 미분 가능한 목적함수를 요구하므로 직접 적용할 수 없다. 좌표하강은 나머지를 고정한 채 계수를 하나씩 최적화하여 이 어려움을 피한다. 각 단일좌표 부분문제가 연성 문턱 연산자로 주어지는 닫힌 형태 해를 가지므로 알고리즘이 단순하면서도 효율적이다.
좌표하강의 착상
\(p\)개 계수를 동시에 최적화하는 대신, 좌표하강은 계수를 하나씩 순회한다. 각 단계에서 다른 계수를 현재 값에 고정한 채 \(\beta_j\) 하나에 대해 목적함수를 최소화한다.
전체 목적함수는
이다. \(\beta_j\)를 제외한 모든 좌표를 고정하면 \(k \neq j\)인 항은 상수가 된다. \(j\)번째 설명변수를 뺀 부분잔차를
로 정의하면 \(\beta_j\)에 대한 부분문제는
이 된다.
단일좌표 갱신
제곱항을 전개하고 상수를 무시하며, 설명변수가 \(\|\mathbf{x}_j\|^2 = n\)이 되도록 표준화되었다고 가정하자.
는 부분잔차를 \(j\)번째 설명변수에 회귀시킨 단순회귀 계수다. 부분문제는
로 줄어들고, 해는 \(z_j\)에 연성 문턱을 적용한 값이다.
전체 알고리즘
입력: 자료 \((\mathbf{X}, \mathbf{y})\), 정칙화 모수 \(\lambda\), 수렴 허용오차 \(\epsilon\).
- 초기화. \(\hat{\boldsymbol{\beta}}^{(0)} = \mathbf{0}\)으로 둔다(\(p < n\)이면 OLS 해로 두어도 된다).
- 순회. 수렴할 때까지 \(t = 1, 2, \ldots\)에 대해, 각 \(j = 1, \ldots, p\)에서 부분잔차와 \(z_j\)를 계산하고 \(\hat{\beta}_j \leftarrow S_\lambda(z_j)\)로 갱신한다.
- 수렴 판정. \(\max_j |\hat{\beta}_j^{(t)} - \hat{\beta}_j^{(t-1)}| < \epsilon\)이면 멈춘다.
잔차의 효율적 갱신
매 단계에서 \(\mathbf{r}^{(j)}\)를 처음부터 다시 계산하지 말고, 실행 잔차 \(\mathbf{r} = \mathbf{y} - \mathbf{X}\hat{\boldsymbol{\beta}}\)를 유지하며 증분 갱신한다. \(\beta_j\)를 갱신하기 전에 옛 기여를 되돌리고(\(\mathbf{r} \leftarrow \mathbf{r} + \mathbf{x}_j\hat{\beta}_j^{\text{old}}\)), 갱신 후 새 기여를 뺀다(\(\mathbf{r} \leftarrow \mathbf{r} - \mathbf{x}_j\hat{\beta}_j^{\text{new}}\)). 좌표당 비용이 \(O(np)\)에서 \(O(n)\)으로 줄어든다.
수렴 성질
좌표하강은 다음 이유로 라쏘의 전역 최적해로 수렴한다.
- 볼록성. 목적함수가 볼록 이차항과 볼록 L1 항의 합이다.
- 비매끄러운 항의 분리성. L1 벌점 \(\sum_j |\beta_j|\)이 좌표별로 분리되므로 \(\partial_{\beta_j}\|\boldsymbol{\beta}\|_1 = \partial|\beta_j|\)가 다른 좌표에 의존하지 않는다.
- 블록 좌표하강 정리. 비매끄러운 부분이 분리 가능한 볼록 목적함수에서 순환 좌표하강은 전역 최소점으로 수렴한다(Tseng, 2001).
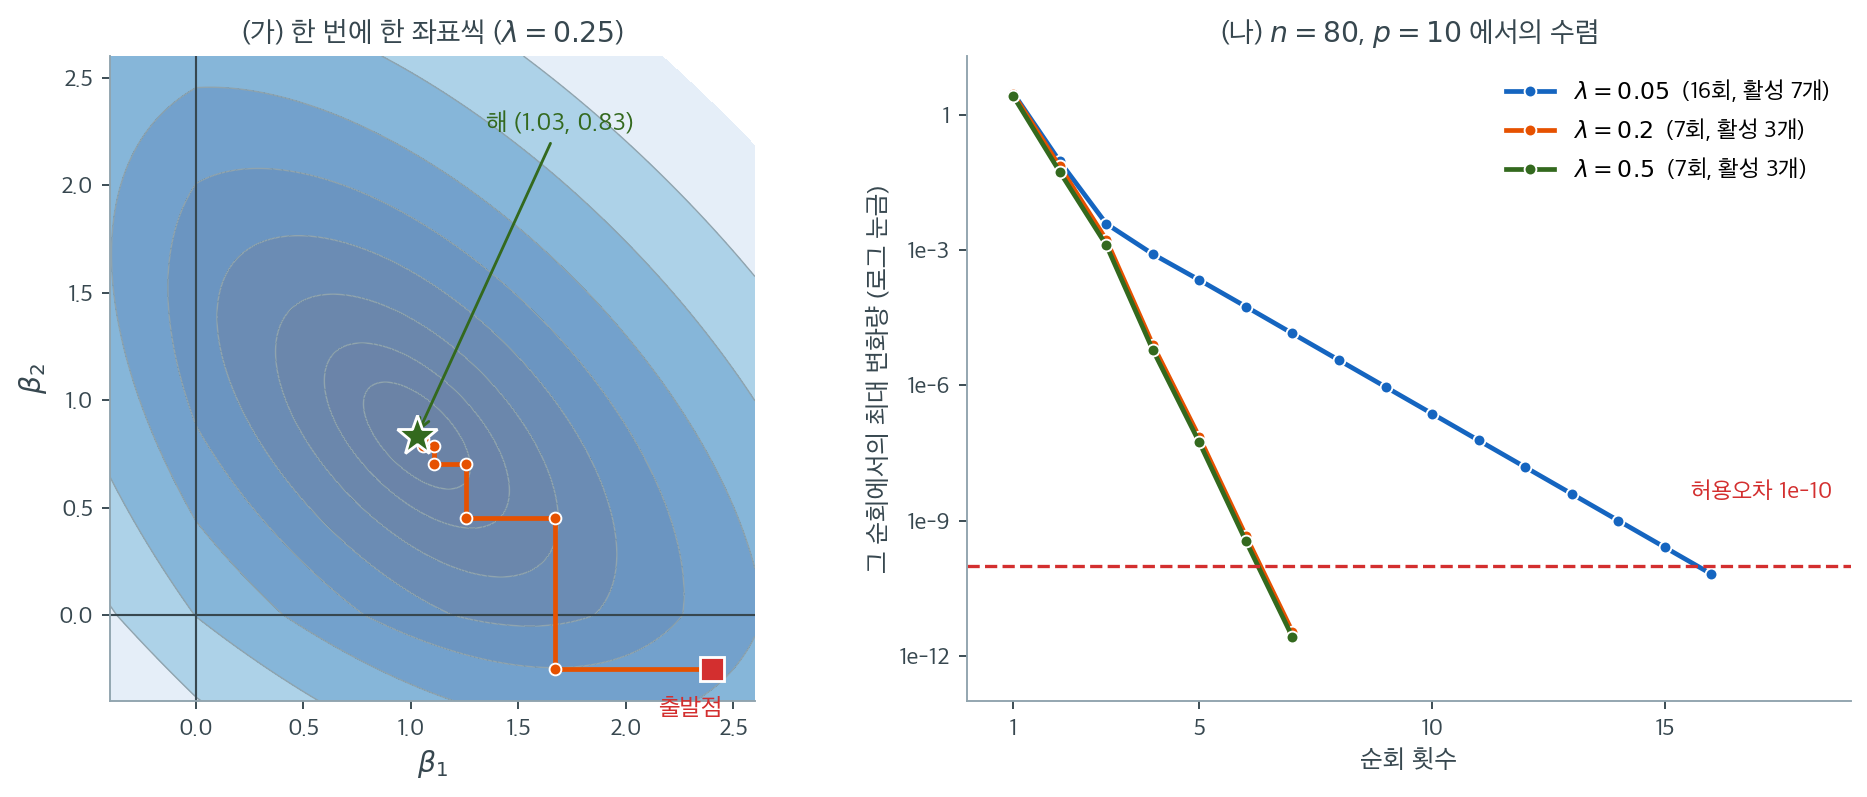
왼쪽은 설명변수 두 개짜리 문제에서 알고리즘이 실제로 밟는 경로다. 색이 진할수록 목적함숫값이 작고, 별이 최적해 \((1.03,\ 0.83)\)이다. 경로가 가로와 세로로만 움직인다는 점을 보라. 한 번에 한 좌표만 갱신하므로 다른 좌표는 그대로 있고, 따라서 모든 이동이 축과 나란하다. 경사하강법이라면 등고선의 수직 방향으로 비스듬히 갔을 자리다.
이 계단 경로가 왜 멈추지 않고 최적해로 가는지도 그림에서 읽을 수 있다. 각 이동은 그 좌표 방향에서 목적함수를 정확히 최소화하므로 값이 절대 올라가지 않는다. 목적함수가 볼록이고 아래로 유계이니 값의 수열이 수렴하고, L1 항이 좌표별로 분리되어 있어 "모든 좌표 방향에서 더 내려갈 곳이 없다"가 곧 "전역 최적"이 된다. 분리되지 않는 벌점에서 이 논증이 깨진다는 것이 위 주석의 요지다.
오른쪽은 \(n = 80\), \(p = 10\)인 문제에서 순회마다 계수가 얼마나 움직였는지를 로그 눈금으로 추적한 것이다. 세 곡선 모두 직선이다. 로그 눈금에서 직선은 곱셈적 감소, 곧 선형수렴을 뜻한다. 한 순회마다 오차가 일정 비율로 줄어든다.
기울기가 \(\lambda\)에 따라 다르다는 점이 실무적으로 중요하다. \(\lambda = 0.2\)와 \(\lambda = 0.5\)는 일곱 번의 순회로 \(10^{-10}\)에 닿는데 \(\lambda = 0.05\)는 열여섯 번이 걸린다. 이유는 범례에 함께 적어 두었다. 벌점이 약하면 활성 변수가 일곱 개로 늘어나 실제로 최적화할 좌표가 많아지고, 벌점이 강하면 세 개뿐이다. 강한 벌점에서 시작해 \(\lambda\)를 조금씩 낮추며 직전 해를 초기값으로 쓰는 온기 시작이 유리한 이유가 여기 있다. 매번 이미 거의 맞는 답에서 출발하므로 한두 번의 순회로 끝난다.
분리되지 않는 벌점
그룹 라쏘 \(\sum_g \|\boldsymbol{\beta}_g\|_2\)처럼 분리되지 않는 벌점에서는 좌표하강의 수렴이 보장되지 않는다. L2 노름이 그룹 내 계수를 결합시키기 때문이다. 이런 벌점에는 개별 좌표가 아니라 그룹을 갱신하는 블록 좌표하강이 필요하다.
온기 시작과 해 경로
실무에서 라쏘는 \(\lambda_{\max}\)에서 그 작은 배수까지 이어지는 격자 위에서 푼다. 온기 시작은 \(\lambda_m\)의 해를 \(\lambda_{m+1}\)의 초기점으로 쓴다. 인접한 \(\lambda\)가 비슷한 해를 내므로 필요한 반복 횟수가 크게 줄어든다.
온기 시작을 쓴 좌표하강으로 전체 정칙화 경로를 계산하는 비용은 단일 \(\lambda\)에서 처음부터 푸는 것과 비슷하다. 이 효율성이 좌표하강이 라쏘의 표준 알고리즘이 된 주된 이유다.
계산 복잡도
| 연산 | 비용 |
|---|---|
| 한 좌표 갱신 | \(O(n)\) |
| 한 번의 전체 순회 | \(O(np)\) |
| 수렴까지 (보통 10–100회 순회) | \(O(np \times \text{반복})\) |
| 전체 경로 (\(M\)개 \(\lambda\), 온기 시작) | \(O(Mnp)\), 상수가 작다 |
\(p\)가 크고 해가 희소하면 활성집합 전략으로 계산을 더 줄일 수 있다. 현재 0이 아니거나 곧 0이 아니게 될 후보만 갱신하는 방식이다.
엘라스틱넷으로의 확장
좌표하강 틀은 엘라스틱넷으로 자연스럽게 확장된다. 단일좌표 갱신은
가 된다. 분모 \(1 + (1-\alpha)\lambda\)가 L2 벌점을, 분자의 연성 문턱이 L1 벌점을 담당한다. \(\alpha\)를 바꾸는 것만으로 같은 알고리즘이 능형, 라쏘, 엘라스틱넷을 모두 처리한다.
연습문제
연습문제 1.
좌표하강을 직접 구현하고 sklearn.linear_model.Lasso와 일치하는지, 몇 번의 순회로 수렴하는지 확인하라.
풀이
import numpy as np
from sklearn.linear_model import Lasso

def soft(z, l):
    return np.sign(z) * np.maximum(np.abs(z) - l, 0)

def cd_lasso(X, y, lam, tol=1e-10, maxit=10000):
    n, p = X.shape
    b = np.zeros(p); r = y.copy()          # 실행 잔차
    for it in range(maxit):
        mx = 0.0
        for j in range(p):
            r += X[:, j]*b[j]              # 옛 기여를 되돌린다
            z = X[:, j] @ r / n
            nb = soft(z, lam)
            mx = max(mx, abs(nb - b[j])); b[j] = nb
            r -= X[:, j]*b[j]              # 새 기여를 뺀다
        if mx < tol:
            return b, it + 1
    return b, maxit

rng = np.random.default_rng(4)
n, p = 80, 10
X = rng.normal(size=(n, p)); X -= X.mean(0); X /= X.std(0)
beta = np.zeros(p); beta[:3] = [3, -2, 1.5]
y = X @ beta + rng.normal(0, 1, n); y -= y.mean()
| \(\lambda\) | 수렴까지 순회 | \(\max_j\lvert\hat\beta_j^{\text{mine}} - \hat\beta_j^{\text{sklearn}}\rvert\) | 0이 아닌 계수 |
|---|---|---|---|
| 0.05 | 16 | \(2.2\times10^{-11}\) | 7 |
| 0.20 | 7 | \(2.4\times10^{-14}\) | 3 |
| 0.50 | 7 | \(8.9\times10^{-16}\) | 3 |
20줄짜리 구현이 sklearn과 기계 정밀도까지 일치한다.
두 가지를 읽어야 한다.
첫째, 수렴이 매우 빠르다. \(\lambda = 0.2\)에서 7번의 순회면 충분하다. 각 순회가 \(O(np) = 800\)번의 연산이므로 전체가 \(5{,}600\)번의 곱셈이다. 이것이 라쏘가 \(p\)가 수만인 문제에서도 실용적인 이유다.
둘째, \(\lambda\)가 클수록 빨리 수렴한다. \(\lambda = 0.05\)에서 16회, \(\lambda = 0.5\)에서 7회다. 벌점이 강하면 활성집합이 작아 실질적으로 최적화할 좌표가 몇 개뿐이기 때문이다. 온기 시작으로 큰 \(\lambda\)부터 내려오는 전략이 효과적인 이유가 여기에 있다.
연습문제 2. \(\|\mathbf{x}_j\|^2 = n\)이라는 표준화 가정을 빼면 갱신식이 어떻게 바뀌는가?
풀이
표준화하지 않으면 부분문제의 이차항 계수가 \(\|\mathbf{x}_j\|^2/n\)이 되어
이고, 해는
가 된다. 즉 연성 문턱을 적용한 뒤 \(\|\mathbf{x}_j\|^2/n\)으로 나눈다.
이 식이 왜 문제인가. 분자의 문턱 \(\lambda\)는 모든 \(j\)에 대해 같은데 분모는 변수마다 다르다. 척도가 큰 변수(\(\|\mathbf{x}_j\|\)가 큰 변수)는 \(z_j\)도 커지므로 문턱을 넘기 쉽다.
구체적으로, 어떤 변수의 단위를 미터에서 킬로미터로 바꾸면 그 열이 \(1000\)배가 되고 \(z_j\)도 \(1000\)배가 되어 거의 확실히 선택된다. 벌점이 계수의 크기를 벌하는데, 계수의 크기는 변수의 단위에 의존하기 때문이다.
따라서 라쏘(그리고 능형, 엘라스틱넷)에서 표준화는 선택이 아니라 필수다. sklearn은 이를 자동으로 하지 않으므로 StandardScaler를 파이프라인에 넣어야 한다. glmnet은 기본적으로 표준화한 뒤 계수를 원래 척도로 되돌려 준다.
정리하며
좌표하강은 좌표를 순회하며 각각에 연성 문턱 연산자를 적용해 라쏘를 푼다. 좌표당 \(O(n)\)으로 효율적이고, 분리 가능한 비매끄러운 벌점에서 전역 최적해로의 수렴이 보장되며, 전체 정칙화 경로 계산을 위한 온기 시작을 자연스럽게 수용한다. 이 단순함과 효율성 덕분에 glmnet과 scikit-learn 같은 널리 쓰이는 패키지의 표준 알고리즘이 되었다.