확률질량함수, 확률밀도함수, 누적분포함수
앞의 두 절에서 분포를 적는 방법을 두 가지 배웠다. 이산이면 확률질량함수, 연속이면 확률밀도함수다. 둘은 성격이 달라 함께 쓰기 불편하다. 하나는 확률이고 하나는 밀도이며, 하나는 더하고 하나는 적분한다.
두 세계를 하나로 묶는 함수가 있다. 누적분포함수 \(F(x) = P(X \le x)\)다. 이산이든 연속이든 똑같이 정의되고, 이것 하나로 분포가 완전히 결정된다. 그리고 이 함수를 뒤집으면 분위수가 나오고, 분위수에서 난수 생성이 나온다.
이 절은 세 개의 정리로 이루어진다. 누적분포함수의 정의와 성질(정리 1), 확률밀도함수와의 미적분 관계(정리 2), 그리고 역함수인 분위수함수와 그 응용(정리 3)이다.
1. 왼쪽부터 무게를 쌓아 나간다
확률질량함수와 확률밀도함수는 "그 지점에" 무게가 얼마인지를 말한다. 누적분포함수는 "그 지점까지" 쌓인 무게가 얼마인지를 말한다. 이 작은 차이가 두 세계를 통일한다.
정리 1. 누적분포함수 — 왼쪽부터 쌓은 총 무게
확률변수 \(X\)의 누적분포함수(CDF) 는
이며 다음 성질을 갖는다.
- \(F\)는 비감소다.
- \(\displaystyle\lim_{x \to -\infty} F(x) = 0\), \(\displaystyle\lim_{x \to +\infty} F(x) = 1\)
- \(F\)는 오른쪽 연속이다.
벽돌 비유로 말하면 \(F(x)\)는 \(-\infty\)부터 \(x\)까지 쌓인 모든 벽돌의 총 무게다. 왼쪽 끝에서는 아무것도 없어 0이고, 오른쪽 끝에서는 전부 쌓여 1이다. 무게가 음수일 수 없으므로 결코 줄어들지 않는다.
이산과 연속의 차이는 모양으로 나타난다. 이산이면 벽돌이 있는 곳에서 계단처럼 뛰고, 연속이면 매끄럽게 오른다. 뛰는 높이가 그 점의 확률이므로, 연속확률변수에서 \(F\)가 연속이라는 사실이 곧 \(P(X = a) = 0\)이다.
분포를 완전히 결정한다. \(F\)를 알면 어떤 구간의 확률이든 계산할 수 있다.
확률질량함수와 확률밀도함수는 각각 이산과 연속에서만 쓸 수 있지만, 누적분포함수는 언제나 존재하고 언제나 통한다. 그래서 이론적 논의에서는 \(F\)를 기본 대상으로 삼는 경우가 많다.
2. 밀도와 누적은 미적분으로 이어져 있다
연속인 경우 두 함수는 서로를 완전히 결정한다. 하나를 알면 다른 하나는 미분하거나 적분해서 얻는다.
정리 2. 미분과 적분 — 확률밀도함수와 누적분포함수의 왕복
\(X\)가 연속확률변수이고 \(f\)가 연속이면
이다. 적분이 밀도에서 누적으로 가고, 미분이 누적에서 밀도로 돌아온다.
보기 1. 확률밀도함수와 누적분포함수의 관계. 표준정규분포의 밀도 \(\varphi\) 와 분포함수 \(\Phi\) 를 나란히 그리고 둘을 잇는 화살표를 가운데 놓는다.
(1) 오른쪽 \(\Phi\) 의 기울기가 가장 가파른 곳은 어디이고 그 기울기는 얼마인가. 그 값은 왼쪽 그림의 무엇인가. \(x = 3\) 에서는 얼마인가.
(2) 두 칸의 세로축이 모두 \([0, 1]\) 로 그려져 있다. 밀도의 세로축은 확률이 아닌데 그래도 괜찮은가. 어떤 분포에서 이 설정이 그림을 망가뜨리는가.
풀이
(1) 정리 2 가 그대로 답이다. \(\Phi'(x) = \varphi(x)\) 이므로 분포함수의 기울기가 곧 밀도의 높이다. 표준정규 밀도는 \(x = 0\) 에서 최대이고 그 값이
이므로 \(\Phi\) 도 \(x = 0\) 에서 가장 가파르며 기울기가 \(0.3989\) 다. 아무리 가파른 자리에서도 \(x\) 가 \(1\) 늘 때 누적확률은 \(0.4\) 밖에 오르지 못한다. 꼬리로 가면 급격히 평평해진다.
\(x = 3\) 에서의 기울기는 꼭짓점의 \(1/90\) 이니 그림에서는 수평선과 구별되지 않는다.
반대 방향도 읽을 수 있다. 왼쪽 그림에서 \([-1, 1]\) 구간의 밀도 아래 넓이가 오른쪽 그림에서 \(\Phi\) 가 그 구간에서 오른 높이와 같다.
왼쪽의 넓이가 오른쪽의 높이다. 가운데 화살표 두 개가 가리키는 것이 이 관계다.
(2) 지금 그림에서는 괜찮지만 일반적으로는 아니다. 밀도의 세로축은 확률이 아니라 단위 길이당 확률이다. 단위가 \(1/x\) 이므로 \(1\) 을 넘어도 아무 문제가 없고, 넘는 일이 흔하다. 정규밀도의 최댓값은
이므로 \(\sigma < 1/\sqrt{2\pi} = 0.3989\) 이면 꼭짓점이 \(1\) 을 넘는다. \(\sigma = 0.2\) 이면 \(1.9947\) 이라 세로축을 \([0,1]\) 로 잘라 놓은 이 코드에서는 봉우리가 통째로 잘려 나간다. \(\text{Uniform}(0, 0.5)\) 는 더 단순해서 밀도가 \(x\) 전체에서 \(2\) 다.
그러니 \([0,1]\) 이라는 설정은 표준정규라서 우연히 들어맞은 것이고, 두 칸의 세로축을 맞춰 둔 것도 눈으로 견주기 좋으라는 편의일 뿐이다. 오른쪽의 \([0,1]\) 은 다르다. 분포함수는 확률이므로 어떤 분포에서도 \([0,1]\) 을 벗어날 수 없다.
(3) 수치적으로. 차분으로 \(\Phi\) 의 기울기를 재어 밀도와 맞춰 본다.
import matplotlib.pyplot as plt
import numpy as np
import scipy.stats as stats

# 왼쪽에 PDF, 오른쪽에 CDF, 가운데에는 둘의 관계를 나타내는 화살표를 놓는다.
fig, (ax_pdf, ax_arrow, ax_cdf) = plt.subplots(1, 3, figsize=(12, 3))

x = np.linspace(-3, 3, 100)

# 왼쪽: 확률밀도함수. 각 점에서 확률이 얼마나 빽빽한지를 나타낸다.
ax_pdf.set_title("PDF", fontsize=16)
ax_pdf.plot(x, stats.norm().pdf(x))

# 가운데: 두 함수를 잇는 연산.
#   PDF -> CDF 는 적분 (왼쪽에서 여기까지의 넓이를 쌓는다)
#   CDF -> PDF 는 미분 (누적이 늘어나는 속도가 곧 밀도다)
ax_arrow.arrow(0.1, 0.6, 0.8, 0, width=0.05, length_includes_head=True)
ax_arrow.arrow(0.9, 0.4, -0.8, 0, width=0.05, length_includes_head=True)
ax_arrow.annotate("Integrate", (0.38, 0.75), fontsize=14)
ax_arrow.annotate("Differentiate", (0.30, 0.2), fontsize=14)
for spine in ax_arrow.spines.values():
    spine.set_visible(False)
ax_arrow.set_xticks([])
ax_arrow.set_yticks([])

# CDF
ax_cdf.set_title("CDF", fontsize=16)
ax_cdf.plot(x, stats.norm().cdf(x))

for ax in (ax_pdf, ax_cdf):
    ax.set_ylim(0, 1)
plt.tight_layout()
plt.show()

# 그림에서 읽을 수치. F'(x) = f(x) 이므로 CDF 의 기울기가 곧 PDF 의 높이다.
nd = stats.norm()
print(f"{'x':>5}{'f(x) = F 의 기울기':>18}{'F(x)':>10}")
for v in (0.0, 1.0, 2.0, 3.0):
    print(f"{v:>5.1f}{nd.pdf(v):>18.6f}{nd.cdf(v):>10.6f}")

# 차분으로 기울기를 재어 밀도와 맞춰 본다.
h = 1e-5
for v in (0.0, 1.0, 3.0):
    slope = (nd.cdf(v + h) - nd.cdf(v - h)) / (2 * h)
    print(f"  x={v:.1f}:  (F(x+h)-F(x-h))/2h = {slope:.8f},  f(x) = {nd.pdf(v):.8f}")

print(f"\n[-1, 1] 에서 밀도 아래 넓이 = F(1) - F(-1) = {nd.cdf(1) - nd.cdf(-1):.6f}")
print(f"  같은 구간에서 CDF 가 오른 높이도 {nd.cdf(1) - nd.cdf(-1):.6f}")

# 세로축을 [0, 1] 로 잘라도 되는가. 분산이 작아지면 밀도가 1 을 넘는다.
print(f"\n밀도의 최댓값 1/(sigma*sqrt(2pi))")
for s in (1.0, 0.5, 0.2):
    print(f"  sigma = {s}:  {1 / (s * np.sqrt(2 * np.pi)):.6f}")
출력:
    x    f(x) = F 의 기울기      F(x)
  0.0          0.398942  0.500000
  1.0          0.241971  0.841345
  2.0          0.053991  0.977250
  3.0          0.004432  0.998650
  x=0.0:  (F(x+h)-F(x-h))/2h = 0.39894228,  f(x) = 0.39894228
  x=1.0:  (F(x+h)-F(x-h))/2h = 0.24197072,  f(x) = 0.24197072
  x=3.0:  (F(x+h)-F(x-h))/2h = 0.00443185,  f(x) = 0.00443185

[-1, 1] 에서 밀도 아래 넓이 = F(1) - F(-1) = 0.682689
  같은 구간에서 CDF 가 오른 높이도 0.682689

밀도의 최댓값 1/(sigma*sqrt(2pi))
  sigma = 1.0:  0.398942
  sigma = 0.5:  0.797885
  sigma = 0.2:  1.994711
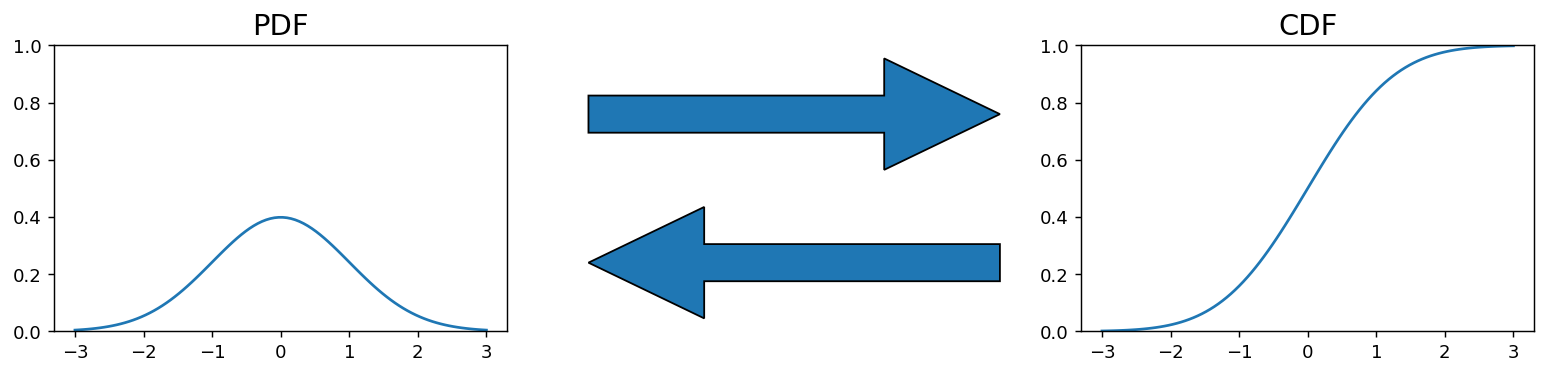
차분으로 잰 기울기가 밀도와 소수 여덟째 자리까지 같다. \(x = 0\) 에서 \(0.39894228\), \(x = 3\) 에서 \(0.00443185\) 다. 넓이와 높이도 \(0.682689\) 로 같다.
두 그림을 눈으로 견주면 같은 이야기가 보인다. 밀도가 가장 높은 \(0\) 부근에서 분포함수의 기울기가 가장 가파르고, 밀도가 \(0\) 에 가까운 양 끝에서는 분포함수가 거의 평평하다. 다만 왼쪽 곡선의 꼭짓점이 세로축 \([0,1]\) 안에서 \(0.4\) 쯤에 머물러 있다는 점은 눈에 담아 두는 것이 좋다. 봉우리가 낮아 보이는 것은 분포의 성질이 아니라 \(\sigma = 1\) 이라는 설정 때문이다.
보기 2. 정규분포에서 구간의 확률. \(X \sim N(50, 10^2)\)일 때 \(P(40 \le X \le 60)\)은 \(F(60) - F(40)\)이다.
풀이
from scipy import stats

mean, std_dev = 50, 10

# P(40 ≤ X ≤ 60) for X ~ N(50, 10²)
prob = stats.norm(mean, std_dev).cdf(60) - stats.norm(mean, std_dev).cdf(40)
print(f"P(40 ≤ X ≤ 60) = {prob * 100:.2f}%")

# P(X ≤ 55)
prob_55 = stats.norm(mean, std_dev).cdf(55)
print(f"P(X ≤ 55) = {prob_55 * 100:.2f}%")
출력:
P(40 ≤ X ≤ 60) = 68.27%
P(X ≤ 55) = 69.15%
3. 누적분포함수를 뒤집으면 분위수가 나온다
지금까지는 "값을 주면 확률을 돌려주는" 방향이었다. 실무에서는 반대 방향이 더 자주 필요하다. "확률 95%에 해당하는 값은 얼마인가?"
정리 3. 분위수함수 — 누적분포함수의 역함수
분위수함수(PPF) 는 누적분포함수의 역함수다.
하한(inf)으로 정의하는 이유는 \(F\)가 계단이거나 평평한 구간이 있어 엄밀한 역함수가 없을 수 있기 때문이다. 연속이고 순증가하는 \(F\)에서는 보통의 역함수와 같다.
이 함수가 통계학 전체에서 쓰이는 곳이 신뢰구간과 임계값이다.
보기 3. 분위수함수는 누적분포함수의 역함수. 표준정규분포에서 \(z_{0.95} = 1.6449\) 와 \(z_{0.975} = 1.9600\) 을 구한다.
(1) 95% 신뢰구간에 \(1.645\) 가 아니라 \(1.96\) 이 쓰인다. 두 수가 각각 어떤 꼬리확률에 대응하며, \(1.645\) 로 만든 양쪽 구간은 몇 %인가.
(2) \(\Phi\) 에는 닫힌 꼴 역함수가 없다. 그런데도 \(1.96\) 을 어떻게 얻는가. \(z_{0.975}\) 가 만족해야 하는 식을 적고 이분법으로 직접 풀어 확인하시오.
풀이
(1) 한쪽 꼬리와 양쪽 꼬리의 차이다. 정의대로 읽으면 \(z_p\) 는 \(\Phi(z_p) = p\) 를 만족하는 수이므로
다. 신뢰구간은 \([-z, z]\) 꼴이라 양쪽 꼬리를 함께 잘라 내므로
을 쓴다. 여기에 넣어 보면
이다. \(1.645\) 로 만든 양쪽 구간은 95%가 아니라 90%다. \(1.645\) 가 95%와 짝이 되는 것은 단측검정처럼 한쪽만 자를 때뿐이다. 두 수를 섞어 쓰면 신뢰수준이 \(90\%\) 와 \(95\%\) 사이에서 소리 없이 바뀐다.
(2) 수치로 푼다. \(\Phi\) 는 초등함수로 적히지 않으므로 그 역함수도 공식이 없다. 구하려는 것은 방정식
의 해이고, 대칭성 \(\Phi(-z) = 1 - \Phi(z)\) 를 쓰면 같은 조건이 \(\Phi(-z) = 0.025\) 로도 적힌다. 즉 양쪽 꼬리가 \(0.025\) 씩 똑같이 잘린다.
\(\Phi\) 가 순증가 연속함수이므로 해가 하나뿐이고 이분법이 반드시 수렴한다. \(\Phi(0) = 0.5 < 0.975\) 이고 \(\Phi(4) = 0.99997 > 0.975\) 이니 \([0, 4]\) 에서 출발하면 되고, 구간이 한 단계마다 절반으로 줄므로 \(k\) 단계 뒤 오차가 \(4/2^k\) 이하다. 열 자리를 맞추려면 \(4/2^k < 10^{-10}\), 곧 \(k > 35\) 단계면 충분하다.
참값은 \(z_{0.975} = 1.9599639845\) 이고, 흔히 쓰는 \(1.96\) 은 그것을 반올림한 것이다. 그 차이가 얼마나 되는지도 재 둘 만하다.
\(1.96\) 을 쓰면 신뢰수준이 \(95\%\) 가 아니라 \(95.00042\%\) 다. 넷째 자리 밖의 일이라 실무에서는 아무 문제가 없다.
(3) 수치적으로.
import scipy.stats as stats

z_95 = stats.norm(0, 1).ppf(0.95)
print(f"95th percentile of N(0,1): {z_95:.4f}")

z_975 = stats.norm(0, 1).ppf(0.975)
print(f"97.5th percentile of N(0,1): {z_975:.4f}")

# 두 수가 각각 어떤 꼬리를 자르는지 확인한다.
nd = stats.norm()
print(f"\n{'z':>10}{'P(Z > z)':>12}{'P(|Z| <= z)':>14}")
for z in (z_95, z_975, 1.96):
    print(f"{z:>10.6f}{nd.sf(z):>12.6f}{2 * nd.cdf(z) - 1:>14.6f}")

# ppf 에 닫힌 꼴이 없으므로 수치로 푼다. 이분법으로 Phi(z) = 0.975 를 푼다.
lo, hi = 0.0, 4.0
print(f"\n이분법으로 Phi(z) = 0.975 를 푼다")
for step in range(1, 41):
    mid = (lo + hi) / 2
    if nd.cdf(mid) < 0.975:
        lo = mid
    else:
        hi = mid
    if step in (5, 10, 20, 40):
        print(f"  {step:>2}단계:  z = {mid:.10f}")
print(f"  scipy 의 ppf = {z_975:.10f}")
출력:
95th percentile of N(0,1): 1.6449
97.5th percentile of N(0,1): 1.9600

         z    P(Z > z)   P(|Z| <= z)
  1.644854    0.050000      0.900000
  1.959964    0.025000      0.950000
  1.960000    0.024998      0.950004

이분법으로 Phi(z) = 0.975 를 푼다
   5단계:  z = 1.8750000000
  10단계:  z = 1.9570312500
  20단계:  z = 1.9599647522
  40단계:  z = 1.9599639845
  scipy 의 ppf = 1.9599639845
꼬리확률 표가 (1) 을 그대로 확인한다. \(1.644854\) 는 한쪽 꼬리 \(0.05\), 양쪽 구간 \(0.90\) 이고 \(1.959964\) 는 한쪽 꼬리 \(0.025\), 양쪽 구간 \(0.95\) 다. 반올림한 \(1.96\) 은 \(0.950004\) 로 참값보다 \(0.0000042\) 넓다.
이분법도 예상대로 간다. 다섯 단계에서 \(1.875\), 열 단계에서 \(1.957\), 스무 단계에서 \(1.9599648\), 마흔 단계에서 \(1.9599639845\) 로 scipy 의 ppf 와 열 자리까지 같다. 한 단계마다 자릿수가 약 \(0.3\) 개씩 늘어난다(\(\log_{10} 2 = 0.301\)). 실제 라이브러리는 이분법보다 훨씬 빠른 유리함수 근사를 쓰지만, 원리는 "닫힌 꼴이 없으니 방정식을 푼다" 로 같다.
\(1.96\) 이라는 익숙한 수가 여기서 나온다. 8장의 95% 신뢰구간에 등장하는 그 값이다.
보기 4. 분위수함수를 그림으로 보기. 표준정규 분포함수를 그리고 \(u = 0.975\) 와 그에 대응하는 \(z = 1.960\) 을 각각 세로축과 가로축에 붉은 점으로 찍는다.
(1) \(u\) 를 \(0.975\) 에서 \(0.990\) 으로 \(0.015\) 만큼 올리면 \(z\) 는 얼마나 움직이는가. 같은 \(0.015\) 를 한가운데인 \(u = 0.5\) 에서 올리면 얼마나 움직이는가.
(2) 두 답이 크게 다른 까닭을 정리 2·3 으로 설명하시오. 분위수함수의 기울기를 밀도로 적을 수 있는가.
풀이
(1) 꼬리에서 훨씬 많이 움직인다. 값을 구하면
이다. 같은 \(0.015\) 인데 꼬리 쪽이 열 배 가까이 멀리 간다.
(2) 분위수함수의 기울기가 밀도의 역수이기 때문이다. \(F^{-1}\) 은 \(F\) 의 역함수이므로 역함수 미분법을 쓴다. \(z = F^{-1}(p)\) 라 두면 \(F(z) = p\) 이고 양변을 \(p\) 로 미분하면 \(F'(z)\,\dfrac{dz}{dp} = 1\) 이다. 정리 2 가 \(F' = f\) 를 주므로
이다. 밀도가 두꺼운 곳에서는 분위수가 천천히 움직이고 밀도가 얇은 꼬리에서는 빠르게 달아난다. 값을 넣으면
이다. \(p = 0.5\) 근처에서는 기울기 \(2.5066\) 이 거의 일정하므로 \(2.5066 \times 0.015 = 0.0376\) 으로 (1) 의 답이 바로 나온다. 꼬리 쪽은 기울기 자체가 \(17.11\) 에서 \(37.52\) 로 두 배 넘게 커지므로 한 점의 기울기로는 모자라고, 평균 기울기를 쓰면 \(25 \times 0.015 = 0.375\) 로 실제 \(0.366\) 에 가깝다.
그래서 극단 분위수는 추정하기 어렵다. \(p\) 를 \(0.999\) 까지 밀면 기울기가 \(297\) 이다. 누적확률을 \(0.001\) 만 잘못 잡아도 분위수가 \(0.3\) 이나 틀어진다는 뜻이고, 꼬리 쪽 위험을 다룰 때마다 되풀이되는 어려움이 이것이다.
(3) 수치적으로.
import matplotlib.pyplot as plt
import numpy as np
import scipy.stats as stats

fig, ax = plt.subplots(figsize=(12, 3))
ax.set_xlim(-3, 3)
ax.set_ylim(-0.2, 1.1)

# CDF 곡선
x = np.linspace(-3, 3, 100)
ax.plot(x, stats.norm().cdf(x), label='CDF')

# CDF와 PPF는 서로 역함수다.
#   CDF: 값 z 를 넣으면 누적확률 u 가 나온다      (가로 -> 세로)
#   PPF: 누적확률 u 를 넣으면 값 z 가 나온다      (세로 -> 가로)
# 아래 두 점이 같은 (z, u) 쌍을 축마다 표시한 것이다.
u = 0.975
z = stats.norm().ppf(u)      # 표준정규분포의 97.5 백분위수. 그 유명한 1.96이다.

ax.plot(0, u, 'or', markersize=8)
ax.plot(z, 0, 'or', markersize=8)
ax.annotate(f"U = {u}", (-1.2, u + 0.02), fontsize=14)
ax.annotate(f"Z = {z:.3f}", (z - 0.3, -0.12), fontsize=14)
ax.annotate("PPF →", (0.3, u + 0.03), fontsize=14)
ax.annotate("↓ CDF", (z + 0.1, 0.5), fontsize=14)

ax.spines[['right', 'top']].set_visible(False)
ax.spines['left'].set_position('zero')
ax.spines['bottom'].set_position('zero')
ax.legend(fontsize=14)
plt.show()

# 왕복이 제자리로 돌아오는지 확인한다.
nd = stats.norm()
print(f"F(F^-1(u)) = {nd.cdf(nd.ppf(u)):.10f}   (u = {u})")
print(f"F^-1(F(z)) = {nd.ppf(nd.cdf(z)):.10f}   (z = {z:.6f})")

# 분위수함수의 기울기는 밀도의 역수다.  (F^-1)'(p) = 1 / f(F^-1(p))
print(f"\n{'p':>8}{'z = F^-1(p)':>14}{'f(z)':>12}{'1/f(z)':>12}")
for p in (0.5, 0.975, 0.99, 0.999):
    zp = nd.ppf(p)
    print(f"{p:>8.3f}{zp:>14.6f}{nd.pdf(zp):>12.6f}{1 / nd.pdf(zp):>12.4f}")

# 같은 폭 0.015 를 가운데와 꼬리에서 각각 움직여 본다.
print(f"\n같은 Delta u = 0.015 가 z 를 얼마나 움직이는가")
for p in (0.500, 0.975):
    dz = nd.ppf(p + 0.015) - nd.ppf(p)
    print(f"  p: {p:.3f} -> {p + 0.015:.3f}   Delta z = {dz:.6f}")
출력:
F(F^-1(u)) = 0.9750000000   (u = 0.975)
F^-1(F(z)) = 1.9599639845   (z = 1.959964)

       p   z = F^-1(p)        f(z)      1/f(z)
   0.500      0.000000    0.398942      2.5066
   0.975      1.959964    0.058445     17.1101
   0.990      2.326348    0.026652     37.5204
   0.999      3.090232    0.003367    296.9924

같은 Delta u = 0.015 가 z 를 얼마나 움직이는가
  p: 0.500 -> 0.515   Delta z = 0.037608
  p: 0.975 -> 0.990   Delta z = 0.366384
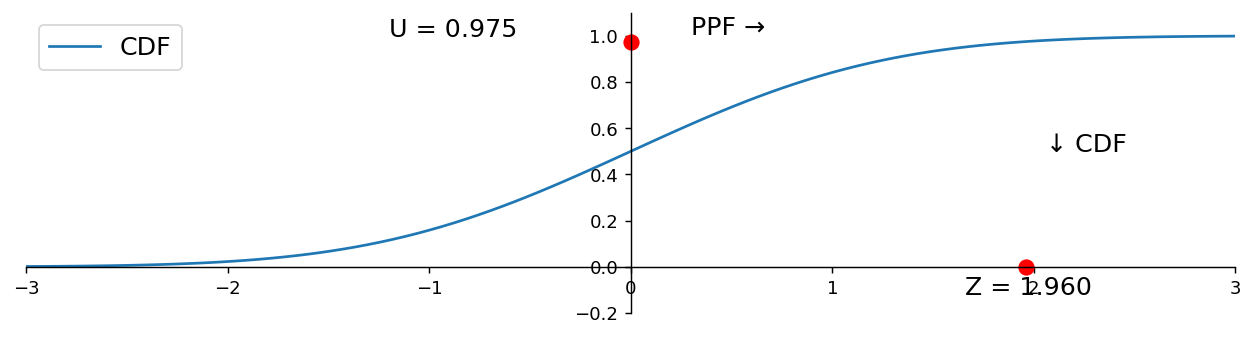
왕복이 제자리로 돌아온다. \(F(F^{-1}(0.975)) = 0.975\) 이고 \(F^{-1}(F(1.959964)) = 1.959964\) 로 열 자리까지 같다. 기울기 표의 \(2.5066\), \(17.1101\), \(37.5204\), \(296.9924\) 가 유도한 \(1/\varphi(z)\) 와 맞고, \(\Delta u = 0.015\) 에 대한 이동 \(0.037608\) 과 \(0.366384\) 도 (1) 과 같다.
그림에서 읽을 것은 두 붉은 점이 같은 하나의 쌍이라는 점이다. 세로축의 점 \(U = 0.975\) 에서 오른쪽으로 가 곡선을 만나고 아래로 내려오면 가로축의 점 \(Z = 1.960\) 에 닿는다. 그 길이 분위수함수이고, 거꾸로 가로축에서 올라가 왼쪽으로 가는 길이 분포함수다. 같은 곡선을 어느 축에서 출발해 읽느냐의 차이일 뿐이다.
곡선의 모양도 (2) 와 맞는다. \(u = 0.975\) 언저리에서 곡선이 거의 수평이라 세로로 조금만 올라가도 가로로 크게 움직여야 곡선을 만난다. 가운데에서는 곡선이 가파르므로 같은 세로 이동에 가로 이동이 작다.
역변환 표집: 균등난수 하나로 어떤 분포든 만든다
분위수함수에는 아름다운 응용이 하나 있다. \(U \sim \text{Uniform}(0,1)\)일 때
로 두면 \(X\)의 누적분포함수가 정확히 \(F\)가 된다. 균등난수만 만들 수 있으면 어떤 분포의 난수든 만들 수 있다는 뜻이다.
증명은 한 줄이다. \(P(X \le x) = P(F^{-1}(U) \le x) = P(U \le F(x)) = F(x)\). 마지막 등식은 \(U\)가 \([0,1]\) 균등분포이기 때문이다.
이것이 역변환 표집이며, 난수 생성기의 기본 원리다. 4장 균등분포에서 다시 다룬다.
보기 5. 역변환 표집으로 정규 표본 만들기. \(U \sim \text{Uniform}(0,1)\) 에서 \(10{,}000\) 개를 뽑아 \(Z = \Phi^{-1}(U)\) 로 옮긴다.
(1) 위 상자의 한 줄 증명 \(P(X \le x) = P(F^{-1}(U) \le x) = P(U \le F(x)) = F(x)\) 에서 가운데 등식이 무엇을 요구하는지 짚으시오. \(F\) 에 계단(점질량)이 있어도 성립하는가.
(2) 만들어 낸 표본이 정말 \(N(0,1)\) 인지 평균·표준편차·분위수로 확인하시오. 어느 정도 차이는 정상인가.
풀이
(1) 가운데 등식은 두 부등식이 같은 사건이라는 주장이다. 곧
를 쓴 것이다. \(F\) 가 순증가 연속이면 양변에 \(F\) 나 \(F^{-1}\) 을 씌워 곧바로 나온다. 그런데 정리 3 처럼 \(F^{-1}(u) = \inf\{x : F(x) \ge u\}\) 로 정의하면 \(F\) 가 어떤 모양이든 이 동치가 성립한다. \(F\) 가 오른쪽 연속이라 하한이 실제로 달성되기 때문이다.
- \(F\) 에 평평한 구간이 있으면 그 구간에는 확률이 없고, \(F^{-1}\) 은 그 구간의 왼쪽 끝만 돌려준다. 그런 \(u\) 는 한 점뿐이라 확률 \(0\) 이다.
- \(F\) 에 계단이 있으면, 곧 \(a\) 에서 크기 \(p\) 만큼 뛰면, \(F^{-1}\) 은 길이 \(p\) 짜리 \(u\) 구간 전체를 \(a\) 로 보낸다. 그러므로 \(P(X = a) = p\) 가 정확히 재현된다.
그러므로 역변환 표집은 연속분포뿐 아니라 이산분포에도 그대로 통한다. 아래 코드에서 \(P(X=0)=0.5\), \(P(X=1)=0.3\), \(P(X=2)=0.2\) 인 분포를 같은 균등난수로 만들어 확인한다.
(2) 흔들림의 크기를 먼저 적는다. \(n = 10^4\) 이므로
이고, 표본 \(p\) 분위수의 표준오차는
다. 분모에 밀도가 들어가는 것이 보기 4 에서 본 \((F^{-1})' = 1/f\) 와 같은 사정이다. \(p = 0.5\) 에서는 \(0.0125\), \(p = 0.05\) 와 \(0.95\) 에서는 \(0.0211\) 로 꼬리 쪽 분위수가 더 흔들린다. 각 값이 자기 표준오차의 두세 배 안에 들어오면 정상이다.
(3) 수치적으로.
import matplotlib.pyplot as plt
import numpy as np
import scipy.stats as stats

np.random.seed(0)

# 역변환 표집: 균등난수만 있으면 어떤 분포든 만들어 낼 수 있다.
# 1단계 — 0과 1 사이 균등난수를 뽑는다. 이것이 "누적확률"에 해당한다.
u = stats.uniform().rvs(10_000)

# 2단계 — 그 누적확률에 대응하는 값을 PPF로 되찾는다.
# U ~ Uniform(0,1) 이면 F^{-1}(U) 는 정확히 F를 분포함수로 갖는다.
z = stats.norm().ppf(u)

plt.figure(figsize=(12, 3))
plt.hist(z, bins=100, density=True, alpha=0.7, label='Inverse Transform Samples')
x = np.linspace(-4, 4, 200)
# 만들어 낸 표본의 히스토그램이 참 정규 밀도와 겹치는지 확인한다
plt.plot(x, stats.norm().pdf(x), 'r--', lw=2, label='N(0,1) PDF')
plt.legend()
plt.show()

# 만들어 낸 표본이 정말 N(0,1) 인지 수로 확인한다.
n = len(z)
nd = stats.norm()
print(f"표본 {n}개")
print(f"  평균     {z.mean():+.4f}  (이론 0,  SE {1 / np.sqrt(n):.4f},"
      f"  z = {z.mean() * np.sqrt(n):+.2f})")
print(f"  표준편차 {z.std(ddof=1):.4f}  (이론 1,  SE {1 / np.sqrt(2 * n):.4f},"
      f"  z = {(z.std(ddof=1) - 1) * np.sqrt(2 * n):+.2f})")

print(f"\n{'p':>7}{'표본 분위수':>12}{'이론':>10}{'SE':>9}{'z':>8}")
for p in (0.05, 0.25, 0.5, 0.75, 0.95):
    q_hat, q = np.quantile(z, p), nd.ppf(p)
    se = np.sqrt(p * (1 - p) / n) / nd.pdf(q)
    print(f"{p:>7.2f}{q_hat:>12.4f}{q:>10.4f}{se:>9.4f}{(q_hat - q) / se:>8.2f}")

ks = stats.kstest(z, "norm")
print(f"\n콜모고로프-스미르노프  D = {ks.statistic:.5f},  p = {ks.pvalue:.4f}")

# F 에 계단(점질량)이 있어도 같은 방법이 통한다.
# P(X=0)=0.5, P(X=1)=0.3, P(X=2)=0.2 인 분포를 균등난수로 만들어 본다.
probs = np.array([0.5, 0.3, 0.2])
cuts = np.cumsum(probs)                  # F 의 계단 높이 0.5, 0.8, 1.0
x_disc = np.searchsorted(cuts, u)        # F^{-1}(u) = inf{x : F(x) >= u}
print(f"\n점질량이 있는 F 에도 통한다")
for k in range(3):
    print(f"  P(X={k}): 모의 {np.mean(x_disc == k):.4f}   참값 {probs[k]:.4f}"
          f"   SE {np.sqrt(probs[k] * (1 - probs[k]) / n):.4f}")
출력:
표본 10000개
  평균     -0.0145  (이론 0,  SE 0.0100,  z = -1.45)
  표준편차 1.0078  (이론 1,  SE 0.0071,  z = +1.11)

      p      표본 분위수        이론       SE       z
   0.05     -1.6715   -1.6449   0.0211   -1.26
   0.25     -0.6893   -0.6745   0.0136   -1.09
   0.50     -0.0163    0.0000   0.0125   -1.30
   0.75      0.6691    0.6745   0.0136   -0.39
   0.95      1.6373    1.6449   0.0211   -0.36

콜모고로프-스미르노프  D = 0.00814,  p = 0.5195

점질량이 있는 F 에도 통한다
  P(X=0): 모의 0.5064   참값 0.5000   SE 0.0050
  P(X=1): 모의 0.2964   참값 0.3000   SE 0.0046
  P(X=2): 모의 0.1972   참값 0.2000   SE 0.0040
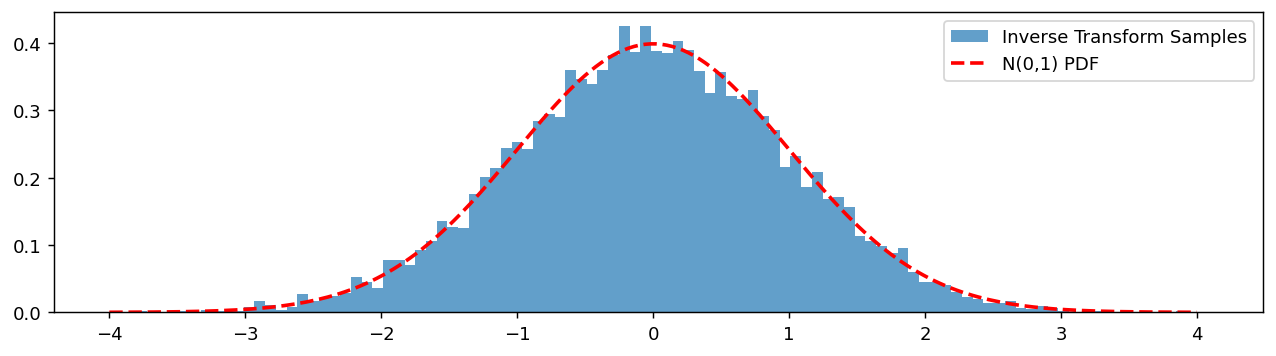
평균 \(-0.0145\) 가 \(-1.45\) 표준오차, 표준편차 \(1.0078\) 이 \(+1.11\) 표준오차다. 다섯 분위수도 \(z\) 가 \(-1.30\) 에서 \(-0.36\) 사이로 모두 두 표준오차 안이다. 다섯 개가 모두 음수 쪽으로 쏠린 것이 눈에 띄지만, 분위수들은 같은 표본에서 나왔으므로 서로 독립이 아니고 평균이 \(-0.0145\) 로 조금 낮은 것이 다섯 곳에 함께 나타난 것이다. 분포 전체를 한 번에 보는 콜모고로프-스미르노프 검정이 \(D = 0.00814\), \(p = 0.52\) 로 아무 이상이 없다고 말한다.
점질량이 있는 분포도 \(0.5064\), \(0.2964\), \(0.1972\) 로 참값 \(0.5\), \(0.3\), \(0.2\) 와 각각 \(1.3\), \(0.8\), \(0.7\) 표준오차 안이다. 같은 균등난수 하나로 연속분포와 이산분포를 둘 다 만들어 냈다.
그림에서는 \(100\) 칸 히스토그램이 붉은 점선 밀도를 따라간다. 칸마다 평균 \(100\) 개가 들어가므로 높이의 상대오차가 \(10\%\) 쯤 되고, 실제로 봉우리 근처에서 그만큼 들쭉날쭉하다. 히스토그램이 울퉁불퉁한 것은 표집이 잘못되어서가 아니라 칸을 잘게 나눈 대가다.
자료에서 추정하기. 실무에서는 참 분포를 모르므로 자료에서 추정한다. 히스토그램이 확률밀도함수의 추정값이고, 경험적 누적분포함수가 누적분포함수의 추정값이다. 2장의 탐색적 자료분석에서 이미 만난 두 그림이 여기서 이론적 대응물을 얻는다.
보기 6. 경험적 밀도와 경험적 분포함수. 표준정규에서 \(200\) 개를 뽑아 히스토그램과 그 누적을 한 그림에 그리고, 이론 분포함수를 겹친다.
(1) 히스토그램과 분포함수를 한 세로축에 겹쳐 그렸다. 두 곡선의 세로축 단위가 다른데 그래도 괜찮은가. 무엇을 읽어도 되고 무엇을 읽으면 안 되는가.
(2) 코드가 그린 계단이 참 경험적 분포함수에서 반 칸 옆으로 어긋나 있다. 왜 그런가. 어긋남의 크기는 얼마인가.
풀이
닫힌 꼴로 유도할 답이 있는 보기가 아니다. \(200\) 개의 표본에서 무엇이 읽히고 무엇이 읽히지 않는가, 그리고 그린 방식이 무엇을 비틀었는가가 이 보기의 전부다.
(1) 단위는 다르지만 겹쳐 놓아도 된다. 히스토그램의 세로축은 밀도라 단위가 \(1/x\) 이고, 분포함수의 세로축은 확률이라 단위가 없다. 섞어 놓은 축에서 읽어도 되는 것과 안 되는 것이 갈린다.
읽어도 되는 것은 두 곡선 각각의 모양이다. 히스토그램에서는 중심이 어디쯤이고 꼬리가 어느 쪽으로 긴지를, 계단에서는 누적이 어디서 빨리 오르는지를 본다. 그리고 보기 1 에서 본 관계 — 히스토그램이 높은 곳에서 계단이 가파르다 — 가 눈으로 확인된다.
읽으면 안 되는 것은 두 곡선의 높이를 서로 견주는 일이다. 히스토그램 막대가 \(0.56\) 이고 계단이 그 자리에서 \(0.5\) 라고 해서 둘이 비슷한 양이라는 뜻이 전혀 아니다. 막대 높이는 구간 폭 \(0.267\) 을 곱해야 확률이 되므로 그 칸의 확률은 \(0.56 \times 0.267 = 0.15\) 다. 또 하나, 히스토그램의 최고 높이 \(0.5618\) 이 이론 최댓값 \(\varphi(0) = 0.3989\) 보다 크다고 놀랄 일이 아니다. \(200\) 개를 \(20\) 칸에 나누면 칸마다 평균 \(10\) 개뿐이라 높이가 크게 튄다.
(2) 계단을 그리는 방식 때문이다. np.cumsum(counts) / np.sum(counts) 가 주는 \(i\) 번째 값은 "\(i\) 번째 구간의 오른쪽 끝까지 쌓인 비율" 이므로, 그 값을 bin_edges[1:](오른쪽 끝들)에 짝지은 것까지는 정확하다. 문제는 where='mid' 다. 이 설정은 계단의 모서리를 이웃한 두 \(x\) 의 중간에 놓으므로, 값이 오른쪽 끝이 아니라 그보다 반 칸 왼쪽에서 이미 올라가 버린다.
구간 폭이 \((2.720 - (-2.620))/20 = 0.267\) 이므로 어긋남은
이다. 증가함수를 왼쪽으로 밀면 위로 올라가므로, 그림의 주황 계단은 참 경험적 분포함수보다 체계적으로 높게 그려져 있다. where='post' 로 바꾸면 모서리가 오른쪽 끝에 와 정확해진다.
값 자체는 맞다는 점을 짚어 둔다. 아래 출력에서 각 오른쪽 끝의 누적값이 그 점에서 직접 센 경험적 분포함수와 소수 넷째 자리까지 같다. 틀린 것은 수가 아니라 그 수를 어디에 찍었는가다.
(3) 수치적으로.
import matplotlib.pyplot as plt
import numpy as np
import scipy.stats as stats

np.random.seed(42)
data = stats.norm.rvs(size=200)      # 표준정규에서 200개

fig, ax = plt.subplots(figsize=(12, 4))

# 경험적 PDF: 히스토그램이 밀도함수의 표본 버전이다
counts, bin_edges, _ = ax.hist(data, bins=20, density=True, alpha=0.6, label="Empirical PDF")

# 경험적 CDF: 히스토그램의 도수를 왼쪽부터 누적하면 된다.
# "PDF를 적분하면 CDF"라는 관계를 이산 버전으로 실행한 것이다.
empirical_cdf = np.cumsum(counts) / np.sum(counts)
# 계단으로 그린다. 경험적 분포함수는 본래 계단함수이기 때문이다.
ax.step(bin_edges[1:], empirical_cdf, where='mid', label="Empirical CDF", lw=2)

# 이론적 CDF를 겹쳐 표본이 모집단을 얼마나 잘 따라가는지 본다
ax.plot(bin_edges, stats.norm.cdf(bin_edges), 'r', lw=2, label="Theoretical CDF")

ax.legend()
ax.spines[['right', 'top']].set_visible(False)
plt.show()

width = bin_edges[1] - bin_edges[0]
print(f"표본 {len(data)}개,  구간 폭 = {width:.4f},  범위 [{data.min():.3f}, {data.max():.3f}]")
print(f"히스토그램 최고 높이 = {counts.max():.4f}  (이론 최댓값 {1 / np.sqrt(2 * np.pi):.4f})")

# 계단의 값이 각 구간 오른쪽 끝에서의 경험적 분포함수와 같은지 확인한다.
print(f"\n{'오른쪽 끝':>10}{'누적':>9}{'참 ECDF':>10}{'이론 F':>10}")
for i in (4, 9, 14, 19):
    edge = bin_edges[i + 1]
    print(f"{edge:>10.4f}{empirical_cdf[i]:>9.4f}"
          f"{np.mean(data <= edge):>10.4f}{stats.norm.cdf(edge):>10.4f}")

# where='mid' 는 계단의 모서리를 오른쪽 끝이 아니라 그 반 칸 왼쪽에 놓는다.
print(f"\nwhere='mid' 가 계단을 옮기는 거리 = 반 칸 = {width / 2:.4f}")

# 경험적 분포함수와 이론 분포함수의 최대 거리(콜모고로프-스미르노프 통계량).
ks = stats.kstest(data, "norm")
print(f"\n경험적 F 와 이론 F 의 최대 거리  D = {ks.statistic:.5f},  p = {ks.pvalue:.4f}")
print(f"  n = {len(data)} 에서 5% 임계값 ~ 1.36/sqrt(n) = {1.36 / np.sqrt(len(data)):.5f}")
출력:
표본 200개,  구간 폭 = 0.2670,  범위 [-2.620, 2.720]
히스토그램 최고 높이 = 0.5618  (이론 최댓값 0.3989)

     오른쪽 끝       누적    참 ECDF      이론 F
   -1.2848   0.0900    0.0900    0.0994
    0.0502   0.5100    0.5100    0.5200
    1.3852   0.9200    0.9200    0.9170
    2.7202   1.0000    1.0000    0.9967

where='mid' 가 계단을 옮기는 거리 = 반 칸 = 0.1335

경험적 F 와 이론 F 의 최대 거리  D = 0.06500,  p = 0.3515
  n = 200 에서 5% 임계값 ~ 1.36/sqrt(n) = 0.09617
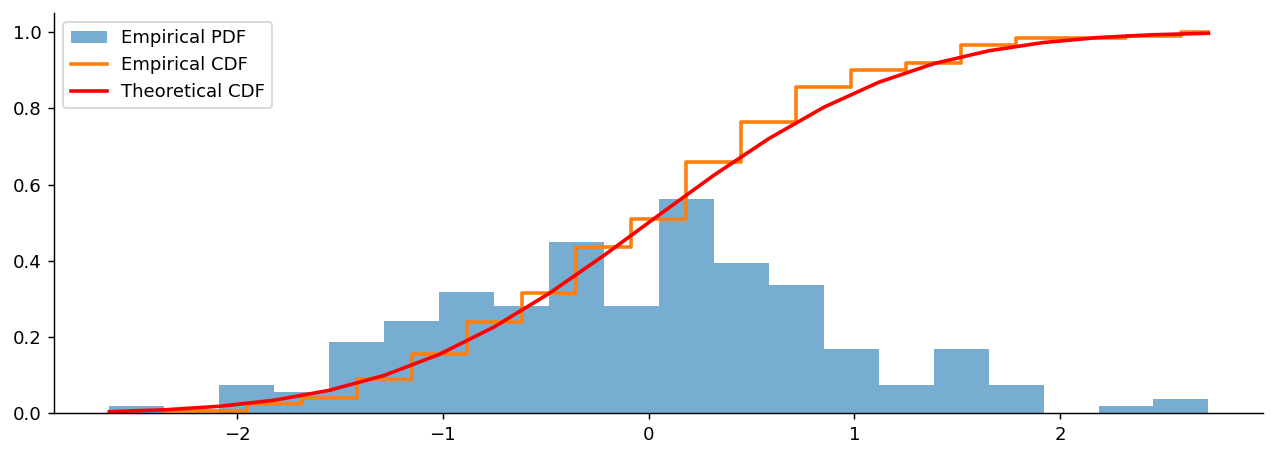
누적값이 참 경험적 분포함수와 네 자리까지 같다(\(0.0900\), \(0.5100\), \(0.9200\), \(1.0000\)). 이론값과도 \(0.0994\), \(0.5200\), \(0.9170\), \(0.9967\) 로 가깝다. 두 분포함수의 최대 거리는 \(D = 0.065\) 이고 \(n = 200\) 에서 5% 임계값 \(1.36/\sqrt{200} = 0.0962\) 보다 작아(\(p = 0.35\)) 표본이 \(N(0,1)\) 에서 나왔다는 데 아무 이상이 없다.
그림에서 읽을 것을 정리하면 이렇다. 붉은 곡선과 주황 계단이 전 구간에서 가까이 붙어 있고, 계단이 붉은 곡선보다 조금씩 위로 지나간다. 그 체계적인 쏠림이 (2) 의 반 칸 어긋남이지 표본의 성질이 아니다. 히스토그램 쪽은 \(0\) 근처가 가장 높고 양 끝으로 갈수록 낮아지지만, \(1.4\) 와 \(1.7\) 근처에 같은 높이의 막대가 둘 나란히 서는 등 곳곳이 울퉁불퉁하다. \(200\) 개로는 밀도의 모양을 이 정도까지밖에 볼 수 없다.
마지막으로 이 그림이 보여 주지 않는 것이 있다. 분포함수는 구간 폭을 고르지 않아도 그릴 수 있는데(관측값마다 \(1/n\) 씩 올리면 된다) 여기서는 히스토그램의 칸을 그대로 물려받아 \(20\) 계단으로 거칠어졌다. 참 경험적 분포함수는 \(200\) 계단이다. 밀도 추정은 칸 나누기가 필요하지만 분포함수 추정은 필요하지 않다는 차이가 이 그림에서는 가려져 있다.
scipy.stats 메서드 대응표. 이 절의 네 함수가 그대로 메서드 이름이 된다.
| 메서드 | 대응하는 개념 |
|---|---|
pdf / pmf |
확률밀도함수 / 확률질량함수 |
cdf |
누적분포함수 \(F(x) = P(X \le x)\) |
sf |
생존함수 \(1 - F(x) = P(X > x)\) |
ppf |
분위수함수 \(F^{-1}(p)\) |
rvs |
난수 표본 생성 |
연습문제
연습문제 1. \(X\) = 공정한 동전을 3번 던졌을 때 앞면의 개수. (a) 확률질량함수를 쓰라. (b) 누적분포함수를 쓰라. (c) \(P(1 \le X \le 2)\)를 두 가지 방법으로 계산하라.
풀이
(a) \(X \sim \mathrm{Binomial}(3, 1/2)\):
| \(x\) | \(p(x)\) |
|---|---|
| 0 | \(1/8\) |
| 1 | \(3/8\) |
| 2 | \(3/8\) |
| 3 | \(1/8\) |
(b) 구간 \((-\infty, 0), [0, 1), [1, 2), [2, 3), [3, \infty)\)에서 \(F(x) = 0, 1/8, 4/8, 7/8, 1\)이다.
(c) 확률질량함수로: \(p(1) + p(2) = 3/8 + 3/8 = 3/4\).
누적분포함수로: \(X\)가 정숫값을 가지므로 \(P(1 \le X \le 2) = F(2) - F(1^-) = F(2) - F(0) = 7/8 - 1/8 = 6/8 = 3/4\).
두 방법이 일치한다.
연습문제 2. \([0, 1]\)에서 확률밀도함수가 \(f(x) = c \cdot x^2\)이고 그 밖에서는 0인 연속확률변수 \(X\)에 대해 (a) \(c\)를 구하라. (b) \(F(x)\)를 계산하라. (c) \(P(0.3 < X < 0.7)\)을 구하라.
풀이
(a) \(\int_0^1 c x^2 \, dx = c/3 = 1\)이므로 \(c = 3\)이다.
(b) \(x \in [0, 1]\)에서 \(F(x) = \int_0^x 3 t^2 \, dt = x^3\)이고, \(x < 0\)이면 \(F(x) = 0\), \(x > 1\)이면 \(F(x) = 1\)이다.
(c) \(P(0.3 < X < 0.7) = F(0.7) - F(0.3) = 0.343 - 0.027 = 0.316\).
연습문제 3. 누적분포함수를 미분해 확률밀도함수 구하기. \(x \ge 0\)에서 \(F(x) = 1 - e^{-\lambda x}\)인 연속확률변수 \(X\)에 대해 확률밀도함수 \(f(x)\)를 계산하라. 이것은 어떤 분포인가?
풀이
\(x \ge 0\)에서 \(f(x) = F'(x) = \lambda e^{-\lambda x}\)이다.
이는 비율 \(\lambda\)인 지수분포다. 성질은 다음과 같다. - 평균 \(1/\lambda\), 분산 \(1/\lambda^2\). - 무기억성: \(P(X > s + t \mid X > s) = P(X > t)\). - 비율이 \(\lambda\)인 포아송 과정에서 사건 사이의 대기시간.
연습문제 4. 역변환 표집. \(U \sim \mathrm{Uniform}(0, 1)\)이고 \(F\)가 연속인 순증가 누적분포함수이면 \(X = F^{-1}(U)\)의 누적분포함수가 \(F\)임을 보여라.
풀이
\(P(X \le x) = P(F^{-1}(U) \le x)\)를 계산한다. 양변에 (증가함수라 부등호를 보존하는) \(F\)를 적용하면
이다. 여기서 가역인 \(F\)에 대해 \(F \circ F^{-1} = \mathrm{id}\)이고, 균등분포의 누적분포함수가 \(u \in [0, 1]\)에 대해 \(P(U \le u) = u\)라는 사실을 썼다.
따라서 \(X\)의 누적분포함수는 \(F\)다. \(\square\)
용도: \(F^{-1}\)을 아는 어떤 분포에서든 표본을 생성하려면 \(U\)를 균등하게 뽑아 \(F^{-1}\)을 적용하면 된다. 자명하지 않은 분포에 대해 여러 난수 생성 루틴이 내부적으로 이렇게 작동한다.
연습문제 5. 분위수, 백분위수, 분위수함수. 이 세 용어를 예를 들어 명확히 구분하라. 분위수함수와 생존함수의 관계를 진술하라.
풀이
분위수(quantile): \(p \in [0, 1]\)에 대해 \(p\)-분위수 \(q_p = F^{-1}(p)\)는 \(P(X \le q_p) = p\)가 되는 값이다. 분위수 = 분위수함수의 값.
백분위수(percentile): \(p \in [0, 100]\)에 대한 \(p\)-백분위수는 \(q_{p/100}\)이다. 단위 관례일 뿐이다. "95번째 백분위수"는 \(q_{0.95}\)를 뜻한다.
분위수함수(PPF): 역 누적분포함수 그 자체, 즉 \(\mathrm{PPF}(p) = F^{-1}(p)\).
생존함수: \(S(x) = 1 - F(x) = P(X > x)\). 역생존함수(ISF)는 "주어진 확률 질량이 그 위에 놓이는 값"을 준다: \(\mathrm{ISF}(p) = S^{-1}(p) = F^{-1}(1 - p) = \mathrm{PPF}(1 - p)\).
scipy.stats에서 dist.ppf(0.95)는 95번째 백분위수를 주고, dist.isf(0.05)는 위쪽 꼬리 확률이 5%인 값을 주는데 이는 95번째 백분위수와 같다. 꼬리 분위수를 계산할 때 ISF가 수치적 정밀도 손실을 피해 준다(\(1 - F\)가 0에 가까우면 정밀도가 나쁘므로 \(S\)를 직접 쓰는 편이 낫다).
연습문제 6. 이상적분. \(x \ge 2\)에서 \(f(x) = 1/(x \ln^2 x)\)을 확률밀도함수로 제안한다. 이것이 타당한 분포를 정의하는가? \(\mathbb{E}[X]\)를 계산하라.
풀이
정규화: \(\int_2^\infty \frac{1}{x \ln^2 x} dx\)를 계산한다. \(u = \ln x\), \(du = dx/x\)로 치환하면
이다. 따라서 \(f(x)\)는 정규화되어 있지 않다. \(c = \ln 2\)로 두고 \(f(x) = c/(x \ln^2 x)\)로 다시 정의하면 \(\int f = 1\)이 되어 타당한 확률밀도함수를 얻는다.
기댓값: \(\mathbb{E}[X] = \int_2^\infty x \cdot \frac{c}{x \ln^2 x} dx = c \int_2^\infty \frac{1}{\ln^2 x} dx\)이다.
피적분함수가 \(1/\ln^2 x\)처럼 감쇠하는데 이는 무한대에서 적분 가능하지 않다(적분이 발산한다). 따라서 \(\mathbb{E}[X] = \infty\)로, 이 분포는 정규화는 유한하지만 평균은 무한하다.
교훈: "타당한 분포"(누적분포함수의 성질이 성립함)는 "유한한 기댓값"보다 약한 요건이다. 이런 꼬리가 두꺼운 분포에는 평균 기반 요약 대신 분위수 기반 요약이 필요하다. 이것이 큰수의 법칙 절 연습문제 5의 주제였다. 평균이 무한한 분포는 큰수의 법칙을 깨뜨린다.
연습문제 7. 연습문제 \(4\)의 역변환 표집은 \(F\)가 연속인 순증가 함수일 때의 이야기였다. 이산분포나 도약이 있는 분포에서는 어떻게 하는가?
풀이
일반화 역함수를 쓴다.
\(F\)가 연속·순증가이면 보통의 역함수와 같고, 도약이나 평탄 구간이 있어도 잘 정의된다.
정리. \(U \sim \text{Uniform}(0,1)\)이면 \(X = F^{-}(U)\)의 분포함수가 \(F\)다.
증명 스케치. \(F^{-}(u) \le x \iff u \le F(x)\)가 핵심 성질이다(\(F\)가 우연속이므로). 그러면
이다. \(\square\)
import numpy as np

rng = np.random.default_rng(0)
pk = np.array([0.1, 0.3, 0.4, 0.2])
F = np.cumsum(pk)

u = rng.random(500_000)
x = np.searchsorted(F, u, side="left")        # 일반화 역함수

print("일반화 역함수로 이산분포 표집")
for v in range(4):
    print(f"  P(X={v}): 모의 {np.mean(x == v):.5f}   참값 {pk[v]:.5f}")
출력:
일반화 역함수로 이산분포 표집
  P(X=0): 모의 0.10026   참값 0.10000
  P(X=1): 모의 0.29910   참값 0.30000
  P(X=2): 모의 0.40091   참값 0.40000
  P(X=3): 모의 0.19974   참값 0.20000
searchsorted 가 정확히 일반화 역함수다. 누적확률 배열에서 \(u\)가 들어갈 자리를 찾는 것이 \(\inf\{x: F(x) \ge u\}\)와 같다.
도약과 평탄 구간이 서로 대응된다.
| \(F\)의 특징 | 뜻 | \(F^{-}\)의 특징 |
|---|---|---|
| 도약 (점 \(x_0\)에서) | \(P(X = x_0) > 0\) | 평탄 구간 |
| 평탄 구간 | 그 구간에 확률 없음 | 도약 |
도약의 높이가 곧 그 값이 뽑힐 확률이고, \(U\)가 그 높이만큼의 구간에 떨어지면 같은 \(x_0\)가 나온다.
실무에서 어디에 쓰이는가.
- 난수 생성의 기본 방법이다. 균등난수 하나로 어떤 분포든 생성할 수 있다. 다만 \(F^{-}\)를 계산하기 어려우면 기각표집이나 다른 방법을 쓴다.
- 분위수 정의와 직결된다. 2장 ECDF 문서 연습문제 8에서 본 여러 분위수 정의가 \(F^{-}\)를 어떻게 보간하느냐의 차이다.
inverted_cdf방법이 바로 이 일반화 역함수다. - 컨포멀 예측과 부트스트랩이 경험분포의 일반화 역함수를 쓴다. \(\square\)
연습문제 8. 누적분포함수 말고도 분포를 나타내는 함수가 여럿 있다. 생존함수, 위험률, 누적위험의 관계를 정리하고 확인하라.
풀이
이고, 네 함수가 서로를 완전히 결정한다.
import numpy as np

lam = 0.7                                      # 지수분포
print(f"{'t':>6}{'S(t)':>10}{'f(t)':>10}{'h(t)':>10}{'H(t)':>10}{'exp(-H)':>10}")
for t in np.linspace(0.2, 3.0, 5):
    S = np.exp(-lam * t)
    f = lam * np.exp(-lam * t)
    print(f"{t:>6.2f}{S:>10.5f}{f:>10.5f}{f / S:>10.5f}{lam * t:>10.5f}"
          f"{np.exp(-lam * t):>10.5f}")
출력:
     t      S(t)      f(t)      h(t)      H(t)   exp(-H)
  0.20   0.86936   0.60855   0.70000   0.14000   0.86936
  0.90   0.53259   0.37281   0.70000   0.63000   0.53259
  1.60   0.32628   0.22840   0.70000   1.12000   0.32628
  2.30   0.19989   0.13992   0.70000   1.61000   0.19989
  3.00   0.12246   0.08572   0.70000   2.10000   0.12246
마지막 두 열이 정확히 같다. \(S(t) = e^{-H(t)}\)가 확인된다. 그리고 지수분포에서는 \(h(t)\)가 상수 \(\lambda\)다(연속형 문서 연습문제 10).
왜 여러 표현을 두는가. 같은 정보를 담지만 읽기 쉬운 질문이 다르다.
| 함수 | 답하는 질문 |
|---|---|
| \(f(t)\) | 이 값 근처의 밀도는? |
| \(F(t)\) | \(t\) 이하일 확률은? |
| \(S(t)\) | \(t\) 를 넘길 확률은? |
| \(h(t)\) | 여기까지 왔을 때 바로 다음 위험은? |
| \(H(t)\) | 누적된 위험의 총량은? |
꼬리를 다룰 때는 \(S\)가 낫다. \(F(t) = 0.9999\)와 \(S(t) = 10^{-4}\)는 같은 정보인데, 부동소수점에서 후자가 훨씬 정확하다. 그래서 scipy 의 모든 분포가 cdf 와 별도로 sf(survival function)를 제공한다.
누적위험 \(H\)의 실용적 가치. 생존분석에서 \(H\)를 추정하는 넬슨–알렌 추정량이 카플란–마이어보다 수치적으로 안정적이고, \(\log S\)를 그리면 지수분포일 때 직선이 되어 진단에 쓰인다(2장 선그림 문서 연습문제 9의 로그 축과 같은 발상).
이산에서도 성립한다. \(h_k = P(X=k)/P(X \ge k)\)로 두면 \(S_k = \prod_{j<k}(1-h_j)\)이며, 이것이 생명표와 카플란–마이어 추정량의 형태다. \(\square\)
연습문제 9. 확률변수가 둘이면 결합 누적분포함수를 쓴다. 그것이 주변분포와 의존구조를 어떻게 분리하는가?
풀이
스클라의 정리. 임의의 결합분포함수 \(F_{X,Y}\)는
로 쓸 수 있고, \(F_X, F_Y\)가 연속이면 코퓰라 \(C\)가 유일하다. 즉 결합분포가 주변분포와 의존구조로 완전히 분해된다.
import numpy as np
from scipy import stats

rng = np.random.default_rng(0)
n = 400_000
z = rng.multivariate_normal([0, 0], [[1, 0.7], [0.7, 1]], n)

u1, u2 = stats.norm.cdf(z[:, 0]), stats.norm.cdf(z[:, 1])   # 코퓰라로 이동
x1 = stats.expon.ppf(u1)                                     # 주변분포만 갈아 끼운다
x2 = stats.lognorm.ppf(u2, 1)

print("같은 코퓰라, 다른 주변분포")
print(f"{'':>22}{'피어슨':>10}{'스피어만':>11}")
print(f"{'(정규, 정규)':>22}{np.corrcoef(z.T)[0,1]:>10.4f}"
      f"{stats.spearmanr(z)[0]:>11.4f}")
print(f"{'(지수, 로그정규)':>22}{np.corrcoef(x1, x2)[0,1]:>10.4f}"
      f"{stats.spearmanr(x1, x2)[0]:>11.4f}")
출력:
같은 코퓰라, 다른 주변분포
                             피어슨       스피어만
              (정규, 정규)    0.7000     0.6828
            (지수, 로그정규)    0.6024     0.6828
스피어만 상관은 정확히 보존되고(\(0.6828\), 이론값 \(\tfrac{6}{\pi}\arcsin\tfrac{0.7}{2} = 0.6829\)) 피어슨은 바뀐다(\(0.70 \to 0.60\)).
이유가 명확하다. 스피어만은 순위만 쓰므로 각 변수의 단조 변환에 불변이다. 코퓰라가 곧 순위 구조이므로, 코퓰라를 고정하면 스피어만도 고정된다. 피어슨은 값 자체를 쓰므로 주변분포가 바뀌면 함께 바뀐다.
이것이 왜 중요한가.
- 의존구조를 주변분포와 따로 모형화할 수 있다. 각 자산의 수익률 분포는 따로 적합하고, 그들이 함께 움직이는 방식은 코퓰라로 따로 모형화한다.
- 꼬리 의존성이 상관계수에 잡히지 않는다. 정규 코퓰라는 꼬리 의존이 \(0\)이라 "함께 폭락할 확률"이 매우 낮다고 말한다. \(t\) 코퓰라는 같은 상관계수에서도 꼬리 의존이 양수다. \(2008\)년 금융위기에서 정규 코퓰라를 쓴 것이 문제로 지목되었다(앞 절 독립 문서 연습문제 10의 공통원인 고장과 같은 구조).
- "상관계수가 같으면 위험이 같다"는 틀렸다. 2장 산점도 문서 연습문제 8에서 본 "상관이 같아도 결합 구조가 다르다"의 이론적 정식화다.
주의. 코퓰라는 강력하지만 의존구조를 추정하는 것이 여전히 어렵다. 특히 꼬리 의존은 정의상 드문 사건에 대한 것이라 자료가 거의 없다. \(\square\)
연습문제 10. 연습문제 \(6\)처럼 밀도가 그럴듯해 보여도 분포가 성립하지 않거나 적률이 없을 수 있다. 판정 절차를 세우되, 수치적분으로는 판정할 수 없음을 함께 보여라.
풀이
import warnings
import numpy as np
from scipy import integrate

warnings.simplefilter("ignore")               # 발산 경고를 잠시 끈다

candidates = [("1/x        (x>=1)", lambda x: 1 / x, 1),
              ("1/x^2      (x>=1)", lambda x: 1 / x ** 2, 1),
              ("1/(x ln^2 x) (x>=2)", lambda x: 1 / (x * np.log(x) ** 2), 2)]

print("f 의 부분적분 — 분포가 되는가")
print(f"{'f(x)':>20}{'[lo, 10]':>12}{'[lo, 10^3]':>13}{'[lo, 10^6]':>13}")
for name, g, lo in candidates:
    vals = [integrate.quad(g, lo, T, limit=400)[0] for T in (10, 1e3, 1e6)]
    print(f"{name:>20}" + "".join(f"{v:>13.5f}" for v in vals))

print("\nx f(x) 의 부분적분 — 평균이 존재하는가")
print(f"{'f(x)':>20}{'[lo, 10]':>12}{'[lo, 10^3]':>13}{'[lo, 10^6]':>13}")
for name, g, lo in [candidates[1], candidates[2], ("3/x^4      (x>=1)", lambda x: 3 / x ** 4, 1)]:
    vals = [integrate.quad(lambda x: x * g(x), lo, T, limit=400)[0] for T in (10, 1e3, 1e6)]
    print(f"{name:>20}" + "".join(f"{v:>13.5f}" for v in vals))
출력:
f 의 부분적분 — 분포가 되는가
                f(x)    [lo, 10]   [lo, 10^3]   [lo, 10^6]
   1/x        (x>=1)      2.30259      6.90776     13.81551
   1/x^2      (x>=1)      0.90000      0.99900      1.00000
 1/(x ln^2 x) (x>=2)      1.00840      1.29793      1.37031

x f(x) 의 부분적분 — 평균이 존재하는가
                f(x)    [lo, 10]   [lo, 10^3]   [lo, 10^6]
   1/x^2      (x>=1)      2.30259      6.90776     13.81551
 1/(x ln^2 x) (x>=2)      3.66288     34.68506   6246.97574
   3/x^4      (x>=1)      1.48500      1.50000     -0.00000
부분적분의 움직임이 말해 준다.
- \(1/x\): \(2.30 \to 6.91 \to 13.82\)로 \(T\)가 \(10\)배 될 때마다 \(\log 10 \approx 2.30\)씩 일정하게 늘어난다(\(T = 10 \to 10^3\)은 두 칸, \(10^3 \to 10^6\)은 세 칸이다). \(\log T\)로 자라므로 발산이다. 분포가 되지 않는다.
- \(1/x^2\): \(0.900 \to 0.999 \to 1.000\)으로 정착한다. 분포가 된다.
- \(1/(x\ln^2 x)\): \(1.008 \to 1.298 \to 1.370\)으로 아주 천천히 오른다. 실제로는 \(1/\ln 2 \approx 1.4427\)로 수렴하지만, 이 표만으로는 발산과 구별하기 어렵다.
평균 쪽도 마찬가지다. \(1/x^2\)의 \(\int x f\)는 \(\log T\)로 자라고, \(1/(x\ln^2 x)\)는 \(6247\)까지 폭증한다. 둘 다 평균이 없다.
수치적분은 수렴을 판정하지 못한다
\(T \to \infty\)까지 계산할 수 없으므로, 부분적분이 정착하는 것처럼 보여도 아주 느리게 발산하는 중일 수 있다. \(1/(x\ln^2 x)\)가 그 반대 방향의 예다. 수렴하는데도 발산처럼 보인다.
더 나쁜 것은 scipy.integrate.quad 에 \(\infty\)를 직접 넘기면 경고와 함께 아무 의미 없는 유한한 수를 돌려준다는 것이다. \(\int_1^\infty dx/x\)에 대해 수십에서 수백 사이의 값이 나오고(limit 을 어떻게 주느냐에 따라 달라진다) 그 값에는 아무 뜻이 없다. 수치 알고리즘이 유한한 표본점만 보기 때문이다. 경고를 무시하면 발산하는 적분을 유한한 값으로 착각하게 된다.
수렴 판정은 반드시 해석적으로 해야 한다.
해석적 판정: 꼬리의 감소 속도가 전부다. \(f(x) \sim x^{-(\alpha+1)}\)이면
| 꼬리 | 분포? | \(\mathbb{E}[X]\) | \(\operatorname{Var}(X)\) |
|---|---|---|---|
| \(x^{-1}\) | 아니다 | — | — |
| \(x^{-2}\) | 그렇다 | 무한 | 무한 |
| \(x^{-3}\) | 그렇다 | 유한 | 무한 |
| \(x^{-5}\) | 그렇다 | 유한 | 유한 |
| \(e^{-x}\) | 그렇다 | 유한 | 모든 적률 유한 |
규칙은 \(k < \alpha\)인 적률만 존재한다는 것이다.
\(1/(x\ln^2 x)\)가 경계선의 흥미로운 예다. \(x^{-1}\)보다 아주 조금 빨리 줄어 적분은 수렴하지만, \(xf(x) \sim 1/\ln^2 x\)의 적분은 발산해 평균이 없다. 로그 인자가 분포는 만들되 평균은 만들지 못한다.
세 단계 절차로 정리하면.
- \(f \ge 0\)인가.
- \(\int f\)가 유한하고 양수인가 — 꼬리 지수를 보고 해석적으로 판정한다.
- 필요한 적률이 존재하는가 — \(k < \alpha\)인지 확인한다.
실무적 함의. 소득·손실·대기시간처럼 무거운 꼬리가 예상되는 곳에서는 쓰려는 통계량이 존재하는지부터 따져야 한다. 존재하지 않는 평균을 추정하려 애쓰는 것은 무의미하며(연속형 문서 연습문제 9), 그때는 중앙값이나 절단 평균으로 옮겨야 한다. \(\square\)
정리하며
누적분포함수는 이산과 연속을 하나로 묶는 함수다.
- 정리 1은 \(F(x) = P(X \le x)\)를 정의했다. 왼쪽부터 쌓은 총 무게이며, 이산이면 계단으로 뛰고 연속이면 매끄럽게 오른다. 어느 쪽이든 분포를 완전히 결정한다.
- 정리 2는 연속인 경우 밀도와 누적이 미분·적분으로 왕복함을 보였다.
- 정리 3은 \(F\)를 뒤집어 분위수함수를 얻었다. 신뢰구간의 \(1.96\)이 여기서 나오고, 역변환 표집으로 난수 생성까지 이어진다.
3.3절 전체를 한 줄로 줄이면 이렇다. 확률변수는 결과를 수로 옮기고, 그 결과 실직선 위에 무게 배치가 생기며, 그것을 적는 방법이 세 가지 함수다. 값마다의 무게(확률질량함수), 구간당 무게(확률밀도함수), 왼쪽부터 쌓은 무게(누적분포함수).
이제 분포를 적을 수 있게 되었으니 다음 물음이 자연스럽다. 분포를 몇 개의 수로 요약할 수 없을까? 주사위 눈의 분포 전체를 말하는 대신 "평균 3.5"라고 말하는 것처럼.
다음 절의 기댓값이 그 첫 번째 요약값이고, 이어지는 분산이 두 번째다. 그리고 이 요약이 통계학이 자료를 다루는 방식 전체의 출발점이 된다.