이원배치 분산분석: 교호작용 효과
1. 이원배치 분산분석의 수행 절차
1단계: 가설 세우기
- 주효과 A에 대해:
- \(H_0: \mu^A_1=\mu^A_2=\cdots=\mu^A_a\)
- \(H_A\): 요인 A의 수준 사이에서 적어도 한 평균이 다르다.
- 주효과 B에 대해:
- \(H_0: \mu^B_1=\mu^B_2=\cdots=\mu^B_b\)
- \(H_A\): 요인 B의 수준 사이에서 적어도 한 평균이 다르다.
- 교호작용 효과 (A × B)에 대해:
- 모든 \(i\), \(j\)에 대해 \(H_0: (\mu_{ij} - \mu_{i\cdot} - \mu_{\cdot j} + \mu_{\cdot \cdot}) = 0\)
- \(H_A\): 요인 A와 요인 B 사이에 교호작용이 있다.
여기서 \(\mu_{ij}\)는 요인 A의 수준 \(i\)와 요인 B의 수준 \(j\)에서의 평균, \(\mu_{i\cdot}\)는 수준 \(i\)에서 요인 A의 주변평균, \(\mu_{\cdot j}\)는 수준 \(j\)에서 요인 B의 주변평균, \(\mu_{\cdot \cdot}\)는 전체 평균이다.
2단계: 전체 평균과 집단 평균 계산
3단계: 총제곱합 SST 계산
4단계: SSA와 SSB 계산
5단계: 교호작용 변동 SSAB 계산
6단계: 잔차 변동 SSE 계산
7단계: 분해 확인
8단계: F-통계량 계산
9단계: 임계값 또는 p-값 구하기
F-통계량을 F-분포표의 임계값과 비교하거나 p-값을 쓴다.
10단계: 판정
주효과나 교호작용의 F-통계량이 임계값보다 크면(또는 p-값이 선택한 유의수준보다 작으면) 그 효과에 대한 귀무가설을 기각한다.
2. 이원배치 분산분석 패키지
statsmodels: 교호작용 그림과 분산분석
보기 1. 분산분석표는 칸평균 여섯 개에서 나온다. ToothGrowth 는 \(a = 2\)(supp), \(b = 3\)(dose), 칸마다 \(c = 10\) 인 균형 설계다.
(1) 균형 설계의 세 제곱합
을 쓰고, 요인 A 의 수준이 둘일 때 \(\delta_j = \bar y_{1j} - \bar y_{2j}\) (수준 \(j\) 에서의 두 수준 격차)라 두면
임을 보이시오. 곧 교호작용 제곱합은 격차들의 흩어짐이다.
(2) 칸평균 여섯 개만으로 \(SSA\), \(SSB\), \(SSAB\) 를 계산해 출력표와 맞추시오.
풀이
(1) 해석적으로. \(a = 2\) 이면 교호작용 편차
가 열마다 더해서 \(0\) 이 된다. 실제로 \(\bar y_{\cdot j} = \frac{\bar y_{1j} + \bar y_{2j}}{2}\) 이고 \(\bar y = \frac{\bar y_{1\cdot}+\bar y_{2\cdot}}{2}\) 이므로
이다. 따라서 \(d_{2j} = -d_{1j}\) 이고
이다(\(\bar\delta = \bar y_{1\cdot} - \bar y_{2\cdot}\) 는 \(\delta_j\) 들의 평균이기도 하다). 제곱해 두 행을 더하면
이다. 교호작용 제곱합이 "격차 \(\delta_j\) 들이 서로 얼마나 다른가"를 그대로 잰 수가 되었다. 격차가 모든 수준에서 같으면(\(\delta_j \equiv \bar\delta\)) \(SSAB = 0\) 이고, 이것이 바로 교호작용 그림의 두 선이 평행하다는 말이다. "평행"의 대수적 뜻이 이 식에 담겨 있다.
(2) 수치적으로.
import matplotlib.pyplot as plt
import pandas as pd
from statsmodels.formula.api import ols
from statsmodels.stats.anova import anova_lm
from statsmodels.graphics.factorplots import interaction_plot

def load_data():
    """ToothGrowth 자료를 읽는다. 보충제 종류와 투여량, 그리고 치아 길이다."""
    url = 'https://raw.githubusercontent.com/vincentarelbundock/Rdatasets/1dcc2bf5f955cc1224a3e1307256e1fe86b68dae/csv/datasets/ToothGrowth.csv'
    df = pd.read_csv(url, usecols=[1, 2, 3])
    return df

def plot_interaction(df):
    """교호작용 그림. 두 선이 나란하면 교호작용이 없다는 뜻이다.

    선이 벌어지거나 엇갈리면 한 요인의 효과가 다른 요인의 수준에 따라
    달라진다는 것이고, 그때는 주효과만 말해서는 안 된다.
    """
    fig, ax = plt.subplots(figsize=(12, 3))
    interaction_plot(df.dose, df.supp, df.len,
                     colors=['red', 'blue'],
                     markers=['*', 'P'],
                     markersize=7, ax=ax,
                     legendloc='lower right',
                     linestyles=["--", "--"])
    ax.set_title("Interaction Plot: Dose vs. Supplement on Tooth Length")
    ax.set_xlabel("Dose Level")
    ax.set_ylabel("Tooth Length")
    plt.show()

def perform_two_way_anova(df):
    """이원배치 분산분석. 그림에서 본 것이 통계적으로도 유의한지 확인한다."""
    model = ols('len ~ C(supp) + C(dose) + C(supp):C(dose)', data=df).fit()
    anova_results = anova_lm(model)
    print("\nTwo-Way ANOVA Results:")
    print(anova_results)

df = load_data()
plot_interaction(df)
perform_two_way_anova(df)
출력:
Two-Way ANOVA Results:
                   df       sum_sq      mean_sq          F        PR(>F)
C(supp)           1.0   205.350000   205.350000  15.571979  2.311828e-04
C(dose)           2.0  2426.434333  1213.217167  91.999965  4.046291e-18
C(supp):C(dose)   2.0   108.319000    54.159500   4.106991  2.186027e-02
Residual         54.0   712.106000    13.187148        NaN           NaN
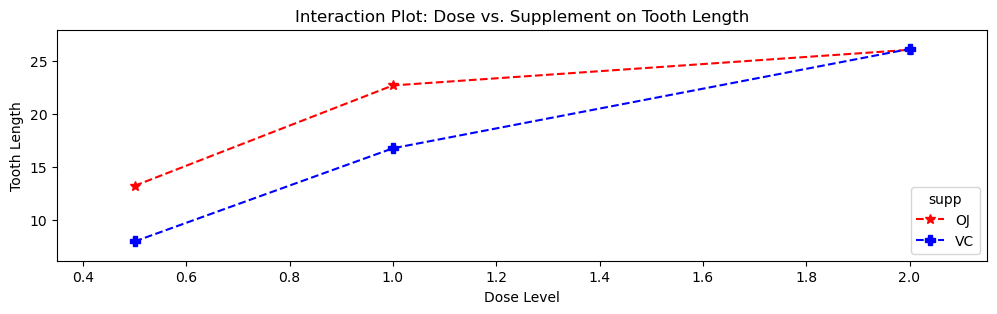
이제 칸평균 여섯 개만으로 같은 표를 만들어 본다.
import numpy as np

c = 10
M = df.pivot_table(index='supp', columns='dose', values='len', aggfunc='mean')
print("칸평균")
print(M)

row, col = M.mean(axis=1), M.mean(axis=0)
grand = M.values.mean()
SSA = 3 * c * ((row - grand) ** 2).sum()
SSB = 2 * c * ((col - grand) ** 2).sum()
D = M.values - row.values[:, None] - col.values[None, :] + grand
SSAB = c * (D ** 2).sum()
print(f"\n행평균 {row.values.round(4)}  열평균 {col.values.round(4)}  전체 {grand:.4f}")
print(f"SSA  = {SSA:.4f}   (표: 205.3500)")
print(f"SSB  = {SSB:.4f}   (표: 2426.4343)")
print(f"SSAB = {SSAB:.4f}   (표: 108.3190)")

# a=2 의 지름길: 격차의 흩어짐
delta = M.loc['OJ'] - M.loc['VC']
print(f"\n격차 delta_j = {delta.values.round(2)},  평균 {delta.mean():.2f}")
print(f"(c/2) * sum (delta - mean)^2 = {c / 2 * ((delta - delta.mean()) ** 2).sum():.4f}")

SSE = sum(((v.values - v.values.mean()) ** 2).sum()
          for _, v in df.groupby(['supp', 'dose'])['len'])
SST = ((df['len'] - df['len'].mean()) ** 2).sum()
print(f"\nSSE = {SSE:.4f},  네 제곱합의 합 = {SSA + SSB + SSAB + SSE:.4f},  SST = {SST:.4f}")
출력:
칸평균
dose    0.5    1.0    2.0
supp
OJ    13.23  22.70  26.06
VC     7.98  16.77  26.14

행평균 [20.6633 16.9633]  열평균 [10.605 19.735 26.1  ]  전체 18.8133
SSA  = 205.3500   (표: 205.3500)
SSB  = 2426.4343   (표: 2426.4343)
SSAB = 108.3190   (표: 108.3190)

격차 delta_j = [ 5.25  5.93 -0.08],  평균 3.70
(c/2) * sum (delta - mean)^2 = 108.3190

SSE = 712.1060,  네 제곱합의 합 = 3452.2093,  SST = 3452.2093
세 제곱합이 칸평균만으로 복원된다. \(SSA = 205.3500\), \(SSB = 2426.4343\), \(SSAB = 108.3190\) 이 모두 분산분석표와 소수 넷째 자리까지 같다. 원자료 \(60\) 개가 쓰인 곳은 \(SSE\) 뿐이다. 분산분석표는 "칸평균 여섯 개 + 칸 안의 흩어짐" 두 덩어리로 완전히 정해진다.
(1)의 지름길도 맞는다. 격차가 \(\delta = (5.25,\ 5.93,\ -0.08)\) 이고 평균이 \(3.70\) 이다. 이 셋의 편차제곱합에 \(c/2 = 5\) 를 곱하면 \(108.3190\) 으로 \(SSAB\) 와 정확히 같다. 교호작용이 유의한 까닭이 여기서 한눈에 보인다. 격차 셋 중 둘은 \(5\) 를 넘는데 하나는 \(0\) 에 붙어 있다. 그 흩어짐이 교호작용의 전부다.
덧붙이면 \(\bar\delta = 3.70\) 이 바로 supp 주효과의 크기이고(보기 2의 Tukey 표에 나온 meandiff\(= -3.70\) 과 같은 수다), \(SSA = \frac{abc}{4}\bar\delta^2 = 15 \times 3.7^2 = 205.35\) 로도 나온다. 주효과는 격차의 평균, 교호작용은 격차의 분산이다.
출력 해석
교호작용 그림: 용량이 0.5에서 2.0으로 커질수록 두 보충제 모두에서 치아 길이가 대체로 늘어난다. 낮은 용량(0.5와 1.0)에서는 "OJ"가 "VC"보다 뚜렷하게 긴 치아 길이를 낳는다. 가장 높은 용량(2.0)에서는 그 차이가 훨씬 작다. 두 선이 평행하지 않다는 점이 교호작용 효과의 가능성을 시사한다.
분산분석 결과표:
| 항 | df | sum_sq | mean_sq | F | PR(>F) |
|---|---|---|---|---|---|
| C(supp) | 1.0 | 205.350 | 205.350 | 15.572 | 2.31e-04 |
| C(dose) | 2.0 | 2426.434 | 1213.217 | 91.999 | 4.05e-18 |
| C(supp):C(dose) | 2.0 | 108.319 | 54.160 | 4.107 | 2.19e-02 |
| Residual | 54.0 | 712.106 | 13.187 | NaN | NaN |
보충제 종류와 용량 수준 모두 치아 길이에 통계적으로 유의한 효과를 갖는다. 둘 사이의 교호작용도 유의하여, 각 보충제의 효과가 용량 수준에 따라 달라짐을 시사한다.
Tukey의 HSD를 이용한 사후검정
보기 2. Tukey HSD로 하는 사후검정. 보기 1의 ToothGrowth 자료를 쓴다.
(1) Tukey HSD는 스튜던트화 범위 분포를 쓴다. 균형설계에서 집단당 \(m\)개일 때
임을 적고, 왜 이것이 집단별오류율(FWER)을 정확히 \(\alpha\)로 맞추는지 설명하시오. 그리고 dose 주효과 표의 세 줄을 손계산으로 맞추시오.
(2) Tukey를 쓰려면 \(F\)-검정이 먼저 유의해야 하는가. "보호된 LSD"(\(F\)가 유의할 때만 짝비교)와 나란히, 완전 영가설(모든 평균이 같음)과 부분 영가설(한 집단만 멀리 떨어짐)에서 FWER를 재어 답하시오.
풀이
(1) 해석적으로. 핵심은 "최대"를 쓴다는 것이다. 균형 일원배치에서 완전 영가설 \(\mu_1 = \cdots = \mu_k\) 아래의 스튜던트화 범위
는 모수 \(k\)와 \(N-k\)를 갖는 스튜던트화 범위 분포를 따른다. 여기서 \(\sqrt{MSE/m}\)은 집단평균 하나의 표준오차다.
이제 모든 쌍을 동시에 보자. 어떤 쌍이든 그 차의 절댓값은 최대와 최소의 차를 넘지 못하므로
이다. 곧 "어느 한 쌍이라도 임계값을 넘는다"는 사건과 "범위가 임계값을 넘는다"는 사건이 같은 사건이다. 따라서
이고, FWER가 \(\alpha\) 이하가 아니라 정확히 \(\alpha\)다. 본페로니처럼 부등식으로 느슨하게 막는 것이 아니라, 최대의 분포를 직접 써서 딱 맞춘다. 이 등식이 성립하려면 모든 쌍의 표준오차가 같아야 하므로 균형설계가 필요하다. 불균형이면 \(\sqrt{MSE/m}\)이 쌍마다 달라지고 Tukey-Kramer 수정이 보수적인 부등식으로 바뀐다.
신뢰구간의 폭이 \(q_\alpha\sqrt{MSE/m}\)으로 모든 쌍에서 같다는 점도 여기서 나온다. 이 공통 폭을 "정직한 유의차(honestly significant difference)"라 부르고 그래서 이름이 HSD다. 조정 \(p\)-값은 \(p_{ij} = P(Q > q_{ij})\)다.
\(F\)-검정은 필요하지 않다. 위 유도에 \(F\)가 등장하지 않는다. FWER 보증이 범위의 분포에서 무조건적으로 나오므로, \(F\)를 먼저 통과시키라는 요구는 보증에 아무것도 더하지 않고 검정력만 깎는다.
(2) 이론이 예측하는 값. 두 절차 모두 명목 FWER가 \(0.05\)다. 재어 보면 Tukey는 어느 상황에서도 \(0.05\)를 넘지 않는 반면, 보호된 LSD는 \(F\)의 보호가 작동하지 않는 상황에서 무너질 것이다. \(F\)는 "모든 평균이 같다"를 검정하므로, 한 집단만 멀리 떨어져 있으면 \(F\)가 거의 언제나 유의해 문이 늘 열려 있다. 그러면 남은 집단들 사이의 짝비교가 보정 없이 수행되고, 쌍이 \(r\)개면 FWER가 대략 \(1-(1-0.05)^r\)까지 올라간다.
수치적으로. 먼저 패키지를 돌린다.
from statsmodels.stats.multicomp import pairwise_tukeyhsd

# 1단계: 이원배치 분산분석
url = 'https://raw.githubusercontent.com/vincentarelbundock/Rdatasets/1dcc2bf5f955cc1224a3e1307256e1fe86b68dae/csv/datasets/ToothGrowth.csv'
df = pd.read_csv(url, usecols=[1, 2, 3])
model = ols('len ~ C(supp) + C(dose) + C(supp):C(dose)', data=df).fit()
anova_results = anova_lm(model)
print(anova_results, end="\n\n")

# 2단계: 주효과에 대한 Tukey HSD
tukey_dose = pairwise_tukeyhsd(endog=df['len'], groups=df['dose'], alpha=0.05)
print(tukey_dose, end="\n\n")

tukey_supp = pairwise_tukeyhsd(endog=df['len'], groups=df['supp'], alpha=0.05)
print(tukey_supp, end="\n\n")

# Step 3: 교호작용에 대한 사후검정
# 두 요인을 붙여 하나의 요인으로 만든다. 수준이 2 x 3 = 6개가 되고
# 비교는 15쌍으로 늘어난다. 그만큼 Tukey의 보정도 커진다.
df['supp_dose'] = df['supp'].astype(str) + "_" + df['dose'].astype(str)
tukey_interaction = pairwise_tukeyhsd(endog=df['len'], groups=df['supp_dose'], alpha=0.05)
print(tukey_interaction, end="\n\n")
출력:
                   df       sum_sq      mean_sq          F        PR(>F)
C(supp)           1.0   205.350000   205.350000  15.571979  2.311828e-04
C(dose)           2.0  2426.434333  1213.217167  91.999965  4.046291e-18
C(supp):C(dose)   2.0   108.319000    54.159500   4.106991  2.186027e-02
Residual         54.0   712.106000    13.187148        NaN           NaN

Multiple Comparison of Means - Tukey HSD, FWER=0.05
===================================================
group1 group2 meandiff p-adj  lower   upper  reject
---------------------------------------------------
   0.5    1.0     9.13   0.0  5.9018 12.3582   True
   0.5    2.0   15.495   0.0 12.2668 18.7232   True
   1.0    2.0    6.365   0.0  3.1368  9.5932   True
---------------------------------------------------

Multiple Comparison of Means - Tukey HSD, FWER=0.05
=================================================
group1 group2 meandiff p-adj  lower  upper reject
-------------------------------------------------
    OJ     VC     -3.7 0.0604 -7.567 0.167  False
-------------------------------------------------

 Multiple Comparison of Means - Tukey HSD, FWER=0.05
======================================================
group1 group2 meandiff p-adj   lower    upper   reject
------------------------------------------------------
OJ_0.5 OJ_1.0     9.47    0.0   4.6719  14.2681   True
OJ_0.5 OJ_2.0    12.83    0.0   8.0319  17.6281   True
OJ_0.5 VC_0.5    -5.25 0.0243 -10.0481  -0.4519   True
OJ_0.5 VC_1.0     3.54  0.264  -1.2581   8.3381  False
OJ_0.5 VC_2.0    12.91    0.0   8.1119  17.7081   True
OJ_1.0 OJ_2.0     3.36 0.3187  -1.4381   8.1581  False
OJ_1.0 VC_0.5   -14.72    0.0 -19.5181  -9.9219   True
OJ_1.0 VC_1.0    -5.93 0.0074 -10.7281  -1.1319   True
OJ_1.0 VC_2.0     3.44 0.2936  -1.3581   8.2381  False
OJ_2.0 VC_0.5   -18.08    0.0 -22.8781 -13.2819   True
OJ_2.0 VC_1.0    -9.29    0.0 -14.0881  -4.4919   True
OJ_2.0 VC_2.0     0.08    1.0  -4.7181   4.8781  False
VC_0.5 VC_1.0     8.79    0.0   3.9919  13.5881   True
VC_0.5 VC_2.0    18.16    0.0  13.3619  22.9581   True
VC_1.0 VC_2.0     9.37    0.0   4.5719  14.1681   True
------------------------------------------------------
세 표를 함께 읽어야 한다.
- 용량의 주효과: 세 수준이 서로 모두 유의하게 다르다. 용량이 오를수록 치아가 길어진다.
- 보충제의 주효과: OJ와 VC의 차이가 \(p = 0.060\)으로 유의하지 않다. 그런데 분산분석표의
C(supp)는 \(p = 0.00023\)으로 강하게 유의하다. 모순처럼 보이지만 그렇지 않다. 분산분석은 용량을 모형에 넣은 채 보충제의 효과를 보는 반면, 여기 Tukey는 용량을 무시하고 OJ와 VC를 통째로 비교한다. 용량이 만들어 내는 큰 변동이 잡음으로 남아 차이를 덮는다. - 교호작용: 마지막 표의
OJ_2.0 VC_2.0행을 보라. 평균 차이가 0.08이고 \(p = 1.0\)이다. 용량 2.0에서는 두 보충제가 사실상 같다. 반면 용량 0.5에서는 차이가 \(-5.25\)(\(p = 0.024\))로 유의하다. 보충제의 효과가 용량에 따라 달라진다는 것이 곧 교호작용이며, 분산분석표의 \(p = 0.022\)가 이를 뒷받침한다.
교호작용 사후검정의 핵심 결과: 낮은 용량에서는 OJ가 VC보다 유의하게 긴 치아 성장을 낳는 경향이 있다. 가장 높은 용량(2.0)에서는 두 보충제의 효과가 비슷하다(OJ_2.0 대 VC_2.0: 평균차 = 0.08, p = 1.0).
이제 dose 표를 (1)의 식으로 손계산해 맞춘다.
import numpy as np
from scipy import stats

# dose 주효과 Tukey 표를 스튜던트화 범위 분포로 직접 만든다.
g = df.groupby('dose')['len']
m_i = g.mean().values
n_i = g.count().values
k, N = len(n_i), n_i.sum()
dfe = N - k
MSE = ((n_i - 1) * g.var(ddof=1).values).sum() / dfe
se = np.sqrt(MSE / n_i[0])                      # 집단평균 하나의 표준오차
q_crit = stats.studentized_range.ppf(0.95, k, dfe)

print(f"MSE = {MSE:.6f},  오차 자유도 = {dfe}")
print(f"집단평균 하나의 표준오차 sqrt(MSE/m) = {se:.6f}")
print(f"q_crit(0.05, k={k}, df={dfe}) = {q_crit:.4f}")
print(f"HSD = q_crit * sqrt(MSE/m)   = {q_crit * se:.4f}   <- 모든 쌍에 같은 폭")
print(f"대조: 보정 없는 t 임계값 {stats.t.ppf(0.975, dfe):.4f},  "
      f"Tukey 는 t 척도로 {q_crit / np.sqrt(2):.4f}")

lv = g.mean().index.values
print(f"\n{'group1':>6s} {'group2':>6s} {'meandiff':>9s} {'q':>8s} "
      f"{'p-adj':>9s} {'lower':>9s} {'upper':>9s}")
for a in range(k):
    for b in range(a + 1, k):
        d = m_i[b] - m_i[a]
        q = abs(d) / se
        print(f"{lv[a]:>6.1f} {lv[b]:>6.1f} {d:9.4f} {q:8.4f} "
              f"{stats.studentized_range.sf(q, k, dfe):9.6f} "
              f"{d - q_crit * se:9.4f} {d + q_crit * se:9.4f}")
출력:
MSE = 17.996053,  오차 자유도 = 57
집단평균 하나의 표준오차 sqrt(MSE/m) = 0.948579
q_crit(0.05, k=3, df=57) = 3.4032
HSD = q_crit * sqrt(MSE/m)   = 3.2282   <- 모든 쌍에 같은 폭
대조: 보정 없는 t 임계값 2.0025,  Tukey 는 t 척도로 2.4064

group1 group2  meandiff        q     p-adj     lower     upper
   0.5    1.0    9.1300   9.6249  0.000000    5.9018   12.3582
   0.5    2.0   15.4950  16.3350  0.000000   12.2668   18.7232
   1.0    2.0    6.3650   6.7100  0.000042    3.1368    9.5932
세 줄이 패키지 표와 똑같다. meandiff \(9.13\), \(15.495\), \(6.365\)가 같고 신뢰구간 \([5.9018,\ 12.3582]\), \([12.2668,\ 18.7232]\), \([3.1368,\ 9.5932]\)도 넷째 자리까지 같다. pairwise_tukeyhsd는 위 두 줄의 식을 계산하는 것 이상을 하지 않는다.
구간 폭이 모든 쌍에서 \(\pm 3.2282\)로 같다. 균형설계(\(m = 20\))여서 표준오차가 쌍마다 같기 때문이고, 그래서 "정직한 유의차"라는 이름이 붙었다. 보정의 크기도 한눈에 보인다. 보정 없는 \(t\) 임계값이 \(2.0025\)인데 Tukey는 \(t\) 척도로 \(2.4064\)를 요구한다. \(20\%\)만 더 엄격하다. 세 쌍에 본페로니를 쓰면 \(t_{1-0.05/6,\,57}\)을 써야 하므로 이보다 더 엄격해진다.
이제 (2)의 물음에 답한다.
import numpy as np
from itertools import combinations
from scipy import stats

# 평균이 서로 같은 집단들 사이에서 "한 번이라도 거짓 기각이 나는" 확률을 센다.
# 이것이 집단별오류율(FWER)이고 이론값은 0.05 다.
rng_sim = np.random.default_rng(2026)
n, B = 10, 2000
print(f"집단당 n = {n}, 반복 {B}회, 명목 FWER 0.05, "
      f"몬테카를로 오차 {np.sqrt(0.05 * 0.95 / B):.4f}")
print(f"\n{'k':>3s} {'delta':>6s} {'같은쌍':>7s} {'F 유의':>7s} "
      f"{'Tukey':>7s} {'보호 LSD':>9s}")
for k in [3, 4, 5, 6]:
    dfe = k * n - k
    q_crit = stats.studentized_range.ppf(0.95, k, dfe)
    t_crit = stats.t.ppf(0.975, dfe)
    f_crit = stats.f.ppf(0.95, k - 1, dfe)
    for delta in [0.0, 8.0]:
        # delta = 0 이면 완전 영가설, delta = 8 이면 한 집단만 멀리 떨어진 부분 영가설
        mu = np.array([0.0] * (k - 1) + [delta])
        pairs = (list(combinations(range(k), 2)) if delta == 0.0
                 else list(combinations(range(k - 1), 2)))
        Y = rng_sim.normal(mu[None, :, None], 1.0, size=(B, k, n))
        gm = Y.mean(axis=2)
        MSW = ((Y - gm[:, :, None]) ** 2).sum(axis=(1, 2)) / dfe
        SSB = (n * (gm - gm.mean(axis=1, keepdims=True)) ** 2).sum(axis=1)
        sig_F = (SSB / (k - 1)) / MSW > f_crit

        any_tukey = np.zeros(B, bool)
        any_lsd = np.zeros(B, bool)
        for a, b in pairs:
            d = np.abs(gm[:, a] - gm[:, b])
            any_tukey |= d / np.sqrt(MSW / n) > q_crit
            any_lsd |= d / np.sqrt(MSW * 2 / n) > t_crit
        print(f"{k:3d} {delta:6g} {len(pairs):7d} {sig_F.mean():7.4f} "
              f"{any_tukey.mean():7.4f} {(sig_F & any_lsd).mean():9.4f}")
출력:
집단당 n = 10, 반복 2000회, 명목 FWER 0.05, 몬테카를로 오차 0.0049

  k  delta     같은쌍    F 유의   Tukey    보호 LSD
  3      0       3  0.0595  0.0560    0.0595
  3      8       1  1.0000  0.0195    0.0520
  4      0       6  0.0480  0.0425    0.0480
  4      8       3  1.0000  0.0320    0.1185
  5      0      10  0.0500  0.0495    0.0500
  5      8       6  1.0000  0.0355    0.1980
  6      0      15  0.0525  0.0545    0.0525
  6      8      10  1.0000  0.0330    0.2810
완전 영가설(\(\delta = 0\))에서는 둘 다 맞는다. Tukey의 FWER가 \(0.0560\), \(0.0425\), \(0.0495\), \(0.0545\)로 네 \(k\) 전부에서 명목 \(0.05\)와 몬테카를로 오차 \(0.0049\)의 두 배 안쪽이다. (1)에서 "정확히 \(\alpha\)"라고 유도한 것이 수로 확인된다 — 보수적으로 \(0.03\) 같은 값이 나오는 것이 아니라 \(0.05\)에 붙어 있다. 보호된 LSD도 \(F\) 유의 비율과 같은 값(\(0.0595\), \(0.0480\), \(0.0500\), \(0.0525\))으로 통제된다. 완전 영가설에서는 \(F\)가 \(5\%\)만 문을 열어 주므로 그 뒤에서 무슨 짓을 해도 FWER가 \(5\%\)를 넘지 못한다.
부분 영가설(\(\delta = 8\))에서 갈린다. \(F\) 유의 비율이 네 경우 모두 \(1.0000\)이다. 한 집단이 \(8\sigma\) 떨어져 있으니 \(F\)는 언제나 유의하고, 보호가 작동하지 않는다. 그러면 남은 \(k-1\)개 집단(평균이 모두 같다) 사이의 짝비교가 보정 없이 수행된다.
| \(k\) | 같은 평균 쌍 수 | 보호된 LSD | \(1-0.95^r\) | Tukey |
|---|---|---|---|---|
| 3 | 1 | \(0.0520\) | \(0.050\) | \(0.0195\) |
| 4 | 3 | \(0.1185\) | \(0.143\) | \(0.0320\) |
| 5 | 6 | \(\mathbf{0.1980}\) | \(0.265\) | \(0.0355\) |
| 6 | 10 | \(\mathbf{0.2810}\) | \(0.401\) | \(0.0330\) |
\(k = 6\)에서 보호된 LSD의 거짓 기각 확률이 \(0.2810\)이다. 명목 \(5\%\)라고 적어 놓고 실제로는 네 번에 한 번 틀린 결론을 내놓는다. \(1-0.95^r\)로 어림한 값보다 작은 것은 짝비교들이 같은 \(MSW\)와 같은 집단평균을 공유해 서로 양의 상관을 갖기 때문이다.
\(k = 3\)만 예외다. 쌍이 하나뿐이니 다중성이 없고 보호된 LSD가 \(0.0520\)으로 맞는다. Fisher의 LSD가 "세 집단에서는 괜찮다"고 알려져 온 까닭이 이것이며, 집단이 넷 이상이면 그 면제가 사라진다.
Tukey는 어디서나 \(0.05\) 아래다. \(0.0195\)에서 \(0.0355\) 사이인데, 명목보다 작은 것은 부분 영가설에서 거짓 기각이 가능한 쌍이 전체 쌍의 일부이기 때문이다. Tukey는 모든 쌍에 걸쳐 FWER를 \(0.05\)로 맞추므로, 그 가운데 일부만 보면 당연히 그보다 작게 나온다. 보증이 느슨해서가 아니라 더 넓은 범위를 지키고 있어서 그렇다.
그래서 (2)의 답은 "아니다"다. Tukey는 \(F\)-검정을 먼저 통과시킬 필요가 없다. FWER 보증이 \(F\)와 무관하게 성립하므로, \(F\)로 문을 만드는 것은 검정력만 깎는 군더더기다. 거꾸로 LSD는 \(F\)의 보호가 필요한데도 그 보호가 가장 필요한 상황에서 작동하지 않는다. 한 집단만 멀리 떨어진 자료야말로 실무에서 흔한 모양이고(처치 하나만 효과가 있는 경우), 바로 그때 보호가 사라진다. "왜 Tukey인가"의 답이 이 표다.
3. 보기: 교수법과 학습시간에 따른 시험 점수
문제 1.
시험 점수에 영향을 주는 두 요인: 전통식과 온라인 수준을 갖는 요인 A(교수법), 1시간과 2시간 수준을 갖는 요인 B(학습시간).
| 교수법 | 학습시간 | 점수 1 | 점수 2 | 평균 |
|---|---|---|---|---|
| 전통식 | 1시간 | 60 | 62 | 61 |
| 전통식 | 2시간 | 68 | 70 | 69 |
| 온라인 | 1시간 | 65 | 63 | 64 |
| 온라인 | 2시간 | 72 | 74 | 73 |
풀이
1단계: 전체 평균 계산
2단계: 요인별 평균과 칸 평균 계산
- 전통식: 65, 온라인: 68.5
- 1시간: 62.5, 2시간: 71
- 칸 평균: 전통식/1시간 = 61, 전통식/2시간 = 69, 온라인/1시간 = 64, 온라인/2시간 = 73
3단계: 제곱합 계산
- \(SS_{\text{Total}} = 177.5\)
- \(SS_A = 4 \times ((65 - 66.75)^2 + (68.5 - 66.75)^2) = 24.5\)
- \(SS_B = 4 \times ((62.5 - 66.75)^2 + (71 - 66.75)^2) = 144.5\)
- \(SS_{AB} = 0.5\) (각 칸이 0.125씩 기여)
- \(SS_E = 177.5 - 24.5 - 144.5 - 0.5 = 8\)
4단계: 자유도, 평균제곱, F-통계량
| 원천 | SS | df | MS | F | PR(>F) |
|---|---|---|---|---|---|
| 요인 A | 24.5 | 1 | 24.5 | 12.25 | 0.024896 |
| 요인 B | 144.5 | 1 | 144.5 | 72.25 | 0.001051 |
| 교호작용 AB | 0.5 | 1 | 0.5 | 0.25 | 0.643330 |
| 오차 | 8.0 | 4 | 2.0 | ||
| 전체 | 177.5 | 7 |
해석
- 요인 A(교수법): \(F_A = 12.25\), \(p = 0.0249\)로 0.05에서 유의하다. 교수법이 시험 점수에 유의한 효과를 갖는다.
- 요인 B(학습시간): \(F_B = 72.25\), \(p = 0.0011\)로 0.01에서 유의하다. 학습시간이 시험 점수에 유의한 효과를 갖는다.
- 교호작용 (A × B): \(F_{AB} = 0.25\), \(p = 0.6433\)으로 유의하지 않다. 교수법과 학습시간 사이에 유의한 교호작용이 없다.
보기 3. \(2\times2\) 설계에서 교호작용 \(p = 0.64\) 는 무엇을 뜻하는가. 교수법 둘 × 학습시간 둘, 칸마다 \(c = 2\) 명인 설계다.
(1) 보기 1의 식에서 \(a = b = 2\) 일 때
임을 보이고, 네 제곱합을 모두 손으로 계산하시오. 또 \(F_{AB} = t^2\) 이며 \(t = L/\widehat{\operatorname{SE}}(L)\) 임을 확인하시오.
(2) 잔차 자유도가 \(4\) 뿐이라는 사실의 대가를 수로 재시오. \(5\%\) 에서 유의하려면 \(|L|\) 이 얼마보다 커야 하는가. 참값이 \(L = 2,\,4,\,6,\,8\) 일 때의 검정력을 구하고, \(p = 0.64\) 를 "교호작용이 없다"로 읽으면 왜 안 되는지 말하시오.
풀이
(1) 해석적으로. 보기 1에서 \(a = 2\) 일 때 \(SSAB = \frac{c}{2}\sum_j(\delta_j - \bar\delta)^2\) 였다. 이제 \(b = 2\) 이면 \(\delta_1, \delta_2\) 둘뿐이고 \(\bar\delta = \frac{\delta_1+\delta_2}{2}\) 이므로
이고(여기서 \(L = \delta_1 - \delta_2\) 가 보기에 적힌 네 칸평균의 대비다) 따라서
이다. 자유도가 \((a-1)(b-1) = 1\) 이므로 \(MSAB = SSAB\) 다.
한편 \(L\) 은 네 칸평균의 계수 \((+1,-1,-1,+1)\) 짜리 대비이고 각 칸평균의 분산이 \(\sigma^2/c\) 이므로
이고
로 \(F_{AB}\) 가 정확히 \(t^2\) 이다. 자유도 \(1\) 의 \(F\) 가 늘 그렇다.
칸평균은 \((60,62)\to 61\), \((68,70)\to 69\), \((65,63)\to 64\), \((72,74)\to 73\) 이다. 수를 넣으면 아래에서 확인한다.
(2) 검정력. 참 대비가 \(L\) 일 때 비중심모수는
이고 검정력은 \(P\!\left(F'(1,4;\lambda) > F_{0.95}(1,4)\right)\) 다. \(F_{0.95}(1,4) = 7.7086\) 으로 임계값이 매우 높다는 것이 자유도 \(4\) 의 대가다.
import pandas as pd
from statsmodels.formula.api import ols
from statsmodels.stats.anova import anova_lm

# 교수법 둘과 학습시간 둘, 칸마다 두 명씩인 2x2 설계다.
# 칸당 반복이 둘뿐이라 자유도가 매우 적다. 교호작용을 재려면 칸마다
# 반복이 적어도 둘은 있어야 한다는 요구를 겨우 맞춘 셈이다.
data = {
    'Teaching_Method': ['Traditional', 'Traditional', 'Traditional', 'Traditional',
                        'Online', 'Online', 'Online', 'Online'],
    'Study_Time': ['1 Hour', '1 Hour', '2 Hours', '2 Hours',
                   '1 Hour', '1 Hour', '2 Hours', '2 Hours'],
    'Score': [60, 62, 68, 70, 65, 63, 72, 74]
}
df = pd.DataFrame(data)

model = ols('Score ~ C(Teaching_Method) + C(Study_Time) + C(Teaching_Method):C(Study_Time)', data=df).fit()
anova_results = anova_lm(model)
print("Two-Way ANOVA Results:")
print(anova_results)
출력:
Two-Way ANOVA Results:
                                   df  sum_sq  mean_sq      F    PR(>F)
C(Teaching_Method)                1.0    24.5     24.5  12.25  0.024896
C(Study_Time)                     1.0   144.5    144.5  72.25  0.001051
C(Teaching_Method):C(Study_Time)  1.0     0.5      0.5   0.25  0.643330
Residual                          4.0     8.0      2.0    NaN       NaN
손계산한 표와 정확히 일치한다. (1)과 (2)를 수로 확인한다.
import warnings

import numpy as np
from scipy import stats

c = 2
M = df.pivot_table(index='Teaching_Method', columns='Study_Time',
                   values='Score', aggfunc='mean')
print("칸평균")
print(M)

row, col = M.mean(axis=1), M.mean(axis=0)
grand = M.values.mean()
SSA = 2 * c * ((row - grand) ** 2).sum()
SSB = 2 * c * ((col - grand) ** 2).sum()
L = (M.iloc[0, 0] - M.iloc[0, 1]) - (M.iloc[1, 0] - M.iloc[1, 1])
SSAB = c * L ** 2 / 4
SSE = sum(((v.values - v.values.mean()) ** 2).sum()
          for _, v in df.groupby(['Teaching_Method', 'Study_Time'])['Score'])
print(f"\n행평균 {row.values}  열평균 {col.values}  전체 {grand}")
print(f"SSA = {SSA}   SSB = {SSB}   L = {L}   SSAB = c L^2/4 = {SSAB}")
print(f"SSE = {SSE}   합 = {SSA + SSB + SSAB + SSE}   "
      f"SST = {((df['Score'] - df['Score'].mean()) ** 2).sum()}")

MSE = SSE / 4
se_L = np.sqrt(4 * MSE / c)
t_L = L / se_L
print(f"\nMSE = {MSE},  SE(L) = {se_L},  t = {t_L},  t^2 = {t_L ** 2}")

# 자유도 4 에서 잡아낼 수 있는 교호작용의 크기는 얼마인가.
t_crit = stats.t.ppf(0.975, 4)
print(f"\nt(0.975, 4) = {t_crit:.4f}  ->  |L| > {t_crit * se_L:.4f} 이어야 유의하다")
print(f"견줄 것: 학습시간 주효과의 크기 = {col.iloc[1] - col.iloc[0]:.1f}")

F_crit = stats.f(1, 4).ppf(0.95)
print(f"\n{'참 L':>8}{'lambda':>10}{'검정력':>10}")
with warnings.catch_warnings():
    warnings.simplefilter("ignore")
    for L_true in (1, 2, 4, 6, 8):
        lam = c * L_true ** 2 / (4 * MSE)
        print(f"{L_true:>8}{lam:>10.3f}{stats.ncf(1, 4, lam).sf(F_crit):>10.4f}")
출력:
칸평균
Study_Time       1 Hour  2 Hours
Teaching_Method
Online             64.0     73.0
Traditional        61.0     69.0

행평균 [68.5 65. ]  열평균 [62.5 71. ]  전체 66.75
SSA = 24.5   SSB = 144.5   L = -1.0   SSAB = c L^2/4 = 0.5
SSE = 8.0   합 = 177.5   SST = 177.5

MSE = 2.0,  SE(L) = 2.0,  t = -0.5,  t^2 = 0.25

t(0.975, 4) = 2.7764  ->  |L| > 5.5529 이어야 유의하다
견줄 것: 학습시간 주효과의 크기 = 8.5

     참 L    lambda       검정력
       1     0.250    0.0679
       2     1.000    0.1222
       4     4.000    0.3360
       6     9.000    0.6193
       8    16.000    0.8433
(1)이 그대로 맞는다. 손으로 구한 \(SSA = 24.5\), \(SSB = 144.5\), \(SSAB = 0.5\), \(SSE = 8.0\) 이 분산분석표와 똑같고 합이 \(SST = 177.5\) 다. 대비는 \(L = -1.0\) 이고 \(SSAB = \frac{2}{4}\times 1 = 0.5\) 다. \(t = -0.5\) 를 제곱하면 \(0.25\) 로 표의 \(F_{AB}\) 와 같다.
(2) 자유도 \(4\) 의 대가가 크다. \(\widehat{\operatorname{SE}}(L) = 2.0\) 이고 \(t_{0.975,4} = 2.7764\) 이므로 \(|L| > 5.55\) 여야 유의하다고 말할 수 있다. 그런데 이 자료에서 가장 큰 효과인 학습시간 주효과가 \(8.5\) 점이다. 곧 주효과에 맞먹는 크기의 교호작용이 아니면 이 설계는 잡아내지 못한다.
검정력 표가 그것을 수로 말해 준다.
| 참 \(L\) | \(\lambda\) | 검정력 |
|---|---|---|
| \(1\) | \(0.25\) | \(0.068\) |
| \(2\) | \(1.00\) | \(0.122\) |
| \(4\) | \(4.00\) | \(0.336\) |
| \(6\) | \(9.00\) | \(0.619\) |
| \(8\) | \(16.00\) | \(0.843\) |
관측된 \(L = -1\) 이 참값이라면 검정력이 \(0.068\) 로 명목수준 \(0.05\) 와 거의 다르지 않다. \(L = 4\) 라는 꽤 큰 교호작용이 실제로 있어도 세 번에 두 번은 놓친다.
그러므로 \(p = 0.64\) 는 "교호작용이 없다"는 증거가 아니라 "이 설계로는 알 수 없다"는 뜻이다. 기각하지 못한 것과 귀무가설이 참인 것은 다르다. 교호작용을 진지하게 보려면 칸마다 반복을 늘려야 한다. \(c\) 를 \(2\) 에서 \(8\) 로 늘리면 \(\lambda\) 가 네 배가 되고 분모 자유도도 \(4\) 에서 \(28\) 로 커져 임계값이 \(7.71\) 에서 \(4.20\) 으로 내려간다.
R 코드
# 필요한 라이브러리
library(dplyr)
library(stats)

data <- data.frame(
  Teaching_Method = factor(c('Traditional', 'Traditional', 'Traditional', 'Traditional',
                             'Online', 'Online', 'Online', 'Online')),
  Study_Time = factor(c('1 Hour', '1 Hour', '2 Hours', '2 Hours',
                        '1 Hour', '1 Hour', '2 Hours', '2 Hours')),
  Score = c(60, 62, 68, 70, 65, 63, 72, 74)
)

model <- aov(Score ~ Teaching_Method + Study_Time + Teaching_Method:Study_Time, data = data)
anova_results <- summary(model)
print("Two-Way ANOVA Results:")
print(anova_results)
R 출력 해석
R 출력은 Df, Sum Sq, Mean Sq, F value, Pr(>F) 열을 가진 동일한 분산분석표를 준다. 유의성 표시(*는 p < 0.05, **는 p < 0.01)가 다음을 확인해 준다:
Teaching_Method와Study_Time모두Score에 통계적으로 유의한 주효과를 갖는다.Teaching_Method와Study_Time사이의 교호작용은 통계적으로 유의하지 않으므로, 교수법이 점수에 미치는 효과가 학습시간에 의존하지 않음을 시사한다.
연습문제
연습문제 1. 이원배치 분산분석 모형 \(Y_{ijk} = \mu + \alpha_i + \beta_j + (\alpha\beta)_{ij} + \varepsilon_{ijk}\)에서 교호작용 항 \((\alpha\beta)_{ij}\)가 무엇을 나타내는지 말로 설명하라. 교육 맥락에서 유의한 교호작용이 예상되는 구체적인 예를 들어라.
풀이
교호작용 항 \((\alpha\beta)_{ij}\)는 요인 A가 수준 \(i\)이고 요인 B가 수준 \(j\)일 때, 주효과 \(\alpha_i\)와 \(\beta_j\)만으로 예측되는 것을 넘어서 반응에 추가로 나타나는 효과를 담는다. 한 요인의 효과가 다른 요인의 수준에 얼마나 의존하는지를 잰다.
예: 요인 A가 교수법(강의식 대 실습식)이고 요인 B가 학생 배경(STEM 대 인문학)이라고 하자. 실습식 교육의 주효과가 전체적으로는 양수일 수 있지만, 인문학 학생보다 STEM 학생에게 훨씬 더 이롭다면 교호작용 항이 유의해진다. 교호작용 그림에서 두 선이 평행하지 않은 것으로 이를 확인할 수 있다.
연습문제 2. 칸당 반복 \(c = 4\)인 \(2 \times 3\) 요인실험에서 \(\text{SSA} = 30\), \(\text{SSB} = 80\), \(\text{SSAB} = 24\), \(\text{SSE} = 60\)을 얻었다. 전체 분산분석표를 작성하고 \(\alpha = 0.05\)에서 세 효과를 모두 검정하라.
풀이
자유도: \(a - 1 = 1\), \(b - 1 = 2\), \((a-1)(b-1) = 2\), \(ab(c-1) = 6 \times 3 = 18\).
| 원천 | SS | df | MS | F |
|---|---|---|---|---|
| 요인 A | 30 | 1 | 30.0 | 9.00 |
| 요인 B | 80 | 2 | 40.0 | 12.00 |
| 교호작용 | 24 | 2 | 12.0 | 3.60 |
| 오차 | 60 | 18 | 3.333 | |
| 전체 | 194 | 23 |
\(\alpha = 0.05\)에서 임계값: \(F_{0.05, 1, 18} \approx 4.41\), \(F_{0.05, 2, 18} \approx 3.55\).
- 요인 A: \(F = 9.00 > 4.41\)이므로 \(H_0\)을 기각한다. 주효과가 유의하다.
- 요인 B: \(F = 12.00 > 3.55\)이므로 \(H_0\)을 기각한다. 주효과가 유의하다.
- 교호작용: \(F = 3.60 > 3.55\)이므로 \(H_0\)을 기각한다. 교호작용이 (아슬아슬하게) 유의하다.
연습문제 3. 치아 성장 자료(보충제 종류 OJ 대 VC, 용량 0.5, 1.0, 2.0)에서 교호작용 그림은 낮은 용량에서 OJ가 VC보다 긴 치아 길이를 낳지만 용량 2.0에서는 둘이 수렴함을 보여준다. 유의한 교호작용을 함께 고려하지 않고 보충제 종류의 주효과만 해석해서는 안 되는 이유를 설명하라.
풀이
유의한 교호작용이 있으면 한 요인의 효과가 다른 요인의 수준에 의존하므로 주효과가 오도한다. OJ가 평균적으로 더 큰 치아 성장을 낳는다고(주효과) 보고하면, 그 우위가 가장 높은 용량에서는 사라진다는 사실을 무시하는 것이다. 용량 2.0에서는 두 보충제의 효과가 같으므로 보충제 종류의 주효과는 전적으로 낮은 용량 수준에서 나온다. 올바른 해석에는 단순 효과, 즉 각 용량 수준에서 보충제의 효과를 따로 살피는 일이 필요하다.
연습문제 4. 반복 없는 이원배치 분산분석과 반복 있는 경우의 차이를 설명하라. 반복이 없을 때 교호작용 제곱합이 오차항과 교란되는 이유는 무엇인가?
풀이
반복 있는 이원배치 분산분석에서는 각 요인 수준 조합에 관측값이 여럿 있어 전체 변동을 \(\text{SSA} + \text{SSB} + \text{SSAB} + \text{SSE}\)로 분해할 수 있다. 칸 내 변동이 오차(\(\text{SSE}\))의 독립적인 추정값을 준다.
반복 없는 이원배치 분산분석에서는 각 칸에 관측값이 하나뿐이다. 칸당 관측값이 하나면 \(\text{SSE}\)를 따로 추정할 칸 내 변동이 없다. 그래서 잔차인 \(\text{SSAB}\)가 오차항 역할을 하게 되고, 교호작용 효과를 독립적으로 검정할 수 없다. 참 교호작용이 있으면 오차에 흡수되어 교호작용을 가리는 동시에 오차분산을 부풀릴 수 있다.
연습문제 5. 교호작용 검정이 주효과 검정보다 검정력이 훨씬 낮다는 사실을 확인하고, 그 이유를 대비의 분산으로 설명하라.
풀이
\(2\times2\) 설계의 세 대비. 칸 평균을 \((\bar y_{11},\bar y_{10},\bar y_{01},\bar y_{00})\)이라 하면
| 효과 | 대비 계수 | \(\sum c_i^2\) |
|---|---|---|
| A 주효과 | \((\tfrac12,\tfrac12,-\tfrac12,-\tfrac12)\) | 1 |
| B 주효과 | \((\tfrac12,-\tfrac12,\tfrac12,-\tfrac12)\) | 1 |
| 교호작용 | \((1,-1,-1,1)\) | 4 |
각 칸 평균의 분산이 \(\sigma^2/n\)이므로 교호작용 대비의 분산이 네 배다.
import warnings
warnings.filterwarnings("ignore", category=RuntimeWarning)

import numpy as np
from scipy import stats

def n_needed(delta, var_coef, sigma=1.0, power=0.80, alpha=0.05):
    """대비의 분산이 var_coef·σ²/n 일 때 크기 delta 를 잡는 데 필요한 n."""
    for n in range(3, 100_000):
        se = sigma * np.sqrt(var_coef / n)
        df = 4 * (n - 1)
        ncp = (delta / se)**2
        if stats.ncf.sf(stats.f.ppf(1 - alpha, 1, df), 1, df, ncp) >= power:
            return n

print(f"{'δ':>5s} {'주효과 n':>10s} {'교호작용 n':>12s} {'비':>6s}")
for d in [0.3, 0.5, 0.8, 1.0]:
    a = n_needed(d, 1.0)
    b = n_needed(d, 4.0)
    print(f"{d:5.1f} {a:10d} {b:12d} {b / a:6.2f}")
    δ      주효과 n       교호작용 n      비
  0.3         88          350   3.98
  0.5         32          127   3.97
  0.8         13           50   3.85
  1.0          9           32   3.56
같은 크기의 효과를 잡으려면 표본이 약 4배 필요하다.
이것이 "교호작용은 놓치기 쉽다"의 정확한 이유다. 표준오차가 2배이므로 \(t\) 통계량이 절반이고, 따라서 \(n\)이 4배 필요하다.
모의실험으로도 확인된다.
import pandas as pd
import statsmodels.api as sm
from statsmodels.formula.api import ols

rng = np.random.default_rng(1122)
M, sigma = 2_000, 1.0
print(f"\n2×2, 칸당 n, 칸 평균 (0, d, d, 3d) — 교호작용 크기 = d")
print(f"{'n':>4s} {'d':>5s} {'A 주효과':>10s} {'B 주효과':>10s} {'교호작용':>10s}")
for n in [10, 20, 40]:
    for d in [0.5, 1.0]:
        mu = {(0, 0): 0.0, (0, 1): d, (1, 0): d, (1, 1): 3 * d}
        a = b = c = 0
        for _ in range(M):
            frames = []
            for i in range(2):
                for j in range(2):
                    frames.append(pd.DataFrame(
                        {"y": rng.normal(mu[(i, j)], sigma, n),
                         "A": i, "B": j}))
            df = pd.concat(frames)
            tab = sm.stats.anova_lm(ols("y ~ C(A)*C(B)", data=df).fit(), typ=2)
            a += tab.loc["C(A)", "PR(>F)"] < 0.05
            b += tab.loc["C(B)", "PR(>F)"] < 0.05
            c += tab.loc["C(A):C(B)", "PR(>F)"] < 0.05
        print(f"{n:4d} {d:5.1f} {a / M:10.4f} {b / M:10.4f} {c / M:10.4f}")
2×2, 칸당 n, 칸 평균 (0, d, d, 3d) — 교호작용 크기 = d
   n     d      A 주효과      B 주효과       교호작용
  10   0.5     0.6425     0.6515     0.1105
  10   1.0     0.9965     0.9945     0.3260
  20   0.5     0.9070     0.9045     0.1995
  20   1.0     1.0000     1.0000     0.6050
  40   0.5     0.9960     0.9980     0.3225
  40   1.0     1.0000     1.0000     0.8725
\(n=10\), \(d=0.5\)에서 주효과는 0.64로 잡는데 교호작용은 0.11이다.
\(n\)을 4배로 늘리면 교호작용의 검정력이 주효과의 원래 수준에 가까워진다. \(n=10\)의 주효과 0.64와 \(n=40\)의 교호작용 0.32를 비교하면 아직 부족하지만, 여기서는 주효과의 크기가 \(1.5d\)로 교호작용(\(d\))보다 커서 그렇다.
실무적 함의 넷.
- 교호작용을 주 관심사로 하는 연구는 표본을 4배로 잡아야 한다.
- "교호작용이 유의하지 않다"를 "없다"로 읽지 않는다. 검정력이 0.11일 수 있다.
- 교호작용의 신뢰구간을 함께 보고한다. 구간이 넓으면 "결정 불가"다.
- 탐색적 하위집단 분석이 위험한 이유가 여기 있다. 하위집단별 효과 차이는 곧 교호작용이고, 대개 검정력이 턱없이 부족하다.
일반화. \(a\times b\) 설계에서 교호작용의 자유도는 \((a-1)(b-1)\)로 주효과보다 크다. 자유도가 크면 임계값도 커져 불리함이 더해진다.
연습문제 6. 연습문제 2의 분산분석표를 코드로 재현하고, 효과크기까지 계산하라.
풀이
import numpy as np
from scipy import stats

SSA, SSB, SSAB, SSE = 30.0, 80.0, 24.0, 60.0
a, b, c = 2, 3, 4                      # 2×3 요인, 칸당 반복 4
N = a * b * c
df_a, df_b, df_ab, df_e = a - 1, b - 1, (a - 1) * (b - 1), a * b * (c - 1)
SS_total = SSA + SSB + SSAB + SSE

print(f"{'원천':>8s} {'SS':>8s} {'df':>4s} {'MS':>9s} {'F':>9s} {'p':>9s}")
MSE = SSE / df_e
for name, ss, dfx in [("A", SSA, df_a), ("B", SSB, df_b),
                      ("A×B", SSAB, df_ab)]:
    ms = ss / dfx
    F = ms / MSE
    print(f"{name:>8s} {ss:8.2f} {dfx:4d} {ms:9.4f} {F:9.4f} "
          f"{stats.f.sf(F, dfx, df_e):9.4f}")
print(f"{'오차':>8s} {SSE:8.2f} {df_e:4d} {MSE:9.4f}")
print(f"{'전체':>8s} {SS_total:8.2f} {N - 1:4d}")

print(f"\n효과크기")
for name, ss, dfx in [("A", SSA, df_a), ("B", SSB, df_b),
                      ("A×B", SSAB, df_ab)]:
    eta2 = ss / SS_total
    partial = ss / (ss + SSE)
    omega2 = (ss - dfx * MSE) / (SS_total + MSE)
    print(f"  {name:>4s}:  η² = {eta2:.4f},  부분 η² = {partial:.4f},  "
          f"ω² = {omega2:.4f}")
      원천       SS   df        MS         F         p
       A    30.00    1   30.0000    9.0000    0.0077
       B    80.00    2   40.0000   12.0000    0.0005
     A×B    24.00    2   12.0000    3.6000    0.0484
      오차    60.00   18    3.3333
      전체   194.00   23

효과크기
     A:  η² = 0.1546,  부분 η² = 0.3333,  ω² = 0.1351
     B:  η² = 0.4124,  부분 η² = 0.5714,  ω² = 0.3716
   A×B:  η² = 0.1237,  부분 η² = 0.2857,  ω² = 0.0878
세 효과가 모두 유의하다. 교호작용은 \(p=0.043\)으로 경계에 있다.
\(\eta^2\)과 부분 \(\eta^2\)이 크게 다르다.
| 효과 | \(\eta^2\) | 부분 \(\eta^2\) |
|---|---|---|
| A | 0.155 | 0.333 |
| B | 0.412 | 0.571 |
| A×B | 0.124 | 0.286 |
부분 \(\eta^2\)은 다른 효과가 설명한 변동을 분모에서 뺀다. 그래서 언제나 더 크고, 세 값의 합이 1을 넘을 수 있다(0.333+0.571+0.286=1.19).
어느 것을 보고할까.
| 목적 | 지표 |
|---|---|
| 전체 변동의 분해 | \(\eta^2\)(합이 1이 됨) |
| 다른 설계의 연구와 비교 | 부분 \(\eta^2\)(관례) |
| 편향이 적은 추정 | \(\omega^2\) |
\(\omega^2\)이 가장 작다. \(\eta^2\)의 위쪽 편향을 보정하기 때문이다. 교호작용에서 0.124 → 0.088로 29% 줄어든다.
\(H_0\)가 참이면 \(E[\text{SS}_{\text{효과}}]=\text{df}\cdot\text{MSE}\)이므로, 그만큼 빼면 기댓값이 0에 가까워진다.
자유도가 검정력에 어떻게 들어가는지 보인다. A의 SS(30)가 A×B의 SS(24)보다 조금 큰데 \(F\)는 9.0 대 3.6으로 2.5배 차이난다. 자유도가 1과 2로 다르기 때문이다.
연습문제 7. 연습문제 4가 지적한 반복 없는 이원배치를 다루는 방법으로 터키의 1자유도 비가법성 검정을 구현하라.
풀이
문제. 칸마다 관측이 하나뿐이면 \(\text{SSE}\)를 따로 추정할 수 없다. 교호작용 제곱합이 곧 잔차 제곱합이 되어 둘을 구분할 수 없다.
터키의 해법. 교호작용이 곱셈 형태 \((\alpha\beta)_{ij}=\lambda\alpha_i\beta_j\)라고 가정하면, 자유도 1짜리 성분만 추정하면 된다.
import numpy as np
import pandas as pd
from scipy import stats
import statsmodels.api as sm
from statsmodels.formula.api import ols

rng = np.random.default_rng(7788)
a, b = 4, 5
base = np.add.outer(np.array([0., 1, 2, 3]), np.array([0., 0.5, 1, 1.5, 2]))

def tukey_nonadditivity(Y):
    """반복 없는 이원배치에서 터키의 1자유도 비가법성 검정."""
    a, b = Y.shape
    grand = Y.mean()
    alpha = Y.mean(1) - grand
    beta = Y.mean(0) - grand
    fitted = grand + alpha[:, None] + beta[None, :]
    resid = Y - fitted
    SSE = (resid**2).sum()
    SS_na = ((resid * np.outer(alpha, beta)).sum()**2
             / ((alpha**2).sum() * (beta**2).sum()))
    df_e = (a - 1) * (b - 1)
    F = SS_na / ((SSE - SS_na) / (df_e - 1))
    return SS_na, SSE, F, stats.f.sf(F, 1, df_e - 1)

# ① 진짜 가법 모형
Y1 = base + rng.normal(0, 0.8, (a, b))
df1 = pd.DataFrame([{"y": Y1[i, j], "A": i, "B": j}
                    for i in range(a) for j in range(b)])
print("① 가법 자료 — 반복 없는 이원배치")
print(sm.stats.anova_lm(ols("y ~ C(A)+C(B)", data=df1).fit(), typ=2).round(4))
ss, sse, F, p = tukey_nonadditivity(Y1)
print(f"  터키 비가법성: SS = {ss:.4f} / SSE = {sse:.4f},  "
      f"F(1,{(a - 1) * (b - 1) - 1}) = {F:.4f},  p = {p:.4f}")

# ② 곱셈형(비가법) 자료
Y2 = np.exp(base * 0.6) + rng.normal(0, 0.8, (a, b))
ss2, sse2, F2, p2 = tukey_nonadditivity(Y2)
print(f"\n② 곱셈형 자료")
print(f"  터키 비가법성: SS = {ss2:.4f} / SSE = {sse2:.4f},  "
      f"F = {F2:.4f},  p = {p2:.4f}")
① 가법 자료 — 반복 없는 이원배치
           sum_sq    df        F  PR(>F)
C(A)      45.9658   3.0  27.2948  0.0000
C(B)      19.6479   4.0   8.7503  0.0015
Residual   6.7362  12.0      NaN     NaN
  터키 비가법성: SS = 0.2574 / SSE = 6.7362,  F(1,11) = 0.4371,  p = 0.5221

② 곱셈형 자료
  터키 비가법성: SS = 44.3733 / SSE = 58.1807,  F = 35.3512,  p = 0.0001
가법 자료에서는 잡아내지 않는다(\(p=0.52\)). 비가법성 SS가 0.257로 전체 잔차 6.736의 4%에 불과하다.
곱셈형 자료에서는 강하게 잡는다(\(p=0.0001\)). 비가법성 SS가 44.4로 잔차 58.2의 76%를 차지한다. 자유도 1짜리 성분 하나가 잔차의 대부분을 설명한다는 뜻이다.
이 검정이 하는 일. 잔차 \((a-1)(b-1)\)개 중에서 "\(\hat\alpha_i\hat\beta_j\) 방향"의 1자유도만 떼어 내 검정한다. 남은 \((a-1)(b-1)-1\)개가 순수 오차 역할을 한다.
한계 셋.
- 곱셈형 교호작용만 잡는다. 다른 모양(예: 한 칸만 튀는 경우)은 놓친다.
- 자유도가 1뿐이라 검정력이 제한적이다.
- 유의하면 무엇을 할지가 애매하다. 교호작용의 모양을 추정할 수는 없다.
유의할 때의 대처.
| 방법 | 내용 |
|---|---|
| 변환 | \(\log\)나 제곱근이 곱셈형을 덧셈형으로 바꾼다 |
| 반복을 늘림 | 가능하면 칸당 2개 이상 |
| 다른 모형 | 비가법성을 명시적으로 모형화 |
변환이 실제로 통하는지 확인해 보자.
Y2_log = np.log(np.clip(Y2, 0.1, None))
ss3, sse3, F3, p3 = tukey_nonadditivity(Y2_log)
print(f"로그 변환 후: SS = {ss3:.4f} / SSE = {sse3:.4f},  "
      f"F = {F3:.4f},  p = {p3:.4f}")
로그 변환 후: SS = 1.7980 / SSE = 4.5126, F = 7.2859, p = 0.0207
로그 변환이 비가법성을 크게 줄인다. \(F\)가 35.35에서 7.29로, 비가법성이 차지하는 잔차 비율이 76%에서 40%로 떨어진다.
그러나 완전히 사라지지는 않는다(\(p=0.021\), 여전히 유의). 자료를 \(\exp(\text{가법})+\varepsilon\)으로 만들었기 때문이다. 오차가 지수 안이 아니라 밖에 더해져 있어, 로그를 취하면 오차 자체가 곱셈형으로 뒤틀린다.
여기서 배울 것. 변환은 만병통치약이 아니다.
| 자료 생성 구조 | 로그 변환의 결과 |
|---|---|
| \(\exp(\mu+\alpha_i+\beta_j)\cdot\varepsilon\) | 완전히 가법이 됨 |
| \(\exp(\mu+\alpha_i+\beta_j)+\varepsilon\) | 크게 줄지만 잔존 |
곱셈형 구조가 의심되면 로그 변환을 먼저 시도하되, 변환 후에도 검정을 다시 하라.
반복이 없는 설계를 피하는 것이 최선이다. 칸당 2개만 있어도 교호작용을 자유도 \((a-1)(b-1)\)로 제대로 검정할 수 있다.
연습문제 8. 연습문제 3의 ToothGrowth 상황에서, 교호작용을 무시하고 주효과만 적합하면 무엇이 달라지는지 확인하라.
풀이
import numpy as np
import pandas as pd
import statsmodels.api as sm
from statsmodels.formula.api import ols

tooth = [4.2, 11.5, 7.3, 5.8, 6.4, 10, 11.2, 11.2, 5.2, 7,
         16.5, 16.5, 15.2, 17.3, 22.5, 17.3, 13.6, 14.5, 18.8, 15.5,
         23.6, 18.5, 33.9, 25.5, 26.4, 32.5, 26.7, 21.5, 23.3, 29.5,
         15.2, 21.5, 17.6, 9.7, 14.5, 10, 8.2, 9.4, 16.5, 9.7,
         19.7, 23.3, 23.6, 26.4, 20, 25.2, 25.8, 21.2, 14.5, 27.3,
         25.5, 26.4, 22.4, 24.5, 24.8, 30.9, 26.4, 27.3, 29.4, 23]
df = pd.DataFrame({
    "len": tooth,
    "supp": ["VC"] * 30 + ["OJ"] * 30,
    "dose": ([0.5] * 10 + [1.0] * 10 + [2.0] * 10) * 2,
})

full = ols("len ~ C(supp) * C(dose)", data=df).fit()
add = ols("len ~ C(supp) + C(dose)", data=df).fit()
print("교호작용 포함 모형")
print(sm.stats.anova_lm(full, typ=2).round(4))
print("\n주효과만 있는 모형")
print(sm.stats.anova_lm(add, typ=2).round(4))
print(f"\nR²:  포함 {full.rsquared:.4f}   주효과만 {add.rsquared:.4f}")
print(f"조정 R²:  포함 {full.rsquared_adj:.4f}   주효과만 {add.rsquared_adj:.4f}")
print(f"AIC:  포함 {full.aic:.4f}   주효과만 {add.aic:.4f}")
교호작용 포함 모형
                    sum_sq    df       F  PR(>F)
C(supp)           205.3500   1.0  15.572  0.0002
C(dose)          2426.4343   2.0  92.000  0.0000
C(supp):C(dose)   108.3190   2.0   4.107  0.0219
Residual          712.1060  54.0     NaN     NaN

주효과만 있는 모형
             sum_sq    df        F  PR(>F)
C(supp)    205.3500   1.0  14.0166  0.0004
C(dose)   2426.4343   2.0  82.8109  0.0000
Residual   820.4250  56.0      NaN     NaN

R²:  포함 0.7937   주효과만 0.7623
조정 R²:  포함 0.7746   주효과만 0.7496
AIC:  포함 330.7056   주효과만 335.2013
주효과의 제곱합은 똑같다(205.35, 2426.43). 균형 설계이므로 교호작용을 넣든 빼든 주효과의 SS가 변하지 않는다.
달라지는 것은 오차와 \(F\)다.
| 교호작용 포함 | 주효과만 | |
|---|---|---|
| \(\text{SSE}\) | 712.11 | 820.43 |
| \(\text{df}_e\) | 54 | 56 |
| \(\text{MSE}\) | 13.19 | 14.65 |
| supp의 \(F\) | 15.57 | 14.02 |
교호작용을 빼면 그 변동(108.32)이 오차로 들어간다. \(\text{MSE}\)가 13.19에서 14.65로 11% 커지고, 주효과의 \(F\)가 작아진다.
주효과 검정에는 오히려 손해다. 교호작용이 유의한데 모형에서 빼면 오차를 부풀려 주효과의 검정력을 떨어뜨린다.
모형 비교 지표도 포함 쪽을 지지한다.
| 지표 | 포함 | 주효과만 |
|---|---|---|
| \(R^2\) | 0.794 | 0.763 |
| 조정 \(R^2\) | 0.775 | 0.751 |
| AIC | 330.71 | 335.20 |
AIC가 4.5 낮다. 자유도 2를 더 쓰는 대가보다 설명력의 이득이 크다.
그런데 이것이 "주효과를 해석해도 된다"는 뜻은 아니다. 모형이 잘 적합되는 것과 주효과의 해석이 타당한 것은 별개다.
print("주효과만 있는 모형의 예측값 (칸별)")
grid = pd.DataFrame([{"supp": s, "dose": d}
                     for s in ["OJ", "VC"] for d in [0.5, 1.0, 2.0]])
grid["예측"] = add.predict(grid).round(4)
grid["실제"] = [df[(df.supp == r.supp) & (df.dose == r.dose)].len.mean()
               for r in grid.itertuples()]
grid["잔차"] = (grid["실제"] - grid["예측"]).round(4)
print(grid.to_string(index=False))
주효과만 있는 모형의 예측값 (칸별)
supp  dose     예측    실제     잔차
  OJ   0.5 12.455 13.23  0.775
  OJ   1.0 21.585 22.70  1.115
  OJ   2.0 27.950 26.06 -1.890
  VC   0.5  8.755  7.98 -0.775
  VC   1.0 17.885 16.77 -1.115
  VC   2.0 24.250 26.14  1.890
가법 모형이 용량 2.0을 체계적으로 틀리게 예측한다. OJ를 1.89 과대, VC를 1.89 과소 예측한다.
잔차가 \(+\)와 \(-\)로 대칭인 패턴이 곧 교호작용의 흔적이다. 잔차 그림을 그리면 이 구조가 눈에 보인다.
결론. 교호작용이 유의하면
- 모형에 포함한다(오차가 작아지고 적합이 좋아진다).
- 주효과는 그대로 해석하지 않는다(단순주효과로 간다).
- 두 결정은 별개의 문제다.
연습문제 9. 순서형 교호작용과 비순서형 교호작용을 수치 예로 구분하고, 각각에서 주효과의 의미가 어떻게 달라지는지 보여라.
풀이
import numpy as np
import pandas as pd
import statsmodels.api as sm
from statsmodels.formula.api import ols

rng = np.random.default_rng(4321)
n, sigma = 20, 1.0

def build(cells, rng, n=20, sigma=1.0):
    frames = []
    for (i, j), mu in cells.items():
        frames.append(pd.DataFrame({"y": rng.normal(mu, sigma, n),
                                    "A": i, "B": j}))
    return pd.concat(frames, ignore_index=True)

scenarios = {
    "교호작용 없음": {(0, 0): 0.0, (0, 1): 1.0, (1, 0): 2.0, (1, 1): 3.0},
    "순서형 (크기만 다름)": {(0, 0): 0.0, (0, 1): 1.0, (1, 0): 2.0, (1, 1): 4.0},
    "비순서형 (교차)": {(0, 0): 0.0, (0, 1): 2.0, (1, 0): 2.0, (1, 1): 0.0},
}
for label, cells in scenarios.items():
    df = build(cells, rng, n, sigma)
    tab = sm.stats.anova_lm(ols("y ~ C(A)*C(B)", data=df).fit(), typ=2)
    m = df.groupby(["A", "B"]).y.mean()
    simple0 = m[(1, 0)] - m[(0, 0)]      # B=0 에서 A 의 효과
    simple1 = m[(1, 1)] - m[(0, 1)]      # B=1 에서 A 의 효과
    marg = df.groupby("A").y.mean()
    print(f"[{label}]")
    print(f"  A 의 단순효과:  B=0 에서 {simple0:+.3f},  B=1 에서 {simple1:+.3f}")
    print(f"  A 의 주효과(주변):  {marg[1] - marg[0]:+.3f}")
    print(f"  A: p={tab.loc['C(A)', 'PR(>F)']:.4f}   "
          f"B: p={tab.loc['C(B)', 'PR(>F)']:.4f}   "
          f"A×B: p={tab.loc['C(A):C(B)', 'PR(>F)']:.4f}\n")
[교호작용 없음]
  A 의 단순효과:  B=0 에서 +2.143,  B=1 에서 +1.848
  A 의 주효과(주변):  +1.996
  A: p=0.0000   B: p=0.0000   A×B: p=0.5066

[순서형 (크기만 다름)]
  A 의 단순효과:  B=0 에서 +1.800,  B=1 에서 +3.089
  A 의 주효과(주변):  +2.444
  A: p=0.0000   B: p=0.0000   A×B: p=0.0018

[비순서형 (교차)]
  A 의 단순효과:  B=0 에서 +1.505,  B=1 에서 -1.700
  A 의 주효과(주변):  -0.097
  A: p=0.6632   B: p=0.5486   A×B: p=0.0000
세 경우의 성격이 뚜렷이 다르다.
| 상황 | 단순효과 | 주효과 | 주효과의 의미 |
|---|---|---|---|
| 교호작용 없음 | \(+2.14\), \(+1.85\) | \(+2.00\) | 정확한 요약 |
| 순서형 | \(+1.80\), \(+3.09\) | \(+2.44\) | 평균이지만 부호는 맞다 |
| 비순서형 | \(+1.51\), \(\mathbf{-1.70}\) | \(-0.10\) | 완전히 오도 |
비순서형에서 주효과가 0에 가깝다(\(-0.10\), \(p=0.66\)). A의 효과가 \(+1.51\)과 \(-1.70\)로 서로 상쇄되었기 때문이다.
"A는 효과가 없다"고 결론지으면 명백히 틀렸다. A는 B=0에서 강한 양의 효과, B=1에서 강한 음의 효과를 갖는다. 두 효과 모두 실재한다.
이것이 비순서형 교호작용에서 주효과를 보고하지 말라는 이유다. 주효과의 \(p\)값(A는 0.66, B는 0.55)만 보면 "아무 효과도 없는 자료"로 읽히지만, 교호작용은 \(p<0.0001\)이다.
순서형은 덜 위험하다. \(+1.80\)과 \(+3.09\)의 평균 \(+2.44\)가 어느 쪽에서도 부호가 같으므로, "A가 y를 높인다"는 진술은 여전히 참이다. 다만 "얼마나"가 B에 따라 다르다.
구분 방법.
| 순서형 | 비순서형 | |
|---|---|---|
| 교호작용 그림 | 선이 교차하지 않음 | 선이 교차 |
| 단순효과의 부호 | 모두 같음 | 다름 |
| 주효과 해석 | 조건부로 가능 | 불가 |
주의 — 그림의 교차만으로 판단하지 않는다. 관측 범위 밖에서 교차할 수도 있고, 표본 변동으로 우연히 교차해 보일 수도 있다. 단순효과의 부호와 그 신뢰구간을 확인하는 것이 확실하다.
실무 절차 셋.
- 교호작용이 유의하면 단순효과를 먼저 계산한다.
- 부호가 다르면(비순서형) 주효과를 보고하지 않는다.
- 부호가 같으면(순서형) 주효과를 보고하되 "크기가 조건에 따라 다르다"를 반드시 병기한다.
연습문제 10. 교호작용을 다루는 전체 지침을 정리하라.
풀이
교호작용이란 무엇인가.
에서 \((\alpha\beta)_{ij}\)는 "두 요인의 효과가 단순히 더해지지 않는 정도"다. 가법 모형이 예측하는 값과 실제 칸 평균의 차이다.
핵심 사실 다섯.
| 사실 | 근거 |
|---|---|
| 교호작용 검정은 검정력이 낮다 | 대비 분산이 4배(연습문제 5) |
| 유의하면 주효과 해석이 달라진다 | 비순서형에서 완전히 오도(연습문제 9) |
| 유의해도 모형에는 포함한다 | 빼면 오차가 커진다(연습문제 8) |
| 반복이 없으면 오차와 교란된다 | 터키 검정으로 부분적 해결(연습문제 7) |
| 척도에 의존한다 | 로그 변환으로 사라질 수 있다 |
마지막 항목이 미묘하다. 교호작용은 측정 척도의 성질이기도 하다. 원 척도에서 곱셈형이면 로그 척도에서 가법이 된다. "교호작용이 있다/없다"는 절대적 사실이 아니라 어떤 척도에서 보는가에 달려 있다.
해석 흐름.
교호작용 F 검정
    │
    ├─ 유의하지 않음
    │     ├─ 검정력이 충분했는가? (효과크기·구간 확인)
    │     └─ 주효과를 해석하되 "교호작용을 찾지 못했다"고 서술
    │
    └─ 유의함
          ├─ 단순효과를 계산한다
          │     ├─ 부호가 같음(순서형)
          │     │     └─→ 주효과 + "크기가 다름" 명시
          │     └─ 부호가 다름(비순서형)
          │           └─→ 주효과 보고 금지, 단순효과만
          ├─ 다중비교 보정
          └─ 순서형 요인이면 교호작용을 선형·이차로 분해
보고 점검 목록.
- [ ] 칸 평균 표(각 칸의 \(n\), 평균, 표준편차)
- [ ] 교호작용 그림
- [ ] 교호작용의 \(F\), df, \(p\), 효과크기와 구간
- [ ] 순서형인지 비순서형인지
- [ ] 유의하면 단순효과와 보정 방법
- [ ] 유의하지 않으면 검정력의 한계를 언급
자주 하는 실수 다섯.
| 실수 | 대가 |
|---|---|
| 교호작용 \(p>0.05\)를 "없음"으로 | 검정력이 0.11일 수 있다 |
| 비순서형에서 주효과 인용 | 존재하는 효과를 "없다"고 보고 |
| 유의한 교호작용을 모형에서 제거 | 오차가 커져 주효과 검정력 손실 |
| 단순효과에 보정 없음 | FWER 부풀림 |
| 척도 의존성을 무시 | 변환으로 사라질 교호작용을 실체로 해석 |
한 문장. 교호작용은 "효과가 상황에 따라 달라지는가"를 묻는 것이고, 그 답이 "그렇다"면 "효과가 얼마인가"라는 질문 자체를 다시 세워야 한다.
정리하며
이원배치에서는 세 가지 가설을 차례로 검정한다.
- 교호작용을 먼저 본다. 유의하면 주효과의 해석이 달라지기 때문이다. "\(A\) 의 효과"라는 말 자체가 \(B\) 의 수준마다 다르므로 하나의 수로 요약되지 않는다.
- 교호작용이 유의하면 단순주효과로 간다. \(B\) 의 각 수준에서 \(A\) 의 효과를 따로 보는 방식이며, 주변평균 비교는 오해를 부른다.
- 교호작용이 유의하지 않으면 주효과를 그대로 읽는다. 이때 주변평균의 비교가 의미를 갖는다.
- 각 검정의 분모는 같은 MSE 다. 세 \(F\) 통계량이 같은 오차항을 공유하며, 그래서 오차 자유도도 공통이다.
- 유의하지 않은 교호작용 항을 빼고 다시 적합할지는 판단의 문제다. 빼면 오차 자유도가 늘어 검정력이 오르지만, 자료를 보고 모형을 바꾼 셈이 된다.
다음 절 이원배치 분산분석 파이프라인에서 실제 자료로 돌려 본다.