사후 Dunn 검정
Kruskal-Wallis 검정이 귀무가설을 기각하면 적어도 한 집단이 나머지와 다르다는 것을 알게 되지만, 어느 집단이 다른지는 알 수 없다. Dunn 검정은 바로 이 목적을 위해 설계된 사후 다중비교 절차이다. Kruskal-Wallis 분석에서 얻은 평균순위를 이용해 모든 집단 쌍을 비교하고, 다중검정에 대해 \(p\)값을 보정한다.
동기
집단이 \(k\)개인 Kruskal-Wallis 결과가 유의하면 가능한 쌍별 비교가 \(\binom{k}{2} = k(k-1)/2\)개 있다. 각각을 보정 없이 유의수준 \(\alpha\)로 수행하면 집단별 오류율(FWER)이 부풀려진다. Dunn 검정은 쌍별 \(p\)값에 Bonferroni 보정(또는 다른 보정)을 적용하여 이 부풀림을 통제한다.
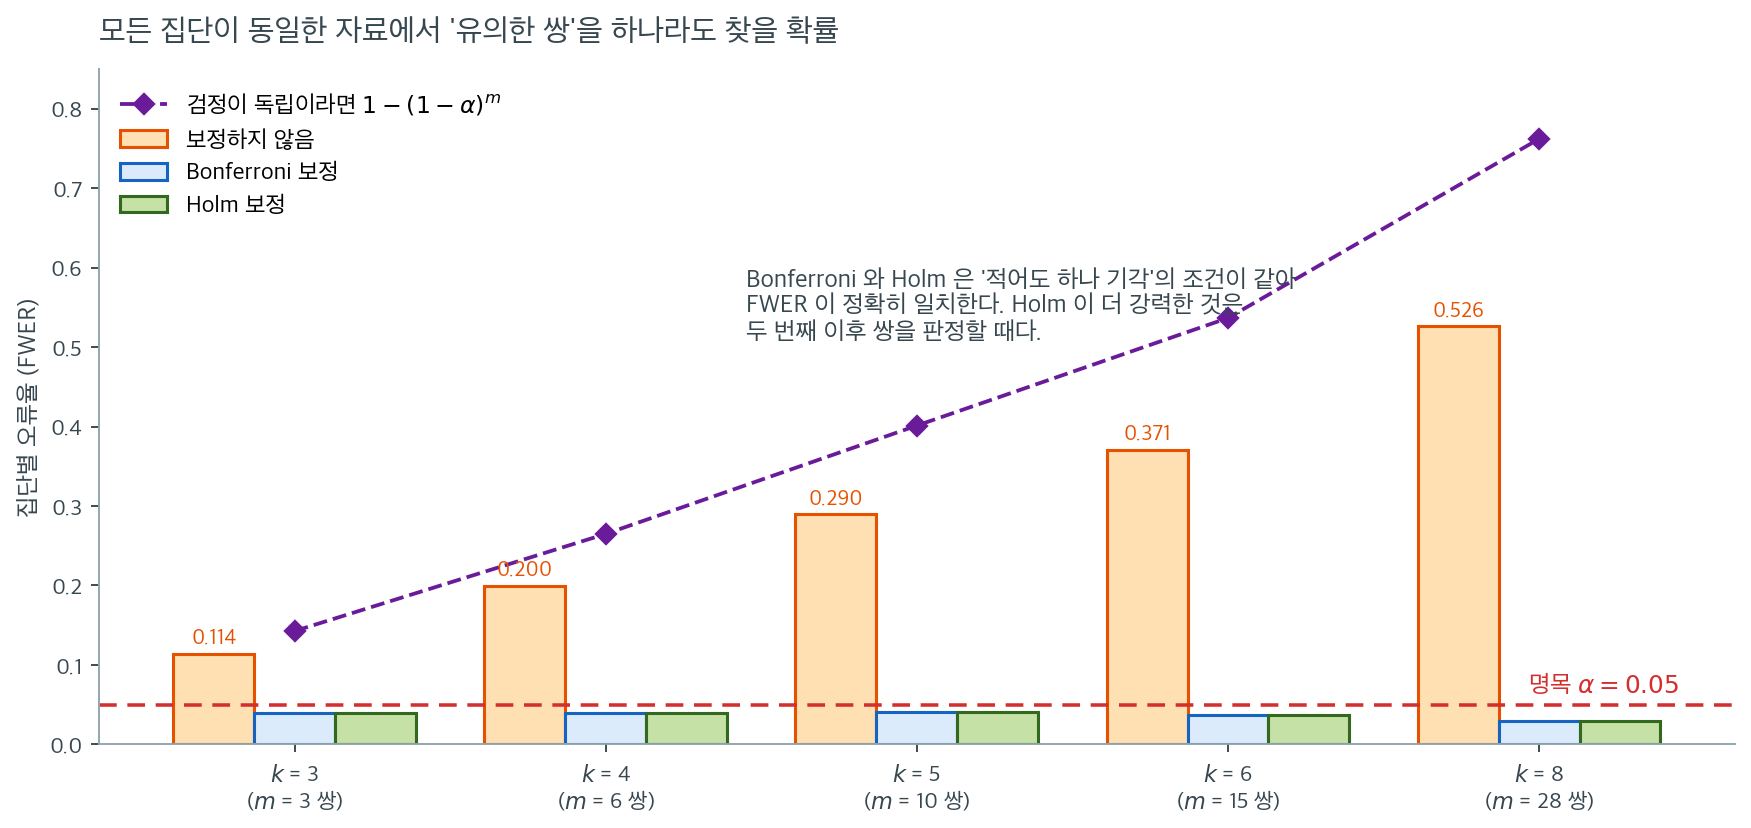
"FWER이 부풀려진다"가 구체적으로 얼마인지 재 보자. 위 그림은 모든 집단이 실제로 동일한 자료(\(k\)개 집단, 집단당 \(n = 12\), 모두 \(\mathcal{N}(0,1)\))를 \(4{,}000\)번 만들어, 쌍별 비교에서 "유의한 쌍"을 하나라도 찾는 비율을 센 것이다. 진짜 차이는 하나도 없으므로 여기서 나오는 모든 기각은 거짓 양성이다.
보정하지 않은 주황 막대는 \(k = 3\)에서 벌써 \(0.114\)이고, \(k = 5\)에서 \(0.290\), \(k = 8\)에서 \(0.526\)이다. 집단이 여덟이면 동전을 던지는 것과 비슷한 확률로 아무것도 아닌 쌍을 유의하다고 선언한다. 보정을 넣은 파란·초록 막대는 모든 \(k\)에서 \(0.05\) 아래에 머문다.
보라색 점선이 검정들이 독립이라면 나왔을 값 \(1 - (1-\alpha)^m\)이다. 실제 기각률이 그보다 일관되게 낮다는 점에 주목하라. \(k = 8\)에서 \(0.762\) 대 \(0.526\)이다. Dunn 검정의 \(\binom{k}{2}\)개 비교는 같은 합친 순위에서 만들어지므로 서로 상관되어 있고, 그래서 독립 가정이 주는 값보다 덜 샌다. 그러나 덜 샌다는 것이 안 샌다는 뜻은 아니다. 어느 \(k\)에서도 명목수준을 크게 넘는다.
Bonferroni와 Holm의 막대 높이가 정확히 같다는 것도 우연이 아니다. "적어도 하나를 기각한다"는 사건은 두 절차 모두 \(\min_j p_j \cdot m < \alpha\)일 때 일어나므로 FWER이 항상 일치한다. Holm이 균일하게 더 강력하다는 말은 가장 작은 \(p\)값을 기각한 다음 단계부터, 즉 두 번째 이후의 쌍을 판정할 때 적용된다.
검정통계량
각 집단 쌍 \((i, j)\)에 대해 Dunn 검정은 평균순위를 비교한다. Kruskal-Wallis 검정에서 쓴 합친 순위로부터 집단 \(i\)와 \(j\)의 평균순위를 \(\bar{R}_i\), \(\bar{R}_j\)라 하자. 검정통계량은
이고 표준오차는
이다. 여기서 \(N = \sum_{i=1}^k n_i\)는 전체 표본크기이고 \(n_i, n_j\)는 집단 크기이다.
동점 보정
합친 표본에 동점이 있으면 표준오차는
가 된다. 여기서 \(g\)는 동점 집단의 개수, \(t_l\)은 \(l\)번째 집단의 동점 관측값 개수이다.
p값과 다중검정 보정
각 쌍의 보정하지 않은 양측 \(p\)값은
이다. FWER을 통제하기 위해 \(p\)값을 보정한다. 흔한 방법은 다음과 같다.
| 방법 | 보정 | 성질 |
|---|---|---|
| Bonferroni | \(m = \binom{k}{2}\)일 때 \(p_{ij}^* = \min\!\bigl(m \cdot p_{ij}, \; 1\bigr)\) | 보수적, FWER 통제 |
| Holm (단계적 하강) | \(p\)값을 순위 매긴 뒤 \(p_{(r)}^* = \min\!\bigl((m - r + 1) \cdot p_{(r)}, \; 1\bigr)\) | Bonferroni보다 덜 보수적, FWER 통제 |
| Benjamini-Hochberg | \(p_{(r)}^* = \min\!\bigl(m \cdot p_{(r)} / r, \; 1\bigr)\) | FWER 대신 FDR 통제 |
Holm 대 Bonferroni
Holm 단계적 하강 절차는 유의수준 \(\alpha\)에서 FWER을 통제하면서도 Bonferroni 보정보다 균일하게 더 강력하다. Bonferroni 보정이 특별히 요구되는 경우가 아니라면 Holm을 쓰는 편이 낫다.
보기 1. 비료 자료의 Dunn 사후검정. Kruskal-Wallis 절의 비료 보기를 이어 보자. Kruskal-Wallis 검정이 \(H = 11.816\), \(p = 0.0027\)로 \(H_0\)을 기각했다. 세 집단은 다음과 같았다.
- 비료 A: \(n_1 = 5\), \(\bar{R}_A = 7.7\)
- 비료 B: \(n_2 = 5\), \(\bar{R}_B = 13.0\)
- 비료 C: \(n_3 = 5\), \(\bar{R}_C = 3.3\)
\(N = 15\)이고 쌍별 비교는 \(m = 3\)개이다.
표준오차 (간단히 하기 위해 동점이 없다고 가정):
풀이
쌍별 비교:
| 쌍 | \(\lvert\bar{R}_i - \bar{R}_j\rvert\) | \(z_{ij}\) | \(p_{ij}\) | \(p_{ij}^*\) (Bonferroni) |
|---|---|---|---|---|
| A 대 B | 5.3 | 1.874 | 0.0610 | 0.183 |
| A 대 C | 4.4 | 1.556 | 0.1198 | 0.359 |
| B 대 C | 9.7 | 3.429 | 0.0006 | 0.0018 |
\(\alpha = 0.05\)에서의 해석:
- B 대 C: \(p^* = 0.0018 < 0.05\). 비료 B와 C가 유의하게 다르다. 비료 B가 더 큰 식물을 낸다(평균순위가 높다).
- A 대 B: \(p^* = 0.183 > 0.05\). A와 B 사이에 유의한 차이가 없다.
- A 대 C: \(p^* = 0.359 > 0.05\). A와 C 사이에 유의한 차이가 없다.
Kruskal-Wallis의 기각은 주로 비료 B와 비료 C의 큰 차이가 이끌어 낸 것이다.
이 자료에는 실제로 동점이 하나 있다
비료 A와 C가 모두 \(10\)을 포함하므로 크기 2인 동점 집단이 하나 있다. 동점 보정을 적용하면 표준오차가 \(2.8284\)에서 \(2.8259\)로 미세하게 줄어들고 보정된 \(p\)값은 \(0.182\), \(0.358\), \(0.00179\)가 된다. 결론은 바뀌지 않는다.
동점 비율이 높으면 보정이 훨씬 중요해진다. scikit-posthocs의 posthoc_dunn은 동점 보정을 자동으로 적용한다.
절차 요약
- Kruskal-Wallis 검정을 수행한다. \(H_0\)이 기각될 때에만 Dunn 검정으로 넘어간다.
- 각 쌍 \((i, j)\)에 대해 Kruskal-Wallis 분석의 평균순위를 써서 \(z_{ij}\)를 계산한다.
- 표준정규분포에서 보정하지 않은 \(p\)값을 구한다.
- 다중검정 보정(Bonferroni, Holm, Benjamini-Hochberg)을 적용한다.
- 보정된 \(p\)값이 \(\alpha\)보다 작은 쌍을 유의하다고 선언한다.
쌍별 Mann-Whitney와의 비교
또 다른 사후 전략은 Bonferroni 보정을 적용한 쌍별 Mann-Whitney \(U\) 검정이다. 핵심 차이는 Dunn 검정이 Kruskal-Wallis 분석의 합친 순위를 쓰는 반면, 쌍별 Mann-Whitney는 각 쌍에 대해 관측값의 순위를 다시 매긴다는 점이다. Dunn 검정이 더 흔히 쓰이는 것은 전체검정에 쓰인 전역 순위와 일관되기 때문이다.
연습문제
연습문제 1. 비료 보기에서 Bonferroni 보정 대신 Holm 보정과 Benjamini-Hochberg 보정을 적용하면 결과가 어떻게 달라지는가? 세 보정을 모두 계산하고 비교하라.
풀이
보정하지 않은 \(p\)값을 작은 것부터 정렬한다. \(m = 3\)이다.
Bonferroni: 모두 \(\times 3\).
Holm: \(r\)번째 작은 값에 \((m - r + 1)\)을 곱하고, 앞선 값보다 작아지지 않도록 누적 최댓값을 취한다.
Benjamini-Hochberg: \(r\)번째 값에 \(m/r\)을 곱하고, 뒤에서부터 누적 최솟값을 취한다.
import numpy as np
from scipy import stats
from statsmodels.stats.multitest import multipletests

p = np.array([0.000604, 0.061, 0.1198])   # B-C, A-B, A-C
for m in ("bonferroni", "holm", "fdr_bh"):
    print(m, multipletests(p, method=m)[1].round(5))
출력:
bonferroni [0.00181 0.183   0.3594 ]
holm [0.00181 0.122   0.122  ]
fdr_bh [0.00181 0.0915  0.1198 ]
| 쌍 | 원 \(p\) | Bonferroni | Holm | BH (FDR) |
|---|---|---|---|---|
| B 대 C | \(0.000604\) | \(0.00181\) | \(0.00181\) | \(0.00181\) |
| A 대 B | \(0.0610\) | \(0.183\) | \(0.122\) | \(0.0915\) |
| A 대 C | \(0.1198\) | \(0.359\) | \(0.122\) | \(0.1198\) |
결론은 세 방법 모두 같다. B 대 C만 유의하다.
그러나 \(p\)값의 크기는 뚜렷이 다르다. A 대 C에서 Bonferroni는 \(0.359\), Holm은 \(0.122\), BH는 \(0.120\)이다. Bonferroni가 가장 보수적이고 BH가 가장 관대하다.
Holm이 Bonferroni를 지배하는 이유. Holm은 가장 작은 \(p\)값에만 \(m\)을 곱하고, 그다음부터는 \(m-1\), \(m-2\)로 줄여 간다. 이미 기각된 가설이 있으면 남은 비교에 대한 "예산"이 줄어들 필요가 없다는 논리이다. 어떤 상황에서도 Bonferroni보다 작거나 같은 보정값을 주므로 무조건 더 강력하다.
BH는 다른 것을 통제한다. FWER(거짓 발견을 하나라도 낼 확률)이 아니라 FDR(발견 중 거짓의 기대 비율)을 통제한다. 비교가 수십 개 이상이고 탐색적 분석이라면 BH가 적절하지만, 확증적 연구에서는 FWER 통제가 표준이다.
연습문제 2. Dunn 검정과 쌍별 Mann-Whitney 검정(Bonferroni 보정)의 결과를 비료 자료에서 비교하라. 왜 다른 값이 나오는가?
풀이
import numpy as np, itertools
from scipy import stats
from statsmodels.stats.multitest import multipletests

A = [12, 15, 14, 10, 13]; B = [20, 18, 22, 17, 19]; C = [8, 11, 9, 7, 10]
groups = {"A": A, "B": B, "C": C}
pairs = list(itertools.combinations(groups, 2))
pv = [stats.mannwhitneyu(groups[i], groups[j], method='exact').pvalue
      for i, j in pairs]
print(pairs)
print(np.round(pv, 5))
print(np.round(multipletests(pv, method='bonferroni')[1], 4))
출력:
[('A', 'B'), ('A', 'C'), ('B', 'C')]
[0.00794 0.03175 0.00794]
[0.0238 0.0952 0.0238]
| 쌍 | 원 MWU \(p\) | Dunn (Bonferroni) | 쌍별 MWU (Bonferroni) |
|---|---|---|---|
| A 대 B | \(0.00794\) | \(0.183\) | \(0.0238\) |
| A 대 C | \(0.03175\) | \(0.359\) | \(0.0952\) |
| B 대 C | \(0.00794\) | \(0.0018\) | \(0.0238\) |
결론이 갈린다. Dunn 검정은 B 대 C만 유의하다고 하지만, 쌍별 Mann-Whitney는 A 대 B와 B 대 C를 유의하다고 한다.
차이의 원인은 두 가지이다.
-
순위를 다시 매기는가. Mann-Whitney는 각 쌍에 대해 \(10\)개 관측값만 놓고 순위를 다시 매긴다. A와 B는 완전히 분리되어 있으므로(\(A\)의 최댓값 \(15 < B\)의 최솟값 \(17\)) \(U = 0\)이 되어 가능한 최소 \(p\)값 \(2/\binom{10}{5} = 2/252 = 0.0079\)가 나온다. B와 C도 마찬가지로 완전 분리이다. Dunn 검정은 전역 순위를 쓰므로 A의 순위(\(4.5\)--\(10\))와 B의 순위(\(11\)--\(15\))가 겹치지 않는다는 사실이 평균순위 차이 \(5.3\)으로만 반영된다.
-
정확검정 대 정규근사. Mann-Whitney는 \(n = 5, 5\)에서 정확 \(p\)값을 쓰지만 Dunn 검정은 정규근사를 쓴다. \(N = 15\)는 정규근사에 작다.
어느 쪽이 옳은가? 정답은 없지만 주의할 점이 있다.
- 쌍별 Mann-Whitney는 각 쌍에서 다른 순위 체계를 쓰므로 결과가 서로 모순될 수 있다(비이행성).
- Dunn 검정은 전역 순위를 쓰므로 일관되지만, 관계없는 세 번째 집단이 두 집단의 비교에 영향을 준다. 여기서 집단 C의 존재가 A와 B의 순위 간격을 넓혀 놓았다.
실무 권고: 전체검정과 사후검정의 논리적 일관성을 중시하면 Dunn을, 각 쌍의 정확한 비교를 중시하면 쌍별 Mann-Whitney를 쓴다. 둘 다 돌려 보고 유의한 쪽을 고르는 것은 명백한 오용이다.
연습문제 3. "전체검정이 유의할 때에만 사후검정을 하라"는 규칙이 정말로 FWER을 통제하는가? \(k\)가 커질수록 이 두 단계 절차의 실제 오류율이 어떻게 되는지 모의실험으로 확인하라.
풀이
귀무가설이 완전히 참인(\(k\)개 집단이 모두 같은 분포) 상황에서, 어느 쌍이라도 유의하다고 선언할 확률을 센다.
import numpy as np, itertools
from scipy import stats
from statsmodels.stats.multitest import multipletests
rng = np.random.default_rng(0)
B, n = 1500, 15

def dunn_p(groups):
    N = sum(len(g) for g in groups)
    r = stats.rankdata(np.concatenate(groups))
    idx, mr = 0, []
    for g in groups:
        mr.append(r[idx:idx + len(g)].mean()); idx += len(g)
    out = []
    for i, j in itertools.combinations(range(len(groups)), 2):
        sd = np.sqrt(N * (N + 1) / 12 * (1/len(groups[i]) + 1/len(groups[j])))
        out.append(2 * stats.norm.sf(abs(mr[i] - mr[j]) / sd))
    return np.array(out)

for k in (3, 5, 8):
    gated = unrestricted = 0
    for _ in range(B):
        gs = [rng.normal(0, 1, n) for _ in range(k)]
        pw = multipletests(dunn_p(gs), method='holm')[1]
        any_sig = (pw < 0.05).any()
        unrestricted += any_sig
        gated += any_sig and (stats.kruskal(*gs).pvalue < 0.05)
    print(k, gated / B, unrestricted / B)
출력:
3 0.03333333333333333 0.034666666666666665
5 0.034 0.04
8 0.02266666666666667 0.03333333333333333
| \(k\) | 전체검정 통과 후 (게이트) | 게이트 없이 |
|---|---|---|
| 3 | 0.033 | 0.035 |
| 5 | 0.034 | 0.040 |
| 8 | 0.023 | 0.033 |
두 절차 모두 \(\alpha = 0.05\) 아래로 FWER을 유지한다. Holm 보정만으로도 이미 통제되기 때문이다.
그렇다면 전체검정 게이트는 왜 필요한가? 세 가지 이유가 있다.
- 보정을 하지 않는 경우를 막는다. 실무에서 사후 비교의 다중성 보정을 잊는 일이 흔하다. 게이트가 최소한의 방어선이 된다.
- 보정된 검정을 더 보수적으로 만든다. 위 표에서 게이트 있는 쪽이 언제나 더 낮고, \(k = 8\)에서는 \(0.023\) 대 \(0.033\)으로 격차가 벌어진다.
- 논리적 일관성. 전체검정이 기각하지 못했는데 어떤 쌍이 유의하다고 보고하면 독자가 혼란스럽다.
다만 게이트에도 대가가 있다. 전체검정이 놓치는 상황 --- 예를 들어 \(k = 8\) 중 두 집단만 크게 다른 경우 --- 에서 게이트가 참인 발견을 막을 수 있다. Kruskal-Wallis는 모든 집단의 차이를 평균하므로 국소적인 큰 차이를 희석하기 때문이다.
연습문제 4. Dunn 검정의 표준오차 공식 \(\sigma_{ij} = \sqrt{\frac{N(N+1)}{12}(\frac{1}{n_i} + \frac{1}{n_j})}\)을 유도하라.
풀이
\(H_0\) 아래에서 \(1, \ldots, N\)의 순위가 집단들에 무작위로 배정된다. 이는 크기 \(N\)인 유한모집단 \(\{1, \ldots, N\}\)에서 비복원추출하는 것과 같다.
유한모집단의 모수. 순위 전체의 평균과 분산은
이다.
평균순위의 분산. 크기 \(n_i\)인 비복원 표본평균의 분산은 유한모집단 보정을 포함하여
이다.
공분산. 두 집단이 같은 순위 집합을 나누어 가지므로 음의 상관이 있다. 비복원추출에서
이다.
차이의 분산.
import numpy as np
rng = np.random.default_rng(0)
N, ni, nj = 15, 5, 5
ranks = np.arange(1, N + 1)
d = []
for _ in range(200000):
    perm = rng.permutation(ranks)
    d.append(perm[:ni].mean() - perm[ni:ni + nj].mean())
print(np.var(d), N * (N + 1) / 12 * (1 / ni + 1 / nj))   # 8.049, 8.0
출력:
8.049307944999 8.0
모의실험 분산 \(8.049\)가 공식값 \(8.0\)과 일치한다.
유도에서 공분산 항이 결정적이다. 이를 빠뜨리고 두 집단이 독립이라고 가정하면 분산이 \(\frac{N+1}{12}(\frac{N-n_i}{n_i} + \frac{N-n_j}{n_j}) = 5.33\)으로 나와 \(33\%\) 과소평가된다. 그러면 \(z\)가 부풀려져 검정이 지나치게 많이 기각하게 된다.
정리하며
Dunn 검정은 Kruskal-Wallis 결과가 유의할 때 평균순위 차이에 기반한 \(z\) 통계량으로 쌍별 비교를 수행한다. 다중검정 보정(Bonferroni, Holm, Benjamini-Hochberg)이 \(\binom{k}{2}\)개 비교 전체의 오류율을 통제한다. Kruskal-Wallis 검정과 같은 합친 순위를 쓰므로 전체검정과 사후분석 사이의 일관성이 보장된다.