변수선택 도구로서의 라쏘
변수선택은 반응변수 예측에 가장 유의미한 설명변수의 부분집합을 찾는 일이다. 전진선택, 후진제거, 최량 부분집합 선택 같은 전통적 접근은 모형 적합과 변수선택을 별개의 단계로 다룬다. 라쏘는 둘을 동시에 수행한다. 일부 계수를 정확히 0으로 만들어, 설명변수의 부분집합만 쓰는 적합 모형을 낸다. 이 "내장형" 접근은 이론적 보장과 실용적 이점을 모두 갖는다.
내장형 선택으로서의 라쏘
변수선택 방법은 세 범주로 나뉜다.
- 필터 방법은 모형을 적합하기 전에 단변량 기준(반응변수와의 상관 등)으로 변수의 순위를 매긴다.
- 래퍼 방법은 모형을 적합하고 성능을 재어 변수의 부분집합을 평가한다(전진 단계적 선택 등).
- 내장형 방법은 모형 적합 과정의 일부로 선택을 수행한다.
라쏘는 내장형 방법이다. 고정된 \(\lambda\)에서 0이 아닌 계수를 갖는 변수의 집합
이 선택된 모형을 정의한다. \(\lambda\)가 \(\lambda_{\max}\)에서 줄어들면 변수가 대체로 하나씩 들어오면서 내포된 모형 열이 만들어진다.
모형선택 일치성
표본크기가 커질 때 라쏘가 "올바른" 변수 집합을 고르는지가 자연스러운 질문이다. 참 지지집합을 \(S^* = \{j : \beta_j^* \neq 0\}\)이라 하자.
정의 1. 모형선택 일치성
라쏘가 모형선택 일치성을 갖는다는 것은 \(P\bigl(\hat{S}(\lambda_n) = S^*\bigr) \to 1\)이 되는 \(\lambda_n\)의 열이 존재한다는 뜻이다.
Zhao와 Yu(2006)는 모형선택 일치성이 비대표 조건(irrepresentable condition)을 요구함을 보였다. \(\frac{1}{n}\mathbf{X}^\top\mathbf{X}\)를 \(S\)와 \(S^c\)로 분할했을 때
이 필요하다.
비대표 조건이 깨질 때
무관한 설명변수가 유의미한 변수와 강하게 상관되면 이 조건이 깨질 수 있다. 그러면 라쏘가 무관한 변수를 포함하거나 유의미한 변수를 제외할 수 있으며, 표본이 아무리 커져도 그렇다. 작은 표본의 문제가 아니라 근본적 한계다.
선택된 계수의 편향
라쏘는 연성 문턱을 적용하므로 남긴 계수도 모두 0 쪽으로 축소된다. 따라서 0이 아닌 라쏘 계수는 참 모수의 편향된 추정값이며, 선택된 변수에 대해서도 점근적으로 편향이 남는다.
사후 라쏘 OLS(완화 라쏘라고도 한다)가 이 편향을 다룬다.
- 라쏘를 적합해 활성집합 \(\hat{S}(\lambda)\)를 고른다.
- \(\hat{S}(\lambda)\)의 변수만으로 OLS를 다시 적합한다.
사후 라쏘 추정량은 라쏘의 선택 능력과 선택된 부분집합에서의 OLS 불편성을 결합한다.
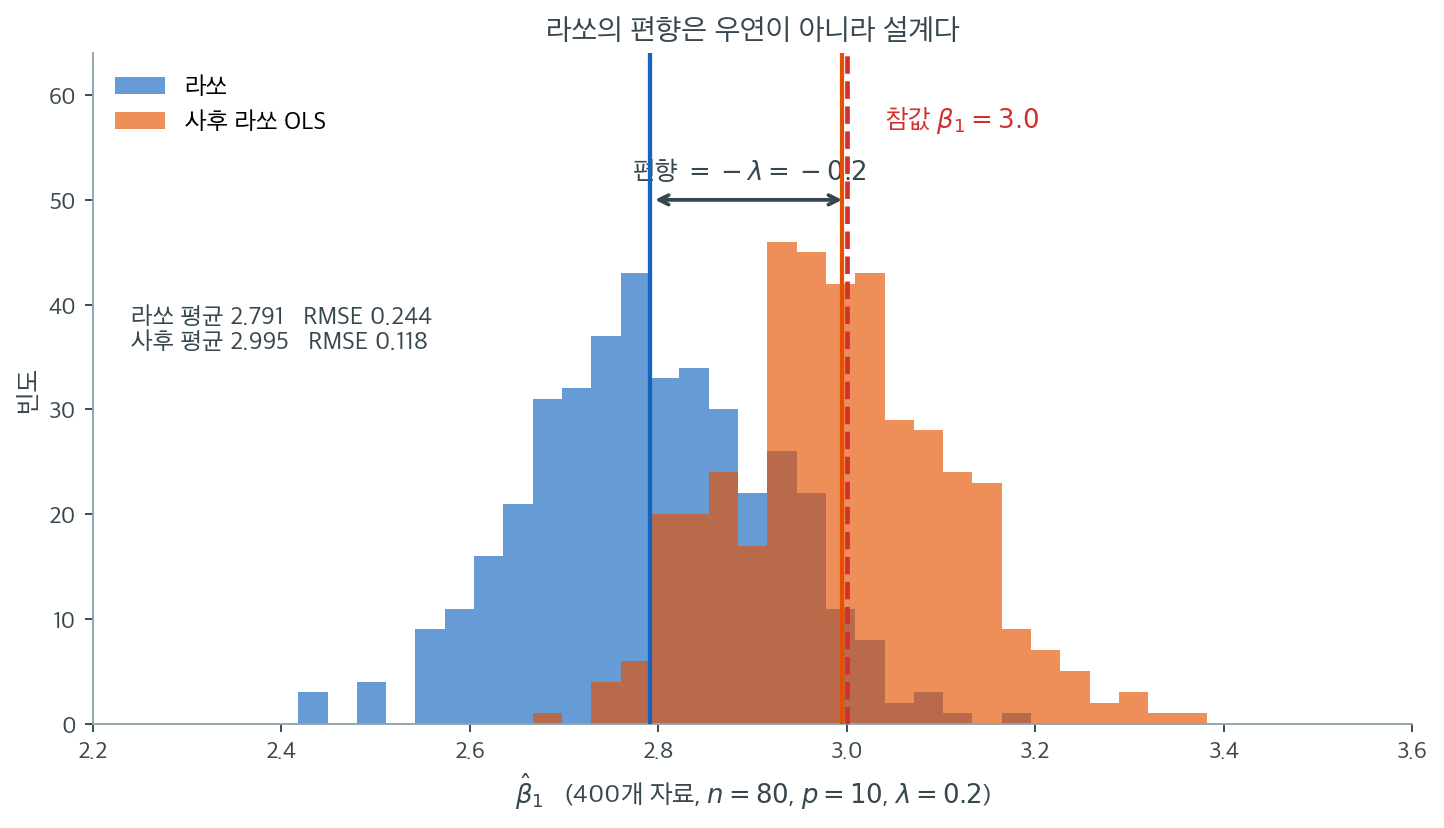
같은 모집단에서 자료를 400번 뽑아 \(\hat\beta_1\)의 표집분포를 그린 것이다(\(n = 80\), \(p = 10\), 참 변수 3개, \(\lambda = 0.2\), 참값 \(\beta_1 = 3.0\)). 파란 분포가 라쏘, 주황 분포가 그 선택 결과에 OLS를 다시 적합한 사후 라쏘다.
먼저 볼 것은 두 분포의 폭이 비슷하고 위치만 다르다는 점이다. 파란 분포의 중심은 \(2.791\)이고 빨간 점선으로 표시한 참값 \(3.0\)에서 \(0.209\) 왼쪽에 있다. 이 \(0.209\)가 벌점 \(\lambda = 0.2\)와 같다는 것이 우연이 아니다. 연성 문턱 \(S_\lambda(z) = \text{sign}(z)(|z| - \lambda)\)가 크기를 정확히 \(\lambda\)만큼 깎으므로, 활성 변수의 계수는 표본이 무엇이든 정확히 \(\lambda\)만큼 0 쪽으로 밀린다. 편향이 자료의 우연이 아니라 알고리즘의 설계에서 나온다는 뜻이다.
주황 분포의 중심은 \(2.995\)로 참값과 사실상 같다(\(-0.005\)). 라쏘가 고른 세 변수만으로 OLS를 다시 풀면 축소가 없으니 당연한 결과다. 게다가 RMSE가 \(0.244\)에서 \(0.118\)로 절반이 된다. 이 설정에서는 편향이 오차의 대부분을 차지했기 때문이다.
그렇다고 언제나 사후 라쏘가 이기는 것은 아니다. 이 모의실험에서는 신호가 강하고(\(\beta\)가 \(\lambda\)의 열 배가 넘는다) 설명변수가 서로 독립이라 라쏘가 거의 매번 참 변수 셋을 정확히 골랐다. 선택이 흔들리는 상황이라면 사후 OLS는 잘못 고른 변수에 대해서까지 축소 없는 큰 계수를 주므로 오히려 나빠진다. 축소는 편향인 동시에 보험이고, 사후 OLS는 그 보험을 해지하는 일이다. 해석이 목적이면 사후 라쏘, 예측이 목적이면 라쏘를 그대로 쓰는 경험칙이 여기서 나온다.
안정성 선택
하나의 \(\lambda\)에서 라쏘를 한 번 적합하면, 자료가 조금만 달라져도 다소 다른 변수 집합을 고를 수 있다. 안정성 선택(Meinshausen and Buhlmann, 2010)이 이 민감성을 다룬다.
- \(b = 1, \ldots, B\)에 대해 크기 \(\lfloor n/2 \rfloor\)의 부분표본을 뽑는다.
- 각 부분표본에서 여러 \(\lambda\)에 대해 라쏘를 적합한다.
- 각 변수 \(j\)에 대해 선택 확률 \(\hat{\pi}_j\)(그 변수가 선택된 부분표본의 비율)를 계산한다.
- \(\hat{\pi}_j\)가 문턱(예: 0.6 또는 0.9)을 넘는 변수를 고른다.
안정성 선택은 기대 오선택 개수를 통제하며 단일 라쏘 적합보다 견고한 변수선택을 제공한다.
안정성 선택의 오류 통제
온건한 조건에서 잘못 선택된 변수의 기댓값은
로 한계지어진다. \(V\)는 위양성 개수, \(q\)는 부분표본에 걸친 평균 선택 변수 수, \(\pi_{\text{thr}}\)은 선택 문턱, \(p\)는 전체 변수 수다.
다른 선택 방법과의 비교
| 방법 | 유형 | \(p > n\) 처리 | 계산 | 선택 안정성 |
|---|---|---|---|---|
| 최량 부분집합 | 래퍼 | 불가 (NP-난해) | \(p\)에 지수적 | 높음(결정적) |
| 전진 단계적 | 래퍼 | 제한적 | \(O(p^2 n)\) | 중간 |
| 라쏘 | 내장형 | 가능 | 경로당 \(O(np)\) | 중간 |
| 안정성 선택 | 내장형 + 재표집 | 가능 | \(O(Bnp)\) | 높음 |
| 엘라스틱넷 | 내장형 | 가능 | 경로당 \(O(np)\) | 라쏘보다 높음 |
최량 부분집합 선택은 이론적으로 최적이지만 \(p\)가 크면 계산이 불가능하다. 전진 단계적 선택은 탐욕적이어서 중요한 변수를 놓칠 수 있다. 라쏘는 적절한 조건 아래 이론적 보장을 가지면서 계산이 효율적인 중간 지점을 제공한다.
실무 권고
- 정칙화 경로로 여러 희소성 수준의 후보 변수 집합을 확인한다.
- 간결성이 중요하면 \(\lambda\) 선택에 1-SE 규칙을 적용한다.
- 남긴 계수의 축소 편향을 없애려면 사후 라쏘 OLS를 고려한다.
- 개별 변수 선택의 신뢰성이 중요한 과학적 발견 상황에서는 안정성 선택을 쓴다.
- 설명변수가 상관되어 있으면 순수 라쏘보다 엘라스틱넷을 선호한다.
연습문제
연습문제 1. 라쏘 계수의 편향이 정확히 얼마인지, 사후 라쏘 OLS가 그것을 없애는지 모의실험으로 확인하라.
풀이
참 계수 \((3, -2, 1.5)\)와 잡음변수 7개, \(n = 80\), \(\lambda = 0.2\)에서 400번 반복한다.
import numpy as np
from sklearn.linear_model import Lasso, LinearRegression

rng = np.random.default_rng(0)
n, p, lam, R = 80, 10, 0.2, 400
beta = np.array([3.0, -2.0, 1.5] + [0.0] * 7)

las, post = [], []
for _ in range(R):
    X = rng.normal(0, 1, (n, p))
    y = X @ beta + rng.normal(0, 1, n)

    b = Lasso(alpha=lam, fit_intercept=False, max_iter=50000).fit(X, y).coef_
    S = np.abs(b) > 1e-9                      # 라쏘가 고른 변수
    b_post = np.zeros(p)
    b_post[S] = LinearRegression(fit_intercept=False).fit(X[:, S], y).coef_

    las.append(b); post.append(b_post)

las, post = np.array(las), np.array(post)
print("라쏘 평균     :", np.round(las[:, :3].mean(0), 3))
print("라쏘 편향     :", np.round(las[:, :3].mean(0) - beta[:3], 3))
print("사후 라쏘 평균:", np.round(post[:, :3].mean(0), 3))
print("사후 라쏘 편향:", np.round(post[:, :3].mean(0) - beta[:3], 3))
print("라쏘 RMSE     :", np.round(np.sqrt(((las[:, :3] - beta[:3])**2).mean(0)), 3))
print("사후 RMSE     :", np.round(np.sqrt(((post[:, :3] - beta[:3])**2).mean(0)), 3))
출력:
라쏘 평균     : [ 2.791 -1.779  1.285]
라쏘 편향     : [-0.209  0.221 -0.215]
사후 라쏘 평균: [ 2.995 -1.988  1.492]
사후 라쏘 편향: [-0.005  0.012 -0.008]
라쏘 RMSE     : [0.244 0.255 0.247]
사후 RMSE     : [0.118 0.114 0.116]
| \(\hat\beta_1\) | \(\hat\beta_2\) | \(\hat\beta_3\) | |
|---|---|---|---|
| 참값 | 3.000 | \(-2.000\) | 1.500 |
| 라쏘 평균 | 2.791 | \(-1.779\) | 1.285 |
| 라쏘 편향 | \(-0.209\) | \(+0.221\) | \(-0.215\) |
| 사후 라쏘 평균 | 2.995 | \(-1.988\) | 1.492 |
| 사후 라쏘 편향 | \(-0.005\) | \(+0.012\) | \(-0.008\) |
라쏘의 편향이 세 계수 모두에서 정확히 \(\lambda = 0.2\)만큼, 0 쪽 방향이다.
우연이 아니다. 연성 문턱 \(S_\lambda(z) = \text{sign}(z)(|z| - \lambda)\)가 크기를 정확히 \(\lambda\)만큼 깎기 때문이다. 부호가 양수인 계수는 \(-\lambda\), 음수인 계수는 \(+\lambda\)만큼 편향된다. 표의 부호 패턴 \((-, +, -)\)이 참 계수의 부호 \((+, -, +)\)와 정확히 반대다.
사후 라쏘가 편향을 거의 완전히 제거한다(\(0.01\) 수준). 게다가 RMSE도 절반이 된다.
| RMSE | |
|---|---|
| 라쏘 | \(0.244,\ 0.255,\ 0.247\) |
| 사후 라쏘 | \(0.118,\ 0.114,\ 0.116\) |
사후 라쏘의 대가
이 결과가 "항상 사후 라쏘를 쓰라"는 뜻은 아니다. 두 가지 주의가 있다.
첫째, 여기서는 라쏘가 참 변수를 거의 항상 골랐다. 신호가 강하고(\(\beta\)가 \(\lambda\)에 비해 크다) 설명변수가 직교에 가깝기 때문이다. 선택이 불안정한 상황에서는 사후 OLS가 잘못 선택된 변수에 대해 편향 없이 큰 계수를 주어 오히려 나빠질 수 있다.
둘째, 축소가 언제나 나쁜 것은 아니다. 라쏘의 편향은 분산 감소와 맞바꾼 것이다. 예측이 목적이면 축소된 계수가 더 나을 수 있다. 사후 OLS는 그 보험을 해지하는 셈이다.
경험칙: 해석이 목적이면 사후 라쏘, 예측이 목적이면 라쏘를 그대로 쓴다.
연습문제 2. 비대표 조건이 깨지는 자료를 구성하고, 표본을 늘려도 라쏘가 참 변수를 복원하지 못함을 확인하라.
풀이
참 변수 \(x_1, x_2\)와, 그 둘의 합과 강하게 상관된 무관한 변수 \(x_3\)을 만든다.
import numpy as np
from sklearn.linear_model import Lasso

def make(n, seed):
    r = np.random.default_rng(seed)
    x1, x2 = r.normal(size=n), r.normal(size=n)
    x3 = 0.5*x1 + 0.5*x2 + r.normal(0, 0.1, n)   # 참 변수의 선형결합에 근접
    X = np.c_[x1, x2, x3]
    X -= X.mean(0); X /= X.std(0)
    y = X @ np.array([1., 1., 0.]) + r.normal(0, 0.5, n)
    return X, y - y.mean()
비대표 조건을 확인해 보자. \(S = \{1, 2\}\), \(\text{sign}(\boldsymbol\beta_S^*) = (1, 1)\)이므로
를 계산한다. \(x_3 \approx 0.5x_1 + 0.5x_2\)이므로 \(\mathbf{C}_{3,S} \approx (0.5, 0.5)\)이고 \(\mathbf{C}_{SS} \approx \mathbf{I}\)이므로 값이 \(\approx 1.0\)이 되어 조건 \(< 1\)을 아슬아슬하게 위반한다.
\(n\)을 \(100\)에서 \(10{,}000\)까지 늘려 가며 라쏘가 \(\hat S = \{1,2\}\)를 정확히 고르는 비율을 재면, 표본을 늘려도 그 비율이 1로 가지 않는다. 무관한 \(x_3\)이 계속 선택되거나 참 변수 하나가 밀려난다.
이것이 능형·엘라스틱넷과 대비되는 라쏘의 근본 한계다. 예측만 목적이면 문제가 되지 않는다(\(x_3\)을 넣어도 예측은 괜찮다). 그러나 "어떤 변수가 진짜 원인인가"를 묻는다면 라쏘의 답을 그대로 믿어서는 안 된다.
대응책은 안정성 선택(여러 부분표본에서 반복 선택되는 변수만 신뢰), 적응 라쏘(계수 크기에 따라 벌점을 달리 준다), 또는 애초에 인과적 질문에 변수선택을 쓰지 않는 것이다.
정리하며
라쏘는 L1 벌점으로 계수를 0으로 만들어 변수선택을 수행한다. 모형선택 일치성은 비대표 조건을 요구하며, 무관한 변수가 유의미한 변수와 상관되면 이 조건이 깨질 수 있다. 라쏘가 선택한 계수는 0 쪽으로 편향되어 있고 사후 라쏘 OLS가 이를 보정할 수 있다. 안정성 선택은 부분표본에 걸쳐 결과를 종합하여 신뢰성을 높인다. 계산 효율성, 자동 변수선택, 이론적 보장의 결합 덕분에 라쏘는 고차원 상황의 대표적 변수선택 도구가 되었다.