대응자료에 대한 윌콕슨 부호순위검정¶
들어가는 이야기 — 내려간 한 사람이 올라간 셋보다 클 때
한 회사가 교육 프로그램 전후로 직원 \(12\) 명의 생산성 점수를 재었다. 열 명은 올랐고 두 명은 내렸는데, 내린 쪽 하나가 \(-8\) 이어서 올라간 쪽의 \(+7\), \(+5\), \(+3\) 보다 크다. 부호만 세면 \(10\) 대 \(2\) 로 끝날 일인데, 그 \(-8\) 을 제 크기로 세면 결론이 흔들릴 수도 있다. 둘을 어떻게 저울질할 것인가.
이 검정의 저울질은 완곡하다. 가장 큰 차이 \(13\) 이 받는 것은 \(13\) 이 아니라 순위 \(12\) 이고, \(-8\) 이 깎아내리는 것도 \(8\) 이 아니라 순위 \(7\) 이다. 그래서 음의 순위합은 \(1 + 7 = 8\) 에 그치고 양의 쪽 \(70\) 과 합해 \(78\) 이 된다. 같은 자료에서 단측 \(p\) 값이 부호검정 \(0.0193\), 이 검정 \(0.0061\), 대응 \(t\) 검정 \(0.0028\) 로 늘어선다 — 쓰는 정보의 양이 그대로 그 차례다.
대신 통계량을 어느 꼴로 적는지가 뜻밖에 중요하다. 교과서 표가 쓰는 것은 두 순위합 가운데 작은 쪽인데, 둘의 합이 \(78\) 로 못 박혀 있으니 작은 쪽은 언제나 제 평균 아래에 있다. 그러면 「올랐는가」만 묻는 오른쪽 단측검정에서는 어떤 자료가 와도 기각이 일어나지 않는다 — 실제로 재어 보면 기각률이 \(0.0000\) 이다. 양의 순위합 하나를 일관되게 쓰고 방향은 부호로 읽어야 한다.
그렇다면 차이의 크기를 순위로 들여와 얻는 것과 대칭이라는 가정에 치르는 값은 각각 얼마인가. 이 쪽이 절차를 다섯 단계로 끊고, 같은 크기의 차이에 중간순위를 주는 셈과 그에 딸린 분산 보정을 적은 뒤, 이 검정이 왜 부호검정보다 강력한지를 수로 보인다.
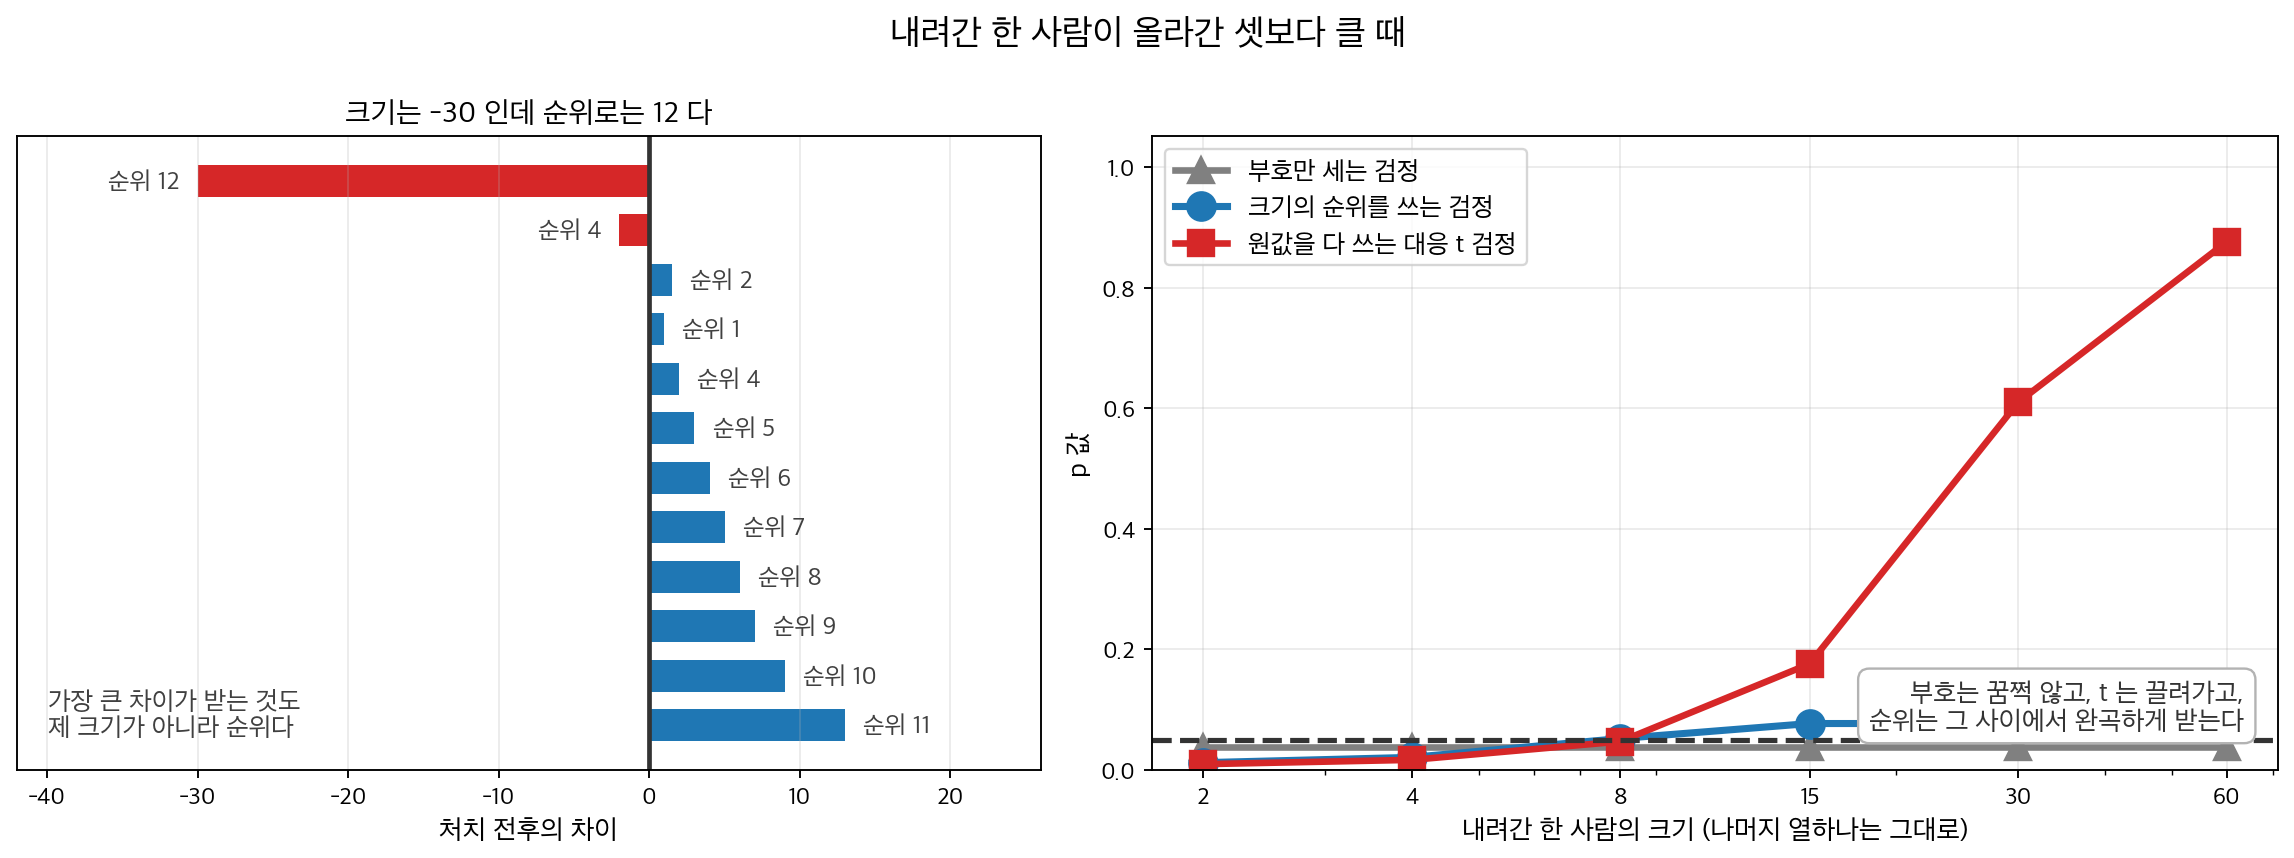
왼쪽. 저울질이 완곡하다. 가장 큰 차이가 받는 것은 제 크기가 아니라 순위이고, 내려간 사람도 제 크기가 아니라 순위만큼만 깎아낸다. 오른쪽. 그래서 그 한 사람의 크기를 \(-2\) 에서 \(-60\) 까지 키우면 세 검정이 저마다 다르게 반응한다 — 부호만 세는 쪽은 \(0.0386\) 에서 꿈쩍도 하지 않고(부호가 바뀌지 않으니까), 원값을 다 쓰는 \(t\) 검정은 \(0.0097\) 에서 \(0.8764\) 로 끌려가며, 순위를 쓰는 쪽은 \(0.0122\) 에서 \(0.0771\) 까지 올랐다가 멈춘다. 순위가 매길 수 있는 가장 큰 값이 \(12\) 라 더 커질 데가 없기 때문이다. 쓰는 정보의 양이 그대로 그 세 반응이다.
대응 부호검정은 대응차이의 중앙값이 0인지 검정하지만 각 차이가 얼마나 큰지는 무시한다. 차이가 의미 있는 수치 척도로 측정되고 그 분포가 근사적으로 대칭이라면, 대응자료에 대한 윌콕슨 부호순위검정이 각 절대차이의 부호와 순위를 모두 반영하여 더 강력한 대안을 제공한다. 이는 윌콕슨 부호순위 절차를 차이 \(D_i = X_i - Y_i\)에 그대로 적용한 것이다.
1. 물음 — 차이의 중앙값이 0 인가¶
단측 대립가설(alternative hypothesis, \(H_a \colon \text{중앙값} > 0\) 또는 \(< 0\))도 마찬가지이다.
가정 — 차이가 대칭이어야 한다¶
- 쌍 \((X_i, Y_i)\)들이 독립이다.
- 각 차이 \(D_i = X_i - Y_i\)가 연속분포에서 나온다.
- \(H_0\) 아래에서 \(D_i\)의 분포가 중앙값을 중심으로 대칭이다.
대칭성 요구가 대응 부호검정에 비해 추가되는 핵심 가정이다. 차이가 눈에 띄게 치우쳐 있다면 대응 부호검정이나 대응 순열검정이 더 적절할 수 있다.
2. 통계량 — 절대차이에 순위를 매겨 부호를 되돌린다¶
1단계. 대응차이 \(D_i = X_i - Y_i\)를 계산한다.
2단계. \(D_i = 0\)인 쌍을 제외한다. 남은 쌍의 개수를 \(n\)이라 하자.
3단계. 절대차이 \(|D_1|, |D_2|, \ldots, |D_n|\)을 작은 값부터 순위를 매기고 동점에는 중간순위를 배정한다.
4단계. 부호순위합을 계산한다.
\(W^+ + W^- = n(n+1)/2\)임에 유의하라.
5단계. 양측검정(two-sided test)의 검정통계량(test statistic)은 \(T = \min(W^+, W^-)\)이다. 동치로 \(W^+\)를 그 귀무분포와 비교해도 된다.
3. 표집분포 — 모든 부호 배정이 같은 확률이다¶
차이가 대칭인 \(H_0\) 아래에서 모든 부호 배정이 동등하게 가능하다. \(W^+\)의 귀무분포는
을 갖는다. \(n\)이 클 때의 정규근사는
이다. 절대차이의 동점 집단이 \(g\)개이고 크기가 \(t_1, \ldots, t_g\)일 때 보정된 분산은
이다.
두 가지 표준화 방식¶
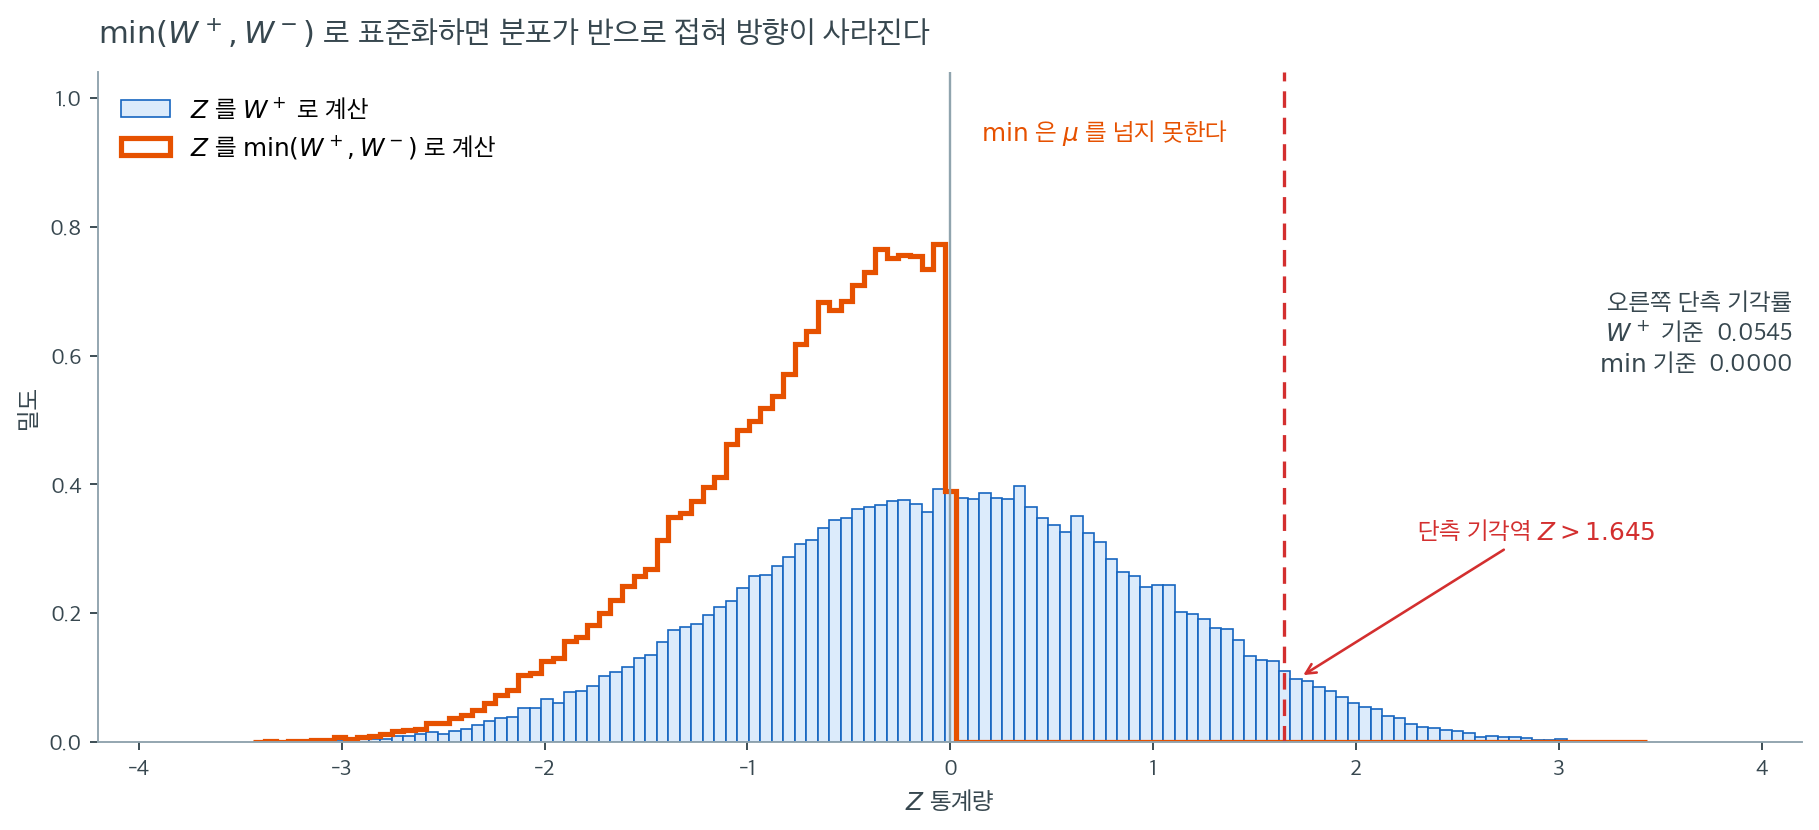
말로만 들으면 사소한 표기 문제 같지만 결과는 그렇지 않다. \(n = 15\)인 자료를 \(H_0\) 아래에서 \(60{,}000\)번 만들어 두 방식으로 \(Z\)를 계산한 것이 위 그림이다.
옅은 파란 히스토그램이 \(W^+\)로 표준화한 \(Z\)이다. \(0\)을 중심으로 좌우대칭이고 표준정규에 가깝다. 오른쪽 꼬리 \(Z > 1.645\)로 떨어지는 비율이 \(0.0545\)로 명목수준과 맞는다. 이 분포는 "양의 차이가 우세한가 음의 차이가 우세한가"를 좌우로 구별해 담고 있다.
주황 윤곽선이 \(\min(W^+, W^-)\)로 표준화한 \(Z\)이다. 모양이 전혀 다르다. \(\min\)은 정의상 \(W^+\)와 \(W^-\) 중 작은 쪽이고 둘의 합이 \(n(n+1)/2 = 120\)으로 고정되어 있으므로 \(\min \le 60 = \mu\)가 항상 성립한다. 따라서 \(Z\)가 결코 \(0\)을 넘지 못하고, 분포가 \(0\)에서 칼로 자른 듯 끊긴 채 왼쪽으로 접혀 있다. 오른쪽 단측 기각률은 \(0.0000\)이다. 오른쪽 단측검정을 \(\min\)으로 수행하면 어떤 자료가 와도 기각하지 못한다.
양측검정에서는 왜 괜찮은가. \(|Z|\)를 보는 순간 접힌 분포와 접히기 전 분포가 같은 대답을 주기 때문이다(모의실험에서 양측 기각률이 두 방식 모두 \(0.0484\)였다). 그러나 이것은 우연한 일치일 뿐 원칙이 아니다. \(W^+\)를 일관되게 쓰고 부호로 방향을 읽는 습관을 들이면 단측·양측을 가리지 않고 안전하다.
4. 검정 — 표는 작은 쪽을 싣고 임계값 이하면 기각이다¶
관측한 \(W^+\) 를 귀무분포에 대고 그보다 더 치우친 부호 배정의 몫을 읽는다.
\(p \le \alpha\) 이면 「차이의 중앙값이 \(0\) 이다」를 버린다. 표로 읽을 때는 꼴이 뒤집힌다 — 표가 싣는 것은 \(W^+\) 와 \(W^-\) 가운데 작은 쪽이고, 그 값이 임계값 이하면 기각이다. 치우칠수록 작은 쪽이 더 작아지기 때문이다.
버리고 남은 쌍의 수 \(n'\) 이 경계를 정한다. \(n'\) 이 작으면 \(2^{n'}\) 가지를 그대로 세어 정확 \(p\) 값을 얻고, \(n'\) 이 \(20\) 을 넘으면 앞 절의 \(Z\) 로 바꾼다. 동점이 있으면 그 \(Z\) 의 분산에서 보정항을 빼야 하고, 빼먹으면 분모가 커져 \(p\) 가 크게 나온다.
5. 세 보기로 끝까지 풀어 본다¶
보기 1. 교육 프로그램과 생산성 점수. 한 회사가 교육 프로그램이 직원의 생산성 점수를 높이는지 검정한다. 직원 12명을 프로그램 전후에 측정했다.
| 직원 | 전 (\(Y_i\)) | 후 (\(X_i\)) | \(D_i = X_i - Y_i\) | \(\lvert D_i \rvert\) | 순위 | 부호순위 |
|---|---|---|---|---|---|---|
| 1 | 45 | 52 | 7 | 7 | 5.5 | \(+5.5\) |
| 2 | 38 | 41 | 3 | 3 | 2 | \(+2\) |
| 3 | 50 | 48 | \(-2\) | 2 | 1 | \(-1\) |
| 4 | 42 | 49 | 7 | 7 | 5.5 | \(+5.5\) |
| 5 | 55 | 60 | 5 | 5 | 3.5 | \(+3.5\) |
| 6 | 48 | 53 | 5 | 5 | 3.5 | \(+3.5\) |
| 7 | 41 | 50 | 9 | 9 | 8 | \(+8\) |
| 8 | 53 | 45 | \(-8\) | 8 | 7 | \(-7\) |
| 9 | 47 | 58 | 11 | 11 | 9.5 | \(+9.5\) |
| 10 | 44 | 55 | 11 | 11 | 9.5 | \(+9.5\) |
| 11 | 50 | 62 | 12 | 12 | 11 | \(+11\) |
| 12 | 46 | 59 | 13 | 13 | 12 | \(+12\) |
순위합을 구한다.
풀이
검산: \(W^+ + W^- = 70 + 8 = 78 = 12(13)/2\). \(\checkmark\)
검정통계량: \(T = \min(70, 8) = 8\).
정규근사 (\(n = 12\)):
절대차이에 크기 2인 동점 집단이 세 개 있다(\(|D| = 5\)가 둘, \(|D| = 7\)이 둘, \(|D| = 11\)이 둘). 따라서 \(\sum_j (t_j^3 - t_j) = 3(8 - 2) = 18\)이고
\(\alpha = 0.05\)에서 \(H_0\)을 기각한다. 교육 프로그램이 생산성 점수를 개선했다는 유의한 증거가 있다.
정확 \(p\) 값
\(n = 12\)에서는 SciPy가 정확검정을 쓸 수 있으며 결과는 \(p = 0.0122\)이다. 정규근사값 \(0.0149\)보다 작다.
import numpy as np
from scipy import stats
D = np.array([7, 3, -2, 7, 5, 5, 9, -8, 11, 11, 12, 13])
print(stats.wilcoxon(D, method='exact').pvalue)   # 0.012207
print(stats.wilcoxon(D, method='approx', correction=False).pvalue)  # 0.014906
출력:
0.01220703125
0.014906162657892297
동점이 있으면 정확 귀무분포가 엄밀하게는 성립하지 않으므로, SciPy의 정확값도 "동점이 없었다면"의 값임에 유의하라.
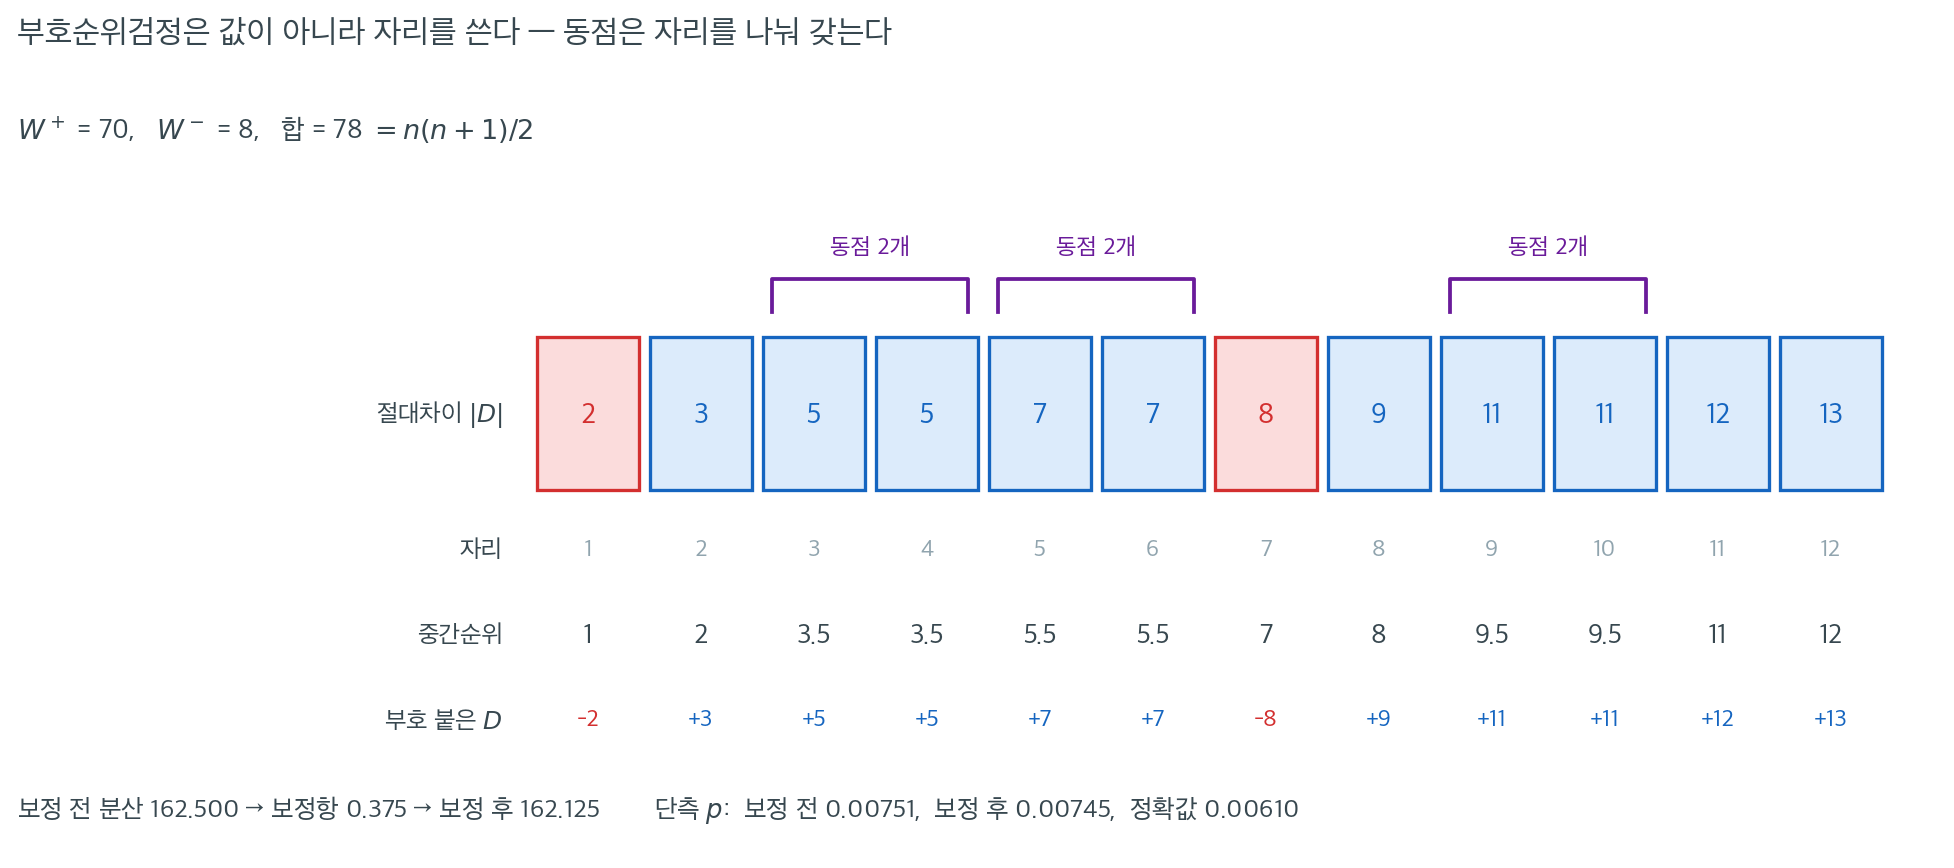
절차의 3단계와 4단계가 실제로 무슨 일을 하는지 한 줄로 펼쳐 보자. 맨 윗줄이 절대차이 \(|D|\)를 작은 것부터 세운 것이고, 파란 칸은 원래 차이가 양수였던 것, 빨간 칸은 음수였던 것이다.
두 번째 줄의 "자리"와 세 번째 줄의 "중간순위"가 다른 지점을 보라. \(|D| = 5\)가 두 개 있어 자리 \(3\)과 \(4\)를 차지하는데, 어느 쪽에 \(3\)을 주고 어느 쪽에 \(4\)를 줄 이유가 없으므로 둘 다 \((3+4)/2 = 3.5\)를 받는다. \(|D| = 7\)인 두 개는 \(5.5\), \(|D| = 11\)인 두 개는 \(9.5\)를 받는다. 이렇게 배정해도 순위의 총합은 \(78 = 12 \cdot 13 / 2\)로 변하지 않는다. \(W^+ = 70\), \(W^- = 8\)이고 합이 정확히 \(78\)인 것이 검산이다.
이 그림에서 부호순위검정이 크기를 쓰는 방식이 얼마나 완곡한지도 드러난다. 가장 큰 차이 \(13\)이 받는 것은 \(13\)이 아니라 순위 \(12\)이고, 음의 차이 \(-8\)이 깎아내리는 것은 \(8\)이 아니라 순위 \(7\)이다. 그래서 \(W^-\)가 \(1 + 7 = 8\)에 그친다. 이 완곡함 덕에 이상치(outlier)가 통계량을 끌고 가지 못하는 동시에, 순위 \(1\)과 순위 \(12\)를 구별하므로 부호만 세는 것보다는 훨씬 많은 정보를 쓴다. 단측 \(p\) 값이 부호검정 \(0.0193\), 부호순위검정 \(0.0061\), 대응 \(t\) 검정 \(0.0028\)로 늘어서는 것이 그 순서이다.
동점 보정은 이 자료에서 거의 하는 일이 없다. 크기 \(2\)인 동점 집단이 셋뿐이라 보정항이 \(\frac{1}{48}\sum (t_j^3 - t_j) = \frac{3 \times 6}{48} = 0.375\)에 불과하여, 분산이 \(162.500\)에서 \(162.125\)로 \(0.2\%\) 줄고 단측 \(p\) 값은 \(0.00751\)에서 \(0.00745\)로 바뀔 뿐이다. 보정이 문제가 되는 것은 동점 집단이 크거나 많을 때이며, 리커트 척도처럼 값이 몇 개뿐인 자료가 전형적인 경우이다.
교수법 개선¶
보기 2. 교수법 개선. 상황: 한 연구자가 새 교수법이 시험 점수를 높이는지 검정하려 한다. 학생 10명이 새 방법을 쓰기 전과 후에 시험을 본다. 점수가 유의하게 향상되었는지 검정하라.
자료는 이렇다.
| 학생 | 전 | 후 | 차이 (\(d_i\)) |
|---|---|---|---|
| 1 | 70 | 72 | 2 |
| 2 | 68 | 69 | 1 |
| 3 | 75 | 78 | 3 |
| 4 | 80 | 85 | 5 |
| 5 | 72 | 75 | 3 |
| 6 | 74 | 76 | 2 |
| 7 | 69 | 70 | 1 |
| 8 | 77 | 79 | 2 |
| 9 | 73 | 74 | 1 |
| 10 | 76 | 80 | 4 |
풀이
1단계 --- 차이: 모든 차이가 양수이다. \(d = [2, 1, 3, 5, 3, 2, 1, 2, 1, 4]\)
2단계 --- 절대차이의 순위를 매긴다.
정렬: \([1, 1, 1, 2, 2, 2, 3, 3, 4, 5]\)
동점 순위: \([2, 2, 2, 5, 5, 5, 7.5, 7.5, 9, 10]\)
원래 순서로 배정: \([5, 2, 7.5, 10, 7.5, 5, 2, 5, 2, 9]\)
3단계 --- 부호 배정: 모든 차이가 양수이므로 모든 순위가 양수이다.
4단계 --- \(W^+\) 와 \(W^-\) 를 구한다.
- \(W^+ = 5 + 2 + 7.5 + 10 + 7.5 + 5 + 2 + 5 + 2 + 9 = 55\)
- \(W^- = 0\)
- \(W = \min(55, 0) = 0\)
5단계 --- 유의성을 판정한다.
\(n = 10\), \(\alpha = 0.05\)(양측)에 대한 윌콕슨 표의 임계값은 8이다. \(W = 0 < 8\)이므로 \(H_0\)을 기각한다.
결론: 새 교수법이 시험 점수를 향상시킨다는 유의한 증거가 있다.
정확 \(p\) 값과 근사 \(p\) 값
모든 차이가 양수인 이 자료의 정확 양측 \(p\) 값은
이다. 동점 보정을 적용한 정규근사는 \(Z = (55 - 27.5)/\sqrt{95.125} = 2.820\)에서 \(p = 0.00481\)을 준다. 근사값이 정확값의 2.5배로, \(n = 10\)에서 정규근사가 얼마나 부정확한지를 보여 준다.
이 자료에서는 모든 차이가 같은 방향이므로 부호검정도 같은 정확 \(p\) 값 \(0.001953\)을 낸다. 부호검정이 크기 정보를 버려도 손해를 보지 않는 유일한 경우이다.
동점이 있으면 임계값의 뜻이 달라진다¶
보기 3. 동점이 있으면 임계값 8 의 뜻이 달라진다. 훈련 전후 점수 10쌍에서 열 쌍 모두 점수가 올랐다. wilcoxon(after, before) 이 \(W = 0\), \(p = 0.001953125\) 를 준다.
(1) 정확 양측 p 값이 \(2/1024\) 인 까닭을 말하시오. \(\lvert d \rvert\) 에 동점이 많은데도 이 값이 동점에 전혀 영향받지 않는 까닭은 무엇인가.
(2) 아래 연습문제 12 는 \(n = 10\) 의 양측 임계값이 \(8\) 이고 그 실제 수준이 \(0.0488\) 이라고 한다. 그것은 동점이 없을 때의 값이다. 이 자료의 중간순위로 귀무분포를 다시 열거하면 실제 수준이 얼마인가.
풀이
(1) 극단에서는 순위의 세부가 지워진다. 차이는
로 열 개가 모두 양수다. 따라서 \(W^- = 0\) 이고 \(W^+\) 는 순위의 총합 \(55\) 다.
\(H_0\) 과 대칭성 아래에서 각 순위의 부호는 독립적인 동전던지기이므로 \(2^{10} = 1024\) 가지 부호 배정이 모두 확률 \(1/1024\) 다. 그 가운데
- \(W^- = 0\) 을 주는 배정 — "모두 \(+\)" 하나
- \(W^+ = 0\) 을 주는 배정 — "모두 \(-\)" 하나
둘뿐이므로
동점이 영향을 주지 못하는 까닭이 여기 있다. 중간순위를 쓰든 \(1, 2, \dots, 10\) 을 쓰든 순위의 총합은 \(55\) 로 같고, "모두 한 부호" 인 배정은 언제나 두 개다. \(T = 0\) 은 분포의 양 끝이므로 순위가 어떻게 뭉쳤는지와 무관하다. scipy 의 정확검정이 동점을 무시하는 표를 쓰면서도 여기서 맞는 답을 주는 것은 운이다 — 이 자료가 하필 극단에 있기 때문이다.
(2) 실제 수준은 \(0.0488\) 이 아니라 \(0.0430\) 이다. 이 자료의 중간순위는
다. \(\lvert d \rvert\) 에서 \(1\) 이 셋(\(\to\) 순위 \(1,2,3\) 의 평균 \(2\)), \(2\) 가 셋(\(\to 4,5,6\) 의 평균 \(5\)), \(3\) 이 둘(\(\to 7,8\) 의 평균 \(7.5\)), \(4\) 와 \(5\) 가 각각 하나(\(\to 9\), \(10\))다. 이 순위로 \(1024\) 가지를 다시 열거해 \(T = \min(W^+, W^-)\) 의 분포를 얻으면
| \(c\) | 동점 없음 \(P(T \leq c)\) | 이 자료 \(P(T \leq c)\) |
|---|---|---|
| 6 | 0.027344 | 0.021484 |
| 7 | 0.037109 | 0.039062 |
| 8 | 0.048828 | 0.042969 |
| 9 | 0.064453 | 0.062500 |
\(c = 8\) 의 실제 수준이 \(0.048828\) 에서 \(0.042969\) 로 내려간다. 명목 \(0.05\) 를 쓰고 있다고 믿으면서 실제로는 \(0.043\) 짜리 검정을 돌리는 셈이다.
움직이는 방향이 한결같지 않다는 점도 보라. \(c = 7\) 에서는 오히려 \(0.037109\) 에서 \(0.039062\) 로 올라간다. 중간순위는 격자를 반 칸씩 밀어 놓으므로 어느 쪽으로 움직일지는 동점의 모양에 달려 있고, 미리 알 수 없다. \(T\) 가 가질 수 있는 값도 \(28\) 가지에서 \(43\) 가지로 늘어난다 — 반정수 \(7.5\) 가 끼어 부분합이 \(0.5\) 단위로 나오기 때문이다.
그러므로 동점이 있는 자료에 표의 임계값을 그대로 쓰지 말아야 한다. \(n\) 이 작으면 관측된 \(\lvert d \rvert\) 의 중간순위로 직접 열거하는 것이 옳다.
수치적으로.
import numpy as np
from scipy.stats import wilcoxon

# 훈련 전후의 점수. 같은 사람을 두 번 잰 대응자료다.
before = np.array([70, 68, 75, 80, 72, 74, 69, 77, 73, 76])
after = np.array([72, 69, 78, 85, 75, 76, 70, 79, 74, 80])

# 부호순위검정은 대응 t 검정의 비모수 대응이다. 차이의 부호와 크기 순위만
# 쓰므로 정규성을 요구하지 않는다. 열 쌍 모두 점수가 올랐으므로 통계량이
# 0 이 되고, 그때 나올 수 있는 가장 작은 p 값이 (1/2)^10 의 두 배다.
stat, p_value = wilcoxon(after, before)

print(f"Test Statistic: {stat}")     # 0.0
print(f"P-value: {p_value}")         # 0.001953125

# 결과 해석
alpha = 0.05
if p_value < alpha:
    print("Reject the null hypothesis: Significant improvement in scores.")
else:
    print("Fail to reject the null hypothesis: No significant improvement in scores.")
출력:
Test Statistic: 0.0
P-value: 0.001953125
Reject the null hypothesis: Significant improvement in scores.
import itertools
from scipy import stats

d = after - before
r = stats.rankdata(np.abs(d))
n = len(d)
print(f"차이        {d.tolist()}")
print(f"|차이| 순위  {r.tolist()}   합 {r.sum()}  (n(n+1)/2 = {n * (n + 1) / 2})")

signs = np.array(list(itertools.product([0, 1], repeat=n)))

def null_T(ranks):
    W_plus = signs @ ranks
    return np.minimum(W_plus, ranks.sum() - W_plus)

T_plain = null_T(np.arange(1, n + 1, dtype=float))   # 동점이 없을 때
T_tied = null_T(r)                                   # 이 자료의 중간순위
print(f"\nT 가 가질 수 있는 값: 동점 없음 {len(set(np.round(T_plain, 6)))} 가지,"
      f"  이 자료 {len(set(np.round(T_tied, 6)))} 가지")
print("  c   동점없음 P(T<=c)   이 자료 P(T<=c)")
for c in (0, 6, 7, 8, 9):
    print(f" {c:>2} {float((T_plain <= c + 1e-9).mean()):>16.6f} "
          f"{float((T_tied <= c + 1e-9).mean()):>17.6f}")
for lab, T in (("동점 없음", T_plain), ("이 자료  ", T_tied)):
    c = max(k for k in range(28) if (T <= k + 1e-9).mean() <= 0.05)
    print(f"  {lab}: 임계값 c = {c},  실제 수준 {float((T <= c + 1e-9).mean()):.6f}")
출력:
차이        [2, 1, 3, 5, 3, 2, 1, 2, 1, 4]
|차이| 순위  [5.0, 2.0, 7.5, 10.0, 7.5, 5.0, 2.0, 5.0, 2.0, 9.0]   합 55.0  (n(n+1)/2 = 55.0)

T 가 가질 수 있는 값: 동점 없음 28 가지,  이 자료 43 가지
  c   동점없음 P(T<=c)   이 자료 P(T<=c)
  0         0.001953          0.001953
  6         0.027344          0.021484
  7         0.037109          0.039062
  8         0.048828          0.042969
  9         0.064453          0.062500
  동점 없음: 임계값 c = 8,  실제 수준 0.048828
  이 자료  : 임계값 c = 8,  실제 수준 0.042969
\(c = 0\) 에서는 두 분포가 똑같이 \(0.001953\) 을 주고(\(= 2/1024\)), \(c = 8\) 에서는 \(0.048828\) 과 \(0.042969\) 로 갈린다. (1) 과 (2) 의 결론이 한 표에 나란히 보인다 — 극단에서는 동점이 지워지고, 중간에서는 지워지지 않는다.
6. 왜 대응 부호검정보다 강력한가¶
같은 자료에서 대응 부호검정은 \(n_+ = 10\), \(n_- = 2\)를 셀 뿐이다. 음의 차이(\(-2\)와 \(-8\))가 양의 차이보다 대체로 작다는 사실을 무시한다. 윌콕슨 부호순위검정은 음의 차이에 낮은 순위(1과 7)를 배정하고 양의 차이가 높은 순위를 쌓아 가게 함으로써 이 사실을 포착한다. 크기를 반영한 이 가중치가 증거를 훨씬 효과적으로 모은다.
ARE 비교
차이가 정규일 때 대응 윌콕슨 검정의 대응 \(t\) 검정 대비 ARE는 \(3/\pi \approx 0.955\)이다. 대응 부호검정의 ARE는 \(2/\pi \approx 0.637\)에 그친다. 즉 윌콕슨 검정은 \(t\) 검정의 검정력에 맞추려면 관측값이 약 5% 더 필요한 반면, 부호검정은 약 57% 더 필요하다.
AI로 보는 통계학 1. 짝지은 것이 사람이 아니라 자료집합일 때
이 쪽의 대응 윌콕슨 부호순위검정은 오늘 기계학습 논문이 두 알고리즘을 견줄 때 쓰라고 권고받는 바로 그 검정이다. 달라진 것은 「짝」이 무엇이냐 하나뿐이다. 위 보기 \(1\) 에서 짝은 교육 전후의 같은 직원이었고, 거기서는 같은 자료집합에서 잰 두 알고리즘의 성적이다.
그 권고가 적힌 곳이 \(2006\) 년 『Journal of Machine Learning Research』 \(7\) 권 \(1\)–\(30\) 쪽, 야네즈 뎀샤르의 논문이다. 그는 당시 관행을 훑은 뒤 여러 검정을 이론과 실험으로 따져 보고 초록에 이렇게 적었다. 「… 분류기의 통계적 비교를 위해 단순하면서도 안전하고 로버스트한 비모수(nonparametric) 검정 한 벌을 권한다 — 두 분류기를 견줄 때는 윌콕슨 부호순위검정, 여러 분류기를 여러 자료집합에서 견줄 때는 프리드먼 검정과 그에 딸린 사후검정(post hoc test).」 이 쪽과 프리드먼 검정 쪽이 이름으로 호명되어 있다.
까닭은 이 쪽이 줄곧 말해 온 것과 같다. 자료집합마다 정확도의 척도가 다르다. 어떤 자료집합에서는 \(0.99\) 대 \(0.98\) 이고 다른 데서는 \(0.61\) 대 \(0.55\) 다. 차이를 그대로 평균 내면 척도가 큰 자료집합 하나가 결론을 통째로 끌고 간다. 순위로 바꾸면 각 자료집합은 「어느 쪽이 이겼는가, 그 차이가 다른 자료집합들에 견주어 몇 번째로 컸는가」만 기여한다.
자료집합 \(20\) 개에서 두 알고리즘을 재었다고 하자. \(\mathrm A\) 가 \(18\) 개에서 조금씩 이기고 \(2\) 개에서 크게 진다.
import numpy as np
from scipy import stats

# 자료집합 20 개에서 잰 두 알고리즘의 정확도 (설명을 위해 지어낸 값)
A = np.array([0.832, 0.954, 0.699, 0.677, 0.827, 0.643, 0.635, 0.798, 0.782, 0.929,
              0.833, 0.795, 0.789, 0.708, 0.630, 0.689, 0.857, 0.694, 0.660, 0.550])
B = np.array([0.825, 0.946, 0.691, 0.673, 0.822, 0.635, 0.632, 0.790, 0.774, 0.923,
              0.828, 0.790, 0.784, 0.702, 0.624, 0.683, 0.848, 0.686, 0.742, 0.621])

d = A - B
print(f"A 가 이긴 자료집합  {(d > 0).sum()} / {len(d)}")
print(f"차이의 평균        {d.mean():+.4f}")

t = stats.ttest_rel(A, B)
w = stats.wilcoxon(A, B)
print(f"대응 t 검정        t = {t.statistic:+.3f}, p = {t.pvalue:.4f}")
print(f"부호순위검정       W = {w.statistic:.1f}, p = {w.pvalue:.4f}")
출력:
A 가 이긴 자료집합  18 / 20
차이의 평균        -0.0019
대응 t 검정        t = -0.332, p = 0.7438
부호순위검정       W = 39.0, p = 0.0121
두 검정이 방향마저 다르게 말한다. 차이의 평균은 \(-0.0019\) 로 \(\mathrm B\) 쪽이 낫다고 하고 대응 \(t\) 는 \(p = 0.74\) 로 아무 말도 하지 않는다. 두 자료집합에서 난 \(-0.08\) 짜리 손실이 나머지 열여덟 개의 \(+0.005\) 를 혼자 상쇄했기 때문이다. 부호순위검정은 그 둘에게 가장 높은 순위인 \(19\) 와 \(20\) 을 주어 가장 무겁게 쳐 주고도 \(W = 39\), \(p = 0.012\) 를 낸다. 음의 순위합 \(39\) 가 전체 \(210\) 의 \(1/5\) 에 못 미치기 때문이다.
다만 이 검정이 말해 주는 것은 「이 스무 개의 모둠에서 한쪽이 더 자주 낫다」뿐이다. 자료집합 모둠을 누가 어떻게 골랐는지가 결론을 정하는데, 검정은 그 선택에 대해 한마디도 하지 않는다.
확인한 곳 — 논문이 Janez Demšar 의 「Statistical Comparisons of Classifiers over Multiple Data Sets」이고 『Journal of Machine Learning Research』 \(7\) 권 \(1\)–\(30\) 쪽(\(2006\) 년 \(1\) 월 간행, \(2004\) 년 \(8\) 월 투고)이며 슬로베니아 류블랴나 대학 소속으로 적혀 있다는 것, 그리고 인용한 초록의 권고 문장은 JMLR 의 공개 PDF 첫 쪽에서 읽었다. 위 코드의 정확도는 설명을 위해 지어낸 값이고 출력은 그 값으로 실제로 돌려 받은 것이다
짝을 버리면 검정력이 어디까지 떨어지는가¶
보기 4. 짝을 버리면 검정력이 0 까지 떨어진다. 아래 코드는 독립인 두 집단에 순위합검정을 쓴다 — 쓰임이 맞는 자리다. 그런데 아래 경고 상자는 같은 함수를 대응자료에 쓰면 \(p\) 가 \(0.0086\) 에서 \(0.141\) 로 뛴다고 한다.
(1) 개체 간 변동(사람마다 기본 수준이 다른 것)의 크기를 바꾸어 가며, 짝을 쓰는 부호순위검정과 짝을 버리는 순위합검정의 검정력을 모의실험으로 재시오.
(2) 개체 간 변동이 없으면 어느 쪽이 나은가. 그 까닭은 무엇인가.
풀이
(1) 모형을 세우고 재 본다. 참가자 \(i\) 의 기본 수준을 \(S_i \sim \mathcal{N}(0, \sigma_s^2)\), 측정 잡음을 \(\varepsilon \sim \mathcal{N}(0,1)\), 처리 효과를 \(\delta\) 라 하고
로 15쌍을 만든다. 차이 \(X_i - Y_i = \delta + \varepsilon_{i1} - \varepsilon_{i2}\) 에서 \(S_i\) 가 깨끗이 사라진다. 이것이 대응설계의 핵심이다. 반면 두 열을 따로 떼어 독립표본(independent samples)으로 보면 \(S_i\) 의 산포가 그대로 잡음으로 남는다.
이론이 예측하는 바는 분명하다. \(\delta = 1\), \(\sigma_s = 10\) 이면 차이의 표준편차는 \(\sqrt{1+1} = 1.414\) 로 신호 \(\delta = 1\) 과 비슷한 크기이지만, 각 열의 표준편차는 \(\sqrt{100 + 1} = 10.05\) 로 신호의 열 배다. 순위합검정은 신호를 찾을 수 없다.
\(\alpha = 0.05\), 반복 2000회로 재면
| \(\sigma_s\) | \(\delta\) | 부호순위(짝 사용) | 순위합(짝 무시) |
|---|---|---|---|
| 10 | 1 | 0.690 | 0.000 |
| 1 | 1 | 0.701 | 0.439 |
| 0 | 1 | 0.700 | 0.742 |
| 10 | 0 | 0.049 (크기) | 0.000 |
(반복 2000회의 몬테카를로(Monte Carlo) 오차는 기각률 \(0.7\) 근처에서 \(\pm 0.010\), \(0.05\) 근처에서 \(\pm 0.005\) 다.)
\(\sigma_s = 10\) 에서 순위합검정의 검정력이 \(0.000\) 이다. 2000번 가운데 한 번도 기각하지 못했다. 부호순위검정의 검정력 \(0.690\) 은 \(\sigma_s\) 가 \(0\) 이든 \(10\) 이든 거의 같다 — 차이를 취하면서 \(S_i\) 를 지웠으므로 개체 간 변동이 아예 보이지 않는다.
맨 아래 줄도 눈여겨볼 일이다. \(\delta = 0\) 일 때 부호순위검정의 기각률은 \(0.049\) 로 명목수준과 맞지만 순위합검정은 \(0.000\) 이다. 순위합검정이 검정력만 잃은 것이 아니라 아예 작동을 멈춘 것이다. 두 열이 같은 \(S_i\) 를 공유하므로 합친 30개 관측값이 "쌍끼리 붙어 있는" 모양이 되고, 순위합이 기댓값 근처에 못 박힌다.
(2) 개체 간 변동이 없으면 순위합이 조금 앞선다. \(\sigma_s = 0\) 줄에서 \(0.742\) 대 \(0.700\) 이다(차이 \(0.042\), 몬테카를로 오차 \(\pm 0.010\) 수준). 까닭은 쓰는 순위의 개수다. 부호순위검정은 15개 차이에 \(1 \sim 15\) 의 순위를 매기지만, 순위합검정은 30개 관측값에 \(1 \sim 30\) 의 순위를 매긴다. 짝지을 것이 없는 자료에서 억지로 짝을 지으면 자유도를 반으로 줄이는 셈이다.
그러므로 "대응 검정이 늘 낫다"가 아니다. 옳은 서술은 "자료가 대응이면 대응 검정을 써야 한다" 다. 자료의 구조가 검정을 정하고, 구조를 잘못 읽으면 양쪽 방향으로 틀린다 — 대응자료에 독립 검정을 쓰면 검정력을 통째로 잃고(\(0.690 \to 0.000\)), 독립자료를 억지로 짝지으면 조금 잃는다(\(0.742 \to 0.700\)).
수치적으로.
from scipy import stats

# 서로 다른 두 집단에서 독립적으로 얻은 관측값이어야 한다.
# 크기가 달라도 되는 것이 대응표본 검정과의 큰 차이다.
a = [12, 15, 18, 22, 25]
b = [8, 10, 14, 19, 21, 24]

# ranksums 는 순위합 검정이다. Mann-Whitney U 와 수학적으로 같은 검정이지만
# 정규근사만 쓰고 동점 보정을 하지 않는다. 표본이 작으면 mannwhitneyu 쪽이 낫다.
statistic, p_value = stats.ranksums(a, b, alternative="two-sided")
print(f"Z = {statistic:.4f}, p = {p_value:.4f}")
# Z = 0.7303, p = 0.4652
출력:
Z = 0.7303, p = 0.4652
import numpy as np

rng = np.random.default_rng(0)
B, n = 2000, 15

print("sigma_s  delta   부호순위   순위합")
for sigma_s, delta in ((10.0, 1.0), (1.0, 1.0), (0.0, 1.0), (10.0, 0.0)):
    p_paired, p_indep = [], []
    for _ in range(B):
        S = rng.normal(0, sigma_s, n)           # 개체 간 변동
        X = S + delta + rng.normal(0, 1, n)
        Y = S + rng.normal(0, 1, n)
        p_paired.append(stats.wilcoxon(X, Y).pvalue)
        p_indep.append(stats.ranksums(X, Y).pvalue)
    print(f"{sigma_s:>7} {delta:>6}   "
          f"{np.mean(np.array(p_paired) < 0.05):>8.3f} "
          f"{np.mean(np.array(p_indep) < 0.05):>8.3f}")
print(f"\n반복 {B} 회의 몬테카를로 오차: 0.7 근처에서 "
      f"{np.sqrt(0.7 * 0.3 / B):.4f}, 0.05 근처에서 {np.sqrt(0.05 * 0.95 / B):.4f}")
출력:
sigma_s  delta   부호순위   순위합
   10.0    1.0      0.690    0.000
    1.0    1.0      0.701    0.439
    0.0    1.0      0.700    0.742
   10.0    0.0      0.049    0.000

반복 2000 회의 몬테카를로 오차: 0.7 근처에서 0.0102, 0.05 근처에서 0.0049
이론이 예측한 대로다. 부호순위검정의 검정력이 \(\sigma_s\) 에 거의 무관하게 \(0.69 \sim 0.70\) 에 머무르는 것은 차이를 취하면서 \(S_i\) 가 지워지기 때문이고, 순위합검정이 \(0.742 \to 0.439 \to 0.000\) 으로 무너지는 것은 \(S_i\) 의 산포가 그대로 잡음이 되기 때문이다. \(\delta = 0\) 줄의 \(0.049\) 는 명목수준 \(0.05\) 와 몬테카를로 오차(\(\pm 0.005\)) 안에서 맞는다.
대응자료에 순위합검정을 쓰지 말 것
부호순위검정 보기의 학생 자료를 두 열로 쪼개어 ranksums에 넣으면
\(Z = 1.472\), \(p = 0.141\)이 나온다. 부호순위검정의 \(p = 0.0086\)과 비교하면
16배이다.
이는 대응 구조를 버렸기 때문이며, 오류이다. 같은 학생의 처치 전 점수와 처치 후 점수는 독립이 아니다. 대응자료에는 반드시 부호순위검정이나 대응 \(t\) 검정을 써야 한다.
연습문제¶
연습문제 1. 위 생산성 자료에 네 가지 대응 검정(부호검정, 윌콕슨, 순열검정(permutation test), \(t\) 검정)을 모두 적용하여 양측 \(p\) 값을 비교하고, 순서를 설명하라.
풀이
import numpy as np, itertools
from scipy import stats
D = np.array([7, 3, -2, 7, 5, 5, 9, -8, 11, 11, 12, 13])

print(stats.binomtest(10, 12).pvalue)                      # 0.03857
print(stats.wilcoxon(D, method='exact').pvalue)            # 0.01221
print(stats.ttest_1samp(D, 0).pvalue)                      # 0.00569

a = np.abs(D); T = D.sum()
allT = np.array([np.dot(s, a) for s in itertools.product([-1, 1], repeat=12)])
print((np.abs(allT) >= abs(T)).mean())                     # 0.01074
출력:
0.03857421875
0.01220703125
0.00569322392504434
0.0107421875
| 검정 | 양측 \(p\) 값 |
|---|---|
| 대응 부호검정 | \(0.0386\) |
| 대응 윌콕슨 (정확) | \(0.0122\) |
| 대응 순열검정 | \(0.0107\) |
| 대응 \(t\) | \(0.0057\) |
사용하는 정보량 순서와 정확히 일치한다. 부호만 → 부호+순위 → 부호+원값 → 정규모형까지 가정. 각 단계마다 \(p\) 값이 작아진다.
이 자료는 차이가 대칭에 가깝고 이상치가 없어 \(t\) 검정에 유리한 조건이다. \(-8\)이라는 비교적 큰 음의 차이가 하나 있지만 \(+13\), \(+12\), \(+11\), \(+11\)이 이를 압도한다.
순열검정(\(0.0107\))이 윌콕슨(\(0.0122\))보다 조금 작다. 순열검정이 원값을 그대로 쓰므로 \(+13\)과 \(+11\)의 차이를 순위 \(12\)와 \(9.5\)의 차이보다 정확하게 반영하기 때문이다.
연습문제 2. \(n = 12\)에서 윌콕슨 부호순위검정의 정확 귀무분포를 직접 열거하여 구하고, 관측된 \(W^+ = 70\)의 정확 \(p\) 값을 계산하라. 정규근사와 비교하라.
풀이
import numpy as np, itertools
n = 12
ranks = np.arange(1, n + 1)
Wplus = np.array([np.dot(s, ranks)
                  for s in itertools.product([0, 1], repeat=n)])
print(len(Wplus))                       # 4096 = 2^12
print(Wplus.mean(), Wplus.var())        # 39.0, 162.5
p = 2 * min((Wplus >= 70).mean(), (Wplus <= 70).mean())
print(p)                                # 0.012207
출력:
4096
39.0 162.5
0.01220703125
열거로 얻은 평균 \(39.0\)과 분산 \(162.5\)가 공식 \(n(n+1)/4\)와 \(n(n+1)(2n+1)/24\)의 값과 정확히 일치한다.
| 방법 | \(p\) 값 |
|---|---|
| 정확 (열거) | \(0.01221\) |
| 정규근사, 동점 보정 없음 | \(0.01502\) |
| 정규근사, 동점 보정 | \(0.01491\) |
동점 보정의 효과가 미미하다(\(0.01502 \to 0.01491\), 0.8% 감소). 보정항 \(18/48 = 0.375\)가 분산 \(162.5\)의 0.23%에 불과하기 때문이다. 동점이 크기 2짜리 세 개뿐이라 그렇다.
반면 정규근사 자체의 오차는 훨씬 크다. \(0.0149\) 대 \(0.0122\)로 22% 과대평가한다. \(n = 12\)에서 \(W^+\)의 분포가 아직 계단이 굵어 정규곡선과 잘 맞지 않기 때문이다.
교훈: 동점 보정보다 정확검정을 쓰는 편이 훨씬 중요하다. \(n \le 25\) 정도면 정확 계산이 즉시 끝난다.
연습문제 3. 차이 분포가 대칭이 아니면 대응 윌콕슨 검정이 위험하다. 처치 효과가 일부 피험자에게만 나타나는 상황을 모형화하여 이 문제를 보여라.
풀이
처치가 피험자의 30%에게만 크게 작용하고 나머지 70%에게는 아무 효과가 없다고 하자. 이때 차이의 분포는 0에 몰린 덩어리와 오른쪽 꼬리로 이루어진 심한 비대칭 혼합이다.
import numpy as np
from scipy import stats
rng = np.random.default_rng(4)

def sim(n, B=2000):
    pw = np.empty(B); ps = np.empty(B)
    for b in range(B):
        responder = rng.random(n) < 0.3
        d = rng.normal(0, 1, n) + responder * 3.0
        pw[b] = stats.wilcoxon(d).pvalue
        nz = d[d != 0]
        ps[b] = stats.binomtest(int((nz > 0).sum()), len(nz)).pvalue
    return (pw < .05).mean(), (ps < .05).mean()

for n in (10, 20, 40):
    print(n, sim(n))
출력:
10 (0.2445, 0.0875)
20 (0.486, 0.246)
40 (0.811, 0.432)
여기서 참인 중앙값 차이는 0이 아니다(반응자가 30%이므로 중앙값은 여전히 0 근처이지만 평균은 \(+0.9\)이다). 따라서 이것은 크기 문제가 아니라 두 검정이 서로 다른 것을 재고 있음을 보여 주는 예이다.
| \(n\) | 윌콕슨 기각률 | 부호검정 기각률 |
|---|---|---|
| 10 | 0.244 | 0.088 |
| 20 | 0.486 | 0.246 |
| 40 | 0.811 | 0.432 |
윌콕슨이 훨씬 자주 기각한다. 그런데 이것을 "검정력이 높다"고 말할 수 있을까?
문제는 무엇을 결론으로 삼느냐이다. 윌콕슨이 기각할 때 우리가 아는 것은 "월시 평균의 중앙값이 0이 아니다"이고, 이는 여기서 참이다. 그러나 실무자는 이를 "전형적인 환자가 개선된다"로 읽기 쉽다. 그런데 참가자의 70%는 아무 효과도 없다.
부호검정은 정직하게 "개선된 사람이 절반을 넘는가?"를 묻고, 답은 "그렇다, 하지만 약하게"이다(\(n = 40\)에서 기각률 0.43으로 윌콕슨의 0.81의 절반이다).
실무 권고: 반응자/비반응자 혼합이 의심되면 검정 하나로 요약하지 말고 차이의 히스토그램을 반드시 그려야 한다. 이봉 분포가 보이면 "평균 효과"라는 개념 자체가 오도적이며, 반응자 비율을 추정하는 것이 옳은 분석이다.
연습문제 4. 대응 윌콕슨 검정으로 중앙값 차이의 신뢰구간을 만들고, 대응 부호검정 기반 구간 및 \(t\) 구간과 폭을 비교하라.
풀이
윌콕슨 구간은 차이의 월시 평균 \((D_i + D_j)/2\) (\(i \le j\))에 기반한다.
import numpy as np, itertools
from scipy import stats
D = np.array([7, 3, -2, 7, 5, 5, 9, -8, 11, 11, 12, 13])
n = len(D)

walsh = np.sort([(D[i] + D[j]) / 2 for i in range(n) for j in range(i, n)])
ranks = np.arange(1, n + 1)
Wplus = np.array([np.dot(s, ranks) for s in itertools.product([0, 1], repeat=n)])
k = max(c for c in range(30) if 2 * (Wplus <= c).mean() <= 0.05)
print(k, len(walsh), walsh[k], walsh[-(k + 1)])   # 13 78 1.5 10.0

Ds = np.sort(D)
m = max(c for c in range(n) if 2 * stats.binom.cdf(c, n, 0.5) <= 0.05)
print(m, Ds[m + 1], Ds[n - m - 1])                # 2 5 11
print(stats.ttest_1samp(D, 0).confidence_interval())
출력:
13 78 1.5 10.0
2 5 11
ConfidenceInterval(low=2.1717302734032677, high=9.994936393263398)
| 방법 | 95% 신뢰구간 | 폭 | 실제 포함확률 |
|---|---|---|---|
| 대응 부호검정 | \((5, \; 11)\) | \(6.0\) | \(0.961\) |
| 대응 윌콕슨 | \((1.5, \; 10.0)\) | \(8.5\) | \(0.958\) |
| 대응 \(t\) | \((2.17, \; 9.99)\) | \(7.8\) | \(0.950\) |
세 구간 모두 0을 포함하지 않으므로 세 검정이 모두 기각한 것과 일관된다.
부호검정 구간이 가장 좁다는 것이 뜻밖으로 보인다. 검정력이 가장 낮은 검정이 왜 가장 좁은 구간을 주는가? 이는 두 구간이 다른 방식으로 만들어지기 때문이다. 부호검정 구간은 순서통계량 \(D_{(3)} = 5\)와 \(D_{(10)} = 11\) 사이이고, 이 자료의 차이가 대부분 \(5\) 이상에 몰려 있어 우연히 좁게 나왔다. 윌콕슨 구간은 월시 평균에 기반하므로 \(-8\)과 \(-2\)가 만드는 낮은 쌍평균들까지 반영되어 아래쪽으로 늘어난다.
구간의 폭은 검정력의 좋은 지표가 아니다. 표본이 하나뿐일 때 어느 구간이 좁은지는 그 표본의 우연에 크게 좌우된다. 검정력을 비교하려면 여러 표본에 걸친 평균 폭을 보아야 한다.
점추정값을 비교하면 부호검정의 점추정(point estimation)은 표본중앙값 \(7.0\), 윌콕슨의 호지스–레만(Hodges–Lehmann) 추정은 월시 평균의 중앙값 \(7.0\), \(t\)의 점추정은 표본평균(sample mean) \(6.08\)이다.
연습문제 5. 본문 보기의 교육 프로그램을 다른 부서의 직원 여섯 명에게 시범 적용했다.
| 직원 | 전 (\(Y_i\)) | 후 (\(X_i\)) |
|---|---|---|
| 1 | 40 | 43 |
| 2 | 44 | 43 |
| 3 | 51 | 55 |
| 4 | 38 | 44 |
| 5 | 47 | 55 |
| 6 | 42 | 53 |
(a) \(\lvert D_i \rvert\) 의 순위와 \(W^+\), \(W^-\) 를 구하고 \(W^+ + W^- = n(n+1)/2\) 로 검산하라.
(b) \(n = 6\) 이면 부호 배정이 \(2^6 = 64\) 가지뿐이다. 관측된 \(W^+\) 의 양측 정확 \(p\) 값을 손으로 세어 구하라.
(c) 같은 자료에 대응 부호검정을 적용하여 양측 \(p\) 값을 구하고 (b) 와 비교하라.
(d) \(n = 6\) 에서 두 검정이 달성할 수 있는 가장 작은 양측 \(p\) 값은 둘 다 \(1/32\) 다. 왜 같은지 설명하고, 그렇다면 윌콕슨을 쓰는 이득은 어디에 있는지 (b), (c) 의 수로 답하라.
풀이
(a) 차이는 \(D = (3, -1, 4, 6, 8, 11)\) 이다. 절대차이 \(1 < 3 < 4 < 6 < 8 < 11\) 에 동점이 없으므로 순위는
| \(D_i\) | \(3\) | \(-1\) | \(4\) | \(6\) | \(8\) | \(11\) |
|---|---|---|---|---|---|---|
| \(\lvert D_i \rvert\) | \(3\) | \(1\) | \(4\) | \(6\) | \(8\) | \(11\) |
| \(R_i\) | \(2\) | \(1\) | \(3\) | \(4\) | \(5\) | \(6\) |
이고
이다. 검산: \(20 + 1 = 21 = 6 \cdot 7/2\). \(\checkmark\) 검정통계량은 \(T = \min(20, 1) = 1\) 이다.
(b) \(H_0\) 아래에서 \(W^+\) 는 \(\{1,2,3,4,5,6\}\) 의 부분집합 \(64\) 개의 합이 모두 같은 확률로 나오는 분포다. 꼬리는 세기 쉽다. \(W^+ \ge 20\) 은 \(W^- = 21 - W^+ \le 1\) 과 같은 말이고, 합이 \(1\) 이하인 부분집합은 \(\varnothing\) 과 \(\{1\}\) 둘뿐이다. 따라서
이다. \(\alpha = 0.05\) 에서 기각하지 못한다. 참고로 합이 \(w\) 인 부분집합의 개수 \(c(w)\) 를 모두 세면(\(\prod_{k=1}^{6}(1 + x^k)\) 의 계수)
| \(w\) | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| \(c(w)\) | 1 | 1 | 1 | 2 | 2 | 3 | 4 | 4 | 4 | 5 | 5 |
이고 \(c(w) = c(21 - w)\) 로 대칭이다. \(\sum_w c(w) = 64\) 임을 검산할 수 있다.
(c) 양의 차이가 \(n_+ = 5\), 음의 차이가 \(n_- = 1\) 이다. \(\mathrm{Bin}(6, 1/2)\) 에서
이다. 윌콕슨의 \(0.0625\) 보다 \(3.5\) 배 크다. 하나뿐인 음의 차이가 가장 작은 차이(\(-1\))라는 사실을 부호검정은 전혀 쓰지 못한 결과다.
(d) 가장 극단적인 결과는 "여섯 차이가 모두 양수"이고, 이것은 윌콕슨에서 \(W^+ = 21\), 부호검정에서 \(n_+ = 6\) 인 같은 하나의 부호 배정이다. 확률이 \(1/64\) 이니 단측 \(p\) 의 최솟값이 \(1/64\), 양측은 \(1/32 = 0.03125\) 로 두 검정이 같다. 극단값 하나만 보면 순위를 쓰는 이득이 없다.
이득은 \(p\) 값 격자의 촘촘함에 있다. \(n = 6\) 에서 부호검정이 낼 수 있는 양측 \(p\) 는
네 개뿐이지만, 윌콕슨은 \(c(w)\) 의 누적합에서
를 낸다. 이 자료가 바로 그 사이에 떨어져서, 부호검정은 "\(0.219\)" 라고 뭉개는 것을 윌콕슨은 "\(0.0625\), 유의수준 바로 앞" 이라고 말해 준다. 소표본에서 비모수 검정의 진짜 제약은 검정력이 아니라 \(p\) 값이 취할 수 있는 값이 몇 개뿐이라는 거칠기이고, 순위를 쓰는 일은 그 격자를 촘촘하게 만드는 일이다.
연습문제 6. \(H_0\) 아래에서 \(\lvert D_i \rvert\) 의 순위 \(R_i\) 는 고정되어 있고 부호만 동전처럼 정해지므로 \(W^+ = \sum_i R_i B_i\) (\(B_i\) 는 독립인 베르누이 \(1/2\))이다. 따라서 동점이 있든 없든
이다. 이 한 줄이 §3 의 동점 보정식의 정체다.
(a) 동점에 중간순위를 배정했을 때 위 식이 §3 의 보정식과 정확히 같음을 보여라. 곧 보정식은 근사가 아니다. (힌트: 크기 \(t\) 인 동점 집단에서 제곱합(sum of squares)이 줄어드는 양은 \(t\) 곱하기 그 자리 \(t\) 개의 분산 \((t^2-1)/12\) 다.)
(b) 절대차이가 모두 같은 극단(\(g = 1\), \(t_1 = n\))에서 보정된 분산이 \(n(n+1)^2/16\) 임을 (a) 에서 얻어라. 이때 윌콕슨 검정이 부호검정과 똑같아진다는 사실로 그 값을 독립적으로 확인하라.
(c) 동점 보정을 빼먹으면 검정이 보수적이 되는가 과감해지는가? (b) 의 극단에서 \(n = 20\) 일 때 표준편차가 몇 배 틀리는지, 그리고 \(n \to \infty\) 에서 그 배수의 극한을 구하라. \(n_+ = 15\) 인 자료에 대해 양측 \(p\) 값 세 개(보정 없음·보정·정확)를 비교하라.
풀이
(a) 크기 \(t\) 인 동점 집단이 자리 \(a+1, \ldots, a+t\) 를 차지하면 중간순위는 그 자리들의 평균 \(\bar r = a + (t+1)/2\) 다. 같은 평균을 가진 수들을 모두 평균으로 바꾸면 제곱합은 "편차제곱합"만큼 줄어든다.
집단마다 이만큼 줄어드니 중간순위의 제곱합은
이고, \(4\) 로 나누면
로 §3 의 식이 그대로 나온다. \(\square\)
본문 보기로 검산하면 \(n = 12\) 에 크기 \(2\) 인 집단이 셋이므로 \(\sum(t_j^3 - t_j) = 18\), 분산 \(162.5 - 18/48 = 162.125\) 로 일치한다. 보정항이 "어디선가 가져온 보정"이 아니라 중간순위를 쓰면 제곱합이 줄어든다는 산수일 뿐이라는 점이 중요하다.
(b) \(g = 1\), \(t_1 = n\) 이면 모든 중간순위가 \((n+1)/2\) 이므로
이다. (a) 의 식으로 계산해도 같다.
독립 확인: 순위가 모두 \((n+1)/2\) 이면 \(W^+ = \frac{n+1}{2} n_+\) 이고 \(n_+ \sim \mathrm{Bin}(n, 1/2)\) 이므로
로 같다. \(\checkmark\) 더 중요한 것은 이때 \(T\) 가 \(n_+\) 의 단조함수라는 점이다. 절대차이에 크기 정보가 전혀 남지 않으면 윌콕슨 검정은 부호검정으로 정확히 퇴화한다. ARE 가 \(3/\pi = 0.955\) 에서 \(2/\pi = 0.637\) 로 떨어지는 것이 이 퇴화의 대가다.
(c) 보정항은 항상 분산에서 빼는 양이므로 보정을 빼먹으면 분산을 과대평가한다. 그러면 \(\sigma\) 가 크고 \(\lvert Z \rvert\) 가 작고 \(p\) 가 커진다 — 보수적이 된다.
\(n = 20\) 의 극단에서
이고 비는 \(26.786/23.479 = 1.141\) 이다. 일반적으로
이므로 표준편차의 배수는 \(2/\sqrt3 = 1.155\) 로 올라간다. 곧 \(\lvert Z \rvert\) 를 최대 \(13\%\) 깎아 먹는다.
\(n_+ = 15\) 이면 \(W^+ = 15 \times 10.5 = 157.5\), \(\mu = 105\), 편차 \(52.5\) 다.
| 방법 | \(z\) | 양측 \(p\) |
|---|---|---|
| 정규근사, 보정 없음 | \(1.960\) | \(0.0500\) |
| 정규근사, 동점 보정 | \(2.236\) | \(0.0253\) |
| 정확 (\(=\) 부호검정) | — | \(0.0414\) |
보정을 빼먹은 쪽은 참값 \(0.0414\) 보다 \(21\%\) 큰 \(p\) 를 내놓는다. 거꾸로 보정한 정규근사는 이번엔 너무 작게 나오는데, 이는 분산 때문이 아니라 \(W^+\) 의 계단이 \(10.5\) 로 굵어졌는데 연속성 수정(continuity correction)을 하지 않은 탓이다. 반 계단 \(5.25\) 를 빼면 \(z = 52.5 - 5.25\) 를 쓴 \(2.012\), \(p = 0.0442\) 로 정확값에 붙는다. 동점이 많으면 보정항과 연속성 수정이 둘 다 필요하고, 그럴 상황이면 애초에 정확검정이나 순열검정을 쓰는 것이 낫다.
연습문제 7. §6 의 ARE \(3/\pi \approx 0.955\) 는 "표본을 \(1/0.955 - 1 = 4.7\%\) 더 모으면 대응 \(t\) 검정과 같아진다"는 뜻이다. 이 주장을 모의실험으로 확인하라.
차이가 정규일 때 \(n = 40\) 의 \(t\) 검정과 \(n = 42\)(\(= \lceil 40 \times 1.047 \rceil\))의 윌콕슨 검정의 검정력을 비교하라. 윌콕슨의 임계값은 정규근사가 아니라 정확 귀무분포에서 얻어야 한다(\(2^{40}\) 을 열거하지 말고 \(\prod_k (1 + x^k)\) 의 계수를 점화식으로 쌓아라). 이어 차이가 자유도 \(2\) 인 \(t\) 분포일 때 같은 비교를 하여 트레이드오프(trade-off)의 반대쪽을 보라. 반복은 \(20{,}000\) 회로 한다.
풀이
import numpy as np
from scipy import stats

# === W+ 의 정확 귀무분포와 양측 0.05 임계값 ===
def null_pmf(n):
    c = np.ones(1)
    for k in range(1, n + 1):
        new = np.zeros(len(c) + k)
        new[:len(c)] += c
        new[k:] += c
        c = new
    return c / c.sum()

def crit(n, alpha=0.05):
    cdf = np.cumsum(null_pmf(n))
    return int(np.max(np.where(2 * cdf <= alpha)[0]))

# === 두 검정의 기각률 (벡터화) ===
def rates(D, c, tcrit):
    n = D.shape[1]
    R = stats.rankdata(np.abs(D), axis=1)
    W = (R * (D > 0)).sum(1)
    M = n * (n + 1) / 2
    wil = ((W <= c) | (W >= M - c)).mean()
    t = (np.abs(D.mean(1) / (D.std(1, ddof=1) / np.sqrt(n))) > tcrit).mean()
    return wil, t

B = 20000
for name, delta in [("정규", 0.4), ("t(2)", 0.6)]:
    for n in (40, 42):
        rng = np.random.default_rng(7)
        for d in (0.0, delta):
            D = (rng.standard_normal((B, n)) if name == "정규"
                 else rng.standard_t(2, (B, n))) + d
            w, t = rates(D, crit(n), stats.t.ppf(0.975, n - 1))
            print(f"{name} delta={d:.1f} n={n}  Wilcoxon {w:.4f}  t {t:.4f}")
출력:
정규 delta=0.0 n=40  Wilcoxon 0.0508  t 0.0510
정규 delta=0.4 n=40  Wilcoxon 0.6725  t 0.6905
정규 delta=0.0 n=42  Wilcoxon 0.0503  t 0.0502
정규 delta=0.4 n=42  Wilcoxon 0.6902  t 0.7128
t(2) delta=0.0 n=40  Wilcoxon 0.0503  t 0.0382
t(2) delta=0.6 n=40  Wilcoxon 0.7232  t 0.4511
t(2) delta=0.0 n=42  Wilcoxon 0.0522  t 0.0399
t(2) delta=0.6 n=42  Wilcoxon 0.7419  t 0.4633
먼저 크기를 보면 정규 차이에서 두 검정이 모두 \(0.050\) 근처다. 윌콕슨 임계값을 정확 귀무분포에서 잡았으므로 명목수준보다 살짝 낮다(\(n = 40\) 에서 \(2P(W^+ \le 264) = 0.0498\)).
정규, \(\delta = 0.4\) 에서 이렇게 된다.
| 검정 | \(n\) | 검정력 |
|---|---|---|
| 대응 \(t\) | 40 | \(0.6905\) |
| 대응 윌콕슨 | 40 | \(0.6725\) |
| 대응 윌콕슨 | 42 | \(0.6902\) |
같은 \(n = 40\) 에서 윌콕슨은 \(0.0180\) 만큼 뒤진다. 그런데 \(n\) 을 \(40\) 에서 \(42\) 로 두 개만 늘리면 \(0.6902\) 가 되어 \(t\) 검정의 \(0.6905\) 와 사실상 같다(차이 \(0.0003\), 모의 표준오차 약 \(0.0033\) 의 \(1/10\) 수준). ARE \(3/\pi\) 가 말하는 "\(4.7\%\) 더"가 바로 이것이다. 정규성이라는 가정을 버리는 값은 관측값 두 개였다.
자유도 \(2\) 인 \(t\) 분포(평균은 있고 분산은 무한)로 바꾸면 트레이드오프의 방향이 뒤집힌다.
| 검정 | \(n = 40\) 크기 | \(n = 40\) 검정력 (\(\delta = 0.6\)) |
|---|---|---|
| 대응 \(t\) | \(0.0382\) | \(0.4511\) |
| 대응 윌콕슨 | \(0.0503\) | \(0.7232\) |
윌콕슨의 검정력이 \(t\) 검정의 \(1.6\) 배다. 이상치 하나가 \(\bar D\) 를 끌고 가는 동시에 \(s\) 를 더 크게 부풀려 \(t\) 통계량의 분모를 키우기 때문이다. \(t\) 검정은 크기마저 \(0.038\) 로 내려가 있다 — 꼬리가 두꺼우면 \(t\) 통계량의 분포가 \(t_{n-1}\) 보다 더 뭉쳐 보수적이 되고, 그 보수성이 곧 검정력 손실이다.
요약: 정규일 때 비모수가 내는 비용은 표본 \(4.7\%\) 로 상수에 가깝고 유한하다. 반면 꼬리가 두꺼울 때 모수검정이 내는 비용은 상한이 없다. 어느 쪽이 모르는 상황에서 더 나은 기본값인지는 이 비대칭이 답한다.
연습문제 8. 풀이 3 과 4 는 윌콕슨 검정이 재는 것이 중앙값이 아니라 월시 평균의 중앙값이라고 했다. 그 까닭을 다음 항등식에서 끌어내라. 동점이 없다고 하자.
(a) \(W^+ = \#\{(i, j) : i \le j, \ D_i + D_j > 0\}\) 를 증명하라.
(b) (a) 에서 \(p_1 = P(D > 0)\), \(p_2 = P(D_1 + D_2 > 0)\) 이라 할 때
임을 보이고, 귀무평균 \(n(n+1)/4\) 가 되려면 \(p_1 = 1/2\) 와 \(p_2 = 1/2\) 가 둘 다 필요함을 확인하라.
(c) \(U \sim \mathrm{Unif}(0,1)\) 로 \(D\) 를 "확률 \(1/2\) 로 \(-U\), 확률 \(1/2\) 로 \(5U\)" 라 정의하면 \(D\) 의 중앙값은 정확히 \(0\) 이다. \(p_1\) 과 \(p_2\) 를 계산하고 \(n = 20\) 에서 \(E[W^+]\) 를 구하라. 중앙값이 \(0\) 이라는 참인 귀무가설(null hypothesis)을 윌콕슨이 체계적으로 기각하게 되는 까닭과, 그 쏠림이 \(n\) 과 함께 어떻게 커지는지 밝혀라. 부호검정은 왜 괜찮은가?
풀이
(a) 동점이 없으면 \(\lvert D_i \rvert \ne \lvert D_j \rvert\) 이므로 \(D_i + D_j\) 의 부호는 절댓값이 큰 쪽의 부호와 같다(\(i = j\) 이면 \(D_i\) 자신의 부호). 그러므로 \(D_i + D_j > 0\) 인 쌍 \((i,j)\), \(i \le j\) 를 "절댓값이 큰 쪽의 첨자 \(k\)" 로 묶어 세면, 그 \(k\) 는 반드시 \(D_k > 0\) 을 만족하고 짝 \(j\) 는 \(\lvert D_j \rvert \le \lvert D_k \rvert\) 인 것 전부(\(j = k\) 포함)다. 그 개수가 바로 순위 \(R_k\) 이므로
이다. \(\square\)
본문 보기로 검산하면 \(n = 12\) 에서 \(\binom{12}{2} + 12 = 78\) 개의 쌍 가운데 \(D_i + D_j > 0\) 인 것이 \(70\) 개이고 \(W^+ = 70\) 과 맞는다.
(b) 지시함수로 쓰면 \(W^+ = \sum_{i} \mathbf 1(D_i > 0) + \sum_{i < j} \mathbf 1(D_i + D_j > 0)\) 이다. 대각항이 \(n\) 개, 비대각항이 \(\binom n2\) 개이고 \(D_i\) 가 독립이고 같은 분포이므로 기댓값을 취하면
이다. 한편
이므로 \(p_1 = p_2 = 1/2\) 는 귀무평균을 준다. 거꾸로 \(p_1\) 과 \(p_2\) 는 서로 묶여 있지 않으므로, 둘 중 하나만 \(1/2\) 여도 평균이 어긋난다. \(0\) 에 대한 대칭성은 \(p_1 = p_2 = 1/2\) 를 둘 다 주지만, 중앙값이 \(0\) 이라는 조건은 \(p_1 = 1/2\) 만 준다. 여기가 대칭성 가정이 들어가는 정확한 자리다.
(c) \(P(D < 0) = P(D > 0) = 1/2\) 이고 \(0\) 의 양쪽에 밀도가 양수이므로 중앙값은 유일하게 \(0\) 이고 \(p_1 = 1/2\) 다. \(p_2\) 는 세 경우로 나눈다. \(D_1, D_2\) 를 독립인 두 복사본이라 하고 \(U, V \sim \mathrm{Unif}(0,1)\) 이라 하면
- 둘 다 음수 (확률 \(1/4\)): 합이 음수. 기여 \(0\).
- 둘 다 양수 (확률 \(1/4\)): 합이 양수. 기여 \(1/4\).
- 하나는 음수 하나는 양수 (확률 \(1/2\)): \(P(5U - V > 0) = P(V < 5U) = \int_0^1 \min(5u, 1)\,du = \int_0^{0.2} 5u\,du + \int_{0.2}^{1} 1\,du = 0.1 + 0.8 = 0.9\).
따라서 \(n = 20\) 에서
인데 귀무평균은 \(20 \cdot 21/4 = 105\) 이고 귀무표준편차는 \(\sqrt{20 \cdot 21 \cdot 41/24} = \sqrt{717.5} = 26.79\) 다. 평균이 이미 \(1.42\) 표준편차만큼 오른쪽으로 밀려 있다.
쏠림의 증가 속도가 결정적이다.
이므로 표준화된 쏠림이 \(O(\sqrt n)\) 로 자란다. 중앙값이 정확히 \(0\) 인데도 윌콕슨의 기각확률이 \(1\) 로 간다. 이것은 검정력이 아니라 크기의 붕괴다. 윌콕슨이 실제로 검정하는 모수는 월시 평균의 중앙값
(호지스–레만 모수)이고, 이 분포에서는 \(p_2 = 0.7 > 1/2\) 이므로 \(\theta > 0\) 이다. 검정은 틀린 답을 내는 것이 아니라 우리가 묻지 않은 질문에 맞는 답을 내고 있다.
부호검정의 통계량은 \(n_+ \sim \mathrm{Bin}(n, p_1)\) 이고 중앙값이 \(0\) 이면 \(p_1 = 1/2\) 이므로, 왜도(skewness)가 아무리 심해도 크기가 정확히 유지된다. 그것이 "대칭성을 포기하는 대가"로 사는 것이다. 풀이 3 의 반응자 혼합이 바로 이 현상이 실무에서 나타나는 모습이다.
연습문제 9. 풀이 2 는 \(n = 12\) 에서 정규근사가 정확 \(p\) 값 \(0.0122\) 를 \(0.0149\) 로 \(22\%\) 과대평가하는 것을 보았다. 이것이 우연인지 체계적인지 \(n = 10\) 에서 끝까지 따져라.
\(W^+\) 의 정확 귀무분포를 열거하고, 달성 가능한 모든 꼬리값에 대해 (i) 정확 양측 \(p\), (ii) 연속성 수정 없는 정규근사, (iii) 연속성 수정 있는 정규근사를 비교하라. 그리고 왜 그 방향으로 틀리는지를 귀무분포의 첨도(kurtosis)로 설명하라. 힌트: \(W^+ = \sum_k k B_k\) 이고 \(B_k\) 는 독립인 베르누이 \(1/2\) 다.
풀이
import numpy as np
from scipy import stats

n = 10
c = np.ones(1)
for k in range(1, n + 1):
    new = np.zeros(len(c) + k)
    new[:len(c)] += c
    new[k:] += c
    c = new
pmf = c / c.sum()
w = np.arange(len(pmf))
mu, var = n * (n + 1) / 4, n * (n + 1) * (2 * n + 1) / 24
sd = np.sqrt(var)

k2 = (np.arange(1, n + 1) ** 2).sum()
k4 = (np.arange(1, n + 1) ** 4).sum()
print(f"평균 {pmf @ w:.4f}  분산 {pmf @ (w - mu) ** 2:.4f}")
print(f"첨도 {(pmf @ (w - mu) ** 4) / var ** 2:.4f}  공식 {3 - 2 * k4 / k2 ** 2:.4f}")
print("  W+     정확      근사     근사+cc    근사/정확")
for v in range(46, 56):
    ex = 2 * pmf[w >= v].sum()
    ap = 2 * stats.norm.sf((v - mu) / sd)
    cc = 2 * stats.norm.sf((v - mu - 0.5) / sd)
    print(f"{v:4d}  {ex:.6f}  {ap:.6f}  {cc:.6f}  {ap / ex:8.3f}")
출력:
평균 27.5000  분산 96.2500
첨도 2.6582  공식 2.6582
  W+     정확      근사     근사+cc    근사/정확
  46  0.064453  0.059336  0.066546     0.921
  47  0.048828  0.046853  0.052787     0.960
  48  0.037109  0.036658  0.041491     0.988
  49  0.027344  0.028417  0.032313     1.039
  50  0.019531  0.021824  0.024932     1.117
  51  0.013672  0.016605  0.019059     1.215
  52  0.009766  0.012515  0.014433     1.282
  53  0.005859  0.009344  0.010827     1.595
  54  0.003906  0.006910  0.008045     1.769
  55  0.001953  0.005062  0.005922     2.592
열거한 평균 \(27.5\) 와 분산 \(96.25\) 가 \(n(n+1)/4\), \(n(n+1)(2n+1)/24\) 와 일치한다.
오차의 방향이 꼬리 깊이에 따라 뒤집힌다. 마지막 열을 보면 \(W^+ = 48\) 쯤에서 비가 \(1\) 을 지나간다.
- \(W^+ \le 48\) (정확 \(p \ge 0.037\)): 수정 없는 근사가 \(p\) 를 작게 본다(\(46\) 에서 \(0.0593\) 대 \(0.0645\)). 계단 폭 \(1\) 의 절반을 빼먹은 탓이고, 연속성 수정이 이것을 거의 완벽히 고친다(\(0.0665\) 대 \(0.0645\)).
- \(W^+ \ge 50\): 두 근사가 모두 \(p\) 를 크게 본다. 극단 \(W^+ = 55\) 에서 정확값 \(0.00195\) 를 수정 없는 근사는 \(0.00506\)(\(2.6\) 배), 연속성 수정은 \(0.00592\)(\(3.0\) 배)로 본다. 여기서는 연속성 수정이 오차를 더 키운다.
까닭은 귀무분포의 첨도다. \(W^+ = \sum_{k=1}^{n} k B_k\) 에서 \(B_k\) 가 독립이고 \(kB_k\) 의 4차 누적률(cumulant) \(\kappa_4\) 가 \(-2 \cdot k^4/16\) 이므로(4차 누적률은 독립인 합에서 그대로 더해지고, 분산의 제곱으로 나누면 초과첨도가 된다)
이다. \(n = 10\) 이면 \(\sum k^2 = 385\), \(\sum k^4 = 25333\) 이므로 초과첨도 \(= -2(25333)/385^2 = -0.3418\), 첨도 \(2.6582\) 로 출력의 열거값과 소수 넷째 자리까지 일치한다. 큰 \(n\) 에서는 \(\sum k^4 \sim n^5/5\), \((\sum k^2)^2 \sim n^6/9\) 이므로 초과첨도 \(\approx -3.6/n\) 로 느리게 사라진다.
첨도가 \(3\) 보다 작다는 것은 귀무분포의 꼬리가 정규보다 얇다는 뜻이고, 실제로 \(W^+\) 는 \([0, 55]\) 에 갇혀 있어 \(W^+ = 55\) 를 넘는 일이 아예 없다. 정규곡선은 거기서도 꼬리를 계속 내밀므로 깊은 꼬리의 \(p\) 값을 과대평가한다. 풀이 2 의 \(n = 12\) 사례(\(0.0122 \to 0.0149\))는 우연이 아니라 이 구조의 한 점이다.
교훈 두 개. 첫째, 연속성 수정은 \(\alpha\) 근처에서는 분명히 도움이 되지만 "\(p < 0.001\)" 처럼 깊은 꼬리를 보고할 때는 믿을 것이 아니다. 둘째, \(n \le 25\) 에서는 위 다섯 줄짜리 점화식으로 정확 분포를 즉시 얻을 수 있으니 근사를 쓸 이유가 없다.
연습문제 10. §2 의 2단계는 \(D_i = 0\) 인 쌍을 버린다. 이것은 공짜가 아니다. 다른 관례도 있다. 절대차이 \(0\) 에도 순위를 주고 그 순위합을 양쪽에 반씩 나누는 zsplit, 순위는 주지만 통계량에서는 빼는 Pratt 이다.
리커트 척도 차이 자료
에 대해 (a) 세 관례의 \(W^+\) 와 양측 \(p\) 값을 손으로 계산하라. 중간순위와 동점 분산 보정을 명시하라. (b) zsplit 과 Pratt 의 \(Z\) 통계량 분자가 항등적으로 같고 분모만 다른 까닭을 밝혀라. (c) 대칭인 참 귀무가설 아래에서 세 관례의 1종오류를 모의로 재고 왜 그렇게 갈리는지 설명하라. (d) 이 자료에 정확검정을 쓸 수 없는 까닭을 한 줄로 적어라.
풀이
(a) 연습문제 6 에서 얻은 \(\operatorname{Var}(W^+) = \frac14\sum_i R_i^2\) 를 쓰면 세 관례를 한 틀에서 다룰 수 있다.
wilcox (버리기). \(0\) 인 여섯 쌍을 버려 \(n = 10\) 이다. 절대차이는 \(1\) 이 다섯, \(2\) 가 셋, \(3\) 이 둘이므로 중간순위는 각각 \(3\), \(7\), \(9.5\) 다. 양수는 \(1\) 이 넷, \(2\) 가 둘, \(3\) 이 하나이므로
검산 \(35.5 + 19.5 = 55 = 10 \cdot 11/2\). \(\checkmark\) \(\mu = 27.5\) 이고 동점 집단이 \(t = 5, 3, 2\) 이므로
zsplit. \(n = 16\) 전부에 순위를 준다. \(0\) 이 여섯 개로 자리 \(1\)–\(6\) 을 차지해 중간순위 \(3.5\)(합 \(21\)), \(1\) 이 다섯 개로 자리 \(7\)–\(11\) 에서 중간순위 \(9\), \(2\) 가 셋으로 \(13\), \(3\) 이 둘로 \(15.5\) 다. \(0\) 의 순위합 \(21\) 을 반씩 나누면
\(\mu = 16 \cdot 17/4 = 68\), 동점 집단 \(t = 6, 5, 3, 2\) 이므로
Pratt. 순위는 zsplit 과 같이 매기지만 \(0\) 인 쌍은 통계량에서 뺀다. \(W^+ = 77.5\) 이고 귀무평균은 \(0\) 이 아닌 쌍의 순위합의 절반, 곧 \((136 - 21)/2 = 57.5\) 다. 분산은 \(0\) 이 아닌 순위만 모아
(b) zsplit 에서 \(0\) 의 순위합을 \(Z\), \(0\) 이 아닌 순위합을 \(S\), 양수의 순위합을 \(P\) 라 하면
이고 Pratt 에서는 \(W^+ - \mu = P - S/2\) 다. 분자가 글자 그대로 같다(여기서 둘 다 \(77.5 - 57.5 = 88 - 68 = 20\)). 차이는 분산뿐이고 그 차이는 정확히 \(0\) 인 순위들이 보태는 양
이다. 따라서 Pratt 은 zsplit 보다 항상 \(\lvert z \rvert\) 가 크다 — zsplit 은 \(0\) 인 쌍을 통계량에는 기여시키지 않으면서 귀무분산만 키우므로 구조적으로 보수적이다.
(c) \(D\) 가 \(\{-2,-1,0,1,2\}\) 에서 확률 \((0.15, 0.2, 0.3, 0.2, 0.15)\) 를 갖는 대칭 분포, 곧 참인 귀무가설 아래에서 재 본다.
import numpy as np
from scipy import stats

# === 리커트 차이 자료: 0 이 여섯 개, 동점 덩어리가 넷 ===
D = np.array([0, 0, 0, 0, 0, 0, 1, 1, 1, 1, 2, 2, 3, -1, -2, -3])
for zm in ("wilcox", "zsplit", "pratt"):
    r = stats.wilcoxon(D, zero_method=zm, correction=False,
                       method="approx", alternative="two-sided")
    print(f"{zm:7s} T={r.statistic:6.1f}  p={r.pvalue:.6f}")

# === 대칭 귀무가설 아래 1종오류: D in {-2,-1,0,1,2}, P(0)=0.3 ===
rng = np.random.default_rng(1)
B, n = 20000, 20
vals = np.array([-2, -1, 0, 1, 2])
pr = np.array([0.15, 0.2, 0.3, 0.2, 0.15])
Ds = rng.choice(vals, size=(B, n), p=pr)
for zm in ("wilcox", "zsplit", "pratt"):
    p = stats.wilcoxon(Ds, zero_method=zm, correction=True, method="approx",
                       alternative="two-sided", axis=1).pvalue
    print(f"{zm:7s} 기각률 {(p < 0.05).mean():.4f}")
출력:
wilcox  T=  19.5  p=0.407102
zsplit  T=  48.0  p=0.296160
pratt   T=  37.5  p=0.283756
wilcox  기각률 0.0420
zsplit  기각률 0.0397
pratt   기각률 0.0462
(a) 의 손계산 \(0.4071\), \(0.2962\), \(0.2838\) 이 SciPy 와 소수 넷째 자리까지 맞는다. SciPy 가 찍는 \(T\) 는 \(\min(W^+, W^-)\) 이므로 \(19.5 = 55 - 35.5\), \(48 = 136 - 88\), \(37.5 = 115 - 77.5\) 다.
| 관례 | 1종오류 (\(\alpha = 0.05\)) |
|---|---|
| wilcox (버리기) | \(0.0420\) |
| zsplit | \(0.0397\) |
| Pratt | \(0.0462\) |
셋 다 명목수준보다 낮다. \(D\) 가 다섯 값만 취해 \(p\) 값이 몇 개 값만 가질 수 있고(이산성), 거기에 연속성 수정이 한 번 더 보수적으로 밀기 때문이다. 순서는 (b) 가 예측한 그대로 Pratt \(>\) zsplit 이고, 그 간격 \(0.0065\) 는 모의 표준오차 \(0.0015\) 의 네 배가 넘어 우연이 아니다. wilcox 는 그 사이인데, \(0\) 을 버려 \(n\) 이 \(20\) 에서 평균 \(14\) 로 줄면 귀무분포가 더 거칠어져 이산성 손실이 커지는 쪽과, 남은 순위가 작아져 분산이 줄어드는 쪽이 서로 상쇄한 결과다.
세 관례가 같은 자료에서 \(p = 0.284\) 부터 \(0.407\) 까지 흔들리는 것을 기억하라. \(0\) 이 많은 자료(\(\alpha\) 경계 근처라면 더욱)에서는 어느 관례를 썼는지 반드시 적어야 하고, 코드에서도 zero_method 를 생략하지 말아야 한다.
(d) 절대차이에 동점이 있으면 "모든 부호 배정이 같은 확률" 이라는 귀무분포를 중간순위 위에서 다시 세워야 하므로 표에 실린 정확 임계값이 성립하지 않는다. 이 자료처럼 동점이 많으면 정확검정 대신 관측된 \(\lvert D_i \rvert\) 를 고정한 부호 순열검정(\(2^{10}\) 전수 열거)을 써야 한다.
연습문제 11. 교수법 보기 자료에서 네 가지 검정(대응 \(t\), 윌콕슨 정확·근사, 부호검정)의 \(p\) 값을 모두 계산하고, 왜 부호검정이 윌콕슨과 같은 값을 내는지 설명하라.
풀이
import numpy as np
from scipy import stats
before = np.array([70, 68, 75, 80, 72, 74, 69, 77, 73, 76])
after  = np.array([72, 69, 78, 85, 75, 76, 70, 79, 74, 80])
d = after - before

print(stats.ttest_rel(after, before).pvalue)                    # 0.000325
print(stats.wilcoxon(d, method='exact').pvalue)                 # 0.001953
print(stats.wilcoxon(d, method='approx', correction=False).pvalue)  # 0.004809
print(stats.binomtest(10, 10).pvalue)                           # 0.001953
출력:
0.0003248947130212966
0.001953125
0.004808563078561356
0.001953125
| 검정 | 양측 \(p\) 값 |
|---|---|
| 대응 \(t\) | \(0.000325\) |
| 윌콕슨 (정확) | \(0.001953\) |
| 부호검정 (정확) | \(0.001953\) |
| 윌콕슨 (정규근사) | \(0.004809\) |
부호검정과 윌콕슨 정확검정이 같은 값을 낸다. 이유는 자료가 극단적으로 한쪽에 쏠려 있기 때문이다.
두 검정 모두 \(2^{10} = 1024\)가지 부호 배정을 귀무분포로 쓴다. 관측된 배정은 "모두 \(+\)"인 단 하나이다. 윌콕슨에서 \(W^+ = 55\)는 도달 가능한 최댓값이고, 이를 달성하는 배정은 하나뿐이다. 부호검정에서 \(n_+ = 10\)을 달성하는 배정도 하나뿐이다. 따라서 두 정확 \(p\) 값이 모두 \(2/1024\)가 된다.
일반적으로는 두 검정이 갈라진다. 음의 차이가 하나라도 있으면 그 차이의 크기가 윌콕슨에는 영향을 주지만 부호검정에는 주지 않는다.
윌콕슨 정규근사가 \(0.004809\)로 정확값의 2.5배임에 유의하라. 관측값이 분포의 끝점에 놓여 있어 정규근사가 가장 나쁘게 작동하는 위치이다. 꼬리 확률을 근사할 때 정규근사가 체계적으로 부정확한 이유이다.
연습문제 12. \(n = 10\)일 때 윌콕슨 부호순위검정의 양측 임계값이 왜 \(8\)인지 정확 귀무분포를 열거하여 확인하라. 이 임계값의 실제 유의수준은 얼마인가?
풀이
import numpy as np, itertools
n = 10
ranks = np.arange(1, n + 1)
W = np.array([np.dot(s, ranks) for s in itertools.product([0, 1], repeat=n)])
T = np.minimum(W, n * (n + 1) // 2 - W)      # min(W+, W-)
for c in range(6, 12):
    print(c, (T <= c).mean())
출력:
6 0.02734375
7 0.037109375
8 0.048828125
9 0.064453125
10 0.083984375
11 0.10546875
| 임계값 \(c\) | \(P(T \le c)\) |
|---|---|
| 6 | 0.0273 |
| 7 | 0.0371 |
| 8 | 0.0488 |
| 9 | 0.0645 |
| 10 | 0.0840 |
| 11 | 0.1055 |
\(c = 8\)이 \(0.05\)를 넘지 않는 가장 큰 값이다(\(0.0488 \le 0.05 < 0.0645\)). 그래서 표에 \(8\)이 실려 있다.
실제 유의수준은 \(0.0488\)로 명목값 \(0.05\)에 매우 가깝다. \(n = 10\)에서 부호검정의 실제 크기가 \(0.0215\)였던 것과 비교하면 훨씬 낫다. 윌콕슨의 귀무분포는 \(T = \min(W^+, W^-)\)가 가질 수 있는 값이 \(28\)가지(\(0\)부터 \(27\)까지)라 \(\alpha\)를 촘촘히 채울 수 있는 반면, 부호검정은 \(6\)가지밖에 없다.
이것이 윌콕슨 검정이 부호검정보다 강력한 두 번째 이유이다. ARE가 \(0.955\) 대 \(0.637\)인 것뿐 아니라, 소표본에서 유의수준을 훨씬 효율적으로 쓴다.
연습문제 13. 교수법 보기에서 모든 차이가 양수인 것은 우연이 아닐 수 있다. 이 자료가 실제로 정규 차이에서 나왔다면 \(n = 10\)에서 모두 같은 부호일 확률은 얼마인가? 관측된 차이의 분포는 무엇을 시사하는가?
풀이
차이는 \(d = [2, 1, 3, 5, 3, 2, 1, 2, 1, 4]\)로 평균 \(2.4\), 표준편차 \(1.35\)이다.
참인 차이 분포가 \(\mathcal{N}(2.4, 1.35^2)\)이라면 한 관측값이 음수일 확률은
이고, 10개가 모두 양수일 확률은 \((1 - 0.0377)^{10} = 0.681\)이다. 전혀 놀랍지 않다.
import numpy as np
from scipy import stats
d = np.array([2, 1, 3, 5, 3, 2, 1, 2, 1, 4])
print(d.mean(), d.std(ddof=1))                          # 2.4, 1.3499
p_neg = stats.norm.cdf(0, d.mean(), d.std(ddof=1))
print(p_neg, (1 - p_neg) ** 10)                         # 0.0377, 0.681
출력:
2.4 1.3498971154211057
0.037709049885978514 0.680869711192701
그러나 자료 자체를 보면 다른 문제가 보인다. 차이의 값이 \(\{1, 2, 3, 4, 5\}\) 다섯 가지뿐이고 모두 정수이다. 시험 점수가 정수라 차이도 정수인 것은 자연스럽지만, 이 정도 이산성에서는 동점이 많이 생겨 순위 기반 검정의 정확 귀무분포가 엄밀하게는 성립하지 않는다.
실제로 이 자료에는 크기 3, 3, 2의 동점 집단이 있다. SciPy가 반환한 "정확" \(p\) 값 \(0.001953\)은 동점이 없다고 가정한 값이다. 다행히 모든 차이가 양수라 \(W^+\)가 최댓값이라는 사실은 동점 여부와 무관하므로 이 경우에는 문제가 되지 않는다.
일반적 교훈: 이산 척도(정수 점수, 리커트 척도)에서는 동점이 필연적이며, 순위 기반 검정의 "정확" \(p\) 값이 사실은 근사이다. 동점 비율이 높으면 순열검정으로 동점을 포함한 실제 귀무분포를 직접 계산하는 편이 정직하다.
연습문제 14. §3 의 「두 가지 표준화 방식」은 \(\min(W^+, W^-)\) 로 표준화하면 오른쪽 단측 기각률이 \(0.0000\) 이 되고, 양측에서는 두 방식이 모두 \(0.0484\) 로 "우연히" 일치했다고 말한다. 그 "우연" 을 따져 보자. \(d_i = 0\) 인 쌍이 없어 \(W^+ + W^- = n(n+1)/2\) 라고 하자.
(1) \(Z_{W^+} = (W^+ - \mu)/\sigma\), \(Z_{\min} = (\min(W^+, W^-) - \mu)/\sigma\) 라 쓸 때(\(\mu = n(n+1)/4\), \(\sigma = \sqrt{n(n+1)(2n+1)/24}\)) 어떤 자료에서나
임을 보이시오.
(2) 그러므로 양측검정의 일치는 우연이 아니라 항등식이다. 본문의 모의실험에서 두 양측 기각률이 "몬테카를로 오차 안에서 비슷한" 것이 아니라 \(0.0484\) 로 똑같은 수였던 까닭을 설명하라. 또 오른쪽 기각률이 "아주 작은 값" 이 아니라 정확히 \(0\) 인 까닭도 말하라.
(3) 그렇다면 \(\min\) 으로 왼쪽 단측검정은 할 수 있는가. "\(Z_{\min} < -1.645\) 이면 기각" 을 수준 \(0.05\) 의 왼쪽 단측검정이라 믿고 쓰면 실제로는 무슨 검정을 하는 셈이며 그 실제 크기는 얼마인가. 본문 그림에 적힌 수치를 쓰라.
풀이
(1) 두 통계량은 \(\mu\) 를 중심으로 서로의 거울상이다. \(W^+ + W^- = n(n+1)/2 = 2\mu\) 이므로
다. \(a = W^+ - \mu\) 라 두면 \(W^- - \mu = -a\) 이고
이다. 양변을 \(\sigma > 0\) 으로 나누면 \(Z_{\min} = -\lvert a \rvert/\sigma = -\lvert Z_{W^+}\rvert\) 다. \(\square\)
(2) 양측검정은 글자 그대로 같은 검정이다. (1) 에서 \(\lvert Z_{\min}\rvert = \lvert Z_{W^+}\rvert\) 가 모든 표본에서 성립하므로, 두 방식의 양측 p 값이 같고 기각 여부도 표본마다 하나하나 같다. 모의실험의 두 기각률은 같은 사건을 두 번 센 것이어서 \(60{,}000\) 개 가운데 기각된 개수가 똑같고, 따라서 소수점까지 같은 \(0.0484\) 가 나온다. 두 수가 조금이라도 달랐다면 그것은 모의오차가 아니라 코드의 버그다.
오른쪽 기각률도 같은 이유로 "작은 값" 이 아니다. \(Z_{\min} = -\lvert \cdot \rvert \leq 0\) 이 항등적으로 성립하므로
이 정확히 참이다. 표본을 얼마나 많이 뽑아도 \(0.0000\) 이지 \(0.0003\) 이 될 수 없다.
(3) 할 수 없다. 그것은 수준 \(0.109\) 의 양측검정이다. (1) 을 넣으면
이다. 곧 \(W^+\) 의 양측검정을 임계값 \(1.645\) 로 수행하는 것과 같다. 본문 그림에서 \(W^+\) 쪽의 오른쪽 꼬리 \(Z > 1.645\) 가 \(0.0545\) 였고 분포가 좌우대칭이므로 실제 크기는 약
다. 수준 \(0.05\) 라고 믿으면서 \(0.109\) 짜리 검정을 돌리는 셈이고, 더 나쁜 것은 차이가 크게 양수일 때에도 "중앙값이 0 보다 작다" 는 결론으로 기각한다는 점이다.
정리하면 \(\min\) 은 양측에서는 \(W^+\) 와 완전히 같고, 단측에서는 한쪽은 영원히 기각하지 못하고 다른 쪽은 크기가 두 배가 되면서 방향을 잘못 읽는다. 본문의 권고 — \(W^+\) 를 일관되게 쓰고 부호로 방향을 읽으라 — 는 "대개 안전하다" 가 아니라 단측검정을 하려면 유일한 선택이다.
연습문제 15. 연습문제 12 의 풀이는 "\(T = \min(W^+, W^-)\) 가 가질 수 있는 값이 \(28\) 가지(\(0\) 부터 \(27\) 까지)라 \(\alpha\) 를 촘촘히 채울 수 있는 반면, 부호검정은 \(6\) 가지밖에 없다" 고 했다. 그 두 수를 세어 확인하고 대가를 계산하라.
(1) 동점이 없는 \(n = 10\) 에서 \(T\) 의 값역이 정확히 \(\{0, 1, \dots, 27\}\) 임을 보이시오. 상한이 왜 \(27.5\) 가 아니라 \(27\) 인가. 일반 \(n\) 에서 값역의 크기를 \(n\) 으로 나타내라.
(2) 부호검정에서 \(\min(n_+, n_-)\) 의 값역이 \(\{0, \dots, 5\}\) 임을 보이시오. 연습문제 12 의 표와 대응 부호검정 연습문제 11 의 표를 써서 두 검정의 "\(0.05\) 를 넘지 않는 가장 큰 도달가능 수준" 과 그때 버리는 \(\alpha\) 를 비교하라. 부호검정의 검정력 손실 가운데 ARE 와 무관한 몫이 여기 있다는 것을 설명하라.
(3) \(n\) 을 키우면 버리는 \(\alpha\) 는 두 검정에서 각각 어떤 속도로 줄어드는가. 임계점 근처의 점질량을 정규근사로 근사하여 \(n\) 의 거듭제곱으로 답하고, \(n = 10\) 의 실제 간격과 자릿수가 맞는지 확인하라.
풀이
(1) \(W^+\) 는 \(\{1, 2, \dots, 10\}\) 의 부분집합합이다. 귀납법으로 \(\{1, \dots, k\}\) 의 부분집합합이 \(0\) 부터 \(k(k+1)/2\) 까지의 모든 정수를 덮는다. \(k = 1\) 이면 \(\{0, 1\}\) 로 참이다. \(k\) 에서 참이라 하면 \(\{1, \dots, k+1\}\) 의 부분집합합은 이전 범위 \([0,\ k(k+1)/2]\) 와 거기에 \(k+1\) 을 더한 \([k+1,\ (k+1)(k+2)/2]\) 의 합집합을 포함하고, \(k(k+1)/2 \geq k\) 이므로 두 구간이 끊기지 않고 이어진다. 따라서 \(W^+\) 는 \(0, 1, \dots, 55\) 를 모두 취한다.
이제 \(T = \min(W^+,\ 55 - W^+)\) 다. \(T \leq 55/2 = 27.5\) 이고 \(T\) 는 정수이므로 \(T \leq 27\) 이다. 합 \(55\) 가 홀수라 \(W^+ = W^-\) 가 불가능하고, 가장 균형잡힌 쪼갬이 \(27\) 과 \(28\) 이다 — 그래서 상한이 \(27.5\) 가 아니라 \(27\) 이다. 거꾸로 \(t = 0, \dots, 27\) 마다 \(W^+ = t\) 가 실현되고 그때 \(55 - t \geq 28 > t\) 이므로 \(T = t\) 다. 값역은 정확히 \(\{0, \dots, 27\}\) 이고 \(28\) 가지다.
일반 \(n\) 에서는 같은 논법으로
이다. \(n = 10\) 이면 \(\lfloor 27.5 \rfloor + 1 = 28\) 로 맞는다.
(2) 부호검정은 \(n_+ \in \{0, \dots, 10\}\) 뿐이다. \(\min(n_+, 10 - n_+) \leq 5\) 이고 \(n_+ = 0, \dots, 5\) 가 각각 \(0, \dots, 5\) 를 주므로 값역은 \(\{0, \dots, 5\}\), \(6\) 가지다. \(11\) 가지 중 절반이 접혀 사라진다.
| 검정 | \(0.05\) 이하의 도달가능 수준 | 가장 큰 것 | 버리는 \(\alpha\) |
|---|---|---|---|
| 윌콕슨 (\(T \leq c\)) | \(0.0020,\ \dots,\ 0.0273,\ 0.0371,\ 0.0488\) | \(0.0488\) | \(0.0012\) |
| 부호검정 (\(\min \leq c\)) | \(0.0020,\ 0.0215\) | \(0.0215\) | \(0.0285\) |
버리는 \(\alpha\) 가 \(0.0012\) 대 \(0.0285\) 로 약 \(24\) 배 차이다. 윌콕슨은 명목 \(5\%\) 의 \(97.6\%\) 를 쓰는데 부호검정은 \(43\%\) 만 쓴다.
여기서 ARE 와 무관한 손실이 보인다. 연습문제 12 의 풀이가 지적한 대로, \(n = 10\) 에서 부호검정을 "\(\alpha = 0.05\) 로 돌린다" 고 말하는 사람은 실제로는 수준 \(0.0215\) 짜리 검정을 돌리고 있다. ARE \(0.637\) 은 \(\alpha\) 를 같게 맞춘 뒤의 비교이므로, 소표본에서 부호검정이 실제로 겪는 불리함은 \(0.637\) 보다 더 크다. 격자가 거친 검정은 쓰라고 준 \(\alpha\) 를 다 쓰지 못한다.
(3) 격자 간격은 임계점 근처 점질량의 두 배다. 도달가능 수준이 \(2P(\cdot \leq c)\) 꼴이므로 이웃한 두 수준의 차는 \(2P(\cdot = c+1)\) 이다.
- 부호검정: \(n_+\) 의 표준편차가 \(\sqrt n / 2\) 이므로 눈금 하나가 \(z\) 축에서 \(2/\sqrt n\) 이다. 따라서 \(2P(S = c) \approx 2\varphi(1.96) \cdot 2/\sqrt n = 0.234\, n^{-1/2}\).
- 윌콕슨: \(\sigma = \sqrt{n(n+1)(2n+1)/24} \approx n^{3/2}/\sqrt{12}\) 이므로 눈금 하나가 \(\sqrt{12}\, n^{-3/2}\) 이고 \(2P(T = c) \approx 2\varphi(1.96)\sqrt{12}\, n^{-3/2} = 0.405\, n^{-3/2}\).
\(n = 10\) 에서 근사값은 \(0.234/\sqrt{10} = 0.074\) 와 \(0.405 \times 10^{-3/2} = 0.0128\) 이고, 표에서 읽은 실제 간격은 \(0.1094 - 0.0215 = 0.0879\) 와 \(0.0645 - 0.0488 = 0.0157\) 로 자릿수가 맞는다.
그러므로 버리는 \(\alpha\) 는 부호검정에서 \(O(n^{-1/2})\), 윌콕슨에서 \(O(n^{-3/2})\) 로 줄어든다. 윌콕슨의 이산성은 \(n\) 이 조금만 커져도 사실상 사라지지만, 부호검정은 \(n = 100\) 에서도 간격이 \(0.023\) 쯤으로 여전히 명목수준의 절반 가까이를 흔든다. 부호검정으로 정확한 수준을 맞추려면 \(\alpha\) 를 고르는 대신 \(\alpha\) 가 골라 주는 것을 받아들여야 한다.
연습문제 16. §6 의 쪽지는 윌콕슨의 점근상대효율이 \(0.955 \approx 3/\pi\) 라고 적는다. 그 뜻은 "정규분포 아래에서 표본을 \(1/0.955 = 1.047\) 배, 곧 \(4.7\%\) 더 모으면 대응 \(t\) 검정과 같은 검정력에 이른다" 다. 두 방향의 대가를 모의실험으로 재라.
차이가 \(N(0.25, 1)\) 인 경우와 꼬리가 두꺼운 \(t_3 + 0.40\) 인 경우에 대해, 대응 \(t\) 검정과 윌콕슨 검정(§3 의 정규근사)의 양측 \(5\%\) 검정력을 \(n = 100, 105, \dots\) 에서 재라. 반복은 \(40{,}000\) 회로 한다.
(1) 정규일 때 \(n = 105\) 의 윌콕슨이 \(n = 100\) 의 \(t\) 검정과 같은 검정력인지 몬테카를로 오차 안에서 확인하라. \(4.7\%\) 라는 예측과 맞는가.
(2) \(t_3\) 에서는 대가가 어느 쪽으로 가는가. \(t\) 검정이 \(n = 100\) 의 윌콕슨을 따라잡으려면 몇 쌍이 필요한지 표에서 보간하여 구하라.
(3) 두 결과를 한 문장으로 합쳐 "무엇을 포기하고 무엇을 얻는가" 에 답하라.
풀이
import numpy as np
from scipy.stats import rankdata, t as tdist

B = 40000


def powers(n, delta, dist):
    rng = np.random.default_rng(0)
    if dist == "정규":
        d = delta + rng.standard_normal((B, n))
    else:                                     # 자유도 3 의 t, 꼬리가 두껍다
        d = delta + rng.standard_t(3, size=(B, n))
    # 대응 t 검정
    tstat = d.mean(axis=1) / (d.std(axis=1, ddof=1) / np.sqrt(n))
    pw_t = float((np.abs(tstat) > tdist.ppf(0.975, n - 1)).mean())
    # 윌콕슨 부호순위 (W+ 로 표준화한 정규근사)
    r = rankdata(np.abs(d), axis=1)
    W = (r * (d > 0)).sum(axis=1)
    Z = (W - n * (n + 1) / 4) / np.sqrt(n * (n + 1) * (2 * n + 1) / 24)
    return pw_t, float((np.abs(Z) > 1.959964).mean())


print(f"4.7% 더 모은다는 것: 100 / 0.955 = {100 / 0.955:.1f}")
print("차이분포   delta    n    t 검정   윌콕슨")
for dist, delta, ns in (("정규", 0.25, (100, 105, 110)),
                        ("t(3)", 0.40, (100, 105, 160, 170))):
    for n in ns:
        a, b = powers(n, delta, dist)
        print(f"{dist:>6} {delta:>8.2f} {n:>4} {a:>9.4f} {b:>8.4f}")
출력:
4.7% 더 모은다는 것: 100 / 0.955 = 104.7
차이분포   delta    n    t 검정   윌콕슨
    정규     0.25  100    0.6960   0.6732
    정규     0.25  105    0.7180   0.6981
    정규     0.25  110    0.7359   0.7184
  t(3)     0.40  100    0.6871   0.8727
  t(3)     0.40  105    0.7073   0.8909
  t(3)     0.40  160    0.8504   0.9774
  t(3)     0.40  170    0.8691   0.9829
(1) 예측이 맞는다. 검정력이 \(0.7\) 쯤일 때 모의오차는 \(\sqrt{0.7 \times 0.3/40000} = 0.0023\) 이다.
| 검정 | \(n\) | 검정력 |
|---|---|---|
| 대응 \(t\) | 100 | \(0.6960\) |
| 윌콕슨 | 100 | \(0.6732\) |
| 윌콕슨 | 105 | \(\mathbf{0.6981}\) |
| 윌콕슨 | 110 | \(0.7184\) |
같은 \(n = 100\) 에서는 윌콕슨이 \(0.6732\) 로 \(t\) 검정보다 \(0.023\) 만큼 뒤진다(두 검정을 같은 자료에 돌렸으니 비교가 더 정밀하고, 차이의 모의오차 상한 \(\sqrt 2 \times 0.0023 = 0.0033\) 의 일곱 배이니 실재하는 차이다). 그런데 \(n = 105\) 로 다섯 쌍을 더하면 \(0.6981\) 이 되어 \(t\) 검정의 \(0.6960\) 과 차이가 \(0.0021\), 곧 모의오차 하나보다 작다. \(100/0.955 = 104.7\) 이라는 예측과 맞는다. 정규분포 아래에서 분포가정을 버리는 값은 100 쌍에 5 쌍이다.
(2) \(t_3\) 에서는 \(t\) 검정이 \(70\) 쌍 넘게 더 필요하다. \(n = 100\) 의 윌콕슨이 \(0.8727\) 인데 \(t\) 검정은 \(n = 160\) 에서 \(0.8504\), \(n = 170\) 에서 \(0.8691\) 이다. 그 구간에서 \(10\) 쌍마다 \(0.0187\) 씩 오르므로
다. 곧 \(t\) 검정은 윌콕슨과 같은 검정력을 얻으려 \(1.7\) 배의 표본이 필요하다. 꼬리가 두꺼운 분포에서 표본평균은 큰 관측값 몇 개에 흔들리고 \(s\) 도 같이 커져 \(t\) 통계량이 커지지 못하는데, 순위는 그 관측값을 "가장 큰 하나" 로만 세기 때문이다. 2장에서 중앙값이 평균보다 로버스트했던 것과 같은 일이 검정 수준에서 반복된다.
(3) \(4.7\%\) 를 보험료로 내고 \(70\%\) 를 보험금으로 받는다. 정규가 참일 때 윌콕슨을 쓴 손해는 \(100\) 쌍에 \(5\) 쌍이지만, 꼬리가 두꺼울 때 \(t\) 를 고집한 손해는 \(100\) 쌍에 \(72\) 쌍이다. 정규성(normality)을 확신할 수 없다면 이 트레이드오프는 비모수 쪽이 압도적으로 유리하다 — 특히 본문이 지적한 대로 \(n < 20\) 에서는 정규성을 확인할 방법조차 마땅치 않다.
연습문제 17. 보기 2 의 각주는 \(W^+ = 55\) 에서 정확 p 값이 \(0.001953\) 인데 정규근사는 \(0.00481\) 로 \(2.5\) 배라고 했다. 그것이 끝점에서만 벌어지는 일인지 전체적인 일인지 확인하라.
\(n = 10\) 의 \(2^{10} = 1024\) 가지 부호 배정을 전수 열거해 \(T = \min(W^+, W^-)\) 의 정확 귀무분포를 얻고, 각 \(t\) 에서 정확 p 값 \(P(T \leq t)\), 정규근사 p 값 \(2\Phi(-(\mu - t)/\sigma)\), 연속성 수정을 넣은 p 값 \(2\Phi(-(\mu - t - 0.5)/\sigma)\) 를 비교하라.
(1) 근사가 보수적(근사 p 값이 정확값보다 큼)인 구역과 과감한 구역을 가르는 \(t\) 를 찾아라. 비율이 가장 나쁜 곳은 꼬리인가 중앙인가. \(\alpha = 0.05\) 의 판정까지 틀어지는가.
(2) 연속성 수정이 고치는 곳과 오히려 망치는 곳을 각각 지적하고, 끝점에서 왜 망치는지 설명하라. 수정을 넣으면 \(\alpha = 0.05\) 의 실제 크기는 어떻게 되는가.
(3) 각주가 쓴 \(\sigma^2 = 95.125\) 는 동점 보정을 넣은 값이다(크기 \(3, 3, 2\) 의 동점 집단에서 \(\sum (t_k^3 - t_k) = 54\), 그리고 \(96.25 - 54/48 = 95.125\)). 동점 보정을 빼먹으면 검정이 보수적이 되는가 과감해지는가. 출력의 두 p 값으로 답하고 까닭을 말하라.
풀이
import itertools
import numpy as np
from scipy.stats import norm

n = 10
ranks = np.arange(1, n + 1)
tot = n * (n + 1) // 2                                  # 55
Wp = np.array([s @ ranks for s in itertools.product([0, 1], repeat=n)])
T = np.minimum(Wp, tot - Wp)                            # min(W+, W-)

mu, sd = tot / 2, np.sqrt(n * (n + 1) * (2 * n + 1) / 24)
print(f"mu = {mu},  sigma = {sd:.4f}")
print("  t    정확 p      근사 p      수정 p    근사/정확  수정/정확")
for t in (0, 3, 5, 7, 8, 9, 11, 14, 17, 20, 23, 27):
    p_ex = float((T <= t).mean())
    p_ap = float(2 * norm.sf((mu - t) / sd))
    p_cc = float(2 * norm.sf((mu - t - 0.5) / sd))
    print(f" {t:>2} {p_ex:>9.4f} {p_ap:>11.4f} {p_cc:>11.4f}"
          f" {p_ap / p_ex:>11.3f} {p_cc / p_ex:>10.3f}")

for lab, g in (("근사", lambda x: 2 * norm.sf(x / sd)),
               ("수정", lambda x: 2 * norm.sf((x - 0.5) / sd))):
    bad = [t for t in range(28) if g(mu - t) < (T <= t).mean()]
    print(f"{lab} p < 정확 p 인 t 는 {min(bad)} 부터 {max(bad)} 까지 {len(bad)} 개")

# 보기 2 자료의 동점 보정: 3,3,2 집단 -> sum(t^3 - t) = 54
var_tie = n * (n + 1) * (2 * n + 1) / 24 - 54 / 48
print(f"\nt = 0 에서  동점 보정 전 sigma^2 = {sd**2:.4f},  p = "
      f"{float(2 * norm.sf(27.5 / sd)):.6f}")
print(f"            동점 보정 후 sigma^2 = {var_tie:.4f},  p = "
      f"{float(2 * norm.sf(27.5 / np.sqrt(var_tie))):.6f}")
print(f"            정확 p = {float((T <= 0).mean()):.6f}")
출력:
mu = 27.5,  sigma = 9.8107
  t    정확 p      근사 p      수정 p    근사/정확  수정/정확
  0    0.0020      0.0051      0.0059       2.592      3.032
  3    0.0098      0.0125      0.0144       1.282      1.478
  5    0.0195      0.0218      0.0249       1.117      1.277
  7    0.0371      0.0367      0.0415       0.988      1.118
  8    0.0488      0.0469      0.0528       0.960      1.081
  9    0.0645      0.0593      0.0665       0.921      1.032
 11    0.1055      0.0926      0.1029       0.878      0.976
 14    0.1934      0.1688      0.1851       0.873      0.958
 17    0.3223      0.2845      0.3081       0.883      0.956
 20    0.4922      0.4446      0.4755       0.903      0.966
 23    0.6953      0.6465      0.6835       0.930      0.983
 27    1.0000      0.9594      1.0000       0.959      1.000
근사 p < 정확 p 인 t 는 7 부터 27 까지 21 개
수정 p < 정확 p 인 t 는 10 부터 26 까지 17 개

t = 0 에서  동점 보정 전 sigma^2 = 96.2500,  p = 0.005062
            동점 보정 후 sigma^2 = 95.1250,  p = 0.004809
            정확 p = 0.001953
(1) 경계는 \(t = 7\) 이고, 비율이 나쁜 곳은 꼬리다. \(t \leq 6\) 에서는 근사 p 값이 정확값보다 크고(보수적), \(t \geq 7\) 에서는 작다(과감하다 — \(28\) 개 값 가운데 \(21\) 개가 그렇다).
두 방향의 불일치가 크기가 전혀 다르다는 점이 중요하다.
- 꼬리: \(t = 0\) 에서 비율 \(2.592\) — 근사가 정확값의 \(2.6\) 배다. 각주의 "\(2.5\) 배" 가 바로 이 칸이다(각주는 동점 보정을 넣어 \(0.00481\) 을, 여기서는 넣지 않아 \(0.00506\) 을 쓴다).
- 중앙: 비율이 가장 낮은 곳이 \(t = 14\) 의 \(0.873\) 으로, 근사가 정확값의 \(87\%\) 다. 불일치가 \(13\%\) 를 넘지 않는다.
곱셈으로 보면 꼬리가 압도적으로 나쁘지만 뺄셈으로 보면 중앙이 나쁘다 — \(t = 0\) 의 절대오차는 \(0.0031\) 이고 \(t = 14\) 의 절대오차는 \(0.0246\) 이다. p 값은 작은 값에서 자릿수가 중요하므로 꼬리의 상대오차가 더 문제다.
판정은 다행히 틀어지지 않는다. "근사 p 값 \(\leq 0.05\) 이면 기각" 은 \(t \leq 8\) 에서 기각하는 규칙이다(\(0.0469 \leq 0.05 < 0.0593\)). 그 기각역(rejection region)의 실제 크기는 정확열의 \(0.0488\) 이므로 \(0.05\) 를 넘지 않는다. p 값이 \(4\%\) 과감했어도 격자 간격(\(0.0488 \to 0.0645\))이 그보다 거칠어 결정이 같은 칸에 남은 것이다. 격자가 근사오차를 삼켜 준 운 좋은 경우다.
(2) 수정은 중앙을 고치고 끝점을 망친다.
| 구역 | 근사/정확 | 수정/정확 |
|---|---|---|
| 끝점 \(t = 0\) | \(2.592\) | \(3.032\) |
| \(t = 5\) | \(1.117\) | \(1.277\) |
| \(t = 11 \sim 23\) | \(0.878 \sim 0.930\) | \(0.976 \sim 0.983\) |
중앙에서는 불일치가 \(12\%\) 에서 \(2\%\) 로 줄어든다. 수정이 하는 일이 바로 이것이다: \(T\) 가 정수 격자 위에 있으므로 \(P(T \leq t)\) 를 연속분포로 바꿀 때 \(t\) 에서 자르지 말고 \(t + 0.5\) 까지 세어야 하고, 이는 \(\mu - t\) 를 \(0.5\) 줄이는 것과 같다.
끝점에서는 반대로 나빠진다(\(2.592 \to 3.032\)). 까닭은 끝점에는 "반 칸 너머" 가 없다는 데 있다. \(t = 0\) 은 지지집합의 벽이고, \(T = 0\) 의 점질량은 정규밀도가 아니라 \(2/1024\) 라는 조합적 사실로 정해진다. 꼬리에서 근사가 틀리는 진짜 원인은 격자가 아니라 정규밀도가 이 이산분포의 끝을 너무 두껍게 본다는 것이고, 수정은 p 값을 더 키우는 방향이므로 틀린 곳을 더 틀리게 만든다.
수정을 넣으면 \(\alpha = 0.05\) 의 기각역은 \(t \leq 7\) 로 한 칸 좁아진다(\(0.0415 \leq 0.05 < 0.0528\)). 실제 크기가 \(0.0488\) 에서 \(0.0371\) 로 떨어져 연습문제 15 에서 본 "버리는 \(\alpha\)" 가 \(0.0012\) 에서 \(0.0129\) 로 열 배 늘어난다. p 값은 정확해지고 수준 활용은 나빠지는 트레이드오프다.
(3) 동점 보정을 빼먹으면 보수적이 된다. 출력의 마지막 세 줄에서
로, 보정을 넣은 쪽의 p 값이 더 작다. 보정은 \(\sigma^2\) 를 \(54/48 = 1.125\) 만큼 줄이고, 분모가 작아지면 \(\lvert Z \rvert\) 가 커지고(\(2.8031 \to 2.8196\)) p 값이 작아진다. 그러므로 보정을 빼먹은 검정은 p 값을 부풀리고 기각을 덜 하는 보수적 검정이다 — 1종 오류는 커지지 않지만 검정력을 잃는다.
까닭은 분산의 뜻에 있다. 동점이 생기면 같은 중간순위를 나눠 가진 관측값들이 부호에 따라 서로 다른 순위를 주지 못하므로 \(W^+\) 가 흔들릴 폭이 실제로 줄어든다. 보정 없는 \(n(n+1)(2n+1)/24\) 는 있지도 않은 변동을 더 넣은 값이고, 그만큼 통계량을 과소평가하게 된다.
세 수를 나란히 두면 이 쪽의 교훈이 한 줄로 모인다: 정확 \(0.001953\), 동점 보정 근사 \(0.004809\), 보정 없는 근사 \(0.005062\). 동점 보정은 바른 방향으로 \(0.00025\) 를 움직이지만, 정규근사 자체가 끝점에서 만드는 \(0.003\) 짜리 오차 앞에서는 잔돈이다. \(n\) 이 작고 관측값이 꼬리에 있으면 보정이든 수정이든 손보기보다 전수 열거로 정확분포를 쓰는 것이 답이다.
정리하며¶
대응자료에 대한 윌콕슨 부호순위검정은 절대 대응차이에 순위를 매기고 각 부호에 그 순위만큼 가중치를 준다. 대칭성 가정이 성립하면 대응 부호검정보다 강력한 검정이 된다. 절차는 차이 \(D_i = X_i - Y_i\)에 일표본 윌콕슨 부호순위검정을 적용한 것과 동일하다. 소표본에서는 정확 임계값을 쓸 수 있고, 표본이 크면 동점 보정을 적용한 정규근사가 신뢰할 만한 \(p\) 값을 준다.
다음 쪽 대응 순열검정으로 넘어가며 16.3절을 마무리한다. 앞의 둘이 차이에서 무엇을 쓸지를 미리 골랐다면(부호만, 부호와 순위), 순열검정은 고르지 않고 차이의 값을 그대로 쓰면서 귀무분포를 부호 뒤집기로 만든다.