가족단위 오류율
1. 다중검정이 거짓 양성을 부풀리는 이유
들어가는 이야기 — 검정 하나하나는 약속을 지켰는데
검정을 여러 번 하면 무슨 일이 생기는지는 아주 작은 수에서도 보인다. 어떤 회사가 신약을 혈압·콜레스테롤·체중 세 평가변수로 재고, 「어느 한 변수라도 \(\alpha = 0.05\) 에서 유의하면 성공」이라고 선언한다. 약에 아무 효과가 없어도 이 선언이 성공을 집어 올릴 확률은 \(0.05\) 가 아니라 \(0.143\) 이다. 검정 하나하나는 약속한 \(5\%\) 를 정확히 지켰는데 연구 전체는 그 세 배를 쓴 셈이고, 평가변수를 스물로 늘리면 같은 확률이 \(0.642\) 까지 오른다. 규제기관이 이런 선언에 보정을 요구하는 까닭이 여기 있다. 세어야 하는 것은 가설 하나하나가 아니라 잘못 기각할 기회의 수다.
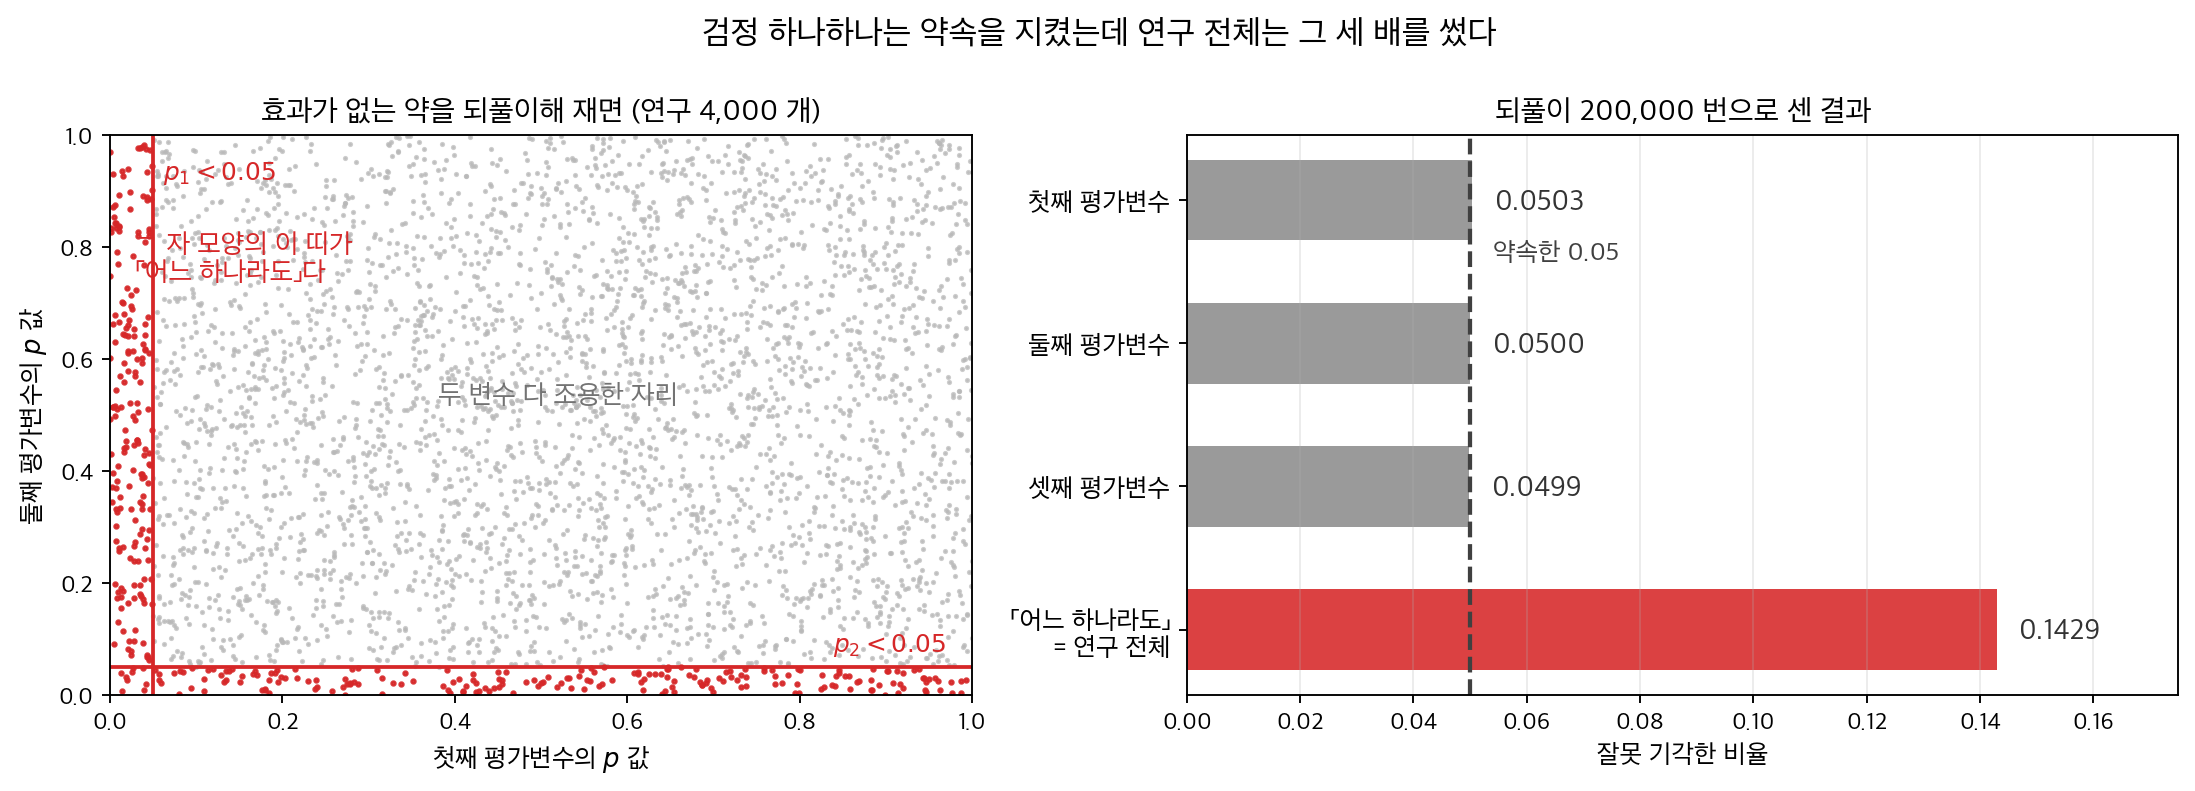
왼쪽. 점 하나가 연구 하나다. 두 축 각각에서 붉은 점은 전체의 \(5\%\) 씩인데, 둘을 합친 ㄱ 자 모양의 띠는 그보다 넓다 — 「어느 하나라도」가 세는 자리가 그 띠다. 오른쪽. 반복 \(20\) 만 번으로 세면 평가변수별 기각률이 \(0.0503 \cdot 0.0500 \cdot 0.0499\) 로 저마다 약속을 지키는데, 「어느 하나라도 유의하면 성공」이라는 선언의 성공률은 \(0.1429\) 다. 검정 하나하나를 아무리 잘 지켜도 묶는 순간 달라진다. 세 변수를 서로 무관하다고 보고 뽑은 것이고, 상관이 있으면 그보다 낮아진다.
그러면 「연구 전체의 오류율」이란 정확히 무엇이며, 검정 수와 함께 어떻게 자라는가. 집단 열 개를 둘씩 견주기만 해도 검정이 \(45\) 번이다. 이 쪽이 그 양을 정의하고 자라는 꼴을 그린다. 그 수가 수만 번이 되는 분야에서 보정을 빠뜨리면 무엇이 켜지는지는 아래 상자가 죽은 생선 한 마리로 보인다.
연구자가 유의수준 \(\alpha = 0.05\)에서 가설검정을 한 번만 하면 참인 귀무가설(null hypothesis)을 잘못 기각할 확률이 5%이다. 검정 하나만 놓고 보면 받아들일 만한 오류율이다. 그러나 현대의 연구는 흔히 많은 가설을 동시에 검정한다 — 전장유전체 연관분석(genome-wide association study, GWAS)은 수십만 개의 유전 변이를 검정할 수 있고, 임상시험은 여러 평가변수에 걸쳐 치료를 평가할 수 있다. 검정 수가 늘어나면 각 검정을 같은 \(\alpha\)로 수행하더라도 참인 귀무가설을 적어도 하나 잘못 기각할 확률이 함께 커진다. 가족단위 오류율(familywise error rate, FWER)이 이 누적 위험을 형식화한다.
정의 1. 가족단위 오류율
가설검정 \(H_1, H_2, \ldots, H_m\)의 가족을 생각하고 각각을 개별 유의수준 \(\alpha\)에서 검정한다고 하자. \(V\)를 잘못 기각된 참인 귀무가설의 개수(거짓 양성)라 하자. 가족단위 오류율(familywise error rate, FWER)은 가족 전체에서 제1종 오류(type I error)를 적어도 한 번 범할 확률이다.
말로 하면 FWER은 \(m\)개 검정 중 적어도 하나가 잘못된 기각을 낼 확률이다. 수준 \(\alpha\)에서의 강한 통제란 어느 가설이 참이고 어느 가설이 거짓이든 \(\text{FWER} \leq \alpha\)임을 뜻한다.
2. 독립일 때의 FWER
거짓 양성 위험이 얼마나 빨리 커지는지 보기 위해, \(m\)개 검정이 모두 독립이고 \(m\)개 귀무가설이 모두 참인 특수한 경우를 생각하자. 각 검정은 확률 \(\alpha\)로 잘못 기각하고 확률 \(1 - \alpha\)로 올바르게 기각하지 않는다. 검정이 독립이므로 어느 것도 잘못 기각하지 않을 확률은 다음과 같다.
따라서 FWER은 다음과 같다.
이 식은 \(m\)이 커지면 빠르게 증가한다. 아래 표가 각 검정이 \(\alpha = 0.05\) 를 쓸 때의 FWER 을 \(m\) 에 따라 적는다.
| 검정의 수 \(m\) | FWER |
|---|---|
| 1 | 0.050 |
| 5 | 0.226 |
| 10 | 0.401 |
| 20 | 0.642 |
| 50 | 0.923 |
| 100 | 0.994 |
독립인 검정 20개만으로도 거짓 양성이 적어도 하나 나올 확률이 64%이다. 100개면 그 확률이 99%를 넘는다.
그림으로 보는 통계학 1. 믿기지 않아서 발표하지 않았다
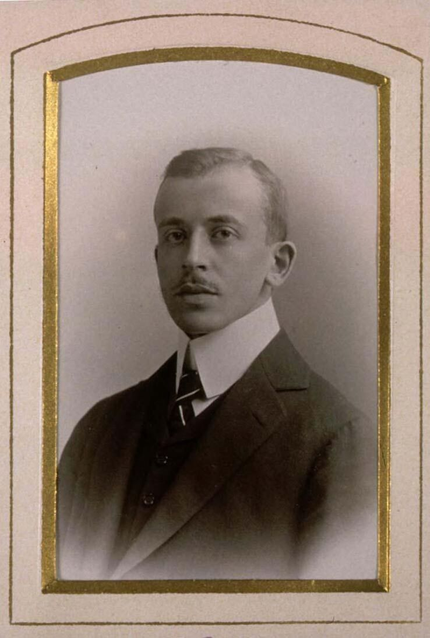
리하르트 폰 미제스 \((1883\text{–}1953)\). 금테를 두른 대지에 붙인 사진관 초상이다. (프랑스 국립도서관 소장, Wikimedia Commons, PD-US-expired)
위 표를 처음 보면 믿기 어렵다 — 검정 스무 개에 \(0.642\) 라니. 꼭 같은 믿기 어려움으로 역사에 이름이 남은 물음이 생일 문제다. 날이 \(d=365\) 일 때 사람이 \(n=23\) 명만 모여도 생일이 겹치는 짝이 있을 확률 \(P_n\) 이 벌써 \(\tfrac12\) 을 넘는다. 스물세 명이면 반이 넘는다니, 날이 삼백예순다섯이나 되는데 말이다.
그 「믿기 어려움」이 이 문제의 역사를 만들었다. 이 문제를 처음 활자로 낸 사람은 위의 리하르트 폰 미제스이고, 해는 \(1939\) 년이다. 그런데 그보다 십여 년 앞서 영국의 수론학자 해럴드 데이븐포트가 이미 같은 계산을 알고 있었다고 전해진다. 그는 발표하지 않았고, 자기가 처음이라고 주장하지도 않았다. 까닭이 남아 있다 — 「누군가 이미 말해 두지 않았을 리가 없다고 생각해서」다.
너무 놀라운 나머지, 발견한 사람 스스로 새 것일 리 없다고 여겨 묻혀 있던 셈이다. 놀라움의 정체는 사람 수가 아니라 짝의 수다. 스물세 명이 만드는 짝은 \(\binom{23}{2}=253\) 쌍이고, 이쯤 되면 반이 넘는 것이 이상한 일이 아니다. 데이븐포트가 믿지 못한 것은 수가 아니라 자기 직관이었다.
다중검정도 똑같다. 세어야 하는 것은 가설 하나하나가 아니라 잘못 기각할 기회의 수이고, \(1-(1-\alpha)^m\) 의 \(m\) 이 생일 문제의 \(253\) 에 해당한다. 집단 \(g\) 개를 둘씩 견주면 검정이 \(\binom{g}{2}\) 개이니, 거기서는 짝 세기가 글자 그대로 반복된다 — 집단 \(10\) 개면 벌써 \(45\) 번이다.
확인한 곳 — Wikipedia 「Birthday problem」 — 「일반적으로 \(1927\) 년 무렵의 해럴드 데이븐포트에게 돌리지만 그는 당시 발표하지 않았다. 데이븐포트는 자신이 발견자라고 주장하지 않았는데 「그것이 더 일찍 말해지지 않았을 리 없다고 믿을 수 없었기」 때문이다. 이 문제의 어떤 판을 처음 발표한 것은 \(1939\) 년 리하르트 폰 미제스다」가 그대로 적혀 있다 · \(\binom{23}{2}=253\) 과 \(P_{23} > \tfrac12\) 는 직접 셈했다 · 초상은 Commons 파일 쪽

3. 본페로니 (합집합) 한계
공식 \(1 - (1 - \alpha)^m\)은 검정이 독립일 것을 요구한다. 독립이 아니어도 성립하는 상한이 합집합 한계 \(\text{FWER} \le m\alpha\) 다. 먼저 그림으로 세 경우를 견주고, 유도는 그 아래에 적는다.
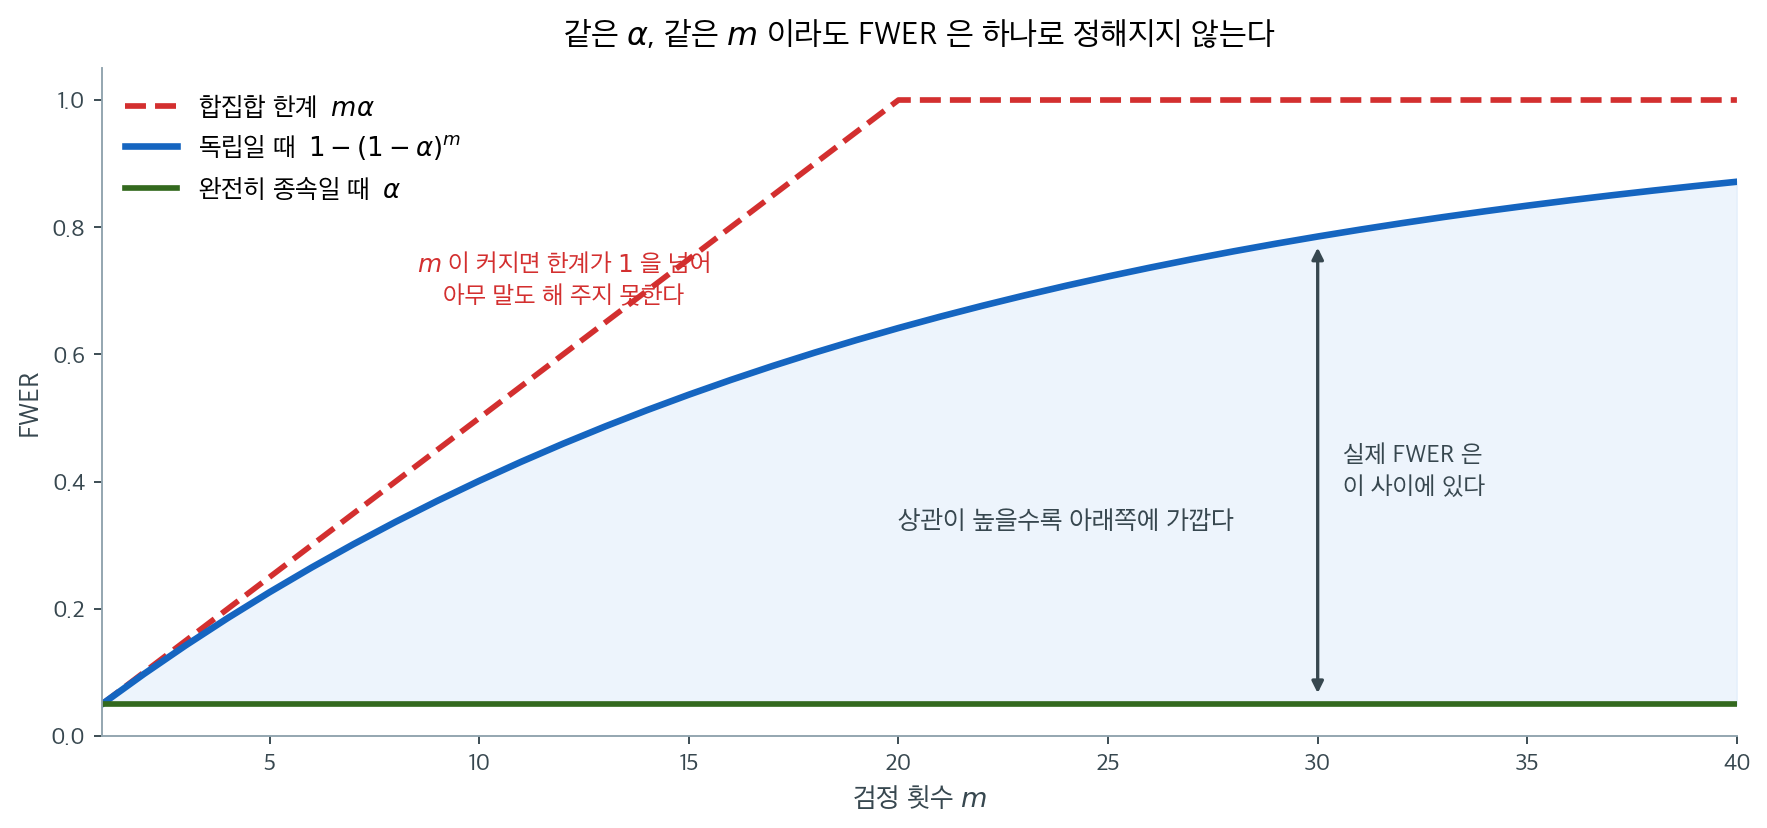
세 선의 관계가 이 절의 요점이다. 위의 붉은 파선이 합집합 한계 \(m\alpha\)이고, 아래의 초록 선이 검정들이 완전히 종속일 때의 FWER인 \(\alpha\)다. 실제 FWER은 언제나 이 둘 사이에 있으며, 독립일 때의 파란 곡선은 그 사이의 한 경우일 뿐이다.
여기서 두 가지를 읽을 수 있다. 첫째, 합집합 한계는 상관 구조를 전혀 묻지 않는 대신 느슨하다. \(m\)이 20을 넘으면 \(m\alpha > 1\)이 되어 "FWER은 1 이하"라는, 아무 내용 없는 말이 된다. 그럼에도 쓸모가 있는 것은 어떤 종속 구조에서도 성립하기 때문이다.
둘째, 검정들이 비슷할수록 FWER은 덜 부풀려진다. 같은 자료에 거의 같은 검정을 여러 번 하면 결과가 함께 움직이므로 "적어도 하나가 튀는" 일이 덜 일어난다. 앞 쪽 절단점을 고르면: 상관된 후보와 유효 후보 수의 탐색이 이 현상을 수치로 보여 주는데, 후보 64개를 시도해도 오류율이 독립일 때의 96%가 아니라 52%에 그친다. 실제로는 검정통계량(test statistic)이 상관되어 있는 경우가 많다 — 예컨대 겹치는 변수 집합을 검정하거나 모든 검정에 같은 자료를 쓸 때 그렇다. 더 일반적인 결과는 부울 부등식(합집합 한계)에서 나온다.
\(m\)개 검정 사이의 어떤 종속 구조에서도 이렇게 된다.
여기서 \(A_i\)는 검정 \(i\)가 참인 귀무가설을 잘못 기각하는 사건이다. 각 검정을 수준 \(\alpha\)에서 수행하면 각 \(i\)에 대해 \(P(A_i) \leq \alpha\)이므로 이렇게 된다.
이 한계는 검정 간 종속성에 대한 어떤 가정도 없이 성립한다. 본페로니 보정의 수학적 토대이다: FWER을 수준 \(\alpha\)로 통제하려면 각 가설을 보정된 수준 \(\alpha / m\)에서 검정한다.
정확한 공식과 한계의 관계
\(\alpha\)가 작으면 \((1 - \alpha)^m\)의 1차 테일러 전개가 \((1 - \alpha)^m \approx 1 - m\alpha\)를 주므로, 독립일 때의 정확한 FWER \(1 - (1 - \alpha)^m \approx m\alpha\)이다. 따라서 \(m\alpha\)가 작을 때 본페로니 한계 \(m\alpha\)가 좋은 근사이다. 그러나 \(m\)이 크면 \(m\alpha\)가 1을 넘을 수 있는 반면 참 FWER은 언제나 1 이하이다. 검정 수 \(m\)이 \(1/\alpha\)에 견줄 만큼 클 때(곧 \(m\alpha\)가 \(1\)에 가까워질 때) 이 한계가 느슨해진다.
4. 강한 통제와 약한 통제
FWER 통제에는 중요한 두 가지 방식이 있다.
- 약한 통제: 모든 귀무가설이 참인 완전 귀무가설(complete null hypothesis) 아래에서 FWER \(\leq \alpha\). 실제 효과가 전혀 없을 때만 거짓 양성을 막아 준다.
- 강한 통제: 참·거짓 귀무가설의 가능한 모든 배열 아래에서 FWER \(\leq \alpha\). 실무에서는 어느 가설이 참인지 모르므로 강한 통제가 표준 요건이다.
본페로니 보정과 홀름의 단계적 하강법 같은 절차는 강한 FWER 통제를 제공한다(다음 쪽 본페로니와 홀름 보정).
보기 1. 비료 다섯 가지의 검정. 어떤 연구자가 비료 다섯 가지 각각이 대조군에 비해 수확량을 늘리는지 \(\alpha = 0.05\)에서 t-검정으로 따로 검정한다. 실제로는 어느 비료도 효과가 없고(다섯 귀무가설이 모두 참이고) 다섯 검정이 독립이라면 FWER은 얼마인가. FWER을 \(0.05\) 로 통제하려면 각 검정에 어떤 수준을 써야 하는가.
풀이
순전한 우연으로 적어도 하나의 비료가 효과 있어 보일 확률이 약 23%이다. FWER을 0.05로 통제하려면 본페로니 보정으로 각 가설을 \(\alpha / 5 = 0.01\)에서 검정한다. 그러면 독립일 때 FWER은
로 목표 0.05 아래가 된다.
보기 2. 유전체 선별. 전장유전체 연관분석에서 연구자가 유전 변이 \(m = 500{,}000\)개를 질병과의 연관에 대해 검정한다. 개별 수준 \(\alpha = 0.05\) 로 검정하면 FWER은 어떻게 되는가. FWER을 \(0.05\) 로 통제하려면 검정마다 어떤 수준을 써야 하는가.
풀이
본페로니 한계가 1을 넘으므로 여기서는 정보가 되지 못하지만, 독립일 때의 정확한 FWER은 사실상 1.0이다. FWER을 0.05로 통제하려면 본페로니로 보정한 검정별 유의수준이
이 된다. 유전체 연구가 "전장유전체 유의성"을 \(p < 5 \times 10^{-8}\)로 보고하는 이유가 이 극도로 엄격한 기준이다(이웃한 변이끼리 함께 유전되어 상관되는 연관 불평형을 감안한 유효 독립 검정 수 약 100만 개를 반영한다 — \(0.05/10^6 = 5\times10^{-8}\)). 이런 보수성 때문에 덜 엄격한 대안인 거짓발견율(false discovery rate, FDR)이 등장한다(9.7절 거짓발견율 (Benjamini-Hochberg)).
5. FWER 통제가 적절한 때
FWER 통제는 다음 경우에 가장 적절하다.
- 거짓 양성이 단 하나라도 대가가 클 때(예: 효과 없는 약의 승인)
- 검정 수가 적당할 때(대략 \(m \leq 100\))
- 개별 가설에 대해 확정적인 주장을 해야 할 때
검정 수가 아주 많고 거짓 양성을 어느 정도 감수할 수 있으면 거짓발견율(FDR)이 통계적 검정력을 더 남기는 덜 보수적인 틀을 제공한다(9.7절 거짓발견율 (Benjamini-Hochberg)). FWER을 통제하는 구체적인 절차는 본페로니와 홀름 보정을 보라.
한 가지 덧붙이면, 이 절의 합집합 한계는 가족의 종속 구조를 모를 때 쓰는 도구다. 구조를 아는 가족이라면 같은 FWER을 더 정확하게 통제할 수 있다. 분산분석(analysis of variance) 뒤의 사후비교(post hoc comparison)가 그런 경우로(10.3절 본페로니와 셰페 방법), 거기서는 모든 비교가 하나의 합동 집단내 평균제곱 \(\text{MS}_W\)와 하나의 오차 자유도를 공유하므로 상관이 알려져 있고, 10.3절 투키 정직유의차가 그 구조를 그대로 써서 정확한 임계값을 얻는다.
6. 검정 수에 따라 FWER 이 자라는 모양
절 \(2\) 는 독립일 때 \(\text{FWER} = 1 - (1-\alpha)^m\) 임을 적었다. 그 식이 \(m\) 과 \(\alpha\) 에 따라 어떻게 자라는지, 그리고 무보정으로 몇 개까지 버틸 수 있는지를 수로 본다.
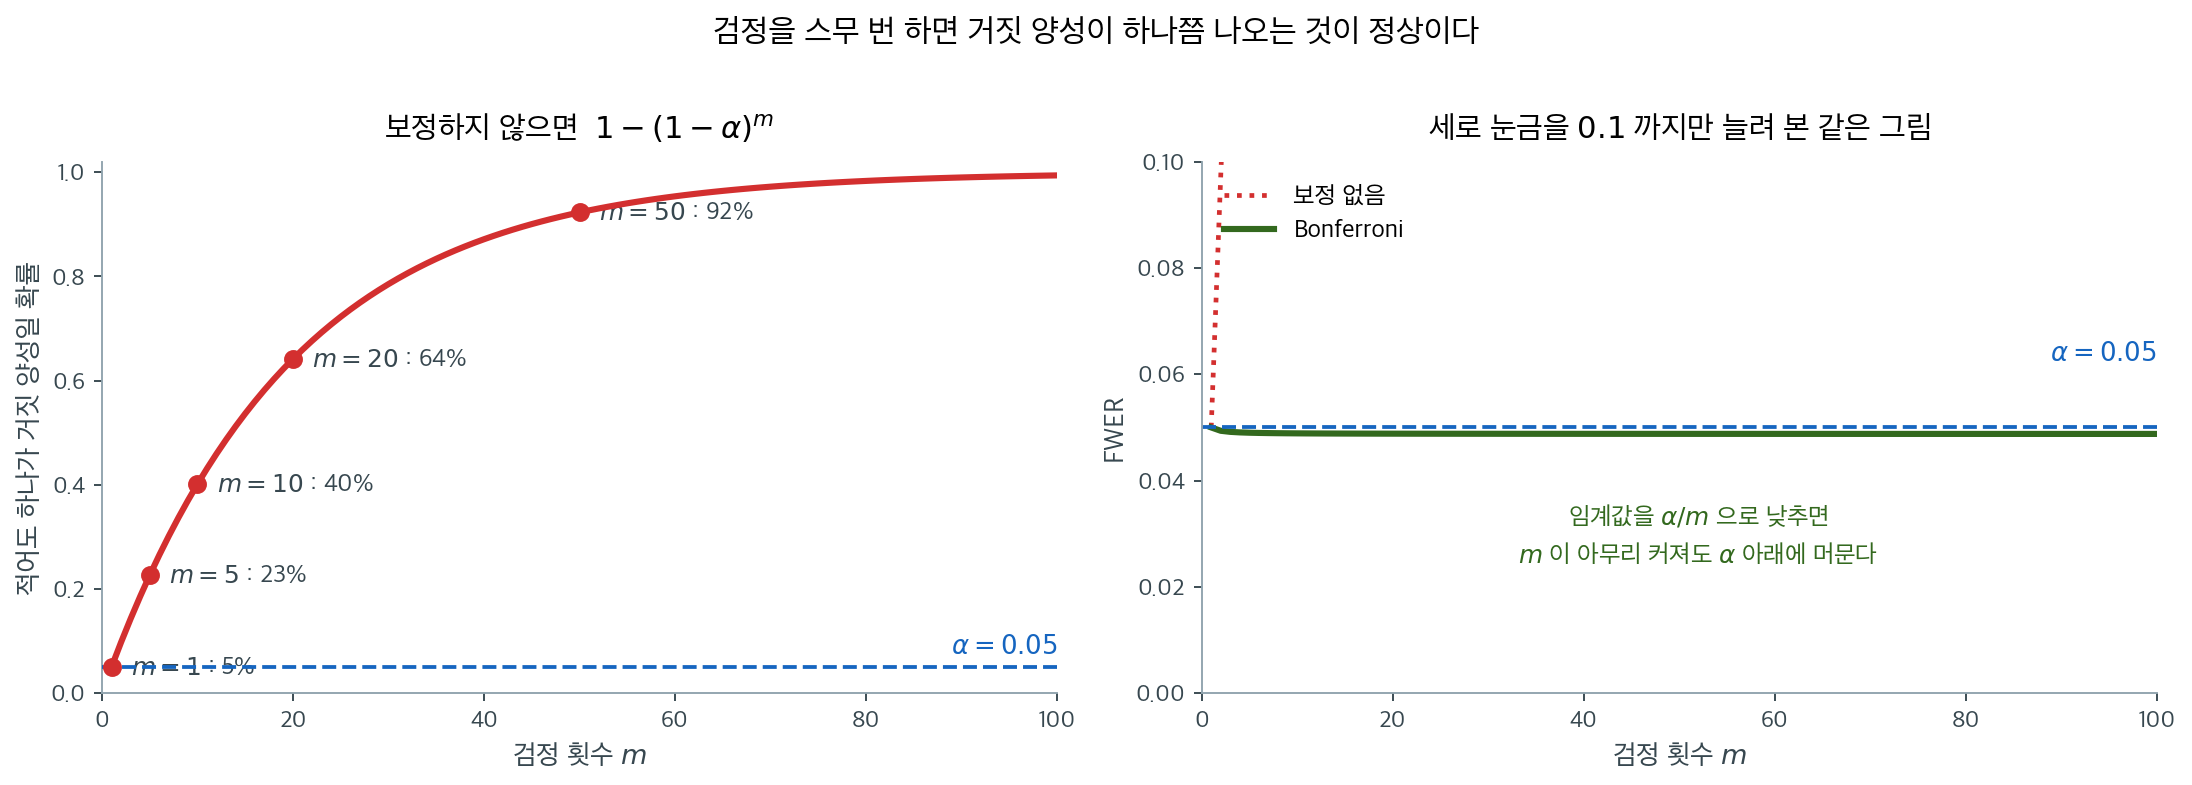
왼쪽 곡선은 절 \(2\) 의 표를 그림으로 옮긴 것이다. 가파르게 오르는 것에 주목하라 — 검정을 다섯 번만 해도 이미 \(0.226\) 이다. 흔히 「\(\alpha = 0.05\) 로 검정했다」고 말할 때 지켜지는 것은 검정 하나의 오류율이지 연구 전체의 오류율이 아니며, 둘의 차이가 이 곡선의 높이다.
오른쪽은 세로축을 \(0.1\) 까지만 잡아 같은 그림을 다시 그린 것이다. 검정별 유의수준을 \(\alpha/m\) 으로 낮추면 초록 곡선이 \(m\) 과 무관하게 \(\alpha\) 아래에 머문다. 절 \(3\) 의 합집합 한계가 보장하는 것이 이것이며, 대가는 검정력이다. 유의수준이 낮아진 만큼 진짜 효과도 놓치기 쉬워진다.
그림으로 보는 통계학 2. 죽은 연어의 뇌
2009 년, 베넷과 동료들은 fMRI 장비를 점검하려고 이것저것 넣어 보고 있었다. 호박을 넣어 보고, 콘월산 닭을 넣어 보고, 그다음에 대서양 연어 한 마리를 넣었다. 죽은 연어였다. 장비가 돌아가는지만 보면 되는 일이었으므로, 하던 대로 사람들이 찍힌 사진을 보여 주고 「이 사람이 어떤 감정인지 판단하라」고 지시했다.
보정 없이 복셀마다 \(p < 0.001\) 로 자르자 연어의 뇌에서 세 점이 켜졌다. 다중비교(multiple comparisons) 보정을 넣으니 하나도 남지 않았다. 베넷은 이것을 논문이 아니라 다른 사람들을 향한 경고로 내놓았다. 그 무렵(\(2008\) 년) 주요 뇌영상 학술지 여섯 곳에 실린 fMRI 논문의 \(25\)~\(30\%\) 가 보정하지 않은 임계값을 쓰고 있었다. 2012 년 이그노벨 신경과학상을 받았고, 수상 사유는 「복잡한 장비와 단순한 통계를 쓰면 어디서든 의미 있는 뇌 활동을 볼 수 있음을 — 죽은 연어에서조차 — 보인 공로」였다.
위 곡선만 보면 처방이 간단해 보인다. \(m\) 이 크니 검정별 유의수준을 낮추면 된다. 그런데 저 곡선은 검정들이 독립일 때의 그림이고, 뇌영상에서는 그렇지 않다. 이웃한 복셀끼리 닮아 있고, 분석 과정에서 일부러 평활을 넣기도 한다. 그래서 현장에는 다른 안전장치가 널리 쓰인다 — 「이웃한 복셀 셋 이상이 함께 켜져야 인정한다」는 규칙이다. 한 점이 우연히 켜질 수는 있어도 세 점이 붙어서 켜지기는 어려우리라는 직관이다.
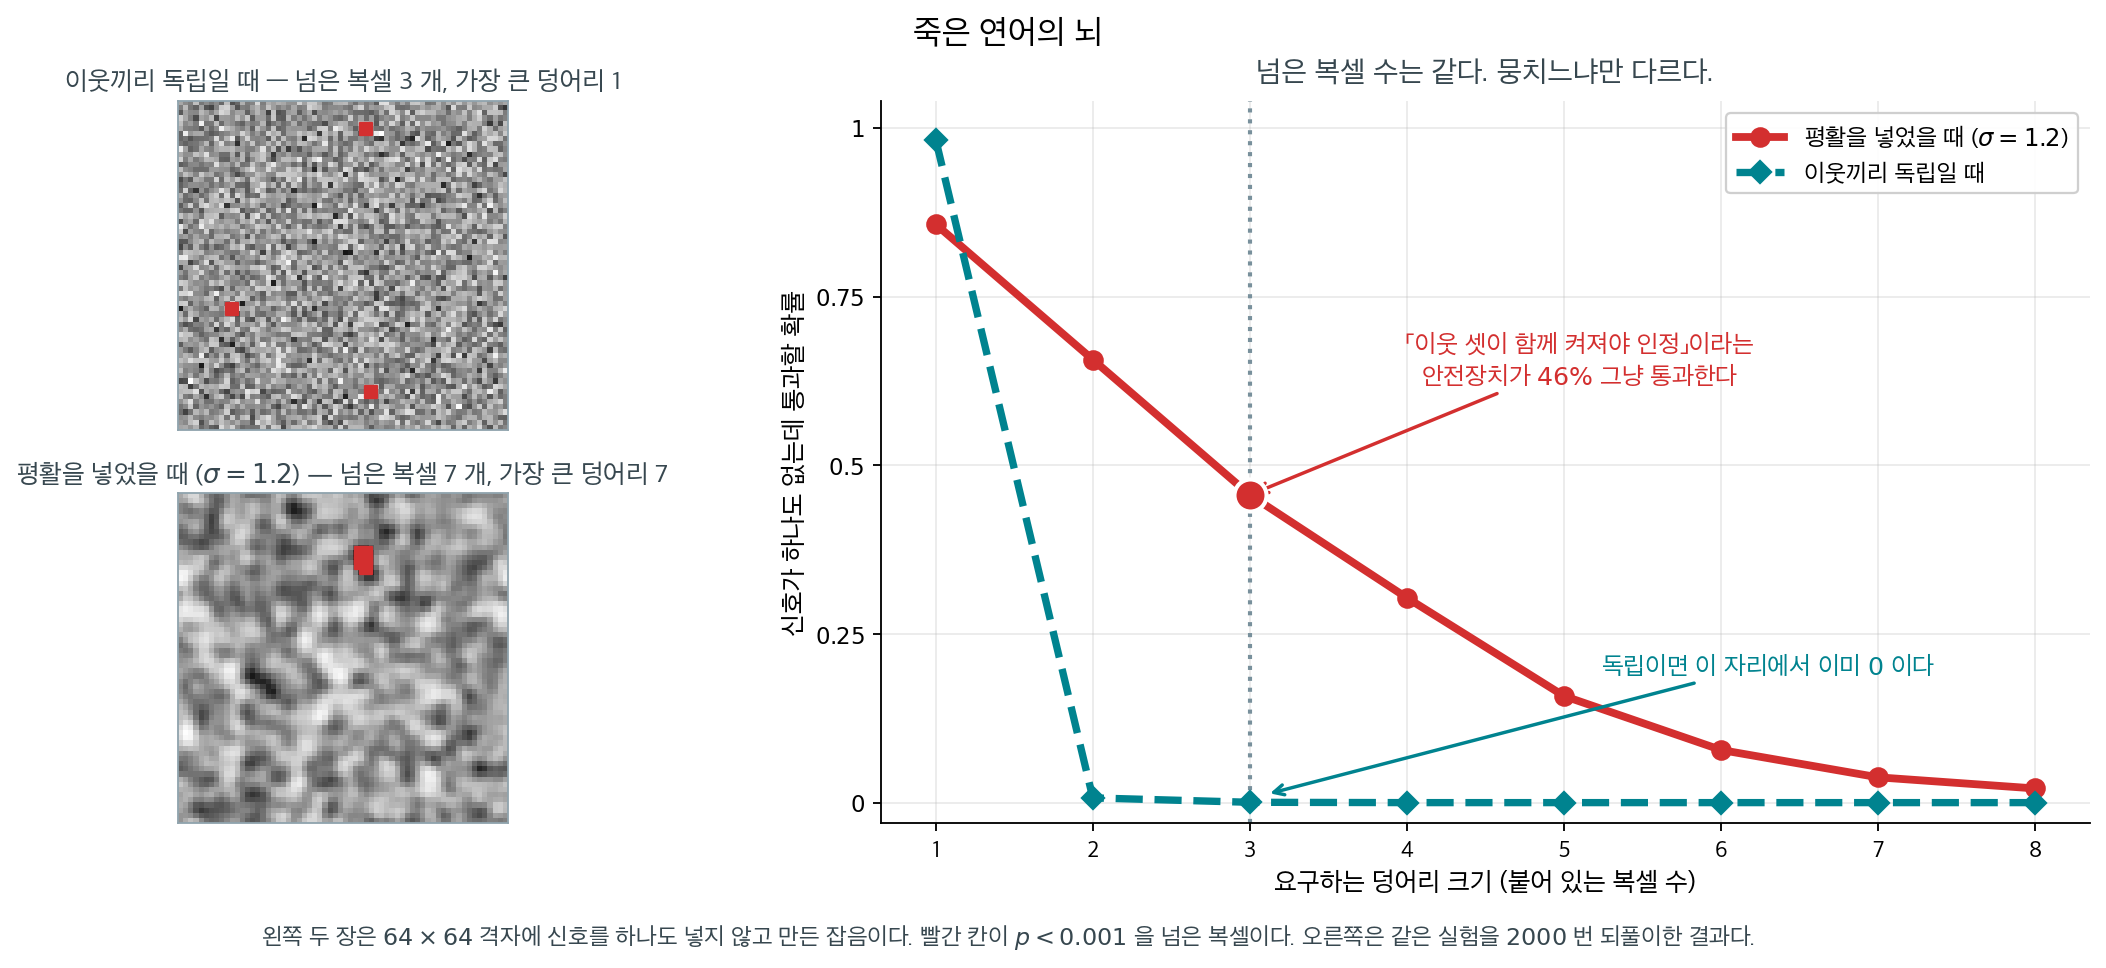
왼쪽 두 장 모두 신호를 하나도 넣지 않은 잡음이다. 빨간 칸이 \(p < 0.001\) 을 넘은 복셀이다.
\(64 \times 64\) 격자에 신호를 하나도 넣지 않고 재 보았다. 임계값을 넘는 복셀 수는 양쪽 모두 평균 \(4.1\) 개로 같다 — 당연하다. 복셀 하나하나를 따로 보면 어느 쪽이든 넘을 확률이 \(0.001\) 이기 때문이다. 다른 것은 그 넷이 흩어지느냐 뭉치느냐뿐이다.
그런데 그 차이가 안전장치를 통째로 무력화한다. 이웃끼리 독립이면 셋이 붙어서 켜질 확률이 \(0.001\) 로, 직관대로 거의 일어나지 않는다. 평활을 조금만 넣으면 같은 확률이 \(0.456\) 이 된다. 신호가 하나도 없는 자료에서 열 번에 네다섯 번은 「유의한 덩어리」가 나온다.
여기서 얻을 것은 「보정하라」가 아니다. 그 말은 이미 교과서에 있다. 요점은 어떤 보정이 무엇을 가정하고 있는지다. \(\alpha/m\) 도, 덩어리 규칙도, 9.7절 거짓발견율 (Benjamini-Hochberg)의 BH 절차도 검정들 사이의 의존 구조에 대해 저마다 다른 가정을 깔고 있다. 가정이 틀리면 보정은 지켜 주는 시늉만 한다 — 그리고 그 시늉은 보정을 아예 안 한 것보다 더 위험하다. 했다고 믿게 만들기 때문이다.
확인한 곳 — 베넷 등이 \(2009\) 년 \(6\) 월 샌프란시스코의 인간뇌지도학회에서 발표한 것, 시험 대상으로 호박과 콘월산 닭을 거쳐 대서양 연어를 넣었다는 것, 유의한 복셀 셋이 연어 뇌의 정중선을 따라 붙어서 나왔다는 것, \(2012\) 년 이그노벨 신경과학상의 수상 사유가 「복잡한 장비와 단순한 통계를 쓰면 어디서든 — 죽은 연어에서조차 — 의미 있는 뇌 활동을 볼 수 있음을 보인 공로」였다는 것 · Bennett · Wolford · Miller, "The principled control of false positives in neuroimaging", 『Social Cognitive and Affective Neuroscience』 \(4\) 권 \(4\) 호 \(417\)–\(422\) 쪽(\(2009\))이 \(2008\) 년 주요 뇌영상 학술지 여섯 곳을 조사해 학술지마다 fMRI 논문의 \(25\)~\(30\%\) 가 보정하지 않은 임계값을 썼다고 보고한 것. 격자 모의실험의 수는 모두 직접 돌린 값이다
보기 3. 검정 수에 따른 FWER. 독립인 검정 \(m = 100\)개를 각각 수준 \(\alpha\)에서 수행하고, 모든 귀무가설이 참이라고 하자.
(1) \(\alpha = 0.05,\ 0.01,\ 0.001\)에서 FWER을 구하시오.
(2) \(m = 100\)에서 FWER을 정확히 \(0.05\)로 맞추는 \(\alpha\)를 구하고, 본페로니의 \(\alpha/m\)과 견주시오. 어느 쪽이 더 보수적인가.
풀이
(1) 해석적으로. 검정 \(i\)가 잘못 기각하지 않을 확률이 \(1-\alpha\)이고 \(m\)개가 독립이므로, 하나도 잘못 기각하지 않을 확률은 \((1-\alpha)^m\)이다. 적어도 하나를 잘못 기각할 확률은 그 여집합이다.
\(m = 100\)에 세 값을 넣는다.
(2) 해석적으로. \(1 - (1-\alpha)^{100} = 0.05\)를 \(\alpha\)에 대해 푼다.
이것이 시닥(Šidák) 보정이다. 본페로니는 \(\alpha/m = 0.05/100 = 0.00050000\)을 쓴다.
본페로니 쪽이 더 작으므로 더 보수적이다. 비가 \(0.00051280/0.00050000 = 1.0256\)이니 약 \(2.6\%\) 차이다. 두 값이 가까운 까닭은 \(\alpha\)가 작을 때 \(1-(1-\alpha)^m \approx m\alpha\)이기 때문이고, 실제로 \(\ln(1-x) \approx -x\)를 쓰면
로 본페로니의 \(0.05/m\)과 분자만 \(2.6\%\) 다르다. 시닥이 조금 덜 보수적이지만 그 이득은 미미하고, 대신 독립성(independence)을 가정해야 한다. 본페로니는 종속성이 어떻든 성립한다.
수치적으로.
import numpy as np

# 검정 m 개가 모두 참 귀무가설이고 서로 독립이라면, 하나도 잘못 기각하지
# 않을 확률이 (1-a)^m 이다. 적어도 하나를 잘못 기각할 확률이 그 나머지다.
# m=100, a=0.05 면 0.994 — 거의 확실하게 거짓 양성이 하나는 나온다.
m_vals = np.arange(1, 501)
alphas = [0.05, 0.01, 0.001]
for a in alphas:
    fwer = 1 - (1 - a) ** m_vals
    print(f"alpha={a}, m=100: FWER={1 - (1-a)**100:.4f}")

# (2) FWER 을 0.05 로 맞추는 alpha.
m = 100
sidak = 1 - 0.95 ** (1 / m)
bonf = 0.05 / m
print(f"\n시닥   alpha = {sidak:.8f}   확인 FWER = {1 - (1 - sidak) ** m:.6f}")
print(f"본페로니 alpha = {bonf:.8f}   확인 FWER = {1 - (1 - bonf) ** m:.6f}")
print(f"비 시닥/본페로니 = {sidak / bonf:.4f}")
출력:
alpha=0.05, m=100: FWER=0.9941
alpha=0.01, m=100: FWER=0.6340
alpha=0.001, m=100: FWER=0.0952

시닥   alpha = 0.00051280   확인 FWER = 0.050000
본페로니 alpha = 0.00050000   확인 FWER = 0.048782
비 시닥/본페로니 = 1.0256
(1)과 (2)의 값이 모두 그대로 나왔다. 시닥의 \(\alpha\)를 넣으면 FWER이 정확히 \(0.050000\)이고, 본페로니는 \(0.048782\)로 목표보다 낮다. 보수적이라는 말의 뜻이 이것이다.
검정 100개를 \(\alpha = 0.05\)로 하면 거짓 양성이 하나도 없을 확률이 \(0.6\%\)에 불과하다. \(\alpha\)를 \(0.001\)까지 낮춰야 FWER이 \(10\%\) 아래로 내려온다. 이것이 본페로니가 하는 일이고, 동시에 본페로니가 검정력을 잃는 이유이기도 하다.
연습문제
연습문제 1. 가족단위 오류율(FWER)을 정의하라. 모든 귀무가설이 참인 독립 검정 10개를 각각 \(\alpha = 0.05\)에서 수행하면 정확한 FWER은 얼마인가?
풀이
FWER은 \(m\)개 검정 전체에서 제1종 오류를 적어도 한 번 범할 확률이다.
독립인 검정이 \(m = 10\)개이고 각각 \(P(\text{기각} \mid H_0) = 0.05\)이면 이렇게 된다.
거짓 양성이 적어도 하나 나올 확률이 40%로, 검정당 명목 수준 5%를 훨씬 넘는다.
연습문제 2. FWER의 강한 통제와 약한 통제의 차이를 설명하라.
풀이
약한 통제는 완전 귀무가설 아래에서만(즉 \(m\)개 귀무가설이 모두 동시에 참일 때만) FWER \(\leq \alpha\)를 보장한다. 일부 귀무가설이 거짓일 때의 거짓 양성은 막아 주지 않는다.
강한 통제는 어떤 귀무가설이 몇 개나 참이든, 참·거짓의 어떤 배열에서도 FWER \(\leq \alpha\)를 보장한다. 훨씬 강한 보장이며 다중검정 절차의 표준 요건이다.
예를 들어 약한 통제만 갖춘 절차는 모든 귀무가설이 참일 때 FWER이 5%이지만 10개 중 5개가 거짓일 때 FWER이 30%일 수 있다. 강한 통제를 갖춘 절차는 두 경우 모두 FWER \(\leq 5\%\)를 유지한다. 본페로니와 홀름은 둘 다 강한 통제를 제공한다.
연습문제 3. (모든 귀무가설이 참이고 검정이 독립일 때) 검정 수 \(m \to \infty\)이면 보정하지 않은 검정의 FWER이 1에 다가감을 보여라.
풀이
독립이고 모든 귀무가설이 참일 때 이렇게 된다.
\(m \to \infty\)이면 이렇게 된다.
따라서 \(\text{FWER} \to 1\)이다. 예를 들어 \(\alpha = 0.05\)이면 이렇게 된다.
- \(m = 10\): FWER \(\approx 0.40\)
- \(m = 50\): FWER \(\approx 0.92\)
- \(m = 100\): FWER \(\approx 0.994\)
독립인 검정 100개만으로도 거짓 양성이 적어도 하나 생기는 것이 사실상 확실하다. 그래서 대규모 검정에서는 FWER 통제가 필수적이다.
연습문제 4. 어떤 임상시험이 세 가지 주요 평가변수(혈압, 콜레스테롤, 체중)에 대해 약을 검정한다. 회사는 \(\alpha = 0.05\)에서 어느 한 변수라도 유의한 개선을 보이면 성공이라고 주장한다. 독립일 때의 FWER을 계산하고 규제기관이 다중검정 보정을 요구하는 이유를 설명하라.
풀이
약이 어느 평가변수에도 효과가 없고(세 귀무가설이 모두 참이고) 검정이 독립이면 이렇게 된다.
회사가 우연히 성공을 주장할 확률이 14.3%로, 의도한 5%의 거의 세 배이다. 평가변수가 5개면 FWER \(\approx 0.226\), 10개면 \(\approx 0.401\)이다.
규제기관(예: FDA, EMA)이 다중검정 보정을 요구하는 이유는, 보정 없이 여러 평가변수 중 하나에 근거해 약을 승인하면 잘못된 승인 비율이 부풀기 때문이다. 흔한 접근으로 본페로니 보정, 게이트키핑 절차(미리 정한 순서대로 평가변수를 계층적으로 검정), 분할–알파 전략(합이 0.05가 되도록 평가변수마다 다른 \(\alpha\)를 배분)이 있다.
연습문제 5. FWER 통제의 검정력 비용을 정량화하라. 검정 수가 늘 때 표본을 얼마나 늘려야 같은 검정력을 유지하는가?
풀이
import numpy as np
from scipy import stats

zb = stats.norm.ppf(0.80)
base = None
print(f"{'m':>6s} {'보정 α':>10s} {'집단당 n':>9s} {'배율':>7s} "
      f"{'n 증가율':>9s}")
for m in [1, 2, 5, 10, 100, 10_000, 10**6]:
    za = stats.norm.ppf(1 - 0.05 / (2 * m))
    n = 2 * (za + zb)**2 / 0.5**2          # d = 0.5
    if base is None:
        base = n
    print(f"{m:6d} {0.05 / m:10.2e} {np.ceil(n):9.0f} {n / base:7.2f} "
          f"{(n / base - 1):9.1%}")
     m       보정 α     집단당 n      배율     n 증가율
     1   5.00e-02        63    1.00      0.0%
     2   2.50e-02        77    1.21     21.1%
     5   1.00e-02        94    1.49     48.8%
    10   5.00e-03       107    1.70     69.6%
   100   5.00e-04       150    2.38    138.0%
 10000   5.00e-06       234    3.72    272.4%
1000000   5.00e-08       317    5.05    404.5%
\(m\)이 \(10^6\)배 늘어도 표본은 5배면 된다. 매우 완만하다.
왜 그런가. \(n\propto(z_{1-\alpha/(2m)}+z_{1-\beta})^2\)이고, 정규분포의 꼬리에서
이므로 \(z\)가 \(\sqrt{\log m}\)으로 자란다. 따라서 \(n\)이 \(\log m\) 정도로만 는다. 검정 수가 지수적으로 늘어도 표본은 선형으로만 늘리면 된다.
이것이 유전체 연구가 가능한 이유다. \(m=10^6\)에서 \(\alpha=5\times10^{-8}\)이라는 극단적 유의수준을 쓰면서도, 표본은 단일 검정의 5배면 된다. 실제 전장유전체 연관분석(GWAS)이 수만~수십만 명 규모인 것은 효과크기(effect size)가 매우 작기 때문이지 보정 때문이 아니다.
다만 주의할 점 셋.
- 검정력을 80%로 유지한다는 전제다. 표본을 늘리지 않으면 검정력이 급격히 떨어진다. \(m=100\)에서 집단당 \(n=64\)(보정 없는 \(m=1\) 의 표본크기 \(63\) 을 흔히 쓰는 \(64\) 로 올린 값)를 유지하면 검정력이
za = stats.norm.ppf(1 - 0.05 / 200)
print(f"m=100, n=64, d=0.5 의 검정력: "
      f"{stats.norm.sf(za - 0.5 * np.sqrt(64 / 2)):.4f}")
m=100, n=64, d=0.5 의 검정력: 0.2571
0.80에서 0.26으로 3분의 1 아래로 떨어진다.
연습문제 6. 게이트키핑 절차를 설명하고, 임상시험의 다중 평가변수에 어떻게 적용되는지 예로 보여라.
풀이
상황. 주 평가변수 \(H_1\)과 부 평가변수 \(H_2,H_3,H_4\)가 있다. 주 평가변수가 유의하지 않으면 부 평가변수의 결과는 의미가 없다.
직렬 게이트키핑. \(H_1\)을 수준 \(\alpha\)로 검정하고,
- 기각되지 않으면 거기서 끝,
- 기각되면 \(H_2,H_3,H_4\)를 수준 \(\alpha\)의 FWER 절차(홀름 등)로 검정한다.
전체 FWER이 \(\alpha\)로 유지된다. 닫힌 검정 원리(closed testing principle, 아래 연습문제 10)로 증명된다.
병렬 게이트키핑. 주 평가변수가 여럿(\(H_1,H_2\))이고 적어도 하나가 유의하면 다음 단계로 넘어간다. 이때는 \(\alpha\)의 일부만 물려줄 수 있다.
import numpy as np
from scipy import stats

rng = np.random.default_rng(55)
M, alpha = 40_000, 0.05

# H1(주) 은 참, H2~H4(부) 도 참인 최악의 경우로 FWER 확인
p = rng.random((M, 4))

# ① 직렬 게이트키핑
gate = p[:, 0] < alpha
thr = alpha / (3 - np.arange(3))                  # 홀름 임계값
sub = np.sort(p[:, 1:], axis=1) <= thr
serial = gate & (sub.any(1))
print(f"직렬 게이트키핑 FWER = {(gate | serial).mean():.4f}")

# ② 보정 없이 네 개 모두 검정
print(f"보정 없음 FWER      = {(p < alpha).any(1).mean():.4f}")

# ③ 본페로니
print(f"본페로니 FWER       = {(p < alpha / 4).any(1).mean():.4f}")
직렬 게이트키핑 FWER = 0.0503
보정 없음 FWER      = 0.1862
본페로니 FWER       = 0.0503
직렬 게이트키핑이 FWER을 0.05로 유지한다. 본페로니와 같은 보장을 주면서, 주 평가변수에는 \(\alpha\)를 온전히 쓴다.
이것이 결정적인 장점이다. 본페로니라면 주 평가변수도 \(\alpha/4=0.0125\)로 검정해야 해서 주 결과의 검정력을 크게 잃는다. 게이트키핑은 가장 중요한 가설에 자원을 집중한다.
그래프 기반 절차로의 일반화. 브레츠(Bretz)·마우러(Maurer)·브라나트(Brannath)·포슈(Posch)가 \(2009\) 년에 제안한 방법이다.
- 가설을 노드로, \(\alpha\)의 초기 배분을 가중치로 둔다.
- 노드를 기각하면 그 노드의 \(\alpha\)를 정해진 비율로 다른 노드에 물려준다.
- 물려주는 규칙(그래프의 간선)을 사전에 명시한다.
이 틀이 직렬·병렬 게이트키핑, 홀름, 고정 순서를 모두 특수한 경우로 포함한다.
설계 시 고려.
- 순서를 임상적 중요도로 정한다. 통계적 검정력이 아니라.
- 앞이 막히면 뒤를 못 본다는 점을 이해관계자에게 미리 알린다.
- 탐색적 분석은 게이트키핑 밖에 두고 그렇게 표시한다.
연습문제 7. 순열 기반 FWER 통제(웨스트폴–영)의 원리를 설명하고 구현하라.
풀이
원리. 귀무가설 아래에서 최소 \(p\) 값의 분포를 순열로 구한다. 상관 구조가 자동으로 반영된다.
단일 단계 판.
를 순열로 추정하고, \(\tilde p_j\le\alpha\)이면 기각한다.
단계적 하강 판. 이미 기각된 가설을 빼고 최솟값을 다시 계산해 검정력을 높인다.
import numpy as np
from scipy import stats

rng = np.random.default_rng(91)
n, m, B = 40, 20, 2_000

# 상관이 강한 결과변수 20개, 그중 3개에 참 효과
rho = 0.7
S = rho * np.ones((m, m)) + (1 - rho) * np.eye(m)
L = np.linalg.cholesky(S)
g = np.repeat([0, 1], n // 2)
y = rng.standard_normal((n, m)) @ L.T
y[g == 1, :3] += 1.2

def tstats(y, g):
    a, b = y[g == 0], y[g == 1]
    se = np.sqrt(a.var(0, ddof=1) / len(a) + b.var(0, ddof=1) / len(b))
    return (b.mean(0) - a.mean(0)) / se

t_obs = np.abs(tstats(y, g))
mx = np.empty(B)
for i in range(B):
    gp = rng.permutation(g)
    mx[i] = np.abs(tstats(y, gp)).max()

p_wy = np.array([(np.sum(mx >= t) + 1) / (B + 1) for t in t_obs])
p_raw = 2 * stats.t.sf(t_obs, n - 2)
p_bonf = np.minimum(p_raw * m, 1)

print(f"{'변수':>5s} {'원 p':>9s} {'본페로니':>10s} {'웨스트폴-영':>12s}")
for j in list(range(5)) + [m - 1]:
    print(f"{j:5d} {p_raw[j]:9.4f} {p_bonf[j]:10.4f} {p_wy[j]:12.4f}")
print(f"\nα=0.05 기각 수: 본페로니 {(p_bonf <= 0.05).sum()}, "
      f"웨스트폴-영 {(p_wy <= 0.05).sum()}")
   변수       원 p       본페로니       웨스트폴-영
    0    0.0005     0.0100       0.0075
    1    0.0008     0.0168       0.0105
    2    0.0001     0.0020       0.0025
    3    0.9677     1.0000       1.0000
    4    0.6760     1.0000       1.0000
   19    0.8373     1.0000       1.0000

α=0.05 기각 수: 본페로니 3, 웨스트폴-영 3
참 신호 셋 가운데 둘에서 웨스트폴–영의 보정 \(p\)가 본페로니보다 작다(0.0075 대 0.0100, 0.0105 대 0.0168). 상관을 반영해 "최소 \(p\) 값이 그만큼 작을 확률"을 실제로 계산하기 때문이다. 변수 2 에서는 0.0025 대 0.0020 으로 뒤집히는데, 순열 \(B = 2{,}000\) 번으로는 보정 \(p\) 가 \(1/(B+1) \approx 0.0005\) 단위로만 움직이므로 이만큼 작은 값에서는 그 차이를 가릴 수 없다. 여기서는 세 신호가 모두 강해 기각 수가 같지만, 경계 근처에서는 차이가 결론을 가른다.
장점.
- 상관 구조를 자료에서 가져온다. 가정이 필요 없다.
- 분포가정이 없다. 순열이 \(H_0\) 분포를 만든다.
- FWER을 강하게 통제한다(부분집합 축차성(subset pivotality) — 참인 가설들의 통계량이 이루는 결합분포(joint distribution)가 나머지 가설의 참·거짓에 좌우되지 않는다는 조건 — 이 성립할 때).
한계.
- 교환가능성이 필요하다. 무작위 배정 실험에서 자연스럽지만 관측연구에서는 근거가 약하다.
- 계산이 무겁다. \(B\times m\)번의 통계량 계산.
- \(B\)가 해상도를 제한한다. 최소 보정 \(p\)가 \(1/(B+1)\)이다. \(m\)이 크면 \(B\)도 커야 한다.
- 결측이나 불균형이 있으면 순열 구조를 설계하기 까다롭다.
언제 쓰는가. 상관이 강하고 \(m\)이 중간 규모(수십~수천)인 경우에 이득이 가장 크다. \(m\)이 아주 크면 FDR 쪽이 실용적이다.
연습문제 8. FWER을 통제해야 하는 상황과 그럴 필요가 없는 상황을 구체적 사례로 구분하라.
풀이
| 사례 | FWER 필요? | 이유 |
|---|---|---|
| 신약의 주 평가변수 3개 중 하나라도 유의하면 승인 | 필요 | "하나라도"가 곧 결론 |
| 한 논문의 서로 무관한 세 연구 | 불필요 | 결론이 각각 독립 |
| 분산분석 후 쌍별 비교 | 필요 | 하나의 "차이가 있다" 결론 |
| 유전체 1만 개 유전자 선별 | FDR이 적절 | 후속 검증이 있음 |
| 하위집단 분석(사전 정의 5개) | 필요 | 하나를 골라 주장하므로 |
| 하위집단 분석(탐색적) | 보정 대신 탐색적임을 명시 | 확증이 아님 |
| 회귀계수 10개의 개별 해석 | 불필요(개별 구간) | 각 계수를 따로 해석 |
| 회귀에서 "어느 변수든 효과가 있는가" | 필요(또는 \(F\) 검정) | 전체 결론 |
| A/B 시험의 지표 20개 | 상황에 따라 | 결정 규칙이 무엇인지에 달림 |
| 품질관리 관리도의 반복 점검 | 필요(경계 설계) | 반복 검정 구조 |
판단의 핵심 질문 셋.
-
"하나라도 유의하면 ~라고 결론 내리는가?" 그렇다면 FWER이 필요하다.
-
잘못된 결론 하나가 큰 손해인가? 규제 승인처럼 그렇다면 FWER, 후속 검증이 있으면 FDR.
-
몇 개를 검정하는가? \(m\)이 수백을 넘으면 FWER이 비현실적이다.
애매한 사례 — A/B 시험.
- "주 지표(전환율)로 결정하고 나머지는 모니터링" → 보정 불필요. 주 지표 하나만 결정에 쓴다.
- "어느 지표든 개선되면 출시" → FWER 필요.
- "20개 지표 중 개선된 것을 찾아 다음 실험 설계" → FDR이나 탐색적 표시.
실무 권고.
-
결정 규칙을 먼저 적는다. "무엇을 보고 무엇을 결정하는가." 이것이 정해지면 보정 필요성이 자동으로 따라온다.
-
주 결과를 하나로 좁히려 노력한다. 가장 효과적인 해결책이다.
-
보정하지 않기로 했다면 그 이유를 밝힌다. "각 가설을 독립적인 연구 질문으로 보았으며, 모든 검정 결과를 표 2에 보고한다"처럼.
연습문제 9. FWER 통제 절차의 가정과 로버스트성을 정리하라. 어떤 상황에서 보장이 깨지는가?
풀이
| 절차 | 필요한 가정 | 깨지는 경우 |
|---|---|---|
| 본페로니 | 없음 | 깨지지 않음(개별 \(p\)가 타당하면) |
| 홀름 | 없음 | 같음 |
| 시닥 | 독립(또는 특정 양의 종속) | 음의 종속 |
| 호크버그 | PRDS(양의 종속) | 음의 종속이 섞이면 |
| 호멜 | 심스 부등식 성립 | 일부 종속 구조 |
| 투키 | 정규·등분산·독립 | 이분산, 비정규 |
| 셰페 | 정규·등분산 | 같음 |
| 웨스트폴–영 | 교환가능성, 부분집합 축차성 | 관측연구, 불균형 설계 |
표의 PRDS 는 「부분집합에 대한 양의 회귀 종속(positive regression dependence on a subset)」의 약어로, 검정통계량들이 함께 커지는 쪽으로만 종속된 경우를 가리킨다.
가장 중요한 사실. 본페로니와 홀름은 어떤 종속 구조에서도 타당하다. 합집합 한계가 종속에 무관하기 때문이다. 이것이 두 절차의 가장 큰 장점이다.
그런데 더 근본적인 가정이 있다 — 개별 \(p\) 값의 타당성.
이것이 깨지면 어떤 보정도 소용없다. 깨지는 경우가 흔하다.
- 정규성(normality)·등분산 위배. 9.2절 σ²에 대한 카이제곱 검정의 분산 검정처럼 개별 \(p\)가 이미 부정확하면, 보정이 그 오차를 물려받는다.
- 이산성. 개별 \(p\)가 초균등(superuniform)이면, 곧 \(H_0\) 아래에서 \(P(p\le u)<u\) 여서 균등분포보다 큰 쪽으로 몰려 있으면 보정이 지나치게 보수적이 된다.
- 모형 오설정. 누락변수, 잘못된 연결함수.
- 선택적 보고. 검정한 것 중 일부만 보정 대상에 넣으면 \(m\)이 과소평가된다.
가장 흔한 실패 — \(m\)의 과소평가.
실제로 30개를 검정했는데 논문에는 5개만 실으면서 "\(m=5\)로 본페로니 보정"을 한다면, 실제 FWER은 통제되지 않는다. 이것은 절차의 문제가 아니라 정직성의 문제다.
로버스트성을 높이는 방법.
| 문제 | 대처 |
|---|---|
| 개별 \(p\)의 부정확 | 순열·부트스트랩 기반 \(p\) |
| 종속 구조 불명 | 홀름(항상 타당) 또는 순열 |
| 이산성 | 이산성 반영 보정, 중간-\(p\) |
| \(m\)의 정의 | 사전등록으로 고정 |
| 모형 오설정 | 로버스트 표준오차, 민감도 분석 |
한 문장. 보정 절차는 개별 \(p\) 값이 타당하다는 전제 위에 선다. 그 전제를 점검하지 않고 보정만 정교하게 하는 것은 기초가 부실한 집에 지붕을 올리는 일이다.
연습문제 10. 닫힌 검정 원리를 설명하고, 그것이 홀름 절차를 어떻게 정당화하는지 보여라.
풀이
닫힌 검정 원리(마커스·페리츠·가브리엘). 가설족 \(\{H_1,\dots,H_m\}\)에 대해 모든 교집합 가설
을 각각 수준 \(\alpha\)로 검정한다. 그리고
\(H_i\)를 기각한다 \(\iff\) \(i\)를 포함하는 모든 \(H_I\)가 수준 \(\alpha\)에서 기각된다
로 정한다. 이 절차는 FWER을 강하게 통제한다.
증명. 참인 가설의 집합을 \(I_0\)라 하자. \(H_{I_0}\)는 참이므로 그것을 기각할 확률이 \(\alpha\) 이하다. 그런데 참인 \(H_i\)(\(i\in I_0\))를 하나라도 기각하려면 \(H_{I_0}\)도 기각해야 한다(\(I_0\ni i\)이므로). 따라서
놀랍도록 단순한 논증이며, 개별 검정에 아무 보정도 요구하지 않는다는 점이 핵심이다.
홀름과의 연결. 교집합 가설 \(H_I\)를 본페로니로 검정한다고 하자. 즉 \(\min_{i\in I}p_i\le\alpha/|I|\)이면 \(H_I\)를 기각한다. 그러면 닫힌 절차가 정확히 홀름 절차가 된다.
왜인가. \(p_{(1)}\le\cdots\le p_{(m)}\)에서 \(H_{(k)}\)를 기각하려면, \((k)\)를 포함하는 모든 \(I\)에 대해 \(\min_{i\in I}p_i\le\alpha/|I|\)여야 한다. 가장 까다로운 \(I\)는 \(\{(k),(k+1),\dots,(m)\}\)이며 크기가 \(m-k+1\)이다. 그 조건이
로, 홀름의 기각 기준과 같다. 게다가 \((k)\)보다 작은 \(p\)들도 각자의 조건을 만족해야 하므로 "순차적으로 멈춤"이 나온다.
이 틀이 주는 것.
| 교집합 검정 | 나오는 절차 |
|---|---|
| 본페로니 | 홀름 |
| 심스 | 호멜 |
| 최대 통계량(순열) | 웨스트폴–영 |
| \(F\) 검정 | 셰페와 관련 |
| 고정 순서 | 고정 순서 절차 |
더 강한 교집합 검정을 쓰면 더 강력한 절차가 나온다. 이것이 닫힌 원리의 실용적 가치다.
계산의 문제. \(2^m-1\)개의 교집합 가설이 있어 \(m\)이 크면 불가능하다. 다행히 위의 방법들은 단축 알고리즘이 있어 \(O(m\log m)\)에 계산된다. 일반적인 경우에는 \(m\le20\) 정도가 한계다.
연습문제 11. \(m\)개 검정이 독립일 때 가족단위 오류율이 \(\text{FWER} = 1 - (1 - \alpha)^m\)을 만족함을 증명하라. 검정이 양의 상관을 가지면 어떻게 되는가?
풀이
모든 귀무가설이 참이라고 하자. 검정 하나가 잘못 기각하지 않을 확률이 \(1-\alpha\) 이므로, 독립일 때 \(m\)개 검정이 모두 올바르게 기각하지 않을 확률은 그 곱인 \((1-\alpha)^m\)이다. 여집합 법칙에 의해,
검정이 양의 상관을 가지면 아무것도 기각하지 않을 결합확률이 \((1-\alpha)^m\)보다 커지므로 실제 FWER은 독립 공식이 예측하는 것보다 작다. 이 경우 독립 가정이 FWER의 상한을 준다. \(\square\)
연습문제 12. 하위집단 분석의 다중성 문제를 다루고, 상호작용 검정과 무엇이 다른지 밝혀라.
풀이
흔한 잘못. 전체에서는 유의하지 않았는데 "여성에서만 유의했다"고 보고하는 것이다.
문제 1 — 다중성. 하위집단이 \(k\)개면 검정이 \(k\)개다.
import numpy as np
from scipy import stats

rng = np.random.default_rng(66)
M, n, k = 20_000, 200, 5        # 하위집단 5개, 전체 n명

cnt = 0
for _ in range(M):
    sub = rng.integers(0, k, n)
    g = rng.integers(0, 2, n)
    y = rng.normal(0, 1, n)      # 효과 전혀 없음
    for s in range(k):
        msk = sub == s
        if msk.sum() > 10 and len(np.unique(g[msk])) == 2:
            if stats.ttest_ind(y[msk & (g == 0)],
                               y[msk & (g == 1)]).pvalue < 0.05:
                cnt += 1
                break
print(f"하위집단 {k}개 중 하나라도 유의할 확률: {cnt / M:.4f}")
하위집단 5개 중 하나라도 유의할 확률: 0.2227
명목 5%가 22%다.
문제 2 — 검정력. 하위집단의 표본이 작아 검정력이 낮다. 9.5절 검정력 분석 연습문제 15 가 정의하는 M-오류(유의한 결과만 모았을 때 효과크기가 과장되는 비)로 효과가 크게 과장된다.
문제 3 — 잘못된 질문. "여성에서 유의, 남성에서 비유의"는 두 집단의 효과가 다르다는 뜻이 아니다. 9.3절 μ₁−μ₂에 대한 이표본 Z-검정의 상자 「유의한 것과 유의하지 않은 것의 차이」가 보이듯 유의성의 비교는 차이의 검정이 아니다.
올바른 접근 — 상호작용 검정.
에서 \(\beta_3=0\)을 검정한다. 이것이 "효과가 하위집단마다 다른가"라는 질문의 정확한 형태다.
상호작용 검정의 검정력은 매우 낮다. 같은 크기의 차이를 탐지하려면 주효과의 약 네 배 표본이 필요하다.
from scipy import stats

# 주효과 d=0.5 를 검정력 80% 로 탐지하려면 집단당 64명
# 상호작용(두 하위집단의 효과 차이가 0.5)은?
za, zb = stats.norm.ppf(0.975), stats.norm.ppf(0.80)
n_main = 2 * (za + zb)**2 / 0.5**2
n_inter = 4 * n_main            # 상호작용의 분산이 4배
print(f"주효과: 집단당 {n_main:.0f}명,  상호작용: 집단당 {n_inter:.0f}명")
주효과: 집단당 63명, 상호작용: 집단당 251명
네 배다. 상호작용 항의 추정량이 네 집단 평균의 차이의 차이라 분산이 네 배이기 때문이다.
실무 지침.
- 하위집단을 사전에 정의하고 개수를 밝힌다.
- 상호작용 검정을 먼저 한다. 유의하지 않으면 하위집단별 결과는 탐색적이다.
- 하위집단별 효과크기와 구간을 숲그림(forest plot)으로 제시한다. \(p\) 값보다 유익하다.
- 전체 효과를 주 결과로 삼는다. 하위집단 결과는 보조.
- 생물학적·이론적 근거가 있는 하위집단만 사전 지정한다.
유명한 사례. 한 대규모 심혈관 시험에서 별자리별 하위집단 분석을 수행해, 특정 별자리에서는 아스피린의 효과가 나타나지 않는다는 결과를 내보였다. 하위집단 분석의 위험을 보여 주려는 의도적 예시였다.
연습문제 13. 메타분석에서의 다중성 문제를 정리하라. 여러 연구를 합칠 때 무엇을 조심해야 하는가?
풀이
메타분석이 다중성을 해결하는 면.
- 여러 연구를 합치면 검정력이 오른다. 개별 연구의 낮은 검정력 문제를 완화한다.
- 효과크기의 추정이 안정된다. M-오류가 줄어든다.
그런데 새로운 다중성이 생긴다.
1 — 출판 편향. 유의한 연구만 발표되면 메타분석의 요약 효과가 부풀려진다.
import numpy as np
from scipy import stats

rng = np.random.default_rng(100)
K, n = 30, 40                      # 연구 30개, 각 집단당 20명
true_d = 0.2
ds, ses, pubs = [], [], []
for _ in range(K):
    x = rng.normal(0, 1, n // 2)
    y = rng.normal(true_d, 1, n // 2)
    sp = np.sqrt((x.var(ddof=1) + y.var(ddof=1)) / 2)
    d = (y.mean() - x.mean()) / sp
    se = np.sqrt(4 / n + d**2 / (2 * n))
    p = stats.ttest_ind(x, y).pvalue
    ds.append(d)
    ses.append(se)
    pubs.append(p < 0.05)
ds, ses, pubs = np.array(ds), np.array(ses), np.array(pubs)

def meta(d, se):
    w = 1 / se**2
    return (w * d).sum() / w.sum()

print(f"참 효과크기 {true_d}")
print(f"모든 연구 포함  {meta(ds, ses):.4f}  (K={K})")
print(f"유의한 것만     {meta(ds[pubs], ses[pubs]):.4f}  (K={pubs.sum()})")
참 효과크기 0.2
모든 연구 포함  0.1308  (K=30)
유의한 것만     0.7115  (K=3)
유의한 연구만 합치면 0.71로 참값의 3.6배가 된다. 모든 연구를 합치면 0.131로 참값 근처다(연구 30개로도 추정오차가 남는다).
2 — 같은 자료의 중복 계산. 한 연구가 여러 논문으로 쪼개져 발표되면 이중으로 셈된다.
3 — 결과변수 선택. 각 연구에서 여러 결과변수 중 하나를 고르면, 그 선택이 편향을 낳는다.
4 — 하위집단 메타분석. 여러 조절변수를 훑으면 다중성 문제가 재현된다.
5 — 누적 메타분석. 연구가 추가될 때마다 다시 분석하면 임의 중단(optional stopping, 이 절의 분석의 자유는 곱해진다 \(\S 3\))과 같은 구조가 된다. 순차 메타분석 방법(trial sequential analysis, TSA)이 이를 다룬다.
대처.
| 문제 | 대처 |
|---|---|
| 출판 편향 | 깔때기 그림, 트림앤필, 선택모형, 미발표 연구 수집 |
| 중복 | 저자·표본 확인 |
| 결과변수 선택 | 프로토콜에서 결과변수를 사전 정의 |
| 조절변수 다중성 | 사전 정의, 보정, 메타회귀 |
| 누적 분석 | 순차 경계(TSA) |
가장 효과적인 것 — 등록. 임상시험 등록 의무화 이후 메타분석의 신뢰도가 크게 올랐다. 미발표 자료를 포함하는 것이 어떤 통계적 보정보다 낫다.
한 문장. 메타분석은 문헌의 편향을 증폭할 수도, 교정할 수도 있다. 어느 쪽이 될지는 포함 기준과 검색의 철저함이 결정한다.
정리하며
검정을 여러 번 하면 적어도 하나가 틀릴 확률이 빠르게 커진다.
- \(m=20\) 이면 \(0.64\) 다. 모든 귀무가설이 참인데도 세 번 중 두 번은 "유의한 발견"이 하나 나온다. 검정 하나의 \(5\%\) 가 문제가 아니다.
- \(m\) 이 커지면 \(1\) 에 붙는다. 전장유전체 연관분석처럼 \(m\) 이 수십만이면 보정 없는 결과는 전부 잡음이라고 보아야 한다.
- \(p\)-해킹과 다른 문제다. 해킹은 자료를 본 뒤의 선택이 원인이고 — 고의가 아니어도 일어난다 — 몇 번 시도했는지가 보고되지 않아 \(m\) 을 모른다. FWER 증가는 \(m\) 을 숨김없이 밝히고 여러 번 검정하기만 해도 생긴다.
- "가족"의 범위를 정하는 것이 실무의 어려움이다. 한 논문의 모든 검정인가, 한 표의 검정들인가, 한 연구 프로그램 전체인가. 답이 하나가 아니며, 미리 정해 밝혀야 한다.
- 독립이 아니면 공식이 달라진다. 검정들이 양의 상관을 가지면 실제 FWER 은 위 값보다 작다.
다음 절 본페로니와 홀름 보정에서 이를 통제하는 방법을 다룬다.