Patsy를 이용한 스플라인
개요
훈련한 스플라인 모형으로 새 자료를 예측할 때 식 문자열로 설계행렬을 한 번 더 만들면, patsy 는 새로 넘긴 자료로 매듭을 다시 계산한다. 그렇게 짝이 어긋난 기저에 계수를 곱해 얻은 예측은 올바른 예측과 \(39{,}608\) 달러까지 벌어진다 — 예측값 전체의 폭 \(194{,}087\) 달러의 \(20\%\) 다. 그런데 출력은 형태가 멀쩡한 수 \(300\) 개이고 그려 보면 곡선도 매끄럽다. 기저를 어떻게 만들었는지가 이렇게까지 결과를 가른다면, 매듭과 자유도와 기저의 종류는 각각 무엇을 정하는 것인가.
이 페이지는 patsy의 식 인터페이스로 B-스플라인과 자연 스플라인 기저행렬을 만들어 스플라인 회귀를 수행하는 방법을 보인다. King County 주택 자료를 써서 B-스플라인, 자유도를 달리한 자연 스플라인, 사용자 지정 매듭 배치를 비교하고, 이 유연한 방법들을 선형·다항 회귀와 대조한다.
1. 수학적 배경 — B-스플라인과 자연 스플라인
그림으로 보는 통계학 1. 굽히는 자가 곡선을 정하던 때
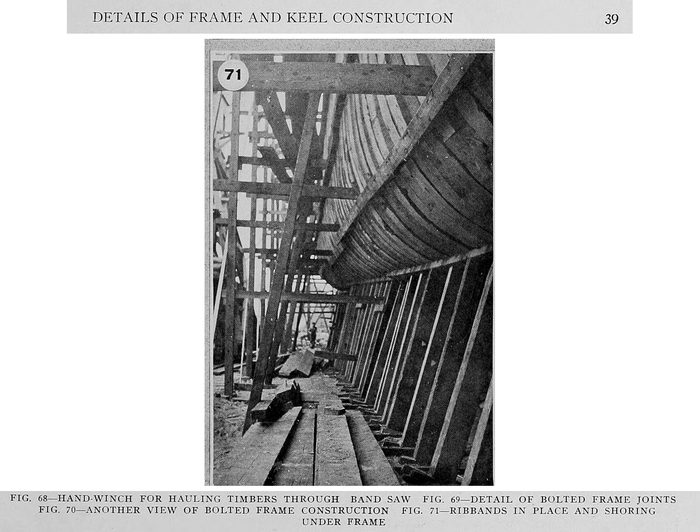
에스텝 『목조선은 어떻게 짓는가』(\(1918\)) 인쇄 쪽 \(39\). 머리글의 쪽 번호와 사진 설명 「FIG. \(71\)—RIBBANDS IN PLACE AND SHORING UNDER FRAME」이 읽힌다. 세워 놓은 늑골 위로 리밴드라 부르는 길고 가는 나무오리가 지나가며 선체의 곡선을 잡아 준다. (Internet Archive · 저작권 없음)
스플라인이라는 낱말은 수학에서 나오지 않았다. 얇고 긴 자의 이름이고, 그 자를 굽혀 곡선을 긋던 일터가 배를 짓는 자리였다.
배의 곡면은 식으로 주어지지 않는다. 설계도에 적히는 것은 몇몇 자리에서 잰 점뿐이고, 그 점들 사이를 어떻게 이을지는 따로 정해야 한다. 같은 책이 그 방법을 이렇게 적는다 — 나무자나 쇠자가 가진 「고른 곡선으로 휘는 성질」(bending in a fair curve)을 끌어다 쓴다고. 얇고 긴 자를 바닥에 놓고 점들을 지나도록 굽힌 뒤, 그 자를 따라 선을 긋는 것이다. 책의 다른 대목은 더 간결하다 — 「얇은 자를 점들을 지나가도록 매끄럽게 놓고, 그렇게 얻은 선을 그어 넣는다.」
사진의 리밴드는 그 일을 종이가 아니라 실물 크기로 하는 모습이다. 늑골 수십 개가 점의 구실을 하고, 그 위를 지나는 가는 나무오리가 선을 정한다.
굽은 자가 왜 하필 매끄러운 곡선이 되는지에는 까닭이 있다. 가는 자는 휘는 데 드는 힘을 가장 적게 쓰는 모양을 저절로 찾아가고, 휘는 정도가 작을 때 그 모양은 점과 점 사이에서 삼차식이 된다. 아래에서 조각마다 삼차식을 쓰고 매듭에서만 이어 붙이는 까닭이 여기에 있고, 이름을 그 자에서 따온 까닭도 여기에 있다.
여기에 자유도로 이어지는 교훈도 하나 있다. 점을 많이 찍는다고 선이 좋아지지는 않는다. 자를 억지로 많은 점에 맞추면 점과 점 사이가 물결치기 시작하고, 조선소에서는 그런 자리를 「fair 하지 않다」고 하여 점을 고쳐 찍었다. 다항식 하나로 모든 점을 지나게 할 때 차수가 올라가며 곡선이 흔들리는 것과 똑같은 일이고, 아래 「자유도」가 세는 것이 바로 그 변동의 여지다. 배를 짓던 사람들은 식을 세우지 않고도 그 사실을 알고 있었다.
확인한 곳 — 쪽 번호 \(39\) 와 사진 설명 「FIG. \(71\)—RIBBANDS IN PLACE AND SHORING UNDER FRAME」은 Internet Archive 의 \(1918\) 년 판 스캔(0-based leaf n55 = 인쇄 쪽 \(39\))에서 직접 읽었다. 「the property which a wooden or metallic batten has of bending in a fair curve」, 「a thin batten is set so it can pass fairly through the spots and the line so found is rased in」, 그리고 「Hence a fairing or correcting process has to be performed」는 같은 책 전문 OCR 에서 찾았다. 다만 이 책은 그 자를 batten 이라고만 부르고 spline 이라는 낱말은 한 번도 쓰지 않는다 — 자의 이름이 수학의 이름이 된 사정은 Wikipedia 「Spline (mathematics)」 와 「Flat spline」에서 확인했다(휘는 데 드는 힘이 가장 적은 모양을 자가 저절로 찾는다는 것도 뒤 문서에 있다).
B-스플라인(기저 스플라인)
매듭이 \(\xi_1 < \cdots < \xi_K\)인 \(d\)차 B-스플라인은 각 매듭에서 \((d-1)\)번 연속미분 가능한 조각별 다항식이다. 회귀모형은
여기서 \(B_{m,d}\)는 B-스플라인 기저함수이다. 기저함수의 개수는 \(K + d + 1\)이다(내부 매듭 + 차수 + 1).
자연 스플라인
자연 삼차 스플라인은 경계 매듭 바깥에서 \(f(x)\)가 선형이라는 제약을 추가한다. 이 제약이 자유도를 4만큼 줄이고(각 경계에서 \(f'' = 0\)과 \(f''' = 0\), 두 경계에 각각 두 개) 외삽 거동을 훨씬 안정적으로 만든다.
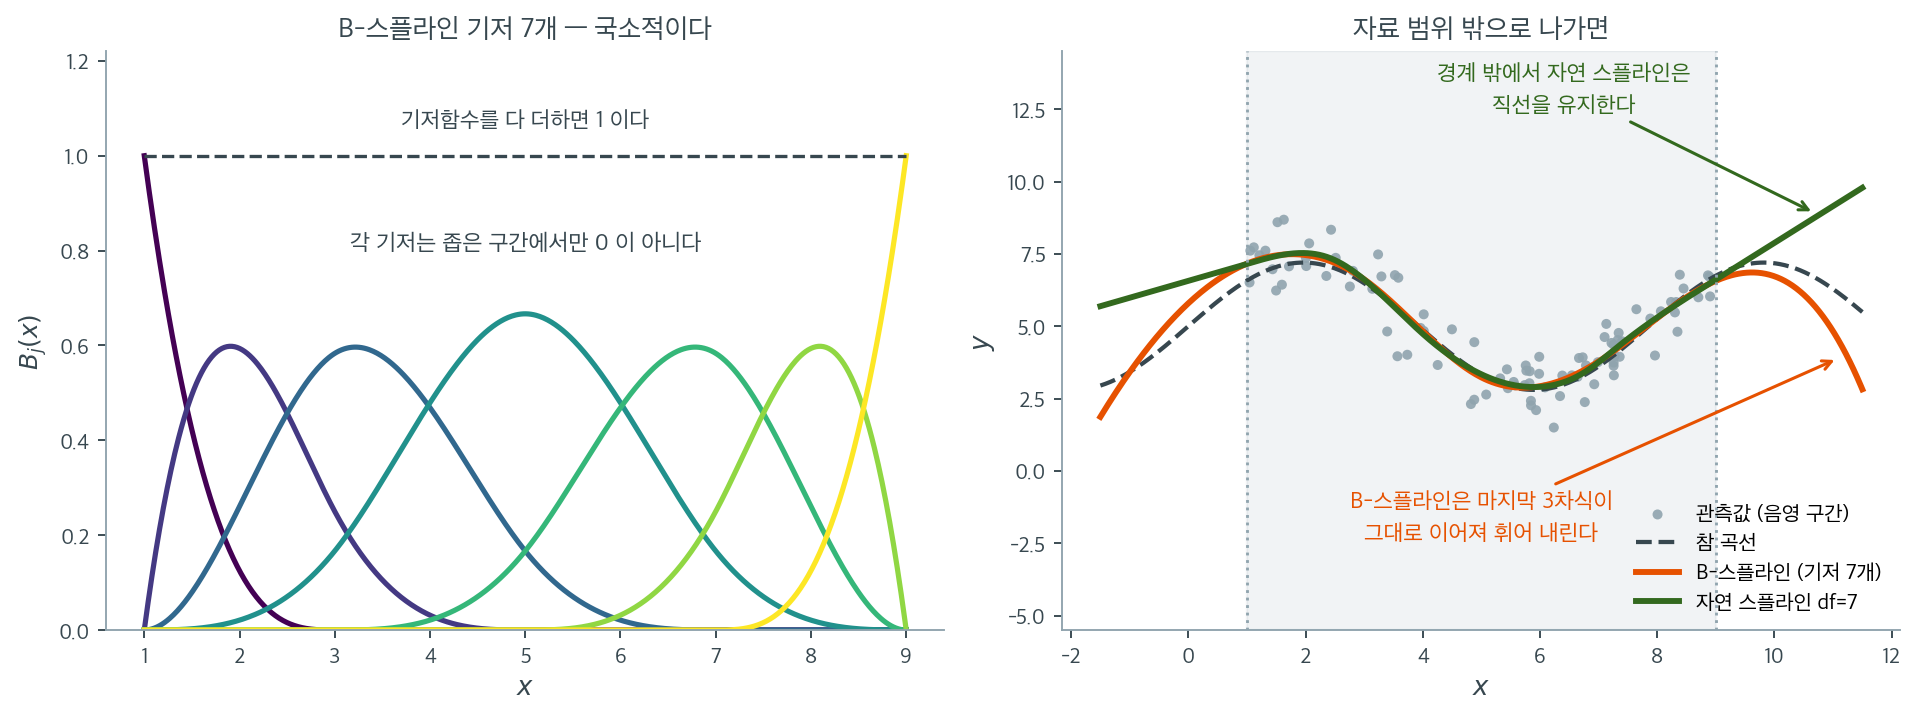
왼쪽이 "B-스플라인 기저"라는 말의 그림이다. 구간 \([1, 9]\)에 \(3\)차 B-스플라인 기저 \(7\)개를 그렸다. 각 봉우리가 기저함수 하나이며, 저마다 좁은 구간에서만 0이 아니다. 이것이 고차 다항식과 갈라지는 지점이다. \(x^{10}\) 같은 항은 정의역 전체에서 값을 가지므로 한쪽 끝의 관측값 하나가 반대쪽 끝의 적합까지 흔들지만, B-스플라인은 어떤 \(x\) 근처의 자료가 서너 개 기저의 계수에만 영향을 준다. 검은 점선이 보여 주듯 기저함수를 모두 더하면 항상 \(1\)이 되는데, 이 성질 덕분에 계수들이 곧 곡선의 국소적인 높이처럼 행동한다.
오른쪽이 자연 스플라인의 제약이 무엇을 하는지다. 회색 음영이 자료가 있는 \([1.05,\ 8.90]\) 구간이고, 두 스플라인 모두 그 안에서는 참 곡선을 거의 똑같이 따라간다. 훈련 RMSE도 \(0.680\)과 \(0.678\)로 차이가 없다. 갈라지는 것은 밖으로 나간 뒤다. 주황색 B-스플라인은 경계에서 마지막 \(3\)차식이 그대로 이어지므로 위로 솟았다가 아래로 꺾여 내려간다. \(x = 11.5\)에서 예측이 \(2.82\)인데 참값은 \(5.49\)다. 초록색 자연 스플라인은 경계 매듭 바깥에서 \(f'' = 0\)이라는 제약을 받아 직선으로 뻗는다. 같은 자리에서 예측이 \(9.79\)로, 이쪽도 참값에서 멀지만 적어도 곡선이 폭주하지는 않는다.
이 대비가 "자유도를 \(4\)만큼 쓰고 대신 안정성을 산다"는 자연 스플라인의 거래다. \(3\)차식이 통제 없이 뻗어 나가는 쪽과 직선이 뻗어 나가는 쪽 가운데, 외삽의 위험이 훨씬 작은 것은 후자다. 물론 어느 쪽이든 자료 범위 밖의 예측은 믿을 것이 못 된다는 점은 같다. 자연 스플라인은 그 오차가 폭발하지 않도록 막아 줄 뿐이다.
자유도 — 유연성을 조절하는 손잡이
스플라인의 자유도(df)가 유연성을 조절한다.
- B-스플라인: \(\mathrm{df} = K + d + 1 - 1\) (기저함수 개수에서 절편(intercept)을 뺀 것)
- df가 클수록 더 요동치는 적합이 가능하다
- 최적 df는 교차검증(cross-validation)으로 고를 수 있다
AI로 보는 통계학 1. 화면의 곡선이 하필 삼차인 까닭
삼차함수 \(ax^{3}+bx^{2}+cx+d\) 는 계수가 넷이므로 독립인 조건 넷이면 하나로 정해진다. 이 셈이 스플라인의 차수를, 그리고 화면에 그려지는 거의 모든 곡선의 차수를 정해 놓았다.
글꼴의 외곽선도, 움직임이 빨라졌다 느려지는 가속 곡선도, 짧은 조각을 이어 붙여 만든다. 이을 때 지켜야 할 것이 둘이다 — 이음매에서 높이가 같아야 끊기지 않고, 기울기도 같아야 꺾이지 않는다. 그러면 조각 하나가 받아야 할 조건은 양 끝에서 높이와 기울기, 모두 넷이다. 거꾸로 읽으면 그 넷을 모두 받아 줄 수 있는 가장 낮은 차수가 삼이다. 이차식은 계수가 셋뿐이라 모자라고, 사차식은 하나가 남아 모양이 정해지지 않는다.
import numpy as np

def cubic_from(p0, m0, p1, m1):
    """f(0)=p0, f'(0)=m0, f(1)=p1, f'(1)=m1 을 만족하는 삼차함수의 계수."""
    A = np.array([[0, 0, 0, 1],      # f(0)  = d
                  [0, 0, 1, 0],      # f'(0) = c
                  [1, 1, 1, 1],      # f(1)  = a+b+c+d
                  [3, 2, 1, 0]])     # f'(1) = 3a+2b+c
    return np.linalg.solve(A, [p0, m0, p1, m1])   # [a, b, c, d]

A = np.array([[0,0,0,1],[0,0,1,0],[1,1,1,1],[3,2,1,0]])
print("네 조건의 계수행렬 — 행렬식 =", round(np.linalg.det(A), 10), "(0 이 아니므로 꼭 하나)")
print()
for name, cond in (("높이만 0→1, 기울기 0", (0,0,1,0)),
                   ("높이 0→1, 기울기 1→1", (0,1,1,1)),
                   ("높이 2→2, 기울기 3→-3", (2,3,2,-3))):
    a,b,c,d = cubic_from(*cond)
    chk = (np.polyval([a,b,c,d],0), np.polyval([3*a,2*b,c],0),
           np.polyval([a,b,c,d],1), np.polyval([3*a,2*b,c],1))
    print(f"{name:22s} f = {a:5.1f}x³ {b:+5.1f}x² {c:+5.1f}x {d:+5.1f}"
          f"   되넣어 보면 {tuple(round(v,6) for v in chk)}")
print()
print("  3 조건 계수행렬의 계수(rank) =", np.linalg.matrix_rank(A[:3]), "< 4")
실행하면 다음이 나온다.
네 조건의 계수행렬 — 행렬식 = 1.0 (0 이 아니므로 꼭 하나)

높이만 0→1, 기울기 0         f =  -2.0x³  +3.0x²  +0.0x  +0.0   되넣어 보면 (0.0, 0.0, 1.0, 0.0)
높이 0→1, 기울기 1→1        f =   0.0x³  +0.0x²  +1.0x  +0.0   되넣어 보면 (0.0, 1.0, 1.0, 1.0)
높이 2→2, 기울기 3→-3       f =   0.0x³  -3.0x²  +3.0x  +2.0   되넣어 보면 (2.0, 3.0, 2.0, -3.0)

  3 조건 계수행렬의 계수(rank) = 3 < 4
계수행렬의 행렬식이 \(1\) 이니 어떤 네 수를 주어도 삼차함수가 꼭 하나 나온다. 첫 줄의 \(-2x^{3}+3x^{2}\) 이 양 끝에서 기울기가 \(0\) 인 채 \(0\) 에서 \(1\) 로 올라가는 곡선 — 화면에서 부드럽게 시작해 부드럽게 멈추는 움직임이 이것이다.
둘째 줄에서 \(a=b=0\) 이 되어 직선 \(y=x\) 가 나온 것도 같은 셈 그대로다. 이 셈이 말하는 것은 「삼차식이 된다」가 아니라 계수 넷이 정해진다는 것이고, 그 모임은 이차·일차·상수까지 품는다. 자연 스플라인이 경계 밖에서 직선으로 뻗는 것도 이 모임 안의 일이다. 그리고 조건을 하나 빼면 계수행렬의 rank 가 \(3\) 이라 해가 무수히 많다 — 조건이 넷보다 적으면 하나로 정해지지 않는다는 말이 그 자리다.
다만 이음매에서 휘는 정도까지 맞추려 들면 조각마다 조건이 여섯이 되어 삼차로는 모자란다. 그래서 더 매끄러운 이음이 필요한 곳에서는 차수를 올리거나, 조각마다 따로 풀지 않고 전체를 한꺼번에 푸는 쪽으로 간다. 위의 B-스플라인이 바로 그 한꺼번에 푸는 쪽이고, 그래서 삼차인데도 매듭에서 \(d-1=2\) 번까지 연속미분이 된다. 조건을 하나하나 끼워 맞추는 대신 기저 \(K+d+1\) 개의 계수를 최소제곱으로 한 번에 정하는 것이며, 그 개수에서 절편 하나를 뺀 것이 바로 위의 자유도 \(\mathrm{df}\) 다. 삼차가 널리 쓰이는 까닭은 가장 좋아서가 아니라 끊김과 꺾임만 막는 데 드는 최소이기 때문이다.
Patsy 문법
bs(x, df=4, degree=3): 자유도 4의 삼차 B-스플라인bs(x, knots=[20, 40, 60]): 내부 매듭을 지정한 B-스플라인cr(x, df=4): 자유도 4의 자연 삼차 회귀 스플라인
2. 자료
세 페이지가 공유하는 King County(시애틀) 주택 매매 자료를 읽는다.
보기 1. 주택 자료 읽기. 이 쪽과 뒤의 두 쪽이 공유하는 King County 매매 자료를 읽어 가격·면적·건축연도의 요약표를 본다.
(1) 요약표의 평균과 중앙값만으로 AdjSalePrice의 왜도(skewness)를 읽으시오. 최솟값과 최댓값에서 걸리는 것이 있는가.
(2) 나이–가격 관계를 스플라인으로 다룰 때 YrBuilt가 설명변수(explanatory variable)로 적당한 까닭을 요약표의 수로 말하고, 매듭을 놓을 때 걸림돌이 될 만한 것을 하나 짚으시오.
풀이
유도할 식이 없는 보기다. 자료를 읽어 들이는 것이 전부이므로, 요약표에서 실제로 읽히는 수를 따라간다.
import pandas as pd

# "Practical Statistics for Data Scientists" 저장소의 자료. 탭으로 구분되어 있다.
url = ("https://raw.githubusercontent.com/gedeck/"
       "practical-statistics-for-data-scientists/8a6d3bb6468e979c861d4b37215e1413702dfdfa/data/house_sales.csv")
house = pd.read_csv(url, sep='\t')

print(f"{len(house)}건, 열 {house.shape[1]}개")
print(house[['AdjSalePrice', 'SqFtTotLiving', 'YrBuilt']].describe().round(1).to_string())
출력:
22687건, 열 22개
       AdjSalePrice  SqFtTotLiving  YrBuilt
count       22687.0        22687.0  22687.0
mean       565233.3         2080.2   1971.2
std        385402.9          913.7     30.3
min          3368.0          370.0   1900.0
25%        360563.0         1420.0   1950.0
50%        471315.0         1910.0   1977.0
75%        649411.0         2540.0   2000.0
max      11644855.0        10740.0   2015.0
요약표가 말하지 않는 몇 가지를 더 찍어 둔다.
import numpy as np
from scipy import stats

price = house['AdjSalePrice'].values
age = 2024 - house['YrBuilt'].values

print(f"평균/중앙값 = {price.mean() / np.median(price):.3f},  최댓값/중앙값 = {price.max() / np.median(price):.1f}")
print(f"가격 왜도 = {stats.skew(price):.2f}")
yrs = np.unique(house['YrBuilt'])
print(f"서로 다른 건축연도 {yrs.size}개, 빠진 해 {len(set(range(1900, 2016)) - set(yrs.tolist()))}개")
counts = house['YrBuilt'].value_counts()
print(f"연도별 건수 최소 {counts.min()}({counts.idxmin()}) ~ 최대 {counts.max()}({counts.idxmax()})")
print(f"나이 20년 이하 {(age <= 20).sum()}건,  100년 이상 {(age >= 100).sum()}건")
출력:
평균/중앙값 = 1.199,  최댓값/중앙값 = 24.7
가격 왜도 = 5.85
서로 다른 건축연도 116개, 빠진 해 0개
연도별 건수 최소 20(2015) ~ 최대 1266(2006)
나이 20년 이하 4170건,  100년 이상 2256건
(1) 가격은 오른쪽으로 크게 치우쳐 있다. 평균 565,233 달러가 중앙값 471,315 달러의 \(1.199\) 배다. 평균이 중앙값보다 크다는 것만으로도 오른쪽 꼬리를 짐작하지만, 왜도의 정도는 끝값이 말해 준다. 최댓값 11,644,855 달러는 중앙값의 \(24.7\) 배이고, 표본왜도는 \(5.85\) 다. 대칭분포라면 \(0\) 이어야 하는 값이다.
최솟값 3,368 달러는 정상 매매로 보기 어렵다. 370 평방피트짜리 집이라도 시애틀 권역에서 이 값에 거래되지는 않는다. 가족 간 명의 이전이나 기록 오류일 것이다. 이런 값은 그대로 두면 회귀의 왼쪽 끝을 끌어내린다.
주의할 것은 스플라인이 왜도를 고쳐 주지 않는다는 점이다. 스플라인은 설명변수 쪽을 유연하게 만드는 장치이고, 적합하는 것은 여전히 조건부 평균이다. 꼬리가 긴 반응변수에는 \(\log\) 변환이 따로 필요하다.
(2) YrBuilt는 빈틈이 없다. 1900 년부터 2015 년까지 서로 다른 연도가 \(116\) 개 있고, 그 사이에 빠진 해가 하나도 없다. 곧 나이가 \(9\) 년부터 \(124\) 년까지 정수 전체를 덮는다. 매듭을 어디에 놓아도 그 좌우에 자료가 있으므로, 분위수(quantile) 매듭이든 지정 매듭이든 안전하게 쓸 수 있다. 표준편차 \(30.3\) 년이라는 넓은 산포도 유연한 적합을 받쳐 준다.
걸림돌은 건수가 연도마다 고르지 않다는 것이다. 2015 년생 집은 \(20\) 건뿐인데 2006 년생은 \(1{,}266\) 건으로 \(63\) 배 차이가 난다. 나이 \(20\) 년 이하가 \(4{,}170\) 건, \(100\) 년 이상이 \(2{,}256\) 건이니 경계 쪽이 가운데보다 성기다. 자료가 성긴 곳에서는 매듭을 촘촘히 놓아도 계수의 표준오차가 커진다. 경계에서 3차식이 폭주하는 문제가 바로 여기서 생기며, 자연 스플라인의 선형 제약이 그것을 겨냥한 장치다(보기 4).
B-스플라인 회귀
보기 2. B-스플라인 기저 만들기. bs(age, df=4, degree=3, include_intercept=False)로 기저행렬을 만들어 가격에 회귀한다.
(1) 이 식이 만드는 기저 열의 개수와 내부 매듭의 개수를 손으로 세시오. patsy 는 그 매듭을 어디에 놓겠는가.
(2) 코드를 돌려 설계행렬의 모양과 patsy 가 실제로 쓴 매듭벡터를 꺼내, (1)의 답과 맞는지 확인하시오.
풀이
(1) 해석적으로. \(d\) 차 B-스플라인에서 내부 매듭이 \(K\) 개이면 기저함수는
개다. 쪽머리의 식 그대로다. patsy 의 df 는 절편을 뺀 열 개수를 뜻하므로
이고, 여기서 \(\mathrm{df} = 4\), \(d = 3\) 이니
내부 매듭은 하나다. 그러므로 기저 열은 \(K + d = 4\) 개다. 이것이 df 와 같은 수인 것은 우연이 아니라 df 의 정의다.
내부 매듭이 하나이면 patsy 는 그것을 자료의 중앙값에 놓는다. 내부 매듭 \(K\) 개를 \(0, 100\) 을 뺀 등간격 분위수에 두는 규칙이므로, \(K = 1\) 일 때 그 분위수는 \(50\%\) 뿐이다.
매듭벡터의 길이도 미리 알 수 있다. B-스플라인을 계산하려면 양 끝의 경계매듭을 각각 \(d + 1\) 번 겹쳐 적어야 하므로
개가 나열된다.
(2) 수치적으로. patsy 는 매듭을 design_info 안에 기억해 두므로 꺼내 볼 수 있다.
import numpy as np
import pandas as pd
from patsy import dmatrix, build_design_matrices
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score, mean_squared_error

# 건축연도 대신 집의 나이를 쓴다. 나이와 가격의 관계는 직선이 아니다.
age = 2024 - house['YrBuilt'].values
df = pd.DataFrame({'age': age, 'price': house['AdjSalePrice'].values})

# patsy 의 bs() 가 B-스플라인 기저를 만들어 준다. df=4 면 매듭을 자료의
# 분위수에 맞춰 알아서 놓는다. 끝의 -1 은 patsy 가 붙이는 절편을 빼는 것이고,
# 절편은 아래 LinearRegression 이 따로 넣는다.
bs_design = dmatrix("bs(age, df=4, degree=3, include_intercept=False) - 1",
                    {"age": df['age']}, return_type='dataframe')
bs_model = LinearRegression().fit(bs_design, df['price'])
bs_r2 = r2_score(df['price'], bs_model.predict(bs_design))
def patsy_knots(design):
    """patsy 가 design_info 에 기억해 둔 매듭벡터를 꺼낸다."""
    info = list(design.design_info.factor_infos.values())[0]
    return list(info.state['transforms'].values())[0]._all_knots

print("기저 열 개수 =", bs_design.shape[1])
print("매듭벡터     =", patsy_knots(bs_design), "  길이", len(patsy_knots(bs_design)))
print(f"내부 매듭 {patsy_knots(bs_design)[4]:.0f},  나이의 중앙값 {np.median(df['age']):.0f}")
print(f"R^2 = {bs_r2:.4f}")
출력:
기저 열 개수 = 4
매듭벡터     = [  9.   9.   9.   9.  47. 124. 124. 124. 124.]   길이 9
내부 매듭 47,  나이의 중앙값 47
R^2 = 0.0346
셋이 모두 맞는다. 열은 \(4\) 개, 매듭벡터는 길이 \(9\) 로 양 끝의 \(9\) 와 \(124\) 가 각각 네 번 겹쳐 적혀 있고, 가운데 하나뿐인 내부 매듭이 \(47\) 이다. 나이의 중앙값도 \(47\) 이다.
남는 수는 \(R^2 = 0.0346\) 이다. 나이 하나로 가격 변동의 \(3.5\%\) 만 설명한다. 스플라인이 유연하다는 것이 곧 잘 맞는다는 뜻은 아니다. 집값을 가르는 것은 면적과 입지이고 나이는 작은 조각일 뿐이다. 이 쪽에서 비교할 것은 \(R^2\) 의 크기가 아니라 같은 변수를 두고 기저를 바꿀 때 생기는 차이다.
사용자 지정 매듭을 쓰는 B-스플라인
보기 3. 매듭 자리를 직접 정하기. df 대신 knots=[20, 40, 60]을 주어 매듭을 손으로 놓는다.
(1) 이 식이 만드는 기저 열의 개수와 매듭벡터의 길이를 보기 2 의 식으로 예측하시오.
(2) 같은 개수의 열을 자동 배치로도 얻을 수 있다. df=6으로 적합한 것과 \(R^2\) 를 견주어, 열의 개수가 같을 때에도 매듭 자리가 적합을 바꾸는지 확인하시오.
풀이
(1) 해석적으로. 매듭을 직접 주면 df 를 거꾸로 계산하는 셈이다. 내부 매듭이 \(K = 3\) 개, 차수가 \(d = 3\) 이므로 보기 2 의 식에서
곧 열이 \(6\) 개다. 매듭벡터의 길이는
이고, 양 끝의 경계매듭 \(9\) 와 \(124\) 가 각각 네 번, 가운데 \(20, 40, 60\) 이 한 번씩 적힌다.
df=6, degree=3 으로도 열은 똑같이 \(6\) 개가 나온다. 같은 유연성을 두 가지 다른 매듭 배치로 쓰는 것이므로, 둘을 견주면 매듭 자리의 몫만 남는다.
(2) 수치적으로.
# 매듭 자리를 직접 정할 수도 있다. 관계가 꺾인다고 볼 만한 근거가 있으면
# 분위수에 맡기는 것보다 낫다.
knots_custom = [20, 40, 60]
bs_custom_design = dmatrix(
    f"bs(age, knots={knots_custom}, degree=3, include_intercept=False) - 1",
    {"age": df['age']}, return_type='dataframe'
)
bs_custom_model = LinearRegression().fit(bs_custom_design, df['price'])
print("기저 열 개수 =", bs_custom_design.shape[1])
print("매듭벡터     =", patsy_knots(bs_custom_design))
print(f"지정 매듭 [20, 40, 60]  R^2 = "
      f"{r2_score(df['price'], bs_custom_model.predict(bs_custom_design)):.4f}")

# 열 개수가 같은 자동 배치와 견준다.
auto6 = dmatrix("bs(age, df=6, degree=3, include_intercept=False) - 1",
                {"age": df['age']}, return_type='dataframe')
auto6_model = LinearRegression().fit(auto6, df['price'])
print(f"자동 매듭 {patsy_knots(auto6)[4:7]}  R^2 = "
      f"{r2_score(df['price'], auto6_model.predict(auto6)):.4f}")
출력:
기저 열 개수 = 6
매듭벡터     = [  9   9   9   9  20  40  60 124 124 124 124]
지정 매듭 [20, 40, 60]  R^2 = 0.0352
자동 매듭 [24. 47. 74.]  R^2 = 0.0349
열 개수와 매듭벡터는 예측한 \(6\) 과 길이 \(11\) 이 그대로 나왔다.
\(R^2\) 는 지정 매듭이 \(0.0352\), 자동 매듭이 \(0.0349\) 다. 열의 개수가 같아도 매듭 자리가 적합을 바꾼다. 다만 바뀌는 폭이 \(0.0003\) 이라는 것도 함께 읽어야 한다. 보기 2 의 \(\mathrm{df} = 4\) 에서 여기 \(\mathrm{df} = 6\) 으로 열을 둘 늘려 얻은 것이 \(0.0346 \to 0.0349\) 였으니, 자유도를 늘려 얻는 몫과 매듭을 옮겨 얻는 몫이 같은 자리 수다.
자동 배치의 매듭은 \(24, 47, 74\) 로 나이의 세 사분위수(quartile)에 놓였고, 지정한 \(20, 40, 60\) 은 그보다 왼쪽으로 쏠려 있다. 나이가 작은 쪽에 자료가 몰려 있으므로(보기 1 에서 \(20\) 년 이하가 \(4{,}170\) 건) 지정 매듭이 집이 많은 구간을 더 촘촘히 나눈 꼴이고, 그만큼 조금 더 맞았다.
다만 이 차이가 의미 있다고 주장하려면 훈련 \(R^2\) 로는 모자란다. 열의 개수가 같아 두 \(R^2\) 를 바로 견줄 수 있다는 것까지는 옳지만, \(0.0003\) 은 표본을 바꾸면 뒤집힐 만한 크기다. 게다가 매듭을 자료를 보고 옮겨 가며 고르면 그것 자체가 선택 과정이므로 훈련 \(R^2\) 는 낙관적이 된다. 매듭 배치를 고르는 일도 교차검증에 맡겨야 한다.
자연 스플라인 회귀
보기 4. 자연 3차 스플라인. cr(age, df=4)로 자연 3차 회귀 스플라인 기저를 만들어 같은 자료에 적합한다.
(1) cr 기저의 네 열을 행마다 더하면 무엇이 되는가. 그것을 보이고, LinearRegression()이 절편을 한 열 더 붙일 때 설계행렬에 무슨 일이 생기는지 말하시오.
(2) 절편을 떼고(fit_intercept=False) 다시 적합하면 계수 네 개가 각각 무엇을 뜻하는지 보이시오. bs(age, df=4)와 \(R^2\) 를 견주어 자연 스플라인의 제약이 적합에 얼마를 물리는지도 적으시오.
풀이
(1) 해석적으로 — cr 의 네 열은 더하면 1 이다. patsy 의 cr 은 매듭 \(\xi_1 < \cdots < \xi_m\) 에서
이 되도록 고른 기저다. 곧 \(j\) 번째 기저함수는 \(j\) 번째 매듭에서 \(1\), 나머지 매듭에서 \(0\) 인 자연 3차 스플라인이다. 이런 기저를 기본기저(cardinal basis)라 부른다.
이제 \(g(x) = \sum_{j=1}^m B_j(x)\) 를 보자. \(g\) 는 자연 3차 스플라인들의 합이므로 자연 3차 스플라인이고, 매듭에서의 값은
로 모두 \(1\) 이다. 한편 상수함수 \(1\) 도 매듭에서 모두 \(1\) 인 자연 3차 스플라인이다(양 끝 바깥에서 선형이어야 한다는 조건을 상수는 당연히 만족한다). 주어진 매듭값을 지나는 자연 3차 스플라인은 유일하므로
이다. 그러므로 cr 의 네 열은 이미 절편을 품고 있다. - 1 로 patsy 의 절편 열을 뺐더라도 네 열의 합이 \(1\) 인 벡터이기 때문이다.
여기에 LinearRegression() 이 상수 열을 하나 더 붙이면 설계행렬은 열이 \(5\) 개인데 계수(rank)가 \(4\) 뿐인 완전한 다중공선이 된다. 정규방정식(normal equations)의 해가 유일하지 않다. 적합값과 \(R^2\) 는 그래도 정해지지만 계수는 정해지지 않는다. sklearn 은 최소제곱 해를 lstsq 로 구하므로 예외를 던지지 않고 아무 해 하나를 돌려주는데, 그 해의 계수와 절편은 서로 상쇄되는 거대한 수가 된다.
보기 2 의 bs(..., include_intercept=False) 에는 이 일이 생기지 않는다. 기저함수 하나를 빼 두었으므로 남은 네 열의 합은 \(1\) 이 아니다.
(2) 수치적으로.
# 자연 3차 스플라인. 양 끝에서 직선이 되도록 묶어 두어, 자료가 드문
# 바깥쪽에서 곡선이 크게 튀는 일을 막는다. B-스플라인의 약점을 고친 것이다.
cs_design = dmatrix("cr(age, df=4) - 1",
                    {"age": df['age']}, return_type='dataframe')
cs_model = LinearRegression().fit(cs_design, df['price'])
cs_r2 = r2_score(df['price'], cs_model.predict(cs_design))
print("기저 열 개수 =", cs_design.shape[1], " 매듭 =", patsy_knots(cs_design).round(2))
print(f"행별 합  최소 {cs_design.sum(axis=1).min():.12f}  최대 {cs_design.sum(axis=1).max():.12f}")

# 절편 열을 하나 더 붙이면 어떻게 되는가. 특이값이 바로 말해 준다.
X1 = np.column_stack([np.ones(len(cs_design)), cs_design.values])
print("절편을 붙인 설계행렬의 특이값 =", np.linalg.svd(X1, compute_uv=False).round(4))
print(f"열은 {X1.shape[1]}개인데 계수(rank)는 {np.linalg.matrix_rank(X1)}")
print(f"LinearRegression() 계수의 최대 절대값 = 10^{np.log10(np.abs(cs_model.coef_).max()):.1f}")

# 절편을 떼고 다시 적합한다.
cs_stable = LinearRegression(fit_intercept=False).fit(cs_design, df['price'])
Ck = pd.DataFrame(np.asarray(build_design_matrices(
    [cs_design.design_info], {"age": patsy_knots(cs_design)})[0]),
    columns=cs_design.columns)
B = Ck.values
print(f"매듭에서의 기저값: 대각 {np.diag(B).round(6)},  비대각 최대 "
      f"{np.abs(B - np.diag(np.diag(B))).max():.1e}")
print("계수             =", cs_stable.coef_.round(0))
print("매듭에서의 적합값 =", cs_stable.predict(Ck).round(0))
print(f"R^2 = {cs_r2:.4f} (절편 포함) 대 "
      f"{r2_score(df['price'], cs_stable.predict(cs_design)):.4f} (절편 없이)")
print(f"예측의 최대 차이 = "
      f"{np.abs(cs_model.predict(cs_design) - cs_stable.predict(cs_design)).max():.0f}")
출력:
기저 열 개수 = 4  매듭 = [  9.    47.33  85.67 124.  ]
행별 합  최소 1.000000000000  최대 1.000000000000
절편을 붙인 설계행렬의 특이값 = [175.5037  77.3597  52.5336  29.7136   0.    ]
열은 5개인데 계수(rank)는 4
LinearRegression() 계수의 최대 절대값 = 10^17.2
매듭에서의 기저값: 대각 [1. 1. 1. 1.],  비대각 최대 4.6e-17
계수             = [713887. 515523. 508845. 673888.]
매듭에서의 적합값 = [713887. 515523. 508845. 673888.]
R^2 = 0.0301 (절편 포함) 대 0.0301 (절편 없이)
예측의 최대 차이 = 5936
(1)의 유도가 그대로 확인된다. 행별 합이 소수 열두째 자리까지 \(1\) 이고, 절편을 붙인 설계행렬의 다섯째 특이값이 \(0\) 이다. 특이값이 하나 죽었다는 것이 계수가 \(5\) 가 아니라 \(4\) 라는 말의 수치적 표현이다. 그래서 LinearRegression() 이 돌려준 계수는 \(10^{17.2}\) 규모로 터져 있고, 절편이 그만큼 음수여서 둘이 상쇄된다. 이 자릿수는 선형대수 라이브러리에 따라 달라질 수 있다. 정해지지 않은 값이니 달라지는 것이 당연하다.
(2) 계수는 매듭에서의 적합값이다. fit_intercept=False 로 적합하니 계수가
이고, 매듭 \(9,\, 47.33,\, 85.67,\, 124\) 에서의 적합값이 같은 네 수로 나왔다. (1)에서 \(B_j(\xi_k) = \delta_{jk}\) 라 했으므로
이어야 하고, 실제로 그렇다. 기저값 행렬의 대각이 모두 \(1\), 비대각이 \(4.6 \times 10^{-17}\) 이니 단위행렬이다. 이것이 cr 기저의 쓸모다. B-스플라인 계수는 뜻을 읽기 어렵지만 cr 계수는 "나이 \(9\) 년 집의 적합가격 \(713{,}887\) 달러" 처럼 바로 읽힌다.
그 네 수가 \(713{,}887 \to 515{,}523 \to 508{,}845 \to 673{,}888\) 로 내려갔다 올라간다. 새 집이 가장 비싸고, 여든 살쯤에서 가장 싸고, 백 년을 넘기면 다시 오른다. 오래된 집이 비싼 것은 집이 좋아서가 아니라 오래된 동네가 도심에 있기 때문일 것이다. 교란변수다.
절편을 잘못 넣은 적합은 얼마나 나빴나. \(R^2\) 는 둘 다 \(0.0301\) 로 소수 넷째 자리까지 같고, 예측의 최대 차이도 \(5{,}936\) 달러다. 예측값이 \(50\) 만 달러 대인 것에 비하면 \(1\%\) 가량이다. 곧 적합값은 거의 멀쩡하고 망가진 것은 계수뿐이다. 열 공간이 같으므로 이론적으로는 예측이 완전히 같아야 하는데 \(5{,}936\) 달러가 벌어진 것은 \(10^{17}\) 규모의 수를 더하고 빼면서 생긴 유효숫자 손실(loss of significance)이다.
마지막으로 제약의 값. 같은 \(\mathrm{df} = 4\) 로 보기 2 의 B-스플라인은 \(R^2 = 0.0346\), 여기 자연 스플라인은 \(0.0301\) 이다. 차이가 \(0.0045\) 다.
이 비교를 중첩모형의 비교로 읽을 수는 없다. 두 기저의 매듭이 다르므로(\(47\) 하나 대 \(9,\,47.33,\,85.67,\,124\)) 한쪽 열공간이 다른 쪽에 들어 있지 않다. 그래도 방향은 설명이 된다. B-스플라인 쪽은 네 열에 절편까지 모수가 \(5\) 개인데 자연 스플라인 쪽은 네 열이 절편을 품고 있어 모수가 \(4\) 개이고, 거기에 양 끝 바깥에서 선형이라는 제약까지 걸려 있다. 모수 하나와 경계 제약을 내주고 외삽의 안정성을 산 것이다. 그 안정성이 실제로 무엇인지는 연습문제 3 에서 본다 — 자연 스플라인은 자료 범위 밖에서도 값을 돌려주는데 B-스플라인은 예외를 던진다.
격자에서의 예측
보기 5. 예측할 때 기저 재사용하기. 나이 \(9\) 에서 \(124\) 까지 \(300\) 점 격자를 만들어 두 모형의 적합곡선을 얻는다. 기저는 build_design_matrices로 원래 것을 그대로 쓴다.
(1) 격자에 dmatrix를 다시 불렀다면 내부 매듭이 어디에 놓이겠는가. 격자가 자료와 같은 구간을 덮는데도 매듭이 달라지는 까닭을 말하시오.
(2) 두 방식의 예측을 실제로 견주시오. 차이가 가장 큰 곳과 차이가 \(0\) 인 곳은 각각 어디이며, 왜 그런가.
풀이
(1) 해석적으로. 보기 2 에서 보았듯이 patsy 의 bs 는 df=4, degree=3 에 대해 내부 매듭 하나를 넘겨받은 자료의 중앙값에 놓는다. 매듭을 정하는 재료가 구간이 아니라 값들의 분포라는 것이 요점이다.
훈련 자료는 나이 \(22{,}687\) 개이고 그 중앙값이 \(47\) 이다. 격자는 \([9, 124]\) 를 등간격으로 \(300\) 등분한 것이므로 분포가 균등하고, 그 중앙값은 구간의 중점
이다. 두 집합은 최솟값과 최댓값이 같은데 중앙값이 다르다. 자료에는 젊은 집이 몰려 있어 중앙값이 왼쪽으로 쏠렸고, 격자는 고르게 퍼져 있다. 그래서 같은 식 문자열이 다른 기저를 만든다.
계수 \(\hat\gamma\) 는 매듭이 \(47\) 인 기저에 맞추어 구해졌다. 그것을 매듭이 \(66.5\) 인 기저에 곱하면 계수와 기저의 짝이 어긋난다. 오류도 경고도 나지 않는다. 그저 틀린 곡선이 나온다.
경계에서는 어긋나지 않는다. 양 끝 \(9\) 와 \(124\) 는 두 경우 모두 경계매듭이고, 경계매듭이 \(d+1\) 번 겹쳐 있으면 그 점에서 기저는 한 함수만 \(1\) 이고 나머지가 \(0\) 이다. 매듭벡터의 가운데가 무엇이든 그 값은 변하지 않으므로 \(x = 9\) 와 \(x = 124\) 에서의 예측은 정확히 같다.
(2) 수치적으로.
age_grid = np.linspace(df['age'].min(), df['age'].max(), 300)

# 예측할 때는 반드시 원래 기저를 그대로 써야 한다. 새 자료로 dmatrix 를
# 다시 부르면 매듭이 그 자료의 분위수로 다시 정해져, 훈련 때와 다른 기저가
# 만들어진다. design_info 를 넘겨 주는 것이 그 실수를 막는 방법이다.
bs_grid = build_design_matrices([bs_design.design_info], {"age": age_grid})[0]
bs_pred = bs_model.predict(np.asarray(bs_grid))

cs_grid = build_design_matrices([cs_design.design_info], {"age": age_grid})[0]
cs_pred = cs_model.predict(np.asarray(cs_grid))
# 해서는 안 되는 쪽. 식 문자열로 dmatrix 를 다시 부른다.
bs_wrong_design = dmatrix("bs(age, df=4, degree=3, include_intercept=False) - 1",
                          {"age": age_grid}, return_type='dataframe')
bs_wrong = bs_model.predict(np.asarray(bs_wrong_design))

print(f"올바른 기저의 내부 매듭   = {patsy_knots(bs_design)[4]:.1f}  (자료 22687건의 중앙값)")
print(f"다시 부른 기저의 내부 매듭 = {patsy_knots(bs_wrong_design)[4]:.1f}  (격자 300점의 중앙값)")
gap = np.abs(bs_wrong - bs_pred)
print(f"두 예측의 최대 차이 = {gap.max():,.0f}   (age = {age_grid[gap.argmax()]:.1f})")
print(f"양 끝 age = 9, 124 에서의 차이 = {gap[0]:.0f}, {gap[-1]:.0f}")
print(f"예측값 자체의 범위 = {bs_pred.min():,.0f} ~ {bs_pred.max():,.0f}")
출력:
올바른 기저의 내부 매듭   = 47.0  (자료 22687건의 중앙값)
다시 부른 기저의 내부 매듭 = 66.5  (격자 300점의 중앙값)
두 예측의 최대 차이 = 39,608   (age = 46.7)
양 끝 age = 9, 124 에서의 차이 = 0, 0
예측값 자체의 범위 = 462,491 ~ 656,578
(1)에서 예측한 \(47\) 과 \(66.5\) 가 그대로 나왔다. 양 끝에서의 차이도 예측대로 정확히 \(0\) 이다.
차이가 가장 큰 곳은 \(\text{age} = 46.7\) 로, 원래 매듭이 있던 자리다. 내부 매듭은 곡선이 꺾일 수 있는 자리이고 기저함수들의 모양이 그 근처에서 가장 많이 다르므로, 짝이 어긋난 효과가 거기서 가장 크게 드러난다.
크기를 보자. \(39{,}608\) 달러다. 예측값이 통째로 \(462{,}491\) 에서 \(656{,}578\) 사이, 곧 폭이 \(194{,}087\) 달러인데 그 \(20\%\) 가 틀린 것이다. 보기 4 에서 절편을 잘못 넣어 생긴 오차가 \(5{,}936\) 달러였던 것과 견주면 여섯 배 이상 나쁘다.
이 결함이 고약한 까닭은 조용하다는 것이다. 보기 4 의 공선성은 특이값 \(0\) 과 \(10^{17}\) 짜리 계수라는 비명을 남겼지만, 여기서는 형태가 멀쩡한 \(300\) 개의 수가 나온다. 그려 보면 곡선도 매끄럽다. 틀린 줄 알 방법은 매듭을 직접 꺼내 보는 것뿐이다. 그래서 build_design_matrices 에 design_info 를 넘기는 것이 선택이 아니라 규칙이다.
새 자료에 dmatrix를 다시 부르면 안 된다
식 문자열로 dmatrix를 다시 호출하면 patsy가 새로 넘긴 자료로 매듭을 다시 계산한다. 그러면 훈련에 쓴 기저와 다른 기저가 만들어져 계수가 엉뚱한 기저에 곱해진다. 반드시 원래 설계행렬의 design_info를 build_design_matrices에 넘겨 같은 매듭을 재사용해야 한다.
3. 국소 제어가 수치 안정성을 준다
- B-스플라인은 국소 제어를 제공한다. 각 기저함수가 좁은 구간에서만 0이 아니므로 한 구역의 적합이 멀리 떨어진 자료와 비교적 무관하다. 그래서 수치적으로 안정적이고 해석하기 좋다.
- 자연 스플라인은 경계 매듭 바깥에서 적합을 선형으로 제약하므로 경계에서 더 안정적이다. 제약 없는 삼차 스플라인이 보이는 격렬한 외삽을 피한다.
- 자유도: df를 키우면 훈련자료 적합은 좋아지지만 과적합(overfitting) 위험이 커진다. 최적 df는 교차검증이나 정보기준으로 고른다.
- 매듭 배치: 자동 배치(균등 분위수)가 대부분의 경우 잘 작동한다. 관계의 성격이 바뀌는 지점을 분야 지식으로 안다면 사용자 지정 매듭이 유용하다.
- 비교: 스플라인은 하나의 전역적 모양을 강제하는 대신 국소적 유연성을 제공하므로, 복잡도가 같은 다항식보다 대체로 낫다.
연습문제
연습문제 1. df를 3에서 8까지 바꿔 가며 B-스플라인을 적합하고 그 결과 곡선을 그려라. 어느 df에서 과적합의 징후가 나타나기 시작하는가?
풀이
삼차 B-스플라인에서는 df가 degree보다 작을 수 없다. df=2, degree=3을 넣으면
patsy가 ValueError: df=2 is too small for degree=3을 던지므로 3부터 시작한다.
for d in range(3, 9):
    design = dmatrix(f"bs(age, df={d}, degree=3, include_intercept=False) - 1",
                     {"age": df['age']}, return_type='dataframe')
    model = LinearRegression().fit(design, df['price'])
    grid_design = build_design_matrices([design.design_info],
                                       {"age": age_grid})[0]
    print(f"df={d}: R^2 = {model.score(design, df['price']):.4f}")
출력:
df=3: R^2 = 0.0292
df=4: R^2 = 0.0346
df=5: R^2 = 0.0351
df=6: R^2 = 0.0349
df=7: R^2 = 0.0353
df=8: R^2 = 0.0354
\(R^2\)가 df=4에서 0.0346까지 오른 뒤로는 거의 늘지 않는다(df=6에서는 오히려 미세하게 줄었는데, 매듭 위치가 달라지면서 생기는 일이다). 훈련 자료에 대한 적합이므로 이 값만으로는 과적합을 판단할 수 없다.
과적합은 곡선의 모양에서 드러난다. 지나친 요동으로 나타나며, 특히 자료가 성긴 경계 근처에서 두드러진다. 이 자료에서는 대체로 df > 6에서 징후가 보이기 시작한다. 형식적으로 고르려면 교차검증을 써야 한다. \(\square\)
연습문제 2. 매듭이 \(K\)개인 자연 삼차 스플라인의 자유도가 (제약 없는 삼차 스플라인의 \(K + 4\)가 아니라) \(K\)인 이유를 설명하라. "잃어버린" 4개의 자유도는 어디로 가는가?
풀이
매듭 \(\xi_1 < \cdots < \xi_K\)가 있을 때(양 끝의 경계 매듭을 포함해 센다) 함수를 실수 직선 전체에서 보고 제약 없는 삼차 스플라인의 차원을 세어 보자. 매듭 \(K\)개가 직선을 \(K+1\)개 조각으로 나누고 조각마다 삼차 다항식이므로 계수는 \(4(K+1)\)개이다. 매듭 \(K\)개 각각에서 \(f\), \(f'\), \(f''\)의 연속성이 3개씩 제약을 주므로 제약은 \(3K\)개이고, 따라서 삼차 스플라인의 차원은 \(4(K+1) - 3K = K + 4\)이다.
자연 스플라인은 여기에 경계 바깥에서 선형이라는 조건을 얹는다. 이는 양쪽 끝 각각에서
이라는 4개의 제약을 뜻한다. 따라서 차원은
가 된다. 잃어버린 4개의 자유도는 양쪽 바깥 조각의 이차항과 삼차항 계수 네 개이며, 이들이 0으로 강제되어 그 구간에서 함수가 직선이 된다.
df 세는 방식의 차이
절편을 df에 포함하느냐에 따라 문헌마다 숫자가 하나씩 달라진다. patsy의 cr(x, df=4)나 R의 ns(x, df=4)는 절편을 뺀 기저 열 4개를 돌려주므로, 모형 절편을 더하면 전체 차원이 5가 된다. 어떤 규약을 쓰든 자연 스플라인이 같은 매듭의 삼차 스플라인보다 정확히 4만큼 작다는 점은 변하지 않는다. \(\square\)
연습문제 3. 자료 범위 바깥(예: age = 150이나 age = 0)에서 B-스플라인 모형과 자연 스플라인 모형의 예측을 비교하라. 어느 쪽이 더 합리적으로 외삽하는가?
풀이
age_extrap = np.array([0.0, 5.0, 145.0, 150.0])

# 자연 스플라인: 선형으로 외삽한다.
cs_extrap = build_design_matrices([cs_design.design_info],
                                  {"age": age_extrap})[0]
print("Natural:", cs_model.predict(np.asarray(cs_extrap)).round(0))

# B-스플라인: 매듭 바깥에서는 예외를 던진다.
try:
    bs_extrap = build_design_matrices([bs_design.design_info],
                                      {"age": age_extrap})[0]
    print("B-spline:", bs_model.predict(np.asarray(bs_extrap)).round(0))
except Exception as exc:
    print(f"B-spline: {type(exc).__name__}")
출력:
Natural: [772512. 741152. 775648. 801248.]
B-spline: PatsyError
자연 스플라인은 문제없이 계산되며 경계에서의 기울기를 그대로 이어 선형으로 외삽한다.
B-스플라인 쪽은 값을 돌려주는 대신 예외를 던진다.
PatsyError: Error evaluating factor: NotImplementedError:
some data points fall outside the outermost knots,
and I'm not sure how to handle them.
이 오류 자체가 답이다. B-스플라인 기저는 최외곽 매듭 바깥에서 정의되지 않으므로 patsy는 추측해서 값을 만들어 내는 대신 거부한다. 설령 삼차식을 그대로 연장하도록 구현했더라도 그 외삽값은 극단적이고 비현실적이었을 것이다. 자료 범위를 벗어나 예측해야 한다면 자연 스플라인을 써야 한다. \(\square\)
연습문제 4. 적합 목적함수에 능형회귀(ridge regression) 형태의 항 \(\lambda \|\boldsymbol{\gamma}\|^2\)을 더해 B-스플라인에 거칢 벌점을 구현하라. 이것은 평활 스플라인과 어떤 관계인가?
풀이
from sklearn.linear_model import Ridge

design = dmatrix("bs(age, df=8, degree=3, include_intercept=False) - 1",
                 {"age": df['age']}, return_type='dataframe')
ridge_model = Ridge(alpha=1e4).fit(design, df['price'])
\(\lambda\|\boldsymbol{\gamma}\|^2\)을 더하면 기저 계수가 0 쪽으로 축소되어 곡선이 매끄러워진다. 이는 2계 도함수에 벌점을 주는 평활 스플라인의 벌점 \(\lambda\int [f'']^2\)에 대한 근사이다. 정확한 평활 스플라인은 \(D_{jk} = \int B_j''(t)B_k''(t)\,dt\)인 벌점행렬 \(\mathbf{D}\)를 쓰지만, \(\lambda\mathbf{I}\)(능형 벌점)가 더 간단한 근사를 제공한다. \(\square\)
연습문제 5. 매듭이 자료점에 놓인 자연 삼차 스플라인에 대해, 평활 스플라인 추정량이 두 번 미분 가능한 모든 함수 가운데 \(\sum(y_i - f(x_i))^2 + \lambda\int[f''(t)]^2\,dt\)를 최소화함을 증명하라.
풀이
비모수(nonparametric) 회귀의 고전적 결과이다. 핵심은 매듭에서 주어진 값을 보간하는 모든 함수 \(g\) 가운데 자연 삼차 스플라인이 \(\int [g'']^2\,dt\)(거칢)를 최소화한다는 것이다. 변분법적 논증으로 보인다. \(g\) 를 두 번 미분 가능한 임의의 함수, \(f\) 를 자료점에서 \(g\) 와 같은 값을 갖는 자연 삼차 스플라인이라 하고 \(g = f + h\) 로 쓰면(따라서 모든 자료점에서 \(h(x_i) = 0\) 이다)
부분적분과 자연 스플라인의 경계조건에 의해 교차항 \(\int f'' h'' = 0\)이므로 \(\int[g'']^2 \geq \int[f'']^2\)이다. 교차항이 사라지는 까닭은 이렇다. 부분적분하면 \(\int f'' h'' = [f'' h'] - \int f''' h'\) 인데, 첫 항은 양 끝에서 \(f'' = 0\) 이라 없어지고, 둘째 항은 \(f'''\) 이 매듭 사이에서 상수이므로 각 조각에서 (상수) \(\times\, [h]\) 가 되어 \(h(x_i) = 0\) 때문에 없어진다. 이제 \(g\) 를 \(f\) 로 바꾸면 자료점에서의 값이 같으니 잔차제곱합은 그대로이고 벌점은 커지지 않는다. 따라서 자연 삼차 스플라인이 임의의 \(\lambda > 0\)에 대해 벌점 목적함수의 유일한 최소화 함수이다. \(\square\)
연습문제 6. 연습문제 1 의 표가 df=3 에서 시작하는 것은 patsy 가 df=2, degree=3 을 거부하기 때문이다. 그 거부의 경계를 들여다본다.
(1) 보기 2 의 식 \(\mathrm{df} = K + d\) 로 거부를 설명하고, 경계인 \(\mathrm{df} = d\) 에서 bs 가 쓰는 매듭벡터를 적으시오.
(2) bs(age, df=3, degree=3, include_intercept=False) 에 LinearRegression() 의 절편을 더한 모형이 나이의 3 차 다항회귀와 같은 모형임을 보이시오. 연습문제 1 의 표에 적힌 \(R^2 = 0.0292\) 가 이 주장과 어떻게 맞물리는가.
(3) 그렇다면 그 표에서 \(\mathrm{df} = 3\) 과 \(\mathrm{df} = 8\) 의 차이는 무엇의 값인가. 그 수를 적고, 이 표만으로 3절의 마지막 항목("복잡도가 같은 다항식보다 대체로 낫다")을 검증할 수 있는지 판단하시오.
풀이
(1) 거부의 정체. 보기 2 에서 보았듯 patsy 의 df 는 절편을 뺀 열 개수이므로 \(\mathrm{df} = K + d\), 곧
이다. 내부 매듭의 개수는 음수가 될 수 없으니 \(\mathrm{df} \ge d = 3\) 이어야 한다. df=2 는 \(K = -1\) 을 요구한다. 그래서 patsy 가 멈춘다. 거부의 까닭은 차수가 커서가 아니라 매듭이 음수 개 필요해서다.
경계인 \(\mathrm{df} = d = 3\) 에서는 \(K = 0\) 이다. 매듭벡터의 길이는 보기 2 의 식에서
이고, 경계매듭 \(9\) 와 \(124\) 가 각각 네 번씩 겹쳐 적힌
이다. 내부 매듭이 하나도 없다.
(2) 매듭이 없는 스플라인은 다항식이다. 내부 매듭이 없으면 \([9, 124]\) 가 쪼개지지 않으므로, 그 위의 "조각별 3 차식" 은 조각이 하나뿐인 단일 3 차식이다. 곧 기저가 펼치는 공간은 3 차 이하 다항식의 공간 \(\mathcal{P}_3\) 이고, 차원은 \(K + d + 1 = 4\) 로 \(\dim \mathcal{P}_3\) 과 맞는다.
include_intercept=False 가 돌려주는 열은 \(B_2, B_3, B_4\) 세 개뿐이지만, 기저함수의 합이 \(1\) 이라는 성질(쪽머리 그림의 검은 점선)에서 빠진 함수가
로 되살아난다. LinearRegression() 이 붙이는 상수 열이 바로 그 \(1\) 이다. 그러므로
한편 \(1, x, x^2, x^3\) 도 \(\mathcal{P}_3\) 의 기저다. 두 설계행렬의 열공간이 같다. 최소제곱의 적합값은 열공간만으로 정해지므로(사영) 두 모형의 적합값은 점마다 똑같고, 따라서 \(R^2\) 도 똑같다.
연습문제 1 의 표가 적은 \(\mathrm{df} = 3\) 의 \(R^2 = 0.0292\) 는 그러므로 스플라인의 수가 아니라 3 차 다항회귀의 수다. age, age**2, age**3 로 회귀해도 같은 \(0.0292\) 가 나오며, 적합값의 최대 차이는 \(0\) 이다. 기저만 바꾼 것이니 당연하다.
(3) 표가 재는 것. \(\mathrm{df} = 3\) 줄이 다항회귀이고 \(\mathrm{df} = 8\) 줄이 내부 매듭 \(K = 5\) 개를 쓴 스플라인이므로, 표의 두 끝의 차이
가 매듭 다섯 개가 3 차 다항식 위에 더해 준 몫이다. 3 차 다항식 자신의 \(0.0292\) 에 견주면 \(21\%\) 늘어난 것이지만, 가격 변동 전체로 보면 \(0.62\) 퍼센트포인트다.
이 표로는 3절의 주장을 검증할 수 없다. "복잡도가 같은 다항식보다 낫다" 를 재려면 모수의 개수를 맞춰 겨뤄야 한다. \(\mathrm{df} = 8\) 의 스플라인은 절편까지 모수가 \(9\) 개이므로 상대는 \(8\) 차 다항식이어야 한다. 그런데 표에 있는 다항식은 모수 \(4\) 개의 3 차식뿐이다. 복잡도가 같은 상대가 표에 없다. 표가 보이는 것은 "같은 자유도에서 스플라인이 다항식을 이긴다" 가 아니라 "자유도를 늘리면 훈련 적합이 좋아진다" 는 훨씬 약한 사실이다. \(\square\)
연습문제 7. 보기 5 에서 틀린 기저와 올바른 기저의 예측 차이가 양 끝 \(\text{age} = 9, 124\) 에서 정확히 \(0\) 이었다. 쪽의 설명은 "경계매듭이 \(d+1\) 번 겹쳐 있으면 그 점에서 기저는 한 함수만 \(1\) 이고 나머지가 \(0\)" 이라는 것인데, include_intercept=False 는 바로 그 "한 함수" 가운데 하나를 빼 버린다(보기 4).
(1) 보기 2 의 설계행렬에서 \(x = 9\) 인 행과 \(x = 124\) 인 행을 각각 네 수로 적으시오. 그 두 행이 내부 매듭의 자리와 무관함을 보이고, 차이가 \(0\) 인 것이 계수 \(\hat\gamma\) 의 값과도 무관한 항등식임을 논하시오.
(2) 그 네 열의 행별 합이 \(x\) 에 따라 어떻게 움직이는지 구하시오. 보기 4 의 공선성이 여기서는 왜 생기지 않는지 그 합으로 정확히 말하고, include_intercept=True 로 바꾸면 무슨 일이 생기는지 적으시오.
풀이
(1) 두 행은 \((0,0,0,0)\) 과 \((0,0,0,1)\) 이다. 보기 2 의 매듭벡터는
이고 전체 기저함수는 \(K + d + 1 = 1 + 3 + 1 = 5\) 개, 곧 \(B_1, \dots, B_5\) 다. 경계매듭이 \(d+1 = 4\) 번 겹쳐 있으므로 왼쪽 끝에서는
이고 오른쪽 끝에서는 \(B_5(124) = 1\), 나머지가 \(0\) 이다. patsy 의 include_intercept=False 는 첫 함수를 뺀다. 남는 네 열은 \((B_2, B_3, B_4, B_5)\) 이므로
내부 매듭과 무관하다. 위의 경계값을 얻는 데 쓴 것은 매듭벡터의 앞 네 자리 \(t_1 = \cdots = t_4 = 9\) 와 뒤 네 자리 \(t_6 = \cdots = t_9 = 124\) 뿐이고, 가운데 \(t_5\) 는 들어오지 않았다. \(t_5\) 가 \(47\) 이든 \(66.5\) 이든 두 행은 같은 수들이다.
그래서 예측은
이 되고, 보기 5 의 두 예측은 같은 모형 bs_model 의 같은 \(\hat\beta_0, \hat\gamma\) 를 쓰므로 양 끝에서 차이가 \(0\) 이다. 이것은 수치적으로 작은 것이 아니라 \(\hat\gamma\) 가 무엇이든 성립하는 항등식이다. 보기 5 의 출력이 소수점 아래 없이 딱 0, 0 인 까닭이 여기 있다.
뒤집어 보면 이 등식은 경고이기도 하다. 매듭이 어긋난 기저는 양 끝에서 늘 올바른 기저와 일치하므로, 끝점 두 개만 찍어 보는 점검으로는 보기 5 의 결함을 절대 잡을 수 없다. 차이는 가운데서만 드러난다(보기 5 에서 \(\text{age} = 46.7\), \(39{,}608\) 달러).
(2) 행별 합은 \(0\) 에서 \(1\) 까지 움직인다. 다섯 함수의 합이 \([9, 124]\) 에서 항상 \(1\) 이므로 남은 네 열의 합은
\(B_1\) 은 받침(support, 값이 \(0\) 이 아닌 구간)이 \((t_1, t_5) = (9, 47)\) 이라 \(B_1(9) = 1\) 이고 \(x \ge 47\) 에서는 \(0\) 이다. 그러므로 행별 합은 \(x = 9\) 에서 \(0\), \(x \ge 47\) 에서 \(1\) 이고 그 사이에서 \(0\) 에서 \(1\) 로 올라간다. 상수가 아니다.
보기 4 의 공선성은 "네 열의 합이 상수 벡터 \(\mathbf{1}\)" 이라는 한 개의 정확한 선형종속이었다. 여기서는 열의 합이 \(1 - B_1\) 이고 그 값이 \(0\) 과 \(1\) 을 모두 취하므로 어떤 상수 \(c\) 에 대해서도 합 \(\ne c\mathbf{1}\) 이다. 그 종속은 없다.
더 나아가 완전 계수(full rank)임을 증명할 수 있다. \(1 = \sum_{m=1}^5 B_m\) 에서 \(B_1 = 1 - (B_2 + \cdots + B_5)\) 이므로
이고 오른쪽은 차원 \(5\) 다. 절편을 붙인 설계행렬의 열 \(5\) 개가 독립이므로 계수가 \(5\) 다. 보기 4 처럼 특이값이 죽는 일이 없다.
include_intercept=True 로 바꾸면 보기 4 가 되살아난다. 그러면 열이 \(B_1, \dots, B_5\) 전부이고 합이 정확히 \(1\) 이므로, LinearRegression() 의 상수 열과 합쳐 열 \(6\) 개에 계수 \(5\) 가 된다. 특이값 하나가 \(0\) 이 되고 계수는 서로 상쇄되는 거대한 수가 되며, 적합값만 멀쩡해진다 — 보기 4 가 cr 에서 보인 것과 같은 그림이다. 덧붙여 df 의 뜻도 바뀐다. include_intercept=True 에서는 df 가 기저함수를 모두 세므로 \(\mathrm{df} = K + d + 1\) 이고, 보기 2 와 같은 매듭 \(47\) 을 얻으려면 df=5 라고 써야 한다. \(\square\)
연습문제 8. 연습문제 1 의 표에서 \(R^2\) 가 \(\mathrm{df} = 5\) 의 \(0.0351\) 에서 \(\mathrm{df} = 6\) 의 \(0.0349\) 로 줄었다. 최소제곱에서는 설명변수 열을 더하면 \(R^2\) 가 절대 줄지 않으므로 이것은 설명이 필요하다.
(1) 열공간의 말로 까닭을 밝히시오. bs 에 절편을 더한 모형의 열공간이 무엇인지 먼저 적고, 매듭집합이 포함관계일 때 두 열공간이 어떤 관계인지 증명한 뒤, \(\mathrm{df} = 5\) 와 \(6\) 의 내부 매듭을 꺼내 포함관계가 깨지는 자리를 짚으시오.
(2) 같은 표에서 \(\mathrm{df} = 4 \to 6\) 과 \(\mathrm{df} = 5 \to 8\) 은 왜 줄 수 없었는지 같은 논리로 확인하시오.
(3) 매듭집합이 실제로 포함관계인 사슬을 만들어 \(R^2\) 가 단조로 커지는 것을 수치로 보이시오.
풀이
(1) 열공간은 스플라인 공간 전체다. 경계 \([a, b] = [9, 124]\) 와 차수 \(d = 3\) 을 고정하고, 내부 매듭집합 \(S \subset (a, b)\) 에 대해
라 쓰자. 차원은 \(\lvert S \rvert + 4\) 다. 연습문제 7(2)의 논법을 그대로 쓰면, bs(..., include_intercept=False) 의 열에 절편을 더해 얻는 공간은 빠진 \(B_1\) 을 되살리므로 \(\mathcal{S}(S)\) 전체다. 모수는 \(\lvert S \rvert + 4\) 개다.
이제 \(S_1 \subseteq S_2\) 라 하자. \(f \in \mathcal{S}(S_1)\) 이면 \(f\) 는 조각별 3 차식이고 \(S_1\) 에서 \(C^2\) 이다. \(S_2 \setminus S_1\) 의 점들은 \(f\) 의 어떤 조각 내부에 있으므로 거기서 \(f\) 는 다항식이고 따라서 \(C^\infty\) 다. 곧 \(f\) 는 \(S_2\) 의 모든 점에서도 \(C^2\) 이므로 \(f \in \mathcal{S}(S_2)\). 그러므로
큰 공간에서의 최소값이 작은 공간에서의 최소값보다 클 수 없기 때문이다. 단조성을 보장하는 것은 열의 개수가 아니라 매듭집합의 포함관계다.
patsy 가 쓴 매듭을 꺼내 보자.
for k in range(3, 9):
    dd = dmatrix(f"bs(age, df={k}, degree=3, include_intercept=False) - 1",
                 {"age": df['age']}, return_type='dataframe')
    kn = patsy_knots(dd)
    print(f"df={k}  내부 매듭 {kn[4:len(kn) - 4]}")
출력:
df=3  내부 매듭 []
df=4  내부 매듭 [47.]
df=5  내부 매듭 [32. 65.]
df=6  내부 매듭 [24. 47. 74.]
df=7  내부 매듭 [21. 38. 58. 80.]
df=8  내부 매듭 [20. 32. 47. 65. 84.]
\(\mathrm{df} = 5\) 는 \(\{32, 65\}\) 를 쓰고 \(\mathrm{df} = 6\) 은 \(\{24, 47, 74\}\) 를 쓴다. \(32 \notin \{24, 47, 74\}\) 이고 \(65 \notin \{24, 47, 74\}\) 이므로
다. 두 열공간은 어느 쪽도 다른 쪽에 들어 있지 않다. 중첩모형이 아니므로 \(R^2\) 에 아무 부등식도 걸리지 않고, \(0.0351 > 0.0349\) 는 모순이 아니다. df 를 하나 올릴 때 patsy 는 매듭 하나를 더하는 것이 아니라 등간격 분위수 전체를 다시 깐다. 열 하나가 늘어나는 대신 기존 매듭이 전부 옮겨 간다.
(2) 우연히 중첩인 쌍들. 표를 다시 보면 포함관계가 성립하는 쌍이 있다.
- \(\varnothing \subset\) 모든 집합: \(\mathrm{df} = 3\) 의 \(0.0292\) 가 표의 최솟값이어야 한다. 실제로 그렇다.
- \(\{47\} \subset \{24, 47, 74\}\): \(\mathrm{df} = 4 \le \mathrm{df} = 6\), 곧 \(0.0346 \le 0.0349\). 성립한다.
- \(\{32, 65\} \subset \{20, 32, 47, 65, 84\}\): \(\mathrm{df} = 5 \le \mathrm{df} = 8\), 곧 \(0.0351 \le 0.0354\). 성립한다.
짝수 분위수가 홀수 분위수의 일부가 되는 자리에서만 이런 일이 생긴다. 반면 \(\mathrm{df} = 7\) 의 \(\{21, 38, 58, 80\}\) 은 \(\mathrm{df} = 8\) 의 집합에 들어 있지 않으므로 \(0.0353 \le 0.0354\) 는 보장된 것이 아니라 그냥 그렇게 나온 것이다.
(3) 진짜 중첩 사슬. 분위수 수준을 반씩 쪼개면 \(\{1/2\} \subset \{1/4, 1/2, 3/4\} \subset \{1/8, \dots, 7/8\}\) 로 수준 자체가 중첩되므로 매듭집합도 중첩된다.
chain = []
for j in (1, 2, 3):
    q = np.quantile(df['age'], np.arange(1, 2 ** j) / 2 ** j)
    chain.append(sorted({float(v) for v in q}))

for S in chain:
    dd = dmatrix(f"bs(age, knots={S}, degree=3, include_intercept=False) - 1",
                 {"age": df['age']}, return_type='dataframe')
    mm = LinearRegression().fit(dd, df['price'])
    print(f"내부 매듭 {len(S)}개 {S}  열 {dd.shape[1]}개  "
          f"R^2 = {r2_score(df['price'], mm.predict(dd)):.6f}")
출력:
내부 매듭 1개 [47.0]  열 4개  R^2 = 0.034638
내부 매듭 3개 [24.0, 47.0, 74.0]  열 6개  R^2 = 0.034925
내부 매듭 7개 [18.0, 24.0, 36.0, 47.0, 62.0, 74.0, 96.0]  열 10개  R^2 = 0.035835
\(47 \in \{24, 47, 74\} \subset \{18, 24, 36, 47, 62, 74, 96\}\) 이 눈으로 확인되고, \(R^2\) 가 \(0.034638 < 0.034925 < 0.035835\) 로 단조로 커진다. (1)의 증명이 요구하는 그대로다.
실천적인 교훈은 이것이다. df 를 훑어 만든 \(R^2\) 의 수열은 중첩모형의 수열이 아니다. 그 수열의 울퉁불퉁함을 "과적합의 징후" 나 "자유도의 최적점" 으로 읽으면 안 된다. 그것은 매듭이 옮겨 다니는 소리이고, 모형을 고르는 일은 어차피 훈련 \(R^2\) 가 아니라 교차검증에 맡겨야 한다. \(\square\)
연습문제 9. 연습문제 3 의 출력은 \(\text{age} = 0, 5, 145, 150\) 에 대해 Natural: [772512. 741152. 775648. 801248.] 이었다. 자연 3 차 스플라인은 경계매듭 \(9\) 와 \(124\) 바깥에서 직선이므로, 이 네 수만으로 왼쪽 직선과 오른쪽 직선이 완전히 정해진다.
(1) 두 직선의 기울기를 구하고, 그것으로 \(\hat f(9)\) 와 \(\hat f(124)\) 를 외삽해 보기 4 가 적은 매듭에서의 적합값 \(713{,}887\) 과 \(673{,}888\) 과 견주시오.
(2) 어긋난다. 코드의 어디에서 온 불일치인지 짚고, 보기 4 의 출력 가운데 그 크기를 미리 알려 준 수를 찾으시오. 두 수 가운데 어느 쪽을 믿어야 하며, 연습문제 3 을 고치려면 무엇을 바꿔야 하는가.
풀이
(1) 두 직선을 복원한다. 왼쪽은 \((0,\ 772512)\) 와 \((5,\ 741152)\) 를 지나므로
달러/년이다. 이 직선을 경계매듭 \(x = 9\) 까지 밀면
오른쪽은 \((145,\ 775648)\) 과 \((150,\ 801248)\) 을 지나므로
달러/년이고, \(x = 124\) 로 되돌리면
보기 4 가 적은 값과 나란히 놓자.
| 경계매듭 | 연습문제 3 에서 외삽 | 보기 4 의 적합값 | 차이 |
|---|---|---|---|
| \(x = 9\) | \(716{,}064\) | \(713{,}887\) | \(2{,}177\) |
| \(x = 124\) | \(668{,}128\) | \(673{,}888\) | \(-5{,}760\) |
(2) 같은 모형이라면 차이가 \(0\) 이어야 한다. 자연 3 차 스플라인은 \([9, 124]\) 바깥에서 정확히 직선이고, 그 직선은 경계매듭에서 곡선과 이어 붙는다. 그러므로 바깥의 두 점으로 정한 직선은 경계매듭의 적합값을 오차 없이 맞혀야 한다. 맞히지 못했으니 두 수는 같은 적합에서 나온 것이 아니다.
코드를 보면 바로 보인다. 연습문제 3 은 cs_model.predict(...) 를 쓰고, 보기 4 의 \(713{,}887\) 과 \(673{,}888\) 은 cs_stable 의 계수다. 보기 4 가 밝힌 대로 cs_model 은 절편을 한 열 더 붙여 계수가 \(4\) 뿐인 열 \(5\) 개에 적합한 모형이고, 그 계수의 크기가 \(10^{17.2}\) 다. 이 거대한 수들을 더하고 빼는 과정에서 유효숫자가 잘려 나간다.
크기를 미리 알려 준 수는 보기 4 의 마지막 줄
이다. 열공간이 같으므로 이론적으로는 두 모형의 예측이 완전히 같아야 하는데 유효숫자 손실 때문에 최대 \(5{,}936\) 달러가 벌어진다고 적혀 있었다. 우리가 찾은 불일치 \(2{,}177\) 과 \(5{,}760\) 은 둘 다 그 범위 안이다. 보기 4 가 예고한 오차가 연습문제 3 의 출력에서 실제로 모습을 드러낸 것이다.
믿어야 하는 쪽은 cs_stable, 곧 보기 4 의 \(713{,}887\) 과 \(673{,}888\) 이다. 그 모형은 열 \(4\) 개에 계수 \(4\) 로 완전 계수이므로 최소제곱 해가 유일하고, 계수의 크기도 적합값과 같은 자리 수여서 상쇄로 잃을 자리가 없다. 반대로 cs_model 은 해 자체가 정해지지 않은 모형이다.
고치는 방법은 한 글자다. 연습문제 3 에서 cs_model.predict 를 cs_stable.predict 로 바꾸면 된다. 그러면 외삽한 네 수로 복원한 직선이 \(713{,}887\) 과 \(673{,}888\) 을 자리까지 맞힌다.
마지막으로 수의 뜻. 왼쪽 기울기가 음(\(-6{,}272\) 달러/년)이라는 것은 새 집이 비싸다는 말이고, 오른쪽 기울기가 양(\(+5{,}120\) 달러/년)이라는 것은 아주 오래된 집이 다시 비싸진다는 말이다. 보기 4 에서 본 "내려갔다 올라가는" 모양의 양 끝 접선이다. 다만 \(\text{age} = 0\) 이나 \(150\) 은 자료에 없는 나이이므로 이 두 직선은 모형의 성질이고 세상의 성질이 아니다. 자연 스플라인의 미덕은 그 외삽이 맞는다는 것이 아니라, 틀리더라도 폭주하지 않는다는 것뿐이다. \(\square\)
연습문제 10. 보기 4 는 \(\mathrm{df} = 4\) 의 B-스플라인(\(R^2 = 0.0346\))과 자연 스플라인(\(0.0301\))을 견주고는 "두 기저의 매듭이 다르므로 이 비교를 중첩모형의 비교로 읽을 수는 없다" 고 물러섰다. 그 비교를 제대로 만들어 보자.
(1) cr(age, df=4) 가 쓴 매듭 \(9,\ 47.33,\ 85.67,\ 124\) 를 그대로 받아, 같은 매듭의 제약 없는 3 차 스플라인을 bs 로 만들어라. 두 모형의 모수 개수를 세고, 자연 스플라인의 네 열이 제약 없는 쪽의 열공간에 들어 있음을 수치로 확인하시오.
(2) 모수의 차이가 \(4\) 가 아니라 \(2\) 다. 연습문제 2 는 자연 스플라인이 \(4\) 만큼 작다고 했는데 어긋나지 않는가. 어긋나지 않는 까닭을 밝히시오.
(3) 이제 두 \(R^2\) 를 중첩모형으로 견주고 경계 제약을 \(F\) 검정하시오. 결과를 "자연 스플라인은 외삽만 손본다" 는 흔한 요약과 맞세워 해석하시오.
풀이
(1) 같은 매듭의 제약 없는 스플라인. cr(age, df=4) 의 매듭 네 개 가운데 \(9\) 와 \(124\) 는 경계매듭이고 내부 매듭은 \(47.33\) 과 \(85.67\), 곧 \(K = 2\) 다. 같은 매듭의 제약 없는 3 차 스플라인 공간은 차원이 \(K + d + 1 = 2 + 3 + 1 = 6\) 이므로, patsy 로는 \(\mathrm{df} = K + d = 5\) 열에 절편을 더해 모수 \(6\) 개다. 반면 cr 은 네 열이 절편을 품고 있어 모수 \(4\) 개다(보기 4).
from scipy import stats

inner = [float(v) for v in patsy_knots(cs_design)[1:3]]
bs_same = dmatrix(f"bs(age, knots={inner}, degree=3, include_intercept=False) - 1",
                  {"age": df['age']}, return_type='dataframe')
bs_same_model = LinearRegression().fit(bs_same, df['price'])

# cr 의 네 열을 span(1, bs) 에 사영해 잔차를 본다. 0 이면 들어 있다는 뜻이다.
Xfull = np.column_stack([np.ones(len(bs_same)), bs_same.values])
maxdev = max(np.abs(cs_design[c].values
                    - Xfull @ np.linalg.lstsq(Xfull, cs_design[c].values,
                                              rcond=None)[0]).max()
             for c in cs_design.columns)
print(f"bs 의 모수 {bs_same.shape[1] + 1}개,  cr 의 모수 {cs_design.shape[1]}개")
print(f"cr 의 네 열을 span(1, bs) 에 사영한 잔차의 최대 = {maxdev:.1e}")
출력:
bs 의 모수 6개,  cr 의 모수 4개
cr 의 네 열을 span(1, bs) 에 사영한 잔차의 최대 = 3.0e-14
잔차가 \(3 \times 10^{-14}\) 다. 기계 정밀도이니 \(\mathcal{N} \subset \mathcal{S}\) 가 수치적으로 확인되었다. 여기서 \(\mathcal{N}\) 은 자연 스플라인 공간, \(\mathcal{S}\) 는 같은 매듭의 제약 없는 스플라인 공간이다. 이제 두 모형은 진짜 중첩모형이다.
(2) 안에서 보면 제약이 두 개다. 연습문제 2 의 셈은 함수를 \(\mathbb{R}\) 전체에서 보고 매듭 \(K_{\text{tot}} = 4\) 개가 직선을 \(5\) 조각으로 나눈다고 센 것이다. 그 공간의 차원이 \(K_{\text{tot}} + 4 = 8\) 이고, 양 끝 조각에서 \(f'' = f''' = 0\) 이라는 제약 네 개를 걸어 \(8 - 4 = 4\) 가 된다.
그런데 bs 가 모형화하는 것은 \([9, 124]\) 안이다. 안에서는 조각이 \(K + 1 = 3\) 개뿐이므로 차원이 \(4 \cdot 3 - 3 \cdot 2 = 6\) 이다. 바깥의 두 조각이 애초에 없으니, 그 조각의 3 차항을 죽이는 제약 \(f'''(9) = f'''(124) = 0\) 은 셀 것이 없다. 안에 남는 제약은
두 개뿐이다. 그래서 \(6 - 2 = 4\) 다. 두 셈이 모두 \(\dim \mathcal{N} = 4\) 로 끝나므로 어긋나지 않는다. "\(4\) 만큼 작다" 는 전체 직선에서의 말이고, 자료 구간 안에서 검정할 수 있는 제약은 두 개다. \(F\) 검정의 분자 자유도가 \(2\) 여야 하는 까닭이다.
(3) 제약의 값을 재는 \(F\) 검정.
y = df['price'].values
rss_f = ((y - bs_same_model.predict(bs_same)) ** 2).sum()
rss_r = ((y - cs_stable.predict(cs_design)) ** 2).sum()
n, pf, pr = len(y), bs_same.shape[1] + 1, cs_design.shape[1]
F = ((rss_r - rss_f) / (pf - pr)) / (rss_f / (n - pf))
print(f"R^2:  bs(같은 매듭) {1 - rss_f / ((y - y.mean()) ** 2).sum():.6f}  "
      f"대  cr {1 - rss_r / ((y - y.mean()) ** 2).sum():.6f}")
print(f"F = {F:.2f}  (자유도 {pf - pr}, {n - pf}),  p = {stats.f.sf(F, pf - pr, n - pf):.2e}")
출력:
R^2:  bs(같은 매듭) 0.034731  대  cr 0.030106
F = 54.34  (자유도 2, 22681),  p = 2.87e-24
이제 두 \(R^2\) 를 마음 놓고 견줄 수 있다. 같은 매듭에서 제약 없는 쪽이 \(0.034731\), 자연 스플라인이 \(0.030106\) 이고, 부등호의 방향은 (1)의 중첩에서 이미 보장되어 있었다. 차이 \(0.004625\) 는 자연 스플라인 쪽 \(R^2\) 의 \(15\%\) 다. \(F = 54.34\), \(p \approx 3 \times 10^{-24}\) 이니 경계에서의 \(f'' = 0\) 은 이 자료에서 압도적으로 기각된다.
보기 4 가 "모수 하나와 경계 제약을 내주고 외삽의 안정성을 산다" 고 한 거래의 값이 이것이다. 매듭을 맞추고 보니 내준 모수는 둘이었고, 적합의 손실은 측정 가능할 만큼 크다.
"자연 스플라인은 외삽만 손본다" 는 요약은 틀렸다. 제약은 \(x < 9\), \(x > 124\) 에 걸린 것이 아니라 경계매듭 그 점에서 \(f'' = 0\) 으로 걸린다. 그리고 그 점은 자료의 안쪽 끝이다. \(\mathrm{df} = 4\) 처럼 매듭이 적으면 양 끝 조각이 각각 \(38\) 년 폭이어서 자료의 큰 부분을 담는데, 그 조각의 곡률이 한쪽 끝에서 \(0\) 으로 묶인다. 그러니 자료 구간 안의 적합도(goodness of fit) 함께 나빠진다. 보기 1 이 짚은 대로 나이 \(20\) 년 이하가 \(4{,}170\) 건, \(100\) 년 이상이 \(2{,}256\) 건으로 경계 쪽에도 자료가 적지 않으니, 그 손실이 \(F = 54\) 로 잡히는 것이 이상하지 않다.
한 가지 유보. 가격의 왜도가 \(5.85\) 이고(보기 1) 분산도 고르지 않을 터이니 \(p\) 값의 자릿수를 그대로 믿을 것은 아니다. 다만 \(F = 54\) 는 명목 임계값 \(3.00\) 의 \(18\) 배이므로, 결론의 방향은 정규성(normality) 가정이 조금 흔들려도 뒤집히지 않는다. 제약을 받아들일 근거는 적합이 아니라 바깥에서 폭주하지 않기를 원한다는 우리의 선택이다. \(\square\)
정리하며
스플라인은 조각별 다항을 매끄럽게 이어 붙인다.
- B-스플라인이 계산에 안정적인 기저다. 매듭 사이에서 3차 다항이고 매듭에서 2계 도함수까지 연속이므로, 계단함수의 불연속 문제가 사라진다.
- 자연 스플라인은 양 끝에서 선형으로 제약한다. 자료가 드문 경계에서 3차 다항이 폭주하는 것을 막으며, 외삽이 조금 덜 위험해진다.
- 매듭의 개수가 유연성을 정한다. 위치보다 개수가 중요하며, 보통 분위수에 균등 배치하고 자유도를 교차검증으로 고른다.
- patsy 식으로 간단히 쓴다.
bs(x, df=5)나cr(x, df=5)를 수식에 넣으면 기저행렬이 자동 생성되어 보통의 OLS 로 적합된다. - 여전히 선형모형이다. 기저함수가 비선형일 뿐 계수에 대해서는 선형이므로, 선형회귀(linear regression)에서 본 추론(표준오차·\(F\) 검정)이 그대로 적용된다.
다음 절 일반화가법모형으로 넘어간다. 여기까지가 설명변수 하나를 휘게 하는 법이고, GAM 은 그 매끄러운 함수를 설명변수마다 하나씩 두어 더한다.