Welch의 일원배치 분산분석
Welch 분산분석은 등분산(등분산성) 가정이 어긋날 때 둘 이상 집단의 평균이 유의하게 다른지 판정하는 검정이다. 집단 사이의 등분산을 가정하는 전통적인 일원배치 분산분석의 대안이다.
1. Welch 분산분석을 언제 쓰는가
- 둘 이상 집단의 평균을 비교할 때.
- 집단 분산이 서로 다를 때(이분산).
- 각 집단에서 정규성 가정이 근사적으로 만족될 때(또는 중심극한정리를 적용할 만큼 표본이 클 때).
2. 가정
- 각 집단의 자료가 독립적으로 무작위 추출되었다.
- 각 집단이 근사적으로 정규분포를 따른다(또는 중심극한정리를 적용할 만큼 표본크기가 크다).
- 집단 분산이 같다고 가정하지 않는다.
3. 가설
- 귀무가설 (\(H_0\)): 집단 평균이 모두 같다.
- 대립가설 (\(H_a\)): 적어도 한 집단의 평균이 다르다.
4. 검정통계량
Welch 분산분석은 가중치를 이용해 검정통계량 \(F\)를 계산한다. 가중치와 가중 전체평균을
로 두면 검정통계량은
이다. 여기서
- \(\bar{X}_i\): \(i\)번째 집단의 평균.
- \(s_i^2\): \(i\)번째 집단의 분산.
- \(n_i\): \(i\)번째 집단의 표본크기.
- \(\tilde{X}\): 모든 집단에 걸친 가중평균.
자유도는 Welch-Satterthwaite 식으로 계산하며, 그렇게 얻은 \(F\)-통계량을 \(F\)-분포와 비교한다.
5. 자유도 계산을 위한 Welch-Satterthwaite 식
Welch-Satterthwaite 식은 분산이 다른 상황에서 집단 평균을 비교할 때 자유도의 근사를 제공한다. 이 조정된 자유도는 검정통계량이 올바른 분포를 따르도록 하는 데 필수적이다.
분자 자유도는 \(\text{df}_1 = k - 1\)이고, 분모의 유효 자유도는 다음과 같다:
공식의 구성 요소:
-
가중치 (\(w_i\)): \(w_i = \frac{n_i}{s_i^2}\)이며 \(n_i\)는 표본크기, \(s_i^2\)은 집단 \(i\)의 분산이다. 가중치는 각 집단의 분산에 반비례하도록 조정하여 분산이 작은 집단에 더 큰 영향력을 준다.
-
\(1 - w_i/W\): 전체 가중치 중 집단 \(i\)가 차지하는 몫이 얼마나 작은지를 나타낸다. 어느 한 집단이 압도적이면 유효 자유도가 줄어든다.
-
\(n_i - 1\)로 나누기: 각 집단의 분산 추정이 얼마나 불확실한지를 반영한다.
목적: 이 식은 분산과 표본크기의 차이를 반영하여 유효 자유도를 제공한다. 이 값은 반드시 정수는 아니지만, F-통계량을 F-분포의 임계값과 비교하는 데 결정적이다.
가중치 \(w_i = n_i/s_i^2\)이 실제로 무엇을 바꾸는지, 아래 연습문제 1의 투자 전략 자료로 확인해 보자. 모멘텀 \((n = 36,\ s^2 = 12.5)\), 가치 \((n = 24,\ s^2 = 3.1)\), 인덱스 \((n = 48,\ s^2 = 5.8)\)이다.
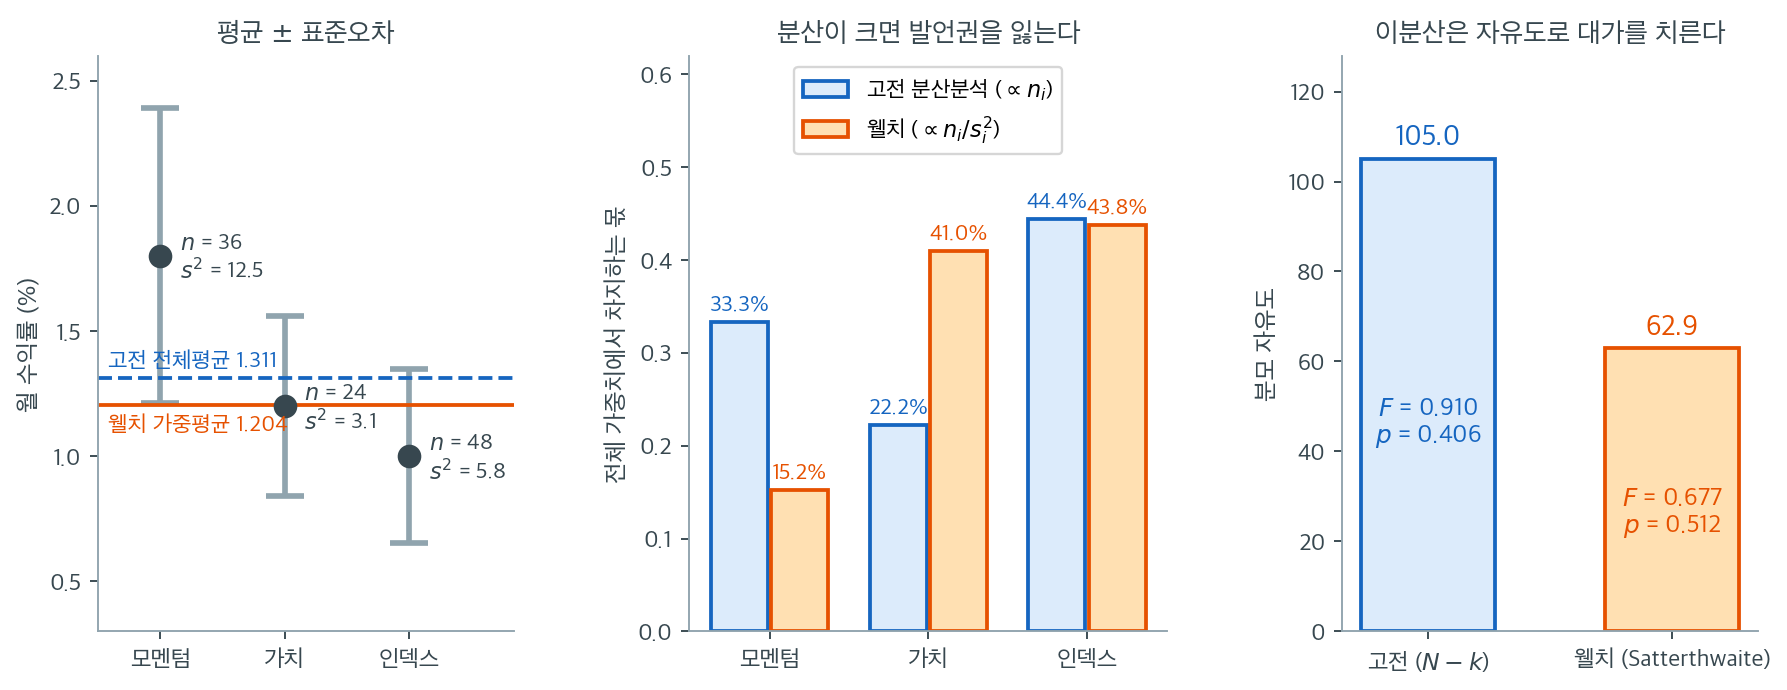
왼쪽 그림이 출발점이다. 모멘텀은 표본이 \(36\)개로 적지 않은데도 분산이 \(12.5\)로 커서 표준오차가 \(\sqrt{12.5/36} = 0.589\)나 된다. 가치는 표본이 \(24\)개뿐이지만 분산이 \(3.1\)이라 표준오차가 \(0.359\)이고, 인덱스는 \(0.348\)이다. 표본이 가장 많은 쪽이 아니라 분산이 가장 작은 쪽이 평균을 가장 정밀하게 추정한다.
가운데가 두 검정의 차이다. 고전 분산분석은 모든 집단이 같은 \(\sigma^2\)을 공유한다고 보므로, 각 집단의 발언권이 표본크기에만 비례한다. 모멘텀이 \(36/108 = 33.3\%\)를 가져간다. 웰치는 \(w_i = n_i/s_i^2\)로 가중하므로 모멘텀의 몫이 \(2.88/18.898 = 15.2\%\)로 반토막 난다. 반대로 가치는 \(22.2\%\)에서 \(41.0\%\)로 거의 두 배가 된다. "표본이 많다"가 아니라 "정밀하다"가 발언권의 기준이 되는 것이다. 그 결과 전체평균도 옮겨 간다. 표본크기로만 가중한 \(1.311\)에서, 정밀도로 가중한 \(\tilde{X} = 1.204\)로 내려앉는다. 가장 높은 평균 \(1.8\)을 기록한 모멘텀이 영향력을 잃었기 때문이다.
오른쪽이 그 대가다. 고전 분산분석의 분모 자유도는 \(N - k = 108 - 3 = 105\)로 고정이지만, Welch-Satterthwaite 식이 주는 유효 자유도는 \(62.9\)로 \(40\%\)가 깎인다. 분산이 같다는 정보를 포기한 값이다. 집단마다 분산을 따로 추정하느라 오차분산 추정의 불확실성이 커졌고, 그 불확실성이 자유도 감소로 표현된다. 이 자료에서는 두 검정 모두 기각하지 않지만(\(F = 0.910,\ p = 0.406\) 대 \(F_W = 0.677,\ p = 0.512\)), 등분산이 실제로 참일 때 웰치가 검정력에서 조금 손해를 본다는 9절의 한계가 이 자유도 감소로 나타난다.
6. Welch 분산분석의 수행 절차
- 가설 진술: \(H_0\): 모든 집단 평균이 같다. \(H_a\): 적어도 한 집단의 평균이 다르다.
- 가정 확인: 독립성, 정규성, 이분산(등분산일 필요는 없다).
- 검정통계량 계산: \(F\)와 그에 대응하는 자유도를 계산한다.
- p-값 결정: 계산된 자유도의 \(F\)-분포와 \(F\)-통계량을 비교한다.
- 판정: \(p \leq \alpha\)(예: 0.05)이면 \(H_0\)을 기각한다.
- 사후분석: \(H_0\)을 기각하면 어느 집단이 다른지 찾기 위해 사후검정(예: Games-Howell 검정)을 수행한다.
7. Python 구현
보기 1. 분산이 다른 경우의 Welch 분산분석.
풀이
import pingouin as pg
import pandas as pd

# 예시 자료
data = {
    "Group": ["A", "A", "A", "B", "B", "B", "C", "C", "C", "C"],
    "Values": [12, 14, 13, 22, 23, 19, 31, 33, 29, 35],
}
df = pd.DataFrame(data)

# Welch 분산분석 수행. scipy에는 없고 pingouin에 있다.
anova_results = pg.welch_anova(dv="Values", between="Group", data=df)

print(anova_results)
출력:
  Source  ddof1     ddof2          F     p_unc       np2
0  Group      2  4.142737  84.415503  0.000439  0.953739
- \(F\): 검정통계량.
- \(p\)(
p_unc): \(H_0\)을 기각할지 판단하는 p-값. pingouin 0.6부터 열 이름이p-unc에서p_unc로 바뀌었다. ddof2가 4.14로 정수가 아니다. Welch-Satterthwaite 자유도라서 그렇다. 표준 분산분석이었다면 \(N - k = 7\)이었을 텐데, 분산이 다르다는 사실이 실효 자유도를 그만큼 깎아냈다.
사후검정
Welch 분산분석이 유의한 차이를 찾으면, 등분산이나 동일 표본크기를 가정하지 않는 Games-Howell 검정 같은 사후검정을 쓴다:
보기 2. 합동을 버리면 늘 손해인가. 세 집단은 \(n = (3,3,4)\), \(s^2 = (1.00,\ 4.33,\ 6.67)\) 로 분산이 꽤 다르다.
(1) Games-Howell 과 Tukey–Kramer 가 같은 쌍에 쓰는 표준오차
를 나란히 두고, 세 쌍 중 어느 쌍에서 Games-Howell 쪽이 더 작은지 미리 짚으시오. 합동이 늘 유리한 것은 아님을 설명하시오.
(2) 출력표의 hedges 열이
임을 수치로 확인하고, 두 절차의 \(p\)-값을 견주시오.
풀이
(1) 해석적으로. 합동 \(MSW\) 는 세 집단의 분산을 자유도로 가중해 하나의 수로 만든다.
그러면 분산이 작은 집단은 손해를 보고 큰 집단은 이득을 본다. 자기 몫보다 큰(또는 작은) 분산을 배정받기 때문이다.
- A–B: 두 집단의 분산이 \(1.00\) 과 \(4.33\) 으로 합동값 \(4.381\) 보다 작거나 비슷하다. 합동은 이 쌍에 너무 큰 분산을 준다. 그러므로 \(\widehat{\operatorname{SE}}_{\text{GH}} < \widehat{\operatorname{SE}}_{\text{TK}}\) 이고 Games-Howell 쪽이 유리하다.
- A–C: \(1.00\) 과 \(6.67\) 의 조합인데, 분산이 큰 C 가 \(n = 4\) 로 크기도 커서 \(s_C^2/n_C\) 가 덜 부담스럽다. 역시 Games-Howell 쪽이 조금 작다.
- B–C: \(4.33\) 과 \(6.67\) 로 둘 다 합동값보다 크다. 여기서는 합동이 너무 작은 분산을 주므로 \(\widehat{\operatorname{SE}}_{\text{TK}} < \widehat{\operatorname{SE}}_{\text{GH}}\) 이고 Tukey 쪽이 (부당하게) 유리하다.
그러므로 "합동하면 자유도를 벌어 늘 유리하다"는 말은 틀렸다. 합동이 하는 일은 분산을 재분배하는 것이고, 등분산이 아니면 어떤 쌍은 득을 보고 어떤 쌍은 손해를 본다. Games-Howell 이 자유도를 잃는 대가로 얻는 것은 쌍마다 올바른 분모다.
(2) 수치적으로.
# Games-Howell 사후검정. Tukey HSD와 달리 쌍마다 자유도를 따로 계산한다.
post_hoc = pg.pairwise_gameshowell(dv="Values", between="Group", data=df)
print(post_hoc.round(4).to_string(index=False))
출력:
A B  mean_A  mean_B     diff     se        T     df   pval  hedges
A B 13.0000 21.3333  -8.3333 1.3333  -6.2500 2.8764 0.0188 -4.0825
A C 13.0000 32.0000 -19.0000 1.4142 -13.4350 4.0755 0.0004 -7.6277
B C 21.3333 32.0000 -10.6667 1.7638  -6.0474 4.9154 0.0044 -3.7514
세 쌍이 모두 유의하다. df 열이 쌍마다 2.88, 4.08, 4.92로 다르다는 점이 Games-Howell의 특징이다. Tukey HSD라면 세 비교 모두 같은 자유도 \(N - k = 7\)을 썼을 것이다.
hedges 열은 효과크기(Hedges의 \(g\))다. 두 절차를 나란히 돌리고 hedges 열도 손으로 만들어 본다.
import numpy as np
from itertools import combinations

from scipy import stats
from statsmodels.stats.multicomp import pairwise_tukeyhsd

g = df.groupby('Group')['Values'].agg(['mean', 'var', 'count'])
N, k = len(df), 3
MSW = ((g['count'] - 1) * g['var']).sum() / (N - k)
print(g.round(4))
print(f"합동 MSW = {MSW:.4f}  (자유도 {N - k})")

print(f"\n{'pair':<8}{'diff':>10}{'SE(GH)':>9}{'SE(TK)':>9}{'T(GH)':>9}{'T(TK)':>9}"
      f"{'df(GH)':>9}{'p(GH)':>9}{'p(TK)':>9}")
for a, b in combinations('ABC', 2):
    ma, va, na = g.loc[a]
    mb, vb, nb = g.loc[b]
    d = ma - mb
    se_gh = np.sqrt(va / na + vb / nb)
    se_tk = np.sqrt(MSW * (1 / na + 1 / nb))
    nu = (va / na + vb / nb) ** 2 / ((va / na) ** 2 / (na - 1)
                                     + (vb / nb) ** 2 / (nb - 1))
    p_gh = stats.studentized_range.sf(np.sqrt(2) * abs(d / se_gh), k, nu)
    p_tk = stats.studentized_range.sf(np.sqrt(2) * abs(d / se_tk), k, N - k)
    print(f"{a + '-' + b:<8}{d:>10.4f}{se_gh:>9.4f}{se_tk:>9.4f}{d / se_gh:>9.4f}"
          f"{d / se_tk:>9.4f}{nu:>9.4f}{p_gh:>9.4f}{p_tk:>9.4f}")

print("\nstatsmodels 의 Tukey-Kramer")
print(pairwise_tukeyhsd(df['Values'], df['Group'], alpha=0.05))

# hedges 열 재현
print(f"\n{'pair':<8}{'s_p':>9}{'d/s_p':>9}{'J':>9}{'hedges g':>10}")
for a, b in combinations('ABC', 2):
    ma, va, na = g.loc[a]
    mb, vb, nb = g.loc[b]
    dfp = na + nb - 2
    sp = np.sqrt(((na - 1) * va + (nb - 1) * vb) / dfp)
    J = 1 - 3 / (4 * dfp - 1)
    print(f"{a + '-' + b:<8}{sp:>9.4f}{(ma - mb) / sp:>9.4f}{J:>9.4f}"
          f"{J * (ma - mb) / sp:>10.4f}")
출력:
          mean     var  count
Group
A      13.0000  1.0000      3
B      21.3333  4.3333      3
C      32.0000  6.6667      4
합동 MSW = 4.3810  (자유도 7)

pair          diff   SE(GH)   SE(TK)    T(GH)    T(TK)   df(GH)    p(GH)    p(TK)
A-B        -8.3333   1.3333   1.7090  -6.2500  -4.8762   2.8764   0.0188   0.0044
A-C       -19.0000   1.4142   1.5986 -13.4350 -11.8853   4.0755   0.0004   0.0000
B-C       -10.6667   1.7638   1.5986  -6.0474  -6.6725   4.9154   0.0044   0.0007

statsmodels 의 Tukey-Kramer
Multiple Comparison of Means - Tukey HSD, FWER=0.05
===================================================
group1 group2 meandiff p-adj  lower   upper  reject
---------------------------------------------------
     A      B   8.3333 0.0044 3.3003 13.3664   True
     A      C     19.0    0.0 14.292  23.708   True
     B      C  10.6667 0.0007 5.9587 15.3747   True
---------------------------------------------------

pair          s_p    d/s_p        J  hedges g
A-B        1.6330  -5.1031   0.8000   -4.0825
A-C        2.0976  -9.0579   0.8421   -7.6277
B-C        2.3944  -4.4548   0.8421   -3.7514
(1)의 예측이 맞는다. 표준오차를 견주면
| 쌍 | \(\widehat{\operatorname{SE}}_{\text{GH}}\) | \(\widehat{\operatorname{SE}}_{\text{TK}}\) | 어느 쪽이 작은가 |
|---|---|---|---|
| A–B | \(1.3333\) | \(1.7090\) | GH |
| A–C | \(1.4142\) | \(1.5986\) | GH |
| B–C | \(1.7638\) | \(1.5986\) | TK |
로 B–C 에서만 방향이 뒤집힌다. 분산이 작은 A 가 끼는 두 쌍에서는 합동이 분모를 부풀려 손해를 주고, 분산이 큰 둘끼리 견주는 B–C 에서는 합동이 분모를 깎아 (부당하게) 도와준다. 통계량도 그대로 따라가 A–B 에서 \(|T|\) 가 \(4.88 \to 6.25\) 로 커지고 B–C 에서는 \(6.67 \to 6.05\) 로 작아진다.
그런데 \(p\)-값의 순서는 그대로가 아니다. A–B 에서 \(|T|\) 가 더 큰데도 \(p\) 는 \(0.0044\) 에서 \(0.0188\) 로 커졌다. 자유도가 \(7\) 에서 \(2.8764\) 로 깎였기 때문이다. \(\nu\) 가 \(3\) 아래로 내려가면 문턱이 가팔라진다는 것은 11.4절 Games-Howell 보기에서 본 그대로다. Games-Howell 이 치르는 값은 자유도이고, 그 값이 올바른 분모가 주는 이득을 넘어설 수도 있다.
그래도 결론은 세 쌍 모두에서 같다. 두 절차 다 세 쌍을 모두 유의하다고 판정한다. 효과가 워낙 커서(\(\lvert T\rvert \ge 6\)) 어지간한 자유도 손실로는 뒤집히지 않는다.
(2) hedges 열이 공식대로다. A–B 에서 합동표준편차가 \(s_p = 1.6330\), 표준화 차이가 \(-5.1031\), 소표본 보정 \(J = 1 - \frac{3}{4\cdot4-1} = 0.8\) 이므로 \(g = -4.0825\) 로 표와 같다. 나머지 두 쌍도 \(J = 0.8421\)(\(df = 5\))로 맞는다.
\(-3.75\) 에서 \(-7.63\) 이라는 값은 통상적인 기준의 "큼"(\(0.8\))을 한참 넘는다. 집단 간 차이가 집단 내 산포보다 훨씬 크다는 뜻이며, 관측값이 10개뿐인데도 \(p\) 가 이렇게 작은 이유이기도 하다. 다만 \(J\) 가 \(0.8\) 까지 내려간다는 것은 보정 전 값이 \(25\%\) 나 부풀려져 있었다는 뜻이고, 자유도가 이렇게 작으면 효과크기 추정 자체의 불확실성도 크다는 점을 함께 기억해 두는 편이 좋다.
8. 장점
- 등분산 가정이 없다: 이분산을 다룰 수 있다.
- 불균형 설계에 로버스트하다: 집단 크기가 달라도 적용할 수 있다.
- 분산이 다를 때 전통적인 일원배치 분산분석보다 정확하다.
9. 한계
- 정확한 결과를 위해서는 정규성 가정이 필요하다.
- 분산이 실제로 같을 때에는 전통적인 분산분석보다 검정력이 낮을 수 있다.
- 손으로 계산하기가 더 복잡하다.
10. 요약
Welch 분산분석은 등분산 가정이 어긋날 때 평균을 비교하도록 설계된 일원배치 분산분석의 확장이다. 로버스트하고 유연하며 이분산 자료를 분석하는 데 필수적이다. 어느 집단이 다른지 찾으려면 Games-Howell 검정 같은 사후검정을 권한다.
연습문제
연습문제 1. 세 가지 투자 전략을 월 수익률(%)로 비교한다. 자료는 다음과 같다:
| 전략 | \(n\) | \(\bar{Y}\) | \(s^2\) |
|---|---|---|---|
| 모멘텀 | 36 | 1.8 | 12.5 |
| 가치 | 24 | 1.2 | 3.1 |
| 인덱스 | 48 | 1.0 | 5.8 |
(a) 이 자료에 표준 일원배치 분산분석 F-검정이 적절하지 않을 수 있는 이유를 설명하라.
(b) Welch 분산분석은 다음 검정통계량을 쓴다:
여기서 \(w_i = n_i / s_i^2\)이고 \(\tilde{Y} = \sum w_i \bar{Y}_i / \sum w_i\)이다. 가중치 \(w_1, w_2, w_3\)과 가중 전체평균 \(\tilde{Y}\)를 계산하라.
(c) 전체 계산을 마치지 않더라도, Welch 접근이 분산이 작은 집단에 더 큰 가중치를 주는 이유를 개념적으로 설명하라.
풀이
(a) 집단 분산이 상당히 다르다: \(s_1^2 = 12.5\), \(s_2^2 = 3.1\), \(s_3^2 = 5.8\). 가장 큰 분산이 가장 작은 것의 약 네 배이다. 표본크기도 서로 다르므로(\(n = 36, 24, 48\)) 표준 F-검정의 등분산성 가정이 어긋난다. 합동분산 추정값은 어느 집단의 변동도 제대로 대표하지 못한다.
(b) 가중치: \(w_1 = 36/12.5 = 2.88\), \(w_2 = 24/3.1 = 7.74\), \(w_3 = 48/5.8 = 8.28\).
가중치의 합: \(\sum w_i = 2.88 + 7.74 + 8.28 = 18.90\).
가중 전체평균:
(c) 가중치 \(w_i = n_i / s_i^2\)은 집단 분산에 반비례한다. 분산이 작은 집단은 모평균을 더 정밀하게 추정하므로 분석에서 더 큰 가중치를 받는다. 분산이 작은 관측값이 추정에 더 많이 기여하는 가중최소제곱과 같은 원리이다. 모멘텀 전략은 표본크기가 가장 크지만 분산이 커서(\(s^2 = 12.5\)) 표본평균이 모평균의 덜 신뢰할 만한 추정값이 되므로 가장 낮은 가중치를 받는다.
연습문제 2. 연습문제 1을 끝까지 계산하라. \(F_W\), 자유도, \(p\)-값을 구하고 표준 \(F\) 검정의 결과와 비교하라.
풀이
import numpy as np
from scipy import stats

n = np.array([36.0, 24.0, 48.0])
m = np.array([1.8, 1.2, 1.0])
v = np.array([12.5, 3.1, 5.8])
k = len(n)

# --- 웰치 ---
w = n / v
W = w.sum()
mt = (w * m).sum() / W
A = (w * (m - mt)**2).sum() / (k - 1)
lam = ((1 - w / W)**2 / (n - 1)).sum()
B = 1 + 2 * (k - 2) / (k**2 - 1) * lam
F_w = A / B
df2 = (3 / (k**2 - 1) * lam)**-1
print("가중치 w:", np.round(w, 4), "  W =", round(W, 4))
print(f"가중 전체평균 = {mt:.4f}")
print(f"분자 A = {A:.6f},  보정항 B = {B:.6f},  λ = {lam:.6f}")
print(f"F_W = {F_w:.4f},  df1 = {k - 1},  df2 = {df2:.4f},  "
      f"p = {stats.f.sf(F_w, k - 1, df2):.4f}")

# --- 표준 F ---
N = n.sum()
gm = (n * m).sum() / N
SSB = (n * (m - gm)**2).sum()
SSW = ((n - 1) * v).sum()
F_c = (SSB / (k - 1)) / (SSW / (N - k))
print(f"\n표준 F = {F_c:.4f},  df = ({k - 1}, {int(N - k)}),  "
      f"p = {stats.f.sf(F_c, k - 1, N - k):.4f}")
가중치 w: [2.88   7.7419 8.2759]   W = 18.8978
가중 전체평균 = 1.2039
분자 A = 0.683777,  보정항 B = 1.010600,  λ = 0.042400
F_W = 0.6766,  df1 = 2,  df2 = 62.8933,  p = 0.5120

표준 F = 0.9102,  df = (2, 105),  p = 0.4056
두 검정 모두 기각하지 않는다. 세 전략의 월 수익률에 유의한 차이가 없다.
| \(F\) | \(\text{df}_2\) | \(p\) | |
|---|---|---|---|
| 웰치 | 0.677 | 62.89 | 0.512 |
| 표준 | 0.910 | 105 | 0.406 |
자유도가 105에서 62.89로 떨어진다. 40% 감소다. 분산이 다르다는 사실이 실효 정보량을 깎아먹은 것이다.
\(F\) 자체도 작아진다(0.910 → 0.677). 웰치는 분산이 큰 모멘텀 전략에 낮은 가중치를 주는데, 하필 그 집단의 평균(1.8)이 가장 높다. 평균이 가장 튀는 집단의 목소리를 줄인 셈이다.
보정항 \(B=1.0106\)은 1에 매우 가깝다. \(\lambda=0.0424\)가 작기 때문인데, 표본이 24~48개로 넉넉해서다. \(B\)는 표본이 작을 때만 의미 있게 작동한다.
결론을 어떻게 쓸까. "세 전략의 평균 월 수익률에 유의한 차이가 없다(웰치 \(F(2,\,62.9)=0.68\), \(p=0.51\))." 자유도를 소수점까지 적는 것이 웰치 결과 보고의 관례다.
주의. 이 자료에서는 결론이 같지만, 분산비가 4배 정도로 완만하고 표본이 충분했기 때문이다. 더 극단적인 상황에서는 두 검정이 정반대의 답을 낸다(연습문제 4).
연습문제 3.
요약통계만으로 웰치 분산분석을 수행하는 함수를 만들고, 원자료가 있을 때 pingouin의 결과와 소수점 여섯 자리까지 일치하는지 확인하라.
풀이
왜 필요한가. 논문에는 \(n\), 평균, 표준편차만 실려 있고 원자료가 없는 경우가 많다. 요약통계만으로 웰치 검정이 가능하다.
import numpy as np
import pandas as pd
from scipy import stats
import pingouin as pg

def welch_anova_summary(n, m, v):
    """요약통계(n, 평균, 분산)만으로 웰치 F 와 자유도를 계산한다."""
    n, m, v = map(np.asarray, (n, m, v))
    k = len(n)
    w = n / v
    W = w.sum()
    mt = (w * m).sum() / W
    lam = ((1 - w / W)**2 / (n - 1)).sum()
    F = ((w * (m - mt)**2).sum() / (k - 1)
         / (1 + 2 * (k - 2) / (k**2 - 1) * lam))
    df2 = (3 / (k**2 - 1) * lam)**-1
    return F, k - 1, df2, stats.f.sf(F, k - 1, df2)

# 검증: 평균과 분산을 정확히 지정한 자료를 만들어 대조한다
rng = np.random.default_rng(5)
rows = []
for i, (ni, mi, vi) in enumerate(zip([30, 20, 40], [0, 0.5, 1.0],
                                     [4.0, 1.0, 2.0])):
    x = rng.normal(0, 1, ni)
    x = (x - x.mean()) / x.std(ddof=1) * np.sqrt(vi) + mi   # 표준화 후 재척도
    rows.append(pd.DataFrame({"y": x, "g": f"G{i}"}))
df = pd.concat(rows, ignore_index=True)

g = df.groupby("g").y.agg(["size", "mean", "var"])
F, d1, d2, p = welch_anova_summary(g["size"], g["mean"], g["var"])
print(f"자작 구현:   F = {F:.6f},  df2 = {d2:.6f},  p = {p:.6f}")

r = pg.welch_anova(dv="y", between="g", data=df)
print(f"pingouin:  F = {r.F[0]:.6f},  df2 = {r.ddof2[0]:.6f},  "
      f"p = {r.p_unc[0]:.6f}")
자작 구현:   F = 2.988446,  df2 = 52.608843,  p = 0.058981
pingouin:  F = 2.988446,  df2 = 52.608843,  p = 0.058981
여섯 자리까지 완전히 일치한다. 구현이 옳다.
이 함수가 여는 문. 셋.
- 메타분석. 여러 논문의 요약통계를 모아 재분석한다.
- 검정력 분석. 가상의 \((n,\bar y,s^2)\)을 넣어 설계를 미리 평가한다.
- 민감도 분석. 한 집단의 분산을 바꿔 가며 결론이 얼마나 흔들리는지 본다.
검증 방법이 요령이다. 난수를 그냥 뽑으면 표본 평균·분산이 지정값과 다르다. 여기서는
x ← (x - x̄) / s × √v + m
로 표본 평균과 표본 분산을 정확히 원하는 값으로 고정했다. 구현을 대조할 때 자주 쓰는 기법이다.
한계. 요약통계만으로는 정규성과 이상값을 점검할 수 없다. 웰치가 완화한 것은 등분산 하나뿐이므로(연습문제 9), 원자료 없이 얻은 \(p\)는 가정이 성립한다는 전제 아래에서만 유효하다.
연습문제 4. 표준 \(F\) 검정이 이분산에서 얼마나 무너지는지 모의실험으로 재라. 표본크기와 분산의 짝짓기 방향이 결정적임을 보여라.
풀이
핵심 개념. 표본크기와 분산의 짝짓기에 이름이 있다.
| 이름 | 정의 | 표준 \(F\) |
|---|---|---|
| 정페어링 | 큰 \(n\)에 큰 \(\sigma\) | 보수적(오류율 하락) |
| 역페어링 | 큰 \(n\)에 작은 \(\sigma\) | 자유로움(오류율 폭증) |
import numpy as np
from scipy import stats

def welch_p(groups):
    n = np.array([len(g) for g in groups], float)
    m = np.array([g.mean() for g in groups])
    v = np.array([g.var(ddof=1) for g in groups])
    k = len(n)
    w = n / v
    W = w.sum()
    mt = (w * m).sum() / W
    lam = ((1 - w / W)**2 / (n - 1)).sum()
    F = ((w * (m - mt)**2).sum() / (k - 1)
         / (1 + 2 * (k - 2) / (k**2 - 1) * lam))
    return stats.f.sf(F, k - 1, (3 / (k**2 - 1) * lam)**-1)

rng = np.random.default_rng(20240)
M = 2_000
print(f"{'설계':>32s} {'표준 F':>8s} {'웰치':>8s}")
cases = [
    ("등분산 n=(20,20,20) σ=(1,1,1)", [20, 20, 20], [1, 1, 1]),
    ("이분산 n=(20,20,20) σ=(1,1,3)", [20, 20, 20], [1, 1, 3]),
    ("정페어링 n=(10,20,40) σ=(1,2,3)", [10, 20, 40], [1, 2, 3]),
    ("역페어링 n=(10,20,40) σ=(3,2,1)", [10, 20, 40], [3, 2, 1]),
    ("역페어링 n=(5,10,40)  σ=(4,2,1)", [5, 10, 40], [4, 2, 1]),
]
for lab, ns, sds in cases:
    a = b = 0
    for _ in range(M):
        gs = [rng.normal(0, s, n) for n, s in zip(ns, sds)]
        a += stats.f_oneway(*gs).pvalue < 0.05
        b += welch_p(gs) < 0.05
    print(f"{lab:>32s} {a / M:8.4f} {b / M:8.4f}")
                              설계     표준 F       웰치
      등분산 n=(20,20,20) σ=(1,1,1)   0.0525   0.0540
      이분산 n=(20,20,20) σ=(1,1,3)   0.0780   0.0565
     정페어링 n=(10,20,40) σ=(1,2,3)   0.0150   0.0480
     역페어링 n=(10,20,40) σ=(3,2,1)   0.1930   0.0475
     역페어링 n=(5,10,40)  σ=(4,2,1)   0.3745   0.0635
역페어링에서 표준 \(F\)의 제1종 오류율이 0.37이다. 명목의 7.5배다. 참인 귀무가설을 세 번에 한 번 이상 기각한다.
웰치는 모든 경우에 0.05 근처를 유지한다(0.048~0.064). 마지막 줄의 0.0635는 약간 높은데, \(n=5\) 집단이 있어 자유도 근사가 덜 정확하기 때문이다.
왜 짝짓기 방향이 중요한가. 표준 \(F\)의 분모는 합동 MSE다.
\(n_i-1\)로 가중하므로 큰 집단의 분산이 지배한다.
| 짝짓기 | MSE가 반영하는 것 | 결과 |
|---|---|---|
| 역페어링 | 큰 \(n\) = 작은 \(\sigma\) → MSE가 과소 | 분모가 작아져 \(F\) 폭증 |
| 정페어링 | 큰 \(n\) = 큰 \(\sigma\) → MSE가 과대 | 분모가 커져 \(F\) 위축 |
정페어링의 0.0150도 문제다. 오류율이 낮아 보이지만 이는 검정력을 잃었다는 뜻이다. 실제 차이가 있어도 못 잡는다.
등분산 검정을 먼저 하면 되지 않을까. 권장되지 않는다.
- 레빈 검정의 검정력이 낮아 작은 표본에서 이분산을 놓친다.
- 두 단계 절차 자체가 오류율을 왜곡한다(사전검정의 역설).
- 웰치의 손실이 작다(연습문제 5).
권고 — 등분산 검정을 거치지 말고 처음부터 웰치를 쓴다. 이는 현대 통계 교과서의 일반적 조언이며, 웰치 \(t\) 검정을 기본으로 삼는 것과 같은 논리다.
연습문제 5. "등분산일 때는 표준 \(F\)가 낫다"는 말의 값을 재라. 웰치가 잃는 검정력은 얼마인가?
풀이
import numpy as np
from scipy import stats

def welch_p(groups):
    n = np.array([len(g) for g in groups], float)
    m = np.array([g.mean() for g in groups])
    v = np.array([g.var(ddof=1) for g in groups])
    k = len(n)
    w = n / v
    W = w.sum()
    mt = (w * m).sum() / W
    lam = ((1 - w / W)**2 / (n - 1)).sum()
    F = ((w * (m - mt)**2).sum() / (k - 1)
         / (1 + 2 * (k - 2) / (k**2 - 1) * lam))
    return stats.f.sf(F, k - 1, (3 / (k**2 - 1) * lam)**-1)

rng = np.random.default_rng(555)
M = 2_000
print(f"{'설계 (모두 등분산 σ=1)':>32s} {'표준 F':>8s} {'웰치':>8s} {'손실':>8s}")
for lab, ns, mus in [
    ("n=(10,10,10) μ=(0,0.5,1)", [10, 10, 10], [0, 0.5, 1.0]),
    ("n=(20,20,20) μ=(0,0.5,1)", [20, 20, 20], [0, 0.5, 1.0]),
    ("n=(5,5,5)    μ=(0,1,2)", [5, 5, 5], [0, 1, 2]),
    ("n=(10,10,10,10,10) μ=0..1", [10] * 5, [0, 0.25, 0.5, 0.75, 1.0]),
]:
    a = b = 0
    for _ in range(M):
        gs = [rng.normal(u, 1, n) for n, u in zip(ns, mus)]
        a += stats.f_oneway(*gs).pvalue < 0.05
        b += welch_p(gs) < 0.05
    print(f"{lab:>32s} {a / M:8.4f} {b / M:8.4f} {(a - b) / max(a, 1):8.4f}")
                 설계 (모두 등분산 σ=1)     표준 F       웰치       손실
        n=(10,10,10) μ=(0,0.5,1)   0.4690   0.4455   0.0501
        n=(20,20,20) μ=(0,0.5,1)   0.7830   0.7780   0.0064
          n=(5,5,5)    μ=(0,1,2)   0.7060   0.6210   0.1204
       n=(10,10,10,10,10) μ=0..1   0.4430   0.4090   0.0767
손실이 작다. 상대 손실이 \(n=20\)에서 0.6%, \(n=10\)에서 5%다.
| 설계 | 상대 손실 |
|---|---|
| \(n=20\), \(k=3\) | 0.6% |
| \(n=10\), \(k=3\) | 5.0% |
| \(n=10\), \(k=5\) | 7.7% |
| \(n=5\), \(k=3\) | 12.0% |
손실은 \(n\)이 작을수록, \(k\)가 클수록 커진다. 자유도 조정 때문인데, 등분산·등표본에서도 웰치의 \(\text{df}_2\)는
로 표준의 \(N-k=k(n-1)\)보다 작다(연습문제 7).
비용과 편익을 나란히 놓으면 답이 분명하다.
| 등분산일 때 | 이분산일 때 | |
|---|---|---|
| 표준 \(F\) | 기준 | 오류율 0.37(연습문제 4) |
| 웰치 | 검정력 \(-0.6\%\sim-12\%\) | 오류율 0.05 유지 |
작은 보험료로 큰 재앙을 막는다. \(n\geq10\)이면 손실이 5% 이하이고, 이분산일 때의 이득은 오류율 7배 차이다.
예외. \(n\leq5\)처럼 표본이 아주 작으면 손실이 12%로 커진다. 그런 자료에서는
- 등분산을 믿을 근거가 설계에 있는지 따진다,
- 순열검정을 쓴다,
- 애초에 표본을 늘린다.
세 번째가 정답이다.
연습문제 6. \(k=2\)일 때 웰치 분산분석이 웰치 \(t\) 검정의 제곱과 정확히 같음을 확인하고, 자유도도 일치함을 보여라.
풀이
import numpy as np
from scipy import stats

def welch_F(groups):
    n = np.array([len(g) for g in groups], float)
    m = np.array([g.mean() for g in groups])
    v = np.array([g.var(ddof=1) for g in groups])
    k = len(n)
    w = n / v
    W = w.sum()
    mt = (w * m).sum() / W
    lam = ((1 - w / W)**2 / (n - 1)).sum()
    F = ((w * (m - mt)**2).sum() / (k - 1)
         / (1 + 2 * (k - 2) / (k**2 - 1) * lam))
    df2 = (3 / (k**2 - 1) * lam)**-1
    return F, df2, stats.f.sf(F, k - 1, df2)

rng = np.random.default_rng(777)
print(f"{'':4s} {'F_W':>10s} {'t²':>10s} {'df2':>9s} "
      f"{'t 의 df':>9s} {'p(F)':>9s} {'p(t)':>9s}")
for i in range(4):
    a = rng.normal(0, 1, rng.integers(8, 25))
    b = rng.normal(0.6, 2.5, rng.integers(8, 25))
    F, df2, p = welch_F([a, b])
    t = stats.ttest_ind(a, b, equal_var=False)
    print(f"{i:4d} {F:10.6f} {t.statistic**2:10.6f} {df2:9.4f} "
          f"{t.df:9.4f} {p:9.6f} {t.pvalue:9.6f}")
            F_W         t²       df2    t 의 df      p(F)      p(t)
   0   8.778756   8.778756   31.1663   31.1663  0.005792  0.005792
   1   1.767110   1.767110   17.8449   17.8449  0.200486  0.200486
   2   0.145205   0.145205   14.9190   14.9190  0.708532  0.708532
   3   2.267246   2.267246   19.6365   19.6365  0.148052  0.148052
네 경우 모두 소수점 여섯 자리까지 같다.
증명. \(k=2\)이면 보정항이
로 사라진다. 분자는
인데, \(\tilde X=(w_1\bar X_1+w_2\bar X_2)/W\)이므로
이고, 따라서
마지막 등식은 \(w_i=n_i/s_i^2\)을 넣고 정리하면 나온다.
자유도도 같다. \(k=2\)에서
이고, \(1-w_1/W=w_2/W\)이므로 이것이 곧 새터스웨이트 식
이 된다. \(\square\)
의미 셋.
- 웰치 분산분석은 웰치 \(t\) 검정의 자연스러운 확장이다. 새 아이디어가 아니라 같은 아이디어의 \(k\)-집단 판이다.
- \(F=t^2\) 관계는 표준 분산분석과 합동 \(t\) 검정 사이에서도 성립한다. 같은 구조가 반복된다.
- 보정항 \(B\)는 \(k\geq3\)에서만 작동한다. \(k=2\)에서는 보정할 것이 없다.
연습문제 7. 웰치의 \(\text{df}_2\)가 등분산·등표본에서도 \(N-k\)보다 작음을 보이고, 닫힌 식을 유도하라.
풀이
유도. 모든 \(n_i=n\), 모든 \(s_i^2\)이 같으면 \(w_i\)가 모두 같으므로
이고, 따라서
표준 분산분석의 \(N-k=k(n-1)\)과 비교하면
import numpy as np

print(f"{'k':>3s} {'df2/(N-k)':>11s}   해석")
for k in [2, 3, 4, 5, 6, 10, 20]:
    r = (k + 1) / (3 * (k - 1))
    note = "표준보다 큼" if r > 1 else ("같음" if abs(r - 1) < 1e-9 else "표준보다 작음")
    print(f"{k:3d} {r:11.4f}   {note}")

print(f"\n{'n':>5s} {'k':>3s} {'df2':>9s} {'N-k':>6s}")
for ns, vs in [([10, 10, 10], [1, 1, 1]),
               ([10, 10, 10], [1, 1, 100]),
               ([5, 5, 100], [1, 1, 1]),
               ([100, 100, 100], [1, 1, 1]),
               ([5, 5, 5], [1, 1, 1])]:
    n = np.array(ns, float)
    v = np.array(vs, float)
    k = len(n)
    w = n / v
    W = w.sum()
    lam = ((1 - w / W)**2 / (n - 1)).sum()
    df2 = (3 / (k**2 - 1) * lam)**-1
    print(f"{str(ns):>16s} {str(vs):>12s} → df2 = {df2:9.4f}   "
          f"N-k = {int(n.sum() - k):4d}")
  k   df2/(N-k)   해석
  2      1.0000   같음
  3      0.6667   표준보다 작음
  4      0.5556   표준보다 작음
  5      0.5000   표준보다 작음
  6      0.4667   표준보다 작음
 10      0.4074   표준보다 작음
 20      0.3684   표준보다 작음

    n   k       df2    N-k
    [10, 10, 10]    [1, 1, 1] → df2 =   18.0000   N-k =   27
    [10, 10, 10]  [1, 1, 100] → df2 =   16.0528   N-k =   27
     [5, 5, 100]    [1, 1, 1] → df2 =    5.8523   N-k =  107
 [100, 100, 100]    [1, 1, 1] → df2 =  198.0000   N-k =  297
       [5, 5, 5]    [1, 1, 1] → df2 =    8.0000   N-k =   12
핵심 사실 넷.
- \(k=2\)에서만 비율이 1이다. 웰치 \(t\) 검정이 등분산·등표본에서 합동 \(t\) 검정과 자유도가 같다는 익숙한 사실과 일치한다.
- \(k\geq3\)이면 언제나 작다. \(k=3\)에서 2/3, \(k=10\)에서 0.41이다.
- \(k\)가 커질수록 비율이 \(1/3\)로 수렴한다. 이것이 연습문제 5에서 \(k=5\)의 손실이 \(k=3\)보다 컸던 이유다.
- 극단적 불균형이 자유도를 파괴한다. \(n=(5,5,100)\)에서 \(N-k=107\)인데 \(\text{df}_2=5.85\)다.
네 번째가 실무적으로 가장 중요하다. 표본 107개를 모았는데 실효 자유도가 6에 불과하다. 작은 두 집단이 병목이기 때문이다.
설계 지침. 웰치를 쓸 계획이라면 집단 크기를 고르게 하라. 한 집단만 키워도 실효 자유도는 거의 늘지 않는다.
표준 \(F\)에서는 왜 이런 일이 없나. 합동 MSE가 모든 집단의 정보를 하나로 합치기 때문이다. 그것이 등분산 가정의 대가이자 보상이다. 가정이 맞으면 자유도를 벌고, 틀리면 오류율을 잃는다.
연습문제 8. 본문이 권하는 게임스-하웰과 Tukey HSD의 가족단위 오류율을 이분산 아래에서 비교하라.
풀이
게임스-하웰의 구조. 스튜던트화 범위 분포를 쓰되, 쌍마다 표준오차와 자유도를 따로 계산한다.
import numpy as np
from scipy import stats
from statsmodels.stats.libqsturng import qsturng

def tukey_any(groups, qcrit):
    """Tukey-Kramer: 합동 MSE 와 공통 자유도를 쓴다."""
    n = np.array([len(g) for g in groups], float)
    m = np.array([g.mean() for g in groups])
    v = np.array([g.var(ddof=1) for g in groups])
    MSE = ((n - 1) * v).sum() / (n.sum() - len(n))
    for i in range(len(n)):
        for j in range(i + 1, len(n)):
            if abs(m[i] - m[j]) / np.sqrt(MSE / 2 * (1 / n[i] + 1 / n[j])) > qcrit:
                return True
    return False

def gh_any(groups, alpha=0.05):
    """게임스-하웰: 쌍마다 웰치형 표준오차와 자유도를 쓴다."""
    k = len(groups)
    n = np.array([len(g) for g in groups], float)
    m = np.array([g.mean() for g in groups])
    v = np.array([g.var(ddof=1) for g in groups])
    for i in range(k):
        for j in range(i + 1, k):
            s = v[i] / n[i] + v[j] / n[j]
            df = s**2 / (v[i]**2 / (n[i]**2 * (n[i] - 1))
                         + v[j]**2 / (n[j]**2 * (n[j] - 1)))
            if abs(m[i] - m[j]) / np.sqrt(s / 2) > qsturng(1 - alpha, k, df):
                return True
    return False

rng = np.random.default_rng(8642)
M = 1_500
print("완전 귀무 하의 FWER (세 집단 평균 모두 0, 명목 0.05)")
print(f"{'설계':>32s} {'Tukey':>8s} {'G-H':>8s}")
for lab, ns, sds in [
    ("등분산 n=(20,20,20) σ=(1,1,1)", [20, 20, 20], [1, 1, 1]),
    ("이분산 n=(20,20,20) σ=(1,1,4)", [20, 20, 20], [1, 1, 4]),
    ("역페어링 n=(10,20,40) σ=(4,2,1)", [10, 20, 40], [4, 2, 1]),
    ("정페어링 n=(10,20,40) σ=(1,2,4)", [10, 20, 40], [1, 2, 4]),
]:
    qc = qsturng(0.95, 3, sum(ns) - 3)
    a = b = 0
    for _ in range(M):
        gs = [rng.normal(0, s, n) for n, s in zip(ns, sds)]
        a += tukey_any(gs, qc)
        b += gh_any(gs)
    print(f"{lab:>32s} {a / M:8.4f} {b / M:8.4f}")
완전 귀무 하의 FWER (세 집단 평균 모두 0, 명목 0.05)
                              설계    Tukey      G-H
      등분산 n=(20,20,20) σ=(1,1,1)   0.0460   0.0473
      이분산 n=(20,20,20) σ=(1,1,4)   0.0760   0.0487
     역페어링 n=(10,20,40) σ=(4,2,1)   0.2640   0.0373
     정페어링 n=(10,20,40) σ=(1,2,4)   0.0067   0.0393
연습문제 4와 똑같은 그림이 사후검정 수준에서 반복된다.
| 설계 | Tukey | G-H |
|---|---|---|
| 등분산 | 0.046 | 0.047 |
| 이분산(균형) | 0.076 | 0.049 |
| 역페어링 | 0.264 | 0.037 |
| 정페어링 | 0.007 | 0.039 |
역페어링에서 Tukey의 FWER이 0.264다. 다섯 배가 넘는다.
등분산에서는 둘이 사실상 같다(0.046 대 0.047). 게임스-하웰을 기본으로 써도 잃는 것이 거의 없다는 뜻이다.
게임스-하웰이 약간 보수적인 경우가 있다(0.037, 0.039). 자유도 근사가 작은 표본에서 보수적으로 작동하기 때문인데, 오류율이 명목보다 낮은 쪽이 높은 쪽보다 안전하다.
정페어링에서 Tukey의 0.0067은 위험 신호다. 오류율이 명목의 1/7이라는 것은 검정력을 그만큼 버렸다는 뜻이다. 실제 차이가 있어도 찾지 못한다.
파이프라인이 일관되어야 한다.
| 전체 검정 | 사후검정 |
|---|---|
| 표준 \(F\) | Tukey HSD |
| 웰치 \(F\) | 게임스-하웰 |
웰치로 검정하고 Tukey로 사후분석하는 것은 모순이다. 앞에서는 등분산을 가정하지 않다가 뒤에서 가정하는 셈이기 때문이다.
더넷형 비교가 필요하면 등분산을 가정하지 않는 변형(Dunnett's T3, Dunnett's C)을 쓴다. pingouin의 pairwise_gameshowell이 가장 손쉬운 선택이다.
연습문제 9. 웰치가 완화한 것은 등분산 하나뿐이다. 치우침과 두꺼운 꼬리에서 어떻게 되는지 재고, 절사평균 기반 대안이 만능이 아닌 이유를 보여라.
풀이
import numpy as np
from scipy import stats

def welch_p(groups):
    n = np.array([len(g) for g in groups], float)
    m = np.array([g.mean() for g in groups])
    v = np.array([g.var(ddof=1) for g in groups])
    k = len(n)
    w = n / v
    W = w.sum()
    mt = (w * m).sum() / W
    lam = ((1 - w / W)**2 / (n - 1)).sum()
    F = ((w * (m - mt)**2).sum() / (k - 1)
         / (1 + 2 * (k - 2) / (k**2 - 1) * lam))
    return stats.f.sf(F, k - 1, (3 / (k**2 - 1) * lam)**-1)

def trim_stats(x, tr=0.2):
    """절사평균과 윈저화 분산(Yuen 의 표준오차용)."""
    x = np.sort(x)
    n = len(x)
    g = int(np.floor(tr * n))
    win = np.clip(x, x[g], x[n - g - 1])
    d = win.var(ddof=1) * (n - 1) / ((n - 2 * g - 1) * (n - 2 * g))
    return x[g:n - g].mean(), d, n - 2 * g

def yuen_welch(groups, tr=0.2):
    """절사평균에 웰치 구조를 씌운 검정 (Yuen)."""
    st = [trim_stats(g, tr) for g in groups]
    m = np.array([s[0] for s in st])
    d = np.array([s[1] for s in st])
    h = np.array([s[2] for s in st], float)
    k = len(groups)
    w = 1 / d
    W = w.sum()
    mt = (w * m).sum() / W
    lam = ((1 - w / W)**2 / (h - 1)).sum()
    F = ((w * (m - mt)**2).sum() / (k - 1)
         / (1 + 2 * (k - 2) / (k**2 - 1) * lam))
    return stats.f.sf(F, k - 1, (3 / (k**2 - 1) * lam)**-1)

rng = np.random.default_rng(3141)
M = 1_500
print("제1종 오류율 — 세 집단 평균이 모두 0, n=(10,20,40), σ 배율=(3,2,1)")
print(f"{'분포':>24s} {'표준 F':>8s} {'웰치':>8s} {'절사웰치':>9s}")
dists = {
    "정규": lambda n, s: rng.normal(0, s, n),
    "로그정규": lambda n, s: (np.exp(rng.normal(0, 1, n)) - np.exp(0.5)) * s,
    "지수": lambda n, s: (rng.exponential(1, n) - 1) * s,
    "t(3)": lambda n, s: rng.standard_t(3, n) * s,
}
for lab, f in dists.items():
    a = b = c = 0
    for _ in range(M):
        gs = [f(n, s) for n, s in zip([10, 20, 40], [3, 2, 1])]
        a += stats.f_oneway(*gs).pvalue < 0.05
        b += welch_p(gs) < 0.05
        c += yuen_welch(gs) < 0.05
    print(f"{lab:>24s} {a / M:8.4f} {b / M:8.4f} {c / M:9.4f}")
제1종 오류율 — 세 집단 평균이 모두 0, n=(10,20,40), σ 배율=(3,2,1)
                      분포     표준 F       웰치      절사웰치
                      정규   0.2067   0.0427    0.0600
                    로그정규   0.1973   0.1753    0.3120
                      지수   0.2033   0.1140    0.1833
                    t(3)   0.1893   0.0320    0.0533
웰치도 심한 치우침에서 무너진다. 로그정규에서 0.175, 지수에서 0.114다.
| 분포 | 웰치 | 판정 |
|---|---|---|
| 정규 | 0.043 | 양호 |
| \(t(3)\) 두꺼운 꼬리 | 0.032 | 양호(약간 보수적) |
| 지수(치우침 2) | 0.114 | 문제 |
| 로그정규(치우침 6) | 0.175 | 심각 |
두꺼운 꼬리는 견디지만 치우침은 못 견딘다. 대칭이면 \(\bar X\)의 분포가 빨리 정규에 가까워지지만, 치우치면 \(\bar X\) 자체가 치우친 채 남기 때문이다.
그런데 절사평균 웰치가 더 나쁘다(0.312). 왜 그런가.
함정의 정체. 이 모의실험은 기저 분포에 배율 \(s\)를 곱해 집단을 만든다. 평균은 모두 0이지만,
기저 로그정규의  평균  =  0.000
기저 로그정규의 20% 절사평균 = -0.537    ← 0 이 아니다!

따라서 배율 s 를 곱하면
  s=3: 평균 0,  절사평균 -1.610
  s=2: 평균 0,  절사평균 -1.073
  s=1: 평균 0,  절사평균 -0.537
세 집단의 절사평균이 서로 다르다. 절사평균 검정에게 이 상황은 귀무가설이 거짓이다. 0.312는 오류율이 아니라 검정력이었다.
여기서 배울 것 — 로버스트 방법은 다른 모수를 검정한다.
| 방법 | 검정하는 모수 |
|---|---|
| 표준 \(F\) · 웰치 | 평균 \(\mu_i\) |
| 절사평균 웰치 | 절사평균 \(\mu_{t,i}\) |
| 크러스컬-월리스 | 확률적 우위(\(P(X_i>X_j)\)) |
대칭 분포에서는 셋이 일치하지만, 치우치면 갈린다. "로버스트 방법으로 바꾸자"는 말은 질문 자체를 바꾸자는 말일 수 있다.
치우친 자료에서 평균을 비교하려면.
| 방법 | 내용 |
|---|---|
| 변환 | 로그·제곱근으로 대칭화한 뒤 웰치 — 단, 해석 척도가 바뀐다 |
| 부트스트랩 | 집단별 재표집으로 웰치 \(F\)의 영분포를 직접 만든다 |
| 일반화 선형모형 | 감마·로그정규 회귀로 치우침을 모형화한다 |
| 표본 늘리기 | 중심극한정리에 기대되, 치우침 6이면 \(n\)이 수백 필요 |
최종 정리. 웰치는 등분산만 해결한다. 정규성이 깨지면 별도의 처방이 필요하고, 그 처방을 고를 때는 "무엇을 비교하려는가"를 먼저 정해야 한다.
연습문제 10. 웰치 일원배치 분산분석의 사용 지침을 정리하라.
풀이
한 줄 요약. 웰치는 합동 분산을 쓰지 않는 \(F\) 검정이다. 집단마다 \(s_i^2\)을 따로 두고 \(w_i=n_i/s_i^2\)로 가중하며, 자유도를 새터스웨이트로 근사한다.
언제 쓰는가.
| 상황 | 선택 |
|---|---|
| 분산이 다를 가능성이 조금이라도 있음 | 웰치 |
| 표본크기가 불균형 | 웰치(역페어링이 치명적) |
| 등분산을 설계로 보장 + \(n\)이 매우 작음 | 표준 \(F\) 고려 |
| 심한 치우침 | 변환·부트스트랩(웰치만으로는 부족) |
| 이상값 지배 | 로버스트 방법(단, 모수가 바뀐다) |
핵심 수치 다섯.
| 사실 | 값 | 출처 |
|---|---|---|
| 역페어링에서 표준 \(F\)의 오류율 | 0.37 | 연습문제 4 |
| 등분산일 때 웰치의 검정력 손실 | 0.6~12% | 연습문제 5 |
| 등분산·등표본에서 \(\text{df}_2/(N-k)\) | \(\dfrac{k+1}{3(k-1)}\) | 연습문제 7 |
| 역페어링에서 Tukey의 FWER | 0.26 | 연습문제 8 |
| 로그정규에서 웰치의 오류율 | 0.18 | 연습문제 9 |
실행 절차.
1. 집단별 n, 평균, 표준편차를 먼저 본다
     ↓
2. 분산비와 n 의 짝짓기 방향을 확인한다
     (역페어링이면 표준 F 를 절대 쓰지 않는다)
     ↓
3. 웰치 F 를 수행한다  →  pg.welch_anova
     ↓
4. 잔차의 치우침을 확인한다
     (심하면 변환·부트스트랩)
     ↓
5. 유의하면 게임스-하웰로 사후검정
     ↓
6. 보고: F(df1, df2) 를 소수점까지, 효과크기, 집단별 요약
하지 말아야 할 것 넷.
- 등분산 검정으로 웰치 여부를 고르지 않는다. 사전검정은 오류율을 왜곡한다.
- 웰치로 검정하고 Tukey로 사후분석하지 않는다. 가정이 모순된다.
- 자유도를 반올림해 보고하지 않는다. 62.89를 63으로 적으면 재현이 어려워진다.
- 정규성 문제를 웰치로 덮지 않는다. 웰치는 등분산만 다룬다.
도구.
| 작업 | 도구 |
|---|---|
| 웰치 분산분석 | pingouin.welch_anova |
| 게임스-하웰 | pingouin.pairwise_gameshowell |
| 두 집단 웰치 | scipy.stats.ttest_ind(equal_var=False) |
| 요약통계만 있을 때 | 직접 구현(연습문제 3) |
한 문장. 등분산을 의심할 이유가 조금이라도 있으면 웰치를 쓴다. 보험료는 검정력 몇 퍼센트이고, 보험금은 오류율 일곱 배다.
정리하며
웰치 분산분석은 등분산 가정을 없앤 일원배치 검정이다.
- 표준 \(F\) 검정은 합동 MSE 를 쓴다. 모든 집단이 같은 \(\sigma^2\) 을 공유한다고 보고 하나로 합치는 것이며, 그 가정이 깨지면 제1종 오류율이 어긋난다.
- 웰치는 집단마다 분산을 따로 쓰고 가중한다. 가중치가 \(w_i=n_i/s_i^2\) 이므로 정밀한 집단에 더 무게를 준다. 7장에서 본 역분산 가중과 같은 원리다.
- 자유도가 새터스웨이트 근사로 정해진다. 정수가 아니며, 8장·9장의 웰치 \(t\) 검정과 같은 장치다.
- 정규성은 여전히 필요하다. 웰치가 완화한 것은 등분산 하나뿐이며, 심한 치우침이나 이상치에는 여전히 취약하다.
- 불균형 설계에서 특히 유용하다. 분산이 다르고 표본크기도 다를 때 표준 \(F\) 가 가장 크게 어긋난다.
다음 절 Welch의 이원배치 분산분석으로 넘어간다.