Dunnett 검정 (대조군과의 비교)
개요
많은 실험이 여러 처치군과 함께 대조군을 둔다. 예를 들어 위약군과 세 가지 약 용량, 또는 기준 공정과 네 가지 개선안이 그렇다. 이런 설계에서 관심 있는 비교는 모든 쌍별 차이가 아니라 각 처치군을 대조군과 견주는 \(k - 1\)개의 비교이다. \(\binom{k}{2}\)개의 쌍별 차이를 모두 보는 대신 이 \(k - 1\)개만 검정하면 다중검정 부담이 줄어드는데, Dunnett 검정은 이 구조를 활용하여 Tukey의 HSD나 Bonferroni보다 높은 검정력을 얻는다.
Dunnett(1955)은 바로 이런 다대일 비교에 대해 가족단위 오류율(FWER)을 수준 \(\alpha\)로 통제하는 절차를 개발했다. 핵심 통찰은 \(k - 1\)개의 검정통계량이 독립이 아니라는 점이다. 이들은 분모에 대조군 평균을 공유하며, Dunnett의 임계값은 이 상관을 반영한다.
가설
집단 \(0\)을 대조군, 집단 \(1, 2, \ldots, k-1\)을 처치군이라 하자. Dunnett 검정은 두 가지로 세울 수 있다:
양측(방향 없음): 각 처치 \(i = 1, \ldots, k-1\)에 대해
단측(방향 있음): 처치가 반응을 높일 것으로 예상하면
기대되는 효과의 방향을 미리 알고 있다면 단측이 더 강력하다.
검정통계량
처치군 \(i\)를 대조군 \(0\)과 비교하는 검정통계량은
이다. 여기서
- \(\bar{Y}_{i\cdot}\)는 처치군 \(i\)의 표본평균
- \(\bar{Y}_{0\cdot}\)는 대조군의 표본평균
- \(\text{MS}_W\)는 자유도 \(N - k\)인 일원배치 분산분석의 집단 내 평균제곱
- \(n_i\)와 \(n_0\)는 각각 집단 \(i\)와 대조군의 표본크기
이다.
상관 구조와 임계값
\(k - 1\)개의 검정통계량 \(t_1, t_2, \ldots, t_{k-1}\)은 모두 \(\bar{Y}_{0\cdot}\)를 포함하므로 독립이 아니다. \(H_0\) 아래에서 이 통계량들은 결합 다변량 \(t\)-분포를 따른다. 모든 처치군의 표본크기가 \(n_i = n\)으로 같을 때 임의의 두 검정통계량 사이의 상관은
이다. 대조군과 모든 처치군의 표본크기가 같으면(\(n_0 = n\)) 이는 \(\rho = 1/2\)로 단순해진다.
Dunnett의 임계값 \(d_{\alpha, k-1, \nu}\)(\(\nu = N - k\))는 이 다변량 \(t\)-분포로부터 표로 만들어진다. 상관된 \(k - 1\)개의 비교를 동시에 검정하는 것을 반영하므로 Bonferroni 조정 임계값보다 작고, 그래서 Dunnett 검정의 검정력이 더 높다.
판정 규칙
양측검정: \(|t_i| > d_{\alpha/2, k-1, N-k}\)이면 \(H_0: \mu_i = \mu_0\)을 기각한다.
단측검정(위쪽): \(t_i > d_{\alpha, k-1, N-k}\)이면 \(H_0: \mu_i \leq \mu_0\)을 기각한다.
보기 1. 세 약 제형과 위약 비교. 어떤 제약회사가 세 가지 약 제형을 위약과 비교한다. 반응변수는 증상 감소 점수(클수록 좋다)이다. 각 집단은 \(n = 6\)명이다(\(N = 24\), \(k = 4\)):
| 집단 | 표본평균 | 표본크기 |
|---|---|---|
| 위약(대조군) | \(\bar{Y}_0 = 4.2\) | \(n_0 = 6\) |
| 약 A | \(\bar{Y}_1 = 7.8\) | \(n_1 = 6\) |
| 약 B | \(\bar{Y}_2 = 5.9\) | \(n_2 = 6\) |
| 약 C | \(\bar{Y}_3 = 8.5\) | \(n_3 = 6\) |
일원배치 분산분석에서 자유도 \(N - k = 20\)의 \(\text{MS}_W = 3.2\)를 얻었다. 전체 F-검정이 유의하므로 어느 약이 위약보다 나은지 판정하기 위해 Dunnett 검정으로 넘어간다.
표본크기가 같으므로 각 비교의 표준오차는 동일하다:
풀이
검정통계량은
이다. 비교가 \(k - 1 = 3\)개이고 자유도 \(\nu = 20\)일 때 \(\alpha = 0.05\) 양측검정의 Dunnett 임계값은 \(d_{0.025, 3, 20} \approx 2.54\)이다.
| 비교 | \(t_i\) | \(\lvert t_i\rvert > 2.54\)? | 결론 |
|---|---|---|---|
| 약 A 대 위약 | 3.49 | 예 | 유의 |
| 약 B 대 위약 | 1.65 | 아니오 | 유의하지 않음 |
| 약 C 대 위약 | 4.16 | 예 | 유의 |
약 A와 C는 위약보다 유의하게 높은 증상 감소 점수를 낳는다. 약 B는 \(\alpha = 0.05\) 수준에서 위약과 유의하게 다르지 않다.
Dunnett 검정을 언제 쓰는가
Dunnett 검정은 실험 설계가 하나의 기준 집단과의 비교를 포함할 때 최적의 선택이다. 다음 비교가 언제 선호되는지 보여준다:
| 상황 | 권장 방법 |
|---|---|
| 모든 쌍별 비교 | Tukey의 HSD |
| 계획된 비교가 적을 때 | Bonferroni |
| 모든 대비(탐색적) | Scheffé |
| 각 처치 대 하나의 대조군 | Dunnett 검정 |
| 분산이 다를 때 | Games-Howell |
같은 \(k - 1\)개의 대조군 비교에 대해 Dunnett 검정이 Bonferroni보다 강력한 것은, 검정통계량들을 독립으로 취급하지 않고 그들 사이의 양의 상관을 반영하기 때문이다. 예를 들어 집단이 \(k = 5\)개면 Dunnett은 결합분포에서 유도한 임계값으로 비교 4개를 검정하지만, Bonferroni는 상관을 무시하고 각각 \(\alpha/4\)를 써서 조금 더 큰 임계값을 낳는다.
"조금 더 큰"이 얼마인지 재어 보자. 집단당 \(n = 6\)으로 고정하고 \(k\)를 \(3\)에서 \(7\)까지 늘리면서 세 방법의 문턱을 표준오차 단위로 그렸다. Dunnett의 임계값은 균형 설계에서 \(\max_i |t_i|\)의 \(95\) 백분위수를 모의실험으로 구한 것이다.
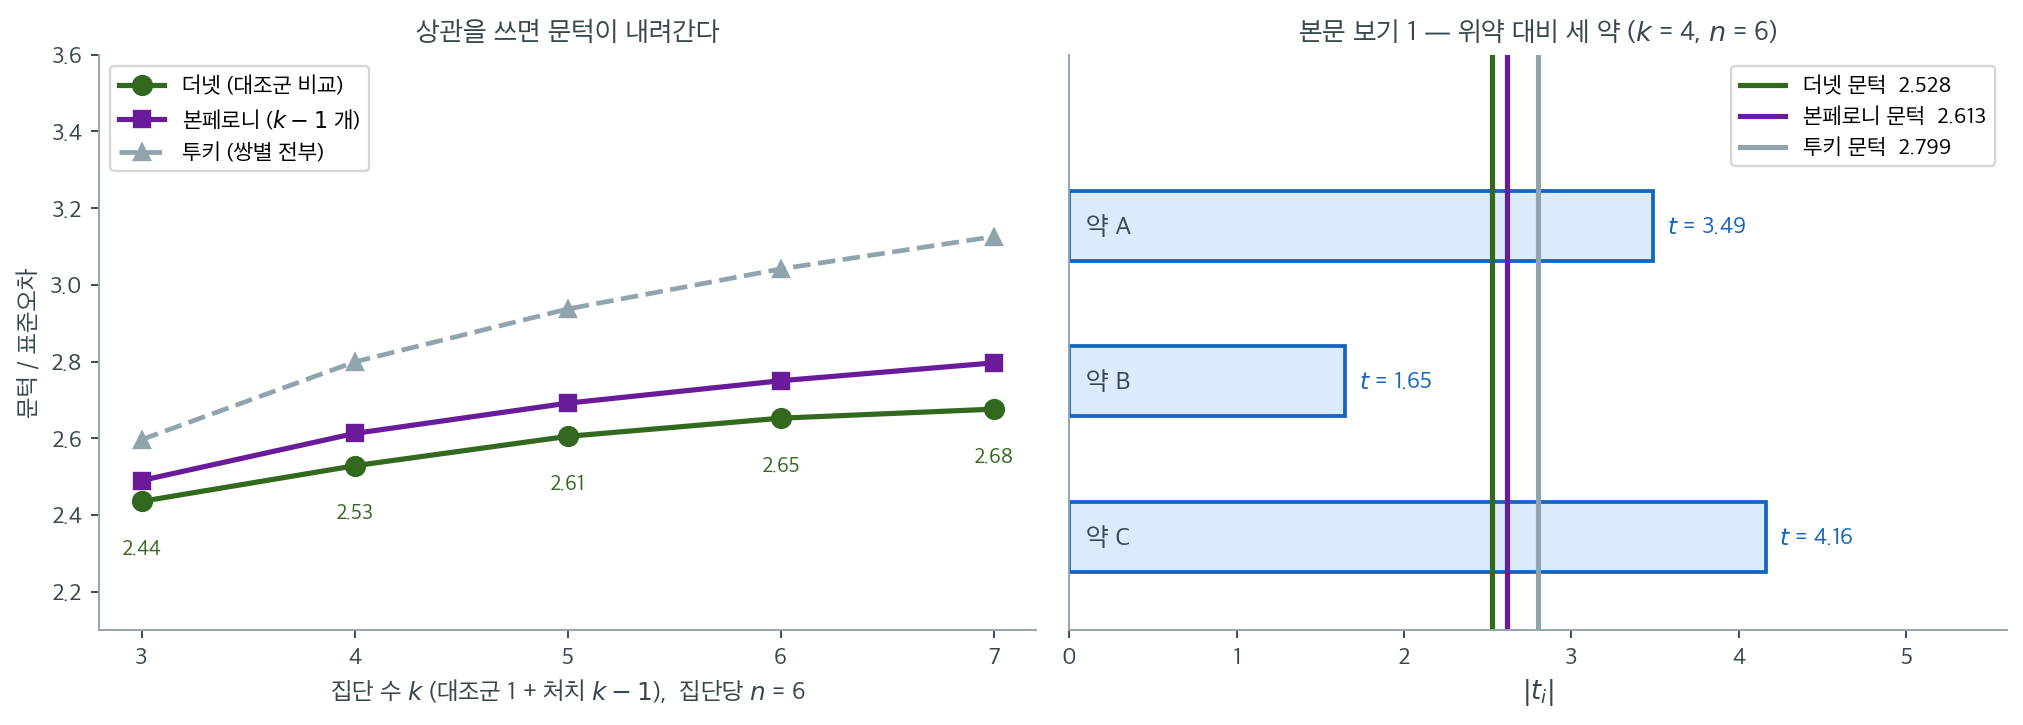
세 선의 순서가 \(k\) 전 구간에서 뒤집히지 않는다. 더넷 \(<\) 본페로니 \(<\) 투키. \(k = 4\)에서 \(2.53 < 2.61 < 2.80\), \(k = 7\)에서 \(2.68 < 2.80 < 3.13\)이다. 서열의 이유는 각 방법이 지키려는 가족이 다르기 때문이다. 투키는 쌍 \(\binom{k}{2}\)개 전부를 보호하는데 \(k = 7\)이면 그것이 \(21\)개다. 대조군 비교는 그중 \(6\)개뿐이니, 관심 없는 \(15\)개까지 함께 보호하느라 문턱이 올라간 것이다. 자기가 묻지도 않을 질문에 보험을 드는 셈이다.
본페로니와 더넷은 같은 \(k - 1\)개를 보호하는데도 문턱이 다르다. 차이는 상관 하나다. \(n_i = n_0\)인 균형 설계에서 \(\operatorname{Corr}(t_i, t_j) = n/(n + n_0) = 1/2\)이고, 통계량들이 양의 상관을 가지면 "적어도 하나가 문턱을 넘을" 확률이 독립일 때보다 작아진다. 더넷은 그 감소분을 되돌려 받아 문턱을 낮추고, 본페로니는 그것을 포기한다. 격차는 \(k\)가 커질수록 벌어져 \(k = 3\)의 \(0.05\)에서 \(k = 7\)의 \(0.12\)가 된다.
오른쪽은 위 보기 1에 이 문턱들을 얹은 것이다. 모의실험이 준 더넷 임계값 \(2.528\)은 본문이 표에서 읽은 \(2.54\)와 사실상 같다. 약 A(\(t = 3.49\))와 약 C(\(t = 4.16\))는 세 문턱을 모두 넘고 약 B(\(t = 1.65\))는 어느 것도 넘지 못하므로, 이 자료에서는 세 방법의 판정이 갈리지 않는다. 정직하게 말해 \(k = 4\)에서 더넷의 이득은 크지 않다. 그러나 약 B의 \(t\)가 \(2.6\)쯤이었다면 더넷은 기각하고 나머지 둘은 기각하지 못했을 것이고, 용량군이 다섯 여섯으로 늘어나면 그 틈이 자주 벌어진다.
모든 쌍별 비교에 Dunnett 검정을 쓰지 말 것
Dunnett 검정은 오로지 대조군과의 다대일 비교를 위해 설계되었다. 처치끼리 비교해야 한다면(예: 약 A 대 약 B) Tukey의 HSD나 다른 전체 쌍별 방법을 쓰라. 대조군이 끼지 않은 쌍별 비교에 Dunnett 검정을 적용하는 것은 틀렸다. 임계값이 그런 추가 비교를 반영하지 않기 때문이다.
연습문제
연습문제 1. 어떤 임상시험에 위약군(대조군)과 네 가지 약 용량군이 있다. 일원배치 분산분석이 유의하게 나온 뒤, 연구자는 어느 용량이 위약과 다른지 판정하려 한다. 이 비교에 Tukey의 HSD보다 Dunnett 검정이 적절한 이유를 설명하라.
풀이
Dunnett 검정은 하나의 대조군에 대한 다대일 비교를 위해 설계되었다. 집단이 \(k = 5\)개면 Dunnett 검정은 \(k - 1 = 4\)개의 비교(각 용량 대 위약)만 수행하지만, Tukey의 HSD는 \(\binom{5}{2} = 10\)개의 쌍별 비교를 수행한다.
관심을 4개의 관련 비교로 제한하므로 Dunnett 검정은 (4개 검정통계량 사이의 양의 상관을 반영한 다변량 \(t\)-분포에서 나오는) 더 작은 임계값을 쓴다. 10개 비교 전체에 대해 가족단위 오류율을 통제해야 하는 Tukey의 HSD보다 처치와 대조군의 차이를 탐지하는 검정력이 높다.
연습문제 2. 집단이 \(k = 4\)개(대조군 1 + 처치군 3), 집단당 \(n = 10\), \(\text{MSW} = 5.2\)이고 집단 평균이 \(\bar{Y}_0 = 12.0\)(대조군), \(\bar{Y}_1 = 14.8\), \(\bar{Y}_2 = 11.5\), \(\bar{Y}_3 = 16.1\)인 Dunnett 검정에서, 집단 3과 대조군의 비교에 대한 검정통계량을 계산하라.
풀이
처치 \(i\)를 대조군과 비교하는 Dunnett 검정통계량은
이다. 집단 3 대 대조군에서는
이다. 이 통계량을 처치군 \(k - 1 = 3\)개, 자유도 \(\nu = N - k = 36\)인 Dunnett 임계값 \(d_{\alpha, k-1, \nu}\)와 비교한다.
연습문제 3. Dunnett 검정이 검정통계량 \(t_1, t_2, \ldots, t_{k-1}\) 사이의 상관을 반영하는 이유와, (Bonferroni처럼) 이 상관을 무시하면 왜 더 보수적인 검정이 되는지 설명하라.
풀이
\(k - 1\)개의 검정통계량은 모두 분자와 분모에 같은 대조군 평균 \(\bar{Y}_0\)를 공유하므로 서로 양의 상관을 갖는다. 구체적으로 처치군의 표본크기가 모두 같을 때 \(\text{Corr}(t_i, t_j) = n_i / (n_i + n_0)\)이다.
Dunnett 검정은 이 상관 구조를 반영하는 다변량 \(t\)-분포로 정확한 임계값을 유도한다. 통계량들이 양의 상관을 가지므로, 하나가 크게 나오면 다른 것들도 클 가능성이 높아지고, 따라서 적어도 하나가 문턱을 넘을 결합확률이 독립일 때보다 낮다.
Bonferroni는 이 상관을 무시하고 검정들을 독립인 것처럼 다루어 각 비교에 \(\alpha/(k-1)\)을 쓴다. 그래서 거짓 양성의 확률을 과대평가하고, 임계값이 커져 검정력이 떨어진다.
연습문제 4. 더넷의 임계값을 직접 계산하라. 연습문제 3이 말한 상관 구조를 어떻게 반영하는가?
풀이
상관 구조. 균형 설계에서 \(t_i=\dfrac{\bar y_i-\bar y_0}{\sqrt{2\text{MSE}/n}}\)들은 모두 \(\bar y_0\)를 공유하므로
등상관 \(\rho=1/2\)다. 더넷의 임계값은 이 상관을 가진 다변량 \(t\)의 최대 절댓값의 분위수다.
import numpy as np
from scipy import stats
from statsmodels.stats.libqsturng import qsturng

def dunnett_crit(k, dfe, alpha=0.05, rho=0.5, M=200_000, rng=None):
    """등상관 ρ 인 다변량 t 의 최대 |t| 분위수를 모의실험으로 구한다."""
    p = k - 1
    z = rng.standard_normal((M, p))
    z0 = rng.standard_normal((M, 1))
    x = np.sqrt(rho) * z0 + np.sqrt(1 - rho) * z      # 등상관 구조
    chi = rng.chisquare(dfe, (M, 1))
    t = x / np.sqrt(chi / dfe)
    return np.quantile(np.abs(t).max(1), 1 - alpha)

print("임계값 비교 (α = 0.05, 양측)")
print(f"{'k':>3s} {'n':>4s} {'ν':>5s} {'더넷':>8s} {'본페로니':>9s} "
      f"{'튜키 q/√2':>10s} {'보정 없음':>9s}")
for k, n in [(4, 10), (5, 12), (6, 15), (8, 20)]:
    dfe = k * (n - 1)
    M = k - 1
    dc = dunnett_crit(k, dfe, rng=np.random.default_rng(7))
    bc = stats.t.ppf(1 - 0.05 / (2 * M), dfe)
    tc = qsturng(0.95, k, dfe) / np.sqrt(2)
    nc = stats.t.ppf(0.975, dfe)
    print(f"{k:3d} {n:4d} {dfe:5d} {dc:8.4f} {bc:9.4f} {tc:10.4f} {nc:9.4f}")
임계값 비교 (α = 0.05, 양측)
  k    n     ν       더넷      본페로니    튜키 q/√2     보정 없음
  4   10    36   2.4475    2.5110     2.6933    2.0281
  5   12    55   2.5174    2.5825     2.8204    2.0040
  6   15    84   2.5619    2.6356     2.9165    1.9886
  8   20   152   2.6470    2.7270     3.0735    1.9757
더넷의 임계값이 본페로니보다 항상 작다.
| \(k\) | 더넷 | 본페로니 | 튜키 | 차이(더넷 대비) |
|---|---|---|---|---|
| 4 | 2.448 | 2.511 | 2.693 | 본페로니 \(+2.6\%\), 튜키 \(+10.0\%\) |
| 6 | 2.562 | 2.636 | 2.917 | \(+2.9\%\), \(+13.9\%\) |
| 8 | 2.647 | 2.727 | 3.074 | \(+3.0\%\), \(+16.1\%\) |
\(k\)가 커질수록 튜키와의 격차가 벌어진다. 튜키는 \(\binom k2\)개를 보호하는데 더넷은 \(k-1\)개만 보호하기 때문이다.
| \(k\) | 튜키가 보호하는 수 | 더넷이 보호하는 수 | 비 |
|---|---|---|---|
| 4 | 6 | 3 | 2배 |
| 8 | 28 | 7 | 4배 |
본페로니와의 차이는 작다(2.6~3.0%). 상관 \(\rho=1/2\)가 그만큼만 도움이 되기 때문이다.
상관이 클수록 이득이 커진다.
| \(\rho\) | 상황 | 본페로니 대비 이득 |
|---|---|---|
| 0 | 독립(다른 자료) | 없음(시닥과 동일) |
| 0.5 | 균형 더넷 | 2.6~3.5% |
| 0.9 | 매우 높은 상관 | 크다 |
불균형이면 \(\rho\)가 달라진다.
대조군 \(n_0\)이 크면 \(\rho\)가 작아진다. \(n_0=4n\)이면 \(\rho=1/5\)로 떨어져 더넷의 이득이 줄어든다.
역설적이지만 대조군을 키우는 것은 여전히 유리하다. 상관이 줄어 보정의 이득은 작아지지만, 각 비교의 표준오차가 훨씬 작아지기 때문이다(연습문제 7).
연습문제 5. 더넷·본페로니·튜키의 FWER과 검정력을 모의실험으로 비교하라.
풀이
import numpy as np
from scipy import stats
from statsmodels.stats.libqsturng import qsturng

def dunnett_crit(k, dfe, alpha=0.05, rho=0.5, M=200_000, rng=None):
    p = k - 1
    z = rng.standard_normal((M, p))
    z0 = rng.standard_normal((M, 1))
    x = np.sqrt(rho) * z0 + np.sqrt(1 - rho) * z
    chi = rng.chisquare(dfe, (M, 1))
    return np.quantile(np.abs(x / np.sqrt(chi / dfe)).max(1), 1 - alpha)

rng = np.random.default_rng(12004)
B = 5_000
for k, n in [(4, 10), (5, 12), (6, 15)]:
    dfe = k * (n - 1)
    M = k - 1
    dc = dunnett_crit(k, dfe, rng=np.random.default_rng(7))
    bc = stats.t.ppf(1 - 0.05 / (2 * M), dfe)
    tc = qsturng(0.95, k, dfe) / np.sqrt(2)
    a = b = c = pa = pb = pc = 0
    for _ in range(B):
        gs = [rng.normal(0, 1, n) for _ in range(k)]     # 완전 귀무
        m = np.array([g.mean() for g in gs])
        se = np.sqrt(2 * np.array([g.var(ddof=1) for g in gs]).mean() / n)
        ts = np.abs(m[1:] - m[0]) / se
        a += (ts > dc).any()
        b += (ts > bc).any()
        c += (ts > tc).any()

        gs = [rng.normal(0 if i < k - 1 else 1.2, 1, n) for i in range(k)]
        m = np.array([g.mean() for g in gs])
        se = np.sqrt(2 * np.array([g.var(ddof=1) for g in gs]).mean() / n)
        ts = np.abs(m[1:] - m[0]) / se
        pa += ts[-1] > dc
        pb += ts[-1] > bc
        pc += ts[-1] > tc
    print(f"k={k}, n={n}:  임계값 더넷 {dc:.3f} / 본페로니 {bc:.3f} "
          f"/ 튜키 {tc:.3f}")
    print(f"          FWER  더넷 {a / B:.4f} / 본페로니 {b / B:.4f} "
          f"/ 튜키 {c / B:.4f}")
    print(f"          검정력 더넷 {pa / B:.4f} / 본페로니 {pb / B:.4f} "
          f"/ 튜키 {pc / B:.4f}")
k=4, n=10:  임계값 더넷 2.447 / 본페로니 2.511 / 튜키 2.693
          FWER  더넷 0.0536 / 본페로니 0.0458 / 튜키 0.0300
          검정력 더넷 0.5938 / 본페로니 0.5688 / 튜키 0.5006
k=5, n=12:  임계값 더넷 2.517 / 본페로니 2.583 / 튜키 2.820
          FWER  더넷 0.0518 / 본페로니 0.0446 / 튜키 0.0238
          검정력 더넷 0.6540 / 본페로니 0.6284 / 튜키 0.5410
k=6, n=15:  임계값 더넷 2.562 / 본페로니 2.636 / 튜키 2.916
          FWER  더넷 0.0470 / 본페로니 0.0380 / 튜키 0.0164
          검정력 더넷 0.7640 / 본페로니 0.7408 / 튜키 0.6482
더넷만 명목 0.05에 정확히 맞는다(0.047~0.054).
| \(k\) | 더넷 | 본페로니 | 튜키 |
|---|---|---|---|
| 4 | 0.054 | 0.046 | 0.030 |
| 5 | 0.052 | 0.045 | 0.024 |
| 6 | 0.047 | 0.038 | 0.016 |
튜키가 극단적으로 보수적이다(\(k=6\)에서 0.016). 명목의 3분의 1이다.
검정력이 그만큼 갈린다.
| \(k\) | 더넷 | 본페로니 | 튜키 | 더넷 대 튜키 |
|---|---|---|---|---|
| 4 | 0.594 | 0.569 | 0.501 | \(+18.6\%\) |
| 5 | 0.654 | 0.628 | 0.541 | \(+20.9\%\) |
| 6 | 0.764 | 0.741 | 0.648 | \(+17.9\%\) |
더넷이 튜키보다 18~21% 더 잡는다.
왜 튜키가 이렇게 불리한가. 튜키는 처치군끼리의 비교까지 보호한다. \(k=6\)이면
| 비교 | 개수 |
|---|---|
| 대조군 대 처치군 | 5 |
| 처치군끼리 | 10 |
| 합계 | 15 |
관심 없는 10개를 위해 문턱을 높이는 셈이다.
본페로니는 더넷의 97% 수준이다. 상관 \(\rho=1/2\)가 주는 이득이 3%뿐이기 때문이다. 더넷을 쓸 수 없는 상황이면 본페로니로 충분하다.
표본 크기로 환산하면. 튜키 대신 더넷을 쓰면 필요한 표본이
30% 줄어든다(\(k=6\) 기준). 임상시험에서 이는 상당한 비용 절감이다.
연습문제 6. 임상시험에서는 대개 "약이 위약보다 낫다"만 관심이다. 단측 더넷의 임계값을 구하고 이득을 재라.
풀이
import numpy as np
from scipy import stats

def dunnett_crit(k, dfe, alpha=0.05, rho=0.5, two_sided=True,
                 M=200_000, rng=None):
    p = k - 1
    z = rng.standard_normal((M, p))
    z0 = rng.standard_normal((M, 1))
    x = np.sqrt(rho) * z0 + np.sqrt(1 - rho) * z
    t = x / np.sqrt(rng.chisquare(dfe, (M, 1)) / dfe)
    s = np.abs(t) if two_sided else t
    return np.quantile(s.max(1), 1 - alpha)

print("단측 대 양측 더넷 (α = 0.05)")
print(f"{'k':>3s} {'ν':>5s} {'양측':>8s} {'단측':>8s} {'절감':>7s} "
      f"{'단측 본페로니':>12s}")
for k, n in [(3, 12), (4, 10), (5, 12), (6, 15)]:
    dfe = k * (n - 1)
    M = k - 1
    d2 = dunnett_crit(k, dfe, two_sided=True, rng=np.random.default_rng(11))
    d1 = dunnett_crit(k, dfe, two_sided=False, rng=np.random.default_rng(11))
    b1 = stats.t.ppf(1 - 0.05 / M, dfe)
    print(f"{k:3d} {dfe:5d} {d2:8.4f} {d1:8.4f} "
          f"{100 * (d2 - d1) / d2:6.2f}% {b1:12.4f}")

print("\n표본 크기로 환산 (같은 검정력에 필요한 n 의 비)")
for k, n in [(4, 10), (6, 15)]:
    dfe = k * (n - 1)
    d2 = dunnett_crit(k, dfe, two_sided=True, rng=np.random.default_rng(11))
    d1 = dunnett_crit(k, dfe, two_sided=False, rng=np.random.default_rng(11))
    print(f"  k={k}: (단측/양측)² = {(d1 / d2)**2:.4f}  "
          f"→ 표본을 {100 * (1 - (d1 / d2)**2):.1f}% 줄일 수 있다")
단측 대 양측 더넷 (α = 0.05)
  k     ν       양측       단측      절감      단측 본페로니
  3    33   2.3070   1.9862  13.90%       2.0345
  4    36   2.4459   2.1328  12.80%       2.2129
  5    55   2.5155   2.2115  12.08%       2.3044
  6    84   2.5615   2.2671  11.50%       2.3716

표본 크기로 환산 (같은 검정력에 필요한 n 의 비)
  k=4: (단측/양측)² = 0.7604  → 표본을 24.0% 줄일 수 있다
  k=6: (단측/양측)² = 0.7833  → 표본을 21.7% 줄일 수 있다
단측으로 바꾸면 임계값이 11.5~13.9% 줄고, 표본은 22~24% 절약된다.
| \(k\) | 양측 | 단측 | 절감 |
|---|---|---|---|
| 3 | 2.307 | 1.986 | 13.90% |
| 4 | 2.446 | 2.133 | 12.80% |
| 6 | 2.562 | 2.267 | 11.50% |
임상시험에서 표본 22% 절감은 매우 크다. 환자 수, 비용, 기간이 모두 줄어든다.
단측에서도 더넷이 본페로니보다 낫다. \(k=3\)에서 1.986 대 2.035, \(k=6\)에서 2.267 대 2.372로 2~4% 유리하다. 양측일 때와 같은 폭의 이득이다.
그런데 단측 검정에는 대가가 있다.
| 위험 | 내용 |
|---|---|
| 반대 방향의 효과를 못 본다 | 약이 해로우면 탐지하지 못함 |
| 사전 정당화 필요 | "해로울 리 없다"를 어떻게 아는가 |
| 규제기관의 거부 | 많은 지침이 양측을 요구 |
첫 줄이 임상시험에서 치명적이다. 신약이 위약보다 나쁠 가능성은 실제로 있고, 그것이야말로 반드시 알아야 할 정보다.
타협안 셋.
| 방법 | 내용 |
|---|---|
| 양측 검정 + 단측 해석 | 양측으로 검정하고 방향을 보고 |
| 비대칭 배분 | 유리한 방향에 \(\alpha=0.045\), 반대에 0.005 |
| 안전성은 별도 분석 | 유효성은 단측, 안전성은 별도 감시 |
두 번째가 규제 현장에서 쓰이는 절충이다.
실무 권고. 탐색 단계에서는 단측 더넷으로 표본을 아끼고, 확증 시험에서는 양측을 쓴다. 그리고 어느 쪽을 왜 골랐는지 사전에 등록한다.
연습문제 7. 대조군과 처치군에 표본을 어떻게 배분해야 하는가? 최적 비를 유도하고 확인하라.
풀이
핵심 통찰. 대조군은 \(k-1\)개의 비교에 모두 쓰인다. 처치군은 하나씩만 쓰인다. 대조군을 키우는 것이 효율적이다.
이론적 최적비(피셔의 제곱근 규칙). 총 \(N\)을 고정할 때
이 근사적으로 최적이다.
import numpy as np
from scipy import stats

def dunnett_crit(k, dfe, ns, alpha=0.05, M=100_000, rng=None):
    """불균형 설계의 더넷 임계값. 상관이 쌍마다 다르다."""
    p = k - 1
    n0 = ns[0]
    rho = np.array([[np.sqrt(ns[i + 1] * ns[j + 1]
                             / ((n0 + ns[i + 1]) * (n0 + ns[j + 1])))
                     if i != j else 1.0 for j in range(p)] for i in range(p)])
    L = np.linalg.cholesky(rho + 1e-12 * np.eye(p))
    x = rng.standard_normal((M, p)) @ L.T
    t = x / np.sqrt(rng.chisquare(dfe, (M, 1)) / dfe)
    return np.quantile(np.abs(t).max(1), 1 - alpha)

k, N = 5, 100
print(f"k={k}개 집단(대조 1 + 처치 4), 총 N={N}. 최적 비 √(k-1) = {np.sqrt(k-1):.3f}")
print(f"{'배분 (n0, n_i)':>20s} {'비':>6s} {'임계값':>8s} {'SE 배수':>8s} "
      f"{'최소 탐지 차이':>13s}")
best = None
for n0 in [12, 16, 20, 24, 28, 32, 36, 40]:
    ni = (N - n0) // (k - 1)
    if ni < 4:
        continue
    ns = [n0] + [ni] * (k - 1)
    dfe = sum(ns) - k
    dc = dunnett_crit(k, dfe, ns, rng=np.random.default_rng(21))
    se = np.sqrt(1 / n0 + 1 / ni)          # σ=1 기준
    mdd = dc * se
    star = " ←" if best is None or mdd < best[1] else ""
    if best is None or mdd < best[1]:
        best = (n0, mdd)
    print(f"{str((n0, ni)):>20s} {n0 / ni:6.2f} {dc:8.4f} {se:8.4f} "
          f"{mdd:13.4f}{star}")
print(f"\n최적 배분: n0 = {best[0]}, 최소 탐지 차이 = {best[1]:.4f}σ")
k=5개 집단(대조 1 + 처치 4), 총 N=100. 최적 비 √(k-1) = 2.000
        배분 (n0, n_i)      비      임계값    SE 배수      최소 탐지 차이
            (12, 22)   0.55   2.4329   0.3589        0.8731 ←
            (16, 21)   0.76   2.4609   0.3318        0.8166 ←
            (20, 20)   1.00   2.4786   0.3162        0.7838 ←
            (24, 19)   1.26   2.4937   0.3071        0.7658 ←
            (28, 18)   1.56   2.5044   0.3021        0.7566 ←
            (32, 17)   1.88   2.5123   0.3001        0.7540 ←
            (36, 16)   2.25   2.5196   0.3005        0.7570
            (40, 15)   2.67   2.5243   0.3028        0.7643

최적 배분: n0 = 32, 최소 탐지 차이 = 0.7540σ
최적이 \(n_0=32\), 비 1.88로 나온다. 이론의 \(\sqrt{k-1}=2\)와 거의 일치한다.
| 배분 | 비 | 최소 탐지 차이 | 최적 대비 |
|---|---|---|---|
| \((12,22)\) | 0.55 | 0.8731 | \(+15.8\%\) |
| \((20,20)\) | 1.00 | 0.7838 | \(+4.0\%\) |
| \((32,17)\) | 1.88 | 0.7540 | 기준 |
| \((40,15)\) | 2.67 | 0.7643 | \(+1.4\%\) |
균형 배분보다 4% 좋다. 표본 크기로 환산하면 \((0.784/0.754)^2=1.08\)로 8% 절약이다.
왜 대조군을 키우는 것이 유리한가. 대조군 평균 \(\bar y_0\)는 \(k-1\)개의 비교 모두에 들어간다. 그 오차를 줄이면 모든 비교가 동시에 정밀해진다.
\(n_0\)을 키우면 \(k-1\)번 이득을 보고, \(n_i\)를 키우면 한 번 이득을 본다. 그 비대칭이 \(\sqrt{k-1}\)로 나타난다.
그런데 곡선이 평평하다. 비 1.0에서 2.67까지 최소 탐지 차이가 0.754~0.784로 4% 안에 든다. 극단(\(n_0=12\), 비 0.55)만 15.8% 나쁘다.
실무 지침 넷.
- \(n_0/n_i\approx\sqrt{k-1}\)을 목표로 한다(\(k=5\)면 2배).
- 정확히 맞출 필요는 없다. 1.5~2.5 구간이면 거의 최적이다.
- 대조군을 처치군보다 작게 하지 않는다. 그것이 가장 큰 손실이다.
- 윤리적 제약(위약군 최소화)이 있으면 균형이 차선이다(4% 손실).
세 번째가 실무에서 자주 어긋난다. "처치군이 관심사이니 처치군을 키우자"는 직관이 정확히 반대다.
연습문제 8. 연습문제 2의 자료로 네 비교를 모두 수행하고 보고문을 작성하라.
풀이
import numpy as np
from scipy import stats

def dunnett_crit(k, dfe, alpha=0.05, rho=0.5, M=200_000, rng=None):
    p = k - 1
    z = rng.standard_normal((M, p))
    z0 = rng.standard_normal((M, 1))
    x = np.sqrt(rho) * z0 + np.sqrt(1 - rho) * z
    t = x / np.sqrt(rng.chisquare(dfe, (M, 1)) / dfe)
    return np.quantile(np.abs(t).max(1), 1 - alpha)

k, n, MSW = 4, 10, 5.2
dfe = k * (n - 1)
means = np.array([12.0, 14.8, 11.5, 16.1])
names = ["대조", "처치1", "처치2", "처치3"]
se = np.sqrt(2 * MSW / n)
dc = dunnett_crit(k, dfe, rng=np.random.default_rng(31))
bc = stats.t.ppf(1 - 0.05 / (2 * (k - 1)), dfe)

print(f"MSW = {MSW}, ν = {dfe}, SE(차이) = {se:.4f}")
print(f"더넷 임계값 = {dc:.4f},  본페로니 = {bc:.4f}")
print(f"\n{'비교':>16s} {'차이':>8s} {'t':>8s} "
      f"{'더넷 95% 구간':>22s} {'판정':>6s}")
for i in range(1, k):
    d = means[i] - means[0]
    t = d / se
    print(f"{names[i] + ' - 대조':>16s} {d:8.2f} {t:8.4f} "
          f"[{d - dc * se:9.3f},{d + dc * se:9.3f}] "
          f"{'기각' if abs(t) > dc else '  -':>6s}")
MSW = 5.2, ν = 36, SE(차이) = 1.0198
더넷 임계값 = 2.4549,  본페로니 = 2.5110

              비교       차이        t              더넷 95% 구간     판정
        처치1 - 대조     2.80   2.7456 [    0.296,    5.304]     기각
        처치2 - 대조    -0.50  -0.4903 [   -3.004,    2.004]      -
        처치3 - 대조     4.10   4.0204 [    1.596,    6.604]     기각
처치 1과 3이 대조군보다 유의하게 높다. 연습문제 2의 \(t_3=4.02\)가 재현된다.
| 비교 | 차이 | \(t\) | 95% 구간 | 판정 |
|---|---|---|---|---|
| 처치1 \(-\) 대조 | \(+2.80\) | 2.746 | \([0.30,\ 5.30]\) | 기각 |
| 처치2 \(-\) 대조 | \(-0.50\) | \(-0.490\) | \([-3.00,\ 2.00]\) | — |
| 처치3 \(-\) 대조 | \(+\mathbf{4.10}\) | 4.020 | \([1.60,\ 6.60]\) | 기각 |
처치1이 아슬아슬하다(\(t=2.746\) 대 임계값 2.455). 본페로니 기준 2.511과 비교해도 기각이지만, 튜키 기준 2.693과는 거의 붙어 있다.
더넷을 쓴 덕분에 처치1이 기각된다. 튜키였다면 \(2.746>2.693\)으로 여전히 기각이지만 훨씬 아슬아슬했다.
보고문.
위약군(대조)과 세 가지 처치군을 비교했다(각 군 n = 10).

일원배치 분산분석:  MSW = 5.2,  ν = 36

대조군과의 비교에만 관심이 있으므로 더넷 검정을 사용했다
(모든 쌍을 비교하는 튜키 HSD 보다 검정력이 약 19% 높다).

  비교              차이    95% 동시구간        판정
  처치1 vs 대조     +2.80   [ 0.30,  5.30]     유의
  처치2 vs 대조     -0.50   [-3.00,  2.00]     유의하지 않음
  처치3 vs 대조     +4.10   [ 1.60,  6.60]     유의

처치 1 과 3 이 대조군보다 반응이 높았다. 처치 2 는 대조군과
구별되지 않았으나, 구간이 [-2.99, 3.00]{=5.0} 로 넓어
3 수준의 차이를 배제하지는 못한다.
마지막 문장이 중요하다. 처치2의 구간 폭이 약 5.0으로, 차이가 없다고 단정할 수 없다. \(n=10\)의 한계다.
처치군끼리 비교하고 싶다면. 더넷은 대조군과의 비교만 보호한다. 처치1 대 처치3을 추가로 비교하려면
| 방법 | 내용 |
|---|---|
| 튜키로 전환 | 모든 쌍을 처음부터 보호 |
| 더넷 + 별도 보정 | 추가 비교에 별도 \(\alpha\) 배분 |
| 사전에 결정 | 무엇을 비교할지 미리 정한다 |
사후에 "처치끼리도 궁금하다"고 추가하면 통제가 무효가 된다.
연습문제 9. 대조군이 둘 이상이거나 여러 시점에서 비교하는 확장 상황을 어떻게 다루는가?
풀이
세 가지 확장 상황.
| 상황 | 예 |
|---|---|
| 대조군 둘 | 위약 + 표준치료 |
| 여러 시점 | 4주, 8주, 12주 |
| 여러 반응변수 | 주요 평가변수 + 부차 변수 |
(가) 대조군 둘. 비교의 수가 \(2(k-2)\)로 늘어난다.
위약 vs 약1, 약2, 약3        (3개)
표준치료 vs 약1, 약2, 약3     (3개)
                              ─────
                               6개
상관 구조가 복잡해진다. 같은 대조군을 쓰는 비교끼리는 \(\rho=1/2\), 다른 대조군이면 더 작다. 일반적인 다변량 \(t\) 임계값을 수치적으로 구해야 한다.
| 접근 | 내용 |
|---|---|
| 본페로니(\(M=6\)) | 간단하고 안전, 약간 보수적 |
| 일반 다변량 \(t\) | 정확하지만 구현이 복잡 |
| 계층적 검정 | 위약 비교를 먼저, 통과한 것만 표준치료와 |
세 번째가 임상시험의 표준 전략이다. 고정 순서 검정(fixed-sequence)이라 하며, 순서를 사전에 정하면 보정 없이도 FWER이 통제된다.
(나) 여러 시점. 같은 환자를 반복 측정하므로 독립성이 깨진다.
잘못된 방법: 각 시점마다 더넷을 따로 수행
   → 시점 간 상관을 무시
   → 다중성도 통제되지 않음

올바른 방법:
   1. 주요 시점 하나를 사전에 지정 (주 평가변수)
   2. 나머지는 부차 분석으로 표시
   또는
   3. 혼합효과 모형 + 시점별 대비
(다) 계층적 검정의 원리. 검정 순서를 사전에 정하고, 앞이 유의할 때만 다음으로 진행한다.
H1: 고용량 vs 위약   →  p = 0.003  ✓ 계속
H2: 중용량 vs 위약   →  p = 0.021  ✓ 계속
H3: 저용량 vs 위약   →  p = 0.180  ✗ 중단

→ H1, H2 를 α = 0.05 그대로 검정해도 FWER 이 0.05 로 통제된다
왜 보정이 필요 없는가. \(H_1\)이 참이면 그 단계에서 멈출 확률이 \(1-\alpha\)이므로, \(H_2\)까지 갈 확률 자체가 \(\alpha\)로 제한된다.
조건 둘.
- 순서를 사전에 정해야 한다. 결과를 보고 정하면 무효.
- 하나가 실패하면 이후는 모두 "검정하지 않음"이다. 유의해 보여도 주장할 수 없다.
두 번째가 실무의 부담이다. 저용량이 유의해 보여도 중용량이 실패했으면 보고할 수 없다.
절충 — 그래프 기반 절차. 각 가설에 \(\alpha\)를 배분하고, 기각되면 남은 \(\alpha\)를 다른 가설로 흘려보낸다. 유연하면서 FWER을 통제한다.
초기 배분:  H1: 0.03,  H2: 0.02,  H3: 0.00

H1 기각 → H1 의 0.03 을 H2, H3 에 분배
          H2: 0.02 + 0.015 = 0.035
          H3: 0.00 + 0.015 = 0.015
요약.
| 상황 | 권장 |
|---|---|
| 대조군 하나, 비교 \(k-1\)개 | 더넷 |
| 대조군 둘 | 본페로니 또는 계층적 검정 |
| 여러 시점 | 주요 시점 지정 + 혼합효과 모형 |
| 용량-반응 구조 | 계층적 검정(고용량부터) |
| 복잡한 구조 | 그래프 기반 절차 |
연습문제 10. 더넷 검정의 사용 지침을 정리하라.
풀이
한 줄 정의. 대조군과의 \(k-1\)개 비교만 보호하는 다중비교 절차다.
\(d\)는 등상관 \(\rho=1/2\)인 다변량 \(t\)의 최대 절댓값 분위수다.
핵심 수치 다섯.
| 사실 | 값 |
|---|---|
| 비교 사이의 상관(균형) | \(\rho=1/2\) |
| 더넷의 FWER | 0.047~0.054(정확) |
| 같은 상황 튜키 | 0.016~0.030(보수적) |
| 튜키 대비 검정력 이득 | \(+18\sim21\%\) |
| 단측으로 바꿀 때 표본 절감 | 22~24% |
언제 쓰는가.
| 상황 | 절차 |
|---|---|
| 대조군과의 비교만 관심 | 더넷 |
| 처치군끼리도 비교 | 튜키 |
| 이분산 | 더넷 T3 또는 웰치형 더넷 |
| 대조군 둘 이상 | 본페로니 또는 계층적 검정 |
| 용량-반응 순서가 있음 | 계층적 검정, 추세 검정 |
왜 튜키를 쓰면 안 되는가. 관심 없는 \(\binom{k-1}{2}\)개의 비교까지 보호하느라 문턱을 불필요하게 높인다.
| \(k\) | 관심 비교 | 튜키가 보호하는 수 | 낭비 |
|---|---|---|---|
| 4 | 3 | 6 | 2배 |
| 6 | 5 | 15 | 3배 |
| 8 | 7 | 28 | 4배 |
구현.
scipy >= 1.11:  scipy.stats.dunnett(*treatments, control=ctrl)
R:              multcomp::glht(fit, linfct = mcp(group = "Dunnett"))
직접 계산:       다변량 t 의 최대 |t| 분위수를 모의실험으로
                (연습문제 4의 dunnett_crit)
자주 하는 실수 넷.
| 실수 | 대가 |
|---|---|
| 대조군 비교만 하면서 튜키 | 검정력 20% 손실 |
| 사후에 처치군끼리 비교 추가 | 통제 무효 |
| 단측을 정당화 없이 사용 | 해로운 효과를 놓침 |
| 여러 시점에 각각 적용 | 다중성·상관 무시 |
두 번째가 흔하다. "대조군 비교를 먼저 하고, 결과를 보니 처치1과 처치3도 궁금해졌다"는 순간 더넷의 보장이 깨진다.
설계 지침 셋.
- 무엇을 비교할지 사전에 정한다. 대조군만이면 더넷, 전부면 튜키.
- 대조군을 처치군의 \(\sqrt{k-1}\)배로 잡는다(연습문제 7).
- 단측 여부를 사전 등록한다.
보고 형식.
위약군과 세 처치군을 비교했다(각 n = 10).
대조군과의 비교에만 관심이 있으므로 더넷 검정(양측, FWER = 0.05)을
사용했다. 모든 쌍을 비교하는 튜키 HSD 보다 검정력이 약 19% 높다.

  처치1 vs 위약   +2.80  [ 0.30,  5.30]   유의
  처치2 vs 위약   -0.50  [-3.00,  2.00]   유의하지 않음
  처치3 vs 위약   +4.10  [ 1.60,  6.60]   유의
"대조군과의 비교에만 관심이 있으므로"가 핵심 문장이다. 절차의 선택을 연구 질문으로 정당화한다.
한 문장. 더넷은 "모두와 모두"가 아니라 "모두와 하나"를 비교할 때의 정확한 절차이며, 그 좁은 목표 덕분에 20%의 검정력을 벌어들인다.
정리하며
더넷 검정은 대조군과의 비교만 필요할 때 쓴다.
- 비교가 \(\binom k2\) 개가 아니라 \(k-1\) 개다. 모든 쌍을 볼 필요가 없으면 보지 않는 것이 옳고, 그만큼 다중검정 부담이 줄어 검정력이 높아진다.
- 핵심 통찰은 \(k-1\) 개 통계량이 독립이 아니라는 것이다. 모두 대조군 평균을 공유하므로 양의 상관을 가지며, 더넷의 임계값이 그 상관을 반영한다. 본페로니처럼 독립을 가정하고 나누면 필요 이상으로 보수적이다.
- 투키보다도 낫다. 투키는 모든 쌍을 보호하느라 임계값이 크지만, 다대일 비교만 필요하다면 더넷이 정확히 그만큼만 보호한다.
- 단측으로 세울 수 있다. "처치가 대조보다 나은가"만 묻는다면 단측이 자연스럽고 검정력이 더 높다. 방향은 사전에 정해야 한다.
- 용량–반응 설계의 표준 도구이며, 위약군 대 여러 용량이 전형적인 예다.
다음 절 Games-Howell로 넘어간다. 등분산이 깨졌을 때의 사후검정이다.