베타–이항 켤레 갱신
개요
\(581\) 명에게 물어 \(281\) 명이 그 후보를 지지한다고 답했다. \(\hat\theta = 0.4836\) 이니 과반에 못 미친다고 읽고 싶지만, 「못 미칠 확률」을 수 하나로 적으려면 사전분포(prior distribution)를 골라야 한다. 여섯을 차례로 끼워 보면 그 확률이 \(0.7037\) 에서 \(0.8483\) 까지 벌어진다 — 자료는 하나도 바뀌지 않았다. 더 뜻밖인 것은 사후평균을 가장 크게 당긴 사전분포가 가상관측을 가장 많이 들고 온 쪽이 아니라는 점이다. 무게가 훨씬 작은 사전분포가 어떻게 더 세게 당기는가.
이항 결과(성공/실패)를 모형화할 때 베타분포는 베르누이 및 이항 가능도의 켤레 사전분포가 된다. 사후분포(posterior distribution)도 베타가 되므로 베이즈 갱신이 사전분포의 모수에 계수를 더하는 간단한 일이 된다. 이 페이지에서는 사전분포의 선택이 사후분포를 어떻게 바꾸는지 보이고, 정보가 있는 사전분포와 무정보 사전분포(noninformative prior)에 걸쳐 민감도 분석을 수행하며, 의사결정을 위한 사후확률을 계산하는 방법을 보인다.
1. 켤레성과 사후평균
정리 1. 베타–이항 켤레성
성공확률 \(\theta\) 가 미지인 독립 베르누이 시행(Bernoulli trial) \(n\) 번에서 \(k\) 번 성공을 관측했고 사전분포가 \(\theta \sim \text{Beta}(a,b)\) 이면, 사후분포도 베타다.
사후평균은 사전평균과 MLE 의 가중평균이다.
증명
베이즈 정리(Bayes' theorem)에서 사후분포는 가능도와 사전분포의 곱에 비례한다. \(\theta\) 를 담지 않는 인수는 모두 정규화 상수로 흘려보낸다.
지수가 그냥 더해진다. 오른쪽은 \(\text{Beta}(a+k,\, b+n-k)\) 의 밀도에서 상수를 뗀 꼴이고, 밀도는 적분이 1 이 되게 하는 상수까지 포함해 하나로 정해지므로 사후분포가 그 베타다.
왜 베타가 다시 베타가 되는가가 이 계산에 드러난다. 베타 밀도와 이항 가능도가 같은 꼴 \(\theta^{\bullet}(1-\theta)^{\bullet}\) 이라서, 곱해도 모양이 바뀌지 않고 지수만 움직인다. 그것이 켤레성의 정의다.
사후평균. \(\text{Beta}(\alpha,\beta)\) 의 평균이 \(\alpha/(\alpha+\beta)\) 이므로
다. 분자를 \(a\) 와 \(k\) 로 갈라 각각 \(\frac{a+b}{a+b}\) 와 \(\frac nn\) 을 곱해 두면
이고 두 가중치의 합이 1 이다. \(\square\)
\(a+b\) 가 사전 유효 표본크기처럼 작동한다. 가중치가 \((a+b)\) 대 \(n\) 으로 갈리므로, 사전분포는 \(a+b\) 번의 가상 관측과 같은 무게를 갖는다. \(\text{Beta}(1,1)\) 은 균등분포이면서 관측 두 번어치의 무게를 갖는 셈이고, 그래서 \(k=7, n=10\) 에서 사후평균이 \(8/12 = 0.6667\) 로 MLE \(0.7\) 보다 \(1/2\) 쪽으로 조금 당겨진다.
\(n \to \infty\) 이면 자료가 이긴다. \(w_{\text{자료}} \to 1\) 이므로 사후평균이 MLE 로 수렴한다. 사전분포의 영향이 사라지는 속도가 \(O(1/n)\) 이라는 것도 식에서 읽힌다.
\(a + b\)는 사전 유효 표본크기로 작동한다. 이 값이 클수록 자료에 비해 사전분포의 영향이 커진다.
그림으로 보는 통계학 1. 내일 해가 뜰 확률
바로 위에서 「사전분포의 영향이 \(O(1/n)\) 로 사라진다」고 했다. 대체로 맞는 말인데, 사라지지 않는 구석이 하나 있다. 그리고 그 구석에서 통계학사에서 가장 오래 조롱받은 계산이 나왔다.
라플라스가 \(1814\) 년 『확률에 관한 철학적 시론』에서 물었다. 해가 \(n\) 번 떴다. 내일도 뜰 확률은 얼마인가.
위의 켤레 갱신을 \(k = n\) 에 그대로 넣으면 답이 나온다. 균등 사전분포 \(\text{Beta}(1,1)\) 에 성공 \(n\) 번을 더하면 \(\text{Beta}(n+1,\,1)\) 이고, 사후평균이
이다. 계승 규칙(rule of succession)이라 부른다. 기록된 역사를 \(5{,}000\) 년으로 잡으면 \(n = 1{,}826{,}213\) 일이고, 답은
이 수는 이백 년 동안 웃음거리였다 — 「라플라스는 해가 안 뜰 수도 있다고 생각했다」는 식으로. 그런데 라플라스는 바로 다음 문장에서 이 수를 쓰면 안 되는 경우를 적어 두었다. 낮과 계절을 지배하는 원리를 아는 사람에게는 이 수가 턱없이 작다는 것이다. 조롱은 그 문장을 빼고 이루어졌다.
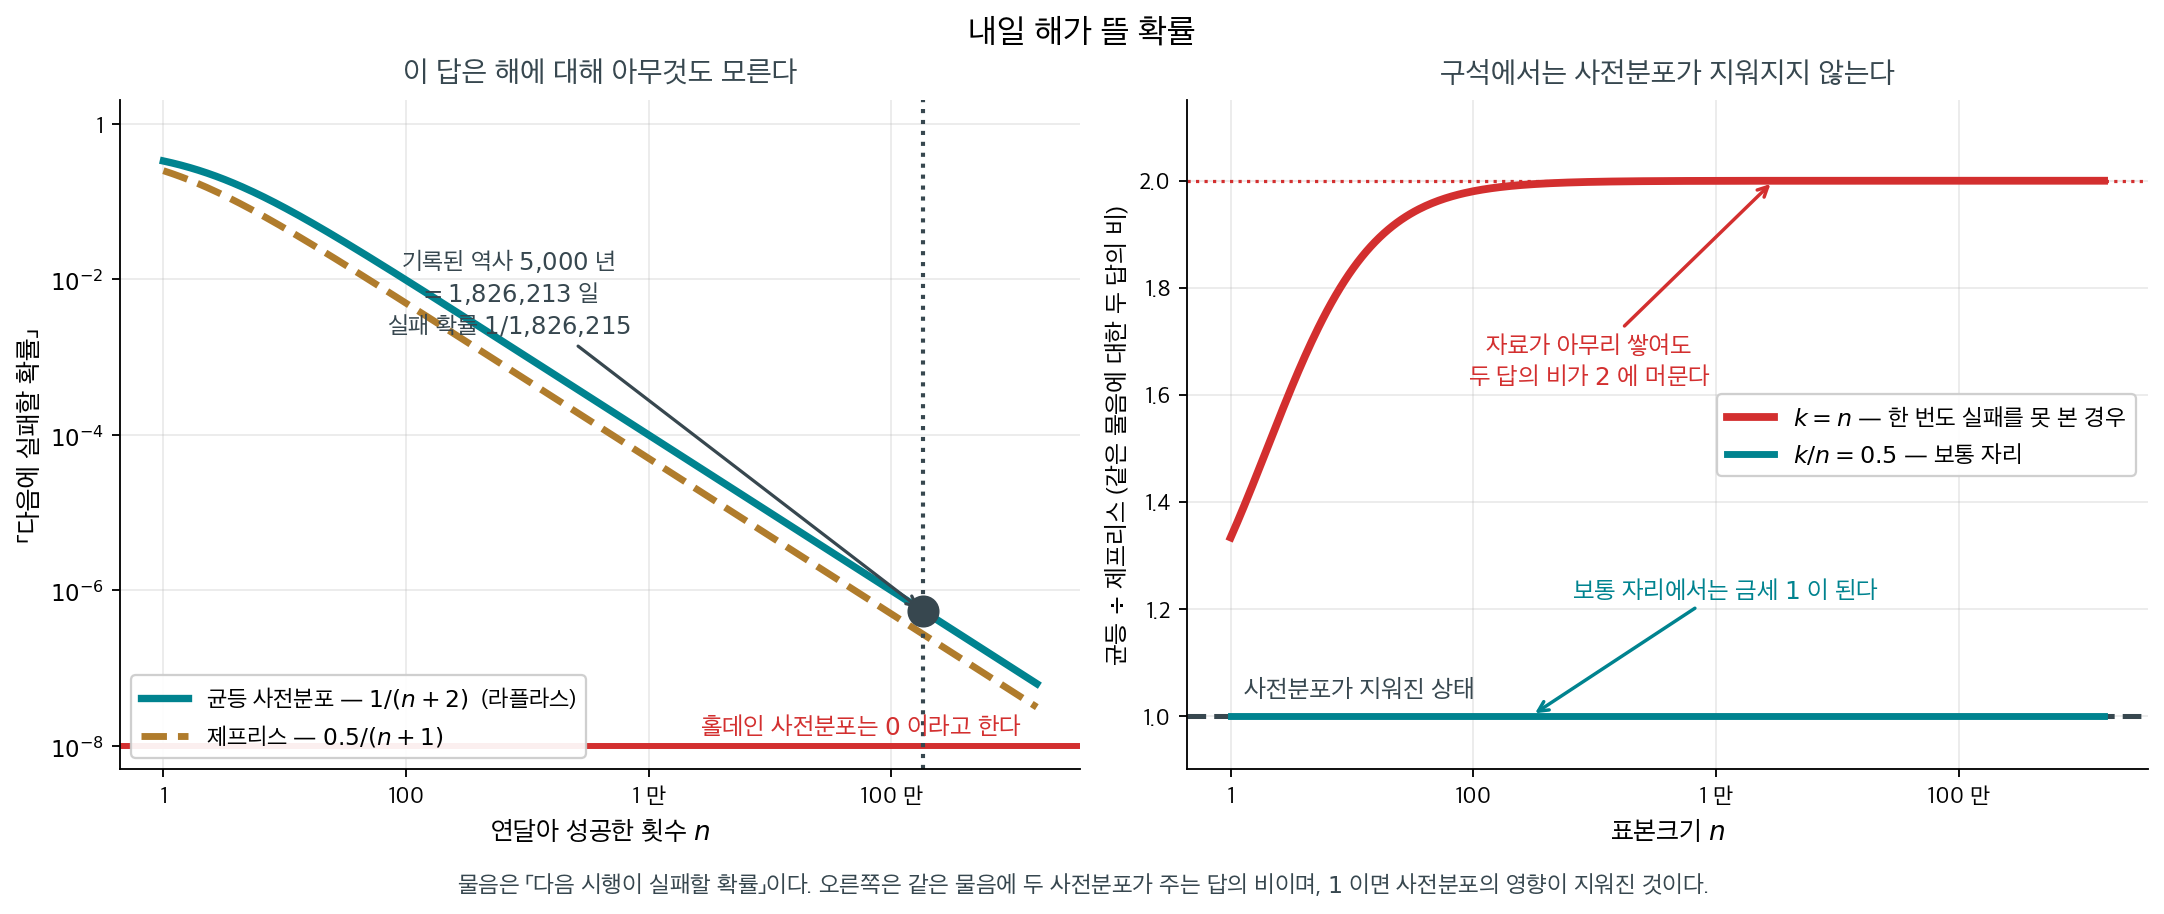
오른쪽 세로축은 같은 물음에 두 사전분포가 주는 답의 비다. \(1\) 이면 사전분포의 영향이 지워진 것이다.
요점은 이것이다. 이 답은 해에 대해 아무것도 모른다. 오직 \(n\) 과 사전분포만 보고 나온 수다. 왼쪽 그림의 직선이 그 뜻이다 — 무엇을 세든 \(n\) 번 연달아 성공했으면 같은 답이 나온다.
그리고 여기서 사전분포가 지워지지 않는다. \(k = n\) 일 때 「다음에 실패할 확률」은
| 사전분포 | 답 |
|---|---|
| 균등 \(\text{Beta}(1,1)\) | \(1/(n+2)\) |
| 제프리스 \(\text{Beta}(0.5,0.5)\) | \(0.5/(n+1)\) |
| 홀데인 \(\text{Beta}(0,0)\) | \(\mathbf{0}\) |
오른쪽 그림의 붉은 선이 앞의 둘의 비인데, \(n\) 이 백만이 되어도 \(2\) 에 머문다. 반면 \(k/n = 0.5\) 인 보통 자리(청록)에서는 같은 비가 금세 \(1\) 이 된다. 위에서 말한 \(O(1/n)\) 의 소멸은 보통 자리의 이야기다.
까닭은 간단하다. 한 번도 보지 못한 사건의 확률을 물으면, 자료에는 그 사건이 하나도 없다. 답을 만드는 것은 자료가 아니라 사전분포에 들어 있던 가상의 한 건이다. 그러니 자료를 더 모아도 그 비율은 그대로다.
그래서 이 계산을 쓸 때 물어야 할 것은 「\(n\) 이 충분히 큰가」가 아니라 「내가 세고 있는 것들이 정말로 교환가능한가」이다. 해가 뜨는 일은 그렇지 않다. 라플라스도 그렇게 적었다.
확인한 곳 — 라플라스가 『확률에 관한 철학적 시론』(\(1814\))에서 해 뜨는 문제를 다루며 계승 규칙 \((n+1)/(n+2)\) 를 내놓은 것과, 그가 \(p\) 에 균등 사전분포를 두어 무지를 적었다는 것. 표와 그림의 수는 모두 직접 계산한 값이다
위 상자는 베이즈 쪽 답이다. 같은 물음에 빈도론 쪽에서 내놓은 답이 하나 더 있는데, 사전분포를 쓰지 않고도 맞힌다.
AI로 보는 통계학 1. 한 번도 보지 못한 것의 확률
말뭉치에서 단어를 \(N\) 개 읽었다. 다음에 나올 단어가 지금까지 한 번도 보지 못한 단어일 확률은 얼마인가?
MLE 의 답은 \(0\) 이다. 보지 못한 것의 상대도수가 \(0\) 이니 당연하다. 그런데 천 단어만 읽은 상태라면 참값은 \(0.40\) 이다. 열 번에 네 번은 처음 보는 단어가 나오는데, MLE 는 그런 일이 일어날 수 없다고 말한다.
라플라스 평활은 반대 방향으로 틀린다. 가상의 관측을 칸마다 하나씩 더하는데, 어휘가 \(50{,}000\) 종이면 보지 못한 칸들에 통째로 \(0.97\) 을 몰아 준다.
이 문제는 1940 년대 초 블레츨리 파크에서 앨런 튜링이 마주친 것과 같은 모양이다. 암호 열쇠의 어떤 꼴은 가로챈 전문에 아직 한 번도 나타나지 않았다. 나타나지 않았다는 이유로 확률을 \(0\) 으로 두면 안 된다는 것은 분명한데, 그러면 얼마로 두어야 하는가.
튜링의 답은 어이없을 만큼 짧다.
딱 한 번 나온 것의 개수만 세면 된다. 까닭은 이렇다 — 말뭉치를 한 단어 더 늘렸을 때 「처음 보는 단어」가 될 뻔했던 것들이 바로 지금 한 번만 나와 있는 단어들이다. 한 번 나온 것들이 미지의 세계로 난 창인 셈이다.
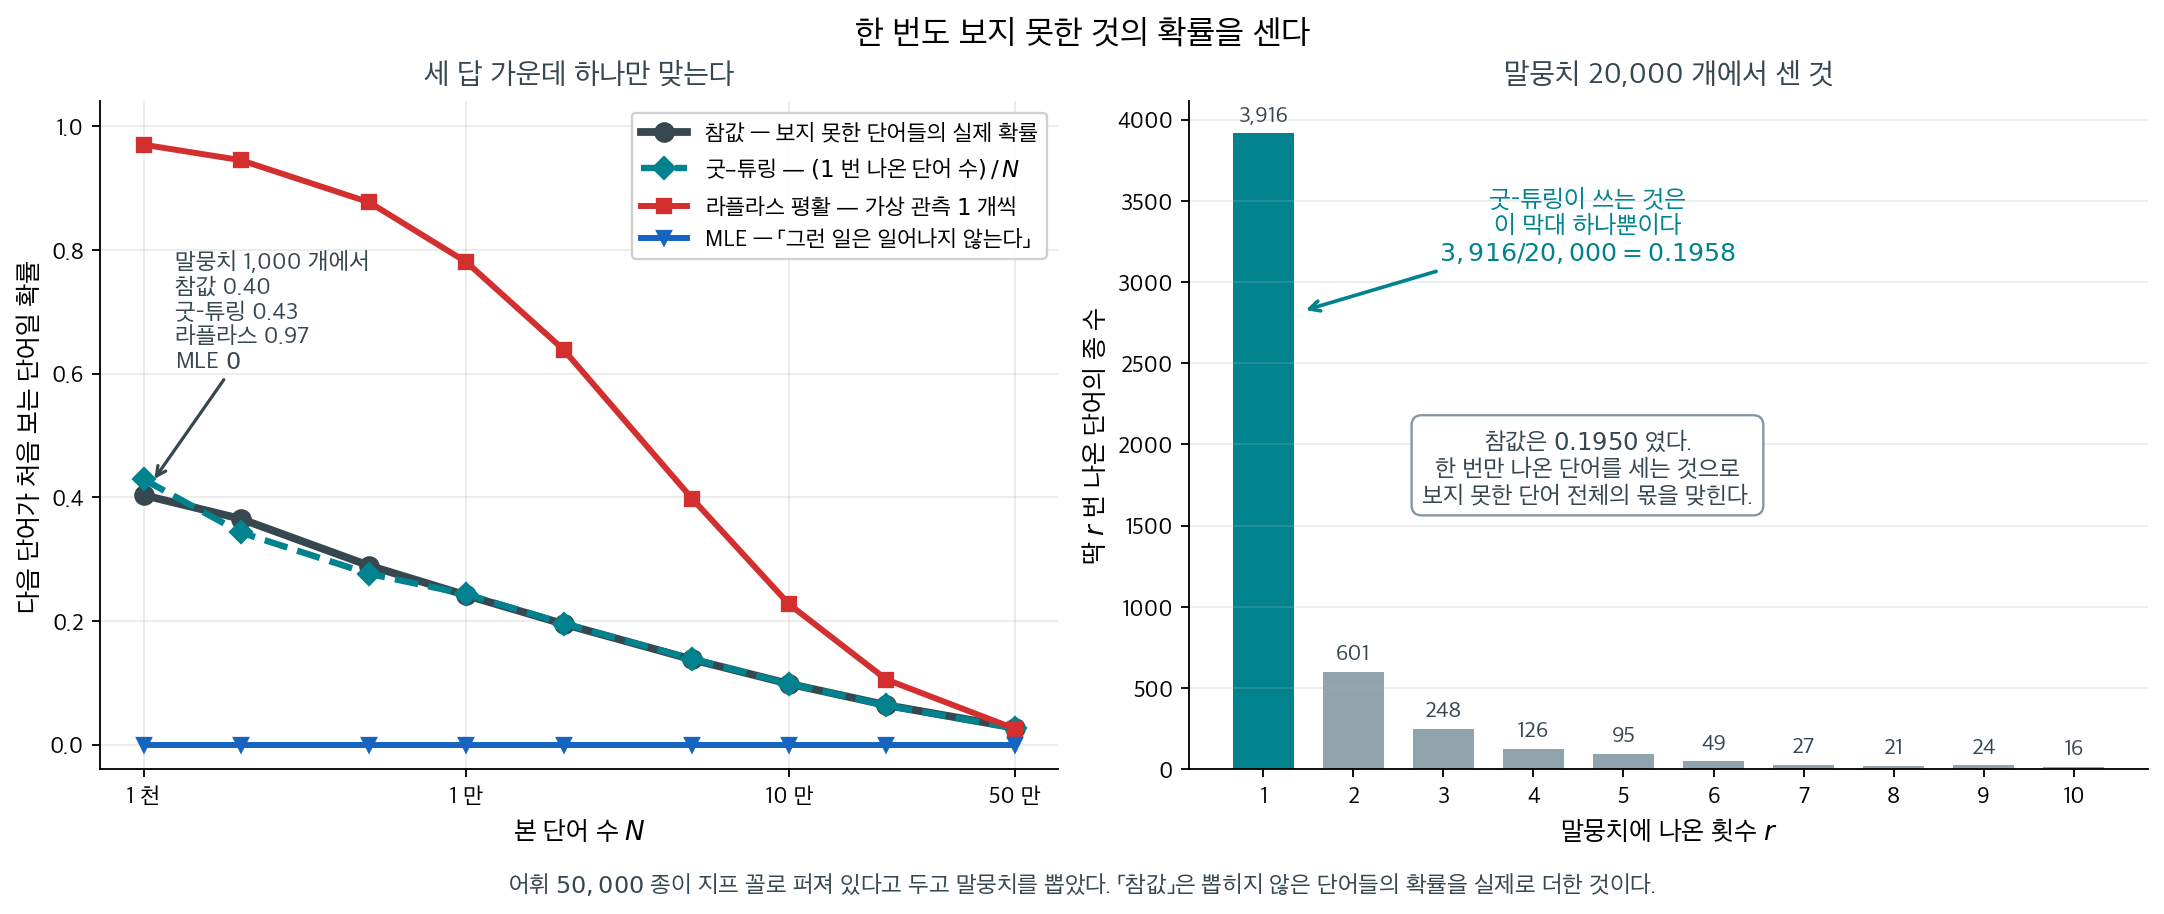
왼쪽에서 굿–튜링(청록 점선)이 참값(검정)과 겹쳐 보이지 않을 정도다. 오른쪽에서 이 추정이 쓰는 것은 맨 왼쪽 막대 하나뿐이다.
| 말뭉치 \(N\) | 참값 | 굿–튜링 | MLE | 라플라스 |
|---|---|---|---|---|
| \(1{,}000\) | \(0.4034\) | \(\mathbf{0.4290}\) | \(0\) | \(0.9701\) |
| \(20{,}000\) | \(0.1950\) | \(\mathbf{0.1958}\) | \(0\) | \(0.6386\) |
| \(500{,}000\) | \(0.0273\) | \(\mathbf{0.0263}\) | \(0\) | \(0.0256\) |
네 자릿수에 걸쳐 따라간다. 가능도를 쓰지도 않았고 모형을 세우지도 않았다. 한 번 나온 단어를 세었을 뿐이다.
이 방법도 전시에는 묶여 있었다. 튜링의 조수였던 I. J. 굿이 \(1953\) 년에 『바이오메트리카』에 실으면서 착상을 튜링에게 돌렸고, 그래서 굿–튜링 추정이라 불린다.
그리고 이것이 오늘날 언어모형이 서 있는 자리다. 신경망이 오기 전까지 \(n\)-그램 모형은 모두 이 계열의 평활에 기대었다. 보지 못한 단어열에 \(0\) 을 주면 그 문장 전체의 확률이 \(0\) 이 되어 모형이 무너지기 때문이다. 큰 모형이 흔히 걸리는 병도 같은 뿌리다 — 훈련에서 보지 못한 것을 불가능한 것으로 다루는 일. 그 병에 처음 이름을 붙이고 처방을 낸 사람이 암호를 풀던 사람이었다.
확인한 곳 — 어빙 J. 굿의 「The population frequencies of species and the estimation of population parameters」(『Biometrika』 \(40\) 권 \(237\)–\(264\) 쪽, \(1953\))가 블레츨리 파크에서 튜링과 함께한 작업을 전시 기밀이 풀린 뒤 활자로 옮긴 것이고 그래서 굿–튜링이라 불린다는 것. 표의 수는 모두 직접 모의실험한 값이다
2. 베이즈 갱신 함수
핵심 계산은 놀랄 만큼 단순하다. 관측된 계수를 사전분포의 모수에 더하기만 하면 된다.
보기 1. 베이즈 갱신 함수. 사전분포 \(\text{Beta}(a,b)\)에서 출발해 \(n\)번 중 \(k\)번 성공을 관측한다.
(1) 사후분포가 \(\text{Beta}(a+k,\, b+n-k)\)임을 유도하고, 사후평균이 사전평균과 MLE의 가중평균임을 가중치까지 구하시오.
(2) \(\text{Beta}(1,1)\)에서 \(k = 7\), \(n = 10\)을 보면 사후평균이 \(0.6667\)이다. (1)의 가중평균과 맞는지 확인하시오.
풀이
(1) 해석적으로. 베이즈 정리에서 사후밀도는 가능도와 사전밀도의 곱에 비례한다. \(\theta\)에 의존하지 않는 상수(이항계수와 베타함수)를 모두 비례기호 뒤로 보내면
이다. 오른쪽이 바로 \(\text{Beta}(a+k,\, b+n-k)\)의 밀도 꼴이고, 밀도는 적분이 \(1\)이 되도록 정규화되므로 비례만으로 분포가 정해진다.
적분을 하나도 하지 않았다. 지수가 더해질 뿐이라 모수 덧셈이 전부인데, 이것이 켤레성이 주는 이득이다.
가중평균. \(\text{Beta}(\alpha,\beta)\)의 평균이 \(\alpha/(\alpha+\beta)\)이므로 사후평균은 \((a+k)/(a+b+n)\)이다. 사전의 가상표본크기를 \(\nu = a+b\), 사전평균을 \(\mu_0 = a/\nu\), MLE를 \(\hat\theta = k/n\)이라 두면
로 쪼개진다(오른쪽을 통분하면 \(a/(\nu+n) + k/(\nu+n)\)으로 되돌아간다). 가중치가
로 관측 수의 비 그대로다. \(\nu = a+b\)를 "미리 본 시행 횟수"로 읽으면 전체가 \(\nu + n\)번의 시행이고 각자 제 몫만큼 발언권을 갖는 셈이다.
(2) 수치적으로. \(\text{Beta}(1,1)\)이면 \(\nu = 2\), \(\mu_0 = 0.5\)이고 \(k=7\), \(n=10\)이면 \(\hat\theta = 0.7\)이므로
이 되어야 한다. 코드로 확인한다.
import numpy as np
from scipy.stats import beta

def bayesian_update(a_prior, b_prior, k, n):
    """n번 중 k번 성공을 관측한 뒤의 사후 베타 모수를 구한다.

    베타분포가 이항 가능도의 **켤레 사전분포**라서 이렇게 단순해진다.
    사후 = 가능도 x 사전 을 전개하면 지수가 그냥 더해지므로,
    적분을 하나도 하지 않고 모수 덧셈만으로 사후분포가 나온다.

    a는 "성공 횟수", b는 "실패 횟수"처럼 읽으면 된다.
    Beta(2, 3)을 사전분포로 쓴다는 것은 "성공 1번, 실패 2번을
    미리 본 셈 친다"는 뜻이다(균등분포 Beta(1,1)이 기준점).
    """
    a_post = a_prior + k          # 성공 횟수를 더한다
    b_post = b_prior + n - k      # 실패 횟수를 더한다
    return a_post, b_post


# 균등한 사전분포 Beta(1,1)에서 출발해 10번 중 7번 성공을 보면?
a, b = bayesian_update(1, 1, k=7, n=10)
print(f"사후분포 Beta({a}, {b})")
# 베타분포의 평균은 a/(a+b) 다. MLE 0.7 보다 살짝 0.5 쪽으로 당겨진다.
print(f"사후평균 {a/(a+b):.4f}   (MLE = {7/10:.4f})")

# (1) 의 가중평균 분해와 맞는지 본다.
nu, mu0, theta_hat, n_obs = 1 + 1, 1 / (1 + 1), 7 / 10, 10
w_prior = nu / (nu + n_obs)
w_data = n_obs / (nu + n_obs)
blend = w_prior * mu0 + w_data * theta_hat
print(f"\n가중치: 사전 {w_prior:.6f}, 자료 {w_data:.6f}, 합 {w_prior + w_data:.6f}")
print(f"가중평균 {w_prior:.6f} x {mu0} + {w_data:.6f} x {theta_hat} = {blend:.6f}")
print(f"사후평균 a/(a+b) = {a / (a + b):.6f}")
print(f"두 값이 같은가? {np.isclose(blend, a / (a + b), rtol=0, atol=1e-12)}")
출력:
사후분포 Beta(8, 4)
사후평균 0.6667   (MLE = 0.7000)

가중치: 사전 0.166667, 자료 0.833333, 합 1.000000
가중평균 0.166667 x 0.5 + 0.833333 x 0.7 = 0.666667
사후평균 a/(a+b) = 0.666667
두 값이 같은가? True
가중평균 분해가 맞는다. 사후평균 \(8/12 = 0.666667\)이 \(\tfrac16(0.5) + \tfrac56(0.7)\)과 소수 열두째 자리까지 같다. 가중치의 합이 \(1\)인 것도 확인된다.
읽어 둘 점은 \(\hat\theta = 0.7\)에서 \(0.6667\)로 \(0.5\) 쪽으로 당겨졌다는 것이다. 당겨진 양은
으로, 가중치와 거리의 곱이다. 이 꼴이 다음 보기에서 그대로 쓰인다.
균등분포 \(\text{Beta}(1,1)\)조차 \(\nu = 2\)만큼의 무게를 갖는다는 점도 짚어 두자. "아무 정보가 없는" 사전분포라 불리지만 가상의 시행 두 번이 섞여 있고, \(n = 10\)에서는 그 \(2\)가 전체의 \(17\%\)라 무시할 수 없다. \(n\)이 수백이 되면 비로소 사라진다.
3. 사전분포에 따른 민감도 분석
여론조사 상황을 생각해 보자. 전체 \(n = 581\)명 중 \(k = 281\)명이 어떤 후보를 지지하여 MLE는 \(\hat{\theta} = 281/581 \approx 0.4836\)이다. 여섯 가지 사전분포가 사후분포에 어떤 영향을 주는지 살펴본다.
보기 2. 사전분포에 따른 민감도 분석. \(n = 581\), \(k = 281\)인 여론조사에 사전분포 여섯을 차례로 적용한다.
(1) 사후평균이 MLE에서 당겨지는 양을 \(\nu\)와 \(\mu_0\)로 쓰고, 여섯 중 어느 사전분포가 가장 크게 당기겠는지 코드를 돌리기 전에 지목하시오.
(2) 표를 만들어 (1)의 예측을 확인하고, \(P(\theta < 0.5)\)가 사전분포에 따라 어떻게 달라지는지 설명하시오.
풀이
(1) 해석적으로. 보기 1의 분해에서 양변에 \(\hat\theta\)를 빼면
이다. 당기는 힘은 무게와 거리의 곱이다. \(\nu/(\nu+n)\)이 사전분포가 가진 발언권이고 \(\mu_0 - \hat\theta\)가 사전분포가 가리키는 방향과 거리다. 둘 중 하나만 커도 소용없다.
\(\hat\theta = 281/581 = 0.48365\)를 넣고 여섯을 계산한다.
| 사전분포 | \(\nu\) | 무게 \(\nu/(\nu+n)\) | \(\mu_0\) | 거리 \(\mu_0 - \hat\theta\) | 당김 |
|---|---|---|---|---|---|
| \(\text{Beta}(1,1)\) | 2 | 0.0034 | 0.5 | \(+0.0164\) | \(+0.000056\) |
| \(\text{Beta}(5,5)\) | 10 | 0.0169 | 0.5 | \(+0.0164\) | \(+0.000277\) |
| \(\text{Beta}(50,50)\) | 100 | 0.1468 | 0.5 | \(+0.0164\) | \(+0.002401\) |
| \(\text{Beta}(2,8)\) | 10 | 0.0169 | 0.2 | \(-0.2836\) | \(-0.004799\) |
| \(\text{Beta}(8,2)\) | 10 | 0.0169 | 0.8 | \(+0.3164\) | \(+0.005353\) |
| \(\text{Beta}(100,100)\) | 200 | 0.2561 | 0.5 | \(+0.0164\) | \(+0.004187\) |
가장 크게 당기는 것은 \(\text{Beta}(8,2)\)다. \(\text{Beta}(100,100)\)이 아니다. 뜻밖으로 보이지만 곱의 두 인수를 보면 당연하다. \(\text{Beta}(100,100)\)은 무게가 \(0.2561\)로 \(\text{Beta}(8,2)\)의 \(0.0169\)보다 \(15\)배 크지만, 가리키는 자리 \(0.5\)가 \(\hat\theta = 0.4836\) 바로 옆이라 거리가 \(0.0164\)밖에 안 된다. 반면 \(\text{Beta}(8,2)\)는 가벼워도 \(0.8\)을 가리켜 거리가 \(0.3164\)로 \(19\)배 멀다. \(19 > 15\)라 곱이 뒤집힌다.
"강한 사전분포"라는 말이 두 가지를 뒤섞는다는 것이 요점이다. \(\nu\)가 큰 것과 자료에서 먼 것은 다른 이야기이고, 결과를 움직이는 것은 둘의 곱이다.
(2) 수치적으로.
n = 581
k = 281

# 사전분포 여섯 개. a + b 가 곧 "가상의 표본 크기"라고 읽으면 된다.
#   (1,1)     : 가상표본 2. 사실상 아무 정보도 넣지 않는다(균등).
#   (5,5)     : 가상표본 10. 자료 581에 비해 미미하다.
#   (50,50)   : 가상표본 100. 자료의 6분의 1쯤 되는 무게.
#   (2,8),(8,2): 크기는 작지만 한쪽으로 치우친 사전분포.
#   (100,100) : 가상표본 200. 자료의 3분의 1이라 결과를 눈에 띄게 당긴다.
priors = [
    (1, 1, "Uniform (a=1, b=1)"),
    (5, 5, "Weakly informative (a=5, b=5)"),
    (50, 50, "Moderate prior centered at 0.5"),
    (2, 8, "Prior skewed toward low p"),
    (8, 2, "Prior skewed toward high p"),
    (100, 100, "Strong prior at 0.5"),
]

for a, b, label in priors:
    a_post, b_post = bayesian_update(a, b, k, n)
    # 베타분포의 평균은 a/(a+b) 다.
    # 자료 n=581 이 사전분포보다 훨씬 무거우면 사후평균이 MLE(0.4836)에 붙는다.
    post_mean = a_post / (a_post + b_post)
    # 사후확률 P(p < 0.5). 베이즈 방법에서는 이것을 그대로 "후보가 과반에
    # 못 미칠 확률"이라고 읽을 수 있다. 빈도주의 p 값과 해석이 다른 지점이다.
    p_less_half = beta.cdf(0.5, a_post, b_post)
    print(f"{label:<35s}  a_post={a_post:>4d}  b_post={b_post:>4d}  "
          f"mean={post_mean:.4f}  P(p<0.5)={p_less_half:.4f}")

# (1) 의 당김 공식과 견준다. 사후표준편차도 함께 잰다.
mle = k / n
print(f"\nMLE = {mle:.5f}")
print(f"{'사전':>10} {'nu':>5} {'무게':>8} {'거리':>9} {'당김':>10} "
      f"{'예측평균':>9} {'실제평균':>9} {'사후sd':>8}")
for a, b, _ in priors:
    nu = a + b
    w = nu / (nu + n)
    d = a / nu - mle
    A, B = bayesian_update(a, b, k, n)
    sd = np.sqrt(A * B / ((A + B) ** 2 * (A + B + 1)))
    print(f"{f'Beta({a},{b})':>10} {nu:>5} {w:>8.4f} {d:>+9.4f} {w * d:>+10.6f} "
          f"{mle + w * d:>9.4f} {A / (A + B):>9.4f} {sd:>8.5f}")
출력:
Uniform (a=1, b=1)                   a_post= 282  b_post= 301  mean=0.4837  P(p<0.5)=0.7845
Weakly informative (a=5, b=5)        a_post= 286  b_post= 305  mean=0.4839  P(p<0.5)=0.7829
Moderate prior centered at 0.5       a_post= 331  b_post= 350  mean=0.4860  P(p<0.5)=0.7669
Prior skewed toward low p            a_post= 283  b_post= 308  mean=0.4788  P(p<0.5)=0.8483
Prior skewed toward high p           a_post= 289  b_post= 302  mean=0.4890  P(p<0.5)=0.7037
Strong prior at 0.5                  a_post= 381  b_post= 400  mean=0.4878  P(p<0.5)=0.7518

MLE = 0.48365
        사전    nu       무게        거리         당김      예측평균      실제평균     사후sd
 Beta(1,1)     2   0.0034   +0.0164  +0.000056    0.4837    0.4837  0.02068
 Beta(5,5)    10   0.0169   +0.0164  +0.000277    0.4839    0.4839  0.02054
Beta(50,50)   100   0.1468   +0.0164  +0.002401    0.4860    0.4860  0.01914
 Beta(2,8)    10   0.0169   -0.2836  -0.004799    0.4788    0.4788  0.02053
 Beta(8,2)    10   0.0169   +0.3164  +0.005353    0.4890    0.4890  0.02054
Beta(100,100)   200   0.2561   +0.0164  +0.004187    0.4878    0.4878  0.01787
예측과 실제가 네 자리까지 모두 같다. 당김 공식 \(\frac{\nu}{\nu+n}(\mu_0 - \hat\theta)\)가 여섯 줄 어디서도 어긋나지 않는다. 그리고 (1)에서 지목한 대로 당김이 가장 큰 것은 \(\text{Beta}(8,2)\)의 \(+0.005353\)이고 \(\text{Beta}(100,100)\)의 \(+0.004187\)이 그 다음이다. 무게로는 \(15\)배 밀리는 사전분포가 거리 덕에 앞섰다.
\(P(\theta<0.5)\)는 두 가지에 함께 움직인다. 사후분포가 거의 정규이므로
인데, 사후평균이 \(0.5\)에 가까워질수록 이 값이 \(0.5\) 쪽으로 내려가고 사후표준편차가 작아질수록 평균이 \(0.5\)의 어느 쪽에 있느냐에 따라 더 멀리 밀린다. 표에서
- \(\text{Beta}(2,8)\): 평균이 \(0.4788\)로 가장 낮아 \(P = 0.8483\)으로 가장 크다.
- \(\text{Beta}(8,2)\): 평균이 \(0.4890\)으로 가장 높아 \(P = 0.7037\)로 가장 작다.
로 순서가 그대로 뒤집힌다. 둘의 사후표준편차는 \(0.02053\)과 \(0.02054\)로 사실상 같으므로 차이를 만든 것은 오로지 평균의 이동이다.
사후표준편차의 방향도 읽어 두자. \(\nu\)가 커질수록 사후표준편차가 \(0.02068 \to 0.01914 \to 0.01787\)로 줄어든다. 사후분포의 총 가상관측수가 \(\nu + n\)이고 표준편차가 대략 \(1/\sqrt{\nu+n}\)으로 작아지기 때문이다. 곧 강한 사전분포는 사후분포를 넓히는 것이 아니라 좁힌다. 다만 좁아진 그 봉우리가 자료가 가리키는 자리에서 비껴나 있을 수 있고, 그것이 강한 사전분포의 진짜 위험이다.
4. 사전분포에서 사후분포로의 갱신 시각화
각 사전분포에 대해 사전밀도(파란 점선), 사후밀도(빨간 실선), 음영으로 표시한 영역 \(P(\theta < 0.5)\), 그리고 세로 점선으로 표시한 MLE를 그린다.
보기 3. 사전에서 사후로 가는 과정 그리기. 여섯 사전분포 각각에 대해 사전밀도(파란 점선), 사후밀도(빨간 실선), 음영 \(P(\theta<0.5)\), MLE 세로선을 한 판에 그린다.
(1) 그림을 그리기 전에 두 가지를 예측하시오. 여섯 패널 가운데 사후분포가 가장 좁은 것은 어느 것이고, 사후 봉우리가 MLE 선에서 가장 멀리 벗어나는 것은 어느 것인가.
(2) 그림에서 실제로 무엇이 보이는지 적고, 사전밀도와 사후밀도의 높이 차이가 왜 그렇게 큰지 설명하시오.
풀이
(1) 해석적으로. 두 물음의 답이 서로 다른 패널이다.
가장 좁은 것은 \(\text{Beta}(100,100)\)이다. 사후분포 \(\text{Beta}(\alpha,\beta)\)의 표준편차가
이므로 \(\nu\)가 클수록 좁아진다. \(\nu = 200\)인 \(\text{Beta}(100,100)\)이 \(\nu+n = 781\)로 가장 크니 가장 좁다. 보기 2의 표가 \(0.01787\)로 이미 보여 주었다.
가장 멀리 벗어나는 것은 \(\text{Beta}(8,2)\)다. 봉우리는 최빈값이고
인데, \(\alpha\)와 \(\beta\)가 수백이라 최빈값이 평균과 소수 넷째 자리까지 같다. 그러므로 보기 2의 당김 표가 그대로 답이고, \(\text{Beta}(8,2)\)가 \(+0.00535\)로 가장 크다.
코드의 주석 "마지막 패널(강한 사전분포)에서 가장 크게 벌어진다"는 맞지 않는다. 가장 크게 벌어지는 것은 다섯째 패널이다.
(2) 수치적으로.
import matplotlib.pyplot as plt

plt.rcParams["font.sans-serif"] = ["NanumGothic", "Apple SD Gothic Neo", "Malgun Gothic"]
plt.rcParams["font.family"] = "sans-serif"
plt.rcParams["axes.unicode_minus"] = False

theta = np.linspace(0, 1, 1000)

fig, axes = plt.subplots(2, 3, figsize=(16, 10))
for idx, (a, b, label) in enumerate(priors):
    a_post, b_post = bayesian_update(a, b, k, n)
    p_less_half = beta.cdf(0.5, a_post, b_post)
    ax = axes.flatten()[idx]

    ax.plot(theta, beta.pdf(theta, a, b), "b--", lw=2, label="Prior")
    ax.plot(theta, beta.pdf(theta, a_post, b_post), "r-", lw=2.5,
            label="Posterior")

    # 사후분포의 0.5 왼쪽을 칠한다. 그 넓이가 곧 P(p < 0.5) 다.
    # 베이즈에서는 모수 자체가 확률변수이므로 이런 진술이 가능하다.
    mask = theta <= 0.5
    ax.fill_between(theta[mask],
                    beta.pdf(theta[mask], a_post, b_post),
                    alpha=0.2, color="blue",
                    label=f"P(p<0.5) = {p_less_half:.3f}")
    # MLE를 세로선으로 표시한다. 사후분포(빨강)의 봉우리가 이 선에서
    # 얼마나 벗어나는지가 곧 사전분포가 결과를 당긴 정도다.
    # 마지막 패널(강한 사전분포)에서 가장 크게 벌어진다.
    ax.axvline(k / n, color="green", linestyle=":", lw=1.5,
               label=f"MLE = {k/n:.3f}")
    ax.set_title(label)
    ax.set_xlabel("theta")
    ax.set_ylabel("Density")
    ax.legend(fontsize=7)
    ax.set_xlim(0.35, 0.65)

plt.tight_layout()
plt.show()

# 그림으로는 읽기 어려운 두 양을 수로 찍는다.
print(f"{'사전':>14} {'MAP':>9} {'MAP-MLE':>9} {'사후 봉우리':>12} {'사전 최대':>11}")
on_window = (theta >= 0.35) & (theta <= 0.65)
for a, b, _ in priors:
    A, B = bayesian_update(a, b, k, n)
    mode = (A - 1) / (A + B - 2)
    print(f"{f'Beta({a},{b})':>14} {mode:>9.5f} {mode - k / n:>+9.5f} "
          f"{beta.pdf(mode, A, B):>12.2f} "
          f"{beta.pdf(theta, a, b)[on_window].max():>11.2f}")
출력:
            사전       MAP   MAP-MLE       사후 봉우리       사전 최대
     Beta(1,1)   0.48365  +0.00000        19.27        1.00
     Beta(5,5)   0.48387  +0.00022        19.40        2.46
   Beta(50,50)   0.48601  +0.00236        20.82        7.96
     Beta(2,8)   0.47878  -0.00487        19.41        1.23
     Beta(8,2)   0.48896  +0.00532        19.39        1.23
 Beta(100,100)   0.48780  +0.00416        22.30       11.27
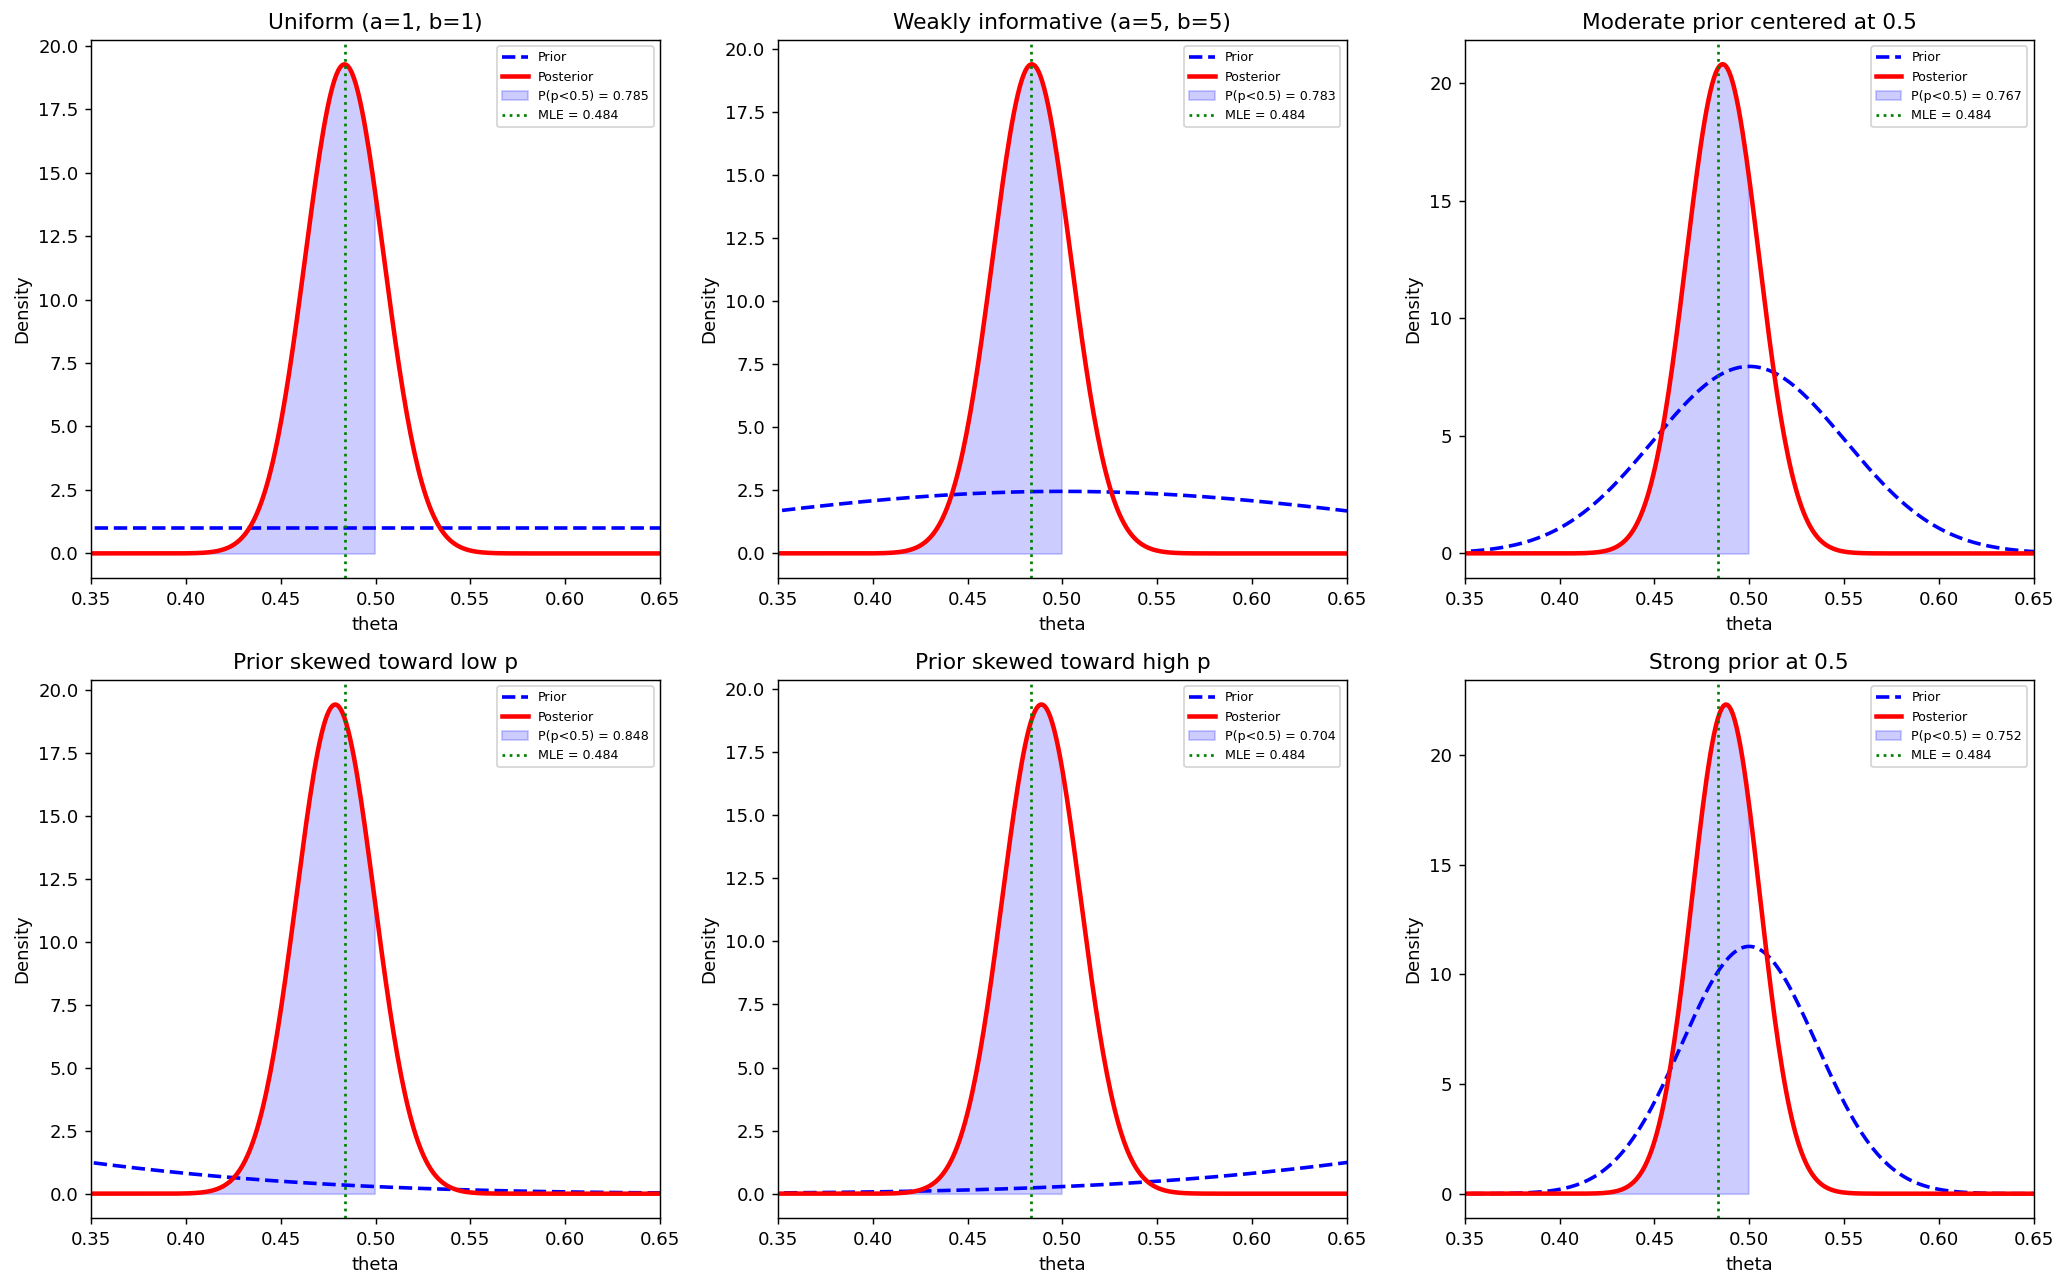
(1)의 두 예측이 모두 맞는다. 봉우리가 가장 높고 좁은 것은 여섯째 패널 \(\text{Beta}(100,100)\)으로 높이가 \(22.30\)이고 나머지는 \(19.3 \sim 20.8\)이다. MLE에서 가장 멀리 벗어난 것은 다섯째 패널 \(\text{Beta}(8,2)\)로 \(+0.00532\)이며 여섯째 패널의 \(+0.00416\)보다 크다. 최빈값이 보기 2의 사후평균과 소수 넷째 자리까지 같다는 것도 확인된다.
그러나 그림만으로는 이 차이를 읽을 수 없다. 가로축이 \(0.35\)부터 \(0.65\)까지 폭 \(0.30\)인데 가장 큰 이탈이 \(0.00532\), 곧 폭의 \(1.8\%\)다. 다섯째·여섯째 패널에서 빨간 봉우리가 초록 점선 오른쪽으로 아주 조금 밀려 보이기는 하나 어느 쪽이 더 큰지는 눈으로 가릴 수 없다. 수로 재야 알 수 있는 것을 그림이 보여 주리라 기대하면 안 된다. 이 그림이 잘 보여 주는 것은 봉우리의 높이와 폭이지 위치의 미세한 이동이 아니다.
사전밀도가 납작해 보이는 까닭. 파란 점선의 최대 높이가 균등분포에서 \(1.00\), \(\text{Beta}(5,5)\)에서 \(2.46\)인데 빨간 실선은 \(19\)가 넘는다. 밀도는 넓이가 \(1\)이 되도록 정규화되므로 좁을수록 높다. 사전분포는 \([0,1]\) 전체에 퍼져 있고 사후분포는 폭 \(0.02\) 남짓에 몰려 있으니 높이가 스무 배 가까이 차이 난다. 관측 \(581\)개가 \(\theta\)를 그만큼 좁혔다는 뜻이고, 셋째·여섯째 패널에서 파란 점선이 제법 솟아 보이는 것도 그 사전분포들이 그만큼 좁기 때문이다.
\(x\)축이 가리는 것. 치우친 두 사전분포 \(\text{Beta}(2,8)\)과 \(\text{Beta}(8,2)\)가 그림에서 거의 밋밋한 직선으로 보인다. 두 밀도의 봉우리는 각각 \(0.125\)와 \(0.875\)에 있는데 둘 다 \([0.35, 0.65]\) 바깥이라 잘려 나갔고, 창 안에 남은 것은 완만한 기울기뿐이다. 창 안 최대 높이가 \(1.23\)으로 둘이 같은 것은 좌우 대칭이기 때문이다. 이 두 패널만 보고 "치우친 사전분포"의 생김새를 짐작하면 안 된다.
5. 사후평균과 MAP 는 어디에 놓이는가
정리 1 의 사후평균은 사전평균과 MLE 의 가중평균이다. 그러면 MAP 는 어디에 놓이는가. 셋을 한 자료에서 나란히 재어 보면 순서가 드러나고, 그 순서가 신용구간이 어느 쪽으로 기우는지까지 정한다.
보기 4. 베타–이항 켤레모형으로 비율 추정하기. 사전분포 \(\text{Beta}(2,2)\)에 \(n = 50\)번 중 \(k = 32\)번 성공을 관측한다.
(1) 사후평균과 MAP를 각각 "사전값과 MLE의 가중평균" 꼴로 쓰고 가중치를 구하시오. 셋(\(\text{MLE}\), 사후평균, MAP) 가운데 어느 것이 가운데에 놓이겠는가.
(2) 확인하고, \(95\%\) 신용구간의 아래끝이 \(0.4980\)으로 \(0.5\)를 간신히 넘지 못하는 것이 무엇을 뜻하는지 적으시오.
풀이
(1) 해석적으로. 사후분포가 \(\text{Beta}(\alpha_0+k,\ \beta_0+n-k) = \text{Beta}(34, 20)\)이다.
사후평균. \(\nu = \alpha_0+\beta_0 = 4\)라 두면
로 가중치가 \((0.0741,\ 0.9259)\)다.
MAP. 최빈값은 \((\alpha-1)/(\alpha+\beta-2)\)이므로
로 가중치가 \((0.0385,\ 0.9615)\)다. 사전값 자리에 사전분포의 최빈값 \((\alpha_0-1)/(\nu-2) = 1/2\)가 들어간다는 점만 다르다.
두 가지 "유효 표본크기". 평균을 볼 때 사전분포의 무게는 \(\nu = \alpha_0+\beta_0 = 4\)이고, 최빈값을 볼 때는 \(\nu - 2 = 2\)다. 아래 주석 상자가 "\(\alpha_0-1\)번 성공, \(\beta_0-1\)번 실패를 미리 본 셈"이라 말하는 것은 최빈값 쪽 셈법이다. 어느 쪽이 옳고 그른 것이 아니라 어떤 요약값을 보느냐에 따라 사전분포의 무게가 \(2\)만큼 달라진다.
순서. 사전값이 둘 다 \(0.5\)로 MLE \(0.64\)보다 작으므로 사후평균과 MAP가 모두 MLE 아래에 놓인다. 그런데 MAP 쪽 사전 무게 \(0.0385\)가 사후평균 쪽 \(0.0741\)의 절반이므로 MAP가 덜 당겨져 MLE에 더 가깝다. 따라서
곧 MAP가 가운데다.
(2) 수치적으로.
import numpy as np
from scipy import stats

def demo_beta_binomial():
    """베타-이항 켤레모형으로 비율을 추정한다."""
    alpha_0, beta_0 = 2, 2  # weakly informative prior

    n, k = 50, 32  # observed data

    # 사후분포의 모수. 켤레 사전분포라 형태가 그대로 유지된다.
    alpha_post = alpha_0 + k
    beta_post = beta_0 + (n - k)

    # 점추정값: 사후평균과 사후최빈값.
    map_est = (alpha_post - 1) / (alpha_post + beta_post - 2)
    post_mean = alpha_post / (alpha_post + beta_post)
    mle = k / n

    print(f"Prior:     Beta({alpha_0}, {beta_0})")
    print(f"Data:      {k} successes in {n} trials")
    print(f"Posterior: Beta({alpha_post}, {beta_post})")
    print(f"MAP        = {map_est:.4f}")
    print(f"Post. mean = {post_mean:.4f}")
    print(f"MLE        = {mle:.4f}")

    # 95% 신용구간: 사후분포의 2.5·97.5 백분위점.
    ci_low = stats.beta.ppf(0.025, alpha_post, beta_post)
    ci_high = stats.beta.ppf(0.975, alpha_post, beta_post)
    print(f"95% CI:    [{ci_low:.4f}, {ci_high:.4f}]")

    # (1) 의 두 가중평균 분해와 맞는지 본다.
    nu = alpha_0 + beta_0
    mean_blend = nu / (nu + n) * 0.5 + n / (nu + n) * mle
    map_blend = (nu - 2) / (nu - 2 + n) * 0.5 + n / (nu - 2 + n) * mle
    print(f"\n사후평균 가중치 ({nu / (nu + n):.4f}, {n / (nu + n):.4f})  "
          f"-> {mean_blend:.6f}  (실제 {post_mean:.6f})")
    print(f"MAP 가중치      ({(nu - 2) / (nu - 2 + n):.4f}, "
          f"{n / (nu - 2 + n):.4f})  -> {map_blend:.6f}  (실제 {map_est:.6f})")
    print(f"순서: 사후평균 {post_mean:.4f} < MAP {map_est:.4f} < MLE {mle:.4f}  "
          f"-> {post_mean < map_est < mle}")

    # 신용구간이 0.5 를 포함하는가. 포함한다면 얼마나 아슬아슬한가.
    print(f"\n구간이 0.5 를 포함하는가? {ci_low < 0.5 < ci_high}")
    print(f"P(p > 0.5) = {1 - stats.beta.cdf(0.5, alpha_post, beta_post):.4f}")

demo_beta_binomial()
출력:
Prior:     Beta(2, 2)
Data:      32 successes in 50 trials
Posterior: Beta(34, 20)
MAP        = 0.6346
Post. mean = 0.6296
MLE        = 0.6400
95% CI:    [0.4980, 0.7521]

사후평균 가중치 (0.0741, 0.9259)  -> 0.629630  (실제 0.629630)
MAP 가중치      (0.0385, 0.9615)  -> 0.634615  (실제 0.634615)
순서: 사후평균 0.6296 < MAP 0.6346 < MLE 0.6400  -> True

구간이 0.5 를 포함하는가? True
P(p > 0.5) = 0.9733
두 분해가 모두 소수 여섯째 자리까지 맞는다. 가중치 \((0.0741, 0.9259)\)가 사후평균을, \((0.0385, 0.9615)\)가 MAP를 정확히 재현한다. 순서도 예측대로 \(0.6296 < 0.6346 < 0.6400\)이다. MAP가 사후평균보다 MLE에 가까운 것은 MAP 쪽에서 사전분포의 무게가 절반이기 때문이고, 사전분포가 균등이 아니라 \(\text{Beta}(2,2)\)인 데서 비롯한 차이다.
신용구간의 아래끝 \(0.4980\). 구간이 \(0.5\)를 간신히 포함한다. 그러므로 "\(95\%\) 신용구간 안에 \(0.5\)가 있으니 과반이라고 단정할 수 없다"가 정직한 보고다. 그러나 이것이 "\(p > 0.5\)일 가능성이 반반"이라는 뜻은 결코 아니다. 실제로 계산하면
으로 \(97\%\)가 넘는다. 구간이 \(0.5\)를 포함하는 것과 \(0.5\) 너머에 사후확률이 거의 다 몰려 있는 것은 전혀 모순이 아니다. \(95\%\) 구간은 양쪽 꼬리를 \(2.5\%\)씩 잘라 낸 것이고, 아래 꼬리 \(2.5\%\)가 \(0.4980\)까지 뻗어 있을 뿐이다.
이것이 구간만 보고 판단할 때 생기는 전형적인 오해다. 베이즈 방법의 이점은 \(P(p > 0.5)\)를 그대로 계산해 "\(97.3\%\)의 확률로 과반이다"라고 말할 수 있다는 데 있다. 의사결정이 필요하면 구간이 아니라 이 수를 보고하는 것이 옳다. 빈도주의 신뢰구간에서는 이런 진술 자체가 허용되지 않는다는 점도 함께 기억해 두자.
가상 자료로서의 사전분포
Beta\((\alpha_0, \beta_0)\) 사전분포는 실제 자료를 보기 전에 이미 \(\alpha_0 - 1\)번의 성공과 \(\beta_0 - 1\)번의 실패를 관측한 것처럼 작동한다. \(\alpha_0 = \beta_0 = 2\)이면 사전분포가 총 2개의 "가상 관측값"에 해당하는 기여를 한다.
6. 사전분포를 바꾸면 사후가 어디로 움직이나
- 균등 사전분포 \(\text{Beta}(1,1)\): 사후분포가 전적으로 자료로 결정된다. 사후평균이 MLE와 거의 같고 \(P(\theta < 0.5)\)는 자료의 증거만 반영한다.
- 약정보 사전분포(weakly informative prior, 작은 \(a + b\)): 사전분포의 유효 표본크기가 \(n = 581\)에 비해 무시할 만하므로 사후분포가 균등 사전분포일 때와 거의 구별되지 않는다.
- 0.5에 집중된 강한 사전분포 \(\text{Beta}(100, 100)\): 사전 유효 표본크기가 200으로 \(n = 581\)에 비해 상당하다. 사후평균이 0.5 쪽으로 당겨지고, 사후분포는 오히려 좁아진다(사후표준편차가 \(0.02054\)에서 \(0.01787\)로 준다). 유효 표본크기가 \(581\)에서 \(781\)로 늘어난 셈이기 때문이다. 다만 당겨지는 양은 \(\text{Beta}(8,2)\) 쪽이 더 크다 — 무게는 15배 작지만 거리가 19배 멀다(보기 2).
- 치우친 사전분포: 사전분포 \(\text{Beta}(2, 8)\)(평균 0.2)과 \(\text{Beta}(8, 2)\)(평균 0.8)는 유효 표본크기가 작아(\(a + b = 10\)) 자료에 쉽게 압도된다.
- 사후확률 \(P(\theta < 0.5)\)는 직접적이고 해석 가능한 양으로 의사결정에 유용하다. 예를 들어 어떤 후보가 과반에 못 미치는 지지를 받을 가능성이 큰지 판단할 수 있다.
자료가 사전분포를 압도한다
관측값이 \(n = 581\)개이면 강한 \(\text{Beta}(100, 100)\) 사전분포조차 자료에 의해 상당히 갱신된다. 이것이 베이즈 일치성(Bayesian consistency)이다. \(n \to \infty\)이면 사전분포와 무관하게 사후분포가 참 모수값에 집중된다.
연습문제
연습문제 1. 베타–이항 켤레 모형에서 출발하여 \(a > 1\), \(b > 1\)일 때 사후최빈값(MAP 추정값)이 다음과 같음을 보여라.
\(a = b = 1\)(균등 사전분포)이면 어떻게 되는가?
풀이
사후분포는 \(\text{Beta}(a + k, b + n - k)\)이다. \(\text{Beta}(\alpha, \beta)\)의 최빈값은 이렇게 된다.
\(\alpha = a + k\), \(\beta = b + n - k\)를 대입하면 이렇게 된다.
\(a = b = 1\)(균등 사전분포)이면 이는 \(k/n\)이 되어 정확히 MLE와 같다. 균등 사전분포는 아무 정보도 기여하지 않으므로 MAP와 MLE가 일치한다. \(\square\)
연습문제 2. 동전을 \(n = 20\)번 던져 \(k = 14\)번 앞면이 나왔다. 세 가지 사전분포 \(\text{Beta}(1,1)\), \(\text{Beta}(10,10)\), \(\text{Beta}(2,5)\) 아래에서 사후평균, MAP, MLE를 비교하라. 어느 사전분포가 사후평균을 MLE에서 가장 멀리 끌어당기는가?
풀이
MLE는 \(\hat{p} = 14/20 = 0.70\)이다.
Beta(1, 1): 사후분포 \(\text{Beta}(15, 7)\). 평균 \(= 15/22 \approx 0.6818\). MAP \(= 14/20 = 0.70\).
Beta(10, 10): 사후분포 \(\text{Beta}(24, 16)\). 평균 \(= 24/40 = 0.60\). MAP \(= 23/38 \approx 0.6053\).
Beta(2, 5): 사후분포 \(\text{Beta}(16, 11)\). 평균 \(= 16/27 \approx 0.5926\). MAP \(= 15/25 = 0.60\).
\(\text{Beta}(10, 10)\) 사전분포는 사후평균을 0.60으로(MLE에서 0.10만큼) 끌어당기고, \(\text{Beta}(2, 5)\)는 0.5926으로(0.1074만큼) 끌어당긴다. \(\text{Beta}(2, 5)\) 사전분포가 사후평균을 MLE에서 가장 멀리 끌어당기는데, 이는 작은 \(p\) 값 근처에 질량을 몰아 두고 유효 표본크기 7이 자료 크기와 견줄 만하기 때문이다. \(\square\)
연습문제 3. 어떤 여론조사원이 후보가 과반의 지지를 받는지(\(\theta > 0.5\)) 판단하려 한다. \(\text{Beta}(1,1)\) 사전분포로 \(n = 581\)번의 시행에서 \(k = 281\)번 성공을 관측했다. \(P(\theta > 0.5 \mid \text{자료})\)를 계산하라. 과반 지지라고 결론짓겠는가? 사전분포가 \(\text{Beta}(100, 100)\)이라면 어떠한가?
풀이
균등 사전분포 \(\text{Beta}(1,1)\): 사후분포는 \(\text{Beta}(282, 301)\)이다.
1 - beta.cdf(0.5, 282, 301)을 계산하면 약 \(0.21\)이다. 0.5보다 훨씬 작으므로 과반 지지라고 결론짓지 않는다. 오히려 자료는 이 후보의 지지가 50%에 못 미칠 가능성이 높다고 시사한다.
강한 사전분포 \(\text{Beta}(100, 100)\): 사후분포는 \(\text{Beta}(381, 400)\)이다.
이는 약 \(0.25\)이다. 0.5에 집중된 강한 사전분포가 사후분포를 0.5 쪽으로 끌어당기므로(사후평균이 0.4837에서 0.4878로 올라간다) 과반 지지의 사후확률이 오히려 조금 커진다.
두 경우 모두에서 증거는 과반 지지라는 주장을 뒷받침하지 않는다. \(\square\)
연습문제 4. 베타–이항 모형에서 \(\theta\)의 사후분산을 유도하라. \(n\)이 커질수록 줄어듦을 보이고 그 감소 속도를 해석하라.
풀이
사후분포는 \(\text{Beta}(a + k, b + n - k)\)이다. \(\alpha = a + k\), \(\beta = b + n - k\)라 하자. \(\text{Beta}(\alpha, \beta)\) 분포의 분산은 이렇게 된다.
\(\alpha + \beta = a + b + n\)이므로 분모에 \((a + b + n)^2(a + b + n + 1)\)이라는 인수가 들어간다. \(n \to \infty\)일 때 이렇게 된다.
여기서 \(\theta\)는 참 모수이다. 사후분산은 \(O(1/n)\)의 속도로 줄어들며, 이는 MLE의 표집분산(sampling variance)이 줄어드는 속도와 같다. 사후분포가 빈도주의 표준오차가 줄어드는 것과 같은 속도로 참값 주위에 집중된다는 뜻이다. \(\square\)
연습문제 5. 두 분석자가 같은 자료(\(n = 100\), \(k = 60\))에 서로 다른 사전분포 \(\text{Beta}(1, 1)\)과 \(\text{Beta}(50, 50)\)을 사용한다고 하자. 각각의 사후평균을 계산하라. (\(k/n\)을 0.6으로 유지할 때) 두 사후평균의 차가 0.005보다 작아지려면 \(n\)이 얼마나 커야 하는가?
풀이
분석자 1 (균등 사전분포): 사후분포 \(\text{Beta}(61, 41)\). 평균 \(= 61/102 \approx 0.5980\).
분석자 2 (정보가 있는 사전분포): 사후분포 \(\text{Beta}(110, 90)\). 평균 \(= 110/200 = 0.55\).
차이: \(0.5980 - 0.55 = 0.048\).
일반적으로 \(k = 0.6n\)일 때 두 평균은 이렇게 된다.
통분하면 분자의 \(0.6n^2\) 항이 상쇄되어 차이가 깔끔하게 정리된다.
\(|m_1 - m_2| < 0.005\)로 두면 \(0.005n^2 - 9.29n + 1 > 0\), 즉 \(n^2 - 1858n + 200 > 0\)이므로 \(n \gtrsim 1858\)이다.
관측값이 약 1900개는 되어야 두 사후평균의 차가 0.005 아래로 떨어진다. 어느 정도 정보가 있는 사전분포조차 무시할 만해지려면 상당한 양의 자료가 필요함을 보여 준다. \(\square\)
연습문제 6. \(\text{Beta}(a,b)\) 사전분포 아래에서 다음 관측의 사후 예측분포를 구하라. 그 결과가 사후평균과 어떻게 이어지는가?
풀이
자료 \(x\)를 본 뒤 사후분포가 \(\text{Beta}(a', b')\)(\(a'=a+k\), \(b'=b+n-k\))라 하자. 다음 한 번의 시행 \(\tilde X\)에 대한 예측분포는 \(\theta\)를 적분해 없앤 것이다.
사후 예측확률이 곧 사후평균이다. 베르누이 가능도가 \(\theta\)에 선형이기 때문이다.
다음 \(m\)번의 시행. 성공 횟수 \(\tilde K\)의 예측분포는 베타–이항분포(beta-binomial distribution)다.
평균이 \(ma'/(a'+b')\)이고 분산이
로(\(\bar\theta = a'/(a'+b')\) 는 사후평균), 이항분포의 분산 \(m\bar\theta(1-\bar\theta)\) 보다 크다. \(\theta\)를 모른다는 불확실성이 예측의 불확실성에 더해지기 때문이다.
왜 중요한가. 빈도주의에서 "추정값을 대입한" 예측 \(\text{Binomial}(m,\hat p)\)은 \(\hat p\)의 불확실성을 무시한다. 사후 예측분포는 모수 불확실성과 표집 불확실성을 모두 담는다. \(n\)이 작을수록 그 차이가 크다.
이것이 베이즈 접근의 실용적 강점 중 하나다. 예측구간(prediction interval)을 만들 때 두 종류의 불확실성을 자동으로 합쳐 준다.
연습문제 7. \(\text{Beta}(a,b)\) 사전분포의 \(a+b\)를 사전 표본크기로 읽는 해석을 설명하고, 사전분포를 정할 때 이를 어떻게 활용하는지 적어라.
풀이
해석. 사후분포가 \(\text{Beta}(a+k,\ b+n-k)\)이므로, 사전분포가 "성공 \(a\)번, 실패 \(b\)번"이라는 가상의 자료처럼 더해진다. 따라서
을 사전 표본크기로 읽는다. 사후평균이
로 가중평균이 되고, 가중치가 정확히 두 "표본크기"의 비다.
사전분포를 정하는 실용적 절차.
- 중심을 정한다. 사전평균 \(\mu_0 = a/(a+b)\)를 전문가 지식이나 과거 자료로 정한다.
- 강도를 정한다. "이 믿음이 관측 몇 개에 해당하는가"를 묻는다. \(n_0 = 2\)면 거의 무정보, \(n_0 = 20\)이면 꽤 강한 믿음이다.
- 되돌린다. \(a = n_0\mu_0\), \(b = n_0(1-\mu_0)\).
이 방식이 좋은 것은 답하기 쉬운 질문으로 바꿔 준다는 점이다. "\(\text{Beta}(3.2, 8.4)\)가 적절한가"는 답하기 어렵지만 "대략 28% 정도이고 관측 12개만큼 확신한다"는 판단할 수 있다.
관례적인 선택.
| 사전분포 | \(n_0\) | 성격 |
|---|---|---|
| \(\text{Beta}(1,1)\) 균등 | 2 | 라플라스. 평평하지만 무정보는 아니다 |
| \(\text{Beta}(0.5,0.5)\) 제프리스 | 1 | 모수화 불변. 경계를 덜 누른다 |
| \(\text{Beta}(0,0)\) 홀데인 | 0 | 부적절(improper, 적분이 발산해 확률분포가 아니다). \(k=0\)이나 \(k=n\)이면 사후분포도 부적절 |
민감도 확인. 정한 사전분포에서 \(n_0\)를 두세 배 바꿔 가며 결론이 얼마나 움직이는지 본다. 크게 움직이면 자료가 아니라 사전분포가 결론을 만들고 있다는 뜻이므로 그 사실을 보고해야 한다.
연습문제 8. 베이즈 신용구간과 빈도주의 신뢰구간의 해석 차이를 설명하고, 베타–이항 모형에서 두 구간이 언제 비슷해지고 언제 크게 다른지 적어라.
풀이
해석의 차이.
| 신용구간 | 신뢰구간 | |
|---|---|---|
| 무엇이 확률변수인가 | 모수 \(\theta\) | 구간 |
| 진술 | \(P(\theta\in C\mid x)=0.95\) | 반복하면 95%가 참값을 담는다 |
| 자료 | 관측된 것만 | 관측되지 않은 자료도 고려 |
신용구간의 해석이 사람들이 원하는 것이다. "참 비율이 이 구간에 있을 확률이 95%"라고 말할 수 있다. 신뢰구간에 대해 그렇게 말하면 틀린 해석이다.
비슷해지는 경우.
- \(n\)이 클 때. 베른슈타인–폰 미제스 정리(Bernstein–von Mises theorem, 표본이 크면 사후분포가 MLE 를 중심으로 한 정규분포에 가까워진다는 정리)에 따라 사후분포가 \(N(\hat\theta,\ I^{-1}/n)\)에 수렴하므로(\(I\) 는 관측 하나의 피셔 정보), 사전분포가 무엇이든 신용구간이 왈드 신뢰구간과 같아진다.
- 사전분포가 약할 때. \(n_0 \ll n\)이면 사후분포가 사실상 정규화된 가능도다.
- 실제로 \(\text{Beta}(0.5,0.5)\) 제프리스 사전분포의 신용구간은 빈도주의 포함확률도 명목값에 매우 가깝다. 윌슨 구간과 성능이 비슷하며, 왈드 구간보다 낫다.
크게 다른 경우.
- \(n\)이 작을 때. \(n=5\), \(k=0\)이면 신뢰구간(클로퍼–피어슨)이 \((0, 0.52)\)인데, \(\text{Beta}(1,1)\) 사전분포의 신용구간은 \((0.004, 0.46)\)으로 더 좁다. 사전분포가 정보를 넣고 있기 때문이다.
- 사전분포가 강할 때. \(n_0\)가 \(n\)과 비슷하면 사후분포가 사전분포 쪽으로 크게 당겨진다.
- 경계 근처. \(\hat p=0\)이면 신뢰구간은 0을 포함하지만 신용구간은 (사전분포가 \(a>0\)이면) 0을 제외한다. "참 비율이 정확히 0일 확률이 0"이라는 사전분포의 주장이 반영된 것이다.
보고할 때. 어느 쪽을 썼는지, 베이즈라면 어떤 사전분포를 썼는지 반드시 밝힌다. 사전분포를 밝히지 않은 신용구간은 해석할 수 없다.
연습문제 9. 베타–이항 모형에서 베이즈 인자(Bayes factor)를 계산하는 방법을 설명하라. \(H_0: p=0.5\) 대 \(H_a: p\sim\text{Beta}(1,1)\)을 \(n=20\), \(k=15\)인 자료로 비교하라.
풀이
베이즈 인자. 두 모형의 주변가능도(marginal likelihood, 가능도를 사전분포로 평균한 값)의 비다.
\(H_0\) 아래. \(p=0.5\)로 고정이므로
\(H_a\) 아래. \(p\)를 사전분포로 적분해 없앤다.
(\(\text{Beta}(1,1)\)에서는 \(P(K=k) = 1/(n+1)\)로 균등하다는 깔끔한 결과가 나온다.)
베이즈 인자.
해석. 제프리스의 기준으로 \(B_{10}=3.22\)는 "\(H_a\)에 대한 약한 증거"다(\(1\sim3\) 언급할 가치 없음, \(3\sim10\) 약함, \(10\sim30\) 상당함, \(>30\) 강함).
\(p\) 값과의 대비. 같은 자료의 양측 \(p\) 값은 \(2P(K\ge15) = 0.0414\)로 5%에서 유의하다. "유의하다"와 "약한 증거"가 갈린다.
이 차이를 린들리의 역설이라 한다. 원인은 베이즈 인자가 \(H_a\)의 사전분포 전체에 대해 평균을 내기 때문이다. \(p\)가 0.75 근처면 자료를 잘 설명하지만 0.1이나 0.9면 못 하고, 그 평균이 희석된다.
중요한 주의. 베이즈 인자는 \(H_a\)의 사전분포에 매우 민감하다. \(\text{Beta}(1,1)\) 대신 \(\text{Beta}(10,10)\)을 쓰면 값이 크게 달라진다. 사전분포가 넓을수록 \(B_{10}\)이 작아지며(오컴의 면도날 효과), 부적절 사전분포에서는 아예 정의되지 않는다. 베이즈 인자를 보고할 때는 사전분포에 대한 민감도 분석이 필수적이다.
연습문제 10. 여러 집단의 비율을 동시에 추정할 때 쓰는 계층 베타–이항 모형을 설명하라. 각 집단을 따로 추정하는 것에 견주어 무엇이 나은가?
풀이
모형. 집단 \(j=1,\dots,J\)에서 \(k_j\)번 성공/\(n_j\)번 시행을 관측했다.
각 집단이 고유한 \(p_j\)를 갖되, 그 \(p_j\)들이 공통의 분포에서 나온다고 본다.
따로 추정하는 것과의 비교.
| 완전 분리(각자 \(\hat p_j = k_j/n_j\)) | 완전 결합(\(\hat p\) 하나) | 계층 | |
|---|---|---|---|
| 가정 | 집단이 서로 무관 | 모든 집단이 같음 | 그 사이 |
| \(n_j\)가 작을 때 | 매우 불안정 | 안정하지만 편향 | 적절히 축소 |
| 극단값 | 그대로 보고 | 무시 | 중앙으로 당김 |
계층 모형의 이점.
- 축소가 자동으로 일어난다. 사후평균이 대략
$$ E[p_j\mid x] \approx \frac{n_j}{n_j+n_0}\cdot\frac{k_j}{n_j}+\frac{n_0}{n_j+n_0}\cdot\bar p $$
로, \(n_j\)가 작은 집단일수록 전체 평균 쪽으로 더 많이 당겨진다. 표본이 적어 불안정한 추정을 자료가 알아서 보정한다.
-
축소의 정도를 자료가 정한다. \(n_0 = a+b\)가 추정되므로, 집단 간 차이가 실제로 크면 축소가 약하고 작으면 강하다. 분석자가 임의로 정하지 않아도 된다.
-
다중비교(multiple comparisons) 문제가 완화된다. 축소가 극단적인 값을 눌러 주므로, 여러 집단을 비교할 때 우연히 극단적으로 보이는 집단이 덜 생긴다. 별도의 본페로니 보정 없이도 거짓 양성(false positive)이 줄어든다.
-
정보를 빌려 온다. 제임스–스타인과 같은 원리이며, 실제로 계층 베이즈가 축소 추정의 자연스러운 틀이다.
응용. 야구 선수의 타율 추정(에프론과 모리스의 고전적 예), 병원별 사망률 평가, 소지역 추정, 웹사이트의 다중 A/B 테스트가 모두 이 구조다. 특히 "성과가 가장 좋은 집단을 고르는" 상황에서 축소가 결정적이다. 축소하지 않으면 표본이 가장 적은 집단이 우연히 1등으로 뽑히기 쉽다.
연습문제 11. \(\text{Beta}(1, 1)\)(균등) 사전분포로 \(n = 10\)번의 베르누이 시행에서 \(k = 7\)번 성공을 관측했다고 하자. 사후분포, 사후평균, MAP 추정값, 95% 신용구간을 계산하라.
풀이
사후분포는 \(\text{Beta}(1 + 7, 1 + 3) = \text{Beta}(8, 4)\)이다.
사후평균: \(\frac{8}{8 + 4} = \frac{2}{3} \approx 0.6667\).
MAP: \(\frac{8 - 1}{8 + 4 - 2} = \frac{7}{10} = 0.7\) (MLE와 같다).
scipy.stats.beta.ppf 를 쓴 95% 신용구간은 이렇게 된다.
from scipy.stats import beta
ci = (beta.ppf(0.025, 8, 4), beta.ppf(0.975, 8, 4))
print(f"95% CI: [{ci[0]:.4f}, {ci[1]:.4f}]")
출력:
95% CI: [0.3903, 0.8907]
결과는 약 \([0.3903, 0.8907]\)이다. \(\square\)
연습문제 12. 베타–이항 모형의 사후평균을 사전평균과 MLE의 볼록결합으로 쓸 수 있음을 증명하라. 가중을 찾아 해석하라.
풀이
\(\pi_0 = \alpha_0/(\alpha_0 + \beta_0)\)을 사전평균, \(\hat{p} = k/n\)을 MLE라 하자. 사후평균은 이렇게 된다.
다시 쓰면 이렇게 된다.
여기서 \(w = (\alpha_0 + \beta_0)/(\alpha_0 + \beta_0 + n)\)이다.
사전분포에 대한 가중 \(w\)는 \(n\)이 커질수록 줄어든다. 사전분포의 "유효 표본크기"가 \(\alpha_0 + \beta_0\)이며, 사후평균은 사전분포와 자료에 각각의 표본크기에 비례하여 가중을 배분한다. \(\square\)
연습문제 13. 유병률이 약 1%인 희귀질환의 확률을 추정한다고 하자. 동료가 \(\text{Beta}(1, 99)\) 사전분포를 제안한다. \(n = 500\)명을 검사하여 \(k = 8\)명이 양성이었을 때 사후평균과 MLE를 비교하라. 사전분포의 선택이 적절한가?
풀이
사전분포: 평균이 \(1/100 = 0.01\)인 \(\text{Beta}(1, 99)\).
사후분포: \(\text{Beta}(1 + 8, 99 + 492) = \text{Beta}(9, 591)\).
사후평균: \(9/600 = 0.015\).
MLE: \(8/500 = 0.016\).
사전분포의 유효 표본크기는 \(1 + 99 = 100\)으로 \(n = 500\)에 비해 크지 않다. 사후평균(0.015)은 MLE(0.016)에서 사전평균(0.01) 쪽으로 약간 당겨져 있다. 이 사전분포는 합리적이다. (1) 질환이 드물다는 실제 분야 지식을 담고 있고, (2) 유효 표본크기가 실제 표본크기보다 훨씬 작아 자료를 압도하지 않으며, (3) 자료가 희소해도 사후분포를 잘 정의된 상태로 유지해 주기 때문이다. \(\square\)
연습문제 14. 사전분포가 결론에 얼마나 영향을 주는지 확인하는 민감도 분석의 절차를 적고, 보고할 때 무엇을 포함해야 하는지 정리하라.
풀이
절차.
-
기준 사전분포를 정한다. 근거를 명시한다(선행 연구, 전문가 의견, 관례적 약정보 사전분포).
-
강도를 바꿔 본다. 사전 표본크기 \(n_0\)를 절반과 두 배(또는 0에 가깝게)로 바꿔 사후 요약값이 얼마나 움직이는지 본다.
-
중심을 바꿔 본다. 사전평균을 그럴듯한 범위의 양끝으로 옮겨 본다. 반대 방향의 믿음에서 출발해도 같은 결론이 나오는지가 중요하다.
-
분포족을 바꿔 본다. 정규 대신 \(t\), 베타 대신 절단 정규처럼 꼬리가 다른 사전분포를 써 본다. 특히 꼬리가 두꺼운 사전분포는 자료가 사전분포와 어긋날 때 자료를 더 존중하므로 안전한 선택이다.
-
극단적인 경우를 본다. 부적절 사전분포나 무정보 사전분포에서의 결과(사실상 가능도만 쓴 결과)를 함께 계산한다. 이것이 "자료만이 말하는 바"의 기준선이 된다.
보고에 포함할 것.
- 사용한 사전분포와 그 근거. 이것이 없으면 결과를 해석할 수 없다.
- 주요 결론이 사전분포에 얼마나 민감한지. 표나 그림으로 여러 사전분포에서의 사후평균·신용구간을 나란히 보인다.
- 자료와 사전분포의 상대적 기여. 사전 표본크기 \(n_0\)와 실제 \(n\)을 함께 적으면 독자가 바로 가늠한다.
- 사전–사후 충돌 여부. 사전분포의 질량이 거의 없는 곳으로 사후분포가 옮겨 갔다면 그 사실을 밝힌다. 모형이나 사전분포에 문제가 있다는 신호다.
판단 기준. 결론이 사전분포에 크게 의존하면 두 가지 중 하나다. 자료가 부족하거나, 사전분포가 너무 강하다. 어느 쪽이든 하나의 답을 자신 있게 보고하는 것보다 범위를 제시하는 것이 정직하다.
정리하며
베타–이항 켤레는 베이즈 갱신의 표준 보기다.
- 갱신이 덧셈이다. 성공 수를 \(a\) 에, 실패 수를 \(b\) 에 더하면 끝난다. 그래서 사전분포를 가상의 사전 관측으로 읽을 수 있고, \(a+b\) 가 그 가상 표본의 크기에 해당한다.
- 사후평균이 가중평균으로 적힌다.
\(n\) 이 커지면 \(k/n\) 으로 다가가고, \(n\) 이 작으면 사전평균 쪽에 붙는다. - 민감도 분석이 필수다. \(\text{Beta}(1,1)\)(균등), \(\text{Beta}(0.5,0.5)\)(제프리스), 정보가 있는 사전분포를 나란히 돌려 결론이 얼마나 달라지는지 확인한다. 결론이 사전분포에 크게 흔들리면 자료가 부족하다는 신호다. - 사후확률로 바로 의사결정을 한다. \(P(\theta>0.5\mid\text{자료})\) 같은 양을 직접 계산할 수 있으며, 이는 \(p\) 값으로는 불가능한 진술이다. - 경계 문제가 없다. 최대가능도에서 \(k=0\) 이면 \(\hat p=0\) 이지만, 사전분포가 있으면 사후평균이 \(a/(a+b+n)>0\) 으로 합리적인 값을 준다.
다음 절 최대사후확률 추정으로 넘어간다. 켤레 쌍 둘을 보는 동안 사후분포를 분포로 다루었는데, 거기서 수 하나를 뽑아야 할 때가 있다. 그 수를 최빈값으로 고르면 벌점이 붙은 최대가능도와 같은 식이 되어, 능형회귀(ridge regression)와 라쏘(lasso)가 그 자리에서 나온다.