sklearn LinearRegression 인터페이스
들어가는 이야기 — 그 수가 얼마나 흔들리는지는 적히지 않는다
fit 하고 score 하면 소수 넷째 자리까지 수가 하나 나온다. 그 수를 보고서에 옮겨 적고 모형을 고르는 일이 흔한데, 그 수가 얼마나 흔들리는지는 같은 호출이 알려 주지 않는다.
세 줄로 적합하고 자료의 \(20\%\) 를 떼어 채점하면 — 훈련 \(80\) 개, 시험 \(20\) 개다 — 시험 \(R^2 = 0.9855\) 가 나온다. 같은 모형의 훈련 \(R^2\) 는 \(0.9664\) 이니 보지 않은 자료에서 더 잘 맞힌 셈이다. 그 자체가 이상한 일은 아니다 — 떼어 낸 \(20\) 개가 어떤 자료인지에 따라 얼마든지 일어난다.
분할을 \(200\) 번 다시 해 보면 그 사정이 수로 나온다. 시험 \(R^2\) 의 평균이 \(0.9653\), 표준편차가 \(0.0151\) 이고 가장 낮은 번 \(0.9136\) 에서 가장 높은 번 \(0.9894\) 까지 벌어진다. 평균의 \(\pm 2\) 표준편차가 \(0.935\) 에서 \(0.996\) 이니 \(0.9855\) 는 그 안에서 운이 좋았던 한 번이고, 훈련 \(R^2\) 보다 높게 나온 것도 그 운에 들어 있다.
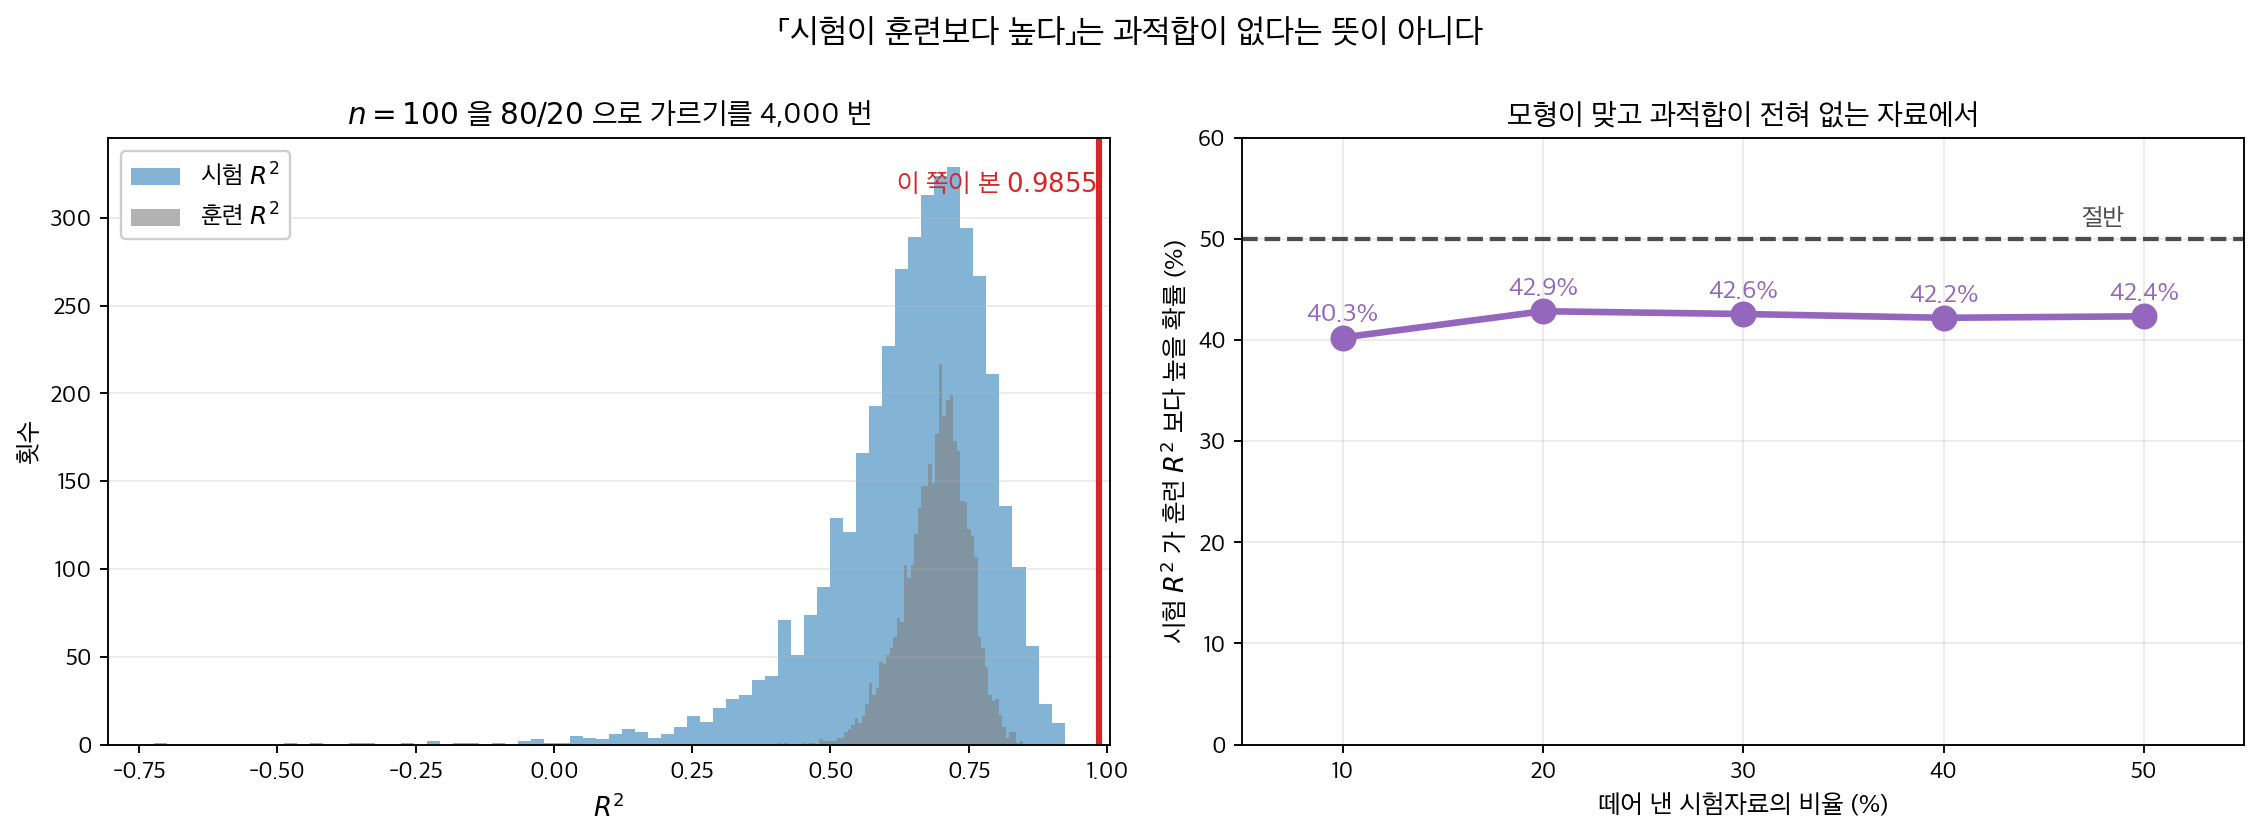
모형이 맞고 과적합(overfitting)이 전혀 없는 자료에서 같은 일을 \(4{,}000\) 번 해 보았다. 왼쪽. 훈련 \(R^2\) 는 좁게 모이는데 시험 \(R^2\) 는 넓게 퍼진다 — 채점에 쓴 관측이 스무 개뿐이기 때문이다. 이 쪽이 본 \(0.9855\) 는 그 오른쪽 끝에 가까운 한 번이다. 오른쪽. 그래서 시험이 훈련보다 높은 일이 떼어 낸 비율과 상관없이 세 번에 한 번쯤 일어난다. 과적합이 없어서가 아니라 분할 하나로는 아무것도 결론 낼 수 없어서다.
그래서 「시험이 훈련보다 높다」를 「과적합이 없다」로 읽으면 안 된다. 그 비교가 말해 준 것은 분할 하나로는 아무것도 결론 낼 수 없다는 사실뿐이다. 고치는 길은 교차검증(cross-validation)처럼 여러 번 재어 평균과 폭을 함께 보는 것이고, cross_val_score 가 돌려주는 것이 그 여러 번이다. 소수 넷째 자리까지 찍히는 score 의 값은 무엇을 재는 수이고, 그 수가 얼마나 흔들리는지는 어디서 보는가. 아래 상자가 그 수가 음수로 나오는 자리를 따라간다.
확인한 곳 — 이 쪽 「score() 가 음수를 돌려줄 때」 상자와 그 출처 줄
statsmodels가 통계적 추론을 위해 설계된 반면, scikit-learn의 LinearRegression은 예측을 위해 설계되었다. scikit-learn의 일관된 추정기 API — fit, predict, score — 를 따르며 라이브러리의 전처리, 파이프라인, 교차검증 도구와 매끄럽게 통합된다. 대가는 sklearn이 p 값, 신뢰구간, 진단검정을 기본으로 제공하지 않는다는 점이다.
1. 기본 사용법
LinearRegression 클래스는 최소제곱으로 모형 \(Y = \mathbf{X}\boldsymbol{\beta} + \varepsilon\)을 적합한다. statsmodels와 달리 절편(intercept)을 기본으로 자동 추가한다.
보기 1. 모형 적합과 계수. 참 절편이 \(2.0\), 참 계수가 \((3.0,\ 1.5)\), 잡음이 \(N(0, 0.5^2)\) 인 자료 \(100\) 개를 만들어 LinearRegression으로 적합한다.
(1) fit_intercept=True 인 LinearRegression이 푸는 것은 \(1\) 로 채운 열을 붙인 설계행렬의 정규방정식(normal equations)이다. 그 해를 손으로 구해 intercept_, coef_와 맞추시오.
(2) 추정값 \(2.046,\ 3.095,\ 1.414\) 가 참값 \(2.0,\ 3.0,\ 1.5\) 에서 벗어난 정도를 표준오차의 몇 배로 적으시오. 참 \(\sigma = 0.5\) 를 알고 있으니 표준오차를 미리 계산할 수 있다.
풀이
(1) 해석적으로. fit_intercept=True 는 설계행렬에
처럼 \(1\) 로 채운 열을 앞에 붙인 것과 같다. 최소제곱의 해는 정규방정식
이고, sklearn 은 그 결과의 첫 성분을 intercept_ 에, 나머지를 coef_ 에 나누어 담는다. (실제로는 평균을 뺀 뒤 절편을 되살리는 방식으로 계산하지만 수학적으로 같다.)
(2) 표준오차. \(\varepsilon \sim N(0, \sigma^2 \mathbf{I})\) 이므로
이다. 여기서 \(\sigma = 0.5\) 가 참값으로 주어져 있으므로 자료의 잔차를 보지 않고도 표준오차를 계산할 수 있다.
크기를 가늠해 두자. \(X\) 의 두 열은 서로 독립인 표준정규이므로 \(\mathbf{X}^\top\mathbf{X} \approx n\mathbf{I}\) 이고
이다. 더 정확히는 \(\mathrm{SE}(\hat\beta_j) \approx \sigma/(s_j\sqrt{n})\) 이어서, 그 열의 표본표준편차 \(s_j\) 가 \(1\) 보다 작으면 표준오차가 커진다.
그러므로 추정값이 참값에서 \(0.05\) 의 몇 배쯤 벗어나는 것이 정상이고, \(3\) 배를 넘으면 뭔가 잘못된 것이다.
import numpy as np
from sklearn.linear_model import LinearRegression

# 참 계수가 [3.0, 1.5], 절편이 2.0 인 자료다.
np.random.seed(42)
n = 100
X = np.random.randn(n, 2)
beta_true = np.array([3.0, 1.5])
y = X @ beta_true + 2.0 + np.random.randn(n) * 0.5

# sklearn 은 절편을 자동으로 넣는다(fit_intercept 의 기본값이 True).
# statsmodels 와 달리 1 로 채운 열을 붙일 필요가 없다.
model = LinearRegression()
model.fit(X, y)

# 적합 뒤에 만들어지는 속성은 이름 끝에 밑줄이 붙는다. sklearn 의 관례다.
print("Intercept:", model.intercept_)
print("Coefficients:", model.coef_)
출력:
Intercept: 2.046396690621326
Coefficients: [3.09536017 1.41392895]
이제 정규방정식을 직접 풀고 표준오차를 계산한다.
X_design = np.column_stack([np.ones(n), X])
beta_hat = np.linalg.solve(X_design.T @ X_design, X_design.T @ y)
sklearn_beta = np.r_[model.intercept_, model.coef_]
print("정규방정식 :", beta_hat)
print("sklearn    :", sklearn_beta)
print(f"최대 차이  = {np.abs(beta_hat - sklearn_beta).max():.3e}")

XtX_inv = np.linalg.inv(X_design.T @ X_design)
se = 0.5 * np.sqrt(np.diag(XtX_inv))          # 참 sigma = 0.5 를 쓴다
true = np.r_[2.0, beta_true]
print(f"SE (참 sigma=0.5) = {se.round(5)},   sigma/sqrt(n) = {0.5 / np.sqrt(n):.5f}")
print(f"X 열의 표본표준편차 = {X.std(axis=0, ddof=1).round(4)}")
print(f"(추정 - 참)/SE   = {((beta_hat - true) / se).round(3)}")
출력:
정규방정식 : [2.04639669 3.09536017 1.41392895]
sklearn    : [2.04639669 3.09536017 1.41392895]
최대 차이  = 1.332e-15
SE (참 sigma=0.5) = [0.05049 0.05871 0.05034],   sigma/sqrt(n) = 0.05000
X 열의 표본표준편차 = [0.8563 0.9989]
(추정 - 참)/SE   = [ 0.919  1.624 -1.71 ]
(1) 정규방정식과 sklearn 이 같다. 최대 차이가 \(1.3 \times 10^{-15}\) 로 배정밀도의 반올림 한계다. LinearRegression 이 하는 일은 결국 이 한 줄이며, 다른 알고리즘이 아니다.
(2) 세 이탈이 모두 \(2\) 표준오차 안에 있다. \(0.919\), \(1.624\), \(-1.710\) 이다. 가장 큰 것이 \(1.71\) 이니 흔히 보는 크기다. "추정값이 \(3.095\) 로 참값 \(3.0\) 보다 크다" 는 사실 자체는 아무것도 뜻하지 않는다. 표준오차 \(0.0587\) 로 나누어 \(1.62\) 라는 것을 보아야 한다.
표준오차의 크기도 유도한 대로다. \(\sigma/\sqrt{n} = 0.05\) 라고 가늠했고, 실제 값은 \(0.0505, 0.0587, 0.0503\) 이다. 둘째 것만 눈에 띄게 크다. 그 까닭은 바로 아래 줄에 있다. \(X\) 의 첫째 열의 표본표준편차가 \(0.8563\) 으로 \(1\) 보다 작아서다. \(0.5/(0.8563 \cdot 10) = 0.0584\) 로 \(0.0587\) 에 거의 맞는다. 설명변수(explanatory variable)가 덜 퍼져 있으면 그 계수를 덜 정확하게 안다.
마지막으로 담는 자리. scikit-learn 은 절편을 intercept_ 에, 기울기를 coef_ 에 따로 담는다. statsmodels 가 둘을 한 배열에 담는 것과 다르며, 두 라이브러리를 오가며 쓸 때 자주 헷갈리는 지점이다. 또한 X 에 \(1\) 로 채운 열을 붙이면 안 된다. 붙이면 그 열과 내부 절편이 완전 공선이 되어, 앞 절들에서 본 계수 폭주가 생긴다.
2. 예측
predict 메서드는 새 자료의 적합값을 계산한다.
보기 2. 예측하기. 새 입력 \((1.0,\ 0.5)\) 와 \((-0.5,\ 2.0)\) 의 예측값을 구한다.
(1) 두 예측값을 보기 1 의 계수로 손으로 계산하여 predict의 출력과 맞추시오.
(2) 두 점의 레버리지(leverage)를 계산하여 어느 점의 예측이 더 불안한지 가리시오. 두 점이 훈련자료의 범위 안에 있는가.
풀이
(1) 해석적으로. 예측은 계수와의 내적에 절편을 더하는 것뿐이다.
보기 1 의 값을 넣으면 첫째 점은
이고 둘째 점은
이다. predict 가 하는 일이 이 두 줄이다.
(2) 레버리지. 적합값의 분산은
이고 \(h(\mathbf{x})\) 를 레버리지라 부른다. 훈련점들의 레버리지 평균은 \(p/n = 3/100 = 0.03\) 이다. 새 점의 \(h\) 가 그보다 크면 자료의 중심에서 먼 곳이고 예측이 덜 믿을 만하다.
두 점을 눈으로 보면 \((-0.5, 2.0)\) 이 원점에서 더 멀므로(\(\|\mathbf{x}\| = 2.06\) 대 \(1.12\)) 레버리지도 더 클 것이다.
y_pred_train = model.predict(X)

# 새 자료로 예측할 때도 열의 개수와 순서가 훈련 때와 같아야 한다.
X_new = np.array([[1.0, 0.5], [-0.5, 2.0]])
y_pred_new = model.predict(X_new)
print("Predictions:", y_pred_new)
출력:
Predictions: [5.84872133 3.3265745 ]
by_hand = model.intercept_ + X_new @ model.coef_
print("sklearn :", model.predict(X_new))
print("손계산  :", by_hand)
print(f"최대 차이 = {np.abs(by_hand - model.predict(X_new)).max():.3e}")

resid = y - model.predict(X)
s2 = (resid ** 2).sum() / (n - 3)
for x_new in X_new:
    xx = np.r_[1.0, x_new]
    h = xx @ XtX_inv @ xx
    print(f"  x = {x_new}  레버리지 h = {h:.5f}  (평균 p/n = {3 / n:.3f}),  "
          f"적합값의 SE = {np.sqrt(s2 * h):.4f}")
print(f"훈련자료 X 의 범위: {X.min(axis=0).round(3)} ~ {X.max(axis=0).round(3)}")
출력:
sklearn : [5.84872133 3.3265745 ]
손계산  : [5.84872133 3.3265745 ]
최대 차이 = 0.000e+00
  x = [1.  0.5]  레버리지 h = 0.02896  (평균 p/n = 0.030),  적합값의 SE = 0.0910
  x = [-0.5  2. ]  레버리지 h = 0.05179  (평균 p/n = 0.030),  적합값의 SE = 0.1217
훈련자료 X 의 범위: [-2.62  -1.988] ~ [1.886 2.72 ]
(1) 손계산과 predict 가 정확히 같다. 차이가 \(0\) 이다(반올림 오차조차 없다). 유도한 \(5.848721\) 과 \(3.326575\) 가 출력의 \(5.84872133\), \(3.3265745\) 다.
(2) 둘째 점이 두 배 가까이 불안하다. 레버리지가 \(0.02896\) 대 \(0.05179\) 이고, 적합값의 표준오차가 \(0.0910\) 대 \(0.1217\) 이다. 예측한 대로 원점에서 먼 점이 더 크다. 첫째 점은 평균 레버리지 \(0.03\) 과 거의 같으니 자료의 중심에 놓인 전형적인 점이다.
두 점 모두 훈련자료의 범위 안에 있다. 첫째 좌표의 범위가 \([-2.620,\ 1.886]\), 둘째가 \([-1.988,\ 2.720]\) 이므로 \(1.0, 0.5\) 와 \(-0.5, 2.0\) 이 다 들어간다. 외삽이 아니다. 다만 변수별 범위에 들어간다는 것과 자료의 중심에 가깝다는 것은 다른 이야기이고, 레버리지가 그 차이를 잰다.
표준오차 \(0.09 \sim 0.12\) 는 적합값의 것이고 새 관측값의 예측구간(prediction interval)은 더 넓다. 거기에는 새 관측의 잡음 \(\sigma\) 가 더해져 \(\sqrt{s^2(1 + h)} \approx 0.54\) 가 된다. 곧 \(0.09\) 와 \(0.54\) 는 다른 질문의 답이다.
실무의 주의 하나. predict 는 2차원 배열을 받으므로 관측값이 하나여도 [[x1, x2]] 모양으로 넣어야 한다. 열의 개수와 순서가 훈련 때와 같아야 하며, pandas DataFrame 으로 적합했다면 열 이름까지 맞추는 것이 안전하다.
3. 모형 성능 평가
score 메서드는 주어진 자료에서의 \(R^2\)를 돌려준다.
보기 3. 결정계수(coefficient of determination). score가 돌려주는 훈련 \(R^2\) 를 본다.
(1) 참 모형을 알고 있으므로 모집단 \(R^2\) 를 해석적으로 구하시오. 참 \(\beta\) 를 그대로 써도 넘을 수 없는 값이다.
(2) 관측된 훈련 \(R^2 = 0.9706\) 이 그 값보다 작다. 두 가지 까닭을 수로 가려내시오.
풀이
(1) 해석적으로. 참 모형은
이다. 세 항이 서로 독립이므로 분산이 쪼개진다. 절편은 상수여서 분산에 들어가지 않는다.
설명할 수 있는 몫은 \(\varepsilon\) 을 뺀 \(11.25\) 이므로
\(0.9783\) 이 모집단의 천장이다.
(2) 떨어질 수 있는 두 길. 관측값이 천장보다 작다면 길은 두 가지다.
첫째, 추정한 \(\hat\beta\) 가 참 \(\beta\) 와 달라서. 이 몫은 \(n\) 이 커지면 사라진다.
둘째, 이 표본이 모집단과 달라서. 천장 자체가 표본마다 흔들린다. 실현된 신호의 분산 \(\widehat{\operatorname{Var}}(\mathbf{X}\boldsymbol\beta)\) 와 실현된 잡음의 분산 \(\widehat{\operatorname{Var}}(\boldsymbol\varepsilon)\) 로 다시 계산한 "이 표본의 천장"
이 \(0.9783\) 과 다를 수 있다. 어느 쪽이 더 큰 몫인지는 수로 가린다.
반대 방향도 짚어 두자. 최소제곱은 이 표본에 맞추므로 참 \(\beta\) 보다 이 표본에서 더 잘 맞는다. 곧 훈련 \(R^2\) 는 "참 \(\beta\) 로 계산한 \(R^2\)" 보다 크다. 이것이 과적합의 가장 작은 형태다.
# 회귀 모형의 score 는 R^2 다. 분류 모형이면 정확도를 돌려준다.
r2_train = model.score(X, y)
print(f"R-squared (training): {r2_train:.4f}")
출력:
R-squared (training): 0.9706
print(f"훈련 R^2 = {model.score(X, y):.6f}")
V_signal_pop = beta_true[0] ** 2 + beta_true[1] ** 2
print(f"모집단 R^2 = {V_signal_pop} / ({V_signal_pop} + 0.25) = {V_signal_pop / (V_signal_pop + 0.25):.6f}")

# 이 표본에서 실제로 실현된 신호와 잡음의 분산
np.random.seed(42); _ = np.random.randn(n, 2); eps = np.random.randn(n) * 0.5
V_signal = (X @ beta_true).var(ddof=1)
print(f"이 표본에서  Var(X beta) = {V_signal:.4f} (참 11.25),  Var(eps) = {eps.var(ddof=1):.4f} (참 0.25)")
print(f"이 표본의 상한 = {V_signal / (V_signal + eps.var(ddof=1)):.6f}")

tss = ((y - y.mean()) ** 2).sum()
rss_oracle = ((y - (X @ beta_true + 2.0)) ** 2).sum()
print(f"참 beta 를 그대로 쓴 R^2 = {1 - rss_oracle / tss:.6f}")
print(f"sigma 추정값 = sqrt(RSS/(n-3)) = {np.sqrt(s2):.4f}  (참 0.5)")
출력:
훈련 R^2 = 0.970625
모집단 R^2 = 11.25 / (11.25 + 0.25) = 0.978261
이 표본에서  Var(X beta) = 9.0931 (참 11.25),  Var(eps) = 0.2939 (참 0.25)
이 표본의 상한 = 0.968689
참 beta 를 그대로 쓴 R^2 = 0.969088
sigma 추정값 = sqrt(RSS/(n-3)) = 0.5349  (참 0.5)
범인은 표본이다. 이 표본에서 \(X\) 가 실제로 만들어 낸 신호의 분산은 \(9.0931\) 로 참값 \(11.25\) 보다 \(19\%\) 작고, 잡음의 분산은 \(0.2939\) 로 참값 \(0.25\) 보다 \(18\%\) 크다. 둘 다 \(R^2\) 를 내리는 방향이다. 다시 계산한 이 표본의 천장은 \(0.968689\) 이고, 모집단 값 \(0.978261\) 보다 \(0.0096\) 낮다.
그리고 관측된 \(0.970625\) 는 그 천장보다 오히려 높다. 어떻게 그럴 수 있는가. 유도의 마지막 단락이 답이다. 참 \(\beta\) 를 그대로 써서 계산한 \(R^2\) 가 \(0.969088\) 인데, 최소제곱으로 적합한 \(R^2\) 는 \(0.970625\) 다. 최소제곱이 정답보다 이 표본에서 더 잘 맞는다. 차이가 \(0.0015\) 이니 외운 잡음의 양이 아주 적지만, 방향은 언제나 이쪽이다. 모수 \(3\) 개를 관측값 \(100\) 개에 맞췄으니 그만큼이다.
정리하면 \(0.9783\)(모집단) \(\to 0.9687\)(이 표본의 천장) \(\to 0.9691\)(참 \(\beta\)) \(\to 0.9706\)(최소제곱)이다. 첫 걸음이 표본추출의 운, 마지막 걸음이 과적합이다.
잡음의 크기도 되찾았다. \(\sqrt{\mathrm{RSS}/(n-3)} = 0.5349\) 가 참 \(\sigma = 0.5\) 와 \(7\%\) 차이다. 이 표본의 실현된 잡음 표준편차(\(\sqrt{0.2939} = 0.542\))와는 \(1\%\) 차이다.
다른 성능 측도가 필요하면 sklearn.metrics 를 쓴다.
보기 4. 여러 성능 측도. MAE, MSE, RMSE 를 같은 잔차에서 계산한다.
(1) \(\mathrm{RMSE} \ge \mathrm{MAE}\) 가 언제나 성립함을 증명하고, 등호가 성립하는 때를 말하시오.
(2) 잔차가 정규분포라면 \(\mathrm{MAE}/\mathrm{RMSE}\) 가 어떤 수에 가까워지는지 유도하고, 출력의 비와 맞추시오.
풀이
(1) 코시–슈바르츠로 끝난다. 잔차의 절대값을 \(a_i = |y_i - \hat y_i| \ge 0\) 이라 하자.
코시–슈바르츠 부등식을 벡터 \((a_1, \ldots, a_n)\) 과 \((1, \ldots, 1)\) 에 쓰면
이고, 양변을 \(n^2\) 으로 나누면
이다. 둘 다 음이 아니므로 \(\mathrm{MAE} \le \mathrm{RMSE}\) 다. 같은 말을 확률로 하면 \((E|Z|)^2 \le E[Z^2]\), 곧 \(\operatorname{Var}(|Z|) \ge 0\) 이다.
등호는 모든 \(a_i\) 가 같을 때만 성립한다. 코시–슈바르츠의 등호 조건이 두 벡터의 비례이고, 상대가 \((1,\ldots,1)\) 이므로 \(a_1 = \cdots = a_n\) 이라는 뜻이다. 현실의 잔차가 모두 같은 크기일 수는 없으니 실제로는 늘 엄격한 부등호다.
(2) 정규잔차의 비. \(\varepsilon \sim N(0, \sigma^2)\) 이면 반정규분포의 평균이
이므로
이다. \(\sigma\) 가 약분되어 잡음의 크기와 무관한 수가 된다는 것이 요점이다. 그러므로 이 비는 잔차분포의 모양을 재는 척도다.
- 비가 \(0.798\) 근처면 잔차가 정규에 가깝다.
- 비가 그보다 작으면 큰 잔차 몇 개가 RMSE 를 끌어올린 것이므로 꼬리가 두껍다는 신호다.
- 비가 그보다 크면 잔차의 크기가 고르다는 뜻이다. 극단은 모두 같을 때의 \(1\) 이다.
from sklearn.metrics import mean_absolute_error, mean_squared_error, root_mean_squared_error

y_pred = model.predict(X)

# 셋 다 작을수록 좋다. RMSE 는 단위가 반응과 같아 읽기 편하고,
# MAE 는 이상치에 덜 휘둘린다.
mae = mean_absolute_error(y, y_pred)
mse = mean_squared_error(y, y_pred)
rmse = root_mean_squared_error(y, y_pred)

print(f"MAE:  {mae:.4f}")
print(f"MSE:  {mse:.4f}")
print(f"RMSE: {rmse:.4f}")
출력:
MAE:  0.4211
MSE:  0.2775
RMSE: 0.5268
print(f"RMSE^2 = {rmse ** 2:.6f},  MSE = {mse:.6f}")
print(f"MAE / RMSE = {mae / rmse:.4f},   sqrt(2/pi) = {np.sqrt(2 / np.pi):.4f}")
print(f"둘의 차이 = {abs(mae / rmse - np.sqrt(2 / np.pi)):.4f}")
출력:
RMSE^2 = 0.277509,  MSE = 0.277509
MAE / RMSE = 0.7994,   sqrt(2/pi) = 0.7979
둘의 차이 = 0.0015
(1)이 맞는다. \(\mathrm{MAE} = 0.4211 < 0.5268 = \mathrm{RMSE}\) 다. 그리고 \(\mathrm{RMSE}^2 = 0.277509\) 가 \(\mathrm{MSE}\) 와 소수 여섯째 자리까지 같다. 두 함수가 같은 양의 다른 표현일 뿐임을 확인한 셈이다.
(2)가 아주 잘 맞는다. \(\mathrm{MAE}/\mathrm{RMSE} = 0.7994\) 이고 유도한 \(\sqrt{2/\pi} = 0.7979\) 와 차이가 \(0.0015\), 비율로 \(0.2\%\) 다. 잔차 \(100\) 개로 잰 값이니 이 정도 변동은 당연하다.
이 일치가 뜻하는 것은 잔차가 정규에 가깝다는 것이고, 자료를 np.random.randn 으로 만들었으니 그래야 한다. 실제 자료에서 이 비가 \(0.6\) 쯤으로 나왔다면 몇몇 큰 잔차가 RMSE 를 혼자 밀어 올리고 있다는 뜻이므로, 이상치(outlier)를 찾아보거나 MAE 를 쓰는 쪽을 고려해야 한다. 두 측도의 비 하나가 잔차 히스토그램을 그리지 않고도 꼬리를 알려 준다.
root_mean_squared_error는 scikit-learn 1.4부터
이 함수는 scikit-learn 1.4에서 추가되었다. 더 낮은 버전에서는 mean_squared_error(y, y_pred, squared=False)를 쓰거나 np.sqrt(mean_squared_error(...))로 직접 계산한다.
그림으로 보는 통계학 1. score() 가 음수를 돌려줄 때
score 가 돌려주는 \(R^2\) 를 \(0\) 과 \(1\) 사이의 수로 아는 사람이 많다. 그렇게 배우는 것도 무리가 아니다 — 절편을 넣고 훈련자료에서 재면 그 범위를 벗어날 수 없기 때문이다. 그런데 그 두 조건 가운데 하나만 빠져도 음수가 나온다.
식을 보면 까닭이 바로 보인다.
분모는 「그 자료의 평균 하나로만 맞췄을 때의 오차」다. 그러니 \(R^2\) 은 「내 모형이 그 자료의 평균보다 얼마나 나은가」를 재는 수이고, 평균보다 못하면 음수가 된다.
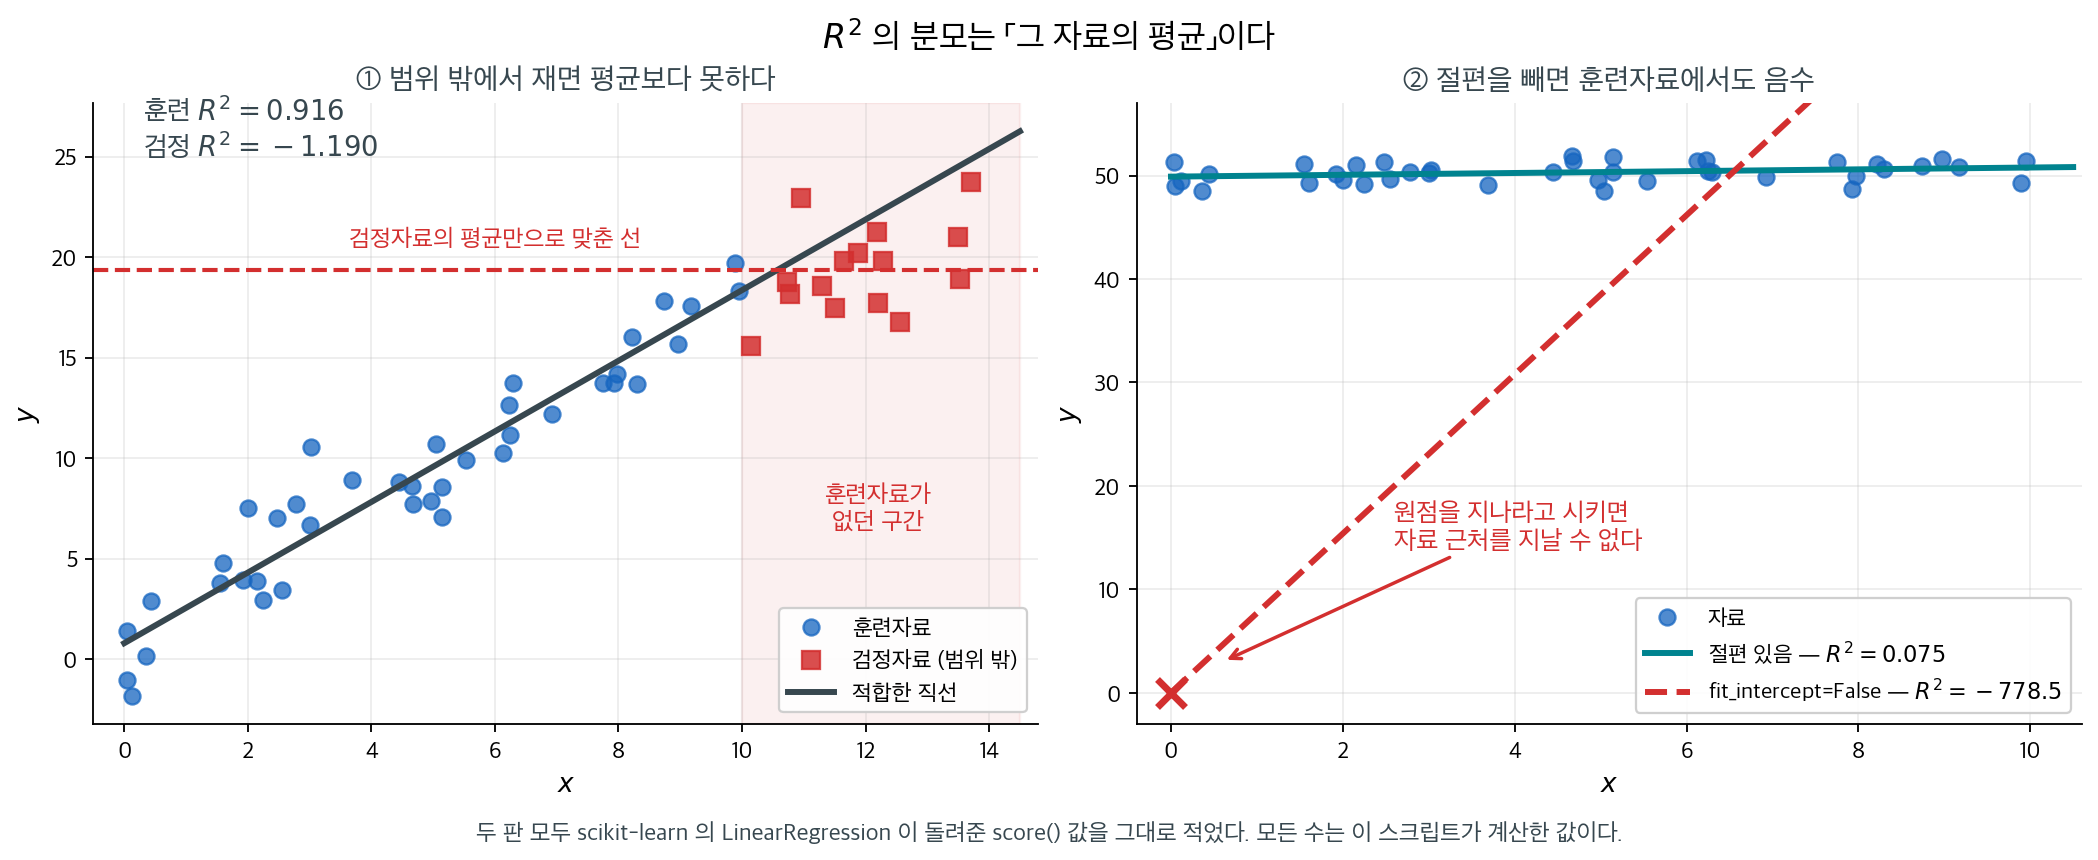
왼쪽은 흔한 자리다. \(x \in [0, 10]\) 에서 적합해 훈련 \(R^2 = 0.916\) 을 얻은 모형을 \(x \in [10, 14]\) 의 새 자료에 대고 재면 \(R^2 = -1.190\) 이다. 그림의 붉은 파선이 시험자료의 평균인데, 그 구간에서는 기울어진 적합선보다 저 평평한 선이 더 잘 맞는다. 수로는 오차제곱합이 평균 쪽 \(69.29\), 모형 쪽 \(151.76\) 이다. 모형이 틀린 것이 아니라 없던 구간에 대고 물은 것이고, \(R^2\) 은 그것을 음수로 알려 준다.
오른쪽은 더 놀란다. fit_intercept=False 로 적합하면 훈련자료에서도 음수가 된다. \(y\) 가 \(50\) 근처에 모여 있는 자료에서 직선에게 원점을 지나라고 시키면 자료 근처를 지날 수가 없고, 그 결과가 \(R^2 = -778.5\) 다. 같은 자료에 절편을 넣으면 \(0.075\) 다. 절편은 모형의 한 조각이 아니라 \(R^2\) 이라는 자의 받침대이기도 하다.
음수가 나오는 셋째 까닭은 규약이다
cross_val_score(..., scoring="neg_mean_squared_error") 가 돌려주는 값도 늘 음수다. 이 자료에서는 겹마다 \(-4.29\), \(-2.98\), \(-1.12\), \(-2.90\), \(-2.30\) 이 나왔다. 여기서는 모형이 나빠서가 아니라 sklearn 이 「클수록 좋다」로 점수를 통일해 두었기 때문이다. MSE 는 작을수록 좋으므로 부호를 뒤집어 돌려준다. 같은 호출에서 scoring 을 비우면 기본값이 \(R^2\) 라 \(0.436\)–\(0.943\) 이 나온다. 음수를 보면 먼저 그것이 성적인지 규약인지부터 가려야 한다.
확인한 곳 — 모든 수는 scikit-learn 의 LinearRegression 과 cross_val_score 를 직접 돌려 얻은 값이다. 씨앗을 고정했으므로 그림을 만드는 스크립트를 다시 돌리면 같은 수가 나온다
4. 훈련–검정 분할
표본 밖 성능을 추정하려면 적합하기 전에 자료를 나눈다.
보기 5. 훈련·시험 나누기. 자료의 \(20\%\) 를 떼어 두고 \(80\) 개로 적합한 뒤 떼어 둔 쪽에서 \(R^2\) 를 잰다.
(1) 시험 \(R^2 = 0.9855\) 가 훈련 \(R^2\) 보다 높다. 그것이 "모형이 표본 밖에서 더 잘한다"는 뜻일 수 없는 까닭을 말하시오. 또 보기 3 의 \(0.9706\) 과 바로 견주는 것이 왜 공정하지 않은가.
(2) 분할을 \(200\) 번 다시 해서 시험 \(R^2\) 의 산포를 재고, 이 한 번의 값이 그 안에서 어디에 놓이는지 적으시오.
풀이
(1) 두 가지를 분리해야 한다.
첫째, 견주는 대상이 어긋났다. 보기 3 의 \(0.9706\) 은 관측값 \(100\) 개 전부로 적합한 모형의 훈련 \(R^2\) 다. 여기의 모형은 \(80\) 개로 적합한 다른 모형이다. 같은 모형의 훈련 \(R^2\) 와 시험 \(R^2\) 를 견주어야 한다.
둘째, 기댓값으로 보면 훈련 쪽이 높아야 한다. 최소제곱은 훈련자료의 잔차제곱합을 최소화하므로 그 자료에서는 반드시 유리하다. 식으로 적으면
이다. 관측값당으로 고치면 훈련 쪽이 \(1 - p/n_{\text{train}}\) 배, 시험 쪽이 \(1 + p/n_{\text{train}}\) 배다. 그러므로 시험오차가 훈련오차보다 크고 시험 \(R^2\) 가 더 작은 것이 정상이다.
그런데 관측된 것은 반대다. 남은 설명은 하나뿐이다. \(n_{\text{test}} = 20\) 이라 시험 \(R^2\) 가 크게 흔들린다. 분모의 \(\mathrm{TSS}_{\text{test}}\) 도 그 \(20\) 개의 평균으로 계산되므로 분자와 분모가 함께 요동친다. 그 산포를 재면 \(0.9855\) 가 운인지 아닌지 가려진다. 닫힌 꼴로 적기 어려우니 모의실험으로 센다.
(2) 수치적으로.
from sklearn.model_selection import train_test_split

# 훈련자료에서 잰 성능은 과적합을 잡아내지 못한다. 그래서 자료를 나눈다.
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

model = LinearRegression()
model.fit(X_train, y_train)

r2_test = model.score(X_test, y_test)
print(f"R-squared (test): {r2_test:.4f}")
출력:
R-squared (test): 0.9855
scores = []
for s in range(200):
    a, b, c, d = train_test_split(X, y, test_size=0.2, random_state=s)
    scores.append(LinearRegression().fit(a, c).score(b, d))
scores = np.array(scores)

print(f"이 분할에서 같은 모형의 훈련 R^2 = {model.score(X_train, y_train):.4f},  시험 R^2 = {r2_test:.4f}")
print(f"200 번 다시 나눈 시험 R^2: 평균 {scores.mean():.4f}  표준편차 {scores.std(ddof=1):.4f}"
      f"  최소 {scores.min():.4f}  최대 {scores.max():.4f}")
print(f"random_state=42 의 값은 평균에서 {(scores[42] - scores.mean()) / scores.std(ddof=1):+.2f} 표준편차")
print(f"보기 3 의 훈련 R^2 0.9706 은 평균에서 {(0.970625 - scores.mean()) / scores.std(ddof=1):+.2f} 표준편차")
출력:
이 분할에서 같은 모형의 훈련 R^2 = 0.9664,  시험 R^2 = 0.9855
200 번 다시 나눈 시험 R^2: 평균 0.9653  표준편차 0.0151  최소 0.9136  최대 0.9894
random_state=42 의 값은 평균에서 +1.33 표준편차
보기 3 의 훈련 R^2 0.9706 은 평균에서 +0.35 표준편차
(1)의 첫 지적이 수로 확인된다. 같은 모형의 훈련 \(R^2\) 는 \(0.9706\) 이 아니라 \(0.9664\) 다. 관측값 \(80\) 개로 적합했으니 \(100\) 개로 적합한 것보다 낮다. 비교의 바른 짝은 \(0.9664\) 대 \(0.9855\) 다.
(2) 그 차이는 운이다. 분할을 \(200\) 번 다시 하면 시험 \(R^2\) 가 평균 \(0.9653\), 표준편차 \(0.0151\) 로 나오고 범위가 \(0.9136\) 에서 \(0.9894\) 까지 \(0.076\) 폭으로 벌어진다. random_state=42 가 준 \(0.9855\) 는 평균에서 \(+1.33\) 표준편차, 곧 운이 좋은 쪽이었다.
평균 \(0.9653\) 을 보면 이야기가 뒤집힌다. 시험 \(R^2\) 의 평균이 훈련 \(R^2\) \(0.9664\) 보다 낮다. 유도한 방향 그대로다. 과적합이 없다고 말할 수는 있지만, 그 근거는 "시험이 훈련보다 높다" 가 아니라 "둘의 차이 \(0.0011\) 이 분할 잡음 \(0.0151\) 에 묻힌다" 는 것이다.
여기서 교훈이 하나 나온다. \(n_{\text{test}} = 20\) 짜리 한 번의 분할로 얻은 점수를 성능이라고 보고하면 안 된다. 소수 넷째 자리까지 적어 둔 \(0.9855\) 가 실은 \(\pm 0.03\) 의 불확실성을 지닌 수다. 아래 보기 6 의 교차검증이 이 변동을 줄이는 방법이다.
그래도 원칙은 바뀌지 않는다. 시험 \(R^2\) 는 모형이 적합 과정에서 그 자료를 보지 않았으므로 편향이 없는 추정이다. 문제는 편향이 아니라 분산이다.
5. 교차검증
scikit-learn은 훈련–시험 분할의 반복을 자동화하는 교차검증 도구를 제공한다.
보기 6. 교차검증. cross_val_score로 5겹 교차검증 \(R^2\) 를 구한다.
(1) 회귀에서 cv=5가 쓰는 분할 방식이 무엇인지 적고, 그 다섯 점수를 KFold로 직접 재현하시오. 어느 관측값이 어느 겹에 들어가는가.
(2) 출력의 Std CV R-squared: 0.0054가 무엇의 표준편차인지 가려내시오. 평균 \(0.9683\) 의 불확실성으로 읽으면 어디가 틀리는가.
풀이
(1) 섞지 않고 통째로 자른다. cross_val_score 는 반응변수가 연속이면 KFold 를, 범주이면 StratifiedKFold 를 쓴다. 그리고 KFold 의 기본값이 shuffle=False 다. 그러므로 관측값 \(100\) 개가 들어온 순서대로
다섯 토막으로 끊긴다. 겹 \(k\) 를 검증에 쓰고 나머지 \(80\) 개로 적합하는 일을 다섯 번 반복한다.
이것이 함정이 될 수 있다. 자료가 시간순이거나 집단별로 정렬되어 있으면, 섞지 않은 겹은 "앞 \(80\%\) 로 배워 뒤 \(20\%\) 를 맞히라" 는 전혀 다른 문제가 된다. 여기서는 np.random.randn 으로 만든 자료라 순서에 뜻이 없어 괜찮다.
(2) 겹 사이의 표준편차다. cv_scores.std() 는 다섯 점수가 서로 흩어진 정도이며, 평균의 정밀도가 아니다. 독립인 다섯 수의 평균이라면 평균의 표준오차는
이므로 \(0.0054/\sqrt{5} \approx 0.0024\) 쪽이 평균의 불확실성에 가깝다. \(0.0054\) 를 "평균 \(0.9683 \pm 0.0054\)" 로 읽으면 두 배 넘게 부풀린 셈이다.
다만 \(\sqrt{5}\) 로 나누는 것도 정확하지는 않다. 다섯 겹의 훈련집합이 서로 \(60\) 개를 공유하므로 점수들이 독립이 아니다. 양의 상관이 있으면 평균의 분산이 \(s^2/5\) 보다 커진다. 그러므로 참값은 \(0.0024\) 와 \(0.0054\) 사이에 있다고 말하는 것이 옳다. 교차검증 점수의 표준오차를 제대로 쓰기 어렵다는 것이 널리 알려진 사정이다.
from sklearn.model_selection import cross_val_score

# 한 번 나누는 것보다 낫다. 모든 관측값이 한 번씩 검증에 쓰이고,
# 겹마다의 점수가 흩어진 정도까지 알려 준다.
model = LinearRegression()
cv_scores = cross_val_score(model, X, y, cv=5, scoring='r2')

print(f"CV R-squared scores: {cv_scores}")
print(f"Mean CV R-squared: {cv_scores.mean():.4f}")
print(f"Std CV R-squared: {cv_scores.std():.4f}")
출력:
CV R-squared scores: [0.96022772 0.96777464 0.9761083  0.96564245 0.97171516]
Mean CV R-squared: 0.9683
Std CV R-squared: 0.0054
from sklearn.model_selection import KFold
from sklearn.metrics import r2_score

kf = KFold(n_splits=5)          # 기본값은 shuffle=False
manual = []
for train_idx, test_idx in kf.split(X):
    m = LinearRegression().fit(X[train_idx], y[train_idx])
    manual.append(r2_score(y[test_idx], m.predict(X[test_idx])))
manual = np.array(manual)

print("cross_val_score :", cv_scores)
print("손으로 KFold    :", manual)
print(f"최대 차이 = {np.abs(manual - cv_scores).max():.3e}")
for i, (_, test_idx) in enumerate(kf.split(X)):
    print(f"  겹 {i}: 검증 색인 {test_idx.min()}~{test_idx.max()} ({len(test_idx)}개)")
print(f"겹 사이 표준편차 = {cv_scores.std():.4f},  평균의 표준오차 = {cv_scores.std(ddof=1) / np.sqrt(5):.4f}")
출력:
cross_val_score : [0.96022772 0.96777464 0.9761083  0.96564245 0.97171516]
손으로 KFold    : [0.96022772 0.96777464 0.9761083  0.96564245 0.97171516]
최대 차이 = 0.000e+00
  겹 0: 검증 색인 0~19 (20개)
  겹 1: 검증 색인 20~39 (20개)
  겹 2: 검증 색인 40~59 (20개)
  겹 3: 검증 색인 60~79 (20개)
  겹 4: 검증 색인 80~99 (20개)
겹 사이 표준편차 = 0.0054,  평균의 표준오차 = 0.0027
(1) 다섯 점수가 정확히 재현된다. 최대 차이가 \(0\) 이다. 겹의 경계도 유도한 대로 \(0\)–\(19\), \(20\)–\(39\), …, \(80\)–\(99\) 로 연속한 토막이다. cross_val_score 에 숨은 마법이 없음을 확인한 셈이고, 섞기가 필요하면 KFold(n_splits=5, shuffle=True, random_state=0) 를 cv 에 직접 넘겨야 한다.
(2) 평균의 표준오차는 \(0.0027\) 이다. 보고된 \(0.0054\) 의 절반이다. \(\sqrt{5} = 2.24\) 로 나눈 결과이며, 유도한 \(0.0024\) 와 조금 다른 것은 분모를 \(n-1\) 로 쓴 표본표준편차를 썼기 때문이다.
보기 5 와 견주면 교차검증의 값어치가 보인다. 한 번 분할의 시험 \(R^2\) 는 분할마다 표준편차 \(0.0151\) 로 흔들렸다. 교차검증의 겹 사이 표준편차는 \(0.0054\) 이고 그 평균의 변동은 더 작다. 모든 관측값을 한 번씩 검증에 쓰고 다섯 점수를 평균하므로 분할의 운이 상쇄된다.
남은 주의 하나. 교차검증 평균 \(0.9683\) 도 그 모형을 고르는 데 쓰였다면 낙관적이 된다. 여러 모형의 CV 점수를 비교해 가장 좋은 것을 고른 뒤 그 점수를 일반화 성능으로 보고하면 선택 편향(selection bias)이 섞인다. 고르는 것과 평가하는 것은 다른 자료로 해야 한다.
scoring 인자는 scikit-learn 의 어떤 채점기도 받는다. 회귀에서 흔한 선택은 'r2', 'neg_mean_squared_error', 'neg_mean_absolute_error' 이다. "neg" 접두사가 붙는 것은 점수가 높을수록 좋다는 scikit-learn 의 관례 때문이며, 그래서 오차 측도에 음수를 붙인다.
왜 한 번 나누는 것으로는 부족한가
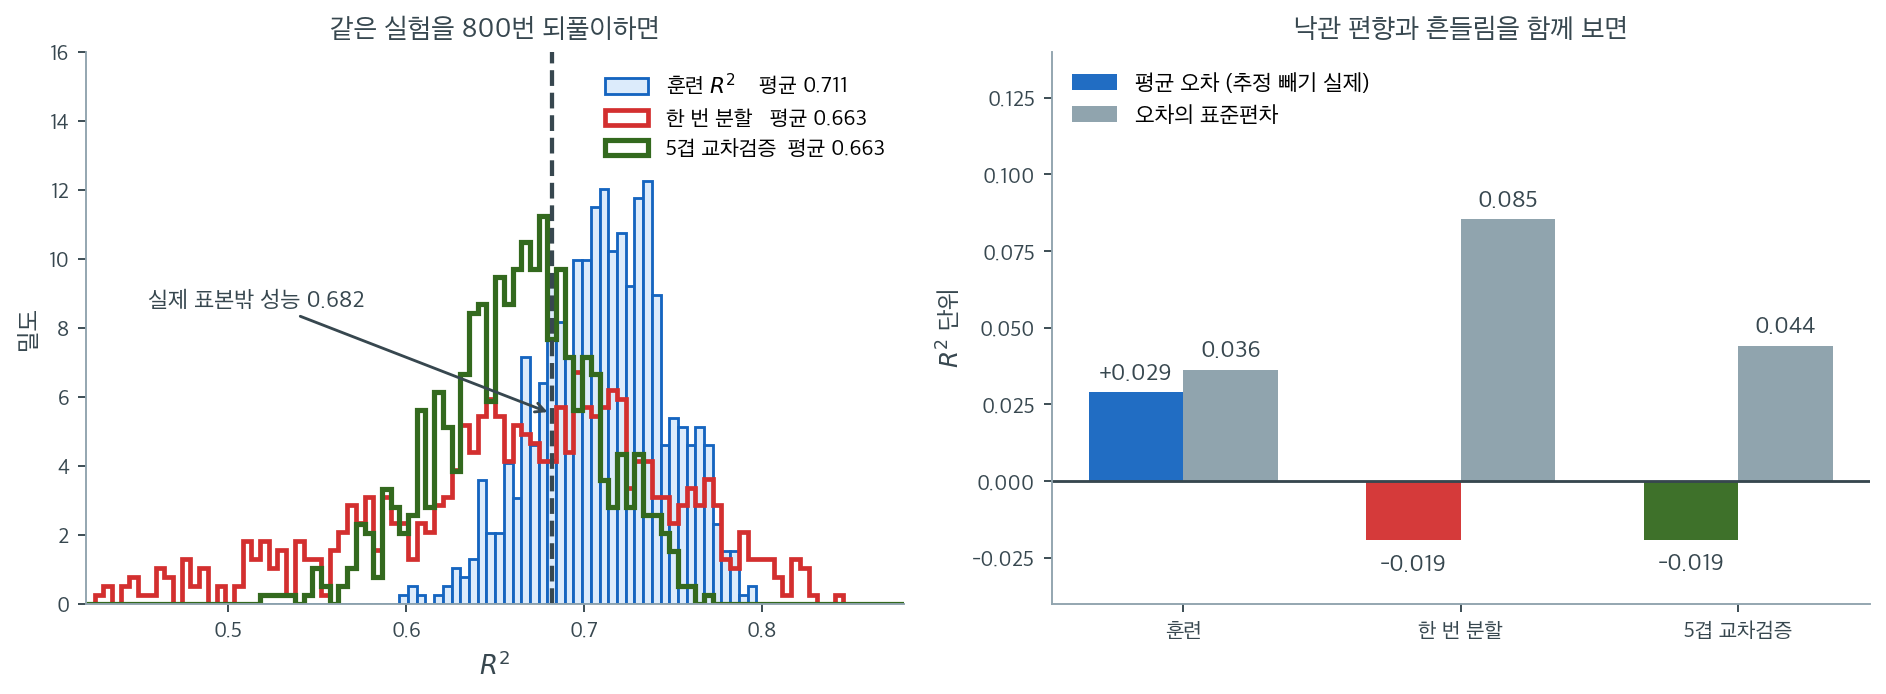
세 가지 채점 방식이 실제로 무엇을 재는지 모의실험으로 확인해 보자. 관측값 \(200\)개, 설명변수 \(8\)개(그중 셋만 진짜 효과가 있다)로 회귀를 적합하고, 따로 만든 아주 큰 자료에서 그 모형의 실제 표본밖 \(R^2\)을 잰다. 그 값이 우리가 추정하려는 목표다. 이 실험을 \(800\)번 반복했다.
왼쪽 히스토그램이 결과다. 실제 표본밖 성능은 평균 \(0.682\)인데(검은 점선), 훈련 \(R^2\)(파랑)은 평균 \(0.711\)로 언제나 오른쪽으로 치우쳐 있다. 같은 자료로 계수를 정하고 같은 자료로 점수를 매겼으니 당연한 일이다. 한 번 분할(빨강)과 5겹 교차검증(초록)은 둘 다 평균 \(0.663\)으로 목표 근처에 있다. 약간 낮은 것은 훈련에 쓰는 자료가 줄었기 때문이다.
차이는 폭에 있다. 오른쪽 막대가 각 방식의 오차(추정값 빼기 실제값)를 정리한 것이다. 평균 오차는 훈련이 \(+0.029\), 한 번 분할과 교차검증이 각각 \(-0.019\)로 비슷하다. 그런데 오차의 표준편차가 훈련 \(0.036\), 한 번 분할 \(0.085\), 교차검증 \(0.044\)로 한 번 분할이 교차검증의 두 배 가까이 흔들린다. 시험자료가 \(50\)개뿐이라 그 \(50\)개를 어떻게 뽑았느냐에 점수가 크게 좌우되기 때문이다. 교차검증은 모든 관측값을 한 번씩 검증에 쓰고 다섯 점수를 평균하므로 그 운을 상쇄한다.
그래서 train_test_split 한 번으로 얻은 점수를 모형의 성능이라고 보고하는 것은 위험하다. 운이 좋으면 실제보다 \(0.1\) 높게, 나쁘면 \(0.1\) 낮게 나올 수 있다. 모형 둘을 비교할 때는 특히 그렇다. 차이가 우연인지 실제인지 구별하려면 겹마다의 점수 산포까지 보아야 하고, 위 보기가 cv_scores.std()를 함께 찍는 이유가 여기에 있다.
6. 파이프라인
파이프라인은 전처리와 모형화 단계를 하나의 객체로 엮어, 훈련과 예측에서 변환이 일관되게 적용되도록 보장한다.
보기 7. 파이프라인. 표준화 → 이차 다항 특성 → 선형회귀(linear regression)를 하나의 객체로 엮어 적합한다.
(1) PolynomialFeatures(degree=2, include_bias=False)가 입력 \(p = 2\) 개에서 만드는 특성의 개수를 세고 이름을 적으시오.
(2) 세 단계 가운데 StandardScaler는 선형회귀의 예측을 전혀 바꾸지 못한다. 그것을 증명하고 수로 확인하시오. 그러면 시험 \(R^2\) 가 보기 5 보다 조금 오른 것은 무엇의 몫인가.
풀이
(1) 특성은 5 개다. 차수 \(2\) 의 단항식은 일차항과 이차항으로 나뉜다. 일차항은 \(x_1, \ldots, x_p\) 로 \(p\) 개, 이차항은 \(x_i x_j\) (\(i \le j\)) 의 꼴이므로 중복을 허용한 조합의 수
개다. 합하면
이고, 이름은 \(x_0,\ x_1,\ x_0^2,\ x_0 x_1,\ x_1^2\) 이다. include_bias=False 이므로 상수항 \(1\) 은 빠지고, 그것은 LinearRegression 이 절편으로 넣는다. 그러므로 모수가 \(5 + 1 = 6\) 개이고, 보기 5 의 \(3\) 개보다 세 개 많다.
(2) 표준화는 예측을 바꾸지 못한다. StandardScaler 가 하는 일은 열마다
이다. 벡터로 쓰면 \(\tilde{\mathbf{x}} = \mathbf{D}^{-1}(\mathbf{x} - \bar{\mathbf{x}})\) 이고 \(\mathbf{D} = \operatorname{diag}(s_1, \ldots, s_p)\) 는 가역이다. 설계행렬로는
이고 \(\mathbf{A}\) 가 가역이다. 가역행렬을 오른쪽에 곱하는 것은 열공간을 바꾸지 않으므로
이다. 최소제곱의 적합값은 \(\mathbf{y}\) 를 열공간에 사영한 것이므로 같은 값이 나온다. 계수만 \(\hat{\boldsymbol\beta}_{\text{new}} = \mathbf{A}^{-1}\hat{\boldsymbol\beta}\) 로 다시 표현된다.
그러므로 표준화는 계수의 해석과 벌점(능형회귀(ridge regression), 라쏘)에서만 뜻을 가진다. 보통의 OLS 예측에는 아무 영향이 없다.
남은 차이는 PolynomialFeatures 의 몫이다. 모수를 \(3\) 개에서 \(6\) 개로 늘렸으니 시험 \(R^2\) 가 오르든 내리든 그 셋 때문이다.
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler, PolynomialFeatures

# 파이프라인은 전처리와 모형을 하나로 묶는다. 교차검증에 넣으면 각 겹에서
# 표준화가 훈련 부분만 보고 이뤄지므로, 검증자료의 정보가 새지 않는다.
# 전처리를 미리 해 두고 나누면 이 누출이 조용히 일어난다.
pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('poly', PolynomialFeatures(degree=2, include_bias=False)),
    ('regression', LinearRegression())
])

pipeline.fit(X_train, y_train)
r2_pipeline = pipeline.score(X_test, y_test)
print(f"Pipeline R-squared (test): {r2_pipeline:.4f}")
출력:
Pipeline R-squared (test): 0.9858
poly = pipeline.named_steps['poly']
print("만들어진 특성 :", poly.get_feature_names_out().tolist())
print(f"특성 개수 = {poly.n_output_features_}   (p + p(p+1)/2 = 2 + 3 = 5)")
print("회귀 계수    :", pipeline.named_steps['regression'].coef_.round(4))

# 표준화만 넣은 파이프라인은 맨 OLS 와 완전히 같아야 한다.
scale_only = Pipeline([('scaler', StandardScaler()),
                       ('regression', LinearRegression())]).fit(X_train, y_train)
plain = LinearRegression().fit(X_train, y_train)
print(f"표준화만 R^2 = {scale_only.score(X_test, y_test):.10f}")
print(f"맨 OLS  R^2 = {plain.score(X_test, y_test):.10f}")
print(f"예측의 최대 차이 = {np.abs(scale_only.predict(X_test) - plain.predict(X_test)).max():.3e}")
print(f"이차항까지 넣은 R^2 = {pipeline.score(X_test, y_test):.10f}"
      f"  (이득 {pipeline.score(X_test, y_test) - plain.score(X_test, y_test):+.6f})")
출력:
만들어진 특성 : ['x0', 'x1', 'x0^2', 'x0 x1', 'x1^2']
특성 개수 = 5   (p + p(p+1)/2 = 2 + 3 = 5)
회귀 계수    : [ 2.6443e+00  1.3872e+00 -2.2000e-03  4.0100e-02 -2.0500e-02]
표준화만 R^2 = 0.9854954588
맨 OLS  R^2 = 0.9854954588
예측의 최대 차이 = 3.553e-15
이차항까지 넣은 R^2 = 0.9857604753  (이득 +0.000265)
(1)의 셈과 이름이 그대로 나왔다. 특성 \(5\) 개가 \(x_0, x_1, x_0^2, x_0x_1, x_1^2\) 이다.
(2) 표준화는 소수 열째 자리까지 같은 \(R^2\) 를 준다. \(0.9854954588\) 이 양쪽에서 똑같고, 예측값의 최대 차이가 \(3.6 \times 10^{-15}\) 로 반올림 한계다. 유도한 "열공간이 같으므로 사영도 같다" 가 수치로 확인되었다.
이차항의 몫은 \(+0.000265\) 다. \(0.9855 \to 0.9858\) 로 소수 넷째 자리에서 겨우 보인다. 모수 세 개를 더 썼는데 이것뿐인 까닭은 참 모형이 선형이기 때문이다. 계수를 보면 분명하다. 일차항이 \(2.644\) 와 \(1.387\) 인데 이차항 셋은 \(-0.0022\), \(0.0401\), \(-0.0205\) 로 두 자리 작다. 자료가 "이차항은 필요 없다" 고 말한 것이다.
보기 5 에서 본 분할 잡음 \(0.0151\) 과 견주면 \(0.000265\) 는 잡음에 완전히 묻힌다. 이 비교로 "다항 특성이 도움이 되었다" 고 말할 근거는 전혀 없다.
끝으로 파이프라인을 쓰는 진짜 이유. 이 파이프라인은 각 설명변수를 평균 \(0\), 분산 \(1\) 로 표준화하고, 다음으로 교호작용(interaction) 항을 포함한 다항 특성을 만들고, 마지막으로 선형회귀를 적합한다. 전체를 cross_val_score 에 넘기면 각 겹에서 표준화가 그 겹의 훈련 부분만 보고 이뤄진다. 전처리를 미리 해 두고 나누면 검증자료의 평균과 표준편차가 변환에 스며들어 자료 누출이 조용히 일어난다. 위에서 보았듯 OLS 에서는 표준화가 예측을 바꾸지 않으므로 그 누출이 해롭지 않지만, 능형회귀나 라쏘에서는 곧바로 낙관적인 점수로 나타난다.
파이프라인이 중요한 이유
파이프라인 없이 작업하면 전체 자료로 계산한 훈련 통계량으로 시험자료를 표준화하거나 변환하는 실수(자료 누출)를 저지르기 쉽다. 파이프라인은 각 변환 단계를 그 시점에 사용 가능한 자료에만 적용하여 이를 막아 준다.
7. sklearn과 statsmodels 중 무엇을 쓸 것인가
| 작업 | 권장 라이브러리 |
|---|---|
| 계수에 대한 가설검정 | statsmodels |
| \(\beta_j\)의 신뢰구간 | statsmodels |
| 잔차 진단(정규성, 이분산) | statsmodels |
| AIC/BIC를 통한 모형 비교 | statsmodels |
| 새 자료에 대한 예측 | sklearn |
| 교차검증 기반 모형 평가 | sklearn |
| 전처리 파이프라인과의 통합 | sklearn |
| 정칙화 회귀(능형회귀, 라쏘) | sklearn |
| 고차원 자료 (\(p > n\)) | sklearn |
경쟁이 아니라 상호보완 관계이다
흔한 작업 흐름은 모형을 세우는 단계에서 statsmodels로 가설을 검정하고 진단을 살피고 설명변수를 고른 뒤, 예측 파이프라인에 배포하기 위해 최종 모형을 sklearn으로 다시 적합하는 것이다. 계수 추정값은 (둘 다 OLS를 쓰므로) 동일하며, 선택의 기준은 모형 주위에 어떤 도구가 필요한가이다.
연습문제
연습문제 1. scikit-learn으로 인공자료에 선형회귀를 적합하고, 예측을 계산하며, \(R^2\) 점수를 출력하는 Python 코드를 작성하라.
풀이
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split

rng = np.random.default_rng(42)
X = rng.normal(0, 1, (200, 3))
y = 2 * X[:, 0] - 1.5 * X[:, 1] + 0.5 * X[:, 2] + rng.normal(0, 0.5, 200)

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

model = LinearRegression()
model.fit(X_train, y_train)

print(f"Coefficients: {model.coef_.round(3)}")
print(f"Intercept: {model.intercept_:.3f}")
print(f"R^2 (test): {model.score(X_test, y_test):.4f}")
출력:
Coefficients: [ 2.012 -1.519  0.442]
Intercept: -0.015
R^2 (test): 0.9440
참 계수가 \(2, -1.5, 0.5\)인데 추정값이 \(2.012, -1.519, 0.442\)로 잘 맞는다. 시험 자료의 \(R^2\)는 0.944다.
연습문제 2.
model.score()와 예측값에서 \(R^2\)를 직접 계산하는 것의 차이를 설명하라. 둘은 동등한가?
풀이
model.score(X, y)는 다음을 계산한다.
여기서 \(\hat{y}_i\)는 model.predict(X)이고 \(\bar{y}\)는 넘겨준 y의 평균이다. 이는 다음을 직접 계산하는 것과 동등하다.
y_pred = model.predict(X)
ss_res = np.sum((y - y_pred) ** 2)
ss_tot = np.sum((y - y.mean()) ** 2)
r2 = 1 - ss_res / ss_tot
둘은 수학적으로 동일하다. 다만 시험자료에 적용할 때 \(\bar{y}\)는 (훈련자료가 아니라) 시험자료의 평균이며, 그래서 모형이 나쁘게 적합하면 시험 \(R^2\)가 음수가 될 수 있다.
연습문제 3.
scikit-learn의 LinearRegression이 계수의 p 값이나 신뢰구간을 제공하지 않는 이유는 무엇인가? 어떻게 얻을 수 있는가?
풀이
scikit-learn은 통계적 추론이 아니라 예측을 주된 목적으로 설계되었다. LinearRegression은 OLS를 기계학습 알고리즘으로 구현하며 .fit(), .predict(), .score()에 집중한다. 표준오차, t 통계량, p 값, 신뢰구간은 계산하지 않는다.
추론 통계량을 얻으려면
- statsmodels 사용:
import statsmodels.api as sm; model = sm.OLS(y, sm.add_constant(X)).fit(); print(model.summary())가 p 값, 신뢰구간, 진단 통계량을 담은 완전한 회귀표를 제공한다. - 직접 계산: \(\hat{\boldsymbol{\beta}}\)를 구한 뒤 \(s^2 = \text{SSE}/(n-p)\)(\(p\)는 절편을 포함한 모수의 개수), \(\text{SE}(\hat{\beta}_j) = s\sqrt{[(\mathbf{X}^\top\mathbf{X})^{-1}]_{jj}}\), \(t_j = \hat{\beta}_j/\text{SE}(\hat{\beta}_j)\)를 계산한다.
예측 중심(sklearn)과 추론 중심(statsmodels) 도구가 나뉘어 있는 것은 모형과 알고리즘의 구분을 반영한다.
연습문제 4.
sklearn.model_selection.cross_val_score로 선형회귀 모형의 일반화 성능을 추정하는 방법을 기술하라.
풀이
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import cross_val_score
import numpy as np

model = LinearRegression()
scores = cross_val_score(model, X, y, cv=5, scoring="r2")

print(f"CV R^2 scores: {scores.round(4)}")
print(f"Mean R^2: {scores.mean():.4f} (+/- {scores.std():.4f})")
출력:
CV R^2 scores: [0.9531 0.9465 0.9701 0.9306 0.965 ]
Mean R^2: 0.9530 (+/- 0.0140)
5겹 교차검증의 \(R^2\)가 0.93에서 0.97 사이에 흩어져 있다. 한 번의 훈련/시험 분할로 얻은 값 하나만 보고하면 이 변동이 숨는다.
cross_val_score는 내부에서 k-겹 교차검증을 수행한다. 자료를 cv=5개의 겹으로 나누고, 4개 겹으로 모형을 적합한 뒤 5번째 겹에서 평가하며, 모든 겹에 대해 반복한다. scoring 인자가 성능 측도를 지정한다(선택지로 "r2", "neg_mean_squared_error", "neg_mean_absolute_error" 등이 있다).
참고: sklearn은 점수가 클수록 좋다는 관례(채점기는 최대화되어야 한다)를 지키기 위해 음의 MSE(neg_mean_squared_error)를 쓴다.
연습문제 5. 보기 2 는 레버리지 \(h(\mathbf{x}) = \tilde{\mathbf{x}}^\top (\mathbf{X}_{\text{design}}^\top\mathbf{X}_{\text{design}})^{-1} \tilde{\mathbf{x}}\) 를 두 점에서 계산해 \(0.02896\) 과 \(0.05179\) 를 얻었고, 훈련점의 레버리지 평균이 \(p/n = 0.03\) 이라고 했다.
(1) 보기 7 (2) 에서 쓴 "가역행렬을 오른쪽에 곱해도 열공간이 바뀌지 않는다"는 수법을 그대로 써서
임을 보이시오.
(2) 이 식에서 \(h\) 가 가질 수 있는 가장 작은 값과 그 값이 나오는 점을 말하시오. 보기 2 의 두 점에서 둘째 항은 각각 얼마인가. 또 적합값의 표준오차(\(s = 0.5349\))가 가장 작아질 수 있는 값을 구해 보기 2 의 \(0.0910\) 과 견주시오.
풀이
(1) 중심화로 블록을 떼어 낸다. \(\mathbf{X}^c = \mathbf{X} - \mathbf{1}\bar{\mathbf{x}}^\top\) 라 하면
이다(오른쪽을 곱해 보면 둘째 블록이 \(\mathbf{1}\bar{\mathbf{x}}^\top + \mathbf{X}^c = \mathbf{X}\) 다). 중심화한 열은 \(\mathbf{1}^\top\mathbf{X}^c = \mathbf{0}^\top\) 으로 \(\mathbf{1}\) 과 직교하므로
처럼 블록대각이 된다. 따라서 \(\mathbf{X}_{\text{design}}^\top\mathbf{X}_{\text{design}} = \mathbf{A}^\top \operatorname{diag}(n, \mathbf{S})\,\mathbf{A}\) 이고
이다. \(\mathbf{A}^{-1} = \begin{pmatrix} 1 & -\bar{\mathbf{x}}^\top \\ \mathbf{0} & \mathbf{I}\end{pmatrix}\) 이므로 \(\tilde{\mathbf{x}} = (1, \mathbf{x})^\top\) 에 대해
이고, 이것을 가운데 블록대각 행렬에 끼워 넣으면
가 나온다. \(\square\)
(2) 바닥은 \(1/n\) 이다. \(\mathbf{S}\) 가 양정부호이므로 둘째 항은 \(0\) 이상이고, \(\mathbf{x} = \bar{\mathbf{x}}\) 일 때만 \(0\) 이다. 그러므로
이다. 보기 2 의 두 점에서 둘째 항은 각각 \(0.02896 - 0.01 = 0.01896\) 과 \(0.05179 - 0.01 = 0.04179\) 다. \(\mathbf{S} = (n-1)\widehat{\boldsymbol\Sigma}\) 이므로 둘째 항은 마할라노비스 거리의 제곱을 \(n-1\) 로 나눈 것이고, 거리로 되돌리면 \(\sqrt{99 \times 0.01896} = 1.370\) 과 \(\sqrt{99 \times 0.04179} = 2.034\) 다. 중심에서 각각 \(1.37\) 과 \(2.03\) 만큼 떨어져 있다는 뜻이다.
표준오차의 바닥은
이고, 보기 2 의 첫째 점은 \(0.0910 = 1.70 \times 0.05349\) 다. 그 배수가 \(\sqrt{h/h_{\min}} = \sqrt{0.02896/0.01} = 1.702\) 로 설명된다.
읽을 거리는 평균 레버리지의 뜻이다. 훈련점의 레버리지 합은 사영행렬의 대각합이라 \(p = 3\) 이고 평균이 \(0.03\) 이다. 그러나 평균 레버리지의 점은 "가장 좋은" 점이 아니다. 바닥이 \(0.01\) 이므로 평균짜리 점조차 중심의 점보다 표준오차가 \(\sqrt{3} = 1.73\) 배 크다. 보기 2 가 "첫째 점은 평균과 거의 같으니 전형적인 점" 이라고 한 것은 맞지만, 전형적이라는 것이 정확하다는 뜻은 아니다.
연습문제 6. 보기 4 (2) 는 잔차가 정규일 때 \(\mathrm{MAE}/\mathrm{RMSE} \to \sqrt{2/\pi} = 0.79788\) 임을 보이고, 이 비가 잔차분포의 모양을 재는 척도라고 했다.
(1) 이 비가 절대값 \(\lvert\varepsilon\rvert\) 의 변동계수(coefficient of variation) \(\mathrm{CV} = \sqrt{\operatorname{Var}\lvert\varepsilon\rvert}\,/\,E\lvert\varepsilon\rvert\) 하나로 정해짐을 보이시오. 곧 극한값이 \(1/\sqrt{1 + \mathrm{CV}^2}\) 임을 보이시오.
(2) 그 식으로 라플라스분포(\(f(x) = \frac{1}{2b}e^{-\lvert x\rvert/b}\))와 균등분포 \(U(-a, a)\) 에서 비의 극한값을 구하고, 정규분포의 \(0.79788\) 과 함께 크기순으로 늘어놓으시오. 보기 4 가 적어 둔 세 줄 해석과 어긋나지 않는가. 이 비가 정확히 \(1\) 이 되는 분포는 무엇이고, \(0\) 에 얼마든지 가깝게 만들 수 있는가.
풀이
(1) 제곱하면 변동계수만 남는다. 큰 수의 법칙으로 \(\mathrm{MAE} \to E\lvert\varepsilon\rvert\), \(\mathrm{RMSE} \to \sqrt{E[\varepsilon^2]}\) 이다. \(E[\varepsilon^2] = E[\lvert\varepsilon\rvert^2] = (E\lvert\varepsilon\rvert)^2 + \operatorname{Var}\lvert\varepsilon\rvert\) 이므로
이고 따라서 \(\mathrm{MAE}/\mathrm{RMSE} \to (1 + \mathrm{CV}^2)^{-1/2}\) 다. 잔차의 부호와 크기 척도는 모두 약분되고, 남는 것은 "잔차의 크기가 서로 얼마나 다른가" 뿐이다.
(2) 세 분포를 넣어 본다.
라플라스라면 \(\lvert\varepsilon\rvert \sim \mathrm{Exp}(b)\) 이고 지수분포(exponential distribution)는 평균과 표준편차가 모두 \(b\) 이므로 \(\mathrm{CV} = 1\) 이다.
직접 세어도 같다. \(E\lvert\varepsilon\rvert = b\), \(E[\varepsilon^2] = 2b^2\) 이므로 \(b/(b\sqrt{2})\) 다.
균등분포라면 \(\lvert\varepsilon\rvert \sim U(0, a)\) 이고 평균 \(a/2\), 분산 \(a^2/12\) 이므로 \(\mathrm{CV}^2 = (a^2/12)/(a^2/4) = 1/3\) 이다.
역시 직접 세면 \(E\lvert\varepsilon\rvert = a/2\), \(\sqrt{E[\varepsilon^2]} = a/\sqrt3\) 로 같은 값이다. 정규분포도 확인된다. 반정규의 \(\mathrm{CV}^2 = (1 - 2/\pi)/(2/\pi) = \pi/2 - 1\) 이므로 \((1 + \pi/2 - 1)^{-1/2} = \sqrt{2/\pi}\) 다.
크기순으로는
이고 첨도(kurtosis)가 \(6 > 3 > 1.8\) 로 정확히 거꾸로다. 꼬리가 두꺼울수록 비가 작다는 보기 4 의 세 줄과 어긋나지 않는다.
비가 \(1\) 이 되는 것은 \(\mathrm{CV} = 0\), 곧 \(\lvert\varepsilon\rvert\) 가 상수일 때뿐이다. 잔차가 \(\pm c\) 두 값만 갖는 분포가 그것이며, 보기 4 (1) 의 코시–슈바르츠 등호 조건("모든 \(a_i\) 가 같다")과 같은 조건이다.
아래로는 \(0\) 에 얼마든지 가까워진다. 확률 \(1-p\) 로 \(0\), 확률 \(p\) 로 \(\pm c\) 인 잔차를 두면 \(E\lvert\varepsilon\rvert = pc\), \(E[\varepsilon^2] = pc^2\) 이므로
이다. 그러므로 이 척도의 범위는 \((0, 1]\) 이다. "거의 모든 잔차가 0 이고 몇 개만 크다" 가 비를 0 으로 미는 극단이며, 그것이 꼬리가 두꺼운 쪽의 끝이다. 보기 4 가 "비가 \(0.6\) 쯤이면 이상치를 찾아보라" 고 한 까닭이 여기서 수로 보인다.
연습문제 7. 보기 3 은 네 수를 \(0.9783\)(모집단) \(\to 0.9687\)(이 표본의 천장) \(\to 0.9691\)(참 \(\beta\)) \(\to 0.9706\)(최소제곱)로 늘어놓았다. 이 사슬의 첫 걸음과 마지막 걸음은 성질이 다르다.
(1) 같은 자료에서 \(R^2_{\text{OLS}} \ge R^2_{\text{참}\,\beta}\) 가 어떤 표본에서도 성립함을 보이시오. 또 그 차이의 기댓값이 근사적으로 \(p\sigma^2/(n\operatorname{Var}(y))\) 임을 보이고 보기 3 의 설정에서 수를 구하시오.
(2) 반면 "이 표본의 천장이 모집단 \(R^2\) 보다 낮다"는 것은 표본마다 달라지는 말이다. 표본 \(2000\) 개를 새로 만들어 두 주장이 성립하는 비율과, (1) 의 차이의 평균·최소·최대를 재어 (1) 을 확인하시오.
풀이
(1) 분모가 같으므로 부등식이 된다. 두 \(R^2\) 는 같은 \(\mathbf{y}\) 로 계산하니 분모 \(\mathrm{TSS}\) 가 같고, 분자만 다르다. 최소제곱은 절편과 기울기를 모두 움직여 \(\mathrm{RSS}\) 를 최소화하며 참값 \((2.0,\ 3.0,\ 1.5)\) 도 그 후보 가운데 하나다. 그러므로
이고, 등호는 최소제곱 해가 참값과 정확히 같을 때뿐이므로 확률 \(0\) 이다. 표본을 보고 나서 정하는 부등식이 아니라 언제나 성립하는 부등식이다.
차이의 크기는 두 기댓값에서 나온다.
이므로 분자의 차이가 \(p\sigma^2\) 이고, \(\mathrm{TSS} \approx n\operatorname{Var}(y)\) 로 나누면
다. 보기 3 에서 실제로 본 차이는 \(0.970625 - 0.969088 = 0.001537\) 로 이 평균의 \(2.4\) 배다. 차이가 \(\sigma^2\chi^2_p/\mathrm{TSS}\) 꼴이어서 (\(\chi^2_p\) 의 평균이 \(p\), 분산이 \(2p\) 이므로) 표준편차가 평균의 \(\sqrt{2p}/p = \sqrt{2/p} = 0.82\) 배나 되므로 그만큼 흔들린다.
(2) 수치적으로.
import numpy as np
from sklearn.linear_model import LinearRegression

rng = np.random.default_rng(0)
beta_true = np.array([3.0, 1.5])
n, reps = 100, 2000
gap, ols_wins, ceil_low = [], 0, 0

for _ in range(reps):
    Xr = rng.normal(size=(n, 2))
    eps = rng.normal(scale=0.5, size=n)
    yr = Xr @ beta_true + 2.0 + eps
    tss = ((yr - yr.mean()) ** 2).sum()

    r2_ols = LinearRegression().fit(Xr, yr).score(Xr, yr)
    r2_oracle = 1 - ((yr - (Xr @ beta_true + 2.0)) ** 2).sum() / tss
    gap.append(r2_ols - r2_oracle)
    ols_wins += r2_ols >= r2_oracle

    v_sig = (Xr @ beta_true).var(ddof=1)        # 이 표본에서 실현된 신호의 분산
    ceil_low += v_sig / (v_sig + eps.var(ddof=1)) < 11.25 / 11.5

gap = np.array(gap)
print(f"R^2(OLS) >= R^2(참 beta) 인 비율 = {ols_wins / reps:.4f}")
print(f"차이의 평균 = {gap.mean():.6f}   (유도 p sigma^2/(n Var y) = {3 * 0.25 / (n * 11.5):.6f})")
print(f"차이의 최소 = {gap.min():.6f},  최대 = {gap.max():.6f}")
print(f"이 표본의 천장이 0.978261 보다 낮은 비율 = {ceil_low / reps:.4f}")
출력:
R^2(OLS) >= R^2(참 beta) 인 비율 = 1.0000
차이의 평균 = 0.000658   (유도 p sigma^2/(n Var y) = 0.000652)
차이의 최소 = 0.000001,  최대 = 0.004182
이 표본의 천장이 0.978261 보다 낮은 비율 = 0.4845
부등식은 \(2000\) 번 가운데 \(2000\) 번 성립했다. 비율이 \(1.0000\) 이고 차이의 최소값이 \(0.000001\) 로 한 번도 \(0\) 아래로 내려가지 않았다. 평균 \(0.000658\) 은 유도한 \(0.000652\) 와 \(1\%\) 차이다. 최대값이 \(0.004182\) 로 평균의 \(6\) 배까지 벌어지는 것은 \(\chi^2_3\) 의 긴 꼬리 때문이다.
반면 첫 걸음은 동전 던지기다. "이 표본의 천장이 모집단 \(0.978261\) 보다 낮다"가 성립한 비율이 \(0.4845\) 로 반이다. 보기 3 의 표본에서 천장이 \(0.968689\) 로 낮게 나온 것은 그 표본의 운이고, 다른 표본에서는 거꾸로 \(0.978261\) 보다 높은 천장이 나온다.
정리하면 보기 3 의 사슬에서 마지막 걸음은 법칙이고 첫 걸음은 운이다. 그래서 훈련 \(R^2\) 는 모집단 \(R^2\) 보다 클 수도 작을 수도 있지만, 참 \(\beta\) 로 계산한 \(R^2\) 보다는 반드시 크다.
연습문제 8.
보기 7 (2) 는 StandardScaler 가 OLS 의 예측을 바꾸지 못함을 \(\mathbf{A}\) 가 가역이라는 것으로 보였다. 그 \(\mathbf{A}\) 의 첫 행이 설계행렬의 \(\mathbf{1}\) 열에 곱해진다는 것에 주의하라.
(1) LinearRegression(fit_intercept=False) 로 바꾸면 이 결론이 깨진다. 중심화(\(-\bar x_j\))와 척도화(\(/s_j\)) 가운데 어느 쪽이 깨뜨리는지 가리고, StandardScaler(with_mean=False) 는 fit_intercept=False 에서도 예측을 바꾸지 못함을 보이시오.
(2) \(n = 2\), \(p = 1\) 의 가장 작은 반례를 만들어 (1) 을 확인하시오. 그리고 fit_intercept=False 에서도 중심화가 예측을 바꾸지 못하는 조건을 적고, 그 조건이 보기 7 의 증명에서 어디에 숨어 있었는지 말하시오.
풀이
(1) 깨뜨리는 것은 중심화다. 두 연산을 따로 보아야 한다.
척도화만 하면 설계행렬이 \(\mathbf{X}\mathbf{D}^{-1}\) 이고 \(\mathbf{D}^{-1}\) 은 \(p \times p\) 가역행렬이다. 가역행렬을 오른쪽에 곱하는 것은 열공간을 바꾸지 않으므로
이고 사영이 같아 적합값과 예측이 모두 그대로다. 계수만 \(\hat{\boldsymbol\beta}_{\text{new}} = \mathbf{D}\hat{\boldsymbol\beta}\) 로 바뀐다. 그러므로 with_mean=False 는 절편이 없어도 안전하다.
중심화를 하면 설계행렬이 \(\mathbf{X}^c = \mathbf{X} - \mathbf{1}\bar{\mathbf{x}}^\top\) 이 된다. 이 열들은 \(\mathcal{C}([\,\mathbf{1}\;\;\mathbf{X}\,])\) 안에 있지만 \(\mathcal{C}(\mathbf{X})\) 안에 있을 이유가 없다. 보기 7 의 \(\mathbf{A}\) 에서 중심화가 만들어 낸 항이 첫 행의 \(-\bar{\mathbf{x}}^\top\mathbf{D}^{-1}\) 이었고, 그것이 곱해지는 상대가 바로 \(\mathbf{1}\) 열이다. \(\mathbf{1}\) 열이 중심화를 흡수해 주었기 때문에 열공간이 보존된 것이고, 그 열이 없으면 흡수할 데가 없다.
(2) 가장 작은 반례. \(n = 2\), \(p = 1\), \(\mathbf{x} = (1, 3)^\top\), \(\mathbf{y} = (0, 1)^\top\) 을 절편 없이 적합한다.
원래 자료로는
이다. 중심화하면 \(\bar x = 2\), \(\mathbf{x}^c = (-1, 1)^\top\) 이므로
다. 예측이 \((0.3, 0.9)\) 에서 \((-0.5, 0.5)\) 로 완전히 달라지고 \(\mathrm{RSS}\) 가 다섯 배가 되었다. 중심화한 쪽은 열이 \((-1, 1)\) 뿐이라 \(\mathbf{y}\) 의 평균 \(0.5\) 를 맞출 길이 아예 없다. 척도화를 더해도 (\(\mathbf{x}^c/s\)) 적합값은 그대로이니, 범인이 중심화임이 분명하다.
조건은 "\(\mathbf{1}\bar{\mathbf{x}}^\top\) 의 열이 \(\mathcal{C}(\mathbf{X})\) 안에 있다" 다. 곧 다음 둘 가운데 하나다.
- \(\bar{\mathbf{x}} = \mathbf{0}\): 각 열의 평균이 \(0\) 이면 중심화가 아무 일도 하지 않는다.
- \(\mathbf{1} \in \mathcal{C}(\mathbf{X})\): 설계행렬이 이미 절편을 품고 있으면 \(\mathbf{1}\bar{\mathbf{x}}^\top\) 을 빼도 열공간을 벗어나지 않는다.
fit_intercept=True 는 \(\mathbf{1}\) 열을 직접 붙여 두 번째 조건을 보장한다. 보기 7 의 증명이 조건을 따로 적지 않은 까닭이 이것이며, 조건은 그 \(\mathbf{1}\) 열 안에 숨어 있었다.
단서 하나를 붙여 둔다. \(\mathbf{1} \in \mathcal{C}(\mathbf{X})\) 라도 중심화가 랭크를 떨어뜨리면 예측이 달라진다. \(\mathbf{X}\) 의 한 열이 \(\mathbf{1}\) 그 자체이면 중심화가 그 열을 \(\mathbf{0}\) 으로 만들어 차원이 하나 줄기 때문이다. 보기 1 의 끝에서 "X 에 \(1\) 로 채운 열을 붙이면 안 된다" 고 한 자리와 같은 함정이다.
연습문제 9.
보기 6 (1) 은 cv=5 가 shuffle=False 로 자료를 통째로 다섯 토막 낸다는 것을 보이고 "자료가 시간순이거나 집단별로 정렬되어 있으면 함정이 된다"고 했다. 그 함정의 크기를 재어 보자. 보기 1 의 자료 \(100\) 개를 \(y\) 가 커지는 순서로 줄 세운 뒤 똑같이 cross_val_score(..., cv=5) 를 부른다.
(1) 다섯 점수를 수로 보이고, 음수가 되는 겹이 생기는 까닭을 \(R^2 = 1 - \mathrm{RSS}/\mathrm{TSS}\) 의 분자와 분모로 나누어 설명하시오. 모형의 예측이 나빠진 것인가.
(2) KFold(n_splits=5, shuffle=True, random_state=0) 를 cv 에 넘기면 되돌아오는지 확인하고, 이 함정이 보기 6 의 자료에서는 드러나지 않았던 까닭을 말하시오.
풀이
먼저 무슨 일이 일어날지 생각해 두자. 줄 세운 뒤의 겹 하나는 "\(y\) 가 서로 비슷한 \(20\) 개" 다. 모형은 나머지 \(80\) 개로 적합되므로 예측 자체는 멀쩡하겠지만, \(R^2\) 의 분모는 그 겹 안에서의 \(y\) 의 산포로 계산된다. 그 산포가 거의 없으니 분모가 작아져 비가 폭발할 것이다.
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import KFold, cross_val_score

# 보기 1 의 자료를 그대로 다시 만든다.
np.random.seed(42)
n = 100
Xo = np.random.randn(n, 2)
yo = Xo @ np.array([3.0, 1.5]) + 2.0 + np.random.randn(n) * 0.5

order = np.argsort(yo)                      # y 가 커지는 순서로 줄 세운다
Xs, ys = Xo[order], yo[order]

print("원래 순서   :", cross_val_score(LinearRegression(), Xo, yo, cv=5, scoring='r2').round(4))
print("y 로 정렬   :", cross_val_score(LinearRegression(), Xs, ys, cv=5, scoring='r2').round(4))
kf_shuffle = KFold(n_splits=5, shuffle=True, random_state=0)
print("정렬 + 섞기 :", cross_val_score(LinearRegression(), Xs, ys, cv=kf_shuffle, scoring='r2').round(4))

print(f"전체 분산 = {((yo - yo.mean()) ** 2).mean():.4f}")
for i, (tr, te) in enumerate(KFold(n_splits=5).split(Xs)):
    m = LinearRegression().fit(Xs[tr], ys[tr])
    rss = ((ys[te] - m.predict(Xs[te])) ** 2).mean()
    tss = ((ys[te] - ys[te].mean()) ** 2).mean()
    print(f"  겹 {i}: y 범위 {ys[te].min():6.2f} ~ {ys[te].max():5.2f}   겹 안 분산 {tss:7.4f}"
          f"   평균제곱오차 {rss:.4f}   R^2 = {1 - rss / tss:8.4f}")
출력:
원래 순서   : [0.9602 0.9678 0.9761 0.9656 0.9717]
y 로 정렬   : [ 0.759  -0.3969 -0.0976  0.1281  0.6808]
정렬 + 섞기 : [0.9828 0.9718 0.9374 0.9671 0.9566]
전체 분산 = 9.4472
  겹 0: y 범위  -4.53 ~ -0.78   겹 안 분산  1.3962   평균제곱오차 0.3365   R^2 =   0.7590
  겹 1: y 범위  -0.74 ~  0.63   겹 안 분산  0.1613   평균제곱오차 0.2254   R^2 =  -0.3969
  겹 2: y 범위   0.72 ~  2.49   겹 안 분산  0.2215   평균제곱오차 0.2431   R^2 =  -0.0976
  겹 3: y 범위   2.52 ~  4.53   겹 안 분산  0.3446   평균제곱오차 0.3004   R^2 =   0.1281
  겹 4: y 범위   4.58 ~  8.44   겹 안 분산  1.2130   평균제곱오차 0.3872   R^2 =   0.6808
(1) 짧아진 것은 자(尺)이고 모형은 그대로다. 점수가 \(0.96\) 대에서 \(0.759,\ -0.397,\ -0.098,\ 0.128,\ 0.681\) 로 주저앉고 가운데 두 겹이 음수다. 분자와 분모를 따로 보라.
분자(평균제곱오차(mean squared error))는 거의 그대로다. 겹 \(1\) 의 \(0.2254\) 는 보기 4 에서 본 전체 MSE \(0.2775\) 보다 오히려 작다. 예측은 전혀 나빠지지 않았다.
분모가 무너졌다. 전체 분산이 \(9.4472\) 인데 겹 \(1\) 의 겹 안 분산은 \(0.1613\) 으로 \(59\) 배 작다. \(y\) 로 줄 세운 \(20\) 개는 \(-0.74\) 에서 \(0.63\) 사이에 몰려 있으니 당연하다. 그래서 \(1 - 0.2254/0.1613 = -0.397\) 이 된다.
\(R^2\) 가 재는 것은 "모형이 그 겹의 \(y\) 평균보다 얼마나 나은가" 다. \(y\) 로 줄 세운 겹 안에서는 그 평균이 이미 아주 좋은 예측이어서 모형이 이기기 어렵다. \(R^2\) 가 음수라는 말은 "평균보다 못하다"일 뿐이며, 여기서는 상대가 반칙으로 강해진 것이다.
양 끝 겹은 사정이 둘이다. 겹 안 분산이 \(1.40\), \(1.21\) 로 가운데보다 넓고(분포의 꼬리라 퍼져 있다), 평균제곱오차도 \(0.3365\), \(0.3872\) 로 조금 나쁘다. 훈련자료에 그 겹의 \(y\) 범위가 없어 외삽이기 때문이다. 그래도 분모가 살아 있어 \(0.759\), \(0.681\) 로 버틴다.
(2) 섞으면 돌아온다. shuffle=True 로 바꾼 점수가 \([0.9828,\ 0.9718,\ 0.9374,\ 0.9671,\ 0.9566]\) 으로 원래 순서의 \(0.96\) 대와 같다. 각 겹이 \(y\) 의 전 범위를 담으므로 분모가 제자리를 찾는다.
보기 6 에서 드러나지 않은 까닭은 그 자료를 np.random.randn 으로 만들어 행의 순서에 뜻이 없었기 때문이다. 섞지 않은 겹이 우연히 섞은 겹과 같은 구실을 했다. 그러나 실제 자료는 날짜순·지역순·환자번호순으로 정렬되어 들어오는 일이 흔하고, 그러면 cv=5 한 줄이 조용히 위의 실험을 한다. 교차검증 점수가 설명 없이 낮게(또는 높게) 나오면 겹의 짜임을 먼저 의심하라.
연습문제 10. 보기 5 (1) 은 두 기댓값 식
을 썼다.
(1) 둘을 관측값당 평균제곱오차로 고쳐 쓰고, 보기 5 의 설정(\(\sigma = 0.5\), \(n_{\text{train}} = 80\), \(p = 3\))에서 두 수와 그 비를 계산하시오. \(\operatorname{Var}(y) = 11.5\) 를 써서 그것을 \(R^2\) 척도로 옮기면 훈련과 시험의 차이는 얼마인가.
(2) 같은 설정의 자료를 \(5000\) 번 새로 만들어 \(80/20\) 으로 나누고 두 평균제곱오차의 평균을 재어 (1) 과 맞추시오. 그 값을 보기 5 에서 관측한 차이 \(0.0011\) 과 분할 잡음 \(0.0151\) 과 함께 놓으면, 한 번의 분할로 과적합을 재려 할 때 무슨 일이 생기는가.
풀이
(1) 관측값당으로 고친다. 양변을 관측값 수로 나누면 \(p\) 가 \(n_{\text{train}}\) 에 대한 비율로만 남는다.
이고 비는
다. \(R^2 = 1 - \mathrm{MSE}/\operatorname{Var}(y)\) 이므로 \(R^2\) 척도로 옮기면
이다. \(n_{\text{train}} = 80\), \(p = 3\) 짜리 모형이 지닌 과적합의 참 크기가 \(R^2\) 로 \(0.0016\) 이라는 뜻이다.
(2) 수치적으로.
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error

rng = np.random.default_rng(1)
beta_true = np.array([3.0, 1.5])
reps = 5000
mse_tr, mse_te = [], []

for _ in range(reps):
    Xr = rng.normal(size=(100, 2))
    yr = Xr @ beta_true + 2.0 + rng.normal(scale=0.5, size=100)
    a, b, c, d = train_test_split(Xr, yr, test_size=0.2, random_state=0)
    m = LinearRegression().fit(a, c)
    mse_tr.append(mean_squared_error(c, m.predict(a)))
    mse_te.append(mean_squared_error(d, m.predict(b)))

mse_tr, mse_te = np.array(mse_tr), np.array(mse_te)
se_tr = mse_tr.std(ddof=1) / np.sqrt(reps)
se_te = mse_te.std(ddof=1) / np.sqrt(reps)
print(f"훈련 MSE 평균 = {mse_tr.mean():.6f} +- {se_tr:.6f}   (유도 {0.25 * (1 - 3 / 80):.6f})")
print(f"시험 MSE 평균 = {mse_te.mean():.6f} +- {se_te:.6f}   (유도 {0.25 * (1 + 3 / 80):.6f})")
print(f"두 평균의 비 = {mse_te.mean() / mse_tr.mean():.4f}   (유도 1.0375/0.9625 = {1.0375 / 0.9625:.4f})")
print(f"R^2 척도로 옮긴 차이 = {(mse_te.mean() - mse_tr.mean()) / 11.5:.6f}   (유도 {0.01875 / 11.5:.6f})")
출력:
훈련 MSE 평균 = 0.240032 +- 0.000554   (유도 0.240625)
시험 MSE 평균 = 0.259584 +- 0.001158   (유도 0.259375)
두 평균의 비 = 1.0815   (유도 1.0375/0.9625 = 1.0779)
R^2 척도로 옮긴 차이 = 0.001700   (유도 0.001630)
네 수가 모두 모의오차 안에서 맞는다. 훈련 \(0.240032 \pm 0.000554\) 가 유도한 \(0.240625\) 와 \(1.1\) 표준오차, 시험 \(0.259584 \pm 0.001158\) 이 \(0.259375\) 와 \(0.2\) 표준오차 차이다. 참고로 시험 쪽의 더 정확한 식은 \(\sigma^2\bigl(1 + p/(n_{\text{train}} - p - 1)\bigr) = 0.25(1 + 3/76) = 0.259868\) 인데, 표본 \(5000\) 개로도 \(0.259375\) 와 구별되지 않는다. 그 둘의 차이 \(0.0005\) 가 표준오차 \(0.0012\) 보다 작기 때문이다.
그리고 여기서 보기 5 의 수수께끼가 완전히 풀린다. 과적합의 참 간격은 \(R^2\) 로 \(0.0016\) 이다. 그런데 보기 5 에서 잰 분할 잡음은 \(0.0151\) 이었다. 신호가 잡음의 \(1/9\) 다.
표준편차의 \(0.11\) 배짜리 차이는 한 번 재서 보이지 않는다. 실제로 random_state=42 의 한 분할은 간격을 \(0.9664 - 0.9855 = -0.0191\), 곧 부호까지 거꾸로 내놓았다. \(200\) 번 다시 나눈 뒤에야 \(0.9664\) 대 \(0.9653\) 으로 \(+0.0011\) 이라는 바른 부호가 나왔고, 그 평균의 표준오차 \(0.0151/\sqrt{200} = 0.0011\) 을 생각하면 유도값 \(0.0016\) 과도 구별되지 않는다.
그러므로 한 번 분할의 훈련–시험 차이는 과적합의 척도가 아니다. 「왜 한 번 나누는 것으로는 부족한가」의 그림이 오차의 표준편차 \(0.085\) 대 \(0.044\) 로 같은 말을 했고, 여기서는 재려는 양 자체가 \(0.0016\) 밖에 안 된다는 쪽에서 본 셈이다. 과적합이 걱정되면 분할을 반복해 평균을 보거나, 애초에 \(p/n_{\text{train}}\) 을 보라. 식이 알려 주는 간격이 \(2p\sigma^2/n_{\text{train}}\) 이니 모수의 개수와 훈련자료의 크기만 알면 그 크기를 미리 가늠할 수 있다.
정리하며
scikit-learn 은 예측을 위한 도구다.
- API 가 일관적이다.
fit·predict·score세 메서드로 모든 모형을 같은 방식으로 다루며, 파이프라인·교차검증·격자탐색과 매끄럽게 이어진다. - 절편이 기본으로 들어간다.
statsmodels와 반대이며, 둘을 오가며 쓰면 헷갈리기 쉽다. - \(p\) 값과 신뢰구간을 주지 않는다. 설계상의 선택이며, 추론이 필요하면
statsmodels로 가야 한다. - 전처리를 파이프라인에 넣는다. 표준화나 특성 생성을
Pipeline안에 두어야 교차검증에서 자료 누출이 생기지 않는다. - 둘을 함께 쓰는 것이 실무다. 계수의 검정·진단과 보고는
statsmodels, 교차검증과 예측 파이프라인은sklearn.
이것으로 13장의 본론이 끝난다. 단순회귀(simple linear regression)에서 시작해 다중회귀(multiple regression)와 그 추론, 네 가지 가정 점검과 회귀 진단, 성능 척도와 모형선택, 스플라인·GAM 까지 보았다.
다음 절 무엇을 언제 쓸 것인가로 넘어간다. statsmodels 와 sklearn 을 추론과 예측이라는 두 목적에 비추어 가른다.