등분산에 대한 F-검정
이 주제를 다루는 다른 곳
여기서는 분산분석의 등분산성 가정을 확인하는 용도로 짧게 다룬다. 자유도, 정규성 민감도, 검정력까지 갖춘 논의는 15.3 두 분산 비교를 위한 F 검정에 있다.
개요
등분산 F-검정은 표본분산의 비를 만들어 정규분포를 따르는 두 모집단의 분산을 비교한다. 등분산성에 대한 고전적인 이표본 검정이며 분산분석 F-검정을 비롯한 여러 절차의 바탕이 된다. 그러나 정규성 위반에 극도로 민감하여 실무에서는 대체로 Levene 검정이 선호된다. 이 페이지에서는 검정을 유도하고 처음부터 구현하며 여러 분산비 시나리오에서 그 행동을 살펴본다.
가설과 검정통계량
분산이 \(\sigma_1^2\), \(\sigma_2^2\)인 정규 모집단에서 크기 \(n_1\), \(n_2\)의 독립 표본 둘이 주어졌을 때 가설은
이다. 검정통계량은 표본분산의 비이다:
\(H_0\) 아래에서 이 비는 F-분포를 따른다:
유의수준 \(\alpha\)의 양측검정에서는
일 때 \(H_0\)을 기각한다. 양측 p-값은
이다.
카이제곱 분포와의 연결
F-분포는 각각 자유도로 나눈 독립인 두 카이제곱 확률변수의 비로 나타난다. 정규 자료에서 \((n_i - 1)S_i^2 / \sigma_i^2 \sim \chi^2(n_i - 1)\)이므로 \(H_0: \sigma_1^2 = \sigma_2^2\) 아래에서
이며, 이것이 \(F(n_1 - 1, n_2 - 1)\) 분포의 정의 형태이다.
다음 함수는 양측 F-검정을 구현한다. 어느 표본을 분자에 두느냐는 분석자의 임의 선택이므로, 그 선택이 결론을 바꾸지 않아야 한다는 점을 먼저 확인해 둘 필요가 있다.
보기 1. 등분산 F 검정 구현. 두 표본의 순서를 바꾸면 통계량은 \(F \mapsto 1/F\)로, 자유도는 \((d_1, d_2) \mapsto (d_2, d_1)\)로 바뀐다.
(1) 그래도 양측 p-값 \(p = 2\min(G_{d_1,d_2}(F),\, 1 - G_{d_1,d_2}(F))\)는 바뀌지 않음을 보이시오. 임계값에 대해서는 \(F_{1-\alpha/2}(d_1, d_2) = 1/F_{\alpha/2}(d_2, d_1)\)이 성립함도 보이시오.
(2) 크기가 서로 다른 두 표본(\(n = 20\)과 \(n = 35\))에 함수를 두 순서로 적용해 (1)을 확인하시오.
풀이
(1) 해석적으로. 바탕이 되는 사실 하나로 모두 따라온다. \(G \sim F(d_2, d_1)\)이면
이다. \(F\)-분포가 두 카이제곱의 비 \(\dfrac{\chi^2_{d_2}/d_2}{\chi^2_{d_1}/d_1}\)로 정의되므로 역수를 취하면 분자와 분모가 맞바뀌는 것뿐이다.
이제 관측된 비를 \(f = s_1^2/s_2^2\)라 하고 순서를 바꾼 쪽의 분포함수를 계산한다. \(G \sim F(d_2, d_1)\)에 대해
이고 같은 계산으로 \(P(G \ge 1/f) = G_{d_1,d_2}(f)\)다. 곧 두 꼬리 확률이 서로 자리를 맞바꿀 뿐이다. \(\min\)은 두 인수의 순서에 영향받지 않으므로
이다. 양측 p-값은 표본의 순서에 의존하지 않는다.
임계값 관계도 같은 사실에서 나온다. \(G \sim F(d_2, d_1)\)일 때
이므로 괄호 안의 값이 바로 \(F_{d_1,d_2}\)의 상위 \(\alpha/2\) 분위수다. 곧
특히 \(d_1 = d_2 = d\)이면 \(F\)와 \(1/F\)가 같은 분포를 가지므로 \(P(F \le 1) = P(F \ge 1) = 1/2\), 곧 \(F(d,d)\)의 중앙값은 정확히 \(1\)이다. 아래 보기 2에서 \(\sigma_Y = 1\)일 때 p-값이 정확히 \(1.000\)으로 찍히는 까닭이 이것이다.
(2) 수치적으로. 자유도가 실제로 뒤바뀌도록 두 표본의 크기를 다르게 둔다.
import numpy as np
import scipy.stats as stats

def f_test(data_0, data_1):
    """두 분산이 같은지 F 검정한다.

    두 표본분산의 비가 F 분포를 따른다는 사실을 쓴다. 카이제곱과 마찬가지로
    좌우가 대칭이 아니므로 작은 쪽 꼬리를 두 배 해 양측 p-값을 만든다.
    이 검정은 정규성에 매우 민감하다 — 그래서 실제로는 Levene 을 더 쓴다.
    """
    statistic = data_0.var(ddof=1) / data_1.var(ddof=1)
    df1 = data_0.shape[0] - 1
    df2 = data_1.shape[0] - 1
    p_value = 2 * min(
        stats.f(df1, df2).cdf(statistic),
        stats.f(df1, df2).sf(statistic)
    )
    return statistic, p_value

# 표본 크기를 일부러 다르게 두어 자유도가 뒤바뀌는 것까지 보이게 한다.
rng = np.random.default_rng(7)
a = rng.normal(scale=1.0, size=20)
b = rng.normal(scale=1.7, size=35)

Fab, pab = f_test(a, b)
Fba, pba = f_test(b, a)
print(f"f_test(a, b):  F = {Fab:.6f}   p = {pab:.6f}   (자유도 19, 34)")
print(f"f_test(b, a):  F = {Fba:.6f}   p = {pba:.6f}   (자유도 34, 19)")
print(f"F 는 역수인가 ?      {np.isclose(Fab * Fba, 1.0)}")
print(f"p 는 같은가 ?        {np.isclose(pab, pba)}")

# 임계값의 역수 관계. F_{1-a/2}(d1,d2) = 1 / F_{a/2}(d2,d1).
d1, d2 = 19, 34
hi = stats.f(d1, d2).ppf(0.975)
lo_swapped = stats.f(d2, d1).ppf(0.025)
print(f"\nF_0.975(19,34)        = {hi:.6f}")
print(f"1 / F_0.025(34,19)    = {1 / lo_swapped:.6f}")

# 양측 p-값이 1 을 넘지 않는 까닭은 d1 = d2 일 때 가장 또렷하다.
# F(d,d) 는 역수에 대해 대칭이므로 중앙값이 정확히 1 이다.
print(f"\nP(F(99,99) <= 1)      = {stats.f(99, 99).cdf(1):.6f}")
출력:
f_test(a, b):  F = 0.237062   p = 0.001581   (자유도 19, 34)
f_test(b, a):  F = 4.218313   p = 0.001581   (자유도 34, 19)
F 는 역수인가 ?      True
p 는 같은가 ?        True

F_0.975(19,34)        = 2.153050
1 / F_0.025(34,19)    = 2.153050

P(F(99,99) <= 1)      = 0.500000
세 가지가 모두 맞는다. 통계량은 \(0.237062\)와 \(4.218313\)으로 곱이 \(1\)이고, p-값은 \(0.001581\)로 소수점 여섯째 자리까지 같다. 임계값은 \(F_{0.975}(19,34) = 2.153050\)이 \(1/F_{0.025}(34,19)\)와 자리까지 일치하며, \(F(99,99)\)의 중앙값이 \(1\)임도 \(P(F \le 1) = 0.500000\)으로 확인된다.
실무적으로는 이것이 안심거리다. "큰 분산을 분자에 두라"는 흔한 지침은 양측검정에서는 필요하지 않다. 그 지침이 뜻을 갖는 것은 한쪽 꼬리만 보는 단측검정이나, 상위 분위수표만 실린 책에서 손으로 임계값을 찾을 때다. 다만 구현을 바꿔 p = 2 * sf(statistic)처럼 한쪽 꼬리만 두 배 하면 이 대칭이 깨져 순서에 따라 결론이 달라진다. 위 함수가 min을 쓰는 이유다.
보기는 \(X \sim N(0, 1)\)과 여러 \(\sigma_Y\) 값에 대한 \(Y \sim N(1, \sigma_Y)\)을 생성한다. 씨앗을 고정하므로 두 표본이 같은 난수열에서 나온다는 점을 눈여겨보라.
보기 2. 검정 실행. 집단당 \(n = 100\), 씨앗 seed = 1을 고정하고 \(\sigma_Y\)만 바꾼다.
(1) 씨앗이 고정되어 있을 때 \(F = S_X^2/S_Y^2\)가 자료에 전혀 의존하지 않고 \(1/\sigma_Y^2\)으로 정확히 정해짐을 보이시오. 또 이 설정에서 \(p = 0.05\)가 되는 \(\sigma_Y\)를 구하시오.
(2) 검정을 실행해 (1)의 두 답을 확인하고, \(\sigma_Y = 1.20\)에서 왜 \(\alpha = 0.05\)에 닿지 못하는지 설명하시오.
풀이
(1) 해석적으로. 같은 씨앗에서 norm(loc, scale).rvs 는 같은 표준정규열 \(z_1, \ldots, z_n\)을 꺼내 \(\text{loc} + \text{scale}\cdot z_i\)로 바꾼다. 그러므로 \(x_i = z_i\)이고 \(y_i = 1 + \sigma_Y z_i\)이며, 표본분산은 위치이동에 둔감하고 배율의 제곱만큼 커진다.
\(s_z^2\)이 약분되어 사라진다. 자료가 무엇이든 \(F\)는 \(1/\sigma_Y^2\) 하나로 정해지며, 표집 변동이 전혀 들어오지 않는다. 그래서 이 표는 검정력의 표가 아니라 분산비 하나를 F-분포에 비추어 본 표다.
\(p = 0.05\)가 되는 \(\sigma_Y\)를 구해 보자. \(F\)가 아래쪽으로 밀려가므로 걸리는 임계값은 하위 \(2.5\%\) 분위수다. \(F = F_{0.025}(99,99)\)에서
이다. \(\sigma_Y\)가 \(1.2191\)을 넘어야 기각된다. 격자의 마지막 값 \(1.20\)은 그보다 작으므로 기각되지 않으며, 이것이 \(p = 0.071\)의 정체다.
(2) 수치적으로. 다섯 \(\sigma_Y\)에 대해 돌린다.
# Bartlett 검정과 같은 설정으로 돌려 두 검정의 p-값을 견주어 볼 수 있다.
seed, size = 1, 100
x = stats.norm(loc=0, scale=1).rvs(size, random_state=seed)

for scale in [1.00, 1.05, 1.10, 1.15, 1.20]:
    y = stats.norm(loc=1, scale=scale).rvs(size, random_state=seed)
    stat, pval = f_test(x, y)
    print(f"sigma_y={scale:.2f}: F={stat:.2f}, p={pval:.3f}")
출력:
sigma_y=1.00: F=1.00, p=1.000
sigma_y=1.05: F=0.91, p=0.628
sigma_y=1.10: F=0.83, p=0.345
sigma_y=1.15: F=0.76, p=0.166
sigma_y=1.20: F=0.69, p=0.071
\(F = 1/\sigma_Y^2\)이 다섯 자리에서 모두 맞는다. \(1/1.05^2 = 0.9070\), \(1/1.10^2 = 0.8264\), \(1/1.15^2 = 0.7561\), \(1/1.20^2 = 0.6944\)가 출력의 \(0.91,\ 0.83,\ 0.76,\ 0.69\)와 일치한다. 근사가 아니라 등식이다.
\(\sigma_Y = 1.00\)에서 p-값이 정확히 \(1.000\)인 것도 (1)의 부산물이다. \(F = 1\)이고 보기 1에서 본 대로 \(F(99,99)\)의 중앙값이 \(1\)이므로 \(p = 2 \times 0.5 = 1\)이다. p-값이 꼭 \(1\)로 찍히는 일은 여기서처럼 통계량이 귀무분포의 중앙값에 정확히 앉을 때만 일어난다.
\(\sigma_Y = 1.20\)이 \(\alpha = 0.05\)에 닿지 못하는 까닭은 (1)에서 계산한 \(\sigma_Y^* = 1.2191\)과 비교하면 바로 보인다. \(F = 0.6944\)가 임계값 \(0.67284\)보다 아직 크다. 간발의 차이로 보이지만 그 간격이 곧 \(p = 0.071\)과 \(p = 0.05\)의 차이다. \(F(99,99)\)가 \(F = 1\) 부근에 두툼하게 몰려 있으므로, 분산비 \(1.44\)쯤은 귀무가설과 구별되지 않는다.
주의할 점이 하나 있다. \(\sigma_Y^* = 1.2191\)은 이 설정에서만 성립하는 경계다. 씨앗을 바꾸면 두 표본이 더 이상 같은 난수열이 아니고, \(F\)에 표집 변동이 끼어들어 결론이 표본마다 달라진다. 아래 연습문제의 검정력 식
에 \(d = 99\), \(r = 1/1.44\)를 넣으면 \(\sigma_Y = 1.20\)에서의 실제 검정력은 \(0.438\)이다. 다섯 줄의 표가 보여 준 "기각하지 못함"은 열 번 중 여섯 번 일어나는 일이지, 이 검정이 늘 못 잡는다는 뜻은 아니다.
p-값이 앞의 Bartlett 검정과 소수점 셋째 자리까지 같다. 우연이 아니다. 집단이 둘이고 자료가 정규일 때 Bartlett 검정은 등분산 \(F\)-검정과 동등하다.
표로 정리하면:
| \(\sigma_Y\) | \(F = S_X^2/S_Y^2\) | p-값 |
|---|---|---|
| 1.00 | 1.000 | 1.000 |
| 1.05 | 0.907 | 0.628 |
| 1.10 | 0.826 | 0.345 |
| 1.15 | 0.756 | 0.166 |
| 1.20 | 0.694 | 0.071 |
해석
- \(\sigma_Y = 1.00\)이면 참 분산비가 1이고 F-통계량도 1에 가까워 p-값이 크다. 검정이 \(H_0\)을 올바르게 유지한다.
- \(\sigma_Y\)가 커질수록 \(S_Y^2\)이 \(S_X^2\)에 비해 커져 F-통계량이 1에서 멀어지고 p-값이 작아진다.
- 검정력은 표본크기에 달려 있다. 집단당 \(n = 100\)에서는 완만한 이탈(예: \(\sigma_Y = 1.15\), \(p = 0.166\))을 탐지하지 못하고, \(\sigma_Y = 1.20\)에서도 \(p = 0.071\)로 \(\alpha = 0.05\)에 미치지 못한다. 표본이 커야 안정적으로 탐지할 수 있다.
이 검정의 결정적인 한계는 비정규성에 극도로 민감하다는 점이다. 정규성에서 약간만 벗어나도(예: 완만한 치우침이나 이상점 몇 개) 제1종 오류율이 크게 부풀 수 있다. 실제 자료에는 Levene 검정을 권한다.
두 주장 — 검정력이 낮다는 것과 정규성에 민감하다는 것 — 을 각각 그림으로 확인해 두자.
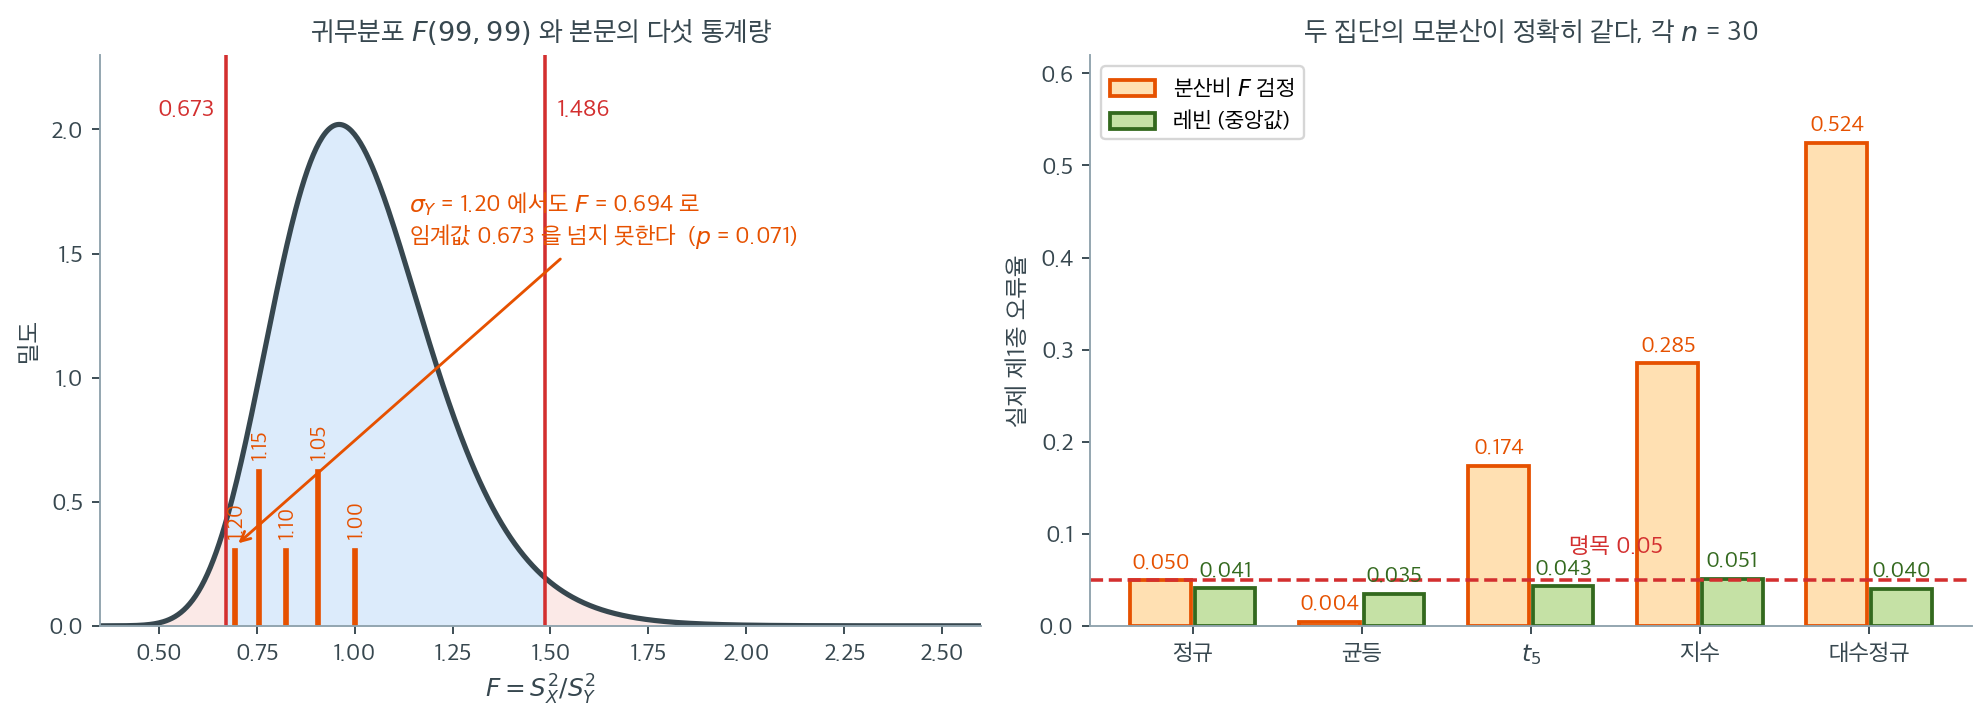
왼쪽은 귀무분포 \(F(99, 99)\) 위에 본문 표의 다섯 통계량을 얹은 것이다. 양측 \(5\%\)의 임계값이 \(0.673\)과 \(1.486\)이다. \(\sigma_Y\)가 커질수록 \(F = S_X^2/S_Y^2\)이 \(1.000 \to 0.907 \to 0.826 \to 0.756 \to 0.694\)로 왼쪽으로 밀려가지만, 마지막 값 \(0.694\)조차 임계값 \(0.673\)에 닿지 못한다. 간발의 차이로 보이지만 그 간격이 곧 \(p = 0.071\)과 \(p = 0.05\)의 차이다. 분포가 \(F = 1\) 부근에 이렇게 두툼하게 몰려 있으니, 분산비 \(1.44\)쯤은 귀무가설과 구별되지 않는다.
오른쪽이 이 검정을 실무에서 쓰지 않는 진짜 이유다. 두 집단의 모분산이 정확히 같은 자료를 각 \(n = 30\)으로 8,000번 만들어 검정했다. 정규분포에서는 \(0.050\)으로 정확하다. 그런데 \(t_5\)에서 \(0.174\), 지수분포에서 \(0.285\), 대수정규에서 \(0.524\)가 된다. 분산이 한 치도 다르지 않은데 절반 넘게 기각한다. 반대로 꼬리가 얇은 균등분포에서는 \(0.004\)로 검정이 멈춰 선다. 같은 자료에 레빈 검정을 적용하면 다섯 분포 모두 \(0.035\)–\(0.051\)이다.
"약간만 벗어나도"라는 표현이 과장이 아니다. \(t_5\)는 정규분포와 눈으로 구별하기 어려운 분포인데도 오류율이 세 배 넘게 부푼다. 원인은 \(\operatorname{Var}(S^2)\)가 첨도에 직접 의존한다는 데 있다. \(F\)-분포의 꼬리는 \(\gamma_2 = 0\)을 전제로 계산된 것이고, 꼬리가 두꺼운 자료에서는 \(S_X^2/S_Y^2\)가 그보다 훨씬 크게 요동친다. 검정은 그 요동을 "분산이 다르다"는 신호로 읽는다.
집단이 둘이고 자료가 정규일 때 이 검정이 Bartlett 검정과 동등하다는 사실을 떠올리면, 바틀렛이 대수정규에서 \(0.673\)까지 갔던 것과 여기 \(0.524\)가 같은 현상의 두 얼굴임을 알 수 있다(집단 수와 표본크기가 달라 값이 정확히 일치하지는 않는다).
연습문제
연습문제 1. 크기가 \(n_1 = 20\), \(n_2 = 25\)인 두 표본에서 표본분산 \(S_1^2 = 15.3\), \(S_2^2 = 8.7\)을 얻었다. F-통계량을 계산하고 자유도를 진술하라.
풀이
F-통계량은
이다. 자유도는 \(df_1 = n_1 - 1 = 19\), \(df_2 = n_2 - 1 = 24\)이다. \(H_0\) 아래에서 \(F \sim F(19, 24)\)이다.
연습문제 2. \(F \sim F(d_1, d_2)\)이면 \(1/F \sim F(d_2, d_1)\)임을 보여라. 이 성질이 양측검정에서 왜 중요한가?
풀이
정의에 의해 \(U \sim \chi^2(d_1)\)과 \(V \sim \chi^2(d_2)\)가 독립이면
이다. 역수를 취하면
이다. 이 성질이 중요한 이유는 큰 쪽 표본분산을 분자에 두어 언제나 \(F \ge 1\)이 되도록 배치할 수 있기 때문이다. 그러면 양측 p-값을 \(2 \cdot P(F_{d_1, d_2} \ge F_{\text{obs}})\)로 계산할 수 있다. 한편 위 구현의 \(\min\) 형태는 이런 규약 없이도 양쪽 꼬리를 직접 처리한다.
연습문제 3. 등분산 F-검정이 평균에 대한 이표본 \(t\)-검정보다 비정규성에 더 민감한 이유를 설명하라.
풀이
\(t\)-검정은 표본평균에 기반하는데, 적률이 존재하기만 하면 바탕 분포와 무관하게 중심극한정리에 의해 표본평균이 정규로 수렴한다. 반면 분산에 대한 F-검정은 표본분산에 기반하고 표본분산은 자료의 4차 적률과 관련된다. \(S^2\)의 표본분포는 바탕 분포의 첨도에 강하게 영향을 받는다. 꼬리가 두꺼운 분포에서는 이따금 나오는 극단값이 \(S^2\)을 크게 부풀려 비 \(S_1^2/S_2^2\)이 F-분포에서 크게 벗어난다. \(t\)-통계량이 \(t\)-분포에서 벗어나는 정도보다 훨씬 심하다. 그래서 분산에 대한 F-검정은 고전적 검정 중 가장 로버스트하지 않은 축에 든다.
연습문제 4. \(n_1 = n_2 = 50\), \(\alpha = 0.05\)에서 근사 임계값 \(F_{0.025}(49, 49)\)와 \(F_{0.975}(49, 49)\)를 구하라. 역수 관계로 하나를 다른 하나로 표현하라.
풀이
F-분포표나 소프트웨어에서 \(F_{0.975}(49, 49) \approx 1.762\)이다. 역수 성질에 의해
이다. \(F < 0.568\)이거나 \(F > 1.762\)이면 \(H_0\)을 기각한다. 자유도가 같으면 기각역이 로그 척도에서 1을 중심으로 대칭임에 유의하라: \(\ln(0.568) \approx -0.567\), \(\ln(1.762) \approx 0.567\).
연습문제 5. 어떤 품질 기술자가 두 공장에서 공정의 분산을 측정하여 \(n_1 = 30\)에서 \(S_1^2 = 2.1\)을, \(n_2 = 30\)에서 \(S_2^2 = 3.8\)을 얻었다. 자료는 완만하게 오른쪽으로 치우쳐 있다. F-검정을 써야 하는가? 더 나은 대안을 제시하고 이유를 설명하라.
풀이
자료가 오른쪽으로 치우쳐 F-검정이 요구하는 정규성 가정을 위반하므로 F-검정을 쓰면 안 된다. 완만한 치우침만으로도 오도하는 p-값이 나올 수 있다.
더 나은 대안은 각 집단의 중앙값으로부터의 절대편차를 계산한 뒤 그 편차에 표준 분산분석을 수행하는 Levene 검정이다. 제곱편차가 아니라 절대편차를 쓰므로 치우침과 이상점의 영향을 훨씬 덜 받는다. Python에서는 scipy.stats.levene(data_1, data_2, center='median')이다. 분산비에 대한 검정이 특별히 필요하다면 (분산비를 재표본추출하는) 붓스트랩 접근이 분포에 의존하지 않는 대안이 된다.
연습문제 6. 연습문제 3의 주장을 같은 자료로 두 검정을 돌려 확인하라. 분산의 \(F\) 검정과 평균의 웰치 \(t\) 검정이 비정규성에 각각 얼마나 민감한가?
풀이
import numpy as np
from scipy import stats

def F_p(x, y):
    F = x.var(ddof=1) / y.var(ddof=1)
    d1, d2 = len(x) - 1, len(y) - 1
    return 2 * min(stats.f.cdf(F, d1, d2), stats.f.sf(F, d1, d2))

rng = np.random.default_rng(606)
B = 15_000
dists = {
    "정규": lambda n: rng.normal(0, 1, n),
    "균등": lambda n: rng.uniform(-np.sqrt(3), np.sqrt(3), n),
    "t(8)": lambda n: rng.standard_t(8, n),
    "t(5)": lambda n: rng.standard_t(5, n),
    "지수": lambda n: rng.exponential(1, n),
    "로그정규": lambda n: np.exp(rng.normal(0, 1, n)),
}
print("두 집단 모두 같은 분포에서 (n=25 씩), 명목 0.05")
print(f"{'분포':>20s} {'F 검정(분산)':>12s} {'웰치 t(평균)':>12s}")
for lab, f in dists.items():
    a = b = 0
    for _ in range(B):
        x, y = f(25), f(25)
        a += F_p(x, y) < 0.05
        b += stats.ttest_ind(x, y, equal_var=False).pvalue < 0.05
    print(f"{lab:>20s} {a / B:12.4f} {b / B:12.4f}")
두 집단 모두 같은 분포에서 (n=25 씩), 명목 0.05
                  분포     F 검정(분산)     웰치 t(평균)
                  정규       0.0529       0.0505
                  균등       0.0043       0.0493
                t(8)       0.1115       0.0481
                t(5)       0.1653       0.0481
                  지수       0.2770       0.0477
                로그정규       0.5049       0.0355
로그정규에서 \(F\) 검정의 오류율이 0.505다. 절반이다. 같은 자료의 \(t\) 검정은 0.036으로 멀쩡하다.
| 분포 | \(F\) 검정 | 웰치 \(t\) |
|---|---|---|
| 정규 | 0.053 | 0.051 |
| 균등 | 0.004 | 0.049 |
| \(t(8)\) | 0.112 | 0.048 |
| \(t(5)\) | 0.165 | 0.048 |
| 지수 | 0.277 | 0.048 |
| 로그정규 | 0.505 | 0.036 |
\(t\) 검정은 여섯 분포 모두에서 0.036~0.051을 유지한다. \(F\) 검정은 0.004에서 0.505까지 요동친다.
왜 이렇게 다른가. 두 검정이 기대는 적률의 차수가 다르다.
| 검정 | 통계량의 바탕 | 표집분포가 의존하는 것 |
|---|---|---|
| \(t\) | \(\bar X\) (1차 적률) | 2차 적률(분산) |
| \(F\) | \(S^2\) (2차 적률) | 4차 적률(첨도) |
중심극한정리는 한 차수만 올려 준다. \(\bar X\)의 분포를 정규로 만드는 데 필요한 것은 유한한 분산뿐이다. 반면 \(S^2\)의 표집분포를 알려면 첨도를 알아야 하는데, 중심극한정리는 그것을 정규값 3으로 만들어 주지 않는다.
\(n\to\infty\)에서도 \(\gamma_2\)가 남는다.
균등분포의 0.0043도 잊지 말자. 가벼운 꼬리(\(\gamma_2=-1.2\))에서는 지나치게 보수적이 된다. 검정력을 잃는다는 뜻이다.
이것이 연습문제 3의 정확한 답이다. "\(F\) 검정이 더 민감하다"가 아니라 "\(t\)는 중심극한정리의 보호를 받고 \(F\)는 받지 못한다"가 이유다.
실무 결론. \(t\) 검정은 큰 표본에서 믿어도 되지만, \(F\) 검정은 표본을 아무리 키워도 정규성이 필요하다.
연습문제 7. 연습문제 2의 역수 성질을 이용해 분산비 \(\sigma_1^2/\sigma_2^2\)의 신뢰구간을 유도하고, 실제 피복확률을 재라.
풀이
유도. \(\dfrac{S_1^2/\sigma_1^2}{S_2^2/\sigma_2^2}\sim F(d_1,d_2)\)이므로
이고, 뒤집으면
연습문제 2의 역수 성질 \(F_{\alpha/2}(d_1,d_2)=1/F_{1-\alpha/2}(d_2,d_1)\) 덕분에 표 하나로 양쪽 분위수를 모두 얻을 수 있다. 표를 손으로 보던 시절의 관례가 여기서 왔다.
import numpy as np
from scipy import stats

def ratio_ci(x, y, a=0.05):
    d1, d2 = len(x) - 1, len(y) - 1
    R = x.var(ddof=1) / y.var(ddof=1)
    return R / stats.f.ppf(1 - a / 2, d1, d2), R / stats.f.ppf(a / 2, d1, d2)

rng = np.random.default_rng(707)
B = 10_000
print("참 분산비 = 1 을 덮는 비율 (명목 95%)")
print(f"{'분포':>12s} {'n=25':>8s} {'n=100':>8s}")
for lab, f in {"정규": lambda n: rng.normal(0, 1, n),
               "t(8)": lambda n: rng.standard_t(8, n),
               "t(5)": lambda n: rng.standard_t(5, n),
               "지수": lambda n: rng.exponential(1, n),
               "균등": lambda n: rng.uniform(-1, 1, n)}.items():
    row = []
    for n in [25, 100]:
        c = 0
        for _ in range(B):
            lo, hi = ratio_ci(f(n), f(n))
            c += lo <= 1.0 <= hi
        row.append(c / B)
    print(f"{lab:>12s} {row[0]:8.4f} {row[1]:8.4f}")
참 분산비 = 1 을 덮는 비율 (명목 95%)
          분포     n=25    n=100
          정규   0.9503   0.9495
        t(8)   0.8971   0.8786
        t(5)   0.8345   0.7848
          지수   0.7272   0.6852
          균등   0.9955   0.9969
정규에서는 0.9503으로 정확하다. 근사가 아니라 정확한 구간이기 때문이다.
비정규에서는 무너지고, \(n\)을 늘리면 더 나빠진다.
| 분포 | \(n=25\) | \(n=100\) |
|---|---|---|
| 정규 | 0.950 | 0.950 |
| \(t(8)\) | 0.897 | 0.879 |
| \(t(5)\) | 0.835 | 0.785 |
| 지수 | 0.727 | 0.685 |
| 균등 | 0.996 | 0.997 |
연습문제 6과 같은 이유다. 첨도의 영향이 \(n\)과 함께 사라지지 않는다.
구간이 얼마나 넓은지도 봐야 한다. \(n_1=n_2=25\), \(S_1^2/S_2^2=1\)이면 구간이
이다. 참 분산비가 2여도 이 구간 안에 들어간다. 표본 25개로는 두 배 차이도 구분하지 못한다.
보고 방법. 분산비는 로그 척도에서 대칭이므로
로 쓰면 대칭이 드러난다. "분산비가 1을 중심으로 ±2.3배 범위"라고 말하는 것이 정확하다.
연습문제 8. 연습문제 5의 품질 기술자에게 권할 로버스트 대안을 두 가지 제시하고, 제1종 오류율을 비교하라.
풀이
두 대안.
| 방법 | 발상 |
|---|---|
| 브라운-포사이드 | 중앙값으로부터의 절대편차에 분산분석 |
| 순열검정 | 중심을 맞춘 뒤 라벨을 섞어 영분포를 만든다 |
import numpy as np
from scipy import stats

rng = np.random.default_rng(707)

def perm_p(x, y, rng, R=600):
    """로그 분산비의 순열검정. 중앙값으로 중심을 맞춘 뒤 섞는다."""
    obs = abs(np.log(x.var(ddof=1) / y.var(ddof=1)))
    z = np.concatenate([x - np.median(x), y - np.median(y)])
    n = len(x)
    cnt = 0
    for _ in range(R):
        p = rng.permutation(z)
        cnt += abs(np.log(p[:n].var(ddof=1) / p[n:].var(ddof=1))) >= obs
    return (cnt + 1) / (R + 1)

B = 4_000
print("두 집단의 분산이 실제로 같음, n=25 씩, 명목 0.05")
print(f"{'분포':>12s} {'F 검정':>8s} {'브라운-포사이드':>14s} {'순열(로그 분산비)':>16s}")
for lab, f in {"정규": lambda n: rng.normal(0, 1, n),
               "t(5)": lambda n: rng.standard_t(5, n),
               "지수": lambda n: rng.exponential(1, n),
               "로그정규": lambda n: np.exp(rng.normal(0, 1, n))}.items():
    a = b = c = 0
    for _ in range(B):
        x, y = f(25), f(25)
        F = x.var(ddof=1) / y.var(ddof=1)
        a += 2 * min(stats.f.cdf(F, 24, 24), stats.f.sf(F, 24, 24)) < 0.05
        b += stats.levene(x, y, center="median").pvalue < 0.05
        c += perm_p(x, y, rng) < 0.05
    print(f"{lab:>12s} {a / B:8.4f} {b / B:14.4f} {c / B:16.4f}")
두 집단의 분산이 실제로 같음, n=25 씩, 명목 0.05
          분포     F 검정       브라운-포사이드       순열(로그 분산비)
          정규   0.0520         0.0387           0.0462
        t(5)   0.1658         0.0398           0.0488
          지수   0.2732         0.0460           0.0565
        로그정규   0.5020         0.0430           0.0580
\(F\) 검정만 무너진다.
| 분포 | \(F\) 검정 | 브라운-포사이드 | 순열 |
|---|---|---|---|
| 정규 | 0.052 | 0.039 | 0.046 |
| \(t(5)\) | 0.166 | 0.040 | 0.049 |
| 지수 | 0.273 | 0.046 | 0.057 |
| 로그정규 | 0.502 | 0.043 | 0.058 |
두 대안 모두 0.04~0.06 범위에 머문다. 브라운-포사이드가 약간 보수적(0.039~0.046), 순열검정이 약간 자유롭다(0.046~0.058).
순열검정의 요령이 중요하다. 그냥 원자료를 섞으면 안 된다. 중심이 다르면 분산 차이와 평균 차이가 뒤섞이기 때문이다. 위 코드처럼
z = [x - median(x)] ++ [y - median(y)]
로 각 집단의 중심을 먼저 맞춘 뒤 섞어야 "분산만 같다"는 귀무가설을 제대로 검정한다.
왜 로그 분산비를 쓰는가. \(S_1^2/S_2^2\)은 1을 중심으로 비대칭이다(\([0.5,1]\)과 \([1,2]\)가 같은 크기의 차이인데 길이가 다르다). 로그를 취하면 대칭이 되어 양측검정의 절댓값이 의미를 갖는다.
품질 기술자에게 할 답.
자료가 오른쪽으로 치우쳐 있으므로 \(F\) 검정을 쓰면 안 됩니다. 그 상황에서 \(F\) 검정의 거짓 양성률은 명목 5%가 아니라 최대 50%까지 갑니다.
대신 브라운-포사이드 검정(
scipy.stats.levene의 기본값)을 쓰거나, 표본이 충분하면 순열검정을 쓰십시오. 분산비 2.1 대 3.8(비 1.81)은 \(n=30\)으로는 검정력이 부족할 수 있으므로, 결과와 함께 분산비의 신뢰구간을 보고하는 것이 좋습니다.
덧붙일 것 — 로그 변환. 공정 자료가 오른쪽으로 치우쳐 있다면 애초에 로그 척도에서 분석하는 것이 자연스러울 수 있다. 그러면 정규성과 등분산이 함께 회복되는 경우가 많다.
연습문제 9. 분산비를 검정력 0.80으로 탐지하려면 집단당 표본이 얼마나 필요한가? 평균 비교와 비교하라.
풀이
검정력 식. \(H_1\) 아래에서 \(\dfrac{S_1^2}{S_2^2}\sim r\cdot F(d,d)\)이므로(\(r=\sigma_1^2/\sigma_2^2\))
from scipy import stats

def n_var(ratio, power=0.80, alpha=0.05):
    for n in range(4, 100_000):
        d = n - 1
        lo = stats.f.ppf(alpha / 2, d, d)
        hi = stats.f.ppf(1 - alpha / 2, d, d)
        pw = stats.f.cdf(lo / ratio, d, d) + stats.f.sf(hi / ratio, d, d)
        if pw >= power:
            return n

print(f"{'σ1²/σ2²':>8s} {'집단당 n':>9s}")
for r in [1.5, 2.0, 2.5, 3.0, 4.0]:
    print(f"{r:8.2f} {n_var(r):9d}")
 σ1²/σ2²     집단당 n
    1.50       193
    2.00        68
    2.50        40
    3.00        28
    4.00        19
분산비 2를 탐지하려면 집단당 68개가 필요하다.
평균 비교와 나란히 놓으면.
| 목표 | 집단당 \(n\) |
|---|---|
| 평균 차이 \(d=0.5\)(중간) | 64 |
| 평균 차이 \(d=0.8\)(큼) | 26 |
| 분산비 2.0 | 68 |
| 분산비 1.5 | 193 |
분산비 2가 평균 효과크기 0.5와 비슷한 난이도다. 그런데 분산비 2는 표준편차로 1.41배로, 직관적으로 꽤 큰 차이다.
분산비 1.5(표준편차 1.22배)를 잡으려면 193개가 필요하다. 분산 비교는 평균 비교보다 훨씬 비싸다.
왜 그런가. \(S^2\)의 상대표준오차가
인데, \(\bar X\)의 상대오차와 달리 \(\sqrt2\)라는 상수가 붙고 \(\sigma\)에 무관하다. \(n=68\)이면 11%이므로 두 집단의 비를 볼 때 15% 정도의 오차가 있고, 그 정도면 1.41배 차이를 겨우 구분한다.
실무 함의 셋.
- "분산에 차이가 없다"를 보이려면 표본이 수백 개 필요하다.
- 등분산 검정이 유의하지 않은 것을 등분산의 근거로 삼지 않는다(검정력 부족).
- 애초에 등분산을 가정하지 않는 방법(웰치)을 쓰면 이 문제가 사라진다.
세 번째가 가장 실용적인 결론이다. 등분산을 증명하려 애쓰는 대신 가정하지 않는 것이 표본을 아끼는 길이다.
연습문제 10. 등분산 \(F\) 검정의 사용 지침을 정리하라.
풀이
검정의 구조.
핵심 수치 넷.
| 사실 | 값 |
|---|---|
| 로그정규에서 제1종 오류율 | 0.505 |
| 같은 상황 웰치 \(t\) 검정 | 0.036 |
| 분산비 2 탐지에 필요한 집단당 \(n\) | 68 |
| \(n=25\)에서 분산비의 95% 구간 폭 | \([0.44,\ 2.27]\) |
사용 조건 셋.
| 조건 | 왜 |
|---|---|
| 정규성 | 첨도가 통계량의 분포를 지배 |
| 독립성 | 설계로 확보 |
| 표본이 충분 | 분산 추론은 비싸다 |
첫 줄이 절대적이다. \(t\) 검정과 달리 표본을 키워도 구제되지 않는다(연습문제 6).
결정 흐름.
두 집단의 분산을 비교하려 한다
    │
    ├─ 목적이 "분산분석을 써도 되나" 확인이라면
    │     └─→ 하지 말 것. 웰치를 쓴다
    │
    └─ 분산 자체가 연구 질문이라면
          │
          ├─ 정규성이 보장됨 ──→ F 검정 + 분산비 신뢰구간
          │
          └─ 그 외 ──→ 브라운-포사이드  또는  순열검정
                          (중앙값으로 중심을 맞춘 뒤 섞는다)
방법 비교표.
| 방법 | 정규에서 | 비정규에서 | 비고 |
|---|---|---|---|
| \(F\) 검정 | 0.052 (정확) | 0.502 | 구간을 바로 얻음 |
| 브라운-포사이드 | 0.039 | 0.040~0.046 | 약간 보수적 |
| 순열검정 | 0.046 | 0.049~0.058 | 계산이 무겁다 |
자주 하는 실수 넷.
| 실수 | 결과 |
|---|---|
| 치우친 자료에 그대로 적용 | 오류율 0.50 |
| 단측 \(p\)를 두 배 | 왼쪽 이탈에서 틀림 |
| 유의하지 않음 → "등분산" | \(n=30\)의 검정력은 낮다 |
| 원자료를 그냥 섞는 순열검정 | 평균 차이가 섞여 들어감 |
보고 형식.
공장 A: n = 30, S² = 2.10
공장 B: n = 30, S² = 3.80
분산비 = 0.553

자료가 오른쪽으로 치우쳐 F 검정은 부적절.
브라운-포사이드 검정: W = ..., p = ...
분산비의 95% 부트스트랩 구간: [..., ...]
분산비와 그 구간을 항상 함께 적는다. \(p\)만으로는 "얼마나 다른가"를 알 수 없다.
한 문장. 등분산 \(F\) 검정은 정규성 위에서만 정확하며, 그 조건을 확인할 수 없다면 브라운-포사이드나 순열검정으로 바꾸는 것이 옳다.
정리하며
등분산 \(F\) 검정은 고전적이지만 실무에서는 밀려났다.
- 정규성 위반에 극도로 민감하다. 꼬리가 조금만 두꺼워도 제1종 오류율이 명목값을 크게 넘으며, 분산이 같아도 기각한다.
- 그래서 레빈 검정이 선호된다. 다음 절의 주제이며, 정규성에 훨씬 덜 민감하다.
- 분산분석 \(F\) 검정과 이름은 같지만 다른 검정이다. 여기서는 두 분산의 비를 보고, 분산분석에서는 집단 간·집단 내 분산의 비를 본다. 같은 분포를 참조할 뿐이다.
- 정당한 용도는 분산 자체가 관심사일 때다. 두 공정의 변동 비교 같은 경우이며, 그때도 정규성을 먼저 확인해야 한다.
- 합동 \(t\) 검정이나 분산분석의 사전 확인용으로 쓰지 말 것. 2단계 절차의 문제에 더해 이 검정 자체가 믿을 수 없다.
다음 절 Levene 검정으로 넘어간다.